Artikel über maschinelles Lernen im Handel.

Erstellen von KI-basierten Handelsrobotern: native Integration der Bibliotheken für Python, Matrizen und Vektoren, Mathematik und Statistik und vieles mehr.
Finden Sie heraus, wie Sie maschinelles Lernen im Handel einsetzen können. Neuronen, Perzeptronen, Faltungs- und rekurrente Netze, Vorhersagemodelle – beginnen Sie mit den Grundlagen und arbeiten Sie sich bis zur Entwicklung Ihrer eigenen KI vor. Sie lernen, wie man neuronale Netze für den algorithmischen Handel auf Finanzmärkten trainiert und anwendet.
Neuer Artikel

Sie verpassen Handelsmöglichkeiten:
- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Registrierung
Einloggen
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Wenn Sie kein Benutzerkonto haben, registrieren Sie sich


MQL5-Assistent-Techniken, die Sie kennen sollten (Teil 22): Conditional GANs
Generative Adversarial Networks (GAN) sind eine Kombination von neuronalen Netzen, die sich gegenseitig trainieren, um genauere Ergebnisse zu erzielen. Wir nehmen den bedingten Typ dieser Netze an, da wir eine mögliche Anwendung bei der Vorhersage von Finanzzeitreihen innerhalb einer Klasse von Expertensignalen anstreben.

MQL5-Assistent-Techniken, die Sie kennen sollten (Teil 31): Auswahl der Verlustfunktion
Die Verlustfunktion ist die wichtigste Kennzahl für Algorithmen des maschinellen Lernens, die eine Rückmeldung für den Trainingsprozess liefert, indem sie angibt, wie gut ein bestimmter Satz von Parametern im Vergleich zum beabsichtigten Ziel funktioniert. Wir untersuchen die verschiedenen Formate dieser Funktion in einer nutzerdefinierten MQL5-Assistenten-Klasse.


Gating-Mechanismen beim Ensemblelernen
In diesem Artikel setzen wir unsere Untersuchung von Ensemblemodellen fort, indem wir das Konzept der Gates erörtern, insbesondere wie sie bei der Kombination von Modellergebnissen nützlich sein können, um entweder die Vorhersagegenauigkeit oder die Modellgeneralisierung zu verbessern.


Die Grenzen des maschinellen Lernens überwinden (Teil 4): Überwindung des irreduziblen Fehlers durch mehrere Prognosehorizonte
Maschinelles Lernen wird oft durch die Brille der Statistik oder der linearen Algebra betrachtet, aber dieser Artikel betont eine geometrische Perspektive der Modellvorhersagen. Sie zeigt, dass sich die Modelle dem Ziel nicht wirklich annähern, sondern es auf ein neues Koordinatensystem abbilden, was zu einer inhärenten Fehlausrichtung führt, die irreduzible Fehler zur Folge hat. In dem Artikel wird vorgeschlagen, dass mehrstufige Vorhersagen, bei denen die Prognosen des Modells über verschiedene Zeithorizonte hinweg verglichen werden, einen effektiveren Ansatz darstellen als direkte Vergleiche mit dem Ziel. Durch die Anwendung dieser Methode auf ein Handelsmodell zeigt der Artikel erhebliche Verbesserungen der Rentabilität und Genauigkeit, ohne das zugrunde liegende Modell zu verändern.


Nutzung des CatBoost Machine Learning Modells als Filter für Trendfolgestrategien
CatBoost ist ein leistungsfähiges, baumbasiertes, maschinelles Lernmodell, das auf die Entscheidungsfindung auf der Grundlage stationärer Merkmale spezialisiert ist. Andere baumbasierte Modelle wie XGBoost und Random Forest haben ähnliche Eigenschaften in Bezug auf ihre Robustheit, ihre Fähigkeit, komplexe Muster zu verarbeiten, und ihre Interpretierbarkeit. Diese Modelle haben ein breites Anwendungsspektrum, das von der Merkmalsanalyse bis zum Risikomanagement reicht.


Aufbau eines Remote-Forex-Risikomanagementsystems in Python
Wir entwickeln einen professionellen Remote-Risikomanager für Forex in Python, der Schritt für Schritt auf dem Server installiert wird. Im Laufe des Artikels werden wir verstehen, wie man die Forex-Risiken programmatisch verwalten kann und wie man eine Forex-Einlage nicht mehr verschwenden kann.

Algorithmus einer chemischen Reaktionsoptimierung (CRO) (Teil I): Prozesschemie in der Optimierung
Im ersten Teil dieses Artikels werden wir in die Welt der chemischen Reaktionen eintauchen und einen neuen Ansatz zur Optimierung entdecken! Die chemische Reaktionsoptimierung (CRO) nutzt Prinzipien, die sich aus den Gesetzen der Thermodynamik ableiten, um effiziente Ergebnisse zu erzielen. Wir werden die Geheimnisse der Zersetzung, der Synthese und anderer chemischer Prozesse lüften, die die Grundlage für diese innovative Methode bilden.
Die Grenzen des maschinellen Lernens überwinden (Teil 4): Überwindung des irreduziblen Fehlers durch mehrere Prognosehorizonte
Maschinelles Lernen wird oft durch die Brille der Statistik oder der linearen Algebra betrachtet, aber dieser Artikel betont eine geometrische Perspektive der Modellvorhersagen. Sie zeigt, dass sich die Modelle dem Ziel nicht wirklich annähern, sondern es auf ein neues Koordinatensystem abbilden, was zu einer inhärenten Fehlausrichtung führt, die irreduzible Fehler zur Folge hat. In dem Artikel wird vorgeschlagen, dass mehrstufige Vorhersagen, bei denen die Prognosen des Modells über verschiedene Zeithorizonte hinweg verglichen werden, einen effektiveren Ansatz darstellen als direkte Vergleiche mit dem Ziel. Durch die Anwendung dieser Methode auf ein Handelsmodell zeigt der Artikel erhebliche Verbesserungen der Rentabilität und Genauigkeit, ohne das zugrunde liegende Modell zu verändern.


Aufbau des Kerzenmodells Trend-Constraint (Teil 9): Expert Advisor für mehrere Strategien (I)
Heute werden wir die Möglichkeiten der Einbindung mehrerer Strategien in einen Expert Advisor (EA) mit MQL5 untersuchen. Expert Advisors bieten umfassendere Funktionen als nur Indikatoren und Skripte und ermöglichen anspruchsvollere Handelsansätze, die sich an veränderte Marktbedingungen anpassen können. Mehr dazu finden Sie in der Erörterung dieses Artikels.


Erforschung fortgeschrittener maschineller Lerntechniken bei der Darvas Box Breakout Strategie
Die von Nicolas Darvas entwickelte Darvas-Box-Breakout-Strategie ist ein technischer Handelsansatz, der potenzielle Kaufsignale erkennt, wenn der Kurs einer Aktie über einen festgelegten Bereich der „Box“ ansteigt, was auf eine starke Aufwärtsdynamik hindeutet. In diesem Artikel werden wir dieses Strategiekonzept als Beispiel anwenden, um drei fortgeschrittene Techniken des maschinellen Lernens zu untersuchen. Dazu gehören die Verwendung eines maschinellen Lernmodells zur Generierung von Signalen anstelle von Handelsfiltern, die Verwendung von kontinuierlichen Signalen anstelle von diskreten Signalen und die Verwendung von Modellen, die auf verschiedenen Zeitrahmen trainiert wurden, um Handelsgeschäfte zu bestätigen.

Datenwissenschaft und ML (Teil 42): Forex-Zeitreihenvorhersage mit ARIMA in Python, alles was Sie wissen müssen
ARIMA, kurz für Auto Regressive Integrated Moving Average, ist ein leistungsfähiges traditionelles Zeitreihenprognosemodell. Mit der Fähigkeit, Spitzen und Schwankungen in Zeitreihendaten zu erkennen, kann dieses Modell genaue Vorhersagen über die nächsten Werte machen. In diesem Artikel werden wir verstehen, was es ist, wie es funktioniert, was Sie damit tun können, wenn es um die Vorhersage der nächsten Preise auf dem Markt mit hoher Genauigkeit und vieles mehr.

Trendvorhersage mit LSTM für Trendfolgestrategien
Long Short-Term Memory (LSTM) ist eine Art rekurrentes neuronales Netz (RNN), das für die Modellierung sequenzieller Daten entwickelt wurde, indem es langfristige Abhängigkeiten effektiv erfasst und das Problem des verschwindenden Gradienten löst. In diesem Artikel werden wir untersuchen, wie LSTM zur Vorhersage zukünftiger Trends eingesetzt werden kann, um die Leistung von Trendfolgestrategien zu verbessern. Der Artikel behandelt die Einführung von Schlüsselkonzepten und die Motivation hinter der Entwicklung, das Abrufen von Daten aus dem MetaTrader 5, die Verwendung dieser Daten zum Trainieren des Modells in Python, die Integration des maschinellen Lernmodells in MQL5 und die Reflexion der Ergebnisse und zukünftigen Bestrebungen auf der Grundlage von statistischem Backtesting.


MQL5-Assistenten-Techniken, die Sie kennen sollten (Teil 28): GANs überarbeitet mit einer Anleitung zu Lernraten
Die Lernrate ist eine Schrittgröße in Richtung eines Trainingsziels in den Trainingsprozessen vieler maschineller Lernalgorithmen. Wir untersuchen die Auswirkungen, die die vielen Zeitpläne und Formate auf die Leistung eines Generative Adversarial Network haben können, eine Art neuronales Netz, das wir in einem früheren Artikel untersucht haben.

Erstellen von selbstoptimierenden Expert Advisor in MQL5 (Teil 8): Analyse mehrerer Strategien
Wie können wir mehrere Strategien am besten kombinieren, um eine leistungsfähige Gesamtstrategie zu schaffen? Nehmen Sie an dieser Diskussion teil, in der wir drei verschiedene Strategien in unsere Handelsanwendung einbauen wollen. Händler verwenden oft spezielle Strategien für die Eröffnung und Schließung von Positionen, und wir wollen wissen, ob unsere Maschinen diese Aufgabe besser erfüllen können. In unserer einleitenden Diskussion machen wir uns mit den Fähigkeiten des Strategietesters und den Prinzipien der OOP vertraut, die wir für diese Aufgabe benötigen.


Datenwissenschaft und ML (Teil 47): Marktprognosen mithilfe des DeepAR-Modells in Python
In diesem Artikel werden wir versuchen, den Markt mit einem soliden Modell für Zeitreihenprognosen namens DeepAR vorherzusagen. Ein Modell, das eine Kombination aus tiefen neuronalen Netzen und autoregressiven Eigenschaften darstellt, die in Modellen wie ARIMA und Vector Autoregressive (VAR) zu finden sind.


Algorithmus einer Anarchischen Gesellschaftsoptimierung (ASO)
In diesem Artikel machen wir uns mit dem Algorithmus Anarchic Society Optimization (Anarchischen Gesellschaftsoptimierung, ASO) vertraut und erörtern, wie ein Algorithmus, der auf dem irrationalen und abenteuerlichen Verhalten von Teilnehmern in einer anarchischen Gesellschaft (einem anomalen System sozialer Interaktion, das frei von zentraler Macht und verschiedenen Arten von Hierarchien ist) basiert, in der Lage ist, den Lösungsraum zu erkunden und die Fallen des lokalen Optimums zu vermeiden. Der Artikel stellt eine einheitliche ASO-Struktur vor, die sowohl auf kontinuierliche als auch auf diskrete Probleme anwendbar ist.


Verschaffen Sie sich einen Vorteil auf jedem Markt (Teil IV): CBOE: Volatilitätsindizes von Euro und Gold
Wir werden alternative, von der Chicago Board Of Options Exchange (CBOE) kuratierte Daten analysieren, um die Genauigkeit unserer tiefen neuronalen Netze bei der Vorhersage des XAUEUR-Symbols zu verbessern.


Vorhersage von Wechselkursen mit klassischen Methoden des maschinellen Lernens: Logit- und Probit-Modelle
In diesem Artikel wird der Versuch unternommen, einen Handels-EA zur Vorhersage von Wechselkursen zu erstellen. Der Algorithmus basiert auf klassischen Klassifikationsmodellen - logistische und Probit-Regression. Das Kriterium des Wahrscheinlichkeitsquotienten wird als Filter für Handelssignale verwendet.


Neuronale Netze leicht gemacht (Teil 85): Multivariate Zeitreihenvorhersage
In diesem Artikel möchte ich Ihnen eine neue komplexe Methode zur Zeitreihenprognose vorstellen, die die Vorteile von linearen Modellen und Transformer harmonisch vereint.

Nachbarschaftsübergreifende Suche (ANS)
Der Artikel zeigt das Potenzial des ANS-Algorithmus als einen wichtigen Schritt in der Entwicklung flexibler und intelligenter Optimierungsmethoden, die die Besonderheiten des Problems und die Dynamik der Umgebung im Suchraum berücksichtigen können.

Integration von MQL5 mit Datenverarbeitungspaketen (Teil 4): Umgang mit großen Daten
Dieser Teil befasst sich mit fortgeschrittenen Techniken zur Integration von MQL5 mit leistungsstarken Datenverarbeitungswerkzeugen und konzentriert sich auf den effizienten Umgang mit Big Data zur Verbesserung der Handelsanalyse und Entscheidungsfindung.

Diskretisierungsmethoden für Preisbewegungen in Python
Wir werden uns die Preisdiskretisierungsmethoden mit Python und MQL5 ansehen. In diesem Artikel werde ich meine praktischen Erfahrungen mit der Entwicklung einer Python-Bibliothek teilen, die eine breite Palette von Ansätzen zur Balkenbildung implementiert – von klassischen Volumen- und Range Bars bis hin zu exotischeren Methoden wie Renko und Kagi. Wir werden Drei-Linien-Durchbruchskerzen und Range-Bars betrachten, ihre Statistiken analysieren und versuchen zu definieren, wie die Preise sonst noch diskret dargestellt werden können.


Pipelines in MQL5
In diesem Beitrag befassen wir uns mit einem wichtigen Schritt der Datenaufbereitung für das maschinelle Lernen, der zunehmend an Bedeutung gewinnt. Pipelines für die Datenvorverarbeitung. Dabei handelt es sich im Wesentlichen um eine rationalisierte Abfolge von Datenumwandlungsschritten, mit denen Rohdaten aufbereitet werden, bevor sie in ein Modell eingespeist werden. So uninteressant dies für den Laien auch erscheinen mag, diese „Datenstandardisierung“ spart nicht nur Trainingszeit und Ausführungskosten, sondern trägt auch zu einer besseren Generalisierung bei. In diesem Artikel konzentrieren wir uns auf einige SCIKIT-LEARN Vorverarbeitungsfunktionen, und während wir den MQL5-Assistenten nicht ausnutzen, werden wir in späteren Artikeln darauf zurückkommen.


Der Optimierungsalgorithmus Brain Storm (Teil II): Multimodalität
Im zweiten Teil des Artikels werden wir uns mit der praktischen Implementierung des BSO-Algorithmus befassen, Tests mit Testfunktionen durchführen und die Effizienz von BSO mit anderen Optimierungsmethoden vergleichen.


Klassische Strategien neu interpretieren (Teil IX): Analyse mehrerer Zeitrahmen (II)
In der heutigen Diskussion untersuchen wir die Strategie der Analyse mehrerer Zeitrahmen, um zu erfahren, in welchem Zeitrahmen unser KI-Modell am besten abschneidet. Unsere Analyse führt uns zu dem Schluss, dass die monatlichen und stündlichen Zeitrahmen Modelle mit relativ niedrigen Fehlerquoten für das EURUSD-Paar ergeben. Wir haben dies zu unserem Vorteil genutzt und einen Handelsalgorithmus entwickelt, der KI-Prognosen auf dem monatlichen Zeitrahmen erstellt und seine Handelsgeschäfte auf dem stündlichen Zeitrahmen ausführt.


Klassische Strategien neu interpretieren (Teil 13): Unsere Kreuz-Strategie in neue Dimensionen führen (Teil 2)
Nehmen Sie an unserer Diskussion teil, in der wir nach weiteren Verbesserungen für unsere Strategie des Kreuzens von gleitenden Durchschnitten suchen, um die Verzögerung in unserer Handelsstrategie durch den Einsatz unserer Kompetenzen im Bereich Data Science auf ein zuverlässigeres Niveau zu reduzieren. Es ist eine gut untersuchte Tatsache, dass die Projektion Ihrer Daten in höhere Dimensionen manchmal die Leistung Ihrer Machine-Learning-Modelle verbessern kann. Wir zeigen Ihnen, was dies für Sie als Händler konkret bedeutet, und veranschaulichen, wie Sie dieses leistungsstarke Prinzip mit Ihrem MetaTrader 5-Terminal für sich nutzen können.

Neuronale Netze leicht gemacht (Teil 86): U-förmiger Transformator
Wir untersuchen weiterhin Algorithmen für die Zeitreihenprognose. In diesem Artikel werden wir eine andere Methode besprechen: den U-förmigen Transformator.


Generative Adversarial Networks (GANs) für synthetische Daten in der Finanzmodellierung (Teil 2): Erstellen eines synthetischen Symbols für Tests
In diesem Artikel erstellen wir ein synthetisches Symbol mit Hilfe eines Generative Adversarial Network (GAN), das realistische Finanzdaten generiert, die das Verhalten tatsächlicher Marktinstrumente, wie z. B. EURUSD, nachahmen. Das GAN-Modell lernt Muster und Volatilität aus historischen Marktdaten und erstellt synthetische Preisdaten mit ähnlichen Merkmalen.


Datenwissenschaft und ML (Teil 36): Der Umgang mit verzerrten Finanzmärkten
Die Finanzmärkte sind nicht vollkommen ausgeglichen. Einige Märkte steigen, andere fallen, und wieder andere zeigen ein gewisses Schwankungsverhalten, das auf Unsicherheit in beide Richtungen hindeutet. Diese unausgewogenen Informationen können beim Trainieren von Machine-Learning-Modellen irreführend sein, da sich die Märkte häufig ändern. In diesem Artikel werden wir verschiedene Möglichkeiten erörtern, dieses Problem zu lösen.


MQL5-Assistenten-Techniken, die Sie kennen sollten (Teil 43): Reinforcement Learning mit SARSA
SARSA, eine Abkürzung für State-Action-Reward-State-Action, ist ein weiterer Algorithmus, der bei der Implementierung von Reinforcement Learning verwendet werden kann. Wie bei Q-Learning und DQN haben wir also untersucht, wie dies als unabhängiges Modell und nicht nur als Trainingsmechanismus in assistentengestützten Expert Advisors implementiert werden kann.

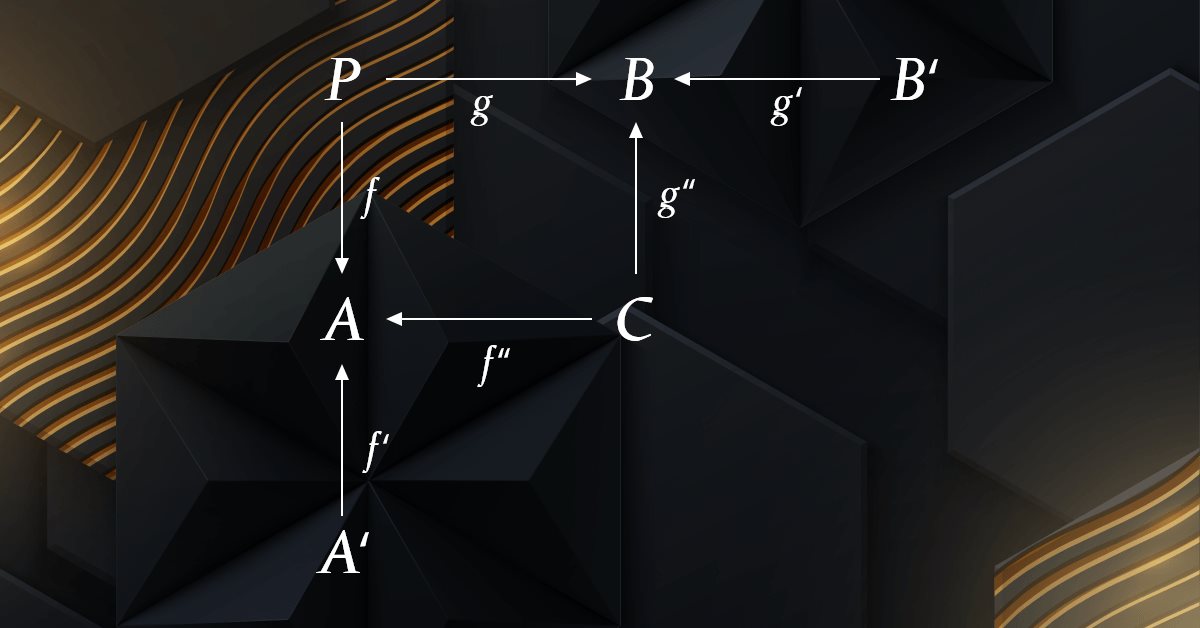
Kategorientheorie in MQL5 (Teil 4): Spannen, Experimente und Kompositionen
Die Kategorientheorie ist ein vielfältiger und expandierender Zweig der Mathematik, der in der MQL-Gemeinschaft noch relativ unentdeckt ist. In dieser Artikelserie sollen einige der Konzepte vorgestellt und untersucht werden, mit dem übergeordneten Ziel, eine offene Bibliothek einzurichten, die Einblicke gewährt und hoffentlich die Nutzung dieses bemerkenswerten Bereichs für die Strategieentwicklung von Händlern fördert.

Developing an MQL5 Reinforcement Learning agent with RestAPI integration (Part 1): How to use RestAPIs in MQL5
In this article we will talk about the importance of APIs (Application Programming Interface) for interaction between different applications and software systems. We will see the role of APIs in simplifying interactions between applications, allowing them to efficiently share data and functionality.

Die Gruppenmethode der Datenverarbeitung: Implementierung des Kombinatorischen Algorithmus in MQL5
In diesem Artikel setzen wir unsere Untersuchung der Algorithmenfamilie Group Method of Data Handling mit der Implementierung des Kombinatorischen Algorithmus und seiner verfeinerten Variante, dem Kombinatorischen Selektiven Algorithmus in MQL5 fort.

Neuronale Netze leicht gemacht (Teil 91): Vorhersage durch Frequenzbereiche (Frequency Domain Forecasting, FreDF)
Wir fahren fort mit der Analyse und Vorhersage von Zeitreihen im Frequenzbereich. In diesem Artikel machen wir uns mit einer neuen Methode zur Vorhersage von Daten im Frequenzbereich vertraut, die zu vielen der bisher untersuchten Algorithmen hinzugefügt werden kann.


Selbstoptimierender Expert Advisor mit MQL5 und Python (Teil IV): Stacking-Modelle
Heute werden wir Ihnen zeigen, wie Sie KI-gestützte Handelsanwendungen entwickeln können, die aus ihren eigenen Fehlern lernen. Wir werden eine Technik demonstrieren, die als Stacking bekannt ist und bei der wir 2 Modelle verwenden, um eine Vorhersage zu treffen. Das erste Modell ist in der Regel ein schwächerer Lerner, und das zweite Modell ist in der Regel ein leistungsfähigeres Modell, das die Residuen unseres schwächeren Lerners lernt. Unser Ziel ist es, ein Ensemble von Modellen zu erstellen, um hoffentlich eine höhere Genauigkeit zu erreichen.


Erforschung des maschinellen Lernens im unidirektionalen Trendhandel am Beispiel von Gold
In diesem Artikel wird ein Ansatz erörtert, der darauf abzielt, nur in der gewählten Richtung (Kauf oder Verkauf) zu handeln. Zu diesem Zweck werden die Technik der kausalen Inferenz und des maschinellen Lernens eingesetzt.

Datenwissenschaft und ML (Teil 35): NumPy in MQL5 - Die Kunst, komplexe Algorithmen mit weniger Code zu erstellen
Die NumPy-Bibliothek treibt fast alle Algorithmen des maschinellen Lernens in der Programmiersprache Python an. In diesem Artikel werden wir ein ähnliches Modul implementieren, das eine Sammlung des gesamten komplexen Codes enthält, um uns bei der Erstellung anspruchsvoller Modelle und Algorithmen jeglicher Art zu unterstützen.


Algorithmus für die künstliche, kooperative Suche (Artificial Cooperative Search, ACS)
Die künstliche, kooperative Suche (Artificial Cooperative Search, ACS) ist eine innovative Methode, bei der eine binäre Matrix und mehrere dynamische Populationen auf der Grundlage von wechselseitigen Beziehungen und Kooperation verwendet werden, um schnell und genau optimale Lösungen zu finden. Der einzigartige Ansatz von ACS in Bezug auf Räuber und Beute ermöglicht es, hervorragende Ergebnisse bei numerischen Optimierungsproblemen zu erzielen.


MQL5-Assistenten-Techniken, die Sie kennen sollten (Teil 35): Support-Vektor-Regression
Die Support-Vektor-Regression ist eine idealistische Methode, um eine Funktion oder „Hyperebene“ zu finden, die die Beziehung zwischen zwei Datensätzen am besten beschreibt. Wir versuchen, dies bei der Zeitreihenprognose innerhalb der nutzerdefinierten Klassen des MQL5-Assistenten auszunutzen.


Datenwissenschaft und ML (Teil 38): AI Transfer Learning auf den Forexmärkten
Die KI-Durchbrüche, die die Schlagzeilen beherrschen, von ChatGPT bis hin zu selbstfahrenden Autos, entstehen nicht durch isolierte Modelle, sondern durch kumulatives Wissen, das aus verschiedenen Modellen oder gemeinsamen Bereichen übertragen wird. Jetzt kann derselbe Ansatz "einmal lernen, überall anwenden" angewandt werden, um unsere KI-Modelle im algorithmischen Handel zu transformieren. In diesem Artikel erfahren wir, wie wir die aus verschiedenen Instrumenten gewonnenen Informationen nutzen können, um mit Hilfe von Transfer Learning die Vorhersagen für andere Instrumente zu verbessern.