Artikel über maschinelles Lernen im Handel.

Erstellen von KI-basierten Handelsrobotern: native Integration der Bibliotheken für Python, Matrizen und Vektoren, Mathematik und Statistik und vieles mehr.
Finden Sie heraus, wie Sie maschinelles Lernen im Handel einsetzen können. Neuronen, Perzeptronen, Faltungs- und rekurrente Netze, Vorhersagemodelle – beginnen Sie mit den Grundlagen und arbeiten Sie sich bis zur Entwicklung Ihrer eigenen KI vor. Sie lernen, wie man neuronale Netze für den algorithmischen Handel auf Finanzmärkten trainiert und anwendet.
Neuer Artikel

Sie verpassen Handelsmöglichkeiten:
- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Registrierung
Einloggen
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Wenn Sie kein Benutzerkonto haben, registrieren Sie sich


Neuronale Netze leicht gemacht (Teil 38): Selbstüberwachte Erkundung bei Unstimmigkeit (Self-Supervised Exploration via Disagreement)
Eines der Hauptprobleme beim Verstärkungslernen ist die Erkundung der Umgebung. Zuvor haben wir bereits die Forschungsmethode auf der Grundlage der intrinsischen Neugier kennengelernt. Heute schlage ich vor, einen anderen Algorithmus zu betrachten: Erkundung bei Unstimmigkeit.

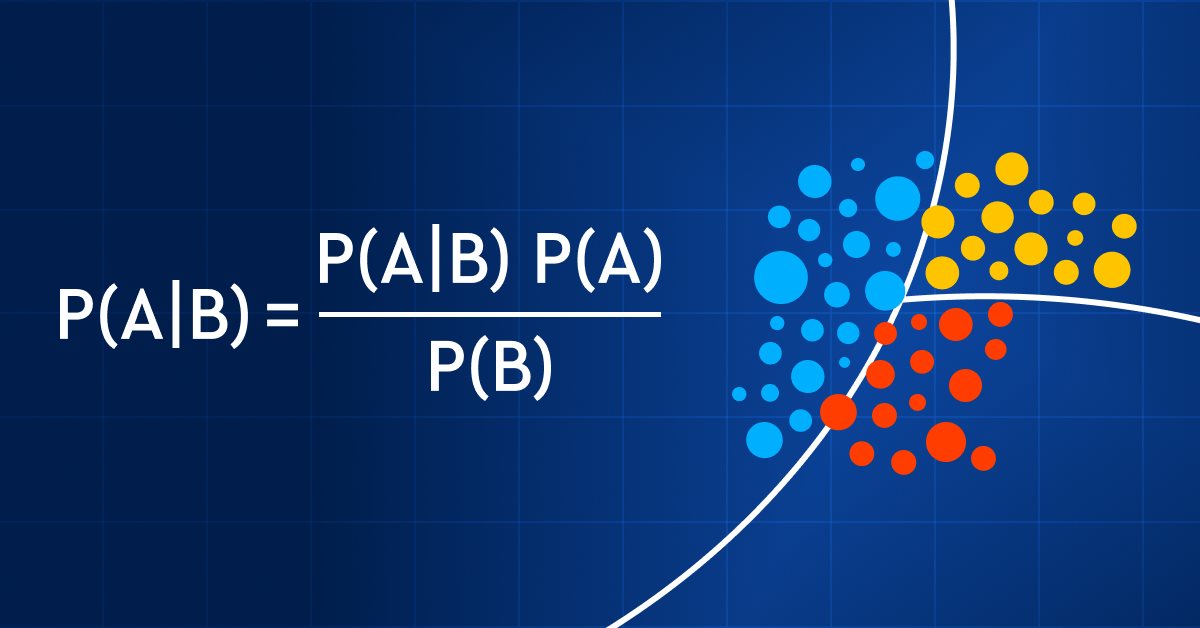
Datenwissenschaft und maschinelles Lernen (Teil 11): Naïve Bayes, Wahrscheinlichkeitsrechnung im Handel
Der Handel mit Wahrscheinlichkeiten ist wie ein Drahtseilakt - er erfordert Präzision, Ausgewogenheit und ein ausgeprägtes Risikobewusstsein. In der Welt des Handels ist die Wahrscheinlichkeit alles. Das ist der Unterschied zwischen Erfolg und Misserfolg, Gewinn und Verlust. Indem sie sich die Macht der Wahrscheinlichkeit zunutze machen, können Händler fundierte Entscheidungen treffen, Risiken effektiv verwalten und ihre finanziellen Ziele erreichen. Ob Sie nun ein erfahrener Anleger oder ein Anfänger sind, das Verständnis der Wahrscheinlichkeit ist der Schlüssel zur Entfaltung Ihres Handelspotenzials. In diesem Artikel werden wir die aufregende Welt des Handels mit Wahrscheinlichkeiten erkunden und Ihnen zeigen, wie Sie Ihr Handelsspiel auf die nächste Stufe heben können.


Datenwissenschaft und ML (Teil 27): Convolutional Neural Networks (CNNs) in MetaTrader 5 Trading Bots — funktioniert das?
Faltende neuronale Netzwerke (Convolutional Neural Networks, CNN) sind für ihre Fähigkeiten bei der Erkennung von Mustern in Bildern und Videos bekannt und werden in den verschiedensten Bereichen eingesetzt. In diesem Artikel untersuchen wir das Potenzial von CNNs zur Erkennung wertvoller Muster auf den Finanzmärkten und zur Erzeugung effektiver Handelssignale für MetaTrader 5-Handelsroboter. Lassen Sie uns herausfinden, wie diese tiefgehende maschinelle Lerntechnik für intelligentere Handelsentscheidungen genutzt werden kann.


Metamodelle für maschinelles Lernen und Handel: Ursprünglicher Zeitpunkt der Handelsaufträge
Metamodelle im maschinellen Lernen: Automatische Erstellung von Handelssystemen mit wenig oder gar keinem menschlichen Eingriff — Das Modell entscheidet selbständig, wann und wie es handelt.

Neuronale Netze leicht gemacht (Teil 32): Verteiltes Q-Learning
Wir haben die Q-Learning-Methode in einem der früheren Artikel dieser Serie kennengelernt. Bei dieser Methode werden die Belohnungen für jede Aktion gemittelt. Im Jahr 2017 wurden zwei Arbeiten vorgestellt, die einen größeren Erfolg bei der Untersuchung der Belohnungsverteilungsfunktion zeigen. Wir sollten die Möglichkeit in Betracht ziehen, diese Technologie zur Lösung unserer Probleme einzusetzen.


Algorithmen zur Optimierung mit Populationen: Evolutionsstrategien, (μ,λ)-ES und (μ+λ)-ES
Der Artikel behandelt eine Gruppe von Optimierungsalgorithmen, die als Evolutionsstrategien (ES) bekannt sind. Sie gehören zu den allerersten Populationsalgorithmen, die evolutionäre Prinzipien für die Suche nach optimalen Lösungen nutzen. Wir werden Änderungen an den herkömmlichen ES-Varianten vornehmen und die Testfunktion und die Prüfstandsmethodik für die Algorithmen überarbeiten.


Neuronale Netze leicht gemacht (Teil 33): Quantilsregression im verteilten Q-Learning
Wir setzen die Untersuchung des verteilten Q-Learnings fort. Heute wollen wir diesen Ansatz von der anderen Seite her betrachten. Wir werden die Möglichkeit prüfen, die Quantilsregression zur Lösung von Preisvorhersageaufgaben einzusetzen.


Datenwissenschaft und maschinelles Lernen (Teil 12): Können selbstlernende neuronale Netze Ihnen helfen, den Aktienmarkt zu überlisten?
Sind Sie es leid, ständig zu versuchen, den Aktienmarkt vorherzusagen? Hätten Sie gerne eine Kristallkugel, die Ihnen hilft, fundiertere Investitionsentscheidungen zu treffen? Selbst trainierte neuronale Netze könnten die Lösung sein, nach der Sie schon lange gesucht haben. In diesem Artikel gehen wir der Frage nach, ob diese leistungsstarken Algorithmen Ihnen helfen können, „die Welle zu reiten“ und den Aktienmarkt zu überlisten. Durch die Analyse großer Datenmengen und die Erkennung von Mustern können selbst trainierte neuronale Netze Vorhersagen treffen, die oft genauer sind als die von menschlichen Händlern. Entdecken Sie, wie Sie diese Spitzentechnologie nutzen können, um Ihre Gewinne zu maximieren und intelligentere Investitionsentscheidungen zu treffen.


Datenwissenschaft und ML (Teil 31): CatBoost AI-Modelle für den Handel verwenden
CatBoost-KI-Modelle haben in letzter Zeit aufgrund ihrer Vorhersagegenauigkeit, Effizienz und Robustheit gegenüber verstreuten und schwierigen Datensätzen in der Community des maschinellen Lernens stark an Popularität gewonnen. In diesem Artikel werden wir im Detail erörtern, wie man diese Art von Modellen in einem Versuch, den Forex-Markt zu schlagen zu implementieren.

Neuronale Netze leicht gemacht (Teil 22): Unüberwachtes Lernen von rekurrenten Modellen
Wir untersuchen weiterhin Modelle und Algorithmen für unüberwachtes Lernen. Diesmal schlage ich vor, dass wir die Eigenschaften von AutoAutoencodern bei der Anwendung auf das Training rekurrenter Modelle diskutieren.

Bauen Sie Ihr erstes Modell einer Glass-Box mit Python und MQL5
Modelle des maschinellen Lernens sind schwer zu interpretieren, und das Verständnis dafür, warum unsere Modelle von unseren Erwartungen abweichen, ist von entscheidender Bedeutung, wenn wir einen Nutzen aus dem Einsatz dieser fortschrittlichen Techniken ziehen wollen. Ohne einen umfassenden Einblick in das Innenleben unseres Modells könnten wir Fehler nicht erkennen, die die Leistung unseres Modells beeinträchtigen, wir könnten Zeit mit der Entwicklung von Funktionen verschwenden, die nicht vorhersagbar sind, und langfristig riskieren wir, die Leistungsfähigkeit dieser Modelle nicht voll auszuschöpfen. Glücklicherweise gibt es eine ausgeklügelte und gut gewartete Komplettlösung, mit der wir genau sehen können, was unser Modell unter seiner Haube macht.

Neuronale Netze leicht gemacht (Teil 31): Evolutionäre Algorithmen
Im vorangegangenen Artikel haben wir uns mit nicht-gradientenbasierten Optimierungsmethoden befasst. Wir haben uns mit dem genetischen Algorithmus vertraut gemacht. Heute werden wir dieses Thema fortsetzen und eine andere Klasse von evolutionären Algorithmen besprechen.

Integrieren Sie Ihr eigenes LLM in EA (Teil 4): Trainieren Sie Ihr eigenes LLM mit GPU
Angesichts der rasanten Entwicklung der künstlichen Intelligenz sind Sprachmodelle (language models, LLMs) heute ein wichtiger Bestandteil der künstlichen Intelligenz, sodass wir darüber nachdenken sollten, wie wir leistungsstarke LLMs in unseren algorithmischen Handel integrieren können. Für die meisten Menschen ist es schwierig, diese leistungsstarken Modelle auf ihre Bedürfnisse abzustimmen, sie lokal einzusetzen und sie dann auf den algorithmischen Handel anzuwenden. In dieser Artikelserie werden wir Schritt für Schritt vorgehen, um dieses Ziel zu erreichen.

Algorithmen zur Populationsoptimierung Optimierung mit invasiven Unkräutern (IWO)
Die erstaunliche Fähigkeit von Unkräutern, unter verschiedensten Bedingungen zu überleben, wurde zur Idee für einen leistungsstarken Optimierungsalgorithmus. IWO (Invasive Weed Optimization) ist einer der besten Algorithmen unter den bisher geprüften.

Experimente mit neuronalen Netzen (Teil 7): Übergabe von Indikatoren
Beispiele für die Übergabe von Indikatoren an ein Perzeptron. Der Artikel beschreibt allgemeine Konzepte und stellt den einfachsten fertigen Expert Advisor vor, gefolgt von den Ergebnissen seiner Optimierung und seines Vorwärtstests.

Neuronales Netz in der Praxis: Die Sekante
Wie bereits im theoretischen Teil erläutert, müssen wir bei der Arbeit mit neuronalen Netzen lineare Regressionen und Ableitungen verwenden. Warum? Der Grund dafür ist, dass die lineare Regression eine der einfachsten Formeln ist, die es gibt. Im Grunde genommen ist die lineare Regression nur eine affine Funktion. Wenn wir über neuronale Netze sprechen, sind wir jedoch nicht an den Auswirkungen der direkten linearen Regression interessiert. Wir interessieren uns für die Gleichung, die diese Linie erzeugt. Wir sind nicht so sehr an der erstellten Linie interessiert. Kennen Sie die wichtigste Gleichung, die wir verstehen müssen? Wenn nicht, empfehle ich, diesen Artikel zu lesen, um ihn zu verstehen.


Neuronale Netze leicht gemacht (Teil 58): Decision Transformer (DT)
Wir setzen das Studium der Methoden des Reinforcement Learning bzw. des Verstärkungslernens fort. In diesem Artikel werde ich mich auf einen etwas anderen Algorithmus konzentrieren, der die Politik des Agenten im Paradigma der Konstruktion einer Sequenz von Aktionen betrachtet.

Datenwissenschaft und ML (Teil 29): Wichtige Tipps für die Auswahl der besten Forex-Daten für AI-Trainingszwecke
In diesem Artikel befassen wir uns eingehend mit den entscheidenden Aspekten der Auswahl der relevantesten und hochwertigsten Forex-Daten, um die Leistung von KI-Modellen zu verbessern.


Algorithmen zur Optimierung mit Populationen Fledermaus-Algorithmus (BA)
In diesem Artikel werde ich den Fledermaus-Algorithmus (Bat-Algorithmus, BA) betrachten, der gute Konvergenz bei glatten Funktionen zeigt.

Neuronale Netze leicht gemacht (Teil 67): Nutzung früherer Erfahrungen zur Lösung neuer Aufgaben
In diesem Artikel werden weitere Methoden zur Sammlung von Daten in einem Trainingssatz erörtert. Es liegt auf der Hand, dass der Lernprozess eine ständige Interaktion mit der Umgebung erfordert. Die Situationen können jedoch unterschiedlich sein.

Neuronale Netze leicht gemacht (Teil 23): Aufbau eines Tools für Transfer Learning
In dieser Artikelserie haben wir bereits mehr als einmal über Transfer Learning berichtet. In diesem Artikel schlage ich vor, diese Lücke zu schließen und einen genaueren Blick auf Transfer Learning zu werfen.

Einführung in MQL5 (Teil 5): Eine Anleitung für Anfänger zu den Array-Funktionen in MQL5
Entdecken Sie die Welt der MQL5-Arrays in Teil 5, der sich an absolute Anfänger richtet. Dieser Artikel vereinfacht komplexe Kodierungskonzepte und legt dabei den Schwerpunkt auf Klarheit und Einbeziehung aller Beteiligten. Werden Sie Teil unserer Gemeinschaft von Lernenden, in der Fragen willkommen sind und Wissen geteilt wird!

Algorithmen zur Optimierung mit Populationen: Der Affen-Algorithmus (Monkey Algorithmus, MA)
In diesem Artikel werde ich den Optimierungsalgorithmus Affen-Algorithmus (MA, Monkey Algorithmus) betrachten. Die Fähigkeit dieser Tiere, schwierige Hindernisse zu überwinden und die unzugänglichsten Baumkronen zu erreichen, bildete die Grundlage für die Idee des MA-Algorithmus.


Algorithmen zur Optimierung mit Populationen Fish School Search (FSS)
Fish School Search (FSS, Suche mittels Fischschulen) ist ein neuer Optimierungsalgorithmus, der durch das Verhalten von Fischen in einem Schwarm inspiriert wurde, von denen die meisten (bis zu 80 %) in einer organisierten Gemeinschaft von Verwandten schwimmen. Es ist erwiesen, dass Fischansammlungen eine wichtige Rolle für die Effizienz der Nahrungssuche und den Schutz vor Räubern spielen.

Datenwissenschaft und maschinelles Lernen (Teil 15): SVM, ein Muss im Werkzeugkasten jedes Händlers
Entdecken Sie die unverzichtbare Rolle von Support Vector Machines (SVM) bei der Gestaltung der Zukunft des Handels. Dieser umfassende Leitfaden zeigt auf, wie SVM Ihre Handelsstrategien verbessern, die Entscheidungsfindung optimieren und neue Chancen auf den Finanzmärkten erschließen kann. Tauchen Sie ein in die Welt der SVM mit realen Anwendungen, Schritt-für-Schritt-Tutorials und Expertenwissen. Rüsten Sie sich mit dem unverzichtbaren Werkzeug aus, das Ihnen helfen kann, die Komplexität des modernen Handels zu bewältigen. Verbessern Sie das Spiel Ihres Handels mit SVM - ein Muss für den Werkzeugkasten eines jeden Händlers.


Einführung in MQL5 (Teil 6): Eine Anleitung für Anfänger zu den Array-Funktionen in MQL5 (II)
Begeben Sie sich auf die nächste Phase unserer MQL5-Reise. In diesem aufschlussreichen und einsteigerfreundlichen Artikel werden wir die übrigen Array-Funktionen näher beleuchten und komplexe Konzepte entmystifizieren, damit Sie effiziente Handelsstrategien entwickeln können. Wir werden ArrayPrint, ArrayInsert, ArraySize, ArrayRange, ArrarRemove, ArraySwap, ArrayReverse und ArraySort besprechen. Erweitern Sie Ihre Kenntnisse im algorithmischen Handel mit diesen wichtigen Array-Funktionen. Begleiten Sie uns auf dem Weg zur MQL5-Meisterschaft!

Funktionsentwicklung mit Python und MQL5 (Teil I): Vorhersage gleitender Durchschnitte für weitreichende AI-Modelle
Die gleitenden Durchschnitte sind bei weitem die besten Indikatoren für die Vorhersage unserer KI-Modelle. Wir können unsere Genauigkeit jedoch noch weiter verbessern, indem wir unsere Daten sorgfältig transformieren. In diesem Artikel wird gezeigt, wie Sie KI-Modelle erstellen können, die in der Lage sind, weiter in die Zukunft zu prognostizieren, als Sie es derzeit tun, ohne dass Ihre Genauigkeit signifikant sinkt. Es ist wirklich bemerkenswert, wie nützlich die gleitenden Durchschnitte sind.

Neuronale Netze leicht gemacht (Teil 39): Go-Explore, ein anderer Ansatz zur Erkundung
Wir setzen die Untersuchung der Umgebung in Modellen des verstärkten Lernens fort. Und in diesem Artikel werden wir uns einen weiteren Algorithmus ansehen – Go-Explore. Er ermöglicht es Ihnen, die Umgebung in der Phase der Modellbildung effektiv zu erkunden.


Algorithmen zur Optimierung mit Populationen Firefly-Algorithmus (FA)
In diesem Artikel werde ich die Optimierungsmethode des Firefly-Algorithmus (FA) betrachten. Dank der Änderung hat sich der Algorithmus von einem Außenseiter zu einem echten Tabellenführer entwickelt.


Kategorientheorie in MQL5 (Teil 14): Funktoren mit linearen Ordnungen
Dieser Artikel, der Teil einer größeren Serie über die Implementierung der Kategorientheorie in MQL5 ist. Er befasst sich mit Funktoren. Wir untersuchen, wie eine lineare Ordnung mit Hilfe von Funktoren auf eine Menge abgebildet werden kann, indem wir zwei Datensätze betrachten, bei denen man normalerweise keinen Zusammenhang vermuten würde.

Neuronale Netze leicht gemacht (Teil 34): Vollständig parametrisierte Quantilfunktion
Wir untersuchen weiterhin verteilte Q-Learning-Algorithmen. In früheren Artikeln haben wir verteilte und Quantil-Q-Learning-Algorithmen besprochen. Im ersten Algorithmus haben wir die Wahrscheinlichkeiten für bestimmte Wertebereiche trainiert. Im zweiten Algorithmus haben wir Bereiche mit einer bestimmten Wahrscheinlichkeit trainiert. In beiden Fällen haben wir a priori Wissen über eine Verteilung verwendet und eine andere trainiert. In diesem Artikel wenden wir uns einem Algorithmus zu, der es dem Modell ermöglicht, für beide Verteilungen trainiert zu werden.


Neuronale Netze leicht gemacht (Teil 48): Methoden zur Verringerung der Überschätzung von Q-Funktionswerten
Im vorigen Artikel haben wir die DDPG-Methode vorgestellt, mit der Modelle in einem kontinuierlichen Aktionsraum trainiert werden können. Wie andere Q-Learning-Methoden neigt jedoch auch DDPG dazu, die Werte der Q-Funktion zu überschätzen. Dieses Problem führt häufig dazu, dass ein Agent mit einer suboptimalen Strategie ausgebildet wird. In diesem Artikel werden wir uns einige Ansätze zur Überwindung des genannten Problems ansehen.

Experimente mit neuronalen Netzen (Teil 2): Intelligente Optimierung neuronaler Netze
In diesem Artikel werde ich mit Hilfe von Experimenten und unkonventionellen Ansätzen ein profitables Handelssystem entwickeln und prüfen, ob neuronale Netze für Händler eine Hilfe sein können. Der MetaTrader 5 als ein autarkes Tool für den Einsatz neuronaler Netze im Handel.

Neuronale Netze leicht gemacht (Teil 41): Hierarchische Modelle
Der Artikel beschreibt hierarchische Trainingsmodelle, die einen effektiven Ansatz für die Lösung komplexer maschineller Lernprobleme bieten. Hierarchische Modelle bestehen aus mehreren Ebenen, von denen jede für verschiedene Aspekte der Aufgabe zuständig ist.

Entwicklung eines Roboters in Python und MQL5 (Teil 2): Auswahl, Erstellung und Training von Modellen, Python Custom Tester
Wir setzen die Serie von Artikeln über die Entwicklung eines Handelsroboters in Python und MQL5 fort. Heute werden wir das Problem der Auswahl und des Trainings eines Modells, das Testen desselben, die Implementierung der Kreuzvalidierung, die Rastersuche sowie das Problem des Modell-Ensembles lösen.


Neuronale Netze leicht gemacht (Teil 72): Entwicklungsvorhersage in verrauschten Umgebungen
Die Qualität der Vorhersage zukünftiger Zustände spielt eine wichtige Rolle bei der Methode des Goal-Conditioned Predictive Coding, die wir im vorherigen Artikel besprochen haben. In diesem Artikel möchte ich Ihnen einen Algorithmus vorstellen, der die Vorhersagequalität in stochastischen Umgebungen, wie z. B. den Finanzmärkten, erheblich verbessern kann.

Algorithmen zur Optimierung mit Populationen: Binärer genetischer Algorithmus (BGA). Teil II
In diesem Artikel befassen wir uns mit dem binären genetischen Algorithmus (BGA), der die natürlichen Prozesse modelliert, die im genetischen Material von Lebewesen in der Natur ablaufen.


Techniken des MQL5-Assistenten, die Sie kennen sollten (Teil 03): Shannonsche Entropie
Der Händler von heute ist ein Philomath, der fast immer (entweder bewusst oder unbewusst...) nach neuen Ideen sucht, sie ausprobiert, sich entscheidet, sie zu modifizieren oder zu verwerfen; ein explorativer Prozess, der einiges an Sorgfalt kosten sollte. Diese Artikelserie wird vorschlagen, dass der MQL5-Assistent eine Hauptstütze für Händler sein sollte.


Integrieren Sie Ihr eigenes LLM in Ihren EA (Teil 3): Training Ihres eigenen LLM mit CPU
Angesichts der rasanten Entwicklung der künstlichen Intelligenz sind Sprachmodelle (language models, LLMs) heute ein wichtiger Bestandteil der künstlichen Intelligenz, sodass wir darüber nachdenken sollten, wie wir leistungsstarke LLMs in unseren algorithmischen Handel integrieren können. Für die meisten Menschen ist es schwierig, diese leistungsstarken Modelle auf ihre Bedürfnisse abzustimmen, sie lokal einzusetzen und sie dann auf den algorithmischen Handel anzuwenden. In dieser Artikelserie werden wir Schritt für Schritt vorgehen, um dieses Ziel zu erreichen.

Eigenvektoren und Eigenwerte: Explorative Datenanalyse in MetaTrader 5
In diesem Artikel werden verschiedene Möglichkeiten untersucht, wie Eigenvektoren und Eigenwerte in der explorativen Datenanalyse eingesetzt werden können, um einzigartige Beziehungen in den Daten aufzudecken.