

梦境优化算法(DOA)
 46
 1

内容
引言
在研究各类优化方法的过程中,我接触了大量算法,其中一种全新而独特的思路引起了我的注意 —— 它的灵感来自一项颇具争议、研究尚不充分的现象:梦境机制。
2025年3月,Y. Lang与Y. Gao向学术界提出了一种新型元启发式优化算法 —— 梦境优化算法(DOA),相关论文发表于《Computer Methods in Applied Mechanics and Engineering》 (《应用力学与工程中的计算机方法》)期刊第436卷。该算法借鉴人类梦境的独有特征,为求解复杂优化问题开辟了新思路,其中就包含交易系统的参数调优。
DOA模拟睡眠过程的三大核心特征:部分记忆留存、选择性遗忘并后续补充信息,以及种群内各个智能体之间的“梦境”信息交互。在算法交易场景下,上述机制能在探索参数空间新区域与利用已有最优解之间取得平衡。这一点,对于在非平稳金融市场环境下优化交易策略而言至关重要。
在本文中,我们将详细剖析该算法的数学原理,基于MQL5完成算法实现,并将其与其他基于种群的优化算法开展对比分析。
算法实现
睡眠时,我们的大脑会完成三项重要工作:记住白天的关键信息、遗忘无关的细节,以及将各类记忆重组形成新想法。
DOA借鉴上述原理来寻找最优解。种群初始化完成后,全部个体被划分为若干群组。每个群组拥有专属的“记忆方式”:从记忆保留程度最高的第一组,到遗忘程度最高的最后一组,各组会根据组别编号和问题总维度数D,修改不同数量的维度k。
算法的绝大部分运行时间都花在探索阶段。首先,每个群组执行记忆策略,将群组内所有智能体重置到该组当前找到的最优位置;随后按一定概率触发遗忘与补充策略。该策略会随机选取k个维度,借助余弦调制公式cos((i+T/10)π/T)对维度进行更新。该机制在迭代初期产生较大搜索步长,之后步长逐步衰减。对于剩余概率,则启用梦境交换策略:从种群中随机挑选一个智能体,复制其k个维度的参数。
迭代的最后,算法进入利用阶段。重置到全局最优解对应的位置,并以极小步长开展精细寻优。该阶段依靠余弦函数cos(iπ/T) —— 该函数在优化末期趋近于0。这有助于在通过群组记忆机制进行搜索空间探索与短时但精确的最终优化之间取得平衡。
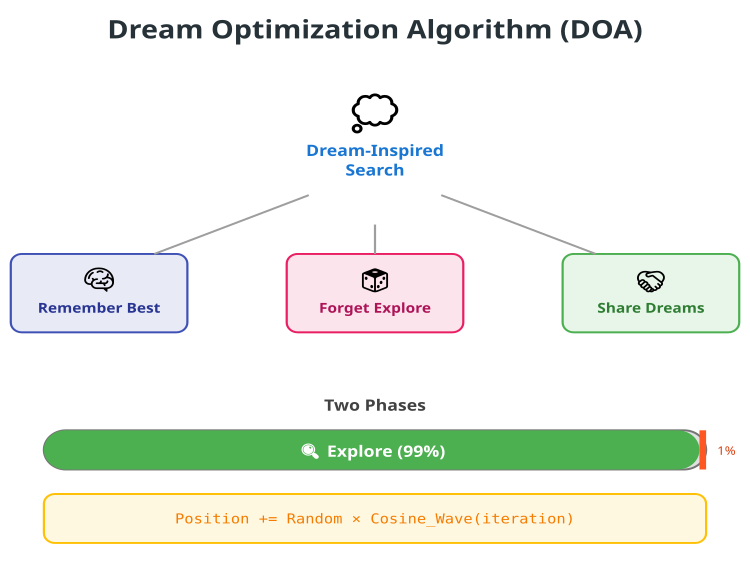
图例1. DOA算法的运行过程
以上为DOA算法的结构示意图。图上方的中心元素是一个标注为“基于梦境的搜索”(Dream-Inspired Search)的思维云图。从云图分出三条分支,对应算法的三大核心策略:蓝色模块记住最优解(Remember Best)对应记忆策略;中间粉色模块遗忘探索(Forget Explore)对应遗忘与补充策略;右侧绿色模块共享梦境(Share Dreams)对应智能体之间的经验交换策略。
三大策略下方是双阶段(Two Phases)区域,用横向进度条展示算法的时间分配:绿色部分占99%,标注为探索(Explore);右侧红色条占剩余1%。直观突出了探索阶段与利用阶段之间极不对称的时间分配。
在示意图的最底部,给出了算法核心数学公式:位置更新 += 随机量 × 余弦波(迭代次数) —— 这一公式凸显了余弦调制在DOA运行中的核心地位。接下来我们编写伪代码。
初始化
DOA算法开始
设置参数:
- 种群规模 = 60个智能体
- 群组数量 = 6
- 探索阶段占总迭代时长 = 99%
- 遗忘策略概率 = 30%
在搜索空间内随机生成60个智能体的位置
将智能体均分为6组(每组10个)
将每组的最优解初始化为最劣值(负无穷)
主优化循环
对每一轮迭代,从1到最大迭代次数:
如果当前迭代轮数不超过探索阶段的迭代轮数上限(占总轮数的99%):
执行探索阶段
否则:
执行利用阶段
探索阶段
对每个群组m,从1到6:
找出第m组内最优的智能体
更新该群组的最优解
计算待修改维度数量:
最小维度数k_min = 向上取整(D/8/m)
最大维度数k_max = 向上取整(D/3/m)
k = 在k_min与k_max之间取随机数
注释:第1组修改更多维度(记忆能力更强)
第6组修改更少维度(遗忘程度更高)
对群组m内的每一个智能体j:
步骤1 - 记忆策略:
将本组最优智能体的位置复制到当前智能体
(组内所有智能体“记住”本组找到的最优解)
步骤2 - 随机挑选k个待修改维度
步骤3 - 遗忘策略或梦境共享策略:
如果随机数小于0.3(30%概率):
//遗忘与补充策略
对选中的k个维度逐个执行:
新值 = 当前值 + 随机数 × 余弦波
其中余弦波 = [cos ((迭代次数 + T/10) × π / T) + 1] / 2
注释:余弦函数在迭代初期产生较大步长,
在整个优化过程接近尾声时,步长逐渐减小
否则(70%概率):
//梦境交换策略
对选中的k个维度逐个执行:
从种群中随机选取一个智能体,复制其对应维度数值
(该智能体“借鉴”其他智能体的解,即梦境交换)
校验并修正所有维度的边界(防止参数超出允许范围)
利用阶段
对全部60个智能体中的每一个智能体j:
步骤1 - 重置至全局最优:
将全局最优解复制到当前智能体
(所有智能体汇聚至当前寻优得到的最优“峰值”)
步骤2 - 精细调优:
计算待修改维度数量:
k = 在2和max(2, 向上取整(D/3))之间取随机数
随机选出k个维度
对选中的k个维度逐个执行:
新值 = 当前值 + 随机数 × 余弦波
其中,余弦波 = [cos (迭代次数 × π / T) + 1] / 2
注释:在算法末期,余弦值趋近于0,
这使得搜索步长极小
校验并修正维度边界
结果更新
每次智能体位置更新完成后:
计算每个智能体的目标函数值
更新全局最优解:
如果找到优于当前全局最优的解:
将其保存为新的全局最优
在探索阶段还需要:
更新每个群组的最优解
单次迭代结束
让我们开始编写算法代码。该类用于实现DOA优化算法,并继承自C_AO基类(各类优化算法的统一接口)。构造函数与析构函数为标准形式,析构函数内不执行额外操作。构造函数指定算法核心参数及其取值,并将参数关联至params参数数组,便于外部统一管理参数。
主要参数:- popSize —— 种群规模,即每次迭代中候选解的数量;
- numGroups —— 分组数量,种群将被划分为若干组以实现信息并行交互;
- explorationRate —— 探索阶段迭代占比,算法在此阶段搜索解空间的新区域;
- forgettingProb —— “遗忘”策略触发概率,用于避免算法陷入局部极小值。
- SetParams() —— 从"params"数组加载并设置类参数;
- Init() —— 通过设置指定的搜索范围和迭代次数来初始化算法;
- Moving() —— 执行单次优化迭代;
- Revision() —— 更新并修正当前解状态。
- currentIteration、totalIterations、explorationIters —— 迭代计数器与阶段分界值;
- groupBest [] —— 数组,存储每个分组的最优解,支撑信息共享与解的迭代进化。
- ExplorationPhase() —— 负责探索搜索模式,拓展搜索范围;
- ExploitationPhase() —— 利用阶段,基于已找到的优质解做进一步优化;
- UpdateGroupBest () —— 更新指定分组内的最优解;
- GetGroupStartIndex ()、GetGroupEndIndex () —— 获取每个分组内候选解索引区间。
该类实现DOA算法,种群会被划分为固定数量的分组。迭代过程中,算法在探索阶段(搜寻新解)与利用阶段(优化已发现的最优解)之间分配计算资源。“遗忘”策略可帮助算法避开局部最优。整体设计旨在平衡新区域探索与已有优质解的精细优化,从而实现高效的全局寻优。
//————————————————————————————————————————————————————————————————————
class C_AO_DOA_dream : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOA_dream () { }
  C_AO_DOA_dream ()
  {
    ao_name = "DOA";
    ao_desc = "Dream Optimization Algorithm";
    ao_link = "https://www.mql5.com/en/articles/19177";

    popSize              = 60;    // population size
    numGroups            = 6;     // number of groups (fixed in the original)
    explorationRate      = 0.99;  // iteration rate for the exploration phase (9/10 in the original)
    forgettingProb       = 0.3;   // probability of using the main forgetting strategy

    ArrayResize (params, 4);

    params [0].name = "popSize";           params [0].val = popSize;
    params [1].name = "numGroups";         params [1].val = numGroups;
    params [2].name = "explorationRate";   params [2].val = explorationRate;
    params [3].name = "forgettingProb";    params [3].val = forgettingProb;
  }

  void SetParams ()
  {
    popSize          = (int)params [0].val;
    numGroups        = (int)params [1].val;
    explorationRate  = params      [2].val;
    forgettingProb   = params      [3].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  int    numGroups;         // number of groups
  double explorationRate;   // iteration rate for the exploration phase
  double forgettingProb;    // probability of applying the main strategy

  private: //---------------------------------------------------------
  int    currentIteration;  // current iteration
  int    totalIterations;   // total number of iterations
  int    explorationIters;  // number of exploration iterations

  S_AO_Agent groupBest [];  // best solutions in each group

  void   ExplorationPhase      ();
  void   ExploitationPhase     ();
  void   UpdateGroupBest       (int groupNum);
  int    GetGroupStartIndex    (int groupNum);
  int    GetGroupEndIndex      (int groupNum);
};
//————————————————————————————————————————————————————————————————————
C_AO_DOA_dream类的初始化方法负责执行优化算法运行前的准备工作,设置初始参数并建立后续迭代所需的内部状态。
首先,调用通用的初始化方法,校验并设置搜索范围与步长,保证参数配置正确。如果该校验或配置过程失败,则终止初始化。
随后设置各类计数器:将当前迭代次数重置为"0",由传入参数确定总迭代次数;再根据设定的探索占比(explorationRate),计算分配给探索阶段的迭代轮数。
接下来,初始化分组最优解数组(groupBest),数组长度等于分组数量。对每一个分组,通过Init方法生成一个初始解,并将该解的适应度函数值设为理论最小值,保证后续可以正常进行对比与更新操作。
执行完该方法后,算法即可基于已配置的参数、计数器和各组初始最优解,开始执行优化流程。
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DOA_dream::Init (const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  currentIteration = 0;
  totalIterations  = epochsP;
  explorationIters = (int)(totalIterations * explorationRate);

  ArrayResize (groupBest, numGroups);
  for (int i = 0; i < numGroups; i++)
  {
    groupBest [i].Init (coords);
    groupBest [i].f = -DBL_MAX; // Initialize with the worst value
  }

  return true;
}
//————————————————————————————————————————————————————————————————————
Moving方法是DOA算法的主迭代步骤,用于实现算法从一轮迭代到下一轮迭代的执行逻辑。首先,对currentIteration计数器自增,追踪算法的运行进度。
初始种群初始化(仅首次运行) 检查"revision"标记;若标记为"false"(代表算法首次执行),则执行种群初始化:对种群内每一个智能体,以及智能体的每一个维度(坐标):
- 调用u.RNDfromCI()函数,在给定上下限(rangeMin和rangeMax)范围内生成随机坐标值;
- 调用u.SeInDiSp()函数,结合步长(rangeStep)对该数值进行修正,将其对齐至最近的合法取值(步长的整数倍);
- 初始化完成后,将"revision"标记设置为 true,防止后续迭代重复执行初始化;
- 至此,该方法执行完毕。
- 判断当前迭代是否属于探索阶段(currentIteration小于等于explorationIters):
- 如果处于探索阶段,则调用ExplorationPhase()方法;
- 否则(进入利用阶段),调用ExploitationPhase()方法。
因此,Moving方法管控整个优化流程:完成种群的一次性初始化,之后依靠迭代计数器在探索阶段与利用阶段之间切换。初始化仅执行一次,此后算法进入循环,根据当前迭代轮数决定执行哪一个阶段。
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DOA_dream::Moving ()
{
  currentIteration++;

  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Determine the phase of the algorithm
  if (currentIteration <= explorationIters)
  {
    ExplorationPhase ();
  }
  else
  {
    ExploitationPhase ();
  }
}
//————————————————————————————————————————————————————————————————————
ExplorationPhase方法实现DOA算法的探索阶段。在该阶段,对各组智能体的候选解进行更新与多样化处理,以此搜寻解空间内新的可行区域。对于每一组智能体,更新该组的最优解,记录当前已搜索到的最优结果。接下来,根据当前分组编号与总维度数,确定遗忘操作需要修改的维度数量。计算每个分组内智能体的起始索引与结束索引。
随后,对组内每一个智能体,将本组最优解复制为该智能体当前解(记忆策略),相当于保留一份可供回溯的历史优质解。生成一份待执行“遗忘”与“补充”操作的维度(坐标)列表。对维度数组进行随机打乱,以此随机挑选将要变更的维度。
对于组内每个智能体,以参数forgettingProb设定的概率决定是否执行选中维度的更新策略;如果命中,则采用带余弦调制的遗忘策略。
为选中维度生成取值范围内的随机偏移量。余弦调制由当前迭代次数与总迭代次数共同决定,可随迭代进程控制修改幅度大小。更新完成后,将数值修正至合法区间并对齐搜索步长。如果未触发遗忘策略,则执行“梦境共享”策略:从种群中的随机智能体复制其参数值,实现智能体之间的信息交互。
因此,该阶段用于探索解空间,提升候选解多样性;借助随机扰动与智能体间的信息交换,帮助算法摆脱局部最优陷阱。
//————————————————————————————————————————————————————————————————————
//--- Exploration phase
void C_AO_DOA_dream::ExplorationPhase ()
{
  // Handle each group
  for (int m = 0; m < numGroups; m++)
  {
    // Update the best solution in the group
    UpdateGroupBest (m);

    // Calculate the number of dimensions to forget
    int kMin = (int)MathCeil ((double)coords / 8.0 / (m + 1));
    int kMax = (int)MathCeil ((double)coords / 3.0 / (m + 1));
    int k    = u.RNDintInRange (kMin, kMax);

    // Handle agents in the group
    int startIdx = GetGroupStartIndex (m);
    int endIdx   = GetGroupEndIndex   (m);

    for (int j = startIdx; j <= endIdx; j++)
    {
      // Memory strategy - reset to the best group solution
      ArrayCopy (a [j].c, groupBest [m].c, 0, 0, WHOLE_ARRAY);

      // Select random dimensions to forget
      int dims [];
      ArrayResize (dims, coords);
      for (int i = 0; i < coords; i++) dims [i] = i;

      // Shuffle the array of dimensions
      for (int i = coords - 1; i > 0; i--)
      {
        int idx    = u.RNDintInRange (0, i);
        int temp   = dims [i];
        dims [i]   = dims [idx];
        dims [idx] = temp;
      }

      // Strategy of forgetting and replenishment
      if (u.RNDprobab () < forgettingProb)
      {
        // Basic strategy with cosine modulation
        for (int h = 0; h < k; h++)
        {
          int    dim              = dims [h];
          double range            = rangeMax [dim] - rangeMin [dim];
          double randomValue      = u.RNDprobab () * range + rangeMin [dim];
          double cosineModulation = (MathCos ((1.0 * currentIteration + totalIterations / 10.0) * M_PI / totalIterations) + 1.0) / 2.0;

          a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
          a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
        }
      }
      else
      {
        // Dream sharing - copying from a random agent
        for (int h = 0; h < k; h++)
        {
          int dim   = dims [h];
          int donor = u.RNDintInRange (0, popSize - 1);
          a [j].c [dim] = a [donor].c [dim];
        }
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
ExploitationPhase方法实现该优化算法的利用阶段。其核心任务是引导搜索向当前已找到的最优解靠拢,以此优化现有结果。
对种群内的每一个智能体,将其候选解重置为全局最优解,从而聚焦于解空间内最有潜力的区域。接下来,确定需要修改的维度数量。通常选取维度数量不少于2个,上限由总维度数决定。生成全部维度(坐标)列表,并对列表随机打乱,从中挑选待修改维度。针对每一个选中的维度:
- 计算该参数的变动区间;
- 在区间内生成随机数值;
- 使用余弦函数对该数值做调制,余弦函数由当前迭代次数与总迭代次数决定,可随迭代进程控制扰动强度;
- 结合生成的随机值与余弦调制结果,更新该参数;
- 之后,将数值修正到合法区间,并按离散步长对齐,保证候选解有效。
该方法的目标是通过可控随机扰动,对已发现的优质解做精细打磨,使算法进入解空间内更优区域,得到质量更高的候选解。
//————————————————————————————————————————————————————————————————————
//--- Exploitation phase
void C_AO_DOA_dream::ExploitationPhase ()
{
  // In the exploitation phase, all agents move towards the global best
  for (int j = 0; j < popSize; j++)
  {
    // Reset to global best solution
    ArrayCopy (a [j].c, cB, 0, 0, WHOLE_ARRAY);

    // Calculate the number of dimensions to modify
    int km = MathMax (2, (int)MathCeil ((double)coords / 3.0));
    int k = u.RNDintInRange (2, km);

    // Select random dimensions
    int dims [];
    ArrayResize (dims, coords);
    for (int i = 0; i < coords; i++) dims [i] = i;

    // Shuffle the array of dimensions
    for (int i = coords - 1; i > 0; i--)
    {
      int idx = u.RNDintInRange (0, i);
      int temp = dims [i];
      dims [i] = dims [idx];
      dims [idx] = temp;
    }

    // Apply the forgetting and addition strategy
    for (int h = 0; h < k; h++)
    {
      int dim = dims [h];
      double range = rangeMax [dim] - rangeMin [dim];

      double randomValue = u.RNDprobab () * range + rangeMin [dim];
      double cosineModulation = (MathCos (currentIteration * M_PI / totalIterations) + 1.0) / 2.0;

      a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
      a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
UpdateGroupBest方法用于确定指定智能体分组内的最优解。其主要执行逻辑如下:
- 获取目标分组所含智能体的起始索引与结束索引;
- 遍历该分组内全部智能体;
- 对于每个智能体,将其评价函数值(即解的质量指标)与分组当前记录的最优值进行对比;
- 如果某个智能体的适应度函数值优于分组记录,则更新分组最优解,替换为当前更优的候选解。
因此,该方法持续维护每个分组的最新最优解信息,对算法后续的搜索策略与解更新操作至关重要。
//————————————————————————————————————————————————————————————————————
//--- Update the best solution in the group
void C_AO_DOA_dream::UpdateGroupBest (int groupNum)
{
  int startIdx = GetGroupStartIndex (groupNum);
  int endIdx   = GetGroupEndIndex (groupNum);

  for (int i = startIdx; i <= endIdx; i++)
  {
    if (a [i].f > groupBest [groupNum].f)
    {
      groupBest [groupNum].f = a [i].f;
      ArrayCopy (groupBest [groupNum].c, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
GetGroupStartIndex方法用于计算候选解 / 智能体数组中,指定分组内元素的起始索引。该方法基于分组在数组内均匀分布的计算假设。核心思路是根据分组编号、总分组数以及种群总规模,计算特定分组中第一个智能体(元素)的位置。
计算公式为:分组编号 × 种群总规模 ÷ 总分组数,得到目标分组第一个元素的索引。该方法保证数据均匀划分至各个分组,方便后续对候选解执行分组相关操作。
//————————————————————————————————————————————————————————————————————
//--- Get the starting index of the group
int C_AO_DOA_dream::GetGroupStartIndex (int groupNum)
{
  return (int)((double)groupNum * popSize / numGroups);
}
//————————————————————————————————————————————————————————————————————
GetGroupEndIndex方法用于计算指定分组所含元素的结束索引。该方法根据分组编号、种群总规模以及总分组数,计算分组内最后一个元素的位置。计算方式为:(分组编号 + 1) × 种群总规模 ÷ 总分组数 - 1,得到该分组最后一个元素的索引。
还需要增加越界校验,防止数组下标越界:如果计算得到的索引超出种群规模,则将其修正为数组最后一个有效索引。该方法确保各智能体分组的边界划分正确。
//————————————————————————————————————————————————————————————————————
//--- Get the ending index of the group
int C_AO_DOA_dream::GetGroupEndIndex (int groupNum)
{
  int endIdx = (int)((double)(groupNum + 1) * popSize / numGroups) - 1;
  if (endIdx >= popSize) endIdx = popSize - 1;
  return endIdx;
}
//————————————————————————————————————————————————————————————————————
Revision方法用于更新算法运行过程中找到的最优解信息。首先,遍历当前种群内所有候选解。在循环内,对每一个解,检查其目标函数值;如果该值优于当前最优值,则更新全局最优适应度fB为当前解的目标函数值,并将当前解设为全局最优解。
随后判断当前迭代是否处于“探索”阶段(依据explorationIters):如果是,则除更新全局最优解外,还会一并考量各个分组内的最优解。实现方式为遍历所有分组,将每组最优解的目标函数值与当前全局最优值对比。
如果该分组内的解更优,则更新fB,并将groupBest中存储的分组最优解复制到全局最优解缓冲区cB。因此,Revision方法会根据算法当前所处阶段(探索或利用)持续监测、更新最优解信息,保证始终保存截至当前迭代找到的最优候选解。
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DOA_dream::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }

  // Update the best solutions of groups in the exploration phase
  if (currentIteration <= explorationIters)
  {
    for (int m = 0; m < numGroups; m++)
    {
      if (groupBest [m].f > fB)
      {
        fB = groupBest [m].f;
        ArrayCopy (cB, groupBest [m].c, 0, 0, WHOLE_ARRAY);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
测试结果
DOA算法实现完毕,下面直接在测试函数集上运行测试。可以看到,DOA算法得分53.62%,该结果将录入我们的算法评级表。
=============================
5 Hilly's;函数运行次数:10000;结果:0.8555594031110225
25 Hilly's;函数运行次数:10000;结果:0.7008493263471764
500 Hilly's;函数运行次数:10000;结果: 0.37279821121874124
=============================
5 Forest's;函数运行次数:10000;结果:0.7342194493052585
25 Forest's;函数运行次数:10000;结果:0.48905397049976357
500 Forest's;函数运行次数:10000;结果:0.24146681094197792
=============================
5 Megacity's;函数运行次数:10000;结果:0.7723076923076921
25 Megacity's;函数运行次数:10000;结果:0.4735384615384616
500 Megacity's;函数运行次数:10000;结果:0.18561538461538593
=============================
总分:4.82541(53.62%)
由低维测试的可视化结果(绿色轨迹)可见,DOA的运行结果离散程度较大,在“Forest”与“Megacity”测试函数上尤为明显。
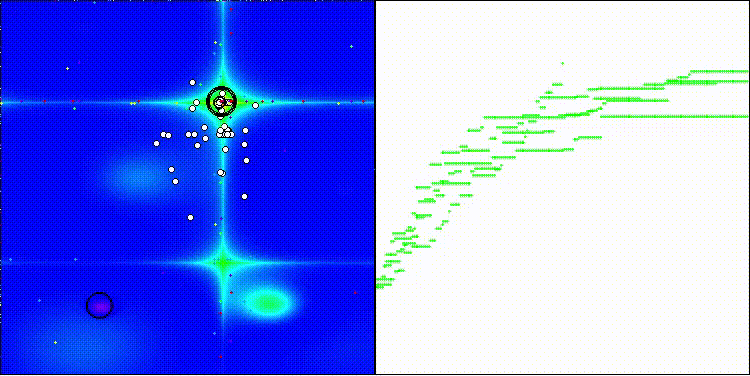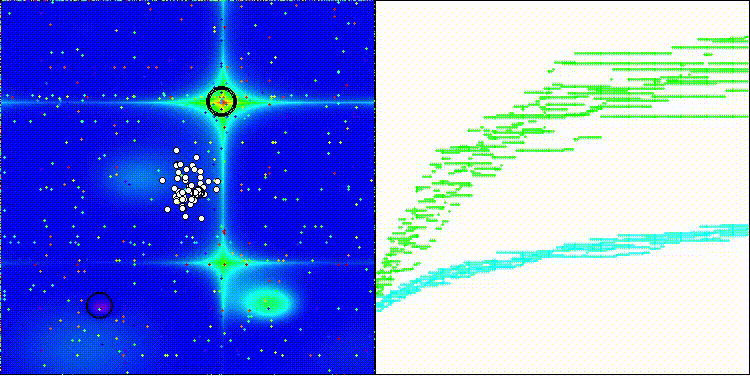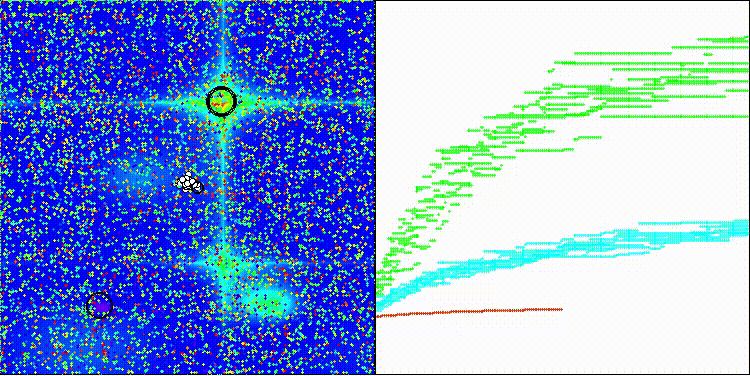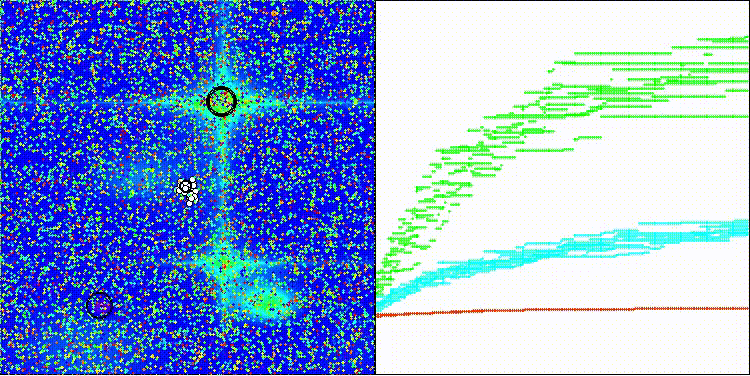
DOA在Hilly测试函数上
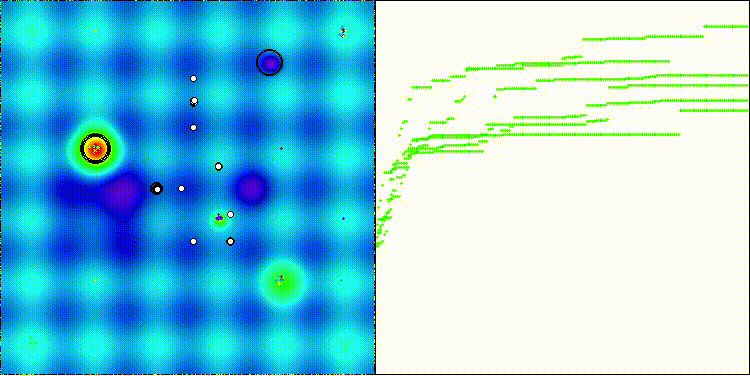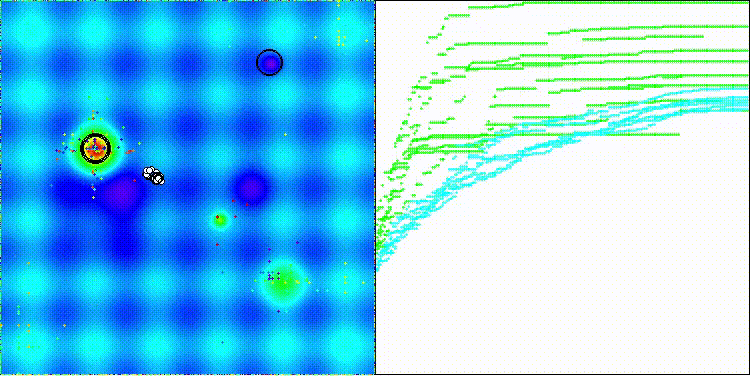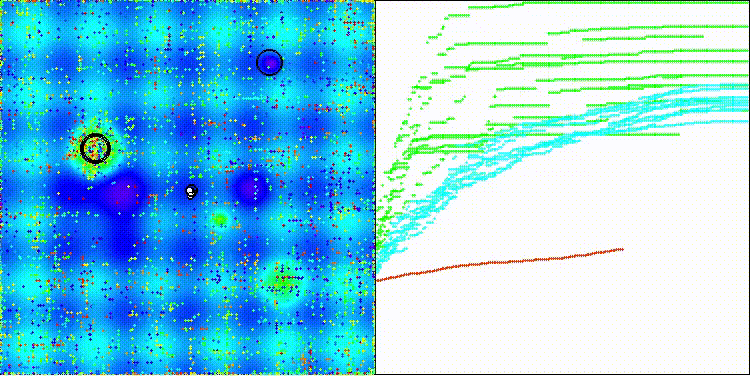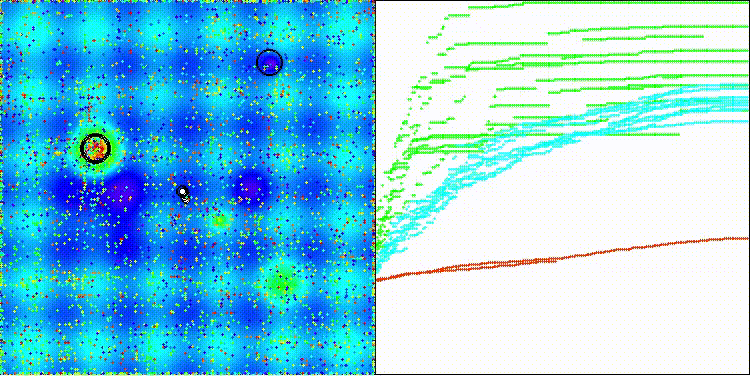
DOA在Forest测试函数上
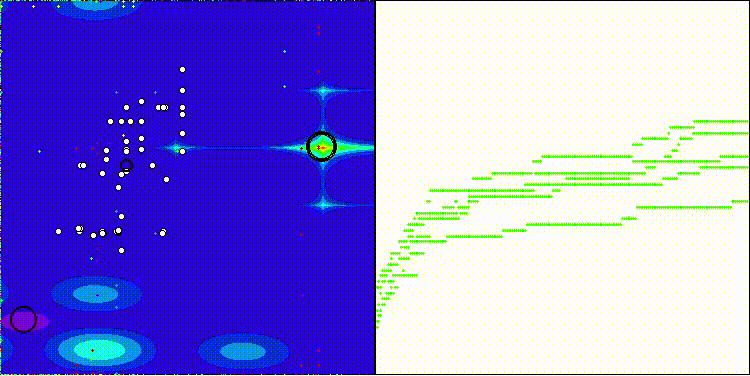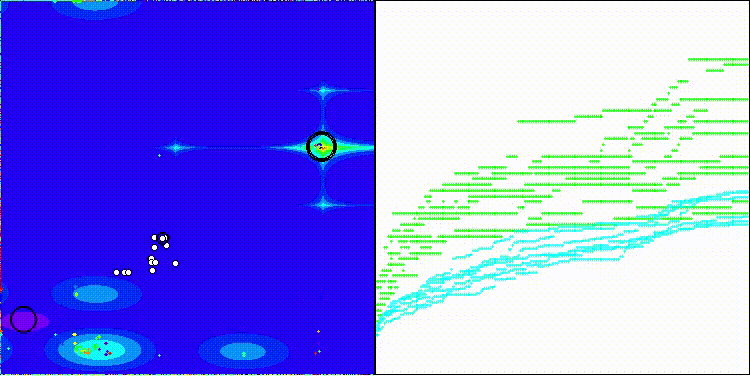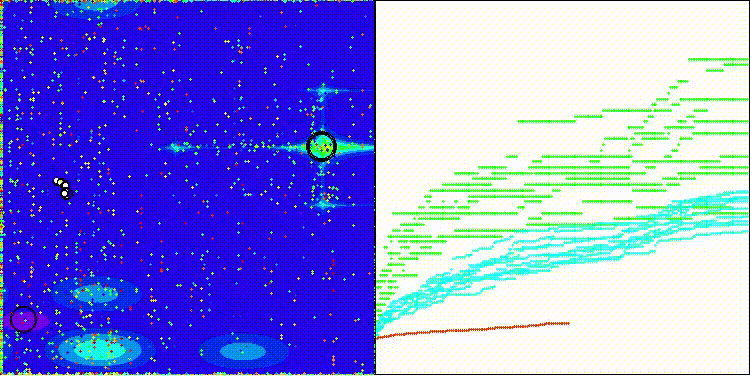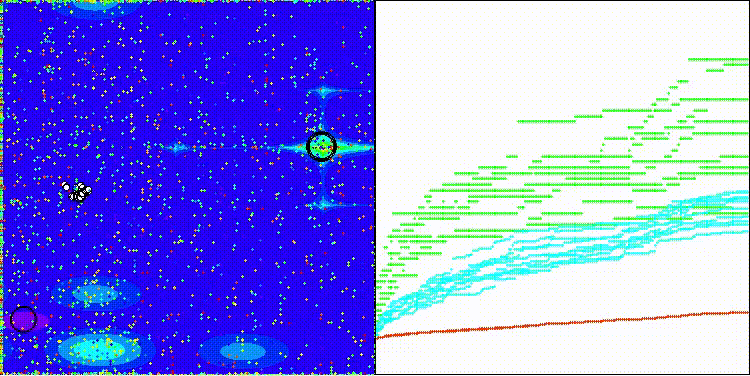
DOA在Megacity测试函数上
根据测试结果,DOA算法在种群优化算法总排行榜中位列第26名。
| # | AO | 描述 | Hilly | Hilly 最终 | Forest | Forest 最终 | Megacity (离散) | Megacity 最终 | 最终 结果 | 占比 (%) 最大 | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | 跨邻域搜索 | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | 密码锁算法(joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | 动物迁徙优化M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O) 进化策略 | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | 彗星尾算法(joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | 时间演化旅行算法(joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | 随机扩散搜索 M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | 台球优化算法M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | 射箭算法M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | 社会群体的进化(joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | 模拟各向同性退火(joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | 极值优化M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | 生物地理学优化算法 | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | 人工协同搜索 | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | 辩证算法 | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | 黑洞算法M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | 无序社会优化 | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | 皇家同花顺优化(joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | 原子轨道搜索M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | 龟壳演化算法(joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | 回溯搜索算法 | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | 差分进化 | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | 成功餐饮经营者算法 (joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | 化学反应优化 | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | 血液遗传优化算法(joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | DOA | 梦境优化算法 | 0.85556 | 0.70085 | 0.37280 | 1.92921 | 0.73421 | 0.48905 | 0.24147 | 1.46473 | 0.77231 | 0.47354 | 0.18561 | 1.43146 | 4.825 | 53.62 |
| 27 | BSA | 鸟群算法 | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 28 | DEA | 差分进化算法 | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 29 | HS | 和声搜索 | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 30 | SSG | 树苗播种和生长 | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51.95 |
| 31 | BCOm | 细菌趋化性优化算法M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 32 | ABO | 非洲水牛优化 | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51.49 |
| 33 | (PO)ES | (PO) 进化策略 | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 34 | FBA | 基于分形的算法 | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50.61 |
| 35 | TSm | 禁忌搜索M | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 36 | BSO | 头脑风暴优化 | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 37 | WOAm | 鲸鱼优化算法M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 38 | AEFA | 人工电场算法 | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 39 | AEO | 基于人工生态系统的优化算法 | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 40 | CAm | 骆驼算法M | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 41 | ACOm | 蚁群优化M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 42 | CMAES | 协方差矩阵自适应演化策略 | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 43 | DA_duelist | 决斗者算法 | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48.28 |
| 44 | BFO-GA | 细菌觅食优化 - ga | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 45 | SOA | 简单优化算法 | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| RW | 随机游走 | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
总结
梦境优化算法(DOA)的表现中规中矩,在本次测试中拿下53.62%的得分,已计入我们的算法评级表。
分析测试结果,可以看到许多元启发式算法的通病:随着问题维度升高,算法性能会出现明显下降。在低维问题上,DOA的测试结果在73%至86%之间;但换成高维问题后,受限于迭代次数,算法效率骤降至18%至37%。
总体来看,该算法在众多优化方法中属于“中等”水平。感兴趣的读者可以尝试调参,该算法仍存在取得更优结果的潜力。
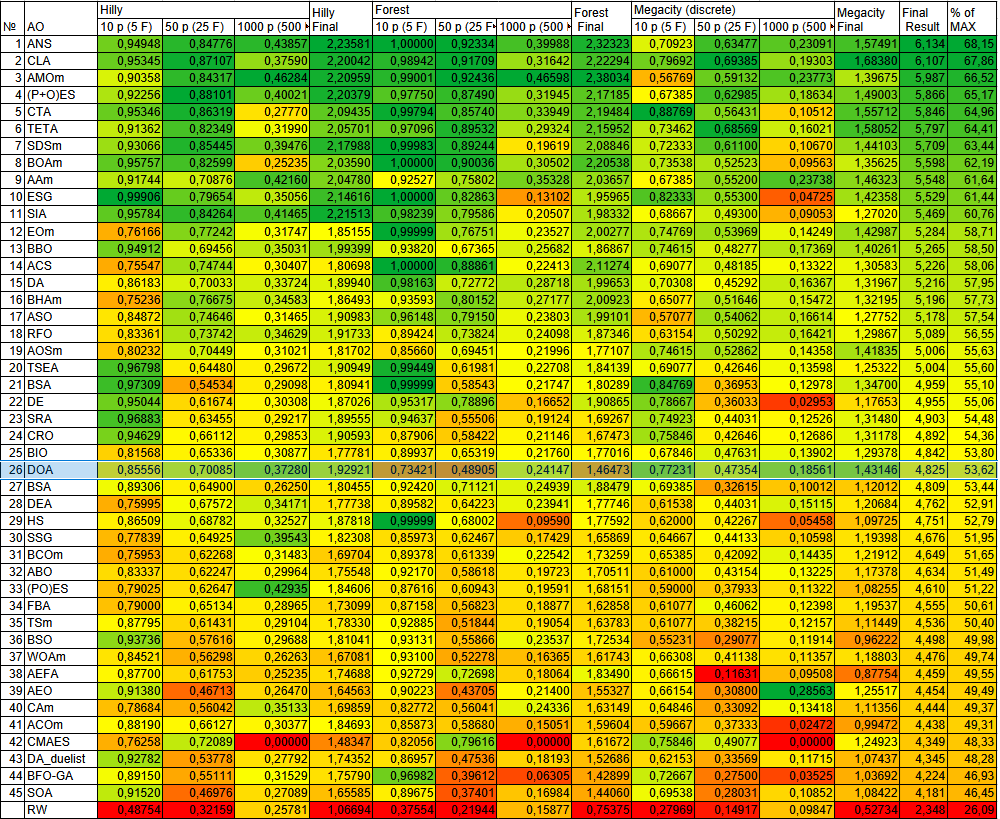
图例2. 算法对应各组测试下的色彩分级图
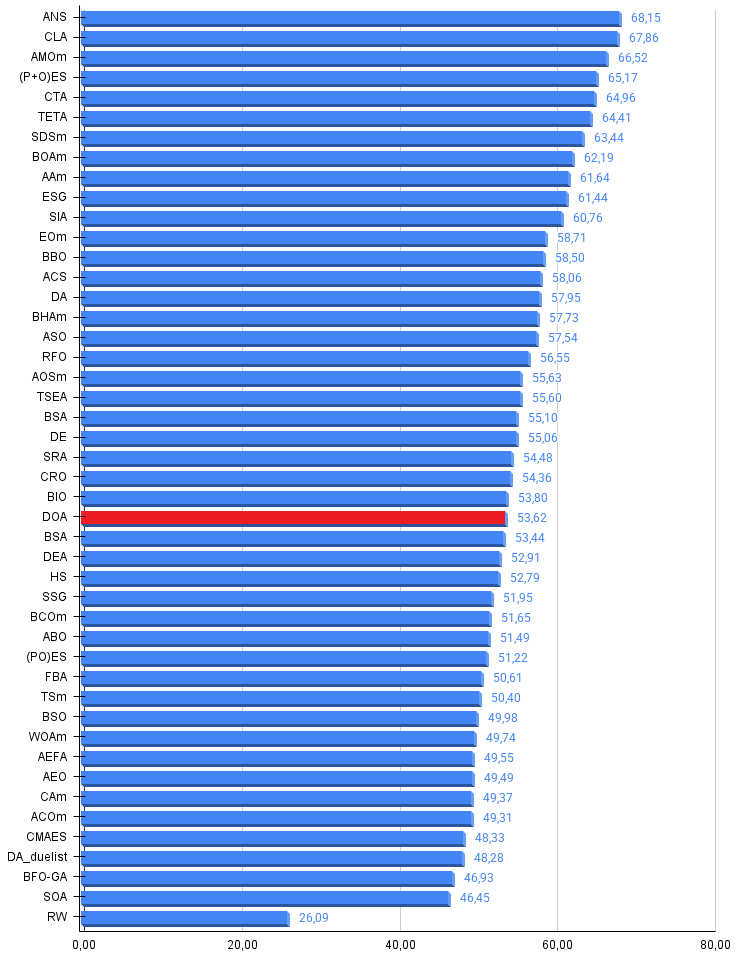
图例3. 算法测试结果的直方图(评分范围为0到100,越高越好,其中100为理论上的最高可能得分,压缩包中附有用于计算排名表的脚本)
DOA的优缺点:
优点:
- 实现简单。
- 运行速度快。
缺点:
- 低维测试函数上方差较高。
包含该算法最新版本代码的压缩包参见附件。本文作者对标准算法描述的绝对准确性不承担责任。为提升搜索能力,已经对其中的许多算法进行了修改。文章中表述的结论和论断都是基于实验的结果。
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | #C_AO.mqh | 库 | 种群优化算法的基类 |
| 2 | #C_AO_enum.mqh | 库 | 种群优化算法的枚举说明 |
| 3 | TestFunctions.mqh | 库 | 测试函数库 |
| 4 | TestStandFunctions.mqh | 库 | 测试台函数库 |
| 5 | Utilities.mqh | 库 | 辅助函数库 |
| 6 | CalculationTestResults.mqh | 库 | 用于计算比较表结果的脚本 |
| 7 | Testing AOs.mq5 | 脚本 | 面向所有种群优化算法的统一测试平台 |
| 8 | Simple use of population optimization algorithms.mq5 | 脚本 | 种群优化算法非可视化简易使用案例 |
| 9 | Test_AO_DOA.mq5 | 脚本 | DOA测试 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19177
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 神经网络在交易中的应用:概率时间序列预测(K²VAE)
 重构经典策略(第十五部分):日线突破交易策略
 基于协整股票的统计套利(第三部分):数据库搭建
 决斗者算法
