

决斗者算法
 38
 2

内容
引言
在算法交易中,每一毫秒都关乎盈亏,因此为交易策略寻找最优参数是一项关键任务。现代交易者正借助人工智能(AI)和进化算法来微调自己的交易系统。
今天我们介绍一种全新的优化方法 —— 决斗者算法,其灵感源自古老的决斗机制。2015年,由Biyanto带领的一组印尼科学家提出了这一算法,作为传统进化算法的替代方案。其目标是通过对优胜个体与落败个体采用差异化处理,减少变异、交叉算子的“盲目性”。本文将详细剖析决斗者算法的数学原理,在MQL5中完成算法实现,并与其他基于种群的优化方法开展对比分析。
算法实现
不妨把交易场想象成一个竞技场,各类策略在此持续博弈。部分策略在特定市场环境中盈利,另一些则会失效。那么,成功交易者的核心特质是什么?既善于从胜负中汲取经验,又能不断调整和完善自己的交易方案。
这正是决斗者算法所蕴含的核心思想。经典遗传算法对所有个体一视同仁,而决斗者算法却对优胜者与落败者区别对待 —— 这正是二者的本质差异。落败者负责学习:分析优胜个体的策略,并吸收其有效部分;优胜者负责创新:在自身核心策略已验证有效的前提下,尝试新方案。冠军承担示范/指导作用,使最优策略得以传承。
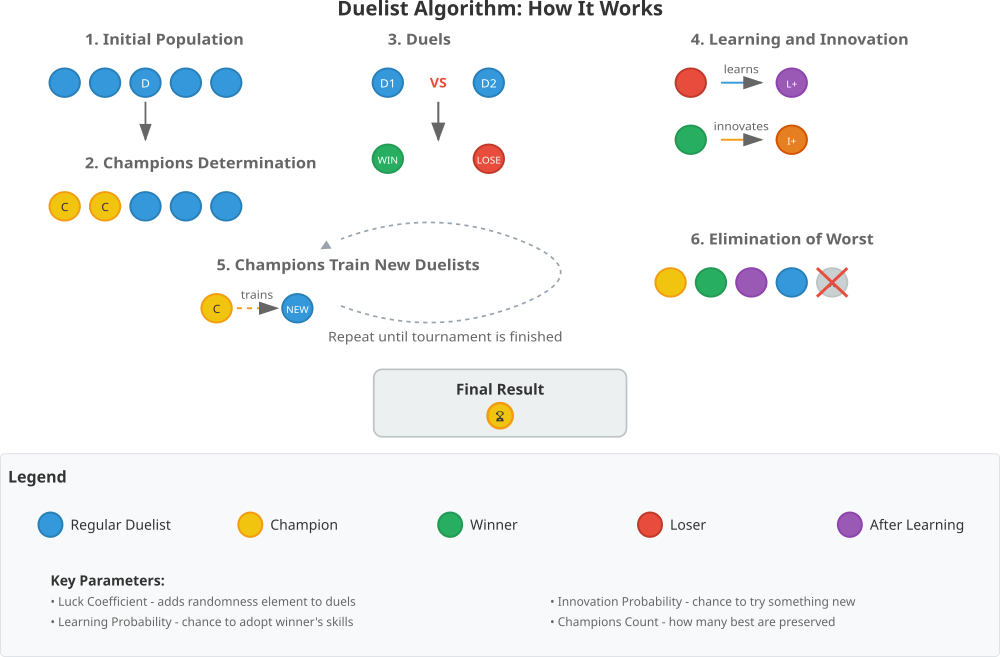
图例1. DAduelist算法的运行过程
通过算法各主要阶段的可视化图展示了决斗者算法的几个关键环节:初始种群 —— 所有决斗个体拥有均等的起始机会;冠军判定 —— 性能最优的决斗个体以金色高亮标记。决斗环节 —— 展示一对一个体对决,并判定胜负;学习与创新 —— 落败者和优胜者两条不同的演化路径;新决斗个体训练 —— 冠军个体将自身特性传递给下一代;淘汰机制 —— 种群中表现最差的个体被移除。
图中还有循环箭头表示算法的迭代特性;同时标注了最终结果、高亮了冠军个体,并附详细图例,说明各图形元素与关键参数的含义。这份可视化图表能帮助读者快速理解算法的核心思想。
将原理梳理清楚后,我们来编写算法的伪代码。
输入:
- popSize:决斗个体的种群规模
- luckCoefficient:决斗运气系数
- learningProbability:落败个体的学习概率
- innovationProbability:优胜个体的创新概率
- championsCount:冠军个体数量
初始化:
1. 校验并修正冠军数量:
- 如果小于1,则设置为1
- 如果大于等于种群规模,则设置为种群规模的1/4
2. 创建空数组winners(优胜者)和losers(落败者)
3. 创建大小为championsCount的champions(冠军)数组
主循环(迭代更新):
如果是第一次迭代:
遍历每一个决斗个体i(索引从0至popSize-1):
遍历每一维度坐标j:
在允许参数范围内随机初始化数值
将revision标识设置为true
退出函数
否则(后续迭代):
1. 种群扩容:
- 将决斗个体数组扩容至popSize + championsCount
- 初始化新增决斗个体的数据结构
2. 判定冠军个体:
- 按适应度值对所有决斗个体排序(冒泡排序)
- 取前championsCount个个体作为冠军
3. 训练新决斗个体:
遍历每一个冠军个体i:
调用TrainNewDuelist(i, popSize + i):
遍历每一维度坐标c:
新个体[c] = 冠军个体[c] + 高斯分布随机数
施加参数范围约束
4. 执行决斗:
清空winners和losers数组
遍历从championsCount到总个体数的每一个决斗个体i: 随机选取一名对手
如果对手不等于i:
判定胜负DetermineWinnerAndLoser(i, opponent):
A_Luck = 个体A适应度 × (运气系数 + 随机数 × 运气系数)
B_Luck = 个体B适应度 × (运气系数 + 随机数 × 运气系数)
如果(A的适应度 + A_Luck)≥(B的适应度 + B_Luck):
A为优胜者,B为落败者
否则:
B为优胜者,A为落败者
将胜负个体分别存入优胜和落败数组
5. 改进优化:
a)落败者学习阶段:
遍历每一组(落败个体,优胜个体)配对:
执行学习流程LearningProcess (loser, winner):
遍历每一维度坐标c:
如果随机值 < 学习概率:
落败个体[c] = 优胜个体[c]
b)优胜者创新阶段:
遍历每一个优胜个体:
执行创新流程InnovationProcess (winner):
遍历每一维度坐标c:
如果随机值 < 创新概率:
winner [c] = 区间内随机值
6. 淘汰筛选:
- 按适应度降序对全部决斗个体排序
- 仅保留前popSize个个体
更新(标记):
遍历所有决斗个体i:
如果个体i的适应度 > 全局最优值global_best:
更新全局最优global_best = 个体i适应度
保存最优解的坐标
重复执行主循环,直到满足终止条件
这里重点说明的是该算法的核心特性:冠军个体不参与决斗,而是负责训练新个体;运气系数引入随机因素,让对决结果具备不确定性。差异化方法:落败个体负责学习,优胜个体尝试寻找创新解。通过淘汰最差个体,使得种群规模保持不变。现在,我们开始实现DA_duelist算法代码。
我们定义C_AO_DA_duelist类,该类继承自C_AO基类,初始化参数数组params,并为各参数指定名称与默认值。
- SetParams() —— 根据params数组中存储的值,修改内部变量(popSize、luckCoefficient等)。
- Init() —— 算法的初始化方法。接收参数范围、参数步长数组以及迭代轮数(epochs)。
- Moving() —— 核心方法,包含“决斗个体”迭代寻优(搜索最优参数)的主逻辑。
- Revision() —— 负责分析结果并调整过程。
变量:
- luckCoefficient —— 运气系数;
- learningProbability —— 学习概率;
- innovationProbability —— 创新概率;
- championsCount —— 冠军个体数量;
- winners[] —— 优胜“决斗个体“索引数组;
- losers[] —— 落败“决斗个体”索引数组;
- champions[] —— “冠军个体”索引数组
- DetermineWinnerAndLoser() —— 判定一场“决斗”的优胜者与落败者;
- LearningProcess() —— 实现落败个体向优胜个体学习的流程;
- InnovationProcess() —— 实现优胜个体的创新流程;
- TrainNewDuelist() —— 基于冠军个体训练生成新的“决斗个体”。
//————————————————————————————————————————————————————————————————————
class C_AO_DA_duelist : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DA_duelist () { }
  C_AO_DA_duelist ()
  {
    ao_name = "DA";
    ao_desc = "Duelist Algorithm";
    ao_link = "https://www.mql5.com/en/articles/19093";

    popSize               = 50;    // number of duelists
    luckCoefficient       = 0.01;  // luck coefficient
    learningProbability   = 0.2;   // learning probability for losers
    innovationProbability = 0.1;   // probability of innovation for winners
    championsCount        = 5;     // number of champions

    ArrayResize (params, 5);

    params [0].name = "popSize";               params [0].val = popSize;
    params [1].name = "luckCoefficient";       params [1].val = luckCoefficient;
    params [2].name = "learningProbability";   params [2].val = learningProbability;
    params [3].name = "innovationProbability"; params [3].val = innovationProbability;
    params [4].name = "championsCount";        params [4].val = championsCount;
  }

  void SetParams ()
  {
    popSize               = (int)params [0].val;
    luckCoefficient       = params      [1].val;
    learningProbability   = params      [2].val;
    innovationProbability = params      [3].val;
    championsCount        = (int)params [4].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double luckCoefficient;       // luck coefficient
  double learningProbability;   // learning probability
  double innovationProbability; // innovation probability
  int    championsCount;        // number of champions

  private: //---------------------------------------------------------
  int    winners [];            // winners' indices
  int    losers  [];            // losers' indices
  int    champions [];          // champions' indices

  void   DetermineWinnerAndLoser (int duelistA, int duelistB);
  void   LearningProcess         (int loserIndex, int winnerIndex);
  void   InnovationProcess       (int winnerIndex);
  void   TrainNewDuelist         (int championIndex, int newDuelistIndex);
};
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的Init方法用于完成算法运行前的准备工作。它的核心任务是在算法启动前,初始化初始参数与各类数据结构。
该方法首先调用标准初始化流程,负责处理参数的取值范围与步长。如果本次标准初始化失败,方法返回false,代表无法继续执行。随后方法对冠军个体数量进行修正:如果该数值小于1,则将其设置为1;如果大于或等于种群规模,则将其缩减为总种群规模的四分之一。接下来,清空并重新分配优胜者、落败者和冠军个体的索引数组,保证数组为空,为算法下一阶段做好准备。最终,方法返回true,代表初始化完成。
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DA_duelist::Init (const double &rangeMinP  [],
                            const double &rangeMaxP  [],
                            const double &rangeStepP [],
                            const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  if (championsCount < 1) championsCount = 1;
  if (championsCount >= popSize) championsCount = popSize / 4;

  ArrayResize (winners, 0);
  ArrayResize (losers,  0);
  ArrayResize (champions, championsCount);

  return true;
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的DetermineWinnerAndLoser方法用于判定种群内两个个体(决斗个体)对决的胜负。执行步骤如下。
- “运气值”计算:分别为两个决斗个体(A和B)计算运气值(A_Luck、B_Luck)。“运气值”由决斗个体的“适应度”f、运气系数luckCoefficient以及u.RNDprobab()生成的随机项共同决定。引入随机量用来模拟对局中的运气因素。
- 判定优胜者:对比个体的适应度f与其“运气值”之和。总和更大或相等的一方判定为优胜者。
- 保存结果:将优胜者与落败者的索引,分别存入对应的winners和losers数组。这些数组用于后续的种群分析与种群演化。
//————————————————————————————————————————————————————————————————————
//--- Determine the winner and loser in a duel
void C_AO_DA_duelist::DetermineWinnerAndLoser (int duelistA, int duelistB)
{
  // Algorithm from the document
  double A_Luck = a [duelistA].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);
  double B_Luck = a [duelistB].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);

  if ((a [duelistA].f + A_Luck) >= (a [duelistB].f + B_Luck))
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistA;
    losers  [ArraySize (losers) - 1] = duelistB;
  }
  else
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistB;
    losers  [ArraySize (losers) - 1] = duelistA;
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的LearningProcess方法实现学习流程:在决斗中落败的个体向优胜个体进行“学习”。该流程的目标是,将优胜个体的部分策略传递给落败个体,以此提升落败个体的性能。下面来看一下该方法内部的执行逻辑:
遍历各维度坐标:通过"for"循环遍历该个体全部的“坐标”。坐标的总数量由变量"coords"决定。
概率复制:在循环内部调用u.RNDprobab()生成随机数做概率判断。如果随机数小于学习概率learningProbability,则执行下述操作。
特征复制:落败个体(loserIndex)从优胜个体(winnerIndex)处“复制”第c维坐标的值。也就是将落败个体对应的特征更新为优胜个体的同维度特征值。从本质上讲,这一步实现了优势策略从强者向弱者的传递。
总而言之,该方法模拟知识或策略从表现更优个体向劣势个体的传递,这正是演化过程的基础。
//————————————————————————————————————————————————————————————————————
//--- A loser learns from a winner
void C_AO_DA_duelist::LearningProcess (int loserIndex, int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < learningProbability)
    {
      // A loser copies part of a winner's strategy
      a [loserIndex].c [c] = a [winnerIndex].c [c];
    }
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的InnovationProcess方法,用于为决斗获胜个体实现“创新”(变异)流程。该流程会对优胜个体的策略引入随机改动,用以探索新的参数可能性。
遍历各维度坐标:通过"for"循环遍历个体全部c坐标,逻辑和LearningProcess方法类似。
概率变异:如果u.RNDprobab()生成的随机数小于创新概率innovationProbability,则触发变异。换言之,个体按照设定概率(由innovationProbability指定)尝试改变自身策略。
新值生成与修正:随机数生成函数u.RNDfromCI()为第c个参数生成一个落在区间rangeMin[c]至rangeMax[c]内的随机值。生成的随机值再经由u.SeInDiSp()做调整。该函数负责将数值转换为给定区间(rangeMin[c], rangeMax[c])内、以步长rangeStep[c]离散取值集合中的有效值。
因此,该方法让优胜个体尝试新策略,有望提升个体自身特性以及对环境的适配能力。这是演化流程中十分重要的一环。
//————————————————————————————————————————————————————————————————————
//--- The innovation process for a winner
void C_AO_DA_duelist::InnovationProcess (int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < innovationProbability)
    {
      // The winner tries a new technique (mutation)
      a [winnerIndex].c [c] = u.RNDfromCI (rangeMin [c], rangeMax [c]);
      a [winnerIndex].c [c] = u.SeInDiSp (a [winnerIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的TrainNewDuelist方法负责创建新的决斗个体(候选解),并基于当前冠军个体对其进行“训练”,完成初始化。这是一种带随机扰动的继承机制,能够为种群引入基因多样性。
遍历各维度坐标:通过"for"循环遍历新决斗个体(newDuelistIndex)的全部c参数(坐标),逐个完成赋值。
计算偏差:计算偏差值,用于确定参数的扰动幅度。
带变异的继承(高斯分布):调用u.GaussDistribution()获取随机偏差,叠加到冠军个体(championIndex)的第c维特征上。该函数生成服从正态分布(高斯分布)的随机数,为继承而来的特征施加随机扰动。传入参数0、rangeMin[c]、rangeMax[c]、8为正态分布配置:均值0、参数上下限,以及控制分布宽度的参数(8)。
离散网格对齐(SeInDiSp):变异后得到的新决斗个体特征值,通过u.SeInDiSp()函数转换为离散集合内的有效值。该函数保证新个体参数落在允许区间内,并且匹配参数步长rangeStep[c]。
最终,新决斗个体获得与冠军个体相近的参数特征,但附带随机扰动。这为种群创造多样性,从而能够探索新的策略。
//————————————————————————————————————————————————————————————————————
//--- A champion trains a new duelist
void C_AO_DA_duelist::TrainNewDuelist (int championIndex, int newDuelistIndex)
{
  for (int c = 0; c < coords; c++)
  {
    // The new duelist inherits the champion's abilities with slight variations
    double deviation = (rangeMax [c] - rangeMin [c]) * 0.1;
    a [newDuelistIndex].c [c] = a [championIndex].c [c] + u.GaussDistribution (0, rangeMin [c], rangeMax [c], 8);
    a [newDuelistIndex].c [c] = u.SeInDiSp (a [newDuelistIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的Moving方法是决斗个体演化算法的核心迭代步骤。该方法包含(首次运行时的)种群初始化、繁殖、筛选、决斗、(基于决斗结果的)学习训练、创新以及淘汰操作。演化流程的核心逻辑都封装在该方法内部:
种群初始化(首次运行):如果是第一次运行(revision为 false),则执行种群初始化:对每一个个体i,按照参数允许的取值范围与步长,为其所有特征j随机赋值。初始化完成后,将revision设置为true,避免后续迭代重复初始化。
繁殖准备:代表种群的数组a扩容,用于存放由冠军个体生成的新决斗个体。初始化新决斗个体(设置初始状态)。
判定冠军个体:按适应度f对种群排序,选出性能最优个体。确定冠军集合 ,随后选取排名前championsCount的个体作为冠军,每位冠军通过TrainNewDuelist方法“繁殖”出一个继承自身特征的新决斗个体。
决斗准备:清空 "winners"和"losers"数组,为存储新一轮决斗结果做准备。
执行决斗:除冠军外,其余所有个体(含新繁殖的决斗个体)各自随机挑选一名对手进行对决。通过DetermineWinnerAndLoser判定每一场决斗的胜负。
决斗个体训练(学习阶段):落败个体向优胜个体学习,通过LearningProcess,让落败者吸收优胜者的优良特征、调整自身参数。
优胜个体创新:优胜个体调用InnovationProcess,尝试改变自身策略,探索新的参数空间。
重新排序:在完成决斗、学习、创新带来的参数变更后,再次依据适应度f对整个种群重新排序,更新个体排名。
淘汰劣质个体:将数组a的大小重置为种群规模popSize,剔除最差个体,维持种群总数恒定。
以上步骤构成一次完整的演化迭代:繁殖后代、筛选优秀个体、执行学习、更新策略,并保持种群规模恒定。Moving方法实现演化算法的基础操作:繁殖、变异、筛选与学习。
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DA_duelist::Moving ()
{
  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Temporary array expansion for new duelists
  int totalDuelists = popSize + championsCount;
  ArrayResize (a, totalDuelists);

  // Initialize new duelists
  for (int i = popSize; i < totalDuelists; i++)
  {
    a [i].Init (coords);
  }

  // Sort to determine champions (using bubble sort)
  for (int i = 0; i < popSize - 1; i++)
  {
    for (int j = 0; j < popSize - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Determine the champions
  for (int i = 0; i < championsCount; i++)
  {
    champions [i] = i;
    // A champion trains a new duelist
    TrainNewDuelist (i, popSize + i);
  }

  // Clear the winners' and losers' arrays
  ArrayResize (winners, 0);
  ArrayResize (losers,  0);

  // Conduct duels (excluding champions)
  for (int i = championsCount; i < totalDuelists; i++)
  {
    // Each duelist fights one random opponent
    int opponent = u.RNDintInRange (championsCount, totalDuelists - 1);
    if (opponent != i)
    {
      DetermineWinnerAndLoser (i, opponent);
    }
  }

  // Improving duelists
  int minCount = MathMin (ArraySize (winners), ArraySize (losers));
  for (int i = 0; i < minCount; i++)
  {
    // Losers learn from winners
    LearningProcess (losers [i], winners [i]);
  }

  for (int i = 0; i < ArraySize (winners); i++)
  {
    // Winners innovate
    InnovationProcess (winners [i]);
  }

  // Sort all duelists
  for (int i = 0; i < totalDuelists - 1; i++)
  {
    for (int j = 0; j < totalDuelists - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Remove the worst duelists
  ArrayResize (a, popSize);
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist类的Revision方法用于更新当前种群中搜索得到的最优解信息。该方法的作用,是在演化过程中持续追踪全局最优解。
遍历种群:通过"for"循环遍历种群内的每一个个体(i从0到popSize)。
适应度对比:循环体内,判断当前个体的适应度 f是否优于当前最优适应度fB。
更新最优解:如果a[i].f优于fB,则更新fB,也就是让fB保存迄今为止找到的最优适应度。同时,将当前个体的各项特征c复制到cB数组中。即cB用于存储当前最优个体对应的特征参数。
最后,Revision方法会扫描整个当前种群,找出适应度最高的个体。如果该个体优于当前“历史记录”,则更新最优个体的相关信息(包含其适应度以及参数特征)。该方法是追踪算法寻优进度、获取全局最优解所必需的。
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DA_duelist::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
测试结果
总体来看,根据=研究结果,决斗者算法整体表现还可以。DA|Duelist Algorithm|100.0|0.01|0.9|0.1|2.0|
=============================
5 Hilly's;函数运行次数:10000;结果:0.9278151663330798
25 Hilly's;函数运行次数:10000;结果:0.5377820196319314
500 Hilly's;函数运行次数:10000;结果:0.27792394907287765
=============================
5 Forest's;函数运行次数:10000;结果:0.8695700230324329
25 Forest's;函数运行次数:10000;结果:0.47535947112902815
500 Forest's;函数运行次数:10000;结果:0.18193288697223736
=============================
5 Megacity's;函数运行次数:10000;结果:0.6215384615384616
25 Megacity's;函数运行次数:10000;结果:0.3356923076923076
500 Megacity's;函数运行次数:10000;结果:0.11715384615384725
=============================
总分:4.34477(48.28%)
算法运行过程的可视化结果显示:无论低维还是高维场景,参数值的分布离散程度都较小,这表明该算法具备良好的搜索能力。
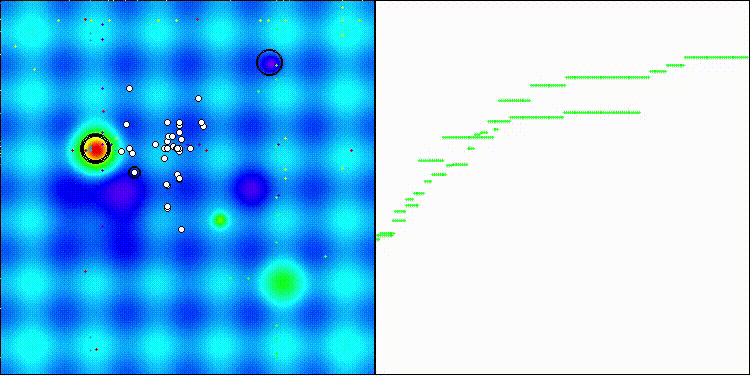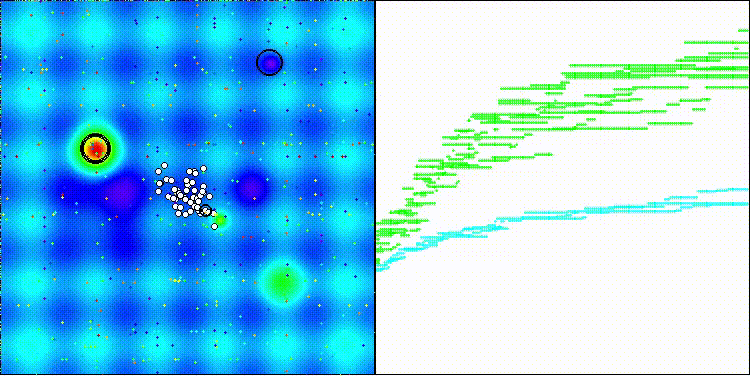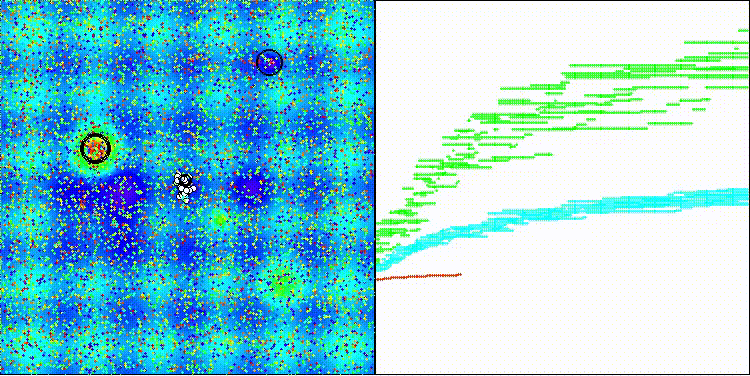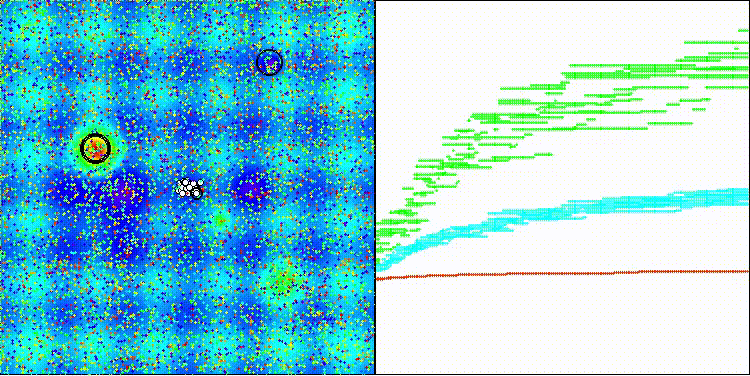
DA_duelist在Hilly测试函数上
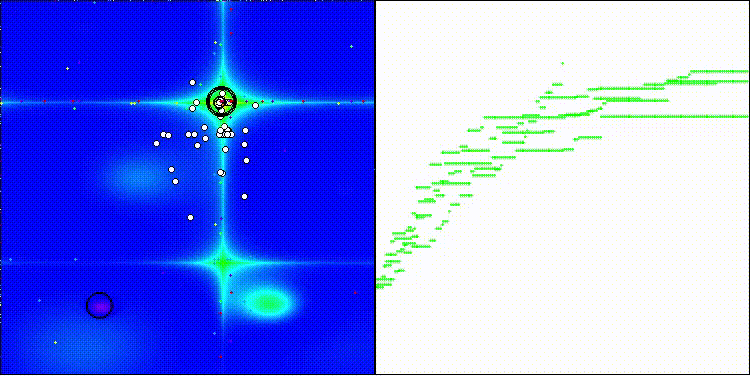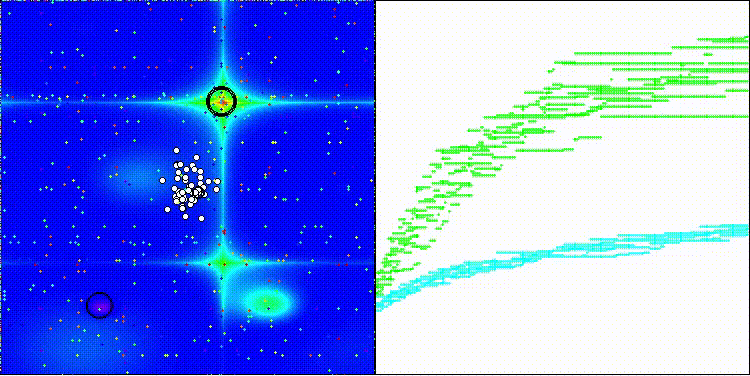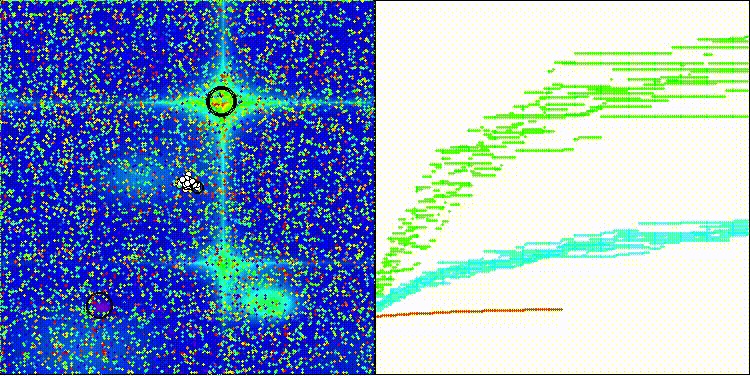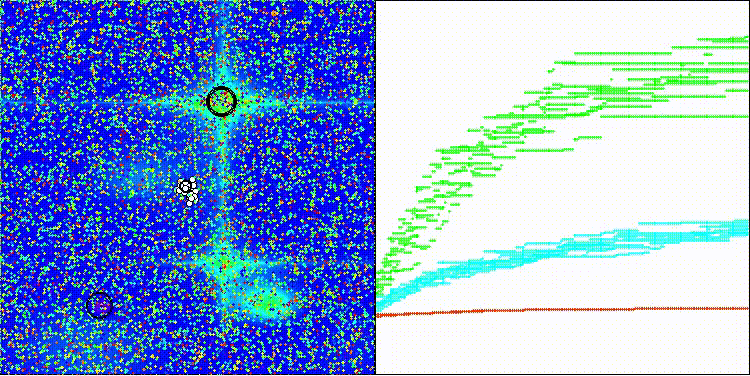
DA_duelist在Forest测试函数上
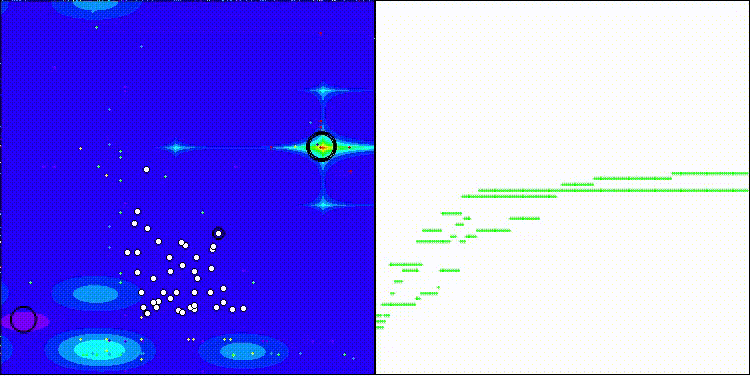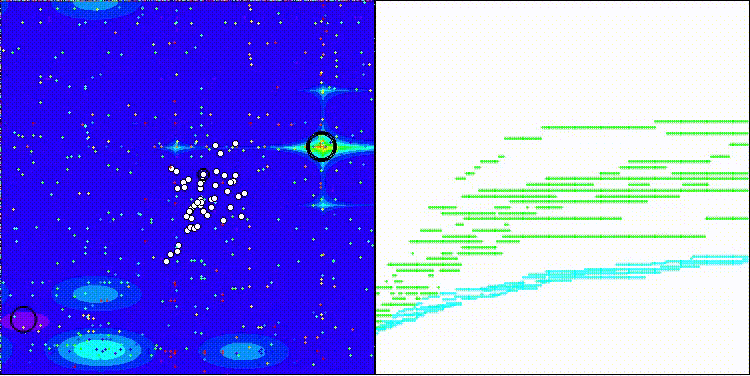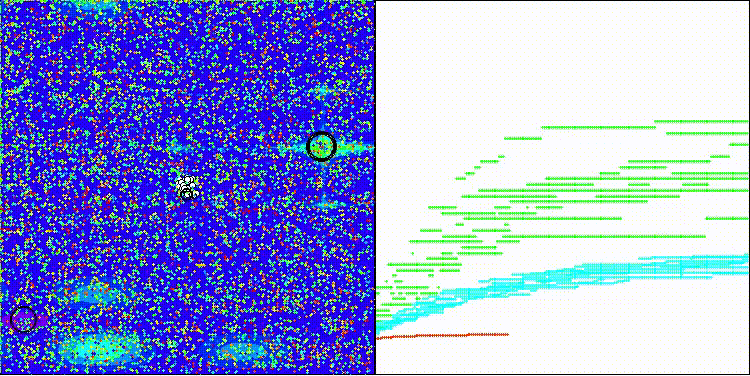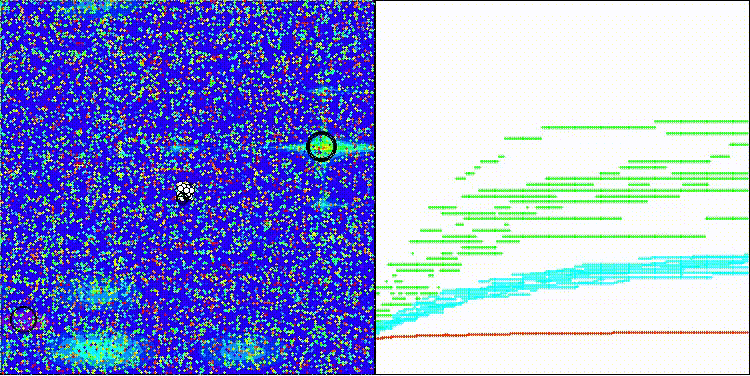
DA_duelist在Megacity测试函数上
根据测试结果,在所有参与对比的优化算法中,决斗者算法位列第42位。
| # | AO | 描述 | Hilly | Hilly 最终 | Forest | Forest 最终 | Megacity (离散) | Megacity 最终 | 最终 结果 | % of 最大 | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | 跨邻域搜索 | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | 密码锁算法(joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | 动物迁徙优化M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O) 进化策略 | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | 彗星尾算法(joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | 时间演化旅行算法(joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | 随机扩散搜索 M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | 台球优化算法M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | 射箭算法M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | 社会群体的进化(joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | 模拟各向同性退火(joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | 极值优化M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | 生物地理学优化算法 | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | 人工协同搜索 | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | 辩证算法 | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | 黑洞算法M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | 无序社会优化 | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | 皇家同花顺优化(joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | 原子轨道搜索M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | 龟壳演化算法(joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | 回溯搜索算法 | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | 差分进化 | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | 成功餐饮经营者算法 (joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | 化学反应优化 | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | 血液遗传优化算法(joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | BSA | 鸟群算法 | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 27 | DEA | 差分进化算法 | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 28 | HS | 和声搜索 | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 29 | SSG | 树苗播种和生长 | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51.95 |
| 30 | BCOm | 细菌趋化性优化算法M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 31 | ABO | 非洲水牛优化 | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51.49 |
| 32 | (PO)ES | (PO) 进化策略 | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 33 | FBA | 基于分形的算法 | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50.61 |
| 34 | TSm | 禁忌搜索M | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 35 | BSO | 头脑风暴优化 | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 36 | WOAm | 鲸鱼优化算法M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 37 | AEFA | 人工电场算法 | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 38 | AEO | 基于人工生态系统的优化算法 | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 39 | CAm | 骆驼算法M | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 40 | ACOm | 蚁群优化M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 41 | CMAES | 协方差矩阵自适应演化策略 | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 42 | DA_duelist | 决斗者算法 | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48.28 |
| 43 | BFO-GA | 细菌觅食优化 - ga | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 44 | SOA | 简单优化算法 | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| 45 | ABHA | 人工蜂巢算法 | 0.84131 | 0.54227 | 0.26304 | 1.64663 | 0.87858 | 0.47779 | 0.17181 | 1.52818 | 0.50923 | 0.33877 | 0.10397 | 0.95197 | 4.127 | 45.85 |
| RW | 随机游走 | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
总结
决斗者算法在元启发式优化算法中的表现尚可,在参与对比的种群优化算法中位列前45名之内(具体为第42位)。它虽算不上最优的优化算法,但核心优势在于运算速度快。
自适应学习策略 —— 在交易系统优化场景中,这意味着表现欠佳的参数组合能快速向成功组合取经;对非平稳金融时间序列而言,这一点尤为宝贵。
利用与探索的平衡 —— 优胜个体不会止步于现有成果,而是持续通过创新寻求性能提升。对于需要适应不断变化市场环境的交易策略而言,这一点至关重要。
可控的随机元素(运气系数) —— 为市场不确定性提供了自然的建模方式:再优秀的策略,也可能因短期波动而阶段性失手。
精英保留机制 —— 确保最优解得以留存并扩散;放到交易场景中,就相当于保住久经考验的成熟策略,同时不断发掘新机会。
决斗者算法不失为一种可靠的优化方案。它借用格斗竞技的比喻,为优化领域带来一个简洁而有效的核心思想:向强者学习,在优势之上寻求创新,并把经验传给下一代。
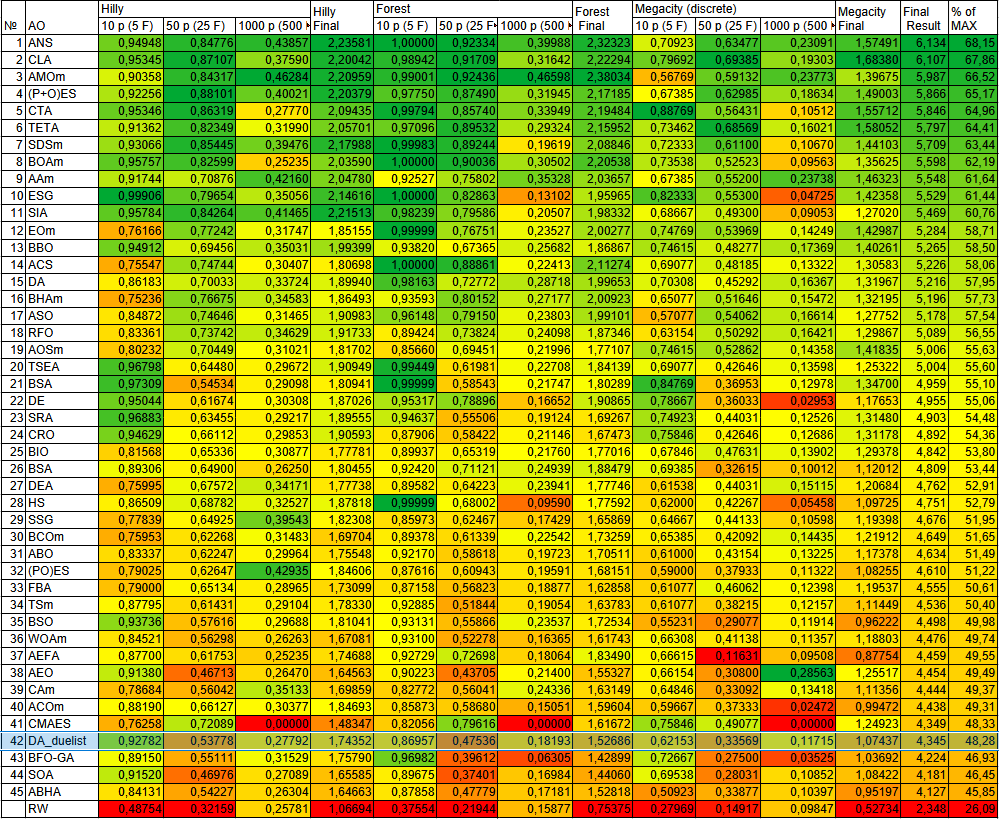
图例2. 算法对应各组测试下的色彩分级图
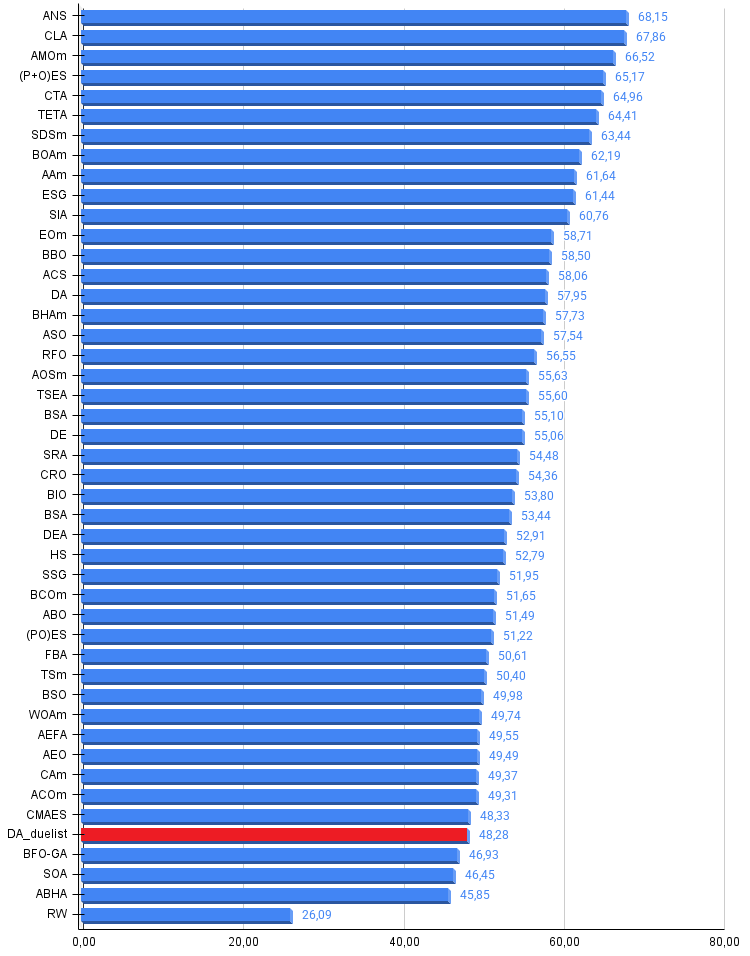
图例3. 算法测试结果的直方图(评分范围为0到100,越高越好,其中100为理论上的最高可能得分,压缩包中附有用于计算排名表的脚本)
决斗者算法的优缺点:
优点:
- 快速。
- 在所有测试函数上的表现都较为稳定(方差小)。
缺点:
- 收敛精度较低。
包含该算法最新版本代码的压缩包参见附件。本文作者对标准算法描述的绝对准确性不承担责任。为提升搜索能力,已经对其中的许多算法进行了修改。文章中表述的结论和论断都是基于实验的结果。
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | #C_AO.mqh | 库 | 种群优化算法的基类 |
| 2 | #C_AO_enum.mqh | 库 | 种群优化算法的枚举说明 |
| 3 | TestFunctions.mqh | 库 | 测试函数库 |
| 4 | TestStandFunctions.mqh | 库 | 测试台函数库 |
| 5 | Utilities.mqh | 库 | 辅助函数库 |
| 6 | CalculationTestResults.mqh | 库 | 用于计算比较表结果的脚本 |
| 7 | Testing AOs.mq5 | 脚本 | 面向所有种群优化算法的统一测试平台 |
| 8 | Simple use of population optimization algorithms.mq5 | 脚本 | 种群优化算法非可视化简易使用案例 |
| 9 | Test_AO_DA_duelist.mq5 | 脚本 | DA_duelist测试 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19093
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 MQL5 自优化 EA(第12部分):利用矩阵分解构建线性分类器
 新手在交易中的10个基本错误


文章《决斗者算法——Duelist Algorithm》 已发布:
作者:Andrey Dik
在擂台上交锋的决斗者。市场并非擂台,而是一片战场。时而身处泥泞,时而深陷沼泽。在冰面上,花样滑冰选手会获胜;但在沼泽里……最终,会造就出怎样的战士呢?
大家可以自己上网查查,这可不是本帖作者杜撰的