

科学家群体优化(CoSO):算法实现
 24
 0

目录
算法的实现
让我们继续描述在文章第一部分中开始的算法实现。在此,我们将展示针对特定测试函数的实验测试结果。
AssignFunds 函数描述了 CoSO 算法中向研究人员分配可用“资金”的机制。这些资源代表着学习、移动或参与后续过程的机会,其分配方式会影响解决方案演化的动态。该函数接受一个参数:availableFunds,即待分配的资金总额。该过程分为几个阶段。
资金分为两部分。计算出外部资金(outsiderFunds),这是专为“外部研究人员”预留的资金部分。这部分金额按可用资金总额的一定比例计算,其中 omegaCurrent(控制外部研究人员资金份额的参数)是一个系数。剩余资金存储在 existingFunds 中,分配给活跃的研究人员。在现有研究人员之间分配资金。 仅当存在“全局报表”(globalReport)时,才会执行此部分。如果其大小大于零,则计算 totalRank - 从 1 到 reportSize 的等差数列中所有排名的总和。本质上,它是用于按比例分配资金的权重因子的总和。然后,资金(existingFunds)将逐一分配:对于每个资金,生成一个随机数乘以总排名,并将此结果用于选择研究人员。对 globalReport 进行迭代。
对于 globalReport 中的每条记录,都会计算一个累计 cumSum,并加上一个等于 (reportSize - i) 的“权重”。这意味着报告中排名较高的研究人员会获得更大的权重,因此更有可能获得资助。如果随机数落在与当前研究人员相关的区间内(即 rnd <= cumSum),则该研究人员的资金数额增加 1。之后,当前基金的分配周期中断,并继续进行下一笔基金的分配。
创建外部研究人员。 最后,调用 CreateOutsiders 函数,并将 outsiderFunds 传递给它。该函数利用专门的“外部”资金来培养新的研究人员,或者换句话说,启动新的研究路径。因此,AssignFunds 实现了一种资助管理策略,该策略既奖励成熟的研究人员(通过 existingFunds 和基于排名的分配),同时又激发新想法或新参与者的出现(通过 outsiderFunds)。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::AssignFunds (int availableFunds)
{
  // Funds for outsiders
  int outsiderFunds = (int)(availableFunds * omegaCurrent);
  int existingFunds = availableFunds - outsiderFunds;

  int reportSize = ArraySize (globalReport);

  // Distribute funds to existing researchers
  if (reportSize > 0)
  {
    int totalRank = reportSize * (reportSize + 1) / 2;

    for (int f = 0; f < existingFunds; f++)
    {
      double rnd = u.RNDprobab () * totalRank;
      double cumSum = 0;

      for (int i = 0; i < reportSize; i++)
      {
        cumSum += reportSize - i;
        if (rnd <= cumSum)
        {
          researchers [globalReport [i].index].m++;
          break;
        }
      }
    }
  }

  // Create outsiders
  CreateOutsiders (outsiderFunds);
}
//————————————————————————————————————————————————————————————————————
CreateOutsiders 函数描述了在 CoSO 模型中创建新的“研究人员”的过程,使用了专门为“外部研究人员”分配的资源。这些新研究人员代表着潜在的多样性或引入到系统中的新思想。该函数接受一个参数:outsiderFunds - 用于创建外部研究人员的资金数额。如果 outsiderFunds 小于或等于零,则该函数立即中止,因为没有资金来创建外部研究人员。
确定新研究人员的数量。已设置 maxNew:当前可创建的新外部研究人员的最大数量。该值取决于当前的种群规模。如果种群很大(超过 100 个元素),则 maxNew 等于 2(以减缓增长速度)。否则,maxNew 为 5。这是一种控制种群增长的机制。将确定实际新增的研究人员数量。它是在 1 到 outsiderFunds 和 maxNew 的最小值之间的范围内随机选择的。这确保了新研究人员的数量不会超过可用资金和既定限额,然后计算每位新研究人员将获得的资金数额(只需将总外部资金除以新研究人员数量即可)。
培养新研究人员的循环。 该函数通过循环多次创建 newResearchers:首先,它在现有的研究员数组中寻找“空闲”空间。如果找到空闲空间(idx != -1),则使用该空间。如果没有空闲空间,但当前种群大小小于最大允许大小(maxPopSize),则将新空间添加到数组末尾(idx = actualPopSize)。
(如有必要)扩展数组。 如果没有可用空间,并且 “actualPopSize” 已经等于或大于 “maxPopSize”,则检查研究人员数组的大小是否可以增加。如果 actualPopSize 已经达到 maxPopSize,则计算一个新的最大大小(newMaxSize),即 maxPopSize + 50,但不超过 500。这是限制种群增长的另一种机制。如果达到 500 的绝对限制,则跳过当前迭代(不会创建新的外部研究人员)。否则,maxPopSize 将更新为 newMaxSize。检查完毕后,idx 设置为 actualPopSize,以使用第一个新位置。如果由于某种原因,在所有查找或创建位置的尝试之后,idx 仍然为 -1,则跳过创建当前研究人员。
初始化新的研究人员。 如果成功找到或创建了 idx 位置,则将 researchers [idx]. alive 设置为 “true”,使研究人员处于活动状态,并将资金或 “motivation” 的数量设置为 fundsPerNew,并将 “strength” 或另一个参数的初始值初始化为随机数。
坐标初始化(在解空间中的位置)。 对于每个 c 坐标(“coords” 是维度数),位置被初始化为给定范围内的随机数。然后,研究人员 [idx].x [c] 使用 SeInDiSp 函数调整采样步骤,并将“最佳”位置(最初等于当前位置)也设置为研究人员 [idx].x [c]。变化率或变化向量由从具有给定参数的正态分布中抽取的随机数初始化。
期刊概率初始化(发表期刊)。 对于每个期刊 “j”(journalsNum — 期刊数量),在期刊 j 上发表文章的概率被初始化为一个随机数。然后对 researchers[idx].rho 调用 NormalizeProbabilities,以确保该研究人员的所有 rho 之和等于 1。
更新种群规模。 如果向数组末尾添加了一个新的研究人员,则 actualPopSize 更新为 idx + 1。
因此,CreateOutsiders 会动态地向种群中添加新的研究人员,在解决方案空间中随机初始化他们,并将分配的资金分配给他们。maxNew 和 maxPopSize 限制机制用于控制种群规模,防止其无限增长。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::CreateOutsiders (int outsiderFunds)
{
  if (outsiderFunds <= 0) return;

  // Limit the number of new outsiders, especially if the population is already large
  int maxNew = (actualPopSize > 100) ? 2 : 5;
  int newResearchers = (int)(u.RNDfromCI (1, MathMin (outsiderFunds, maxNew)));
  int fundsPerNew = outsiderFunds / newResearchers;

  for (int i = 0; i < newResearchers; i++)
  {
    // Find free space
    int idx = -1;
    for (int j = 0; j < actualPopSize; j++)
    {
      if (!researchers [j].alive)
      {
        idx = j;
        break;
      }
    }

    if (idx == -1 && actualPopSize < maxPopSize)
    {
      idx = actualPopSize;
    }

    if (idx == -1) // No space, expand the array
    {
      if (actualPopSize >= maxPopSize)
      {
        // Limit population growth
        int newMaxSize = MathMin (maxPopSize + 50, 500);
        if (newMaxSize == maxPopSize) continue; // Limit reached, skip creation

        maxPopSize = newMaxSize;
        ArrayResize (researchers, maxPopSize);
        for (int j = actualPopSize; j < maxPopSize; j++)
        {
          researchers [j].Init (coords, journalsNum);
          researchers [j].alive = false;
        }
        idx = actualPopSize;
      }
    }

    if (idx == -1) continue; // Failed to create

    researchers [idx].alive = true;
    researchers [idx].m = fundsPerNew;
    researchers [idx].s = u.RNDprobab ();

    // Random initialization
    for (int c = 0; c < coords; c++)
    {
      researchers [idx].x [c] = u.RNDfromCI (rangeMin [c], rangeMax [c]);
      researchers [idx].x [c] = u.SeInDiSp (researchers [idx].x [c], rangeMin [c], rangeMax [c], rangeStep [c]);
      researchers [idx].b [c] = researchers [idx].x [c];
      researchers [idx].v [c] = u.GaussDistribution (0.0, -0.01, 0.01, 1);
    }

    // Initialize journal probabilities
    for (int j = 0; j < journalsNum; j++)
    {
      researchers [idx].rho [j] = u.RNDprobab ();
    }
    NormalizeProbabilities (researchers [idx].rho);

    if (idx >= actualPopSize) actualPopSize = idx + 1;
  }
}
//————————————————————————————————————————————————————————————————————
HireResearchers 功能描述了现有研究人员在获得充足资助的情况下“聘用”新研究人员的过程。这是一种根据现有元素(解决方案)的特点来创造新元素(解决方案)的机制,这是一种复制或多样化的形式。该函数接受一个参数:“主管”( 即负责招聘新研究人员的人)的索引。如果该索引对应研究人员的资金少于或等于 1,则函数立即返回。这意味着需要足够的资金用于招聘。
主管资金分离。 计算主管人员个人的资金份额。这是该主管当前资金总额乘以 researchers[idx].s 得到的保留资金。已计算出可用于招聘的资金。这是剩余的资金。主管资金正在更新。如果 hireFunds 小于或等于 0,则无法招聘,函数中止。
确定需要聘请的研究人员人数。 可聘用的新研究人员数量上限已设定。如果当前种群规模较大(超过 100),则 maxNew 为 1。否则,maxNew 为 3。这是一种控制种群增长的机制。将确定实际新增的研究人员数量。它是从 1 到 hireFunds 和 maxNew 的最小值之间的随机选择值。计算每位新聘研究人员将获得的资金数额(用 hireFunds 除以 newCount)。
培养新研究人员的周期(招聘)。 然后该函数迭代 newCount 次:首先,它在现有的研究人员数组中寻找一个“空闲”位置。空闲空间被视为活动标志设置为 “false” 的索引,如果找到空闲空间,则使用该空间。如果没有空闲空间,但当前种群规模小于允许的最大规模,则在数组末尾添加一个新槽位。
检查招聘的可能性(当达到限额时)。 如果没有可用空间,并且 actualPopSize 已经等于或大于 maxPopSize,或者 actualPopSize 已经等于或大于 500 的绝对限制,则跳过创建当前研究人员(循环进入下一次迭代或终止)。如果 newIdx 仍然是 -1,则表示找不到或无法为新研究人员创建空间,并且跳过当前循环迭代。
初始化新的研究人员。 如果成功找到位置,则将 researchers [newIdx]. alive 设置为“true”,使新研究人员处于活动状态,并将新研究人员的资金设置为 fundsPerNew。新研究人员的“倾向性”参数被初始化为从高斯分布中抽取的随机数。该分布的均值取自 researchers[idx].s(主管参数),意味着新研究员将与其“主管”相似。's' 的值仅限于 '0' 到 '1' 的范围内。
继承主管的特质。新研究人员找到的最佳位置或“知识”直接复制自主管的最佳位置,使新研究人员能够继承“经验”。
初始化位置(坐标)。 对于每个 c 坐标(coords — 维度数),新研究人员的位置初始化为主管的位置,再加上从高斯分布中取的随机扰动。这意味着新研究人员会出现在他们的主管“附近”,但不会和主管在同一个位置。该位置受指定限制。然后,研究人员 [newIdx].x [c] 使用 SeInDiSp 函数对采样步骤进行调整,速率或变化向量也从正态分布中随机初始化。
期刊(发表)概率的初始化。 对于每个 j 期刊(journalsNum — 期刊数量),在 j 期刊上发表文章的概率被初始化为从高斯分布中抽取的随机数。该分布的均值取自主管概率。这样一来,新研究人员就可以继承导师的期刊偏好,但也会有一些随机的变化。负的 ρ 值被截断为 0。然后对 researchers[newIdx].rho 调用 NormalizeProbabilities,以确保该研究者的所有 rho 之和等于 1。
更新种群规模。 如果向数组末尾添加了一个新的研究人员(newIdx 等于或大于 actualPopSize),则 actualPopSize 更新为 newIdx + 1。
因此,HireResearchers 允许成功的研究人员复制自身,创建新的实例,这些实例继承了他们的一些特征,但也存在一些随机变化。这促进了对搜索空间中邻近区域的探索和成功策略的传播,同时控制了总体种群规模。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::HireResearchers (int idx)
{
  if (researchers [idx].m <= 1) return;

  int keepFunds = (int)(researchers [idx].m * researchers [idx].s);
  int hireFunds = researchers [idx].m - keepFunds;
  researchers [idx].m = keepFunds;

  if (hireFunds <= 0) return;

  // Limit the number of people hired, especially in case of a large population
  int maxNew = (actualPopSize > 100) ? 1 : 3;
  int newCount = (int)(u.RNDfromCI (1, MathMin (hireFunds, maxNew)));
  int fundsPerNew = hireFunds / newCount;

  for (int i = 0; i < newCount; i++)
  {
    // Find free space
    int newIdx = -1;
    for (int j = 0; j < actualPopSize; j++)
    {
      if (!researchers [j].alive)
      {
        newIdx = j;
        break;
      }
    }

    if (newIdx == -1 && actualPopSize < maxPopSize)
    {
      newIdx = actualPopSize;
    }

    if (newIdx == -1) // No space
    {
      if (actualPopSize >= maxPopSize || actualPopSize >= 500) continue; // Skip creation when the limit is reached
    }

    if (newIdx == -1) continue; // Unable to find space

    researchers [newIdx].alive = true;
    researchers [newIdx].m = fundsPerNew;
    researchers [newIdx].s = u.GaussDistribution (researchers [idx].s, 0, 1, 1);
    if (researchers [newIdx].s < 0) researchers [newIdx].s = 0;
    if (researchers [newIdx].s > 1) researchers [newIdx].s = 1;

    // Inherit from a supervisor
    ArrayCopy (researchers [newIdx].b, researchers [idx].b, 0, 0, WHOLE_ARRAY);

    // Position near a supervisor
    for (int c = 0; c < coords; c++)
    {
      researchers [newIdx].x [c] = researchers [idx].x [c] + u.GaussDistribution (0.0, -0.01, 0.01, 1);

      // Boundary control
      if (researchers [newIdx].x [c] < rangeMin [c]) researchers [newIdx].x [c] = rangeMin [c];
      if (researchers [newIdx].x [c] > rangeMax [c]) researchers [newIdx].x [c] = rangeMax [c];

      researchers [newIdx].x [c] = u.SeInDiSp (researchers [newIdx].x [c], rangeMin [c], rangeMax [c], rangeStep [c]);
      researchers [newIdx].v [c] = u.GaussDistribution (0.0, -0.01, 0.01, 1);
    }

    // Perturbed journal probabilities
    for (int j = 0; j < journalsNum; j++)
    {
      researchers [newIdx].rho [j] = u.GaussDistribution (researchers [idx].rho [j], 0, 1, 1);
      if (researchers [newIdx].rho [j] < 0) researchers [newIdx].rho [j] = 0;
    }
    NormalizeProbabilities (researchers [newIdx].rho);

    if (newIdx >= actualPopSize) actualPopSize = newIdx + 1;
  }
}
//————————————————————————————————————————————————————————————————————
“ComputeStdDev” 函数旨在计算总体中所有活跃研究人员的目标函数值的标准差。它是衡量数据围绕均值的离散程度的指标,在优化的背景下,它可以指示当前群体中解决方案的多样性。
计算平均值:- 初始化变量 “mean”(用于累加 “f” 值的总和)和 “count”(用于统计活跃研究人员的数量)。
- 该函数遍历 “researchers” 数组中从 “0” 到 actualPopSize - 1 的所有研究人员。
- 在循环内部,它会检查 researchers[i] 是否“活跃”,因为只有活跃的研究人员才应该被纳入计算。
- 如果研究人员活跃,则将其 “f” 值添加到 “mean” 中,“count”加 1。
- 第一次循环结束后,如果 “count” 仍然为 0(未找到活跃的研究人员),则该函数返回 0。
- 最后,将 “mean” 除以 “count”,得到所有活跃研究人员的平均 “f” 值。
- “variance” 变量初始化为 0。
- 该函数再次遍历 “researchers” 数组中的所有研究人员。
- 再次测试活跃研究人员条件。
- 对于每个活跃的研究人员,计算其 “f” 值与已计算的 “mean” 之差的平方。将这个平方差加到 “variance” 中。
- 第二个循环完成后,“variance” 除以 “count”。这给出了活跃研究人员的 “f” 值的方差。
//————————————————————————————————————————————————————————————————————
double C_AO_CoSO::ComputeStdDev ()
{
  if (actualPopSize == 0) return 0;

  double mean = 0;
  int count = 0;

  for (int i = 0; i < actualPopSize; i++)
  {
    if (researchers [i].alive)
    {
      mean += researchers [i].f;
      count++;
    }
  }

  if (count == 0) return 0;
  mean /= count;

  double variance = 0;
  for (int i = 0; i < actualPopSize; i++)
  {
    if (researchers [i].alive)
    {
      variance += MathPow (researchers [i].f - mean, 2);
    }
  }
  variance /= count;

  return MathSqrt (variance);
}
//————————————————————————————————————————————————————————————————————
UpdateOmega 函数动态调整 omegaCurrent 参数,该参数表示算法行为中外部研究人员的比例或选择外部研究人员的概率。该函数的目的是根据研究人员群体的当前状态(即它们在搜索空间中的分散程度)自适应地控制探索/利用策略。
该函数首先调用 ComputeStdDev() 来确定 currentSigma — 活跃研究人员的目标函数值的当前标准差。currentSigma 值越高,意味着解决方案种类越多;而 currentSigma 值越低,意味着解决方案越趋于收敛。
案例一:种群趋同(当前 Sigma < sigma0)。 如果当前标准差小于某个预先定义的 sigma0 阈值,这表明研究人员开始趋同或聚集在某些解决方案周围。在这种情况下,算法进入对已找到的解决方案进行利用(改进)的阶段。为了避免过早收敛到局部最优解,并鼓励进一步探索和寻找更好的解决方案,外部研究人员(omegaCurrent)的比例正在增加。增长量计算公式为(omegaMax - omegaMin)/ 2.0 * epsilonPlus。其中 omegaMax 和 omegaMin 定义了 omegaCurrent 的上限和下限,而 epsilonPlus 是一个控制增长率的正系数。目标是更加重视那些可能与总体趋势有所不同或代表全新方法的元素。
案例 2:种群分化或缺乏趋同(当前Sigma >= sigma0)。 如果标准差大于或等于 sigma0 阈值,则意味着总体分布仍然很分散,或者处于研究的早期阶段。在这种情况下,外部研究人员(omegaCurrent)的份额正在减少。减少量计算公式为 (omegaMax - omegaMin) / 2.0 * epsilonMinus,其中 epsilonMinus 是一个负系数,用于控制减少率。这样做是为了防止算法在种群已经足够多样化的情况下,浪费太多资源进行随机探索,从而可以开始专注于更有前景的领域。
范围限制(omegaCurrent)。 更改 omegaCurrent 后,该函数确保其值保持在指定范围内;如果 omegaCurrent 低于 omegaMin,则将其设置为 omegaMin;如果高于 omegaMax,则将其设置为 omegaMax,从而防止该参数超出合理的运行范围。
一般来说,UpdateOmega 函数实现的是一种自适应策略。当一群研究人员表现出快速收敛的迹象(标准差低)时,该算法会增加选择“外部研究人员”(或可能扰乱当前结构的元素)的概率,以帮助避免陷入局部最优解,并鼓励对更广阔的空间进行新的搜索或探索。相反,当种群分布仍然很广泛时,该算法会减少对外部个体的关注,转而更加系统地探索或利用已发现的有前景的领域。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::UpdateOmega ()
{
  double currentSigma = ComputeStdDev ();

  if (currentSigma < sigma0)
  {
    // Increase the proportion of outsiders at convergence
    omegaCurrent += (omegaMax - omegaMin) / 2.0 * epsilonPlus;
  }
  else
  {
    // Reduce the share of outsiders
    omegaCurrent -= (omegaMax - omegaMin) / 2.0 * epsilonMinus;
  }

  // Limit the range
  if (omegaCurrent < omegaMin) omegaCurrent = omegaMin;
  if (omegaCurrent > omegaMax) omegaCurrent = omegaMax;
}
//————————————————————————————————————————————————————————————————————
NormalizeProbabilities 函数旨在转换数值数组 “probs”,使其表示正确的概率分布。也就是说,执行该函数后,“probs” 数组中所有元素的总和将等于 1。 “sum” 变量初始化为0。它将用于累加 “probs” 数组中所有元素的总和。启动一个循环,遍历该数组的所有元素。在循环内部,probs[i] 的每个值都会添加到 “sum” 变量中。
如果计算出的“总和”为正数,则启动第二个循环,该循环也会遍历 “probs” 数组的所有元素。在这个循环中,数组中的每个元素都除以 “sum”。经过这种除法运算,‘probs[i]’ 的每个值都成为总和的相应分数,数组中所有元素的总和等于 1。这是标准的归一化程序。
如果 “sum” 为 0 或负数(这在概率中并不常见,但该函数可以处理),则表示没有东西可以用来对原始值进行归一化。例如,所有初始概率均为零。在这种情况下,函数采用“均匀分布”。“val” 的计算公式为(1.0 / size)。这意味着数组中的每个元素都具有相同的概率,因此总和为 1。第三个循环开始,该循环遍历 “probs” 数组的所有元素。在这个循环中,每个元素都被赋予计算出的 “val” 值。因此,数组中的每个元素都等于(1 / size),它们的总和为 1。
该函数是一种通用实用方法,用于确保一组权重或“原始”概率可以用作真正的概率分布(“true” 意味着所有概率之和为 1)。这在许多算法中都很重要,例如基于概率的选择方法、轮盘赌或蒙特卡罗方法,因为适当的归一化可以防止错误并确保正确的统计行为。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::NormalizeProbabilities (double &probs [])
{
  double sum = 0;
  int size = ArraySize (probs);

  for (int i = 0; i < size; i++)
  {
    sum += probs [i];
  }

  if (sum > 0)
  {
    for (int i = 0; i < size; i++)
    {
      probs [i] /= sum;
    }
  }
  else
  {
    // Even distribution
    double val = 1.0 / size;
    for (int i = 0; i < size; i++)
    {
      probs [i] = val;
    }
  }
}
//————————————————————————————————————————————————————————————————————
CompactPopulation 函数管理算法中研究人员群体的大小和组成。主要目标是剔除效率最低的研究人员,并在必要时将种群规模减少到可管理的程度,以维持算法的效率和性能。
统计“活跃”研究人员的数量。 aliveCount 变量(幸存者人数)初始化为 0。接下来,循环遍历当前人口中的所有研究人员(从 0 到 actualPopSize - 1)。检查每位研究人员的状态(researchers [i]. alive)。如果资源管理器处于“存活”状态(其 “alive” 属性为 “true”),则 aliveCount 递增 1。压实/减量条件。 在统计出活跃研究人员的数量后,该函数会检查是否需要进行数据压缩。如果满足以下两个条件之一,就会发生这种情况:活跃研究人员的数量 aliveCount 小于当前总种群规模 actualPopSize 的 75%,或者当前种群规模 actualPopSize 大于 200(即使他们中的大多数都还活着,种群也被认为太大,需要减少)。
压实的第一阶段(去除“不活跃”人员)。 如果满足压实条件之一,则压实过程开始。新的索引初始化为 0。该索引将指向 “researchers” 数组开头的下一个空位,“活跃”研究人员将移动到该位置。启动一个循环,遍历所有研究人员(从 0 到 actualPopSize - 1)。在循环内部,如果当前研究人员处于“活跃”状态,则会检查它是否已位于正确的位置,如果不是,则表示需要将其向前移动到数组中。
研究人员被复制到 newIdx 位置。通常情况下,即使原始研究人员已被复制,也会将其标记为“已删除”或不活跃,此时会设置 (researchers [i]. alive = false)。这是清理操作。newIdx 递增 1,指向下一个活跃研究人员的下一个位置。完成此周期后,所有“活跃”的研究人员都将位于 “researchers” 数组的开头。人口数量已更新为 aliveCount。
种群压缩的第二阶段(种群规模大幅减少)。 在第一阶段(移除不活跃用户并将活跃用户转移)之后,该函数会检查 actualPopSize 是否仍然超过 150。这是一个嵌套条件 — 只有当种群已经高度集中或有很多不活跃的研究人员时,才能满足该条件。如果 actualPopSize 大于 150,则表示即使删除了不活跃的用户,人口仍然过多,需要进一步减少到允许的最大规模 150。为此,需要按“适应度”进行排序。 之后,适应度最强的研究人员将排在队伍的最前面。
剔除“最差”的研究人员。 从第 150 个元素开始的所有研究人员(即排序后排在“尾部”的研究人员)都被标记为“不活跃”(researchers [i]. alive = false)。它们的 “m” 参数也被重置。最后,actualPopSize 设置为 150,有效地将人口数量减少到所需的最大规模。此函数确保种群:- 不会积累未使用的个体,从而避免占用内存和减慢处理速度。
- 它不会不受控制地生长,而不受控制的生长也会对生产力和效率产生负面影响,并导致算法过早失效。
- 当种群数量达到临界值时,通过剔除最差的个体来维持一定的质量水平。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::CompactPopulation ()
{
  // Count living researchers
  int aliveCount = 0;
  for (int i = 0; i < actualPopSize; i++)
  {
    if (researchers [i].alive) aliveCount++;
  }

  // If there are too many dead, compactify
  if (aliveCount < actualPopSize * 0.75 || actualPopSize > 200)
  {
    int newIdx = 0;
    for (int i = 0; i < actualPopSize; i++)
    {
      if (researchers [i].alive)
      {
        if (i != newIdx)
        {
          // Copy the living researcher to a new location
          researchers [newIdx] = researchers [i];
          researchers [i].alive = false;
        }
        newIdx++;
      }
    }
    actualPopSize = aliveCount;

    // If the population is still too large, limit it
    if (actualPopSize > 150)
    {
      // Sort by 'fitness' and keep the best
      for (int i = 0; i < actualPopSize - 1; i++)
      {
        for (int j = i + 1; j < actualPopSize; j++)
        {
          if (researchers [i].f < researchers [j].f)
          {
            S_Researcher temp = researchers [i];
            researchers [i] = researchers [j];
            researchers [j] = temp;
          }
        }
      }

      // Kill the worst
      for (int i = 150; i < actualPopSize; i++)
      {
        researchers [i].alive = false;
        researchers [i].m = 0;
      }
      actualPopSize = 150;
    }
  }
}
//————————————————————————————————————————————————————————————————————
CoSO 算法中剩余的修订方法启动一个循环,该循环遍历 “a” 数组中的所有个体,从索引 0 到 “aSize - 1”。在循环内部,对于每个 a[i] 个体,检查 if (a [i]. f > fB) 条件。如果当前个体的目标函数值大于当前全局最优值,则 fB 更新为新的最优值:fB = a[i].f。已保存该最佳个体的索引。
在遍历完 “a” 数组中的所有个体之后,检查 if (bestIND != -1) 条件。如果至少找到一个目标函数优于先前 fB 值的个体,则此条件为 “true”。如果找到了新的最佳个体(bestIND 不等于 -1),则调用 ArrayCopy 函数,将找到的最佳个体的“c”参数复制到全局 cB 数组中。
该方法的主要目的是保持算法在给定时刻找到的全局最优解的当前状态。在像 CoSO 这样的进化算法中,“全局最优”的概念会随着更好解决方案的发现而不断受到监控和更新。然后利用这个“全局最优”结果来指导搜索。从本质上讲,该函数实现了算法每次迭代中“记住最佳解决方案”的步骤。
//————————————————————————————————————————————————————————————————————
void C_AO_CoSO::Revision ()
{
  int bestIND = -1;
  int aSize = ArraySize (a);

  for (int i = 0; i < aSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      bestIND = i;
    }
  }

  if (bestIND != -1)
  {
    ArrayCopy (cB, a [bestIND].c, 0, 0, WHOLE_ARRAY);
  }
}
//————————————————————————————————————————————————————————————————————
测试结果
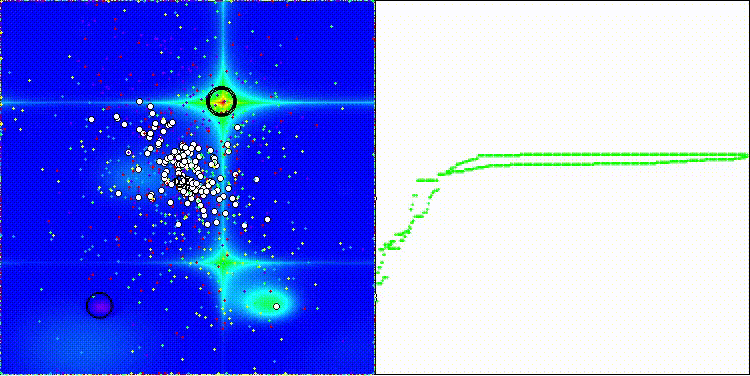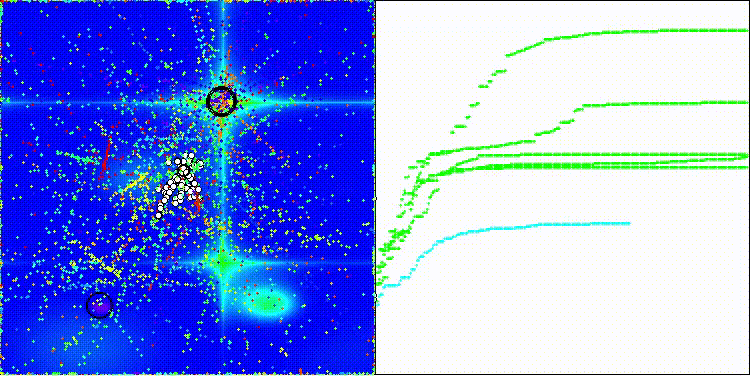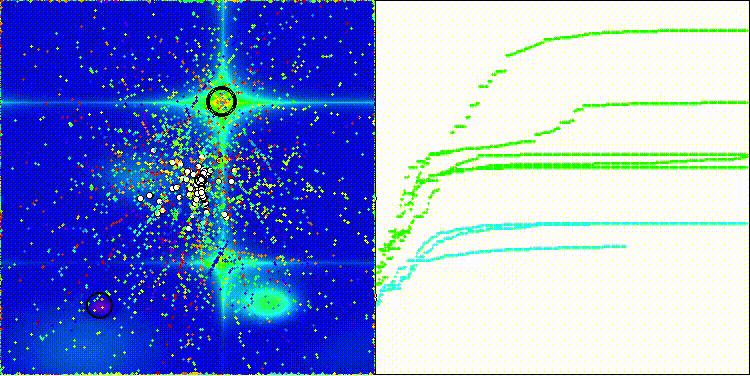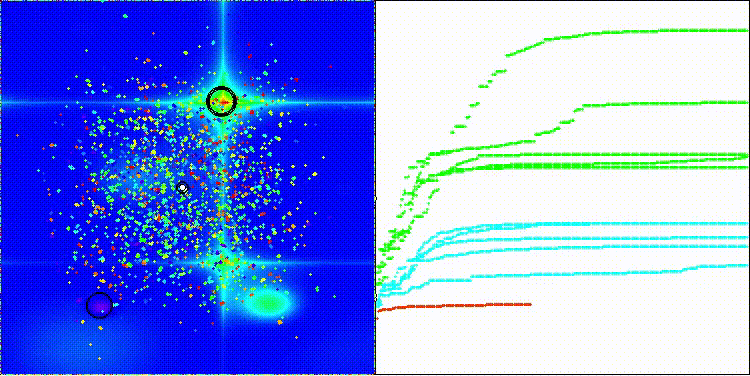
CoSO算法运行良好,结果令人满意。当然,您可以尝试调整这些参数。=============================
5 Hilly's; Func runs:10000; result:0.8047081198587067
25 Hilly's;Func runs:10000; result:0.5429326559833119
500 Hilly's; Func runs:10000; result:0.30916988715342353
=============================
5 Forest's; Func runs:10000; result:0.7383405771205314
25 Forest's; Func runs:10000; result:0.38224371519203115
500 Forest's; Func runs:10000; result:0.20600693936217676
=============================
5 Megacity's; Func runs:10000; result:0.553846153846154
25 Megacity's; Func runs:10000; result:0.2550769230769231
500 Megacity's;Func runs:10000; result:0.11129230769230862
=============================
All score:3.90362 (43.37%)
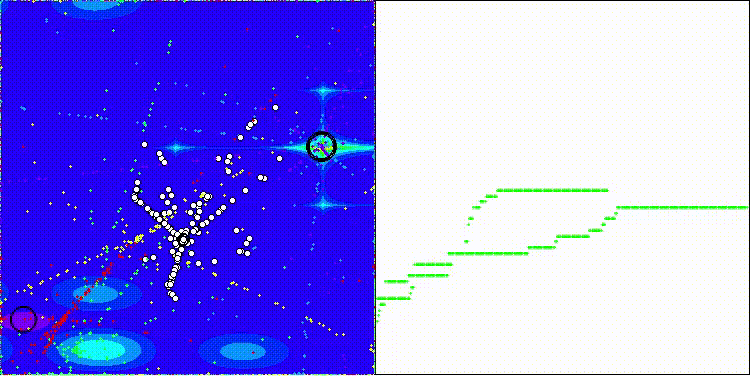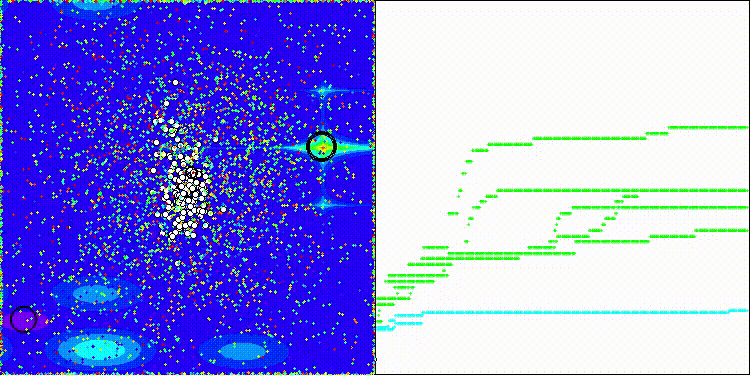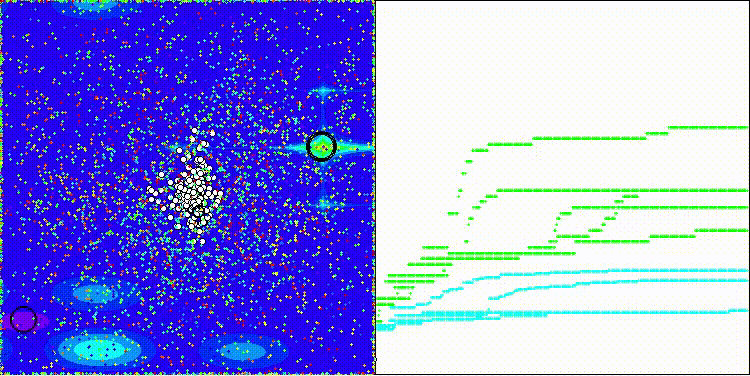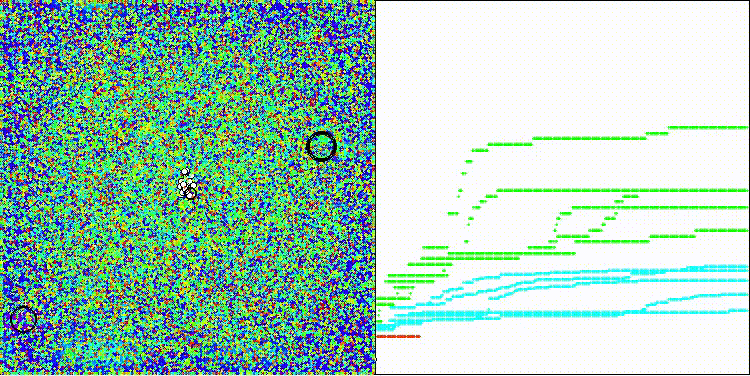
这是我第一次见到这种不同寻常的算法可视化方式,其原因在于该算法具有多层次的实现逻辑。
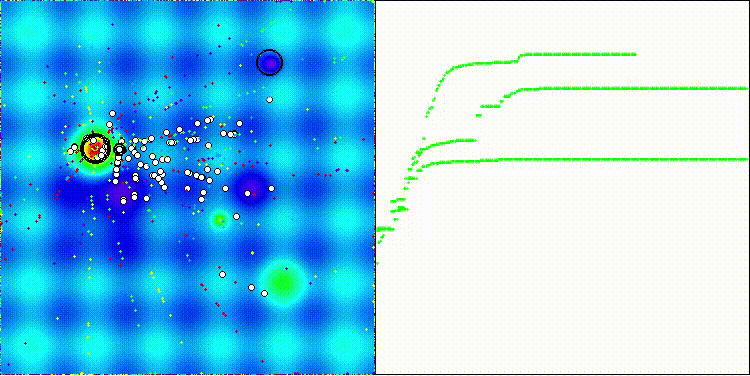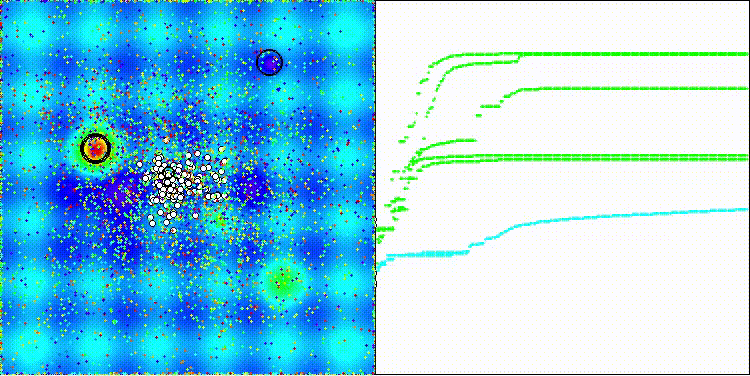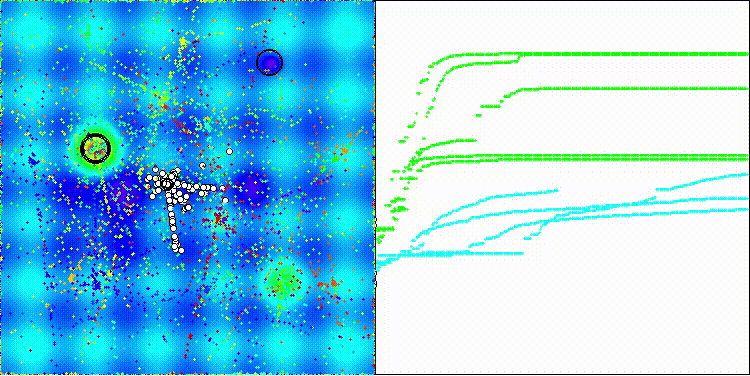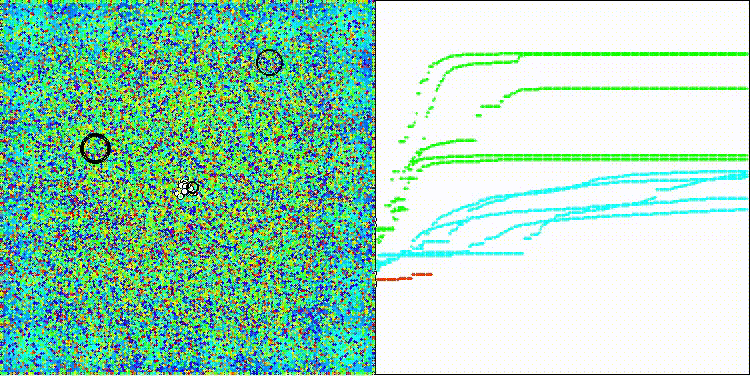
Hilly 测试函数上的 CoSO
Forest 测试函数上的 CoSO
Megacity 测试函数上的 CoSO
根据结果,在排名表中提供了 CoSO 算法以供参考。我想指出的是,我们的表格越来越紧凑,低于 45% 的结果已经超出了它的限制。
| # | 算法 | 描述 | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final 结果 | % 的 最大限度 | ||||||
| 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | ||||||||
| 1 | ANS | 跨邻里搜索(across neighbourhood search) | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | 密码锁算法(joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | 动物迁徙优化 M(animal migration optimization M) | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O) 演进战略((P+O) evolution strategies) | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | 彗尾算法(joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | 时间演化旅行算法(joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | 随机扩散搜索 M(stochastic diffusion search M) | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | 台球优化算法 M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | 射箭算法 M(archery algorithm M) | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | 社会群体的进化(joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | 模拟各向同性退火(joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | 极端优化_M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | 基于生物地理学的优化 | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | 人工协同搜索(artificial cooperative search) | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | 辩证算法 | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | 黑洞算法 M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | 无政府社会优化(anarchy society optimization) | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | 皇家同花顺优化(joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | 原子轨道搜索 M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | 龟壳进化算法(joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | 回溯搜索算法 | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | 差分进化(differential evolution) | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | 成功餐馆算法(joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | 化学反应优化(chemical reaction optimization) | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | 血液遗传优化(joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | BSA | 鸟群算法(bird swarm algorithm) | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 27 | DEA | 海豚回声定位算法 | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 28 | HS | 和声搜索(harmony search) | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 29 | SSG | 树苗播种和生长(saplings sowing and growing) | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51.95 |
| 30 | BCOm | 细菌趋化性优化 M(bacterial chemotaxis optimization M) | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 31 | ABO | 非洲水牛优化 | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51.49 |
| 32 | (PO)ES | (PO) 进化策略((PO) evolution strategies) | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 33 | FBA | 基于分形的算法 | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50.61 |
| 34 | TSm | 禁忌搜索 M(tabu search M) | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 35 | BSO | 头脑风暴优化(brain storm optimization) | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 36 | WOAm | Wale 优化算法 M(wale optimization algorithm M) | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 37 | AEFA | 人工电场算法(artificial electric field algorithm) | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 38 | AEO | 基于人工生态系统的优化算法 | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 39 | CAm | 骆驼算法 M | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 40 | ACOm | 蚁群优化M(ant colony optimization M) | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 41 | CMAES | 协方差矩阵自适应演化策略 | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 42 | BFO-GA | 细菌觅食优化 - ga(bacterial foraging optimization - ga) | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 43 | SOA | 简单优化算法 | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| 44 | ABHA | 人工蜂巢算法(artificial bee hive algorithm) | 0.84131 | 0.54227 | 0.26304 | 1.64663 | 0.87858 | 0.47779 | 0.17181 | 1.52818 | 0.50923 | 0.33877 | 0.10397 | 0.95197 | 4.127 | 45.85 |
| 45 | ACMO | 大气云模型优化(atmospheric cloud model optimization) | 0.90321 | 0.48546 | 0.30403 | 1.69270 | 0.80268 | 0.37857 | 0.19178 | 1.37303 | 0.62308 | 0.24400 | 0.10795 | 0.97503 | 4.041 | 44.90 |
| CoSO | 科学家群体优化 | 0.80471 | 0.54293 | 0.30917 | 1.65681 | 0.73834 | 0.38224 | 0.20600 | 1.32658 | 0.55384 | 0.25507 | 0.11129 | 0.92020 | 3.904 | 43.37 | |
| RW | 随机游走 | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
总结
CoSO 算法在测试函数上的表现为平均水平,达到了最大可能性能的 43%。当然,我原本期待更令人满意的结果。测试台提供了一套扩展的函数,包括标准和众所周知的函数,任何人都可以进一步尝试参数选择和函数选择,以更好地利用算法能力。
当前实现的主要缺点是计算复杂度高。多层架构、日志、动态资源分配和自适应种群管理带来了巨大的负载。该算法明显慢于其他种群方法,这限制了其在需要快速解决方案的问题中的应用。
然而,CoSO 的概念基础具有相当大的意义。科学界的建模引入了已应用的独特机制:动态群体能够根据问题的复杂性自动调整计算资源,期刊系统确保高效的信息交换同时不遗漏最佳解决方案,竞争性资助在没有严格规则的情况下创造自然选择,而招聘机制则试图解决局部/全局搜索的困境。
改进的潜力显而易见。不应将 CoSO 视为现成的解决方案,而应将其视为一个有前景的研究平台。该算法为进化优化开辟了新方向,使人类社会中的社会机制成为计算策略的源泉。经过适当开发,CoSO 可以在那些适应性和应变能力至关重要、计算时间不是关键的任务中找到自己的定位。
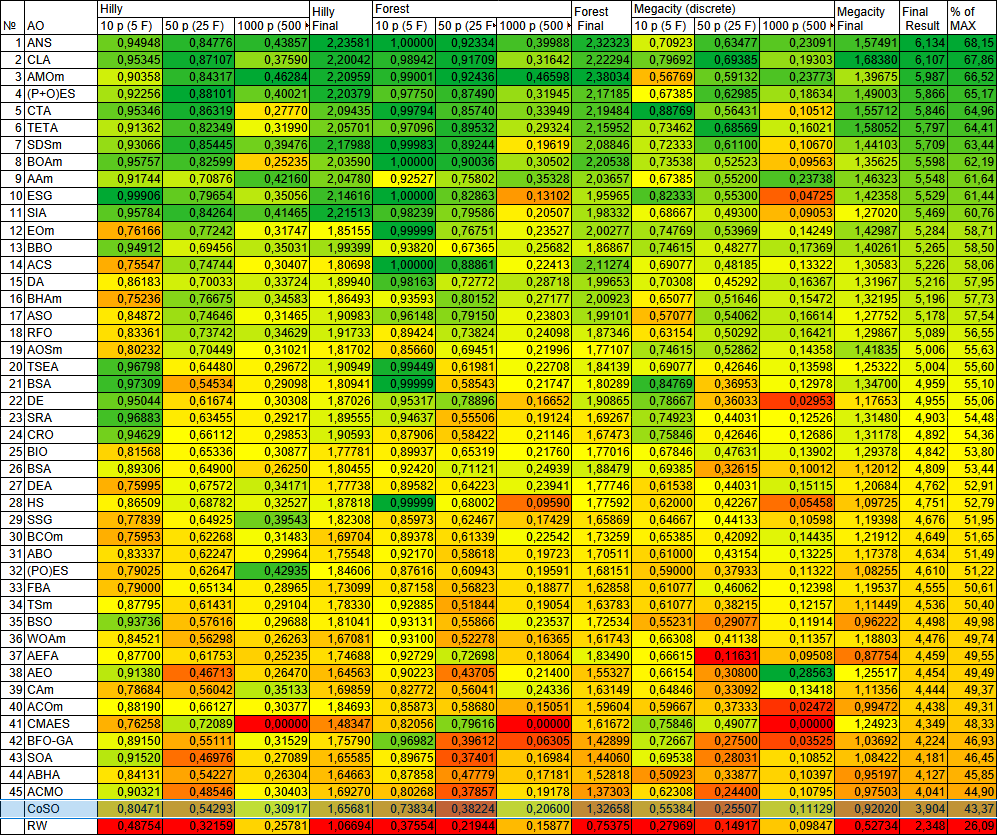
图1。不同测试中算法的颜色编码比较
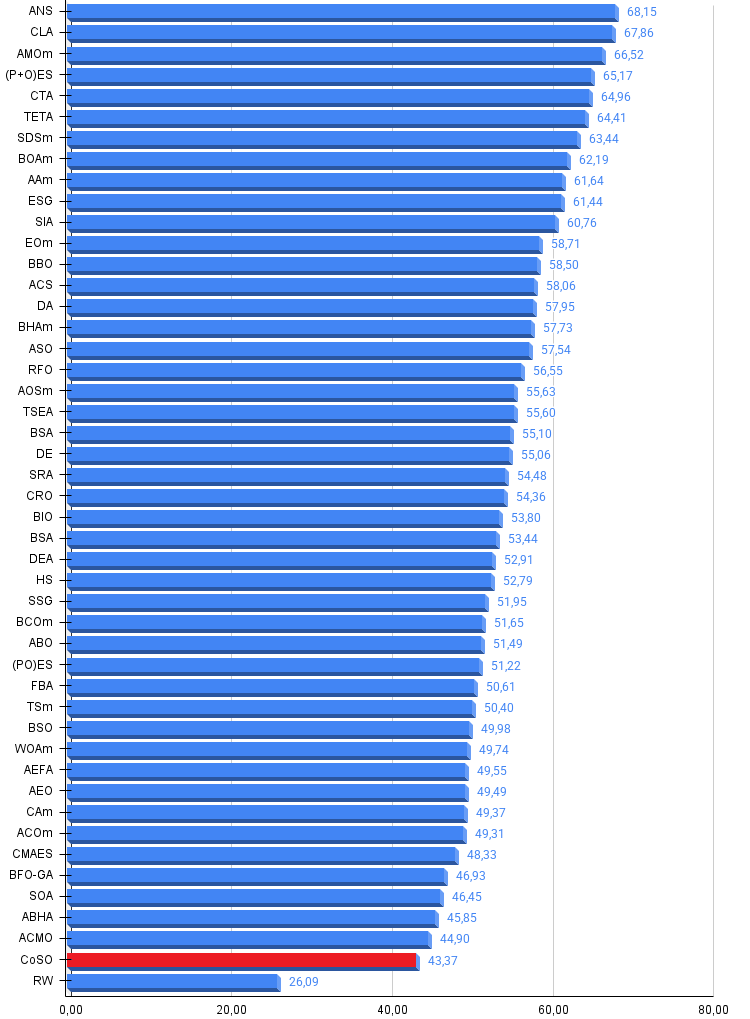
图 2.算法测试结果直方图(范围从 0 到 100,越高越好,其中 100 是可能的最大理论结果,存档中有一个用于计算评级表的脚本)
CoSO 的优缺点:
优点:
- 为开发该算法的新变体奠定了良好的基础。
缺点:
- 大量外部参数;
- 在某些问题上陷入停滞的倾向;
- 慢。
文章附带了包含该算法最新代码版本的压缩包。文章作者不对规范算法描述的绝对准确性负责。为提高搜索能力,已对其中多项功能进行了修改。文章中提出的结论和判断都是基于实验结果。
本文中用到的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | #C_AO.mqh | 包含文件 | 种群优化算法的父类 |
| 2 | #C_AO_enum.mqh | 包含文件 | 种群优化算法的枚举 |
| 3 | TestFunctions.mqh | 包含文件 | 测试函数库 |
| 4 | TestStandFunctions.mqh | 包含文件 | 测试平台函数库 |
| 5 | Utilities.mqh | 包含文件 | 辅助函数库 |
| 6 | CalculationTestResults.mqh | 包含文件 | 用于计算比较表中结果的脚本 |
| 7 | Testing AOs.mq5 | 脚本 | 所有种群优化算法的统一测试平台 |
| 8 | Simple use of population optimization algorithms.mq5 | 脚本 | 使用不带可视化的种群优化算法的简单示例 |
| 9 | Test_AO_CoSO.mq5 | 脚本 | CoSO 测试台 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/18935
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 交易中的神经网络:自适应周期分块(Token生成)
 新手在交易中的10个基本错误
 MQL5 中的量子神经网络(第二部分):基于 ALGLIB 马尔可夫矩阵的神经网络反向传播训练
