

夢最適化アルゴリズム(DOA)
 29
 1

目次
はじめに
最適化手法を幅広く研究するなかで、私は、議論の的となっており、まだ十分に研究されていない現象である「夢」のメカニズムに着想を得た、まったく新しい独特なアプローチに興味を引かれました。
2025年3月、Y. LangとY. Gaoは、学術誌「Computer Methods in Applied Mechanics and Engineering」(第436巻)に、新しいメタヒューリスティック最適化アルゴリズムである「Dream Optimization Algorithm」を発表しました。 人間の夢が持つ独特な特性に着想を得たこのアルゴリズムは、取引システムのパラメータ調整を含む、複雑な最適化問題を解決するための新たな可能性を開きます。
DOAは、睡眠プロセスに関連する3つの重要な側面をシミュレートします。すなわち、記憶の一部を保持すること、情報を選択的に忘却した後に新たな情報を補充すること、そして集団内のエージェント間で「夢」を交換することです。 アルゴリズム取引の文脈では、これらのメカニズムによって、パラメータ空間の新たな領域を探索することと、すでに見つかった良好な解を活用することのバランスを取ります。このバランスは、市場環境が時間とともに変化する非定常な金融市場において、取引戦略を最適化するうえで重要です。
本記事では、アルゴリズムの数学的な基礎を詳しく解説し、MQL5で実装したうえで、ほかの集団ベースの最適化手法との比較分析をおこないます。
アルゴリズムの実装
私たちの脳は、睡眠中に3つの重要な働きをすると考えられています。その日に得た重要な情報を記憶に定着させ、不要な細部を忘れ、さまざまな記憶を組み合わせて新しいアイデアを生み出すことです。
DOAは、これらと同様の原理を利用して最適解を探索します。 初期化の後、集団全体を複数のグループに分割します。 各グループには、それぞれ異なる「記憶スタイル」が割り当てられます。最も多くの次元を変更する第1グループから、変更する次元数が最も少ない第6グループまで、グループごとに変更する次元数(k)が異なります。この数は、グループ番号と問題の全次元数(D)に応じて決まります。
アルゴリズムの実行時間の大部分は、探索フェーズに割り当てられています。 まず、各グループで記憶戦略を適用し、グループ内のすべてのエージェントを、そのグループで見つかった最良の位置に戻します。その後、一定の確率で忘却・補充戦略を適用します。 この場合、ランダムに選択したk個の次元を、余弦変調を用いて変更します。使用する式は「cos((i+T/10)π/T)」です。これにより、探索の初期には大きなステップを取り、時間の経過とともにステップを徐々に小さくします。 残りの確率では、夢交換戦略を適用します。この戦略では、集団内からランダムに選んだ別のエージェントの値を、k個の次元についてコピーします。
最終段階では、アルゴリズムは活用フェーズに移行します。このフェーズでは、すべてのエージェントを大域最良解の位置に戻し、ごく小さなステップで微調整します。微調整には、最適化の終了時にゼロに近づく余弦関数「cos(iπ/T)」を使用します。この仕組みにより、グループの記憶機構を通じた探索空間の探索と、最終段階における短時間かつ精密な最適化とのバランスを実現します。
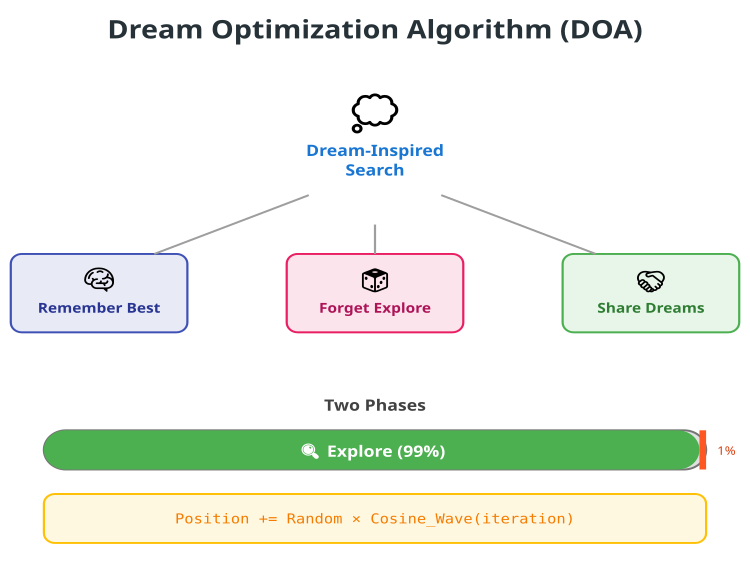
図1: DOAアルゴリズムの動作
上の図は、DOAアルゴリズムの構造図を示しています。 図の上部中央には、「Dream-Inspired Search(夢に着想を得た探索)」と記された雲形の吹き出しがあります。 そこから3本の線が伸び、アルゴリズムの3つの主要な戦略につながっています。青いブロックの「Remember Best」は記憶戦略を表し、中央のピンクのブロック「Forget Explore」は忘却と探索の戦略を、右側の緑のブロック「Share Dreams」はエージェント間で経験を共有する戦略を表しています。
その下の「Two Phases(2つのフェーズ)」では、アルゴリズムの実行時間の配分が横長のバーで示されています。緑色の「Explore(探索)」が全体の99%を占め、右端の赤色の部分が残りの1%を占めています。この図は、探索フェーズと活用フェーズの間に大きな時間配分の偏りがあることを強調しています。
図の最下部には、アルゴリズムの重要な数式「Position += Random × Cosine_Wave(iteration)」が示されています。これは、位置の更新に乱数と余弦波による係数を使用することを表しており、DOAの動作における余弦変調の重要性を示しています。 それでは、擬似コードを見ていきましょう。
初期化
DOAアルゴリズムの開始
パラメータを設定する:
- 集団サイズ = 60エージェント
- グループ数 = 6
- 探索の割合 = 総時間の99%
- 忘却確率 = 30%
探索空間内のランダムな位置に60のエージェントを作成する
エージェントを6つの等しいグループ(各10エージェント)に分割する
各グループの最良解を、考え得る最悪の解で初期化する
メインの最適化ループ
反復番号1から最大反復回数まで、各反復について:
反復番号が総反復回数の99%以下の場合:
探索フェーズを実行する
それ以外の場合:
活用フェーズを実行する
探索
グループm(1から6まで)について:
グループmの最良のエージェントを見つける
グループ最良解を更新する
変更する次元数を計算する:
k_minimum = ceiling(D / 8 / m)
k_maximum = ceiling(D / 3 / m)
k = k_minimumからk_maximumまでの範囲の乱数
注:グループ1はより多くの次元を変更する(記憶力が高い)
グループ6はより少ない次元を変更する(より多く忘れる)
グループmの各エージェントjについて:
ステップ1 - 記憶戦略:
グループ内の最良のエージェントの位置を現在のエージェントにコピーする
(グループ内のすべてのエージェントが、見つかった最良解を「記憶」する)
ステップ2 - 変更するk個の座標成分をランダムに選択する
ステップ3 - 忘却戦略または夢交換戦略:
random_number < 0.3の場合(30%の確率):
// 忘却・補充戦略
選択したk個の座標成分それぞれについて:
new_value = current + random × cosine_wave
ここで、cosine_wave = (cos((iteration + T/10) × π / T) + 1) / 2
注:余弦関数により、探索の初期には大きなステップとなり、
終盤に向けて小さなステップとなる
それ以外の場合(70%の確率):
// 夢交換戦略
選択したk個の座標成分それぞれについて:
集団内からランダムに選んだエージェントの値をコピーする
(そのエージェントは、別のエージェントの解を「夢見る」)
すべての座標成分が範囲内にあるか確認し、必要に応じて補正する
活用
全60エージェントの各エージェントjについて:
ステップ1 - 大域最良解にリセットする:
大域最良解を現在のエージェントにコピーする
(すべてのエージェントが、見つかった「頂点」に集まる)
ステップ2 - 微調整:
変更する次元数を計算する:
k = 2からmaximum(2, ceiling(D/3))までの範囲の乱数
k個の座標成分をランダムに選択する
選択したk個の座標成分それぞれについて:
new_value = current + random × cosine_wave
ここで、cosine_wave = (cos(iteration × π / T) + 1) / 2
注:アルゴリズムの終了時には余弦による係数がほぼ0となり、
非常に小さなステップとなる
範囲内にあるか確認し、必要に応じて補正する
結果の更新
位置を変更するたびに:
各エージェントの目的関数の値を計算する
大域最良解を更新する:
現在の大域最良解よりも優れた解が見つかった場合:
それを新たな大域最良解として保存する
探索フェーズでは、さらに:
各グループの最良解を更新する
反復の終了
それでは、アルゴリズムのコードを書き始めましょう。 今回実装するクラスはDOA最適化アルゴリズムを担い、さまざまな最適化アルゴリズムに共通するインターフェースを提供する基底クラスC_AOを継承します。 コンストラクタとデストラクタは標準的な構成とし、デストラクタには特別な処理を追加しません。 コンストラクタでは、アルゴリズムの主要なパラメータと初期値を設定するとともに、それらをparamsパラメータ配列に関連付けます。これにより、クラスの外部からパラメータを容易に管理できるようになります。
主なパラメータ:- popSize:集団サイズ。各反復で保持する候補解の数です。
- numGroups:集団を分割するグループ数。グループ間で情報を交換するために使用します。
- explorationRate:全反復回数のうち、探索フェーズに割り当てる割合です。このフェーズでは、探索空間内の新しい領域を探索します。
- forgettingProb:忘却戦略を適用する確率です。探索の多様性を保ち、局所最適解に陥ることを避けるのに役立ちます。
- SetParams ():params配列からクラスのパラメータを設定します。
- Init ():探索範囲と反復回数を指定して、アルゴリズムを初期化します。
- Moving ():最適化の1ステップを実行します。
- Revision ():解の現在の状態を再評価し、更新します。
- currentIteration、totalIterations、explorationIters:反復回数のカウンタおよびフェーズの境界を表す変数です。
- groupBest []:各グループの最良解を格納する配列。グループ内で見つかった良好な解を保持し、解の更新や情報共有に利用します。
- ExplorationPhase ():探索フェーズを実行し、新しい解を探索します。
- ExploitationPhase ():すでに見つかった良好な解を活用し、さらに改善します。
- UpdateGroupBest ():指定されたグループの最良解を更新します。
- GetGroupStartIndex ()、GetGroupEndIndex ():各グループ内の解のインデックスの範囲を特定するのに役立ちます。
このクラスでは、集団を一定数のグループに分割してDOAアルゴリズムを実装します。 反復処理の中で、アルゴリズムは探索フェーズと活用フェーズを切り替えます。探索フェーズでは新しい解を探し、活用フェーズではすでに見つかった良好な解をさらに改善します。 また、忘却戦略によって探索に変化を加え、局所最適解にとどまることを避けやすくします。 基本的な考え方は、探索空間の新しい領域を調べることと、発見済みの解を慎重に改善することを組み合わせ、効果的な大域的最適化を実現することです。
//————————————————————————————————————————————————————————————————————
class C_AO_DOA_dream : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOA_dream () { }
  C_AO_DOA_dream ()
  {
    ao_name = "DOA";
    ao_desc = "Dream Optimization Algorithm";
    ao_link = "https://www.mql5.com/ja/articles/19177";

    popSize              = 60;    // population size
    numGroups            = 6;     // number of groups (fixed in the original)
    explorationRate      = 0.99;  // iteration rate for the exploration phase (9/10 in the original)
    forgettingProb       = 0.3;   // probability of using the main forgetting strategy

    ArrayResize (params, 4);

    params [0].name = "popSize";           params [0].val = popSize;
    params [1].name = "numGroups";         params [1].val = numGroups;
    params [2].name = "explorationRate";   params [2].val = explorationRate;
    params [3].name = "forgettingProb";    params [3].val = forgettingProb;
  }

  void SetParams ()
  {
    popSize          = (int)params [0].val;
    numGroups        = (int)params [1].val;
    explorationRate  = params      [2].val;
    forgettingProb   = params      [3].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  int    numGroups;         // number of groups
  double explorationRate;   // iteration rate for the exploration phase
  double forgettingProb;    // probability of applying the main strategy

  private: //---------------------------------------------------------
  int    currentIteration;  // current iteration
  int    totalIterations;   // total number of iterations
  int    explorationIters;  // number of exploration iterations

  S_AO_Agent groupBest [];  // best solutions in each group

  void   ExplorationPhase      ();
  void   ExploitationPhase     ();
  void   UpdateGroupBest       (int groupNum);
  int    GetGroupStartIndex    (int groupNum);
  int    GetGroupEndIndex      (int groupNum);
};
//————————————————————————————————————————————————————————————————————
C_AO_DOA_dreamクラスの初期化メソッドは、最適化アルゴリズムを実行するための準備をします。 初期パラメータを設定し、その後の反復処理に必要な内部状態を確立します。
まず、共通の初期化メソッドを呼び出し、探索範囲とステップ幅を確認・設定して、パラメータが正しく設定されていることを確認します。 この確認または設定に失敗した場合、初期化処理は終了します。
次に、カウンタを設定します。現在の反復回数を「0」にリセットし、反復回数の総数を渡されたパラメータから設定します。また、指定された割合(explorationRate)に基づき、総反復回数のうち探索フェーズに割り当てる反復回数を計算します。
続いて、グループごとの最良解を格納する配列(groupBest)を初期化します。配列のサイズはグループ数と同じです。 各グループについて、Initメソッドを使用して初期解を生成し、その解の評価関数の値を取り得る最小値に設定します。これにより、以降の処理で適切に比較・更新できるようにします。
このメソッドの実行後、アルゴリズムは設定されたパラメータ、カウンタ、各グループの初期解を備え、最適化を開始できる状態になります。
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DOA_dream::Init (const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  currentIteration = 0;
  totalIterations  = epochsP;
  explorationIters = (int)(totalIterations * explorationRate);

  ArrayResize (groupBest, numGroups);
  for (int i = 0; i < numGroups; i++)
  {
    groupBest [i].Init (coords);
    groupBest [i].f = -DBL_MAX; // Initialize with the worst value
  }

  return true;
}
//————————————————————————————————————————————————————————————————————
Movingメソッドは、DOAアルゴリズムの主要な反復処理を担います。 ある反復から次の反復へとアルゴリズムを進めるための処理を実装します。 まず、currentIterationカウンタをインクリメントし、アルゴリズムの進行状況を記録します。
初期化(初回実行時のみ): revisionフラグを確認します。フラグがfalseの場合、つまりアルゴリズムの初回実行時には、集団を初期化します。集団内の各エージェントについて、さらに各座標について、次の処理を実行します。
- u.RNDfromCI()関数を使用し、指定された範囲(rangeMinおよびrangeMax)内で座標の値をランダムに生成します。
- u.SeInDiSp()関数を使用し、ステップ幅(rangeStep)を考慮して値を調整します。この処理により、値をステップ幅の倍数となる最も近い有効な値に合わせます。
- 初期化が完了したら、revisionフラグをtrueに設定し、以降の反復で再初期化されないようにします。
- この時点でメソッドの処理を終了します。
- 現在の反復が探索フェーズに該当するかどうかを確認します(currentIteration <= explorationIters)。
- 探索フェーズに該当する場合は、ExplorationPhase()メソッドを呼び出します。
- それ以外の場合、つまり活用フェーズに該当する場合は、ExploitationPhase()メソッドを呼び出します。
このように、Movingメソッドは、最初に集団を初期化した後、反復回数のカウンタに基づいて探索フェーズと活用フェーズを切り替えながら、最適化処理全体を制御します。 初期化は一度だけ実行され、その後は各反復で実行するフェーズを判定するループに入ります。
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DOA_dream::Moving ()
{
  currentIteration++;

  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Determine the phase of the algorithm
  if (currentIteration <= explorationIters)
  {
    ExplorationPhase ();
  }
  else
  {
    ExploitationPhase ();
  }
}
//————————————————————————————————————————————————————————————————————
ExplorationPhaseメソッドは、DOAアルゴリズムの探索フェーズを実装します。 このフェーズでは、新たな探索空間の領域を見つけるために、各エージェントグループの解を更新し、多様化します。 まず、各グループについて、そのグループ内で現在までに見つかった最良解を更新します。 次に、現在のグループ番号と座標の総数に基づいて、忘却処理で変更する次元数を決定します。 また、各グループに属する最初と最後のエージェントのインデックスを計算します。
続いて、グループ内の各エージェントについて、グループ全体の最良解を現在のエージェントの解にコピーします(記憶戦略)。これにより、エージェントは、以前に見つかった良好な解に立ち戻ることができます。 次に、「忘却」と「補充」の操作対象となる次元(座標)のリストを作成します。 この次元配列をシャッフルすることで、変更する次元をランダムに選択します。
グループ内の各エージェントについて、forgettingProbパラメータで指定された確率に基づき、選択した次元の更新戦略を決定します。「忘却」戦略が選択された場合は、余弦変調を適用します。
選択した次元について、探索範囲内でランダムなオフセットを生成します。 余弦変調は現在の反復回数と総反復回数に応じて変化し、時間の経過に伴う変更幅を制御します。 更新後の値は、ステップ幅を考慮して有効な範囲内に調整されます。 一方、「忘却」戦略が選択されなかった場合は、「夢の共有」戦略を適用します。 この場合、別のエージェントをランダムに選び、そのエージェントの対応する次元の値をコピーします。これにより、エージェント間で情報が交換されます。
このように、探索フェーズでは、ランダムな変更とエージェント間の情報交換を通じて解の多様性を高め、探索空間の幅広い領域を調べることで、局所最適解に陥ることを避けやすくします。
//————————————————————————————————————————————————————————————————————
//--- Exploration phase
void C_AO_DOA_dream::ExplorationPhase ()
{
  // Handle each group
  for (int m = 0; m < numGroups; m++)
  {
    // Update the best solution in the group
    UpdateGroupBest (m);

    // Calculate the number of dimensions to forget
    int kMin = (int)MathCeil ((double)coords / 8.0 / (m + 1));
    int kMax = (int)MathCeil ((double)coords / 3.0 / (m + 1));
    int k    = u.RNDintInRange (kMin, kMax);

    // Handle agents in the group
    int startIdx = GetGroupStartIndex (m);
    int endIdx   = GetGroupEndIndex   (m);

    for (int j = startIdx; j <= endIdx; j++)
    {
      // Memory strategy - reset to the best group solution
      ArrayCopy (a [j].c, groupBest [m].c, 0, 0, WHOLE_ARRAY);

      // Select random dimensions to forget
      int dims [];
      ArrayResize (dims, coords);
      for (int i = 0; i < coords; i++) dims [i] = i;

      // Shuffle the array of dimensions
      for (int i = coords - 1; i > 0; i--)
      {
        int idx    = u.RNDintInRange (0, i);
        int temp   = dims [i];
        dims [i]   = dims [idx];
        dims [idx] = temp;
      }

      // Strategy of forgetting and replenishment
      if (u.RNDprobab () < forgettingProb)
      {
        // Basic strategy with cosine modulation
        for (int h = 0; h < k; h++)
        {
          int    dim              = dims [h];
          double range            = rangeMax [dim] - rangeMin [dim];
          double randomValue      = u.RNDprobab () * range + rangeMin [dim];
          double cosineModulation = (MathCos ((1.0 * currentIteration + totalIterations / 10.0) * M_PI / totalIterations) + 1.0) / 2.0;

          a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
          a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
        }
      }
      else
      {
        // Dream sharing - copying from a random agent
        for (int h = 0; h < k; h++)
        {
          int dim   = dims [h];
          int donor = u.RNDintInRange (0, popSize - 1);
          a [j].c [dim] = a [donor].c [dim];
        }
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
ExploitationPhaseメソッドは、最適化アルゴリズムの活用フェーズを実装します。 主な役割は、これまでに見つかった最良の解に向けて探索を進め、現在の結果を改善することです。
集団内の各エージェントについて、その解をこれまでに見つかった全体の最良解に戻します。これにより、探索空間の中でも特に有望な領域に焦点を当てることができます。 次に、変更する次元数を決定します。 通常、座標の総数に応じて、少なくとも2つ、かつ一定の上限値以下の次元数が選択されます。 すべての次元(座標)のリストを作成し、ランダムにシャッフルすることで、変更する次元をランダムに選択します。 選択された各次元について、次の処理をおこないます。
- その測定値の変動範囲を計算します。
- この範囲内でランダムな値を生成します。
- 現在の反復回数と反復回数の総数に依存する余弦関数を用いて、この値を変調します。これにより、時間の経過に伴う変更の影響度を制御できます。
- 生成した値と余弦変調に基づいて、測定値を変更します。
- その後、解の有効性を維持するため、離散化のステップ幅を考慮しながら、値を許容範囲内に調整します。
このメソッドの目的は、ランダムかつ制御された変更を加えることで、すでに見つかった良好な解をさらに改善することです。これにより、探索空間のより最適な領域へと探索を進め、より良い解を得ることを目指します。
//————————————————————————————————————————————————————————————————————
//--- Exploitation phase
void C_AO_DOA_dream::ExploitationPhase ()
{
  // In the exploitation phase, all agents move towards the global best
  for (int j = 0; j < popSize; j++)
  {
    // Reset to global best solution
    ArrayCopy (a [j].c, cB, 0, 0, WHOLE_ARRAY);

    // Calculate the number of dimensions to modify
    int km = MathMax (2, (int)MathCeil ((double)coords / 3.0));
    int k = u.RNDintInRange (2, km);

    // Select random dimensions
    int dims [];
    ArrayResize (dims, coords);
    for (int i = 0; i < coords; i++) dims [i] = i;

    // Shuffle the array of dimensions
    for (int i = coords - 1; i > 0; i--)
    {
      int idx = u.RNDintInRange (0, i);
      int temp = dims [i];
      dims [i] = dims [idx];
      dims [idx] = temp;
    }

    // Apply the forgetting and addition strategy
    for (int h = 0; h < k; h++)
    {
      int dim = dims [h];
      double range = rangeMax [dim] - rangeMin [dim];

      double randomValue = u.RNDprobab () * range + rangeMin [dim];
      double cosineModulation = (MathCos (currentIteration * M_PI / totalIterations) + 1.0) / 2.0;

      a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
      a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
UpdateGroupBestメソッドは、特定のエージェントグループ内で最良解を特定するために設計されています。 主な処理は以下のとおりです。
- 指定されたグループに属するエージェントの開始位置と終了位置のインデックスを取得します。
- 指定されたグループ内のすべてのエージェントを順に処理します。
- 各エージェントについて、評価関数の値(解の品質を示す指標)を、そのグループについて現在保存されている最良値と比較します。
- エージェントが現在の最良値を上回る適応度関数値を持つ解を見つけた場合、グループ内の最良解の記録を更新し、より優れた解に置き換えます。
このように、このメソッドは各グループ内の最良解に関する最新情報を維持します。これは、探索戦略や解の更新など、アルゴリズムの後続処理において重要な役割を果たします。
//————————————————————————————————————————————————————————————————————
//--- Update the best solution in the group
void C_AO_DOA_dream::UpdateGroupBest (int groupNum)
{
  int startIdx = GetGroupStartIndex (groupNum);
  int endIdx   = GetGroupEndIndex (groupNum);

  for (int i = startIdx; i <= endIdx; i++)
  {
    if (a [i].f > groupBest [groupNum].f)
    {
      groupBest [groupNum].f = a [i].f;
      ArrayCopy (groupBest [groupNum].c, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
GetGroupStartIndexメソッドは、指定されたグループに属する要素の開始インデックスを、解またはエージェントの配列内で計算するために使用されます。 この計算では、配列全体にわたって各グループが均等に分布していることを前提としています。 基本的な考え方は、グループ番号、グループの総数、および集団の総サイズに基づいて、特定のグループに属する最初のエージェント(または要素)の位置を求めることです。
具体的には、グループ番号に集団の総サイズを乗じ、それをグループ数で除算します。これにより、指定されたグループ内の最初の要素のインデックスが得られます。 この方法により、データを各グループに均等に分割でき、解のグループ化に関連する後続の処理にも便利に利用できます。
//————————————————————————————————————————————————————————————————————
//--- Get the starting index of the group
int C_AO_DOA_dream::GetGroupStartIndex (int groupNum)
{
  return (int)((double)groupNum * popSize / numGroups);
}
//————————————————————————————————————————————————————————————————————
GetGroupEndIndexメソッドは、指定されたグループに属する要素の終了インデックスを計算します。 グループ番号、集団の総サイズ、およびグループ数に基づいて、そのグループの最後の要素を特定します。 計算では、グループ番号に1を加えた値に集団の総サイズを乗じ、それをグループ数で除算します。 得られた値から1を引くことで、グループの最後の要素のインデックスを求めます。
配列の範囲外へのアクセスを防ぐため、追加のチェックも必要です。計算されたインデックスが集団サイズを超える場合は、最後の有効なインデックスに修正します。 この方法により、集団内の各エージェントグループの範囲を正しく定義できます。
//————————————————————————————————————————————————————————————————————
//--- Get the ending index of the group
int C_AO_DOA_dream::GetGroupEndIndex (int groupNum)
{
  int endIdx = (int)((double)(groupNum + 1) * popSize / numGroups) - 1;
  if (endIdx >= popSize) endIdx = popSize - 1;
  return endIdx;
}
//————————————————————————————————————————————————————————————————————
Revisionメソッドは、アルゴリズムの実行中に見つかった最良解に関する情報を更新するために設計されています。 まず、現在の集団内のすべての解を順に処理します。 ループ内では、各解の目的関数値を確認し、その値が現在の最良値を上回っている場合、fBをその解の目的関数値で更新し、現在の解を最良解とします。
次に、現在の反復が「探索」フェーズ(explorationIters)に該当するかどうかを確認します。探索フェーズに該当する場合、全体の最良解を更新するだけでなく、各グループ内で見つかった最良解も考慮します。 そのため、すべてのグループを順に処理し、各グループの最良解の目的関数値を現在の最良値と比較します。
グループ内の解の方が優れている場合は、fBを更新し、groupBestに保存されている解をグローバルバッファcBにコピーします。 このように、Revisionメソッドは、アルゴリズムの現在のフェーズ(探索または活用)に応じて、見つかった最良解に関する情報を継続的に監視・更新し、その時点での最良解を保持します。
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DOA_dream::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }

  // Update the best solutions of groups in the exploration phase
  if (currentIteration <= explorationIters)
  {
    for (int m = 0; m < numGroups; m++)
    {
      if (groupBest [m].f > fB)
      {
        fB = groupBest [m].f;
        ArrayCopy (cB, groupBest [m].c, 0, 0, WHOLE_ARRAY);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
テスト結果
これでDOAアルゴリズムの実装が完了したので、さっそくテスト関数を用いた検証に進みます。 ご覧のとおり、DOAアルゴリズムのスコアは53.62%となり、評価表に追加されます。
=============================
5 Hilly's; Func runs: 10000; result: 0.8555594031110225
25 Hilly's; Func runs: 10000; result: 0.7008493263471764
500 Hilly's; Func runs: 10000; result: 0.37279821121874124
=============================
5 Forest's; Func runs: 10000; result: 0.7342194493052585
25 Forest's; Func runs: 10000; result: 0.48905397049976357
500 Forest's; Func runs: 10000; result: 0.24146681094197792
=============================
5 Megacity's; Func runs: 10000; result: 0.7723076923076921
25 Megacity's; Func runs: 10000; result: 0.4735384615384616
500 Megacity's; Func runs: 10000; result: 0.18561538461538593
=============================
All score: 4.82541 (53.62%)
低次元におけるDOAアルゴリズムの性能を可視化した結果(緑色の線)を見ると、特にForest関数とMegacity関数で、結果にばらつきが見られます。
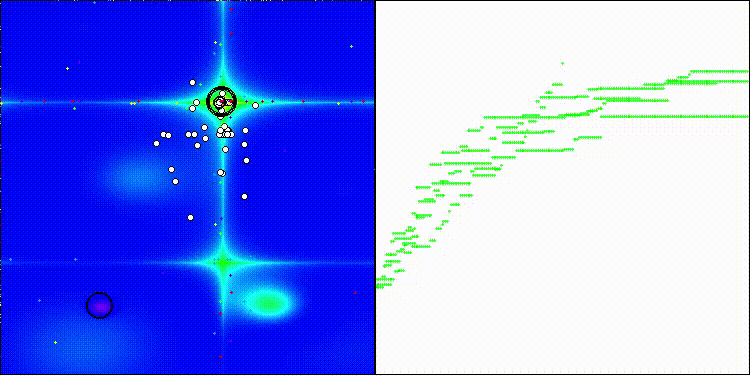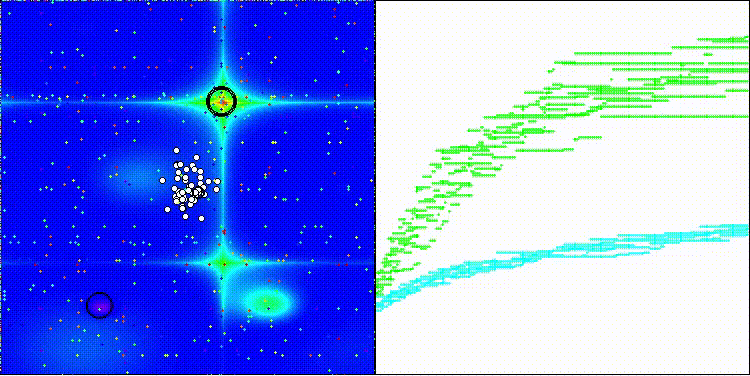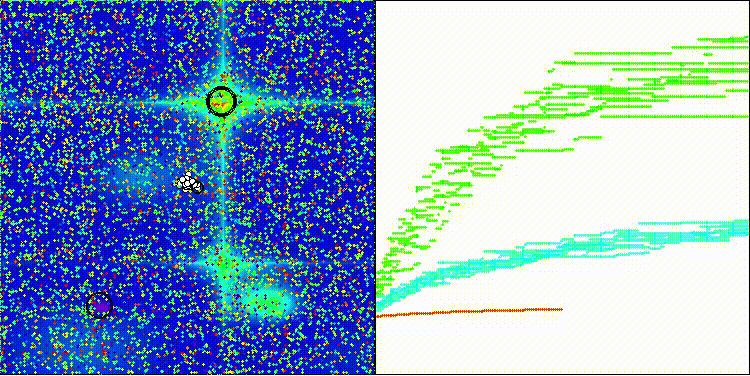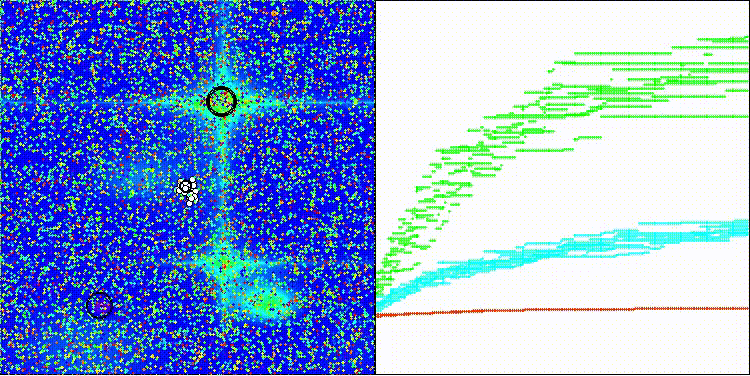
Hillyテスト関数におけるDOAの動作
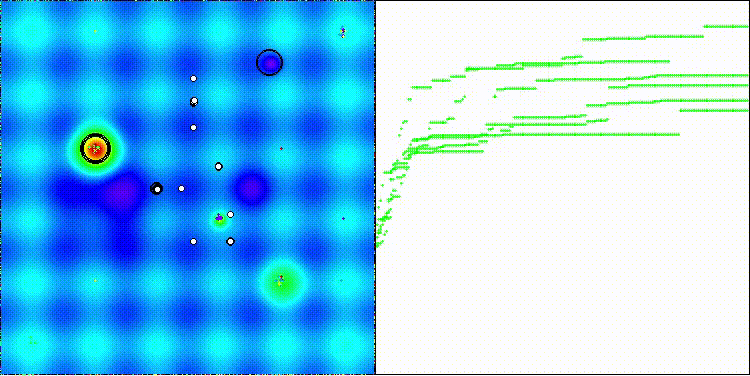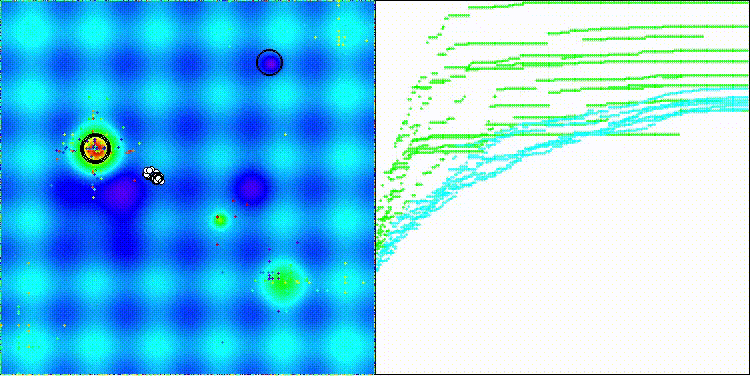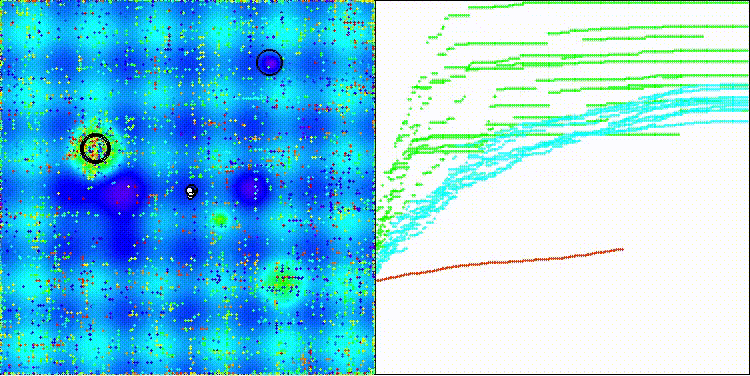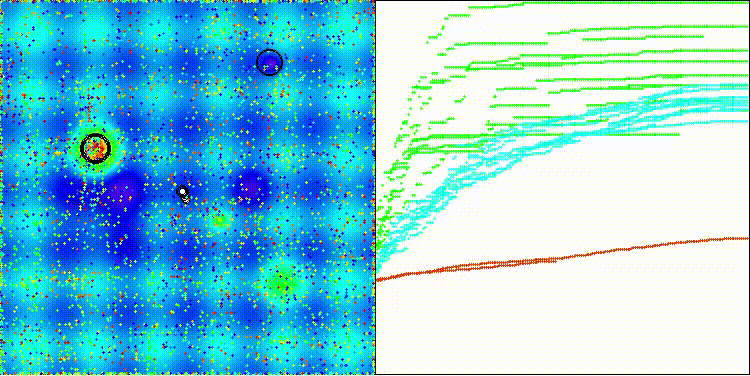
Forestテスト関数におけるDOAの動作
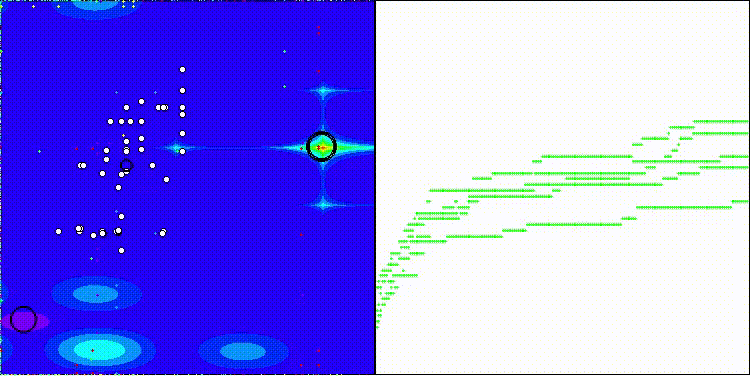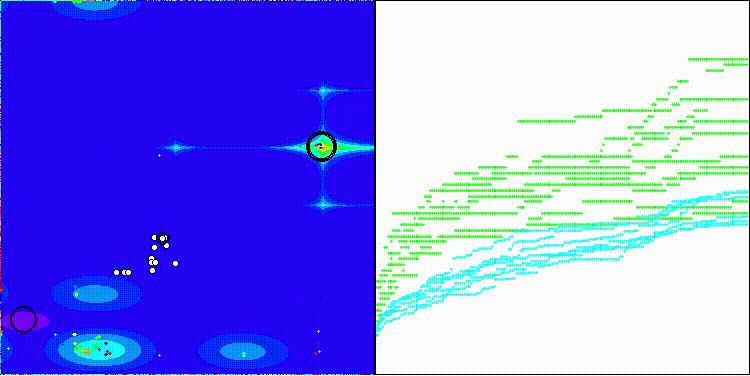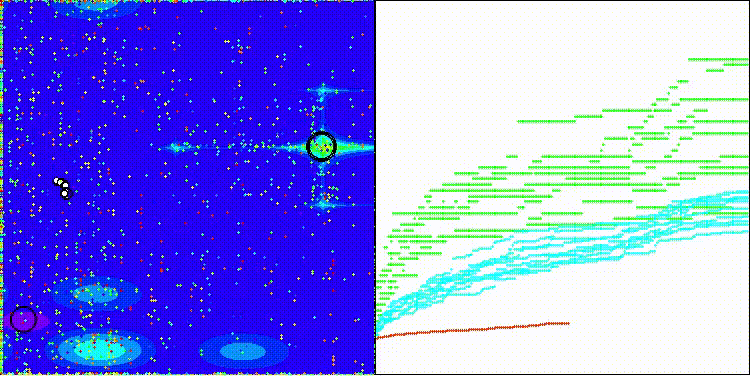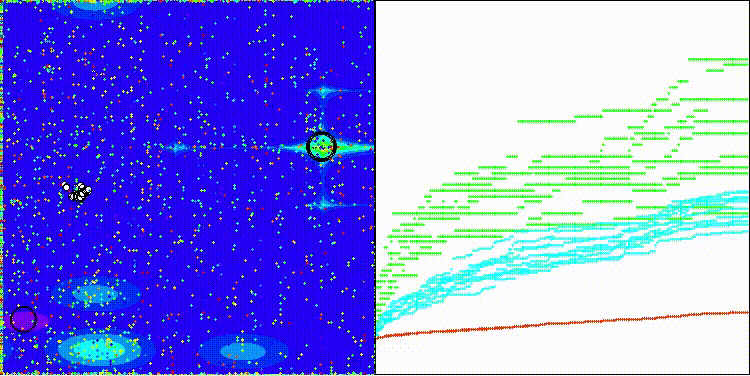
Megacityテスト関数におけるDOAの動作
テスト結果に基づくと、DOAアルゴリズムは集団ベースの最適化アルゴリズムの総合ランキングで26位となっています。
| # | AO | 説明 | Hilly | Hilly 最終値 | Forest | Forest 最終値 | Megacity(離散型) | Megacity 最終値 | 最終 結果 | 最大値に対する割合(%) | ||||||
| 10 p (5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | ||||||||
| 1 | ANS | 近傍横断探索 | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | コードロックアルゴリズム(joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | 動物移動最適化 M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O)進化戦略 | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | 彗尾アルゴリズム(joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | 時間進化移動アルゴリズム(joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | 確率的拡散探索 M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | ビリヤード最適化アルゴリズム M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | アーチェリーアルゴリズム M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | 社会集団の進化(joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | 等方的焼きなまし(joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | 極値最適化M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | 生物地理学に基づく最適化 | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | 人工協調探索 | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | 弁証法的アルゴリズム | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | ブラックホールアルゴリズム M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | 無政府社会最適化 | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | ロイヤルフラッシュ最適化 (joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | 原子軌道探索 M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | 亀甲進化アルゴリズム(joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | バックトラッキング探索アルゴリズム | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | 差分進化 | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | レストラン経営達人アルゴリズム(joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | 化学反応最適化 | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | 血液型遺伝最適化(joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | DOA | dream_optimization_algorithm | 0.85556 | 0.70085 | 0.37280 | 1.92921 | 0.73421 | 0.48905 | 0.24147 | 1.46473 | 0.77231 | 0.47354 | 0.18561 | 1.43146 | 4.825 | 53.62 |
| 27 | BSA | 群鳥アルゴリズム | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 28 | DEA | イルカエコーロケーションアルゴリズム | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 29 | HS | ハーモニーサーチ | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 30 | SSG | 苗木の播種と育成 | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51.95 |
| 31 | BCOm | 細菌走化性最適化 M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 32 | ABO | アフリカ水牛最適化 | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51.49 |
| 33 | (PO)ES | (PO) 進化戦略 | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 34 | FBA | フラクタルベースアルゴリズム | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50.61 |
| 35 | TSm | タブーサーチM | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 36 | BSO | ブレインストーム最適化 | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 37 | WOAm | クジラ最適化アルゴリズム M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 38 | AEFA | 人工電界アルゴリズム | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 39 | AEO | 人工生態系ベースの最適化アルゴリズム | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 40 | CAm | ラクダアルゴリズムM | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 41 | ACOm | 蟻コロニー最適化M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 42 | CMAES | 共分散行列適応進化戦略 | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 43 | DA_duelist | duelist_algorithm | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48.28 |
| 44 | BFO-GA | 細菌採餌最適化 - GA | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 45 | SOA | シンプル最適化アルゴリズム | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| RW | ランダムウォーク | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
まとめ
夢最適化アルゴリズム(DOA)は、今回実施したテストで100%満点中53.62%のスコアを記録し、まずまずの性能を示しました。その結果、評価表にランクインしました。
結果を分析すると、多くのメタヒューリスティックアルゴリズムに共通する傾向が見られます。それは、問題の次元数が増えるにつれて、性能が大幅に低下することです。 低次元の問題ではDOAは73~86%の結果を示しますが、高次元の問題では、反復回数が限られた条件下で、性能が18~37%まで低下します。
総合的に見ると、このアルゴリズムは他の最適化手法と比較して、平均的な位置づけにあります。 興味のある方は、アルゴリズムの設定を変更して試してみるとよいでしょう。設定次第では、さらに良い結果が得られる可能性があります。
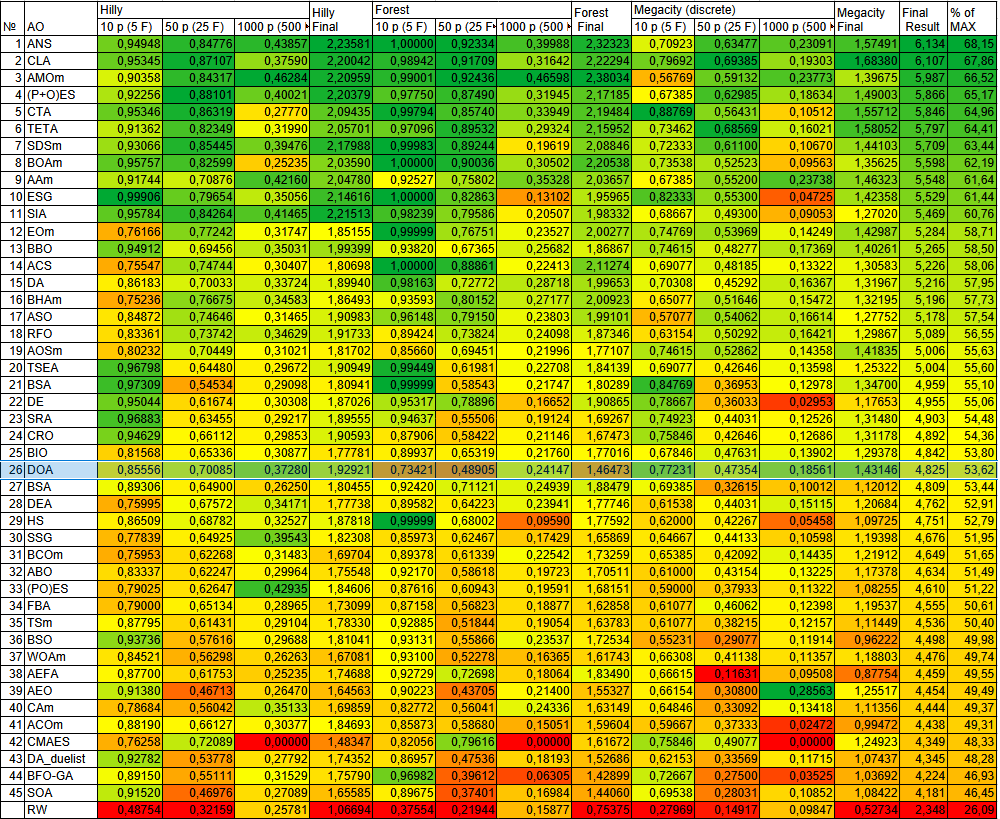
図2: 各テストにおけるアルゴリズムの成績を色の濃淡で表現した図
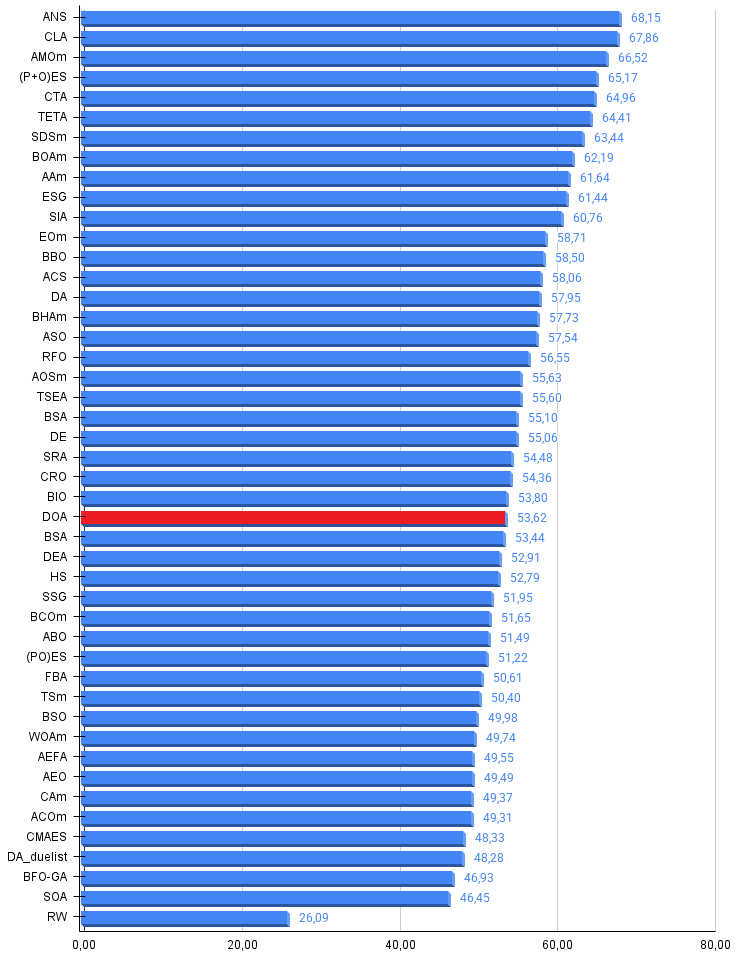
図3: アルゴリズムのテスト結果を示すヒストグラム(0~100のスケール。値が大きいほど良好で、100は理論上の最大値。アーカイブには、ランキング表を計算するためのスクリプトが含まれています)
DOAの長所と短所:
長所:
- 実装が容易。
- 動作が速い。
短所:
- 低次元のテスト関数で結果のばらつきが大きい。
アルゴリズムの最新バージョンのソースコードを含むアーカイブが、記事に添付されています。 記事の著者は、標準的なアルゴリズムの説明が完全に正確であることを保証するものではありません。 探索性能を向上させるため、多くのアルゴリズムに変更が加えられています。 記事に記載された結論や見解は、実験結果に基づいています。
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | #C_AO.mqh | インクルード | 集団ベース最適化アルゴリズムの親クラス |
| 2 | #C_AO_enum.mqh | インクルード | 集団ベース最適化アルゴリズムの列挙型 |
| 3 | TestFunctions.mqh | インクルード | テスト関数ライブラリ |
| 4 | TestStandFunctions.mqh | インクルード | テスト環境用関数ライブラリ |
| 5 | Utilities.mqh | インクルード | 補助関数ライブラリ |
| 6 | CalculationTestResults.mqh | インクルード | 比較表の結果を計算するスクリプト |
| 7 | Testing AOs.mq5 | スクリプト | すべての集団最適化アルゴリズムに共通のテスト環境 |
| 8 | Simple use of population optimization algorithms.mq5 | スクリプト | 可視化機能を使わずに集団最適化アルゴリズムを使用する簡単な例 |
| 9 | Test_AO_DOA.mq5 | スクリプト | DOAのテスト環境 |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19177
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 線形自己回帰モデルの残差を用いた非線形U-Transformerの学習
 取引におけるニューラルネットワーク:Temporal Queryモデル(最終回)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:スケーリングの代わりに分解する(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索