

決闘者アルゴリズム
 20
 2

目次
はじめに
アルゴリズム取引では、わずか1ミリ秒の差が利益にも損失にもつながります。そのため、取引戦略の最適なパラメータを見つけることは、極めて重要な課題です。 現代のトレーダーは、取引システムのパラメータを最適化するために、人工知能や進化アルゴリズムを活用しています。
今回は、古くからおこなわれてきた決闘に着想を得た、新しい最適化手法である「決闘者アルゴリズム」について解説します。 このアルゴリズムは、Biyanto氏率いるインドネシアの科学者グループによって2015年に開発されました。同氏らは、勝者と敗者に異なるアプローチを適用することで、突然変異や交叉の各演算子が持つ「盲目的」な性質を最小限に抑え、従来の進化アルゴリズムに代わる手法を目指しました。 この記事では、決闘者アルゴリズムの数学的な基礎を詳しく解説し、MQL5で実装するとともに、他の集団ベースの最適化手法との比較分析をおこないます。
アルゴリズムの実装
取引の現場を、さまざまな戦略が絶えず競い合う闘技場だと考えてみましょう。 ある市場環境では成功する戦略もあれば、うまく機能しない戦略もあります。 では、優れたトレーダーを生み出すものは何でしょうか。 それは、勝利からも敗北からも学び、絶えず状況に適応しながら、自らのアプローチを磨き続ける能力です。
決闘者アルゴリズムは、まさにこの考え方を体現しています。 すべての個体を等しく扱う従来の遺伝的アルゴリズムとは異なり、このアルゴリズムでは勝者と敗者の違いを明確に捉えます。 敗者は学習します。勝者の戦略を分析し、その成功要素を取り入れます。一方、勝者は新たな可能性を探ります。中核となる戦略の有効性がすでに示されているため、そこからさらに新しいアプローチを試みます。 そして、チャンピオンは指導役となり、優れた戦略を次世代へと伝えます。
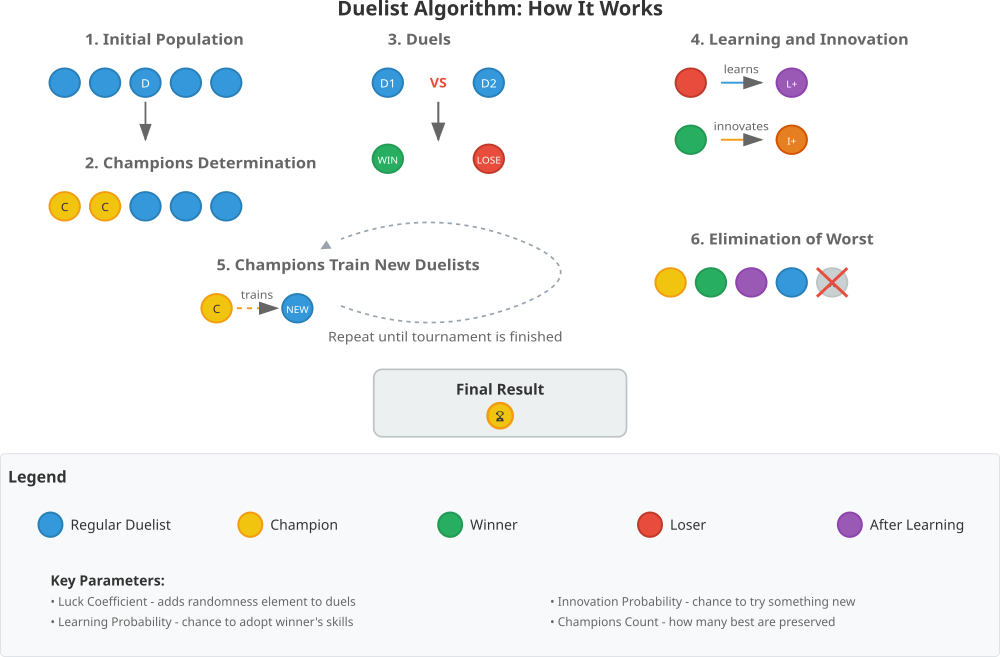
図1: DA_duelistアルゴリズムの動作
アルゴリズムの主要な段階を示したこの図では、決闘者アルゴリズムの重要な仕組みを確認できます。初期集団では、すべての決闘者に同じチャンスが与えられます。チャンピオンの選定では、特に優れた決闘者が金色で強調表示されます。 決闘の段階では、対戦を通じて勝者と敗者が決まります。 学習と革新の段階では、勝者と敗者がそれぞれ異なる経路で進化します。 新たな決闘者の育成では、チャンピオンが自身の能力を次世代に伝えます。そして淘汰の段階では、成績の最も悪い決闘者が集団から除外されます。
図にはさらに、アルゴリズムが反復的に実行されることを示すループ矢印、最終的に選ばれたチャンピオン、および各要素と主要なパラメータを説明する詳細な凡例も含まれています。 この図解によって、読者はアルゴリズムの基本的な仕組みを直感的に理解できます。
それでは、仕組みを詳しく確認したところで、アルゴリズムの擬似コードを記述してみましょう。
入力:
- popSize:決闘者の集団サイズ
- luckCoefficient:決闘における運の係数
- learningProbability:敗者が学習する確率
- innovationProbability:勝者が革新をおこなう確率
- championsCount:チャンピオンの数
初期化:
1. championsCountを確認し、必要に応じて調整する。:
- 1未満の場合は、1に設定する。
- popSize以上の場合は、popSize / 4に設定する。
2. 空のwinners配列とlosers配列を作成する。
3. championsCount個の要素を持つchampions配列を作成する。
メインループ(Moving):
最初の反復の場合:
0からpopSizeまでの各決闘者 i について:
各座標jについて:
許容範囲内のランダムな値で初期化する。
revisionフラグをtrueに設定する。
関数を終了する。
それ以外(以降の反復)の場合:
1. 集団の拡張
- 決闘者の配列のサイズをpopSize + championsCountに拡張する。
- 新たに追加した決闘者の構造体を初期化する。
2. チャンピオンの決定
- 適応度に基づいて決闘者をソートする(バブルソート)。
- 上位championsCount人の決闘者をチャンピオンに選定する。
3. 新しい決闘者の育成
各チャンピオンiについて:
TrainNewDuelist(i, popSize + i)を呼び出す。:
各座標cについて:
new_duelist [c] = champion [c] + GaussDistribution ()
許容範囲を超えないように値を調整する。
4. 決闘の実施:
winners配列とlosers配列をクリアする。
championsCountからtotalDuelistsまでの各決闘者iについて:
対戦相手'opponent'をランダムに選択する。
opponent != iの場合:
DetermineWinnerAndLoser(i, opponent):
A_Luck = fitness [A] * (luckCoef + random () * luckCoef)
B_Luck = fitness [B] * (luckCoef + random () * luckCoef)
IF (fitness [A] + A_Luck) >= (fitness [B] + B_Luck):
Aを勝者、Bを敗者とする。
それ以外の場合:
Bを勝者、Aを敗者とする。
勝者と敗者をそれぞれwinners配列とlosers配列に追加する。
5. 改良
a) 敗者の学習
各(loser, winner)のペアについて:
LearningProcess(loser, winner)を呼び出す。
各座標cについて:
random() < learningProbabilityの場合:
loser [c] = winner [c]
b) 勝者の革新:
各勝者について:
InnovationProcess (winner)を呼び出す。
各座標cについて:
random() < innovationProbabilityの場合
winner [c] = random_value_in_range
6. 淘汰:
- すべての決闘者を適応度の降順でソートする。
- 上位popSize人の決闘者だけを残す。
更新(Revision):
各決闘者iについて:
fitness[i] > global_bestの場合:
global_best = fitness [i] として更新する
global_bestをfitness[i]に更新する。最良解の座標を保存する。
停止条件が満たされるまでメインループを繰り返す。
このアルゴリズムの重要な特徴を強調しておきましょう。チャンピオンは決闘に参加せず、新しい決闘者の育成を担います。また、運の係数によってランダム性が導入されるため、決闘の結果は必ずしも適応度だけでは決まりません。 勝者と敗者には、それぞれ異なるアプローチが適用されます。敗者は勝者から学び、勝者は新しい解決策を探ります。 さらに、成績の悪い決闘者を淘汰することで、集団のサイズを一定に保ちます。 それでは、DA_duelistアルゴリズムの実装コードを見ていきましょう。
まず、C_AOクラスを継承するC_AO_DA_duelistクラスを作成します。このクラスでは、パラメータ配列paramsを初期化し、各パラメータに名前とデフォルト値を設定します。
- SetParams ():params配列に格納された値に基づいて、popSize、luckCoefficientなどの内部変数を更新します。
- Init ():アルゴリズムを初期化します。 パラメータの探索範囲と刻み幅を定義する配列、およびエポック数を受け取ります。
- Moving ():決闘者を進化させながら、最適なパラメータを探索する主要な処理を実行します。
- Revision ():結果を分析し、それに応じて処理を調整します。
変数
- luckCoefficient:運の係数
- learningProbability:学習確率
- innovationProbability:革新確率
- championsCount:チャンピオンの数
- winners []:勝者となった決闘者のインデックスを格納する配列
- losers []:敗者となった決闘者のインデックスを格納する配列
- champions []:チャンピオンのインデックスを格納する配列
- DetermineWinnerAndLoser():決闘の勝者と敗者を決定します。
- LearningProcess ():勝者の情報を利用して敗者が学習する処理を実装します。
- InnovationProcess ():勝者が新たな解決策を探索するための革新処理を実装します。
- TrainNewDuelist ():チャンピオンをもとに新しい決闘者を育成します。
//————————————————————————————————————————————————————————————————————
class C_AO_DA_duelist : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DA_duelist () { }
  C_AO_DA_duelist ()
  {
    ao_name = "DA";
    ao_desc = "Duelist Algorithm";
    ao_link = "https://www.mql5.com/ja/articles/19093";

    popSize               = 50;    // number of duelists
    luckCoefficient       = 0.01;  // luck coefficient
    learningProbability   = 0.2;   // learning probability for losers
    innovationProbability = 0.1;   // probability of innovation for winners
    championsCount        = 5;     // number of champions

    ArrayResize (params, 5);

    params [0].name = "popSize";               params [0].val = popSize;
    params [1].name = "luckCoefficient";       params [1].val = luckCoefficient;
    params [2].name = "learningProbability";   params [2].val = learningProbability;
    params [3].name = "innovationProbability"; params [3].val = innovationProbability;
    params [4].name = "championsCount";        params [4].val = championsCount;
  }

  void SetParams ()
  {
    popSize               = (int)params [0].val;
    luckCoefficient       = params      [1].val;
    learningProbability   = params      [2].val;
    innovationProbability = params      [3].val;
    championsCount        = (int)params [4].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double luckCoefficient;       // luck coefficient
  double learningProbability;   // learning probability
  double innovationProbability; // innovation probability
  int    championsCount;        // number of champions

  private: //---------------------------------------------------------
  int    winners [];            // winners' indices
  int    losers  [];            // losers' indices
  int    champions [];          // champions' indices

  void   DetermineWinnerAndLoser (int duelistA, int duelistB);
  void   LearningProcess         (int loserIndex, int winnerIndex);
  void   InnovationProcess       (int winnerIndex);
  void   TrainNewDuelist         (int championIndex, int newDuelistIndex);
};
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelistクラスのInit は、アルゴリズムの実行準備をおこなうためのメソッドです。 主な役割は、処理を開始する前に、初期パラメータとデータ構造を初期化することです。
このメソッドは、まず標準の初期化処理を呼び出し、パラメータの範囲とステップ幅を設定します。 標準の初期化処理が失敗した場合は、処理を続行できないことを示すため、falseを返します。 次に、チャンピオン数を調整します。チャンピオン数が1未満の場合は1に設定し、集団サイズ以上の場合は、集団全体の4分の1に減らします。 その後、勝者、敗者、チャンピオンのインデックスを格納する各配列をクリアし、次のアルゴリズム段階に備えて初期化します。 最後に、初期化が正常に完了したことを示すため、trueを返します。
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DA_duelist::Init (const double &rangeMinP  [],
                            const double &rangeMaxP  [],
                            const double &rangeStepP [],
                            const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  if (championsCount < 1) championsCount = 1;
  if (championsCount >= popSize) championsCount = popSize / 4;

  ArrayResize (winners, 0);
  ArrayResize (losers,  0);
  ArrayResize (champions, championsCount);

  return true;
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist クラスのDetermineWinnerAndLoserメソッドは、集団に属する2つの個体(決闘者)間の決闘における勝者と敗者を決定します。 処理の流れを順に見ていきましょう。
- 「運」の計算: 各決闘者(AとB)について、運の値(A_LuckおよびB_Luck)を計算します。 運は、各決闘者の基本適応度を表すf値、係数luckCoefficient、およびu.RNDprobab()によって生成されるランダムな値に基づいて決まります。 これにより、運が勝敗に与える影響をシミュレートします。
- 勝者の決定: 各決闘者について、適応度fと運の値を合計し、その合計値を比較します。 合計値が相手以上であれば、その決闘者を勝者とします。
- 結果の保存: 勝者と敗者のインデックスを、それぞれwinners配列とlosers配列に追加します。 これらの配列は、その後の分析や個体群の進化に使用されます。
//————————————————————————————————————————————————————————————————————
//--- Determine the winner and loser in a duel
void C_AO_DA_duelist::DetermineWinnerAndLoser (int duelistA, int duelistB)
{
  // Algorithm from the document
  double A_Luck = a [duelistA].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);
  double B_Luck = a [duelistB].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);

  if ((a [duelistA].f + A_Luck) >= (a [duelistB].f + B_Luck))
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistA;
    losers  [ArraySize (losers) - 1] = duelistB;
  }
  else
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistB;
    losers  [ArraySize (losers) - 1] = duelistA;
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelistクラスのLearningProcessメソッドは、決闘に敗れた個体が勝者から学習するプロセスを実装しています。 このプロセスの目的は、勝者の戦略の一部を敗者に取り入れることで、敗者のパフォーマンスを向上させることです。 メソッドの処理内容を見ていきましょう。
座標の反復処理:forループによって、個体が持つすべての座標を順番に処理します。 座標の数は変数coordsによって決まります。
確率に基づくコピー:ループ内では、u.RNDprobab()を使用してランダムな判定をおこないます。 生成された乱数がlearningProbabilityより小さい場合、次の処理が実行されます。
特性のコピー:敗者(loserIndex)は、勝者(winnerIndex)が持つc番目の座標の値を取り込みます。 つまり、敗者の対応する特性を、勝者の同じ特性の値で更新します。 これにより、敗者は勝者の戦略の一部をコピーします。
このように、このメソッドは、より成功した個体から成功していない個体へ知識や戦略が伝達される過程をシミュレートします。これが、進化プロセスの基礎となります。
//————————————————————————————————————————————————————————————————————
//--- A loser learns from a winner
void C_AO_DA_duelist::LearningProcess (int loserIndex, int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < learningProbability)
    {
      // A loser copies part of a winner's strategy
      a [loserIndex].c [c] = a [winnerIndex].c [c];
    }
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelistクラスのInnovationProcessメソッドは、決闘に勝利した個体に対して革新、すなわち突然変異を発生させる処理を実装しています。 このプロセスでは、勝者の戦略にランダムな変化を加え、新たな可能性を探ります。
座標の反復処理:forループによって、LearningProcessと同様に、個体が持つすべてのc座標を順番に処理します。
確率に基づく突然変異:u.RNDprobab()によって生成された乱数がinnovationProbabilityより小さい場合、突然変異が発生します。 つまり、innovationProbabilityで指定された確率に従って、個体の戦略を変更するかどうかが決まります。
新しい値の生成と補正:乱数生成関数u.RNDfromCI()は、c番目のパラメータについて、rangeMin[c]からrangeMax[c]までの範囲内でランダムな値を生成します。 次に、u.SeInDiSp()を使用して、その値を補正します。 この関数は、指定された範囲(rangeMin[c]~rangeMax[c])内で、刻み幅rangeStep[c]に従った離散的な値に変換する役割を担います。
このように、このメソッドでは、勝者が新たな戦略を試す機会を設けています。その結果、個体の特性や環境への適応能力が向上する可能性があります。 これは、進化プロセスを構成する重要な要素です。
//————————————————————————————————————————————————————————————————————
//--- The innovation process for a winner
void C_AO_DA_duelist::InnovationProcess (int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < innovationProbability)
    {
      // The winner tries a new technique (mutation)
      a [winnerIndex].c [c] = u.RNDfromCI (rangeMin [c], rangeMax [c]);
      a [winnerIndex].c [c] = u.SeInDiSp (a [winnerIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelistクラスのTrainNewDuelistメソッドは、新しい決闘者(個体)を生成し、現在のチャンピオンをもとに学習させることで、その初期設定をおこないます。 これは遺伝の仕組みに似ていますが、ランダム性も取り入れることで、個体群に遺伝的多様性をもたらすプロセスです。
座標の反復処理: forループによって、新しい決闘者(newDuelistIndex)が持つすべてのcパラメータ(座標)を順番に処理し、それぞれの値を設定します。
偏差の計算: deviationを計算します。これは、許容される値の範囲に対して、どの程度の変動を認めるかを決定するものです。
突然変異を伴う遺伝(正規分布): チャンピオン(championIndex)が持つc番目の特性の値に、u.GaussDistribution()関数で生成したランダムな偏差を加えます。 この関数は正規分布(ガウス分布)に従う乱数を生成し、継承する特性にランダムな変動を与えます。 引数の0、rangeMin[c]、rangeMax[c]、8は、正規分布の平均値0、最小値と最大値、および分布の幅を制御するパラメータ8を指定しています。
離散値への調整(SeInDiSp): 突然変異後の新しい決闘者の特性値を、u.SeInDiSp()関数を使用して離散的な値に変換します。 この関数により、新しい決闘者のパラメータが許容範囲内に収まり、刻み幅rangeStep[c]に従った値になるように調整されます。
このように、新しい決闘者はチャンピオンに似た特性を受け継ぎながら、ランダムな変動も加わった状態で生成されます。これによって個体群の多様性が生まれ、新たな戦略を探索できるようになります。
//————————————————————————————————————————————————————————————————————
//--- A champion trains a new duelist
void C_AO_DA_duelist::TrainNewDuelist (int championIndex, int newDuelistIndex)
{
  for (int c = 0; c < coords; c++)
  {
    // The new duelist inherits the champion's abilities with slight variations
    double deviation = (rangeMax [c] - rangeMin [c]) * 0.1;
    a [newDuelistIndex].c [c] = a [championIndex].c [c] + u.GaussDistribution (0, rangeMin [c], rangeMax [c], 8);
    a [newDuelistIndex].c [c] = u.SeInDiSp (a [newDuelistIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelistクラスのMovingメソッドは、決闘者進化アルゴリズムにおける主要な処理を実行します。 このメソッドには、初期化(初回実行時)、繁殖、選択、決闘、学習(決闘の結果を利用)、革新、および淘汰が含まれます。 進化プロセスの中核となる処理を、順を追って見ていきましょう。
集団の初期化(初回実行): 初回実行時(revisionがfalseの場合)、集団を初期化します。各個体iについて、すべての特性jの値を、許容範囲と刻み幅に従ってランダムに設定します。 初期化が完了すると、以降の実行時に再初期化されないよう、revisionをtrueに設定します。
繁殖の準備: 集団を格納する配列aのサイズを拡張し、チャンピオンから新たに生成される決闘者を収容できるようにします。 新しい決闘者を初期化し、それぞれの初期状態を設定します。
チャンピオンの選出: 適応度を表すfパラメータに基づいて個体群をソートし、優れた個体を選びます。 その中から、上位championsCount個体をチャンピオンとして選出します。 各チャンピオンはTrainNewDuelistメソッドを使用して、自身の特性を受け継ぐ新しい決闘者を生成します。
決闘の準備: 新たな決闘の結果を記録できるよう、winners配列とlosers配列をクリアします。
決闘の実行: チャンピオン以外の各個体は、チャンピオンではない個体の中からランダムに選ばれた対戦相手と決闘します。 各決闘の勝者と敗者は、DetermineWinnerAndLoserメソッドによって決定されます。
決闘者の学習: 敗者は勝者から学習します。 LearningProcessメソッドによって、敗者は勝者の優れた特性を取り入れ、自身のパラメータを変更します。
勝者の革新: 優れた個体はInnovationProcessメソッドを使用して、自身の戦略に変化を加え、新たな可能性を探ります。
再ソート: 決闘、学習、革新による変化を反映するため、個体群全体をfパラメータに基づいて再びソートし、個体の順位を更新します。
最下位個体の淘汰: 配列aのサイズをpopSizeに戻し、成績の悪い個体を取り除くことで、集団の規模を一定に保ちます。
この一連の処理が、進化の1ステップに相当します。子孫の生成、優れた個体の選出、学習、戦略の更新をおこないながら、集団の規模を維持します。 Movingメソッドは、繁殖、突然変異、選択、学習という進化アルゴリズムの基本的な操作を実行する役割を担っています。
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DA_duelist::Moving ()
{
  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Temporary array expansion for new duelists
  int totalDuelists = popSize + championsCount;
  ArrayResize (a, totalDuelists);

  // Initialize new duelists
  for (int i = popSize; i < totalDuelists; i++)
  {
    a [i].Init (coords);
  }

  // Sort to determine champions (using bubble sort)
  for (int i = 0; i < popSize - 1; i++)
  {
    for (int j = 0; j < popSize - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Determine the champions
  for (int i = 0; i < championsCount; i++)
  {
    champions [i] = i;
    // A champion trains a new duelist
    TrainNewDuelist (i, popSize + i);
  }

  // Clear the winners' and losers' arrays
  ArrayResize (winners, 0);
  ArrayResize (losers,  0);

  // Conduct duels (excluding champions)
  for (int i = championsCount; i < totalDuelists; i++)
  {
    // Each duelist fights one random opponent
    int opponent = u.RNDintInRange (championsCount, totalDuelists - 1);
    if (opponent != i)
    {
      DetermineWinnerAndLoser (i, opponent);
    }
  }

  // Improving duelists
  int minCount = MathMin (ArraySize (winners), ArraySize (losers));
  for (int i = 0; i < minCount; i++)
  {
    // Losers learn from winners
    LearningProcess (losers [i], winners [i]);
  }

  for (int i = 0; i < ArraySize (winners); i++)
  {
    // Winners innovate
    InnovationProcess (winners [i]);
  }

  // Sort all duelists
  for (int i = 0; i < totalDuelists - 1; i++)
  {
    for (int j = 0; j < totalDuelists - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Remove the worst duelists
  ArrayResize (a, popSize);
}
//————————————————————————————————————————————————————————————————————
C_AO_DA_duelist クラスのRevision メソッドは、現在の集団の中で見つかった最良解に関する情報を更新するために使用されます。 進化の過程を通じて、大域的最適解を追跡することを目的としています。
集団の走査: forループによって、集団内の各個体(i = 0からpopSize - 1まで)を順番に処理します。
適応度の比較: ループ内では、現在の個体の適応度fが、これまでに記録された最良の適応度fBよりも優れているかどうかを判定します。
最良解の更新: 現在の個体の適応度a[i].fがfBよりも優れている場合、fBを更新します。つまり、fBには、それまでに見つかった最良の適応度が記録されます。 さらに、現在の個体が持つc特性の値をcB配列にコピーします。 これにより、cBには、これまでに見つかった最良の個体の特性値が保存されます。
このように、Revisionメソッドは現在の集団を走査し、最も高い適応度を持つ個体を探します。その個体がこれまでの最良記録を上回っている場合、最良の個体に関する情報(適応度と特性値)を更新します。 このメソッドは、アルゴリズムの進捗を追跡し、大域的最適解を見つけるために重要な役割を果たします。
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DA_duelist::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
テスト結果
今回の検証の結果、総じて、決闘者アルゴリズムは良好な性能を発揮することが確認できました。DA|Duelist Algorithm|100.0|0.01|0.9|0.1|2.0|
=============================
5 Hilly's; Func runs: 10000; result: 0.9278151663330798
25 Hilly's; Func runs: 10000; result: 0.5377820196319314
500 Hilly's; Func runs: 10000; result: 0.27792394907287765
=============================
5 Forest's; Func runs: 10000; result: 0.8695700230324329
25 Forest's; Func runs: 10000; result: 0.47535947112902815
500 Forest's; Func runs: 10000; result: 0.18193288697223736
=============================
5 Megacity's; Func runs: 10000; result: 0.6215384615384616
25 Megacity's; Func runs: 10000; result: 0.3356923076923076
500 Megacity's; Func runs: 10000; result: 0.11715384615384725
=============================
All score: 4.34477 (48.28%)
アルゴリズムの動作を可視化した結果、次元数が小さい場合も大きい場合も、値のばらつきが小さいことが確認できます。これは、アルゴリズムが優れた探索性能を備えていることを示しています。
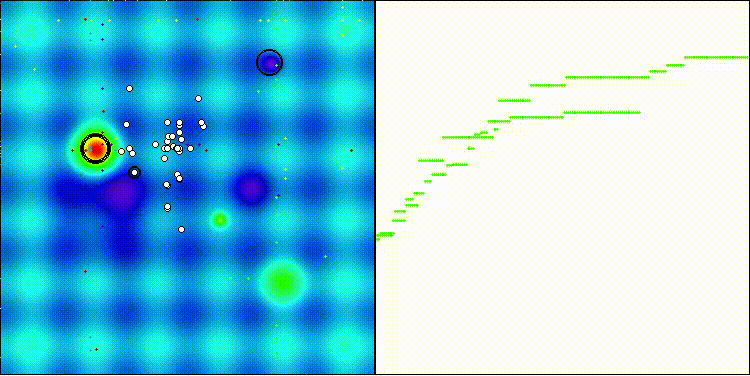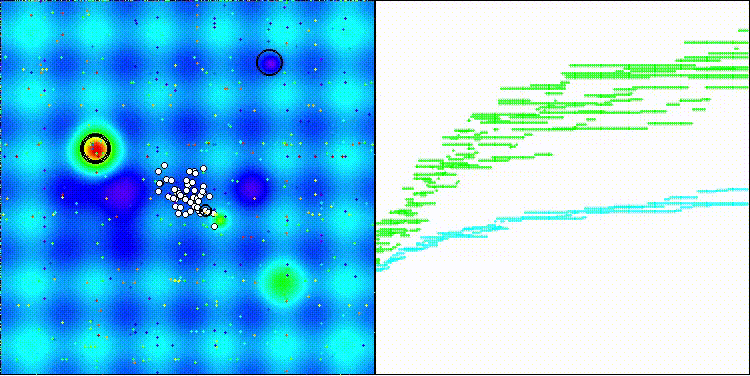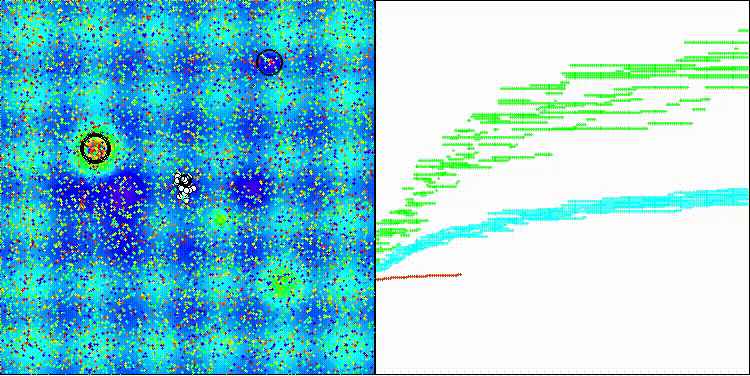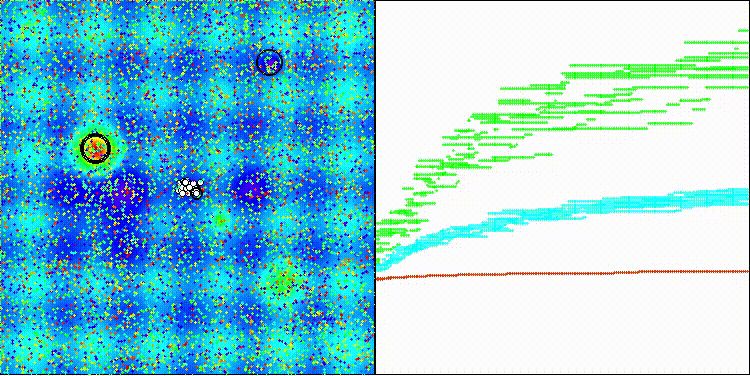
Hillyテスト関数におけるDA_duelistの動作
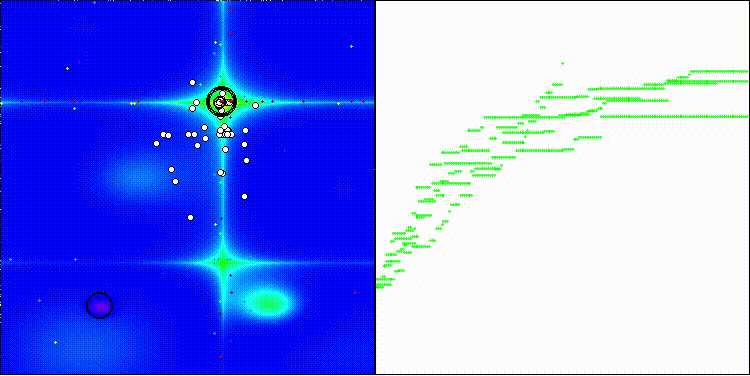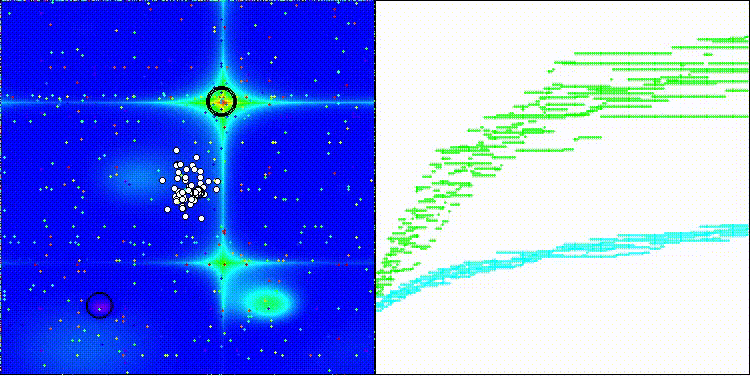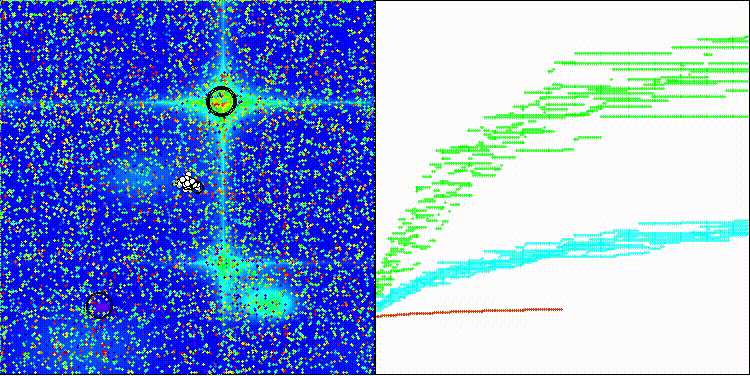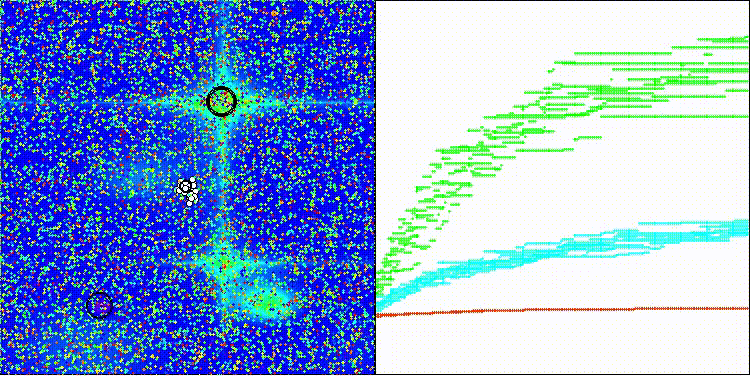
Forestテスト関数におけるDA_duelistの動作
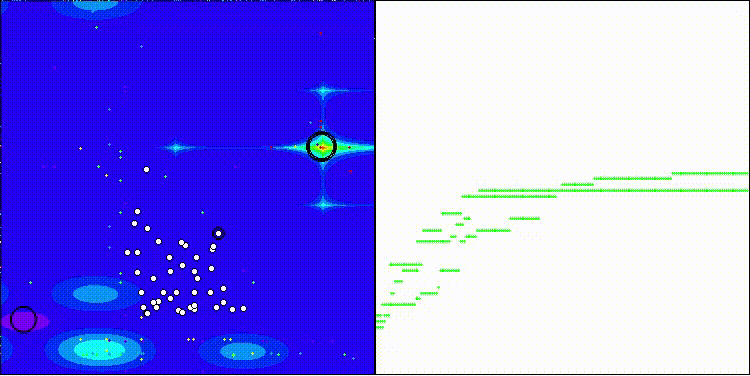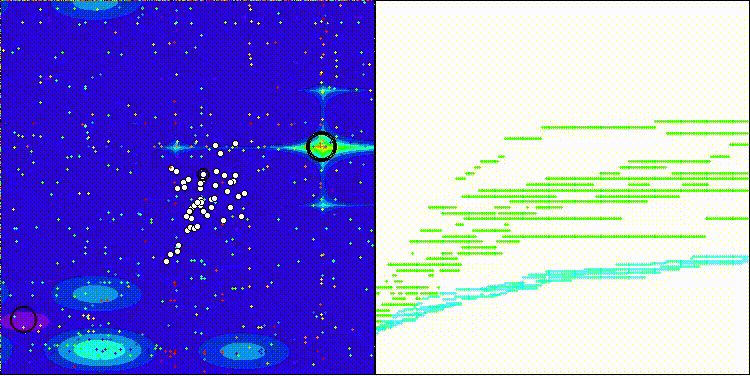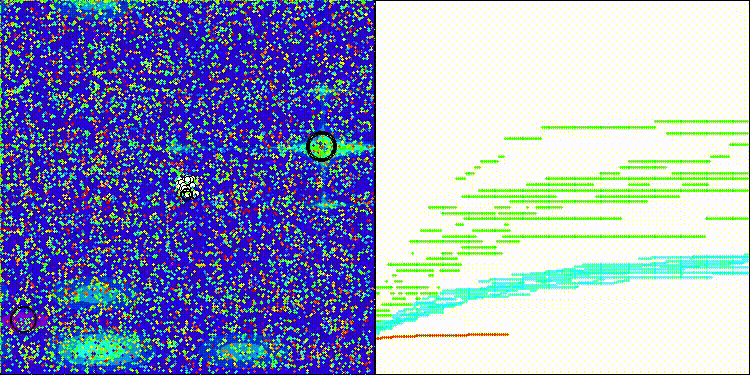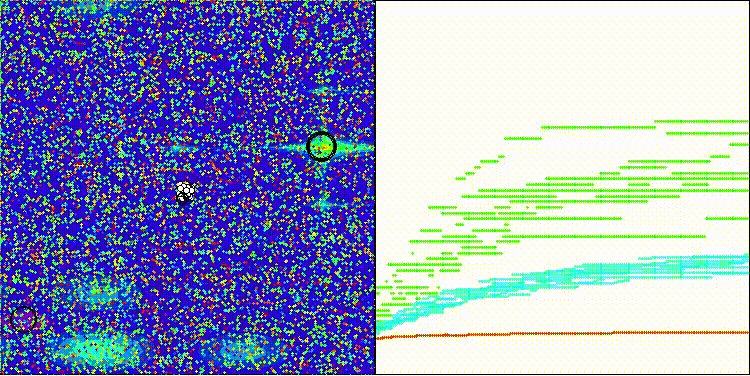
Megacityテスト関数におけるDA_duelistの動作
テスト結果によると、Duelistアルゴリズムは、検証対象となった最適化アルゴリズム全体の中で42位にランクされています。
| # | AO | 説明 | Hilly | Hilly 最終結果 | Forest | Forest 最終結果 | Megacity(離散型) | Megacity 最終結果 | 最終 結果 | 最大値に対する割合 (%) | ||||||
| 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | 10 p(5 F) | 50 p(25 F) | 1000 p(500 F) | ||||||||
| 1 | ANS | 近傍横断探索 | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | コードロックアルゴリズム(joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | 動物移動最適化 M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O)進化戦略 | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | 彗尾アルゴリズム(joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2,19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | 時間進化移動アルゴリズム(joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | 確率的拡散探索 M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | ビリヤード最適化アルゴリズム M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | アーチェリーアルゴリズム M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | 社会集団の進化(joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | 等方的焼きなまし(joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | 極値最適化M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | 生物地理学に基づく最適化 | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | 人工協調探索 | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | 弁証法的アルゴリズム | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | ブラックホールアルゴリズム M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | 無政府社会最適化 | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | ロイヤルフラッシュ最適化(joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | 原子軌道探索 M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | 亀甲進化アルゴリズム(joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | バックトラッキング探索アルゴリズム | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | 差分進化 | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | レストラン経営達人アルゴリズム(joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | 化学反応最適化 | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | 血液型遺伝最適化(joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | BSA | 群鳥アルゴリズム | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 27 | DEA | イルカエコーロケーションアルゴリズム | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 28 | HS | ハーモニーサーチ | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 29 | SSG | 苗木の播種と育成 | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1,19398 | 4.676 | 51.95 |
| 30 | BCOm | 細菌走化性最適化 M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 31 | ABO | アフリカ水牛最適化 | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1,17378 | 4.634 | 51.49 |
| 32 | (PO)ES | (PO) 進化戦略 | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 33 | FBA | フラクタルベースアルゴリズム | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1,19537 | 4.555 | 50.61 |
| 34 | TSm | タブーサーチM | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 35 | BSO | ブレインストーム最適化 | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 36 | WOAm | クジラ最適化アルゴリズム M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 37 | AEFA | 人工電界アルゴリズム | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 38 | AEO | 人工生態系ベースの最適化アルゴリズム | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 39 | CAm | ラクダアルゴリズムM | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 40 | ACOm | 蟻コロニー最適化M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 41 | CMAES | 共分散行列適応進化戦略 | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 42 | DA_duelist | duelist_algorithm | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48.28 |
| 43 | BFO-GA | 細菌採餌最適化 - GA | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 44 | SOA | シンプル最適化アルゴリズム | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| 45 | ABHA | 人工蜂群アルゴリズム | 0.84131 | 0.54227 | 0.26304 | 1.64663 | 0.87858 | 0.47779 | 0.17181 | 1.52818 | 0.50923 | 0.33877 | 0.10397 | 0.95197 | 4.127 | 45.85 |
| RW | ランダムウォーク | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
まとめ
決闘者アルゴリズムは、メタヒューリスティック最適化の分野で良好な結果を示しており、集団ベースのアルゴリズムの中で上位45位以内にランクされています。 最適化手法の中で絶対的な首位を目指すものではありませんが、最大の強みは処理速度にあります。
適応的な学習戦略:取引システムの最適化において、これは、性能の低いパラメータ設定が、性能の高い設定のパターンを迅速に取り入れることを意味します。これは、非定常な金融時系列を扱う際に特に有効です。
活用と探索のバランス:勝者も現状に満足することなく、革新を通じてさらなる改善を目指します。 これは、変化する市場環境に適応しなければならない取引戦略にとって、非常に重要です。
制御されたランダム性:この要素によって、市場の不確実性を自然にモデル化できます。優れた戦略であっても、短期的なボラティリティの影響で、一時的に良好な成績を収められないことがあります。
チャンピオンを中心とした階層構造:優れた解を保持し、その特性を他の個体に伝播させます。取引に置き換えると、実績のある戦略を維持しながら、新たな収益機会を同時に追求することに相当します。
決闘者アルゴリズムは、武術の比喩を通じて、シンプルながらも効果的な考え方を最適化の世界にもたらす、堅実な手法です。すなわち、優れた相手から学び、優位な立場で新たに挑戦し、次の世代に知識を伝えるという考え方です。
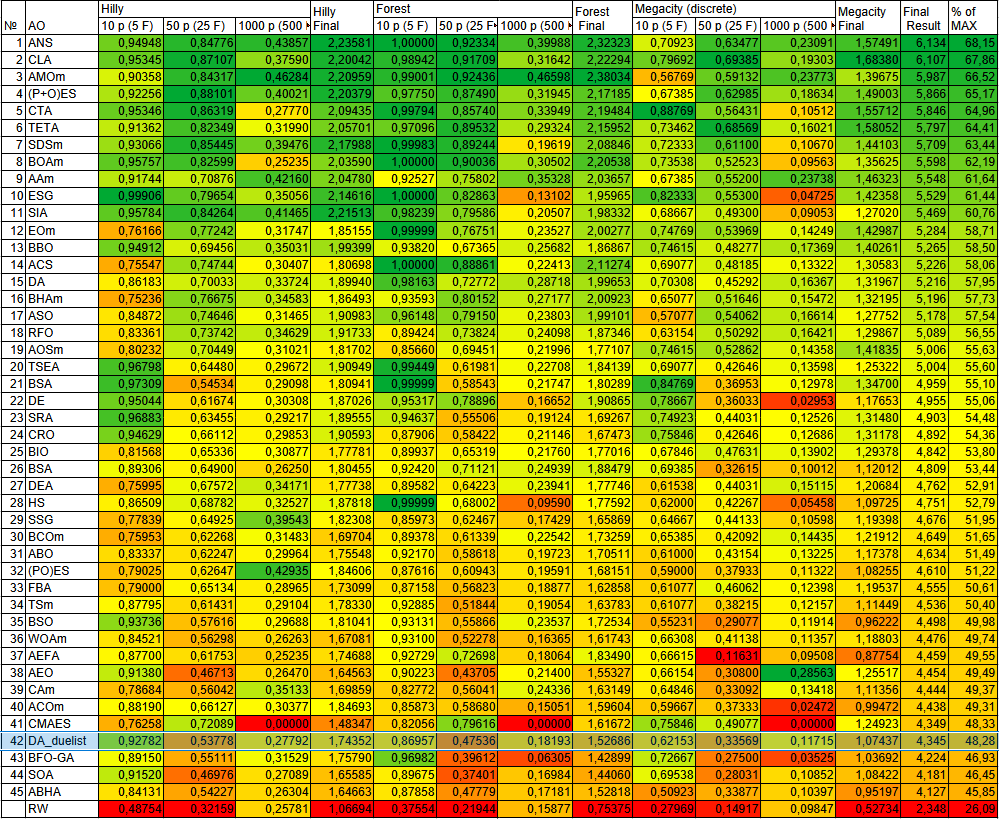
図2: 各テストにおけるアルゴリズムの成績を色の濃淡で表現した図
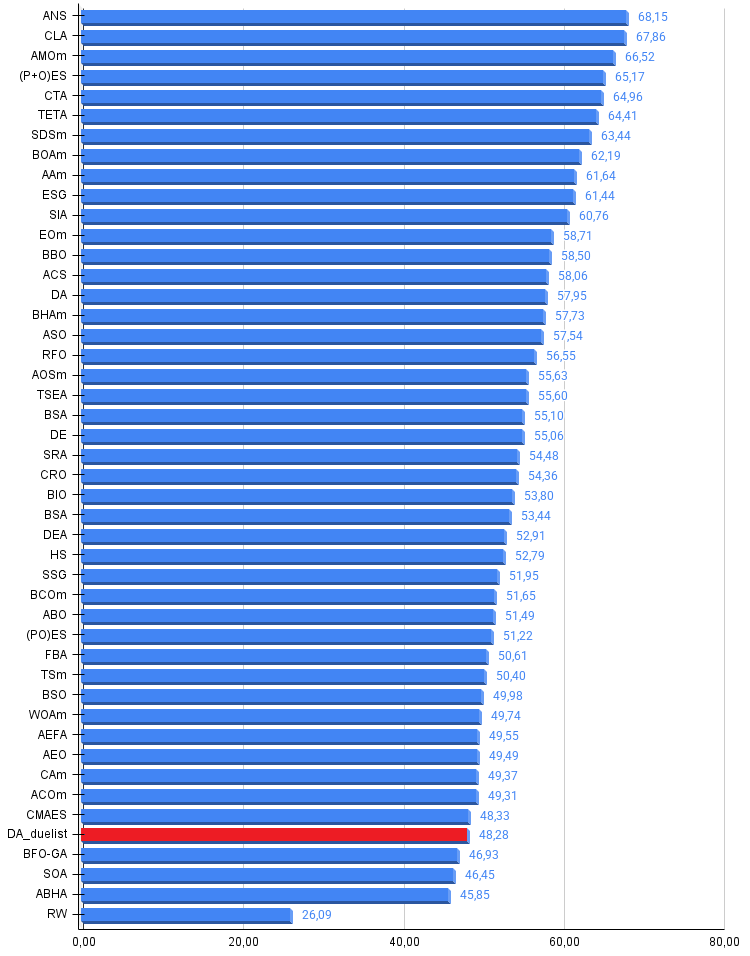
図3: アルゴリズムのテスト結果を示すヒストグラム(0~100のスケール。値が大きいほど良好で、100は理論上の最大値。アーカイブには、ランキング表を計算するためのスクリプトが含まれています)
DA_duelistの長所と短所:
長所:
- 速い。
- テスト関数間での成績のばらつきが小さい。
短所:
- 収束精度が低い。
アルゴリズムの最新バージョンのソースコードを含むアーカイブが、記事に添付されています。 本記事の著者は、標準的なアルゴリズムの説明が完全に正確であることを保証するものではありません。 探索性能を向上させるため、多くのアルゴリズムに変更が加えられています。 記事内で示されている結論や評価は、実験結果に基づいています。
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | #C_AO.mqh | Include | 集団最適化アルゴリズムの親クラス |
| 2 | #C_AO_enum.mqh | Include | 集団最適化アルゴリズムの列挙型 |
| 3 | TestFunctions.mqh | Include | テスト関数ライブラリ |
| 4 | TestStandFunctions.mqh | Include | テスト環境用関数ライブラリ |
| 5 | Utilities.mqh | Include | 補助関数ライブラリ |
| 6 | CalculationTestResults.mqh | Include | 比較表の結果を計算するスクリプト |
| 7 | Testing AOs.mq5 | スクリプト | すべての集団最適化アルゴリズムに共通のテスト環境 |
| 8 | Simple use of population optimization algorithms.mq5 | スクリプト | 可視化機能を使わずに集団最適化アルゴリズムを使用する簡単な例 |
| 9 | Test_AO_DA_duelist.mq5 | スクリプト | DA_duelistのテスト環境 |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19093
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 取引におけるニューラルネットワーク:Temporal Queryモデル(TQNet)
 取引におけるニューラルネットワーク:構造成分の分離(最終回)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:構造成分の分離(Encoder)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
「決闘者のアルゴリズム — Duelist Algorithm」という記事が公開されました:
著者:Andrey Dik
リングで戦う決闘者たち。市場はリングではなく、ある種の「戦場」だ。時には夏場、時には腰まで泥沼に浸かることもある。氷の上ならフィギュアスケーターが勝つが、泥沼では……結局、どんな戦士になるというのか?
インターネットで自分で調べてみてください。これはこのトピックの投稿者がでっち上げた話ではありません。