

取引におけるニューラルネットワーク:Temporal Queryモデル(最終回)
 25
 0

はじめに
TQNetフレームワークは、時系列データや構造化データを効果的に処理するニューラルネットワークモデルを構築するための、洗練された柔軟性の高いアプローチの一つです。 最大の特徴は、局所的依存関係と大域的依存関係を組み合わせ、分析の深さと計算効率を両立させている点にあります。 従来のアーキテクチャとは異なり、TQNetは逐次データを処理する仕組みと、長期的依存関係を捉える手法をシームレスに統合しています。 この特性は、短期的な価格変動と時間の経過に伴って形成されるトレンドの両方が重要となる金融時系列の分析において、特に有用です。
このアルゴリズムは、計算処理を構成する独自のアプローチに基づいています。 その中心的な役割を担うのが、大域相関テンソルです。 これは、シーケンスを構成する要素間の関係を示す一種のマップとして機能し、モデルが局所的なパターンを捉えるとともに、データ構造の全体像を包括的に把握できるようにします。
TQNetの計算プロセスは、相互に連携する一連のステップとして説明できます。 最初の段階では、入力データが局所的な特徴量を抽出する層を通過し、現在の状態を特徴付ける重要な情報が取り出されます。 次に、大域相関メカニズムが作動し、それまでの各ステップで蓄積された構造的依存関係を、抽出された特徴量に反映させます。 この反復的な仕組みにより、モデルは状況の変化に柔軟に適応し、データに潜むパターンを考慮できます。 このアプローチの特徴は、データの処理順序が固定されていないことです。シーケンス内では、さまざまな方向に関係を形成できるため、予測や分析における適用範囲が広がります。
TQNetの実用的な価値は、ノイズを含むデータや、複雑な内部構造を持つデータを扱う際に明確になります。 金融市場、天気予報、産業プロセスの分析など、いずれの分野でも重要なのは、予測精度だけではありません。予期しない外れ値やデータの変動特性の変化に対して、モデルがどれだけ安定性を保てるかも重要です。 適切に設計されたパラメータ更新アルゴリズムと計算リソースの効率的な活用により、TQNetは過剰な学習リソースを必要とせず、大規模なデータセットに対しても安定した性能を発揮します。
著者によるフレームワークの図解を以下に示します。
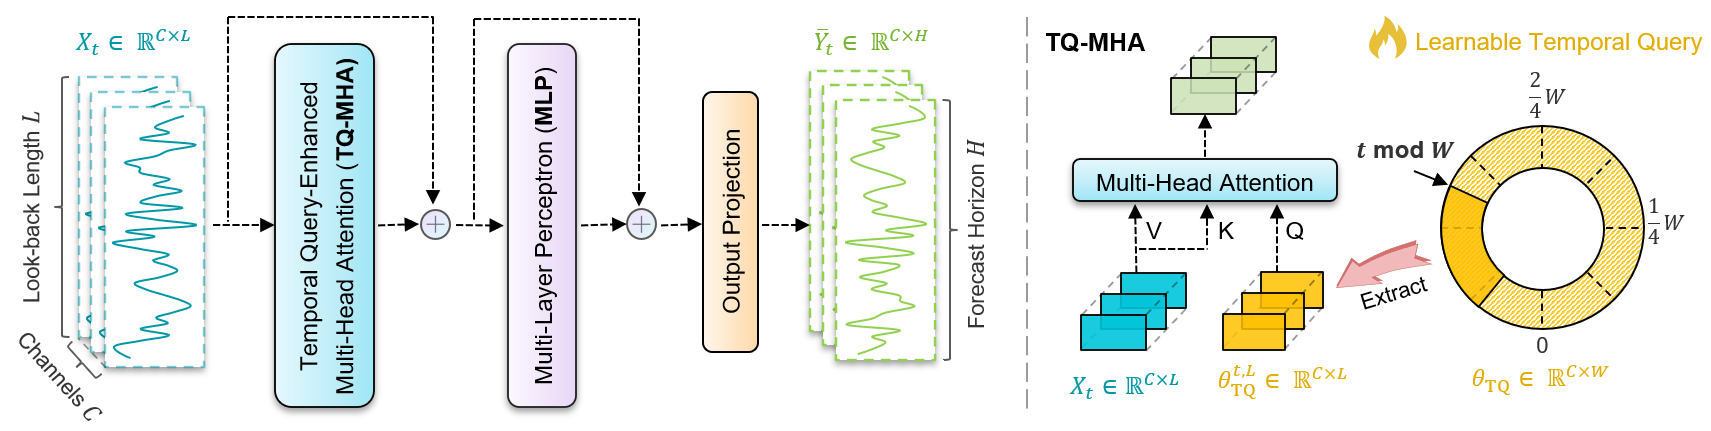
前回の記事では、TQNetフレームワークの理論的な側面について考察しました。具体的には、モジュール型アーキテクチャ、市場環境に柔軟に適応する能力、そして効率的なリソース管理について取り上げました。 しかし、理論はあくまでも全体を支える骨組みにすぎません。 また、大域的な相関関係をオブジェクトとして保存し、各時間ステップで動的に切り替えられるようにするCCircleParamsオブジェクトについても検討しました。 今回は引き続き、MQL5を用いて、TQNetフレームワークの著者らが提案した手法の実装を進めていきます。
TQ-MHAモジュール
相関パラメータのテンソルカルーセルを構成するアルゴリズムの実装に成功したため、次の段階としてTQ-MHAモジュールの作成に進みます。 著者らの構想では、このモジュールは特別な役割を担います。蓄積された相関パラメータを個別に分析するのではなく、分析対象となる入力データと密接に関連付けながら処理する、インテリジェントなフィルタとして機能するのです。 言い換えれば、蓄積された統計情報を処理し、現在の市場環境を踏まえながら、データ間の関係性を捉えようとします。 このアプローチは、表やグラフの数値だけを見るのではなく、実際の出来事や市場の動向と照らし合わせて分析する、経験豊富なアナリストの仕事に例えることができます。
これまで扱ってきたアーキテクチャと比較すると、TQ-MHAは多くの点でCross-Attentionモジュールに似ています。 ただし、ここには独自の特徴があります。KeyとQueryという2つの情報の流れを直接比較するのではなく、より複雑で精緻な処理をおこないます。 TQ-MHAモジュールは、入力データを相関依存行列に適用し、その中から特に重要な交点を特定します。 これは単なる技術的な最適化ではありません。より広い文脈の中で市場シグナルを解釈できるようにする、分析能力の質的な向上を意味します。
ここでもう一つ、注目すべき点があります。 これまでTransformerアーキテクチャの原理に基づいて実装してきたCross-Attentionモジュールには、必ずFeedForwardブロックが含まれていました。これは、Attention層の間でデータを非線形変換する、小規模ながら重要な要素です。一方、TQNetフレームワークの著者らは、形式上、このブロックを省略しています。まるで、従来の処理フローから一つの段階を丸ごと取り除いたかのようです。 一見すると単純化しすぎているようにも思えますが、フレームワークの内部ロジックを詳しく調べたところ、TQ-MHAの後段にMLPモジュールが配置されており、実質的に従来のFeedForwardブロックと同等の機能を果たしていることがわかりました。
違いは、活性化関数という一点にあります。 しかし、これは障害ではありません。むしろ、さまざまな実験をおこなう機会となります。 目的や金融時系列データの具体的な特性に合わせて、活性化関数をより適切なものに置き換えることも容易です。
そこで、蓄積された相関パラメータを考慮しながらCross-Attentionの仕組みを統合し、フレームワーク内の他のモジュールともシームレスに連携できる専用オブジェクトCNeuronTQMHAの設計に着手しました。 新しいクラスの構造を以下に示します。
class CNeuronTQMHA   :  public CNeuronCrossAttention
  {
protected:
   uint              iTimeframe;
   CCircleParams     cParams;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer, CBufferFloat *SecondInput,
                       CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);

public:
                     CNeuronTQMHA(void) {};
                    ~CNeuronTQMHA(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint heads,
                          uint units_in, uint period, uint timeframe,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTQMHA;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
  };
CNeuronTQMHAクラスは、Cross-AttentionオブジェクトであるCNeuronCrossAttentionから基本的な機能と内部オブジェクトの大部分を継承しています。 ただし、通常のCross-Attentionとは異なり、テンソルカルーセルから取得した相関パラメータを扱うように設計されています。
クラス本体では、2つの重要な要素のみを宣言します。 1つ目はiTimeframeで、カルーセル内の相関行列を切り替える時間ステップの間隔を指定します。 2つ目はcParamsで、蓄積された相関パラメータを管理するCCircleParamsクラスのインスタンスです。 これらのパラメータこそが、Multi-Head Attentionによって初期データとの関連において分析される素材となります。
このクラスの内部オブジェクトは静的に宣言されているため、コンストラクタとデストラクタは空のままにできます。つまり、オブジェクトの生成時にも破棄時にも、余計な処理は発生しません。 負荷の大きい処理はすべて初期化メソッドに集約されています。 これにより、オブジェクトのライフサイクルを明確かつ予測可能に管理できます。生成時のコストを抑えながら、動作に向けた準備を明示的に制御できるのです。
Initメソッドでは、いくつかの重要な処理を実行し、それぞれの結果を慎重に確認します。
bool CNeuronTQMHA::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                        uint window, uint window_key, uint heads,
                        uint units_count, uint period, uint timeframe,
                        ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossAttention::Init(numOutputs, myIndex, open_cl, window,
                                   window_key, heads, units_count, window,
                                   units_count, optimization_type, batch))
      return false;
まず、同名の親クラスのメソッドに処理を引き継ぎ、基本的なCross-Attentionのロジックを継承して設定します。 何らかの理由で基本的な初期化に失敗した場合、メソッドは直ちにfalseを返します。このような早期終了により、無効な状態が後続の処理に伝播するのを防ぎ、デバッグも容易になります。
次に、FeedForwardブロックの層間における活性化関数を設定します。
FF[0].SetActivationFunction(GELU);
前述のとおり、フレームワークの著者らがTQ-MHAの後段で使用しているMLPは、実質的に従来のFeedForwardブロックとして機能します。 活性化関数を変更することで、金融時系列データの特性に合わせて非線形性を柔軟に調整することも可能になります。GeLUはより滑らかな近似を提供し、一般に、出力が急激に切り替わるReLUの活性化よりも、ノイズを含むデータに対して安定して動作することがあります。 市場の瞬間的な変動があっても、関数の出力が急激に変化しにくいため、学習もより滑らかに進みます。
iTimeframeパラメータには下限値を設け、ゼロにならないようにしています。これは単純ですが重要な安全対策です。 実際には、設定に誤りがあった場合でも、モジュールが最低限妥当な動作モードで稼働できるようにします。
   iTimeframe = MathMax(1, timeframe);
   if(!cParams.Init(0, 0, OpenCL, window * units_count, period, optimization, iBatch))
      return false;
   if(!cParams.Zeros())
      return false;
//---
   return true;
  }
初期化プロセスの重要な部分は、cParamsオブジェクトの準備です。 ここでは、内部に大域相関の枠組みを明示的に作成します。 各時間ウィンドウ(window)および分析対象となる各単変量系列(units_count)に対して、相関テンソル内に対応する要素を作成します。 初期化時にこれらのバッファをOpenCLコンテキストに関連付けることで、大量のデータを処理する際の効率をさらに高めます。
最後に、cParams.Zerosを呼び出すことで、著者らが推奨する初期化方式を適用します。つまり、グローバルメモリのすべてのパラメータをゼロに設定します。 これは重要な設計上の判断です。ゼロ初期化によって相関関係に初期バイアスが入り込むのを防ぎ、モデルが白紙の状態から学習データのみに基づいて独自の関係性を構築できるようにします。 メモリパラメータのレベルで不要なノイズを導入したくない問題では、この方法はランダム初期化よりも適していることがよくあります。
すべての手順が正常に完了すると、このメソッドはtrueを返します。これでオブジェクトは完全に使用可能な状態になります。バッファが作成され、活性化関数が設定され、周期的メモリの準備とクリアが完了しています。 全体として、このメソッドは後続の処理に向けて、安定性、予測可能性、効率性を備えた基盤を提供します。これにより、CNeuronTQMHAは、蓄積されたθベクトルと分析対象データとの関連付けを実際に開始し、過去の相場価格から学習できるようになります。
クラス構造を説明したところで、次にその主要な処理である順伝播アルゴリズムを分析するのが自然な流れです。 このメソッドは、最も単純でありながら最も基本的な手順、すなわちSecondInputバッファへのポインタが有効であることの確認から始まります。
bool CNeuronTQMHA::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
このバッファには、相関パラメータのカルーセルの位置を決定するための基準点が格納されることを想定しています。 これが存在しない場合、処理は直ちに終了し、falseを返します。 このチェックにより、無効な呼び出しからモジュールを保護し、その後に不要な計算が実行されるのを防ぎます。
次に、カルーセルの現在位置を特定します。 そのために、SecondInputバッファのインデックス0にある要素を読み取ります。 実際には、これが最後のバーの始値時刻であることを想定しています。
   int pos = int(SecondInput[0]);
   pos = (pos / int(iTimeframe)) % cParams.GetPeriod();
   if(!cParams.SetPosition(pos) ||
      !cParams.FeedForward())
      return false;
得られた整数値をパラメータのカルーセルのインデックスに変換します。 まず、iTimeframeで割ることで、連続するステップを指定されたステップ幅のバケットにまとめ、ブロック番号を求めます。 次に、データの周期長で割った余りを求めることで、相関パラメータのカルーセル内にある特定の要素のインデックスを取得します。 これら2つの演算を組み合わせることで、周期的メモリの概念を実現します。つまり、同じブロック内にあり、周期長だけ離れた時点では、同じTQベクトルの集合が使用されます。
次のブロックでは、アクティブなパラメータの複製を厳密に切り替え、その複製に対して順伝播を実行し、相関パラメータを使用できる状態にします。 これらの手順のうち、1つでもエラーが発生した場合、メソッドはfalseを返します。 これにより、以降の処理では、適切に準備されたグローバルパラメータのセットを常に使用できるようになります。
続く手順では、Cross-Attentionモジュールの処理を再現します。 同名の親クラスのメソッドに処理を引き継ぐこともできますが、意味的には問題が生じます。 基本実装では、残差接続がQueryの経路に沿っておこなわれます。 しかし、今回のケースでは、Queryは現在のウィンドウの局所表現ではなく、蓄積されたTQベクトル、つまり大域的なメモリです。 この同じメモリを残差接続の経路に通すと、現在の局所的なKey/Value信号を上書きし、入力データから得られる重要な特徴を抑制してしまうおそれがあります。 金融市場では、これはすぐに問題として現れるでしょう。モデルが過去の情報に基づく枠組みに過度に依存し、新たな市場の動きへの反応が鈍くなり、精度が低下する可能性があります。
そのため、Attention計算の低レベルなロジックは意図的に再利用しつつ、残差接続と結果の正規化については独自のロジックを実装します。 これにより、Attentionの重みを計算する際に大域的なTQの知識を活用しながら、現在のデータの影響も維持できます。
大域相関ベクトルが有効化され、使用できる状態になったら、それらをQuery空間へ射影します。
   if(!Q_Embedding.FeedForward(cParams.AsObject()))
      return false;
//---
   if(!KV_Embedding.FeedForward(NeuronOCL))
      return false;
ここで、Q_Embeddingは大域相関を線形射影し、それらを各Attentionヘッドに分配します。
同時に、外部プログラムから受け取った入力データに基づいて、KeyとValueが生成されます。 その結果、2つの情報の流れが形成されます。1つは長期的依存関係の「メモリ」を保持する大域的なQuery、もう1つは現在の市場の動きを反映する局所的なKey/Valueです。
続いて呼び出される継承元のattentionOutメソッドは、Multi-Head Attentionの計算を担います。 この段階では、標準的なMHA演算が実行されます。 その結果、各HeadのAttention行列が計算され、共有のMHAttentionOutバッファに集約されます。
重要なのは、ここで実装しているのが、大域的な要素(θTQに由来するQuery)と局所的な要素(入力データに由来するKey/Value)を組み合わせるロジックそのものだという点です。これこそがTQアプローチの中核です。
   if(!attentionOut())
      return false;
//---
   if(!W0.FeedForward(GetPointer(MHAttentionOut)))
      return false;
//---
   if(!SumAndNormilize(W0.getOutput(), NeuronOCL.getOutput(), AttentionOut.getOutput(), iWindow))
      return false;
Attentionの計算結果が得られたら、出力射影を通過します。 これは、すべてのAttention Headの出力を、元のデータ空間の次元数に戻して統合するWO行列です。
次に、2つの情報の流れから得られたデータを加算し、その結果を正規化します。 これは、残差接続における標準的な手順です。 入力データのテンソルをAttentionの射影結果に加算した後、iWindowウィンドウにわたって結果を正規化します。 この設計により、学習プロセスが安定し、入力情報が保持され、信号の減衰が防止されます。 また、正規化は分布ドリフトを抑える役割も果たします。これは、ボラティリティが変動する金融時系列データにおいて特に重要です。
続いて、MLPブロックの一連の処理が実行されます。
   if(!FF[0].FeedForward(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].FeedForward(GetPointer(FF[0])))
      return false;
//---
   if(!SumAndNormilize(FF[1].getOutput(), AttentionOut.getOutput(), Output, iWindow))
      return false;
//---
   return true;
  }
これらは、中間に非線形変換(今回の実装ではGeLU)を挟んだ2層の多層パーセプトロンです。 基本的に、これらの層はTransformerにおける従来のFeedForward層と同じ役割を果たします。すなわち、表現の次元を拡張し、非線形性を導入し、有用な特徴を強調するとともに、モデルが信号に耳を傾ける周波数帯域を調整します。
最後に、2回目のSumAndNormilizeの呼び出しによって、MLPの出力と直前の表現が結合され、正規化されて、最終的な結果が生成されます。 このステップで一連の処理が完了します。大域的なTQベクトルの抽出から始まり、モデルの次の階層に渡すための、適応・正規化された表現を得るまでの処理です。
すべての手順が正常に完了した場合、メソッドはtrueを返します。これは、順伝播が正しく完了し、その結果を利用できる状態になったことを示します。
アーキテクチャ上の重要な点は、処理の早い段階でチェックを行い、エラーがあれば早期に処理を終了するという一連の仕組みです。これによりリソースを節約し、OpenCLバッファに対する整合性のない操作を防ぎます。
順伝播の説明に続いて、対となる処理、すなわちCNeuronTQMHA内部での誤差勾配の伝播について見ていきましょう。 ここでは、計算の順序を逆にたどり、ブロックの出力から入力データへと遡りながら、誤差信号を慎重に累積し、MLP、Attention、各種射影、および大域的なcParamsメモリという、すべての構成要素に分配していきます。
bool CNeuronTQMHA::calcInputGradients(CNeuronBaseOCL *prevLayer,
                                      CBufferFloat *SecondInput,
                                      CBufferFloat *SecondGradient,
                                      ENUM_ACTIVATION SecondActivation = None)
  {
   if(!prevLayer)
     return false;
メソッド本体では、まず入力データオブジェクトへのポインタが有効であることを確認します。 これは単純ですが、極めて重要な安全対策です。 前段の層が存在しない場合、意味のない計算処理を続行してはなりません。
次に、MLPの処理系列の末端から、勾配を順に取り出していきます。 MLPの内部パラメータには適切な誤差寄与が与えられ、勾配は処理系列のさらに前段へ伝播できるよう、慎重に準備されます。
   if(!FF[0].CalcHiddenGradients(FF[1].AsObject()))
      return false;
   if(!AttentionOut.CalcHiddenGradients(FF[0].AsObject()))
      return false;
次のコード行は、MLPから、その入力元である AttentionOutへと信号を逆伝播させます。 言い換えれば、Attention ブロックに対して、「MLPの処理に起因する誤差はこれだけなので、入力全体に分配してください」と指示することになります。 これにより、表現を非線形に精緻化する処理と、Attentionによって形成された表現そのものとの間で、一貫性が保たれます。
ただし、次の処理に進む前に、残差接続における第2の情報経路についても誤差勾配を計算する必要があります。これにより、W0射影に対する勾配を求め、それをさらに前の層へと伝播させます。
   if(!SumAndNormilize(FF[1].getGradient(), AttentionOut.getGradient(), W0.getGradient(),
                                                                         iWindow, false))
      return false;
   if(!MHAttentionOut.CalcHiddenGradients(W0.AsObject()))
      return false;
   if(!AttentionInsideGradients())
      return false;
次のステップでは、W0射影の前に形成されたMulti-Head Attentionの出力へと勾配を伝播させます。 言い換えれば、W0射影を逆向きにたどる処理です。この射影に対する勾配はすでに計算されているため、ここでは各Attention headにどのような誤差が伝わるのかを求めます。
AttentionInsideGradientsの呼び出しは、Attentionの内部構造を詳しく解析するうえで重要な処理です。ここでは、Attention機構のすべての内部構成要素に対する勾配を計算し、最終的にはQuery、Key、Valueの各テンソルに対する勾配を求めます。 このステップでは、集約されたAttention Headの空間における誤差信号を、大域的なQueryと局所的なKey/Valueそれぞれに対する勾配へと変換します。
次に、蓄積された勾配を入力元のデータへと逆伝播させます。ここでprevLayerは局所的な入力を表します。 適切なメソッドを呼び出すことで、誤差を各重みに正しく配分するとともに、prevLayer自体の勾配を計算する準備を整えます。
   if(!prevLayer.CalcHiddenGradients(KV_Embedding.AsObject()))
      return false;
   if(!cParams.CalcHiddenGradients(Q_Embedding.AsObject()))
      return false;
これと並行して、大域的なメモリに対しても同様の処理をおこないます。クエリ(Query)に対して得られた勾配を、cParamsに渡します。 これにより、学習の影響は局所的な射影だけでなく、大域相関メモリ自体のパラメータにも及びます。具体的には、θTQにも適切な誤差が配分され、その誤差は後続の重み更新に利用されます。
各寄与を分離した後は、入力データのバックボーンから得られる値を用いて、入力元データの誤差勾配を補完する必要があります。 ただし、その前に、直前の層の活性化関数の導関数を用いて勾配をスケーリングします。 この処理をおこなって初めて、2つの情報経路から得られた結果を合算できます。
   if(!DeActivation(prevLayer.getOutput(), W0.getPrevOutput(), W0.getGradient(),
                                                                    prevLayer.Activation()))
      return false;
   if(!SumAndNormilize(prevLayer.getGradient(), W0.getPrevOutput(), prevLayer.getGradient(),
                                                                          iWindow_K, false))
      return false;
//---
   return true;
  }
これは重要なステップです。この処理により、最終的にprevLayerに渡される勾配には、局所的な入力の影響とW0射影の寄与の両方が反映されます。また、順伝播時に適用された正規化を考慮しながら、それぞれの寄与が適切に配分されます。
これらすべての処理が正常に完了すると、このメソッドは、モジュール内部のすべての構成要素に勾配が正しく配分されたことを示し、重みの更新処理へ進む準備が整ったことを通知します。
ニューロン内部のすべての構造に誤差勾配が適切に配分された後は、それらを実際の学習に適用する段階へと進みます。次の自然なステップは、パラメータの更新です。 updateInputWeightsメソッドが学習サイクルを完了させます。 このメソッドは、計算済みの勾配を用いて、各射影、MLP、そして特に大域相関メモリ自体に対して、順次更新を適用します。
今回採用しているモジュール型の設計により、パラメータ更新用のメソッドを比較的簡潔に記述できます。 内部オブジェクトが持つ同名のメソッドを順番に呼び出し、それぞれの入力元データバッファに対応する適切なポインタを渡すだけです。
bool CNeuronTQMHA::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cParams.UpdateInputWeights())
      return false;
   if(!Q_Embedding.UpdateInputWeights(cParams.AsObject()))
      return false;
   if(!KV_Embedding.UpdateInputWeights(NeuronOCL))
      return false;
   if(!W0.UpdateInputWeights(GetPointer(MHAttentionOut)))
      return false;
   if(!FF[0].UpdateInputWeights(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].UpdateInputWeights(GetPointer(FF[0])))
      return false;
//---
   return true;
  }
updateInputWeightsメソッドは、学習サイクルを慎重かつ適切に締めくくる処理です。 このメソッドにより、大域相関メモリとそのすべての写像、さらに後続の変換処理に対して、正確で一貫性のある更新が適用されます。これは、金融時系列予測タスクにおいて TQNetを安定的かつ信頼性の高い形で利用するうえで、特に重要です。
CNeuronTQMHAクラスと、そのすべてのメソッドの完全なソースコードは、添付ファイルに記載されています。
モデルアーキテクチャ
TQNetフレームワークの構築に必要な構成要素がすべて揃ったので、次の段階として、学習可能なモデルのアーキテクチャについて説明します。 これまでと同様に、目標は、市場環境を自律的に分析し、取引判断を下すことができる取引システムを開発することです。 学習にはActor-Criticパラダイムを採用し、TQNetをEnvironment-State Encoderとして機能させます。 TQNetは、現在の市場状況をコンパクトで情報量の豊富な表現に変換します。Actorはこの表現を利用して行動を選択し、Criticはその行動の良し悪しを評価します。
オリジナル版のTQNetとは異なり、今回はデータの準備と特徴量生成に関してモデルを拡張しました。具体的には、前処理ブロックとコンテキスト情報を集約するブロックを追加し、システムの堅牢性と汎化能力の向上を図っています。 モデルのアーキテクチャを記述する処理は、CreateDescriptionsメソッドに実装されています。 このメソッドは、後続の学習処理と推論処理の基盤となる、層の基本的な構成順序を定義します。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
このメソッドは、シンプルながら重要な処理から始まります。層のコンテナへのポインタがnullの場合、新しいオブジェクトを生成します。 これは単なる形式的な処理ではありません。3つのアーキテクチャブロックそれぞれに、独立した層の記述のコレクションを用意し、順次データを追加できる状態にするためです。 このように明示的にメモリを確保することで、処理の見通しがよくなります。 以降のコードでは、コンテナがすでに存在することを前提にできるため、複数の箇所でその有効性を確認する必要がなくなります。
次に、モデルの中心的な構成要素であるEncoderの構築に進みます。 まずコンテナをクリアし、その後、層の記述を1つずつ追加していきます。各ステップでは、厳密な成功判定を行います。オブジェクトの生成や配列への追加が何らかの理由で失敗した場合、メソッドは確保済みのリソースを適切に解放し、エラーを返します。 このように、メモリと状態を厳密に管理することは、デバッグ時にも本番環境での運用時にも有効です。問題が層構造全体へと波及するのを防ぐことができます。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Encoderの最初の層は、CNeuronBaseOCLによる基本的なニューロン層です。ニューロン数はHistoryBars × BarDescrの積として設定されます。 ここでの考え方は明確です。過去の一定期間のデータを、各バーの特徴量に分解してネットワークに入力します。 この層には活性化関数を設けず、入力データをそのまま受け渡すためのゲートウェイ、つまりバッファとして機能させます。
次のブロックは、CNeuronBatchNormWithNoiseです。この層は前の層の次元数を維持しながら、正規化とノイズによる正則化を適用します。 これは単なる見た目上の工夫ではありません。金融時系列データには、分布の変化や外れ値がつきものです。ノイズを加えるBatchNormは、こうした異常値や変動に対する堅牢性を高め、後続の層に入力するデータを正規化すると同時に、小さなランダム変動への過剰適合を抑制します。
正規化の後は、CNeuronConcatDiffを用いて時間構造を変換します。 この層は、各バーの履歴データを集約しますが、ステップ幅をstep = 1として差分を重視することで、値の水準だけでなく、その変化も明示的に表現します。 この手法により、トレンドの変化、モメンタム、局所的な反転を、モデルがより適切に捉えられるようになることが期待できます。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に登場するのは、CMamba4CastEmbeding層です。この層では、正弦波によるタイムスタンプ埋め込みにマルチウィンドウの仕組みを実装しています。 これにより、モデルは短期的なパターンと長期的なパターンを同時に捉え、市場の状態を豊かに表現できるようになります。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_D1), PeriodSeconds(PERIOD_MN1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ここで注目すべきなのは、それまでの処理が多変量時系列の表現に対しておこなわれていたという点です。 しかし、TQNetフレームワークを正しく動作させるには、単変量時系列の系列が必要です。 そのため、次のステップではテンソルを転置し、後続のAttentionの適用に向けて次元の並びを入れ替えます。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
そして、いよいよ中核となるCNeuronTQMHA層に進みます。 ここでは、期間サイズを 24 × 7 に設定しています。これは、H1時間足における暦週に相当します。 また、ステップサイズは、指定した時間足の1本のバーに含まれる秒数に対応します。 私たちが目指しているのは、TQのカルーセルに週次パターンを保存し、時間足の1時間ごとのステップでそれらを引き出すことです。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTQMHA;
     {
      uint temp[] = {prev_out, 64, 24*7, PeriodSeconds(PERIOD_H1)};
                   // window, window_key, period, timeframe
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.step=NHeads;
   descr.count=prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint count = prev_count;
   uint window = prev_out;
分析対象の金融商品が週末に取引されない場合でも、暦週(7日間)を使用している点に注意してください。 これは必要な措置です。カルーセルの要素をバーの開始時刻に基づいて計算するためです。
次に、活性化関数TANHを使用する畳み込み層が続きます。この層は、得られた表現を圧縮し、指定された予測期間に合わせて射影する役割を果たします。 ここで、豊かな情報を含む表現が、具体的な予測シグナルへと変換されます。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = NForecast;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.count;
次に、もう一度転置をおこない、データを元のデータに近い多変量系列の表現に戻します。
さらに、もう一つの畳み込み層を適用し、特徴量の次元数を元のデータと同じレベルまで削減します。
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
これらの畳み込み処理は局所集約器として機能します。予測対象の各成分にわたって情報を集約し、逆正規化に適した表現を生成します。
Encoderは、CNeuronRevInDenormOCL層で完了します。 このモジュールは予測値を元のスケールに戻し、前処理の段階で取り除かれた分析対象データの平均と分散を復元します。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count*prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
金融分野の応用では、これは不可欠です。予測値は、その意味を解釈でき、取引やリスク計算に適したスケールで表現されていなければなりません。
このアーキテクチャ全体を貫く考え方は一貫しています。まず、入力データを慎重に準備して正規化し、次に、さまざまなスケールで動的特徴量と埋め込み表現を抽出します。その後、TQによって強化されたAttentionを適用し、最後に予測値を集約・射影して、スケールを復元しながら元のデータ空間へと戻します。
ActorモデルとCriticモデルのアーキテクチャは、以前の研究から変更せずに引き継いでいるため、ここでは詳細な説明を省略します。 学習可能なすべてのモデルの完全なアーキテクチャ設計は、添付ファイルに含まれています。
テスト
学習プロセスは、相互に補完する2つの段階で構成されています。これにより、堅固な基盤を確立すると同時に、実際の市場環境で運用するために必要な柔軟性を確保します。
第1段階はオフライン学習です。2024年の1年間を対象に、H1時間足のEURUSDペアの過去データを用いて、徹底的な学習を実施しました。 この年には、落ち着いたレンジ相場、安定したトレンド、突然のボラティリティ上昇、ノイズが増大する局面など、多様な市場レジームが含まれていました。そのため、モデルの学習に非常に適した環境となりました。
第2段階はオンラインでのファインチューニングです。 実際の取引に可能な限り近い環境で学習を実施しました。具体的には、MetaTrader 5ストラテジーテスターにおいて、モデルがローソク足のデータをリアルタイムと同様に逐次処理するようにしました。オンラインモードでは、バッチ学習とはまったく異なる特性が明らかになります。具体的には、ノイズへの耐性、流動性の変化への対応能力、遅延や取引全体を通じたスリッページの影響を適切に考慮する能力です。 ファインチューニングでは実際の約定条件をシミュレーションし、実運用に移行した際にもモデルが予測可能な挙動を示すようにしました。
最後の段階は、おそらく最も厳格な検証であり、完全なアウトオブサンプルデータ、すなわち2025年1月から3月までの市場価格データを用いたテストです。 モデルのすべてのパラメータとハイパーパラメータは固定したままとし、このデータに対する追加調整は一切おこないませんでした。 このような検証により、実用上の有効性を客観的に評価できます。つまり、新しい環境下でもアルゴリズムが予測可能性と堅牢性を維持できるかどうかを確認できます。
テストの結果を以下に示します。
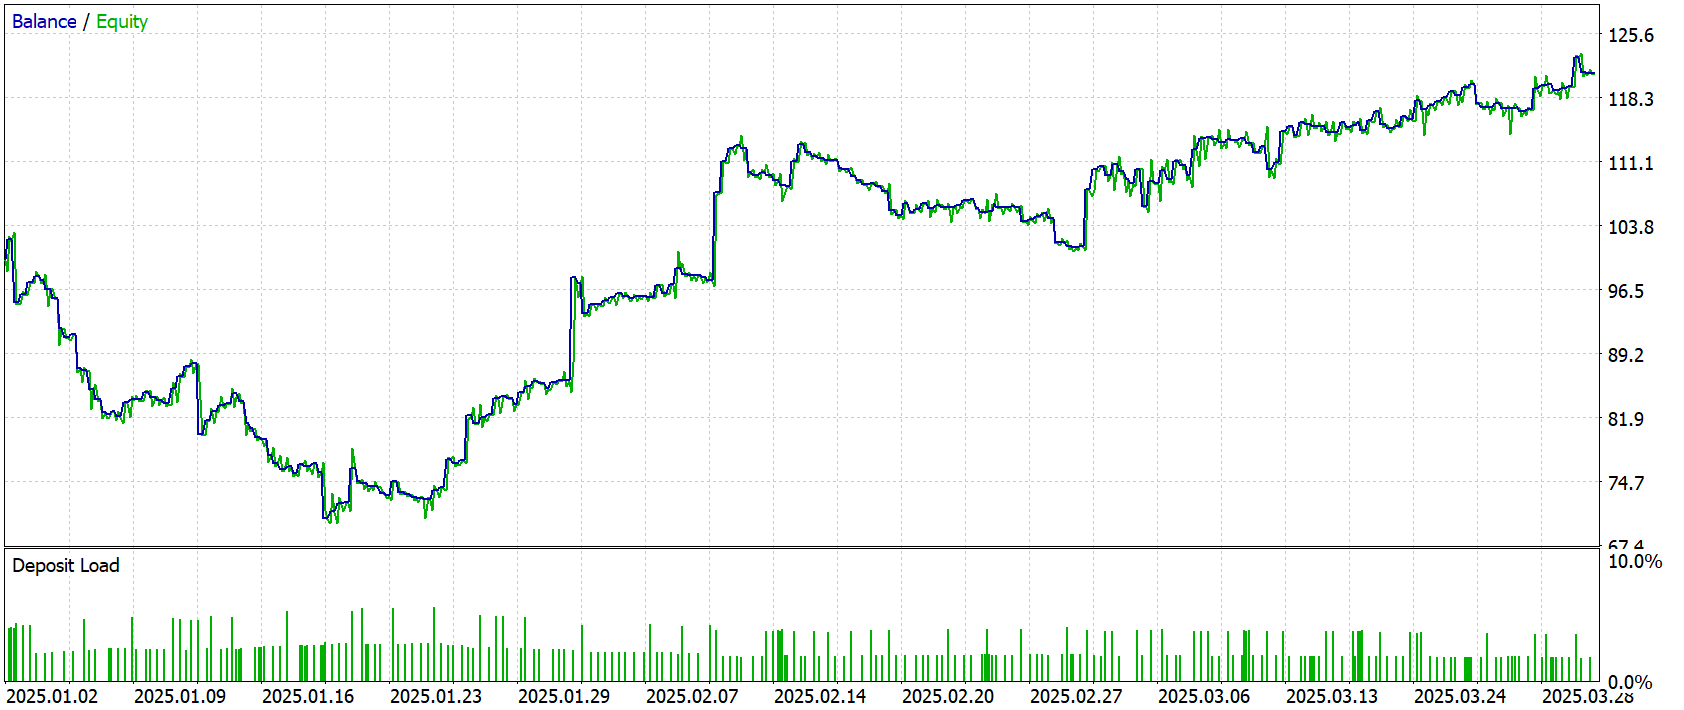
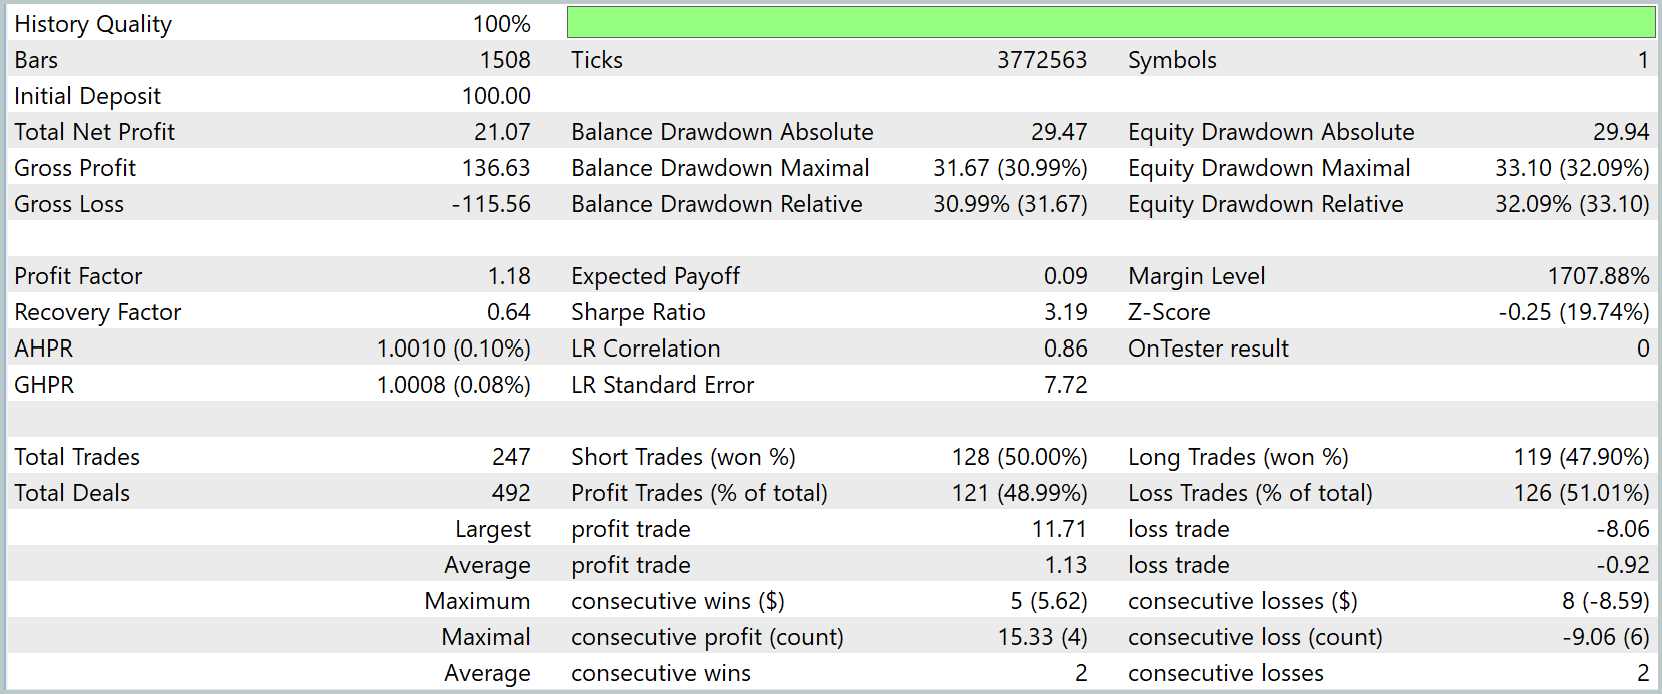
テストの結果、比較的小さいながらも優位性が見られました。 初期入金額100ドルに対し、純利益は21.07ドルでした。 利益が出た取引の割合は49%近くでした。 また、ショートポジションはロングポジションよりも、わずかに高い頻度で利益を上げました。 平均利益額は1取引あたり1.13ドル、平均損失額は0.92ドルでした。 プロフィットファクターは1.18、1取引あたりの期待収益は0.09ドルであり、安全余裕が極めて小さいことを示しています。
エクイティカーブに対する線形回帰では相関係数0.86が得られましたが、誤差は依然として無視できない大きさです。 このことから、結果にノイズが多く含まれていることが確認できます。
リスク特性も、まだ最適とはほど遠い状態です。 大きなドローダウンに加え、1取引あたりの期待収益が低いため、安全に資本を増やしていくことは困難です。 一方、このケースでは証拠金負担は小さく、問題はポジションサイズではなく、エントリーポイントの精度と決済規律にあることを示しています。
結論
本記事では、TQNetフレームワークの理論的基盤と、学習可能な取引モデルのアーキテクチャへの統合に関する具体的な手法を詳しく検討しました。 修正されたCross-Attention機構を含め、各モジュールの設計を支える主要な原則を分析し、金融市場の環境下でアルゴリズムの柔軟性と安定性を高める方法を明らかにしました。
プロジェクトの実践部分では、TQNetが提案する手法をMQL5で実装し、特徴量生成とデータの前処理に独自の改良を加えました。 モデルは2段階で学習させました。すなわち、過去データを用いたオフライン学習と、実際の市場環境に近い条件下での学習(MetaTrader 5ストラテジーテスターを用いたオンライン微調整)です。
未使用の新しい価格データを用いた最終テストでは、プラスの推移が確認されました。 初期のドローダウンの後、モデルの残高は着実に増加しており、市場環境の変化に適応するアルゴリズムの能力が示されました。
これらの結果から、TQNetは、改良されたアーキテクチャ設計と2段階の学習プロセスを組み合わせることで、正の期待値を実現できる可能性があることが示されています。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19181
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 夢最適化アルゴリズム(DOA)
 取引におけるニューラルネットワーク:スケーリングの代わりに分解する(最終回)
 線形自己回帰モデルの残差を用いた非線形U-Transformerの学習
 取引におけるニューラルネットワーク:Temporal Queryモデル(TQNet)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索