

取引におけるニューラルネットワーク:スケーリングの代わりに分解する(最終回)
 15
 0

はじめに
今日の金融市場は、単に買い手と売り手が出会う場ではありません。そこは、何百もの要因が刻々と相互作用し、その結果として一つひとつの価格変動が生まれる、複雑でダイナミックなエコシステムです。 一見すると混沌としている市場の動きも、その背後にはパターンが隠れています。ただし、それらは複雑に絡み合い、多層的な形で現れます。 こうした隠れたパターンを見極め、その後の展開を予測する能力こそが、トレーダーやアルゴリズム取引システムの成否を左右します。 これまでの記事では、SSCNN(Spatial-Sequential Convolutional Neural Network:空間・逐次畳み込みニューラルネットワーク)フレームワークを紹介してきました。 一見すると複雑そうな名称ですが、その根底にあるのは、空間的な依存関係と時間的な依存関係を一つの計算アルゴリズムに統合する、明快で洗練された考え方です。
SSCNNは、時系列データを、多次元のプロセスが時間軸に沿って展開されたものとして捉えます。 ある時点のデータは、過去や未来とのつながりだけでなく、並行して存在する構造、すなわち内部の特徴量空間とも関係しています。こうした特徴量空間は、時系列と同期して変化することもあれば、時間差を伴って変化することもあります。
これらの関係を捉えるために、モデルは、局所的なパターンを抽出する複数のブロックを段階的に組み合わせるとともに、文脈を保持・蓄積する逐次処理モジュールを備えています。 ここで重要な役割を果たすのが、「Attentionに基づく正規化(Attention-based Normalization)」モジュールです。これはAttention機構と正規化を組み合わせたもので、学習プロセスを安定させながら、モデルが特に重要なデータ区間に注目できるようにします。 このアーキテクチャにより、SSCNNはさまざまな粒度で信号を分析できるだけでなく、変化するデータ構造にも適応できます。ボラティリティが不安定で、市場のレジームが移り変わる金融商品を扱ううえで、これはとりわけ重要な特性です。
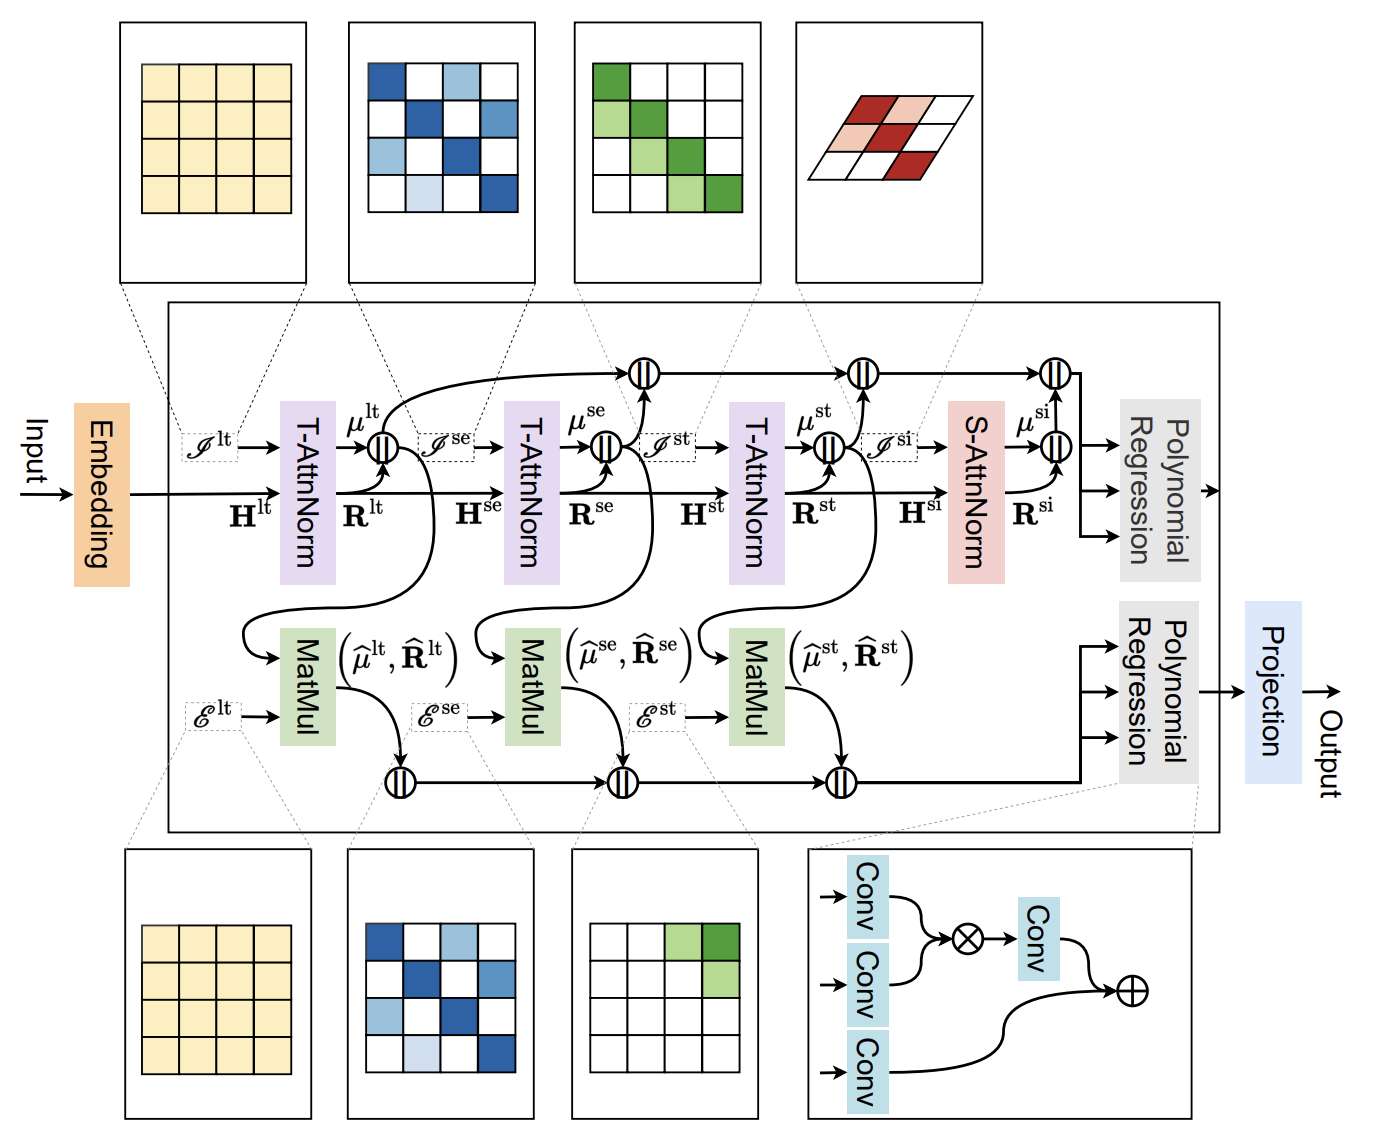
もう一つの大きな利点は、モジュール性です。 SSCNNのアーキテクチャは拡張しやすく、短期的な価格モメンタムの予測から長期的なサイクルの検出まで、目的に応じて柔軟に調整できます。 モデルの各層がそれぞれ独自の特徴量を抽出し、次の層へと引き渡す「階層的なデータ認識」という考え方が、柔軟性と頑健性を支えています。
これまでの記事では、こうした考え方をコードに落とし込み、MQL5環境に統合する方法を詳しく解説し、本格的な取引システムを構築するための基盤を整えてきました。
そして今回、理論を実践に移す最終段階に入ります。 個々の構成要素を一つの統合されたフレームワークにまとめ、SSCNNが市場データをどのように処理し、解釈するのかを検証します。 実際の取引環境に近い条件のもとで、これまでに実装した手法の有効性を評価していきます。 この検証は、予測精度やモデルの安定性を測るだけのものではありません。アルゴリズムが市場の動きをどこまで捉え、隠れた構造を見いだし、状況の変化を認識できるのかを理解するうえでも重要です。 結局のところ、どれほど高度なアーキテクチャを採用していても、それだけで取引システムの成功が保証されるわけではありません。最終的に成否を分けるのは、ノイズや予想外の急変動、そしてチャート上の思いがけない反転に、どれだけ適切に対処できるかという点です。
Encoder
これまでの記事では、SSCNNアーキテクチャを構成する個々のブロックを実装してきました。今回は、それらを単一のEncoderへと統合していきます。Encoderは、長期トレンド、季節性のパターン、短期的な変動、空間的な関係といった複数の情報ストリームを処理する中核的な部分です。それぞれの情報を丁寧に分解・整理し、指定された予測期間に合わせて投影したうえで、最終的に一つの統合された予測表現へとまとめ上げます。
この仕組みをコードとして実装するのが、CNeuronSSCNNEncoderクラスです。 その役割は、単に複数のモジュールを順番に呼び出すことではありません。各モジュールの動作を連携させ、それぞれのロジックに従って情報を抽出し、必要な予測期間まで外挿して、対応する統計量を予測します。そして、得られた結果を統合し、最終的な多項式回帰に用いる、情報量豊かで構造化された表現を構築します。Encoderは各データストリームを管理するほか、位相に基づく処理を適切におこなうため、必要に応じてデータの転置も実施します。さらに、各サブシステムの出力が、所定の形式に従って正しい連結位置に配置されるよう制御します。 クラスの構造を以下に示します。
class CNeuronSSCNNEncoder   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronPeriodNorm       cLongNorm;
   CNeuronConvOCL          cLongExtrapolate;
   CNeuronTransposeOCL     cLongMeanSTDevTransp;
   CNeuronBaseOCL          cLongMeanExtrapolate;
   CNeuronTransposeVRCOCL  cSeasonTransp;
   CNeuronAttentNorm       cSeasonNorm;
   CNeuronTransposeVRCOCL  cUnSeasonTransp;
   CNeuronConvOCL          cSeasonExtrapolate;
   CNeuronConvOCL          cSeasonMeanExtrapolate;
   CNeuronAttentNorm       cShortNorm;
   CNeuronConvOCL          cShortExtrapolate;
   CNeuronConvOCL          cShortMeanExtrapolate;
   CNeuronSAttentNorm      cSpatialNorm;
   CNeuronConvOCL          cSpatialExtrapolate;
   CNeuronConvOCL          cSpatialMeanExtrapolate;
   CNeuronBaseOCL          cConcatenated;
   CNeuronTransposeOCL     cTranspose;
   CNeuronPolynomialRegression   cFusion;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNNEncoder(void) {};
                    ~CNeuronSSCNNEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNNEncoder; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { }
  };
Encoder内部の処理フローは、綿密に設計されています。 内部オブジェクトはすべて静的に宣言されているため、クラスのコンストラクタとデストラクタは空のままとなっています。計算グラフの構築は、Initメソッドに集約されています。
bool CNeuronSSCNNEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                               uint units_count, uint variables, uint forecast,
                               uint season_period, uint short_period,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count + forecast,
                                variables, optimization_type, batch))
      return false;
   activation = None;
このメソッドでは、まず親クラスであるCNeuronTransposeOCLを初期化し、構築するアーキテクチャの基本パラメータを渡します。 この呼び出しによって、グローバルバッファの確保、テンソルのサイズ設定、OpenCLコンテキストとの連携といった、全体の処理基盤が整えられます。
ここで注目したいのは、出力テンソルの次元数が、分析対象の系列長と予測期間の合計として指定されている点です。 これにより、モジュールの出力として、ノイズなどを取り除いた元のデータと、必要な予測値とを、同じ形式で比較できる表現として得ることを意図しているのがわかります。
基本的な初期化が完了したら、続いて現在の層の活性化関数を明示的に無効化します(activation = None)。これは、Encoderが数値表現や統計量を扱うためです。
次に、内部オブジェクトの初期化に進みます。 最初に処理するのは、長期的な情報を担う分岐であるcLongNormです。 ここでは、期間ベースの正規化モジュールを生成し、時系列の安定した成分、すなわちトレンドを抽出・整備します。
   int index = 0;
   if(!cLongNorm.Init(0, index, OpenCL, 1, units_count, iWindow, optimization, iBatch))
      return false;
続いて、トレンド外挿ブロックであるcLongExtrapolateを初期化します。このブロックは、長期成分を予測期間まで外挿する役割を担います。
   index++;
   if(!cLongExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
ここで注目したいのは、著者の実装では、データの外挿に学習可能なパラメータ行列Eを使用している点です。
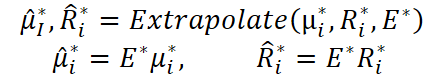
一方、今回の実装では、この処理に活性化関数を持たない畳み込み層を採用しました。 活性化関数のない畳み込み層も線形演算子ですが、実装面でいくつかの利点があります。 畳み込みではパラメータを共有する(重みを共有)ため、ハードウェアによる最適化の恩恵を受けやすく、時系列データによく見られる局所的、あるいは準局所的な変換を自然に表現できます。
長期成分の残差を外挿できたので、次は平均値そのものを外挿します。 ここで、実装上のポイントがあります。CNeuronPeriodNormが返すテンソルでは、各値が平均値と分散のペアとして格納されています。 通常であれば、これらを明示的に分離し、データをコピーする必要があります。しかし、今回はテンソルを転置するだけという、シンプルな方法を採用しました。
転置によってデータの配置を組み替えると、平均値と分散がそれぞれ別の系列として順番に並びます。しかも、平均値の系列が先に配置されます。 そのため、転置後のテンソルをそのまま平均値の外挿モジュールに渡すことができます。 つまり、メモリ上の要素の格納順序を利用することで、余計な処理を最小限に抑えながら、論理的に分離されたデータストリームを取り出しているのです。
   index++;
   if(!cLongMeanSTDevTransp.Init(0, index, OpenCL, iWindow, 2, optimization, iBatch))
      return false;
   if(!cLongMeanSTDevTransp.getGradient().Fill(0))
      return false;
   index++;
   if(!cLongMeanExtrapolate.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
   if(!cLongMeanExtrapolate.getPrevOutput().Fill(1))
      return false;
ただし、あらかじめ対処しておくべき、もう2つの重要なポイントがあります。 1つ目は、分散の勾配に不要な値が混入するのを防ぐことです。 今回の外挿モジュールは平均値のみを扱うため、分散の勾配バッファに予期しない値が残らないようにする必要があります。そうした値が残っていると、その後の誤差逆伝播に悪影響を及ぼすおそれがあります。 この問題には、初期化時に転置オブジェクトの勾配バッファをゼロクリアすることで、シンプルかつ確実に対処しています。 これにより、メモリに残存する不要な値を明示的に取り除き、分散σ²の処理に不正な値が影響するのを防ぎます。
2つ目は、平均値そのものの外挿方法です。 原著の実装では、得られた値をテンソルにそのまま格納しています。 一方、今回の実装では、より効率的な方法として、最も基本的な形の外積を用います。 具体的には、サイズがN×1の平均値の列ベクトルµと、サイズが1×Mのすべての要素が1である行ベクトルを掛け合わせます。 その結果、サイズがN×Mの行列が得られ、各行には対応する平均値µiが繰り返し格納されます。 この方法なら、明示的なループを使わずに、必要なサイズのテンソルへ値を複製することができます。 実装上の利点も明確です。線形演算であるためGPU上で容易に並列化でき、メモリ効率にも優れており、OpenCLのコードにも自然に落とし込めます。
このように、最小限のコードと小さな処理オーバーヘッドで、平均値を外挿するためのシンプルかつ効率的な仕組みを実現できます。 時間方向への線形射影という、原著の設計思想を維持しながら、処理をより効率化し、OpenCLによる並列計算に適した実装にしています。
次に、季節性を扱う分岐に進みます。 まず、cSeasonTranspオブジェクトで、周期に基づくデータの転置を設定します。season_periodパラメータを使って、1周期内の位相ごとにデータをグループ化します。 これにより、後続の処理で対応する位相を選択しやすくなり、係数を備えた汎用的な正規化モジュールであるCNeuronAttentNormを利用できるようになります。
   index++;
   if(!cSeasonTransp.Init(0, index, OpenCL, iWindow, units_count / season_period, season_period,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cSeasonNorm.Init(0, index, OpenCL, season_period, cSeasonTransp.GetCount(), iWindow,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cUnSeasonTransp.Init(0, index, OpenCL, iWindow, season_period, cSeasonTransp.GetCount(),
                                                                          optimization, iBatch))
      return false;
cSeasonNormオブジェクトは、季節成分を抽出するとともに、残差を正規化します。その後、cUnSeasonTranspオブジェクトによってデータを元の向きに戻し、外挿処理に備えます。 季節成分の外挿は、cSeasonExtrapolateオブジェクトとcSeasonMeanExtrapolateオブジェクトがそれぞれ直接実行します。
   index++;
   if(!cSeasonExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSeasonMeanExtrapolate.Init(0, index, OpenCL, season_period, season_period, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonMeanExtrapolate.SetActivationFunction(None);
短期分岐も、基本的には同様のモジュール構成ですが、データの転置はおこないません。 cShortNormオブジェクトは、short_periodで指定された期間内の局所的かつ短期的な変動成分を抽出します。続いて、cShortExtrapolateがその予測を生成し、cShortMeanExtrapolateが短期層の統計量を予測します。 ここで注目したいのは、平均値の外挿オブジェクトの初期化パラメータに、cShortNorm.GetUnits()を使用している点です。これは、データ形式を一致させるためです。こうすることで、後続の各ブロックが正規化モジュールの出力を入力として正しく受け取れるようになります。
   index++;
   if(!cShortNorm.Init(0, index, OpenCL, units_count / short_period, short_period, iWindow, optimization, iBatch))
      return false;
   index++;
   if(!cShortExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cShortExtrapolate.SetActivationFunction(None);
   index++;
   if(!cShortMeanExtrapolate.Init(0, index, OpenCL, cShortNorm.GetUnits(), cShortNorm.GetUnits(), iCount, iWindow,
                                                                                          1, optimization, iBatch))
      return false;
   cShortMeanExtrapolate.SetActivationFunction(None);
   index++;
次に、空間分岐を初期化します。cSpatialNormはS-AttnNormモジュールであり、各特徴量の単変量系列の間に存在する、空間的に整合したパターンを検出します。
   if(!cSpatialNorm.Init(0, index, OpenCL, units_count, variables, optimization, iBatch))
      return false;
   index++;
   if(!cSpatialExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                             optimization, iBatch))
      return false;
   cSpatialExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSpatialMeanExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, 1, iWindow,
                                                                             optimization, iBatch))
      return false;
   cSpatialMeanExtrapolate.SetActivationFunction(None);
   index++;
続いて、cSpatialExtrapolateとcSpatialMeanExtrapolateを初期化します。これらは、指定された予測期間に向けて、空間成分とその統計量をそれぞれ予測します。
こうして得られた各成分の予測値と統計量を、cConcatenatedという単一のテンソルに統合します。 ここでは、テンソルの次元数を明示的に8倍にしています。これは、各分岐の出力が「成分と統計量のペア」を構成するためです。具体的には、Rlt、μlt、Rse、μse、Rst、μst、Rsi、μsiの8つの情報ストリームが、各単位に対して生成されます。
   if(!cConcatenated.Init(0, index, OpenCL, 8 * Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cTranspose.Init(0, index, OpenCL, 8 * iWindow, iCount, optimization, iBatch))
      return false;
こうして得られた幅の広いテンソルを、次にcTransposeモジュールで転置し、最終的な統合層が期待する形式に整えます。
初期化の最後におこなうのが、cFusionの初期化です。これは、多項式回帰器として機能する統合(fusion)モジュールです。入力として8*iWindowの特徴量セットを受け取り、各時点について、情報を保ちながら圧縮した長さiWindowの表現を出力します。 複数の成分間における乗法的な効果と加法的な効果を組み合わせる仕組みは、まさにこの部分に実装されています。
   index++;
   if(!cFusion.Init(0, index, OpenCL, iCount, 8 * iWindow, iWindow, optimization, iBatch))
      return false;
//---
   return true;
  }
各段階でオブジェクトの初期化状況を確認し、エラーが発生した場合、このメソッドはfalseを返します。 このような防御的プログラミングにより、問題が発生した時点でEncoderの構築を直ちに中止できます。 すべてのモジュールの生成と設定が正常に完了すると、メソッドはtrueを返し、Encoderが動作可能な状態になったことを示します。
オブジェクト構造の初期化が完了したら、次はfeedForwardメソッドでEncoderの順伝播処理を構成します。 このメソッドでは、各モジュールを適切な順序で呼び出し、処理を次のモジュールへと引き継いでいきます。処理は段階的に進み、長期成分、季節成分、短期成分、空間成分という4つの成分を順に扱います。その後、各成分を単一の特徴量ベクトルに統合し、多項式融合を担う最終段階へと渡します。 この処理の流れは、コードにも明確に表れています。各ステップで対応するブロックのFeedForwardメソッドを呼び出し、実行が成功したことを確認してから次の処理へ進みます。途中で問題が発生した場合は、関数がfalseを返し、その時点で処理全体が停止します。
bool CNeuronSSCNNEncoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.FeedForward(NeuronOCL))
      return false;
   if(!cLongExtrapolate.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cLongMeanSTDevTransp.FeedForward(cLongNorm.GetMeanSTDevs()))
      return false;
   if(!MatMul(cLongMeanSTDevTransp.getOutput(), cLongMeanExtrapolate.getPrevOutput(),
              cLongMeanExtrapolate.getOutput(), 1, 1, iCount, iWindow, true))
      return false;
まず、長期分岐から処理を開始します。 cLongNorm.FeedForwardを呼び出すことで、分析対象データの長期成分が正規化されます。これは、トレンドを局所的な変動から切り分けるための前処理です。 続いて、cLongExtrapolate.FeedForwardが正規化後のデータを受け取り、長期成分の残差を必要な予測期間まで外挿します。 ここで重要なのは、このモジュールがcLongNormからすでに構造化されたデータを受け取るということです。
次に、統計量である平均値と標準偏差を外挿します。 まず、統計量を格納したテンソルcLongMeanSTDevTranspを転置し、平均値と分散の系列をそれぞれまとめます。この転置の手法については、先ほど説明したとおりです。 その後、行列乗算を実行します。 ここでは、行ベクトルを利用して、転置された統計量を必要な形式へと展開しています。 この実装により、余計なデータをコピーすることなく、平均値を予測期間全体にわたって複製するという目的を達成できます。
続いて、季節分岐の処理に移ります。 まず、cSeasonTranspによって分析対象のデータを周期内の位相ごとに並べ替え、位相に基づく正規化をおこなうための形式に整えます。
//--- Season
   if(!cSeasonTransp.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cSeasonNorm.FeedForward(cSeasonTransp.AsObject()))
      return false;
   if(!cUnSeasonTransp.FeedForward(cSeasonNorm.AsObject()))
      return false;
   if(!cSeasonExtrapolate.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.FeedForward(cSeasonNorm.GetMeans()))
      return false;
続いて、cSeasonNormが周期に基づくAttentionに基づく正規化を実行し、重要な位相位置を特定します。 逆転置をおこなうcUnSeasonTranspによってデータを元の形式に戻し、外挿処理に適した状態に整えます。 その後、cSeasonExtrapolateが元の形式に戻された季節成分の残差を受け取り、その予測を生成します。一方、cSeasonMeanExtrapolateは、正規化モジュールによって得られた季節成分の平均値を外挿します。
短期分岐も、同様の手順で処理されます。
- cShortNormは、あらかじめ季節性を除去したデータを受け取り、局所的かつ急速な変動成分を抽出します。
- cShortExtrapolateは、これらの短期成分の残差を予測します。
- cShortMeanExtrapolateは、それらの統計量を予測します。
//--- Short
   if(!cShortNorm.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.FeedForward(cShortNorm.GetMeans()))
      return false;
季節分岐から短期分岐へデータを渡すのは、意図的な設計上の選択です。まず大きな周期的変動を取り除き、そのうえで局所的な急変動を捉えるという考え方に基づいています。
続いて、空間分岐の処理に移ります。 cSpatialNormモジュールは、ある時点における複数の時系列を分析し、それらの間に存在する空間的に整合した構造を特定します。 次に、cSpatialExtrapolateとcSpatialMeanExtrapolateが、それぞれ空間成分の残差とその統計量を予測します。
//--- Spatial
   if(!cSpatialNorm.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.FeedForward(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.FeedForward(cSpatialNorm.GetMeans()))
      return false;
この処理順序により、空間正規化では、トレンドと季節性の影響をすでに調整したうえで、局所的な影響を捉えることができます。
すべての分岐で予測が生成されたら、次に各特徴量を慎重に組み合わせます。 最初の Concatメソッドの呼び出しでは、長期分岐と季節分岐で予測された残差と平均値を結合し、幅の広いバッファに格納します。
//--- Concat
   if(!Concat(cLongExtrapolate.getOutput(), cLongMeanExtrapolate.getOutput(),
              cSeasonExtrapolate.getOutput(), cSeasonMeanExtrapolate.getOutput(),
              cConcatenated.getOutput(), iCount, iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getOutput(), cShortExtrapolate.getOutput(),
              cShortMeanExtrapolate.getOutput(), cConcatenated.getPrevOutput(),
              4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getOutput(),
              cSpatialMeanExtrapolate.getOutput(), cConcatenated.getOutput(),
              6 * iCount, iCount, iCount, iWindow))
      return false;
続いて、2回目のConcatメソッドの呼び出しで短期データを追加し、結合済みのテンソルを拡張します。 3回目の呼び出しでは、空間成分を結果に追加します。
最後に、融合処理をおこないます。 まず、cTransposeによって、分析対象データを格納した幅の広いテンソルを、多項式回帰器に適した形式に変換します。これは、特徴量の次元と時間ステップの次元を入れ替える処理であり、後続の集約処理に適したデータ構造を整えるものです。 次に、cFusionモジュールが多項式融合処理を実行します。ここでは、加算経路と乗算経路を組み合わせることで、コンパクトでありながら、予測に関する情報を十分に保持した表現を生成します。
//--- Fusion
   if(!cTranspose.FeedForward(cConcatenated.AsObject()))
      return false;
   if(!cFusion.FeedForward(cTranspose.AsObject()))
      return false;
//---
   return CNeuronTransposeOCL::feedForward(cFusion.AsObject());
  }
順伝播アルゴリズムの最後では、親クラスCNeuronTransposeOCLの同名メソッドを呼び出します。この処理により、出力テンソルは、モデル内の後続のニューラルネットワーク層で分析できるよう、特徴量を1つずつ持つ系列の集合に変換されます。
コードでは、各処理の実行結果をその都度、厳密にチェックしています。 これは単なる形式的な確認ではなく、意図的に設けられた安全対策です。例外の発生、バッファの確保エラー、無効な形式などが検出されると、直ちに処理を停止します。これにより、デバッグが容易になるだけでなく、本番環境でもモデルが安全に動作するようにしています。
アーキテクチャの観点から見ると、各メソッドの呼び出し順序には、ボトムアップのアプローチが反映されています。まず、粗く安定した成分を抽出して外挿し、次に、より解像度の高い成分を順に処理します。その後、空間的な関係を分析し、最後に融合モジュールですべての情報を慎重に統合します。 この設計により、エラーの発生箇所を追跡しやすくなり、各ブロックの役割も明確になります。また、トレンドから局所的な急変動に至るまで、各段階で品質を検証できます。
順伝播メソッドを、登場人物を一人ずつ舞台に上げていく脚本にたとえるなら、 calcInputGradientsは、上演が終わったあとに舞台装置を慎重に片付け、演出家の指示を書き集め、誤差信号を各モジュールに返す場面に相当します。こうして各モジュールは、誤差信号に基づいて自身の動作を調整できるようになります。
bool CNeuronSSCNNEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
メソッドの本体では、まず、入力元のデータオブジェクトNeuronOCLへのポインタが有効かどうかを確認します。 これは単純ですが、不可欠な安全対策です。有効なポインタがなければ、勾配をどこに戻せばよいのか分からないため、エラーを検出した時点で安全に処理を終了します。
次に融合フェーズに進みます。 順伝播の最後に実行した処理は、多項式融合と転置でした。そのため、逆伝播では順伝播と逆の順序で、まずこれらのモジュールを通じて勾配を逆向きに伝播させます。
//--- Fusion
   if(!CNeuronTransposeOCL::calcInputGradients(cFusion.AsObject()))
      return false;
   if(!cTranspose.CalcHiddenGradients(cFusion.AsObject()))
      return false;
   if(!cConcatenated.CalcHiddenGradients(cTranspose.AsObject()))
      return false;
親クラスCNeuronTransposeOCLの同名メソッドを呼び出し、外部コンテキストから渡された誤差を多項式回帰モジュールに伝えます。 次に、転置オブジェクトcTransposeへと勾配を逆伝播させます。 最後に、得られた値を、すべての成分の結果を結合して保持している幅広のテンソルオブジェクトcConcatenatedに渡します。
続いて、各成分がどの程度寄与したかを順番に切り分ける必要があります。そのため、DeConcat(逆結合)処理を段階的に実行し、全体の勾配を各成分に対応する部分勾配へと分割します。
//--- DeConcat
   if(!DeConcat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getGradient(),
                cSpatialMeanExtrapolate.getGradient(), cConcatenated.getGradient(),
                6 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cConcatenated.getGradient(), cShortExtrapolate.getGradient(),
                cShortMeanExtrapolate.getGradient(), cConcatenated.getPrevOutput(),
                4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cLongExtrapolate.getGradient(), cLongMeanExtrapolate.getGradient(),
                cSeasonExtrapolate.getGradient(), cSeasonMeanExtrapolate.getGradient(),
                cConcatenated.getGradient(), iCount, iCount, iCount, iCount, iWindow))
      return false;
まず、cConcatenatedから空間分岐(cSpatialExtrapolateと cSpatialMeanExtrapolate)の勾配を取り出します。 続く2回のDeConcatメソッドの呼び出しで、短期・季節・長期の各成分に対応する勾配を順に切り分けます。 つまり、1つの幅広いバッファに格納された勾配を各モジュールに振り分け、順伝播時にそれぞれのモジュールが生成した部分に対応する勾配だけを渡します。
ここから、各分岐に沿って勾配を順次誤差逆伝播させます。処理の順序は、各分岐を構築したときの論理的な順序とは逆になります。 空間分岐では、まず統計量に関する勾配を渡します。これにより、空間成分の平均値を予測するブロックから、その平均値を扱う正規化モジュールへと誤差が伝播します。
//--- Spatial
   if(!cSpatialNorm.GetMeans().CalcHiddenGradients(cSpatialMeanExtrapolate.AsObject()))
      return false;
   if(!cSpatialNorm.CalcHiddenGradients(cSpatialExtrapolate.AsObject()))
      return false;
次に、cSpatialNorm.CalcHiddenGradientsメソッドが、主となるSpatial分岐からの勾配を計算し、下位の層へ伝播できるように準備します。
短期分岐では、慎重に処理を進める必要があります。まず、cShortNorm.CalcHiddenGradientsによって、空間正規化からの勾配を短期成分の正規化モジュールに渡します。
//--- Short
   if(!cShortNorm.CalcHiddenGradients(cSpatialNorm.AsObject()))
      return false;
   CBufferFloat* temp = cShortNorm.getGradient();
   if(!cShortNorm.SetGradient(cShortNorm.getPrevOutput(), false) ||
      !cShortNorm.CalcHiddenGradients(cShortExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cShortNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cShortNorm.SetGradient(temp, false))
      return false;
   if(!cShortNorm.GetMeans().CalcHiddenGradients(cShortMeanExtrapolate.AsObject()))
      return false;
次に、データ外挿オブジェクトから誤差勾配を取得します。 それまでに得られた値を失わないよう、まず、現在の誤差勾配バッファへのポインタをローカル変数tempに保存します。 続いて、巧妙な手法を用います。正規化モジュールが現在参照している勾配バッファへのポインタを、一時的に、同じサイズの空きオブジェクトへのポインタに置き換えます。 その状態で、外挿モジュールに関する勾配を計算します。 計算後、2つの情報経路から得られた値を加算し、データバッファへのポインタを元の状態に戻します。 短期成分の誤差勾配を振り分ける処理の最後では、短期分岐の平均値予測ブロックからの誤差を、その平均値を生成した経路へと戻します。
季節分岐も同様の手順で処理しますが、こちらでは転置処理も追加でおこないます。
//--- Season
   if(!cUnSeasonTransp.CalcHiddenGradients(cShortNorm.AsObject()))
      return false;
   temp = cUnSeasonTransp.getGradient();
   if(!cUnSeasonTransp.SetGradient(cUnSeasonTransp.getPrevOutput(), false) ||
      !cUnSeasonTransp.CalcHiddenGradients(cSeasonExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cUnSeasonTransp.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cUnSeasonTransp.SetGradient(temp, false))
      return false;
   if(!cSeasonNorm.GetMeans().CalcHiddenGradients(cSeasonMeanExtrapolate.AsObject()))
      return false;
   if(!cSeasonNorm.CalcHiddenGradients(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonTransp.CalcHiddenGradients(cSeasonNorm.AsObject()))
      return false;
まず、cUnSeasonTransp.CalcHiddenGradientsによって、短期正規化モジュールからの勾配を逆転置ブロックへ伝播させます。 ここでも、一時バッファを使う手法を用います。勾配をtempに保存し、勾配の出力先を空きバッファに切り替え、CalcHiddenGradientsを実行します。その結果を累積し、cUnSeasonTranspに書き戻します。 これにより、各経路からの寄与を正しく加算し、スケールの整合性を保つことができます。
次に、誤差をSeasonal-Normalizerへ伝播させ、転置を元に戻します。つまり、長期正規化モジュールからデータを受け取ったときの形式に戻します。
長期分岐には、統計量に対する行列乗算の逆伝播という、特に慎重な処理が含まれています。 MatMulGradメソッドでは、順伝播時のベクトル乗算に対応する逆伝播処理をおこないます。具体的には、cLongMeanExtrapolateからの勾配を基に、転置済みバッファcLongMeanSTDevTranspに対する誤差の寄与を計算します。 ここでは、平均値を外挿する際に用いた複製構造を考慮しながら、平均値に関する勾配を振り分けます。 その後、得られた勾配を正規化モジュールへ渡します。
//--- Long
   if(!MatMulGrad(cLongMeanSTDevTransp.getOutput(), cLongMeanSTDevTransp.getGradient(),
                  cLongMeanExtrapolate.getPrevOutput(), cLongMeanExtrapolate.getGradient(),
                  cLongMeanExtrapolate.getGradient(), 1, 1, iCount, iWindow, true))
      return false;
   if(!cLongNorm.GetMeanSTDevs().CalcHiddenGradients(cLongMeanSTDevTransp.AsObject()))
      return false;
   if(!cLongNorm.CalcHiddenGradients(cSeasonTransp.AsObject()))
      return false;
   temp = cLongNorm.getGradient();
   if(!cLongNorm.SetGradient(cLongNorm.getPrevOutput(), false) ||
      !cLongNorm.CalcHiddenGradients(cLongExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cLongNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cLongNorm.SetGradient(temp, false))
      return false;
続いて、cLongNorm.CalcHiddenGradientsによって、季節分岐の転置処理から累積された勾配を長期正規化モジュールへ戻し、再び一時バッファを用いた手法を適用します。 これにより、長期成分の残差の外挿から生じる寄与と、依存関係にある他のモジュールからの寄与を、中間結果を失うことなく累積できます。
最後に、誤差逆伝播の一連の流れを通じて得られた勾配を、前の層(NeuronOCL)へ渡します。 ここが誤差信号の自然な出口となります。内部で必要な再計算をすべて終えた後、Encoderは計算グラフ内の前段のノードに、適切な形式に整えられた勾配を渡します。
//---
   if(!NeuronOCL.CalcHiddenGradients(cLongNorm.AsObject()))
      return false;
//---
   return true;
  }
メソッド内のすべての呼び出しでは、実行結果をチェックしています。 これは単なる信頼性の確保にとどまりません。問題を早期に検出し、後から追跡するのが難しいバッファ内の微妙な不整合を防ぐための、fail-fast(異常を検出したら直ちに処理を停止する)方針です。 このメソッドでは、繰り返し使用される重要な手法がいくつかあります。
- 部分的な勾配を累積するために、一時データバッファを使用する。
- データを失わないよう、アクティブな勾配バッファを切り替える。
- ウィンドウ方向の各寄与を正しく集約するために、SumAndNormilizeを呼び出す。
要するに、このメソッドは順伝播とは逆の順序で処理を進め、結合済みのバッファを分解し、各分岐に勾配を振り分けます。さらに、一時バッファと正規化処理を用いて複数の経路からの寄与を累積し、最後に誤差を下位の層へ返します。 この手順により、各モジュールには、そのモジュールの出力に対応する勾配が正しく渡され、学習時のパラメータ更新も一貫性を保ちながら安定して収束するようになります。
Encoderのすべての分岐で勾配を収集し、慎重に振り分けたら、最後の段階である学習可能なパラメータの更新に移ります。 コードでは、内部コンポーネントの同名メソッドを順番に呼び出すことで、この処理をおこないます。各モジュールは、自身に蓄積された勾配を使って、自らの重みを更新します。
bool CNeuronSSCNNEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cLongExtrapolate.UpdateInputWeights(cLongNorm.AsObject()))
      return false;
//--- Season
   if(!cSeasonNorm.UpdateInputWeights(cSeasonTransp.AsObject()))
      return false;
   if(!cSeasonExtrapolate.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.UpdateInputWeights(cSeasonNorm.GetMeans()))
      return false;
//--- Short
   if(!cShortNorm.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.UpdateInputWeights(cShortNorm.GetMeans()))
      return false;
//--- Spatial
   if(!cSpatialNorm.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.UpdateInputWeights(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.UpdateInputWeights(cSpatialNorm.GetMeans()))
      return false;
//--- Fusion
   if(!cFusion.UpdateInputWeights(cTranspose.AsObject()))
      return false;
//---
   return true;
  }
最終的に、updateInputWeightsメソッドは、簡潔ながら強力なディスパッチャとして機能します。コンポーネントのリストを順番に処理し、それぞれの重みの更新を各コンポーネント自身に委ねるとともに、実行結果のステータスを適切に収集します。 この設計により、モジュール性が維持され、テストが容易になり、アーキテクチャの拡張も簡単になります。新たに学習可能なコンポーネントを追加する場合も、この呼び出しの連鎖の適切な位置に、そのコンポーネントの更新処理を追加するだけで済みます。
これで、Encoder の構築ロジックについての詳しい説明は終わりです。 CNeuronSSCNNEncoderクラスとそのすべてのメソッドの完全なソースコードは、添付ファイルに含まれているので、実装や改修の際の参考として利用できます。
最上位オブジェクト
SSCNNフレームワークはもともと、複数のEncoderを連結し、各段階で分析を深めながら特徴表現の抽象度を高めていく構成として考案されました。 この構成により、まずトレンド、季節性、局所的な急変動といった明確な成分を抽出して、それらの影響を整合させ、その後、情報量が豊富でありながら圧縮された表現を段階的に処理し、微妙な相互関係を特定できるようになります。 この処理の流れを制御するために導入するのが、CNeuronSCNNを継承する最上位オブジェクトCNeuronSSCNNです。
このクラスはディスパッチャとして機能し、複数のEncoderを連結した構成を内部に保持します。また、Encoder 間のテンソルの受け渡しを管理し、サイズと形式の整合性を調整するとともに、連結された処理全体で順伝播と逆伝播が正しくおこなわれるようにします。
class CNeuronSSCNN    :  public   CNeuronSCNN
  {
protected:
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNN(void) {};
                    ~CNeuronSSCNN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period, uint layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNN; }
  };
CNeuronSSCNNの動作は、親クラスから継承したロジックに完全に準拠している点に留意してください。新しいアルゴリズムを考案しているわけではなく、新しい構成で使用するEncoderを明示的に指定しているにすぎません。 このクラスを再定義する理由は、実用上の必要性にあります。複数の段階を順番に構築するために、使用するEncoderの型とパラメータを固定する必要があるのです。 新しいメソッドで変更するのも、必要な部分に限られます。使用するEncoderの型と形式を置き換えるだけで、計算ロジック自体は変更しません。 したがって、すでに説明したアルゴリズムを詳しく検討し直す必要はありません。実装は従来のままです。 このクラスとすべてのメソッドの完全なソースコードは、添付ファイルで確認できます。
モデルの学習
モデルの学習プロセスについて、簡単に説明します。 ここでは、2段階の戦略を採用しています。まずオフラインで集中的に学習をおこない、その後、実運用モードで細かなオンライン微調整を実施します。 オフライン学習を高速化するため、Environment State Encoderにおける環境状態の表現を意図的に簡略化し、補助的な予測モジュールの学習も省略しました。これにより、事前学習に要する時間を大幅に短縮できますが、初期表現の網羅性は低下します。 学習処理は、Trainメソッドに実装されています。
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
まず、このメソッドでは学習ウィンドウの開始インデックスと終了インデックスを計算し、その後、取引ターミナルから過去のデータを読み込みます。 これは標準的なデータ準備処理です。後続の特徴量やサンプルを生成するための基礎となる、生の価格データとタイムスタンプを取得します。
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
続くブロックでは、インジケータのバッファが正常にリサイズされたかどうかを確認します。 バッファを1つでも確保できなかった場合は、デバッグメッセージを出力し、エキスパートアドバイザー(EA)を適切に終了(ExpertRemove)します。これにより、不整合な状態のまま処理が継続されるのを防ぎます。
次に、インジケータの計算が完了するまで待機するループに進みます。 ここでは、所定の反復回数以内にインジケータの計算が完了したかどうかを確認します。 これにより、データの準備がまだ整っていない状況に対処できます。不完全なデータで処理を開始するのではなく、一定時間は待機しますが、無期限に待ち続けることはありません。 上限回数を超えても計算が完了しない場合は、メッセージを出力して処理を終了します。
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
その後、Refreshメソッドでインジケータを更新し、Rates配列をSeriesモードに設定します。これにより、過去データに対して、インデックスを使った通常の順序でアクセスできるようになります。 続いて、利用可能なバーの本数を調整します。 各学習サンプルには、過去のHistoryBars個の値に加え、予測期間NForecast分の余裕が必要になるためです。 調整後の値が負になる場合は、データが不足していることを意味するため、処理を終了します。
次に、作業用ベクトルを準備し、早期終了フラグを設定します。 また、現在時刻も記録します。この時刻は、定期的なUIの更新や処理時間の監視に使用します。
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
メインの学習ループは、エポック(epoch)単位で実行されます。 Epochsで指定された上限に達するか、IsStoppedによる外部からの停止要求が発生するか、内部エラーによってStopフラグが設定されるまで、ループを継続します。 各エポックの開始時には、Encoderの内部状態をクリアします。
   for(int epoch = 0; (epoch < Epochs && !IsStopped() && !Stop); epoch ++)
     {
      if(!cEncoder.Clear())
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
各エポックの内部では、positの位置を順に処理するループが実行されます。 開始位置から終了位置に向かって反復し、各位置でまずCreateBuffersを呼び出して入力データを準備します。この処理でStateバッファとTimeバッファを生成し、ネットワークへの入力とします。 次に、口座状態ベクトルを構築し、参照行動を生成します。
for(int posit = start - HistoryBars - NForecast - 1; posit >= end; posit--)
  {
   if(!CreateBuffers(posit, GetPointer(bState), GetPointer(bTime), Result))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
   const vector<float> target_action = OraculAction(account, Result);
   if(!bAccount.AssignArray(account))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
学習には、報酬信号と先読みを用いた参照軌道に基づく、ハイブリッド学習方式を採用しています。
次に、順伝播を実行します。 まず、Environment State Encoderが現在の市場状態を表現する特徴量に変換します。
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
その後、Actorがエージェントの行動を出力し、 Criticが現在の状態におけるその行動の良さを評価します。
   if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
すべての呼び出しはチェックによって保護されています。エラーが発生した場合は、直ちに処理を中止し、Stopフラグを設定します。
Studyブロックは、報酬に基づく更新処理の中心となる部分です。 ここでは、エージェントの行動を取得し、それに対する報酬を計算します。 注目すべき点として、報酬が負の場合、その値を2倍にしています。つまり、望ましくない判断に対するペナルティを強めています。 この増幅によって、失敗例からの学習を速めることができますが、ペナルティを強くしすぎると学習が不安定になるおそれがあるため、注意が必要です。
//--- Study
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(reward < 0)
   reward *= 2;
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
次に、Critic、Encoder、Actorの順に逆伝播を実行します。 これは典型的なActor-Critic方式です。Criticは価値推定の誤差に基づいて更新され、その後、学習信号が ActorとEncoderに伝えられます。 ここで重要なのは、Critic → Encoder → Actorという順序を守ることです。これにより、共有された計算グラフの構造を通じて、勾配が正しく伝播します。
続いて、Oraculの段階に移り、参照軌道を用いて学習します。 直前にEncoderとActorのパラメータを更新しているため、まず両者の順伝播をもう一度実行します。同じ環境状態を分析しても、更新後のパラメータを使用するため、得られる結果は当然異なります。
//--- Oracul
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Action.AssignArray(target_action))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
次に、エージェントの行動を参照行動に置き換え、その行動に対する報酬を計算します。 そして、Actorの逆伝播を実行し、参照行動を模倣するように学習させます。
if(!cActor.backProp(Action, GetPointer(cEncoder), LatentLayer))
   {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.feedForward(Action, 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
//---
if(GetTickCount() - ticks > 500)
  {
   double percent = (epoch + 1.0 - double(posit - end) / (start - end - HistoryBars - NForecast)) /
                                                                                    Epochs * 100.0;
   string str = "";
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                                    cActor.getRecentAverageError());
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                                   cCritic.getRecentAverageError());
   Comment(str);
   ticks = GetTickCount();
  }
 }
}
続いて、参照行動を入力としてCriticの順伝播と逆伝播を実行します。 その後、Encoderのパラメータも再び最適化します。 このように、各ステップでは、まず自身の経験から学習する強化学習をおこない、次に参照行動に近づくよう方策を調整する教師あり学習をおこないます。 この組み合わせにより、学習の収束がより安定し、速度も向上することが期待できます。
ループの実行中は、約500ミリ秒ごとにステータス文字列を生成し、進捗率とActor、Critic の現在の誤差を表示します。 これは、ユーザーが学習の進行状況を把握するための重要な仕組みです。
すべてのエポックが終了すると、コメント表示をクリアし、最終的な評価指標をターミナルのログに出力してから、プログラムを安全に終了します。
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor", cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic", cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
オフライン学習プログラムの完全なソースコードは、添付ファイルに含まれています。 そこには、本記事の準備に使用したすべてのプログラムのソースコードに加え、学習対象モデルのアーキテクチャも含まれています。このモデルのアーキテクチャは、以前の研究からほぼ変更せずに引き継いだものです。 今回、Encoderのアーキテクチャで変更したのは、Encoderのメイン層の型だけです。
テスト
前述のとおり、学習プロセスは2つの段階で構成されています。 第1段階のオフライン学習では、2024年の1年間におけるEURUSDペアのH1(1時間足)データを使用してモデルを学習させました。 この期間には、相場が落ち着いている局面から急激な変動が発生する局面まで、幅広い市場環境が含まれています。そのため、モデルが典型的な状況だけでなく、まれにしか発生しない状況にも対応できるよう学習することができました。
第2段階では、実際の市場に近い条件下でオンラインファインチューニングをおこないました。 学習にはMetaTrader 5を使用し、モデルにローソク足のライブデータストリームを順次処理させました。 このモードでは、ノイズやデータの歪みに対する頑健性を確認できるほか、市場環境が変化した際にモデルの動作を適応させることもできます。
最後に、これまで学習に使用していない新しいデータ、すなわち2025年1月から3月までの価格データを用いてモデルをテストしました。 すべてのパラメータと設定は変更していません。 得られた結果から、提案手法の予測精度と実用面での信頼性を客観的に評価できます。 テストの結果を以下に示します。
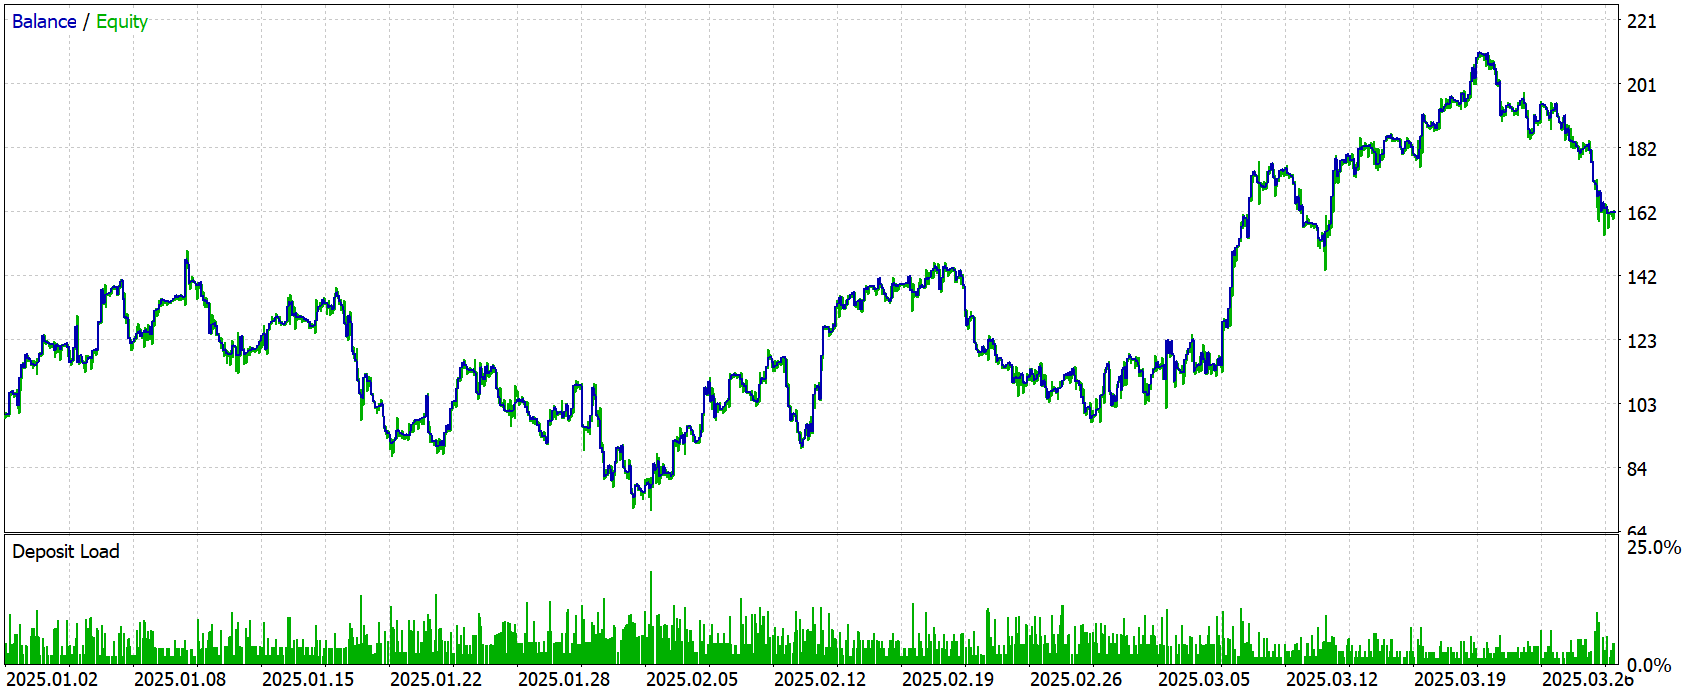
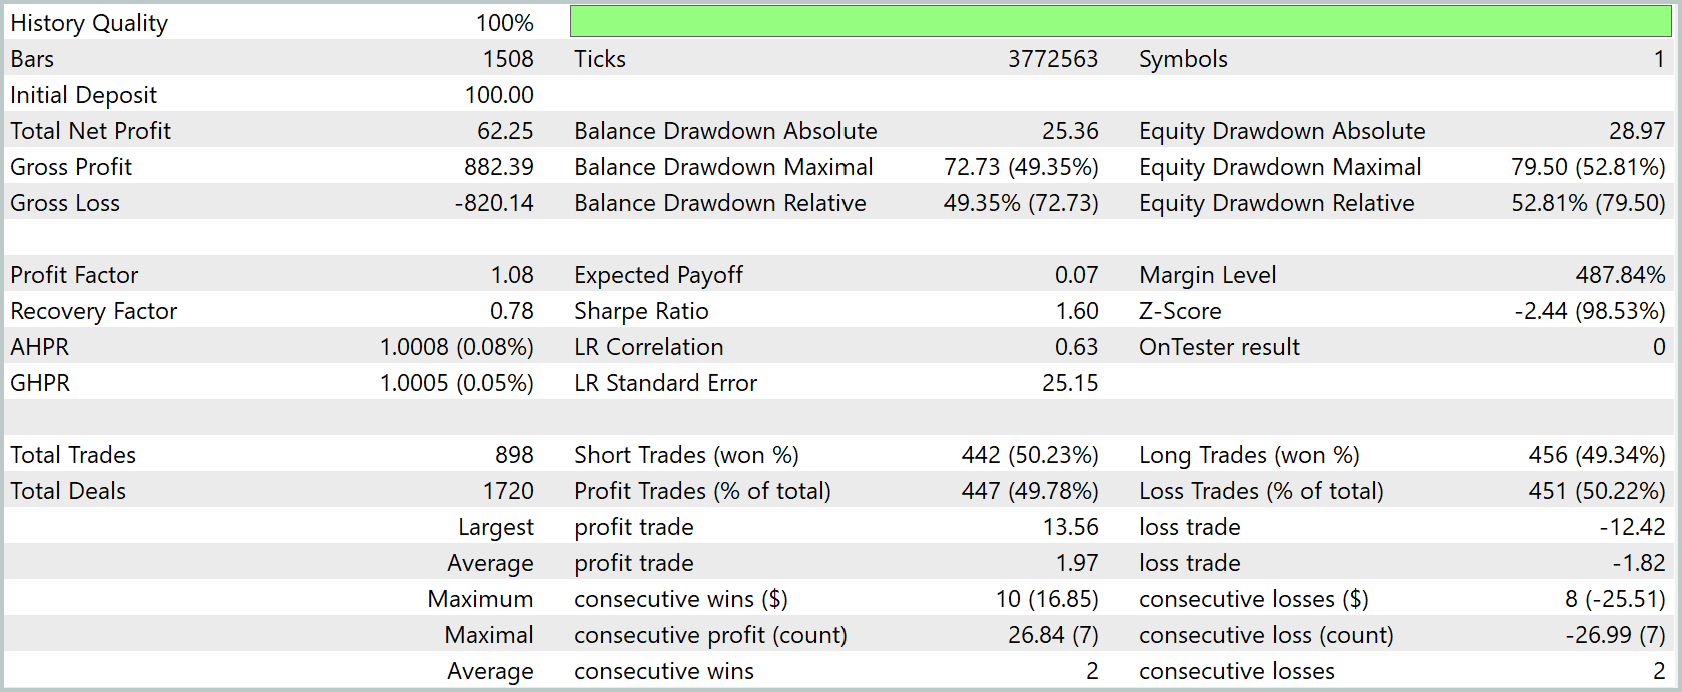
テスト結果からは、ある程度のプラスの推移が確認できます。 初期入金100米ドルで開始したところ、EAは62.25米ドルの利益を上げ、総利益が総損失をわずかに上回りました。 一方、プロフィットファクターは1をわずかに上回る程度であり、この戦略の有効性はそれほど高くないことを示しています。
テスト期間中に実行された取引は898回で、買い取引と売り取引の回数はほぼ同じでした。 どちらの場合も勝率は約50%で、売りポジション側にわずかな偏りが見られました。 平均利益取引額は1.97米ドル、平均損失取引額は1.82米ドルでした。 最大利益は13.56米ドル、最大損失は12.42米ドルでした。
全体として、EAは正確な取引執行と安定した動作を示していますが、戦略の収益性と堅牢性については、依然として疑問が残ります。
結論
本記事をもって、SSCNNフレームワークの提案者が示した手法をMQL5で実装する取り組みを締めくくります。 本記事では、時空間的な特徴量の統合という概念を紹介しました。この手法では、各時点において、内部のデータ構造と外部の市場からの刺激との間に存在する複雑な相互関係を捉えます。
このモデルは、市場の挙動に対する理解を深めるだけでなく、市場レジームの変化、すなわち相場が落ち着いている局面からボラティリティが激しく変動する局面まで、さまざまな状況に適応するための手段も提供します。 Attentionに基づく正規化の実装により、重要な領域への注目が強化され、学習プロセスが安定化します。その結果、SSCNNは、金融時系列データに内在する複雑な構造を解き明かすことのできる、柔軟な分析機構へと発展します。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19134
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:Temporal Queryモデル(最終回)
 取引におけるニューラルネットワーク:Temporal Queryモデル(TQNet)
 夢最適化アルゴリズム(DOA)
 決闘者アルゴリズム

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索