

線形自己回帰モデルの残差を用いた非線形U-Transformerの学習
 22
 1

現代のアルゴリズム取引において、開発者は根本的なジレンマに直面しています。線形モデルはシンプルで解釈しやすい一方、金融時系列に見られる複雑な非線形関係を捉えることができません。 一方、ディープニューラルネットワークは、理論上、あらゆる非線形性をモデル化できますが、市場のノイズが大きく、利用できるデータ量が限られている場合、過学習や予測の不安定化が問題となります。
本記事では、2段階のモデリングによって、このジレンマに対処するハイブリッド手法を紹介します。まず、25個の特徴量を用いた線形自己回帰モデルによって、価格データから主要な統計的パターンを抽出します。次に、専用のU-Transformerアーキテクチャを線形モデルの残差で学習させ、第1段階では捉えきれなかった潜在的な非線形パターンを明らかにします。
この手法の主な革新点は、もともと画像セグメンテーション向けに設計されたU-NetアーキテクチャにTransformerブロックを組み込み、時系列分析に応用したことです。 システムはMQL5で実装されており、動的なポジション管理、パラメータの自動再最適化、ニューラルネットワークのオンライン学習など、一連の取引ロジックを備えています。
実験による検証では、計算効率と結果の解釈可能性を維持しながら、ハイブリッド手法が線形モデルのみを用いる手法を上回ることが示されています。 また、このシステムはリアルタイムで動作し、市場環境の変化に自動的に適応できるよう設計されています。
はじめに
金融市場は複雑な適応システムであり、従来の予測手法にはいくつかの根本的な課題があります。 その中でも、まず挙げられるのが非線形性の問題です。 市場データには、単純な線形モデルでは説明しきれない複雑なパターンが見られます。例えば、ボラティリティのレジームシフト、ニュースに対する非対称な反応、流動性の変化が連鎖的に引き起こす影響などです。 しかし、強力な非線形機械学習モデルを金融データに適用しようとすると、第2の問題である過学習と予測の不安定性に直面することが少なくありません。
この問題は、アルゴリズム取引において特に深刻です。モデルには、価格変動を正確に予測するだけでなく、さまざまな市場環境でも安定した予測性能を維持し、リアルタイム運用に必要な計算効率を確保することが求められます。 ARIMAやVARといった従来の計量経済モデルは、安定性と解釈のしやすさに優れていますが、線形モデルであるため、複雑な市場動向をモデル化する能力には大きな制約があります。
一方、LSTM、GRU、Transformerといった最新のディープラーニングアーキテクチャは、理論上、あらゆる非線形関係を近似できます。しかし、金融データへの適用には、いくつかの難しさがあります。 まず、市場データにはノイズが多く含まれているため、ニューラルネットワークが本質的なパターンを学習するのではなく、ランダムな価格変動を記憶してしまう可能性があります。 さらに、金融時系列は非定常性を持つため、過去のデータから学習したパターンが、短期間で有効性を失うこともあります。
第3の問題は、実装環境に関する制約です。特にMQL5を使用する取引プラットフォームでは、計算資源の制約から、最新のディープラーニングフレームワークを十分に活用できない場合があります。 そのため、開発者はニューラルネットワークのアルゴリズムを一から実装せざるを得ず、実用的に実装できるアーキテクチャの複雑さが大幅に制限されます。
本記事で紹介する解決策は、予測の問題を性質の異なる2つの段階に分けるという考え方に基づいています。第1段階では線形モデルを使って主要な統計的規則性を捉え、第2段階では非線形モデルを使って残差に含まれる複雑な依存関係を捉えます。 このアプローチにより、両者の長所を活かしながら、それぞれの弱点を最小限に抑えることを目指します。
第1段階の線形自己回帰モデルは、慎重に設計された25次元の特徴量空間に基づいて構築されています。ここには、従来の価格のラグ項だけでなく、それらの非線形変換、テクニカル指標、周期成分も含まれています。 このモデルは勾配降下法によって最適化され、結果を解釈しやすいという特長を維持しながら、予測性能の基準となる出力を提供します。
第2段階のニューラルネットワークには、U-Netの原理とTransformerのAttention機構を組み合わせた、専用のU-Transformerアーキテクチャを採用しています。U-Netは、スキップ接続を備えたEncoder-Decoder構造を特徴とするアーキテクチャです。これにTransformerの仕組みを組み合わせることで、時系列データに含まれるパターンを捉えます。 このアプローチの重要なポイントは、ニューラルネットワークを元の価格データではなく、線形モデルの残差で学習させることです。残差に対象を絞ることで、ニューラルネットワークが学習すべき課題を大幅に単純化し、過学習のリスクを低減します。
このように予測処理を2段階に分けることで、自然な正則化の仕組みが生まれます。市場環境が変化し、ニューラルネットワークによる予測が不安定になった場合、システムは自動的に、より保守的な線形モデルの予測へと切り替わります。 これを実現するのが、適応型重み付けの仕組みです。ニューラルネットワークの予測に与える重みは、線形モデルとニューラルネットワークの現在の予測性能に応じて調整されます。
U-Transformerアーキテクチャの理論的基礎
U-Transformerアーキテクチャは、コンピュータビジョンと自然言語処理の分野で用いられる2つの強力な概念、U-NetとAttention機構を組み合わせたものです。 U-Netはもともと、全体的な文脈を維持しながら、対象の位置を正確に特定する必要がある医療画像のセグメンテーション向けに開発されました。 その中核となるのは、対称的なEncoder-Decoder構造と、水平方向のスキップ接続です。この接続によって、初期層で得られた詳細な情報を、Decoderの後段の層へ直接伝達できます。
時系列分析に応用すると、このアーキテクチャは新たな意味を持ちます。 Encoderは、より抽象度の高いパターンを段階的に抽出しながら、時間情報を順次圧縮します。一方、Decoderは、抽象的な表現とスキップ接続を介して伝達される詳細な特徴量の両方を利用して、時間方向の分解能を復元します。 これは、局所的な価格変動が全体的なトレンドと同じくらい重要になり得る金融データにおいて、特に重要な仕組みです。
struct UTransformerNet
{
    NeuralLayer encoder_layers[3];     // Encoder: information compression
    NeuralLayer decoder_layers[3];     // Decoder: restore resolution
    AttentionBlock attention_heads[4]; // Multi-head attention
    double skip_connections[3][32];    // U-Net horizontal connections
    double residuals[6000];            // Residuals for training
    double neural_predictions[6000];   // Neural network predictions
};
Transformerアーキテクチャから取り入れたSelf-Attention機構により、モデルは入力系列の中から、予測に最も関連する部分に動的に注目できるようになります。 畳み込み層や回帰結合層とは異なり、Attention機構では、時間的に離れた事象同士の関係を直接捉えることができます。事象の影響が遅れて現れることもある金融市場では、これは重要な特性です。
void SelfAttention(double &inputs[], AttentionBlock &attention, double &outputs[])
{
    double queries[32], keys[32], values[32];

    // Calculate Q, K, V transformations
    for (int i = 0; i < NeuralNodes; i++)
    {
        queries[i] = 0; keys[i] = 0; values[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            queries[i] += inputs[j] * attention.query_weights[j][i];
            keys[i] += inputs[j] * attention.key_weights[j][i];
            values[i] += inputs[j] * attention.value_weights[j][i];
        }
    }

    // Calculate attention scores: Q × K^T
    for (int i = 0; i < NeuralNodes; i++)
    {
        attention.attention_scores[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            attention.attention_scores[i] += queries[i] * keys[j];
        }
        attention.attention_scores[i] /= MathSqrt(NeuralNodes); // Scaling
    }
}
提案するアーキテクチャと標準的なTransformerとの主な違いは、一般的なTransformerモデルで用いられるトークン系列の表現ではなく、1次元の時系列データに適応させている点です。 また、位置エンコーディングの代わりに、時刻や周期成分などの時間的特徴量を使用します。これにより、モデルは取引セッションに見られる日中の季節性を考慮できるようになります。
ハイブリッドモデル:線形回帰とニューラルネットワークの組み合わせ
このハイブリッドアプローチの中心となる考え方は、性質の異なる2つの成分を加算することで、最終的な予測値を求めることです。
Final_Prediction = Linear_Model(X) + α × U_Transformer(Residuals)
ここで、αは両モデルの現在の予測性能に応じて変化する適応型重み付けの係数です。
線形成分は、特徴量空間を拡張した古典的な自己回帰モデルとして構築されます。
// Calculate linear prediction
double linear_pred = 0;
for (int i = 0; i < 25; i++)
    linear_pred += g_pair.coeffs[i] * features[i];
ニューラルネットワーク成分は、元の価格データではなく、線形モデルの残差を用いて学習されます。
void TrainUTransformer()
{
    // Calculate the residuals of a linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    // Train a neural network on residuals
    for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;
        for (int i = 0; i < g_pair.data_size; i++)
        {
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;
        }
    }
}
このように予測を分解することで、いくつかの重要な利点が得られます。 第一に、ニューラルネットワークが取り組むのは、元の時系列そのものではなく、残差のパターンをモデル化するという、より単純な問題になります。 残差は、元の時系列と比べて分散が小さく、統計的性質も定常的である傾向があります。そのため、学習が容易になり、過学習のリスクも低減されます。
第二に、このシステムには「フェイルセーフ」の考え方が取り入れられています。ニューラルネットワーク成分の予測が不安定になり、損失が大きくなった場合には、線形成分をより重視することで、予測の安定性を維持することを目指します。
double GetHybridPrediction(double price_t1, double price_t2, double price_t3)
{
    // Linear prediction
    double linear_pred = 0;
    for (int i = 0; i < 25; i++)
        linear_pred += g_pair.coeffs[i] * features[i];

    // Neural network correction
    double neural_correction = 0;
    if (g_pair.neural_net.is_trained)
    {
        neural_correction = UTransformerForward(g_pair.coeffs, 0);
    }

    // Adaptive weighting
    double confidence = MathMin(g_pair.current_r2, 0.8);
    double neural_weight = g_pair.neural_net.is_trained ? (1.0 - confidence) : 0.0;

    return linear_pred + neural_weight * neural_correction;
}
neural_weight係数は、モデルの予測性能に応じて自動的に調整されます。線形成分の決定係数(R²)が高い場合、つまり線形モデルの当てはまりが良い場合には、ニューラルネットワーク成分の重みが小さくなります。一方、R²が低い場合には、ニューラルネットワーク成分の重みが大きくなります。 この仕組みにより、さまざまな市場レジームにおいてシステムの安定性を維持し、学習が不十分なニューラルネットワークによって、線形モデルが提供する良好な予測が損なわれるリスクを抑えることを目指します。
多次元特徴量空間と特徴量エンジニアリング
機械学習モデルの性能は、入力特徴量がどれだけ有益な情報を含んでいるかに大きく左右されます。 金融市場の予測では、市場データにノイズが多く、非定常性が強いことから、この点が特に重要になります。 本システムでは、入念に設計された25次元の特徴量空間を使用します。これには、従来の価格のラグ項とその非線形変換、テクニカル指標、周期成分が含まれています。
基本となる特徴量には、価格のラグ項そのものに加え、その2乗項も含まれます。
void CalculateFeatures(double price_t1, double price_t2, double price_t3,
                      int bar_index, string symbol, double &features[])
{
    // Linear price components
    features[0] = price_t1;                    // X(t-1)
    features[1] = MathPow(price_t1, 2);        // X(t-1)²
    features[2] = price_t2;                    // X(t-2)
    features[3] = MathPow(price_t2, 2);        // X(t-2)²
    features[4] = price_t3;                    // X(t-3)

    // Difference operators (momentum)
    features[5] = (price_t1 - price_t2);      // Short-term momentum
    features[9] = (price_t1 - price_t3);      // Medium-term momentum
    features[18] = MathPow(price_t1 - price_t2, 2); // Quadratic momentum
}
周期成分は、異なる時間スケールで繰り返し現れるパターンをモデル化します。
// Low-frequency cycles (daily seasonality)
    features[6] = MathSin(price_t1);
    features[7] = MathCos(price_t1);

    // High-frequency cycles (intraday patterns)
    features[13] = MathSin(price_t1 * 1000);
    features[14] = MathCos(price_t1 * 1000);

    // Time component (trading session hour)
    datetime bar_time = iTime(symbol, PERIOD_H1, bar_index);
    MqlDateTime dt;
    TimeToStruct(bar_time, dt);
    features[17] = (dt.hour / 24.0);
非線形変換を加えることで、モデルがさまざまなボラティリティ局面に適応しやすくなります。
// Root and exponential transformations
    features[15] = MathSqrt(MathAbs(price_t1));
    features[16] = MathExp(-MathAbs(price_t1 - price_t2));

    // Hyperbolic tangent for limiting outliers
    features[23] = MathTanh(price_t1 - ma);
テクニカル指標は、市場のミクロ構造に関する情報を補います。
// RSI and its nonlinear versions
    double rsi = 50.0; // Simplified calculation for demonstration
    features[10] = (rsi / 100.0);
    features[21] = MathPow(rsi / 100.0, 2);

    // Deviation from the moving average
    double ma = price_t1; // Simplified calculation
    features[11] = (price_t1 - ma);

    // Volatility (ATR)
    double atr = MathAbs(price_t1 - price_t2);
    features[12] = atr;
    features[20] = (atr * (price_t1 - price_t2)); // Interaction of volatility and momentum
また、異なる構成要素の間に生じる非線形な相互作用をモデル化するため、交互作用特徴量も設けています。
// Pairwise interactions
    features[8] = (price_t1 * price_t2);
    features[19] = (price_t1 / price_t2);

    // Triple interactions
    features[22] = (price_t1 * price_t2 * price_t3);

    // Constant term
    features[24] = 1.0;
このように多様な特徴量を組み合わせることで、線形モデルは、単純なトレンドの動きから複雑な非線形パターンまで、幅広い市場の特徴を捉えられるようになります。 さらに、ニューラルネットワーク部分は、こうした豊富な特徴量を用いた線形モデルの残差を学習するため、取り組むべき課題が大幅に単純化されます。
MQL5におけるデータ構造とメモリ構成
MQL5環境で複雑な機械学習アルゴリズムを実装するには、メモリ管理とデータ構造の設計に特に注意を払う必要があります。 メモリや計算グラフを自動的に管理する最新のディープラーニングフレームワークとは異なり、MQL5では、開発者自身が効率的なデータ構造を設計しなければなりません。
システムの中核となるPairData構造体は、1つの通貨ペアに必要なデータをまとめて管理します。
struct PairData
{
    string analyst_symbol;    // Symbol for analysis (EURUSD)
    string trade_symbol;      // Symbol for trading (USDJPY)

    // Linear model coefficients
    double coeffs[25];        // Current coefficients
    double best_coeffs[25];   // Best coefficients found

    // Quality metrics
    double current_r2;        // Current R²
    double best_r2;           // Best achieved R²
    double learning_rate;     // Adaptive learning rate

    // Time series and features
    double prices[6000];                    // Target prices
    double features[6000][50][25];          // Sequences of features
    int data_size;                          // Actual data size

    // Position state for averaging/pyramiding
    double last_buy_price;    // Price of the last BUY position
    double last_sell_price;   // Price of the last SELL position
    int buy_levels;           // Number of BUY levels
    int sell_levels;          // Number of SELL levels

    // Neural network component
    UTransformerNet neural_net;
};
ニューラルネットワークの各層を表すNeuralLayer構造体は、行列乗算を効率的に実行できるように設計されています。
struct NeuralLayer
{
    double weights[64][64];   // Layer weight matrix
    double biases[64];        // Bias vector
    double outputs[64];       // Neuron outputs
    double gradients[64];     // Gradients for backpropagation
    int size;                 // Actual size of the layer
};
AttentionBlock構造体は、Multi-Head Attentionの簡略版を実装するためのデータを管理します。
struct AttentionBlock
{
    double query_weights[32][32];  // Query transformation matrix
    double key_weights[32][32];    // Key transformation matrix
    double value_weights[32][32];  // Value transformation matrix
    double attention_scores[32];   // Attention weights
    double context[32];            // Context vector
};
このメモリ構成の大きな特徴は、動的なデータ構造ではなく、サイズが固定された静的配列を使用していることです。 これは、メモリ使用量を予測可能にするためです。
// Maximum array sizes are specified as constants
double prices[6000];                    // Maximum 6000 historical points
double features[6000][50][25];          // Sequences of 50 bars
double residuals[6000];                 // Residuals for training the neural network
3次元配列features[6000][50][25]は、特に注目すべき構造です。 第1次元は最大6,000件の履歴データ、第2次元は50本のバーからなる時系列、第3次元は25個の特徴量に対応しています。 この構成は、再帰機構やアテンション機構での利用を想定したもので、学習や予測に必要なデータへ効率的にアクセスできるようにしています。
ニューラルネットワークの重みの初期化には、学習を安定させるため、Xavier/Glorot初期化法を採用しています。
void InitializeNeuralNetwork()
{
    MathSrand(GetTickCount());

    for (int layer = 0; layer < NeuralLayers; layer++)
    {
        int input_size = (layer == 0) ? 25 : NeuralNodes;
        double scale = MathSqrt(2.0 / (input_size + NeuralNodes));

        for (int i = 0; i < input_size; i++)
        {
            for (int j = 0; j < NeuralNodes; j++)
            {
                g_pair.neural_net.encoder_layers[layer].weights[i][j] =
                    (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
            }
        }
    }
}
このようなメモリ構成により、取引プラットフォームのリソースが限られている環境でも、複雑な機械学習アルゴリズムを実装するための柔軟性を保ちながら、効率的な動作を目指しています。
2つの構成要素による学習アルゴリズム
ハイブリッドシステムの学習は、線形モデルとニューラルネットワークの各構成要素を、連携を保ちながら交互に最適化する反復プロセスです。 この方法により、安定した収束を目指すとともに、それぞれの構成要素が予測問題の異なる部分を担当できるようにします。
最初のステップでは、学習率を適応的に調整しながら、勾配降下法を用いて線形モデルを最適化します。
void OptimizeCoefficients()
{
    double best_coeffs[25];
    ArrayCopy(best_coeffs, g_pair.coeffs);
    double best_r2 = CalculateR2();

    g_pair.learning_rate = InitialLearningRate;

    for (int iter = 0; iter < MaxIterations; iter++)
    {
        double gradients[25];
        ArrayInitialize(gradients, 0.0);

        // Calculate gradients for all training examples
        for (int i = 0; i < g_pair.data_size; i++)
        {
            double actual = g_pair.prices[i];
            double predicted = 0.0;

            // Forward pass of the linear model
            for (int j = 0; j < 25; j++)
                predicted += g_pair.coeffs[j] * g_pair.features[i][0][j];

            double error = predicted - actual;

            // Accumulate gradients: ∂L/∂w_j = 2 * error * x_j
            for (int j = 0; j < 25; j++)
                gradients[j] += 2.0 * error * g_pair.features[i][0][j];
        }

        // Normalize gradients
        for (int j = 0; j < 25; j++)
            gradients[j] /= g_pair.data_size;
勾配の爆発を防ぐために、重要な要素となるのが勾配クリッピングです。
// Gradient clipping for stability
        double gradient_norm = 0.0;
        for (int j = 0; j < 25; j++)
            gradient_norm += gradients[j] * gradients[j];
        gradient_norm = MathSqrt(gradient_norm);

        if (gradient_norm > 1.0)
        {
            for (int j = 0; j < 25; j++)
                gradients[j] /= gradient_norm;
        }

        // Update coefficients
        for (int j = 0; j < 25; j++)
            g_pair.coeffs[j] -= g_pair.learning_rate * gradients[j];
適応的学習率は、最適化の進行状況に応じて自動的に調整されます。
double new_r2 = CalculateR2();

        if (new_r2 > best_r2)
        {
            // Improvement found - increasing learning rate
            best_r2 = new_r2;
            ArrayCopy(best_coeffs, g_pair.coeffs);
            g_pair.learning_rate *= 1.01;
        }
        else
        {
            // Deterioration - roll back and reduce the rate
            ArrayCopy(g_pair.coeffs, best_coeffs);
            g_pair.learning_rate *= 0.8;

            if (g_pair.learning_rate < InitialLearningRate * 0.01)
                break;// Too low speed - stop
        }
    }
}
第2段階では、最適化された線形モデルの残差を使ってニューラルネットワークを学習させます。
void TrainUTransformer()
{
    // Calculate residuals after optimizing a linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    double best_loss = 1e6;
    int no_improve_count = 0;

    for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;

        for (int i = 0; i < g_pair.data_size; i++)
        {
            // Forward pass neural networks
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);

            // Calculate MSE loss
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;

            // Simplified backpropagation (gradient by last layer)
            double gradient = 2.0 * error / g_pair.data_size;

            for (int layer = NeuralLayers - 1; layer >= 0; layer--)
            {
                for (int j = 0; j < NeuralNodes; j++)
                {
                    for (int k = 0; k < NeuralNodes; k++)
                    {
                        g_pair.neural_net.encoder_layers[layer].weights[k][j] -=
                            g_pair.neural_net.learning_rate * gradient * 0.01;
                    }
                }
            }
        }

        total_loss /= g_pair.data_size;

        // Early stopping to prevent overfitting
        if (total_loss < best_loss)
        {
            best_loss = total_loss;
            no_improve_count = 0;
        }
        else
        {
            no_improve_count++;
            if (no_improve_count > 5) break;
        }
    }
}
2つの構成要素の学習は、定期的に再最適化をおこなうことで連携させます。
if (g_pair.bars_since_optimization >= OptimizationInterval)
{
    PrepareOptimizationData();
    OptimizeCoefficients();        // Linear model first

    // Retrain the neural network every 5 optimization cycles
    if (g_pair.neural_net.training_steps % 5 == 0)
    {
        TrainUTransformer();       // Then the neural network on the new residues
    }

    g_pair.bars_since_optimization = 0;
}
U-Transformerによる順伝播処理
U-Transformerの順伝播では、Attention機構を組み込んだEncoder-Decoder構造を通じて、入力データを順次処理します。 まず、時系列データ全体にわたる特徴量の平均値を含む入力ベクトルを準備します。
double UTransformerForward(double &coefficients[], double residual)
{
    double layer_input[32];
    double layer_output[32];
    double attention_output[32];

    // Input data preparation: averaging features over a sequence
    double avg_features[25];
    for (int i = 0; i < 25; i++)
    {
        avg_features[i] = 0;
        for (int j = 0; j < 50; j++)
        {
            avg_features[i] += g_pair.features[0][j][i];
        }
        avg_features[i] /= 50;
    }

    // Initialize the input layer
    for (int i = 0; i < 25; i++)
        layer_input[i] = avg_features[i];
Encoder部分では、複数の層を通じて情報を順次処理します。それぞれの層は、異なる抽象度の特徴量を抽出する役割を担います。
// Pass through encoder layers while preserving skip connections
    for (int layer = 0; layer < NeuralLayers; layer++)
    {
        int input_size = (layer == 0) ? 25 : NeuralNodes;

        // Forward pass via a fully connected layer
        ForwardLayer(layer_input, input_size,
                    g_pair.neural_net.encoder_layers[layer], layer_output);

        // Apply self-attention (for the first layers)
        if (layer < TransformerHeads)
        {
            SelfAttention(layer_output,
                         g_pair.neural_net.attention_heads[layer],
                         attention_output);

            // Residual connection: output = layer + attention
            for (int i = 0; i < NeuralNodes; i++)
                layer_output[i] = layer_output[i] + attention_output[i];
        }

        // Save skip connection for decoder
        for (int i = 0; i < NeuralNodes; i++)
            g_pair.neural_net.skip_connections[layer][i] = layer_output[i];

        // Prepare the input for the next layer
        for (int i = 0; i < NeuralNodes; i++)
            layer_input[i] = layer_output[i];
    }
全結合層では、非線形活性化関数を組み合わせた標準的な線形変換をおこないます。
void ForwardLayer(double &inputs[], int input_size, NeuralLayer &layer, double &outputs[])
{
    for (int j = 0; j < layer.size; j++)
    {
        double sum = layer.biases[j];

        // Matrix multiplication: W * x + b
        for (int i = 0; i < input_size; i++)
            sum += inputs[i] * layer.weights[i][j];

        // GELU activation for better convergence
        outputs[j] = GELU(sum);
    }
}
活性化関数には、ReLUの現代的な代替手法であるGELU (Gaussian Error Linear Unit)を使用します。
double GELU(double x)
{
    return 0.5 * x * (1.0 + Tanh(MathSqrt(2.0 / M_PI) * (x + 0.044715 * x * x * x)));
}
Self-Attention機構では、入力系列の各部分に対するAttentionの重みを計算します。
void SelfAttention(double &inputs[], AttentionBlock &attention, double &outputs[])
{
    double queries[32], keys[32], values[32];

    // Calculate Query, Key, Value vectors
    for (int i = 0; i < NeuralNodes; i++)
    {
        queries[i] = 0; keys[i] = 0; values[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            queries[i] += inputs[j] * attention.query_weights[j][i];
            keys[i] += inputs[j] * attention.key_weights[j][i];
            values[i] += inputs[j] * attention.value_weights[j][i];
        }
    }

    // Softmax normalization of attention weights
    double max_score = attention.attention_scores[0];
    for (int i = 1; i < NeuralNodes; i++)
        if (attention.attention_scores[i] > max_score)
            max_score = attention.attention_scores[i];

    double sum_exp = 0;
    for (int i = 0; i < NeuralNodes; i++)
    {
        attention.attention_scores[i] = MathExp(attention.attention_scores[i] - max_score);
        sum_exp += attention.attention_scores[i];
    }

    for (int i = 0; i < NeuralNodes; i++)
        attention.attention_scores[i] /= sum_exp;

    // Apply attention weights to values
    for (int i = 0; i < NeuralNodes; i++)
    {
        outputs[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
            outputs[i] += attention.attention_scores[j] * values[j];
    }
}
最後に、平均プーリングによって出力を集約し、単一のスカラー値を生成します。
// Decoder part (simplified - uses only the last encoder output)
    double final_sum = 0;
    for (int i = 0; i < NeuralNodes; i++)
        final_sum += layer_output[i];

    return final_sum / NeuralNodes; // Average pooling
}
このアーキテクチャにより、情報を複数の階層で処理できます。下位層では局所的なパターンを抽出し、Attention機構では長期的な依存関係を捉えます。また、スキップ接続によって詳細な情報を保持し、最終的な予測に活用します。
売買シグナル生成システム
このハイブリッドシステムでは、各コンポーネントの品質に応じてシグナルの生成元を自動的に切り替える、2段階のアーキテクチャを採用しています。 この構造により、さまざまな市場環境に対するシステムの耐性を高め、いずれかのモデルの性能が低下した場合にも、システム全体のパフォーマンスが悪化するのを防ぎます。
主なシグナル生成元はU-Transformerです。学習品質が一定の水準に達すると、U-Transformerが有効になります。
void ProcessPair()
{
    // Obtain data for analysis from the analyst symbol
    double price_t1 = iClose(g_pair.analyst_symbol, PERIOD_H1, 1);
    double price_t2 = iClose(g_pair.analyst_symbol, PERIOD_H1, 2);
    double price_t3 = iClose(g_pair.analyst_symbol, PERIOD_H1, 3);

    // Current price of the trading symbol
    double current_ask = SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_ASK);
    double current_bid = SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_BID);
    double current_price = (current_ask + current_bid) / 2.0;

    int signal = 0;

    // MAIN SIGNAL: U-Transformer (at high quality)
    if (g_pair.neural_net.is_trained && g_pair.neural_net.loss < 0.01)
    {
        double features[25];
        CalculateFeatures(price_t1, price_t2, price_t3, 1, g_pair.analyst_symbol, features);
        double neural_prediction = UTransformerForward(g_pair.coeffs, 0);

        double neural_threshold = 0.0001;

        if (neural_prediction > neural_threshold) signal = 1;      // BUY signal
        else if (neural_prediction < -neural_threshold) signal = -1; // SELL signal
    }
}
学習がまだ完了していない場合や、十分な結果が得られていない場合には、バックアップとして線形モデルによるシグナル生成に切り替えます。
// BACKUP SIGNAL: Linear Model
    if (signal == 0 && g_pair.current_r2 > 0.1)
    {
        double predicted_price = GetHybridPrediction(price_t1, price_t2, price_t3);
        double base_threshold = g_pair.current_r2 * 0.001;

        if (predicted_price > current_ask + base_threshold) signal = 1;
        if (predicted_price < current_bid - base_threshold) signal = -1;
    }
重要な要素の一つが、モデルの品質に応じて変化する適応型の判定閾値です。 ニューラルネットワークのシグナルには、正規化された残差を使って学習するため、固定閾値を使用します。 一方、線形モデルのシグナルでは、モデルの決定係数(R²)に比例する閾値を使用します。モデルの当てはまりが良いほど、システムはより積極的にシグナルを生成できる仕組みです。
シグナルの生成元をログに記録することで、売買判断の透明性を確保できます。
if (OpenPosition(true, lot))
{
    Print(g_pair.trade_symbol, ": BUY opened by ",
          g_pair.neural_net.is_trained ? "U-TRANSFORMER" : "LINEAR",
          " R2=", DoubleToString(g_pair.current_r2, 3),
          " UT_Loss=", DoubleToString(g_pair.neural_net.loss, 6));
}
分析対象の銘柄と実際に取引する銘柄を分けることで、練行足などで合成銘柄を利用した取引も可能になります。 たとえば、EURUSDの練行足データを分析してEURUSDの取引シグナルを生成できます。こうした仕組みによって、システムの機能を拡張し、追加情報を活用することでシグナルの品質を改善できる可能性があります。
ポジション管理戦略とリスク管理
ポジション管理システムでは、相互に補完する2つの戦略を採用しています。1つは、含み損のあるポジションを追加して平均取得価格を調整する「ナンピン(平均化)」、もう1つは、利益が出ているポジションに追加する「ピラミッディング」です。 これらの戦略は市場の状況に応じて自動的に調整され、シグナル生成システムと連携して動作します。
ポジション管理用のデータ構造には、複雑な戦略を実装するために必要なパラメータが含まれています。
struct PairData
{
    // Track the status of positions
    double last_buy_price;      // Price of the last BUY position
    double last_sell_price;     // Price of the last SELL position
    int buy_levels;             // Number of BUY position levels
    int sell_levels;            // Number of levels of SELL positions
    bool last_was_averaging;    // Flag of the last averaging operation
};
ナンピン戦略は、価格が指定した距離だけ既存ポジションに不利な方向へ動き、かつシステムが同じ方向のシグナルを引き続き生成している場合に発動します。
// AVERAGING BUY positions
if (g_pair.last_buy_price > 0)
{
    double distance_points = (g_pair.last_buy_price - current_price) /
                            SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_POINT);

    if (EnableAveraging && distance_points >= DistancePoints && signal == 1 &&
        g_pair.buy_levels < MaxAveragingLevels)
    {
        double lot = NormalizeLot(g_pair.trade_symbol, LotSize * AveragingLotMultiplier);
        if (OpenPosition(true, lot))
        {
            g_pair.last_buy_price = current_price;
            g_pair.buy_levels++;
            g_pair.last_was_averaging = true;

            Print(g_pair.trade_symbol, ": BUY AVERAGING level ", g_pair.buy_levels,
                  " at distance ", DoubleToString(distance_points, 1), " points");
        }
    }
}
ピラミッディング戦略はこれとは逆に、利益が出ているポジションに追加します。
// PYRAMIDING BUY positions
distance_points = (current_price - g_pair.last_buy_price) /
                  SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_POINT);

if (EnablePyramiding && distance_points >= DistancePoints && signal == 1 &&
    g_pair.buy_levels < MaxPyramidingLevels && !g_pair.last_was_averaging)
{
    double lot = NormalizeLot(g_pair.trade_symbol, LotSize * PyramidingLotMultiplier);
    if (OpenPosition(true, lot))
    {
        g_pair.last_buy_price = current_price;
        g_pair.buy_levels++;

        Print(g_pair.trade_symbol, ": BUY PYRAMIDING level ", g_pair.buy_levels,
              " at distance ", DoubleToString(distance_points, 1), " points");
    }
}
この実装の重要な特徴は、last_was_averagingフラグによって、ナンピンとピラミッディングを同時に行わないようにしている点です。これにより、ポジションの追加が無秩序に繰り返され、戦略が機能しなくなる事態を防ぎます。
ロット数の管理では、操作の種類に応じて異なる倍率を使用します。
double NormalizeLot(string symbol, double lot)
{
    double min_lot = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MAX);
    double lot_step = SymbolInfoDouble(symbol, SYMBOL_VOLUME_STEP);

    lot = MathRound(lot / lot_step) * lot_step;
    lot = MathMax(min_lot, MathMin(max_lot, lot));

    return lot;
}
このポジション管理アーキテクチャにより、最大リスクを管理しながら、柔軟なポジション運用が可能になります。 システムはさまざまな市場環境に対応し、トレンド相場ではナンピンを、急激な価格変動が起こる局面ではピラミッディングを活用します。また、利益確定のルールも明確に定めます。
モデル係数の自動再最適化
変化する市場環境への適応は、あらゆる売買システムにとって重要な要件です。 金融市場では、マクロ経済イベント、市場のミクロ構造の変化、参加者の行動の変化などによって、統計的なパターンが変わる非定常的な動きが見られます。 このシステムでは、過去のデータを対象とするスライディングウィンドウを用いて、モデルのパラメータを定期的に更新する自動再最適化機能を実装しています。
再最適化は、指定された本数の新しいバーが蓄積されると実行されます。
void OnTick()
{
    if (!g_initialized) return;

    ProcessPair();

    // Check the need for reoptimization
    if (isNewBar())
    {
        if (g_pair.bars_since_optimization >= OptimizationInterval)
        {
            PrepareOptimizationData();      // Data preparation
            OptimizeCoefficients();         // Re-optimization of the linear model

            // Retrain the neural network every 5 cycles
            if (g_pair.neural_net.training_steps % 5 == 0)
            {
                TrainUTransformer();
            }

            g_pair.bars_since_optimization = 0;
        }
    }
}
最適化に使用するデータは、サイズを固定したスライディングウィンドウを用いて準備します。これにより、モデルの安定性と市場の変化への適応性のバランスを取ります。
void PrepareOptimizationData()
{
    g_pair.data_size = 0;

    int available_bars = iBars(g_pair.analyst_symbol, PERIOD_H1);
    if (available_bars < 50)
    {
        Print("WARNING: Insufficient bars for ", g_pair.analyst_symbol);
        return;
    }

    int max_data_points = MathMin(OptimizationBars, 6000);

    for (int i = 50; i < MathMin(max_data_points + 50, available_bars - 1); i++)
    {
        if (g_pair.data_size >= 6000) break;

        double price_t0 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - 1);
        if (price_t0 <= 0) continue;

        g_pair.prices[g_pair.data_size] = price_t0;

        // Collection of time sequences of features
        for (int j = 0; j < 50; j++)
        {
            double price_t1 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j);
            double price_t2 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j - 1);
            double price_t3 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j - 2);

            if (price_t1 <= 0 || price_t2 <= 0 || price_t3 <= 0) continue;

            double features[25];
            CalculateFeatures(price_t1, price_t2, price_t3, i - j,
                            g_pair.analyst_symbol, features);

            for (int k = 0; k < 25; k++)
            {
                g_pair.features[g_pair.data_size][j][k] = features[k];
            }
        }

        g_pair.data_size++;
    }

    Print(g_pair.analyst_symbol, ": Prepared ", g_pair.data_size, " data points");
}
最適化処理には、これまでに見つかった最良の係数を保存する仕組みも組み込まれています。
void OptimizeCoefficients()
{
    if (g_pair.data_size < 10)
    {
        Print(g_pair.analyst_symbol, ": Insufficient data (", g_pair.data_size, ")");
        return;
    }

    double best_coeffs[25];
    ArrayCopy(best_coeffs, g_pair.coeffs);
    double best_r2 = CalculateR2();

    // Improvement criterion for continuing optimization
    double initial_r2 = g_pair.current_r2;

    for (int iter = 0; iter < MaxIterations; iter++)
    {
        // ... gradient descent code ...

        double new_r2 = CalculateR2();

        if (new_r2 > best_r2)
        {
            best_r2 = new_r2;
            ArrayCopy(best_coeffs, g_pair.coeffs);
            g_pair.learning_rate *= 1.01; // Acceleration when improving
        }
        else
        {
            ArrayCopy(g_pair.coeffs, best_coeffs);
            g_pair.learning_rate *= 0.8;  // Slowdown when deteriorating

            if (g_pair.learning_rate < InitialLearningRate * 0.01)
                break;
        }

        // Stop criterion for minimum improvement
        if (iter > 10 && (best_r2 - initial_r2) < MinR2Improvement)
            break;
    }

    // Update the best coefficients
    ArrayCopy(g_pair.coeffs, best_coeffs);
    g_pair.current_r2 = best_r2;

    if (best_r2 > g_pair.best_r2)
    {
        g_pair.best_r2 = best_r2;
        ArrayCopy(g_pair.best_coeffs, best_coeffs);
    }

    Print(g_pair.analyst_symbol, ": R2=", DoubleToString(g_pair.current_r2, 4),
          " Best=", DoubleToString(g_pair.best_r2, 4));
}
システムは、説明できる分散の割合を示す決定係数(R²)を用いて、モデルの品質を監視します。
double CalculateR2()
{
    if (g_pair.data_size < 10) return 0.0;

    double sum_actual = 0.0;
    double sum_squared_total = 0.0;
    double sum_squared_residual = 0.0;

    // Calculate the average value
    for (int i = 0; i < g_pair.data_size; i++)
        sum_actual += g_pair.prices[i];
    double mean_actual = sum_actual / g_pair.data_size;

    // Calculate R² components
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double actual = g_pair.prices[i];
        double predicted = 0.0;

        for (int j = 0; j < 25; j++)
            predicted += g_pair.coeffs[j] * g_pair.features[i][0][j];

        double residual = actual - predicted;
        double total_variance = actual - mean_actual;

        sum_squared_residual += residual * residual;
        sum_squared_total += total_variance * total_variance;
    }

    if (sum_squared_total <= 0.0) return 0.0;

    return 1.0 - (sum_squared_residual / sum_squared_total);
}
残差を用いたニューラルネットワークのオンライン学習
ニューラルネットワーク部分のオンライン学習は、線形モデルの最適化に比べて複雑な処理です。 ニューラルネットワークの再学習は、最適化サイクルごとにおこなうのではなく、5サイクルごとに実施します。これにより、過学習を抑え、計算負荷を軽減します。
void TrainUTransformer()
{
    if (g_pair.data_size < 10)
    {
        Print("Insufficient data for U-Transformer training: ", g_pair.data_size);
        return;
    }

    // Calculate residuals from the optimized linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    Print("Training U-Transformer on ", g_pair.data_size, " residuals...");

    double best_loss = 1e6;
    int no_improve_count = 0;
学習には、MQL5の制約に合わせて簡略化した誤差逆伝播法を使用します。
for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;

        for (int i = 0; i < g_pair.data_size; i++)
        {
            // Forward pass
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);
            g_pair.neural_net.neural_predictions[i] = prediction;

            // Calculate MSE loss
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;

            // Simplified backpropagation
            double gradient = 2.0 * error / g_pair.data_size;

            // Update weights (simplified scheme)
            for (int layer = NeuralLayers - 1; layer >= 0; layer--)
            {
                for (int j = 0; j < NeuralNodes; j++)
                {
                    for (int k = 0; k < NeuralNodes; k++)
                    {
                        g_pair.neural_net.encoder_layers[layer].weights[k][j] -=
                            g_pair.neural_net.learning_rate * gradient * 0.01;
                    }
                }
            }
        }

        total_loss /= g_pair.data_size;

        // Early stopping mechanism
        if (total_loss < best_loss)
        {
            best_loss = total_loss;
            no_improve_count = 0;
        }
        else
        {
            no_improve_count++;
            if (no_improve_count > 5) break; // Stop if there are no improvements
        }

        if (epoch % 5 == 0)
            Print("U-Transformer epoch ", epoch, " loss: ", DoubleToString(total_loss, 6));
    }
学習の最後に、ニューラルネットワークの評価指標と状態を更新します。
g_pair.neural_net.loss = best_loss;
    g_pair.neural_net.is_trained = true;
    g_pair.neural_net.training_steps++;

    Print("U-Transformer training completed. Loss: ", DoubleToString(best_loss, 6));
}
ニューラルネットワークの品質基準(損失が0.01未満)によって、システムがニューラルネットワークのシグナルを使用するかどうかを判断します。
// In the signal generation function
if (g_pair.neural_net.is_trained && g_pair.neural_net.loss < 0.01)
{
    // Use U-Transformer to generate signals
    double neural_prediction = UTransformerForward(g_pair.coeffs, 0);
    // ...
}
このオンライン学習の仕組みにより、計算効率を維持しながら過学習を抑え、ニューラルネットワーク部分を変化する市場環境に適応させることができます。
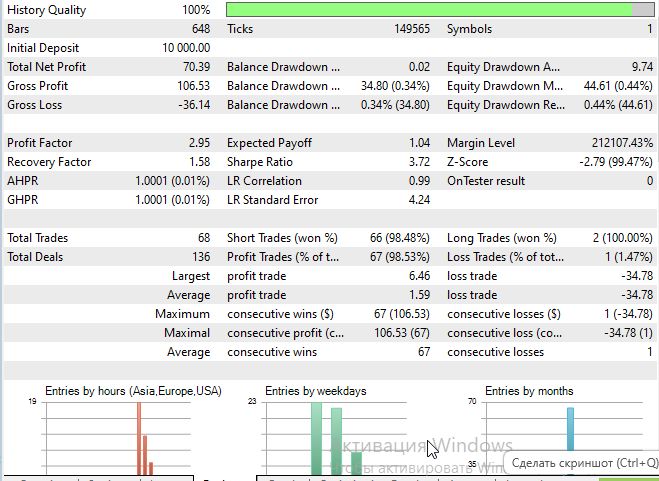
本記事では、回帰モデルを扱った記事で紹介したエキスパートアドバイザー(EA)をベースに、ハイブリッドモデルを追加しました。
2025年7月1日以降の期間を対象に、EURUSDのM15(15分足)でモデルのパフォーマンスを確認してみましょう。
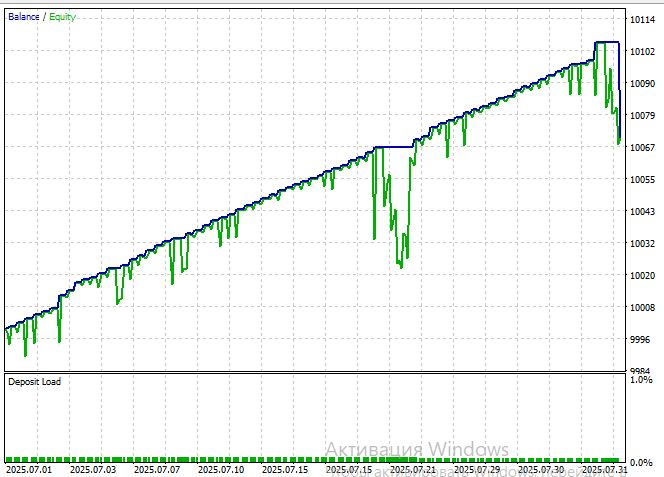
シャープレシオはかなり良好な値となりました。
結論
本記事で紹介したハイブリッドシステムは、MQL5取引プラットフォームの制約内でも、最新のディープラーニングアーキテクチャと従来の計量経済学的手法を実用的に統合できることを示しています。 予測問題を線形成分と非線形成分に分ける2段階の手法により、それぞれのアプローチの長所を活かしながら、短所を最小限に抑えることを目指しています。
主な成果として、U-Netアーキテクチャを金融時系列分析に応用したこと、長期的な依存関係をモデル化するためにAttention機構を組み込んだこと、そしてシグナルの生成元を自動的に切り替える仕組みを実装したことが挙げられます。 また、各コンポーネントへの適応的な重み付けとパラメータの定期的な再最適化により、さまざまな市場環境への対応を目指しています。
このソリューションの実用面での利点は、実際の取引に利用できる構成になっていることです。 ポジション管理、リスク管理、詳細な取引ログの記録を含む、一連の取引ロジックを備えています。 また、分析対象の銘柄と取引対象の銘柄を分けることで、市場間の相関関係を活用する可能性も広がります。
一方で、現時点での実装には限界もあります。 簡略化された誤差逆伝播法、最新の正則化手法の欠如、固定されたネットワーク構造などが、ニューラルネットワーク部分の性能向上を制限しています。 また、動的データ構造ではなく静的配列を使用しているため、システムの拡張性にも大きな制約があります。
それでも、このアプローチは、トレードシステム開発における有望な方向性を示しています。 線形モデルの残差を使ってニューラルネットワークを学習させるという考え方は、金融市場に限らず、幅広い予測問題に応用できます。 モジュール式のアーキテクチャを採用しているため、さまざまな種類のニューラルネットワークやポジション管理戦略を容易に試すこともできます。
特に重要なのは、MQL5のように制約のある開発環境でも、高度な機械学習技術を実装できる可能性を示した点です。 これにより、最新のディープラーニングフレームワークを利用できないトレーダーや開発者にも、新たな可能性が開かれます。
参考文献
- Attention Is All You Need (Vaswani et al., 2017)
- U-Net: Convolutional Networks for Biomedical Image Segmentation (Ronneberger et al., 2015)
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18916
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 夢最適化アルゴリズム(DOA)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:Temporal Queryモデル(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索