

Trauminspirierter Optimierungsalgorithmus (DOA)
 21
 1

Inhaltsverzeichnis
Einleitung
Im Rahmen meiner umfassenden Forschung zu optimalen Optimierungsmethoden wurde ich auf einen völlig neuen und ungewöhnlichen Ansatz aufmerksam, der von einem höchst umstrittenen und bislang kaum erforschten Phänomen inspiriert ist: dem Mechanismus des Träumens.
Im März 2025 stellten Y. Lang und Y. Gao der wissenschaftlichen Gemeinschaft einen innovativen metaheuristischen Optimierungsalgorithmus vor – den Dream Optimization Algorithm (DOA), veröffentlicht in der Fachzeitschrift Computer Methods in Applied Mechanics and Engineering (Band 436). Dieser Algorithmus, der von den einzigartigen Eigenschaften menschlicher Träume inspiriert ist, eröffnet neue Perspektiven für die Lösung komplexer Optimierungsprobleme, darunter auch die Feinabstimmung der Parameter von Handelssystemen.
DOA simuliert drei zentrale Aspekte des Schlafprozesses: die teilweise Gedächtniserhaltung, selektives Vergessen mit anschließender Ergänzung von Informationen sowie den Austausch von „Träumen“ zwischen den Agenten in der Population. Im Kontext des algorithmischen Handels ermöglichen diese Mechanismen ein Gleichgewicht zwischen der Exploration neuer Bereiche des Parameterraums und der Exploitation der gefundenen optimalen Lösungen, was bei der Optimierung von Handelsstrategien im Umfeld nichtstationärer Finanzmärkte von entscheidender Bedeutung ist.
In diesem Artikel werden wir die mathematischen Grundlagen des Algorithmus eingehend untersuchen, ihn in MQL5 implementieren und eine vergleichende Analyse mit anderen populationsbasierten Optimierungsmethoden durchführen.
Implementierung des Algorithmus
Wenn wir schlafen, erledigt unser Gehirn drei wichtige Aufgaben: Es speichert wichtige Informationen des Tages, vergisst unnötige Details und verbindet verschiedene Erinnerungen zu neuen Ideen.
DOA nutzt genau diese Prinzipien, um optimale Lösungen zu finden. Nach der Initialisierung wird die gesamte Population in mehrere Teams aufgeteilt. Jede Gruppe erhält ihren eigenen „Gedächtnisstil“ – von der ersten Gruppe mit dem besten Gedächtnis bis zur Gruppe mit der größten Vergesslichkeit, wobei jede Gruppe je nach Gruppennummer und Gesamtdimensionalität des Problems (D) eine unterschiedliche Anzahl von Dimensionen (k) verändert.
Während des größten Teils seiner Laufzeit befindet sich der Algorithmus in der Explorationsphase. Zunächst wendet jede Gruppe eine Gedächtnisstrategie an, bei der alle ihre Agenten an die von der Gruppe gefundene beste Position zurückgeführt werden; anschließend wird mit einer bestimmten Wahrscheinlichkeit eine Strategie des Vergessens und Hinzufügens angewendet. In diesem Fall werden „k“ zufällig ausgewählte Dimensionen mittels Kosinusmodulation gemäß der Formel cos((i+T/10)π/T) modifiziert, wodurch zu Beginn große Schritte entstehen, die dann allmählich abnehmen. Mit der verbleibenden Wahrscheinlichkeit greift die Tauschstrategie der Träume, bei der „k“ Dimensionen von einem zufällig ausgewählten Agenten aus der Population kopiert werden.
In der letzten Phase des Prozesses tritt der Algorithmus in die Exploitationsphase ein, in der alle Agenten auf die global beste Lösung zurückgesetzt werden und mit minimalen Schrittweiten eine Feinabstimmung vornehmen, dank der Kosinusfunktion cos(iπ/T), die am Ende der Optimierung gegen Null tendiert. Dadurch entsteht ein Gleichgewicht zwischen der Exploration des Suchraums durch den Gruppengedächtnis-Mechanismus und einer kurzfristigen, aber präzisen abschließenden Optimierung.
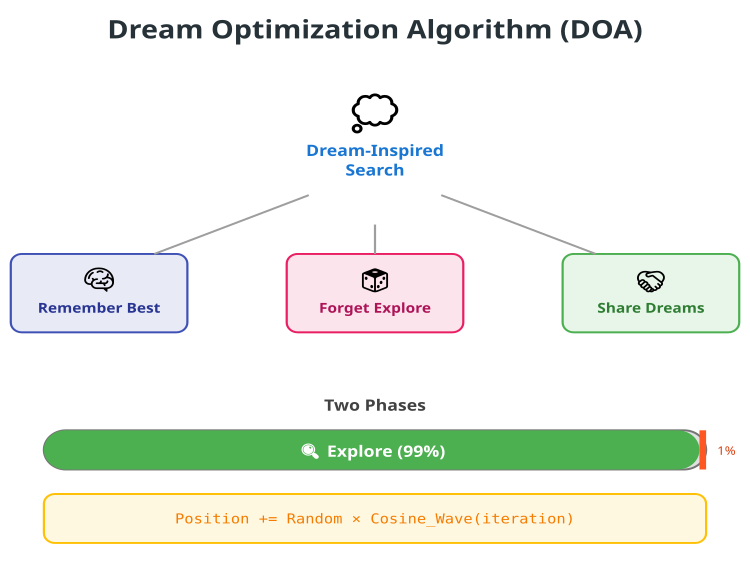
Abbildung 1. DOA-Algorithmus in Aktion
Das obige Bild zeigt das Strukturdiagramm des DOA-Algorithmus. Oben in der Mitte befindet sich eine Gedankenwolke mit der Aufschrift „Dream-Inspired Search“. Von ihr gehen drei Linien aus, die zu den drei Hauptstrategien des Algorithmus führen: Der blaue Block „Remember Best“ spiegelt die Gedächtnisstrategie wider, in der Mitte befindet sich der rosa Block „Forget Explore“, der die Strategie des Vergessens und der Exploration symbolisiert, und rechts ist der grüne Block „Share Dreams“, der die Tauschstrategie der Träume zwischen den Agenten repräsentiert.
Unterhalb dieser drei Strategien befindet sich der Abschnitt „Two Phases“, der die zeitliche Verteilung des Algorithmus als horizontalen Fortschrittsbalken darstellt, wobei der grüne Teil 99 % ausmacht und mit „Explore“ beschriftet ist, während der rote Balken auf der rechten Seite die restlichen 1 % ausmacht, wodurch das extreme Missverhältnis zwischen der Explorations- und der Exploitationsphase visuell hervorgehoben wird.
Ganz unten in der Abbildung ist die zentrale mathematische Formel des Algorithmus „Position += Random × Cosine_Wave(iteration)“ dargestellt, wodurch der technische Charakter und die Bedeutung der Kosinusmodulation für die Funktionsweise des DOA-Algorithmus hervorgehoben werden. Kommen wir nun zum Schreiben des Pseudocodes.
Initialisierung
START des DOA-Algorithmus
SETZE Parameter:
- Populationsgröße = 60 Agenten
- Anzahl der Gruppen = 6
- Explorationsanteil = 99 % der Gesamtzeit
- Vergessenswahrscheinlichkeit = 30 %
ERZEUGE 60 Agenten mit zufälligen Positionen im Suchraum
TEILE die Agenten in 6 gleich große Gruppen auf (jeweils 10)
INITIALISIERE die beste Lösung jeder Gruppe als die schlechtestmögliche
Hauptoptimierungsschleife
FÜR jede Iteration von 1 bis zum Maximum:
WENN Iteration <= 99 % der Gesamtiterationen:
FÜHRE die Explorationsphase aus
SONST:
FÜHRE die Exploitationsphase aus
Explorationsphase
FÜR jede Gruppe m von 1 bis 6:
FINDE den besten Agenten in Gruppe m
AKTUALISIERE die beste Gruppenlösung
BERECHNE die Anzahl der zu ändernden Dimensionen:
k_minimum = ceiling(D / 8 / m)
k_maximum = ceiling(D / 3 / m)
k = Zufallszahl zwischen k_minimum und k_maximum
Hinweis: Gruppe 1 ändert mehr Dimensionen (besseres Gedächtnis),
Gruppe 6 ändert weniger Dimensionen (vergisst mehr)
FÜR jeden Agenten j in Gruppe m:
SCHRITT 1 – Gedächtnisstrategie:
KOPIERE die Position des besten Agenten der Gruppe auf den aktuellen Agenten
(alle Agenten der Gruppe „erinnern“ sich an die beste gefundene Lösung)
SCHRITT 2 – Wähle k zufällige Dimensionen zur Modifikation aus
SCHRITT 3 – Vergessens- oder Tauschstrategie der Träume:
WENN Zufallszahl < 0,3 (30 % Wahrscheinlichkeit):
// Strategie des Vergessens und Hinzufügens
FÜR jede der k ausgewählten Dimensionen:
new_value = current + random × cosine_wave
wobei cosine_wave = (cos((iteration + T/10) × π / T) + 1) / 2
Hinweis: Die Kosinuswelle sorgt zu Beginn für größere Schritte,
gegen Ende der Optimierung für kleine Schritte
SONST (70 % Wahrscheinlichkeit):
// Tauschstrategie der Träume
FÜR jede der k ausgewählten Dimensionen:
KOPIERE den Wert eines zufällig ausgewählten Agenten aus der Population
(der Agent „träumt“ von der Lösung eines anderen Agenten)
PRÜFE und korrigiere die Grenzen für alle Dimensionen
Exploitationsphase
FÜR jeden Agenten j unter allen 60 Agenten:
SCHRITT 1 – Auf global beste Lösung zurücksetzen:
KOPIERE die global beste Lösung auf den aktuellen Agenten
(alle Agenten versammeln sich am gefundenen „Gipfel“)
SCHRITT 2 – Feinabstimmung:
BERECHNE die Anzahl der zu ändernden Dimensionen:
k = Zufallszahl zwischen 2 und maximum(2, ceiling(D/3))
WÄHLE k zufällige Dimensionen aus
FÜR jede der k ausgewählten Dimensionen:
new_value = current + random × cosine_wave
wobei cosine_wave = (cos(iteration × π / T) + 1) / 2
Hinweis: Am Ende des Algorithmus ist der Kosinuswert nahezu 0,
was sehr kleine Schritte ermöglicht
PRÜFE und korrigiere die Grenzen
Ergebnisse aktualisieren
NACH jeder Positionsänderung:
BERECHNE den Wert der Zielfunktion für jeden Agenten
AKTUALISIERE die global beste Lösung:
WENN eine bessere Lösung als die aktuell global beste gefunden wird:
SPEICHERE sie als neue global beste Lösung
Auch in der Explorationsphase:
AKTUALISIERE die besten Lösungen jeder Gruppe
ENDE der Iteration
Fangen wir damit an, den Code für den Algorithmus zu schreiben. Die Klasse wird den DOA-Optimierungsalgorithmus implementieren und von der Basisklasse C_AO (Schnittstelle für verschiedene Optimierungsalgorithmen) erben. Der Konstruktor und der Destruktor entsprechen dem Standard, wobei im Destruktor keine zusätzlichen Aktionen ausgeführt werden. Der Konstruktor legt die wichtigsten Parameter des Algorithmus und deren Werte fest und verknüpft sie zudem mit dem Parameterarray „params“, wodurch sich die Parameter von außen einfach verwalten lassen.
Hauptparameter- popSize – Populationsgröße, die Anzahl der möglichen Lösungen in jeder Iteration;
- numGroups – Anzahl der Gruppen, in die die Population für den parallelen Informationsaustausch unterteilt wird;
- explorationRate – Anteil der Iterationen, die der Explorationsphase zugewiesen werden, in der der Algorithmus nach neuen Bereichen des Suchraums sucht;
- forgettingProb – Wahrscheinlichkeit, die „Vergessensstrategie“ anzuwenden, mit der sich das Feststecken in lokalen Minima vermeiden lässt.
- SetParams () – legt Klassenparameter anhand des Arrays „params“ fest;
- Init () – Initialisierung des Algorithmus unter Angabe der Suchbereiche und der Anzahl der Epochen;
- Moving () – führt einen Optimierungsschritt durch;
- Revision () – überarbeitet und aktualisiert den aktuellen Zustand der Lösung.
- currentIteration, totalIterations, explorationIters – Iterationszähler und Phasengrenzen;
- groupBest [] – Array, in dem die besten Lösungen jeder Gruppe gespeichert werden, was den Informationsaustausch und die Weiterentwicklung der Lösungen erleichtert.
- ExplorationPhase () – zuständig für den explorativen Suchmodus, der den Suchhorizont erweitert;
- ExploitationPhase () – Phase, in der bereits gefundene gute Lösungen genutzt werden, um sie weiter zu verbessern;
- UpdateGroupBest () – aktualisiert die beste Lösung in einer bestimmten Gruppe;
- GetGroupStartIndex (), GetGroupEndIndex () – dienen zur Ermittlung der Bereiche der Lösungsindizes innerhalb jeder Gruppe.
Diese Klasse implementiert den DOA-Algorithmus, bei dem die Population in eine feste Anzahl von Gruppen aufgeteilt wird. Während der Iterationen teilt der Algorithmus seine Zeit zwischen der Explorationsphase (Suche nach neuen Lösungen) und der Exploitationsphase (Verbesserung der bereits gefundenen besten Lösungen) auf. Die Vergessensstrategie ermöglicht es dem Algorithmus, lokale Optima zu vermeiden. Der Grundgedanke besteht darin, ein Gleichgewicht zwischen der Exploration neuer Bereiche und der sorgfältigen Verbesserung bereits gefundener Lösungen sicherzustellen, was eine effektive globale Optimierung fördert.
//————————————————————————————————————————————————————————————————————
class C_AO_DOA_dream : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOA_dream () { }
  C_AO_DOA_dream ()
  {
    ao_name = "DOA";
    ao_desc = "Dream Optimization Algorithm";
    ao_link = "https://www.mql5.com/en/articles/19177";

    popSize              = 60;    // population size
    numGroups            = 6;     // number of groups (fixed in the original)
    explorationRate      = 0.99;  // iteration rate for the exploration phase (9/10 in the original)
    forgettingProb       = 0.3;   // probability of using the main forgetting strategy

    ArrayResize (params, 4);

    params [0].name = "popSize";           params [0].val = popSize;
    params [1].name = "numGroups";         params [1].val = numGroups;
    params [2].name = "explorationRate";   params [2].val = explorationRate;
    params [3].name = "forgettingProb";    params [3].val = forgettingProb;
  }

  void SetParams ()
  {
    popSize          = (int)params [0].val;
    numGroups        = (int)params [1].val;
    explorationRate  = params      [2].val;
    forgettingProb   = params      [3].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  int    numGroups;         // number of groups
  double explorationRate;   // iteration rate for the exploration phase
  double forgettingProb;    // probability of applying the main strategy

  private: //---------------------------------------------------------
  int    currentIteration;  // current iteration
  int    totalIterations;   // total number of iterations
  int    explorationIters;  // number of exploration iterations

  S_AO_Agent groupBest [];  // best solutions in each group

  void   ExplorationPhase      ();
  void   ExploitationPhase     ();
  void   UpdateGroupBest       (int groupNum);
  int    GetGroupStartIndex    (int groupNum);
  int    GetGroupEndIndex      (int groupNum);
};
//————————————————————————————————————————————————————————————————————
Die Initialisierungsmethode der Klasse C_AO_DOA_dream führt vorbereitende Operationen aus, um den Optimierungsalgorithmus zu starten. Sie legt die Anfangsparameter fest und richtet die für weitere Iterationen erforderlichen internen Zustände ein.
Zunächst wird eine allgemeine Initialisierungsmethode aufgerufen, die die Suchbereiche und Schrittweiten überprüft und festlegt, um sicherzustellen, dass die Parameter korrekt eingestellt sind. Sollte diese Überprüfung oder Konfiguration fehlschlagen, wird die Initialisierung abgebrochen.
Anschließend werden die Zähler gesetzt: Die aktuelle Iteration wird auf „0“ zurückgesetzt, die Gesamtzahl der Iterationen wird aus den übergebenen Parametern festgelegt, und die Anzahl der für die Exploration vorgesehenen Iterationen wird als Bruchteil der Gesamtzahl berechnet, wobei der angegebene Anteil (explorationRate) berücksichtigt wird.
Anschließend wird ein Array mit den besten Gruppenlösungen (groupBest) initialisiert, dessen Größe der Anzahl der Gruppen entspricht. Für jede Gruppe wird mithilfe der Methode Init eine Anfangslösung erstellt, und der Wert der Qualitätsfunktion dieser Lösung wird auf den kleinstmöglichen Zahlenwert gesetzt, um künftig einen korrekten Vergleich und eine korrekte Aktualisierung zu gewährleisten.
Nach der Ausführung dieser Methode ist der Algorithmus somit bereit, die Optimierung mit den festgelegten Parametern, Zählern und anfänglichen Gruppenlösungen zu starten.
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DOA_dream::Init (const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  currentIteration = 0;
  totalIterations  = epochsP;
  explorationIters = (int)(totalIterations * explorationRate);

  ArrayResize (groupBest, numGroups);
  for (int i = 0; i < numGroups; i++)
  {
    groupBest [i].Init (coords);
    groupBest [i].f = -DBL_MAX; // Initialize with the worst value
  }

  return true;
}
//————————————————————————————————————————————————————————————————————
Die Methode Moving ist der Hauptiterationsschritt des DOA-Algorithmus. Sie implementiert die Logik des Fortschritts des Algorithmus von einer Iteration zur nächsten. Zunächst wird der Zähler currentIteration erhöht, um den Fortschritt des Algorithmus zu verfolgen.
Erstinitialisierung (nur beim ersten Durchlauf). Das Flag „revision“ wird geprüft; ist es „false“ (d. h., der Algorithmus wird zum ersten Mal ausgeführt), wird die Population initialisiert; anschließend wird für jeden Agenten in der Population und für jede Koordinate des Agenten Folgendes ausgeführt:
- ein zufälliger Koordinatenwert wird mithilfe der Funktion u.RNDfromCI() innerhalb des vorgegebenen Bereichs (rangeMin und rangeMax) generiert;
- unter Berücksichtigung der Schrittweite (rangeStep) wird mithilfe der Funktion u.SeInDiSp() eine Anpassung dieses Werts vorgenommen; dadurch wird der Wert auf den nächstgelegenen zulässigen Wert (ein Vielfaches der Schrittweite) gebracht;
- nach der Initialisierung wird das Flag „revision“ auf „true“ gesetzt, um eine erneute Initialisierung in künftigen Iterationen zu vermeiden;
- an dieser Stelle schließt die Methode ihre Ausführung ab.
- es wird geprüft, ob sich die aktuelle Iteration in der Explorationsphase befindet (currentIteration <= explorationIters);
- Befindet sich die Iteration in der Explorationsphase, wird die Methode ExplorationPhase() aufgerufen;
- Andernfalls (wenn sich die Iteration in der Exploitationsphase befindet) wird die Methode ExploitationPhase() aufgerufen.
Somit steuert die Methode Moving den Optimierungsprozess, indem sie eine Initialisierung der Anfangspopulation vornimmt und anschließend anhand eines Iterationszählers zwischen der Explorations- und der Exploitationsphase wechselt. Die Initialisierung erfolgt nur einmal; danach durchläuft der Algorithmus eine Schleife, die bestimmt, welche Phase in der aktuellen Iteration ausgeführt werden soll.
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DOA_dream::Moving ()
{
  currentIteration++;

  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Determine the phase of the algorithm
  if (currentIteration <= explorationIters)
  {
    ExplorationPhase ();
  }
  else
  {
    ExploitationPhase ();
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode ExplorationPhase implementiert die Explorationsphase des DOA-Algorithmus. In dieser Phase werden die Lösungen für die Agentengruppen aktualisiert und diversifiziert, um neue mögliche Bereiche des Suchraums zu erschließen. Für jede Gruppe von Agenten wird die beste Lösung innerhalb der Gruppe aktualisiert, um das aktuell beste gefundene Ergebnis widerzuspiegeln. Anschließend wird die Anzahl der Dimensionen (Dimensionalität) für die Vergessensprozedur auf Grundlage der aktuellen Gruppennummer und der Gesamtzahl der Koordinaten bestimmt. Für jede Gruppe werden die Indizes des ersten und des letzten darin enthaltenen Agenten berechnet.
Anschließend wird für jeden Agenten innerhalb der Gruppe die beste Lösung der gesamten Gruppe in die aktuelle Lösung des Agenten kopiert (die Gedächtnisstrategie), wodurch eine „alte“, bewährte Lösung als Rückfalloption zur Verfügung steht. Es wird eine Liste von Dimensionen (Koordinaten) erstellt, die der Operation des „Vergessens“ und „Hinzufügens“ unterzogen werden. Das Array der Dimensionen wird gemischt, um zufällig auszuwählen, welche davon geändert werden sollen.
Für jeden Agenten in der Gruppe wird mit einer durch den Parameter forgettingProb festgelegten Wahrscheinlichkeit eine Strategie zur Aktualisierung der ausgewählten Dimensionen bestimmt; dabei kommt eine Vergessensstrategie mit Kosinusmodulation zum Einsatz.
Für die ausgewählten Dimensionen wird ein zufälliger Versatz innerhalb des Bereichs generiert. Die Kosinusmodulation hängt von der aktuellen Iteration und der Gesamtzahl der Iterationen ab, wodurch sich der Grad der Veränderung im Zeitverlauf steuern lässt. Nach der Aktualisierung wird der Dimensionswert unter Berücksichtigung der Schrittweiten in einen gültigen Bereich gebracht. Oder, falls das Szenario „Vergessen“ nicht ausgewählt wird, kommt die Tauschstrategie der Träume zur Anwendung. Die Dimensionswerte werden von einem zufällig ausgewählten anderen Agenten übernommen, was bedeutet, dass zwischen den Agenten Informationen ausgetauscht werden.
Dadurch fördert diese Phase die Exploration des Suchraums, erhöht die Vielfalt der Lösungen und trägt durch zufällige Änderungen und den Informationsaustausch zwischen den Agenten dazu bei, lokale Fallen zu vermeiden.
//————————————————————————————————————————————————————————————————————
//--- Exploration phase
void C_AO_DOA_dream::ExplorationPhase ()
{
  // Handle each group
  for (int m = 0; m < numGroups; m++)
  {
    // Update the best solution in the group
    UpdateGroupBest (m);

    // Calculate the number of dimensions to forget
    int kMin = (int)MathCeil ((double)coords / 8.0 / (m + 1));
    int kMax = (int)MathCeil ((double)coords / 3.0 / (m + 1));
    int k    = u.RNDintInRange (kMin, kMax);

    // Handle agents in the group
    int startIdx = GetGroupStartIndex (m);
    int endIdx   = GetGroupEndIndex   (m);

    for (int j = startIdx; j <= endIdx; j++)
    {
      // Memory strategy - reset to the best group solution
      ArrayCopy (a [j].c, groupBest [m].c, 0, 0, WHOLE_ARRAY);

      // Select random dimensions to forget
      int dims [];
      ArrayResize (dims, coords);
      for (int i = 0; i < coords; i++) dims [i] = i;

      // Shuffle the array of dimensions
      for (int i = coords - 1; i > 0; i--)
      {
        int idx    = u.RNDintInRange (0, i);
        int temp   = dims [i];
        dims [i]   = dims [idx];
        dims [idx] = temp;
      }

      // Strategy of forgetting and replenishment
      if (u.RNDprobab () < forgettingProb)
      {
        // Basic strategy with cosine modulation
        for (int h = 0; h < k; h++)
        {
          int    dim              = dims [h];
          double range            = rangeMax [dim] - rangeMin [dim];
          double randomValue      = u.RNDprobab () * range + rangeMin [dim];
          double cosineModulation = (MathCos ((1.0 * currentIteration + totalIterations / 10.0) * M_PI / totalIterations) + 1.0) / 2.0;

          a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
          a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
        }
      }
      else
      {
        // Dream sharing - copying from a random agent
        for (int h = 0; h < k; h++)
        {
          int dim   = dims [h];
          int donor = u.RNDintInRange (0, popSize - 1);
          a [j].c [dim] = a [donor].c [dim];
        }
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode ExploitationPhase implementiert die Exploitationsphase des Optimierungsalgorithmus. Ihre Hauptaufgabe besteht darin, die Suche auf die beste gefundene Lösung auszurichten, um die aktuellen Ergebnisse zu verbessern.
Für jeden Agenten in der Population wird die Lösung des Agenten auf die bisher gefundene global beste Lösung zurückgesetzt, wodurch man sich auf die vielversprechendsten Bereiche des Suchraums konzentrieren kann. Als Nächstes wird die Anzahl der zu verändernden Dimensionen (Dimensionalität) festgelegt. In der Regel werden mindestens zwei und höchstens ein bestimmter Höchstwert ausgewählt, der sich nach der Anzahl der Koordinaten richtet. Es wird eine Liste aller Dimensionen (Koordinaten) erstellt und anschließend zufällig durchmischt, um auszuwählen, welche davon geändert werden sollen. Für jede ausgewählte Dimension:
- der Variationsbereich dieser Dimension wird berechnet;
- ein Zufallswert wird innerhalb dieses Bereichs generiert;
- dieser Wert wird mithilfe einer Kosinusfunktion moduliert, die von der aktuellen Iterationsnummer und der Gesamtzahl der Iterationen abhängt, wodurch sich der Einfluss der Änderungen im Zeitverlauf steuern lässt;
- infolgedessen ändert sich der Dimensionswert unter Berücksichtigung des generierten Werts und der Kosinusmodulation;
- anschließend wird der Wert unter Berücksichtigung der Diskretisierungsschrittweite in den zulässigen Bereich gebracht, damit die Lösung gültig bleibt.
Das Ziel dieser Methode besteht darin, die bereits gefundenen guten Lösungen durch zufällige und kontrollierte Modifikationen weiter zu verfeinern, wodurch ein günstigerer Bereich des Suchraums erreicht und bessere Lösungen erzielt werden können.
//————————————————————————————————————————————————————————————————————
//--- Exploitation phase
void C_AO_DOA_dream::ExploitationPhase ()
{
  // In the exploitation phase, all agents move towards the global best
  for (int j = 0; j < popSize; j++)
  {
    // Reset to global best solution
    ArrayCopy (a [j].c, cB, 0, 0, WHOLE_ARRAY);

    // Calculate the number of dimensions to modify
    int km = MathMax (2, (int)MathCeil ((double)coords / 3.0));
    int k = u.RNDintInRange (2, km);

    // Select random dimensions
    int dims [];
    ArrayResize (dims, coords);
    for (int i = 0; i < coords; i++) dims [i] = i;

    // Shuffle the array of dimensions
    for (int i = coords - 1; i > 0; i--)
    {
      int idx = u.RNDintInRange (0, i);
      int temp = dims [i];
      dims [i] = dims [idx];
      dims [idx] = temp;
    }

    // Apply the forgetting and addition strategy
    for (int h = 0; h < k; h++)
    {
      int dim = dims [h];
      double range = rangeMax [dim] - rangeMin [dim];

      double randomValue = u.RNDprobab () * range + rangeMin [dim];
      double cosineModulation = (MathCos (currentIteration * M_PI / totalIterations) + 1.0) / 2.0;

      a [j].c [dim] = a [j].c [dim] + randomValue * cosineModulation;
      a [j].c [dim] = u.SeInDiSp (a [j].c [dim], rangeMin [dim], rangeMax [dim], rangeStep [dim]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „UpdateGroupBest“ dient dazu, die beste Lösung innerhalb einer bestimmten Gruppe von Agenten zu ermitteln. Ihre wichtigsten Schritte sind:
- Ermittlung der Indizes der Start- und Endpositionen der Agenten, die zu einer bestimmten Gruppe gehören;
- Durchlaufen aller Agenten in der angegebenen Gruppe;
- Für jeden Agenten wird der Wert der Bewertungsfunktion (die Metrik für die Lösungsqualität) mit dem aktuell besten Wert verglichen, der für die Gruppe gespeichert ist;
- Wenn ein Agent eine Lösung mit dem besten Wert der Fitnessfunktion findet, aktualisiert er den Eintrag der besten Lösung in der Gruppe und ersetzt ihn durch die beste Lösung.
Somit liefert die Methode aktuelle Informationen über die beste Lösung innerhalb jeder Gruppe, was für weitere Schritte des Algorithmus, wie beispielsweise die Suchstrategie und die Aktualisierung von Lösungen, von Bedeutung ist.
//————————————————————————————————————————————————————————————————————
//--- Update the best solution in the group
void C_AO_DOA_dream::UpdateGroupBest (int groupNum)
{
  int startIdx = GetGroupStartIndex (groupNum);
  int endIdx   = GetGroupEndIndex (groupNum);

  for (int i = startIdx; i <= endIdx; i++)
  {
    if (a [i].f > groupBest [groupNum].f)
    {
      groupBest [groupNum].f = a [i].f;
      ArrayCopy (groupBest [groupNum].c, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „GetGroupStartIndex“ dient zur Berechnung des Startindexes der Elemente, die in der angegebenen Gruppe im Array der Lösungen oder Agenten enthalten sind. Sie basiert auf Berechnungen, bei denen von einer gleichmäßigen Verteilung der Gruppen über das gesamte Array ausgegangen wird. Die Grundidee besteht darin, die Position des ersten Agenten (bzw. Elements) in einer bestimmten Gruppe anhand der Gruppennummer, der Gesamtzahl der Gruppen und der Gesamtgröße der Population zu bestimmen.
Dazu wird die Gruppennummer mit der Gesamtgröße der Population multipliziert und durch die Anzahl der Gruppen dividiert, wodurch sich der Index des ersten Elements innerhalb einer bestimmten Gruppe ergibt. Dieser Ansatz gewährleistet eine gleichmäßige Aufteilung der Daten in Gruppen und eignet sich gut für weitere Operationen im Zusammenhang mit der Gruppierung von Lösungen.
//————————————————————————————————————————————————————————————————————
//--- Get the starting index of the group
int C_AO_DOA_dream::GetGroupStartIndex (int groupNum)
{
  return (int)((double)groupNum * popSize / numGroups);
}
//————————————————————————————————————————————————————————————————————
Die Methode GetGroupEndIndex berechnet den Endindex der Elemente, die zur angegebenen Gruppe gehören. Sie ermittelt das letzte Element einer Gruppe anhand der Gruppennummer, der Gesamtgröße der Population und der Anzahl der Gruppen. Die Berechnung erfolgt, indem die um eins erhöhte Gruppennummer mit der Gesamtgröße der Population multipliziert und durch die Anzahl der Gruppen dividiert wird. Der resultierende Wert wird anschließend um eins verringert, um den Index des letzten Elements in der Gruppe zu ermitteln.
Es ist eine zusätzliche Prüfung erforderlich, um einen Zugriff außerhalb der Array-Grenzen zu verhindern: Wenn der berechnete Index die Größe der Population überschreitet, wird er auf den Wert des letzten gültigen Index gesetzt. Dieser Ansatz stellt sicher, dass die Grenzen jeder Agentengruppe in der Population korrekt definiert sind.
//————————————————————————————————————————————————————————————————————
//--- Get the ending index of the group
int C_AO_DOA_dream::GetGroupEndIndex (int groupNum)
{
  int endIdx = (int)((double)(groupNum + 1) * popSize / numGroups) - 1;
  if (endIdx >= popSize) endIdx = popSize - 1;
  return endIdx;
}
//————————————————————————————————————————————————————————————————————
Die Methode Revision dient dazu, Informationen über die beste Lösung zu aktualisieren, die während des Algorithmuslaufs gefunden wurde. Zunächst durchläuft sie alle Lösungen der aktuellen Population. Innerhalb der Schleife wird für jede Lösung der Wert ihrer Zielfunktion überprüft. Ist dieser Wert größer als der aktuelle Bestwert, wird fB auf den Wert der Zielfunktion der aktuellen Lösung aktualisiert, und die aktuelle Lösung wird zur besten Lösung.
Die Methode prüft anschließend, ob die aktuelle Iteration in der Explorationsphase (explorationIters) liegt; ist dies der Fall, berücksichtigt die Methode neben der Aktualisierung der global besten Lösung auch die besten Lösungen, die innerhalb jeder Gruppe gefunden wurden. Dazu durchläuft die Schleife alle Gruppen, und für jede Gruppe wird der Wert der Zielfunktion der besten Lösung in dieser Gruppe mit dem aktuellen Bestwert verglichen.
Ist die Lösung innerhalb der Gruppe besser, wird fB aktualisiert und die Lösung aus groupBest in den globalen Puffer cB kopiert. Somit überwacht und aktualisiert die Methode Revision kontinuierlich die Informationen über die beste gefundene Lösung in Abhängigkeit von der aktuellen Phase des Algorithmus (Exploration oder Exploitation) und stellt so sicher, dass die zum aktuellen Zeitpunkt beste gefundene Lösung erhalten bleibt.
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DOA_dream::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }

  // Update the best solutions of groups in the exploration phase
  if (currentIteration <= explorationIters)
  {
    for (int m = 0; m < numGroups; m++)
    {
      if (groupBest [m].f > fB)
      {
        fB = groupBest [m].f;
        ArrayCopy (cB, groupBest [m].c, 0, 0, WHOLE_ARRAY);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
Testergebnisse
Nachdem wir nun den DOA-Algorithmus implementiert haben, können wir direkt mit dem Testen anhand von Testfunktionen fortfahren. Wie Sie sehen können, erzielte der DOA-Algorithmus 53,62 % und wird in unsere Bewertungstabelle aufgenommen.
=============================
5 Hilly's; Func runs: 10000; result: 0.8555594031110225
25 Hilly's; Func runs: 10000; result: 0.7008493263471764
500 Hilly's; Func runs: 10000; result: 0.37279821121874124
=============================
5 Forest's; Func runs: 10000; result: 0.7342194493052585
25 Forest's; Func runs: 10000; result: 0.48905397049976357
500 Forest's; Func runs: 10000; result: 0.24146681094197792
=============================
5 Megacity's; Func runs: 10000; result: 0.7723076923076921
25 Megacity's; Func runs: 10000; result: 0.4735384615384616
500 Megacity's; Func runs: 10000; result: 0.18561538461538593
=============================
All score: 4.82541 (53.62%)
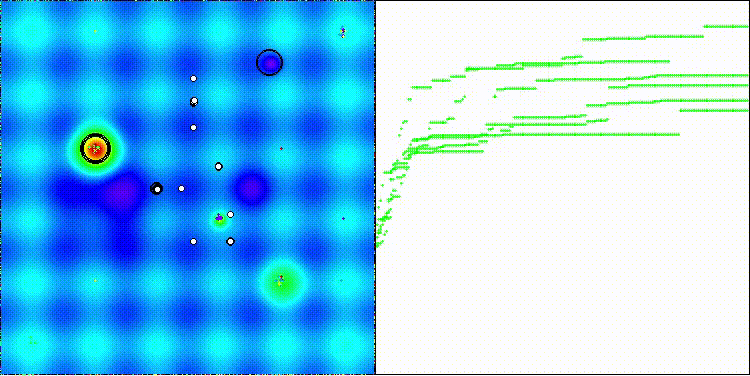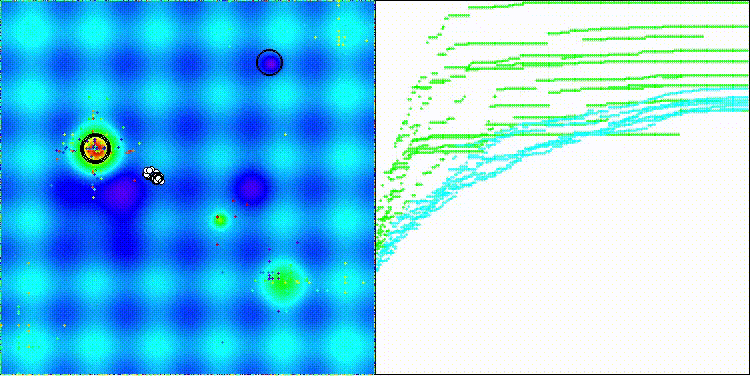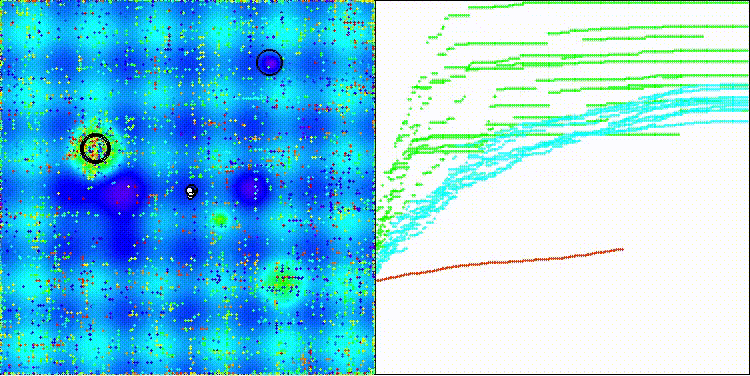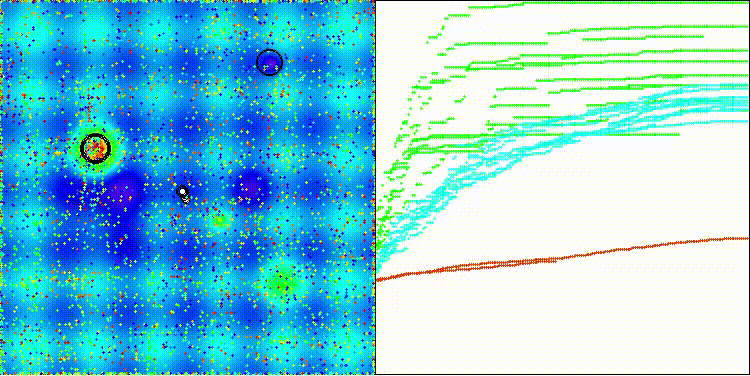
Die Visualisierung der Performance des DOA-Algorithmus bei kleinen Dimensionen (grüne Linien) zeigt eine Streuung der Ergebnisse, insbesondere bei den Funktionen „Forest“ und „Megacity“.
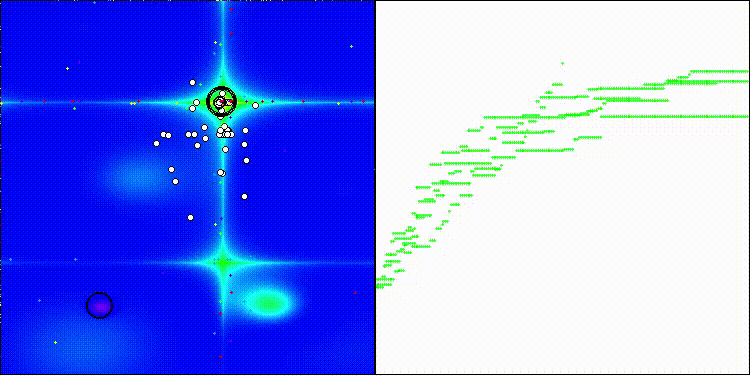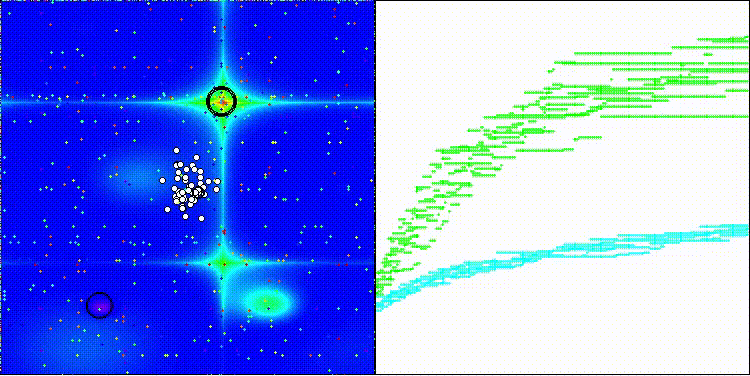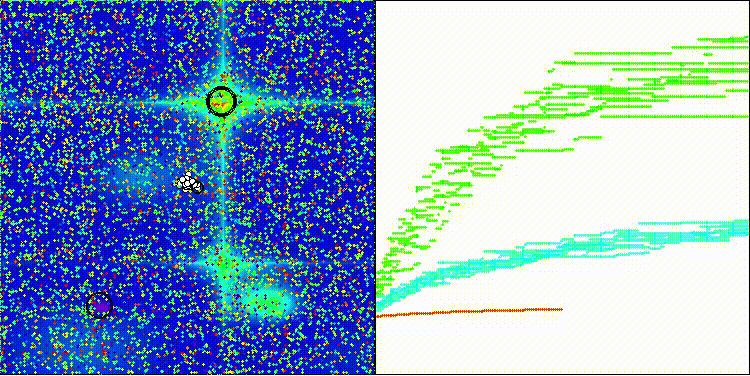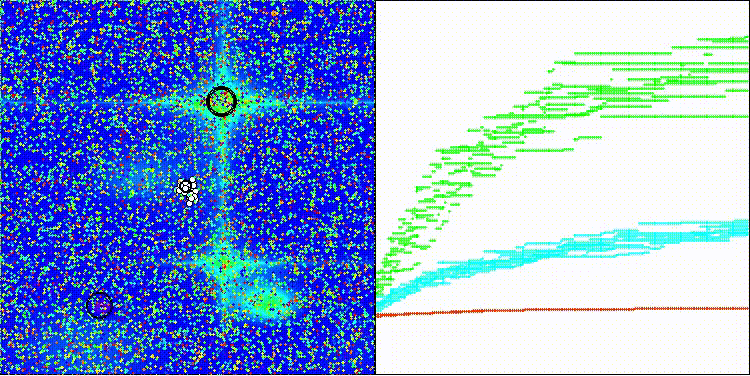
DOA mit der Testfunktion Hilly
DOA mit der Testfunktion Forest
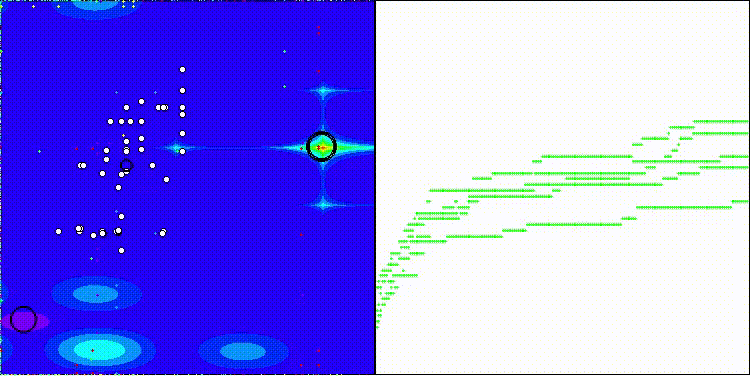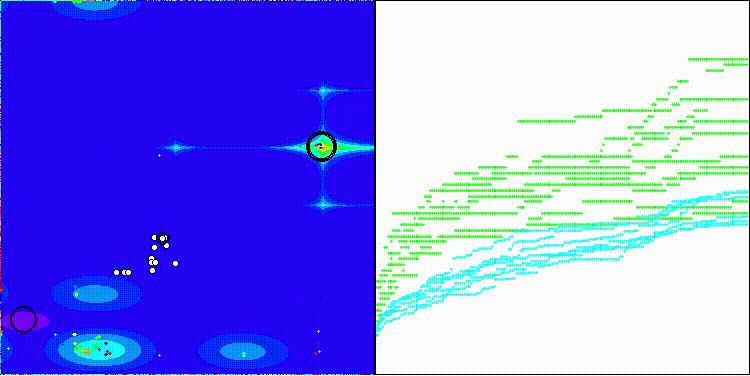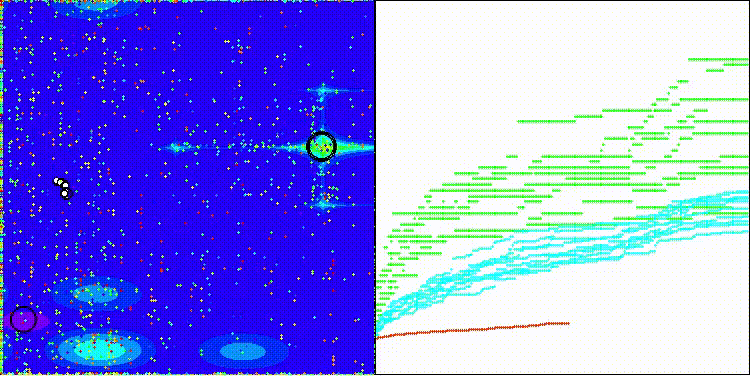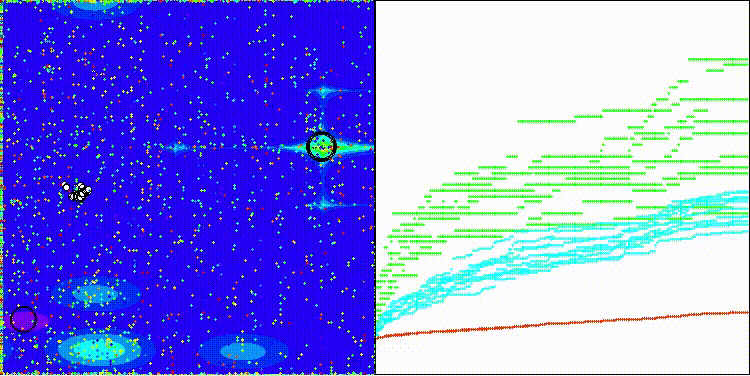
DOA mit der Testfunktion Megacity
Auf Grundlage der Testergebnisse belegt der DOA-Algorithmus Platz 26 in der Gesamtwertung der populationsbasierten Optimierungsalgorithmen.
| # | AO | Beschreibung | Hilly | Hilly Final | Forest | Forest Final | Megacity (diskret) | Megacity Final | Final Result | % von MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | nachbarschaftsübergreifende Suche | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 2 | CLA | Codeschloss-Algorithmus (joo) | 0,95345 | 0,87107 | 0,37590 | 2.20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6.107 | 67,86 |
| 3 | AMOm | Optimierung der Tiermigration M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 4 | (P+O)ES | (P+O)-Evolutionsstrategien | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 5 | CTA | Kometenschweif-Algorithmus (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5.846 | 64,96 |
| 6 | TETA | Algorithmus der zeitlichen Entwicklung und Bewegung (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5.797 | 64,41 |
| 7 | SDSm | Stochastische Diffusionssuche M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 8 | BOAm | Billard-Optimierungsalgorithmus M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| 9 | AAm | Bogenschieß-Algorithmus M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5.548 | 61,64 |
| 10 | ESG | Entwicklung sozialer Gruppen (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| 11 | SIA | simuliertes isotropes Tempern (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 12 | EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| 13 | BBO | biogeografiebasierte Optimierung | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 14 | ACS | künstliche kooperative Suche | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 15 | DA | dialektischer Algorithmus | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 16 | BHAm | Black-Hole-Algorithmus M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 17 | ASO | Anarchy-Society-Optimierung | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 18 | RFO | Royal-Flush-Optimierung (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 19 | AOSm | Atomorbital-Suche M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 20 | TSEA | Turtle-Shell-Evolution-Algorithmus (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 21 | BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4.959 | 55,10 |
| 22 | DE | Differential Evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 23 | SRA | Successful Restaurateur Algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 24 | CRO | Chemical Reaction Optimization | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4.892 | 54,36 |
| 25 | BIO | Blood Inheritance Optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 26 | DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4,825 | 53,62 |
| 27 | BSA | Bird Swarm Algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1.12012 | 4,809 | 53,44 |
| 28 | DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4.762 | 52,91 |
| 29 | HS | Harmony Search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 30 | SSG | Saplings Sowing and Growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 31 | BCOm | Bacterial Chemotaxis Optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4.649 | 51,65 |
| 32 | ABO | African Buffalo Optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 33 | (PO)ES | (PO)-Evolutionsstrategien | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4.610 | 51,22 |
| 34 | FBA | Fraktalbasierter Algorithmus | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 35 | TSm | Tabu-Suche M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4.536 | 50,40 |
| 36 | BSO | Brainstorm-Optimierung | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 37 | WOAm | Wal-Optimierungsalgorithmus M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 38 | AEFA | Algorithmus künstlicher elektrischer Felder | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4.459 | 49,55 |
| 39 | AEO | Optimierungsalgorithmus auf Basis künstlicher Ökosysteme | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 40 | CAm | Kamel-Algorithmus M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 41 | ACOm | Ameisenkolonie-Optimierung M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 42 | CMAES | Kovarianzmatrix-Adaptions-Evolutionsstrategie | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| 43 | DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| 44 | BFO-GA | Bacterial Foraging Optimization - GA | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| 45 | SOA | einfacher Optimierungsalgorithmus | 0,91520 | 0,46976 | 0,27089 | 1,65585 | 0,89675 | 0,37401 | 0,16984 | 1,44060 | 0,69538 | 0,28031 | 0,10852 | 1,08422 | 4,181 | 46,45 |
| RW | Random Walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26.09 | |
Zusammenfassung
Der Dream Optimization Algorithm (DOA) zeigt eine angemessene Leistung: In den durchgeführten Tests erreichte er 53,62 % von möglichen 100 % und sicherte sich damit einen Platz in unserer Rangliste.
Die Analyse der Ergebnisse zeigt ein Muster, das für viele metaheuristische Algorithmen charakteristisch ist: einen deutlichen Leistungsabfall bei zunehmender Dimensionalität des Problems. Bei niedrigdimensionalen Problemen erzielt DOA Ergebnisse im Bereich von 73–86 %, doch beim Übergang zu hochdimensionalen Problemen sinkt die Effizienz innerhalb einer begrenzten Anzahl von Iterationen auf 18–37 %.
Insgesamt liegt der Algorithmus im Mittelfeld der untersuchten Optimierungsmethoden. Interessierte können mit den Algorithmuseinstellungen experimentieren; vielleicht gibt es noch Potenzial, bessere Ergebnisse zu erzielen.
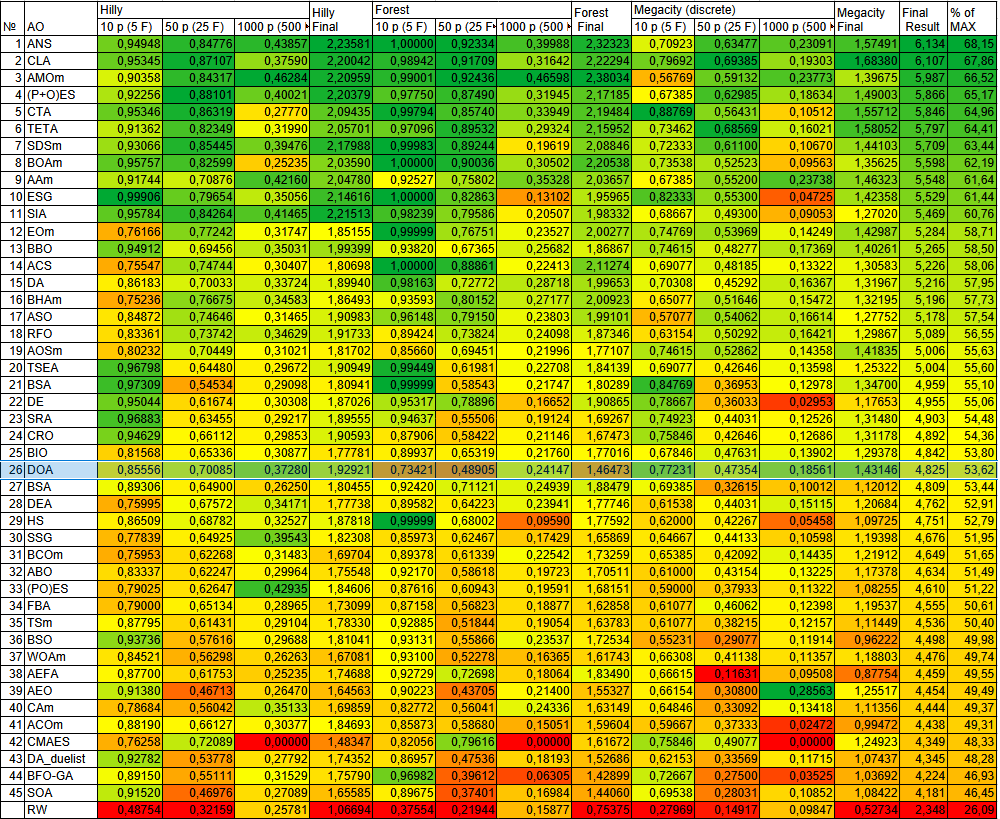
Abbildung 2. Farbabstufung der Algorithmen über die entsprechenden Tests hinweg
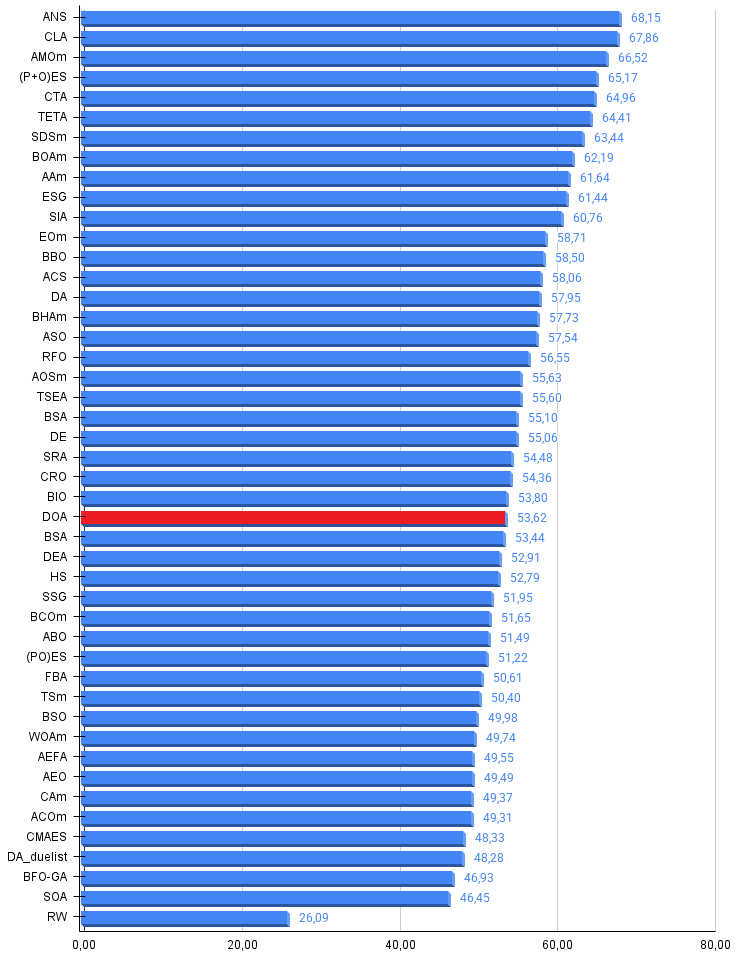
Abbildung 3. Histogramm der Testergebnisse des Algorithmus (Skala von 0 bis 100, je höher, desto besser; wobei 100 das maximal mögliche theoretische Ergebnis darstellt; im Archiv befindet sich ein Skript zur Berechnung der Bewertungstabelle)
Vor- und Nachteile des DOA:
Vorteile:
- Einfache Umsetzung.
- Schnell.
Nachteile:
- Hohe Varianz bei niedrigdimensionalen Testfunktionen.
Dem Artikel ist ein Archiv mit den neuesten Versionen des Algorithmuscodes beigefügt. Der Autor des Artikels übernimmt keine Gewähr für die absolute Richtigkeit der Beschreibung der kanonischen Algorithmen. An vielen von ihnen wurden Änderungen vorgenommen, um die Suchfähigkeiten zu verbessern. Die in den Artikeln dargelegten Schlussfolgerungen und Einschätzungen basieren auf den Ergebnissen der Experimente.
Im Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | #C_AO.mqh | Include | Basisklasse für populationsbasierte Optimierungsalgorithmen |
| 2 | #C_AO_enum.mqh | Include | Enumeration populationsbasierter Optimierungsalgorithmen |
| 3 | TestFunctions.mqh | Include | Bibliothek mit Testfunktionen |
| 4 | TestStandFunctions.mqh | Include | Funktionsbibliothek für den Teststand |
| 5 | Utilities.mqh | Include | Bibliothek mit Hilfsfunktionen |
| 6 | CalculationTestResults.mqh | Include | Skript zur Berechnung der Ergebnisse in der Vergleichstabelle |
| 7 | Testing AOs.mq5 | Skript | Der einheitliche Teststand für alle populationsbasierten Optimierungsalgorithmen |
| 8 | Simple use of population optimization algorithms.mq5 | Skript | Ein einfaches Beispiel für die Verwendung populationsbasierter Optimierungsalgorithmen ohne Visualisierung |
| 9 | Test_AO_DOA.mq5 | Skript | DOA-Teststand |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19177
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Marktsimulation: Positionsanzeige (VII)
 Neuronale Netze im Trading: Das Temporal-Query-Modell (Fazit)
 Neuronale Netze im Trading: Heterogenitätsbasiertes Lernen von Metaparametern (HimNet)
 Neuronale Netze im Trading: Das Temporal-Query-Modell (TQNet)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.