

Estrategia del águila — Eagle Strategy (ES)
 21
 0

Índice
Introducción
En el mundo de la programación, especialmente en el desarrollo de asesores expertos de trading, una optimización eficaz desempeña un papel fundamental. Las tareas altamente especializadas que consisten en buscar la solución óptima entre un enorme conjunto de opciones posibles requieren el uso de algoritmos avanzados. Los métodos tradicionales de optimización suelen resultar ineficaces, ya que se quedan atascados en extremos locales y no encuentran la mejor solución global.
En este sentido, cada vez se presta más atención a los algoritmos metaheurísticos, inspirados en la propia naturaleza, métodos que han experimentado una evolución natural. Estos algoritmos son capaces de encontrar soluciones buenas y, a menudo, cercanas a las óptimas, incluso en problemas en los que la velocidad de cálculo es de vital importancia.
En un contexto de búsqueda constante de soluciones para problemas cada vez más complejos y que requieren muchos recursos, hoy analizaremos otro intento prometedor: el algoritmo Eagle Strategy (ES). Este algoritmo, inspirado en el comportamiento de caza del águila, constituye una nueva metaheurística diseñada para resolver problemas de optimización mediante la imitación de la estrategia de búsqueda visual y persecución dinámica de la presa.
Implementación del algoritmo
Imagine un águila real que planea a gran altura en busca de una presa. Su estrategia de caza es sorprendentemente eficaz y consta de dos fases bien definidas: primero vuela a gran altura, inspeccionando un territorio enorme con movimientos caóticos en zigzag, y luego, al avistar a su presa, se lanza en picado a gran velocidad, concentrando todos sus esfuerzos en una presa concreta. Precisamente esta sabiduría natural sirvió de base para el algoritmo Eagle Strategy (Estrategia del águila), desarrollado en 2010 para resolver problemas complejos de optimización.
En la primera etapa, el algoritmo utiliza los denominados «vuelos de Lévy», un modelo matemático que describe el movimiento en el espacio. A diferencia de la caminata aleatoria habitual, en la que los pasos son más o menos iguales, el vuelo de Lévy consiste en una sucesión de pequeños pasos intercalados con saltos poco frecuentes, pero muy largos.
Cuando el algoritmo encuentra una zona prometedora (como un águila que ha avistado a su presa), se activa la segunda fase: una búsqueda local intensiva mediante el algoritmo de las luciérnagas (Firefly), un algoritmo muy conocido que ya hemos analizado en uno de nuestros artículos. Varios agentes de búsqueda, como luciérnagas en la noche, se sienten atraídos por los vecinos más brillantes (exitosos). El brillo de una luciérnaga se corresponde con la calidad de la solución que ha encontrado, y su fuerza de atracción disminuye con la distancia siguiendo una ley exponencial. Esto crea un equilibrio entre la exploración de los entornos y el avance hacia la mejor solución conocida.
La innovación clave del ES radica en la alternancia cíclica de estos dos modos. Tras una búsqueda local intensiva, el algoritmo vuelve a pasar a la exploración global, dando un gran salto hacia una nueva zona inexplorada del espacio de búsqueda. Esto evita la convergencia prematura y permite encontrar el óptimo global incluso en paisajes muy complejos con numerosos extremos locales.
Los parámetros del algoritmo son intuitivos y fáciles de configurar. El tamaño de la población determina el número de agentes que exploran simultáneamente; el parámetro de Lévy controla la relación entre los saltos cortos y los largos, el radio de la hiperesfera define el área de búsqueda local intensiva, y el coeficiente de aleatorización añade un elemento de azar para salir de situaciones sin salida. Esta flexibilidad permite adaptar el algoritmo a una tarea concreta sin necesidad de tener un conocimiento profundo de la teoría matemática.
La filosofía del algoritmo ES es sencilla y elegante: una visión global combinada con precisión local. Del mismo modo que el águila combina un vuelo de reconocimiento con un ataque certero, el algoritmo busca el equilibrio entre la exploración de áreas desconocidas y la explotación de las soluciones prometedoras que encuentra.
Las características clave del algoritmo son: el cambio automático entre fases cuando mejora la solución, los parámetros adaptativos (λ disminuye en caso de estancamiento, el tamaño del paso se reduce con el tiempo) y el equilibrio entre la exploración de nuevas áreas y la explotación de las soluciones encontradas.
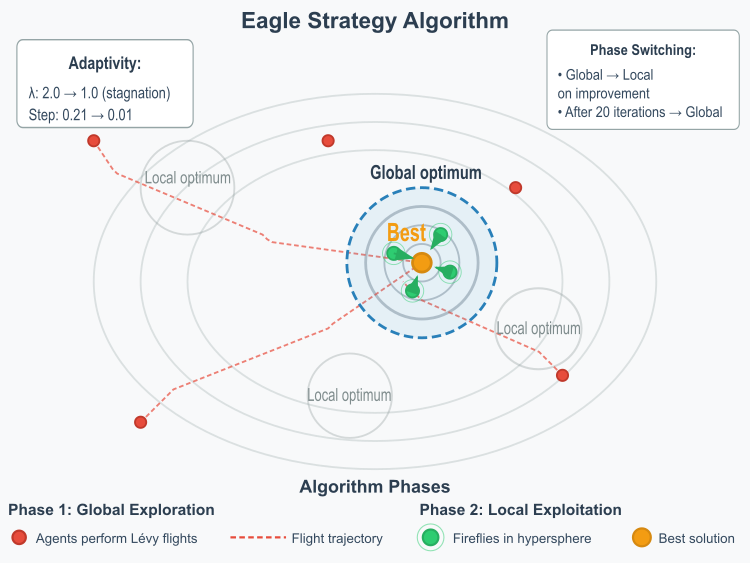
Figura 1. Ilustración del funcionamiento del algoritmo ES
La ilustración muestra las dos fases de funcionamiento del algoritmo: las trayectorias de los vuelos de Lévy (líneas rojas punteadas), la hiperesfera de búsqueda local (círculo azul), el movimiento de las luciérnagas dentro de la esfera (puntos verdes con halos) y las líneas de contorno de la función de optimización.
Pasemos a escribir el pseudocódigo del algoritmo.
INICIALIZACIÓN:
1. Crear una población de agentes con posiciones aleatorias
2. Establecer el indicador de búsqueda global (fase = global)
3. Inicializar los contadores de estancamiento y progreso
CICLO PRINCIPAL (hasta que se cumpla el criterio de parada):
SI (fase = global):
PARA cada agente:
- generar un paso de Lévy utilizando el algoritmo de Mantegna
- calcular la escala adaptativa del paso (mayor al principio, menor al final)
- actualizar la posición: nueva_posición = posición_actual + paso de Lévy × escala
- aplicar las restricciones de contorno
SI (se ha encontrado una mejora del mejor global):
- Cambiar a la fase local
- Encontrar al mejor agente como centro de la búsqueda local
- Reiniciar el contador de estancamiento
SINO:
- Aumentar el contador de estancamiento
- SI (estancamiento > 5 iteraciones):
- Reducir el parámetro λ para vuelos más agresivos
SINO (fase = local):
Con una probabilidad del 80 %:
- Determinar los agentes en la hiperesfera de radio 0,1 alrededor del mejor
- SI (agentes < 5):
- Seleccionar los 5 vecinos más cercanos o el 30 % de la población
PARA cada agente del grupo local:
PARA cada uno de los demás agentes del grupo:
SI (el otro agente es mejor):
- calcular el atractivo β = β₀ × exp(-γ × distancia²)
- desplazar al agente: posición += β × (mejor - actual) + ruido_aleatorio
Con una probabilidad del 20 %:
- Copiar parcialmente las coordenadas del mejor global en agentes aleatorios
- Incrementar el contador de iteraciones locales
- SI (se han realizado 20 iteraciones locales):
- Volver a la fase global
- Restaurar el parámetro original λ
ACTUALIZACIÓN:
PARA cada agente:
- calcular la aptitud (fitness)
- actualizar el mejor personal
- actualizar el mejor global
En esta implementación del algoritmo ES, para generar números con distribución de Lévy se emplea un método numérico: el algoritmo de Mantegna, propuesto por R. N. Mantegna en 1994 y se convirtió en el método estándar para simular los vuelos de Lévy en los algoritmos de optimización. Mantegna demostró matemáticamente que la relación entre dos magnitudes gaussianas escaladas específicamente da lugar a una distribución muy similar a la distribución de Lévy para un rango de valores relevante en aplicaciones prácticas. Su esencia consiste en lo siguiente:
// Cálculo de sigma para el algoritmo de Mantegna
double numerator   = Gamma(1.0 + lambda) * MathSin(M_PI * lambda / 2.0);
double denominator = Gamma((1.0 + lambda) / 2.0) * lambda * MathPow(2.0, (lambda - 1.0) / 2.0);
double sigma = MathPow(numerator / denominator, 1.0 / lambda);

// Generación de u y v a partir de distribuciones normales
double u_val = GenerateGaussian() * sigma;
double v_val = MathAbs(GenerateGaussian());

// Cálculo del paso de Lévy
levyStep[c] = u_val / MathPow(v_val, 1.0 / lambda);
Tomemos dos variables aleatorias:
- u: procedente de una distribución normal N(0, σ²)
- v: procedente de una distribución normal N(0, 1)
σ = [Γ(1+λ) × sin(πλ/2) / (Γ((1+λ)/2) × λ × 2^((λ-1)/2))]^(1/λ)
donde Γ es la función gamma y λ es el parámetro de la distribución de Lévy (1 < λ ≤ 3).
Es importante señalar que, al definir la función gamma (para calcular el parámetro σ en el método de Mantegna), se utiliza la aproximación de Lanczos, un método numérico de alta precisión para calcular la función gamma. Es una de las formas más eficaces de calcular Γ(z) y, en el código, se implementa mediante una función independiente, que analizaremos al final.
La fórmula principal es la siguiente:
Γ(z+1) = √(2π) × ((z+g+0.5)^(z+0.5)) × e^(-(z+g+0.5)) × Ag(z)
donde: g es un parámetro (normalmente 7); Ag(z) es una serie con coeficientes calculados previamente que, para g = 7 y 9 coeficientes, ofrece una precisión de aproximadamente 15 cifras significativas.
Para z < 0,5 se utiliza la relación de la fórmula de reflexión, lo que permite calcular la función gamma para todos los números reales:
Γ(z) × Γ(1-z) = π / sin(πz)
Sin un cálculo eficaz de la función gamma, la generación de vuelos de Lévy sería computacionalmente costosa, lo que ralentizaría considerablemente todo el algoritmo de optimización.
Paso de Lévy final:
step = u / |v|^(1/λ) El algoritmo genera una secuencia de pasos con un comportamiento característico de los vuelos de Lévy: muchos pasos pequeños (exploración local), saltos poco frecuentes pero muy grandes (exploración global) y una ley de potencias para la distribución de las longitudes de los pasos.
Las ventajas de este método son la sencillez de la solución —puesto que solo se necesita un generador de distribución normal— y la estabilidad, es decir, la robustez numérica del algoritmo. Es precisamente esta propiedad la que hace que los vuelos de Lévy sean eficaces para la optimización: proporcionan un equilibrio óptimo entre la exploración detallada de las áreas locales y la transición rápida a nuevas regiones del espacio de búsqueda.
Tras analizar en detalle los métodos utilizados en el algoritmo ES, podemos pasar directamente a escribir la clase «C_AO_ES», que representa la implementación del método de optimización basado en la estrategia de caza del águila y hereda de la clase base «C_AO». El método utiliza un enfoque en dos fases: primero se lleva a cabo una búsqueda global para identificar áreas potencialmente prometedoras y, a continuación, una búsqueda local dentro de la parte seleccionada del espacio de búsqueda para refinar el resultado.
El tamaño de la población «popSize» determina el número de soluciones «candidate» que participan en la búsqueda. El parámetro de Lévy «lambda» controla la distribución de los pasos aleatorios. El radio de la hiperesfera «sphereRadius» define el área de búsqueda local. El número de iteraciones de la búsqueda local «localIterations» indica cuántas veces se refina la solución dentro de la hiperesfera. Los parámetros de aleatorización «alpha» y de atracción «beta0» regulan los componentes de los modelos de búsqueda, como los movimientos aleatorios y la influencia de la «luz» (en términos metafóricos).
La fase de exploración global (GlobalExploration) se centra en la búsqueda de áreas «prometedoras» en todo el espacio de búsqueda, utilizando pasos aleatorios generados según la distribución de Lévy. Este enfoque favorece una búsqueda de amplio alcance y la escalabilidad en espacios de gran tamaño.
La fase de explotación local (LocalExploitation) realiza una búsqueda más exhaustiva dentro de la hiperesfera que rodea el punto seleccionado. En este caso se utilizan pasos más pequeños y precisos, propios de la optimización local.
La generación de pasos de Lévy (GenerateLevyStep) crea movimientos aleatorios según la distribución de Lévy, lo que permite saltos tanto pequeños como grandes en el espacio de búsqueda para equilibrar la exploración y la explotación.
La clase contiene mecanismos para realizar un seguimiento del progreso de la búsqueda, como el almacenamiento de la mejor solución encontrada, contadores de estancamiento (si la solución no mejora), así como bucles por épocas para limitar la ejecución del algoritmo por tiempo o iteraciones, cálculos de los parámetros de las distribuciones para los pasos aleatorios —en particular, la generación de distribuciones gaussianas y de Lévy— y métodos para gestionar las fases de búsqueda, lo que permite alternar entre la etapa global y la local, así como controlar su ejecución.
En resumen, el método constituye una estrategia de búsqueda que combina una amplia exploración del espacio para identificar áreas potenciales, seguida de una optimización local minuciosa para alcanzar soluciones precisas, utilizando parámetros y mecanismos que permiten adaptar su comportamiento a tareas y condiciones concretas.
//————————————————————————————————————————————————————————————————————
class C_AO_ES : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_ES () { }
  C_AO_ES ()
  {
    ao_name = "ES";
    ao_desc = "Eagle Strategy";
    ao_link = "https://www.mql5.com/ru/articles/18460";

    popSize         = 100;   // tamaño de la población
    lambda          = 1.0;  // parámetro de la distribución de Lévy (1 < λ ≤ 3)
    sphereRadius    = 0.1;  // radio de la hiperesfera para la búsqueda local
    localIterations = 20;   // número de iteraciones de la búsqueda local
    alpha           = 0.1;  // parámetro de aleatorización para Firefly
    beta0           = 1.2;  // atractivo inicial

    ArrayResize (params, 6);

    params [0].name = "popSize";         params [0].val = popSize;
    params [1].name = "lambda";          params [1].val = lambda;
    params [2].name = "sphereRadius";    params [2].val = sphereRadius;
    params [3].name = "localIterations"; params [3].val = localIterations;
    params [4].name = "alpha";           params [4].val = alpha;
    params [5].name = "beta0";           params [5].val = beta0;
  }

  void SetParams ()
  {
    popSize         = (int)params [0].val;
    lambda          = params      [1].val;
    sphereRadius    = params      [2].val;
    localIterations = (int)params [3].val;
    alpha           = params      [4].val;
    beta0           = params      [5].val;
  }

  bool Init (const double &rangeMinP  [],  // valores mínimos
             const double &rangeMaxP  [],  // valores máximos
             const double &rangeStepP [],  // paso de variación
             const int     epochsP = 0);   // número de épocas

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double lambda;          // parámetro de la distribución de Lévy (1 < λ ≤ 3)
  double sphereRadius;    // radio de la hiperesfera para la búsqueda local
  int    localIterations; // número de iteraciones de la búsqueda local
  double alpha;           // parámetro de aleatorización
  double beta0;           // atractivo inicial

  private: //---------------------------------------------------------
  double gamma_es;           // coeficiente de absorción de luz
  double levyStep [];        // array de pasos de Lévy

  // Seguimiento de fases
  bool   inLocalSearchPhase; // indicador de búsqueda local
  int    localSearchCenter;  // centro de búsqueda local
  int    localSearchCounter; // contador de iteraciones de la búsqueda local

  // Seguimiento de la convergencia
  double prevBestFitness;    // mejor valor anterior
  int    stagnationCounter;  // contador de estancamiento

  // Seguimiento de épocas
  int    epochCurrent;       // época actual
  int    epochMax;           // número máximo de épocas

  // Métodos auxiliares
  void   GlobalExploration  ();
  void   LocalExploitation  ();
  void   GenerateLevyStep   ();
  double GenerateGaussian   ();
  double Gamma              (double z);
};
//————————————————————————————————————————————————————————————————————
El método «Init» de la clase «C_AO_ES» inicializa el algoritmo de optimización antes de iniciar el proceso de búsqueda. En primer lugar, se invoca el método «StandardInit», encargado de la inicialización estándar del algoritmo; este configura los parámetros generales y las estructuras de datos. Si «StandardInit» falla, el método completo devuelve «false», lo que indica que la inicialización no se ha realizado correctamente.
A continuación, se asigna memoria para el array «levyStep» con un tamaño igual al número de coordenadas «coords». Este array se utilizará para almacenar los pasos generados de acuerdo con la distribución de Lévy. Al indicador «inLocalSearchPhase» se le asigna el valor «false»; el algoritmo se encuentra inicialmente en la fase de búsqueda global. Las variables «localSearchCenter» y «localSearchCounter» se establecen en «0» para preparar los contadores de la búsqueda local.
Inicialización de los parámetros de convergencia:
- prevBestFitness se establece en el valor mínimo posible, para garantizar que la primera solución encontrada se considere mejor que la anterior.
- El contador de estancamiento se establece en «0» para llevar la cuenta del número de iteraciones sin que se mejore la mejor solución encontrada.
Inicialización de los parámetros de las épocas:
- A «epochMax» se le asigna el valor del parámetro de entrada «epochsP», que establece el número máximo de épocas (iteraciones) del algoritmo.
- epochCurrent se establece en «0» para realizar el seguimiento de la época actual.
Configuración de un parámetro fijo: a la variable «gamma_es» se le asigna el valor «1.0». Este parámetro se utiliza en el algoritmo de las luciérnagas (Firefly), que forma parte de la estrategia general.
Se inicializa la población inicial de soluciones «a». Para cada solución de la población:
- Cada coordenada del vector de la solución (a[i].c[c]) se inicializa con un valor aleatorio tomado del intervalo [rangeMin[c], rangeMax[c]].
- El valor de cada coordenada se «redondea» al valor admisible más cercano, teniendo en cuenta el paso (rangeStep[c]), mediante el método «u.SeInDiSp».
- El valor de la función objetivo (a[i].f y a[i].fB) para cada solución se establece en «-DBL_MAX».
//————————————————————————————————————————————————————————————————————
bool C_AO_ES::Init (const double &rangeMinP  [],
                    const double &rangeMaxP  [],
                    const double &rangeStepP [],
                    const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Inicialización de arrays
  ArrayResize (levyStep, coords);

  // Inicialización del seguimiento de fases
  inLocalSearchPhase = false;
  localSearchCenter  = 0;
  localSearchCounter = 0;

  // Inicialización del seguimiento de la convergencia
  prevBestFitness   = -DBL_MAX;
  stagnationCounter = 0;

  // Inicialización del seguimiento de épocas
  epochMax     = epochsP;
  epochCurrent = 0;

  // Parámetro fijo de Firefly
  gamma_es = 1.0;

  // Inicialización aleatoria de la población
  for (int i = 0; i < popSize; i++)
  {
    for (int c = 0; c < coords; c++)
    {
      a [i].c [c] = u.RNDfromCI (rangeMin [c], rangeMax [c]);
      a [i].c [c] = u.SeInDiSp  (a [i].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }

    a [i].f  = -DBL_MAX;
    a [i].fB = -DBL_MAX;
  }

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «Moving» implementa la lógica principal del proceso iterativo de optimización, alternando entre la búsqueda global y la explotación local. Cada vez que se invoca el método, se incrementa el contador de épocas para realizar un seguimiento del progreso del algoritmo.
Procesamiento de las fases de búsqueda:-
si la fase actual es búsqueda global, se lleva a cabo la exploración del espacio mediante pasos modelados según la distribución de Lévy, y se generan nuevas soluciones en todo el espacio para buscar nuevas áreas con potencial;
-
si tras la búsqueda global se encuentra una mejora, el algoritmo pasa a la fase local. En este caso, se elige la solución (agente) más prometedora, en torno a la cual se llevará a cabo la búsqueda con el fin de refinarla;
-
si no se producen mejoras a lo largo de varias iteraciones (se acumula el estancamiento), se intensifica la búsqueda de nuevas soluciones mediante pasos de vuelo más agresivos, reduciendo el parámetro «lambda» para explorar un espacio más amplio;
-
en caso de que el algoritmo se encuentre en la fase de búsqueda local, con una probabilidad del 80 % se lleva a cabo una optimización local utilizando un método que simula el algoritmo de las luciérnagas (Firefly). En este caso, se refina la solución seleccionada y se incrementa el contador de iteraciones locales; una vez alcanzado el número establecido de iteraciones de búsqueda local, o según la lógica establecida, se vuelve a la búsqueda global.
De este modo, el método aplica una estrategia de búsqueda gradual y flexible, que alterna entre la exploración global del espacio y la optimización local específica. Esto permite encontrar un equilibrio entre la exploración de nuevas áreas y la mejora de las soluciones existentes.
//————————————————————————————————————————————————————————————————————
void C_AO_ES::Moving ()
{
  epochCurrent++;

  // TOMA DE DECISIONES SOBRE LA FASE: Alternancia entre la búsqueda global y la búsqueda local
  if (!inLocalSearchPhase)
  {
    // FASE 1: EXPLORACIÓN GLOBAL mediante vuelos de Lévy
    GlobalExploration ();

    // Comprobación de si es necesario cambiar a la búsqueda local
    // Cambiamos de estrategia si encontramos un área prometedora (mejora de la mejor aptitud)
    if (fB > prevBestFitness)
    {
      inLocalSearchPhase = true;
      localSearchCounter = 0;
      prevBestFitness    = fB;
      stagnationCounter  = 0;

      // Búsqueda del mejor agente para centrar la búsqueda local
      localSearchCenter = 0;
      double bestFit = -DBL_MAX;

      for (int i = 0; i < popSize; i++)
      {
        if (a [i].f > bestFit)
        {
          bestFit = a [i].f;
          localSearchCenter = i;
        }
      }
    }
    else
    {
      stagnationCounter++;

      // En caso de estancamiento, ampliamos la exploración
      if (stagnationCounter > 5)
      {
        lambda = MathMax (1.0, lambda - 0.1); // Hacemos más agresivos los vuelos de Lévy
      }
    }
  }
  else
  {
    if (u.RNDprobab () < 0.8)
    {
      // FASE 2: EXPLOTACIÓN LOCAL mediante el algoritmo de las luciérnagas (Firefly)
      LocalExploitation ();

      localSearchCounter++;

      // Volver a la búsqueda global tras completar las iteraciones locales
      if (localSearchCounter >= localIterations)
      {
        inLocalSearchPhase = false;
        lambda = params [1].val; // Restablecimiento de lambda a su valor inicial
      }
    }
    else
    {
      for (int i = 0; i < popSize; i++)
      {
        for (int c = 0; c < coords; c++)
        {
          if (u.RNDprobab () < 0.5)
          {
            a [i].c [c] = cB [c];
          }
        }
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «Revision» está diseñado para actualizar la información sobre las mejores soluciones durante la ejecución del algoritmo. El método recorre todos los elementos de la población actual de soluciones y, para cada solución, compara su aptitud (fitness) actual con la almacenada en su mejor personal. Si el valor actual es mejor, se actualiza el mejor personal y la solución correspondiente (se guarda la mejor solución de la iteración actual).
A continuación, el método compara la aptitud (fitness) de cada solución con el mejor global actual encontrado en toda la población y, si el resultado actual es el mejor, se actualiza el mejor global y se guarda la solución correspondiente. De este modo, el método mantiene información actualizada sobre las soluciones óptimas locales y globales en el estado actual del algoritmo, lo que garantiza que se conserven las mejores soluciones encontradas en cada paso.
//————————————————————————————————————————————————————————————————————
void C_AO_ES::Revision ()
{
  for (int i = 0; i < popSize; i++)
  {
    // Actualización del mejor personal
    if (a [i].f > a [i].fB)
    {
      a [i].fB = a [i].f;
      ArrayCopy (a [i].cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }

    // Actualización del mejor global
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «GlobalExploration» implementa la fase de búsqueda global utilizando vuelos de Lévy para explorar el espacio de soluciones. En un ciclo por toda la población, para cada solución se genera un paso aleatorio utilizando la distribución de Lévy; este determina la dirección y la longitud del desplazamiento en el espacio de soluciones.
La distribución de Lévy se caracteriza por sus «colas pesadas», lo que permite tanto dar pequeños pasos de precisión como realizar grandes saltos poco frecuentes para explorar regiones alejadas. En el ciclo, se calcula para cada coordenada de la solución:
- amplitud de búsqueda (diferencia entre el valor máximo y el mínimo de una coordenada),
- coeficiente de escala adaptativo «stepScale». Se va reduciendo a medida que avanza la búsqueda (cuanto más cerca del final, menores son los pasos), lo que contribuye a estrechar el área de búsqueda en torno a las soluciones prometedoras, mientras que al principio de la búsqueda los pasos son más grandes para permitir una exploración más amplia.
- Se aplica el paso de Lévy: la coordenada de la solución actual varía en una cantidad proporcional al paso de Lévy, a la amplitud de búsqueda y al coeficiente de escala.
- Corrección de límites: se comprueba si la nueva coordenada se sale de los límites permitidos; si es así, el valor se corrige para que se mantenga dentro del rango establecido.
//————————————————————————————————————————————————————————————————————
// FASE 1: Exploración global mediante vuelos de Lévy
void C_AO_ES::GlobalExploration ()
{
  for (int i = 0; i < popSize; i++)
  {
    // Generación del paso de Lévy
    GenerateLevyStep ();

    // Actualización de la posición mediante un vuelo de Lévy
    for (int c = 0; c < coords; c++)
    {
      double range = rangeMax [c] - rangeMin [c];

      // Tamaño de paso adaptativo en función del progreso de la búsqueda
      double progress = (epochMax > 0) ? (double)epochCurrent / (double)epochMax : 0.5;
      double stepScale = 0.01 + 0.2 * (1.0 - progress); // Empezamos con pasos grandes

      // Aplicación del paso de Lévy
      a [i].c [c] += levyStep [c] * range * stepScale;

      // Restricciones de límites
      a [i].c [c] = u.SeInDiSp (a [i].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «LocalExploitation» lleva a cabo la fase de mejora local de las soluciones mediante el algoritmo de las luciérnagas (Firefly). En la fase inicial se identifican los agentes que se encuentran dentro de una hiperesfera dada alrededor de la mejor solución. Para ello, se calcula la distancia de cada agente al centro de la hiperesfera y, si es menor que el radio o si el agente es el centro de búsqueda, se incluye en el grupo seleccionado.
Si hay muy pocos agentes dentro de la hiperesfera, se amplía el área de búsqueda incluyendo a los vecinos más cercanos. Para ello, se calcula la distancia al centro de todos los agentes y se seleccionan los más cercanos, ya sea por cantidad numérica (por ejemplo, 5) o por proporción de la población (por ejemplo, el 30 %). Estos agentes se añaden al grupo.
Aplicación del algoritmo de las luciérnagas (Firefly): los agentes seleccionados interactúan de acuerdo con las reglas del algoritmo:- Para cada agente, se comprueba si hay otro agente en el grupo con mejor aptitud (fitness).
- Si lo hay, el agente actual se desplaza hacia el agente más atractivo (mejor), calculándose al mismo tiempo la distancia entre ambos.
- Cuanto más atractivo es otro agente, mayor es su «luminosidad» (depende de la distancia y de los parámetros del algoritmo).
- El desplazamiento incluye un ajuste cuidadoso: el agente se desplaza hacia el agente más atractivo, con la adición de fluctuaciones aleatorias para diversificar la búsqueda.
- Tras los desplazamientos, se comprueban los límites de las coordenadas para garantizar que las soluciones se mantengan dentro del rango admisible.
Como resultado, el método permite mejorar localmente las soluciones en las proximidades de los mejores puntos encontrados, utilizando la interacción entre los agentes según el modelo de estrategia del algoritmo de las luciérnagas (Firefly): las mejores soluciones atraen a las peores, lo que favorece la optimización puntual del espacio de soluciones.
//————————————————————————————————————————————————————————————————————
// FASE 2: Explotación local mediante el algoritmo de las luciérnagas (Firefly)
void C_AO_ES::LocalExploitation ()
{
  // Identificación de agentes dentro de la hiperesfera que rodea la mejor solución
  double agents_in_sphere [];
  ArrayResize (agents_in_sphere, 0);

  for (int i = 0; i < popSize; i++)
  {
    double normalized_dist = 0.0;

    for (int c = 0; c < coords; c++)
    {
      double diff = (a [i].c [c] - a [localSearchCenter].c [c]) / (rangeMax [c] - rangeMin [c]);
      normalized_dist += diff * diff;
    }
    normalized_dist = MathSqrt (normalized_dist);

    // Incluimos a los agentes que se encuentran dentro de la esfera o en el propio centro
    if (normalized_dist <= sphereRadius || i == localSearchCenter)
    {
      int size = ArraySize (agents_in_sphere);
      ArrayResize (agents_in_sphere, size + 1);
      agents_in_sphere [size] = i;
    }
  }

  // Si hay muy pocos agentes, ampliamos la búsqueda a los vecinos más cercanos
  if (ArraySize (agents_in_sphere) < 5)
  {
    ArrayResize (agents_in_sphere, 0);

    // Calculamos las distancias para todos los agentes
    double distances [];
    ArrayResize (distances, popSize);

    for (int i = 0; i < popSize; i++)
    {
      if (i == localSearchCenter)
      {
        distances [i] = 0.0;
      }
      else
      {
        double dist = 0.0;
        for (int c = 0; c < coords; c++)
        {
          double diff = (a [i].c [c] - a [localSearchCenter].c [c]) / (rangeMax [c] - rangeMin [c]);
          dist += diff * diff;
        }
        distances [i] = MathSqrt (dist);
      }
    }

    // Tomamos los 5 agentes más cercanos o el 30 % de la población
    int numAgents = MathMin (popSize, MathMax (5, popSize / 3));
    ArrayResize (agents_in_sphere, numAgents);

    // Una forma sencilla de elegir los agentes más cercanos
    for (int k = 0; k < numAgents; k++)
    {
      double minDist = DBL_MAX;
      int minIdx = -1;

      for (int i = 0; i < popSize; i++)
      {
        bool already_selected = false;

        for (int j = 0; j < k; j++)
        {
          if (agents_in_sphere [j] == i)
          {
            already_selected = true;
            break;
          }
        }

        if (!already_selected && distances [i] < minDist)
        {
          minDist = distances [i];
          minIdx = i;
        }
      }

      agents_in_sphere [k] = minIdx;
    }
  }

  // Ejecución del algoritmo de las luciérnagas (Firefly) en los agentes seleccionados
  int numLocalAgents = ArraySize (agents_in_sphere);

  for (int i = 0; i < numLocalAgents; i++)
  {
    int idx_i = (int)agents_in_sphere [i];

    for (int j = 0; j < numLocalAgents; j++)
    {
      if (i == j) continue;

      int idx_j = (int)agents_in_sphere [j];

      // Si el agente j es mejor que el agente i, movemos a i hacia j
      if (a [idx_j].f > a [idx_i].f)
      {
        // Cálculo de la distancia
        double r_squared = 0.0;

        for (int c = 0; c < coords; c++)
        {
          double diff = (a [idx_j].c [c] - a [idx_i].c [c]) / (rangeMax [c] - rangeMin [c]);
          r_squared += diff * diff;
        }

        // Cálculo del atractivo
        double beta = beta0 * MathExp (-gamma_es * r_squared);

        // Desplazamiento del agente i hacia el agente j
        for (int c = 0; c < coords; c++)
        {
          double range = rangeMax [c] - rangeMin [c];

          // Ecuación de movimiento del algoritmo de las luciérnagas (Firefly)
          a [idx_i].c [c] += beta * (a [idx_j].c [c] - a [idx_i].c [c]) +
                             alpha * (u.RNDfromCI (-0.5, 0.5)) * range * 0.1;

          // Aplicación de los límites
          a [idx_i].c [c] = u.SeInDiSp (a [idx_i].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
        }
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «GenerateLevyStep» se encarga de generar el paso de Lévy necesario para implementar la estrategia de exploración global en el algoritmo de optimización. El método utiliza el algoritmo de Mantegna para generar estos pasos; ya hemos hablado de este método anteriormente.
Cálculo de sigma:
La fórmula del código calcula el parámetro «sigma». Este parámetro está relacionado con la escala de la distribución de Lévy y depende de la constante «lambda», que caracteriza la forma de la distribución de Lévy (determina lo «pesadas» que serán las colas de la distribución). Gamma() es la función gamma, una generalización del factorial a los números reales (el código de este método se muestra a continuación). Este parámetro es necesario para generar valores que sigan una distribución normal, los cuales se utilizan posteriormente en el algoritmo de Mantegna.
La generación del paso de Lévy se realiza de forma independiente para cada coordenada (parámetro) de la solución. Se generan dos variables aleatorias, «u_val» y «v_val», a partir de una distribución normal (gaussiana); se toma el valor absoluto de «v_val». El paso de Lévy «levyStep[c]» se calcula mediante la fórmula del algoritmo de Mantegna: u_val / Math.pow(v_val, 1.0 / lambda). Se comprueba si se produce una división por cero (si v_val es muy pequeña). El paso de Lévy se limita en valor absoluto. Esto se hace para evitar saltos demasiado grandes.
Como resultado de la aplicación del método, se genera un array denominado «levyStep» que contiene los valores de los pasos de Lévy para cada coordenada. Estos pasos se utilizan posteriormente en el método «GlobalExploration» para actualizar la posición de cada solución en el espacio de búsqueda.
//————————————————————————————————————————————————————————————————————
// Generación del paso de Lévy mediante el algoritmo de Mantegna
void C_AO_ES::GenerateLevyStep ()
{
  // Cálculo de sigma para el algoritmo de Mantegna
  double numerator   = Gamma (1.0 + lambda) * MathSin (M_PI * lambda / 2.0);
  double denominator = Gamma ((1.0 + lambda) / 2.0) * lambda * MathPow (2.0, (lambda - 1.0) / 2.0);
  double sigma = MathPow (numerator / denominator, 1.0 / lambda);

  for (int c = 0; c < coords; c++)
  {
    // Generación de u y v a partir de distribuciones normales
    double u_val = GenerateGaussian () * sigma;
    double v_val = MathAbs (GenerateGaussian ());

    // Cálculo del paso de Lévy
    if (v_val > 1e-10)
    {
      levyStep [c] = u_val / MathPow (v_val, 1.0 / lambda);
    }
    else
    {
      levyStep [c] = 0.0;
    }

    // Limitación de los valores extremos
    if (MathAbs (levyStep [c]) > 10.0)
    {
      levyStep [c] = 10.0 * (levyStep [c] > 0 ? 1.0 : -1.0);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «GenerateGaussian» genera números aleatorios que siguen una distribución normal (gaussiana) con una media de «0» y una desviación estándar de «1». Utiliza la transformación de Box-Muller, un método bastante habitual para esta tarea; ya hemos aplicado este método en artículos anteriores.
Se utilizan las variables estáticas «hasSpare» y «spare»; la transformación de Box-Muller genera dos números aleatorios independientes con distribución normal cada vez; «hasSpare» es una variable booleana que determina si se ha guardado uno de los números generados para la siguiente llamada a la función, y «spare» es la variable que almacena ese número «de reserva».Generación de nuevos números aleatorios (si es necesario):
Si no hay un número «de reserva», se generan dos variables aleatorias independientes, «u_val» y «v_val», a partir de una distribución uniforme en el intervalo (0, 1). La función «u.RNDfromCI» se encarga de generar números distribuidos uniformemente. Se aplica la transformación de Box-Muller:
- Se calcula «mag» (magnitud) como la raíz cuadrada de -2.0 * Math.log(u_val + 1e-10). Es necesario sumar un número pequeño a «u_val» para evitar calcular el logaritmo de cero, lo cual no está permitido.
- El número «de reserva» «spare» se calcula como mag * Math.cos(2.0 * M_PI * v_val).
- Devuelve el valor mag * Math.sin(2.0 * M_PI * v_val).
El método devuelve uno de los números aleatorios generados que siguen una distribución normal.
//————————————————————————————————————————————————————————————————————
// Generación de un número aleatorio gaussiano mediante la transformación de Box-Muller
double C_AO_ES::GenerateGaussian ()
{
  static bool hasSpare = false;
  static double spare;

  if (hasSpare)
  {
    hasSpare = false;
    return spare;
  }

  hasSpare = true;
  double u_val = u.RNDfromCI (0.0, 1.0);
  double v_val = u.RNDfromCI (0.0, 1.0);

  double mag = MathSqrt (-2.0 * MathLog (u_val + 1e-10));
  spare = mag * MathCos (2.0 * M_PI * v_val);

  return mag * MathSin (2.0 * M_PI * v_val);
}
//————————————————————————————————————————————————————————————————————
El método «Gamma» es una función que aproxima la función gamma para un argumento «z» dado. Dado que la función gamma es una función matemática importante, especialmente en estadística y optimización, pero su cálculo exacto puede resultar complicado y consumir muchos recursos, a menudo se recurre a aproximaciones. Utilizamos la aproximación de Lanczos, que ofrece una buena precisión con un esfuerzo computacional relativamente reducido. Repasemos los puntos principales.
Si el argumento «z» es menor que «0,5», se aplica la fórmula de reflexión de Euler. Esto permite calcular la función gamma para argumentos cercanos a cero. La fórmula de reflexión relaciona la función gamma de «z» con la función gamma de «1 - z». Utilizaremos los coeficientes fijos de Lanczos, cuidadosamente seleccionados para garantizar una alta precisión de la aproximación, así como una fórmula con coeficientes que incluye funciones de potencia y exponenciales. El método devuelve un valor aproximado de la función gamma para el argumento «z» especificado.
La aproximación de Lanczos ofrece una buena precisión, suficiente para la mayoría de las aplicaciones prácticas. El algoritmo es relativamente eficiente, ya que solo requiere unas pocas operaciones aritméticas y una consulta en una tabla de coeficientes. Es adecuado para un amplio rango de valores del argumento, especialmente en combinación con la fórmula de reflexión. En general, el método «Gamma» constituye una forma bastante precisa de aproximar la función gamma.
//———————————————————————————————————————————————————————————————————— // Aproximación de la función gamma mediante la aproximación de Lanczos double C_AO_ES::Gamma (double z) { if (z < 0.5) { // Fórmula de reflexión para z < 0,5 return M_PI / (MathSin (M_PI * z) * Gamma (1.0 - z)); } // Coeficientes de Lanczos const double g = 7.0; double coef [] = { 0.99999999999980993, 676.5203681218851, -1259.1392167224028, 771.32342877765313, -176.61502916214059, 12.507343278686905, -0.13857109526572012, 9.9843695780195716e-6, 1.5056327351493116e-7 }; z -= 1.0; double x = coef [0]; for (int i = 1; i < 9; i++) { x += coef [i] / (z + i); } double t = z + g + 0.5; double sqrt2pi = MathSqrt (2.0 * M_PI); return sqrt2pi * MathPow (t, z + 0.5) * MathExp (-t) * x; } //————————————————————————————————————————————————————————————————————
Resultados de las pruebas
Aunque el algoritmo no logró entrar en nuestra tabla de clasificación, los resultados de su desempeño merecen atención.=============================
5 Hilly's; Func runs: 10000; result: 0.7077570016043803
25 Hilly's; Func runs: 10000; result: 0.4307775904381953
500 Hilly's; Func runs: 10000; result: 0.2747545259235643
=============================
5 Forest's; Func runs: 10000; result: 0.7173720280531499
25 Forest's; Func runs: 10000; result: 0.3448423301485268
500 Forest's; Func runs: 10000; result: 0.1597390810339928
=============================
5 Megacity's; Func runs: 10000; result: 0.5184615384615384
25 Megacity's; Func runs: 10000; result: 0.2775384615384615
500 Megacity's; Func runs: 10000; result: 0.11063076923077016
=============================
All score: 3.54187 (39.35%)
En la visualización se aprecia claramente cómo se separan las fases de búsqueda según la estrategia, cuando se producen desplazamientos largos y movimientos cortos de refinamiento.
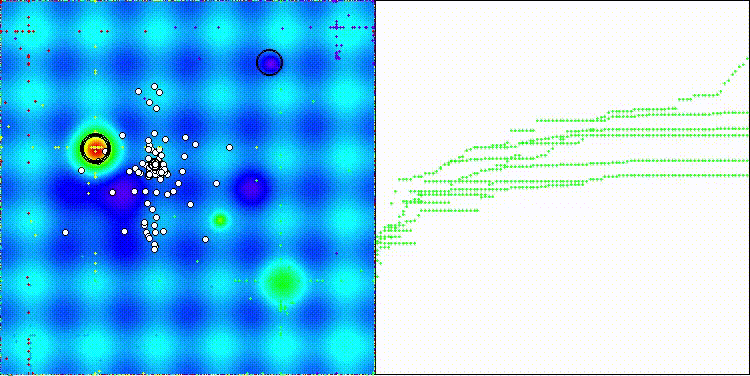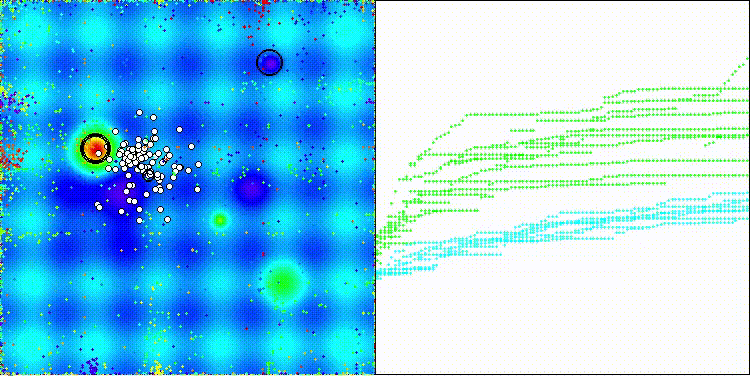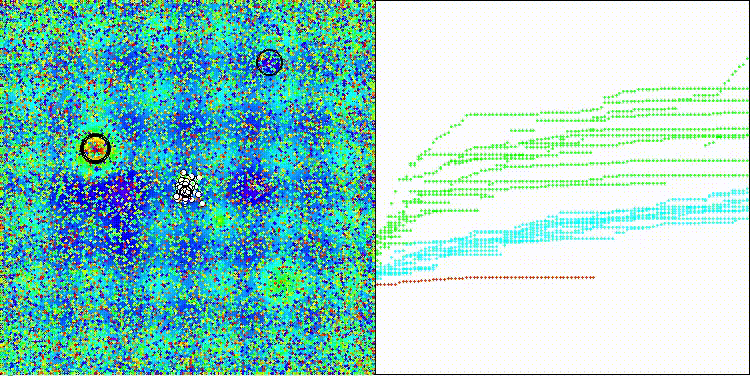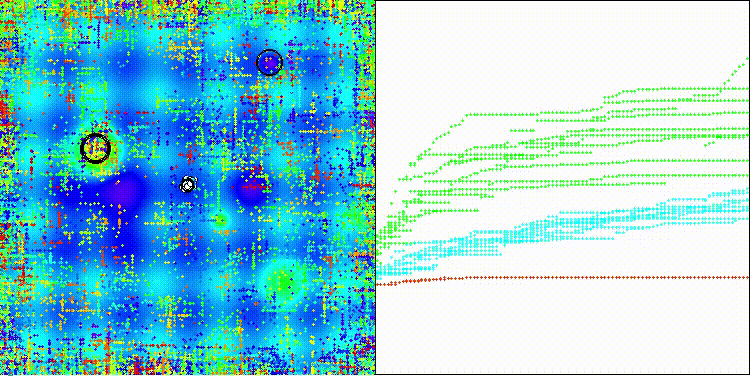
ES en la función de prueba Hilly
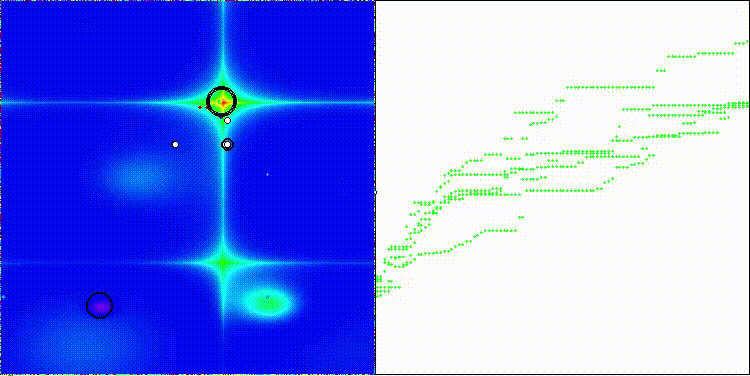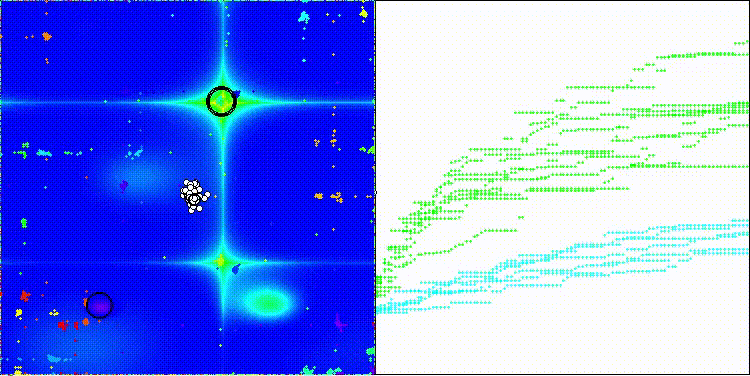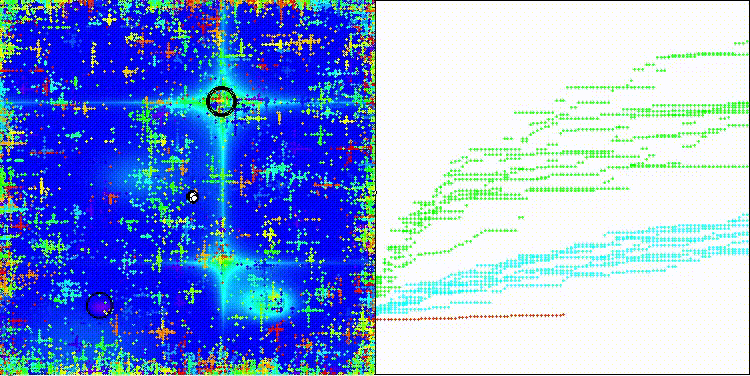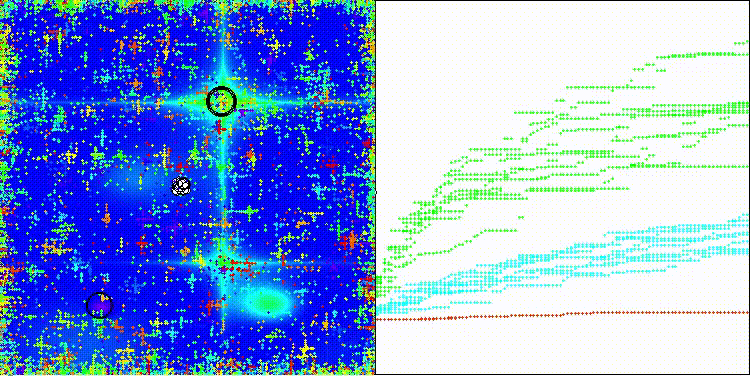
ES en la función de prueba Forest
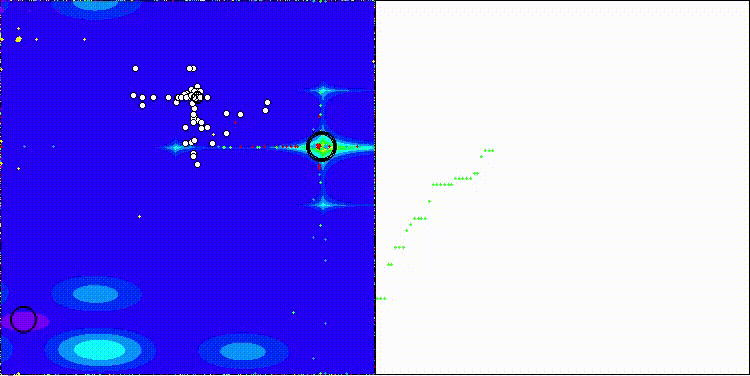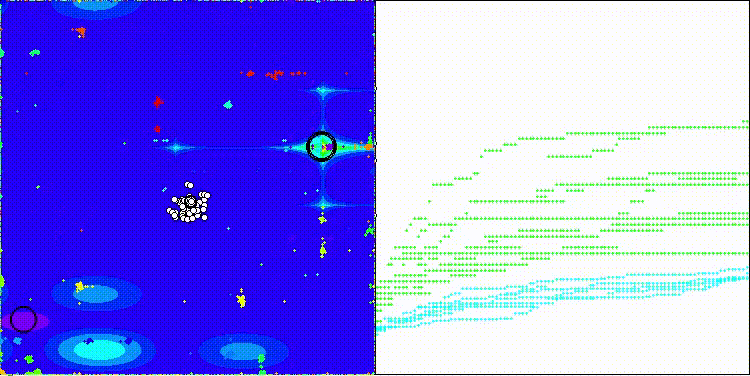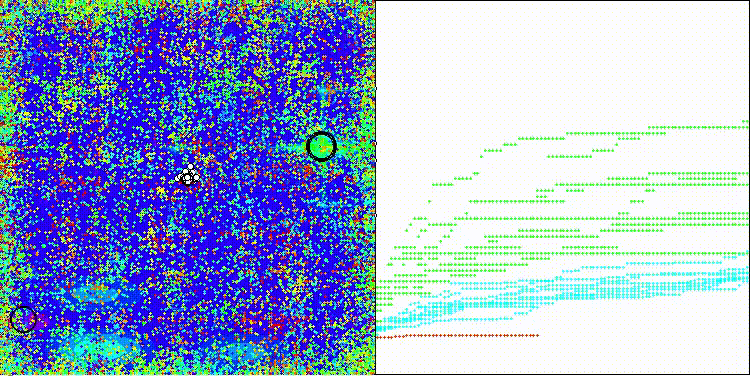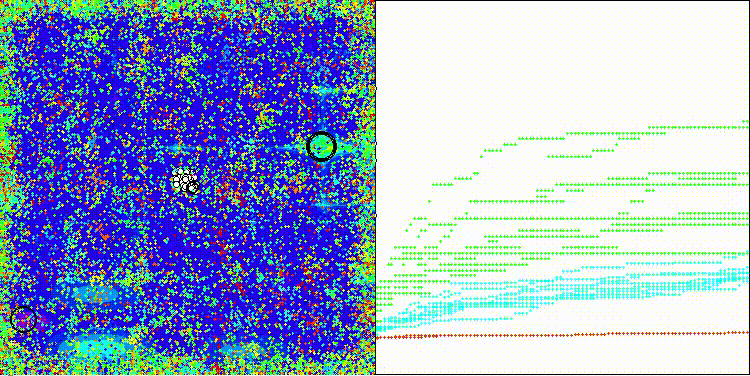
ES en la función de prueba Megacity
El algoritmo ES se presenta en la tabla de clasificación con fines informativos.
| N.º | AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 2 | CLA | code lock algorithm (joo) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| 3 | AMOm | animal migration optimization M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 5 | CTA | comet tail algorithm (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| 6 | TETA | time evolution travel algorithm (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| 7 | SDSm | stochastic diffusion search M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 8 | BOAm | billiards optimization algorithm M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| 9 | AAm | archery algorithm M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| 10 | ESG | evolution of social groups (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| 11 | SIA | simulated isotropic annealing (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 12 | BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 13 | ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 14 | DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 15 | BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 16 | ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 17 | RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 18 | AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 19 | TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 20 | DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 21 | SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 22 | CRO | chemical reaction optimisation | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| 23 | BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 24 | BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1,12012 | 4,809 | 53,44 |
| 25 | HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 26 | SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 27 | BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| 28 | ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 29 | (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| 30 | FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 31 | TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| 32 | BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 33 | WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 34 | AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| 35 | AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 36 | CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 37 | ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 38 | BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| 39 | SOA | simple optimization algorithm | 0,91520 | 0,46976 | 0,27089 | 1,65585 | 0,89675 | 0,37401 | 0,16984 | 1,44060 | 0,69538 | 0,28031 | 0,10852 | 1,08422 | 4,181 | 46,45 |
| 40 | ABHA | artificial bee hive algorithm | 0,84131 | 0,54227 | 0,26304 | 1,64663 | 0,87858 | 0,47779 | 0,17181 | 1,52818 | 0,50923 | 0,33877 | 0,10397 | 0,95197 | 4,127 | 45,85 |
| 41 | ACMO | atmospheric cloud model optimization | 0,90321 | 0,48546 | 0,30403 | 1,69270 | 0,80268 | 0,37857 | 0,19178 | 1,37303 | 0,62308 | 0,24400 | 0,10795 | 0,97503 | 4,041 | 44,90 |
| 42 | ADAMm | adaptive moment estimation M | 0,88635 | 0,44766 | 0,26613 | 1,60014 | 0,84497 | 0,38493 | 0,16889 | 1,39880 | 0,66154 | 0,27046 | 0,10594 | 1,03794 | 4,037 | 44,85 |
| 43 | CGO | chaos game optimization | 0,57256 | 0,37158 | 0,32018 | 1,26432 | 0,61176 | 0,61931 | 0,62161 | 1,85267 | 0,37538 | 0,21923 | 0,19028 | 0,78490 | 3,902 | 43,35 |
| 44 | CROm | coral reefs optimization M | 0,78512 | 0,46032 | 0,25958 | 1,50502 | 0,86688 | 0,35297 | 0,16267 | 1,38252 | 0,63231 | 0,26738 | 0,10734 | 1,00703 | 3,895 | 43,27 |
| 45 | ATAm | artificial tribe algorithm M | 0,71771 | 0,55304 | 0,25235 | 1,52310 | 0,82491 | 0,55904 | 0,20473 | 1,58867 | 0,44000 | 0,18615 | 0,09411 | 0,72026 | 3,832 | 42,58 |
| ES | eagle_strategy_optimization | 0,70776 | 0,43078 | 0,27475 | 1,41328 | 0,71737 | 0,34484 | 0,15973 | 1,22194 | 0,51846 | 0,27754 | 0,11063 | 0,90663 | 3,542 | 39,35 | |
| RW | neuroboids optimization algorithm 2(joo) | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26,09 | |
Conclusiones
El algoritmo ES obtiene resultados medios en las pruebas comparativas de métodos de optimización poblacionales, con un 39 % de la puntuación máxima posible, lo que no le ha permitido entrar en la tabla de clasificación de los 45 algoritmos más potentes.
A pesar de ello, el algoritmo merece atención gracias a su original concepto de búsqueda en dos fases, basado en un modelo biológicamente fundamentado del comportamiento de caza del águila. El uso de los vuelos de Lévy para la exploración global constituye una solución matemáticamente elegante, cuya optimalidad para los problemas de búsqueda aleatoria ha quedado demostrada teóricamente. Los mecanismos adaptativos de implementación, incluidos el cambio dinámico entre fases y el ajuste automático de parámetros en caso de estancamiento, muestran potencial para mejorar el concepto básico.
El algoritmo puede encontrar su nicho en clases específicas de problemas en las que es importante el equilibrio entre la exploración global y la explotación local, especialmente cuando hay múltiples óptimos locales y los datos contienen ruido. La integración del algoritmo de las luciérnagas (Firefly) para la búsqueda local genera una interesante sinergia entre dos métodos inspirados en la naturaleza, aunque el rendimiento general apunta a la necesidad de seguir optimizando los parámetros y de una posible modificación de los mecanismos básicos.
El algoritmo ES puede considerarse un ejemplo ilustrativo de un enfoque híbrido de optimización y una base para el desarrollo de métodos más avanzados que combinen diversas metaheurísticas. Su implementación relativamente sencilla y su lógica intuitiva hacen que este algoritmo sea adecuado para experimentos de investigación en el ámbito de la computación evolutiva.
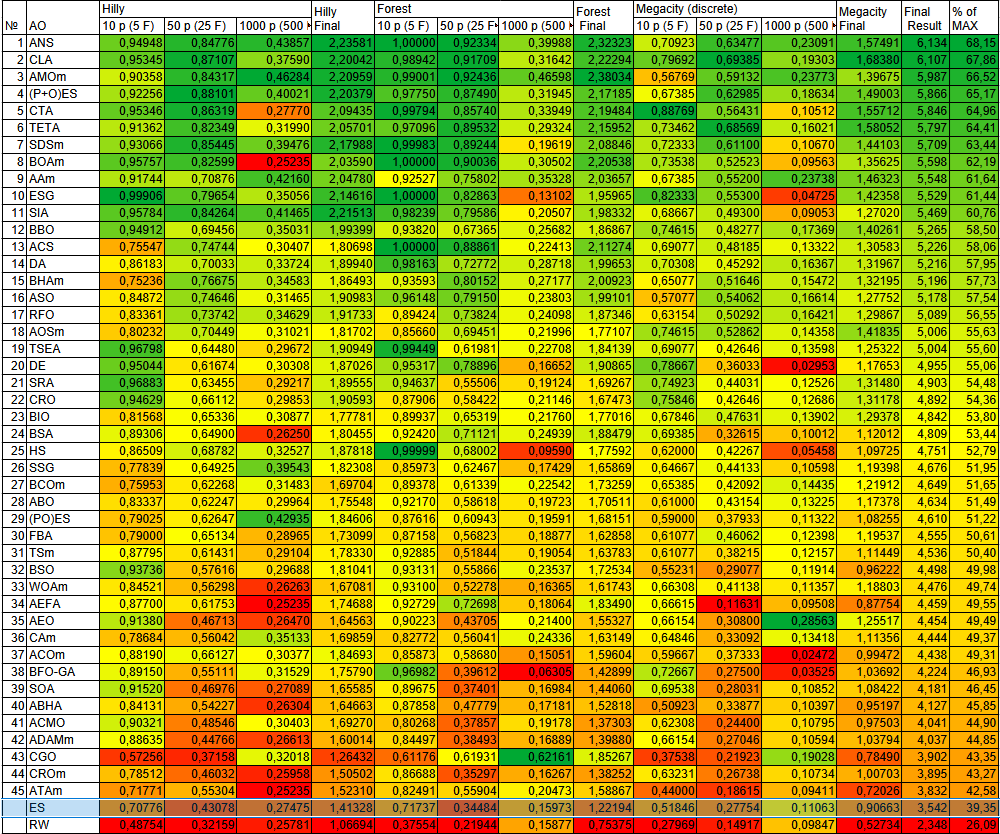
Figura 2. Gradación cromática de los algoritmos según las pruebas correspondientes
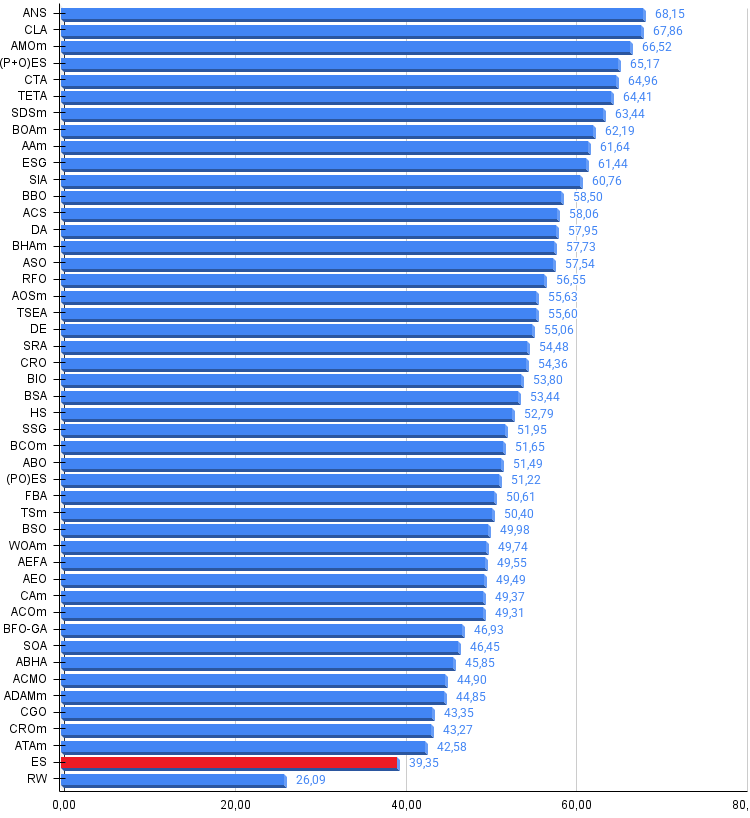
Figura 3. Histograma de los resultados de las pruebas de los algoritmos (en una escala de 0 a 100; cuanto mayor sea el valor, mejor, donde 100 representa el resultado teórico máximo posible; en el archivo se incluye el script para calcular la tabla de clasificación)
Ventajas e inconvenientes del algoritmo ES:
Ventajas:
- Es rápido.
Desventajas:
- Tiene una gran cantidad de parámetros.
Se adjunta al artículo un archivo comprimido con las versiones actualizadas de los códigos de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos, ya que en muchos de ellos se han introducido modificaciones para mejorar las capacidades de búsqueda. Las conclusiones y consideraciones que figuran en los artículos se basan en los resultados de los experimentos realizados.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase padre de los algoritmos de optimización poblacional |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de algoritmos de optimización poblacional |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados destinados a la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | Banco de pruebas unificado para todos los algoritmos de optimización poblacional |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Ejemplo sencillo de uso de algoritmos de optimización poblacional sin visualización |
| 9 | Test_AO_ES.mq5 | Script | Banco de pruebas para ES |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/18460
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Características del Wizard MQL5 que debe conocer (Parte 79): Uso de los osciladores Gator y Acumulación/Distribución con aprendizaje supervisado
 Aprendiendo MQL5 de principiante a profesional (Parte VII): Principios de depuración de aplicaciones MQL
 Evaluación de la calidad de la operativa con spreads en función de los factores de estacionalidad en el mercado Forex en el terminal MetaTrader 5
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 36): Cómo habilitar el acceso directo desde Python a los flujos de mercado de MetaTrader 5

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso