

Aprendiendo MQL5 de principiante a profesional (Parte VII): Principios de depuración de aplicaciones MQL
 17
 2
Introducción
El artículo anterior de esta serie explicaba los principios de creación de asesores expertos en MQL5. Tenía pensado dedicar este artículo a los asesores expertos robustos para el Market, que tuvieran en cuenta el procesamiento de errores corregibles, incluidas las respuestas del servidor. E incluso empecé a escribirla.
Sin embargo, la gente leyó los artículos anteriores, empezó a programar… y a enviarme preguntas por mensaje privado. Por supuesto, eran preguntas típicas de los principiantes y, naturalmente, estaba dispuesto a responderlas (y sigo estándolo). Y, al responder a estas preguntas, me di cuenta con bastante claridad de que, antes de seguir adelante y profundizar en la programación, era necesario explicar cómo puede el propio principiante corregir los errores de su código o del código ajeno. Por eso decidí que los «asesores expertos robustos» vendrían después, y que ahora había que hablar de la depuración.
Todo el mundo se equivoca: unos más a menudo, otros menos… Si usted es principiante en algún ámbito, cometerá muchísimos errores típicos que un profesional detecta de inmediato y evita de forma automática. Sin embargo, incluso los profesionales se equivocan a veces. Simplemente, sus errores suelen ser más difíciles de detectar y tienen mayores consecuencias. Y, en este sentido, la programación no se diferencia en nada de cualquier otra actividad humana. Sin embargo, a diferencia de muchos otros ámbitos de la vida, los errores de programación son bastante fáciles de corregir, siempre que se tenga acceso al código del programa y se disponga de tiempo suficiente.
El proceso de corrección de los errores de un programa se denomina depuración. Y la depuración es una etapa casi imprescindible a la hora de escribir cualquier programa, si este tiene más de 100 líneas. Es imposible vivir sin cometer errores, pero corregirlos es nuestro «derecho sagrado». Por eso, en este artículo voy a explicar los fundamentos de la depuración de programas MQL5 con las herramientas integradas en el entorno MetaEditor. Creo que los profesionales no encontrarán aquí ninguna revelación especial; al fin y al cabo, es una serie para principiantes. Pero si se me escapa algo o lo explico mal, los comentarios, como siempre, están abiertos a todo el mundo.
Análisis de los mensajes de error
Los errores más sencillos son los errores tipográficos y los errores de la sintaxis del lenguaje. Por ejemplo, si está reescribiendo un indicador escrito en MQL4, es probable que tenga que corregir algunas llamadas a funciones como iMA u ObjectFind, ya que estos nombres existen en ambas versiones del lenguaje, pero utilizan un número diferente de parámetros y, a menudo, devuelven valores con un significado distinto. Estos casos son muy sencillos, ya que el compilador los detecta automáticamente y muestra de inmediato información detallada en la ventana correspondiente. Por ejemplo, intente compilar el siguiente código:
//+------------------------------------------------------------------+
//|                                            ErrorsResearching.mq5 |
//|                                     Oleg Fedorov (alias certain) |
//|                                   mailto:coder.fedorov@gmail.com |
//+------------------------------------------------------------------+
#property copyright "Oleg Fedorov (aka certain)"
#property link      "mailto:coder.fedorov@gmail.com"
#property version   "1.00"
#property indicator_chart_window

int g_someInt; // Aquí todo va bien

//+------------------------------------------------------------------+
//| Función de inicialización del indicador personalizado            |
//+------------------------------------------------------------------+
int OnInit()
 {
//--- asignación de búferes del indicador
  g_some_Int = 5; // Aquí hay un error. El nombre de la variable está mal escrito
//---
  return(INIT_SUCCEEDED);
 }
//+------------------------------------------------------------------+
//| Función de cálculo del indicador personalizado                   |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total,
                const int prev_calculated,
                const datetime &time[],
                const double &open[],
                const double &high[],
                const double &low[],
                const double &close[],
                const long &tick_volume[],
                const long &volume[],
                const int &spread[])
 {
//---

//--- valor devuelto por prev_calculated para la siguiente llamada
  return(rates_total);
 }
//+------------------------------------------------------------------+
Ejemplo 1. Código que provoca un error de compilación
El resultado de la compilación de este ejemplo se muestra en la figura 1. El compilador mostrará un error, ya que el nombre de la variable dentro de la función está mal escrito.
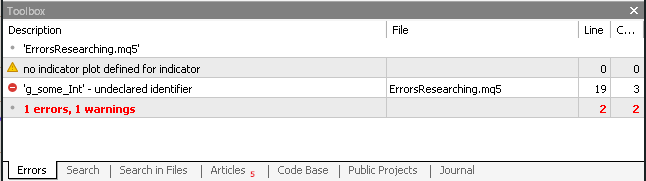
Figura 1. Mensaje de error (variable no declarada)
Merece la pena analizar con más detalle la ventana mostrada en la figura 1, aunque sus elementos sean evidentes. En la primera columna se ofrece una descripción del error. Además, a la izquierda aparece una indicación sobre la categoría a la que pertenece dicho error. En este caso:
- Las advertencias (warnings) se indican con un triángulo amarillo; en principio, las líneas señaladas de este modo pueden ignorarse; sin embargo, en algunos casos su presencia puede provocar un fallo en la lógica del programa, por lo que conviene analizarlas con atención;
- Con el símbolo rojo «stop» se indican los errores (errors) que impiden la compilación;
- Los puntos grises indican mensajes neutros, que no son errores, sino que simplemente proporcionan algún tipo de información.
La columna que sigue a la descripción del error muestra el nombre del archivo en el que se produjo el error, y las dos últimas, el número de línea y de columna del error, respectivamente. Todo esto, en conjunto, proporciona la coordenada exacta en la que el compilador «detecta» el problema. En la mayoría de los casos, basta con hacer doble clic en la línea correspondiente para ir a ese lugar.
A veces, el compilador puede mostrar dos o más mensajes relacionados con un mismo error. Por ejemplo, si se traslada la operación de asignación del ejemplo 1 al ámbito global, tal y como se hace en el ejemplo 2:
#property indicator_chart_window

int g_someInt; // Aquí todo va bien
g_someInt = 5; // Aquí hay un error. No se pueden realizar operaciones
               // (excepto la inicialización) en el ámbito global
Ejemplo 2. Intento de asignar un valor en el ámbito global
El resultado al intentar compilar el ejemplo 2 se muestra en la figura 2.
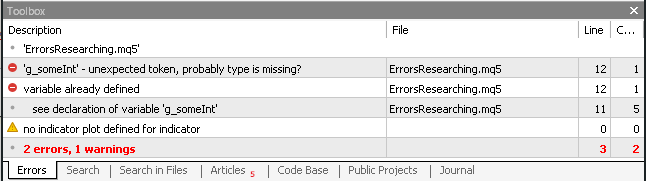
Figura 2. Un solo error puede dar lugar a varios mensajes
En este caso, el compilador intenta interpretar nuestra variable como una nueva declaración. Sin embargo, esta declaración no solo no incluye el tipo de la variable, sino que, además, ya existe una variable con ese nombre (declarada en la línea anterior). Está claro que, en este caso, basta con volver a colocar la línea de asignación dentro de cualquier función, y ambos errores desaparecerán.
Este ejemplo nos da una pista clara: lo más habitual es corregir los errores de uno en uno, de arriba abajo, e intentar compilar después de cada corrección. Aunque, por supuesto, esta regla no es estricta. Así pues, si su compilador muestra varios mensajes del mismo tipo, como variables no declaradas o funciones no declaradas, es posible, por supuesto, corregirlos todos de una sola vez.
Y, para terminar esta sección, voy a incluir un glosario muy breve de términos clave para quienes aún no dominan el inglés lo suficiente como para leer con facilidad los mensajes de error. Este pequeño diccionario está pensado únicamente para ayudar a orientarse en los mensajes del compilador al principio y difícilmente evitará tener que usar diccionarios normales, pero puede ayudar a los principiantes que aún no han encontrado el momento de aprender bien el idioma.
| English | Español | Descripción |
|---|---|---|
| unexpected | inesperado | Suele ocurrir cuando se omite alguna operación o un símbolo importante, como un punto y coma al final de una sentencia. Por ejemplo, en el ejemplo 2, el compilador considera que, al declarar la variable, se ha omitido la especificación del tipo de datos. |
| undeclared | no declarado | Por lo general, ocurre cuando el programador comete un error en el nombre de una variable u olvida declarar una función a la que llama en alguna parte. |
| unbalanced | desequilibrado | Normalmente se refiere a los paréntesis o las llaves. Supongamos que hay un signo de apertura, pero no uno de cierre, o viceversa. |
| missing | falta | El compilador no ha encontrado algo importante. |
| already | ya | Normalmente, en el contexto de «ya existe». |
| wrong | erróneo, incorrecto | Suele aparecer en mensajes que indican un número incorrecto de parámetros al realizar una llamada a una función. |
| invalid | incorrecto, no válido | Por ejemplo, el siguiente códigoint array_variable[]; array_variable = 5;provocará el error «invalid array access» («acceso incorrecto al array»), ya que he intentado escribir un número no en una celda del array, sino directamente en la variable. |
Tabla 1. Breve glosario de términos en inglés que aparecen en los mensajes de error
Errores de tiempo de ejecución
Una vez que hayamos solucionado los errores de compilación, el trabajo principal de depuración no ha hecho más que empezar, ya que a continuación hay que comprobar si nuestro programa funciona correctamente. Es muy frecuente que, por descuido, un programador se salte algún paso importante al diseñar un algoritmo, o que, al «copiar y pegar», modifique una variable equivocada, o que ejecute las acciones en un orden distinto al necesario…
Así pues, el código del ejemplo que aparece en la última línea de la tabla 1 contiene, en realidad, dos errores. Aunque se añadan corchetes y el número del elemento en la segunda línea de este código, el programa seguirá sin funcionar. El caso es que el array array_variable está declarado como dinámico, pero en ningún sitio se establece su tamaño, por lo que no se puede escribir nada en él.
Lamentablemente, el compilador pasará por alto este error sin problemas, ya que, formalmente, todo se ajustará a la sintaxis del lenguaje. Sin embargo, al ejecutarse, el programa mostrará un mensaje de error: «El índice del array está fuera del rango de valores permitido» («array out of range»). Puede ver estos mensajes (al igual que todos los demás mensajes de su programa) en la pestaña «Experts» del terminal (figura 3).
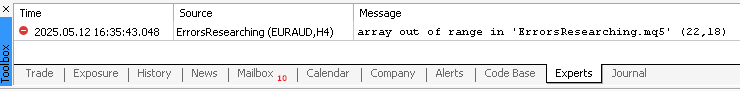
Figura 3. Mensaje de error de tiempo de ejecución
Por cierto, los errores de «fuera de rango» (como en este ejemplo) son muy frecuentes. Los casos más habituales son:
- Los datos de cotización correspondientes a un periodo determinado aún no se han cargado, pero el programa intenta leerlos;
- Se ha indicado incorrectamente el índice del array; por ejemplo, el programador olvida que el último índice del array es 1 menor que su longitud, como en la tercera línea (comentada) del siguiente ejemplo:
int testArray[3]={3,4,5};
int size = ArraySize(testArray);
// Print (testArray[size]); // ¡Error! El programa intenta acceder a un elemento del array que no existe
Print (testArray[size-1]); // Todo va bien
Ejemplo 3. Un caso típico de un posible error debido a un índice de array incorrecto
No todos los errores del algoritmo dan lugar a mensajes de errores críticos del programa. A menudo, el indicador simplemente «no dibuja» o dibuja algo totalmente distinto de lo previsto; el Asesor experto no opera ni siquiera ante situaciones de trading claramente visibles en el historial, y el script se «cuelga» hasta tal punto que hay que reiniciar el terminal… Y entonces hay que buscar los errores. A continuación se describen los métodos de búsqueda más habituales que utilizo.
¿Por dónde se empieza la depuración?
En esta sección se recogen una serie de recomendaciones que, para los programadores con experiencia, resultan tan obvias que no necesitan explicación alguna. Sin embargo, los principiantes (a juzgar por aquellos con los que he hablado en persona o en los foros) cometen a menudo los mismos errores, se vuelven a perder una y otra vez en las mismas cosas básicas y plantean, de diversas formas, la misma pregunta: «¿Por dónde empezar?». Por lo tanto…
Empiece por el principio. Si ese es su código, seguro que usted lo conoce mejor que nadie. Si, por el contrario, es código ajeno, intente comprender qué hace. Para empezar, no entre en detalles. Dé un primer vistazo, por así decirlo, «desde arriba».
- Recuerde que, en los asesores expertos y los indicadores, todo comienza con la función OnInit, mientras que en los scripts y los servicios comienza con OnStart. Cada una de estas funciones se ejecuta exactamente una vez: al iniciar el programa (aunque en los servicios, por lo general, se añade un bucle infinito que procesa determinados eventos durante el trading).
- En los indicadores, en cada tick se llama a la función OnCalculate; en los asesores expertos, a la función OnTick. Asimismo, en los asesores expertos o indicadores se puede configurar un temporizador que la función OnTimer procesa a intervalos regulares.
- Estas cinco funciones (OnInit, OnStart, OnCalculate, OnTick, OnTimer) son puntos de entrada. Cualquier análisis de código ajeno debe comenzar por ellas. Si contienen comentarios, es una gran ventaja; basta con revisarlos. Es muy probable que los comentarios sirvan para destacar los principales bloques lógicos. Si no hay comentarios, procure ver rápidamente qué funciones se utilizan e intente deducir por sus nombres qué hacen. Si el código está bien estructurado y el autor no lo hace todo en una sola función, ha tenido suerte. Si no es así, tampoco pasa nada, aunque es posible que la depuración lleve más tiempo. En cualquier caso, procure comprender las etapas de ejecución del algoritmo, los bloques relativamente grandes, como «cálculo de parámetros», «comprobación de condiciones» (por ejemplo, dibujar o no dibujar), «recorrido por todas las velas»… y así sucesivamente. Está claro que la lista no es, ni mucho menos, exhaustiva, y depende en gran medida de la tarea en cuestión.
- Consulte la lista de funciones adicionales declaradas en este archivo mediante el botón especial de la barra de herramientas (
 ) o la combinación de teclas <Alt>+<M>, e intente deducir por sus nombres para qué sirven;
- A los principiantes les resulta muy útil añadir comentarios con los nombres de los bloques en los puntos clave (si es que no hay comentarios). También resulta muy útil dibujar un diagrama de flujo del algoritmo (por ejemplo, utilizando el lenguaje DRAKON o cualquier otra herramienta que le resulte cómoda). Lo repito una vez más: en esta fase, conviene dibujar el esquema con bloques relativamente grandes.
- Si ha añadido un búfer al indicador y este ha dejado de dibujarse por completo, compruebe lo siguiente:
- al asociar los búferes con los arrays (llamadas a la función SetIndexBuffer), la numeración no se ha desajustado, es decir, todos los números siguen un orden secuencial y sin saltos, empezando por 0;
- la propiedad indicator_buffers refleja con exactitud el número total de búferes, mientras que la propiedad indicator_plots describe con exactitud el número de búferes visibles en la pantalla;
- las propiedades indicator_type, indicator_color, etc., también tienen una numeración correcta; sin embargo, sus números comienzan por 1 y, además, ha especificado cada búfer que se muestra, ya sea mediante propiedades o mediante funciones integradas.
Uso de mensajes de depuración
La forma más tradicional de detectar errores consiste en mostrar mensajes mediante la función Print (o PrintFormat, como prefiera cada uno) en puntos clave del programa.
Hace mucho tiempo, esa era la única forma de entender por qué el programa no funcionaba como debía. Pero incluso hoy en día este método de depuración sigue siendo muy popular, porque es sencillo y rápido y, además, permite guardar la salida en forma de documento que se puede analizar incluso si usted va en transporte público o está sentado en un banco del parque.
Está claro que este tipo de mensajes deben ser informativos e indicar con precisión al programador en qué punto se encuentra y qué ocurre exactamente allí. A menudo se añaden combinaciones especiales de caracteres que no se utilizan en el día a día (como «~~» o algo similar) para saber de qué tipo es el mensaje o de dónde procede. El principio básico de su uso es muy sencillo: los mensajes se colocan en puntos clave del código y, gracias a ellos, el programador puede controlar lo que ocurre en el programa mientras se ejecuta.
Intentemos comprender y corregir los problemas del siguiente código mediante mensajes:
void OnStart()
 {
//---
  int i;
//---
  Print("Program starting, 'i' hasn't initialized");
  for(i=0;i<3;i++);
   {
    Print("In the cycle 'i="+i+"'");
   }
  Print("After cycle 'i="+i+"'");
 }
Ejemplo 4. Código de un programa que funciona mal.
A modo de ejercicio, intente responder cuántos mensajes mostrará este programa y cuáles serán exactamente. Le recomiendo que responda a estas preguntas antes de empezar a leer el siguiente párrafo.
Probablemente, cuando se escribió este código, se suponía que el programa debía mostrar cinco mensajes: dos fuera del bucle y tres dentro. Pero, ¿funcionará esto en este caso concreto? Vamos a comprobarlo:
Program starting, 'i' hasn't initialized
In the cycle 'i=3'
After cycle 'i=3'
Ejemplo 5. Salida del programa del ejemplo 4.
Un resultado inesperado… ¿Por qué solo tres mensajes? ¿Por qué se muestra el número «3» dentro del bucle, cuando deberían aparecer números del 0 al 2? ¿Debe el número de la segunda línea ser igual al de la tercera? Empecemos a pensar.
- Se ejecutan las tres fases de nuestro programa: antes del bucle, dentro del bucle y después del bucle, y eso es motivo de satisfacción.
- La primera fase se ejecuta sin errores.
- En la tercera fase obtenemos el resultado esperado; podemos considerar que con ella también todo está en orden.
- En la segunda fase se muestra el mismo número que en la tercera, lo que significa que el bucle funciona… aunque de alguna manera no como debería.
Teniendo en cuenta lo anterior, cabe suponer que el problema se encuentra en algún punto entre la expresión for(i=0; …) y la salida de los datos que necesitamos. Echemos un vistazo a lo que hay ahí, entre medias… En realidad, ahí hay una llave y un punto y coma.
La llave está equilibrada; de lo contrario, habríamos recibido un mensaje de error de compilación, y no las advertencias que se nos mostraron. Su finalidad es agrupar una o varias sentencias simples en un bloque y, en este caso, cumple esa función correctamente; además, entre las llaves todo está en orden: ahí está exactamente lo que necesitamos, ni más ni menos.
El punto y coma indica el final de alguna sentencia. En este caso… una sentencia vacía. Resulta que, en este caso, el bucle suma inútilmente una unidad a su variable tres veces y, solo después, se muestra al usuario la variable calculada en el bucle. Parece que todo debería funcionar si se elimina ese punto y coma. Vamos a comprobarlo:
Program starting, 'i' hasn't initialized
In the cycle 'i=0'
In the cycle 'i=1'
In the cycle 'i=2'
After cycle 'i=3'
Ejemplo 6. Salida del ejemplo corregido
¡Funcionó! La tarea está resuelta.
Sin embargo, tras depurar el código de esta forma, quedan dispersos por él numerosos mensajes que el usuario final no necesita en absoluto. Si no está creando la aplicación para usted mismo, es probable que, al finalizar la depuración, tenga que encontrar y eliminar toda esa gran cantidad de mensajes. Pero hacerlo mediante una búsqueda normal resulta incómodo (aunque a veces sea necesario). Por eso, cuando los programadores experimentados tienen que añadir mensajes de depuración al código, suelen combinarlos con directivas especiales del preprocesador.
Si tuviéramos que mostrar los números consecutivos del contador del bucle y el resto de mensajes no fueran necesarios en la aplicación final, el código correcto y más práctico tendría el siguiente aspecto:
#define DEBUG
//+------------------------------------------------------------------+
//| Función de inicio del programa de script                         |
//+------------------------------------------------------------------+
void OnStart()
 {
//---
  int i;
//---
#ifdef DEBUG
  Print("Program starting, 'i' hasn't initialized");
#endif

  for(i=0;i<3;i++) // ¡¡¡SIN punto y coma!!!
   {
    Print("In the cycle 'i="+i+"'");
   }

#ifdef DEBUG
  Print("After cycle 'i="+i+"'");
#endif

 }
Ejemplo 7. Uso de directivas de compilación condicional.
En este ejemplo, he declarado una macro llamada DEBUG y, a continuación, en aquellas partes del programa que solo son necesarias durante la depuración, he indicado al preprocesador que incluya el código que muestra los mensajes en el archivo compilado únicamente si existe la macro DEBUG. La existencia de una macro se comprueba mediante la directiva #ifdef. En otras palabras, todo lo que se encuentre entre #ifdef y #endif no se compilará si en el programa no existe una macro llamada DEBUG. De este modo, puede activar y desactivar estos fragmentos simplemente eliminando o añadiendo la primera línea en un único lugar de su proyecto, incluso si este contiene varios archivos.
Y, para terminar este capítulo, diré que este error en concreto (del ejemplo 4) se habría podido detectar aún más fácilmente si, durante la compilación, hubiéramos prestado atención a la advertencia que el compilador intentaba transmitirnos:
empty controlled statement found ErrorsResearching.mq5 23 19
Ejemplo 8. Advertencia del compilador sobre una expresión de control vacía
En este mensaje se indica que el compilador ha detectado una «expresión de control vacía». Si ve este mensaje, lo más probable es que en las coordenadas indicadas haya precisamente un punto y coma de más. ¡Compruébelo siempre!
Uso del depurador interactivo en programas escritos en MQL5
MetaEditor, al igual que muchos entornos de desarrollo integrados (IDE) actuales, cuenta con un depurador interactivo integrado. El término «interactivo» significa que, durante el proceso de depuración, es posible interactuar con el depurador. El principio fundamental de esta interacción es que el programa se compila en un modo especial: el modo de depuración. Este modo permite seguir el funcionamiento del programa directamente en el editor, línea por línea, y ver cómo cambian las variables en los puntos clave de nuestro programa.
Sin embargo, si no se toman medidas especiales, el programa se ejecutará demasiado rápido y no veremos nada. Por eso, en el editor insertamos unas marcas especiales que se denominan «puntos de interrupción» (en inglés, break point). Permiten hacer una pausa dentro de las funciones de nuestro programa y examinar los valores de las variables en el momento de la pausa. Cuando queden claros todos los valores de las variables en el punto de interrupción, se podrá ejecutar la siguiente instrucción o reanudar la ejecución hasta el siguiente punto de interrupción.
Durante el proceso de depuración, todo me parece bastante intuitivo, pero, por si acaso, voy a explicar qué botones hay que pulsar.
- Los puntos de interrupción suelen establecerse o bien al comienzo de la ejecución, o bien tras cada pausa.
- Para colocar o eliminar un punto de interrupción, hay que situar el cursor en cualquier línea dentro de la función y utilizar cualquiera de los siguientes métodos:
-
hacer doble clic en la columna que contiene los números de línea del programa actual;
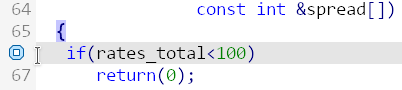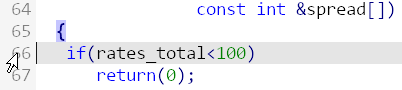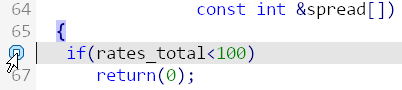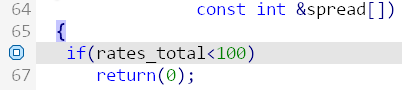
Figura 4. Alternar un punto de interrupción con doble clic
- tecla <F9>;
- el menú contextual de la línea correspondiente o la opción «Depuración» del menú principal -> «Alternar punto de interrupción» (figura 5).
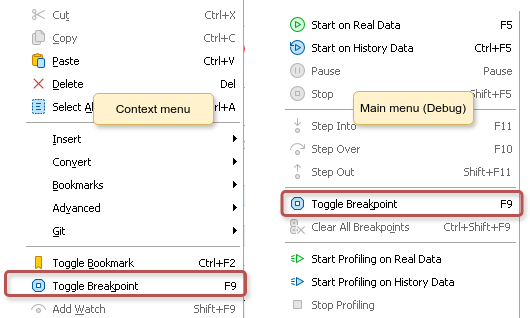
Figura 5. Opción de menú «Alternar punto de interrupción».
- Si ha establecido varios puntos de interrupción, pero ya no los necesita, puede eliminarlos todos a la vez mediante el menú «Depuración» (en la figura 5, la opción correspondiente se encuentra en el menú de la derecha, justo debajo del recuadro rojo) o con la combinación de teclas <Ctrl>+<Shift>+<F9>.
Se puede trabajar con el programa en modo de depuración mediante la parte de la barra de herramientas que se muestra en la figura 6.
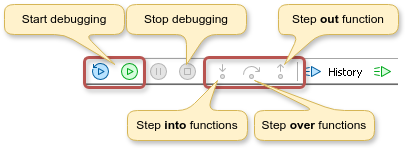
Figura 6. Fragmento de la barra de herramientas destinado a la depuración.
El botón de la izquierda (  ) inicia la depuración con datos históricos, mientras que el de la derecha (
 ) lo hace con datos reales. El botón azul abre un programa especial, el Probador de estrategias, mientras que el verde abre un nuevo gráfico directamente en el terminal. Estas son algunas de las diferencias entre los distintos modos:
- Si necesita comprender cómo funciona el programa que está depurando, es decir, realizar una depuración paso a paso en la vela cero, no hay ninguna diferencia fundamental entre los botones, aunque, por supuesto, la diferencia entre el Probador de estrategias y el terminal es enorme;
- En el Probador de estrategias no se pueden utilizar otras herramientas de análisis, salvo el programa que se esté ejecutando;
- sin embargo, allí se pueden optimizar los parámetros del programa;
- se puede ver, paso a paso, cómo se comporta el programa a lo largo de un periodo de tiempo prolongado;
- los datos del terminal se cargan más rápido al inicio;
- Por lo general, resulta más cómodo depurar programas con datos en tiempo real, siempre que no realicen operaciones de trading, sobre todo en el caso de los indicadores y los scripts;
- Sin embargo, es mejor depurar el trading automático utilizando datos históricos, aunque solo sea para evitar pérdidas.
Sea cual sea el modo de depuración que elija, una vez ejecutado el programa, aparecerán los botones para la ejecución paso a paso del código (en la parte derecha del panel), que aparecen enmarcados en la figura 5. Cada uno de ellos ejecuta el siguiente paso del programa, pero lo hace de forma diferente.
- El botón situado más a la izquierda (
 ) ejecuta el siguiente paso, entrando dentro de cada función cuyo código esté disponible (no las funciones estándar del terminal).
- El botón central (
 ) ejecuta cada función en un solo paso, como si la rodeara por fuera, independientemente de si se trata de una función integrada del terminal o de una función definida por el usuario.
- El botón situado más a la derecha de este grupo (
 ) permite finalizar la función actual en un solo paso y volver al punto desde el que se invocó dicha función.
El botón (  ) finaliza la sesión de depuración actual.
El botón (  ) pausa el programa en ejecución en un punto aleatorio (normalmente al inicio de la función OnCalculate o de otras funciones que el terminal invoca periódicamente).
En el panel inferior de la ventana de depuración, a la izquierda, se muestra toda la pila de llamadas: las últimas funciones que se invocaron antes de que se invocara la actual. A la derecha aparece la lista de todas las variables de esta función. Los valores de esta ventana cambiarán automáticamente en cuanto se modifiquen en el programa.
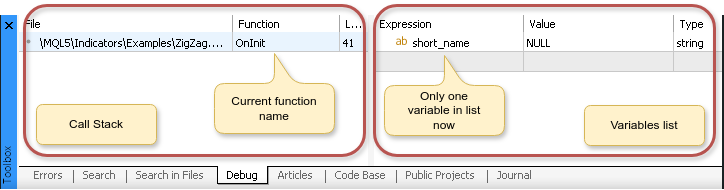
Figura 7. Panel inferior en modo de depuración: lista de variables y pila de llamadas
En la parte derecha de este panel también se pueden añadir algunas expresiones evaluables, como nombres de variables (por ejemplo, globales) o algunas operaciones de tipo aritmético, lógico o bit a bit. Para añadir una expresión a la lista, puede:
- seleccionarla en el texto del programa y pulsar <Shift>+<F9>;
- hacer clic con el botón derecho del ratón sobre la expresión seleccionada y elegir en el menú contextual «Añadir observación» (en inglés: "Add watch");
- hacer doble clic en una línea libre de la ventana de la lista de variables e introducir la expresión directamente.
Para ver el contenido de un array o una estructura, hay que hacer doble clic en él. Sin embargo, es mejor no intentar expandir arrays de tipo «high» o «time» en los indicadores: a veces se puede «colgar» incluso un ordenador potente durante bastante tiempo. Es mejor introducir simplemente en una línea aparte el nombre del array con el índice, por ejemplo, time[i].
Si necesita mostrar un miembro concreto de alguna estructura o clase, la función de autocompletado funciona muy bien: puede poner un punto al final del nombre o pulsar <Ctrl>+<Espacio>; debería aparecer la ventana emergente habitual con sugerencias. Pero, lamentablemente, las llamadas a funciones no se pueden añadir.
Propongo, a modo de ejercicio, analizar algún indicador estándar, por ejemplo, ZigZag. Abra el archivo «Indicators -> Examples -> ZigZag.mq5» y realice en su editor cada una de las acciones descritas en los siguientes apartados.
-
Lo primero que tenemos que hacer es averiguar qué funciones de usuario tiene este indicador. Para acceder a una función, basta con hacer clic en su nombre en la lista (figura 8).
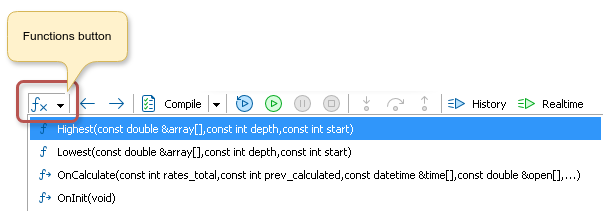
Figura 8. Lista de funciones del indicador ZigZag
-
Coloquemos los puntos de interrupción. Empecemos por la función OnInit, donde marcaremos el inicio (en el momento de escribir este artículo, en mi caso es la línea 41), y en OnCalculate: al principio (línea 66) y donde comienza la búsqueda de extremos (línea 118), para ver en qué se diferencia el funcionamiento de los botones (
 ) y (
 ).
-
Ahora ya podemos ejecutar nuestro programa. En este caso, nos vale cualquiera de los botones de la izquierda. Supongamos que pulsamos el botón verde (
 ).
-
En cuanto el programa se detenga por primera vez en la función OnInit, podemos echarle un vistazo rápido, asegurarnos de que es sencilla —todo está claro en ella— y pulsar sin dudar el botón (
 ) para pasar a la siguiente función.
- La siguiente parada es en la función OnCalculate, en la primera línea, si ha seguido las recomendaciones. Merece la pena analizar esta función en detalle, ya que contiene muchas soluciones útiles para quienes escriben indicadores. Por lo tanto, siéntase libre de explorar y utilice los botones (
 ) o (
 ) para pasar al siguiente paso.
- Para estudiar los bucles for, while y do … while, puede recorrerlos por completo un par de veces, paso a paso, y luego utilizar puntos de interrupción después de finalizar cada bucle y continuar la ejecución de los bucles con el botón (
 ) o (
 ), hasta llegar a la línea 118.
- Recorra el siguiente bucle al menos una vez utilizando el botón (
 ) (Paso con entrada) y preste atención a cómo cambian los valores en la pila de llamadas (que se muestra en la figura 7, a la izquierda).
- Realice la segunda pasada del bucle utilizando el botón (
 ) (Paso por encima) para ver la diferencia.
- El código restante del indicador no aportará nada nuevo en cuanto a técnicas de depuración, así que utilice las técnicas que ya ha aprendido para comprender qué está sucediendo.
- Para finalizar la depuración, puede pulsar el botón (
 ) (finalización de la depuración).
Perfilado
Si tiene varios programas en un gráfico, y hay muchos gráficos de este tipo, es importante que cada programa funcione con rapidez. Sin embargo, a veces ocurre que el programador utiliza algoritmos inadecuados y, aunque la tarea se resuelva, sigue siendo imposible trabajar debido a las ralentizaciones. Esto es especialmente relevante en equipos poco potentes, como netbooks no muy recientes, que todavía a veces se pueden encontrar entre los traders en perfecto estado de funcionamiento.
Para determinar qué función impide que el programa funcione plenamente (o, más concretamente, cómo se distribuye el tiempo entre las funciones), se recurre al perfilado. En este proceso, MetaEditor calcula el tiempo de ejecución de cada función de nuestro programa y, si ese tiempo resulta significativo, lo muestra en forma de diagrama.
Intentemos perfilar el funcionamiento de ese mismo ZigZag. Para ello, se puede utilizar bien la barra de herramientas correspondiente (figura 9), bien el menú «Depuración» (figura 10). El procedimiento de perfilado no se utiliza con mucha frecuencia, por lo que los desarrolladores no han previsto ninguna combinación de teclas para ello.
Figura 9. Panel de control del perfilado.
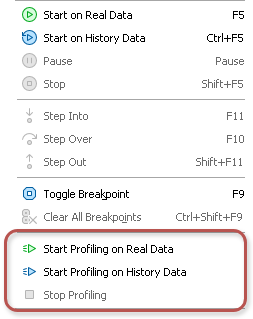
Figura 10. Sección de perfilado del menú «Depuración».
Al igual que en la depuración, el perfilado se puede ejecutar con datos reales o históricos (botones verde y azul, respectivamente). El segundo comando (  ) detiene el proceso de perfilado (en las figuras 9 y 10 aparece inactivo).
Todo el proceso es simple y casi trivial:
- iniciamos el proceso de perfilado pulsando el botón «Inicio»;
- esperamos un rato para que el programa se ejecute por completo;
- detenemos el proceso pulsando el botón «Stop»;
- analizamos los gráficos y corregimos lo que podamos (en el caso de un zigzag, probablemente no haya nada que corregir…).
Al realizar el perfilado de un ZigZag estándar (en uno de esos netbooks tan antiguos), obtuve esta tabla (figura 11):
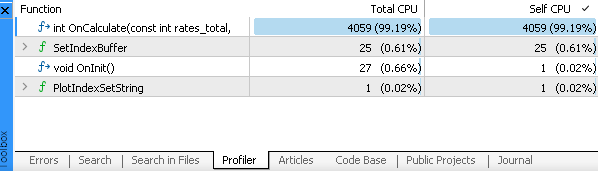
Figura 11. Resultado del perfilado del indicador estándar ZigZag.
Resultó que la función SetIndexBuffer consume la mayor parte del tiempo de OnInit, mientras que Highest y Lowest son tan rápidas que ni siquiera aparecen en esta comparación. Como era de esperar, OnCalculate resultó ser la más lenta, ya que es en ella donde realmente se lleva a cabo la mayor parte del trabajo y, además, se invoca con mucha más frecuencia que OnInit. Es posible que la velocidad de ejecución de esta función pueda mejorarse notablemente.
Los desarrolladores de MetaQuotes han optimizado muy bien el código de este indicador, pero… ¿Quizás precisamente a usted se le ocurra un algoritmo que sea más rápido?
Conclusión
La depuración de aplicaciones es una de las etapas más complejas del ciclo de programación. En algunos proyectos, puede ocupar hasta el 70 % del tiempo, y a veces incluso más. Incluso los proyectos que funcionan bien y cuentan con miles de usuarios pueden contener errores. ¿Y qué decir del código de los principiantes? Pero espero que los métodos de depuración descritos en este artículo ayuden a los programadores principiantes a localizar más fácilmente sus errores y a estudiar de forma eficaz los algoritmos de otros.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/18075
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


 Utilizando redes neuronales en MetaTrader
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 36): Cómo habilitar el acceso directo desde Python a los flujos de mercado de MetaTrader 5
 Particularidades del trabajo con números del tipo double en MQL4
 Reimaginando las estrategias clásicas (Parte 15): Estrategia de ruptura diaria

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso