Algoritmo de circulación coronaria artificial — Artificial Coronary Circulation System (ACCS)
 17
 0

Índice
Introducción
El algoritmo Artificial Coronary Circulation System (ACCS) es un método de optimización metaheurístico inspirado en la biología. El ACCS imita el crecimiento de las arterias coronarias en el corazón humano. La idea es que cada arteria o capilar constituye una solución candidata, y que todo el proceso de crecimiento del sistema vascular es análogo a la búsqueda de la solución óptima en un espacio complejo de soluciones. El algoritmo fue propuesto por A. Kaveh y M. Kooshkbaghi en 2019, en el artículo «Artificial coronary circulation system: A new bio-inspired metaheuristic algorithm».
Implementación del algoritmo
Imagine que su corazón no es solo una bomba, sino un sabio arquitecto que construye caminos perfectos para la sangre. Cada segundo resuelve un problema de lo más complejo: cómo suministrar la máxima cantidad de oxígeno consumiendo la mínima cantidad de energía. Los científicos se inspiraron en esta estrategia genial y decidieron crear, partiendo de ella, el algoritmo ACCS.
Al principio, el caos. Al igual que en la naturaleza, cuando los capilares empiezan a formarse, ACCS genera una población aleatoria de soluciones. El líder capilar (CL), que comienza a buscar el camino hacia la solución óptima, se evalúa en función del factor de crecimiento coronario (CGF); se trata de una especie de nivel de energía que indica en qué medida está llevando a cabo la tarea con éxito. Cada capilar elige cómo crecer: búsqueda —se extiende hacia delante, como una raíz, con la esperanza de encontrar un suelo fértil—; ramificación —si las condiciones son buenas, crea nuevas ramas, como un árbol que echa brotes—; y poda —si el crecimiento es inútil, se detiene para no malgastar recursos—.
La memoria del corazón. Para no olvidar cuáles fueron las ramas más fuertes, ACCS utiliza Heart Memory (HM), un diario en el que se anotan las mejores soluciones. Estos registros sirven de guía para el crecimiento y ayudan a que los nuevos capilares crezcan en la dirección correcta.
Autoaprendizaje y adaptación. Si el capilar crece en la dirección equivocada, el algoritmo activa la búsqueda local: empieza a excavar a su alrededor, como una raíz que busca agua. Si, de repente, el capilar resulta ser el mejor, se pone en marcha una búsqueda global, como si el árbol hubiera decidido crecer en una nueva dirección.
El ACCS no es mera matemática, sino el arte de aprender de la naturaleza. Su corazón lleva toda la vida resolviendo problemas de optimización de lo más complejos, y ahora los algoritmos pueden aprovechar esa misma sabiduría: explore de forma variada (como las arterias coronarias), recuerde lo mejor (como la memoria del corazón), deje atrás los fracasos (como la poda de los vasos sanguíneos) y mantenga el equilibrio entre la búsqueda global y el ajuste local.
Este algoritmo nos recuerda que, con frecuencia, las mejores soluciones ya se encuentran en la naturaleza. Solo hay que saber detectarlas y aprender de la sabiduría que late en el pecho de cada uno de nosotros. Podemos ver cómo se representa en la ilustración.
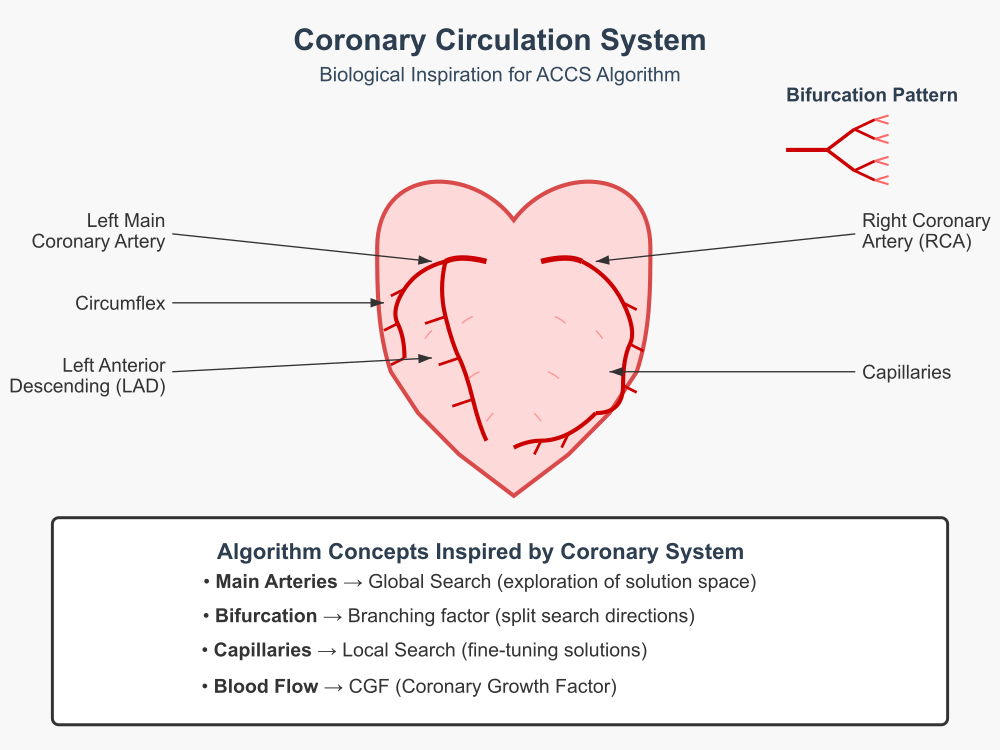
Figura 1. Sistema coronario
En la imagen se muestran los elementos principales: una representación esquemática del corazón con las arterias coronarias. La arteria coronaria izquierda (LCA) con sus ramas, la descendente anterior izquierda (LAD) y la circunfleja; la arteria coronaria derecha (RCA); pequeños capilares para ilustrar la búsqueda local; y un patrón de bifurcación (ramificación) en la parte superior derecha.
Conceptos del algoritmo. En la parte inferior se muestra cómo los elementos biológicos se corresponden con los componentes del algoritmo:
Arterias principales → Búsqueda global
Bifurcación → Factor de ramificación
Capilares → Búsqueda local
Flujo sanguíneo → CGF (factor de crecimiento)
Esta representación visual ayuda a comprender cómo el sistema natural de irrigación sanguínea del corazón ha servido de inspiración para crear un algoritmo de optimización, en el que las «arterias» exploran el espacio de soluciones y los «capilares» realizan el ajuste preciso de las soluciones encontradas. Vamos a escribir el pseudocódigo del algoritmo.
-
Inicialización
-
Establecer los parámetros: tamaño de la población (popSize), tamaño de la memoria del corazón (heartMemorySize)
-
Crear una población inicial de capilares (agentes) con posiciones aleatorias en el espacio de soluciones
-
Inicializar la memoria del corazón (Heart Memory) para almacenar las mejores soluciones
-
-
Ciclo principal (hasta que se cumpla el criterio de parada)
-
Calcular el factor de crecimiento coronario (CGF) para cada agente en función de sus valores de fitness.
-
Realizar una búsqueda global (crecimiento de las arterias): actualizar las posiciones de los agentes, desplazándose hacia el centro de la población o alejándose de él, en función del CGF
-
Comprobar los límites y actualizar la memoria del corazón
-
Realizar una búsqueda local (crecimiento de capilares): actualizar las posiciones de los agentes, desplazándose hacia el mejor agente y alejándose del peor, teniendo en cuenta el factor de la angiogénesis.
-
Comprobar los límites y actualizar la memoria del corazón
-
Aumentar el contador de iteraciones
-
-
Cálculo del CGF (factor de crecimiento coronario)
-
Para cada agente, calcular el CGF como su valor de fitness dividido entre la suma de los valores de fitness de todos los agentes (normalización).
-
-
Búsqueda global (Global Search)
-
Calcular el centro de la población (media de todas las coordenadas)
-
Para cada agente:
-
elegir al azar otro agente distinto del actual;
-
determinar la dirección del movimiento (dr): si el CGF del centro es menor que el CGF del agente actual, entonces dr = -1 (alejarse del centro); en caso contrario, dr = 1 (acercarse al centro);
-
Actualizar la posición: nueva posición = posición del agente aleatorio + dr * CGF del agente actual * (centro - posición del agente aleatorio).
-
-
-
Búsqueda local (Local Search)
-
Calcular el factor de angiogénesis (alpha) como angiogenesisPower * sqrt(iteración_actual / iteración_máxima)
-
Encontrar el mejor y el peor agente de la población actual
-
Actualizar la posición de cada agente: nueva posición = posición actual + alpha * número_aleatorio * (posición_mejor - posición_peor)
-
-
Actualización de la memoria del corazón (Heart Memory)
-
Ordenar los agentes por su valor de fitness en orden descendente
-
Guardar los mejores agentes (en una cantidad igual a heartMemorySize) en la memoria del corazón
-
-
Criterio de parada
-
Se ha alcanzado el número máximo de iteraciones
-
Veamos el esquema de funcionamiento del algoritmo.

Figura 2. Diagrama de flujo del algoritmo ACCS
Pasos del algoritmo representados en el diagrama de flujo:
- inicialización de la población de capilares (posiciones aleatorias),
- cálculo de la función de fitness para cada capilar,
- cálculo del factor de crecimiento coronario (CGF),
- búsqueda global (movimiento hacia el centro o alejándose de él),
- búsqueda local (movimiento hacia el mejor agente y alejándose del peor),
- poda (si la nueva posición es peor, volvemos atrás),
- actualización de la memoria del corazón,
- comprobación del criterio de parada.
Ahora ya tenemos más o menos claro cómo debe funcionar todo, así que vamos a ponernos a escribir el código del algoritmo. Tenemos ante nosotros dos estructuras de datos relacionadas, diseñadas para la optimización y el almacenamiento de información sobre las soluciones.
La primera estructura, denominada «Memoria del corazón» (Heart Memory), está destinada al almacenamiento temporal y la evaluación de las mejores soluciones encontradas, y contiene:
- Una posición es un conjunto de valores numéricos que definen una solución concreta, representada por un punto en el espacio de búsqueda. Estos valores pueden considerarse como las coordenadas de esta solución.
- Fitness: valor numérico que indica la «calidad» de la posición correspondiente. Cuanto mayor sea el fitness, mejor será la solución.
- Inicialización: este componente de la estructura permite especificar el tamaño (número de dimensiones) de la posición y establecer el valor inicial del fitness en un nivel extremadamente bajo, de modo que cualquier solución encontrada se considere mejor.
La segunda estructura, denominada «Posición temporal» (TempPosition), se utiliza para almacenar de forma provisional las nuevas soluciones, recién generadas o calculadas, antes de que sean evaluadas y guardadas en la «memoria del corazón»; incluye:
- Las coordenadas —al igual que la «posición» en la primera estructura— son un conjunto de valores numéricos que determinan una solución concreta.
- Fitness: valor numérico que se asignará a esta solución tras su evaluación.
- Inicialización: al igual que en la primera estructura, este componente permite definir el tamaño (número de dimensiones) de las coordenadas y establecer el valor inicial del fitness en un nivel extremadamente bajo hasta que la solución se haya procesado por completo.
//————————————————————————————————————————————————————————————————————
// Estructura para almacenar la memoria del corazón (Heart Memory)
struct S_HeartMemory
{
    double position [];  // posición en la memoria
    double fitness;      // fitness de la posición

    void Init (int dimensions)
    {
      ArrayResize (position, dimensions);
      fitness = -DBL_MAX;
    }
};

// Estructura para el almacenamiento temporal de nuevas posiciones
struct S_TempPosition
{
    double coords [];   // coordenadas
    double fitness;     // fitness

    void Init (int dimensions)
    {
      ArrayResize (coords, dimensions);
      fitness = -DBL_MAX;
    }
};
//————————————————————————————————————————————————————————————————————
La clase «C_AO_ACCS» implementa un algoritmo de optimización denominado «Sistema artificial de circulación coronaria» (Artificial Coronary Circulation System, ACCS). Esta clase hereda de la clase base «AO».
Campos públicos (public) de la clase:
- El destructor es una función especial que se ejecuta al destruir un objeto de esta clase, lo que garantiza la liberación de los recursos.
- El constructor es una función que se invoca al crear un nuevo objeto e inicializa los parámetros principales del algoritmo:
- Establece el tamaño predeterminado de la población (número de «capilares»): 25.
- Establece el coeficiente de bifurcación por defecto en 0,5.
- Crea una estructura para almacenar los parámetros modificables y guarda en ella los valores iniciales de «popSize» y «bifurcationRate».
- SetParams () — función para establecer o actualizar los parámetros del algoritmo. Lee los valores actuales de los parámetros enumerados y, además, establece el tamaño de la «memoria del corazón» en el 25 % del tamaño de la población, con un mínimo de 1.
- Init () — función destinada a la inicialización del algoritmo. Recibe información sobre los intervalos de búsqueda, los incrementos y el número de épocas (iteraciones).
- Moving () — función encargada de desplazar o actualizar los agentes (capilares) en el espacio de búsqueda.
- Revision () — función encargada de revisar y corregir las soluciones basándose en la lógica del algoritmo.
- bifurcationRate — coeficiente de bifurcación, que influye en el proceso de generación de nuevas soluciones y en la ramificación de la búsqueda.
Campos privados (private) de la clase:
- CalculateCGF () — función interna para calcular el indicador denominado «CGF» para cada agente.
- CalculateCenterPosition () — función interna para determinar la posición central de la población.
- GlobalSearch () — función interna encargada de la búsqueda global, es decir, de la exploración de una amplia región del espacio de soluciones.
- LocalSearch () — función interna encargada de la búsqueda local, es decir, una exploración más detallada de la zona que rodea las soluciones actuales.
- SelectionPhase () — función interna que implementa la fase de selección, es decir, la elección de las mejores soluciones para su desarrollo posterior.
- UpdateHeartMemory () — función interna para actualizar la «memoria del corazón» con las mejores soluciones encontradas.
- heartMemorySize — número que determina el número máximo de soluciones que se pueden guardar en la «memoria del corazón».
- heartMemory — array de objetos que representan la «memoria del corazón», donde se almacenan las mejores soluciones encontradas.
- tempPos — array de objetos temporales que se utilizan para almacenar nuevas posiciones aún no evaluadas, principalmente para la búsqueda global.
- cgf — array que almacena los valores «CGF» de cada agente de la población.
- cgfCenter — valor escalar que representa el «CGF» del centro de la población.
- centerCoords — array que almacena las coordenadas del centro de la población.
- centerFitness — valor numérico que representa la calidad (fitness) de la posición central.
- alpha — variable que representa un coeficiente relacionado con el proceso de «angiogénesis» (crecimiento y desarrollo).
- currentIteration — variable que registra el número de la iteración (paso) actual del algoritmo.
- maxIterations — variable que establece el número máximo de iteraciones que puede realizar el algoritmo.
- firstIteration — indicador lógico que señala si la iteración actual es la primera.
//————————————————————————————————————————————————————————————————————
class C_AO_ACCS : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_ACCS () { }
  C_AO_ACCS ()
  {
    ao_name = "ACCS";
    ao_desc = "Artificial Coronary Circulation System";
    ao_link = "https://www.mql5.com/ru/articles/19861";

    popSize         = 50;    // tamaño de la población (número de capilares)
    bifurcationRate = 0.5;   // coeficiente de bifurcación

    ArrayResize (params, 2);

    params [0].name = "popSize";         params [0].val = popSize;
    params [1].name = "bifurcationRate"; params [1].val = bifurcationRate;
  }

  void SetParams ()
  {
    popSize         = (int)params [0].val;
    bifurcationRate = params      [1].val;

    // Tamaño de la memoria del corazón: 25 % de la población
    heartMemorySize = MathMax (1, (int)(popSize * 0.25));
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP);

  void Moving   ();
  void Revision ();

  private:
  void CalculateCGF ();
  void CalculateCenterPosition ();
  void GlobalSearch ();
  void LocalSearch ();
  void SelectionPhase ();
  void UpdateHeartMemory ();

  //------------------------------------------------------------------
  public:
  double bifurcationRate;   // coeficiente de bifurcación

  private: //---------------------------------------------------------
  int    heartMemorySize;       // tamaño de la memoria del corazón
  S_HeartMemory heartMemory []; // memoria del corazón
  S_TempPosition tempPos [];    // posiciones provisionales para la búsqueda global
  double cgf [];                // array CGF para cada agente
  double cgfCenter;             // CGF del centro
  double centerCoords [];       // coordenadas del centro de la población
  double centerFitness;         // fitness del centro
  double alpha;                 // factor actual de angiogénesis
  int    currentIteration;      // iteración actual
  int    maxIterations;         // número máximo de iteraciones
  bool   firstIteration;        // indicador de la primera iteración
};
//————————————————————————————————————————————————————————————————————
El método de inicialización «Init» de la clase «C_AO_ACCS» está destinado a preparar los parámetros y las estructuras de datos antes de ejecutar el algoritmo de optimización. Acepta los rangos de búsqueda de las variables, los pasos de variación y el número de épocas (iteraciones). El proceso comienza con la llamada a una función de inicialización estándar, que comprueba que los intervalos y los pasos especificados sean correctos. Si esta comprobación falla, la inicialización finaliza con un error.
A continuación, se establece el tamaño de la «memoria del corazón» en el 25 % del tamaño de la población, con un mínimo de un elemento. A partir de este tamaño, se crea un array de estructuras «memoria del corazón» y a cada elemento se le asignan parámetros iniciales en forma de «coordenadas» (identificadas como coords). Luego se crea un array de posiciones temporales, de un tamaño igual al de la población, para almacenar las nuevas soluciones que se generarán en la siguiente fase. A cada elemento de este array se le asignan también unos parámetros iniciales.
Asimismo, se inicializan los arrays para almacenar los valores de CGF de cada agente y las coordenadas del centro de la población. La secuencia finaliza estableciendo la iteración actual en cero, fijando el número máximo de iteraciones según los parámetros de entrada, estableciendo el indicador de la primera iteración en «verdadero» y asignando el valor inicial al factor de angiogénesis («alpha»). En definitiva, tras ejecutar este método, el algoritmo dispone de todas las estructuras y los parámetros necesarios para iniciar la optimización.
//————————————————————————————————————————————————————————————————————
//--- Inicialización
bool C_AO_ACCS::Init (const double &rangeMinP  [],
                      const double &rangeMaxP  [],
                      const double &rangeStepP [],
                      const int     epochsP)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Tamaño de la memoria del corazón: 25 % de la población
  heartMemorySize = MathMax (1, (int)(popSize * 0.25));

  // Inicialización de la memoria del corazón
  ArrayResize (heartMemory, heartMemorySize);
  for (int i = 0; i < heartMemorySize; i++)
  {
    heartMemory [i].Init (coords);
  }

  // Inicialización de posiciones temporales
  ArrayResize (tempPos, popSize);
  for (int i = 0; i < popSize; i++)
  {
    tempPos [i].Init (coords);
  }

  // Inicialización de arrays
  ArrayResize (cgf, popSize);
  ArrayResize (centerCoords, coords);

  currentIteration = 0;
  maxIterations = epochsP;
  firstIteration = true;
  alpha = 0.625;

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «CalculateCGF» está diseñado para calcular los coeficientes de crecimiento (CGF) de cada agente de la población, con el fin de evaluar su contribución al desarrollo del sistema.
El proceso comienza con la determinación de los valores mínimo y máximo de fitness entre todas las soluciones. Si todos los valores de fitness son iguales, a cada agente se le asigna el mismo CGF, igual a 1 dividido entre el número total de agentes, para garantizar un trato igualitario. Si, por el contrario, los valores de fitness son distintos, el fitness de cada agente se normaliza teniendo en cuenta los valores mínimo y máximo, y se añade un pequeño desplazamiento al resultado para estabilizar los cálculos. A continuación, se calcula la suma de todos los valores de fitness normalizados. A cada agente se le asigna un CGF proporcional a su fitness ajustado con respecto a la suma. De forma análoga, se calcula el CGF para el centro de la población.
Este método garantiza una distribución ponderada de la influencia de cada solución en las etapas posteriores del algoritmo en función de su calidad.
//————————————————————————————————————————————————————————————————————
//--- Cálculo del CGF (factor de crecimiento coronario) según la Ley 2
void C_AO_ACCS::CalculateCGF ()
{
  // Para maximizar: CGFi = fiti / Σfiti

  double minFit = DBL_MAX;
  double maxFit = -DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f < minFit) minFit = a [i].f;
    if (a [i].f > maxFit) maxFit = a [i].f;
  }

  double sumFitness = 0.0;

  // Si todos los valores de fitness son iguales
  if (MathAbs (maxFit - minFit) < 1e-10)
  {
    for (int i = 0; i < popSize; i++)
    {
      cgf [i] = 1.0 / popSize;
    }
    cgfCenter = 1.0 / popSize;
    return;
  }

  // Normalizamos los valores de fitness y calculamos la suma
  for (int i = 0; i < popSize; i++)
  {
    double normalizedFit = (a [i].f - minFit) / (maxFit - minFit) + 0.1;
    sumFitness += normalizedFit;
  }

  // Calculamos el CGF para cada capilar
  for (int i = 0; i < popSize; i++)
  {
    double normalizedFit = (a [i].f - minFit) / (maxFit - minFit) + 0.1;
    cgf [i] = normalizedFit / sumFitness;
  }

  // CGF para el centro
  double normalizedCenterFit = (centerFitness - minFit) / (maxFit - minFit) + 0.1;
  cgfCenter = normalizedCenterFit / sumFitness;
}
//————————————————————————————————————————————————————————————————————
El método «CalculateCenterPosition» sirve para calcular el centro de la población a partir de las coordenadas y el valor de fitness. Comienza poniendo a cero el array de coordenadas del centro y la variable para acumular el fitness. A continuación, en un bucle que abarca toda la población, se suman las coordenadas de cada solución para cada variable, así como sus valores de fitness. Luego se dividen las sumas acumuladas entre el tamaño de la población para obtener los valores medios de las coordenadas, que constituyen las coordenadas del centro. Del mismo modo, se determina el nivel medio de fitness, lo que permite evaluar la calidad de este centro.
Este método permite determinar el punto central de toda la población, lo cual es importante para los cálculos posteriores y la elaboración de nuevas soluciones.
//————————————————————————————————————————————————————————————————————
//--- Cálculo de la posición central (Ley 3)
void C_AO_ACCS::CalculateCenterPosition ()
{
  // Xc = mean(X), fitc = mean(fit)
  ArrayInitialize (centerCoords, 0.0);
  centerFitness = 0.0;

  for (int i = 0; i < popSize; i++)
  {
    for (int j = 0; j < coords; j++)
    {
      centerCoords [j] += a [i].c [j];
    }
    centerFitness += a [i].f;
  }

  for (int j = 0; j < coords; j++)
  {
    centerCoords [j] /= popSize;
  }
  centerFitness /= popSize;
}
//————————————————————————————————————————————————————————————————————
El método «GlobalSearch» lleva a cabo una búsqueda global de nuevas posiciones para las soluciones con el objetivo de desarrollar las arterias principales de la población, basándose en la ley 4.
Comienza con una pasada por toda la población; para cada solución se elige un agente al azar (excepto el actual). A continuación, se calcula el factor de bifurcación, proporcional a su «CGF», que influye en la magnitud del cambio. La dirección de la búsqueda se determina comparando el «CGF» del agente actual con el centro de la población: si el «CGF» del agente actual es mayor que el del centro, se elige una dirección; en caso contrario, se elige la dirección opuesta. Para cada parámetro de coordenadas se calcula un nuevo valor mediante una fórmula que depende de la dirección elegida, del factor de bifurcación y de un número aleatorio, lo que aporta un elemento de aleatoriedad y variedad. Después se comprueba el nuevo valor de la coordenada mediante el método «u.SeInDiSp» y, si es necesario, se corrige para mantenerlo dentro de los rangos permitidos.
Este método permite que la solución «crezca» y se desplace por el espacio de búsqueda, lo que fomenta la exploración de nuevas áreas.
//————————————————————————————————————————————————————————————————————
//--- Búsqueda global: crecimiento de las arterias principales (Ley 4)
void C_AO_ACCS::GlobalSearch ()
{
  for (int i = 0; i < popSize; i++)
  {
    // Elegimos un capilar aleatorio r (que no sea el actual)
    int r = i;
    while (r == i && popSize > 1)
    {
      r = (int)MathFloor (u.RNDfromCI (0.0, popSize - 0.001));
      if (r >= popSize) r = popSize - 1;
      if (r < 0) r = 0;
    }

    // Factor de bifurcación Bf = CGFi
    double Bf = cgf [i] * bifurcationRate;

    // Determinamos la dirección basándonos en la comparación de los valores de CGF
    double dir;
    if (cgfCenter < cgf [i])  // Según el documento
    {
      dir = -1.0;
    }
    else
    {
      dir = 1.0;
    }

    // Aplicamos la fórmula de la Ley 4
    for (int j = 0; j < coords; j++)
    {
      double rand_val = u.RNDfromCI (0.0, 1.0);

      // X^(t+1)_i,j = X^t_r,j + dir × Bf × (X^t_c,j - rand × X^t_r,j)
      tempPos [i].coords [j] = a [r].c [j] + dir * Bf * (centerCoords [j] - rand_val * a [r].c [j]);

      // Comprobación de límites
      tempPos [i].coords [j] = u.SeInDiSp (tempPos [i].coords [j], rangeMin [j], rangeMax [j], rangeStep [j]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «LocalSearsh» lleva a cabo una búsqueda local destinada a desarrollar capilares dentro del algoritmo. Comienza con la actualización del factor de crecimiento de los capilares, que depende de la iteración actual y del número máximo de iteraciones: cuantas más iteraciones hayan transcurrido, mayor será el valor del factor. A continuación, se determinan la solución más adecuada y la menos adecuada de la población actual, con el fin de realizar un ajuste local basándose en ellas.
Para cada solución y para cada coordenada se calcula sucesivamente una nueva posición, que se desplaza en la dirección de la diferencia entre las coordenadas de la mejor y la peor solución, teniendo en cuenta el peso aleatorio y el factor de crecimiento. Tras el cálculo, el nuevo valor se comprueba y se corrige mediante el método «u.SeInDiSp» para que permanezca dentro del rango admisible. Este procedimiento contribuye a mejorar las soluciones en la región local de búsqueda, aumentando su calidad y acercándolas al óptimo.
//————————————————————————————————————————————————————————————————————
//--- Búsqueda local: crecimiento de capilares (Ley 6)
void C_AO_ACCS::LocalSearch ()
{
  // Actualizamos el factor de angiogénesis: α = 0,625 × √(itr/itrmax)
  if (maxIterations > 0 && currentIteration > 0)
  {
    alpha = 0.625 * MathSqrt ((double)currentIteration / (double)maxIterations);
  }
  else
  {
    alpha = 0.625;
  }

  // Encontramos la mejor y la peor posición en la población actual
  int bestIdx = 0, worstIdx = 0;

  for (int i = 1; i < popSize; i++)
  {
    if (a [i].f > a [bestIdx].f) bestIdx = i;
    if (a [i].f < a [worstIdx].f) worstIdx = i;
  }

  // Aplicamos la búsqueda local (Ley 6)
  for (int i = 0; i < popSize; i++)
  {
    for (int j = 0; j < coords; j++)
    {
      double rand_val = u.RNDfromCI (0.0, 1.0);

      // X^(t+1)_i,j = X^t_i,j + α × rand × (X^t_b,j - X^t_w,j)
      a [i].c [j] = a [i].c [j] + alpha * rand_val * (a [bestIdx].c [j] - a [worstIdx].c [j]);

      // Comprobación de límites
      a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «SelectionPhase» implementa la fase de selección, en la que se actualizan las soluciones actuales basándose en los resultados de la búsqueda global. Para cada elemento de la población, sus coordenadas actuales se sustituyen por las nuevas, obtenidas previamente durante el proceso de búsqueda global. Esto se hace copiando las nuevas posiciones de los arrays temporales a los arrays principales de soluciones. De esta forma, la fase de selección da paso a nuevas soluciones potencialmente más eficaces, que sirven de preparación para la siguiente etapa del algoritmo.
//————————————————————————————————————————————————————————————————————
//--- Fase de selección (Ley 5)
void C_AO_ACCS::SelectionPhase ()
{
  // Aplicamos las nuevas posiciones obtenidas en la búsqueda global
  for (int i = 0; i < popSize; i++)
  {
    // Copiamos la nueva posición
    ArrayCopy (a [i].c, tempPos [i].coords, 0, 0, coords);
  }
}
//————————————————————————————————————————————————————————————————————
El método «UpdateHeartMemory» se encarga de actualizar la memoria del corazón en el algoritmo, lo que sirve como mecanismo para recordar las mejores soluciones encontradas. Para ello, todas las soluciones actuales se ordenan según el valor de su función de fitness, en orden descendente, de modo que las mejores aparecen al principio. Tras la ordenación, se selecciona el número especificado de mejores soluciones y sus coordenadas, junto con los valores de fitness correspondientes, se guardan en una memoria específica.
Este proceso ayuda a conservar las mejores soluciones y a utilizarlas posteriormente para orientar la búsqueda, manteniendo un equilibrio entre la exploración y la explotación del espacio de soluciones.
//————————————————————————————————————————————————————————————————————
//--- Actualización de la memoria del corazón (Ley 7)
void C_AO_ACCS::UpdateHeartMemory ()
{
  // Creamos un array temporal para ordenar
  struct S_IndexedAgent
  {
    int index;
    double fitness;
  };

  S_IndexedAgent indexed [];
  ArrayResize (indexed, popSize);

  for (int i = 0; i < popSize; i++)
  {
    indexed [i].index = i;
    indexed [i].fitness = a [i].f;
  }

  // Ordenación por burbuja en orden descendente de fitness
  for (int i = 0; i < popSize - 1; i++)
  {
    for (int j = i + 1; j < popSize; j++)
    {
      if (indexed [j].fitness > indexed [i].fitness)
      {
        S_IndexedAgent temp = indexed [i];
        indexed [i] = indexed [j];
        indexed [j] = temp;
      }
    }
  }

  // Guardamos las mejores soluciones en la memoria del corazón
  for (int i = 0; i < heartMemorySize; i++)
  {
    int idx = indexed [i].index;
    ArrayCopy (heartMemory [i].position, a [idx].c, 0, 0, coords);
    heartMemory [i].fitness = a [idx].f;
  }
}
//————————————————————————————————————————————————————————————————————
El paso principal del método «Moving» del algoritmo consiste en la ejecución secuencial de varias etapas clave. En la fase inicial tiene lugar la inicialización de la población: la generación aleatoria de soluciones iniciales dentro de los rangos admisibles, teniendo en cuenta los pasos establecidos, lo cual se lleva a cabo únicamente una vez antes de iniciar las iteraciones posteriores. Tras la inicialización, se actualiza el contador interno de iteraciones.
A continuación, el algoritmo pasa a calcular la posición central, que sirve de punto de referencia para la búsqueda. Luego se calcula el factor de crecimiento coronario (CGF), que ayuda a determinar la importancia y la contribución de cada elemento. Después se lleva a cabo una búsqueda global de nuevas soluciones a partir de los datos obtenidos, lo que amplía el espacio explorado. Al final de cada ciclo tiene lugar un proceso de selección, durante el cual las soluciones actuales se sustituyen por otras nuevas obtenidas durante la búsqueda. Este ciclo se repite para ir mejorando progresivamente las soluciones.
//————————————————————————————————————————————————————————————————————
//--- Paso principal del algoritmo
void C_AO_ACCS::Moving ()
{
  // Inicialización de la población (Ley 1)
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    firstIteration = true;
    currentIteration = 0;
    return;
  }

  currentIteration++;

  // Calculamos la posición central (Ley 3)
  CalculateCenterPosition ();

  // Calculamos el CGF para todos los capilares (Ley 2)
  CalculateCGF ();

  // Realizamos una búsqueda global (Ley 4)
  GlobalSearch ();

  // Aplicamos la selección (Ley 5)
  SelectionPhase ();
}
//————————————————————————————————————————————————————————————————————
El método «Revision» se encarga de comprobar las soluciones actuales y actualizar sus datos para su posterior uso en el algoritmo.
En primer lugar, en la primera iteración se inicializan las mejores posiciones individuales de cada agente y se memoriza la mejor solución de toda la población, lo que contribuye a conservar las soluciones más exitosas. A continuación, para cada individuo se guardan su posición actual y el valor de la función de evaluación como valores anteriores. Luego se comparan las nuevas soluciones con las mejores soluciones personales: si la nueva posición es peor, existe la posibilidad de que se revierta a la mejor posición personal (poda), lo que ayuda a evitar un empeoramiento de los resultados. Si la solución ha mejorado, se convierte en la nueva mejor solución personal.
Acto seguido, se realiza una búsqueda local para optimizar las soluciones, se actualiza la memoria del corazón mediante el método correspondiente y, por último, se comprueba y actualiza la mejor solución global de toda la población.
//————————————————————————————————————————————————————————————————————
//--- Comprobación y actualización de los resultados
void C_AO_ACCS::Revision ()
{
  if (firstIteration)
  {
    firstIteration = false;
    // Inicializamos las mejores posiciones personales
    for (int i = 0; i < popSize; i++)
    {
      a [i].fB = a [i].f;
      ArrayCopy (a [i].cB, a [i].c, 0, 0, coords);
    }
    // Inicializamos la memoria del corazón
    UpdateHeartMemory ();
  }

  // Guardamos las posiciones y los valores de fitness anteriores
  for (int i = 0; i < popSize; i++)
  {
    ArrayCopy (a [i].cP, a [i].c, 0, 0, coords);
    a [i].fP = a [i].f;
  }

  // Tras evaluar el fitness de las nuevas posiciones obtenidas mediante la búsqueda global,
  // comprobamos si hay una mejora (Ley 5: selección y poda)
  for (int i = 0; i < popSize; i++)
  {
    // Si la nueva posición es peor que la mejor posición anterior de este agente
    if (a [i].f < a [i].fB)
    {
      // Probabilidad de poda (pruning)
      double pruningProb = 0.2;
      if (u.RNDfromCI (0.0, 1.0) < pruningProb)
      {
        // Poda: volver a la mejor posición personal
        ArrayCopy (a [i].c, a [i].cB, 0, 0, coords);
        a [i].f = a [i].fB;
      }
    }
    else
    {
      // Actualizamos la mejor solución personal del agente
      a [i].fB = a [i].f;
      ArrayCopy (a [i].cB, a [i].c, 0, 0, coords);
    }
  }

  // Realizamos una búsqueda local (Ley 6)
  LocalSearch ();

  // Actualizamos la memoria del corazón (Ley 7)
  UpdateHeartMemory ();

  // Actualizamos la mejor solución global
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Resultados de las pruebas
Los resultados de las pruebas son, por decirlo suavemente, mediocres. Pero hay un gran «PERO», y de eso hablaré más adelante.
ACCS|Artificial Coronary Circulation System|50.0|0.5|
=============================
5 Hilly's; Func runs: 10000; result: 0.5388483416731469
25 Hilly's; Func runs: 10000; result: 0.40315510603699484
500 Hilly's; Func runs: 10000; result: 0.2750619992528315
=============================
5 Forest's; Func runs: 10000; result: 0.4373687177939665
25 Forest's; Func runs: 10000; result: 0.24807871438181
500 Forest's; Func runs: 10000; result: 0.17536977563388764
=============================
5 Megacity's; Func runs: 10000; result: 0.3692307692307693
25 Megacity's; Func runs: 10000; result: 0.2116923076923077
500 Megacity's; Func runs: 10000; result: 0.10640000000000094
=============================
All score: 2.76521 (30.72%)
Ejecutemos ahora el script de prueba con el algoritmo. Lo primero que llama la atención es que la forma en que se mueven los agentes en el espacio de búsqueda varía considerablemente en función de las características de la superficie de la función estudiada, lo que, de hecho, constituye una característica distintiva de los algoritmos de optimización que merecen especial atención.

ACCS en la función de prueba Hilly

ACCS en la función de prueba Forest

ACCS en la función de prueba Megacity
El mecanismo de búsqueda global mediante el movimiento respecto al centro de la población, teniendo en cuenta la dirección, resulta bastante eficaz para determinados tipos de problemas en los que los extremos se encuentran exactamente en el centro de la función. El algoritmo los resuelve fácilmente, ya que la estrategia de búsqueda se basa en el promedio; una simple coincidencia ya supone una ventaja en la búsqueda. Por tanto, para evaluar el algoritmo de forma “justa”, se necesitan funciones de prueba que planteen problemas de optimización no triviales.
En todos estos tipos de funciones estándar, el algoritmo «funciona» de maravilla; sin embargo, ocurre todo lo contrario con paisajes más complejos, como los de nuestras funciones de prueba (véase más arriba). Existe otra hipótesis (que requiere verificación): la excelente convergencia en estas funciones con un extremo en el centro podría deberse a que son simétricas simultáneamente en dos planos.

ACCS en la función de prueba estándar «Paraboloid»

ACCS en la función de prueba estándar de Ackley

ACCS en la función de prueba estándar de Rastrigin
En la tabla de clasificación, el algoritmo ACCS se presenta a título informativo.
| N.º | AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | DOAdingom | dingo_optimization_algorithm_M | 0,47968 | 0,45367 | 0,46369 | 1,39704 | 0,94145 | 0,87909 | 0,91454 | 2,73508 | 0,78615 | 0,86061 | 0,84805 | 2,49481 | 6,627 | 73,63 |
| 2 | ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 3 | CLA | code lock algorithm (joo) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| 4 | AMOm | animal migration optimization M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 5 | (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 6 | CTA | comet tail algorithm (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| 7 | TETA | time evolution travel algorithm (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| 8 | SDSm | stochastic diffusion search M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 9 | BOAm | billiards optimization algorithm M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| 10 | AAm | archery algorithm M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| 11 | ESG | evolution of social groups (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| 12 | SIA | simulated isotropic annealing (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 13 | EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| 14 | BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 15 | ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 16 | DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 17 | BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 18 | ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 19 | RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 20 | AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 21 | TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 22 | BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4,959 | 55,10 |
| 23 | DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 24 | SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 25 | CRO | chemical reaction optimisation | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| 26 | BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 27 | DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4,825 | 53,62 |
| 28 | BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1,12012 | 4,809 | 53,44 |
| 29 | DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4,762 | 52,91 |
| 30 | HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 31 | SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 32 | BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| 33 | ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 34 | (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| 35 | FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 36 | TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| 37 | BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 38 | WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 39 | AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| 40 | AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 41 | CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 42 | ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 43 | CMAES | covariance_matrix_adaptation_evolution_strategy | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| 44 | DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| 45 | BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| ACCS | artificial_coronary_circulation_system | 0,53885 | 0,40316 | 0,27507 | 1,21708 | 0,43737 | 0,24807 | 0,17537 | 0,86081 | 0,36923 | 0,21169 | 0,10640 | 0,68732 | 2,765 | 30,72 | |
| RW | random walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26,09 | |
Conclusiones
El algoritmo ACCS constituye un interesante intento de trasladar el modelo biológico del crecimiento de las arterias coronarias a los problemas de optimización; sin embargo, su aplicación práctica ha puesto de manifiesto importantes limitaciones. Un resultado del 30 % del máximo posible pone de manifiesto problemas fundamentales en la mecánica del algoritmo, que le impiden competir con los mejores métodos de optimización. La principal debilidad radica en la excesiva dependencia de la distribución actual de la población a través del mecanismo «CGF», lo que da lugar a una convergencia prematura y a una exploración insuficiente del espacio de búsqueda.
El mecanismo de búsqueda global mediante el movimiento respecto al centro de la población, teniendo en cuenta la dirección determinada por la comparación de los valores de CGF, resulta poco eficaz para salir de los óptimos locales, especialmente en paisajes multimodales complejos. La búsqueda local, basada en el movimiento entre la mejor y la peor solución con un factor de angiogénesis decreciente, quizá esté demasiado simplificada y no tenga en cuenta la topología del espacio de búsqueda.
La memoria del corazón, que almacena el 25 % de las mejores soluciones, reproduce de hecho la funcionalidad del elitismo, pero no se utiliza de forma activa para orientar la búsqueda, lo que la convierte más bien en un archivo pasivo que en un componente activo del algoritmo. La metáfora biológica, aunque conceptualmente atractiva, no se traduce en mecanismos computacionales eficaces: los procesos de crecimiento de las arterias, bifurcación y poda en un sistema biológico real están regulados por complejos gradientes químicos y tensiones mecánicas, que resultan difíciles de modelar adecuadamente mediante fórmulas matemáticas sencillas.
El intento de combinar la búsqueda global y la local mediante la aplicación sucesiva de dos estrategias de movimiento diferentes da lugar a un conflicto entre la exploración y la explotación, en lugar de a una sinergia entre ambas. He probado a crear varias versiones del algoritmo con pequeños cambios en el orden de las estrategias de búsqueda y modificaciones de estas, sin apartarme de la idea original, pero no he conseguido una mejora significativa, así que lo dejo todo tal y como está. Para quienes disfrutan experimentando: tienen a su disposición todas las posibilidades y herramientas necesarias para mejorar los resultados. Además, en el marco de este artículo sigue sin resolverse la cuestión relativa a la naturaleza de la elevada eficacia en determinadas tareas.
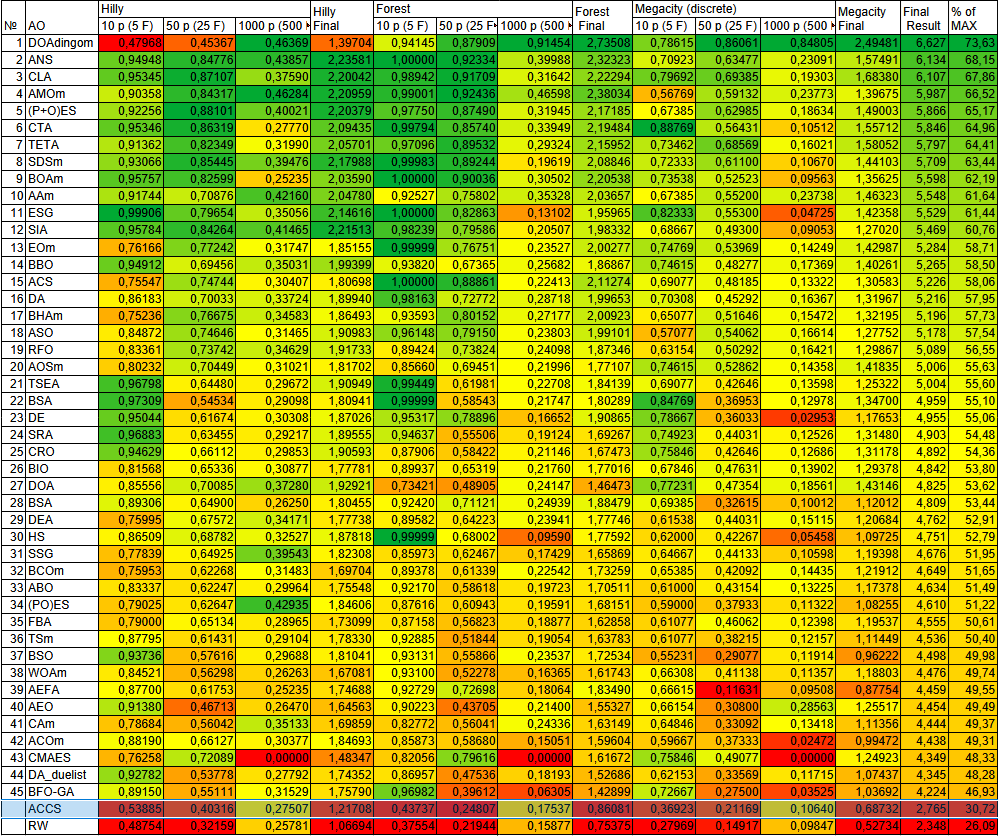
Figura 3. Escala de colores de los algoritmos según las pruebas correspondientes
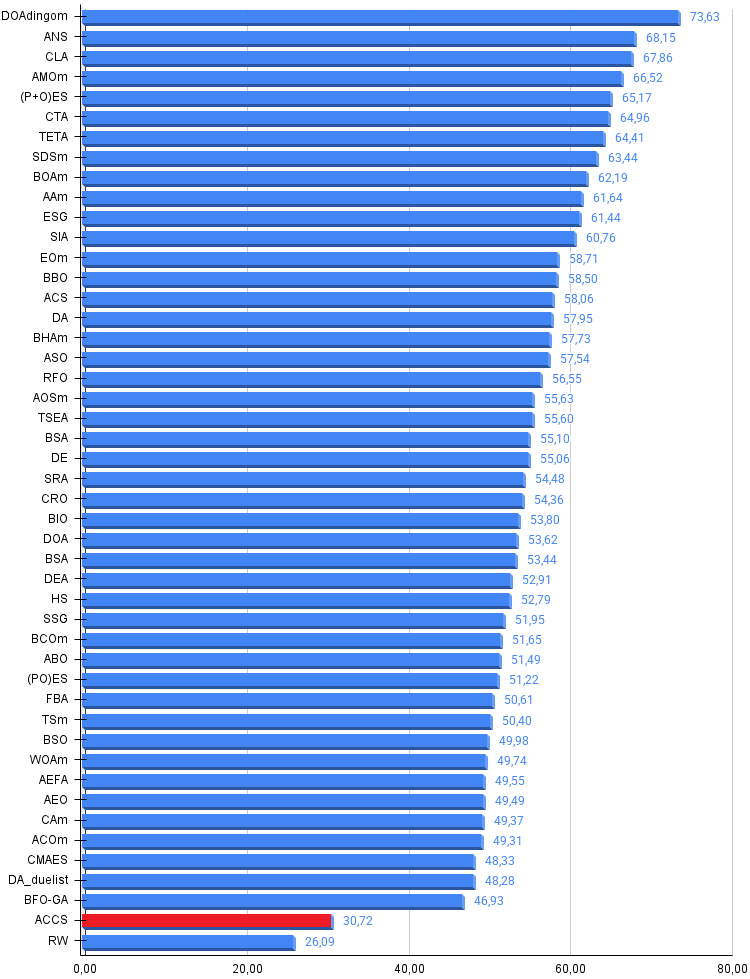
Figura 4. Histograma de los resultados de las pruebas de los algoritmos (en una escala de 0 a 100; cuanto mayor sea el valor, mejor, donde 100 es el resultado teórico máximo posible; en el archivo se incluye el script para calcular la tabla de clasificación)
Ventajas e inconvenientes del algoritmo ACCS:
Ventajas:
- Hay pocos parámetros externos.
- Es extremadamente eficaz en determinados tipos de problemas (incluso de alta dimensión).
Desventajas:
- Convergencia deficiente en paisajes complejos.
Adjuntamos al artículo un archivo comprimido con las versiones actualizadas de los códigos de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos, ya que en muchos de ellos se han introducido modificaciones para mejorar las capacidades de búsqueda. Las conclusiones y consideraciones que figuran en los artículos se basan en los resultados de los experimentos realizados.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase padre de los algoritmos de optimización poblacional |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de algoritmos de optimización poblacional |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados destinados a la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | Banco de pruebas unificado para todos los algoritmos de optimización poblacional |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Ejemplo sencillo de uso de algoritmos de optimización poblacional sin visualización |
| 9 | Test_AO_ACCS.mq5 | Script | Banco de pruebas para ACCS |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19861
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.