

Características del Wizard MQL5 que debe conocer (Parte 79): Uso de los osciladores Gator y Acumulación/Distribución con aprendizaje supervisado
 96
 0

Introducción
En nuestros dos últimos artículos, probamos, como de costumbre, diez patrones de señal utilizando la combinación de indicadores del oscilador Gator y el oscilador de acumulación/distribución. Al hacerlo, como hemos venido haciendo, encontramos tres patrones sistemáticamente rezagados: 0, 3 y 4. En lugar de descartarlas o ignorarlas, este artículo pretende explorar si el aprendizaje supervisado puede revitalizar su rendimiento. Empleamos una CNN mejorada con regresión por kernels y similitud de producto escalar, y examinamos si las redes con dicha arquitectura pueden extraer valor oculto de señales que a veces inicialmente parecen débiles. Tal y como se indica en los dos artículos anteriores, todas las pruebas se realizan sobre el par GBP/JPY y en un marco temporal de 30 minutos.
Regresión de núcleo con similitud de producto escalar
Nuestra elección para un modelo de aprendizaje supervisado es una CNN que utiliza regresión por kernels y similitud de producto escalar. La regresión por kernels estima las salidas de cada capa en una CNN ponderando las entradas observadas de acuerdo con su similitud a un punto de consulta específico. Esta similitud se cuantifica utilizando la similitud del producto escalar como función núcleo. En nuestro modelo, cuyo código se comparte más adelante en la siguiente sección, el método _dot_product_kernel_regression calcula la similitud entre todas las posiciones temporales en un mapa de características utilizando la función torch.bmm(x, x.T) a la que añadimos una normalización softmax que es bastante similar a la autoatención.
La función del producto escalar es ser una medida de similitud que se adapta a los datos, donde un producto alto significa que dos posiciones tienen el mismo patrón de activación en todos los canales, lo que puede conducir a una mayor influencia en la suma ponderada. Una analogía, o una forma diferente de ver esto, podría ser como darle a cada posición "votos" proporcionales a su acuerdo con la posición de la consulta. Una capa de CNN puede considerarse como una hoja de cálculo donde las filas son los pasos de tiempo y las columnas son las características. En este contexto, se toma una sola fila para representar una "posición". Por lo tanto, la "posición de la consulta" es la fila actual que se está actualizando. Durante el proceso de realizar estas actualizaciones, se hacen comparaciones entre esta posición y todas las demás para cuantificar su grado de similitud. Estas actualizaciones tienen lugar durante la retropropagación.
Matemáticamente, los nuevos pesos podrían definirse de la siguiente manera. Dados los vectores de características xi y xj, el peso wij es:
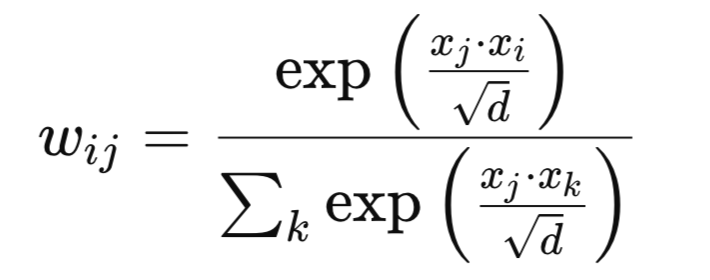
Donde:
- d - es la dimensión del canal.
- exp - es la función exponencial.
Nuestra matriz de ponderación realiza un suavizado no local a lo largo de la secuencia que no está restringido a posiciones vecinas como en una convolución. El efecto de esto es que permite capturar dependencias y correlaciones de largo alcance dentro del espacio de características, lo que potencialmente mejora el rendimiento en tareas con series temporales y datos estructurados. Como guía, la similitud del producto escalar debe utilizarse cuando la tarea en cuestión muestre correlaciones significativas entre características no adyacentes; y se busca un mecanismo similar a la atención que no requiera agregar proyecciones de consulta/clave/valor. Esto puede resultar especialmente sinérgico con las CNN, ya que capturan características locales y regresión por kernels, lo que añade contexto global.
Argumentos a favor de guiar el tamaño del núcleo y los canales de una CNN con el producto escalar
La regresión con núcleo de producto escalar revela dónde y con qué resolución son más fuertes las correlaciones. Ajustar el tamaño del núcleo de la CNN y la profundidad de los canales, en consonancia con una estructura de similitud, puede lograr dos cosas. En primer lugar, puede ayudar a relacionar los campos receptivos con la longitud de correlación. Esto ocurre especialmente en núcleos más grandes si la alta similitud puede persistir a grandes distancias. En segundo lugar, puede asignar canales en función de la complejidad de la correlación. Se asignan más canales cuando los patrones de similitud varían mucho, y menos cuando hay mayor uniformidad. Esto tiene el potencial de dar lugar a una arquitectura que sea a la vez basada en datos y específica para cada tarea, en contraposición a las heurísticas fijas.
En nuestra implementación de esto, como se muestra en el código fuente en las siguientes secciones, los tamaños del kernel varían cíclicamente a través de [3,5,7,9] mientras que las profundidades del canal también aumentan de 32 a 320. Cada dos capas se aplica una regresión por producto escalar en capas alternas, lo que implica que las capas «ven» mapas de correlación globales. Si los mapas de similitud muestran picos amplios de núcleos más grandes en las capas de convolución subsiguientes, esto puede aprovecharse. Si el mapa muestra picos pronunciados, pueden ser suficientes núcleos más pequeños, lo que llevaría a centrarse en pequeños refinamientos. Esto podría asemejarse a un ajuste adaptativo del campo receptivo guiado por una señal de correlación global.
Al utilizarlos en redes neuronales convolucionales (CNN), conviene realizar un preanálisis en el que los datos se introduzcan en un pequeño bloque de núcleo de CNN más producto escalar para analizar las longitudes de correlación, que luego pueden servir de base para establecer el plan de núcleo/canal de la CNN principal. Asimismo, conviene preferir combinar las primeras capas con núcleos más pequeños al realizar la detección local de bordes o patrones, y luego guiar el tamaño de los núcleos de las capas posteriores por la dispersión de similitud observada.
Posibles inconvenientes y posibles alternativas
Nuestro principal inconveniente de usar el núcleo del producto escalar de la forma en que lo estamos haciendo no debería sorprender a nadie, y es el costo computacional. La similitud del producto escalar se escala como O(L²) con una longitud de secuencia de L. Esto puede suponer una carga considerable para señales largas o entradas de características de gran tamaño. Otra preocupación es el alisado excesivo. Si los pesos son demasiado difusos, las características pueden volverse demasiado homogéneas, lo que resulta en la pérdida de algunos detalles finos. La inestabilidad en el entrenamiento es otro punto problemático. En casos de grandes similitudes, si no hay normalización, podemos tener situaciones de pesos que se disparan. Por último, el consumo de memoria necesario para almacenar una matriz de similitud completa puede tener costes prohibitivos.
Sin embargo, estas preocupaciones tienen algunas medidas de mitigación, entre las que se incluye el uso de ventanas de atención local. Así pues, en lugar de calcular la similitud entre todas las posiciones, con el coste computacional ya descrito y enlazada anteriormente, limitamos las comparaciones a una ventana fija alrededor de cada posición de consulta. Esto reduciría el coste computacional y el uso de memoria, y permitiría centrarse en la integración del contexto relevante cercano. Además de esto, también podemos adoptar el escalado de temperatura. Aquí simplemente multiplicamos las puntuaciones de similitud por 1/τ, la temperatura. Una temperatura más baja daría lugar a ponderaciones más precisas y selectivas, donde predominan pocas posiciones o filas de capas. Un valor de τ más alto daría como resultado pesos más suaves y distribuidos de manera más uniforme en todas las cuadrículas de capas. La temperatura sería un hiperparámetro adicional.
Finalmente, también podemos utilizar el submuestreo antes de realizar la regresión del kernel. Esto implicaría reducir la longitud de la secuencia de datos de entrada L mediante el uso de agrupamiento o convoluciones con paso antes de calcular el producto escalar. Un valor de L más corto debería acelerar los cálculos de similitud y también reducir los requisitos de memoria, al tiempo que permite capturar correlaciones a gran escala.
Mejoras alternativas de CNN con el producto escalar
Además de la regresión por kernels con el núcleo de producto escalar, podemos aplicar CNN híbridas de autoatención. Con esto, usaríamos la regresión del producto escalar como un bloque no local junto con las capas CNN en lugar de una capa de atención estándar. Esto difiere de nuestra implementación, cuyo código fuente se explica en la siguiente sección, en que en nuestro modelo aplicamos la regresión del kernel periódicamente en una pila convolucional. El sistema híbrido lo insertaría en ramas paralelas y fusionaría las salidas. También podríamos aplicar nuestro kernel mediante fusión de características multiescala, donde la regresión del kernel se aplica a características que provienen de varias capas de CNN y luego se combinan. La diferencia con lo que hemos hecho es que nosotros utilizamos la regresión de kernel solo en una capa a la vez. La fusión multiescala combina el contexto global de diferentes capas/resoluciones.
También podríamos haber aplicado el kernel mediante tareas de pretexto para la regularización. En este escenario, entrenamos las salidas de la regresión del kernel para resolver tareas auxiliares, como predecir el embedding del siguiente paso, además de la tarea principal. Esto es obviamente diferente de nuestro enfoque descrito a continuación, ya que nosotros usamos el núcleo exclusivamente para el refinamiento de características, mientras que aquí también se utiliza para regularizar. Finalmente, una aplicación alternativa de nuestro núcleo podría haber sido simplemente algo que hemos explorado en artículos anteriores. Dimensionamiento dinámico del núcleo. En este enfoque, usaríamos estadísticas de similitud de la regresión del núcleo para ajustar los tamaños del núcleo de convolución durante el entrenamiento/inferencia. En el enfoque que describimos a continuación, fijamos los tamaños del kernel de antemano.
La Red
A continuación se presenta el código de nuestra clase de red, que implementa este kernel de producto escalar con regresión:
class DotProductKernelRegressionConv1D(nn.Module):
    def __init__(self, input_length=100):
        super().__init__()
        self.input_length = input_length

        self.kernel_sizes, self.channels = self._design_architecture()

        self.conv_layers = nn.ModuleList()
        self.use_kernel_regression = []  # <-- Python list for markers

        in_channels = 1
        for i, (out_channels, kernel_size) in enumerate(zip(self.channels, self.kernel_sizes)):
            conv_layer = nn.Sequential(
                nn.Conv1d(in_channels, out_channels, kernel_size=kernel_size, padding=kernel_size // 2),
                nn.BatchNorm1d(out_channels),
                nn.ReLU(),
                nn.Dropout(0.2))
            self.conv_layers.append(conv_layer)

            self.use_kernel_regression.append(i % 2 == 0)
            in_channels = out_channels

        self.head = nn.Sequential(
            nn.AdaptiveAvgPool1d(1),
            nn.Flatten(),
            nn.Linear(in_channels, 128),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def _dot_product_kernel_regression(self, x):
        """
        Dot product kernel regression.
        For each time position, outputs a weighted sum of all positions using dot product similarity as weights.
        """
        # x: (B, C, L)
        x_ = x.permute(0, 2, 1)  # (B, L, C)
        # Dot product similarity
        sim = torch.bmm(x_, x_.transpose(1, 2))  # (B, L, L)
        # Optionally normalize for stability (like attention)
        weights = F.softmax(sim / (x_.size(-1) ** 0.5), dim=-1)  # (B, L, L)
        out = torch.bmm(weights, x_)  # (B, L, C)
        return out.permute(0, 2, 1)  # (B, C, L)

    def _design_architecture(self):
        num_layers = 10
        kernel_sizes = [3 + (i % 4) * 2 for i in range(num_layers)]
        channels = [32 * (i + 1) for i in range(num_layers)]
        return kernel_sizes, channels

    def forward(self, x):
        x = x.unsqueeze(1)  # (B, 1, L)
        for conv_layer, use_kr in zip(self.conv_layers, self.use_kernel_regression):
            x = conv_layer(x)
            if use_kr:
                x = self._dot_product_kernel_regression(x)
        return self.head(x)
La primera línea de código en nuestro listado anterior es el esqueleto de la clase y el constructor. Hereda de nn.Module, lo que desbloquea el seguimiento de parámetros de PyTorch, .to(device), ,eval(), etc. El valor de input_length se almacena, a pesar de que las convoluciones no dependen de la longitud. Esto ayuda con las comprobaciones de coherencia al exportar a ONNX o al crear lógica dependiente de la longitud posteriormente. A continuación, pasamos al "plano de arquitectura", donde definimos los tamaños del kernel y de los canales. Esto es importante porque centraliza tanto el plan de campo receptivo (tamaños de kernel) como el plan de capacidad (los canales). Mantener todo esto en un solo lugar facilita las cosas en dos aspectos. En primer lugar, cuando se trata de alinear los tamaños del kernel, la similitud observada puede variar desde la regresión del kernel. En segundo lugar, nos permite escalar cuando los patrones de similitud son más complejos.
Para su correcta utilización, la función _design-architecture debe basarse en datos. Se puede analizar un lote de datos para medir la disminución de la similitud a partir del bloque de regresión y, en función de esto, se pueden ampliar los tamaños del núcleo en consecuencia. Además, se podría considerar vincular los canales a la entropía de la distribución de similitud. Si se hiciera así, una mayor entropía daría lugar a más canales que contribuirían a la variabilidad del modelo.
Nuestro siguiente código define la pila convolucional y los marcadores para determinar dónde aplicar la regresión. Esto es importante porque la función ModuleList mantiene las capas registradas de manera que sus pesos se guarden y se carguen bajo demanda. Asignar el relleno a la mitad del tamaño del núcleo hace que las convoluciones tengan una longitud casi similar, o bien conserva su longitud. Esto es importante porque, posteriormente, la regresión del núcleo asume una longitud constante.
El uso de la normalización por lotes, la activación ReLU y el abandono (dropout) también son medidas robustas, donde la normalización por lotes estabiliza el entrenamiento, ReLU introduce no linealidad y el abandono impone cierta regularización. La opción booleana use_kernel_regression nos permite desacoplar la regresión del kernel, que requiere mucha capacidad de cálculo, de cada capa, de modo que solo se pueda colocar donde resulte útil. Para obtener orientación adicional sobre su uso, se pueden activar los saltos residuales alrededor de los bloques de la capa convolucional para facilitar la optimización cuando la regresión del kernel es fuerte.
Con esto, procedemos a definir el cabezal de predicción. Este apilamiento es obviamente fundamental, ya que contiene algunos componentes clave. En primer lugar, tenemos AdaptiveAvgPool1d(1), que produce un resumen global invariante en longitud por canal. Esto es importante cuando se enfrenta a la variabilidad de los datos de entrada. Dicho de otro modo, comprime las series temporales de longitud variable de cada canal en un único valor promedio. Esto genera un vector resumen de tamaño fijo. El efecto de esto es que la salida de la red se vuelve independiente de la longitud de la secuencia de entrada. Esto es crucial cuando el número de pasos de tiempo varía entre las muestras.
La red neuronal multicapa (MLP) asigna el resumen de características a una salida escalar. Para regresión en el rango de 0,0 a 1,0. Por lo tanto, la activación sigmoide es pragmática en este caso; de lo contrario, se puede considerar un cambio a la función identidad para resultados de regresión sin restricciones o a Log-Soft-Max para resultados multiclase. Si existen dudas sobre la neutralidad direccional, por ejemplo, sobre si usar funciones largas o cortas, entonces la función sigmoide podría reemplazarse por una de dos cabezas. La primera cabeza puede ser una distribución de probabilidad, todavía utilizando la función sigmoide. El segundo cabezal puede centrarse en la magnitud, donde la activación utilizada es Soft Plus. Si la explicabilidad también es un requisito, entonces se puede exponer el vector agrupado para calcular la importancia de cada canal.
A continuación, definimos la función central de regresión del kernel. Aquí, lo primero que hacemos es una permutación que transpone los datos de entrada x al formato tamaño-lote, número-canales, tamaño-longitud. Con esto, el producto escalar debería operar sobre las incrustaciones de canal en cada posición. Por eso, C, el número de canales, se convierte en la dimensión interna. A continuación, construimos una matriz de afinidad no local en todas las posiciones con un coste computacional igual al cuadrado de la longitud. Esta es la matriz 'sim'. Con esto, definimos nuestros pesos escalando esta matriz de simulación por la raíz cuadrada del número de canales, para "mantener los logits con un comportamiento adecuado" a medida que aumentan las dimensiones del canal. La función de activación softmax convierte las similitudes brutas en un simplex de probabilidad. Cada fila de la capa se convierte en una combinación convexa de todas las filas. La regresión del núcleo se realiza en el siguiente paso, donde multiplicamos estos pesos por el vector de entrada transpuesto/permutado x. Las filas/posiciones de las capas toman prestada información de posiciones similares en toda la ventana.
Para fines de guía, las secuencias largas utilizan: ventanas locales o atención diagonal por bloques; implementan maniobras de bajo rango como Nystrom o Linformer; y realizan un submuestreo, una regresión de kernel y luego un sobremuestreo. Para tareas de predicción o tareas causales, añadir un enmascaramiento causal antes de la activación del soft max puede evitar la fuga de datos o la posibilidad de ver el futuro. Si se observa un suavizado excesivo, se puede introducir un hiperparámetro de temperatura de la siguiente manera:
weights = F.softmax(sim / (tau * x_.size(-1) ** 0.5), dim=-1)

x = x + alpha * self._dot_product_kernel_regression(x)
Nuestra siguiente función es la que utilizamos para definir/generar la 'arquitectura del modelo'. Esta función proporciona cobertura multiescala en el rango de 3 a 9, de forma repetida, para que cada etapa pueda reaccionar al contexto global de la regresión del núcleo. El crecimiento lineal del canal aumenta la capacidad en las zonas más profundas de la red, donde las características son más abstractas. Hacer que el ciclo responda a la amplitud de similitud medida, donde una mayor similitud conlleva una mayor tendencia hacia núcleos más grandes en consonancia con las capas, puede ser una buena práctica. Los canales tampoco deben ampliarse a ciegas, sino que es necesario monitorizar la dispersión de activación o la entropía de regresión del núcleo para poder asignarlos respectivamente donde sea necesario.
La función final de nuestra clase de red es la función de paso hacia adelante. Aquí comenzamos con la adición inicial de una dimensión para imponer el formato esperado de longitud de canal por lote. Para las CNN unidimensionales, el canal es 1 inicialmente. La alternancia entre convolución local y regresión por kernels global proporciona un patrón potente. La detección de motivos locales permite propagar la información según la similitud aprendida. A continuación, se procede al refinamiento, de forma local, en las siguientes convoluciones. Devolver self.head() ayuda a mantener limpio el grafo de propagación hacia delante para la exportación y el despliegue en ONNX.
Si se requiere un flujo de gradiente más robusto, se pueden complementar las normas de las capas alrededor de la regresión del kernel o los residuos.
Traducción de indicadores
Para utilizar los patrones de señal de los dos últimos artículos como entradas para nuestro modelo de regresión por kernels CNN resaltado anteriormente, necesitamos tener un indicador equivalente en Python. Si bien existen algunas implementaciones de módulos indicadores listas para usar en Python, programar la nuestra desde cero ha resultado igual de sencillo y, al mismo tiempo, nos ha proporcionado una supervisión adecuada de las decisiones tomadas al calcular los valores de los indicadores. Así pues, como en artículos anteriores, codificamos las lecturas de los indicadores para que sean alcistas o bajistas en un vector bidimensional que solo toma valores de 0 o 1. La regresión de kernel sería útil en este caso porque las características extraídas codifican patrones estructurales de barras/osciladores. Las posiciones distantes que "se parecen" o las incrustaciones similares en el producto escalar pueden reforzarse mutuamente. Por lo tanto, la regresión kernel (KR) permite que el modelo aprovechar información estadística compartida a lo largo del tiempo. Esto resulta valioso cuando cada patrón es relativamente raro o débil por sí solo.
Además, el hecho de decidir desde el principio dónde aplicar el KR propaga los motivos básicos. La fase tardía de KR consolida motivos de nivel superior. Probar con un KR menos profundo al principio y con un tamaño de canal más pequeño con un KR más profundo más adelante, mientras se utiliza un C/Channel más grande, es un enfoque sensato.
El oscilador Gator
Esta función construye los componentes Alligator de Bill Williams utilizando la media móvil suavizada del precio medio y sus desplazamientos hacia adelante de mandíbulas/dientes/labios. Esto se trató en los artículos anteriores. Generamos dos búferes de la magnitud de la mandíbula menos los dientes que etiquetamos como 'caimán arriba' y un valor negativo de la magnitud de los dientes MA menos los labios. También añadimos estados de color para el comportamiento de expansión/contracción. Esa es la descripción general de la función que implementamos de la siguiente manera en Python:
def Gator_Oscillator(df: pd.DataFrame,
                     jaw_period: int = 13, jaw_shift: int = 8,
                     teeth_period: int = 8, teeth_shift: int = 5,
                     lips_period: int = 5, lips_shift: int = 3) -> pd.DataFrame:
    """
    Calculate the Bill Williams Gator Oscillator and append the columns to the input DataFrame.

    Adds color columns for each bar:
    - Gator_Up_Color: 'green' for increasing, 'red' for decreasing, else previous color.
    - Gator_Down_Color: 'green' for increasing (less negative), 'red' for decreasing (more negative), else previous color.

    Args:
        df (pd.DataFrame): DataFrame with 'high' and 'low' columns.
        jaw_period (int): Jaw period (default 13).
        jaw_shift (int): Jaw shift (default 8).
        teeth_period (int): Teeth period (default 8).
        teeth_shift (int): Teeth shift (default 5).
        lips_period (int): Lips period (default 5).
        lips_shift (int): Lips shift (default 3).

    Returns:
        pd.DataFrame: Input DataFrame with 'Gator_Up', 'Gator_Down', 'Gator_Up_Color', 'Gator_Down_Color'.
    """
    required_cols = {'high', 'low'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high' and 'low' columns")
    if not all(p > 0 for p in [jaw_period, jaw_shift, teeth_period, teeth_shift, lips_period, lips_shift]):
        raise ValueError("Period and shift values must be positive integers")

    result_df = df.copy()
    median_price = (result_df['high'] + result_df['low']) / 2

    def smma(series, period):
        smma_vals = []
        smma_prev = series.iloc[0]
        smma_vals.append(smma_prev)
        for price in series.iloc[1:]:
            smma_new = (smma_prev * (period - 1) + price) / period
            smma_vals.append(smma_new)
            smma_prev = smma_new
        return pd.Series(smma_vals, index=series.index)

    jaw = smma(median_price, jaw_period).shift(jaw_shift)
    teeth = smma(median_price, teeth_period).shift(teeth_shift)
    lips = smma(median_price, lips_period).shift(lips_shift)

    result_df['Gator_Up'] = (jaw - teeth).abs()
    result_df['Gator_Down'] = -(teeth - lips).abs()

    # Color logic
    up_vals = result_df['Gator_Up'].values
    down_vals = result_df['Gator_Down'].values

    up_colors = ['green']  # Start with green (or change to None/'grey' if you want)
    for i in range(1, len(up_vals)):
        if pd.isna(up_vals[i]) or pd.isna(up_vals[i-1]):
            up_colors.append(up_colors[-1])
        elif up_vals[i] > up_vals[i-1]:
            up_colors.append('green')
        elif up_vals[i] < up_vals[i-1]:
            up_colors.append('red')
        else:
            up_colors.append(up_colors[-1])

    down_colors = ['green']  # Start with green for "less negative" (getting closer to zero is "increasing")
    for i in range(1, len(down_vals)):
        if pd.isna(down_vals[i]) or pd.isna(down_vals[i-1]):
            down_colors.append(down_colors[-1])
        elif down_vals[i] > down_vals[i-1]:
            down_colors.append('green')  # "less negative" = "up"
        elif down_vals[i] < down_vals[i-1]:
            down_colors.append('red')    # "more negative" = "down"
        else:
            down_colors.append(down_colors[-1])

    result_df['Gator_Up_Color'] = up_colors
    result_df['Gator_Down_Color'] = down_colors

    return result_df
Si analizamos el código línea por línea, lo primero que hacemos en nuestra función es protegernos contra entradas mal formadas e hiperparámetros sin sentido. Los valores de desplazamiento deben ser positivos porque las líneas de cocodrilo se desplazan intencionalmente hacia adelante. Su función es está pensada para adelantarse visualmente al precio. A continuación, obtenemos una copia funcional del marco de datos de entrada, así como un búfer/vector de precios medianos. Esto mantiene intactos los datos de entrada originales, y el precio medio reduce el ruido en comparación con el uso exclusivo de precios de cierre. En general, esto se ajusta a las prácticas habituales de Alligator.
Una vez hecho esto, definimos nuestra implementación de promedio móvil suavizado. El SMMA es un suavizador recursivo que reacciona más lentamente que un EMA regular y, por lo tanto, es adecuado para filtrar series temporales irregulares. La inicialización del valor con series.iloc[0] evita un gran período de calentamiento. Después de esto, ajustamos las líneas de cocodrilo, así como el desplazamiento hacia adelante. Los periodos para estos disminuyen desde las mandíbulas hasta los dientes y los labios. Todas están desplazadas hacia adelante, de modo que la "boca" se abre o se cierra antes que la barra actual.
A continuación, estamos listos para definir los dos búferes de datos de salida de destino de gator up y gator down. Estas medidas toman un valor absoluto; miden la magnitud de la separación entre las mandíbulas del caimán. La designación de las barras como positivas y negativas es una convención gráfica. Finalmente, implementamos la lógica de codificación de color, donde el foco está en la tendencia de la propagación, ya sea que se esté ampliando o estrechando. Una barra descendente se representa por debajo de cero, por lo que sus valores son negativos. Si la barra se mueve hacia arriba, no significa que se haya vuelto positiva, sino simplemente que se ha vuelto menos negativa. El manejo de NaN conserva los estados anteriores para evitar parpadeos en arranques bruscos.
El oscilador AD
El objetivo de este oscilador es calcular la línea de acumulación/distribución a partir del producto del multiplicador del flujo monetario y el volumen. Su objetivo es capturar la presión de compra frente a la de venta a través del rango de la barra del precio de cierre, escalado por volumen o volumen de ticks. Implementamos esto en Python de la siguiente manera:
def AD_Oscillator(df: pd.DataFrame, fast_period: int = 5, slow_period: int = 13) -> pd.DataFrame:
    """
    Calculate the Accumulation/Distribution Oscillator (A/D Oscillator) and append it to the input DataFrame.

    A/D Oscillator = EMA(ADL, fast_period) - EMA(ADL, slow_period)

    ADL (Accumulation/Distribution Line) is calculated as:
    Money Flow Multiplier = [(Close - Low) - (High - Close)] / (High - Low)
    Money Flow Volume = Money Flow Multiplier * Volume
    ADL = cumulative sum of Money Flow Volume

    Args:
        df (pd.DataFrame): DataFrame with 'high', 'low', 'close', 'volume' columns.
        fast_period (int): Fast EMA period (default 3).
        slow_period (int): Slow EMA period (default 10).

    Returns:
        pd.DataFrame: Input DataFrame with 'ADL' and 'AD_Oscillator' columns added.
    """
    required_cols = {'high', 'low', 'close', 'tick_volume'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high', 'low', 'close', 'tick_volume' columns")
    if not all(p > 0 for p in [fast_period, slow_period]):
        raise ValueError("Period values must be positive integers")
    if fast_period >= slow_period:
        raise ValueError("fast_period must be less than slow_period")

    result_df = df.copy()
    high = result_df['high']
    low = result_df['low']
    close = result_df['close']
    volume = result_df['tick_volume']

    # Avoid divide by zero, replace zero ranges with np.nan
    range_ = high - low
    range_ = range_.replace(0, pd.NA)

    mfm = ((close - low) - (high - close)) / range_
    mfv = mfm * volume
    result_df['ADL'] = mfv.cumsum()

    fast_ema = result_df['ADL'].ewm(span=fast_period, adjust=False).mean()
    slow_ema = result_df['ADL'].ewm(span=slow_period, adjust=False).mean()
    result_df['AD_Oscillator'] = fast_ema - slow_ema

    return result_df
Si repasamos esto como lo hicimos con el caimán anteriormente, nuestras primeras líneas de código comienzan verificando que los cuatro campos de precio y volumen estén presentes en el marco de datos de entrada. Como estamos realizando pruebas con pares de divisas, al igual que en artículos anteriores, nuestro volumen objetivo se fija en el volumen de ticks y no en el volumen real por razones ya mencionadas en artículos anteriores. Después de esto, procedemos a asegurarnos de que se trata de un "verdadero oscilador" en el sentido de que el período lento debe ser mayor que el período rápido. A continuación, extraemos los datos de las columnas del rango, evitando al mismo tiempo las divisiones por cero. Si el máximo es igual al mínimo, como ocurre con las barras doji o las cotizaciones fuera del mercado, el rango sería cero y esto podría provocar multiplicadores explosivos.
Una vez hecho esto, procedemos a calcular el multiplicador del flujo de dinero y el volumen. El multiplicador tiene un rango limitado, donde los valores altos están más cerca de +1 y los valores bajos de -1. Denominamos a este búfer mfm, siendo mfv su equivalente ponderado por volumen. La función cumsum integra esta presión volumétrica a lo largo del tiempo, y esto da como resultado la línea A/D. A continuación, calculamos los búferes EMA rápidos y lentos de nuestro búfer de línea A/D. Si se establece el parámetro de ajuste en falso, se obtiene una EMA recursiva estándar, que es lo que la mayoría de los operadores esperan. La diferencia entre estos rangos de valores agudiza la señal positiva, lo que pone de manifiesto que cualquier acumulación reciente podría estar superando la tendencia a largo plazo.
Patrones de señal seleccionados
Cada función para los patrones que estamos considerando: 0, 3 y 4 devuelve una matriz NumPy de forma longitud-del-marco-de-datos-de-entrada por 2. Como ya hemos tratado en artículos anteriores, [:, 0] codifica una señal larga o alcista después de comprobar los valores del indicador que definimos en el último artículo. Se registra un 1 si el patrón es alcista; de lo contrario, obtenemos un 0. Mientras tanto, [:, 1] codifica una señal corta o bajista, donde nuevamente obtenemos un 1 si el patrón está presente o un 0 si no se registra ninguna señal corta. Los tres patrones de señal se combinan: los colores del cocodrilo, tal como se establecen en el indicador del oscilador del cocodrilo para los colores ascendentes y descendentes; las restricciones de la acción del precio de las comparaciones con los precios máximos/mínimos/de cierre con la función de desplazamiento; y, finalmente, el impulso/presión de volumen a través del oscilador AD, también con comparaciones de desplazamiento. Además, todos ellos concluyen asignando el valor cero a las primeras filas, dependiendo del intervalo de comparación, para evitar falsos positivos.
Característica-0
Como se mencionó en el penúltimo artículo donde presentamos este patrón de señal, se trata de la divergencia del caimán más una ruptura con confirmación de AD. Nuestra implementación en Python de esta función es la siguiente:
def feature_0(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 0.                                             |
//+------------------------------------------------------------------+

    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'] == 'red'
    cond_2 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     (df['high'].shift(2) > df['high'].shift(3)) &
                     (df['high'].shift(1) >= df['high'].shift(2)) &
                     (df['close'] > df['high'].shift(1)) &
                     (df['AD_Oscillator'].shift(1) > df['AD_Oscillator'].shift(2)) &
                     (df['AD_Oscillator'] <= df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     (df['low'].shift(2) < df['low'].shift(3)) &
                     (df['low'].shift(1) <= df['low'].shift(2)) &
                     (df['close'] < df['low'].shift(1)) &
                     (df['AD_Oscillator'].shift(1) < df['AD_Oscillator'].shift(2)) &
                     (df['AD_Oscillator'] >= df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
En el listado anterior, estamos creando una matriz binaria de 2 columnas para indicadores largos/cortos. A continuación, procedemos a definir el filtro de color principal de Gator. Básicamente estamos requiriendo que se contraiga y por lo tanto sea rojo y que se expanda este verde. Asimismo, procedemos a definir formalmente las reglas del lado largo para la columna 0. Aquí codificamos el estado del caimán, donde nos basamos en las condiciones predefinidas establecidas por los estados de color para establecer el régimen. Para la condición a largo plazo, también se comprueban los máximos crecientes para asegurar que haya una acumulación y esto se combina con una confirmación de ruptura del impulso, marcada por un AD en aumento. Todas estas métricas son clave para confirmar una dirección alcista, ya que buscamos una narrativa de régimen + acumulación + ruptura + impulso controlado. Una señal estructurada, débil pero persistente.
En el lado corto, replicamos la lógica anterior para una ruptura a la baja con una distribución desacelerada después de un empuje a la baja. Concluimos esta función evitando falsos positivos al establecer todos los valores asignados a "ninguno" inducido por el desplazamiento en 0. Al probar este patrón específico en un Asesor Experto creado mediante un asistente, después de exportar la red que procesa estas salidas a través de ONNX, obtenemos el siguiente informe:
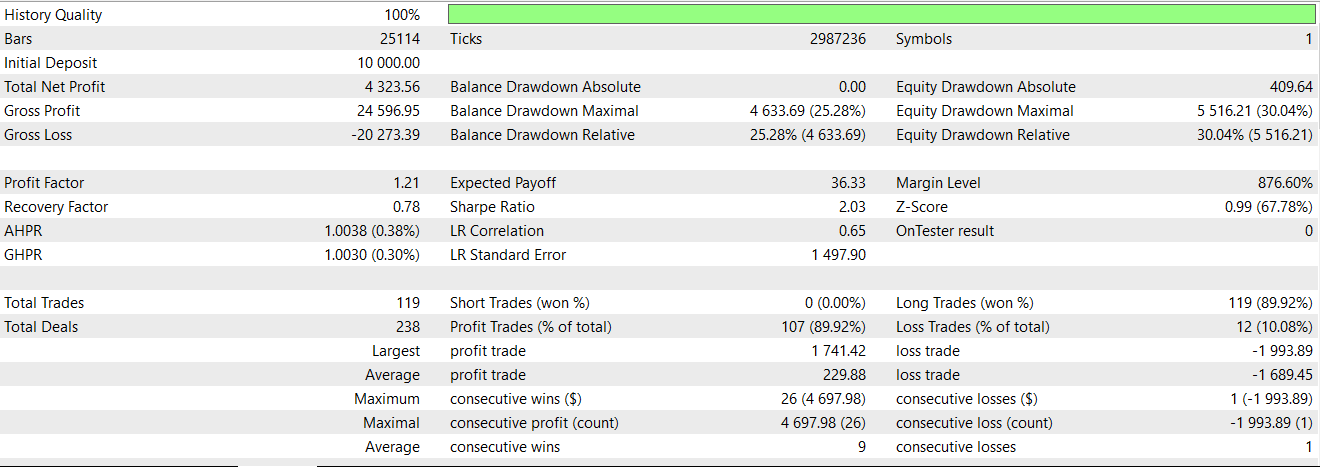
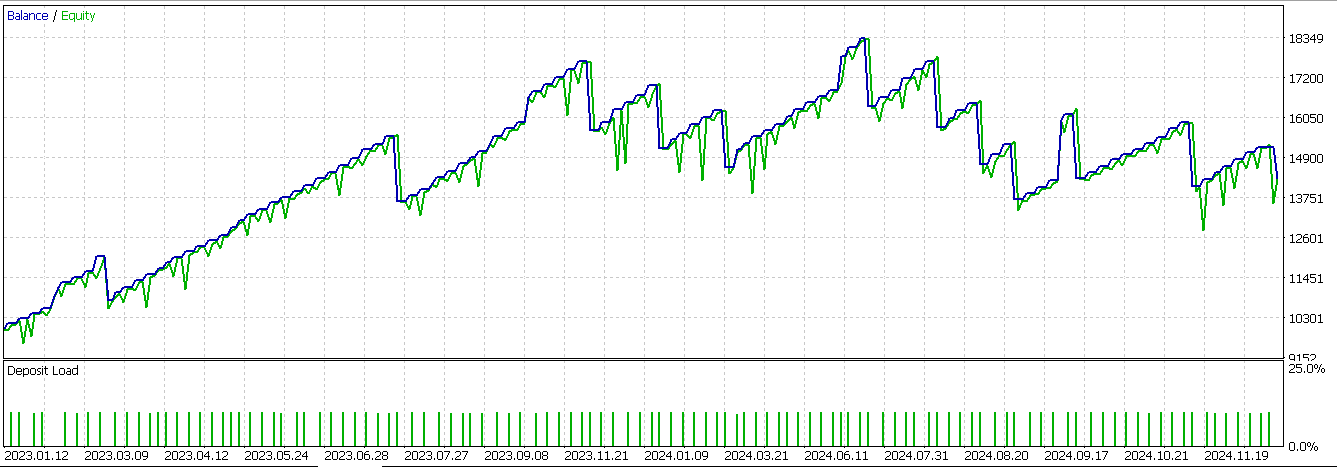
Aunque existen muchas operaciones rentables, parece que esta señal aún no logra rendir de forma rentable en la prueba forward-walk para 2024.
Característica-3
El segundo patrón de señal se basa en la contracción seguida de expansión con empuje intrabarra. Implementamos esto en Python de la siguiente manera:
def feature_3(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 3.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'].shift(1) == 'red'
    cond_2 = df['Gator_Down_Color'].shift(1) == 'red'
    cond_3 = df['Gator_Up_Color'] == 'red'
    cond_4 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close']-df['low'].shift(1) > 0.5*(df['high'].shift(1)-df['low'].shift(1))) &
                     (df['AD_Oscillator'].shift(2) > df['AD_Oscillator']) &
                     (df['AD_Oscillator'] > df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['high'].shift(1)-df['close'] < 0.5*(df['high'].shift(1)-df['low'].shift(1))) &
                     (df['AD_Oscillator'].shift(2) < df['AD_Oscillator']) &
                     (df['AD_Oscillator'] < df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Las condiciones básicas aquí son barras de histograma de Gator previas que indican rojo tanto hacia arriba como hacia abajo, que luego son seguidas por una de ellas que cambia a verde, como señal de una transición, como se trató en el artículo penúltimo. Gran parte de estas descripciones de patrones se trataron en ese artículo, así que pasaremos directamente a nuestro informe de prueba del mismo patrón cuando se aplica a través de nuestra red neuronal como filtro. Obtenemos el siguiente informe:
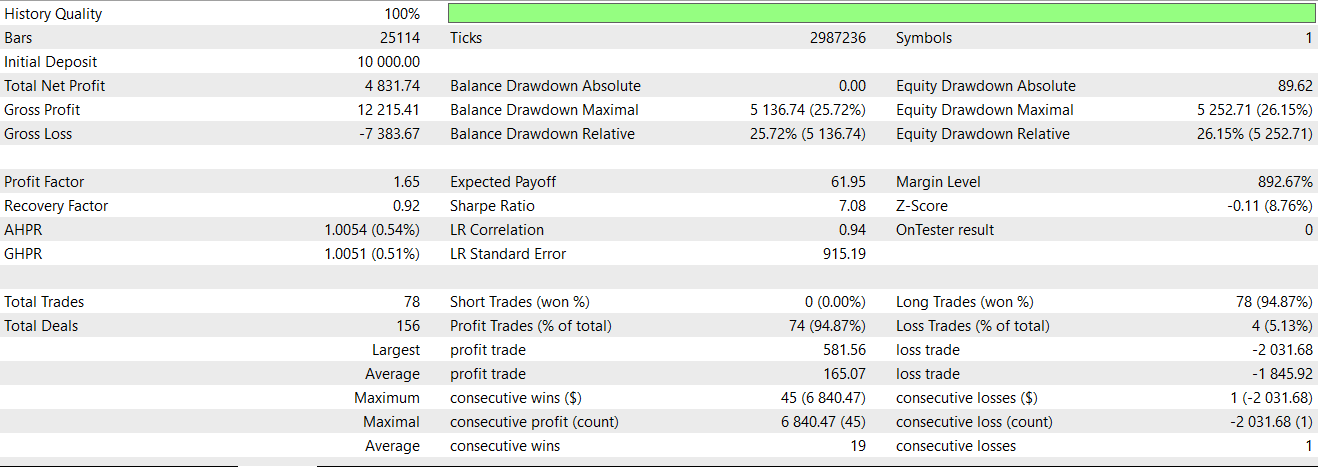
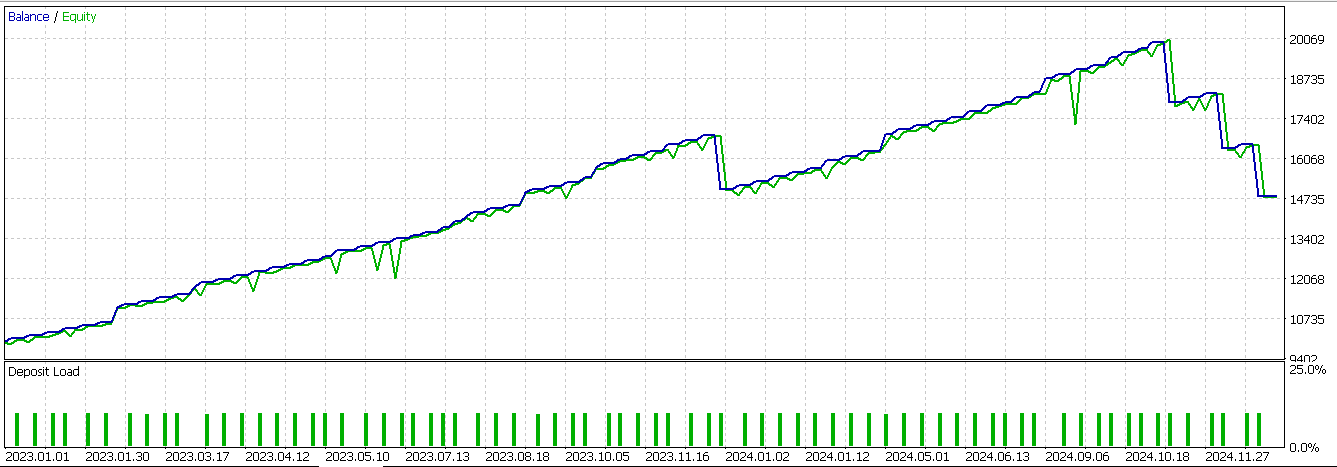
Estuvimos a punto de lograr avanzar hasta la última serie de operaciones no rentables. Nuestros sistemas siempre utilizan objetivos de toma de ganancias sin stop loss, por lo que este es el problema, ya que siempre dependemos de una reversión de la señal para cerrar operaciones no rentables.
Característica-4
El último patrón de señal que analizamos es una continuación de cambio de color con una simple confirmación de impulso. Si la barra anterior mostraba una tendencia ascendente y de expansión con el histograma superior en verde y el inferior en rojo, y en las barras subsiguientes el histograma superior indica contracción en rojo mientras que el inferior es verde, esto podría señalar un cambio de régimen en el oscilador del caimán. También se aplican comprobaciones de rechazo del precio y de impulso AD, como ya se mencionó en artículos anteriores. Nuestra codificación de esta señal en Python toma la siguiente forma:
def feature_4(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 4.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'].shift(1) == 'green'
    cond_2 = df['Gator_Down_Color'].shift(1) == 'red'
    cond_3 = df['Gator_Up_Color'] == 'red'
    cond_4 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close'] > df['close'].shift(1)) &
                     (df['low'].shift(1) > df['low']) &
                     (df['AD_Oscillator'] > df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close'] < df['close'].shift(1)) &
                     (df['high'].shift(1) < df['high']) &
                     (df['AD_Oscillator'] < df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Tras probar esta señal con nuestra red neuronal, que actúa esencialmente como un filtro adicional al Asesor Experto que ya teníamos implementado desde los artículos anteriores, obtenemos el siguiente informe:
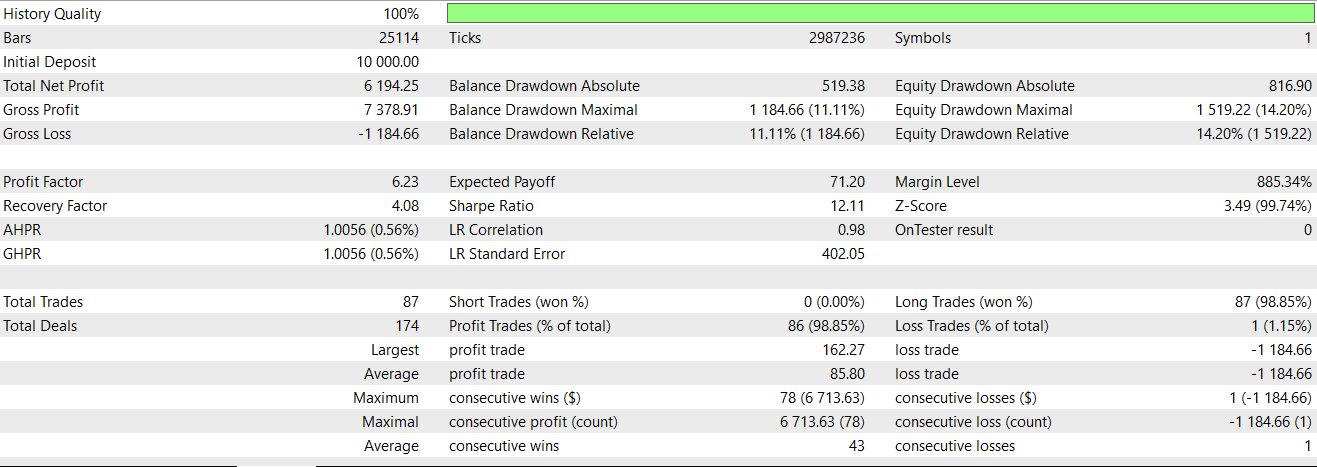
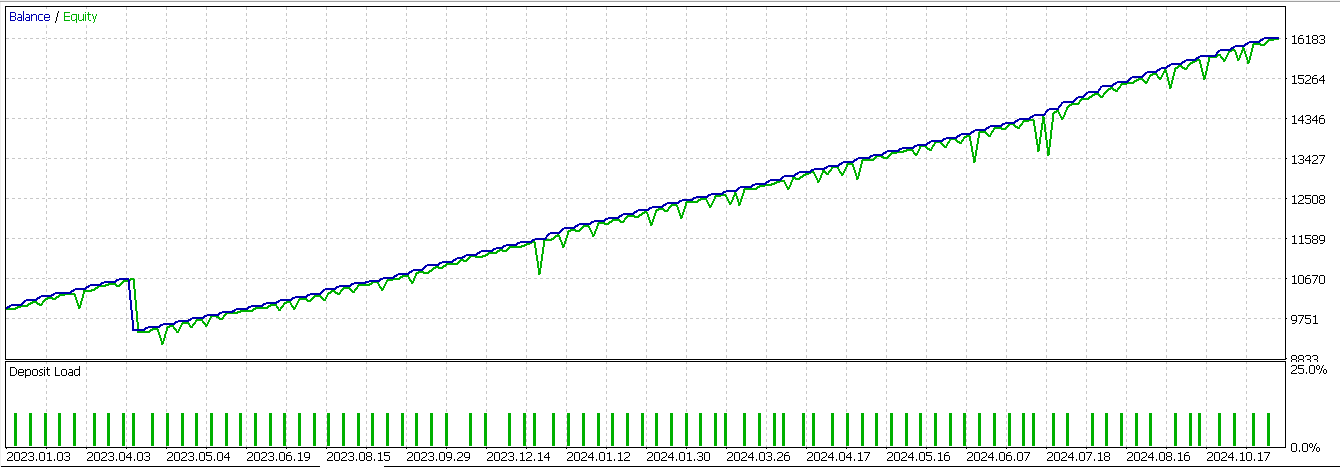
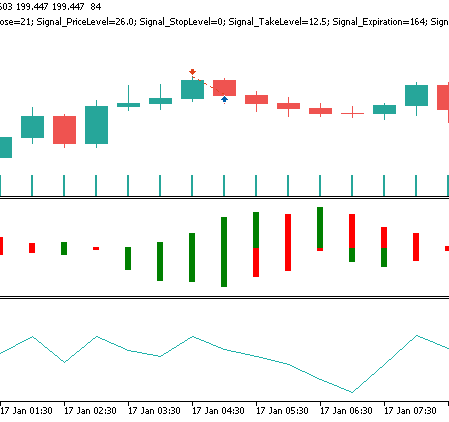
De las tres señales que hemos revisado en este artículo, esta es la única que logra mejorar claramente su desempeño respecto a la prueba inicial.. Una vez más, nuestro período de prueba se limita a solo 2 años, por lo que se espera que cualquier persona que desee desarrollar aún más esta señal actúe con diligencia y de forma independiente. En un gráfico de precios, un patrón de señal bajista para la característica 4 puede aparecer de la siguiente manera:
Conclusión
Los modelos de aprendizaje automático con aprendizaje supervisado, como la CNN que consideramos para este artículo, cuando se mejoran mediante la regresión por kernels y la similitud del producto escalar, muestran cierto potencial para fortalecer patrones de señales débiles. Si bien no todos los patrones que probamos aquí se beneficiaron en la misma medida, el que sí lo hizo, feature-4, destacó por mostrar un cambio radical. Esto podría validar este enfoque como un filtro adecuado en los Asesores Expertos. No obstante, el horizonte de prueba limitado modera las conclusiones que se pueden extraer, aunque el método pone de manifiesto que las arquitecturas adaptativas pueden extraer valor de señales con un historial poco fiable.
| Nombre | Descripción |
|---|---|
| WZ-79.mq5 | El asistente ha creado un Asesor Experto cuyo encabezado indica los archivos utilizados. La guía del asistente se puede consultar aquí. |
| SignalWZ-79.mqh | Archivo de clase de señal usado por el Asistente MQL5 para el ensamblado. |
| 79_0.onnx | Red neuronal exportada de la señal del patrón 0. |
| 79_3.onnx | Red neuronal exportada de la señal del patrón 3. |
| 79_4.onnx | Red neuronal exportada de la señal del patrón 4. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19220
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Evaluación de la calidad de la operativa con spreads en función de los factores de estacionalidad en el mercado Forex en el terminal MetaTrader 5
 Estrategia del águila — Eagle Strategy (ES)
 Creación de un sistema de trading (parte 3): Determinación de los niveles mínimos de riesgo para objetivos de beneficio realistas
 Aprendiendo MQL5 de principiante a profesional (Parte VII): Principios de depuración de aplicaciones MQL

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso