Algoritmo de monos azules — Algoritmo Blue Monkey (BM)
 26
 0

Índice
Introducción
Para encontrar el algoritmo de optimización más adecuado para los problemas discretos de los robots de trading, analizaremos otro método y sus posibilidades. En el corazón de la selva africana habitan unas criaturas cuya vida, llena de interacciones complejas y de una sabia jerarquía, se ha convertido en fuente de inspiración para crear uno de los métodos de optimización. Se trata de los monos azules, o Cercopithecus mitis, pequeños y ágiles habitantes de las copas de los árboles. Su comportamiento, aparentemente caótico pero regido en realidad por profundas leyes biológicas, inspiró el desarrollo de un algoritmo bautizado en su honor: Blue Monkey.
El algoritmo fue desarrollado por M. Mahmood y B. Al-Khateeb y publicado en 2019 en «Periodicals of Engineering and Natural Sciences» (PEN), 7(3):1054-1066, DOI:10.21533/pen.v7i3.621.
Este ecosistema complejo, pero armonioso, se refleja en la abstracción matemática del algoritmo Blue Monkey:
- Grupos como equipos. La población de agentes se divide en equipos independientes, cada uno con su propio líder, que desempeña un papel similar al de un macho dominante.
- El líder: la encarnación de la perfección. El mejor individuo de cada grupo, que posee la mayor «aptitud» (fitness), personifica al macho dominante: un modelo a seguir.
- Las crías: la nueva generación. Los individuos jóvenes, las «crías», representan una nueva etapa en la evolución: están aprendiendo y están preparados para sustituir a sus mayores, aportando ideas y soluciones novedosas.
- Migración: renovación del sistema. El proceso de migración consiste en que las mejores «crías» pueden sustituir a los «adultos» menos aptos, lo que garantiza una renovación constante y una mejora de la eficiencia.
- El aprendizaje social: el camino hacia el líder. El movimiento de las «crías» hacia el líder del grupo, regido por fórmulas matemáticas, imita el proceso de aprendizaje social, en el que los jóvenes aprenden de los más experimentados.
Implementación del algoritmo
Imagine que dirige una expedición de investigación en la selva que busca una ciudad perdida. Usted cuenta con 50 investigadores con experiencia (monos adultos) y 15 aprendices (crías, que representan el 30 % de los adultos).
Organización del trabajo:
- dividimos a los investigadores experimentados en 5 equipos de 10 personas cada uno;
- cada equipo explora su zona de la selva por su cuenta;
- 5 equipos = 5 zonas de búsqueda diferentes: el equipo A se dirigirá al norte, el equipo B se dirigirá al sur, el equipo C buscará en el este, el equipo D explorará en el oeste y el equipo E se quedará en el centro.
Si la ciudad perdida está en el norte, el equipo A la encontrará antes, y los demás se irán acercando paulatinamente. Los aprendices trabajan todos juntos como un grupo de formación. Mecanismo principal: 5 equipos = 5 zonas de búsqueda diferentes. «Sigue el ejemplo de los que tienen éxito». En cada equipo se identifica al líder —aquel que ha encontrado la dirección más acertada—; los demás ajustan su ruta hacia él, ¡pero no van directamente a su encuentro! Mantienen el 70 % de su rumbo y lo ajustan un 30 % hacia el líder. No abandonamos nuestra ruta de inmediato (por si acaso también hay algo allí), pero nos vamos desplazando poco a poco hacia los lugares donde se han obtenido mejores resultados.
Formación de los jóvenes: los aprendices hacen lo mismo, pero todos siguen al mejor estudiante en prácticas. Buscamos al peor de cada equipo y lo comparamos con los mejores estudiantes; si el estudiante es mejor, consigue un puesto fijo, y el que no da la talla es despedido. Los aprendices aportan nuevas ideas: puede que un investigador con experiencia se haya quedado atascado en una zona poco prometedora, mientras que un joven haya dado con una mina de oro por casualidad.
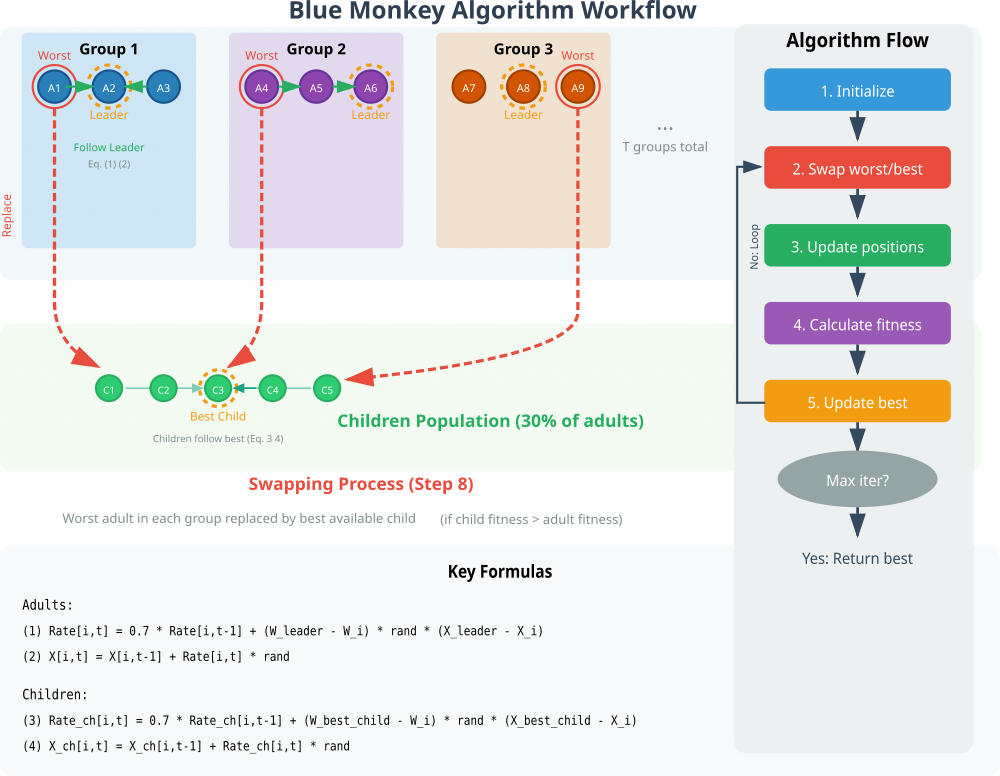
Figura 1. Esquema de funcionamiento del algoritmo BM
En el esquema se muestra el funcionamiento del algoritmo BM, con la lógica dividida en dos ramas independientes para los individuos adultos y las crías, junto con las fórmulas principales. Podemos pasar a redactar el pseudocódigo del algoritmo BM.
Inicialización:
- Crear una población de monos adultos (tamaño N)
- A cada mono se le asigna una posición aleatoria en el espacio de búsqueda
- Inicializar la velocidad de desplazamiento en cero
- Asignar un peso inicial de entre 4 y 6
- Crear una población de crías (el 30 % del tamaño de la población adulta)
- Cada cría recibe una posición aleatoria
- Inicializar la velocidad de desplazamiento en cero
- Asignar un peso inicial de entre 4 y 6
- Dividir a los adultos en grupos
- Dividir la población en T grupos de manera uniforme
- El mono con índice i entra en el grupo (i módulo T)
- Calcular el fitness inicial
- Evaluar la calidad de la posición de cada adulto
- Evaluar la calidad de la posición de cada cría
Ciclo principal (hasta que se cumpla el criterio de parada):
- Actualizar los pesos en función del fitness
- Encontrar los valores mínimo y máximo de fitness entre los adultos
- Normalizar los pesos: peso = 4 + 2 × (fitness - mín.)/(máx. - mín.)
- Repetir con las crías
- Sustituir los peores por los mejores (a partir de la segunda iteración)
- Para cada grupo de adultos:
- Encontrar al mono con peor fitness del grupo
- Seleccionar la siguiente cría con mejor fitness que aún no se haya utilizado
- Si el fitness de la cría es mejor que el del adulto:
- Sustituir al adulto por la cría
- Crear una nueva cría en la plaza que ha quedado libre
- Para cada grupo de adultos:
- Actualizar las posiciones de los monos adultos
- Para cada mono del grupo:
- Encontrar al líder del grupo (el mono con mejor fitness)
- Actualizar la velocidad: nueva velocidad = 0,7 × velocidad anterior + (peso del líder - peso propio) × valor aleatorio × (posición del líder - posición propia)
- Actualizar la posición: nueva posición = posición anterior + velocidad × valor aleatorio
- Restringir la posición a los límites del espacio de búsqueda
- Para cada mono del grupo:
- Actualizar las posiciones de las crías
- Encontrar la mejor cría entre todas
- Para cada una de las demás crías:
- Actualizar la velocidad: nueva velocidad = 0,7 × velocidad anterior + (peso de la mejor cría - peso propio) × valor aleatorio × (posición de la mejor cría - posición propia)
- Actualizar la posición: nueva posición = posición anterior + velocidad × valor aleatorio
- Restringir la posición a los límites
- Calcular el nuevo fitness
- Evaluar la calidad de las nuevas posiciones de todos los monos
- Evaluar la calidad de las nuevas posiciones de todas las crías
- Actualizar la mejor solución global
- Si se encuentra una solución mejor que el récord actual:
- Guardarlo como un nuevo récord
- Aumentar el contador de iteraciones
- Si se encuentra una solución mejor que el récord actual:
- Comprobar el criterio de parada
- Si se ha alcanzado el número máximo de iteraciones O BIEN
- Si se ha alcanzado la precisión requerida:
- Salir del bucle
- De lo contrario: volver al paso 5
Finalización:
- Devolver el resultado
- Devolver la mejor posición encontrada
- Devolver el valor de fitness en esta posición
Ahora vamos a convertir el pseudocódigo en código real. Vamos a crear la clase «C_AO_BM». Esta clase deriva de «C_AO», que es la clase base. La clase «C_AO_BM» hereda todos los campos públicos y protegidos de la clase «C_AO».
Campos públicos:
El constructor «C_AO_BM» inicializa las propiedades básicas del algoritmo y establece sus parámetros iniciales: «popSize» (tamaño de la población), «numGroups» (número de grupos) y «childrenRatio» (proporción de crías). Configura el array «params», que se utiliza para almacenar los parámetros configurables del algoritmo. Para cada parámetro se indica su nombre y su valor actual. Establece los valores mínimo «minW» y máximo «maxW» para los pesos utilizados en el algoritmo.- SetParams(): método para establecer los parámetros del algoritmo a partir del array «params». Lee los valores «val» de «params» y los convierte a los tipos de datos correspondientes (int o double), asignándolos a los miembros de la clase.
- Init(): método de inicialización que prepara el algoritmo para su funcionamiento utilizando los rangos de entrada (rangeMinP, rangeMaxP, rangeStepP) y el número de épocas (epochsP).
- Moving (): método que implementa la lógica principal para desplazar o actualizar los individuos de la población según el algoritmo.
- Revision (): método que se utiliza para revisar o evaluar el estado actual de la población, así como para su posible selección y actualización.
- numGroups: el número de grupos en los que se divide la población.
- childrenRatio: porcentaje de la población que estará representado por «crías» (nuevos individuos).
- numChildren: el número de «crías» de la población, que se calcula a partir de «popSize» y «childrenRatio».
- minW, maxW: valores mínimo y máximo de los pesos.
- Arrays para los monos adultos:
- monkeyRate: almacena la «velocidad» de cada individuo de la población. El tamaño del array depende de «popSize» y del número de dimensiones (coordenadas) en el espacio de búsqueda.
- monkeyWeight: almacena los «pesos» (W) de cada individuo adulto.
- groupId: un array que indica a qué grupo pertenece cada individuo adulto.
- Los arrays para las crías almacenan:
- childPos: posiciones de las «crías» en el espacio de búsqueda.
- childRate: la «velocidad» de las «crías».
- childWeight: los «pesos» de las «crías».
- childFitness: valor de aptitud (fitness) para las «crías».
- Métodos privados:
- SwapWorstWithBest () — implementa el paso 8 del algoritmo, que consiste en sustituir el peor individuo del grupo por el mejor.
- UpdatePositions () — implementa los pasos 9 y 10 del algoritmo, encargados de actualizar las posiciones de los individuos.
- UpdateWeights () — implementa el paso 2 del algoritmo y la actualización general de los pesos.
- FindGroupBest () — encuentra el mejor individuo del grupo indicado.
- FindGroupWorst () — encuentra el peor individuo del grupo indicado.
El algoritmo divide la población en grupos, utiliza los conceptos de «velocidad» (rate) y «pesos» (weight) para desplazar a los individuos, e incluye mecanismos para la creación de «crías» y la sustitución de los peores individuos por los mejores dentro de los grupos. Los miembros privados están destinados a la gestión interna del estado del algoritmo, mientras que los miembros públicos proporcionan una interfaz para configurar y ejecutar la optimización.
//————————————————————————————————————————————————————————————————————
class C_AO_BM : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_BM () { }
  C_AO_BM ()
  {
    ao_name = "BM";
    ao_desc = "Blue Monkey Algorithm";
    ao_link = "https://www.mql5.com/ru/articles/19757";

    popSize        = 50;    // tamaño de la población
    numGroups      = 5;     // número de grupos T
    childrenRatio  = 0.3;   // porcentaje de crías respecto a la población

    ArrayResize (params, 3);
    params [0].name = "popSize";       params [0].val = popSize;
    params [1].name = "numGroups";     params [1].val = numGroups;
    params [2].name = "childrenRatio"; params [2].val = childrenRatio;

    minW           = 4.0;
    maxW           = 6.0;
  }

  void SetParams ()
  {
    popSize       = (int)params [0].val;
    numGroups     = (int)params [1].val;
    childrenRatio = params      [2].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  int    numGroups;      // número de grupos T
  double childrenRatio;  // porcentaje de crías

  private: //---------------------------------------------------------
  int    numChildren;         // número de crías
  double minW;
  double maxW;

  // Arrays para monos adultos
  double monkeyRate   [];     // Rate: velocidad de cambio [popSize * coords]
  double monkeyWeight [];     // W: pesos de los monos
  int    groupId      [];     // pertenencia a un grupo

  // Arrays para crías
  double childPos     [];      // posiciones de las crías [numChildren * coords]
  double childRate    [];      // Velocidad de las crías
  double childWeight  [];      // W para crías
  double childFitness [];      // fitness de las crías

  void SwapWorstWithBest ();   // Paso 8
  void UpdatePositions   ();   // Pasos 9-10
  void UpdateWeights     ();   // Paso 2 y actualización
  int  FindGroupBest     (int groupId);
  int  FindGroupWorst    (int groupId);
};
//————————————————————————————————————————————————————————————————————
La función «Init» realiza las siguientes acciones:
Inicialización estándar. En primer lugar, se llama a la función básica de inicialización «StandardInit» con los parámetros de rango (rangeMinP, rangeMaxP, rangeStepP) pasados como argumentos. Si esta inicialización básica falla, la función «Init» también finaliza devolviendo «false».
Ajuste de los parámetros:
- Luego se comprueba el número de grupos (numGroups).
- El número de «crías» (numChildren) se calcula en función del tamaño de la población y de la proporción de crías (childrenRatio).
- Se modifica el tamaño de los arrays destinados a almacenar datos de individuos «adultos». Esto incluye «monkeyRate» (donde se almacena la velocidad para cada dimensión), «monkeyWeight» (el peso de cada individuo) y «groupId» (la pertenencia del individuo a un grupo).
- Después se modifica el tamaño de los arrays correspondientes a las crías, incluyendo sus posiciones (childPos), velocidades (childRate), pesos (childWeight) y valores de aptitud (childFitness).
Inicialización de las velocidades. Los arrays «monkeyRate» y «childRate» (que se utilizan para determinar la dirección del movimiento) se inicializan con valores iguales a cero.
Inicialización de los pesos: Los pesos (monkeyWeight y childWeight) para los «adultos» y las «crías» se inicializan con valores aleatorios en un rango que va de «minW» a «maxW»; los pesos reales se recalcularán tras el primer cálculo de la aptitud.
Distribución por grupos:
- Los individuos adultos se distribuyen en grupos (groupId) mediante la operación módulo. Es decir, el primer individuo se asigna al grupo 0, el segundo al grupo 1, …, el individuo número numGroups al grupo numGroups - 1, el individuo número (numGroups + 1) de nuevo al grupo 0, y así sucesivamente.
- Todas las crías formarán parte inicialmente de un mismo equipo.
Inicialización de la aptitud de las crías: El array «childFitness» se inicializa con el valor mínimo posible. Esto se hace para que cualquier valor real calculado de la aptitud sea mayor que este valor inicial.
La función devuelve «true» si la inicialización se ha ejecutado correctamente. De este modo, la función «Init» se encarga de todo el trabajo preparatorio: establece los tamaños necesarios de las estructuras de datos, fija los valores iniciales de la velocidad y los pesos, distribuye los individuos por grupos y los prepara para el primer ciclo de cálculos.
//————————————————————————————————————————————————————————————————————
bool C_AO_BM::Init (const double &rangeMinP  [],
                    const double &rangeMaxP  [],
                    const double &rangeStepP [],
                    const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Ajuste de los parámetros
  if (numGroups < 1) numGroups = 1;
  if (numGroups > popSize) numGroups = popSize;

  numChildren = (int)(popSize * childrenRatio);
  if (numChildren < 1) numChildren = 1;

  // Inicialización de arrays para adultos
  ArrayResize (monkeyRate, popSize * coords);
  ArrayResize (monkeyWeight, popSize);
  ArrayResize (groupId, popSize);

  // Inicialización de arrays para las crías
  ArrayResize (childPos, numChildren * coords);
  ArrayResize (childRate, numChildren * coords);
  ArrayResize (childWeight, numChildren);
  ArrayResize (childFitness, numChildren);

  // Paso 2: Inicializar la velocidad Rate y el peso W
  // Rate ∈ [0, 1], W ∈ [4, 6]
  ArrayInitialize (monkeyRate, 0.0);
  ArrayInitialize (childRate, 0.0);

  // Los pesos se actualizarán tras el primer cálculo del fitness
  for (int i = 0; i < popSize; i++)
  {
    monkeyWeight [i] = u.RNDfromCI (minW, maxW);
  }

  for (int i = 0; i < numChildren; i++)
  {
    childWeight [i] = u.RNDfromCI (minW, maxW);
  }

  // Paso 3: Distribución por grupos
  // Los adultos se distribuyen en T grupos
  for (int i = 0; i < popSize; i++)
  {
    groupId [i] = i % numGroups;
  }
  // «while all children in one team» — todas las crías en un mismo equipo desde el principio

  ArrayInitialize (childFitness, -DBL_MAX);

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «Moving» realiza las siguientes acciones: primero se comprueba el indicador «revision» y, si «revision» es «false» (primera ejecución):
Inicialización de la población de adultos (Paso 1). Para cada individuo adulto «i» (de 0 a popSize - 1) y para cada dimensión «j» (de 0 a coords - 1), la posición (a [i].c [j]) se inicializa con un número aleatorio dentro del intervalo especificado (rangeMin [j], rangeMax [j]). A continuación, el valor de la posición se corrige mediante la función «u.SeInDiSp», que garantiza que se mantenga dentro de los límites establecidos y se ajuste al paso (rangeStep [j]).
Inicialización de la población de crías (Paso 1). Para cada cría «i» (de 0 a numChildren - 1) y para cada dimensión «j» (de 0 a coords - 1), la posición (childPos [i * coords + j]) se inicializa con un número aleatorio dentro del intervalo especificado (rangeMin, rangeMax). El valor de la posición también se ajusta mediante la función «u.SeInDiSp».
El indicador «revision» se establece en «true» para que, en las siguientes llamadas al método «Moving», se ejecute otra parte de la lógica. El método finaliza su ejecución. Si «revision» es «true» (ejecuciones posteriores), se invoca el método «UpdatePositions()» para actualizar las posiciones. Este método se encarga de desplazar a los individuos siguiendo la lógica del algoritmo del «mono azul».
De este modo, el método «Moving» tiene dos objetivos principales:
- La primera vez que se ejecuta, inicializa por completo las posiciones de todos los individuos adultos y crías dentro de los rangos establecidos.
- En las llamadas posteriores, delega la tarea principal de desplazar a los individuos en el método «UpdatePositions()», que implementa el núcleo del movimiento del algoritmo.
//————————————————————————————————————————————————————————————————————
void C_AO_BM::Moving ()
{
  if (!revision)
  {
    // Paso 1: Inicialización de la población de adultos
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    // Paso 1: Inicialización de la población de crías
    for (int i = 0; i < numChildren; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        childPos [i * coords + j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        childPos [i * coords + j] = u.SeInDiSp (childPos [i * coords + j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  UpdatePositions ();
}
//————————————————————————————————————————————————————————————————————
El método «Revision» realiza las siguientes acciones:
Actualización de los pesos. En primer lugar, se invoca el método «UpdateWeights()». Esto significa que los pesos de cada individuo se recalculan en función de sus valores actuales de aptitud.Intercambio del peor por el mejor. A continuación, se invoca el método «SwapWorstWithBest()». Este método identifica al individuo con el peor valor de aptitud y lo sustituye por el individuo con el mejor valor de aptitud.
Actualización del mejor individuo. Para los individuos adultos, se recorre cada individuo adulto «i» (de 0 a popSize - 1) y, si su valor actual de aptitud (a [i].f) es mayor que el mejor valor de aptitud que ha alcanzado hasta el momento (a [i].fB), se actualiza el valor de aptitud del individuo. La posición del mejor resultado del individuo (a [i].cB) se copia a partir de la posición actual del individuo (a [i].c).
Del mismo modo, si el valor actual de aptitud de un individuo adulto (a [i].f) es mayor que el mejor valor de aptitud global de toda la población (fB), se actualiza el mejor valor de aptitud global (fB). La posición de la mejor solución global (cB) se copia a partir de la posición actual del individuo (a [i].c).
Para las crías. Se itera sobre todas las crías «i» (desde 0 hasta numChildren - 1). Si el fitness de la cría (childFitness [i]) es mayor que el mejor valor global de aptitud (fB), se actualiza el mejor valor global de aptitud (fB). La posición de la mejor solución global (cB) se actualiza copiando las coordenadas de la cría (childPos).En general, el método «Revision» está diseñado para mejorar la calidad de las soluciones mediante el seguimiento y el almacenamiento de la mejor solución encontrada tanto para cada individuo (récord personal) como para toda la población en su conjunto (récord global), teniendo en cuenta tanto a los individuos adultos como a las crías.
//————————————————————————————————————————————————————————————————————
void C_AO_BM::Revision ()
{
  // Actualizamos los pesos en función del fitness actual
  UpdateWeights ();

  // Paso 8: Intercambio
  SwapWorstWithBest ();

  // Paso 12: Actualizar el mejor resultado actual
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > a [i].fB)
    {
      a [i].fB = a [i].f;
      ArrayCopy (a [i].cB, a [i].c, 0, 0, coords);
    }

    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, coords);
    }
  }

  // Comprobación de las crías para actualizar el mejor resultado global
  for (int i = 0; i < numChildren; i++)
  {
    if (childFitness [i] > fB)
    {
      fB = childFitness [i];
      for (int j = 0; j < coords; j++)
      {
        cB [j] = childPos [i * coords + j];
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «UpdatePositions» de la clase «C_AO_BM» implementa la lógica básica del movimiento de los individuos de la población, siguiendo unas ecuaciones matemáticas determinadas. El método se divide en dos partes: la actualización de las posiciones de los individuos adultos (los llamados «monos azules») y la actualización de las posiciones de las crías.
Actualización de las posiciones de los individuos adultos (monos azules):
El método recorre cada individuo adulto «i» (desde 0 hasta popSize - 1). Búsqueda del líder del grupo: para cada individuo actual se determina su grupo (groupId [i]) y se calcula el índice del mejor individuo de ese grupo (bestIdx = FindGroupBest). Si el individuo en cuestión es el propio líder del grupo o no se ha encontrado al líder, pasamos al siguiente individuo. Actualización según las ecuaciones 1 y 2 (para cada dimensión).
Actualización de la velocidad (ecuación 1):
- Se obtienen los pesos del líder del grupo «Wleader» y del individuo actual «Wi».
- Se obtienen las posiciones actuales del líder «Xbest» y del individuo «Xi» en esta dimensión.
- Se genera un número aleatorio «rand1» comprendido entre 0 y 1.
- Se obtiene la nueva velocidad «monkeyRate» para el individuo actual. Se trata de una combinación de la velocidad anterior (con un coeficiente de 0,9) y del efecto de la diferencia entre los pesos del líder y del individuo actual, multiplicado por un número aleatorio y por la diferencia entre las posiciones del líder y del individuo actual.
Actualización de la posición (ecuación 2):
Se genera otro número aleatorio «rand2» comprendido entre 0 y 1. La nueva posición del individuo se calcula sumando a la posición actual el producto de la nueva velocidad «monkeyRate» y el número aleatorio «rand2». La nueva posición obtenida se limita obligatoriamente a los intervalos especificados (u.SeInDiSp) para que permanezca dentro del área de búsqueda admisible.
Actualización de las posiciones de las crías:
- Búsqueda de la mejor cría: en primer lugar, el método recorre todas las crías «i» de 0 a numChildren - 1 para encontrar la que tenga la mejor aptitud (bestChildFitness) y determinar su índice (bestChildIdx).
- Actualización según las ecuaciones 3 y 4 (si se ha encontrado la mejor cría):
- Si se ha encontrado la mejor cría (bestChildIdx >= 0), el método recorre todas las crías «i» de 0 a numChildren - 1, excepto la mejor.
- Actualización de la velocidad de la cría (ecuación 3):
- Al igual que en el caso de los individuos adultos, se determinan los pesos de la mejor cría, «Wchleader», y de la cría actual, «Wchi».
- Se obtienen las posiciones actuales de la mejor cría «Xchbest» y de la cría actual «Xchi» en esta dimensión.
- Se genera un número aleatorio «rand1» comprendido entre 0 y 1.
- Se calcula la nueva velocidad (childRate) para la cría actual mediante una fórmula similar a la de la ecuación 1.
- Actualización de la posición de la cría (ecuación 4):
- Se genera un número aleatorio «rand2» entre 0 y 1.
- La nueva posición de la cría se calcula sumando a su posición actual el producto de su nueva velocidad (childRate) y el número aleatorio «rand2».
- Restricción de la posición: la nueva posición de la cría también se limita a los intervalos establecidos.
De este modo, el método «UpdatePositions» implementa:
- Modelo de comportamiento de los «monos azules»: los individuos adultos se desplazan guiándose por el líder de su grupo, y la velocidad de desplazamiento depende de la diferencia de peso y de la diferencia de posiciones.
- Modelo de comportamiento de las crías: las crías se desplazan de forma análoga, guiándose por la mejor cría.
- Mantenimiento de los individuos dentro de la región de búsqueda admisible mediante la función «SeInDiSp».
//————————————————————————————————————————————————————————————————————
void C_AO_BM::UpdatePositions ()
{
  // Paso 9: Actualizar la posición de los monos azules mediante las ecuaciones 1 y 2
  for (int i = 0; i < popSize; i++)
  {
    int bestIdx = FindGroupBest (groupId [i]);
    if (bestIdx < 0 || bestIdx == i) continue;

    for (int j = 0; j < coords; j++)
    {
      // Ecuación (1): Actualización de la velocidad
      double Wleader = monkeyWeight [bestIdx];
      double Wi      = monkeyWeight [i];
      double Xbest   = a [bestIdx].c [j];
      double Xi      = a [i].c [j];
      double rand1   = u.RNDfromCI (0, 1);

      // Rate_{i,t} = (0.7 * Rate) + (W_leader - W_i) * rand * (X_best - X_i)
      monkeyRate [i * coords + j] = 0.9 * monkeyRate [i * coords + j] +
                                    (Wleader - Wi) * rand1 * (Xbest - Xi);

      // Ecuación (2): Actualización de la posición
      // X_{i,t} = X_i + Rate_{i,t} * rand
      double rand2 = u.RNDfromCI (0, 1);
      a [i].c [j] = a [i].c [j] + monkeyRate [i * coords + j] * rand2;

      // Limitación dentro del rango
      a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
    }
  }

  // Paso 10: Actualizar la posición de las crías según las ecuaciones 3 y 4
  // Encontramos a la mejor cría
  int bestChildIdx = -1;
  double bestChildFitness = -DBL_MAX;
  for (int i = 0; i < numChildren; i++)
  {
    if (childFitness [i] > bestChildFitness)
    {
      bestChildFitness = childFitness [i];
      bestChildIdx = i;
    }
  }

  if (bestChildIdx >= 0)
  {
    for (int i = 0; i < numChildren; i++)
    {
      if (i == bestChildIdx) continue;

      for (int j = 0; j < coords; j++)
      {
        // Ecuación (3): Actualización de la velocidad de las crías
        double Wchleader = childWeight [bestChildIdx];
        double Wchi      = childWeight [i];
        double Xchbest   = childPos [bestChildIdx * coords + j];
        double Xchi      = childPos [i * coords + j];
        double rand1     = u.RNDfromCI (0, 1);

        childRate [i * coords + j] = 0.9 * childRate [i * coords + j] +
                                     (Wchleader - Wchi) * rand1 * (Xchbest - Xchi);

        // Ecuación (4): Actualización de la posición de las crías
        double rand2 = u.RNDfromCI (0, 1);
        childPos [i * coords + j] = childPos [i * coords + j] + childRate [i * coords + j] * rand2;

        childPos [i * coords + j] = u.SeInDiSp (childPos [i * coords + j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «SwapWorstWithBest» realiza las siguientes acciones:
Preparación de las crías. Se crea un array «childIndices» para almacenar los índices de todas las crías. Este array se rellena con índices que van desde 0 hasta el número total de crías. A continuación, se ordenan los índices de las crías en orden descendente según su valor de aptitud (childFitness). Esto se hace mediante un sencillo algoritmo de ordenación por burbujas. Como resultado, «childIndices [0]» contendrá el índice de la mejor cría, «childIndices [1]» el índice de la segunda mejor, y así sucesivamente. Se crea un array booleano «childUsed» para llevar un control de si cada cría se ha utilizado para la sustitución.
Iteración por grupos de individuos adultos. El método recorre cada grupo de individuos adultos (desde g = 0 hasta numGroups - 1). Para cada grupo, si ya se han utilizado todas las crías, se interrumpe el procesamiento posterior. Dentro de cada grupo se identifica al individuo adulto con peor aptitud (worstAdultIdx). Se selecciona la mejor cría disponible en ese momento (utilizando el array ordenado «childIndices» y el contador «childIndex»). Se comprueba si la aptitud de la cría seleccionada (childFitness [currentChildIdx]) es mejor que la del individuo adulto con peor aptitud del grupo (a [worstAdultIdx].f).
- Sustitución (si es mejor):
- Si la cría es mejor:
- La posición y la velocidad del individuo adulto con peor rendimiento se sustituyen por la posición y la velocidad de la cría seleccionada.
- El valor de la aptitud del individuo adulto se actualiza al valor de la aptitud de la cría.
- El peso del individuo adulto se actualiza al peso de la cría.
- La cría se marca como utilizada (childUsed[currentChildIdx] = true) y el contador «childIndex» se incrementa para pasar a la siguiente cría más adecuada.
- Si la cría es mejor:
- Interrupción de la sustitución (si es peor):
- Si ni siquiera la mejor cría disponible es mejor que el individuo adulto con peor aptitud del grupo actual, se interrumpen los intentos posteriores de sustitución en este grupo y en los siguientes. Esto se debe a que las crías están ordenadas por aptitud y, si la peor de las mejores crías no supera al individuo con peor aptitud, las crías siguientes tampoco aportarán ninguna ventaja.
De este modo, el método «SwapWorstWithBest» desempeña la siguiente función: utiliza activamente a las mejores crías para sustituir a los individuos adultos con peor aptitud dentro de sus grupos, siempre que ello suponga una mejora, trasladando así las mejores soluciones jóvenes a los estratos más «adultos» de la población. Las crías que se han utilizado para la sustitución se «regeneran» a continuación con nuevos parámetros aleatorios.
//————————————————————————————————————————————————————————————————————
void C_AO_BM::SwapWorstWithBest ()
{
  // Paso 8: Sustituir el peor fitness de cada grupo por el mejor fitness del grupo de crías

  // Creamos un array de índices de las crías y lo ordenamos por fitness
  int childIndices [];
  ArrayResize (childIndices, numChildren);
  for (int i = 0; i < numChildren; i++)
  {
    childIndices [i] = i;
  }

  // Ordenamos los índices de las crías en orden descendente según su fitness
  for (int i = 0; i < numChildren - 1; i++)
  {
    for (int j = 0; j < numChildren - i - 1; j++)
    {
      if (childFitness [childIndices [j]] < childFitness [childIndices [j + 1]])
      {
        int temp = childIndices [j];
        childIndices [j] = childIndices [j + 1];
        childIndices [j + 1] = temp;
      }
    }
  }

  // Para el seguimiento de las crías utilizadas
  bool childUsed [];
  ArrayResize (childUsed, numChildren);
  ArrayInitialize (childUsed, false);

  // Intentamos sustituir al peor de cada grupo
  int childIndex = 0;

  for (int g = 0; g < numGroups; g++)
  {
    if (childIndex >= numChildren) break;

    // Encontramos al peor del grupo
    int worstAdultIdx = FindGroupWorst (g);
    if (worstAdultIdx < 0) continue;

    // Utilizamos la mejor cría disponible
    int currentChildIdx = childIndices [childIndex];

    // Comprobamos si la cría es mejor
    if (childFitness [currentChildIdx] > a [worstAdultIdx].f)
    {
      // Realizamos la sustitución
      for (int j = 0; j < coords; j++)
      {
        a [worstAdultIdx].c [j] = childPos [currentChildIdx * coords + j];
        monkeyRate [worstAdultIdx * coords + j] = childRate [currentChildIdx * coords + j];
      }
      a [worstAdultIdx].f = childFitness [currentChildIdx];
      monkeyWeight [worstAdultIdx] = childWeight [currentChildIdx];

      childUsed [currentChildIdx] = true;
      childIndex++;
    }
    else
    {
      // Si la mejor cría no es mejor que el peor adulto,
      // No tiene sentido seguir comprobando (ya están ordenados)
      break;
    }
  }

  // Generamos nuevas crías para sustituir a las que se han utilizado
  for (int i = 0; i < numChildren; i++)
  {
    if (childUsed [i])
    {
      for (int j = 0; j < coords; j++)
      {
        childPos [i * coords + j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        childPos [i * coords + j] = u.SeInDiSp (childPos [i * coords + j],
                                                rangeMin [j], rangeMax [j], rangeStep [j]);
        childRate [i * coords + j] = 0.0;
      }
      childFitness [i] = -DBL_MAX;
      childWeight [i] = u.RNDfromCI (minW, maxW); // Nuevo peso según las condiciones iniciales
    }
  }
}
//————————————————————————————————————————————————————————————————————
La función «UpdateWeights» se encarga de ajustar los pesos de dos grupos de entidades: «monos» (individuos progenitores) y «crías». El ajuste de los pesos se basa en el principio de normalización y escalado en función de la aptitud (fitness) de cada entidad.
Determinación del rango de aptitud. En primer lugar, la función calcula los valores mínimo (minFit) y máximo (maxFit) de aptitud entre todos los «monos» de la población.
Tratamiento del caso de valores de aptitud iguales. Si la diferencia entre la aptitud máxima y la aptitud mínima es muy pequeña (inferior a 1e-10, lo que en la práctica significa que todos los valores de aptitud son aproximadamente iguales), a todos los «monos» se les asigna un peso fijo igual a 5,0 (el valor medio del rango deseado).
Normalización y escalado de los pesos de los «monos». Si el rango de aptitud es suficientemente amplio (superior a 1e-10), ocurre lo siguiente para cada «mono»:
- Su aptitud (a [i].f) se normaliza en el intervalo [0, 1]. Esto se hace restando la aptitud mínima (minFit) y dividiendo el resultado por la diferencia entre la aptitud máxima y la mínima (maxFit - minFit).
- A continuación, el valor normalizado obtenido se escala para obtener un peso final en el intervalo [4, 6]. Esto se consigue multiplicando el valor normalizado por 2,0 y sumándole el peso mínimo (minW). De este modo, los individuos con menor aptitud obtienen un peso cercano a 4,0, mientras que los que tienen mayor aptitud obtienen un peso cercano a 6,0.
Procesamiento de los pesos de las «crías». Tras procesar los «monos», el proceso se repite con las «crías». En primer lugar, se determinan la aptitud mínima (minChildFit) y la máxima (maxChildFit) entre todas las «crías». En este caso, se ignoran las «crías» cuya aptitud no se haya inicializado (se supone que la aptitud no inicializada tiene un valor muy bajo, cercano a -DBL_MAX). Al igual que con los «monos»:
- si la diferencia entre la aptitud máxima y la mínima de las «crías» es pequeña, a todas las «crías» inicializadas se les asigna un peso de 5,0;
- si el rango de aptitud de las «crías» es suficiente, su aptitud se normaliza en el rango [0, 1] y, a continuación, se escala al rango [4, 6] de forma similar a como ocurre con los «monos».
En general, la función «UpdateWeights» transforma los valores de aptitud de los individuos (tanto de los «monos» como de las «crías») en pesos que oscilan entre 4 y 6. Esto se hace con el fin de aumentar o reducir la influencia de los individuos con distintos grados de aptitud en las etapas posteriores del algoritmo. Los individuos con mayor aptitud obtienen un peso más alto, lo que podría indicar que son más importantes.
//————————————————————————————————————————————————————————————————————
void C_AO_BM::UpdateWeights ()
{
  double minFit = DBL_MAX, maxFit = -DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > maxFit) maxFit = a [i].f;
    if (a [i].f < minFit) minFit = a [i].f;
  }

  if (maxFit - minFit > 1e-10)
  {
    for (int i = 0; i < popSize; i++)
    {
      // Normalizamos en [0,1] y escalamos en [4,6]
      double normalized = (a [i].f - minFit) / (maxFit - minFit);
      monkeyWeight [i] = minW + normalized * 2.0; // Obtenemos un valor en el intervalo [4,6]
    }
  }
  else
  {
    for (int i = 0; i < popSize; i++)
    {
      monkeyWeight [i] = 5.0; // Valor medio
    }
  }

  // Actualización de los pesos de las crías
  double minChildFit = DBL_MAX, maxChildFit = -DBL_MAX;

  for (int i = 0; i < numChildren; i++)
  {
    if (childFitness [i] > -DBL_MAX + 1) // Comprobación de la inicialización
    {
      if (childFitness [i] > maxChildFit) maxChildFit = childFitness [i];
      if (childFitness [i] < minChildFit) minChildFit = childFitness [i];
    }
  }

  if (maxChildFit - minChildFit > 1e-10)
  {
    for (int i = 0; i < numChildren; i++)
    {
      if (childFitness [i] > -DBL_MAX + 1)
      {
        double normalized = (childFitness [i] - minChildFit) /
                            (maxChildFit - minChildFit);
        childWeight [i] = minW + normalized * 2.0; // En el intervalo [4,6]
      }
    }
  }
  else
  {
    for (int i = 0; i < numChildren; i++)
    {
      if (childFitness [i] > -DBL_MAX + 1)
      {
        childWeight [i] = 5.0;
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
La función «FindGroupBest» sirve para buscar el mejor individuo dentro de un grupo determinado. La función recorre cada individuo de la población total mediante un bucle (de 0 a popSize - 1).
- bestFitness se actualiza con el valor de aptitud del individuo actual.
- bestIdx se actualiza con el índice «i» del individuo actual.
Una vez finalizado el recorrido completo por la población, la función devuelve el valor «bestIdx». Será el índice del individuo con mayor aptitud dentro del grupo indicado. Si el grupo está vacío o no contiene individuos con una aptitud superior al valor mínimo inicial, la función devolverá -1.
Por lo tanto, la función «FindGroupBest» es una herramienta auxiliar para determinar el líder o la mejor solución (individuo) dentro de un subgrupo concreto de una población.
//————————————————————————————————————————————————————————————————————
int C_AO_BM::FindGroupBest (int grpId)
{
  int bestIdx = -1;
  double bestFitness = -DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (groupId [i] == grpId && a [i].f > bestFitness)
    {
      bestFitness = a [i].f;
      bestIdx = i;
    }
  }

  return bestIdx;
}
//————————————————————————————————————————————————————————————————————
La función «FindGroupWorst» recorre cada individuo, empezando por el índice 0 y terminando por el último individuo de la población (popSize - 1).
Comprobación de la pertenencia al grupo y comparación de la aptitud. Para cada individuo del bucle, primero se comprueba si pertenece al grupo objetivo, definido por el parámetro «grpId». Si un individuo pertenece al grupo que nos interesa, se compara su valor de aptitud (a [i].f) con el peor valor actual (worstFitness). Si la aptitud del individuo actual es inferior al valor actual más desfavorable (worstFitness), esto significa que hemos encontrado un nuevo individuo aún peor. En ese caso:
- worstFitness se actualiza con el valor de aptitud de este nuevo individuo, que es peor;
- worstIdx se actualiza para almacenar el índice «i» de este nuevo individuo, que es peor.
//————————————————————————————————————————————————————————————————————
int C_AO_BM::FindGroupWorst (int grpId)
{
  int worstIdx = -1;
  double worstFitness = DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (groupId [i] == grpId && a [i].f < worstFitness)
    {
      worstFitness = a [i].f;
      worstIdx = i;
    }
  }

  return worstIdx;
}
//————————————————————————————————————————————————————————————————————
Resultados de las pruebas
Echemos un vistazo a los resultados; por desgracia, no es suficiente para entrar en la clasificación.BM|Blue Monkey Algorithm|50.0|3.0|0.7|
=============================
5 Hilly's; Func runs: 10000; result: 0.6730156841791012
25 Hilly's; Func runs: 10000; result: 0.3811383925125479
500 Hilly's; Func runs: 10000; result: 0.26883473381494066
=============================
5 Forest's; Func runs: 10000; result: 0.6116553050534701
25 Forest's; Func runs: 10000; result: 0.3051920014986885
500 Forest's; Func runs: 10000; result: 0.18691769556662757
=============================
5 Megacity's; Func runs: 10000; result: 0.4384615384615385
25 Megacity's; Func runs: 10000; result: 0.19353846153846152
500 Megacity's; Func runs: 10000; result: 0.1037384615384623
=============================
Puntuación total: 3,16249 (35,14 %)
En la visualización se aprecia muy bien la división en grupos y las zonas de concentración de los individuos.

BM en la función de prueba «Hilly»

BM en la función de prueba Forest

BM en la función de prueba «Megacity»
En la tabla de clasificación, el algoritmo BM se presenta a título informativo.
| AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | |||||||
| DOAdingom | dingo_optimization_algorithm_M | 0,47968 | 0,45367 | 0,46369 | 1,39704 | 0,94145 | 0,87909 | 0,91454 | 2,73508 | 0,78615 | 0,86061 | 0,84805 | 2,49481 | 6,627 | 73,63 |
| ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| CLA | code lock algorithm (joo) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| AMOm | animal migration optimization M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| CTA | comet tail algorithm (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| TETA | time evolution travel algorithm (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| SDSm | stochastic diffusion search M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| BOAm | billiards optimization algorithm M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| AAm | archery algorithm M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| ESG | evolution of social groups (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| SIA | simulated isotropic annealing (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4,959 | 55,10 |
| DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| CRO | chemical reaction optimisation | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4,825 | 53,62 |
| BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1,12012 | 4,809 | 53,44 |
| DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4,762 | 52,91 |
| HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| CMAES | covariance_matrix_adaptation_evolution_strategy | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| BM | blue_monkey _algorithm | 0,67301 | 0,38113 | 0,26883 | 1,32297 | 0,61165 | 0,30519 | 0,18691 | 1,10375 | 0,43846 | 0,19354 | 0,10373 | 0,73573 | 3,162 | 35,14 |
| RW | random walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26,09 |
Conclusiones
El algoritmo demostró ser funcional en las funciones de prueba, pero no obtuvo resultados lo suficientemente competitivos como para ser incluido en la tabla de clasificación. Los resultados apuntan a la necesidad de seguir optimizando y perfeccionando los mecanismos clave. La estructura en grupos permite explorar el espacio de búsqueda de forma paralela, y el mecanismo de renovación generacional aporta un elemento de actualización a la población; sin embargo, la velocidad de convergencia hacia la solución óptima es inferior a la esperada.
El algoritmo Blue Monkey ofrece un enfoque interesante para resolver problemas de optimización, basado en la simulación de procesos naturales. A pesar de las limitaciones actuales en cuanto al rendimiento, el concepto tiene potencial para desarrollarse. La versión actual puede recomendarse con fines educativos y como base para futuras investigaciones en el ámbito de los algoritmos metaheurísticos de optimización.
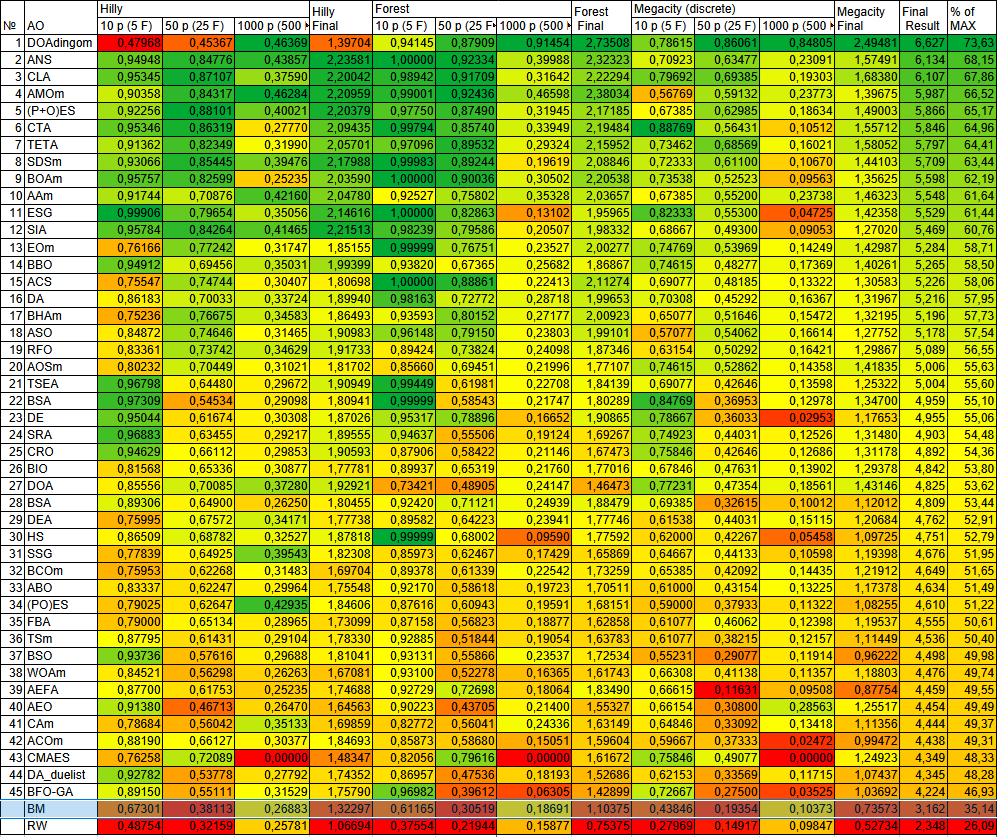
Figura 2. Escala de colores de los algoritmos según las pruebas correspondientes
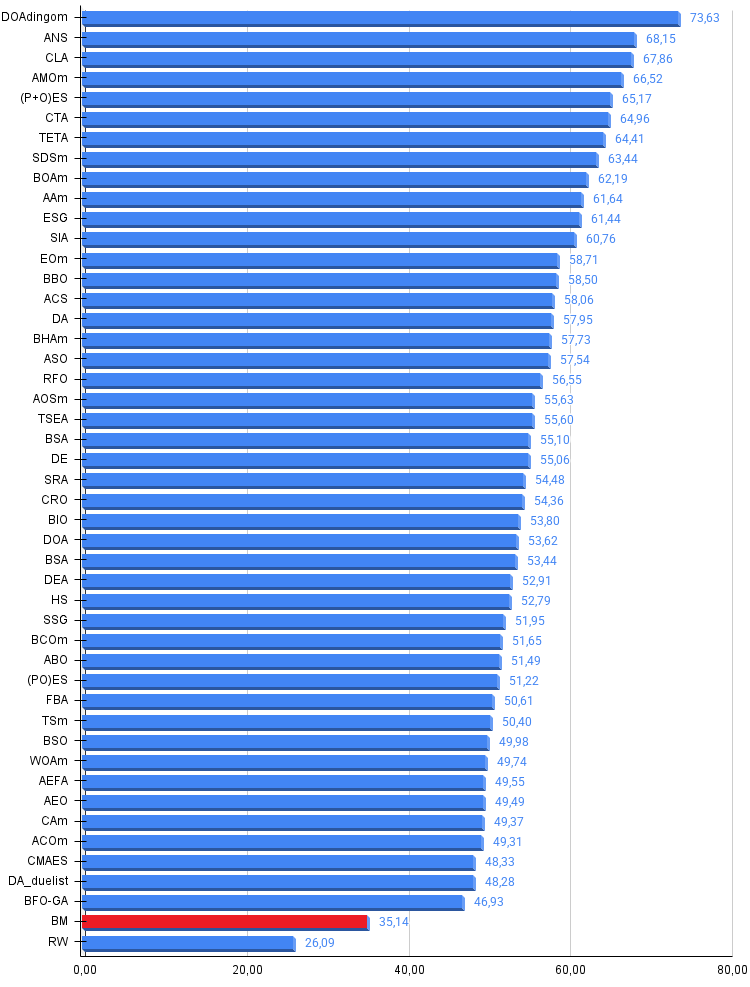
Figura 3. Histograma de los resultados de las pruebas de los algoritmos (en una escala de 0 a 100; cuanto mayor sea el valor, mejor, donde 100 es el resultado teórico máximo posible; en el archivo se incluye el script para calcular la tabla de clasificación)
Ventajas e inconvenientes del algoritmo BM:
Ventajas:
- Un número reducido de parámetros externos.
Desventajas:
- Baja eficacia en la resolución de problemas, especialmente con funciones discretas.
Se adjunta al artículo un archivo comprimido con las versiones actualizadas de los códigos de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos. En muchos de ellos se han introducido modificaciones para mejorar las capacidades de búsqueda. Las conclusiones y consideraciones que figuran en los artículos se basan en los resultados de los experimentos realizados.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase padre de los algoritmos de optimización poblacional |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de algoritmos de optimización poblacional |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados destinados a la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | Banco de pruebas unificado para todos los algoritmos de optimización poblacional |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Ejemplo sencillo de uso de algoritmos de optimización poblacional sin visualización |
| 9 | Test_AO_BM.mq5 | Script | Banco de pruebas para BM |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19757
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.