

Algoritmo del Bisonte: Bison Algorithm (BIA)
 23
 0

Contenido
Introducción
Con el fin de encontrar un método de optimización más eficaz, este artículo presenta el Algoritmo del Bisonte: Bison Algorithm (BIA), un algoritmo de optimización basada en poblaciones e inspirado en los enjambres, diseñado para resolver problemas de optimización continua con una única función objetivo. Las características clave del BIA son dos principios fundamentales inspirados en el comportamiento del bisonte: la capacidad de moverse de forma dinámica y una estrategia defensiva. El algoritmo fue desarrollado por investigadores checos en 2017 y publicado en la serie Lecture Notes in Computer Science (Springer) en 2019.
Los bisontes son animales increíbles, dotados de una gran resistencia y fuerza. Son capaces de alcanzar una gran velocidad y mantenerla durante media hora. Cuando se ven rodeados por depredadores, suelen formar un círculo, con los individuos más fuertes en el perímetro, mientras que el resto de la manada tiende a desplazarse hacia el interior para ponerse a salvo.
Estos dos patrones de comportamiento se modelaron en el algoritmo del bisonte y se aplicaron como técnica de optimización. El primer aspecto, «velocidad y resistencia», permite a los agentes del algoritmo explorar ampliamente el espacio de búsqueda, descubriendo zonas nuevas y potencialmente óptimas. El segundo aspecto, el «círculo defensivo», simula un mecanismo de búsqueda local y estabilización, en el que los agentes se agrupan en torno a las soluciones más prometedoras, protegiéndolas de un rechazo prematuro y perfeccionando sus posiciones. Ahora veamos cómo funciona esto realmente en el algoritmo.
Implementación del algoritmo
Estás observando una manada de bisontes en la pradera. Tienen que encontrar el mejor pastizal, con hierba abundante y agua limpia. ¡Pero la pradera es enorme! ¿Cómo lo hacen? Dividamos la manada en dos grupos.
La manada principal (el 80 % de los bisontes) está formada por animales cautelosos. Se mantienen juntos y se desplazan lentamente en grupo. «¡La unión hace la fuerza!» es su lema.
Los exploradores (el 20 % de los bisontes) son animales jóvenes y valientes. Corren hacia delante en una sola dirección, explorando nuevos territorios. «¿Qué habrá allí, detrás de la colina?», se preguntan.
Se forman dos grupos: 40 bisontes de la manada principal deambulan por una zona conocida, y 10 corredores se reúnen cerca del bisonte más gordo (¡que sin duda sabe dónde está la zona de pastoreo más rica!) y se preparan para la carrera. Cuando un bisonte de la manada principal se desplaza a una nueva posición, primero recuerda dónde estaba. Da varios pasos (de 0 a 3,5 metros). Después prueba la hierba. Si la nueva hierba es peor, vuelve atrás. «Más vale pájaro en mano que ciento volando». Si el corredor-explorador encuentra un lugar mejor que el del bisonte que ocupa el peor puesto de la manada, entonces intercambian sus puestos. Los corredores cambian ligeramente de dirección cada día (un 10 % hacia la izquierda o hacia la derecha). Esto aumenta las posibilidades de descubrir algo nuevo. Cuando una manada se reúne en torno al mejor bisonte, no se limita a agruparse en torno al centro. El líder (el más gordo) tiene un «peso» de 100, el segundo, de 90, el tercero, de 80... y el décimo, de 10.
Ahora imagínate esto:
- Pastizal = espacio de búsqueda de soluciones
- Calidad de la hierba = valor de la función objetivo
- Posición del bisonte = solución potencial
- El mejor pastizal = la solución óptima
El siguiente diagrama muestra la fase de inicialización: la división de la población en un grupo del enjambre (80 %) y un grupo de corredores (20 %). El bucle principal de iteración consta de cuatro pasos: determinación del punto objetivo del enjambre (elección entre el mejor corredor y el centro de élite), desplazamiento del grupo del enjambre hacia el centro (cálculo de la media ponderada del centro de élite), desplazamiento de los corredores en la dirección de exploración, comprobación y actualización de los resultados.
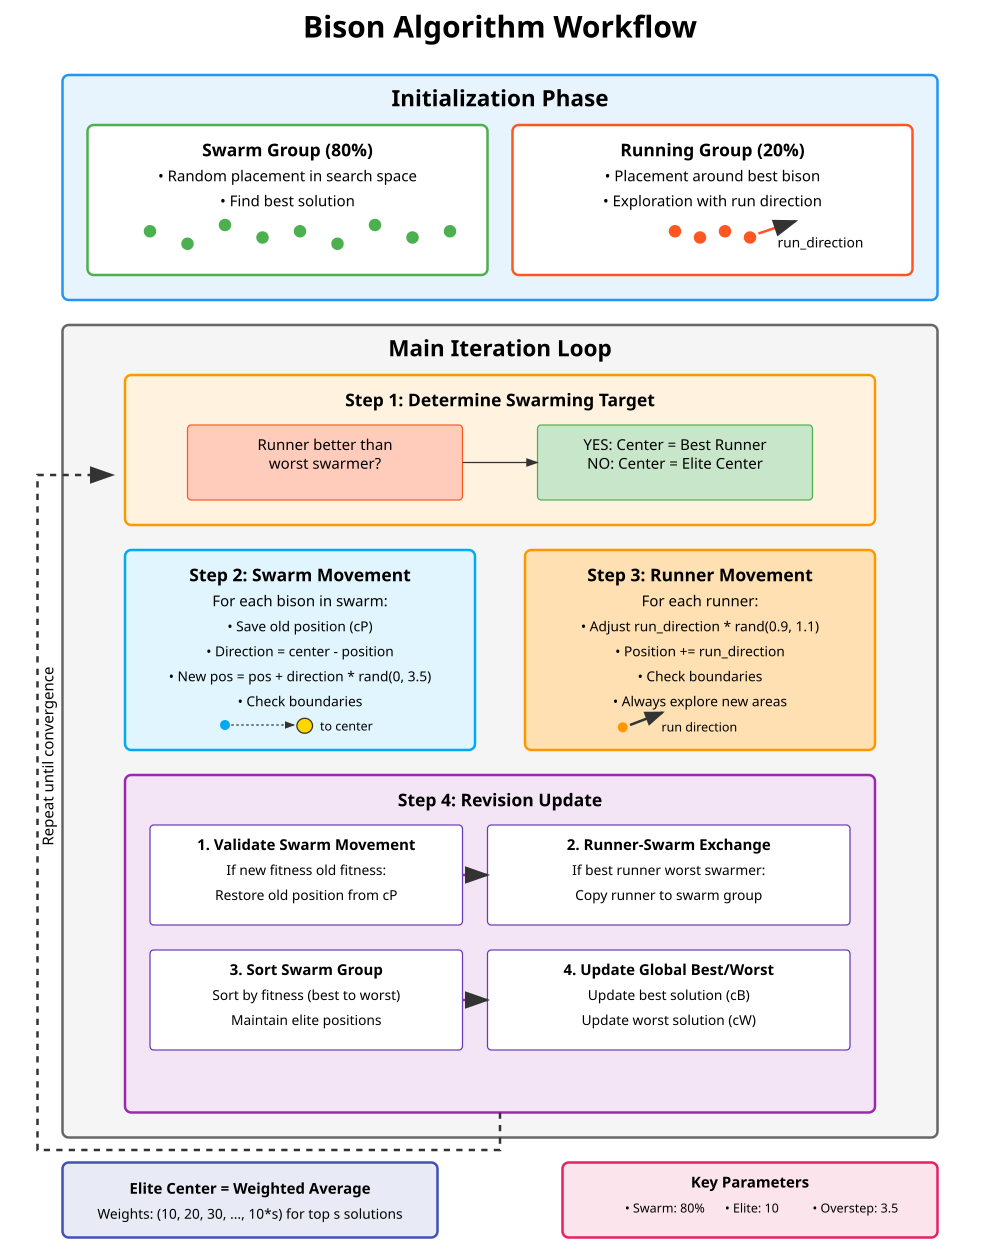
Figura 1. Flujo de trabajo del algoritmo BIA
Parámetros clave del algoritmo. Esquema de colores: verde: grupo del enjambre; naranja: grupo de corredores; morado: fase de comprobación y actualización; azul: movimiento del enjambre. Las flechas indican el flujo de ejecución y las direcciones de movimiento de los grupos.
Empecemos a escribir un pseudocódigo para el algoritmo BIA.
INICIALIZACIÓN:
1. Crear una población de N bisontes
2. Dividir en grupos:
- Grupo del enjambre (80 %): Distribuir los bisontes aleatoriamente por todo el espacio
- Grupo de corredores (20 %): Situar los bisontes alrededor del mejor bisonte del grupo del enjambre
3. Establecer una dirección de carrera aleatoria para los exploradores
CICLO PRINCIPAL (repetir hasta la convergencia):
SELECCIÓN DEL OBJETIVO DE MOVIMIENTO:
- SI el mejor individuo del grupo de corredores ha encontrado un lugar mejor que el del peor individuo de la manada:
Objetivo = posición del mejor individuo del grupo de corredores
- EN CASO CONTRARIO:
Objetivo = centro ponderado de los 10 mejores individuos de la manada
MOVIMIENTO DEL GRUPO DEL ENJAMBRE:
- Para cada bisonte de la manada:
1. Guardar la posición actual
2. Calcular la dirección hacia el objetivo
3. Dar un paso hacia el objetivo (longitud aleatoria entre 0 y 3,5)
4. Comprobar los límites del área de búsqueda
MOVIMIENTO DEL GRUPO EN CARRERA:
- Cambiar ligeramente la dirección de carrera (×0.9-1.1)
- Para cada individuo:
1. Desplazarse en la dirección de carrera
2. Comprobar los límites del área de búsqueda
EVALUACIÓN Y ACTUALIZACIÓN:
1. Comprobar el grupo del enjambre:
- SI la nueva posición es peor que la anterior:
Volver a la posición anterior
2. Intercambio entre grupos:
- SI el mejor individuo de un grupo de corredores es mejor que el peor de la manada:
Sustituir al peor de la manada por el mejor individuo
3. Ordenación:
- Ordenar el grupo del enjambre por calidad
4. Actualización:
- Guardar la mejor solución encontrada
- Guardar la peor solución
FIN DEL CICLO
CÁLCULO DEL CENTRO PONDERADO:
- Seleccionar las 10 mejores soluciones
- Asignar pesos: la 1.ª recibe un peso de 100, la 2.ª, 90, ..., la 10.ª, 10
- Centro = suma(posición × peso) / suma(pesos)
Ahora que entendemos mejor cómo funciona todo, podemos empezar a escribir el código del algoritmo. La clase implementa el algoritmo del bisonte (BIA) y especifica que hereda de la clase base C_AO.
Parámetros del algoritmo:- popSize: define el número total de «individuos» o «agentes» de la población que participan en el algoritmo.
- swarmGroupRate: especifica la proporción (en porcentaje) del número total de individuos que formarán el «grupo del enjambre».
- eliteGroupSize: define el número de los mejores individuos que forman el «grupo de élite» para calcular el centro.
- overstep: establece el paso máximo que puede dar un grupo del enjambre al desplazarse.
El constructor establece los valores por defecto para todos los parámetros. El método SetParams permite actualizar los valores de los parámetros del algoritmo utilizando datos procedentes de una fuente externa (representada por la matriz «params»).
Funcionalidad:
- Init: método para inicializar el algoritmo utilizando rangos de valores para los parámetros.
- Moving: método encargado del desplazamiento o la actualización del estado de los individuos de una población.
- Revision: método utilizado para revisar y ajustar el comportamiento de individuos o parámetros.
- ComputeCenter: método privado para calcular el centro de un grupo de élite.
- CheckIfRunnerBetter: método privado que comprueba si algún corredor es mejor que los demás.
- swarmGroupSize: se calcula a partir de popSize y swarmGroupRate, y determina el número real de individuos del grupo del enjambre.
- runningGroupSize — tamaño del grupo de corredores (un subgrupo de la población total).
- runDirection — matriz que almacena la dirección de movimiento de cada individuo.
- center — matriz que almacena las coordenadas del centro del grupo de élite.
En general, la clase C_AO_BisonAlgorithm es un bloque que implementa una estrategia de búsqueda basada en los conceptos de población, enjambre y grupos de élite, y cuenta con parámetros configurables.
class C_AO_BisonAlgorithm : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_BisonAlgorithm () { }
  C_AO_BisonAlgorithm ()
  {
    ao_name = "BIA";
    ao_desc = "Bison Algorithm";
    ao_link = "https://www.mql5.com/en/articles/19444";

    popSize          = 50;    // population size
    swarmGroupRate   = 0.8;   // share of swarm group from population (80%)
    eliteGroupSize   = 10;    // size of the elite group for calculating the center (s parameter)
    overstep         = 3.5;   // maximum step of the swarm group

    ArrayResize (params, 4);

    params [0].name = "popSize";        params [0].val = popSize;
    params [1].name = "swarmGroupRate"; params [1].val = swarmGroupRate;
    params [2].name = "eliteGroupSize"; params [2].val = eliteGroupSize;
    params [3].name = "overstep";       params [3].val = overstep;
  }

  void SetParams ()
  {
    popSize        = (int)params [0].val;
    swarmGroupRate = params      [1].val;
    eliteGroupSize = (int)params [2].val;
    overstep       = params      [3].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  private:
  void ComputeCenter ();
  bool CheckIfRunnerBetter ();

  //------------------------------------------------------------------
  public:
  double swarmGroupRate;     // share of swarm group
  int    eliteGroupSize;     // size of the elite group (s parameter)
  double overstep;           // maximum step of the swarm group

  private: //---------------------------------------------------------
  int    swarmGroupSize;     // swarm group size
  int    runningGroupSize;   // running group size
  double runDirection [];    // running direction
  double center [];          // elite group center
};
//————————————————————————————————————————————————————————————————————
El método `Init` de la clase `C_AO_BisonAlgorithm` se encarga de la configuración inicial del algoritmo antes de que comience a ejecutarse. En primer lugar, el método intenta realizar la parte común y estandarizada de la inicialización, utilizando los rangos de valores de los parámetros y el número de épocas que recibe. Si esta parte estándar falla, se interrumpe todo el proceso de inicialización. A continuación, a partir del tamaño total de la población y del coeficiente dado, se calcula el número de individuos que formarán parte del «grupo del enjambre». Los individuos restantes forman un «grupo de corredores».
Para garantizar el correcto funcionamiento del algoritmo, se comprueban los tamaños de estos grupos. Se garantiza que el grupo del enjambre siempre contará con al menos un miembro y que no abarcará toda la población (dejando espacio para el grupo de corredores). Del mismo modo, se comprueba que el grupo de élite tenga al menos un individuo y que su tamaño no supere el del grupo del enjambre, del que es un subconjunto.
Se asigna memoria para las matrices auxiliares. Tanto la matriz utilizada para almacenar la dirección de movimiento de los individuos (para cada dimensión del espacio de búsqueda) como la matriz utilizada para almacenar las coordenadas del centro del grupo de élite se redimensionan para que se ajusten al número de dimensiones definidas en el sistema. Si todos los pasos anteriores se han completado correctamente, el método devuelve «true» y el algoritmo está listo para funcionar.
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_BisonAlgorithm::Init (const double &rangeMinP  [],
                                const double &rangeMaxP  [],
                                const double &rangeStepP [],
                                const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Calculate the sizes of groups
  swarmGroupSize   = (int)MathFloor (popSize * swarmGroupRate);
  runningGroupSize = popSize - swarmGroupSize;

  // Adjust group sizes
  if (swarmGroupSize < 1) swarmGroupSize = 1;
  if (swarmGroupSize >= popSize) swarmGroupSize = popSize - 1;
  if (eliteGroupSize < 1) eliteGroupSize = 1;
  if (eliteGroupSize > swarmGroupSize) eliteGroupSize = swarmGroupSize;

  // Initialize auxiliary arrays
  ArrayResize (runDirection, coords);
  ArrayResize (center, coords);

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «Moving» de la clase «C_AO_BisonAlgorithm» constituye el núcleo del algoritmo y se encarga de una iteración o paso de la evolución de la población. Consta de dos fases principales: la inicialización de la población (si el algoritmo se ejecuta por primera vez) y los pasos posteriores de actualización de las posiciones de los individuos.
Fase 1: Inicialización (primera ejecución): Si el algoritmo se ejecuta por primera vez (el indicador «revision» está establecido en «false»), se lleva a cabo la siguiente secuencia de acciones:
- Generación del grupo del enjambre. Los individuos incluidos en el grupo del enjambre se inicializan con valores aleatorios dentro de los rangos especificados para cada parámetro. Una vez generados, estos valores pueden ajustarse de nuevo para respetar el paso de discretización de los parámetros.
- Búsqueda del mejor bisonte. Entre todos los individuos de un grupo del enjambre, hay uno que presenta la mejor aptitud (el valor más alto de la función objetivo).
- Generación del grupo de corredores. Los individuos restantes de la población (el grupo de corredores) se inicializan en torno al mejor bisonte encontrado. Sus posiciones se generan aleatoriamente en un entorno de la mejor solución y, a continuación, se ajustan también de acuerdo con los rangos y los pasos de discretización de los parámetros.
- Inicialización del vector de dirección del movimiento. Para cada dimensión del espacio de búsqueda, se genera un vector de dirección del movimiento aleatorio. La magnitud de este vector depende del rango global de valores de los parámetros, y su signo (positivo o negativo) también se elige al azar.
- Establecimiento del indicador de inicialización. El indicador «revision» se establece en «true», la inicialización ha finalizado y, a partir de ahora, solo se llevarán a cabo pasos de actualización.
Fase 2: Ciclo de iteración principal (pasos siguientes): Una vez realizada la inicialización, el método lleva a cabo los siguientes pasos en cada iteración:
Determinación del punto objetivo del enjambre. El algoritmo comprueba si alguna solución del grupo de corredores es mejor que el «punto objetivo del enjambre» actual.- Si la solución del grupo de corredores resulta ser mejor, el punto objetivo del enjambre (centroide) se hace coincidir con esa solución.
- De lo contrario, se calcula un nuevo centroide, que representa el centro ponderado de las mejores soluciones de la población.
- En primer lugar, se guardan las posiciones actuales y los valores de aptitud del individuo.
- A continuación, se calcula la nueva posición desplazándose desde la posición actual hacia el punto objetivo del enjambre. La magnitud de este movimiento viene determinada por un factor aleatorio que regula cuánto se sobrepasa el punto objetivo.
- A continuación, la nueva posición resultante se ajusta para mantenerse dentro de los rangos permitidos y tener en cuenta el paso de discretización del parámetro.
Corrección del vector de dirección del movimiento. El vector de dirección que utiliza el grupo de corredores varía ligeramente de forma aleatoria. Esto aporta cierta variedad a los movimientos de los corredores.
Movimiento del grupo de corredores. Cada individuo del grupo de corredores se desplaza utilizando el vector de dirección ajustado.
- La nueva posición se calcula sumando el vector de dirección a la posición actual.
- A continuación, esta nueva posición se ajusta para mantenerse dentro de los rangos aceptables y tener en cuenta el paso de discretización del parámetro.
Así pues, el método «Moving» modela el comportamiento de un grupo de individuos: una parte del grupo (el enjambre) se desplaza hacia un objetivo común, respondiendo a las mejores soluciones, mientras que la otra parte (el grupo de corredores) sigue el vector de dirección ajustado, que también puede cambiar.
/————————————————————————————————————————————————————————————————————
//--- Main step of the algorithm
void C_AO_BisonAlgorithm::Moving ()
{
  // Starting initialization of the population
  if (!revision)
  {
    // Generate a swarm group randomly
    for (int i = 0; i < swarmGroupSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    // Find the best solution among the swarm group to initialize the runners
    int bestIdx = 0;
    double bestFit = a [0].f;
    for (int i = 1; i < swarmGroupSize; i++)
    {
      if (a [i].f > bestFit)
      {
        bestFit = a [i].f;
        bestIdx = i;
      }
    }

    // Generate a running group around the best bison
    double neighbourhood = (rangeMax [0] - rangeMin [0]) / 15.0;
    for (int i = swarmGroupSize; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = a [bestIdx].c [j] + u.RNDfromCI (-neighbourhood, neighbourhood);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    // Generate run direction = random((ub-lb)/45, (ub-lb)/15)
    for (int j = 0; j < coords; j++)
    {
      double range = rangeMax [j] - rangeMin [j];
      runDirection [j] = u.RNDfromCI (range / 45.0, range / 15.0);
      if (u.RNDprobab () < 0.5) runDirection [j] = -runDirection [j];
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Main iteration loop

  // 1. Define swarming target
  if (CheckIfRunnerBetter ())
  {
    // If runner is better than swarmer, center = runner
    // center is already set in CheckIfRunnerBetter
  }
  else
  {
    // Otherwise, calculate the center of the strongest solutions
    ComputeCenter ();
  }

  // 2. Swarm group movement
  for (int i = 0; i < swarmGroupSize; i++)
  {
    // Save old positions in cP and fitness in fP
    ArrayCopy (a [i].cP, a [i].c, 0, 0, coords);
    a [i].fP = a [i].f;

    // Calculate a new candidate for the position
    for (int c = 0; c < coords; c++)
    {
      double direction = center [c] - a [i].c [c];
      a [i].c [c] = a [i].c [c] + direction * u.RNDfromCI (0.0, overstep);
      a [i].c [c] = u.SeInDiSp (a [i].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }

  // 3. Correction of the vector 'run direction'
  for (int j = 0; j < coords; j++)
  {
    runDirection [j] = runDirection [j] * u.RNDfromCI (0.9, 1.1);
  }

  // 4. Running group movement
  for (int i = swarmGroupSize; i < popSize; i++)
  {
    for (int c = 0; c < coords; c++)
    {
      a [i].c [c] = a [i].c [c] + runDirection [c];
      a [i].c [c] = u.SeInDiSp (a [i].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «Revision» de la clase C_AO_BisonAlgorithm está destinado a actualizar el estado de la población tras completar un paso de movimiento y evaluar la aptitud de los individuos, así como a resumir los resultados de la iteración.
Corrección del grupo del enjambre. Para cada individuo del grupo del enjambre, se comprueba si su nueva posición (calculada en el paso anterior) es mejor que su posición anterior (guardada). Si la nueva posición es peor, el individuo vuelve a su posición anterior, que era mejor. De este modo, los individuos del grupo del enjambre no empeoran sus resultados.
Comparación entre el grupo de corredores y el grupo del enjambre:
- El mejor individuo del grupo de corredores (con la mayor aptitud) y el peor individuo del grupo del enjambre (con la menor aptitud).
- Si el mejor individuo del grupo de corredores resulta ser mejor que el peor individuo del grupo del enjambre, el peor individuo del grupo del enjambre se sustituye por el mejor individuo del grupo de corredores. Esto permite que las mejores soluciones del grupo de corredores pasen a formar parte del grupo del enjambre.
- Se crea una copia temporal de todos los individuos del grupo del enjambre.
- Esta copia temporal se ordena por aptitud en orden descendente (de mejor a peor).
- Tras la ordenación, los individuos de la copia temporal ordenada se vuelven a copiar en la población general. Esto garantiza que el grupo del enjambre contenga siempre las mejores soluciones encontradas hasta el momento.
- Mejor solución global. La aptitud del mejor individuo del grupo del enjambre (que ahora es la mejor solución tras la ordenación) se compara con la de la mejor solución global actual. Si el mejor individuo del grupo del enjambre es mejor, se actualiza la mejor solución global.
- Peor solución global. A continuación, se examinan todos los individuos de la población (tanto los del grupo del enjambre como los del grupo de corredores) para encontrar al de menor aptitud. Si se encuentra un individuo con un valor de aptitud inferior al de la peor solución global actual, se actualiza dicha solución.
Por lo tanto, el método Revision constituye la fase de procesamiento de resultados que selecciona las mejores soluciones, mantiene el orden y actualiza el grupo del enjambre, y realiza un seguimiento del progreso general del algoritmo, almacenando las mejores y peores soluciones encontradas.
//————————————————————————————————————————————————————————————————————
//--- Update and check results
void C_AO_BisonAlgorithm::Revision ()
{
  // 1. For a swarm group: update positions only if the new position is better
  for (int i = 0; i < swarmGroupSize; i++)
  {
    // If the new position is worse than the old one, return the old one
    if (a [i].f < a [i].fP)
    {
      ArrayCopy (a [i].c, a [i].cP, 0, 0, coords);
      a [i].f = a [i].fP;
    }
  }

  // 2. Let's check if runner has found a better solution than swarmer
  double bestRunnerFitness = -DBL_MAX;
  int bestRunnerIdx = -1;
  double worstSwarmerFitness = DBL_MAX;
  int worstSwarmerIdx = -1;

  for (int i = swarmGroupSize; i < popSize; i++)
  {
    if (a[i].f > bestRunnerFitness)
    {
      bestRunnerFitness = a[i].f;
      bestRunnerIdx = i;
    }
  }

  for (int i = 0; i < swarmGroupSize; i++)
  {
    if (a[i].f < worstSwarmerFitness)
    {
      worstSwarmerFitness = a[i].f;
      worstSwarmerIdx = i;
    }
  }

  // If the runner is better than the worst swarmer, copy the runner to the swarming group
  if (bestRunnerIdx >= 0 && worstSwarmerIdx >= 0 && bestRunnerFitness > worstSwarmerFitness)
  {
    ArrayCopy (a[worstSwarmerIdx].c, a[bestRunnerIdx].c, 0, 0, coords);
    a[worstSwarmerIdx].f = a[bestRunnerIdx].f;
  }

  // 3. Sort the swarm group
  // Create a temporary array to sort only the swarm group
  S_AO_Agent swarmTemp [];
  ArrayResize (swarmTemp, swarmGroupSize);

  // Copy the swarm group
  for (int i = 0; i < swarmGroupSize; i++)
  {
    swarmTemp[i].Init(coords);
    ArrayCopy (swarmTemp[i].c, a[i].c, 0, 0, coords);
    swarmTemp[i].f = a[i].f;
    ArrayCopy (swarmTemp[i].cP, a[i].cP, 0, 0, coords);
    swarmTemp[i].fP = a[i].fP;
  }

  // Sort
  S_AO_Agent tempSorted [];
  ArrayResize (tempSorted, swarmGroupSize);
  u.Sorting (swarmTemp, tempSorted, swarmGroupSize);

  // Copy the swarm group sorted back
  for (int i = 0; i < swarmGroupSize; i++)
  {
    ArrayCopy (a[i].c, swarmTemp[i].c, 0, 0, coords);
    a[i].f = swarmTemp[i].f;
    ArrayCopy (a[i].cP, swarmTemp[i].cP, 0, 0, coords);
    a[i].fP = swarmTemp[i].fP;
  }

  // 4. Update the global best and worst case solution
  if (a[0].f > fB)
  {
    fB = a[0].f;
    ArrayCopy (cB, a[0].c, 0, 0, WHOLE_ARRAY);
  }

  // Find the worst in the entire population
  for (int i = 0; i < popSize; i++)
  {
    if (a[i].f < fW)
    {
      fW = a[i].f;
      ArrayCopy (cW, a[i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método CheckIfRunnerBetter se utiliza para determinar si el grupo de corredores contiene una solución más prometedora que las presentes en el grupo del enjambre. Si se encuentra una solución de este tipo, se convierte en un nuevo punto objetivo del enjambre.
Búsqueda del mejor «corredor». El método examina primero a todos los individuos que pertenecen al «grupo de corredores» (que no forman parte del enjambre). Identifica al individuo con la mejor aptitud (el valor más alto de la función objetivo) entre todos los corredores y almacena su índice y su valor de aptitud.
Búsqueda del peor individuo del «enjambre». A continuación, el método analiza a los individuos que componen el «grupo del enjambre». Encuentra al individuo con la aptitud más baja (el valor más bajo de la función objetivo) del enjambre.
Comparación y determinación del punto objetivo. A continuación, se lleva a cabo una comparación:
- Si el mejor corredor tiene una aptitud superior a la del peor individuo del enjambre, esto significa que el grupo de corredores ha encontrado, efectivamente, una solución mejor.
- En este caso, la posición (coordenadas) del mejor «corredor» se asigna a una variable que representa el «centro» o el «punto objetivo del enjambre». El método devuelve un valor que indica que el punto objetivo del enjambre se ha actualizado.
Devolución del resultado:
- Si el mejor «corredor» es mejor que el peor individuo del «enjambre», el método lo indica devolviendo un valor afirmativo.
- De lo contrario (si ningún «corredor» ha superado al peor individuo del «enjambre»), el método lo indica devolviendo un valor negativo, y el centro del enjambre permanece igual.
Este método permite, por tanto, cambios dinámicos en la dirección de la búsqueda: si surgen soluciones mejores en el grupo de corredores «exploratorio», estas sirven de guía para el grupo del enjambre «social».
//————————————————————————————————————————————————————————————————————
//--- Check whether a runner is better than a swarmer
bool C_AO_BisonAlgorithm::CheckIfRunnerBetter ()
{
  // Find the best runner
  double bestRunnerFitness = -DBL_MAX;
  int bestRunnerIdx = -1;

  for (int i = swarmGroupSize; i < popSize; i++)
  {
    if (a[i].f > bestRunnerFitness)
    {
      bestRunnerFitness = a[i].f;
      bestRunnerIdx = i;
    }
  }

  // Find the worst swarmer
  double worstSwarmerFitness = DBL_MAX;

  for (int i = 0; i < swarmGroupSize; i++)
  {
    if (a[i].f < worstSwarmerFitness)
    {
      worstSwarmerFitness = a[i].f;
    }
  }

  // If the runner is better than the swarmer, set it as the center
  if (bestRunnerIdx >= 0 && bestRunnerFitness > worstSwarmerFitness)
  {
    ArrayCopy (center, a[bestRunnerIdx].c, 0, 0, coords);
    return true;
  }

  return false;
}
//————————————————————————————————————————————————————————————————————
El método ComputeCenter calcula una nueva posición «objetivo» (centro) para el grupo del enjambre basándose en las mejores soluciones encontradas. Así es como funciona:
- Restablecimiento de la posición objetivo. En primer lugar, todos los componentes de la futura posición objetivo (centro) se restablecen a cero. Esto los prepara para acumular nuevos valores.
- Determinación del número de mejores soluciones. El método determina exactamente cuántas de las mejores soluciones se utilizarán para calcular el centro. Toma el valor mínimo de dos parámetros:
- eliteGroupSize — número máximo de soluciones «de élite» que se pueden tener en cuenta;
- swarmGroupSize — tamaño del grupo del enjambre actual;
- Esto garantiza que utilicemos todas las soluciones de élite proporcionadas o, si hay menos soluciones de élite, tantas como haya en el grupo del enjambre.
- Asignación de ponderaciones. Se crea un conjunto de ponderaciones para cada una de las mejores soluciones seleccionadas. Estas ponderaciones aumentan de forma lineal: la primera solución recibe una ponderación menor, la segunda, mayor, y así sucesivamente, hasta la última. Concretamente, las ponderaciones se establecen en 10, 20, 30... hasta s * 10, donde s es el número de mejores soluciones que se tienen en cuenta. Estas ponderaciones indican la importancia que tiene cada solución a la hora de calcular el centro.
- Acumulación de la suma total de las ponderaciones. Se suman todas las ponderaciones calculadas. Esta cantidad total será necesaria para la normalización.
- Suma ponderada de las posiciones. Ahora, para cada dimensión (coordenada) de la posición:
- el valor de la coordenada correspondiente se toma de cada una de las s mejores soluciones;
- este valor de la coordenada se multiplica por la ponderación de la mejor solución correspondiente. Es importante señalar que las ponderaciones se aplican en orden inverso: la mejor solución (la primera de la lista ordenada) recibe la mayor ponderación, la segunda recibe la siguiente mayor, y así sucesivamente.
- los resultados de estas multiplicaciones para las s mejores soluciones se suman para una coordenada determinada.
- Normalización. La suma resultante de las coordenadas ponderadas para cada dimensión se divide entre la suma total de todas las ponderaciones. Esto hace que el cálculo sea una «media ponderada», lo que garantiza que la posición final del centro se sitúe en una zona «intermedia» de las mejores soluciones encontradas, de modo que las soluciones de mayor calidad tengan una mayor influencia.
Como resultado, el método ComputeCenter crea una nueva posición «objetivo», que es una especie de «media» de las mejores soluciones, pero con preferencia por aquellas de mayor calidad, lo que ayuda a orientar la búsqueda posterior del enjambre.
//————————————————————————————————————————————————————————————————————
//--- Calculate the center of the elite group
void C_AO_BisonAlgorithm::ComputeCenter ()
{
  // Reset the center
  for (int j = 0; j < coords; j++)
  {
    center [j] = 0.0;
  }

  // Calculate the weighted center from the s best solutions
  double weights [];
  int s = MathMin(eliteGroupSize, swarmGroupSize);
  ArrayResize (weights, s);
  double totalWeight = 0.0;

  // weight = (10, 20, 30, ..., 10*s)
  for (int i = 0; i < s; i++)
  {
    weights[i] = (i + 1) * 10.0;
    totalWeight += weights[i];
  }

  // center = sum(weight[i] * position[i]) / sum(weights)
  for (int j = 0; j < coords; j++)
  {
    for (int i = 0; i < s; i++)
    {
      center[j] += (weights[s - 1 - i] * a[i].c[j]) / totalWeight;
    }
  }
}
//————————————————————————————————————————————————————————————————————
Resultados de las pruebas
Como podemos ver, los resultados son de nivel medio; en la función discreta Megacity son ligeramente inferiores; el algoritmo tiene más dificultades para resolver problemas de optimización discreta.Bison|algoritmo del bisonte (BIA)|50,0|0,8|10|3,5|
=============================
5 Hilly; Ejecuciones de la función: 10 000; resultado: 0,761847128451914
25 Hilly; Ejecuciones de la función: 10 000; resultado: 0,4002698460741261
500 Hilly; Ejecuciones de la función: 10 000; resultado: 0,25201531651422443
=============================
5 Forest; Ejecuciones de la función: 10 000; resultado: 0,7620992740937584
25 Forest; Ejecuciones de la función: 10 000; resultado: 0,45225292646780135
500 Forest; Ejecuciones de la función: 10 000; resultado: 0,19295587559803248
=============================
5 Megacity; Ejecuciones de la función: 10 000; resultado: 0,48769230769230765
25 Megacity; Ejecuciones de la función: 10 000; resultado: 0,19876923076923075
500 Megacity; Ejecuciones de la función: 10 000; resultado: 0,10058461538461608
=============================
Puntuación total: 3,60849 (40,09 %)
La visualización del rendimiento del algoritmo BIA muestra una dispersión bastante amplia de los resultados, no solo en el caso de las funciones de baja dimensión (líneas verdes), sino también en el de las funciones de dimensión media (líneas azules).
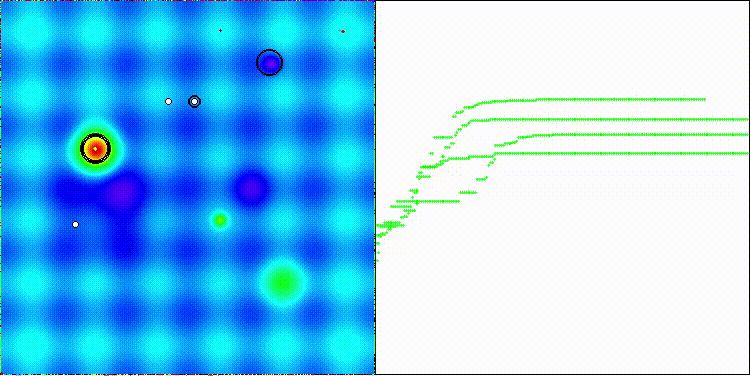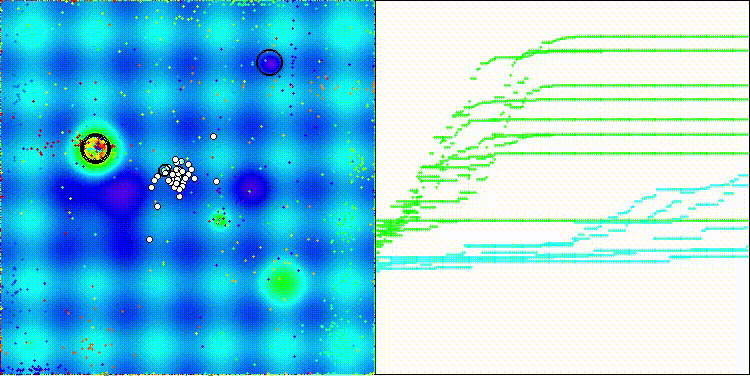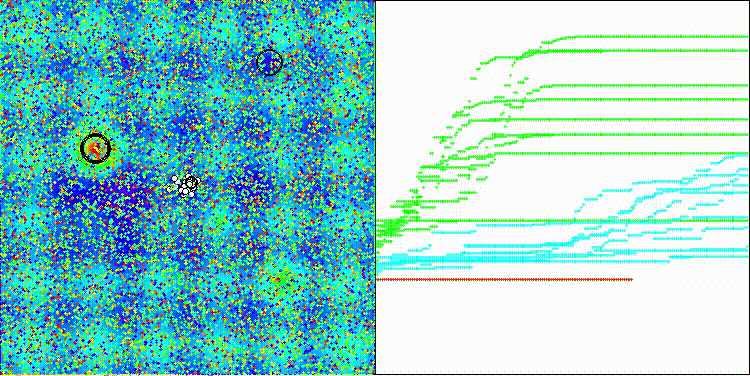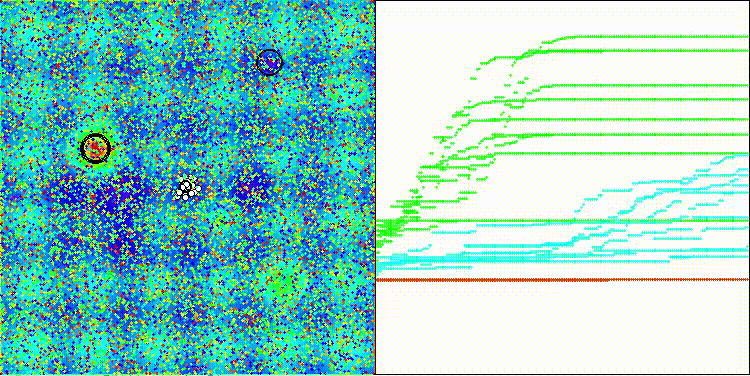
BIA en la función de prueba Hilly
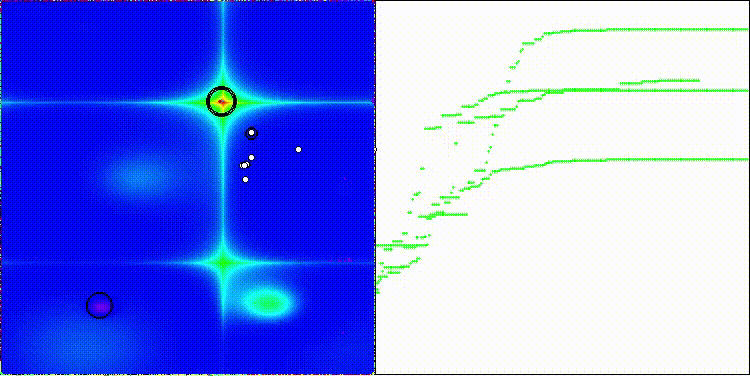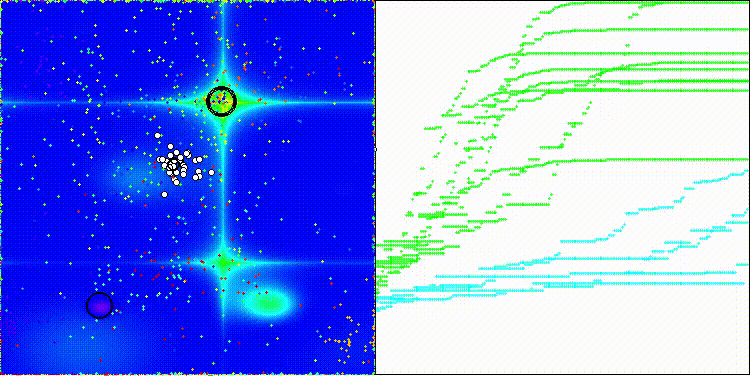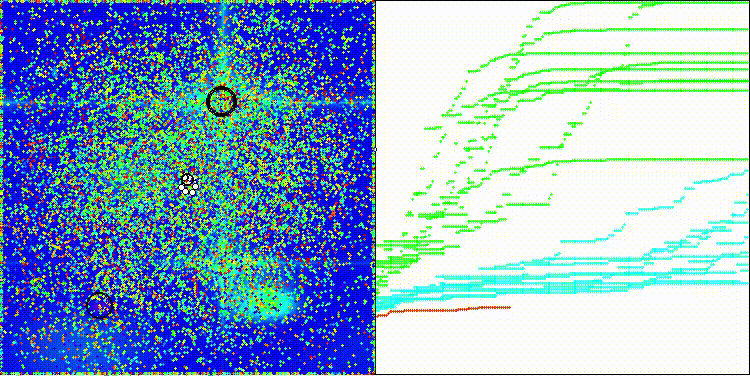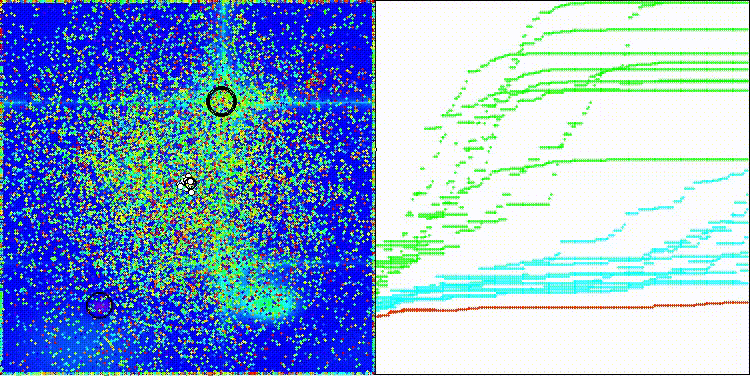
BIA en la función de prueba Forest
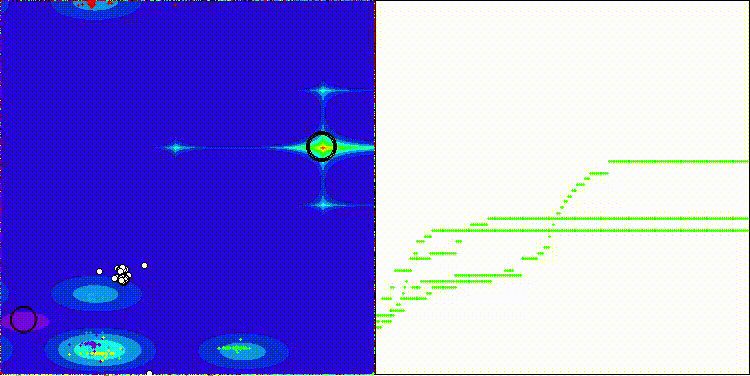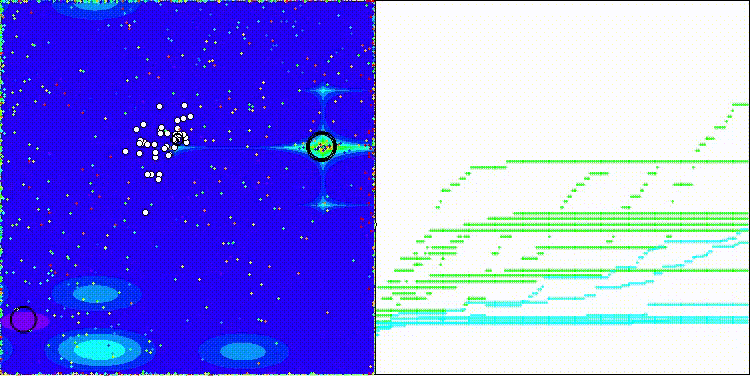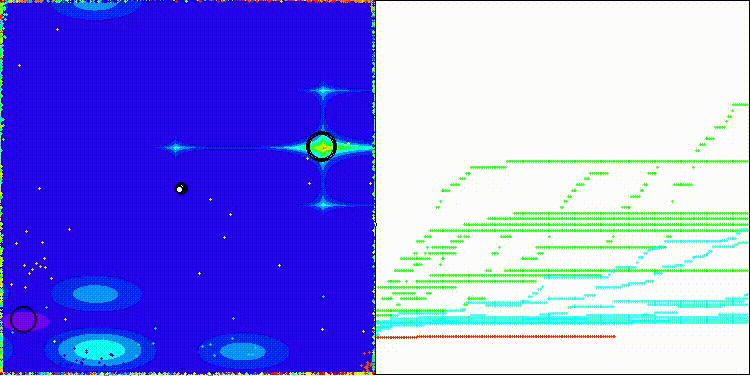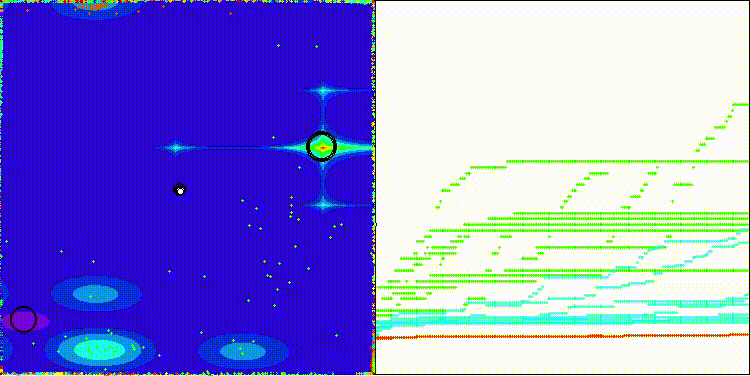
BIA en la función de prueba Megacity
El algoritmo BIA se presenta, a título informativo, en la tabla de clasificación de los métodos de optimización basada en poblaciones.
| # | AO | Descripción | Hilly | Hilly Final | Forest | Forest Final | Megacity (discreta) | Megacity Final | Resultado final | % de MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | DOAdingom | dingo_optimization_algorithm_M | 0,47968 | 0,45367 | 0,46369 | 1,39704 | 0,94145 | 0,87909 | 0,91454 | 2,73508 | 0,78615 | 0,86061 | 0,84805 | 2,49481 | 6,627 | 73,63 |
| 1 | ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 2 | CLA | code lock algorithm (joo) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| 3 | AMOm | animal migration ptimization M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 5 | CTA | comet tail algorithm (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| 6 | TETA | time evolution travel algorithm (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| 7 | SDSm | stochastic diffusion search M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 8 | BOAm | billiards optimization algorithm M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| 9 | AAm | archery algorithm M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| 10 | ESG | evolution of social groups (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| 11 | SIA | simulated isotropic annealing (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 12 | EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| 13 | BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 14 | ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 15 | DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 16 | BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 17 | ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 18 | RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 19 | AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 20 | TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 21 | BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4,959 | 55,10 |
| 22 | DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 23 | SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 24 | CRO | chemical reaction optimization | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| 25 | BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 26 | DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4,825 | 53,62 |
| 27 | BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1.12012 | 4,809 | 53,44 |
| 28 | DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4,762 | 52,91 |
| 29 | HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 30 | SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 31 | BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| 32 | ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 33 | (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| 34 | FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 35 | TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| 36 | BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 37 | WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 38 | AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| 39 | AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 40 | CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 41 | ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 42 | CMAES | covariance_matrix_adaptation_evolution_strategy | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| 43 | DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| 44 | BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| BIA | bison_algorithm | 0,76185 | 0,40027 | 0,25201 | 1,41413 | 0,76210 | 0,45225 | 0,19296 | 1,40731 | 0,48769 | 0,19877 | 0,10058 | 0,78704 | 3,608 | 40,09 | |
| RW | random walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26/09 | |
Resumen
El algoritmo del bisonte (BIA) introduce un concepto interesante de separación entre exploración y explotación, pero en su implementación actual es inferior a las metaheurísticas modernas. El principal valor reside en la idea de una clara separación de funciones, que puede integrarse con éxito en enfoques híbridos.
Los resultados de las pruebas muestran que el algoritmo tiene un rendimiento medio, no alcanza el nivel de las mejores metaheurísticas y presenta dificultades para resolver problemas de optimización discreta. Para entrar en la tabla de clasificación, es necesario introducir mejoras significativas en los mecanismos de movimiento y en la adaptación de los parámetros. El algoritmo puede utilizarse en problemas en los que la sencillez de implementación y la interpretabilidad son importantes, pero no se requiere la máxima precisión.
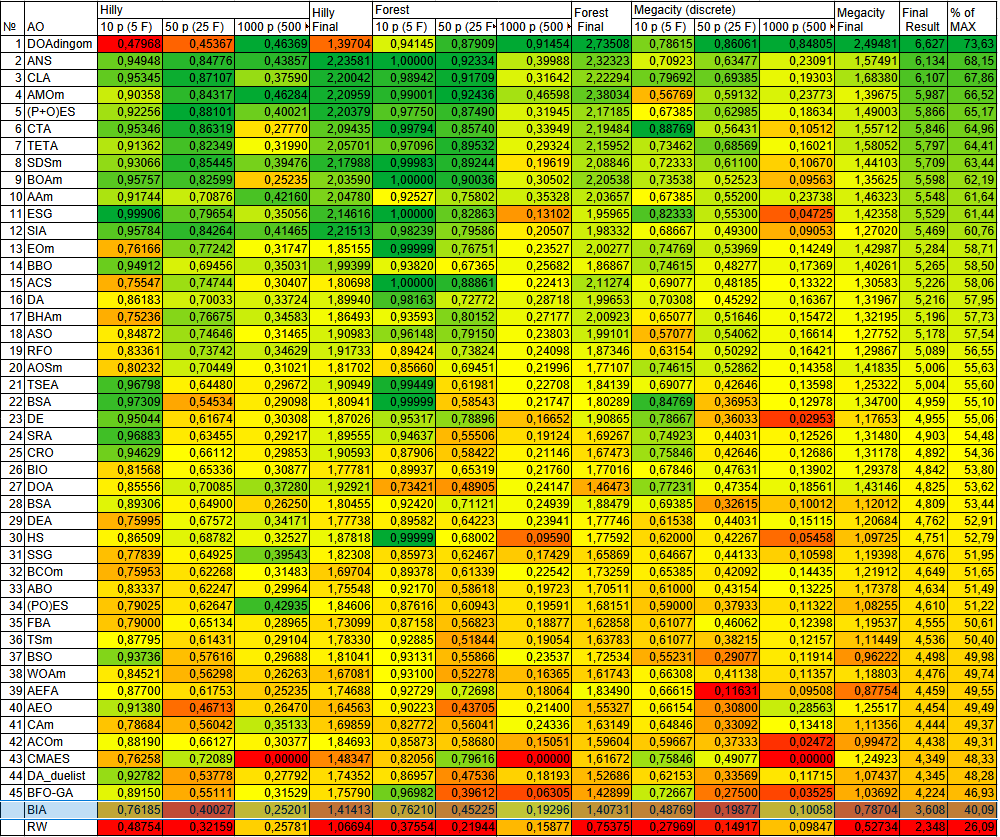
Figura 2. Comparación de algoritmos, codificada por colores, en las pruebas correspondientes
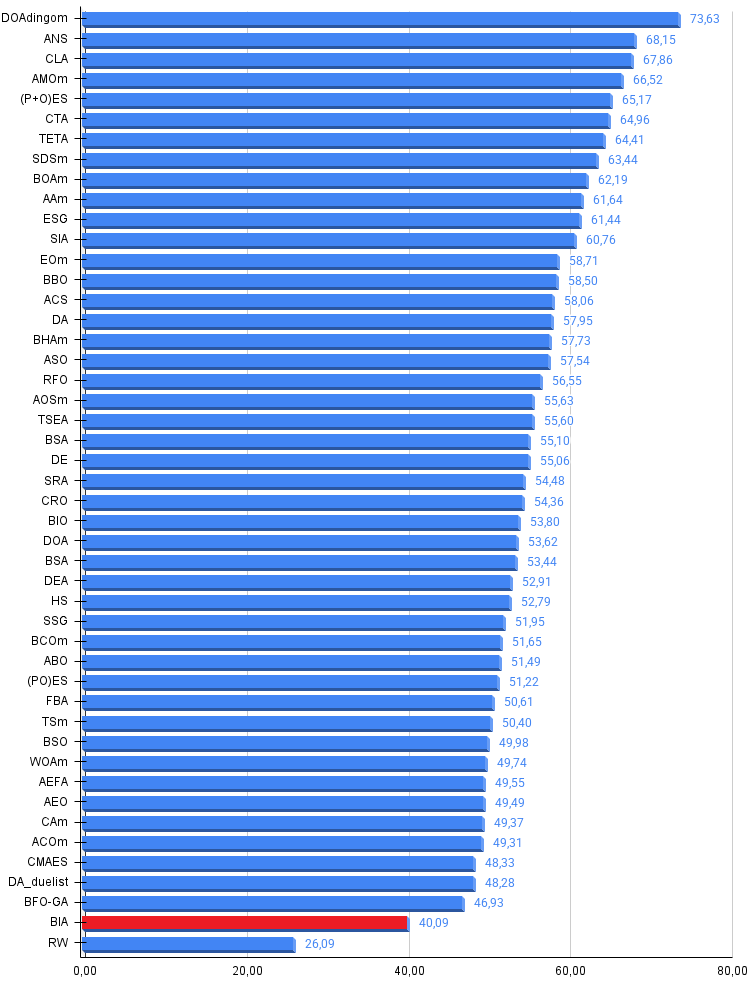
Figura 3. Histograma de los resultados de las pruebas de los algoritmos (escala de 0 a 100; cuanto mayor sea el valor, mejor; 100 es el resultado teórico máximo posible; el archivo incluye un script para calcular la tabla de clasificación)
Ventajas e inconvenientes del BIA:
Ventajas:
- Implementación sencilla.
- Rápido.
Inconvenientes:
- Alta variabilidad en funciones de prueba de baja y media dimensión.
El artículo va acompañado de un archivo con las versiones actuales del código de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos. Se han introducido cambios en muchos de ellos para mejorar su capacidad de búsqueda. Las conclusiones y valoraciones que se presentan en los artículos se basan en los resultados de los experimentos.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase base de los algoritmos de optimización basada en poblaciones |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de los algoritmos de optimización basada en poblaciones |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados de la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | El banco de pruebas unificado para todos los algoritmos de optimización basada en poblaciones |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Un ejemplo sencillo del uso de algoritmos de optimización basada en poblaciones sin visualización |
| 9 | Test_AO_BIA.mq5 | Script | Banco de pruebas de BIA |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19444
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Cómo crear y optimizar un sistema de trading basado en ciclos (Detrended Price Oscillator - DPO)
 Particularidades del trabajo con números del tipo double en MQL4
 Explorador de la biblioteca estándar de MQL5 (Parte 1): Introducción con CTrade, CiMA y CiATR

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso