

Duellanten-Algorithmus
 19
 2

Inhaltsverzeichnis
Einleitung
Beim algorithmischen Handel entscheidet jede Millisekunde über Gewinn oder Verlust, weshalb die Ermittlung der optimalen Parameter für eine Handelsstrategie von entscheidender Bedeutung ist. Moderne Trader setzen auf künstliche Intelligenz und evolutionäre Algorithmen, um ihre Handelssysteme fein abzustimmen.
Heute betrachten wir einen neuen Optimierungsansatz – den Duellanten-Algorithmus –, der von der jahrhundertealten Praxis des Duellierens inspiriert ist. Den Algorithmus entwickelte 2015 eine Gruppe indonesischer Wissenschaftler unter der Leitung von Biyanto als Alternative zu traditionellen evolutionären Algorithmen. Ziel war es, den „blinden“ Charakter der Operatoren für Mutation und Kreuzung durch einen differenzierten Umgang mit Siegern und Verlierern zu minimieren. In diesem Artikel werden wir die mathematischen Grundlagen des Duellanten-Algorithmus im Detail untersuchen, ihn in MQL5 implementieren und eine vergleichende Analyse mit anderen populationsbasierten Optimierungsmethoden durchführen.
Implementierung des Algorithmus
Stellen Sie sich das Börsenparkett als Arena vor, in der verschiedene Strategien ständig miteinander konkurrieren. Manche Strategien sind unter bestimmten Marktbedingungen erfolgreich, während andere scheitern. Aber was macht einen erfolgreichen Trader aus? Die Fähigkeit, sowohl aus den eigenen Erfolgen als auch aus den eigenen Niederlagen zu lernen und die eigene Vorgehensweise ständig anzupassen und zu verfeinern.
Genau dieses Konzept verkörpert der Duellanten-Algorithmus. Im Gegensatz zu klassischen genetischen Algorithmen, bei denen alle Individuen gleich behandelt werden, erkennt der Duellanten-Algorithmus einen grundlegenden Unterschied zwischen Siegern und Verlierern. Verlierer lernen – sie analysieren die Strategien der Sieger und übernehmen deren erfolgreiche Elemente, während Sieger innovieren – sie experimentieren mit neuen Ansätzen, wohl wissend, dass sich ihre Kernstrategie bereits als effizient erwiesen hat. Champions agieren als Mentoren – die besten Strategien werden weitergegeben.
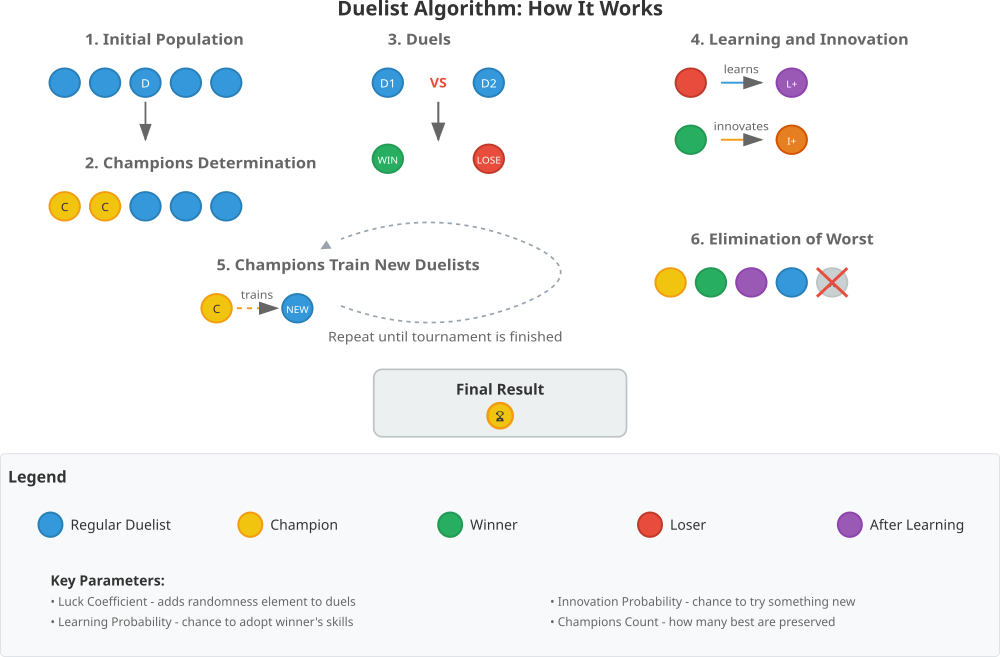
Abbildung 1. Der DA_duelist-Algorithmus in Aktion
Die Darstellung der wichtigsten Phasen des Algorithmus veranschaulicht alle wesentlichen Aspekte des Duellanten-Algorithmus: die Ausgangspopulation – alle Duellanten starten mit gleichen Chancen; die Bestimmung der Champions – die besten Duellanten werden goldfarben hervorgehoben. Duelle – der Ablauf eines Duells mit der Bestimmung eines Siegers und eines Verlierers wird dargestellt. Lernen und Innovation – zwei unterschiedliche Entwicklungswege für Verlierer und Sieger. Training neuer Duellanten, bei dem Champions ihre Fähigkeiten an die nächste Generation weitergeben, sowie Auslese – die schlechtesten Duellanten werden aus der Population entfernt.
Die Abbildung enthält außerdem einen Schleifenpfeil, der den iterativen Charakter des Algorithmus verdeutlicht, das Endergebnis, bei dem der Champion hervorgehoben ist, sowie eine detaillierte Legende, in der alle Elemente und wichtigen Parameter erläutert werden. Die Visualisierung hilft dem Leser, den Kerngedanken des Algorithmus schnell zu erfassen.
Nachdem wir nun eine detaillierte Analyse durchgeführt haben, wollen wir den Pseudocode für den Algorithmus schreiben.
EINGABEN:
- popSize: Größe der Duellantenpopulation
- luckCoefficient: Glückskoeffizient bei Duellen
- learningProbability: Wahrscheinlichkeit, mit der der Verlierer lernt
- innovationProbability: Wahrscheinlichkeit einer Innovation durch den Sieger
- championsCount: Anzahl der Champions
INITIALISIERUNG:
1. Überprüfe championsCount und passe den Wert an:
– Falls < 1, setze den Wert auf 1
– Falls >= popSize, setze den Wert auf popSize / 4
2. Erstelle leere Arrays „winners“ und „losers“
3. Erstelle ein Array namens „champions“ der Größe championsCount
HAUPTZYKLUS (Moving):
WENN erste Iteration:
FÜR jeden Duellanten i von 0 bis popSize:
FÜR jede Koordinate j:
Mit einem Zufallswert innerhalb der zulässigen Grenzen initialisieren
Setze das Flag „revision“ auf true
Beende die Funktion
SONST (nachfolgende Iterationen):
1. ERWEITERUNG DER POPULATION:
– Vergrößere das Array „duelists“ auf die Größe (popSize + championsCount)
– Initialisiere die Strukturen der neuen Duellanten
2. BESTIMMUNG DER CHAMPIONS:
– Sortiere die Duellanten nach Fitness-Wert (Bubble-Sort)
– Die ersten championsCount Duellanten werden zu Champions
3. TRAINING NEUER DUELLANTEN:
FÜR jeden Champion i:
Rufe TrainNewDuelist (i, popSize + i) auf:
FÜR jede Koordinate c:
new_duelist [c] = champion [c] + GaussDistribution ()
Wende die Beschränkungen des Wertebereichs an
4. DURCHFÜHRUNG DER DUELLE:
Leere die Arrays „winners“ und „losers“
FÜR jeden Duellanten i von championsCount bis totalDuelists:
Wähle einen zufälligen „opponent“ aus
WENN opponent != i:
DetermineWinnerAndLoser(i, opponent):
A_Luck = fitness [A] * (luckCoef + random () * luckCoef)
B_Luck = fitness [B] * (luckCoef + random () * luckCoef)
WENN (fitness [A] + A_Luck) >= (fitness [B] + B_Luck):
A – Sieger, B – Verlierer
ANDERNFALLS:
B – Sieger, A – Verlierer
Füge die Sieger und Verlierer den Arrays hinzu
5. VERBESSERUNG:
a) Lernphase für Verlierer:
FÜR jedes Paar (Verlierer, Sieger):
LearningProcess (Verlierer, Sieger):
FÜR jede Koordinate c:
WENN random () < learningProbability:
Verlierer [c] = Sieger [c]
b) Innovationen der Sieger:
FÜR jeden Sieger:
InnovationProcess (Sieger):
FÜR jede Koordinate c:
WENN random () < innovationProbability:
Sieger [c] = random_value_in_range
6. ELIMINIERUNG:
– Alle Duellanten in absteigender Reihenfolge nach „Fitness“ sortieren
– Nur die ersten popSize Duellanten behalten
AKTUALISIERUNG (Revision):
FÜR jeden Duellanten i:
WENN fitness [i] > global_best:
Aktualisiere global_best = fitness [i]
Speichere die Koordinaten der besten Lösung
WIEDERHOLE die Hauptschleife, bis das Abbruchkriterium erreicht ist
Ich möchte die wichtigsten Merkmale dieses Algorithmus hervorheben: Champions nehmen nicht an Duellen teil, sondern trainieren neue Duellanten, und das Element der Zufälligkeit in Form des Glückskoeffizienten macht Duelle unvorhersehbar. Ein differenzierter Ansatz: Verlierer lernen, und Sieger suchen nach innovativen Lösungen. Die Populationsgröße bleibt durch die Eliminierung der leistungsschwächsten Duellanten konstant. Nun können wir zur Implementierung des Codes des DA_duelist-Algorithmus übergehen.
Schreiben wir die Klasse „C_AO_DA_duelist“, die von der Klasse „C_AO“ erbt, ein Parameterarray initialisiert und dessen Elementen Namen und Standardwerte zuweist.
- SetParams () — ändert die Werte interner Variablen (popSize, luckCoefficient usw.) basierend auf den im Array „params“ gespeicherten Werten.
- Init () — Methode zur Initialisierung des Algorithmus . Die Methode akzeptiert Arrays zur Definition von Wertebereichen und Schrittweiten für Parameter sowie die Anzahl der Epochen.
- Moving () — eine Methode, die die Hauptlogik für die Entwicklung der „Duellanten“ enthält (Suche nach optimalen Parametern).
- Revision () — zuständig für die Analyse der Ergebnisse und die Anpassung des Prozesses.
Variablen:
- luckCoefficient — Glückskoeffizient;
- learningProbability — Lernwahrscheinlichkeit;
- innovationProbability — Innovationswahrscheinlichkeit;
- championsCount — Anzahl der Champions;
- winners [] — Array mit den Indizes der siegreichen „Duellanten“;
- losers [] — Array mit den Indizes der „Verlierer“-Duellanten;
- champions [] — Array mit den Indizes der „Champions“.
- Die Funktion „DetermineWinnerAndLoser()“ ermittelt den Sieger und den Verlierer eines „Duells“;
- LearningProcess () implementiert den Lernprozess für den Verlierer mithilfe des Siegers;
- InnovationProcess () implementiert den Innovationsprozess für den Sieger;
- TrainNewDuelist () trainiert einen neuen „Duellanten“ auf Grundlage des Champions.
//————————————————————————————————————————————————————————————————————
class C_AO_DA_duelist : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DA_duelist () { }
  C_AO_DA_duelist ()
  {
    ao_name = "DA";
    ao_desc = "Duelist Algorithm";
    ao_link = "https://www.mql5.com/en/articles/19093";

    popSize               = 50;    // number of duelists
    luckCoefficient       = 0.01;  // luck coefficient
    learningProbability   = 0.2;   // learning probability for losers
    innovationProbability = 0.1;   // probability of innovation for winners
    championsCount        = 5;     // number of champions

    ArrayResize (params, 5);

    params [0].name = "popSize";               params [0].val = popSize;
    params [1].name = "luckCoefficient";       params [1].val = luckCoefficient;
    params [2].name = "learningProbability";   params [2].val = learningProbability;
    params [3].name = "innovationProbability"; params [3].val = innovationProbability;
    params [4].name = "championsCount";        params [4].val = championsCount;
  }

  void SetParams ()
  {
    popSize               = (int)params [0].val;
    luckCoefficient       = params      [1].val;
    learningProbability   = params      [2].val;
    innovationProbability = params      [3].val;
    championsCount        = (int)params [4].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double luckCoefficient;       // luck coefficient
  double learningProbability;   // learning probability
  double innovationProbability; // innovation probability
  int    championsCount;        // number of champions

  private: //---------------------------------------------------------
  int    winners [];            // winners' indices
  int    losers  [];            // losers' indices
  int    champions [];          // champions' indices

  void   DetermineWinnerAndLoser (int duelistA, int duelistB);
  void   LearningProcess         (int loserIndex, int winnerIndex);
  void   InnovationProcess       (int winnerIndex);
  void   TrainNewDuelist         (int championIndex, int newDuelistIndex);
};
//————————————————————————————————————————————————————————————————————
Die Methode „Init“ der Klasse „C_AO_DA_duelist“ dient dazu, den Algorithmus für die Ausführung vorzubereiten. Seine Hauptaufgabe besteht darin, die Anfangsparameter und Datenstrukturen vor Beginn der Ausführung zu initialisieren.
Die Methode beginnt mit dem Aufruf der Standardinitialisierung, die die Wertebereiche und Schrittweiten für die Parameter verarbeitet. Sollte diese Standardinitialisierung fehlschlagen, gibt die Methode „false“ zurück, um anzuzeigen, dass sie nicht fortfahren kann. Die Methode passt dann die Anzahl der Champions an: Ist sie kleiner als eins, wird sie auf eins gesetzt; ist sie größer oder gleich der Populationsgröße, wird sie auf ein Viertel der Gesamtpopulationsgröße reduziert. Die Arrays, in denen die Indizes der Sieger, Verlierer und Champions gespeichert sind, werden anschließend geleert und neu zugewiesen, sodass sie leer und für die nächste Stufe des Algorithmus bereit sind. Am Ende gibt die Methode „true“ zurück, was eine erfolgreiche Initialisierung signalisiert.
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DA_duelist::Init (const double &rangeMinP  [],
                            const double &rangeMaxP  [],
                            const double &rangeStepP [],
                            const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  if (championsCount < 1) championsCount = 1;
  if (championsCount >= popSize) championsCount = popSize / 4;

  ArrayResize (winners, 0);
  ArrayResize (losers,  0);
  ArrayResize (champions, championsCount);

  return true;
}
//————————————————————————————————————————————————————————————————————
Die Methode „DetermineWinnerAndLoser“ der Klasse „C_AO_DA_duelist“ ermittelt den Sieger und den Verlierer in einem Duell zwischen zwei Individuen (Duellanten) der Population. Betrachten wir nun die Reihenfolge der Schritte.
- Berechnung des „Glücks“. Für jeden Duellanten (A und B) wird der Wert „Glück“ (A_Luck und B_Luck) berechnet. Das „Glück“ hängt vom Basiswert f des Duellanten (seiner „Fitness“), vom Koeffizienten „luckCoefficient“ und von einem Zufallselement ab, das mit u.RNDprobab() ermittelt wird. Es wird ein gewisses Maß an Zufälligkeit eingesetzt, um den Einfluss des Glücks zu simulieren.
- Ermittlung des Siegers. Die Summe aus der Fitness f des Duellanten und seinem „Glück“ wird verglichen. Der Duellant mit dem höheren oder zumindest gleich hohen Gesamtwert gilt als Sieger.
- Speichern der Ergebnisse. Die Sieger- und Verliererindizes werden den entsprechenden Arrays „winners“ und „losers“ hinzugefügt. Diese Arrays werden für weitere Analysen und für die Evolution der Population verwendet.
//————————————————————————————————————————————————————————————————————
//--- Determine the winner and loser in a duel
void C_AO_DA_duelist::DetermineWinnerAndLoser (int duelistA, int duelistB)
{
  // Algorithm from the document
  double A_Luck = a [duelistA].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);
  double B_Luck = a [duelistB].f * (luckCoefficient + u.RNDprobab () * luckCoefficient);

  if ((a [duelistA].f + A_Luck) >= (a [duelistB].f + B_Luck))
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistA;
    losers  [ArraySize (losers) - 1] = duelistB;
  }
  else
  {
    ArrayResize (winners, ArraySize (winners) + 1);
    ArrayResize (losers,  ArraySize (losers) + 1);
    winners [ArraySize (winners) - 1] = duelistB;
    losers  [ArraySize (losers) - 1] = duelistA;
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „LearningProcess“ der Klasse „C_AO_DA_duelist“ implementiert einen Lernprozess, bei dem ein Individuum, das ein Duell verliert, vom Sieger „lernt“. Ziel dieses Prozesses ist es, die Leistung des Verlierers zu verbessern, indem ein Teil der Strategie des Siegers auf das verlierende Individuum übertragen wird. Schauen wir uns einmal an, was innerhalb der Methode passiert:
Durchlauf über Koordinaten. Die „for“-Schleife durchläuft alle „Koordinaten“ eines Individuums. Die Anzahl der Koordinaten wird durch die Variable „coords“ festgelegt.
Probabilistisches Kopieren. Innerhalb der Schleife wird mithilfe von u.RNDprobab() eine zufällige Prüfung durchgeführt. Ist die Zufallszahl kleiner als learningProbability, wird die folgende Aktion ausgeführt.
Kopieren von Merkmalen. Ein Verlierer (loserIndex) „übernimmt“ den Wert der Koordinate c vom Sieger (winnerIndex). Das bedeutet, dass das Merkmal des verlierenden Individuums so aktualisiert wird, dass es den Wert des entsprechenden Merkmals des Siegers annimmt. Im Grunde genommen übernimmt der Verlierer einen Teil der Strategie des Siegers.
Letztendlich simuliert diese Methode den Transfer von Wissen oder Strategien von einem erfolgreicheren Individuum auf ein weniger erfolgreiches, was die Grundlage für den evolutionären Prozess bildet.
//————————————————————————————————————————————————————————————————————
//--- A loser learns from a winner
void C_AO_DA_duelist::LearningProcess (int loserIndex, int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < learningProbability)
    {
      // A loser copies part of a winner's strategy
      a [loserIndex].c [c] = a [winnerIndex].c [c];
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „InnovationProcess“ der Klasse „C_AO_DA_duelist“ implementiert den Prozess der „Innovation“ bzw. Mutation für das Individuum, das das Duell gewinnt. Dieser Prozess führt zufällige Änderungen an der Strategie des Siegers ein und erkundet so neue Möglichkeiten.
Durchlauf über Koordinaten. Die „for“-Schleife durchläuft alle „c“-Koordinaten eines Individuums, ähnlich wie bei „LearningProcess“.
Probabilistische Mutation. Wenn die von u.RNDprobab() generierte Zufallszahl kleiner als innovationProbability ist, findet eine Mutation statt. Mit anderen Worten: Ein Individuum versucht, seine Strategie mit einer bestimmten Wahrscheinlichkeit zu ändern, die durch innovationProbability festgelegt wird.
Erzeugung und Korrektur eines neuen Werts. Der Zufallszahlengenerator u.RNDfromCI() erzeugt einen Zufallswert für den Parameter „c“, der im Wertebereich von rangeMin[c] bis rangeMax[c] liegt. Der resultierende Zufallswert wird mithilfe von u.SeInDiSp() angepasst. Diese Funktion dient dazu, einen Wert in eine diskrete Wertemenge mit der Schrittweite rangeStep[c] innerhalb eines vorgegebenen Wertebereichs (rangeMin[c], rangeMax[c]) umzuwandeln.
Dadurch ermöglicht die Methode dem Sieger, mit neuen Strategien zu experimentieren, was potenziell zu verbesserten Eigenschaften des Individuums und seiner Anpassungsfähigkeit an die Umgebung führen kann. Dies ist ein wichtiger Teil des evolutionären Prozesses.
//————————————————————————————————————————————————————————————————————
//--- The innovation process for a winner
void C_AO_DA_duelist::InnovationProcess (int winnerIndex)
{
  for (int c = 0; c < coords; c++)
  {
    if (u.RNDprobab () < innovationProbability)
    {
      // The winner tries a new technique (mutation)
      a [winnerIndex].c [c] = u.RNDfromCI (rangeMin [c], rangeMax [c]);
      a [winnerIndex].c [c] = u.SeInDiSp (a [winnerIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „TrainNewDuelist“ der Klasse „C_AO_DA_duelist“ ist dafür zuständig, einen neuen Duellanten (ein neues Individuum) zu erstellen und seine Ersteinrichtung durch „Training“ auf Basis des aktuellen Champions vorzunehmen. Es handelt sich um einen Vererbungsprozess, der jedoch zufällige Elemente enthält, wodurch genetische Vielfalt in die Population eingebracht werden kann.
Iteration über Koordinaten. Die „for“-Schleife durchläuft alle „c“-Parameter (Koordinaten) des neuen Duellanten (newDuelistIndex) und setzt jeden einzelnen davon.
Berechnung der Abweichung. Es wird die „Abweichung“ berechnet, die den Bereich möglicher Änderungen im Verhältnis zur Spannweite der zulässigen Werte bestimmt.
Vererbung mit Mutation (Gauß-Verteilung). Dem Merkmal „c“ des Champions (championIndex) wird eine zufällige Abweichung hinzugefügt, die mit der Funktion u.GaussDistribution() ermittelt wurde. Diese Funktion generiert eine Zufallszahl aus einer Normalverteilung (Gauß-Verteilung), wodurch zufällige Schwankungen bei den vererbten Merkmalen möglich sind. Die Argumente 0, rangeMin[c], rangeMax[c] und 8 legen die Parameter der Normalverteilung fest: den Mittelwert 0, den Minimal- und den Maximalwert sowie den Parameter, der die Breite der Verteilung bestimmt (8).
Anpassung an das diskrete Raster (SeInDiSp). Der sich nach der Mutation ergebende Wert des Merkmals des neuen Duellanten wird mithilfe der Funktion u.SeInDiSp() in eine diskrete Wertemenge umgewandelt. Diese Funktion stellt sicher, dass die Parameter des neuen Duellanten innerhalb des zulässigen Wertebereichs liegen und der Schrittweite rangeStep[c] entsprechen.
Dadurch erhält der neue Duellant ähnliche Kennwerte wie der Champion, allerdings mit zufälligen Abweichungen, was für Vielfalt in der Population sorgt und die Exploration neuer Strategien ermöglicht.
//————————————————————————————————————————————————————————————————————
//--- A champion trains a new duelist
void C_AO_DA_duelist::TrainNewDuelist (int championIndex, int newDuelistIndex)
{
  for (int c = 0; c < coords; c++)
  {
    // The new duelist inherits the champion's abilities with slight variations
    double deviation = (rangeMax [c] - rangeMin [c]) * 0.1;
    a [newDuelistIndex].c [c] = a [championIndex].c [c] + u.GaussDistribution (0, rangeMin [c], rangeMax [c], 8);
    a [newDuelistIndex].c [c] = u.SeInDiSp (a [newDuelistIndex].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „Moving“ der Klasse „C_AO_DA_duelist“ stellt den Hauptschritt des Evolutionsalgorithmus der Duellanten dar. Dazu gehören Initialisierung (beim ersten Start), Reproduktion, Selektion, Duelle, Training (unter Verwendung der Ergebnisse der Duelle), Innovation und Auslese. Dies ist der Kern des evolutionären Prozesses, der innerhalb der Methode abläuft:
Initialisierung der Population (erster Durchlauf). Wenn es sich um den ersten Durchlauf handelt (revision ist „false“), wird die Population initialisiert: Für jedes Individuum i werden die Werte für alle Merkmale j zufällig gemäß dem zulässigen Wertebereich und der Schrittweite zugewiesen. Nach der Initialisierung wird „revision“ auf „true“ gesetzt, um eine erneute Initialisierung bei nachfolgenden Durchläufen zu vermeiden.
Vorbereitung auf die Reproduktion. Die Größe des Arrays „a“ (das die Population darstellt) wird erhöht, um neue Duellanten aufzunehmen, die von Champions erzeugt wurden. Neue Duellanten werden initialisiert (die Anfangszustände werden festgelegt).
Auswahl der Champions. Die Population wird nach dem Parameter f (Fitness) sortiert, um die besten Individuen auszuwählen. Die Champions werden bestimmt – die championsCount besten Individuen. Jeder Champion verwendet die Methode „TrainNewDuelist“, um einen neuen Duellanten zu erstellen, der die Eigenschaften des Champions erbt.
Vorbereitung auf Duelle. Die Arrays „Sieger“ und „Verlierer“ werden geleert, um sie für neue Duellergebnisse vorzubereiten.
Duelle austragen. Jedes Individuum, mit Ausnahme der Champions, tritt gegen einen zufällig ausgewählten Gegner an (ebenfalls kein Champion). Der Ausgang jedes Duells (wer Sieger ist und wer Verlierer ist) wird mithilfe von „DetermineWinnerAndLoser“ ermittelt.
Training der Duellanten (Lernen). Verlierer lernen von Siegern. „LearningProcess“ ermöglicht es Verlierern, ihre Parameter zu ändern, indem sie die besten Eigenschaften der Sieger übernehmen.
Innovationen der Sieger. Die Sieger nutzen InnovationProcess, um ihre Strategien anzupassen und neue Möglichkeiten auszuloten.
Neusortierung. Die gesamte Population wird erneut nach dem Parameter „f“ sortiert, um die Reihenfolge der Individuen nach den durch Duelle, Training und Innovation vorgenommenen Änderungen zu aktualisieren.
Auslese der Schlechtesten. Die Größe des Arrays „a“ wird auf „popSize“ zurückgesetzt, wobei die schlechtesten Individuen entfernt werden, um eine konstante Populationsgröße aufrechtzuerhalten.
Dieser Zyklus stellt einen Evolutionsschritt dar, in dem Nachkommen erzeugt, die Besten ausgewählt, Lernprozesse durchgeführt, Strategien angepasst und die Populationsgröße aufrechterhalten wird. Die Moving-Methode führt die grundlegenden evolutionären Operationen durch: Reproduktion, Mutation, Selektion und Lernen.
//————————————————————————————————————————————————————————————————————
//--- The main step of the algorithm
void C_AO_DA_duelist::Moving ()
{
  // Initial population setup
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Temporary array expansion for new duelists
  int totalDuelists = popSize + championsCount;
  ArrayResize (a, totalDuelists);

  // Initialize new duelists
  for (int i = popSize; i < totalDuelists; i++)
  {
    a [i].Init (coords);
  }

  // Sort to determine champions (using bubble sort)
  for (int i = 0; i < popSize - 1; i++)
  {
    for (int j = 0; j < popSize - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Determine the champions
  for (int i = 0; i < championsCount; i++)
  {
    champions [i] = i;
    // A champion trains a new duelist
    TrainNewDuelist (i, popSize + i);
  }

  // Clear the winners' and losers' arrays
  ArrayResize (winners, 0);
  ArrayResize (losers,  0);

  // Conduct duels (excluding champions)
  for (int i = championsCount; i < totalDuelists; i++)
  {
    // Each duelist fights one random opponent
    int opponent = u.RNDintInRange (championsCount, totalDuelists - 1);
    if (opponent != i)
    {
      DetermineWinnerAndLoser (i, opponent);
    }
  }

  // Improving duelists
  int minCount = MathMin (ArraySize (winners), ArraySize (losers));
  for (int i = 0; i < minCount; i++)
  {
    // Losers learn from winners
    LearningProcess (losers [i], winners [i]);
  }

  for (int i = 0; i < ArraySize (winners); i++)
  {
    // Winners innovate
    InnovationProcess (winners [i]);
  }

  // Sort all duelists
  for (int i = 0; i < totalDuelists - 1; i++)
  {
    for (int j = 0; j < totalDuelists - i - 1; j++)
    {
      if (a [j].f < a [j + 1].f)
      {
        S_AO_Agent temp = a [j];
        a [j] = a [j + 1];
        a [j + 1] = temp;
      }
    }
  }

  // Remove the worst duelists
  ArrayResize (a, popSize);
}
//————————————————————————————————————————————————————————————————————
Die Methode „Revision“ der Klasse „C_AO_DA_duelist“ dient dazu, Informationen über die beste in der aktuellen Population gefundene Lösung zu aktualisieren. Sie dient dazu, während der Evolution das globale Optimum zu verfolgen.
Iteration über die Population. Die „for“-Schleife durchläuft jedes einzelne Individuum der Population (i von 0 bis popSize).
Fitnessvergleich. Innerhalb der Schleife prüfen wir, ob die Fitness „f“ des aktuellen Individuums besser ist als die derzeit beste Fitness „fB“.
Aktualisierung der besten Lösung. Wenn (a[i].f) besser ist als (fB), wird (fB) aktualisiert, d. h., (fB) speichert die bisher gefundene beste Fitness. Zudem werden die „c“-Merkmale des aktuellen Individuums in das cB-Array kopiert. Das bedeutet, dass cB die Merkmalswerte des bisher gefundenen besten Individuums speichert.
Letztendlich durchsucht die Methode „Revision“ die aktuelle Population, ermittelt das Individuum mit der besten Fitness und aktualisiert, falls dieses Individuum besser ist als der aktuelle „Rekord“, die Informationen über das bisher gefundene beste Individuum (seine Fitness und die Merkmale selbst). Diese Methode ist notwendig, um den Fortschritt des Algorithmus zu verfolgen und das globale Optimum zu finden.
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DA_duelist::Revision ()
{
  // Update the global best solution
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}mit der auf der Testfunktion
//————————————————————————————————————————————————————————————————————
Testergebnisse
Insgesamt lässt sich nach den durchgeführten Untersuchungen feststellen, dass der Duellanten-Algorithmus recht gute Ergebnisse liefert.DA|Duellanten-Algorithmus|100.0|0.01|0.9|0.1|2.0|
=============================
5 Hilly's; Funktionsaufrufe: 10000; Ergebnis: 0.9278151663330798
25 Hilly's; Funktionsaufrufe: 10000; Ergebnis: 0.5377820196319314
500 Hilly's; Funktionsaufrufe: 10000; Ergebnis: 0.27792394907287765
=============================
5 Forest's; Funktionsaufrufe: 10000; Ergebnis: 0.8695700230324329
25 Forest's; Funktionsaufrufe: 10000; Ergebnis: 0.47535947112902815
500 Forest's; Funktionsaufrufe: 10000; Ergebnis: 0.18193288697223736
=============================
5 Megacity's; Funktionsaufrufe: 10000; Ergebnis: 0.6215384615384616
25 Megacity's; Funktionsaufrufe: 10000; Ergebnis: 0.3356923076923076
500 Megacity's; Funktionsaufrufe: 10000; Ergebnis: 0.11715384615384725
=============================
Gesamtpunktzahl: 4.34477 (48.28 %)
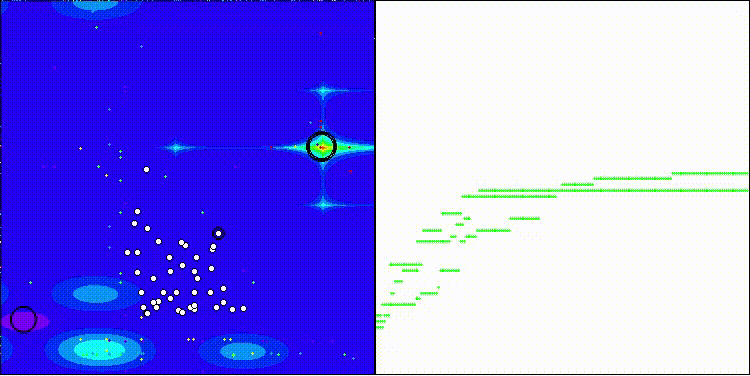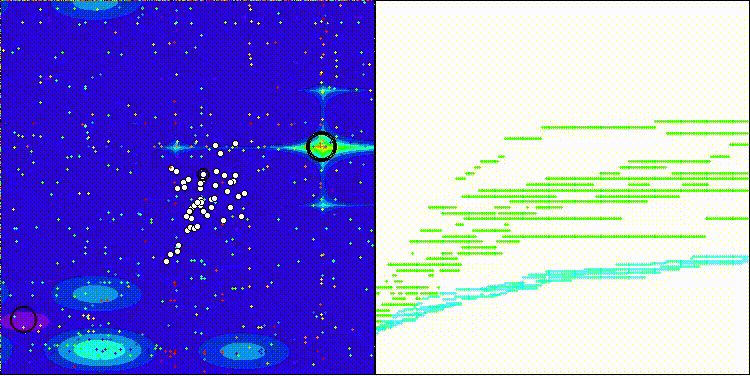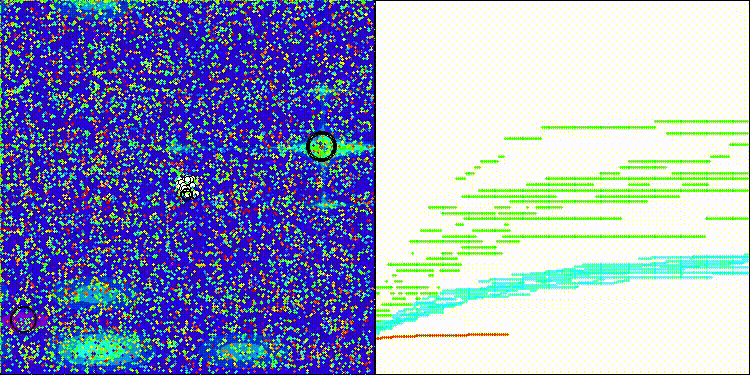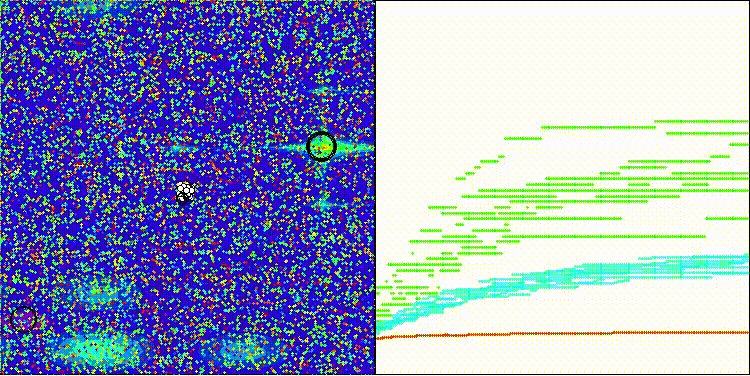
Die Visualisierung der Funktionsweise des Algorithmus zeigt sowohl bei kleinen als auch bei großen Dimensionen eine geringe Streuung der Werte, was auf die guten Suchfähigkeiten des Algorithmus hindeutet.
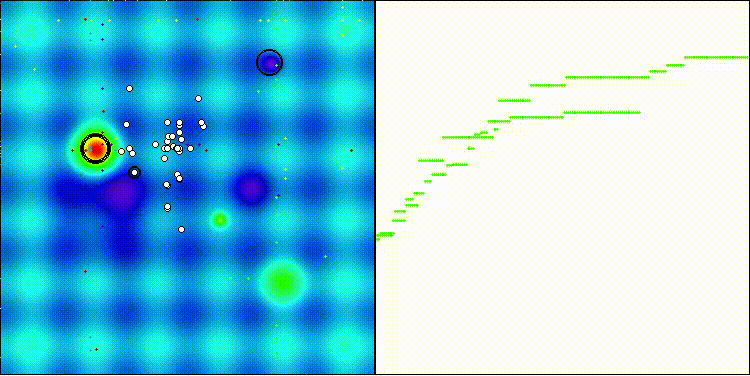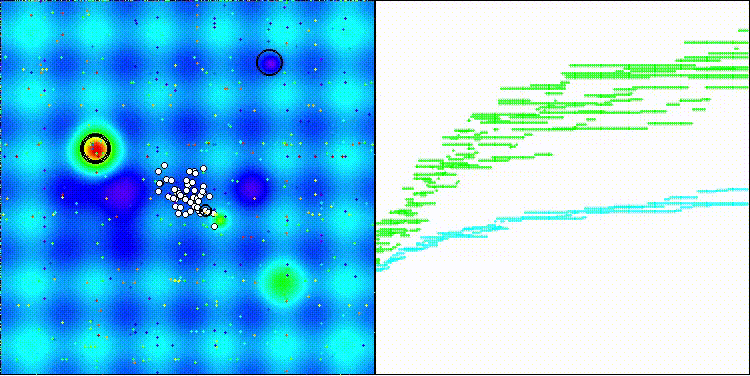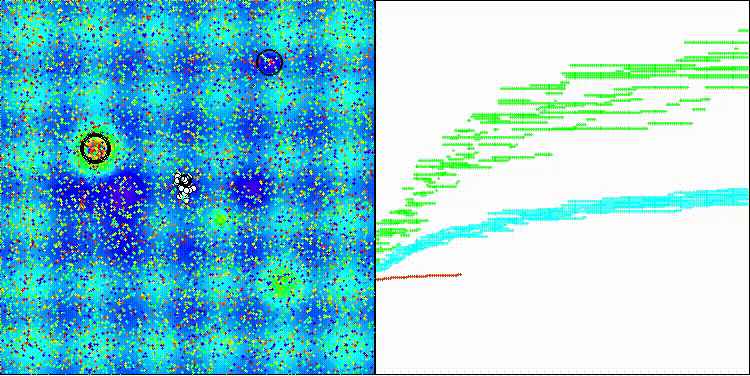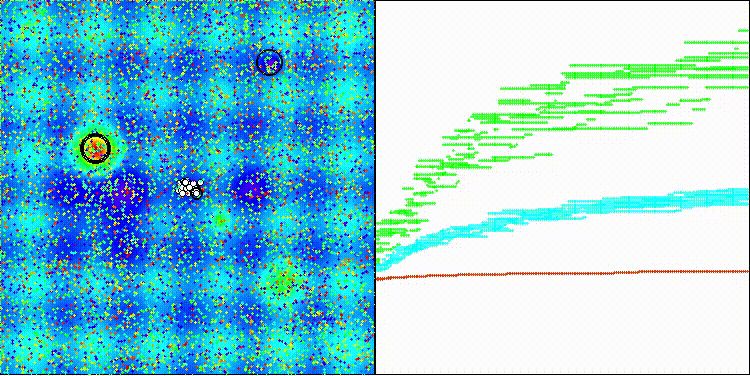
DA_duelist für die Testfunktion Hilly
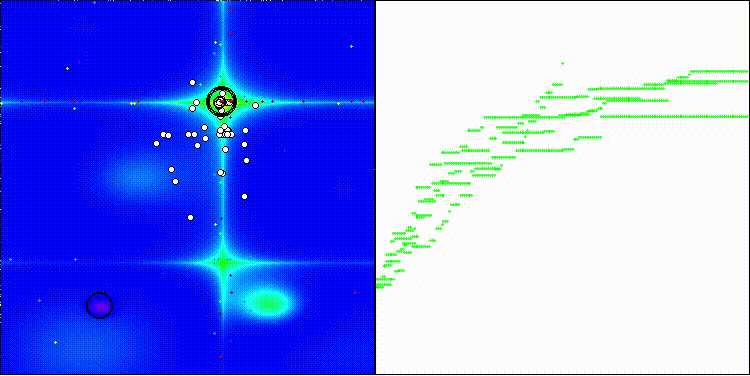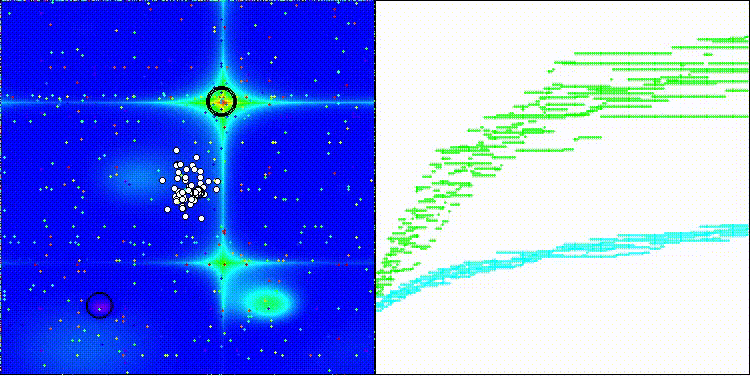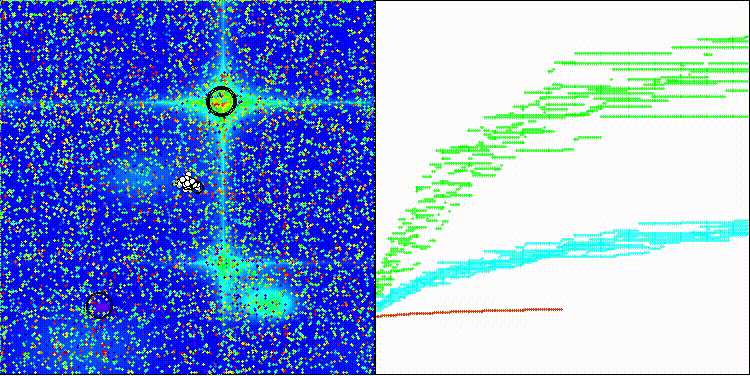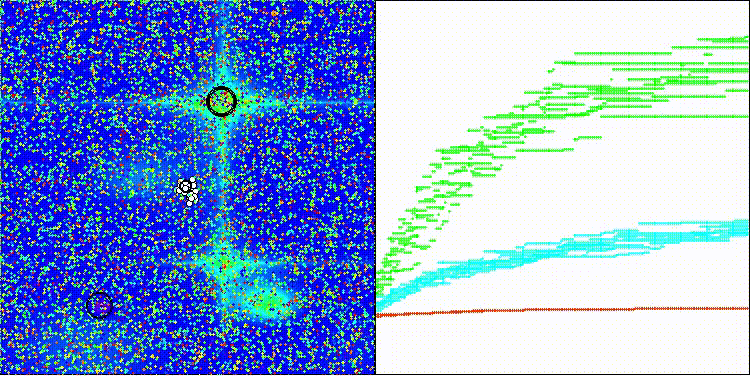
DA_duelist für die Testfunktion Forest
DA_duelist für die Testfunktion Megacity
Auf der Grundlage der Testergebnisse belegt der Duellanten-Algorithmus unter den getesteten Optimierungsalgorithmen den 42. Platz in der Gesamtwertung.
| # | AO | Beschreibung | Hilly | Hilly Final | Forest | Forest Final | Megacity (diskret) | Megacity Final | Endgültiges Ergebnis | % von MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | nachbarschaftsübergreifende Suche | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68.15 |
| 2 | CLA | Codeschloss-Algorithmus (joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67.86 |
| 3 | AMOm | Tiermigrationsoptimierung M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66.52 |
| 4 | (P+O)ES | (P+O)-Evolutionsstrategien | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65.17 |
| 5 | CTA | Kometenschweif-Algorithmus (joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64.96 |
| 6 | TETA | Zeitentwicklungsreise-Algorithmus (joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64.41 |
| 7 | SDSm | Stochastische Diffusionssuche M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63.44 |
| 8 | BOAm | Billard-Optimierungsalgorithmus M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62.19 |
| 9 | AAm | Bogenschieß-Algorithmus M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61.64 |
| 10 | ESG | Evolution sozialer Gruppen (joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61.44 |
| 11 | SIA | simuliertes isotropes Annealing (joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60.76 |
| 12 | EOm | extremal_optimization_M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58.71 |
| 13 | BBO | biogeografiebasierte Optimierung | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58.50 |
| 14 | ACS | künstliche kooperative Suche | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58.06 |
| 15 | DA | dialektischer Algorithmus | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57.95 |
| 16 | BHAm | Black-Hole-Algorithmus M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57.73 |
| 17 | ASO | Optimierung anarchischer Gesellschaften | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57.54 |
| 18 | RFO | Royal-Flush-Optimierung (joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56.55 |
| 19 | AOSm | Atomorbital-Suche M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55.63 |
| 20 | TSEA | Schildkrötenpanzer-Evolutionsalgorithmus (joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55.60 |
| 21 | BSA | Backtracking-Suchalgorithmus | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55.10 |
| 22 | DE | Differentielle Evolution | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55.06 |
| 23 | SRA | Algorithmus des erfolgreichen Gastronomen (joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54.48 |
| 24 | CRO | Optimierung durch chemische Reaktionen | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54.36 |
| 25 | BIO | Optimierung durch Blutvererbung (joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53.80 |
| 26 | BSA | Vogelschwarm-Algorithmus | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53.44 |
| 27 | DEA | Delfin-Echolokationsalgorithmus | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52.91 |
| 28 | HS | Harmoniesuche | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52.79 |
| 29 | SSG | Aussaat und Wachstum von Setzlingen | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51.95 |
| 30 | BCOm | Optimierung durch bakterielle Chemotaxis M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51.65 |
| 31 | ABO | African-Buffalo-Optimierung | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51.49 |
| 32 | (PO)ES | (PO)-Evolutionsstrategien | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51.22 |
| 33 | FBA | fraktalbasierter Algorithmus | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50.61 |
| 34 | TSm | Tabu-Suche M | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50.40 |
| 35 | BSO | Brain-Storm-Optimierung | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49.98 |
| 36 | WOAm | Wal-Optimierungsalgorithmus M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49.74 |
| 37 | AEFA | Algorithmus des künstlichen elektrischen Feldes | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49.55 |
| 38 | AEO | Optimierungsalgorithmus auf Basis künstlicher Ökosysteme | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49.49 |
| 39 | CAm | Kamel-Algorithmus M | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49.37 |
| 40 | ACOm | Ameisenkolonie-Optimierung M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49.31 |
| 41 | CMAES | Kovarianzmatrix-Adaption-Evolutionsstrategie | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48.33 |
| 42 | DA_duelist | Duellanten-Algorithmus | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48.28 |
| 43 | BFO-GA | Optimierung durch bakterielle Nahrungssuche – GA | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46.93 |
| 44 | SOA | einfacher Optimierungsalgorithmus | 0.91520 | 0.46976 | 0.27089 | 1.65585 | 0.89675 | 0.37401 | 0.16984 | 1.44060 | 0.69538 | 0.28031 | 0.10852 | 1.08422 | 4.181 | 46.45 |
| 45 | ABHA | Künstlicher Bienenstock-Algorithmus | 0.84131 | 0.54227 | 0.26304 | 1.64663 | 0.87858 | 0.47779 | 0.17181 | 1.52818 | 0.50923 | 0.33877 | 0.10397 | 0.95197 | 4.127 | 45.85 |
| RW | Random Walk | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
Zusammenfassung
Der Duellanten-Algorithmus erzielt im Bereich der metaheuristischen Optimierung beachtliche Ergebnisse und zählt zu den 45 besten populationsbasierten Algorithmen. Auch wenn er nicht den Anspruch erhebt, der absolute Champion unter den Optimierungsmethoden zu sein, liegt sein entscheidender Vorteil in der Geschwindigkeit.
Adaptive Lernstrategie – im Kontext der Optimierung von Handelssystemen bedeutet dies, dass erfolglose Parameterkonfigurationen schnell erfolgreiche Muster übernehmen, was insbesondere bei der Arbeit mit nicht stationären Finanzzeitreihen von großem Wert ist.
Ein Gleichgewicht zwischen Exploitation und Exploration – Sieger ruhen sich nicht auf ihren Lorbeeren aus, sondern streben durch Innovation stets nach Verbesserung. Dies ist von entscheidender Bedeutung für Handelsstrategien, die sich an veränderte Marktbedingungen anpassen müssen.
Das Element der kontrollierten Zufälligkeit – der Glücksfaktor – bildet auf natürliche Weise die Unsicherheit am Markt ab, wo selbst eine gute Strategie aufgrund kurzfristiger Schwankungen vorübergehend schlechte Ergebnisse erzielen kann.
Eine hierarchische Struktur mit Champions stellt sicher, dass die besten Lösungen erhalten bleiben und weiterverbreitet werden, was im Handel gleichbedeutend ist mit der Beibehaltung bewährter Strategien bei gleichzeitiger Suche nach neuen Chancen.
Der Duellanten-Algorithmus ist eine solide Lösung, die mithilfe der Metapher der Kampfkünste eine einfache, aber wirkungsvolle Idee in die Welt der Optimierung einbringt: von den Starken lernen, aus einer Position der Stärke heraus experimentieren und Wissen an die nächste Generation weitergeben.
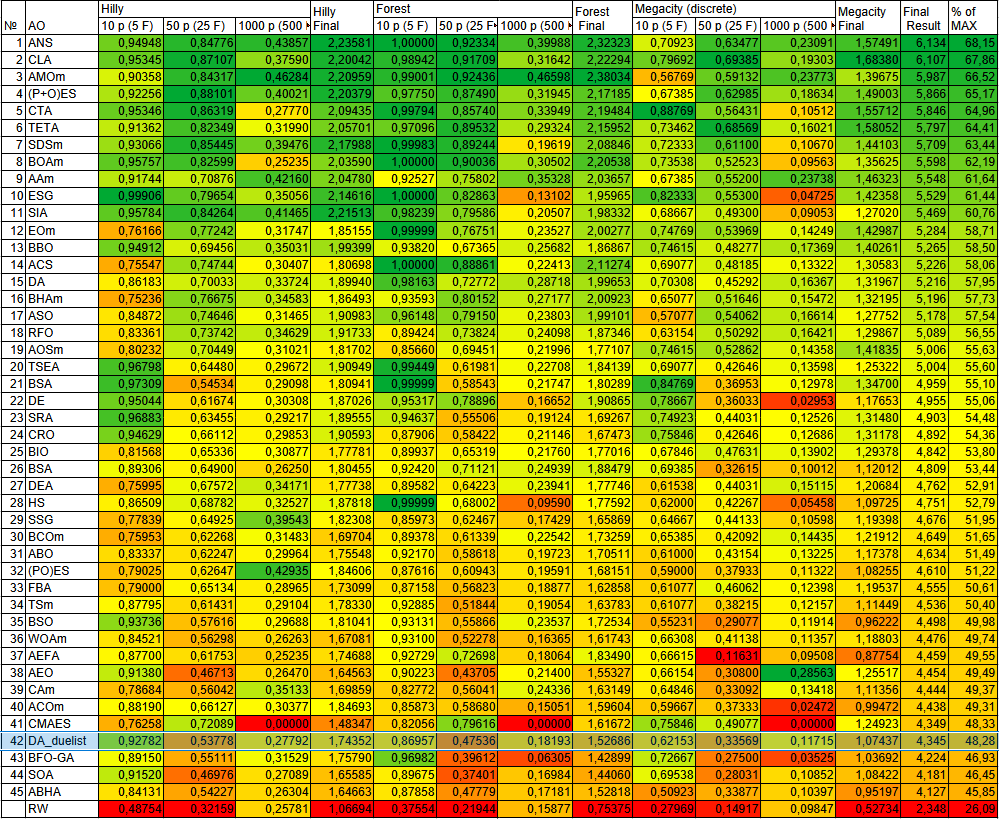
Abbildung 2. Farbabstufung der Algorithmen in den jeweiligen Tests
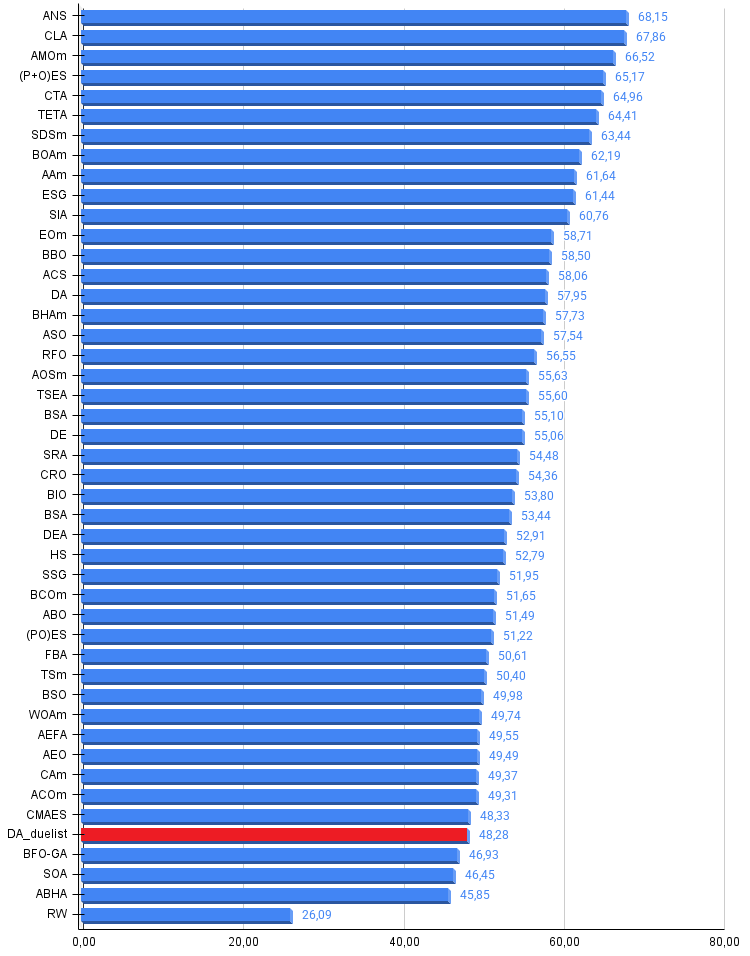
Abbildung 3. Histogramm der Ergebnisse der Algorithmentests (Skala von 0 bis 100; je höher, desto besser; wobei 100 das theoretisch maximal mögliche Ergebnis ist; im Archiv befindet sich ein Skript zur Berechnung der Bewertungstabelle)
Vor- und Nachteile von DA_duelist:
Vorteile:
- Schnell.
- Geringe Varianz über die Testfunktionen hinweg.
Nachteile:
- Geringe Konvergenzgenauigkeit.
Dem Artikel ist ein Archiv mit den neuesten Versionen des Algorithmus-Codes beigefügt. Der Autor des Artikels übernimmt keine Gewähr für die absolute Richtigkeit der Beschreibung der kanonischen Algorithmen. An vielen davon wurden Änderungen vorgenommen, um die Suchfähigkeiten zu verbessern. Die in den Artikeln dargelegten Schlussfolgerungen und Einschätzungen basieren auf den Ergebnissen der Experimente.
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | #C_AO.mqh | Include | Basisklasse für populationsbasierte Optimierungsalgorithmen |
| 2 | #C_AO_enum.mqh | Include | Enumeration populationsbasierter Optimierungsalgorithmen |
| 3 | TestFunctions.mqh | Include | Bibliothek mit Testfunktionen |
| 4 | TestStandFunctions.mqh | Include | Bibliothek mit Teststand-Funktionen |
| 5 | Utilities.mqh | Include | Bibliothek mit Hilfsfunktionen |
| 6 | CalculationTestResults.mqh | Include | Skript zur Berechnung der Ergebnisse in der Vergleichstabelle |
| 7 | Testing AOs.mq5 | Skript | Einheitlicher Teststand für alle populationsbasierten Optimierungsalgorithmen |
| 8 | Simple use of population optimization algorithms.mq5 | Skript | Ein einfaches Beispiel für die Verwendung populationsbasierter Optimierungsalgorithmen ohne Visualisierung |
| 9 | Test_AO_DA_duelist.mq5 | Skript | Teststand für DA_duelist |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19093
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Neuronale Netze im Trading: Das Temporal-Query-Modell (TQNet)
 Marktsimulation: Positionsanzeige (VI)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Trading: Zerlegen statt Skalieren (Fazit)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Der Artikel „Der Duelist-Algorithmus – Duelist Algorithm“ wurde veröffentlicht:
Autor: Andrey Dik
Duellanten, die sich im Ring bekämpfen. Der Markt ist kein Ring, sondern ein Gelände. Mal ist man bis zur Hüfte im Sumpf. Auf dem Eis gewinnt der Eiskunstläufer, aber im Sumpf … Und was für ein Krieger kommt am Ende dabei heraus?
Das könnt ihr selbst im Internet nachsehen, das hat sich der Verfasser des Themas nicht ausgedacht.