

Neuronale Netze im Trading: Das Temporal-Query-Modell (TQNet)
 23
 0

Einleitung
Die multivariate Zeitreihenprognose (MTSF) im Finanzwesen ist ein Wettlauf gegen die Zeit, bei dem Genauigkeit und Geschwindigkeit entscheidend sind. Wechselkurse, Indizes, Handelsvolumina, Zinssätze und Liquiditätsindikatoren – all diese Faktoren stehen in ständiger Wechselwirkung miteinander und bilden ein komplexes, sich ständig veränderndes System. Trader, Vermögensverwalter und Analysten wissen: Um immer einen Schritt voraus zu sein, muss man verstehen, wie sich alle Variablen in Echtzeit gegenseitig beeinflussen. Gerade diese Fähigkeit, das große Ganze zu sehen, bildet den Kern moderner Prognosen auf den Finanzmärkten.
Das Problem ist, dass Finanzdaten nicht mit Labormessungen vergleichbar sind, die unter sterilen Bedingungen durchgeführt werden. Der Markt hat ein Eigenleben: starke Kursschwankungen als Reaktion auf Nachrichten, Phasen hoher und niedriger Volatilität sowie unerwartete Korrelationen, die innerhalb weniger Stunden entstehen und wieder verschwinden. Fügt man dem Ganzen noch Rauschen hinzu (Messfehler, Verzögerungen bei der Kursübermittlung, Datenlücken), stehen wir vor einem klassischen Problem: Wie lässt sich in einer Welt voller Zufälligkeiten ein zuverlässiges Signal herausfiltern? Die Situation wird besonders komplex, wenn lokale Zusammenhänge zwischen Parametern innerhalb eines einzelnen Zeitabschnitts im Widerspruch zum Gesamtbild über die gesamte Beobachtungshistorie stehen. Das ist so, als würde man versuchen, den Wechselkurs einer Währung anhand eines einzigen Tages vorherzusagen, obwohl sich der allgemeine Trend seit Monaten in die entgegengesetzte Richtung bewegt.
Um diese Lücke zu schließen, schlug der Artikel „Temporal Query Network for Efficient Multivariate Time Series Forecasting“ einen neuen Ansatz namens Temporal Query vor – ein Werkzeug, das es ermöglicht, lokale und globale Marktperspektiven zu kombinieren. Das Modell basiert auf trainierbaren Vektoren, die zeitlich zyklisch verschoben werden, und erfasst so stabile Beziehungen zwischen verschiedenen Variablen, die sich über die gesamte Datenhistorie hinweg als stabil erwiesen haben. Gleichzeitig dienen die Kurse, Indikatoren und anderen Marktparameter selbst als Keys und Values in einem Multi-Head-Attention-Mechanismus, wodurch die einzigartigen Merkmale jedes einzelnen Zeitpunkts berücksichtigt werden. Dies hat eine doppelte Wirkung: Das Modell behält seine Fähigkeit, auf momentane Veränderungen zu reagieren, und stützt sich gleichzeitig auf grundlegende, stabilere Marktzusammenhänge.
Auf der Grundlage dieses Prinzips wurde das Temporal Query Network (TQNet)-Framework entwickelt – eine minimalistische und zugleich leistungsstarke Architekturlösung, mit der sich die Dynamik einer Reihe miteinander verbundener Finanzinstrumente prognostizieren lässt. Sein Aufbau ist äußerst einfach: lediglich eine einzige Schicht mit Multi-Head-Attention und ein flaches, vollverbundenes Netz. Hinter dieser Einfachheit verbirgt sich jedoch die Fähigkeit, subtile Abhängigkeiten zwischen Assets zu erkennen und schneller darauf zu reagieren als die meisten herkömmlichen Methoden. In Experimenten, die von den Autoren des Frameworks durchgeführt wurden, zeigte TQNet eine Genauigkeit, die mit der der komplexesten Architekturen vergleichbar war, und arbeitete zugleich mit einer Rechengeschwindigkeit, die der von schlanken linearen Modellen entsprach.
Ein wesentliches Merkmal von TQNet ist seine Fähigkeit, sich an unterschiedliche Prognosehorizonte anzupassen, indem es dasselbe Prinzip des Ausgleichs zwischen lokalen und globalen Abhängigkeiten anwendet. Dies ist besonders auf den Finanzmärkten von großem Wert, wo sich Situationen innerhalb weniger Minuten entwickeln können, dabei aber dennoch langfristigen Mustern folgen, die nicht außer Acht gelassen werden dürfen.
Auf den heutigen Finanzmärkten ist der Erfolg weder denjenigen vorbehalten, die nur die Details im Blick haben, noch denen, die sich ausschließlich auf das große Ganze verlassen, sondern jenen, die es verstehen, diese beiden Wahrnehmungsebenen miteinander zu verbinden. Temporal Query und TQNet bieten genau diese Fähigkeit – und das mit einer eleganten Einfachheit, die einen festen Platz im Werkzeugkasten jedes ernsthaften Analysten verdient.
Der TQNet-Algorithmus
Im Mittelpunkt der multivariaten Zeitreihenprognose (Multivariate Time Series Forecasting, MTSF) steht das Ziel, das zukünftige Verhalten mehrerer miteinander in Zusammenhang stehender Variablen gleichzeitig vorherzusagen. Formal liegt zum Zeitpunkt t eine beobachtete historische Folge Xt ∈ RC*L vor. Dabei steht C für die Anzahl der Variablen oder Kanäle (Währungspaare, Marktindizes, Handelsvolumina und andere Indikatoren) und L für die Länge des Beobachtungsfensters (wie viele vergangene Datenpunkte wir berücksichtigen). Die Aufgabe besteht darin, für einen Prognosehorizont H eine Prognose zu erstellen, indem Yt ∈ RC*H bestimmt wird – eine Folge zukünftiger Werte derselben Variablen.
Aus Sicht der Finanzmärkte kann dies bedeuten, dass auf der Grundlage historischer Daten für den ausgewählten Zeitraum die Kurse wichtiger Währungspaare für die nächsten Stunden, wichtige Indexstände für die nächsten Handelstage oder die Zinsentwicklung über einen Prognosehorizont von mehreren Wochen prognostiziert werden. Es ist wichtig, nicht nur die individuellen zeitlichen Muster der einzelnen Variablen zu berücksichtigen, sondern auch die Korrelationen zwischen ihnen – schließlich bewegt sich der Markt als eine Einheit, und Veränderungen in einem Segment können sich sofort in einem anderen widerspiegeln.
Um dieses Problem anzugehen, wurde das Framework Temporal Query Network (TQNet) vorgeschlagen. Trotz der Einfachheit seines architektonischen Aufbaus vereint das Framework zwei zentrale Mechanismen: die Identifizierung von Abhängigkeiten zwischen Variablen und die Modellierung der zeitlichen Struktur.
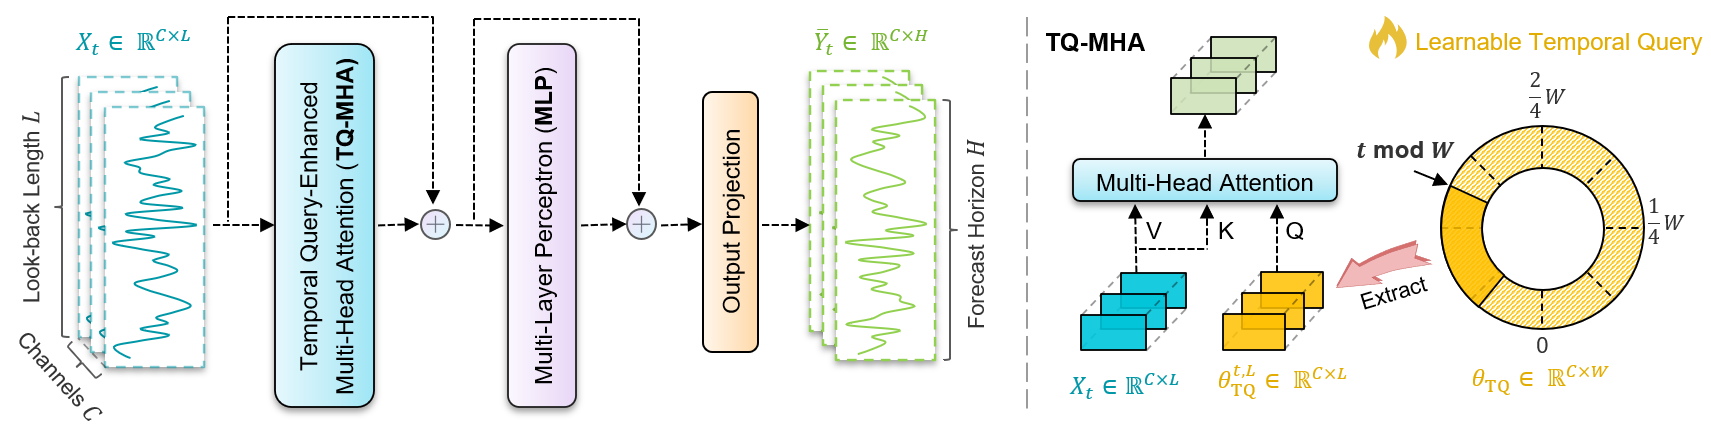
Die Funktionsweise von TQNet beginnt damit, dass die analysierte Sequenz Xt in eine Multi-Head-Attention-Schicht eingespeist wird, die um die Temporal Query-Komponente (TQ-MHA) erweitert ist. Diese Schicht ist dafür zuständig, Korrelationen zwischen Variablen zu erkennen und zu integrieren – sowohl globale, langfristig stabile Korrelationen als auch lokale Korrelationen, die spezifisch für den aktuellen Marktkontext sind. Das Ergebnis wird anschließend von einem flachen, vollverbundenen Multilayer Perceptron (MLP) verarbeitet, das die zeitlichen Abhängigkeiten verfeinert und dem Modell dabei hilft, Trends und Veränderungsrhythmen zu erfassen.
Beide Blöcke (TQ-MHA und MLP) sind mit Residualverbindungen ausgestattet, was die Trainingsstabilität verbessert und das Risiko einer Qualitätsminderung bei großen Datensätzen verringert. Die letzte Stufe besteht aus einer linearen Schicht mit Dropout, die die erhaltenen verborgenen Repräsentationen auf den Ausgaberaum projiziert und so eine Prognose Ŷt ∈ RC*H erzeugt.
Ein wesentliches Element der TQNet-Architektur ist die Temporal Query-Methode (TQ) – eine spezifische Vorgehensweise zur Bildung von Queries (Query) innerhalb des Attention-Mechanismus. Das Konzept ist einfach und elegant: Anstatt Queries direkt aus den Rohdaten abzuleiten, wie es bei klassischer Self-Attention der Fall ist, schlagen die Autoren des Frameworks vor, eine Reihe trainierbarer Vektoren zu verwenden, die periodisch entlang der Zeitachse verschoben werden. Dieser Ansatz ermöglicht es, globale Korrelationen zwischen Variablen zu erfassen, die gegenüber kurzfristigen Marktschwankungen und Rauschen robust sind.
Formal initialisieren wir bei gegebener Periodenlänge W in den zu analysierenden Daten die Parametermatrix θTQ ∈ RC×W. Dabei ist C die Anzahl der Variablen (Kanäle) und W die Vektorlänge, die das periodische Verschiebungsintervall bestimmt. Diese Parameter werden zunächst mit Nullen initialisiert und während des Trainings adaptiv angepasst, um die internen Abhängigkeiten in den Daten widerzuspiegeln. Die Wahl von W ist besonders wichtig: An den Finanzmärkten kann W beispielsweise der Anzahl der Handelssitzungen pro Woche, wiederkehrenden Liquiditätszyklen oder anderen stabilen saisonalen Mustern entsprechen. Dies lässt sich entweder anhand von Expertenwissen über den Markt oder mithilfe statistischer Methoden ermitteln.
Das TQ-Prinzip funktioniert wie folgt: Für jedes zum Zeitpunkt t analysierte Sample extrahieren wir ein Fragment der Länge L aus der Matrix θTQ, beginnend an der Position, die als t mod W berechnet wird, und führen die Auswahl bei Bedarf zyklisch weiter. Somit weisen zwei Zeitpunkte, die genau W Schritte voneinander entfernt sind, identische Query-Vektoren auf. Dadurch entsteht ein periodischer Gedächtniseffekt, der es dem Modell ermöglicht, erlernte globale Abhängigkeiten wiederzuverwenden und die Auswirkungen zufälliger Marktstörungen zu verringern.
Im Finanzkontext lässt sich dies mit einem erfahrenen Trader vergleichen, der sich an typische Marktszenarien an denselben Wochentagen oder während bestimmter Handelszeiten erinnert und dieses Wissen bei der Analyse der aktuellen Situation nutzt.
In TQNet ist dieser Ansatz in den Multi-Head-Attention-Mechanismus (TQ-MHA) integriert. Hier werden Queries (Query) nicht aus den Quelldaten gebildet, sondern aus temporalen TQ-Vektoren, die globale Abhängigkeiten widerspiegeln. Gleichzeitig werden die Keys (Key) und Values (Value) weiterhin aus der aktuell analysierten Sequenz Xt extrahiert, wobei alle lokalen, spezifischen Informationen über den Markt zu diesem Zeitpunkt erhalten bleiben.
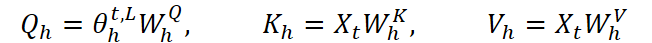
Der Index h entspricht der Nummer des Attention-Heads, und W h Q, W h K sowie W h V sind die trainierbaren Projektionsmatrizen.
Anschließend wird die Attention für jeden Attention-Head berechnet.
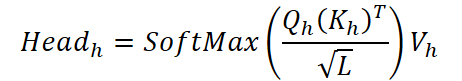
Die Ergebnisse werden anschließend, ähnlich wie bei der klassischen Multi-Head-Self-Attention, kombiniert und durch eine abschließende Projektion geleitet.
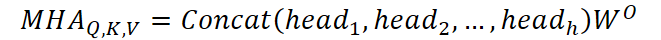
Diese Kombination aus globalen Queries und lokalen Keys/Values schafft ein Gleichgewicht zwischen Robustheit gegenüber Rauschen und Anpassung an den aktuellen Kontext. Bei realen Marktdaten, bei denen ruhige Phasen plötzlich in Phasen hoher Turbulenzen übergehen können, ist dieses Gleichgewicht von entscheidender Bedeutung. Das Modell behält seine Fähigkeit, auf einmalige Ereignisse zu reagieren – wie beispielsweise unerwartete makroökonomische Daten oder starke Marktbewegungen aufgrund von Nachrichten –, stützt sich aber gleichzeitig auf ein Rückgrat globaler Abhängigkeiten, die über die Zeit bestehen bleiben.
Das Ziel der vorgeschlagenen Temporal Query (TQ)-Technik besteht darin, sowohl globale als auch lokale Beziehungen in einer Zeitreihe auf natürliche Weise in den Attention-Mechanismus zu integrieren. Die Idee ist einfach, aber wirkungsvoll: Queries (Query) werden nicht direkt aus den Rohdaten gebildet, sondern aus periodisch verschobenen trainierbaren Vektoren θTQ, während Keys (Key) weiterhin aus der ursprünglichen Sequenz extrahiert werden. Dieser Ansatz ermöglicht es uns, ein Gleichgewicht zwischen dem Gesamtmarktbild und den individuellen Merkmalen der einzelnen Datensegmente herzustellen.
Um die Auswirkungen globaler und lokaler Abhängigkeiten in der Praxis zu bewerten, verglichen die Autoren des Frameworks drei Szenarien:
- Der klassische Ansatz, bei dem Query und Key aus Rohdaten gebildet werden. In diesem Fall erfasst der Attention-Mechanismus nur lokale, instanzspezifische Beziehungen zwischen Beobachtungen.
- Der hybride Ansatz ist derjenige, der in TQNet umgesetzt wurde. Hier wird die Query aus trainierbaren TQ-Vektoren gebildet und der Key aus den Quelldaten. Daher werden bei der Berechnung der Attention-Gewichte sowohl globale als auch instanzspezifische Abhängigkeiten berücksichtigt, was insbesondere auf den Finanzmärkten von Bedeutung ist, wo allgemeine Trends mit kurzfristigen Schwankungen verflochten sind.
- Ein rein globales Schema, bei dem Query und Key aus trainierbaren TQ-Vektoren gebildet werden. Diese Methode lässt lokale Schwankungen völlig außer Acht und konzentriert sich stattdessen auf die Gesamtstruktur der Zeitreihe.
Die aggregierten Ergebnisse, die aus umfangreichen multivariaten Datensätzen mit mehr als 100 Variablen gewonnen und über vier Prognosehorizonte gemittelt wurden, zeigen, dass der TQNet-Ansatz die beste Leistung erzielte. Es vereint beide Arten von Korrelationen. An zweiter Stelle steht das traditionelle Schema mit rein instanzspezifischen Beziehungen, während die rein globale Variante den letzten Platz belegt. Die Schlussfolgerung ist eindeutig: Die ausgewogene Einbeziehung globaler und lokaler Abhängigkeiten verbessert die Prognosegenauigkeit und die Robustheit des Modells, was insbesondere bei der Arbeit mit dynamischen Finanzzeitreihen von großem Wert ist.
Sobald die TQ-MHA-Schicht stabile Beziehungen zwischen Variablen ermittelt und diese mit lokalen Informationen verknüpft hat, kommt ein Multilayer Perceptron (MLP) zum Einsatz. Seine Aufgabe besteht darin, die bereits extrahierten Merkmale in der zeitlichen Dimension weiterzuverarbeiten und dabei Trends, Rhythmen und Verzögerungen in den Wechselbeziehungen zu erfassen.
Trotz seiner Einfachheit bleibt das MLP ein überraschend wirksames Werkzeug zur Erkennung zeitlicher Muster. In der TQNet-Architektur ist es als leichtgewichtige Version implementiert: lediglich zwei vollverbundene Schichten mit der GeLU-Aktivierungsfunktion, die insbesondere bei komplexen Marktschwankungen eine gleichmäßigere Signalverarbeitung ermöglicht als ReLU.
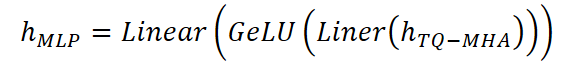
Aus finanzieller Sicht lässt sich dieser Schritt mit einer Situation vergleichen, in der ein Analyst, nachdem er eine Zusammenfassung der wichtigsten Marktzusammenhänge erhalten hat, eine zusätzliche Analyse durchführt: Dabei identifiziert er Intraday-Muster, bewertet die Amplitude der Schwankungen und erkennt Trägheit sowie Umkehrpunkte.
Die daraus resultierenden Repräsentationen werden anschließend an die Ausgabeprojektionsschicht weitergeleitet. Hier wird eine lineare Transformation angewendet, um die internen Repräsentationen an einen bestimmten Prognosehorizont H anzupassen. Darüber hinaus kann Dropout eingesetzt werden, um Überanpassung zu verringern und die Robustheit des Modells zu verbessern.
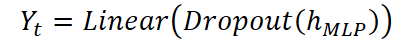
TQNet legt besonderen Wert auf Robustheit gegenüber Verschiebungen der Datenverteilung – ein Phänomen, das im Finanzsektor äußerst häufig auftritt. Wechselkurse, Rohstoffpreise und Aktienindizes – all diese Größen können als Reaktion auf Nachrichten, makroökonomische Faktoren oder regulatorische Entscheidungen starke Veränderungen in ihren statistischen Eigenschaften erfahren. Wenn ein Modell in einer alten Verteilung verankert ist, verlieren seine Prognosen schnell an Relevanz.
Um dies zu vermeiden, nutzt das TQNet-Framework die Reversible Instance Normalization (RevIN) – eine Methode, die sich in einer Reihe moderner Architekturen als wirksam erwiesen hat. Die Idee dahinter ist, dass das Modell vor der Verarbeitung den Mittelwert subtrahiert und die Daten durch die Standardabweichung dividiert und sie nach der Erstellung der Prognose wieder auf ihre ursprüngliche Skala zurückführt. Aus Sicht des Handels lässt sich dies damit vergleichen, wie ein erfahrener Analyst seine Bezugspunkte stets anpasst, wenn sich die Marktbedingungen ändern. Durch die Normalisierung werden kurzfristige Verschiebungen in Skalierung und Volatilität beseitigt, sodass sich das Modell auf Muster statt auf zufällige Schwankungen in der Skalierung der Kurse konzentrieren kann.
Somit dienen im TQNet das MLP und die Ergebnisprojektion als abschließender Feinschliff der Prognose. TQ-MHA liefert das Grundgerüst der Abhängigkeiten zwischen den Variablen, das MLP verfeinert diese im Zeitverlauf, und die Normalisierung schützt vor statistischen Verzerrungen. Infolgedessen liefert das Modell eine Prognose, die sowohl die lokalen Besonderheiten des aktuellen Zeitpunkts berücksichtigt als auch die globale Marktkonsistenz gewährleistet.
Nachfolgend ist die von den Autoren erstellte Darstellung des TQNet-Frameworks abgebildet.
Implementierung in MQL5
Nachdem wir nun die theoretischen Grundlagen des TQNet-Frameworks behandelt und aufgezeigt haben, warum die Kombination globaler und lokaler Korrelationen die Prognosegenauigkeit verbessern kann, ist es an der Zeit, von der Theorie zur Praxis überzugehen. Wir können uns nun auf eine Möglichkeit konzentrieren, diese Ideen in der MQL5-Umgebung umzusetzen und die Architektur für die Zeitreihenanalyse und -prognose auf den Finanzmärkten anzupassen.
Hier wird jedes Element – von der Erstellung von Queries und Keys bis hin zur Datennormalisierung und Ergebnisprojektion – im Code implementiert. Auf diese Weise können wir zeigen, wie Theorie in ein Werkzeug umgesetzt wird, das für den realen Handel einsetzbar ist. Dieser Ansatz ermöglicht es uns, die Wirksamkeit von TQNet anhand von Echtzeitkursen zu testen und seine Robustheit in verschiedenen Marktphasen zu bewerten: von ruhigen Seitwärtsmärkten bis hin zu rasanten Trends.
Auf der Grundlage unserer Erfahrungen bei der Entwicklung verschiedener Attention-Module können wir einen fundierten Vergleich zwischen TQNet und dem klassischen Cross-Attention-Block anstellen. Im traditionellen Cross-Attention-Schema arbeitet Cross-Attention mit Tensoren für Queries (Queries), Keys (Keys) und Values (Values), die aus verschiedenen Datenquellen gebildet werden. Dieser Ansatz ermöglicht es einer Sequenz, die in einer anderen Sequenz enthaltenen Informationen selektiv zu verarbeiten und so die Beziehungen zwischen den Sequenzen zu ermitteln.
Im Fall von TQNet wird dieses Prinzip differenzierter und zielgerichteter an Aufgaben der Zeitreihenprognose angepasst. Hier werden die Rollen der Datenquellen so zugewiesen, dass Queries globale, verallgemeinerte Informationen tragen können, die in den trainierbaren Vektoren θTQ kodiert sind, während Keys die Verbindung zur lokalen Struktur der Quelldaten aufrechterhalten. Diese Kombination spielt auf den Finanzmärkten eine entscheidende Rolle, wo allgemeine Muster – wie saisonale Schwankungen oder wiederkehrende makroökonomische Zyklen – mit lokalen Schwankungen – starken Kurssprüngen, Marktrauschen und kurzfristigen Ungleichgewichten zwischen Angebot und Nachfrage – integriert werden müssen.
Somit lässt sich TQNet als eine Art hybrider Cross-Attention-Mechanismus betrachten, in dem der globale Speicher des Modells und die unmittelbaren Marktsignale in einem einzigen Mechanismus vereint werden. Dies erweitert nicht nur das Spektrum der berücksichtigten Wechselbeziehungen, sondern macht das Modell auch widerstandsfähiger gegenüber abrupten Regimewechseln, was insbesondere unter Bedingungen hoher Volatilität an den Devisen-, Aktien- oder Rohstoffmärkten von großem Wert ist.
In diesem Zusammenhang stehen wir vor einer zentralen Aufgabe: dem Aufbau und Training eines Tensors der globalen Korrelationen, der als Datenquelle für die Generierung von Queries dienen soll. Genau dieser Tensor – bestehend aus den trainierbaren Vektoren θTQ – enthält Informationen über die globalen Beziehungen zwischen den Variablen und bildet die Grundlage für die korrekte Konstruktion des Attention-Mechanismus.
Sein Training erfordert eine sorgfältige Vorgehensweise: Der Tensor muss sich an die Datenstruktur anpassen, indem er stabile Korrelationen erfasst, und gleichzeitig robust gegenüber Rauschen und lokalen Ausreißern bleiben. Für Finanzzeitreihen ist dies besonders wichtig, da Zeitreihen von Vermögenswerten starken Schwankungen unterliegen – von kurzfristigen Liquiditätsspitzen bis hin zu unerwarteten Marktereignissen.
Durch die Erstellung und das Training eines solchen Tensors ermöglichen wir es dem Modell, bei der Verarbeitung jeder neuen Sequenz globale Marktmuster zu nutzen. Auf der Grundlage dieses Tensors generierte Queries fungieren als Filter, der die Attention des Modells auf die wichtigsten Beziehungen zwischen den Variablen lenkt und diese gleichzeitig mit den lokalen Merkmalen des aktuellen Zeitsegments verknüpft. Dadurch kann TQNet eine hohe Prognosegenauigkeit erzielen, indem es die Stabilität des globalen Speichers mit der Anpassungsfähigkeit an spezifische Marktbedingungen kombiniert.
Wir haben bereits ein CParams-Objekt in unserem Toolkit, das einen Algorithmus zum Erstellen und Verwalten trainierbarer Parameter implementiert. Theoretisch könnten wir damit einen Tensor der globalen Korrelationen konstruieren. Dies wirft jedoch die Frage nach der Effizienz eines solchen Ansatzes auf.
Der Punkt ist, dass die multivariate Zeitreihenprognose auf den Finanzmärkten einen relativ großen Tensor erfordert, der Korrelationen über den gesamten Zyklus der analysierten Daten hinweg abbilden kann. Andererseits führt ein übermäßig großer Tensor zu erheblichen Rechenkosten, was sich negativ auf die Trainingsgeschwindigkeit und den Echtzeitbetrieb des Modells auswirkt.
Zudem werden die meisten dieser Rechenressourcen unnötigerweise beansprucht. Bei jedem Schritt des Trainings oder der Prognose verwenden wir nur einen kleinen Teil des Tensors, der dem aktuellen Zeitfenster entspricht. Der verbleibende Teil bleibt ungenutzt, und Operationen darauf sind effektiv wirkungslos.
Gleichzeitig steigen die Tensorgröße und die Anzahl der No-Op-Operationen proportional zur Zykluslänge und zur Anzahl der analysierten Variablen. Bei Finanzdaten, bei denen die Anzahl der Kanäle in die Hunderte gehen kann und die historischen Zeiträume Tausende von Zeitschritten umfassen, wird diese Ineffizienz schnell zu einem Engpass, der das Training verlangsamt und die Gesamtleistung des Modells beeinträchtigt.
Daher ist es von entscheidender Bedeutung, nach Lösungen zu suchen, die unnötige Berechnungen reduzieren und es dem Modell gleichzeitig ermöglichen, globale Korrelationen ohne Genauigkeitsverlust zu erfassen.
Auf der Suche nach einer effizienteren Lösung haben wir beschlossen, unseren Ansatz zur Speicherung und Aktualisierung von Korrelationsparametern etwas zu überdenken. Anstatt ein einziges statisches CParams-Objekt zur Erzeugung des gesamten Tensors zu verwenden, haben wir eine modifizierte Version dieses Objekts erstellt und darin ein Array aus internen, trainierbaren Parameterobjekten implementiert.
Jedes Element des Arrays entspricht nun einem separaten Zeitschritt, sodass wir ausschließlich die Daten und Parameter verwenden können, die für das aktuelle Prognosefenster relevant sind. Dieser Ansatz reduziert unnötige Berechnungen erheblich und bewahrt gleichzeitig die Fähigkeit des Modells, globale Zusammenhänge zwischen Variablen über den gesamten Analysezeitraum hinweg zu erfassen.
Mit anderen Worten: Wir haben einen dynamischen Parametertensor erhalten, in dem jedes Element einem bestimmten Zeitpunkt entspricht, und unnötige Operationen in den anderen Schritten werden vollständig eliminiert. Dadurch ist unsere TQNet-Implementierung wesentlich ressourceneffizienter und für große Finanzdatensätze besser skalierbar.
Nachdem wir nun das Konzept eines dynamischen Parametertensors untersucht und die Notwendigkeit begründet haben, für jeden Zeitschritt ein Array von Objekten zu verwenden, besteht der nächste logische Schritt darin, eine konkrete Umsetzung dieses Ansatzes im Code zu betrachten. Die Klasse CCircleParams spielt in unserer Architektur eine zentrale Rolle; sie erbt ihre Grundfunktionalität von der vollverbundenen neuronalen Schicht CNeuronBaseOCL.
class CCircleParams  :  public CNeuronBaseOCL
  {
protected:
   CLayer            cOnes;
   CNeuronBaseOCL    *cCurrent;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override          { return FeedForward(); }

   ///\ingroup neuron_base_opt
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override   { return UpdateInputWeights(); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override   { return true; }

public:
                     CCircleParams(void) : cCurrent(NULL) {};
                    ~CCircleParams(void)  {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint numNeurons, uint period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   virtual bool      Identity(const int rows, const int cols);
   virtual bool      Zeros(void);
   //---
   virtual bool      FeedForward(void);
   virtual bool      UpdateInputWeights(void);
   virtual bool      SetPosition(int position);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defCircleParams; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat   *getWeightsParams(void);
   virtual int       GetPeriod(void) const { return cOnes.Total(); }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
Diese Klasse ist ein spezieller Container zum Speichern und Verwalten trainierbarer Korrelationsparameter, der sicherstellt, dass diese korrekt aktualisiert werden und effizient mit den OpenCL-Kontextmechanismen zusammenwirken, was insbesondere bei der Arbeit mit großen Finanzdatensätzen auf der GPU von Bedeutung ist.
Innerhalb der Klasse CCircleParams spielt das Objekt cOnes eine besondere Rolle; es handelt sich um ein dynamisches Array aus trainierbaren Tensoren, das den periodischen Charakter des Objekts unterstützt. Der Parameter cCurrent fungiert als Zeiger auf das aktive Objekt im Array und verweist damit auf das aktuell aktive Zeitschrittobjekt. Dadurch kann das Modell dynamisch zwischen Kontexten wechseln und jedes Zeitsegment mit höchster Genauigkeit verarbeiten, während die über den gesamten Analysezeitraum hinweg aufgebauten globalen Abhängigkeiten erhalten bleiben.
Die Struktur des CCircleParams-Objekts wird in der Initialisierungsmethode Init erstellt und konfiguriert, die dafür zuständig ist, alle erforderlichen Komponenten vorzubereiten, damit der Korrelationsparameter-Tensor ordnungsgemäß funktioniert.
bool CCircleParams::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint numNeurons, uint period,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
Wenn die Methode aufgerufen wird, werden die geerbten Schnittstellen zunächst von der übergeordneten Klasse CNeuronBaseOCL initialisiert, die die grundlegenden Parameter des Objekts festlegt. Tritt in dieser Phase ein Fehler auf, gibt die Methode sofort false zurück, wodurch weiteres fehlerhaftes Verhalten verhindert wird.
Als Nächstes bereiten wir das dynamische Array cOnes vor: Wir löschen es und binden es an den OpenCL-Kontext, damit alle nachfolgenden Operationen mit Tensoren effizient auf der GPU ausgeführt werden können.
   cOnes.Clear();
   cOnes.SetOpenCL(OpenCL);
   for(uint i = 0; i < period; i++)
     {
      cCurrent = new CNeuronBaseOCL();
      if(!cCurrent)
         return false;
      if(!cCurrent.Init(Neurons(), i, OpenCL, 1, optimization, iBatch) ||
         !cOnes.Add(cCurrent))
        {
         delete cCurrent;
         return false;
        }
      cCurrent.SetActivationFunction(None);
     }
Die Hauptschleife der Methode ist dafür zuständig, ein Array von Objekten zu erstellen, von denen jedes einem einzelnen Zeitschritt entspricht. Für jeden Zeitschritt wird eine neue Instanz von CNeuronBaseOCL erstellt und mit identischen, für diesen Schritt spezifischen Parametern initialisiert. Nach erfolgreicher Initialisierung wird das Objekt dem cOnes-Container hinzugefügt, der alle Zeitschritte verwaltet. Sollte ein Fehler auftreten, wird das gerade erstellte Objekt sofort gelöscht, wodurch Speicherlecks verhindert werden und die Integrität der Struktur gewahrt bleibt.
Bei jedem neu erstellten Neuron wird zudem die Aktivierungsfunktion deaktiviert, was für die korrekte Funktion des Korrelationstensors wichtig ist, da in der Feed-Forward-Stufe die Werte lediglich ohne nichtlineare Transformation weitergeleitet werden müssen.
Sobald alle Zeitschritt-Objekte erstellt wurden, legt die Methode SetPosition das erste Element unseres Arrays als aktives Element fest und definiert damit den Ausgangszustand für weitere Berechnungen.
//---
   if(!SetPosition(0))
      return false;
//---
   return true;
  }
Die Methode Init erstellt also nicht einfach nur ein Array aus Objekten, sondern bildet einen strukturierten, verwaltbaren Parameterspeicher, in dem jedes Element einen bestimmten Zeitpunkt darstellt. Dadurch kann das Modell globale Korrelationen effektiv nutzen, unnötige Berechnungen vermeiden und die Einsatzbereitschaft für das Training sowie für die multivariate Prognose von Finanzzeitreihen sicherstellen.
Die Methode SetPosition spielt eine zentrale Rolle bei der Verwaltung des dynamischen Parametertensors für Korrelationen in CCircleParams. Ihr Zweck besteht darin, das aktive Objekt auf einen bestimmten Zeitschritt umzuschalten und sicherzustellen, dass das Modell mit den für genau diesen Zeitpunkt relevanten Daten arbeitet.
Wenn die Methode aufgerufen wird, wird der Zeiger cCurrent auf das Element des cOnes-Arrays gesetzt, das der angegebenen Position entspricht. Fehlt das ausgewählte Objekt oder wurde es nicht initialisiert, gibt die Methode false zurück, um auf ein Problem hinzuweisen und fehlerhafte Berechnungen zu verhindern. Andernfalls gibt die Methode, wenn ein Objekt erfolgreich ausgewählt wurde, den Wert true zurück und bestätigt damit, dass das Modell für die weitere Datenverarbeitung bereit ist.
bool CCircleParams::SetPosition(int position)
  {
   cCurrent = cOnes[position];
   if(!cCurrent)
      return false;
//---
   return true;
  }
Hinter dieser Einfachheit verbirgt sich eine wichtige Funktion: Über SetPosition kann das TQNet-Modell dynamisch mit unterschiedlichen Zeitschritten arbeiten und dabei die entsprechenden Korrelationsparameter aktivieren, ohne dass der gesamte Tensor neu erstellt oder neu geladen werden muss. Dies ist insbesondere für Finanzzeitreihen von Bedeutung, da bei jedem neuen Zeitabschnitt sowohl lokale als auch globale Abhängigkeiten berücksichtigt werden müssen und eine effektive Verwaltung der aktiven Position es dem Modell ermöglicht, auch bei großen Datenmengen schnell und anpassungsfähig zu bleiben.
Es sei darauf hingewiesen, dass bei der Standardinitialisierung im Rahmen der Methode Init alle Tensoren der globalen Korrelationen mit Zufallswerten gefüllt werden. In den meisten Fällen ist dieser Ansatz vollkommen akzeptabel: Die zufällige Initialisierung sorgt für eine Vielzahl von Ausgangsbedingungen und ermöglicht es den trainierbaren Parametern, sich schrittweise an die Datenstruktur anzupassen.
Die Autoren des TQNet-Frameworks empfehlen jedoch einen anderen Ansatz – nämlich den Tensor mit Nullwerten zu initialisieren. Diese Methode ist insbesondere bei der Arbeit mit Finanzzeitreihen gerechtfertigt, da es wichtig ist, das Training ohne vorherige Annahmen über Korrelationen zwischen den Variablen zu beginnen, damit das Modell stabile Zusammenhänge schrittweise allein auf der Grundlage historischer Daten erkennen kann.
Zur Umsetzung dieses Ansatzes definiert CCircleParams die Methode Zeros, die die Parameter aller Zeitschritte nacheinander auf Null setzt. Wenn diese Methode aufgerufen wird, wird jedes Element des cOnes-Arrays verarbeitet, und alle Werte des Tensors der globalen Korrelationen werden auf Null gesetzt. Dadurch können wir beim Training mit einer neutralen Ausgangsbasis beginnen und sicherstellen, dass die anfänglichen Vorhersagen des Modells nicht durch zufällige Anfangswerte verzerrt werden und dass der gesamte Anpassungsprozess ausschließlich durch die analysierten Daten und die Struktur von TQNet bestimmt wird.
bool CCircleParams::Zeros(void)
  {
   matrix<float> zeros = matrix<float>::Zeros(Neurons(), 2);
//---
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(zeros))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
Somit bietet die Zeros-Methode eine komfortable und effektive Möglichkeit, den Anfangszustand der globalen Korrelationen zu steuern, wodurch die Transparenz und Vorhersagbarkeit des Modelltrainings anhand von Finanzdaten erhöht wird.
Als Alternative zur Nullinitialisierung implementieren wir eine Methode, mit der wir den Tensor der globalen Korrelationen mit einer Einheitsmatrix initialisieren können. Dieser Ansatz kann nützlich sein, wenn anfänglich unabhängige Variablen vorgegeben werden müssen, während das Modell im Trainingsprozess schrittweise die tatsächlichen Zusammenhänge zwischen ihnen aufdecken kann.
Die Identity-Methode überprüft zunächst, ob die Dimensionen der zu erstellenden Matrix mit der Anzahl der Neuronen im Objekt übereinstimmen.
bool CCircleParams::Identity(const int rows, const int cols)
  {
   if(rows * cols != Neurons())
      return false;
   matrix<float> ident = matrix<float>::Identity(rows, cols);
   if(!ident.Reshape(rows * cols, 1))
      return false;
   if(!ident.Resize(rows * cols, 2))
      return false;
   if(!ident.Col(vector<float>::Zeros(rows * cols), 1))
      return false;
Anschließend wird eine Einheitsmatrix mit den angegebenen Dimensionen erstellt, die dann schrittweise umgeformt und an die internen Datenstrukturen der Klasse angepasst wird. Besonderes Augenmerk wird auf die Speichervorbereitung und Neuallokation mithilfe der Reshape- und Resize-Methoden sowie auf das Nullsetzen der zusätzlichen Bias-Spalte gelegt, um den korrekten Betrieb bei der Zuweisung von Werten zu gewährleisten.
Nachdem die Matrix vorbereitet wurde, durchläuft die Methode alle Zeitschritte im cOnes-Container.
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(ident))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
Für jeden Schritt werden die Gewichte mithilfe der getWeights-Methode abgerufen, und ihnen wird der Inhalt der vorbereiteten Diagonalmatrix zugewiesen. Anschließend wird der Puffer im OpenCL-Kontext freigegeben und mit den neuen Werten neu angelegt, wodurch das korrekte Zusammenspiel mit der GPU während des anschließenden Modelltrainings gewährleistet wird.
Der Vorgang wird durch den Aufruf der FeedForward-Methode abgeschlossen, wodurch sofort überprüft werden kann, ob die Werte korrekt durch die Schicht weitergeleitet werden. Diese Initialisierungsmethode stellt sicher, dass zu Beginn des Trainings die globalen Korrelationen zwischen den Variablen unverzerrt sind und von einem neutralen Zustand ausgehen, während gleichzeitig eine Struktur beibehalten wird, die es dem Modell ermöglicht, tatsächliche Abhängigkeiten während des Prognoseprozesses effektiv zu erfassen und zu berücksichtigen.
Im finanziellen Kontext ist dies besonders wichtig: Die Einheitsmatrix bietet für jede Variable eine neutrale Ausgangsbasis, wodurch anfängliche Verzerrungen beseitigt werden und das Modell gleichzeitig schrittweise stabile Marktzusammenhänge, wie beispielsweise Korrelationen zwischen Vermögenswerten, aufdecken kann.
Nachdem wir nun die Initialisierungsalgorithmen und Methoden zur Vorbereitung der anfänglichen Korrelationsparameter ausführlich untersucht haben, ist es sinnvoll, zur Beschreibung des Vorwärtsdurchlauf-Algorithmus überzugehen – eine der Schlüsselphasen in der Funktionsweise der Klasse CCircleParams.
Die FeedForward-Methode bereitet die globalen Korrelationsparameter vor, die dem aktuellen Zeitschritt entsprechen, sodass das Modell seine internen Zustände aktualisieren kann.
bool CCircleParams::FeedForward(void)
  {
   if(!cCurrent)
      if(!SetPosition(0))
         return false;
//---
   return CNeuronBaseOCL::feedForward(cCurrent);
  }
Zunächst prüft die Methode, ob im cCurrent-Zeiger ein aktiver Schritt festgelegt ist. Wenn das aktuelle Objekt nicht angegeben ist, wird die SetPosition-Methode aufgerufen, um automatisch den ersten Zeitschritt im cOnes-Array auszuwählen und so sicherzustellen, dass die Berechnungen korrekt beginnen.
Nachdem der aktive Schritt festgelegt wurde, wird die Steuerung an die gleichnamige Methode der Basisklasse übergeben, wodurch die erforderlichen globalen Korrelationsparameter gebildet werden können.
Somit fungiert FeedForward als Brücke zwischen der vorbereiteten Struktur des Tensors der globalen Korrelationen und dem Attention-Mechanismus von TQNet. Der vorgeschlagene Ansatz gewährleistet Flexibilität und Genauigkeit bei der Prognose und ermöglicht es dem Modell, sowohl auf lokale Marktschwankungen als auch auf langfristige Trends zu reagieren.
Nachdem wir nun den Mechanismus des Vorwärtsdurchlaufs untersucht und bestätigt haben, wie FeedForward die korrekte Weiterleitung der Daten durch den aktiven Zeitschritt gewährleistet, besteht der nächste logische Schritt darin, die Methode UpdateInputWeights zu untersuchen, die für die Aktualisierung der Modellparameter zuständig ist.
Diese Methode spielt beim Training eine zentrale Rolle: Hier werden die Gewichte und Korrelationsparameter auf der Grundlage der berechneten Gradienten angepasst, wodurch sich das Modell schrittweise an die Struktur der Daten anpassen kann. In CCircleParams wird die Methode implementiert, indem die Steuerung an die gleichnamige Methode der übergeordneten Klasse delegiert und dabei das aktive Zeitschrittelement angegeben wird.
bool CCircleParams::UpdateInputWeights(void)
  {
   return CNeuronBaseOCL::updateInputWeights(cCurrent);
  }
Durch die Übergabe eines Zeigers auf das Objekt des aktuellen Zeitschritts wird sichergestellt, dass die Aktualisierung nur für das relevante Segment des Tensors durchgeführt wird. Dies erhöht die Effizienz und verhindert unnötige Berechnungen für die verbleibenden Zeitschritte.
Es sei darauf hingewiesen, dass wir in dieser Phase bewusst nicht die Gültigkeit des Zeigers in der Variablen cCurrent überprüfen. Das ist beabsichtigt. Es ist äußerst wichtig, dass das Modell sowohl im Vorwärtsdurchlauf als auch im Rückwärtsdurchlauf dasselbe Zeitschritt-Objekt verwendet. Jede Neudefinition dieses Objekts während der Gewichtsaktualisierung könnte die Konsistenz der Berechnungen beeinträchtigen und zu Fehlern bei der Parameteranpassung führen.
In diesem Fall ist die Methode der übergeordneten Klasse dafür zuständig, sicherzustellen, dass der Zeiger gültig ist. Sollte ein Fehler auftreten, wird einfach false zurückgegeben, wodurch verhindert wird, dass die Gewichte falsch aktualisiert werden. Dieser Ansatz ermöglicht es uns, uns auf den Kernprozess der Aktualisierung der Parameter des aktuellen Zeitschritts zu konzentrieren, ohne zusätzlichen Aufwand oder das Risiko, die Struktur des Tensors der globalen Korrelationen zu stören.
Dies ist insbesondere für Finanzzeitreihen von Bedeutung. Das Modell arbeitet bei jedem Schritt zuverlässig mit den aktuellen Daten und bewahrt dabei globale Muster, wodurch Prognosegenauigkeit und Trainingsstabilität auch bei dynamischen und verrauschten Marktveränderungen gewährleistet werden.
Wie bereits aufgefallen sein dürfte, haben wir den Schritt der Rückpropagation der Fehlergradienten nach unten durch das Modell übersprungen. Stattdessen wird die Methode calcInputGradients mit einer Stub-Implementierung überschrieben, die stets ein erfolgreiches Ergebnis zurückgibt. Dieser Ansatz mag ungewöhnlich erscheinen, reicht jedoch für die Aktualisierung der globalen Korrelationsparameter völlig aus. Das Modell muss lediglich die Fehlergradienten auf der Ebene der Schichtausgabe kennen, um die Gewichte des aktuellen Zeitschritts anzupassen.
Die zugrunde liegenden Daten fließen nicht in die Berechnungen ein, da das CCircleParams-Objekt im Wesentlichen nicht mit externen Eingabedaten arbeitet. Es ergibt keinen Sinn, Gradienten bis auf diese Ebene weiterzuleiten.
Die Verwendung einer Stub-Implementierung spielt hierbei eine wichtige Rolle: Sie ermöglicht es, ein neues Objekt in die Gesamtmodellstruktur zu integrieren, wobei die Kompatibilität mit anderen Netzwerkkomponenten gewahrt bleibt und sichergestellt wird, dass die Gewichte korrekt aktualisiert werden können, ohne das System unnötig zu belasten.
Insgesamt verwandeln diese Fähigkeiten CCircleParams von der abstrakten Idee eines dynamischen Tensors der globalen Korrelationen in ein vollwertiges, steuerbares Objekt, das sich effektiv in TQNet integrieren lässt. Das Modell ist in der Lage, gleichzeitig stabile globale Muster zu erfassen und lokale Datenmerkmale in jedem Zeitschritt zu berücksichtigen. Dies ist insbesondere für die Finanzmärkte von Bedeutung: Das Modell lernt, wiederkehrende saisonale Zyklen und stabile Korrelationen zwischen Vermögenswerten zu erkennen sowie auf kurzfristige Schwankungen, Marktrauschen und plötzliche Ereignisse zu reagieren.
Wir haben viel Arbeit hineingesteckt, und der Artikel ist bereits ziemlich lang geworden. All das braucht Zeit, damit die Informationen aufgenommen und verarbeitet werden können. Es ist an der Zeit, eine kurze Pause einzulegen, um über das bisher Besprochene nachzudenken.
Im nächsten Artikel werden wir unsere Arbeit fortsetzen und uns der Entwicklung von Attention-Algorithmen sowie der vollständigen Integration der TQNet-Komponenten zuwenden. Dabei werden wir aufzeigen, wie die beschriebenen Strukturen und Methoden in ein effektives Werkzeug zur Prognose von Finanzzeitreihen umgesetzt werden.
Fazit
In diesem Artikel haben wir das TQNet-Framework untersucht, das Modularität, Flexibilität und hohe Leistung vereint. Dadurch erweist es sich als besonders wertvolles Instrument für die Prognose und Analyse von Finanzzeitreihen. Die Architektur des Frameworks ist so konzipiert, dass jede Komponente eine klar definierte Aufgabe erfüllt und das Ersetzen oder Aktualisieren einzelner Komponenten keine vollständige Überarbeitung des gesamten Systems erfordert.
Im praktischen Teil lag der Schwerpunkt auf der Implementierung des neuen CCircleParams-Objekts, das zur Verwaltung globaler Korrelationsparameter dient. Wir haben den Initialisierungsprozess und die Organisation der Zeitschritte eingehend untersucht und zudem alternative Algorithmen zur Festlegung der Anfangswerte des Tensors entwickelt. Besonderes Augenmerk wurde auf den Aufbau des Vorwärtsdurchlaufs, den Mechanismus zur Gewichtsaktualisierung und die Synchronisation der Berechnungen zwischen den Zeitschritten gelegt.
Damit haben wir eine flexible und zuverlässige Framework-Komponente geschaffen, die für den umfassenden Einsatz in komplexeren Modellen bereit ist. Im nächsten Artikel werden wir uns auf den Aufbau einer einheitlichen Berechnungspipeline konzentrieren und diese anhand historischer Daten testen, um die Effektivität und Robustheit des Systems unter realen Finanzmarktbedingungen zu bewerten.
Links
- Temporal Query Network for Efficient Multivariate Time Series Forecasting
- Weitere Artikel dieser Reihe
Im Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19157
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Duellanten-Algorithmus
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Marktsimulation: Positionsanzeige (VI)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.