

Neuronale Netze im Trading: Das Temporal-Query-Modell (Fazit)
 13
 0

Einleitung
Das TQNet-Framework ist einer der elegantesten und flexibelsten Ansätze zum Aufbau neuronaler Netzmodelle, die Zeitreihen und strukturell organisierte Daten effektiv verarbeiten können. Sein wesentlicher Vorteil liegt in der Fähigkeit, lokale und globale Abhängigkeiten zu kombinieren und so ein besonderes Gleichgewicht zwischen Analysetiefe und Recheneffizienz zu schaffen. Im Gegensatz zu herkömmlichen Architekturen verbindet TQNet Mechanismen zur sequenziellen Datenverarbeitung nahtlos mit Methoden zur Erfassung langfristiger Abhängigkeiten. Dies ist besonders wertvoll bei der Arbeit mit finanziellen Zeitreihen, bei denen sowohl momentane Schwankungen als auch Trends, die sich im Laufe der Zeit entwickeln, eine wichtige Rolle spielen.
Der Algorithmus basiert auf einem eigenständigen Ansatz zur Organisation von Berechnungen. Der globale Korrelationstensor spielt bei diesen Berechnungen eine zentrale Rolle. Er erstellt eine Art Karte der Beziehungen zwischen den Elementen der Sequenz, sodass das Modell lokale Muster erfassen und ein umfassendes Gesamtbild der Datenstruktur aufbauen kann.
Der Rechenprozess innerhalb von TQNet lässt sich als Abfolge koordinierter Schritte beschreiben. In der ersten Stufe durchlaufen die Eingabedaten eine Schicht, die lokale Features erzeugt, wobei wesentliche Eigenschaften des aktuellen Zustands extrahiert werden. Anschließend wird der globale Korrelationsmechanismus aktiviert, der auf diese Features die über alle vorangegangenen Schritte hinweg angesammelten strukturellen Abhängigkeiten anwendet. Dieses iterative Verfahren ermöglicht es dem Modell, sich flexibel an veränderte Bedingungen anzupassen und verborgene Muster zu berücksichtigen. Das Besondere an diesem Ansatz ist, dass das Modell nicht an eine starre Reihenfolge des Datenflusses gebunden ist: Beziehungen können sich innerhalb der Sequenz in jede Richtung bilden, was seine Möglichkeiten bei Prognose- und Analyseaufgaben erweitert.
Der praktische Nutzen von TQNet zeigt sich insbesondere dann, wenn Daten mit Rauschen behaftet sind oder eine komplexe interne Struktur aufweisen. Finanzmärkte, Wettervorhersagen und die Analyse industrieller Prozesse – in all diesen Fällen kommt es nicht nur auf die Genauigkeit der Vorhersage an, sondern auch auf die Robustheit des Modells gegenüber unerwarteten Ausreißern und Veränderungen der Dynamik. Dank eines gut konzipierten Algorithmus zur Parameteraktualisierung und der effizienten Nutzung von Rechenressourcen liefert TQNet auch bei großen Datensätzen eine stabile Leistung, ohne dass dafür übermäßige Trainingsressourcen erforderlich sind.
Die Visualisierung des Frameworks durch den Autor ist unten dargestellt.
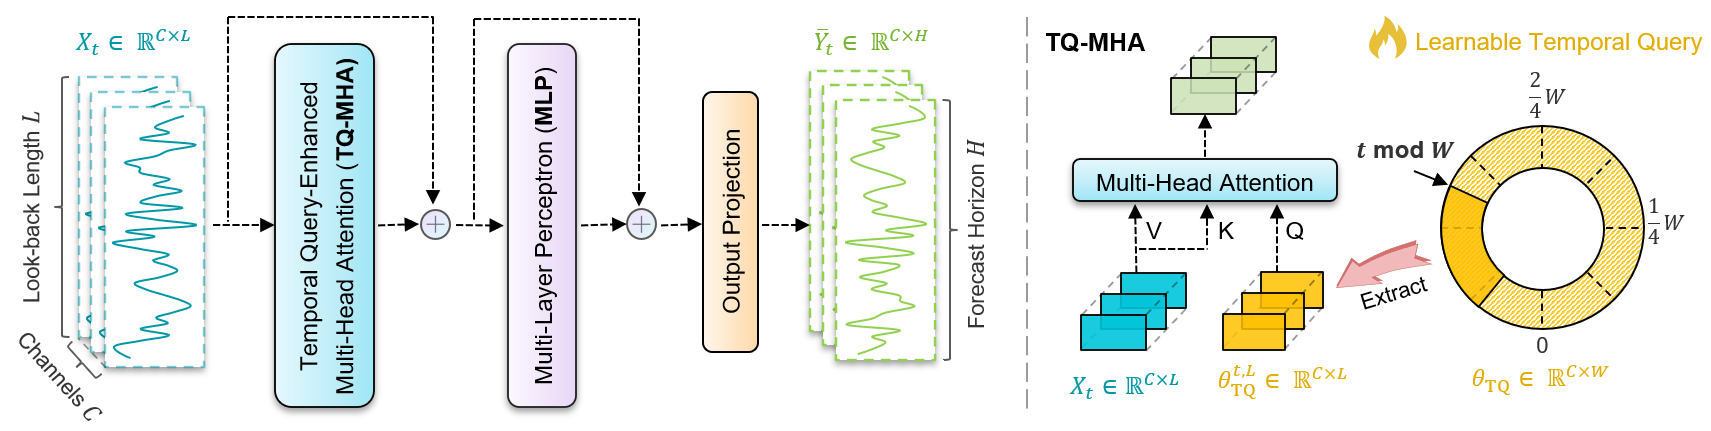
Im vorherigen Artikel haben wir die theoretischen Aspekte des TQNet-Frameworks beleuchtet – seine modulare Architektur, seine Fähigkeit, sich flexibel an die Marktgegebenheiten anzupassen, sowie sein effizientes Ressourcenmanagement. Theorie ist jedoch nur ein Gerüst. Wir haben außerdem das CCircleParams-Objekt untersucht, mit dem globale Korrelationen als Objekte gespeichert werden können, die bei jedem Zeitschritt dynamisch umgeschaltet werden können. Heute setzen wir unsere Arbeit an der Umsetzung der von den Autoren des TQNet-Frameworks vorgeschlagenen Ansätze mithilfe von MQL5 fort.
TQ-MHA-Modul
Der nächste logische Schritt, den wir nach der erfolgreichen Implementierung des Algorithmus zur Organisation des Tensor-Karussells der Korrelationsparameter erreicht haben, ist die Erstellung des TQ-MHA-Moduls. Im Konzept der Autoren spielt dieses Modul eine besondere Rolle: Es fungiert als intelligenter Filter, der in der Lage ist, die akkumulierten Korrelationsparameter nicht isoliert, sondern in enger Verbindung mit den zu analysierenden Quelldaten auszuwerten. Mit anderen Worten: Es wertet statistische Daten aus und versucht, das dynamische Beziehungsgeflecht zu erfassen, wobei es dieses durch den aktuellen Marktkontext ergänzt. Dieser Ansatz lässt sich mit der Arbeit eines erfahrenen Analysten vergleichen, der sich nicht auf trockene Tabellen und Diagramme beschränkt, sondern die Zahlen stets auf den Prüfstand stellt, indem er sie mit realen Ereignissen und der Marktdynamik abgleicht.
Wenn wir Parallelen zu uns vertrauten architektonischen Lösungen ziehen, ähnelt TQ-MHA in vielerlei Hinsicht einem Cross-Attention-Modul. Allerdings gibt es dabei einen besonderen Aspekt: Anstelle eines direkten Vergleichs zweier Informationsströme – Key und Query – liegt ein differenzierterer Prozess vor. Das TQ-MHA-Modul verknüpft die Quelldaten mit den Korrelations- und Abhängigkeitsmatrizen und ermittelt dabei die aussagekräftigsten Schnittpunkte. Hierbei handelt es sich nicht lediglich um eine technische Optimierung, sondern um eine qualitativ neue Analyseebene, die es dem Framework ermöglicht, Marktsignale in einem breiteren Kontext zu interpretieren.
Hier gibt es noch einen weiteren interessanten Punkt, der erwähnenswert ist. In den Cross-Attention-Modulen, die wir zuvor nach den Prinzipien von Transformer-Architekturen implementiert haben, gab es stets einen FeedForward-Block – ein kompaktes, aber wichtiges Element, das als nichtlinearer Datentransformator zwischen den Attention-Schichten fungiert, während die Autoren des TQNet-Frameworks diesen Block formal weglassen, als würden sie einen ganzen Schritt der bekannten Kette ausklammern. Auf den ersten Blick mag dies wie eine zu starke Vereinfachung erscheinen, doch bei genauerer Betrachtung der internen Logik des Frameworks haben wir festgestellt, dass auf TQ-MHA ein MLP-Modul folgt, das im Wesentlichen die gesamte Funktionalität eines klassischen FeedForward-Blocks nachbildet.
Der einzige Unterschied liegt in einem Detail: den Aktivierungsfunktionen. Das ist für uns jedoch kein Hindernis – im Gegenteil, es eröffnet uns Möglichkeiten zum Experimentieren. Wir können die Aktivierungsfunktion problemlos durch eine andere ersetzen, die unseren Zielen und den spezifischen Eigenschaften unserer finanziellen Zeitreihen besser entspricht.
Daher haben wir uns nun der Entwicklung des speziellen CNeuronTQMHA-Objekts zugewandt, das die Cross-Attention-Logik unter Berücksichtigung der akkumulierten Korrelationsparameter integriert und eine nahtlose Interaktion mit den anderen Modulen des Frameworks gewährleistet. Die Struktur der neuen Klasse ist unten dargestellt.
class CNeuronTQMHA   :  public CNeuronCrossAttention
  {
protected:
   uint              iTimeframe;
   CCircleParams     cParams;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer, CBufferFloat *SecondInput,
                       CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);

public:
                     CNeuronTQMHA(void) {};
                    ~CNeuronTQMHA(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint heads,
                          uint units_in, uint period, uint timeframe,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTQMHA;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
  };
Die Klasse CNeuronTQMHA erbt die grundlegende Kernfunktionalität und die meisten ihrer internen Objekte vom Cross-Attention-Objekt CNeuronCrossAttention. Im Gegensatz zur einfachen Cross-Attention-Variante ist sie jedoch so konzipiert, dass sie mit Korrelationsparametern arbeitet, die aus dem Tensor-Karussell gewonnen werden.
Innerhalb der Klasse deklarieren wir nur zwei Schlüsselelemente. Das erste ist iTimeframe, das die Zeitschrittweite für den Wechsel der Korrelationsmatrix in unserem Karussell festlegt. Das zweite ist cParams, eine Instanz der Klasse CCircleParams, die für die akkumulierten Korrelationsparameter zuständig ist. Genau diese Parameter bilden das Ausgangsmaterial, das die Multi-Head-Attention im Kontext der Ausgangsdaten analysieren wird.
Die internen Objekte sind direkt als Klassenmitglieder angelegt, sodass Konstruktor und Destruktor leer bleiben können – beim Erstellen oder Zerstören des Objekts geschieht nichts Zusätzliches. Alle rechenintensiven Vorgänge wurden in die Initialisierungsmethode verlagert. Dies sorgt für eine klare und vorhersehbare Semantik des Objektlebenszyklus: Die Erstellung ist ressourcenschonend, und die Vorbereitung für den Betrieb erfolgt kontrolliert und explizit.
Die Init-Methode führt mehrere wichtige Schritte aus und überprüft das Ergebnis jedes einzelnen sorgfältig.
bool CNeuronTQMHA::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                        uint window, uint window_key, uint heads,
                        uint units_count, uint period, uint timeframe,
                        ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossAttention::Init(numOutputs, myIndex, open_cl, window,
                                   window_key, heads, units_count, window,
                                   units_count, optimization_type, batch))
      return false;
Zunächst wird die Steuerung an die gleichnamige Methode der übergeordneten Klasse übergeben, wodurch die grundlegende Cross-Attention-Logik übernommen und konfiguriert wird. Sollte die grundlegende Initialisierung aus irgendeinem Grund fehlschlagen, gibt die Methode sofort false zurück – diese frühzeitige Rückgabe verhindert, dass ein ungültiger Zustand weiter im Stack propagiert wird, und vereinfacht das Debugging.
Als Nächstes legen wir die Aktivierungsfunktion zwischen den Schichten des FeedForward-Blocks fest.
FF[0].SetActivationFunction(GELU);
Wie oben erläutert, dient das von den Autoren des Frameworks nach TQ-MHA verwendete MLP im Wesentlichen als klassischer FeedForward-Block. Durch die Änderung der Aktivierungsfunktion lässt sich die Nichtlinearität zudem flexibel an die Besonderheiten finanzieller Zeitreihen anpassen. GeLU liefert eine glattere Näherung und verhält sich bei verrauschten Daten oft stabiler als harte ReLU-Aktivierungen. Unmittelbare Marktimpulse wirken sich nicht so stark auf eine solche Funktion aus, wodurch das Training reibungsloser verläuft.
Der Parameter iTimeframe ist durch eine Untergrenze abgesichert – dies ist eine einfache, aber wichtige Sicherheitsmaßnahme: Der Parameterwert kann nicht den Wert null annehmen. In der Praxis bedeutet dies, dass das Modul selbst bei einer fehlerhaften Konfiguration in einem minimal sinnvollen Modus arbeitet.
   iTimeframe = MathMax(1, timeframe);
   if(!cParams.Init(0, 0, OpenCL, window * units_count, period, optimization, iBatch))
      return false;
   if(!cParams.Zeros())
      return false;
//---
   return true;
  }
Ein wesentlicher Bestandteil des Initialisierungsprozesses ist die Vorbereitung des cParams-Objekts. Hier schaffen wir explizit eine interne Struktur für globale Korrelationen. Für jedes Zeitfenster (window) und für jede analysierte univariate Sequenz (units_count) wird ein entsprechendes Element im Korrelationstensor angelegt. Durch die Initialisierung werden diese Puffer an den OpenCL-Kontext gebunden, was bei der Verarbeitung großer Datenmengen für zusätzliche Effizienz sorgt.
Schließlich wird durch den Aufruf von cParams.Zeros die von den Autoren empfohlene Initialisierungsstrategie festgelegt: Alle globalen Speicherparameter werden auf null gesetzt. Dies ist eine wichtige Entwurfsentscheidung: Durch die Null-Initialisierung werden etwaige anfängliche Verzerrungen in den Korrelationen beseitigt, und das Modell erhält ein unbeschriebenes Blatt, auf dem es seine eigenen Zusammenhänge ausschließlich anhand der Trainingsdaten aufbaut. Dieser Ansatz ist bei Problemen, bei denen wir kein unerwünschtes Rauschen auf der Ebene der Speicherparameter einführen wollen, oft einer zufälligen Initialisierung vorzuziehen.
Wenn alle Schritte erfolgreich waren, gibt die Methode true zurück: Das Objekt ist vollständig einsatzbereit; die Puffer wurden angelegt, die Aktivierungsfunktion wurde festgelegt und der periodische Speicher ist bereit und geleert. Insgesamt bietet diese Methode eine stabile, vorhersehbare und effiziente Plattform für nachfolgende Vorgänge, bei denen CNeuronTQMHA tatsächlich damit beginnt, die gesammelten θ-Vektoren mit den zu analysierenden Daten zu verknüpfen und aus historischen Kursnotierungen zu lernen.
Nachdem wir die Klassenstruktur beschrieben haben, liegt es nahe, nun zur Analyse ihres zentralen Verfahrens überzugehen – des Algorithmus für den Vorwärtsdurchlauf. Die Methode beginnt mit dem einfachsten, aber zugleich grundlegendsten Schritt: der Überprüfung, ob der Zeiger auf den SecondInput-Puffer gültig ist.
bool CNeuronTQMHA::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
In diesem Puffer erwarten wir einen Referenzpunkt für die Positionierung des Karussells der Korrelationsparameter. Fehlt dieser, wird die Ausführung sofort abgebrochen und false zurückgegeben. Diese Überprüfung schützt das Modul vor ungültigen Aufrufen und verhindert weitere unnötige Berechnungen.
Als Nächstes ermitteln wir die aktuelle Position im Karussell. Dazu lesen wir das Element am Index 0 aus dem SecondInput-Puffer aus. In der Praxis gehen wir davon aus, dass dies die Eröffnungszeit der letzten Bar ist.
   int pos = int(SecondInput[0]);
   pos = (pos / int(iTimeframe)) % cParams.GetPeriod();
   if(!cParams.SetPosition(pos) ||
      !cParams.FeedForward())
      return false;
Der daraus resultierende ganzzahlige Wert wird anschließend in einen Index für das Parameterkarussell umgewandelt. Zunächst gruppieren wir durch Division durch iTimeframe aufeinanderfolgende Schritte in Zeitintervallen der angegebenen Schrittgröße – daraus ergibt sich die Blocknummer. Anschließend ergibt der Rest der Division durch die Länge der Datenperiode den Index eines bestimmten Elements im Karussell der Korrelationsparameter. Zusammen setzen diese beiden Operationen das Konzept des periodischen Speichers um: Für Zeitpunkte, die innerhalb desselben Blocks liegen und durch die Periodenlänge voneinander getrennt sind, wird derselbe Satz von TQ-Vektoren verwendet.
Der nächste Block schaltet strikt die aktive Parameterkopie um und führt einen Vorwärtsdurchlauf durch sie aus, wobei die Korrelationsparameter für die Verwendung vorbereitet werden. Tritt bei auch nur einem dieser Schritte ein Fehler auf, gibt die Methode false zurück. Dieses Vorgehen stellt sicher, dass wir von diesem Zeitpunkt an stets mit einem ordnungsgemäß vorbereiteten Satz globaler Parameter arbeiten.
Die folgenden Schritte bilden die Funktionsweise des Cross-Attention-Moduls nach. Wir könnten zwar die Steuerung an die gleichnamige Methode der übergeordneten Klasse übergeben, doch semantisch gesehen führt dies zu einem Problem. In der Basisimplementierung verlaufen die Residualverbindungen entlang des Query-Backbones. In unserem Fall ist Query keine lokale Darstellung des aktuellen Fensters, sondern angesammelte TQ-Vektoren – also globaler Speicher. Wenn wir denselben Speicher über den Pfad der Residualverbindungen leiten, riskieren wir ein Überschreiben des aktuellen lokalen Key/Value-Signals und die Unterdrückung wichtiger Features aus den Eingabedaten. Auf den Finanzmärkten wird sich dies schnell zeigen: Das Modell wird sich zunehmend auf den historischen Kontext stützen, schlechter auf frische Impulse reagieren, und die Genauigkeit wird sinken.
Daher verwenden wir bewusst die Low-Level-Logik für die Attention-Berechnung wieder, implementieren jedoch unsere eigene Logik für Residualverbindungen und die Normalisierung der Ergebnisse. Dadurch bleibt der Einfluss der aktuellen Daten erhalten, während bei der Berechnung der Attention-Gewichte gleichzeitig das globale TQ-Wissen genutzt wird.
Sobald die globalen Korrelationsvektoren aktiviert und aufbereitet sind, projizieren wir sie in den Query-Raum.
   if(!Q_Embedding.FeedForward(cParams.AsObject()))
      return false;
//---
   if(!KV_Embedding.FeedForward(NeuronOCL))
      return false;
Hier führt Q_Embedding eine lineare Projektion der globalen Korrelationen durch und verteilt diese auf die Attention-Heads.
Gleichzeitig werden Keys und Values auf Grundlage der von einem externen Programm empfangenen Quelldaten generiert. Daraus ergeben sich zwei Datenströme: globale Querys, die den „Speicher“ langfristiger Abhängigkeiten tragen, und lokale Key/Value-Ströme, die das aktuelle Marktverhalten widerspiegeln.
Der nächste Aufruf der geerbten Methode attentionOut ist für die Berechnung der Multi-Head-Attention zuständig. In dieser Phase wird eine standardmäßige MHA-Operation ausgeführt. Das Ergebnis ist eine pro Attention-Head berechnete Attention-Matrix, die in den gemeinsamen MHAttentionOut-Puffer aggregiert wird.
Wichtig ist, dass hier genau die Logik der Verknüpfung des Globalen (Query aus θTQ) und des Lokalen (Key/Value aus den Quelldaten) umgesetzt wird – dies ist das Herzstück des TQ-Ansatzes.
   if(!attentionOut())
      return false;
//---
   if(!W0.FeedForward(GetPointer(MHAttentionOut)))
      return false;
//---
   if(!SumAndNormilize(W0.getOutput(), NeuronOCL.getOutput(), AttentionOut.getOutput(), iWindow))
      return false;
Nachdem die Attention-Ergebnisse ermittelt wurden, durchlaufen sie die Ausgabeprojektion. Dies ist genau jene WO-Matrix, die die Ausgaben aller Attention-Heads wieder in die Dimensionalität des ursprünglichen Datenraums zusammenführt.
Anschließend werden die Daten aus den beiden Informationsströmen summiert und die resultierenden Werte normiert. Dies ist ein üblicher Schritt bei Residualverbindungen. Der Quelldatentensor wird zur Attention-Projektion addiert, woraufhin das Ergebnis über das iWindow-Fenster normalisiert wird. Diese Konstruktion stabilisiert den Lernprozess, bewahrt die Eingabeinformationen und verhindert eine Signaldämpfung. Die Normalisierung dient hier auch dem Schutz vor Verteilungsdrift, was bei finanziellen Zeitreihen mit variabler Volatilität kritisch ist.
Anschließend wird die MLP-Blocksequenz ausgeführt.
   if(!FF[0].FeedForward(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].FeedForward(GetPointer(FF[0])))
      return false;
//---
   if(!SumAndNormilize(FF[1].getOutput(), AttentionOut.getOutput(), Output, iWindow))
      return false;
//---
   return true;
  }
Dies sind zwei Schichten eines mehrschichtigen Perzeptrons mit einer intermediären Nichtlinearität (in unserer Implementierung haben wir GeLU verwendet). Im Wesentlichen erfüllen diese Schichten denselben Zweck wie die herkömmliche FeedForward-Schicht in Transformern: Sie erweitern die Darstellung, führen Nichtlinearität ein, verstärken nützliche Features und passen den Frequenzbereich an, in dem das Modell auf das Signal hört.
Schließlich kombiniert der zweite Aufruf von SumAndNormilize die Ausgabe des MLP mit der vorherigen Darstellung, normalisiert sie und liefert das Endergebnis. Mit diesem Schritt ist der gesamte Verarbeitungszyklus abgeschlossen: von der Extraktion globaler TQ-Vektoren bis hin zur Gewinnung einer angepassten und normalisierten Darstellung für die nächste Ebene des Modells.
Wenn alle Schritte erfolgreich waren, gibt die Methode true zurück, was bedeutet, dass der Vorwärtsdurchlauf korrekt abgeschlossen wurde und die Ergebnisse zur Verwendung bereitstehen.
Ein wichtiges architektonisches Detail ist die Abfolge von frühzeitigen Prüfungen und frühzeitigen Fehlerrückgaben: Das schont Ressourcen und verhindert inkonsistente Operationen mit OpenCL-Puffern, was in Produktionsumgebungen von entscheidender Bedeutung ist.
Um nahtlos an die Erörterung des Vorwärtsdurchlaufs anzuknüpfen, wenden wir uns nun der Spiegelphase zu – der Verteilung der Fehlergradienten innerhalb von CNeuronTQMHA. Hier verfolgen wir die umgekehrte Reihenfolge der Berechnungen: von den Ausgängen des Blocks zurück zu den Eingabedaten, wobei wir die Fehlersignale sorgfältig akkumulieren und auf alle Komponenten verteilen – das MLP, die Attention, die Projektionen und den globalen cParams-Speicher.
bool CNeuronTQMHA::calcInputGradients(CNeuronBaseOCL *prevLayer,
                                      CBufferFloat *SecondInput,
                                      CBufferFloat *SecondGradient,
                                      ENUM_ACTIVATION SecondActivation = None)
  {
   if(!prevLayer)
     return false;
Im Hauptteil der Methode überprüfen wir sofort, ob der Zeiger auf das Quelldatenobjekt gültig ist. Dieser Schritt bietet eine einfache, aber äußerst wichtige Sicherheitsvorkehrung. Wenn keine vorherige Ebene vorhanden ist, darf die sinnlose Berechnungskette nicht fortgesetzt werden.
Als Nächstes berechnen wir rückwärts die Gradienten entlang der MLP-Kette. Die internen Parameter des MLP erhalten den korrekten Fehlerbeitrag, und die Gradienten werden sorgfältig für die Weiterleitung weiter entlang der Kette aufbereitet.
   if(!FF[0].CalcHiddenGradients(FF[1].AsObject()))
      return false;
   if(!AttentionOut.CalcHiddenGradients(FF[0].AsObject()))
      return false;
Die folgende Codezeile leitet das Signal vom MLP zurück an die Stelle, an der das MLP seine Daten empfangen hat: AttentionOut. Mit anderen Worten: Wir sagen dem Attention-Block: Hier ist der Teil des Fehlers, der auf die Funktionsweise des MLP zurückzuführen ist; verteile ihn auf deine Eingaben. Dadurch wird die Konsistenz zwischen der nichtlinearen Verfeinerung der Darstellung und der durch Attention gebildeten Darstellung selbst gewährleistet.
Bevor wir jedoch fortfahren, müssen wir die Fehlergradienten des zweiten Informationsstroms der Residualverbindungen berechnen, den Gradienten für die W0-Projektion bilden und diesen weiter nach unten weiterleiten.
   if(!SumAndNormilize(FF[1].getGradient(), AttentionOut.getGradient(), W0.getGradient(),
                                                                         iWindow, false))
      return false;
   if(!MHAttentionOut.CalcHiddenGradients(W0.AsObject()))
      return false;
   if(!AttentionInsideGradients())
      return false;
Im nächsten Schritt wird der Gradient in die Multi-Head-Attention-Ausgabe übertragen, die vor der W0-Projektion gebildet wurde. Mit anderen Worten: Wir „wickeln“ die W0-Projektion zurück: Ihr Gradient wurde bereits berechnet, und nun müssen wir wissen, welche Fehler die Attention-Heads selbst erreichen.
Der Aufruf von AttentionInsideGradients ist ein zentraler Schritt zur Analyse der internen Details von Attention. Hier werden Gradienten in Bezug auf alle internen Komponenten des Attention-Mechanismus und letztendlich in Bezug auf die Tensoren Query, Key und Value berechnet. Dieser Schritt ist dafür verantwortlich, das aggregierte Fehlersignal aus dem Raum der aggregierten Attention-Heads in separate Beiträge für globale Queries und lokale Keys/Values umzuwandeln.
Als Nächstes leiten wir die akkumulierten Gradienten zurück an die Quelldaten weiter (prevLayer ist die lokale Eingabe). Wir rufen die entsprechende Methode auf, um den Fehler korrekt auf die Gewichte zu verteilen und die Gradienten für prevLayer selbst vorzubereiten.
   if(!prevLayer.CalcHiddenGradients(KV_Embedding.AsObject()))
      return false;
   if(!cParams.CalcHiddenGradients(Q_Embedding.AsObject()))
      return false;
Parallel dazu spiegeln wir die Handhabung des globalen Speichers: Die für Queries (Query) ermittelten Gradienten werden an cParams übergeben. Somit wirkt sich das Training nicht nur auf die lokalen Projektionen aus, sondern auch auf die Parameter des globalen Korrelationsspeichers selbst: θTQ erhält ordnungsgemäß seinen Anteil des Fehlers, der dann zur Aktualisierung der Gewichte verwendet wird.
Nachdem wir die Beiträge aufgeteilt haben, müssen wir den Fehlergradienten der Quelldaten durch Werte aus dem Eingabedatenpfad ergänzen. Zunächst skalieren wir sie jedoch mit der Ableitung der Aktivierungsfunktion der vorhergehenden Schicht. Erst danach können die Ergebnisse der beiden Informationsströme addiert werden.
   if(!DeActivation(prevLayer.getOutput(), W0.getPrevOutput(), W0.getGradient(),
                                                                    prevLayer.Activation()))
      return false;
   if(!SumAndNormilize(prevLayer.getGradient(), W0.getPrevOutput(), prevLayer.getGradient(),
                                                                          iWindow_K, false))
      return false;
//---
   return true;
  }
Dies ist ein wichtiger Schritt: Er stellt sicher, dass der an prevLayer übergebene endgültige Gradient sowohl den Einfluss der lokalen Eingabe als auch den Beitrag der W0-Projektion berücksichtigt, der im Hinblick auf die im Vorwärtsdurchlauf angewandte Normalisierung korrekt verteilt wurde.
Sobald alle diese Schritte erfolgreich abgeschlossen sind, signalisiert die Methode, dass die Gradienten korrekt auf alle internen Komponenten des Moduls verteilt wurden und dass das Modul für den Schritt der Gewichtsaktualisierung bereit ist.
Sobald die Fehlergradienten sorgfältig auf alle internen Strukturen des Neurons verteilt wurden, besteht der nächste naheliegende und logische Schritt bei ihrer praktischen Anwendung darin, die Parameter zu aktualisieren. Die Methode updateInputWeights schließt den Trainingszyklus ab. Sie nimmt die berechneten Gradienten und wendet sie nacheinander auf die Projektionen, das MLP und – was am wichtigsten ist – auf den globalen Korrelationsspeicher selbst an.
Der von uns verwendete modulare Ansatz ermöglicht es, eine recht kompakte Methode zur Aktualisierung von Parametern zu entwickeln. Wir übergeben die Steuerung einfach nacheinander an die gleichnamigen Methoden der internen Objekte und verwenden dabei die korrekten Zeiger auf die entsprechenden Quelldatenpuffer.
bool CNeuronTQMHA::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cParams.UpdateInputWeights())
      return false;
   if(!Q_Embedding.UpdateInputWeights(cParams.AsObject()))
      return false;
   if(!KV_Embedding.UpdateInputWeights(NeuronOCL))
      return false;
   if(!W0.UpdateInputWeights(GetPointer(MHAttentionOut)))
      return false;
   if(!FF[0].UpdateInputWeights(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].UpdateInputWeights(GetPointer(FF[0])))
      return false;
//---
   return true;
  }
Die Methode updateInputWeights bildet einen sorgfältigen und wohlüberlegten Abschluss des Trainingszyklus. Dadurch wird sichergestellt, dass der globale Korrelationsspeicher und alle seine Abbildungen sowie die nachgelagerten Transformationen korrekte und konsistente Aktualisierungen erhalten, was für den stabilen und zuverlässigen Einsatz von TQNet bei Aufgaben zur Prognose finanzieller Zeitreihen besonders wichtig ist.
Der vollständige Quellcode für die Klasse CNeuronTQMHA und alle ihre Methoden ist im Anhang enthalten.
Modellarchitektur
Nachdem wir alle wesentlichen Komponenten des TQNet-Frameworks zusammengestellt haben, gehen wir zur nächsten Phase über: der Beschreibung der Architektur der trainierbaren Modelle. Wie bisher ist es unser Ziel, ein Handelssystem zu entwickeln, das in der Lage ist, Marktbedingungen eigenständig zu analysieren und Handelsentscheidungen zu treffen. Das Training erfolgt im Rahmen des Actor-Critic-Paradigmas, wobei TQNet als Encoder für den Umgebungszustand fungiert. Es bildet eine kompakte, informative Darstellung der aktuellen Marktsituation, auf die sich der Actor bei der Auswahl von Aktionen stützt und die der Critic zur Bewertung ihrer Qualität verwendet.
Im Gegensatz zur ursprünglichen Version von TQNet haben wir das Modell hinsichtlich der Datenaufbereitung und der Feature-Generierung erweitert: Wir haben Blöcke zur Datenvorverarbeitung und Aggregation von Kontextinformationen hinzugefügt, wodurch die Robustheit und die Generalisierungsfähigkeit des Systems verbessert werden. Die Erstellung von Beschreibungen der Modellarchitektur erfolgt in der Methode CreateDescriptions. Diese Methode bildet die grundlegende Abfolge von Schichten, auf der die gesamte nachfolgende Trainings- und Inferenzlogik basiert.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Die Methode beginnt mit einem einfachen, aber wichtigen Schritt: Wenn die Zeiger auf die Schichtcontainer null sind, werden neue Objekte erstellt. Das ist nicht nur eine Formalität – wir stellen sicher, dass jeder der drei Architekturblöcke über eine eigene, unabhängige Sammlung von Schichtbeschreibungen verfügt, die nacheinander befüllt werden kann. Diese explizite Allokation sorgt für Transparenz. Der folgende Code kann davon ausgehen, dass der Container vorhanden ist, und muss dessen Gültigkeit nicht an mehreren Stellen überprüfen.
Als Nächstes erstellen wir den Encoder – das zentrale Element unseres Modells. Wir leeren den Container und fügen nacheinander Schichtbeschreibungen hinzu, wobei jeder Schritt von einer strengen Erfolgsprüfung begleitet wird: Sollte das Erstellen eines Objekts oder dessen Hinzufügen zum Array aus irgendeinem Grund fehlschlagen, gibt die Methode die Ressourcen sorgfältig frei und gibt einen Fehler zurück. Diese Disziplin bei der Verwaltung von Speicher und Zustand ist sowohl beim Debugging als auch im Produktivbetrieb nützlich – sie verhindert die Ausbreitung von Problemen durch den Stack.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die erste Schicht des Encoders ist eine Basis-Neuronenschicht vom Typ CNeuronBaseOCL; die Anzahl der Neuronen wird als Produkt aus HistoryBars * BarDescr festgelegt. Der Ansatz ist hier klar: Wir speisen ein historisches Fenster in das Netzwerk ein, aufgeschlüsselt nach beschreibenden Features. Diese Schicht enthält keine Aktivierungsfunktion – sie dient als Gateway, als Puffer, an den wir die Eingabedaten einfach weiterleiten.
Der nächste Block – CNeuronBatchNormWithNoise – behält die Dimensionalität der vorherigen Schicht bei, fügt jedoch Normalisierung und Regularisierung durch Rauschen hinzu. Das ist nicht nur ein kosmetisches Detail: Finanzielle Zeitreihen unterliegen Verteilungsdrift und weisen Ausreißer auf. BatchNorm mit Rauschen verbessert die Robustheit gegenüber solchen Anomalien, normalisiert die Eingaben für nachfolgende Schichten und hält das Modell zugleich dazu an, eine Überanpassung an kleine, zufällige Schwankungen zu vermeiden.
Nach der Normalisierung fahren wir damit fort, die zeitliche Struktur mithilfe von CNeuronConcatDiff zu transformieren. Diese Schicht erfasst den Verlauf nach Balken, legt dabei jedoch den Schwerpunkt auf Differenzen mit einer Schrittweite von (step = 1) und liefert so eine explizite Darstellung der Dynamik – nicht nur der Niveaus, sondern auch ihrer Veränderungen. Diese Technik ermöglicht dem Modell oft eine bessere Darstellung von Trendimpulsen, Momentum und lokalen Umkehrpunkten.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes folgt die CMamba4CastEmbeding-Schicht, die eine Mehrfensterlogik für sinusförmige Zeitstempel-Embeddings implementiert. Dadurch kann das Modell kurzfristige und langfristige Muster gleichzeitig berücksichtigen und so eine reichhaltige Repräsentation des Marktzustands bilden.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_D1), PeriodSeconds(PERIOD_MN1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
An dieser Stelle sei angemerkt, dass die vorangegangenen Operationen in der Darstellung einer multivariaten Zeitreihe durchgeführt wurden. Damit das TQNet-Framework jedoch korrekt funktioniert, benötigen wir eine Sequenz univariater Zeitreihen. Daher transponieren wir im nächsten Schritt den Tensor und ordnen die Dimensionen für die anschließende Anwendung von Attention neu an.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
Und nun kommen wir zum Kern der Sache – der CNeuronTQMHA-Schicht. Hier legen wir die Periodenlänge auf 24*7 fest, was einer Kalenderwoche im H1-Timeframe entspricht. Und die Schrittweite entspricht der Anzahl der Sekunden in einem Balken des angegebenen Timeframes. Wir möchten, dass das TQ-Karussell wöchentliche Muster speichert und sie in Schritten des stündlichen Timeframes abruft.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTQMHA;
     {
      uint temp[] = {prev_out, 64, 24*7, PeriodSeconds(PERIOD_H1)};
                   // window, window_key, period, timeframe
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.step=NHeads;
   descr.count=prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint count = prev_count;
   uint window = prev_out;
Bitte beachten Sie, dass wir eine Kalenderwoche (7 Tage) zugrunde legen, auch wenn das analysierte Finanzinstrument an Wochenenden nicht gehandelt wird. Dies ist eine notwendige Maßnahme, da wir das Karussellelement anhand der Eröffnungszeit des Balkens berechnen.
Als Nächstes folgt eine Faltungsschicht mit einer TANH-Aktivierungsfunktion, die dazu dient, die resultierenden Repräsentationen zu komprimieren und auf einen festgelegten Prognosehorizont abzubilden. In dieser Phase wird eine reichhaltige Repräsentation in konkrete Prognosesignale umgewandelt.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = NForecast;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.count;
Anschließend wird eine weitere Transposition durchgeführt, um die Daten wieder in eine multivariate Sequenzdarstellung zu überführen, die den Originaldaten ähnelt.
Eine weitere Faltung soll die Dimensionalität der Features auf das Niveau der Originaldaten reduzieren.
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Diese Faltungsschichten fungieren als lokale Aggregatoren – sie sammeln Informationen aus den verschiedenen Prognosekomponenten und erzeugen eine Darstellung, die für die Denormalisierung bereit ist.
Der Encoder wird durch den Layer CNeuronRevInDenormOCL vervollständigt. Dieses Modul bringt die Prognosen wieder auf ihre ursprüngliche Skala zurück und stellt dabei den Mittelwert und die Varianz der analysierten Daten wieder her, die während der Datenvorverarbeitung entfernt wurden.
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count*prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Für Finanzanwendungen ist dies von entscheidender Bedeutung: Prognosen müssen auf einer Skala vorliegen, die interpretierbar und für den Handel sowie die Risikoberechnung geeignet ist.
Ein Leitgedanke zieht sich durch das gesamte Konstrukt: Zunächst werden die Eingabedaten sorgfältig aufbereitet und normalisiert, dann werden dynamische Features und Embeddings auf verschiedenen Skalen extrahiert, anschließend wird die TQ-erweiterte Attention angewendet, und schließlich werden die vorhergesagten Werte aggregiert und unter Wiederherstellung der Skalierung in den ursprünglichen Datenraum projiziert.
Die Architekturen der Modelle Actor und Critic wurden unverändert aus früheren Arbeiten übernommen; auf ihre detaillierte Erörterung werden wir hier daher nicht weiter eingehen. Der vollständige architektonische Aufbau aller trainierbaren Modelle ist im Anhang enthalten.
Tests
Der Trainingsprozess gliedert sich in zwei aufeinanderfolgende und sich ergänzende Phasen – dies bietet sowohl eine solide Grundlage als auch die nötige Flexibilität, um unter realen Marktbedingungen zu agieren.
In der ersten Offline-Phase haben wir ein gründliches Training anhand historischer Daten für das Währungspaar EURUSD im H1-Timeframe für das gesamte Jahr 2024 durchgeführt. Dieses Jahr umfasste die gesamte Bandbreite an Marktregimen – ruhige Seitwärtsmärkte, stabile Trends, plötzliche Volatilitätssprünge und Phasen mit erhöhtem Rauschen – und wurde dadurch zu einem hervorragenden Trainingsfeld für das Modell.
Die zweite Phase ist die Online-Feinabstimmung. Das Training wurde in einer Umgebung durchgeführt, die dem Live-Trading so nahe wie möglich kam: Im Strategietester von MetaTrader 5 verarbeitete das Modell den Strom von Kerzen nacheinander, genau wie in Echtzeit. Der Online-Modus zeigt völlig andere Eigenschaften als Batch-Training: die Fähigkeit, Rauschen standzuhalten, auf Veränderungen der Liquidität zu reagieren und Verzögerungen sowie die Auswirkungen von End-to-End-Slippage korrekt zu berücksichtigen. Während der Online-Feinabstimmung simulierten wir reale Ausführungsbedingungen, damit das Verhalten des Modells bei der Übertragung auf das Live-Trading vorhersehbar bleibt.
Die letzte – und vielleicht strengste – Phase war der Test auf vollständig separaten Out-of-Sample-Daten: Kursnotierungen von Januar bis März 2025. Alle Modellparameter und Hyperparameter blieben eingefroren; es wurde keine zusätzliche Anpassung auf Basis dieser Daten vorgenommen. Diese Art der Validierung liefert ein objektives Bild der praktischen Wirksamkeit: Sie spiegelt die Fähigkeit des Algorithmus wider, unter neuen Bedingungen vorhersehbar und robust zu bleiben.
Die Testergebnisse sind unten aufgeführt.
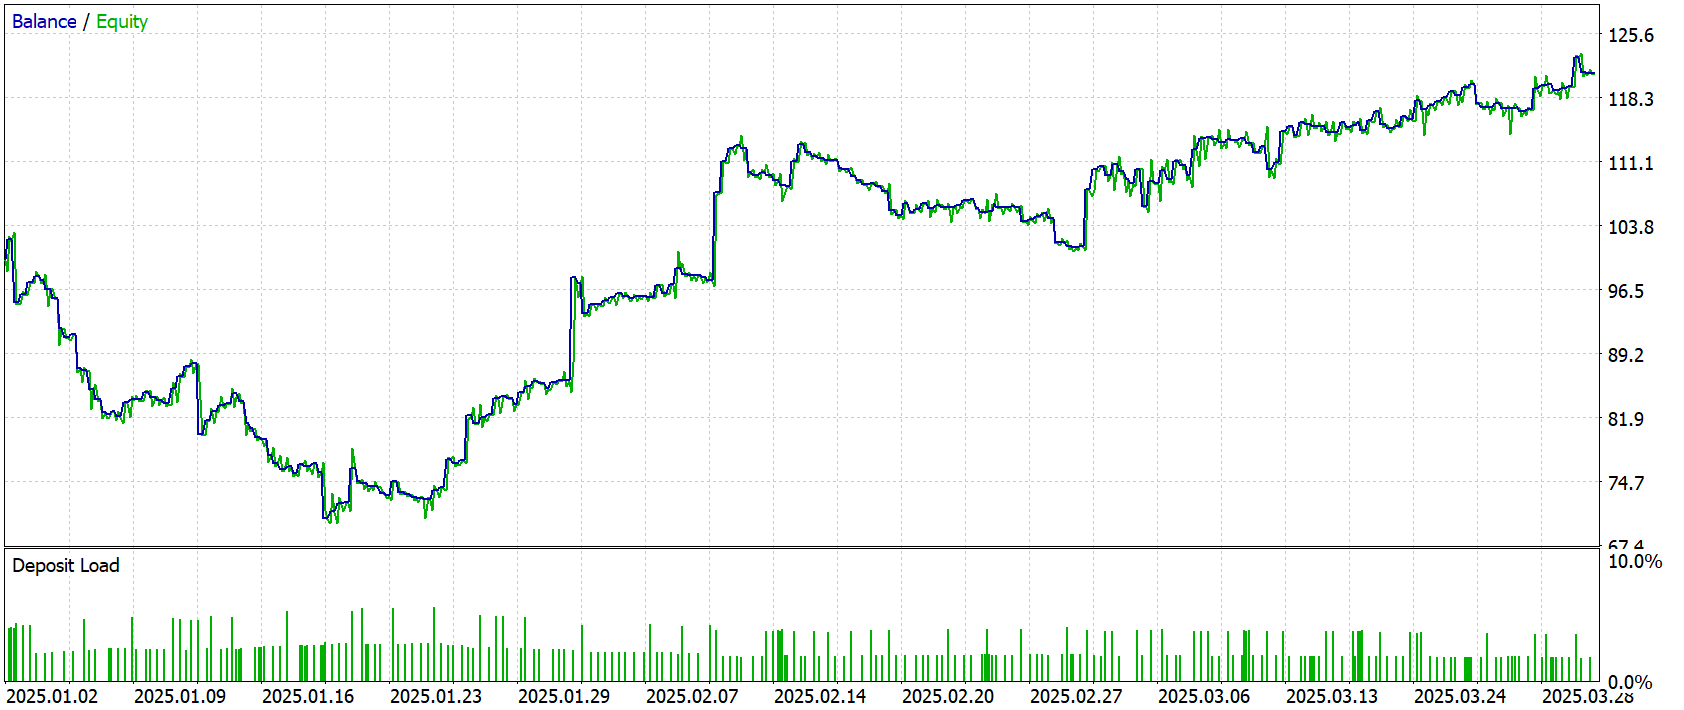
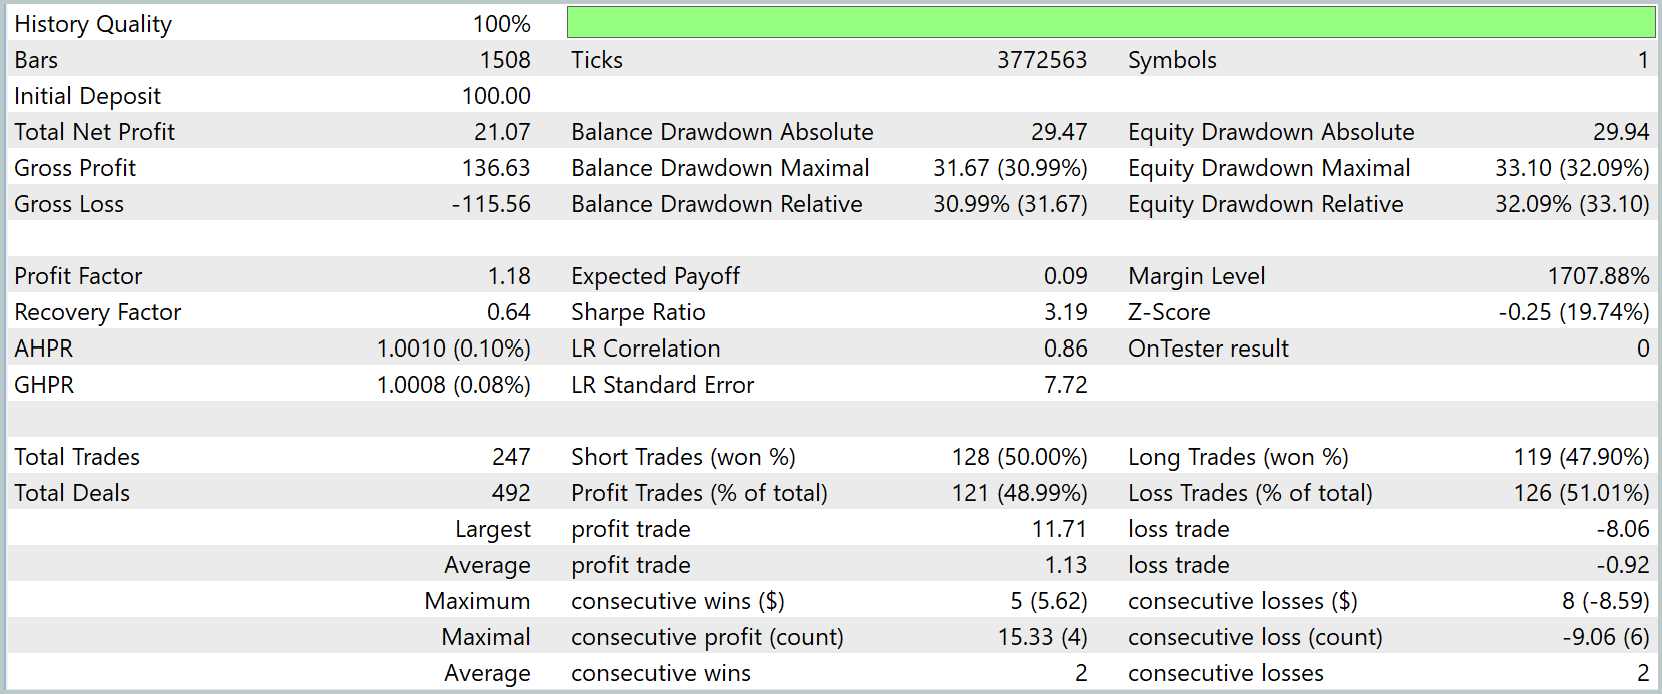
Die Testergebnisse zeigten einen eher geringen positiven statistischen Vorteil. Bei einer Anfangseinlage von 100 Dollar betrug der Nettogewinn 21,07 Dollar. Der Anteil profitabler Trades lag nahe bei 49 %. Zudem wurden Short-Positionen etwas häufiger mit Gewinn abgeschlossen als Long-Positionen. Der durchschnittliche Gewinn pro profitablem Trade betrug 1,13 Dollar, während der durchschnittliche Verlust bei 0,92 Dollar lag. Ein Profitfaktor von 1,18 bei einer erwarteten Rendite von 0,09 Dollar pro Trade deutet darauf hin, dass die Sicherheitsmarge minimal ist.
Eine lineare Regression der Equity-Kurve zeigt eine Korrelation von 0,86, der Fehler bleibt jedoch spürbar. Dies bestätigt, dass die Ergebnisse mit Rauschen behaftet sind.
Das Risikoprofil ist noch weit davon entfernt, optimal zu sein. Tiefe Drawdowns in Verbindung mit einer geringen erwarteten Rendite pro Trade machen es unmöglich, das Kapital sicher zu vermehren. Die Margin-Belastung ist in diesem Fall gering; das Problem liegt daher nicht in der Positionsgröße, sondern in der Qualität der Einstiegspunkte und der Ausstiegsdisziplin.
Fazit
In diesem Beitrag haben wir die theoretischen Grundlagen des TQNet-Frameworks sowie die Besonderheiten seiner Integration in die Architektur trainierbarer Handelsmodelle eingehend untersucht. Die grundlegenden Prinzipien, die der Konzeption der Module zugrunde liegen – darunter modifizierte Cross-Attention-Mechanismen –, wurden analysiert, wodurch eine flexiblere und stabilere Algorithmusleistung unter den Bedingungen der Finanzmärkte erreicht werden konnte.
Im praktischen Teil des Projekts haben wir die in TQNet vorgeschlagenen Ansätze mithilfe von MQL5 umgesetzt und sie durch eigene Verbesserungen bei der Feature-Generierung und der Datenvorverarbeitung ergänzt. Das Modell wurde in zwei Phasen trainiert: anhand historischer Daten (Offline-Training) und unter Bedingungen nahe am realen Markt (Online-Feinabstimmung im Strategietester von MetaTrader 5).
Abschließende Tests mit neuen, zuvor nicht verwendeten Kursnotierungen zeigten eine positive Dynamik. Die Kontostandskurve des Handelskontos zeigte nach einem anfänglichen Drawdown ein stetiges Wachstum, was die Fähigkeit des Algorithmus unterstreicht, sich an veränderte Marktbedingungen anzupassen.
Die Ergebnisse bestätigen, dass TQNet in Kombination mit verfeinerten Architekturlösungen und einem zweistufigen Trainingsprozess einen positiven Erwartungswert liefern kann.
Literaturverzeichnis
- Temporal Query Network for Efficient Multivariate Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Aufbau eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19181
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Trauminspirierter Optimierungsalgorithmus (DOA)
 Neuronale Netze im Trading: Das Temporal-Query-Modell (TQNet)
 Marktsimulation: Positionsanzeige (VII)
 Duellanten-Algorithmus

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.