

Neuronale Netze im Trading: Heterogenitätsbasiertes Lernen von Metaparametern (HimNet)
 15
 0

Einleitung
Das Aufkommen einer Vielzahl von Tools zur Erfassung von Streaming-Daten hat in den unterschiedlichsten Bereichen menschlicher Tätigkeit zu einer umfangreichen Ansammlung räumlich-zeitlicher Reihen geführt. Handelssysteme generieren Ströme von Kursnotierungen, Orders und Trades über verschiedene Handelsplätze, Ticker und Instrumententypen hinweg. Angesichts wachsender Datenmengen wird die genaue Prognose solcher Zeitreihen zu einem Instrument zur Kostensenkung, zum Risikomanagement und zur Verbesserung der Ausführung von Handelsstrategien. Ein Fehler bei der Prognose der lokalen Liquidität oder Volatilität führt unmittelbar zu Slippage, entgangenen Gewinnen und verzerrten Leistungskennzahlen für eine Handelsstrategie. Daher muss ein hochwertiges Modell nicht nur globale Trends berücksichtigen, sondern auch lokale, kontextspezifische Unterschiede: wo und in welchen Marktphasen der Markt eng und in welchen er weit ist.
Die zentrale Herausforderung ist die räumlich-zeitliche Heterogenität der Daten. Räumliche Heterogenität im Markt zeigt sich, wenn verschiedene Handelsplätze oder Assets gleichzeitig unterschiedliche Muster aufweisen. Beispielsweise können einige Börsen über eine hohe Liquidität verfügen, während an anderen Arbitrage-Lücken auftreten können, insbesondere in Zeiten hoher Volatilität. Unter diesen Umständen führt der Versuch, das Verhalten aller Handelsplätze zu mitteln, dazu, dass wichtige lokale Effekte geglättet werden und Genauigkeit verloren geht.
Die zeitliche Heterogenität ist ausgeprägter, als es auf den ersten Blick den Anschein hat. Das Verhalten desselben Finanzinstruments variiert je nach Tageszeit und Kalendertag erheblich. Die Eröffnung und Schließung einer Handelssitzung sind zwei eindrucksvolle Beispiele: In den ersten Minuten nach der Eröffnung kommt es zu einem sprunghaften Anstieg des Volumens und der Volatilität, während die Aktivität am späten Abend hingegen gering ist. Nachrichten und makroökonomische Ankündigungen lösen kurzfristige Regime extremer Volatilität aus. Feiertage und Wochenenden führen zu einer Flaute bei der Aktivität. Insgesamt bedeutet dies, dass dasselbe Muster nicht als zeitlich stationär betrachtet werden kann – seine statistischen Eigenschaften ändern sich, und das Modell muss dies berücksichtigen.
Bisher vorgeschlagene Ansätze haben versucht, das Problem auf verschiedene Weise anzugehen, doch jeder von ihnen hat seine Grenzen, wenn es um die praktische Anwendung im Handel geht. Graphbasierte Methoden stützten sich auf die Topologie und vorab berechnete Ähnlichkeitsmaße zwischen Datenpunkten – ähnlich wie ein Händler, der seine Strategie ausschließlich auf eine im Voraus erstellte Liquiditätskarte stützt. In der Praxis ist die Karte schnell veraltet: Die Zusammensetzung der Market Maker ändert sich, neue Handelsplätze entstehen und es kommt zu vorübergehenden Liquiditätslücken.
Meta-Learning-Verfahren lieferten die Idee, mehrere Parametersätze für verschiedene Regime zu speichern, erforderten jedoch häufig externe Informationen. Im Finanzwesen bedeutet dies, dass für jeden Handelsplatz und jedes Finanzinstrument verfügbare und genaue Metadaten benötigt werden. Es ist jedoch nicht immer möglich, diese Daten in Echtzeit zu erhalten. Zudem sind viele dieser Ansätze zu speicherintensiv und rechenaufwendig.
Repräsentationsbasierte Ansätze (Representation Learning) können informative Einbettungen aus Rohdaten extrahieren. Das ist zwar leistungsstark, doch häufig folgt darauf eine vereinfachte Verarbeitung der Einbettungen, wodurch der Wert einer guten Repräsentation im nächsten Schritt verloren geht. Self-Supervised Learning fügt Hilfsaufgaben hinzu, um die Einbettungen aussagekräftiger zu machen – das ist nützlich, ermöglicht es jedoch nicht immer, das Modell innerhalb eines einzigen Zyklus optimal für die Zielaufgabe der Prognose zu trainieren.
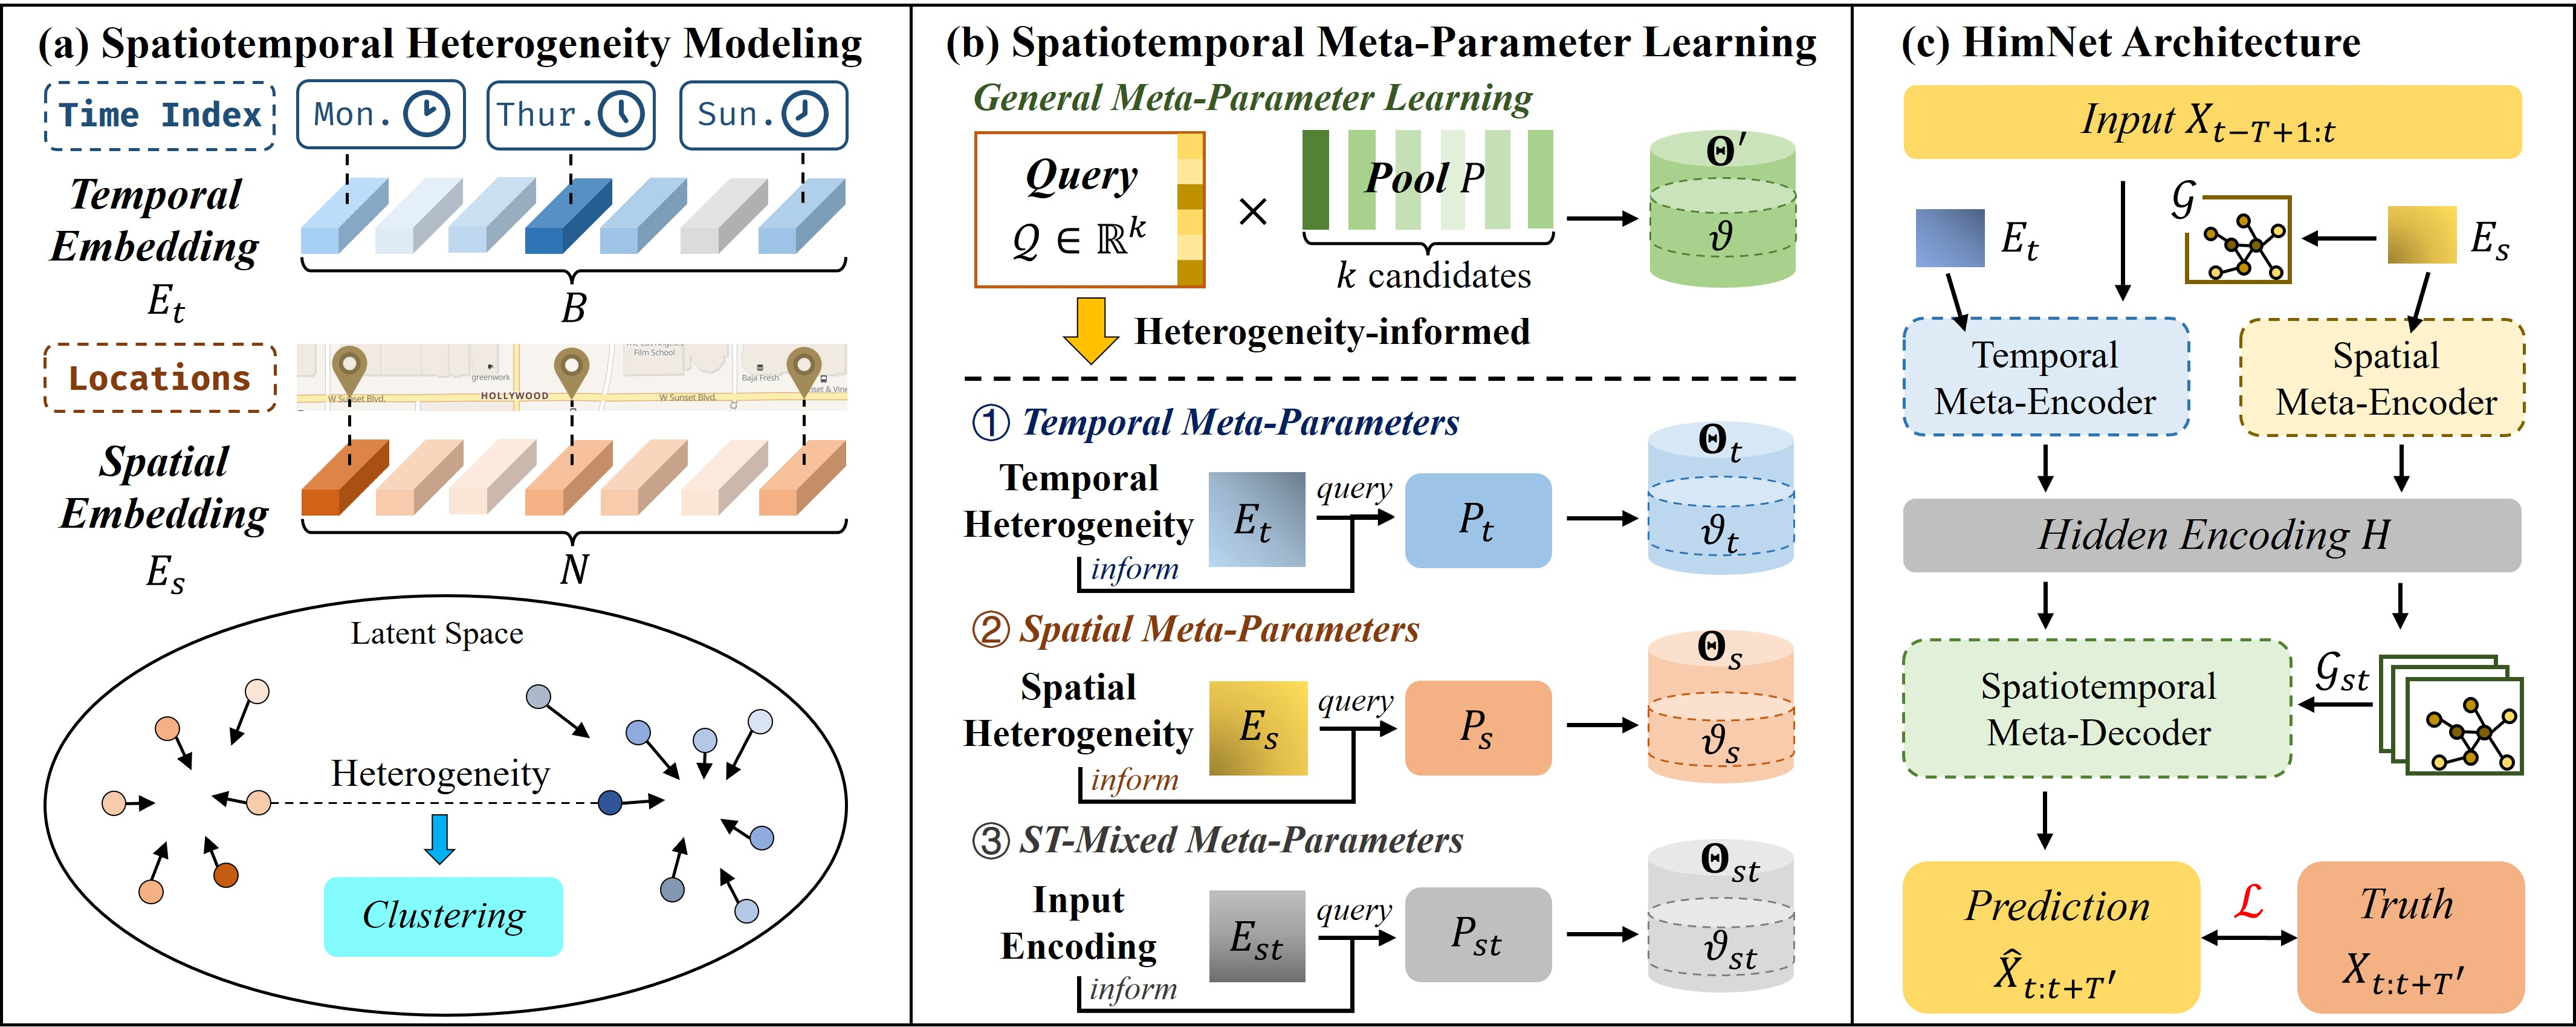
Genau aus diesem Grund haben die Autoren des Artikels „Heterogeneity-Informed Meta-Parameter Learning for Spatiotemporal Time Series Forecasting“ einen anderen Ansatz vorgeschlagen – das HimNet-Framework. Ihre Lösung vereint zwei wesentliche Komponenten. Zunächst wird die Heterogenität implizit durch trainierbare räumliche und zeitliche Einbettungen ermittelt, und anschließend werden diese Informationen für das Meta-Parameter-Lernen der Modellparameter genutzt. Einfach ausgedrückt: Die Entwickler des Frameworks wollen nicht nur Unterschiede zwischen einzelnen Datensegmenten erkennen, sondern das Modell auch so trainieren, dass es für jeden Kontext spezifische Parameter auswählt und generiert.
Stellen Sie sich vor, der Pool an Handelsinformationen enthält:
- Aktien des größten Emittenten an der Hauptbörse während der Handelszeiten;
- dieselben Aktien auf außerbörslichen Handelsplätzen nach einer lokalen Nachrichtenwelle;
- Small-Cap-Wertpapiere mit geringer Liquidität;
- Kryptomärkte mit unterschiedlicher Orderbuchtiefe.
Durch räumliche Einbettungen werden diese Gruppen in unterschiedliche Cluster unterteilt. Das System ruft anschließend für jeden Cluster einen eigenen Parametersatz aus dem Meta-Parameter-Pool ab: aggressive Einstellungen für den Hauptmarkt , die eine geringe Slippage berücksichtigen, konservative Einstellungen für den OTC-Handel, um die Sicherheitsmarge bei der Ausführung zu erhöhen, eine stärkere Regularisierung für Small-Cap-Wertpapiere , um Overfitting an Rauschen zu vermeiden, sowie eine rauschrobuste Konfiguration für Kryptomärkte, die auf hohe Rauschpegel und häufige Arbitrage-Lücken ausgelegt ist. All dies wird in einem einzigen Zyklus trainiert, sodass das Modell lernt, zwischen verschiedenen Kontexten zu unterscheiden und gleichzeitig die besten Parameter für diese auszuwählen.
Zeitliche Beispiele sind ebenso wichtig. Die Eröffnung des Marktes am Morgen erfordert oft eine schnelle Reaktion und kurzfristige Volumenprognosen. Die Zeiträume nach der Veröffentlichung wichtiger makroökonomischer Daten sind ein Regime erhöhter Volatilität. Die späten Stunden sind ein Regime geringer Aktivität. Der von den Autoren des Frameworks vorgeschlagene Meta-Parameter-Mechanismus kann separate Parametersätze für zeitliche Regime zuweisen. Das ist vergleichbar damit, wie ein erfahrener Trader seinen Handelsstil je nach Tageszeit und Kalendertag anpasst.
Technisch gesehen besteht der Kerngedanke darin, Einbettungen zu clustern und Parameter mithilfe eines kleinen, recheneffizienten Pools von Meta-Parametern dynamisch zu quantisieren. Damit lassen sich gleich mehrere Probleme früherer Ansätze auf einen Schlag lösen. Erstens besteht keine strikte Abhängigkeit von externen Hilfsmerkmalen – das Modell erkennt relevante Kontexte selbstständig. Zweitens ist der Pool von Meta-Parametern kompakt, sodass der Speicher- und Rechenressourcenverbrauch überschaubar bleibt, was für Systeme wichtig ist, die eine geringe Ausführungslatenz erfordern. Drittens gehen die Autoren des Frameworks von der passiven Erfassung von Heterogenität zu deren aktiver Nutzung über: Cluster bestimmen direkt, welche Parameter angewendet werden. Dies erhöht die Genauigkeit der Prognosen und verbessert die Ausführungsqualität.
Die Interpretierbarkeit verdient eine besondere Erwähnung. Meta-Parameter und Cluster lassen sich visualisieren: Eine Clusterkarte zeigt, welche Handelsplätze und welche Zeitfenster zum selben Regime gehören; eine Heatmap der Meta-Parameter veranschaulicht, wie sich die Einstellungen zwischen Regimen mit geringer und hoher Volatilität unterscheiden. Für Praktiker ist dies nicht nur eine anschauliche Grafik, sondern auch ein Überwachungsinstrument: Wenn ein Cluster unerwartet Handelsplätze umfasst, die sich grundlegend voneinander unterscheiden, ist dies ein Signal, eine zusätzliche Datenvalidierung durchzuführen oder das Vorverarbeitungsverfahren zu überprüfen.
Und schließlich: Robustheit und Übertragbarkeit. Ein wichtiges Merkmal des HimNet-Frameworks ist seine domänenübergreifende Flexibilität. Meta-Parameter und Einbettungen werden so trainiert, dass sie mit minimalem Feintuning auf andere Instrumente und Handelsplätze angewendet werden können.
Letztendlich bietet das HimNet-Framework eine praktische und effektive Möglichkeit, räumlich-zeitliche Regime zu identifizieren, bildet einen kompakten Pool von Meta-Parametern und trainiert das Modell darauf, die gewonnenen Informationen zu nutzen. Damit steht Tradern und Entwicklern von Prognosesystemen ein Werkzeug zur Verfügung, das gleichzeitig die Genauigkeit verbessert, die Recheneffizienz wahrt und die Interpretierbarkeit erhöht.
Der HimNet-Algorithmus
Ein wesentlicher Aspekt bei der Modellierung räumlich-zeitlicher Heterogenität ist die korrekte Identifizierung und Trennung des Quelldatenkontexts entlang der zeitlichen und räumlichen Dimensionen. Anstatt auf externe Referenzdaten zurückzugreifen, erstellen die Autoren des HimNet-Frameworks trainierbare Einbettungen, die jedem räumlich-zeitlichen Kontext eine eindeutige Repräsentation zuweisen. Dadurch erhält das Modell die Flexibilität und Anpassungsfähigkeit, die zur Lösung praxisnaher Finanzprobleme erforderlich sind.
Für die zeitliche Dimension erstellen die Autoren des Frameworks zwei „embedding dictionaries“:
- Tageszeit-Wörterbuch Dtod ∈ RNd × dtod;
- Wochentag-Wörterbuch Ddow ∈ RNw × ddow.
Dabei sind dtod und ddow die Dimensionen der entsprechenden Vektoren, Nd die Anzahl der Schritte innerhalb eines Handelstages und Nw die Anzahl der Tage in einer Woche.
Für einen Mini-Batch von Eingabedaten Xb ∈ RB×T×N mit der Verlaufslänge T schlagen die Autoren des Frameworks vor, den Zeitstempel des letzten Schritts jedes Samples zu verwenden, um zeitliche Einbettungen Etod ∈ RB×dtod und Edow ∈ RB×ddow aus den Wörterbüchern auszuwählen. Anschließend werden diese zu einer gemeinsamen zeitlichen Einbettung konkateniert.
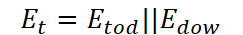
Der praktische Grund für diese Trennung ist einfach. Die Tageszeit erfasst eine hochauflösende Periodizität: morgendliche Ausschläge zur Markteröffnung, eine Mittagsflaute und die abendliche Handelssitzung. Der Wochentag erfasst längere Zyklen: das Verhalten an Wochentagen und Wochenenden sowie wiederkehrende Muster im Zusammenhang mit Berichtsterminen und der Veröffentlichung von Konjunkturdaten. Gemeinsam ermöglichen diese Wörterbücher dem Modell, zeitliche Regime über mehrere Skalen hinweg zu erkennen und dafür geeignete Prognoseparameter auszuwählen.
Für die räumliche Dimension verwenden die Autoren des Frameworks eine räumliche Einbettungsmatrix Es ∈ RN*ds, wobei N die Anzahl der Zeitreihen oder Standorte und ds die Vektordimension für jeden Standort ist. Im Gegensatz zu zeitlichen Wörterbüchern ist hier jedes räumliche Element direkt mit einem eigenen, trainierbaren Vektor verknüpft, der zufällig initialisiert wird. Ziel ist es, die funktionalen Unterschiede zwischen Handelsplätzen zu erfassen, die sich auf Zeitreihenmuster auswirken: Orderbuchtiefe, Ausführungsgeschwindigkeit, Teilnehmerprofile, Instrumententypen und Infrastrukturmerkmale. Dadurch lässt sich die räumliche Heterogenität berücksichtigen, ohne explizit auf Hilfsmerkmale zurückzugreifen.
Bei dieser Art des Einbettungstrainings wird im Wesentlichen ein dynamisches Clustering durchgeführt. Während des Trainings entwickeln sich die Repräsentationen in den Matrizen allmählich auseinander und bilden je nach Eingabedaten Cluster. Einbettungen, die mit räumlich-zeitlichen Kontexten assoziiert sind, die ein ähnliches Verhalten aufweisen, rücken im latenten Raum näher zusammen. Diejenigen mit unterschiedlicher Dynamik driften auseinander. Infolgedessen entstehen natürliche Cluster – typische Verhaltensregime. Das ist vergleichbar mit Sprachmodellen, bei denen sich herausstellt, dass „König“ und „Königin“ semantisch nahe beieinander liegen. Nur hier spiegelt die Nähe die Ähnlichkeit der Marktregime wider. Wichtig ist, dass diese Clusterbildung organisch entsteht, ohne starre externe Einschränkungen oder manuelles Labeling. Das Modell lernt selbstständig, welche Kontexte ähnlich sind und welche nicht.
Betrachten wir einige Beispiele aus dem Finanzbereich etwas genauer, um konkreter zu veranschaulichen, wie dies in der Praxis funktioniert. Betrachten wir einige typische Kontexte:
- Die Eröffnung der Haupthandelssitzung am Aktienmarkt. Hohe Handelsaktivität, große Volumina, rasche Kursschwankungen. Für solche zeitlichen und räumlichen Kombinationen bestimmt das Modell eine spezifische Einbettung und wählt Parameter aus, die auf kurze Zeithorizonte und schnelle Reaktionen ausgerichtet sind – dies ist wichtig für Algorithmen mit schneller Ausführung und zur Verringerung der Slippage.
- Außerbörslicher Handel mit denselben Wertpapieren während der Nacht. Geringe Handelsvolumina, seltene Transaktionen und ein erhöhtes Risiko starker Kursschwankungen, die durch einzelne Orders verursacht werden. Hier unterscheiden sich die zeitlichen Einbettungen, und die Meta-Parameter sorgen dafür, dass das Modell konservativer wird, was die Robustheit erhöht und die Wahrscheinlichkeit von Overfitting gegenüber Rauschen verringert.
- Kryptowährungsbörsen mit unterschiedlicher Orderbuchtiefe. Eine Börse verfügt über hohe Liquidität, während eine andere geringe Liquidität und ein Arbitrage-Profil aufweist. Räumliche Einbettungen werden diese Handelsplätze voneinander trennen, und das Modell wird unterschiedliche Strategien für die Prognose von Volumen und Preis anwenden, was für Arbitrage-Systeme nützlich ist.
- Tage mit wichtigen makroökonomischen Veröffentlichungen oder Quartalsberichten. Zeitliche Einbettungen für den Wochentag werden zusammen mit der Tageszeit solche Zeitfenster identifizieren; das Modell wechselt dann in ein Regime mit erhöhter Empfindlichkeit gegenüber kurzfristigen Signalen und breiteren Konfidenzintervallen.
Die Kernidee ist einfach, aber wirkungsvoll. Unsere Aufgabe besteht nicht nur darin, Heterogenität zu erfassen, sondern auch darin, zu lernen, wie man sie steuert. Damit es in der Praxis für Prognosen und die Ausführung an den Märkten von Nutzen ist. Anstatt zu versuchen, für jede Minute und für jede Börse einen separaten Parametersatz zu verwalten – was wirtschaftlich und technisch nicht tragbar ist –, erweitern die Autoren des Frameworks den Parameterraum des Modells entlang der zeitlichen und räumlichen Dimensionen und stellen diese Erweiterung dann kompakt als kleine Pools von Meta-Parametern dar. Für eine konkrete räumlich-zeitliche Abfrage werden die endgültigen Parameter als gewichtete Kombination von Kandidaten aus dem Pool generiert: Θ = Q · P. Dieser Ansatz ermöglicht es uns, mit einem kompakten Satz von Parametern zu arbeiten, anstatt eine enorme Anzahl individueller Parameter zu optimieren, was den Speicher- und Rechenaufwand drastisch reduziert. Anstelle einer Skalierung über alle Zeitschritte und Orte hinweg beschränken wir den Rechenaufwand für die Anpassung auf eine kleine Anzahl von Kandidaten.
In der Praxis bedeutet dies, dass wir einen separaten kleinen zeitlichen Pool vorhalten, aus dem wir die zeitliche Einbettung Et extrahieren und die zeitlichen Meta-Parameter erhalten. Ebenso fragt die räumliche Einbettung Es den räumlichen Pool ab und liefert Meta-Parameter für jede einzelne Zeitreihe. Gleichzeitig dürfen wir gemischte räumlich-zeitliche Signaturen nicht außer Acht lassen: Da die direkte Konstruktion eines vollständigen gemeinsamen Pools ineffizient wäre, kodieren die Autoren des Frameworks die Eingabedaten Xt in eine räumlich-zeitliche Einbettung Est = Fenc(Xt) und verwenden diese als Abfrage an einen relativ kleinen Pool, um ST-Meta-Parameter zu generieren. Dank dieser Trennung gewinnt das Modell an Flexibilität: Es kann seine Parameter an einen bestimmten Zeitpunkt, einen bestimmten Handelsplatz und eine bestimmte gleichzeitig auftretende Kombination von Ereignissen anpassen, ohne die Handhabbarkeit oder die Laufzeitleistung zu beeinträchtigen.
Dieser Ansatz bietet auch praktische Vorteile für Unternehmen. Die geringe Größe der Pools sorgt dafür, dass die Generierung von Meta-Parametern zur Inferenzzeit ressourcenschonend ist, was für Aufgaben mit strengen Latenzanforderungen von entscheidender Bedeutung ist. Durch das gemeinsame Training der Pools und des Hauptmodells können Gradienten durch die Abfragen an die Pools fließen, sodass die Einbettungen und Parameter koordiniert optimiert werden. Gleichzeitig muss die Trainingsstabilität überwacht und die Verteilung der Abfragegewichte durch Entropiebeschränkungen oder Temperaturglättung gesteuert werden, damit nicht ein einzelner Kandidat den gesamten Datenfluss monopolisiert und zu einem übermäßig komplexen Modell führt, das sich nur schlecht verallgemeinern lässt.
Die Wahl der Poolgröße ist ein Kompromiss zwischen ausgeprägter Anpassungsfähigkeit und dem Risiko von Overfitting; in der Praxis wird sie auf dem Validierungssatz abgestimmt, basierend auf der Anzahl der in den Zielmärkten beobachteten typischen Regime.
Die Architektur des HimNet-Frameworks basiert auf einer Kombination aus Graphkonvolutionen und rekurrenten Mechanismen: Diese Bausteine können gleichzeitig den Verlauf der Eingabedaten verarbeiten und Beziehungen zwischen einzelnen Zeitreihen berücksichtigen. Stellen Sie sich einen Trader vor, der gleichzeitig den Trade-Feed und eine Karte der Beziehungen zwischen den Märkten im Blick hat – und seine Entscheidung auf der Grundlage beider Perspektiven trifft. Genau diese Rolle spielt die Grundzelle des Modells. Sie aggregiert benachbarte Signale über den Graphen hinweg und aktualisiert den verborgenen Zustand im Zeitverlauf.
Aus Sicht der technischen Umsetzung handelt es sich bei dem Basisblock um eine modifizierte Graph Convolutional Recurrent Unit (GCRU). Im Inneren befinden sich die üblichen Reset- und Update-Gates, der Kandidatenzustand sowie die Mischung der alten und neuen verborgenen Repräsentationen. Es gibt jedoch ein wichtiges Detail: Die Parameter der Graphkonvolution sind hier nicht fest vorgegeben. Sie werden mithilfe von Meta-Mechanismen dynamisch generiert. Das bedeutet, dass die Gewichtungsmuster für die Nachbaraggregation (wie eine Sequenz eine andere beeinflusst) je nach Kontext variieren. Für den Finanzmarkt ist dies von entscheidender Bedeutung: Diese Zusammenhänge sind dynamisch. In Phasen breit angelegter Marktreaktionen an einer großen Börse sind sie eng gekoppelt. In einem anderen Zeitintervall, in dem ein Handelsplatz vorübergehend aus dem Handel ausfällt, brechen diese Zusammenhänge zusammen.
Das Modell basiert auf der klassischen Encoder-Decoder-Architektur. Der Encoder im HimNet-Framework arbeitet mit zwei parallelen Datenströmen, die anschließend addiert werden. Ein Datenstrom passt sich entlang der zeitlichen Dimension an. Er erhält zeitliche Einbettungen und nutzt sie, um zeitliche Meta-Parameter zu generieren. Der andere Datenstrom passt sich entlang der räumlichen Dimension an, nutzt räumliche Einbettungen der Sequenzen und gibt für jeden Punkt Meta-Parameter aus. Durch diesen zweikanaligen Ansatz kann das Modell gleichzeitig berücksichtigen, was gerade geschieht und wo es geschieht. Doch die Autoren des Frameworks belassen es nicht dabei. Um gemeinsame räumlich-zeitliche Effekte zu berücksichtigen, erhält der Decoder einen latenten Zustand und projiziert diesen in eine räumlich-zeitliche Einbettung. Dies dient als Abfrage an den Pool der ST-Meta-Parameter. Das Ergebnis ist eine Menge rekurrenter Gewichte, die spezifisch für die jeweilige Kombination aus Zeit, Ort und Dynamik ist.
Die adaptive Adjazenzmatrix ist ein weiterer wichtiger Bestandteil. Anstatt eine statische Verbindungsmatrix zu verwalten, generiert das Modell diese aus räumlichen Einbettungen: Die Skalarprodukte der Einbettungen durchlaufen ReLU und SoftMax. Das Ergebnis ist eine Matrix, die die aktuellen Marktbeziehungen widerspiegelt. In der Praxis bedeutet dies: Wenn an einer Börse ein Anstieg einsetzt, verstärkt das Modell automatisch den Einfluss dieser Börse auf benachbarte Knoten. Wenn Liquidität aus einem bestimmten Handelsplatz abfließt, schwächt sich dessen Einfluss ab. Dadurch reagiert das Modell sensibel auf den tatsächlichen Marktzustand und nicht auf eine statische Darstellung, die schnell veraltet.
Der Decoder in HimNet generiert iterativ Prognosen für die nächsten Schritte. Er nimmt einen anfänglichen verborgenen Zustand als Eingabe, wendet eine GCRU-Zelle mit ST-Meta-Parametern an und gibt für jeden zukünftigen Schritt eine Prognose aus. Dieser Ansatz liefert nicht nur eine gemittelte Prognose für alle Sequenzen, sondern erzeugt Prognosen, die lokale Regime und Zeitfenster berücksichtigen.
Das Training ist End-to-End organisiert. Die Autoren des Frameworks verwenden über alle Schritte und Handelsplätze hinweg eine einfache, aber aussagekräftige Kennzahl – MAE. Das ist praktisch: Der Verlustwert wird in denselben Einheiten gemessen wie der Prognosewert, was die fachliche Interpretation erleichtert. Während des Trainings ist es wichtig, die Stabilität zu überwachen: Es ist hilfreich, eine L2-Regularisierung auf die Meta-Parameter-Pools anzuwenden, bei der Generierung der Gewichte eine Temperaturglättung zu verwenden und die Aktualisierungsrate zu begrenzen. Die Pool-Größen werden als Kompromiss gewählt:
- zu klein – das Modell deckt nicht alle Regime ab;
- zu groß – das Risiko einer Überspezialisierung und der Rechenaufwand steigen.
Aus praktischer Sicht bietet HimNet konkrete Vorteile. Eine genaue Einschätzung der lokalen Liquidität verringert die Slippage bei der Ausführung großer Orderblöcke. HimNet liefert Arbitrage-Systemen die notwendigen Kontextinformationen, um falsche Kurslücken herauszufiltern und anhaltende Diskrepanzen zwischen den Börsen zu erkennen.
Schließlich sorgen die technischen Details dafür, dass sich das System für den Produktiveinsatz eignet. Die Erzeugung von Meta-Parametern erfordert die Multiplikation kleiner Matrizen, was nicht zu einem explosionsartigen Anstieg des Speicherbedarfs führt. Die Pools sind kompakt und ermöglichen es, die Latenz gering zu halten, was für Aufgaben mit strengen zeitlichen Anforderungen notwendig ist. All dies vereinfacht die Integration von HimNet in die Orderausführungs-Pipeline und das Risikokontrollsystem.
Nachstehend ist die von den Autoren erstellte Darstellung des HimNet-Frameworks abgebildet.
Implementierung in MQL5
Nach einer ausführlichen Analyse der theoretischen Grundlagen des HimNet-Frameworks besteht der nächste logische Schritt darin, zu zeigen, wie sich diese Ideen in funktionierendem MQL5-Code umsetzen lassen. Die praktische Umsetzung ist keine bloße Übernahme von Formeln, sondern eine Übertragung der Architektur in die Einschränkungen und Möglichkeiten einer realen Handelsplattform. Wir werden systematisch und sorgfältig vorgehen: Wir werden die größere Architektur in unabhängige, klar definierte Objekte zerlegen und das Modell Schritt für Schritt aufbauen, so wie ein Meisteruhrmacher eine Uhr zusammensetzt – sorgfältig, planvoll und mit Respekt vor jedem einzelnen Zahnrad. Dieser Ansatz vereinfacht das Testen, beschleunigt die Fehlerbehebung und erleichtert die Anpassung der Lösung an verschiedene Märkte und Zeitrahmen.
Auf Ebene der MQL5-Infrastruktur bedeutet dies, dass Vorverarbeitungsblöcke, Einbettungen, Meta-Parameter und rekurrente Zellen als separate Komponenten vorliegen. Datenströme aus Bars und Werten der analysierten Indikatoren werden in übersichtliche Datenfenster mit fester Länge umgewandelt. Zeitliche Einbettungen und Einbettungen univariater Sequenzen werden in die Module zur Gewichtsgenerierung eingespeist. Die GCRU-Zelle nimmt die Graphstruktur des Marktes als Eingabe entgegen und gibt einen aktualisierten verborgenen Zustand zurück. Das klingt alles schlüssig, aber es gibt einen Knoten, ohne den HimNet seinen Vorsprung verliert: die Fähigkeit, Nachbarn im Graphen, die mehrere Kanten entfernt sind, schnell und zuverlässig einzubeziehen. Aus finanzieller Sicht bedeutet dies, dass nicht nur direkte Effekte zwischen Sequenzen erfasst werden, sondern auch Effekte zweiter und dritter Ordnung, bei denen sich ein Liquiditätsanstieg an einem Knoten durch das Netzwerk ausbreitet und das zu analysierende Instrument mit Verzögerung und abgeschwächt erreicht.
An dieser Stelle kommt das Tschebyscheff-Polynom ins Spiel. Damit lässt sich ein lokaler K-Hop-Filter auf einem Graphen konstruieren, ohne auf eine aufwendige Spektralzerlegung zurückgreifen zu müssen. Anstatt Eigenvektoren zu berechnen, verwenden die Autoren des Frameworks eine einfache Rekursion, die aus der Adjazenzmatrix eine Matrizenbasis T0, T1, …, TK-1 erzeugt. Jede dieser Matrizen ist für eine Nachbarschaftsebene zuständig: vom Knoten selbst bis zur K-ten Nachbarschaft. Dadurch wird eine einzelne Faltungsoperation in eine übersichtliche Linearkombination mehrerer vorab berechneter Transformationen umgewandelt. Dies ist für den Handel von entscheidender Bedeutung: geringere Latenz, geringere Speicherbelastung und stabile numerische Leistung bei langen Zeitreihen und für große Werte von N. Wenn der Markt verrauscht ist, hilft dieser Filter dabei, stabile Zusammenhänge zu erkennen und zu vermeiden, auf zufällige Spitzen zu reagieren.
Damit diese Idee im Produktivbetrieb funktioniert, benötigen wir ein separates Objekt, das aus der aktuellen Adjazenzmatrix schnell Tschebyscheff-Polynommatrizen der erforderlichen Ordnung erzeugt. Sie fungiert als stiller Motor der gesamten Graph-Ebene: Sie nimmt eine adaptive Stützmatrix, die aus Einbettungen aufgebaut ist, als Eingabe entgegen und gibt einen kompakten Satz von Tk zurück, der für die Verwendung in der GCRU bereit ist.
Der erste Schritt in unserer praktischen Arbeit besteht darin, Änderungen am OpenCL-Programm vorzunehmen. Die GPU eignet sich ideal für diese Aufgabe: Dank Multithreading und Vektoroperationen können wir große Adjazenzmatrizen wesentlich schneller verarbeiten als auf der CPU. Dies ist besonders wichtig bei Finanzdaten, bei denen der Graph recht groß sein und eine komplexe, verzweigte Struktur aufweisen kann.
Der Algorithmus des ChebStep-Kernels für den Vorwärtsdurchlauf ist gewissermaßen das Herzstück des Mechanismus zur Erzeugung von Tschebyscheff-Polynomen und arbeitet tief im Inneren von OpenCL. Er ähnelt stark dem reibungslosen Betrieb der Matching-Engine einer Börse, bei der jeder Tick und jede Order in eine einheitliche Logik eingebunden wird.
__kernel void ChebStep(__global const float* support,
                       __global float* outputs,
                       const int step
                      )
  {
   const size_t l = get_local_id(0);
   const size_t r = get_global_id(1);
   const size_t c = get_global_id(2);
   const size_t total_l = get_local_size(0);
   const size_t total_r = get_global_size(1);
   const size_t total_c = get_global_size(2);
Das Programm beginnt damit, Koordinaten im Problemraum zu ermitteln. Lokale und globale Thread-IDs stehen für unsere Börsenhändler, von denen jeder für einen eigenen Teil der Matrix verantwortlich ist. Sie arbeiten parallel, sodass der gesamte Datensatz nicht sequenziell – wie beim manuellen Handel alter Prägung –, sondern synchron verarbeitet wird, ähnlich wie bei einem automatisierten Hochfrequenzhandelssystem. Der lokale Temp-Puffer fungiert als temporäre Clearingstelle – hier werden Zwischensummen gespeichert und anschließend synchronisiert, um das Endergebnis zu erzeugen.
   __local float Temp[LOCAL_ARRAY_SIZE];
//---
   if(step <= 0 || total_r != total_c)
      return;
Der Algorithmus auferlegt sofort eine wichtige Einschränkung: Ist die Schrittweite kleiner oder gleich Null oder die Matrix nicht quadratisch, ist es nicht sinnvoll, die Berechnungen fortzusetzen. Genau das ist die Art von Situation, in der ein Trader einen Trade auslässt, wenn die Marktbedingungen nicht den Regeln der Strategie entsprechen.
Anschließend werden die Grade der Tschebyscheff-Polynome in einer schrittweisen Hierarchie aufgebaut. Der erste Schritt ist einfach: Es wird eine Einheitsmatrix gebildet, deren Diagonale mit Einsen gefüllt ist. Es ist wie Startkapital – die Grundlage, von der aus alles beginnt.
if(step <= 3)
  {
   const float diag = (r == c ? 1.0f : 0.0f);
   if(l == 0)
      outputs[RCtoFlat(r, c, total_r, total_c, 0)] = diag;
Im zweiten Schritt kommt die ursprüngliche Adjazenzmatrix ins Spiel – eben jene Verbindungskarte zwischen den Knoten des Graphen, die die tatsächliche Struktur des Marktes widerspiegelt. Sie wird dem Ausgabe-Array hinzugefügt, und hier beginnt die Annäherung an die tatsächlichen Kursbewegungen.
if(step < 2)
   return;
if(l == 0)
  {
   const float s = IsNaNOrInf(support[RCtoFlat(r, c, total_r, total_c, 0)], 0);
   outputs[RCtoFlat(r, c, total_r, total_c, 1)] = s;
  }
Im dritten Schritt wird die zweite Potenz – das Matrixquadrat – gebildet. Der Code in der Schleife multipliziert die Zeilen und Spalten und summiert die Produkte sorgfältig. Dies ist vergleichbar mit der Analyse von Kreuzkorrelationen zwischen Vermögenswerten, bei der wir nicht nur nach direkten Zusammenhängen suchen, sondern auch nach indirekten Zusammenhängen über Zwischenverknüpfungen.
Die resultierende Matrix spiegelt komplexere Wechselwirkungen wider, bei denen der Einfluss nicht auf direkte Verbindungen beschränkt bleibt, sondern über benachbarte Knoten propagiert. Nach dem Summieren werden Normalisierung und Anpassung vorgenommen, um Redundanzen zu beseitigen – ähnlich wie ein Händler Rauschen aus Kursnotierungen herausfiltert und nur aussagekräftige Signale beibehält.
 if(step < 3)
    return;
 float out = 0;
 for(int t = 0; t < total_c; t += total_l)
   {
    const float s1 = IsNaNOrInf(support[RCtoFlat(r, t + l, total_r, total_c, 0)], 0);
    const float s2 = IsNaNOrInf(support[RCtoFlat(t + l, c, total_r, total_c, 0)], 0);
    out += IsNaNOrInf(s1 * s2, 0);
   }
 out = 2 * LocalSum(out, 0, Temp);
 if(l == 0)
   {
    out -= diag;
    outputs[RCtoFlat(r, c, total_r, total_c, 2)] = IsNaNOrInf(out, 0);
   }
 return;
}
Ist der Schritt größer als drei, wechselt der Algorithmus zur allgemeinen Rekursionsformel für Tschebyscheff-Polynome. Hier wird jede neue Matrix nicht von Grund auf neu gebildet, sondern aus einer Kombination der vorherigen Potenzen. Der Code nimmt die Adjazenzmatrix, multipliziert sie mit dem Ergebnis des vorherigen Schritts und passt sie an, indem er davon eine noch frühere Matrix subtrahiert. Dieser Prozess ähnelt der Erstellung komplexer Handelsindikatoren: So berücksichtigen beispielsweise exponentielle gleitende Durchschnitte den vorherigen Zustand und glätten damit starke Schwankungen, ohne dabei historische Informationen zu verlieren.
   float out = 0;
   for(int t = 0; t < total_c; t += total_l)
     {
      if((t + l) >= total_c)
         continue;
      const float s1 = IsNaNOrInf(support[RCtoFlat(r, t + l, total_r, total_c, 0)], 0);
      const float s2 = IsNaNOrInf(outputs[RCtoFlat(t + l, c, total_r, total_c, step - 2)], 0);
      out += IsNaNOrInf(s1 * s2, 0);
     }
   out = 2 * LocalSum(out, 0, Temp);
   if(l == 0)
     {
      out -= IsNaNOrInf(outputs[RCtoFlat(r, c, total_r, total_c, step - 3)], 0);
      outputs[RCtoFlat(r, c, total_r, total_c, step - 1)] = IsNaNOrInf(out, 0);
     }
   return;
  }
Auf diese Weise erstellt das Modell Schritt für Schritt immer tiefere Approximationen der spektralen Eigenschaften des Graphen.
Jede Iteration im Kernel endet mit einer Datensynchronisation und einer Gültigkeitsprüfung. Der Code nutzt in großem Umfang eine Funktion, die vor NaN-Werten und Unendlichkeiten schützt – eine Erinnerung daran, dass der Markt keine Fehler verzeiht. Genauso wie das Risikomanagement Verlustgrenzen regelt, wird auch hier jede Anomalie frühzeitig herausgefiltert, damit sie das Gesamtergebnis nicht verzerrt.
Als Ergebnis dieser schrittweisen Logik erhalten wir eine ganze Reihe von Tschebyscheff-Polynomen, die als Bausteine für Spektralfilter in Graph Neural Networks dienen. In der Praxis bedeutet dies, dass der Algorithmus den Markt nicht einfach nur durch die Brille der aktuellen Zusammenhänge betrachtet, sondern eine vielschichtige Perspektive entwickelt, die sowohl lokale als auch weitreichende Abhängigkeiten zwischen den Finanzinstrumenten erfassen kann. Das lässt sich damit vergleichen, wie ein erfahrener Analyst in den Kursbewegungen von Gold ein indirektes Signal für den Devisenmarkt erkennen kann oder in der Dynamik von Anleihen einen Vorboten für Veränderungen am Aktienmarkt.
Nachdem wir nun den Algorithmus zur direkten Konstruktion von Tschebyscheff-Polynomen untersucht und gesehen haben, wie sich deren Rechenstruktur Schritt für Schritt aufbaut, liegt es nahe, uns nun dem Mechanismus der Fehlerrückpropagierung zuzuwenden. An dieser Stelle kommt ein spezieller Kernel ins Spiel; er ist dafür verantwortlich, die Gradienten präzise auf die Tschebyscheff-Polynome zu verteilen und zurück zur Adjazenzmatrix zu führen, wodurch ein korrektes Training des gesamten Modells gewährleistet wird.
__kernel void ChebStepGrad(__global const float* support,
                           __global float* support_g,
                           __global const float* outputs,
                           __global float* outputs_g,
                           const int step
                          )
  {
   const size_t l = get_local_id(0);
   const size_t r = get_global_id(1);
   const size_t c = get_global_id(2);
   const size_t total_l = get_local_size(0);
   const size_t total_r = get_global_size(1);
   const size_t total_c = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
//---
   if(step < 1 || total_r!=total_c)
      return;
Zu Beginn der Ausführung initialisiert der Algorithmus außerdem lokale und globale Thread-IDs, die – ähnlich wie Marktnotierungen – die Position jeder Recheneinheit innerhalb eines riesigen Rasters paralleler Threads bestimmen. Für ein temporäres Array wird lokaler Speicher zugewiesen, um Reduktionen zu beschleunigen, und die anfänglichen Prüfungen stellen sicher, dass der Schritt gültig ist und die Matrix quadratisch ist. Genauso wie ein Händler niemals ein unvollständiges Orderbuch analysieren würde, bricht das Programm hier unter ungültigen Bedingungen sofort ab.
Wenn der Schritt der Fehlergradientenberechnung größer als oder gleich 2 ist, beginnt der spannendste Teil. Zunächst wird der Gradient aus dem nachfolgenden Schritt entnommen und direkt von der vorherigen Ausgabestufe abgezogen. Dies lässt sich mit einer Prognosekorrektur vergleichen: Wenn die Strategie im letzten Zeitschritt einen Fehler erzeugt hat, wird ihr „Schatten“ auf den vorherigen Zeitschritt übertragen.
if(step >= 2)
  {
   float grad = IsNaNOrInf(outputs_g[RCtoFlat(r, c, total_r, total_c, step)], 0);
   if(l == 0)
      outputs_g[RCtoFlat(r, c, total_r, total_c, step - 2)] -= grad;
Anschließend berechnet der Algorithmus die Gradienten in Bezug auf die Adjazenzmatrix. Jeder Thread übernimmt ein eigenes Datenstück und multipliziert den Fehler aus den Ausgabewerten mit den entsprechenden Werten aus dem vorherigen Schritt, wobei er alles sorgfältig mithilfe des lokalen Speichers aufsummiert. Das Ergebnis ist ein Korrektursignal, das einer Neugewichtung eines Portfolios ähnelt – wenn bestimmte Vermögenswerte übergewichtet sind, wird ihr Einfluss schrittweise neu verteilt.
//--- support grad
grad = 0;
for(int t = 0; t < total_c; t += total_l)
  {
   if((t + l) >= total_c)
      continue;
   const float s2 = IsNaNOrInf(outputs[RCtoFlat(c, t + l, total_r, total_c, step - 2)], 0);
   grad += IsNaNOrInf(outputs_g[RCtoFlat(r, t + l, total_r, total_c, step)] * s2, 0);
  }
grad = LocalSum(grad, 0, Temp);
if(l == 0)
   outputs_g[RCtoFlat(r, c, total_r, total_c, 1)] += grad;
BarrierLoc;
Sobald die Threads synchronisiert sind, geht es weiter mit dem nächsten Schritt – der Berechnung des Gradienten in Bezug auf das Polynom Tk-1. Auch hier gilt dasselbe Prinzip: Jeder Thread übernimmt einen Teil der Adjazenzmatrix, multipliziert diesen mit den Fehlern aus dem nächsten Schritt und fügt seinen Beitrag sorgfältig zur Gesamtsumme hinzu. Infolgedessen wird eine Korrektur für die Polynomgradienten auf der Ebene k-1 erzeugt. Dieser Vorgang ist vergleichbar damit, dass ein Analyst in seinem Modell einen Schritt zurückgeht, um zu prüfen, ob das Risiko dort überschätzt wurde, und die entsprechende Korrektur vornimmt.
 //--- T(k-1) grad
 grad = 0;
 for(int t = 0; t < total_c; t += total_l)
   {
    if((t + l) >= total_c)
       continue;
    const float s2 = IsNaNOrInf(support[RCtoFlat(t + l, r, total_r, total_c, 0)], 0);
    grad += IsNaNOrInf(outputs_g[RCtoFlat(t + l, c, total_r, total_c, step)] * s2, 0);
   }
 grad = LocalSum(grad, 0, Temp);
 if(l == 0)
    outputs_g[RCtoFlat(r, c, total_r, total_c, step - 1)] += grad;
}
Bitte beachten Sie: Wir fassen alle Fehlergradienten sorgfältig in einem Tensor zusammen, der den Tschebyscheff-Polynomen entspricht. Die Zwischengradienten der Adjazenzmatrix, die bei jedem Schritt des Rückwärtsdurchlaufs berechnet werden, sind dort ebenfalls enthalten. Man sollte bedenken, dass die Adjazenzmatrix selbst im Polynom erster Ordnung gespeichert ist, wodurch diese Ebene zum entscheidenden Punkt wird, an dem sich die Datenströme kreuzen. Erst wenn wir diese Ebene erreichen, übertragen wir den kumulierten Fehlergradienten in den Puffer der Adjazenzmatrix – so, als würden wir nach einer Reihe von Zwischenanpassungen den endgültigen Stand festhalten.
Somit übernimmt dieser Kernel die Rolle einer Art „Prüfer“ der Berechnungen und verhindert, dass der Fehler auf dem Rückwärtspfad verloren geht oder zerstreut wird. Jeder Wert durchläuft ein System lokaler Summen, wird angepasst und dorthin weitergeleitet, wo er die Gewichte zugunsten einer genaueren Prognose verändern kann. Genau wie auf einem Markt, auf dem jedes zusätzliche Zehntelprozent eine entscheidende Rolle spielen kann, ermöglicht auch hier eine sorgfältige Verteilung des Gradienten auf die einzelnen Schritte, dass das Modell stabil lernt und auf Kurs bleibt.
Nachdem nun die Grundlage (Matrixgenerierung und Gradientenverteilung) geschaffen ist, stellt sich natürlich die Frage: Wer wird diesen gesamten Prozess auf der Seite des Hauptprogramms steuern? Wir benötigen ein Objekt, das als eine Art Dispatcher fungiert, Low-Level-OpenCL-Kernel sauber kapselt und eine komfortable Schnittstelle für die Interaktion mit anderen Modulen im Modell bereitstellt. Dadurch erhalten wir die Klasse CChebPolinom, die die grundlegenden Schnittstellen vom Objekt der vollständig verbundenen Schicht CNeuronBaseOCL erbt.
class CChebPolinom   :  public CNeuronBaseOCL
  {
protected:
   uint              iDimension;
   uint              iSteps;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return true; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CChebPolinom(void)   {};
                    ~CChebPolinom(void)   {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint dimension,
                          uint steps, ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defChebPolinom; }
   virtual uint      GetDimension(void) const { return iDimension; }
   virtual uint      GetSteps(void) const { return iSteps; }
  };
Sie speichert intern wichtige Parameter: die Raumdimensionalität und die Anzahl der für die Tschebyscheff-Polynom-Entwicklung erforderlichen Schritte. Diese Parameter legen den Umfang der Berechnungen und die Tiefe fest, die das Modell bei der Arbeit mit der Graphstruktur erreichen kann.
Das Objekt wird in der Methode Init initialisiert, in der Sie alle erforderlichen Parameter angeben können.
bool CChebPolinom::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint dimension,
                        uint steps, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, dimension * dimension * steps,
                                                              optimization_type, batch))
      return false;
//---
   iDimension = dimension;
   iSteps = steps;
//---
   return true;
  }
Der Algorithmus für diese Methode ist recht einfach. Zunächst übergeben wir die Steuerung an die gleichnamige Methode der Basisklasse und geben dabei eine Objektdimension an, die groß genug ist, um den verketteten Tensor aller erforderlichen Tschebyscheff-Polynome zu speichern. Das Objekt speichert dann intern zwei Hauptparameter: die Dimension iDimension und die Anzahl der Schritte iSteps. Diese Werte dienen als eine Art „Spezifikation“ für die Klasse, auf die sich alle anderen Methoden beziehen. Man könnte sagen, dass wir hier den Arbeitsbereich endgültig festlegen: Wir legen sowohl die Breite der Leinwand als auch die Anzahl der Ebenen fest, durch die die Informationen fließen werden.
Die Rückgabe von true am Ende der Methode bestätigt, dass das Objekt erfolgreich für den Einsatz vorbereitet wurde. Auch wenn die Implementierung knapp erscheint, wird gerade in dieser Phase die grundlegende Frage geklärt: ob unser Algorithmus in der Lage sein wird, die polynomiale Approximation auf der GPU effizient durchzuführen.
Die Methode für den Vorwärtsdurchlauf feedForward fungiert im Wesentlichen als Dispatcher, der den Aufruf des Kernels des entsprechenden OpenCL-Programms lediglich kapselt und organisiert. Der Aufbau ist leicht zu erkennen: Überprüfung der Eingabedaten, Vorbereitung der Betriebsparameter und anschließender Aufruf des Kernels. Die Besonderheiten der Aufgabe – die Erzeugung und Anwendung von Tschebyscheff-Polynomen – bringen hier jedoch ihre eigenen Feinheiten mit sich.
bool CChebPolinom::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL || NeuronOCL.Neurons() != (iDimension * iDimension))
      return false;
Zunächst überprüft die Methode, ob ein gültiges Objekt als Eingabe übergeben wurde und ob die Anzahl der Neuronen mit der Größe der Adjazenzmatrix, iDimension * iDimension, übereinstimmt. Ist diese Bedingung nicht erfüllt, ergibt eine weitere Verarbeitung schlichtweg keinen Sinn.
Als Nächstes werden die Arbeitsbereiche vorbereitet: Die globalen Abmessungen des Rechenrasters werden so gewählt, dass sie sowohl das tatsächliche Limit der GPU für die lokale Work-Group-Größe berücksichtigen als auch die Matrixstruktur des Problems widerspiegeln – die drei Dimensionen bilden das Rechenraster effektiv entlang der Matrixachsen ab.
   uint global_work_offset[3] = { 0 };
   uint global_work_size[3] = { MathMin(iDimension, uint(OpenCL.GetMaxLocalSize(0))),
                                iDimension, iDimension
                              };
   uint local_work_size[3] = { global_work_size[0], 1, 1 };
Das entscheidende Element hierbei ist die Schleife über die einzelnen Schritte. Genau darin zeigt sich der rekursive Charakter der Konstruktion von Tschebyscheff-Polynomen: Um den Wert eines Polynoms der Stufe k zu erhalten, muss man sich auf die vorherigen Werte stützen. Ausgehend vom kleinsten gültigen Schritt (in der Regel der zweite, da die ersten beiden durch die Basisbedingungen vorgegeben sind) übergibt die Methode nacheinander die Schrittnummer an den Kernel und leitet anschließend die Ausführung ein. Somit erhält die GPU bei jeder Iteration eine neue Aufgabe: die nächste Stufe der Polynomapproximation zu konstruieren.
//---
   uint kernel = def_k_ChebStep;
   setBuffer(kernel, def_k_cheb_support, NeuronOCL.getOutputIndex())
   setBuffer(kernel, def_k_cheb_outputs, getOutputIndex())
   for(int step =::MathMin(2, MathMax(int(iSteps) - 1, 0)); step < int(iSteps); step++)
     {
      setArgument(kernel, def_k_cheb_step, step + 1)
      kernelExecuteLoc(kernel, global_work_offset, global_work_size, local_work_size)
     }
//---
   return true;
  }
Das Ergebnis ist eine Art „Matroschka“ aus Berechnungen: Jeder Schritt hängt vom vorherigen ab, gleichzeitig wird die gesamte Berechnung jedoch über die Elemente der Matrix hinweg parallelisiert. Auf den Finanzmärkten ähnelt dieser Ansatz einer Prognosestrategie auf der Grundlage rollierender Zeithorizonte: Jede neue Prognose wird nicht von Grund auf neu erstellt, sondern knüpft an die vorherige an und verfeinert und vertieft das Gesamtbild.
Genau darin liegt die Stärke dieser Methode: In knapper Form verbindet sie die Einfachheit der Dispatch-Logik mit tiefgehender mathematischer Rekursion.
Die Methode zur Propagation von Fehlergradienten basiert auf einem ähnlichen Prinzip. Wie beim Vorwärtsdurchlauf besteht das Hauptziel dieser Methode darin, die Aufrufe des entsprechenden Kernels des OpenCL-Programms korrekt zu organisieren und dabei die rekursive Struktur der Berechnungen der Tschebyscheff-Polynome zu berücksichtigen. Alle angesammelten Gradienten werden sorgfältig summiert und auf die entsprechenden Schritte verteilt, wobei besonderes Augenmerk auf die Adjazenzmatrix und die Zwischenpolynome gelegt wird.
Sie können diese Methode selbst einer detaillierten zeilenweisen Analyse unterziehen. Der vollständige Quellcode der Klasse, einschließlich aller ihrer Methoden, ist im Anhang enthalten. Dieser bietet einen umfassenden Überblick über die Funktionsweise dieses Teils des Frameworks.
Wir haben bereits viel Stoff durchgenommen, daher ist jetzt ein guter Zeitpunkt für eine kurze Pause, um all die gesammelten Informationen zu ordnen und zu sortieren. Eine detaillierte Schritt-für-Schritt-Erklärung hilft Ihnen dabei, besser zu verstehen, wie das System funktioniert und in welcher Beziehung seine Komponenten zueinander stehen. Im nächsten Artikel werden wir die Entwicklung der Algorithmen für das HimNet-Framework fortsetzen, einschließlich der praktischen Integration aller Module.
Fazit
In diesem Artikel haben wir die theoretischen Aspekte des HimNet-Frameworks beleuchtet und sind anschließend zur praktischen Implementierung der vorgeschlagenen Ansätze unter Verwendung von MQL5 und OpenCL übergegangen. Wir haben das Konzept räumlich-zeitlicher Meta-Parameter eingehend untersucht. Wir haben uns darauf konzentriert, wie graphkonvolutionsbasierte rekurrente Blöcke zeitliche und räumliche Abhängigkeiten berücksichtigen können, und außerdem Algorithmen zur Erzeugung und Anwendung von Tschebyscheff-Polynomen auf der GPU untersucht, um die Berechnungen zu beschleunigen und die Robustheit des Modells zu verbessern.
Im nächsten Artikel werden wir unsere Arbeit an der Entwicklung von Algorithmen für das HimNet-Framework fortsetzen.
Literaturverzeichnis
- Heterogenitätsinformiertes Meta-Parameter-Lernen für räumlich-zeitliche Zeitreihenprognosen
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19233
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Marktsimulation: Positionsanzeige (VII)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Trauminspirierter Optimierungsalgorithmus (DOA)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.