

取引におけるニューラルネットワーク:構造成分の分離(Encoder)
 24
 0

はじめに
SCNNフレームワークの提案者たちが示したアプローチを参考に、独自の実装を進めています。 改めて確認すると、SCNN(構造成分ニューラルネットワーク)は、時系列データ全体を単一の汎用的な仕組みでモデル化するのではなく、5つの主要な成分、すなわち長期成分、季節成分、短期成分、結合成分、残差成分に分解するという、従来とは異なるアプローチを採用しています。 各成分は個別にモデル化され、それぞれに適した方法で外挿されます。これにより、モデルの柔軟性が高まるだけでなく、処理の各段階で得られる結果を解釈できるようになります。
このアーキテクチャの最大の利点は、モデルの内部構造や予測の根拠を把握しやすいことです。 従来のブラックボックス型モデルとは異なり、SCNNでは、予測の各部分をどの構成要素が担っているのか、また、現在の市場環境においてモデルの予測がどの程度信頼できるのかを、アナリストやトレーダーが確認できます。 説明可能性と制御可能性がモデルへの信頼を支える金融データの分析において、これは特に重要な特徴です。 さらに、各成分の性質に応じて外挿手法を使い分けることもできます。たとえば、長期的な傾向や季節性のあるパターンには統計的なヒューリスティックを適用し、短期的な異常や資産間の相互依存関係のモデル化には、学習可能なニューラルネットワークモジュールを利用できます。
このフレームワークは、単純化されたモデルでは見落とされがちな自己相関をはじめ、複雑な時間的依存関係にも対応します。 こうした特性は、日中取引や取引セッションの切り替わり前後における予測などで、特に重要になります。また、SCNNはリアルタイムで生じる統計的特性の変化に動的に適応するとともに、予測の信頼性が低下している可能性のある異常な時点を特定するのにも役立ちます。
著者によるSCNNフレームワークの構成図を以下に示します。
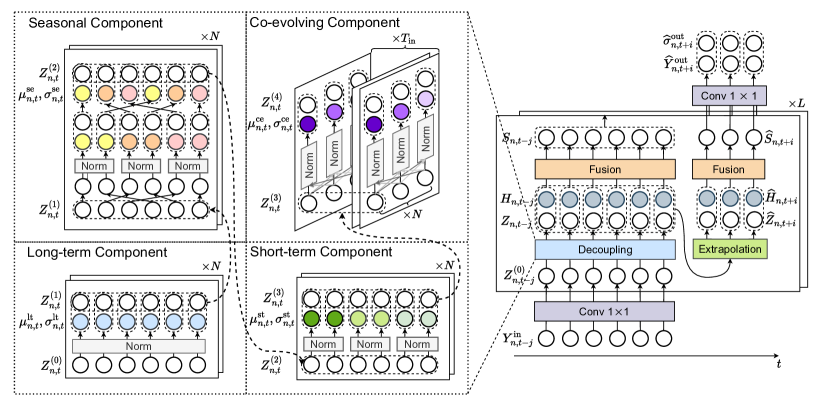
前回の記事の実装編では、時系列データから周期成分を抽出するためのオブジェクトCNeuronPeriodNormを開発しました。 このオブジェクトは、MQL5環境でSCNNフレームワークを実装するための第一歩となるもので、長期成分と短期成分の抽出に使用します。 OpenCLカーネルを活用することで、データを効率的に並列処理できるほか、誤差逆伝播による学習にも対応しています。そのため、このモジュールは、学習可能なニューラルネットワークアーキテクチャの構成要素として利用できます。
さらに後の段階では、データに簡単な変換を施すことで、CNeuronPeriodNormを季節成分の抽出にも応用できることを示します。これにより、このオブジェクトの汎用性はさらに高まります。 今回は、次のステップとして、結合成分の抽出を担うオブジェクトの実装に着手します。結合成分は、時系列を構成する複数の変数の間で生じる、相互に関連した変化を表します。 このモジュールは、複数の変数にまたがる同期的な変動や、異常な連動をモデル化するうえで重要な役割を果たします。こうした機能は、複数の資産を対象とする多変量市場分析において、特に重要です。
結合成分の抽出
実際にモデルを実装してみると、適切なモデルを構築するためには、時間方向の分析だけでは不十分であることがわかります。 同時に考慮しなければならないのが、空間的依存関係、すなわち、ある時点における異なる変数間の関係です。 この役割を担うのが、結合成分の抽出機構です。この機構により、分析対象となる多変量時系列を構成する各成分系列の間で、同方向または逆方向に生じる変動を検出できます。 こうした共進化のパターンは、安定している場合もあれば、時間とともに変化する場合もあります。そのため、正規化にも適応的なアプローチが必要となります。
SCNNフレームワークでは、この問題をAttention機構を利用した空間重み付き正規化によって解決します。 ここからは、金融モデリングの実用的なニーズを踏まえ、提案されたアルゴリズムを独自に解釈して実装する次の段階へ進みます。 これまでと同様に、重み付き平均の計算や適応的な標準化を含む主要な計算処理は、OpenCL側に委ねます。 これにより、処理速度を向上させるとともに、アーキテクチャの設定に柔軟性を持たせることができます。
このため、新たにAdaptSpatialNormというカーネルを作成します。 このカーネルは、変数間のAttention重みを考慮しながら入力データを適応的に正規化し、変数間の空間的な関係をより正確かつ敏感に捉えることを目的としています。 基本的な考え方は、Attentionマスクによって重み付けされた平均と標準偏差を、各時点について計算することです。 これにより、すべての変数を単純に平均するのではなく、それぞれの相対的な重要度、つまり時空間的な文脈における各変数の影響度を反映できます。
__kernel void AdaptSpatialNorm(__global const float* inputs,
                               __global const float* attention,
                               __global float2* mean_stdevs,
                               __global float* outputs
                              )
  {
   const size_t i = get_global_id(0);
   const size_t a = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t total_inputs = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t variables = get_global_size(2);
この計算カーネルでは、時間、変数、ローカルワークアイテムという3つの次元に沿って処理を構成します。 各ワークアイテムは、特定の時点における特定の変数の値を処理します。 最初にインデックスのオフセットを求め、各ワークアイテムが必要なメモリ領域に正しくアクセスできるようにします。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_v = v * total_inputs;
   const int shift_out = shift_v + i;
続いて、主要な計算処理をおこないます。入力配列から各変数の値を取得するとともに、対応するAttention重みを読み込みます。 それぞれの値に重みを乗じ、ローカルメモリを利用した集約処理によって、まず平均を求め、次に分散を計算します。
   float mean = 0, stdev = 0;
   for(uint l = 0; l < variables; l += total_local)
     {
      const int shift_at = v * variables + (a + l);
      float val = IsNaNOrInf(inputs[(a + l) * total_inputs + i], 0);
      float att = IsNaNOrInf(attention[shift_at], 0);
      mean += LocalSum(val * att, 1, Temp);
      BarrierLoc;
      stdev += LocalSum(val * val * att, 1, Temp);
      BarrierLoc;
     }
複数のワークアイテムによる並列計算を正しく実行するため、同期バリアを使用しています。これにより、共有メモリを利用する際のアクセス競合を防ぎます。
ここで、計算処理の構成に関する技術的なポイントを確認しておきましょう。 OpenCLでは、複数のワークアイテムによる値の集約を正しく実行するために、ワークグループという単位を設けます。 同じワークグループに属するワークアイテムは、ローカルメモリを介してデータを共有できます。ローカルメモリはグローバルメモリよりも高速であり、リダクション(集約演算)や加算といった集合的な処理を効率的に実行するのに適しています。
ただし、このアーキテクチャには制約があります。ワークグループのサイズは、GPUなどの計算デバイスが定めるハードウェア上の上限を超えることができません。 そのため、単一のワークグループで同時に処理できる変数の数には限りがあり、入力配列の次元数と一致するとは限りません。
この制約に対応するため、カーネルの本体には専用のループを実装しています。これにより、変数の数がワークグループのサイズを大幅に上回る場合でも、すべての変数を順次処理できます。 具体的には、特徴量の集合を複数のブロックに分割し、各ブロックを順番に処理しながら値を集約します。 この方法により、モデルに含まれる変数の数にかかわらず、数学的な処理の正確性を維持しつつ、計算効率を確保できます。
こうした工夫によって、変数の増加に対する拡張性が高まり、仕様の異なるさまざまなデバイスでも実行できる、柔軟で移植性の高い実装となります。
すべての値を処理した後、各ワークグループ内で1つのワークアイテムだけが最終的な正規化処理を担当します。 二乗値の総和から平均の二乗を差し引いて分散を求め、その平方根を計算して標準偏差を取得します。 また、ゼロ除算を防ぐための対策も設けています。分散が極めて小さい場合には、標準偏差を1に置き換えます。
   if(a == 0)
     {
      stdev -= mean * mean;
      stdev = IsNaNOrInf(sqrt(stdev), 1);
      if(stdev <= 0)
         stdev = 1;
      mean_stdevs[shift_out] = (float2)(mean, stdev);
      outputs[shift_out] = IsNaNOrInf((inputs[shift_out] - mean) / stdev, 0);
     }
  }
その後、入力値を正規化して出力配列に書き込みます。 同時に、計算した平均と標準偏差も保存します。これらの値は、後続の処理で必要になります。
この実装では、データの空間的な分布に関する情報を集約し、その分布に基づいて正規化をおこないます。 これにより、モデルは変数間に潜む関係をより敏感に捉え、複雑な時系列プロセスの動態を、より正確にモデル化できるようになります。これは、特に金融市場の予測において重要です。
モデルを完全に学習させるためには、正規化された値を計算する順伝播だけでなく、誤差勾配を入力データやパラメータへ正しく伝える逆伝播も実装する必要があります。 空間的な重み付き正規化をおこなう AdaptSpatialNormカーネルに続く自然なステップは、逆伝播用のAdaptSpatialNormGradカーネルを実装することです。このカーネルは、入力データとAttention重みに誤差勾配を伝播させる役割を担います。
__kernel void AdaptSpatialNormGrad(__global const float* inputs,
                                   __global float* inputs_gr,
                                   __global const float* attention,
                                   __global float* attention_gr,
                                   __global const float2* mean_stdevs,
                                   __global const float2* mean_stdevs_gr,
                                   __global const float* outputs_gr,
                                   const uint total_inputs
                                  )
  {
   const size_t i = get_global_id(0);              // main
   const size_t loc = get_local_id(1);             // local to sum
   const size_t v = get_global_id(2);              // variable
   const size_t total_main = get_global_size(0);   // total
   const size_t total_loc = get_local_size(1);     // local dimension
   const size_t variables = get_global_size(2);    // total variables
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
このアルゴリズムでは、ワークアイテム間で計算負荷を分散し、それぞれが時間方向の位置と変数の組み合わせに対応する処理を担当します。 中間値の保存にはローカルメモリを使用し、ワークグループ内での加算やデータ集約を高速化します。
まず、入力データに対する勾配を計算します。 入力配列の各要素について、対応するAttention重みと出力勾配を取得します。 次に、正規化パラメータである平均と標準偏差に関する偏微分も考慮しながら、勾配を求めます。これらのパラメータも逆伝播に関与するためです。 部分和を集約した後、計算結果を入力勾配配列に保存します。
//--- Input gradient
     {
      if(i < total_inputs)
        {
         float grad = 0;
         int shift_in = v * total_inputs + i;
         float x = IsNaNOrInf(inputs[shift_in], 0);
         for(int l = 0; l < variables; l += total_loc)
           {
            if((l + loc) >= variables)
               break;
            int shift_out = i + (l + loc) * total_inputs;
            float att = IsNaNOrInf(attention[(l + loc) * variables + v], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float2 ms = mean_stdevs[shift_out];
            float2 ms_gr = mean_stdevs_gr[shift_out];
            float dy = (1 - att) * (1 / ms.y - (x - ms.x) * att * x / pow(ms.y, 3.0f));
            float dmean = IsNaNOrInf(ms_gr.x * att, 0);
            float dstd = IsNaNOrInf(ms_gr.y * x * (att - att * att) / ms.y, 0);
            grad += IsNaNOrInf(dy * out_gr + dmean + dstd, 0);
           }
         grad = LocalSum(grad, 1, Temp);
         if(loc == 0)
            inputs_gr[shift_in] = grad;
        }
      BarrierLoc;
     }
ここで重要なのは、保存した平均と標準偏差が、単なる計算結果ではないという点です。 これらの値は、SCNNフレームワークの後続処理でも利用され、補助的なデータ処理経路を形成します。 そのため、後続の順伝播処理でこれらのパラメータに対して蓄積された誤差勾配も、入力データの段階まで逆伝播させなければなりません。
つまり、逆伝播では主たる情報の流れだけを考慮するのではなく、保存された正規化統計量に関する偏微分から生じる寄与も計算し、最終的な入力勾配に加算します。 この方法によって計算グラフの整合性を保ち、正規化を介して間接的に入力と関係する要素も含め、結果に影響するすべてのパラメータを適切に調整できるようになります。
次に、Attention重みに対する勾配を計算します。 Attention重みの各要素について、対応するすべての時点を順次処理し、入力データと、すでに計算した出力勾配を使用します。 また、平均と標準偏差を介した正規化処理に対して、Attention重みが及ぼす影響も考慮します。 最終的な勾配はローカルメモリを使って集約し、対応するAttention勾配配列に保存します。
//--- Attention gradient
     {
      if(i < variables)
        {
         float grad = 0;
         int shift_att = v * variables + i;
         float att = IsNaNOrInf(attention[shift_att], 0);
         for(int l = 0; l < total_inputs; l += total_loc)
           {
            if((l + loc) >= total_inputs)
               break;
            int shift_out = (l + loc) + v * total_inputs;
            int shift_in = (l + loc) + i * total_inputs;
            float x = IsNaNOrInf(inputs[shift_in], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float2 ms = mean_stdevs[shift_out];
            float2 ms_gr = mean_stdevs_gr[shift_out];
            float dy = -x / ms.y - (x - ms.x) * x * x * (1 - 2 * att) / (2 * pow(ms.y, 3.0f));
            float dmean = IsNaNOrInf(ms_gr.x * x, 0);
            float dstd = IsNaNOrInf(ms_gr.y * x * x * (1 - 2 * att) / (2 * ms.y), 0);
            grad += IsNaNOrInf(dy * out_gr + dmean + dstd, 0);
           }
         grad = LocalSum(grad, 1, Temp);
         if(loc == 0)
            attention_gr[shift_att] = grad;
        }
     }
  }
この実装では、NaNや無限大といった無効な数値が発生する可能性も考慮しています。こうした値が後続の計算へ伝播するのを防ぐことで、アルゴリズムの数値的な頑健性を高めています。
このように、ループによるデータ処理とローカルメモリを組み合わせることで、拡張性と計算効率を確保しています。ワークグループの各次元で処理できるサイズを超える規模の変数や時間ステップを含むデータセットにも対応できます。
以上のように、AdaptSpatialNormGradカーネルは、空間的なAttention重みを考慮しながら、正規化に関係する主要なパラメータの勾配を計算します。これにより、この機構を誤差逆伝播によって学習する複雑なモデルに組み込むことが可能になります。
ここまで説明した空間的な重み付き正規化アルゴリズムをモデル全体のアーキテクチャに統合するため、メインプログラムに専用のCNeuronAdaptSpatialNormクラスを作成します。 このクラスはCNeuronBaseOCLを継承し、ニューラルネットワークの各種構成要素からなるクラス階層に自然に統合できるようにします。 主な目的は、順伝播と逆伝播の計算を適切に管理するとともに、Attention機構に関連する補助構成要素を正しく処理することです。
新しいクラスの構造を以下に示します。
class CNeuronAdaptSpatialNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iVariables;
   uint                    iCount;
   //---
   CParams                 cEn;
   CNeuronTransposeOCL     cEnT;
   CNeuronBaseOCL          cEnEnT;
   CNeuronSoftMaxOCL       cAttan;
   CNeuronBaseOCL          cMeanSTDevs;
   //---
   virtual bool      AdaptSpatialNorm(CNeuronBaseOCL *NeuronOCL);
   virtual bool      AdaptSpatialNormGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronAdaptSpatialNorm(void) : iCount(0), iVariables(1) {};
                    ~CNeuronAdaptSpatialNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAdaptSpatialNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   CNeuronBaseOCL*   GetMeanSTDevs(void) { return cMeanSTDevs.AsObject(); }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
クラス内部には、protectedメンバーがいくつか定義されています。それぞれが構成要素の動作において重要な役割を担います。 変数iVariablesとiCountは、入力データテンソルの次元を指定し、処理対象となる空間的な範囲を定義します。 内部オブジェクトcEn、cEnT、cEnEnT、cAttanは、Attention行列の生成と学習を順番に担います。 最後のcMeanSTDevsは、Attention重みに基づいて入力データを正規化するために使用する平均と標準偏差を保存します。
内部オブジェクトはすべて静的に宣言されているため、メモリ管理と初期化が簡素化されます。 各オブジェクトについて、個別にメモリを確保したり解放したりする必要がないため、実装の信頼性と動作の予測可能性が向上します。 クラスのコンストラクタとデストラクタは空のままです。各オブジェクトはクラスのインスタンス生成時にすでに存在しており、インスタンスのライフサイクルが終了すると自動的に破棄されるためです。
クラス内部の各構成要素の初期化は、Initメソッドに集約します。 このメソッドには、作成するオブジェクトの構造を決定するための主要なパラメータを渡します。これには入力データの次元数も含まれます。 初期化処理は、モデル内部の構造との対応関係が明確になるよう、順序立てて進めます。
bool CNeuronAdaptSpatialNorm::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint units_count, uint variables,
                                   ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * variables, optimization_type, batch))
      return false;
最初に、親クラスCNeuronBaseOCLのInitメソッドを呼び出し、ニューラルネットワークノードの基本的な初期化をおこないます。 出力バッファのサイズは、系列の長さと変数の数の積として計算します。 基底クラスの初期化が成功したら、入力データテンソルのパラメータを設定し、ローカル変数iVariablesとiCountに保存します。
   iVariables = variables;
   iCount = units_count;
//---
   uint dimension = (iVariables + 1) / 2;
   uint index = 0;
   if(!cEn.Init(0, index, OpenCL, iVariables * dimension, optimization, iBatch))
      return false;
   cEn.SetActivationFunction(None);
続いて、Attention行列を構築する内部構成要素を順番に初期化します。 最初に初期化するcEnは、 学習可能パラメータを格納するテンソルです。 その次元数は、変数の数と、その半分に相当する次元数の積として定義されています。 このように次元を削減することで、後続の処理で重要となる特徴を抽出できるようにします。 この段階では、出力信号を変形させずに線形変換をおこなう必要があるため、活性化関数を明示的に無効化しています。
次に、パラメータテンソルの転置コピーを生成するため、転置処理を担当するcEnTオブジェクトを初期化します。
   index++;
   if(!cEnT.Init(0, index, OpenCL, iVariables, dimension, optimization, iBatch))
      return false;
   cEnT.SetActivationFunction(None);
   index++;
   if(!cEnEnT.Init(0, index, OpenCL, iVariables * iVariables, optimization, iBatch))
      return false;
   cEnEnT.SetActivationFunction(None);
cEnEnTは、SCNNフレームワークのAttention機構を構築するうえで重要な役割を果たします。 このオブジェクトには、学習可能パラメータテンソルと、その転置テンソルとの行列積の結果を格納します。 この演算によって、変数間の相互依存関係や関連の強さを表す対称行列が生成されます。 その結果、分析対象となる特徴量のうち、どれがほかの特徴量と強く関連しているかを明示的に表現できるようになります。
続いて、cAttanオブジェクトがAttention機構の構築を完成させます。 相関行列を入力として受け取り、SoftMaxによる正規化を適用することで、変数間にAttention重みを割り当てます。 Attention Headの数は、相関行列の行数に対応します。これにより、データ構造に合わせてAttention機構を柔軟に構成できます。
   index++;
   if(!cAttan.Init(0, index, OpenCL, iVariables * iVariables, optimization, iBatch))
      return false;
   cAttan.SetHeads(iVariables);
最後に、空間的な重み付き正規化によって計算された平均と標準偏差のペアを保存するため、cMeanSTDevsオブジェクトを初期化します。 出力の各要素について2つの値を保存する必要があるため、このオブジェクトの次元数は出力ニューロン数の2倍となります。
   index++;
   if(!cMeanSTDevs.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
      return false;
   cMeanSTDevs.SetActivationFunction(None);
//---
   return true;
  }
このように、Initメソッドでは、SCNNにおける空間的な重み付き正規化機構を適切に動作させるために必要な構成要素をすべて生成し、設定します。 各ブロックの役割が明確に分かれており、定められた順序に従って連携する、モジュール性の高い構造になっています。
内部構成要素の初期化が完了したら、次にfeedForwardメソッドを実装します。このメソッドは順伝播を担当し、Attention行列の生成と、入力データに対する空間的な重み付き正規化を実行します。 これにより、この層の処理における重要な段階が始まります。この段階では、Attention行列が形成され、入力データの空間重み付き正規化がおこなわれます。
bool CNeuronAdaptSpatialNorm::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cEn.FeedForward())
         return false;
      if(!cEnT.FeedForward(cEn.AsObject()))
         return false;
      if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(),
                 iVariables, cEnT.GetWindow(), iVariables, 1, false))
         return false;
      if(!cAttan.FeedForward(cEnEnT.AsObject()))
         return false;
     }
//---
   return AdaptSpatialNorm(NeuronOCL);
  }
ここで、アーキテクチャ上の重要な点を確認しておきましょう。Attention機構のパラメータが形成されるのは、学習中のみです。 これは意図的な仕様です。なぜなら、Attention行列自体はモデルの静的な構成要素であり、動作中に特定の入力データに合わせて適応することはないからです。 つまり、時系列内の変数間の安定した関係を反映した汎用的な重みを学習させるのです。 この方法により、新しいデータに対してもモデルの動作を安定させることができます。また、推論時にはAttention行列の計算を省略できるため、正規化の品質を損なうことなく、処理を大幅に高速化できます。
順伝播の次の段階では、AdaptSpatialNormメソッドを呼び出します。このメソッドは、同名のOpenCLカーネルを呼び出すためのラッパーとして機能します。 ここで処理がOpenCL側に引き渡され、Attention重みに基づく入力データの正規化という主要な計算が実行されます。
OpenCLカーネルを呼び出すラッパーメソッドの構成についても、少し説明しておきましょう。 アルゴリズム全体の基本的な流れは維持しつつ、コードの可読性と信頼性を高めるため、実装の構造を改善しています。 主な変更点は、OpenCL関数の呼び出し方法です。
カーネル引数の設定とカーネルの実行を簡素化し、記述方法を統一するために、いくつかのマクロを導入しました。 たとえば、setBufferマクロはOpenCL.SetArgumentBufferの呼び出しをラップし、エラー処理とデバッグ情報の出力を自動化します。エラーが発生した場合には、カーネル名、エラーコード、エラーが発生したソースコード上の行番号を表示します。 setArgumentマクロも同様の仕組みで、スカラー値をカーネル引数に設定します。
#define setBuffer(kernel, id, buffer)  if(!OpenCL.SetArgumentBuffer(kernel, id, buffer)) { \
                                          printf("Error of set parameter kernel %s: %d; line %d",
                                                 OpenCL.GetKernelName(kernel), GetLastError(), __LINE__); \
                                          return false; }
#define setArgument(kernel, id, value) if(!OpenCL.SetArgument(kernel, id, value)) { \
                                          printf("Error of set parameter kernel %s: %d; line %d",
                                                 OpenCL.GetKernelName(kernel), GetLastError(), __LINE__); \
                                          return false; }
カーネルの実行には、kernelExecuteマクロとkernelExecuteLocマクロを使用します。これらのマクロは、ワークアイテムの実行グリッドを初期化するための定型的な処理を隠蔽します。また、実行に失敗した場合には、呼び出し元の関数名やカーネル名とともに、エラーの詳細を自動的に表示します。
#define kernelExecute(kernel,offset,global)  if(!OpenCL.Execute(kernel, global.Size(), offset, global)) { \
                                                string error; \
                                                CLGetInfoString(OpenCL.GetContext(), CL_ERROR_DESCRIPTION, error); \
                                                printf("Error of execution kernel %s %s: %s", __FUNCSIG__,
                                                        OpenCL.GetKernelName(kernel), error); \
                                                return false; }
#define kernelExecuteLoc(kernel,offset,global,local)  if(!OpenCL.Execute(kernel, global.Size(), offset,
                                                                         global, local)) {  string error; \
                                                         CLGetInfoString(OpenCL.GetContext(), CL_ERROR_DESCRIPTION,
                                                                                                          error); \
                                                         printf("Error of execution kernel %s %s: %s", __FUNCSIG__,
                                                                 OpenCL.GetKernelName(kernel), error); \
                                                         return false; }
この構造により、メソッドのコードが簡潔になり、処理の流れも把握しやすくなります。また、新しいカーネルやパラメータを追加する際にも、容易に拡張できるようになります。
さらに、カーネルを実行する前には、計算デバイスの技術的な制約を考慮する必要があります。特に重要なのが、OpenCLプラットフォームがサポートするワークアイテムの各次元における最大サイズです。 これらの値はグラフィックスアダプターなどのデバイスによって異なり、コードが正しく実行されるかどうかに大きく影響します。
AdaptSpatialNormメソッドではCLGetDeviceInfoを呼び出して、各次元で許容されるワークアイテム数を取得します。 取得した値はsizes共用体に格納され、内部のデータ表現の違いを意識することなく、整数配列として参照できるようになっています。
bool CNeuronAdaptSpatialNorm::AdaptSpatialNorm(CNeuronBaseOCL *NeuronOCL)
  {
   if(!OpenCL || !NeuronOCL)
      return false;
   uint global_work_offset[3] = { 0 };
   union sizes
     {
      long data[3];
      uchar cdata[24];
     } max_workgroup_size;
   uint size = 0;
   if(!CLGetDeviceInfo(OpenCL.GetContext(), CL_DEVICE_MAX_WORK_ITEM_SIZES, max_workgroup_size.cdata, size))
      return false;
これらのパラメータを取得した後、計算全体の実行グリッドを定義するglobal_work_size配列を作成します。 特に、第2次元については、変数の数iVariablesと、デバイスが許容する最大サイズのうち、小さい方を採用します。 この次元はローカルワークグループ内のワークアイテム数に関係しており、この制限によって、データ量が多い場合でもカーネル内のループが正しく動作するようにします。
   uint global_work_size[] = { iCount, MathMin(iVariables, uint(max_workgroup_size.data[1])), iVariables};
   uint local_work_size[] = { 1, global_work_size[1], 1};
//---
   uint kernel = def_k_AdaptSpatialNorm;
   setBuffer(kernel, def_k_asn_inputs, NeuronOCL.getOutputIndex())
   setBuffer(kernel, def_k_asn_mean_stdevs, cMeanSTDevs.getOutputIndex())
   setBuffer(kernel, def_k_asn_attention, cAttan.getOutputIndex())
   setBuffer(kernel, def_k_asn_outputs, getOutputIndex())
   kernelExecuteLoc(kernel, global_work_offset, global_work_size, local_work_size)
//---
   return true;
  }
同時に、local_work_size配列を作成し、第2次元のワークアイテム数を明示的に指定します。 この設定により、特徴量ベクトルの処理においてローカルメモリを効率的に利用できます。
続いて、先ほど定義したsetBufferマクロを使用し、カーネルの各引数に対応するバッファを順番に設定します。これにより、パラメータの初期化方法を統一し、安全性を高めています。 最後に、kernelExecuteLocマクロを呼び出し、指定した制約と計算グリッドの構造に従ってAdaptSpatialNormカーネルを実行します。
このように、カーネルを呼び出すためのラッパーを実装するだけでなく、対象デバイスの技術的な能力に合わせてアルゴリズムを適応させる仕組みも構築しています。これにより、幅広いデバイスでの互換性と安定した動作を確保します。
次に重要となるのが、calcInputGradientsメソッドで実装する誤差勾配の伝播です。 この処理では、内部オブジェクトを通じて誤差を逆方向に伝えます。 蓄積された勾配は順次処理され、入力側の学習可能パラメータへと伝播していきます。 この処理は、予測値と実際の値の差に関する情報に基づいて重みを更新できるようにするため、アルゴリズム全体の中でも特に重要です。
bool CNeuronAdaptSpatialNorm::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!AdaptSpatialNormGrad(NeuronOCL))
      return false;
処理はAdaptSpatialNormGradメソッドの呼び出しから始まります。このメソッドも、順伝播側の対応するメソッドと同様、OpenCLカーネルを呼び出すためのラッパーです。 正規化ブロックの出力から、入力データとAttention行列の学習可能パラメータへ勾配を伝播させます。
AdaptSpatialNormGradメソッドの実装は、基本的に順伝播カーネルを実行する際の構造に従っています。 グローバルおよびローカルのワークサイズを定義し、マクロを使用してバッファを設定したうえで、正しい順序でカーネルにパラメータを渡します。 ただし、誤差逆伝播の性質上、重要な違いがあります。
順伝播では各要素を独立して処理していましたが、勾配の計算では、入力データの各要素について、Attention重みを介して関連する複数の系列からの勾配寄与を集約する必要があります。 そのため、出力テンソルの複数の要素にアクセスし、より複雑な集約処理をおこなわなければなりません。
Attention重みについても、専用の処理が必要です。 ここでは時間方向に沿って勾配を集約し、対応する重みが適用された系列内のすべての位置から情報を集めます。 これは、特に大規模な入力テンソルを扱う場合、計算負荷の大きい処理となります。そのため、ワークグループのサイズを慎重に設定する必要があります。
そこで、勾配を集約する軸の大きさを考慮しながら、対象のOpenCLデバイスがサポートする最大サイズを超えないようにワークグループのサイズを設定します。 この方法によって、ハードウェアの制約を満たすと同時に、不要なオーバーフローやメモリアクセスの競合を回避し、処理効率を高めます。
OpenCL側の計算が完了したら、メソッドは通常のニューラルネットワーク処理へと進みます。 Attention行列を構成する内部オブジェクトを通じて、誤差勾配を順番に逆伝播させます。
   if(!cEnEnT.CalcHiddenGradients(cAttan.AsObject()))
      return false;
   if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
                  cEnT.getOutput(), cEnT.getGradient(),
                  cEnEnT.getGradient(), iVariables,
                  cEnT.GetWindow(), iVariables, 1, false))
      return false;
   if(!cEn.CalcHiddenGradients(cEnT.AsObject()) ||
      !SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(), cEn.getGradient(),
                       cEnT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEn.Activation() != None)
      if(!DeActivation(cEn.getOutput(), cEn.getGradient(), cEn.getGradient(), cEn.Activation()))
         return false;
//---
   return true;
  }
このように、calcInputGradientsメソッドは明確に整理された手順で構成されており、ネットワーク内で誤差を一貫性のある形で逆伝播させます。
パラメータの最適化処理は、ここでは可能な限り簡潔に実装されていますが、その目的は非常に明確です。 処理全体は、学習可能なAttentionパラメータを保持する単一の内部オブジェクトcEnに制御を委ねることに集約されます。 このオブジェクトは、相関行列の構築に用いられるパラメトリックブロックの中核を成します。 モジュール内で学習可能な部分については、このオブジェクトが単独ですべての責任を担います。
bool CNeuronAdaptSpatialNorm::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   return cEn.UpdateInputWeights();
  }
さらに詳しく検討できるよう、CNeuronAdaptSpatialNormクラスと、そのすべてのメソッドの完全なソースコードは添付ファイルに含まれています。
SCNN Encoder
時系列データから個々の成分を抽出するオブジェクトを構築したら、次の自然なステップは、それらを統合し、一貫性のある単一の構造、すなわちSCNN Encoderを構成することです。 この段階では、あらかじめ用意した各ブロックを明確な順序で組み合わせ、分析対象のデータを安定性と信頼性を保ちながら、柔軟に処理できるようにします。
SCNN Encoderの最大の特徴は、モジュール型のアーキテクチャにあります。 4つの並列ブランチで構成され、それぞれが異なる時間スケールの分析を担当します。 1つ目は長期的なトレンド、2つ目は季節性のパターン、3つ目は短期的な変動を捉え、4つ目はデータを適応的に正規化することで、個々の特徴量間の関係性を強調します。
これらのアルゴリズムはすべて、専用のCNeuronSCNNEncoderオブジェクト内に丁寧に実装されています。 その構造には、ここまで説明してきた処理ロジックが反映されており、系列全体を表す統合的な表現を生成するための基盤となります。この表現は、情報を圧縮しながら重要な意味を保持しており、後続の予測処理に適したものです。
class CNeuronSCNNEncoder   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronPeriodNorm       cLongNorm;
   CNeuronTransposeVRCOCL  cSeasonTransp;
   CNeuronPeriodNorm       cSeasonNorm;
   CNeuronTransposeVRCOCL  cUnSeasonTransp;
   CNeuronPeriodNorm       cShortNorm;
   CNeuronAdaptSpatialNorm cAdaptSpatNorm;
   CNeuronBaseOCL          cConcatenated;
   CNeuronSwiGLUOCL        cProjection;
   CNeuronTransposeOCL     cTranspose;
   CNeuronConvOCL          caFusion[2];
   CNeuronBaseOCL          cFusionOut;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSCNNEncoder(void) {};
                    ~CNeuronSCNNEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinAR; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
新しいクラスの構造には、Encoder内でそれぞれ明確に定められた役割を果たす、複数の内部オブジェクトが含まれています。 これらのオブジェクトの具体的な役割については、アルゴリズムの処理ロジックを詳しく見ていく中で、後ほど説明します。 ここでは、アーキテクチャ上の重要な点を一つ挙げておきます。それは、これらの構成要素がすべて静的に宣言されていることです。 つまり、必要なメモリはあらかじめ確保され、各オブジェクトのライフサイクルは、親となるCNeuronSCNNEncoderオブジェクト自体のライフサイクルに厳密に従います。 この設計により、追加の処理が不要となるため、クラスのコンストラクタとデストラクタは空のままです。
宣言された内部オブジェクトと継承した内部オブジェクトの初期化は、すべて Init メソッドでおこないます。このメソッドのパラメータには、オブジェクトのアーキテクチャを定義する各種定数が渡されます。
bool CNeuronSCNNEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint units_count, uint variables, uint forecast,
                              uint season_period, uint short_period,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count + forecast, variables,
                                                                       optimization_type, batch))
      return false;
   SetActivationFunction(None);
まず、親クラスに実装された同名の基底メソッドを呼び出し、アーキテクチャの主要なパラメータを設定します。 初期化が正常に完了したら、この段階で非線形な歪みが生じないよう、中立的な活性化関数を設定します。
続いて、時系列データの前処理を担う各モジュールを順番に初期化していきます。 最初に、長期成分を正規化するブロックを初期化します。
   uint index = 0;
   if(!cLongNorm.Init(0, index, OpenCL, 1, units_count, variables, optimization, iBatch))
      return false;
   cLongNorm.SetActivationFunction(None);
次に重要なのは、季節成分を抽出することです。 SCNNフレームワークの原著者が提案した基本概念では、この処理は、季節周期に相当するステップ幅でデータを正規化するものとして解釈されています。 一見すると、これを実現するには専用のモジュールが必要に思えるかもしれません。 しかし、私たちは古典的なシステム設計の原則に沿って、より合理的なアプローチを採用しました。
そこで、一定の周期ごとにデータを処理する汎用的な正規化オブジェクトを開発しました。 このオブジェクト自体は、季節構造に関する情報を持ちません。季節構造は、分析対象となる配列の表現を変更することで初めて現れます。 具体的には、時間ステップの系列を季節周期の長さに応じて転置するだけで、必要な間隔のデータが自動的にグループ化されます。 こうして新たに形成された系列は、周期正規化モジュールが想定する入力形式にそのまま適合します。
このように、正規化オブジェクト自体の構造には一切手を加えることなく、最小限の変更で季節成分を抽出する強力な仕組みを実現できます。 必要なのは、入力データを適切に並べ替えることだけです。その後の処理は、実績があり、十分に調整されたアルゴリズムに委ねられます。
   index++;
   if(!cSeasonTransp.Init(0, index, OpenCL, variables, units_count / season_period, season_period,
                                                                            optimization, iBatch))
      return false;
   cSeasonTransp.SetActivationFunction(None);
   index++;
   if(!cSeasonNorm.Init(0, index, OpenCL, cSeasonTransp.GetCount(), season_period, variables,
                                                                       optimization, iBatch))
      return false;
   cSeasonNorm.SetActivationFunction(None);
   index++;
   if(!cUnSeasonTransp.Init(0, index, OpenCL, variables, season_period, cSeasonTransp.GetCount(),
                                                                           optimization, iBatch))
      return false;
   index++;
季節成分を抽出した後、逆転置処理によってデータを元の配列表現に戻し、短期成分を正規化するブロックを初期化します。
   if(!cShortNorm.Init(0, index, OpenCL, units_count / short_period, short_period, variables, optimization, iBatch))
      return false;
   cSeasonNorm.SetActivationFunction(None);
   index++;
   if(!cAdaptSpatNorm.Init(0, index, OpenCL, units_count, variables, optimization, iBatch))
      return false;
   cAdaptSpatNorm.SetActivationFunction(None);
次に、入力系列内の各変数間の関係性を考慮する、適応型空間正規化を初期化します。
各ソースからのデータの準備が整ったら、すべての正規化ブロックの出力を集約し、単一の特徴行列に統合するマージモジュールを作成します。 このモジュールのサイズは、各ブロックの主出力だけでなく、それぞれの正規化ブロックに関連する統計量も考慮して、動的に算出されます。
   index++;
   uint concatSize = units_count * variables;                                         //inputs
   concatSize += cLongNorm.Neurons() + cLongNorm.GetMeanSTDevs().Neurons();           // long term
   concatSize += cSeasonNorm.Neurons() + cSeasonNorm.GetMeanSTDevs().Neurons();       // seasons
   concatSize += cShortNorm.Neurons() + cShortNorm.GetMeanSTDevs().Neurons();         // short term
   concatSize += cAdaptSpatNorm.Neurons() + cAdaptSpatNorm.GetMeanSTDevs().Neurons(); // spatial
   if(!cConcatenated.Init(0, index, OpenCL, concatSize, optimization, iBatch))
      return false;
   cConcatenated.SetActivationFunction(None);
次に配置するのは、射影ブロックです。このブロックは、多次元の特徴空間を効率的に圧縮し、その構造を再編成する役割を担います。
   index++;
   if(!cProjection.Init(0, index, OpenCL, concatSize / variables, concatSize / variables,
                             units_count + forecast, 1, variables, optimization, iBatch))
      return false;
その出力は転置モジュールに渡され、後続の処理で必要となる形式に応じて、時間方向と特徴量方向の表現を相互に変換します。
   index++;
   if(!cTranspose.Init(0, index, OpenCL, variables, units_count + forecast, optimization, iBatch))
      return false;
   index++;
   if(!caFusion[0].Init(0, index, OpenCL, variables, variables, variables, units_count + forecast,
                                                                            optimization, iBatch))
      return false;
   caFusion[0].SetActivationFunction(TANH);
   index++;
   if(!caFusion[1].Init(0, index, OpenCL, variables, variables, variables, units_count + forecast,
                                                                            optimization, iBatch))
      return false;
   caFusion[1].SetActivationFunction(SIGMOID);
   index++;
   if(!cFusionOut.Init(0, index, OpenCL, caFusion[0].Neurons(), optimization, iBatch))
      return false;
//---
   return true;
  }
最終段階では、異なる信号フィルタリング機構を実装した2つの畳み込み層を並列に配置します。 一方の層では双曲線正接関数(tanh)を使用し、出力を滑らかに飽和させます。もう一方の層ではシグモイド関数を使用し、出力値をロジスティック関数に基づく範囲内に収めます。 これら2つの層の出力は、最後の畳み込みモジュールで統合され、これをもってアーキテクチャ全体が完成します。
ここまで、かなりの作業を進めてきました。記事の分量も大幅に増えています。 この先は、Encoderの順伝播と逆伝播を実現する、複雑なアルゴリズムを詳しく検討します。ここは特に注意深く取り組む必要がある段階です。 そこで、いったん短い休憩を挟み、ここまでの内容を整理し、理解を深める時間を取るのがよいでしょう。 次回の記事では、引き続き実装を進めて今回の作業を完成させるとともに、実際の過去データを用いて、実装した手法の有効性を評価します。
結論
本記事では、SCNNフレームワークの実装における次の段階として、適応型空間正規化オブジェクトの構築と統合、さらに主要な構成要素を単一のEncoderに統合するまでの過程を詳しく解説しました。 適切に設計されたアーキテクチャと、最新の OpenCLによる並列計算技術を組み合わせることで、時系列データに含まれる構造的な成分を効果的に抽出し、後続の予測処理に向けて高品質なデータを準備できることを示しました。
次回の記事では、実データを用いたSCNNフレームワークのテストと性能評価に焦点を当て、研究をさらに進めます。これにより、今回実装した手法の実用的な意義と、金融分野の予測タスクにおける有効性を検証します。
リンク
- Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18982
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:構造成分の分離(最終回)
 取引におけるニューラルネットワーク:構造成分の分離(SCNN)
 決闘者アルゴリズム
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索