

取引におけるニューラルネットワーク:Temporal Queryモデル(TQNet)
 24
 0

はじめに
金融分野における多変量時系列予測は、時間との戦いです。精度と速度が何よりも重要になります。 為替レート、株価指数、取引高、金利、そして流動性指標が絶えず相互に影響し合い、複雑で刻々と変化するシステムを形成しています。 トレーダーや資産運用担当者、アナリストにとって、常に一歩先を行くには、さまざまな変数がリアルタイムで互いにどのような影響を及ぼしているのかを把握することが欠かせません。 こうした市場の全体像を捉える能力こそ、現代の金融市場における予測の核心です。
しかし、金融データは、管理された実験室環境で得られる測定データとは異なります。 市場は独自の動きを見せます。ニュースを受けて価格が急騰・急落し、ボラティリティが高まる時期もあれば、落ち着く時期もあります。また、予期せぬ相関関係が現れたかと思えば、わずか数時間で消えてしまうこともあります。 さらに、測定誤差、気配値の遅延、データの欠落といったノイズが加わることで、ランダム性に満ちた環境から、いかに信頼できるシグナルを抽出するかという典型的な問題に直面します。 特に厄介なのは、ある時間区間における変数間の局所的な関係が、観測期間全体を通して見られる傾向と食い違う場合です。 たとえば、ここ数か月の大きな流れが反対方向に向かっているにもかかわらず、たった1日の値動きだけを基に為替レートを予測しようとするようなものです。
このギャップを埋めるため、論文「Temporal Query Network for Efficient Multivariate Time Series Forecasting」では、Temporal Query (TQ)と呼ばれる新たな手法が提案されました。これは、市場の局所的な動きと大局的な傾向の両方を捉えるための仕組みです。 その中核となるのは、時間軸に沿って循環的にシフトされる学習可能なベクトルです。これにより、データの履歴全体を通じて裏づけられた、変数間の安定的な関係を捉えます。 一方、気配値や各種指標などの市場データそのものは、Multi-Head AttentionにおけるKeyとValueとして用いられ、各時点に固有の特徴を反映します。 この仕組みによって、モデルは市場の急激な変化に対応する能力を保ちながら、より根本的で安定した市場の関係性も活用できるようになります。
この原理を基に開発されたのがTemporal Query Network (TQNet)フレームワークです。TQNetは、相互に関連する複数の金融商品の値動きを予測するための、シンプルでありながら高い性能を備えたアーキテクチャです。 その構造は極めて簡潔で、Multi-Head Attention層を1層と、浅い全結合ニューラルネットワークを組み合わせた構成となっています。 しかし、そのシンプルな構造の中に、金融商品間の微妙な依存関係を捉える能力が備わっています。 このフレームワークの開発者らの実験では、TQNetは複雑なアーキテクチャに匹敵する予測精度を達成しながら、軽量な線形モデルに匹敵する計算速度を実現しました。
TQNetのもう一つの重要な特徴は、予測期間が異なる場合にも対応できることです。局所的な依存関係と大域的な依存関係のバランスを取るという同じ原理を適用することで、短期から長期まで、さまざまな予測期間に対応できます。 市場の状況が数分で一変する一方、より長期的なパターンも予測に影響する金融市場において、これは特に重要な特性です。
今日の金融市場で優位に立つために必要なのは、目先の動きだけに注目することでも、大局的な傾向だけに頼ることでもありません。この二つの視点を適切に組み合わせることです。Temporal Query(TQ)とTQNetは、まさにその実現を目指すアプローチです。シンプルな構造の中に高度な予測メカニズムを備えたTQNetは、金融市場の分析や予測に取り組む専門家にとって、注目に値するフレームワークといえるでしょう。
TQNetアルゴリズム
多変量時系列予測(Multivariate Time Series Forecasting, MTSF)の目的は、相互に関連する複数の変数の将来の値を同時に予測することです。 形式的には、時刻tにおいて、過去の観測データからなる系列Xt ∈ RC*Lが与えられています。 ここで、Cは変数またはチャネルの数(通貨ペア、市場指数、取引高、その他の指標など)を表し、Lは観測窓の長さ、すなわち予測に用いる過去のデータポイントの数を表します。 目標は、予測期間 H にわたる将来の値を推定し、同じ変数の将来の系列Yt ∈ RC*Hを生成することです。
金融市場に当てはめると、指定した期間の過去データを基に、今後数時間の主要通貨ペアの気配値、今後数取引日の主要株価指数の水準、あるいは数週間先までの金利の動向を予測することに相当します。 このとき重要なのは、各変数に固有の時間的パターンだけでなく、変数間の相関関係も考慮することです。市場は相互につながったシステムとして動いており、ある市場で生じた変化が、別の市場に即座に波及することもあるからです。
こうした課題に対応するために提案されたのが、Temporal Query Network (TQNet)フレームワークです。 シンプルなアーキテクチャでありながら、変数間の依存関係を捉える仕組みと、時間的な構造をモデル化する仕組みという、2つの重要な機能を組み合わせています。
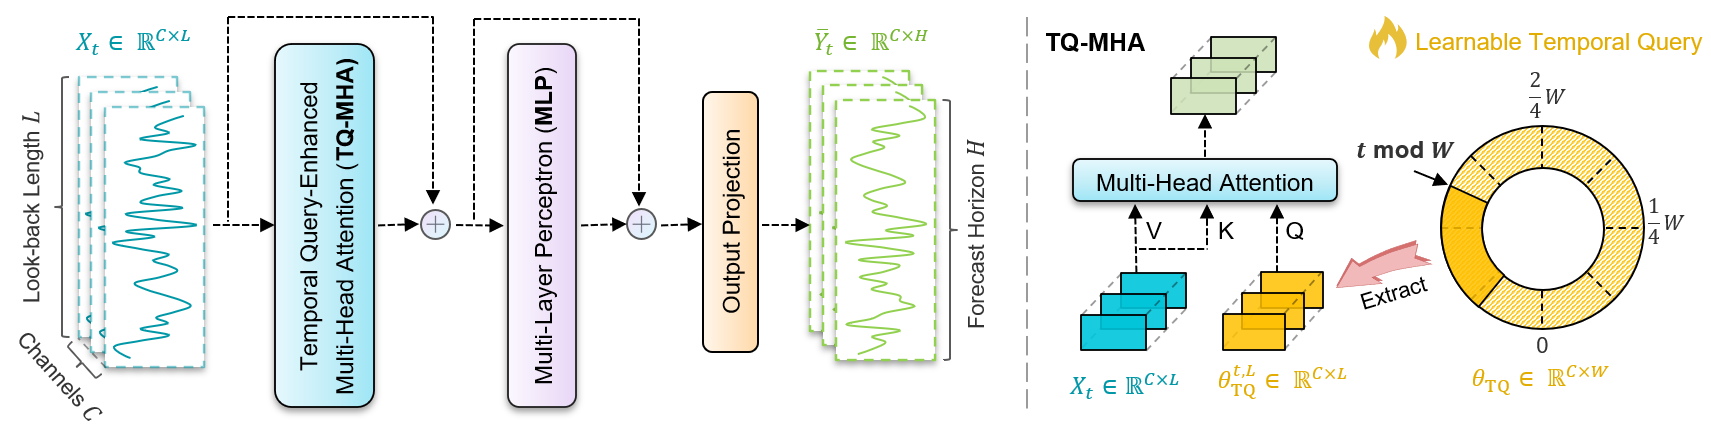
TQNetでは、まず分析対象の系列Xtを、Temporal Query(TQ)コンポーネントを組み込んだMulti-Head Attention層(TQ-MHA)に入力します。 この層は、変数間の相関関係を抽出して統合します。対象となるのは、時間を通じて比較的安定した大域的な相関と、その時点の市場環境に固有の局所的な相関の両方です。 続いて、その出力を、全結合層からなる浅い多層パーセプトロン(MLP)で処理します。MLPは、時間方向の依存関係をさらに精緻化し、トレンドや変化のリズムを捉える役割を担います。
TQ-MHAとMLPの両ブロックには残差接続が組み込まれており、学習の安定性を高め、大規模なデータセットで学習する際の性能低下のリスクを抑えます。 最後に、ドロップアウトを備えた線形層によって、得られた隠れ表現を出力空間へ射影し、予測値Ŷt ∈ RC*Hを生成します。
TQNetの重要な構成要素が、Temporal Query(TQ)という手法です。これは、Attention機構で使用するQueryを生成するための独自の方法です。 その基本的な考え方はシンプルです。従来のSelf-Attentionでは、Queryを入力データから直接生成します。一方、TQNetでは、学習可能なベクトル群を用意し、それらを時間軸に沿って周期的にシフトさせることでQueryを生成します。 この方法により、短期的な市場変動やノイズに左右されにくい、変数間の大域的な相関関係を捉えることができます。
形式的には、分析対象データの周期長Wを設定し、パラメータ行列θTQ ∈ RC×Wを初期化します。 ここで、Cは変数(チャネル)の数、Wはベクトルの長さであり、周期的なシフトの間隔を決定します。 これらのパラメータは初期状態ではゼロに設定され、学習を通じてデータ内部の依存関係を反映するように調整されます。 Wの設定は特に重要です。金融市場では、たとえば1週間の取引セッション数、繰り返し現れる流動性のサイクル、その他の安定した季節性パターンなどに対応させることが考えられます。 Wは、市場に関する専門知識に基づいて設定することも、統計的手法を用いて決定することもできます。
TQの仕組みを具体的に説明しましょう。時刻tのサンプルを分析する際、モデルはパラメータ行列θTQから長さLの部分を抽出します。その開始位置はt mod Wによって決まり、抽出範囲が行列の末尾に達した場合は、先頭に戻って循環的に取り出します。 この仕組みにより、Wステップだけ離れた2つの時点では、同一のクエリベクトルが使用されます。 これによって、モデルに周期的な記憶のような効果が生まれます。つまり、学習によって獲得した大域的な依存関係を繰り返し利用できるため、市場で発生するランダムな変動の影響を抑えられるのです。
金融市場に置き換えるなら、熟練したトレーダーが、特定の曜日や取引時間帯に繰り返し現れる典型的な市場の動きを記憶し、その知識を現在の相場分析に活用するようなものです。
TQNetでは、この仕組みをMulti-Head Attention機構(TQ-MHA)に組み込んでいます。 クエリ(Query)入力データそのものからではなく、大域的な依存関係を反映する時間的なTQベクトルから形成されます。 一方、キー(Key)とバリュー(Value)は、引き続き現在分析中の系列Xtから生成されます。これにより、その時点の市場状況に固有の局所的な情報を保持できます。
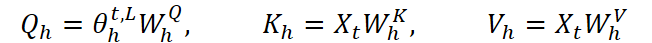
添字hはAttention Headの番号を表します。また、W h Q、W h K、W h Vは、それぞれQuery、Key、Valueを生成するための学習可能な射影行列です。
次に、各HeadについてAttentionを計算します。
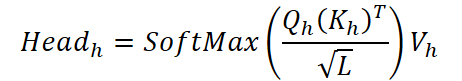
その後、従来のMulti-Head Self-Attentionと同様に、各Headの出力を結合し、最終的な射影を適用します。
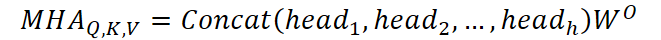
大域的なQueryと局所的なKey/Valueを組み合わせることで、ノイズに対する頑健性と現在のコンテキストへの適応力を両立できます。 実際の市場では、穏やかな相場が突然、激しい変動局面へと移行することがあります。このような環境では、両者のバランスが極めて重要です。 TQNetは、予想外のマクロ経済指標の発表やニュースを受けた急激な値動きなど、特異な事象に対応する能力を維持しながら、時間の経過を通じて持続する大域的な依存関係を予測の基盤として活用します。
Temporal Query (TQ)手法の目的は、時系列に含まれる大域的な関係と局所的な関係を、Attention機構に統合することです。 その考え方はシンプルですが効果的です。クエリ(Query)は生データから直接生成するのではなく、周期的にシフトする学習可能なベクトルθTQから生成し、キー(Key)キーは元の入力系列から抽出します。 これにより、市場全体の傾向と、個々のデータ区間に固有の特徴とのバランスを取ることができます。
大域的な依存関係と局所的な依存関係が予測性能に及ぼす影響を評価するため、TQNetの開発者らは、次の3つの方式を比較しました。
- 従来のアプローチでは、QueryとKeyの両方を生データから構築します。 この方式では、Attention機構は各サンプルに固有の局所的な関係を捉えます。
- ハイブリッド方式は、TQNetで採用されている方式です。 Queryは学習可能なTQベクトルから生成し、Keyは入力データから生成します。 その結果、Attention重みの計算において、大域的な依存関係と各サンプルに固有の依存関係の両方を考慮できます。全体的なトレンドと短期的な変動が複雑に絡み合う金融市場では、特に重要な特徴です。
- 大域的な依存関係のみを用いる方式では、QueryとKeyの両方を学習可能なTQベクトルから生成します。 この方式では、局所的な変動を考慮せず、時系列全体の構造に焦点を当てます。
100を超える変数を含む大規模な多変量データセットを用い、4つの予測期間にわたって平均した実験結果では、TQNetのハイブリッド方式が最も高い性能を示しました。 この手法は、両方の相関を組み合わせます。 次いで、サンプル固有の関係のみを扱う従来方式が続き、大域的な依存関係のみを用いる方式は最も低い性能となりました。 この結果は、大域的な依存関係と局所的な依存関係をバランスよく組み合わせることが、予測精度とモデルの頑健性の向上につながることを示しています。変化の激しい金融時系列を扱ううえで、重要な知見といえるでしょう。
TQ-MHA層が変数間の比較的安定した関係を特定し、それらを局所的な情報と統合した後は、多層パーセプトロン(MLP)がその出力をさらに処理します。 MLPの役割は、抽出された特徴を時間方向に沿って分析し、トレンド、変動のリズム、変数間の関係における時間的な遅れなどを捉えることです。
シンプルな構造でありながら、MLPは時間的パターンを捉えるうえで効果的な手法です。 TQNetでは軽量な構成を採用しており、GeLU活性化関数を用いた2つの全結合層で実装されています。GeLUは、ReLUと比べて滑らかな活性化特性を持ち、複雑な市場変動を扱う際の特徴抽出に役立ちます。
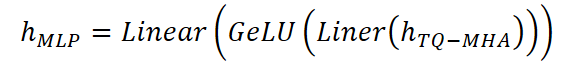
金融分析の場面に例えるなら、アナリストが市場の主要な相関関係を整理した後、さらに詳しく検討する段階に相当します。たとえば、日中の値動きのパターンを特定し、変動幅を評価し、価格の動きが持続する傾向や反転の兆候を検出するといった作業です。
こうして得られた表現は、出力射影層に渡されます。 ここでは線形変換を適用し、内部表現を指定された予測期間Hに対応する出力へと変換します。 また、ドロップアウトを適用することで、過学習を抑制し、モデルの汎化性能を高めることができます。
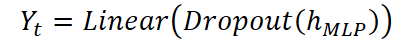
TQNetが特に重視しているのが、データ分布の変化に対する頑健性です。 金融市場では、こうした変化が頻繁に発生します。為替レート、商品価格、株価指数などは、ニュース、マクロ経済要因、規制上の決定などによって、統計的な特性が大きく変化することがあります。 モデルが過去のデータ分布に過度に依存していると、市場環境が変化した際に予測の有効性が急速に低下しかねません。
この問題に対処するため、TQNetでは可逆インスタンス正規化(RevIN)を採用しています。RevINは、近年のさまざまな時系列予測モデルでも利用されている手法です。 基本的な仕組みは、入力データをインスタンスごとに正規化してからモデルに入力し、予測を生成した後に元のスケールへ戻すというものです。一般的には、入力データから平均値を差し引き、標準偏差で割ることで正規化します。予測後には、そのときに用いた統計量を使って逆変換をおこないます。 金融取引の観点から見ると、これは、市場環境が変化するたびに分析の基準を見直す熟練アナリストの姿に例えられます。 正規化によって、平均値やスケールの短期的な変化が予測に及ぼす影響を軽減できるため、モデルは価格水準やボラティリティの変化そのものに過度に左右されず、時系列に含まれるパターンを捉えやすくなります。
このように、TQNetでは、MLPと出力射影層が予測を仕上げる役割を担います。TQ-MHAが変数間の依存関係の骨格を形成し、MLPがその特徴を時間方向に沿ってさらに精緻化します。そして、RevINがデータ分布の変化に伴う影響を軽減します。 その結果、TQNetは、現在の市場環境に固有の局所的な特徴を考慮しながら、変数間の大域的な関係も反映した予測を生成することを目指します。
以下に、TQNetフレームワークの著者らによる構成図を示します。
MQL5での実装
ここまで、TQNetフレームワークの理論的な基礎を解説し、大域的な相関と局所的な相関を組み合わせることで予測精度の向上が期待できることを見てきました。 ここからは、理論から実践へと進みます。本節では、これらの考え方をMQL5環境で実装する方法の一つを取り上げ、金融市場の時系列分析と予測に適したアーキテクチャへと落とし込んでいきます。
ここでは、QueryやKeyの生成から、データの正規化、出力の射影に至るまで、各要素をコードで実装します。 これにより、理論が実際の取引に活用できるツールへとどのように変換されるかを示します。 また、リアルタイムの気配値を用いてTQNetの有効性を検証し、方向感の乏しい横ばい相場から急速なトレンド相場まで、さまざまな市場局面での頑健性を評価します。
これまでにさまざまなAttentionモジュールを開発してきた経験を活かし、TQNetと従来のCross-Attentionブロックを詳しく比較してみましょう。 従来のCross-Attentionでは、異なるデータソースから生成されたクエリ(Queries)、キー(Keys)、バリュー(Values)の各テンソルを用いて処理をおこないます。 この仕組みにより、一方の系列がもう一方の系列に含まれる情報を選択的に処理し、両者の間にある関係性を特定できます。
TQNetでは、この原理を時系列予測という目的に合わせ、より工夫された形で応用しています。 学習可能なベクトルθTQに符号化された大域的・総合的な情報をQueryに持たせる一方、Keyには元のデータが持つ局所的な構造とのつながりを維持させます。 この組み合わせは金融市場において重要な役割を果たします。季節性や繰り返し現れるマクロ経済サイクルといった全体的なパターンを、価格の急騰・急落、市場ノイズ、短期的な需給の不均衡など、局所的な変動と統合する必要があるためです。
このように、TQNetは、大域的な記憶とその時々の市場シグナルを一つの仕組みに統合した、いわばハイブリッド型のCross-Attention機構と捉えることができます。 これにより、考慮できる変数間の関係性が広がるだけでなく、市場のレジームが急激に変化した場合にも、モデルの頑健性を高めることができます。この特性は、為替、株式、商品市場など、ボラティリティの高い市場で特に有用です。
ここで重要になるのが、Queryの生成元となる大域的な相関関係のパラメータテンソルを構築し、学習させることです。 学習可能なベクトルθTQから構成されるこのテンソルには、変数間の大域的な関係性に関する情報が保持されており、アテンション機構を適切に構成するための基盤となります。
このテンソルの学習には、慎重な設計が必要です。ノイズや局所的な外れ値の影響を受けにくい状態を保ちながら、データの構造に適応し、安定した相関関係を捉えなければなりません。 金融時系列では、流動性の短期的な急変から予期せぬ市場イベントまで、資産価格が大きく変動することがあるため、この点が特に重要です。
このようなテンソルを構築して学習させることで、モデルは新しい系列を処理する際にも、大域的な市場パターンを活用できるようになります。このテンソルに基づいて生成されるQueryは、変数間の重要な関係性に注意を向けるためのフィルタとして機能します。同時に、それらの関係性を、現在の時間区間に固有の局所的な特徴と組み合わせます。 こうしてTQNetは、大域的な記憶がもたらす安定性と個々の市場状況への適応力を両立し、高い予測精度を実現することを目指します。
私たちの開発環境には、学習可能なパラメータの生成と管理をおこなうアルゴリズムを実装したCParamsオブジェクトがすでに用意されています。 理論上は、これを利用して大域的な相関テンソルを構築することも可能です。 しかし、ここで検討すべきなのは、その方法が計算効率の面で適切かどうかという点です。
金融市場の多変量時系列予測では、分析対象のデータ周期全体にわたる相関関係を保持できる、比較的大きなテンソルが必要になります。 一方、テンソルを過度に大きくすると、計算コストが増大し、学習速度やリアルタイム処理の性能が低下します。
さらに、こうした計算リソースの大部分は、実際には無駄になってしまいます。 学習時も予測時も、各ステップで使用するのは、現在の予測ウィンドウに対応するテンソルのごく一部だけだからです。 残りの部分は使用されず、それらに対する演算は実質的に何の処理もおこなわない、いわゆるノーオペレーション(no-op)となります。
しかも、テンソルのサイズと不要な演算の数は、周期の長さと分析対象の変数の数に比例して増加します。 金融データでは、チャネル数が数百に達し、数千の時間ステップに及ぶ過去データを扱うこともあります。このような条件では、計算の非効率性がすぐにボトルネックとなり、学習速度が低下し、モデル全体の性能にも悪影響を及ぼします。
したがって、予測精度を損なうことなく大域的な相関関係を捉える能力を維持しながら、不要な計算を削減する方法を見つけることが重要です。
そこで私たちは、相関パラメータの保存と更新の方法を見直し、より効率的な解決策を検討することにしました。 テンソル全体を生成するために単一の静的なCParamsオブジェクトを使用する代わりに、そのオブジェクトの修正版を作成し、その内部に学習可能なパラメータオブジェクトの配列を実装しました。
この配列の各要素は、それぞれ独立した時間ステップに対応します。これにより、現在の予測ウィンドウに関係するデータとパラメータだけを使用できるようになります。 変数間の大域的な関係性を分析期間全体にわたって捉える能力を維持しながら、不要な計算を大幅に削減できます。
言い換えれば、各要素が特定の時点に対応する動的パラメータテンソルを実現したことになります。これにより、使用しない時間ステップに対する不要な演算を完全に排除できます。 その結果、TQNetの実装は、計算リソースをより効率的に利用できるようになり、大規模な金融データセットにも対応しやすくなります。
動的パラメータテンソルの考え方と、各時間ステップにオブジェクトを配置する必要性を確認したところで、次は具体的なコード実装を見ていきましょう。 このアーキテクチャで重要な役割を担うのが、CCircleParamsクラスです。このクラスは、全結合ニューラルネットワーク層であるCNeuronBaseOCLを継承し、その基本機能を引き継いでいます。
class CCircleParams  :  public CNeuronBaseOCL
  {
protected:
   CLayer            cOnes;
   CNeuronBaseOCL    *cCurrent;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override          { return FeedForward(); }

   ///\ingroup neuron_base_opt
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override   { return UpdateInputWeights(); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override   { return true; }

public:
                     CCircleParams(void) : cCurrent(NULL) {};
                    ~CCircleParams(void)  {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint numNeurons, uint period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   virtual bool      Identity(const int rows, const int cols);
   virtual bool      Zeros(void);
   //---
   virtual bool      FeedForward(void);
   virtual bool      UpdateInputWeights(void);
   virtual bool      SetPosition(int position);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defCircleParams; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat   *getWeightsParams(void);
   virtual int       GetPeriod(void) const { return cOnes.Total(); }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
このクラスは、学習可能な相関パラメータを格納・管理するための専用コンテナです。パラメータが正しく更新されるとともに、OpenCLのコンテキスト機構と効率的に連携できるように設計されています。これは、GPUを使用して大規模な金融データセットを処理する際に、特に重要となります。
CCircleParamsクラスでは、cOnesオブジェクトが特別な役割を担います。これは、オブジェクトの周期的な性質に対応する、学習可能なテンソルを格納した動的配列です。 一方、cCurrentパラメータは、この配列内で現在アクティブなオブジェクトを指し、処理対象となる時間ステップのオブジェクトを参照します。 これにより、モデルはコンテキストを動的に切り替えながら、各時間区間を高い精度で処理できます。同時に、分析期間全体を通じて蓄積された大域的な依存関係も保持されます。
CCircleParamsオブジェクトの構造は、初期化メソッドであるInit内で生成・設定されます。このメソッドは、相関パラメータ用テンソルが正しく機能するために必要なすべての構成要素を準備する役割を担います。
bool CCircleParams::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint numNeurons, uint period,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
このメソッドが呼び出されると、まず親クラスであるCNeuronBaseOCLによって継承されたインターフェースが初期化され、オブジェクトの基本パラメータが設定されます。 この段階でエラーが発生した場合、メソッドは直ちにfalseを返し、その後の処理で不具合が生じるのを防ぎます。
次に、動的配列cOnesを準備します。配列をクリアしたうえでOpenCLコンテキストに関連付け、以降のテンソル操作をGPU上で効率的に実行できるようにします。
   cOnes.Clear();
   cOnes.SetOpenCL(OpenCL);
   for(uint i = 0; i < period; i++)
     {
      cCurrent = new CNeuronBaseOCL();
      if(!cCurrent)
         return false;
      if(!cCurrent.Init(Neurons(), i, OpenCL, 1, optimization, iBatch) ||
         !cOnes.Add(cCurrent))
        {
         delete cCurrent;
         return false;
        }
      cCurrent.SetActivationFunction(None);
     }
このメソッドのメインループでは、時間ステップごとに対応するオブジェクトの配列を生成します。 各ステップについて、CNeuronBaseOCLの新しいインスタンスを作成し、その時間ステップに必要な同一のパラメータを設定して初期化します。 初期化に成功したら、そのオブジェクトを、すべての時間ステップを管理するコンテナcOnesに追加します。 途中でエラーが発生した場合は、生成中のオブジェクトを直ちに削除します。これにより、メモリリークを防ぎ、データ構造の整合性を維持します。
また、新しく作成した各ニューロンでは、活性化関数を無効にします。これは、相関テンソルを正しく機能させるうえで重要です。順伝播段階では非線形変換を適用せず、値をそのまま次の処理へ渡す必要があるためです。
すべての時間ステップに対応するオブジェクトの生成が完了すると、SetPositionメソッドによって配列の最初の要素がアクティブに設定され、以降の計算に向けた初期状態が確立されます。
//---
   if(!SetPosition(0))
      return false;
//---
   return true;
  }
このように、Initメソッドは単にオブジェクトの配列を生成するだけではありません。各要素が特定の時点に対応する、構造化された管理可能なパラメータ格納領域を構築します。 これにより、モデルは大域的な相関を効果的に活用し、不要な計算を回避するとともに、学習や多変量金融時系列の予測に備えることができます。
SetPositionメソッドは、CCircleParamsにおける相関用の動的パラメータテンソルを管理するうえで、重要な役割を果たします。 その目的は、アクティブなオブジェクトを指定された時間ステップのものに切り替え、モデルがその時点に対応するデータを用いて処理を行えるようにすることです。
このメソッドが呼び出されると、cCurrentポインタは、指定された位置に対応するcOnes配列の要素を指すように設定されます。 選択されたオブジェクトが存在しない場合、または初期化されていない場合、メソッドはfalseを返します。これにより、問題の発生を通知し、不正な計算を防ぎます。 一方、オブジェクトが正常に選択されると、メソッドはtrueを返し、モデルが次のデータ処理に進める状態であることを示します。
bool CCircleParams::SetPosition(int position)
  {
   cCurrent = cOnes[position];
   if(!cCurrent)
      return false;
//---
   return true;
  }
一見シンプルなSetPositionメソッドですが、その役割は重要です。このメソッドを通じて、TQNetモデルはテンソル全体を再生成したり再読み込みしたりすることなく、時間ステップを動的に切り替え、それぞれに対応する相関パラメータを有効化できます。 これは金融時系列を扱ううえで特に重要です。新たな時間区間を処理する際には、局所的な依存関係と大域的な依存関係の両方を考慮する必要があります。アクティブな位置を効率的に管理することで、大量のデータを扱う場合でも、モデルの高速性と適応性を維持できます。
なお、通常の初期化処理では、Initメソッドの実行時に、すべての大域的相関テンソルがランダムな値で初期化されます。 多くのケースでは、この方法で問題ありません。ランダム初期化によって多様な初期状態が得られ、学習可能なパラメータがデータの構造に合わせて徐々に調整されるためです。
しかし、TQNetフレームワークの著者らは、これとは異なる方法、すなわちテンソルをゼロで初期化する方法を推奨しています。 この方法は、特に金融時系列を扱う場合に有効です。変数間の相関について事前の仮定を置かずに学習を開始することで、モデルが過去のデータだけに基づいて、安定した関係性を段階的に見いだせるようにするためです。
この方法を実装するため、CCircleParamsクラスにはZerosメソッドが定義されています。このメソッドは、すべての時間ステップのパラメータを順次ゼロに設定します。 このメソッドが呼び出されると、cOnes配列の各要素を処理し、大域的相関テンソルのすべての値をゼロにします。 これにより、学習を白紙の状態から開始できます。初期の予測がランダムな初期値に左右されるのを防ぎ、モデルの適応過程全体を、分析対象のデータとTQNetの構造によって決まるものにします。
bool CCircleParams::Zeros(void)
  {
   matrix<float> zeros = matrix<float>::Zeros(Neurons(), 2);
//---
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(zeros))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
このように、Zerosメソッドは、大域的相関の初期状態を簡単かつ効果的に制御する手段を提供します。これにより、金融データを用いたモデル学習の透明性と予測可能性を高めることができます。
ゼロ初期化に代わる方法として、大域的相関テンソルを単位行列で初期化するメソッドも実装します。 この方法は、学習開始時点では各変数が互いに独立している状態を設定しつつ、学習の進行に伴って、モデルが変数間の実際の関係性を徐々に見いだせるようにしたい場合に有効です。
Identityメソッドでは、まず、生成する行列の次元がオブジェクト内のニューロン数と一致しているかを確認します。
bool CCircleParams::Identity(const int rows, const int cols)
  {
   if(rows * cols != Neurons())
      return false;
   matrix<float> ident = matrix<float>::Identity(rows, cols);
   if(!ident.Reshape(rows * cols, 1))
      return false;
   if(!ident.Resize(rows * cols, 2))
      return false;
   if(!ident.Col(vector<float>::Zeros(rows * cols), 1))
      return false;
次に、指定された次元の単位行列を作成し、それを順次再形成して、クラス内部のデータ構造に適合させます。 値を割り当てる際に正しく動作するよう、ReshapeメソッドとResizeメソッドを使用したメモリの準備と再確保、および追加のバイアス列をゼロに設定する処理に特に注意を払います。
行列の準備が完了すると、このメソッドはcOnesコンテナ内のすべての時間ステップを順番に処理します。
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(ident))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
各ステップにおいて、getWeightsメソッドを使用して重みを取得し、準備した対角行列の内容をそれらに割り当てます。 その後、OpenCLコンテキスト内のバッファを解放し、新しい値で再作成します。これにより、以降のモデル学習において、GPUとの適切な連携が確保されます。
最後に、FeedForwardメソッドを呼び出し、値が層内を正しく伝播することを直ちに確認します。 この初期化メソッドにより、学習開始時の変数間の大域的相関は偏りのない中立的な状態から始まります。同時に、予測処理の過程で、モデルが実際の依存関係を効果的に蓄積し、考慮できる構造も維持されます。
金融分野では、これは特に重要です。単位行列を用いることで、各変数を「白紙の状態」から開始でき、初期の偏りを排除しながら、資産間の相関など、市場における安定した関係性をモデルが徐々に見いだせるようになります。
初期化アルゴリズムと相関パラメータの初期値を準備するメソッドについて詳しく見てきたので、次に、CCircleParamsクラスの動作における重要な段階の一つである、順伝播アルゴリズムについて説明します。
FeedForwardメソッドは、現在の時間ステップに対応する大域的相関パラメータを準備し、モデルが内部状態を更新できるようにします。
bool CCircleParams::FeedForward(void)
  {
   if(!cCurrent)
      if(!SetPosition(0))
         return false;
//---
   return CNeuronBaseOCL::feedForward(cCurrent);
  }
まず、このメソッドは、cCurrentポインタにアクティブなステップが設定されているかどうかを確認します。 現在のオブジェクトが指定されていない場合、SetPositionメソッドを呼び出して、cOnes配列の最初の時間ステップを自動的に選択し、計算が正しく開始されるようにします。
アクティブな時間ステップが設定されると、処理は親クラスの同名メソッドに引き継がれ、必要な大域的相関パラメータが生成されます。
このように、FeedForwardは、準備された大域的相関テンソルの構造とTQNetのAttention機構をつなぐ役割を果たします。 この手法により、予測の柔軟性と精度が確保され、モデルは市場の局所的な変動と長期的なトレンドの両方に対応できるようになります。
順伝播の仕組みを確認し、FeedForwardによってアクティブな時間ステップを通じてデータが正しく伝播することを見てきました。次に、モデルのパラメータ更新を担うUpdateInputWeightsメソッドについて見ていきましょう。
このメソッドは学習において重要な役割を果たします。計算された勾配に基づいて重みと相関パラメータを調整し、モデルがデータの構造に徐々に適応できるようにします。 CCircleParamsでは、このメソッドは、アクティブな時間ステップの要素を指定したうえで、親クラスの同名メソッドに処理を委譲する形で実装されています。
bool CCircleParams::UpdateInputWeights(void)
  {
   return CNeuronBaseOCL::updateInputWeights(cCurrent);
  }
現在の時間ステップのオブジェクトへのポインタを渡すことで、テンソルの該当部分に対してのみ更新が行われます。 これにより効率が向上し、残りの時間ステップに対する不要な計算を防ぐことができます。
ここで強調しておきたいのは、この段階では、cCurrent変数内のポインタが有効かどうかをチェックしていないという点です。 これは意図的な設計です。 モデルが順伝播と逆伝播の両方で、同じ時間ステップのオブジェクトを使用することが極めて重要だからです。 重みの更新処理中にこのオブジェクトを変更すると、計算の一貫性が損なわれ、パラメータの調整にエラーが生じる可能性があります。
この場合、ポインタの有効性の確認は親クラスのメソッドに任されています。 エラーが発生した場合、このメソッドは単にfalseを返し、重みが誤って更新されるのを防ぎます。 このアプローチにより、余分な処理負荷や大域的相関テンソルの構造を乱すリスクを伴わずに、現在の時間ステップのパラメータ更新という中核的な処理に集中できます。
これは、特に金融時系列データにおいて重要です。 モデルは各ステップで現在のデータを確実に処理しながら、大域的なパターンを維持します。これにより、市場が動的に変化し、ノイズが多い状況でも、予測精度と学習の安定性を確保します。
モデル全体を通じて誤差勾配を逆伝播させる手順を省略していることに、お気づきかもしれません。 その代わりに、calcInputGradientsメソッドは、常に成功を示す結果を返すスタブ実装でオーバーライドされています。 一見すると珍しい方法に思えるかもしれませんが、大域的相関パラメータの更新には十分です。 モデルが現在の時間ステップの重みを調整するために必要なのは、レイヤーの出力レベルで計算された誤差勾配だけです。
CCircleParamsオブジェクトは、基本的に外部からの入力データを扱わないため、元の入力データは計算に関与しません。 このレベルまで勾配を伝播させる意味はありません。
ここでスタブ実装を使用することには重要な意味があります。システムに不要な負荷をかけることなく、他のネットワークコンポーネントとの互換性を維持しながら、新しいオブジェクトをモデル全体の構造に組み込むことができます。同時に、重みを正しく更新できるようになります。
これらの機能を組み合わせることで、CCircleParamsは、動的な大域的相関テンソルという抽象的な概念から、TQNetに効果的に統合できる、実用的で制御可能なオブジェクトへと発展します。 モデルは、安定した大域的パターンを捉えると同時に、各時間ステップにおける局所的なデータの特徴も考慮できます。 これは金融市場において特に重要です。モデルは、繰り返し現れる季節的なサイクルや資産間の安定した相関関係を認識するだけでなく、短期的な変動、市場のノイズ、突発的な出来事にも対応できるよう学習します。
ここまで多くの作業を進めてきたため、本記事もかなりの長さになりました。 ここまでの情報を理解し、十分に消化するには時間が必要です。 これまでの内容を振り返るため、ここで少し休憩を取りましょう。
次回の記事では、Attention機構のアルゴリズム開発とTQNetコンポーネントの完全な統合へと進みます。そこで、ここまで説明してきた構造やメソッドが、金融時系列を予測するための効果的なツールへとどのように発展するのかを示します。
結論
この記事では、モジュール性、柔軟性、高いパフォーマンスを兼ね備えたTQNetフレームワークについて解説しました。 こうした特長から、金融時系列の予測と分析に特に有用なツールとなっています。 このフレームワークのアーキテクチャでは、各コンポーネントが明確に定義された役割を担うように設計されています。そのため、個々のコンポーネントを置き換えたり改良したりする際に、システム全体を全面的に作り直す必要はありません。
実装編では、大域的相関パラメータを管理するために設計された、新しいCCircleParamsオブジェクトの実装に焦点を当てました。 その初期化プロセスと時間ステップの構成を詳しく検討し、テンソルの初期値を設定するための代替アルゴリズムも開発しました。 特に、順伝播の構築、重みの更新機構、時間ステップ間の計算の同期に重点を置きました。
このようにして、より複雑なモデルに本格的に組み込んで使用できる、柔軟で信頼性の高いフレームワークコンポーネントを構築しました。 次回の記事では、統一された計算パイプラインの構築に焦点を当て、過去のデータを用いてテストを行います。そして、実際の金融市場環境におけるシステムの有効性と頑健性を評価します。
リンク
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19157
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 決闘者アルゴリズム
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:構造成分の分離(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索