

Modifikation des Dingo-Optimierungsalgorithmus (DOAm)
 18
 2

Inhaltsverzeichnis
Einleitung
Fragen wir uns einmal: Gibt es populationsbasierte metaheuristische Algorithmen, die mit einer begrenzten Anzahl von Iterationen – in unserem Fall 10.000 – ein Ergebnis von 100 % erzielen können? Die Leistungsfähigkeit eines solchen Algorithmus müsste ziemlich überwältigend sein. Tatsächlich bezweifle ich manchmal, dass es überhaupt möglich ist, im Bereich der Optimierung einen solchen Schatz zu entdecken.
Es mag solche Algorithmen für diesen Zweck geben, und heute werden wir eine der einzigartigen Optimierungsmethoden kennenlernen – genauer gesagt eine modifizierte Version des Dingo-Optimierungsalgorithmus, den ich bereits im vorherigen Artikel beschrieben habe. Diese Version bringt uns der Lösung einer solch schwierigen Aufgabe einen Schritt näher.
Implementierung des Algorithmus
Während meiner Arbeit am Dingo-Optimierungsalgorithmus begann ich mich für das Prinzip der Modellierung der Dingo-Jagd zu interessieren, bei der verschiedene Strategien zum Einsatz kommen. Wir haben uns mit diesem Algorithmus vertraut gemacht und seine Funktionsweise im Detail analysiert. Der Test des Algorithmus lieferte durchschnittliche Ergebnisse; er schaffte es nicht in die Rangliste, da er die Aufnahmeschwelle noch um 20 % verfehlte. Man könnte meinen, wir könnten das Thema ad acta legen und weitermachen. Ich habe mich jedoch entschlossen, ein wenig mit den Formeln zu experimentieren, und das ist dabei herausgekommen:
Formel für den Gruppenangriff (Gleichung 2), Originalfassung:
x⃗ᵢ(t+1) = β₁ · [Σₖ₌₁ⁿᵃ φ⃗ₖ(t)]/nₐ - x⃗*(t)
sieht nun so aus:
a[agentIdx].c[c] = cB[c] + beta1 * sumAttack;
Wie Sie sehen können, wurde das Vorzeichen geändert – statt die beste Lösung zu subtrahieren, verwenden wir nun die Addition. Außerdem ist die Berechnung von „sumAttack“ komplizierter – der Wert wird durch (na * coords) geteilt, statt einfach nur durch „na“.
Die Überlebensschwelle in der Originalversion lautet survival[r] <= 0.3; ändern wir sie auf survival[r] <= 0.01. Wir senken die Schwelle deutlich, was bedeutet, dass wir Überlebensstrategien nur auf die „schwächsten“ Agenten anwenden werden.
Die ursprüngliche Formel für die Aassuche (Gleichung 4):
x⃗ᵢ(t+1) = ½ · e^β₂ · |x⃗ᵣ₁(t) - (-1)^σ · x⃗ᵢ(t)|
Neue Version:
a[agentIdx].c[c] = (MathExp(beta2) * a[r1].c[c] - sign * a[agentIdx].c[c]) / 2.0;
Nun entfällt der Absolutbetrag, sodass negative Koordinaten möglich sind. Zudem führt der modifizierte Algorithmus die Mittelwertbildung der Positionsdifferenz gleichzeitig über alle Koordinaten durch statt für jede Koordinate einzeln.
Warum könnten diese Änderungen die Leistung des Algorithmus verbessern? Ein Vorzeichenwechsel beim Gruppenangriff kann eine Bewegung „hin zu einer besseren Lösung unter Berücksichtigung der Positionen der anderen“ bewirken, statt einer Bewegung weg von der besten Lösung wie in der Version der Autoren. Die Senkung der Überlebensschwelle ermöglicht es den meisten Agenten, grundlegende Jagdstrategien anzuwenden und nur in Extremfällen auf die Überlebensprozedur zurückzugreifen. Der Verzicht auf den Absolutbetrag in der Formel für die Aassuche ermöglicht eine freiere Bewegung im Suchraum.
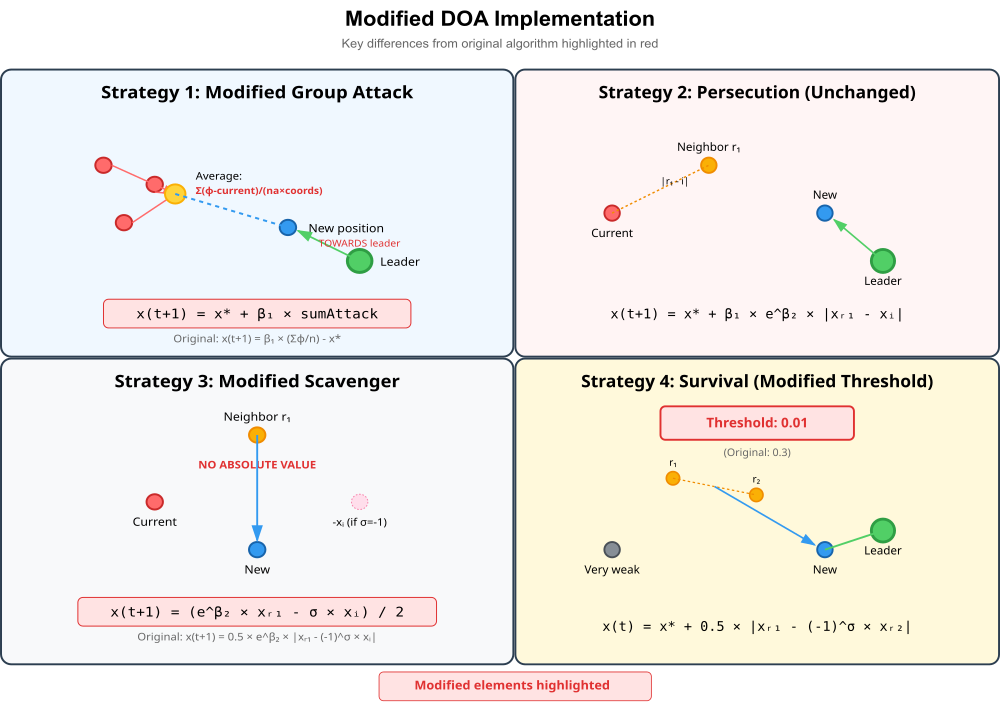
Abbildung 1. Änderungen an der DOAm_dingo-Strategie
Die obige Abbildung zeigt die wesentlichen Unterschiede zwischen der modifizierten Version und der von den Autoren des Algorithmus beschriebenen Originalversion: Bei einem Gruppenangriff erfolgt die Bewegung auf einen Anführer zu statt von ihm weg. Die Überlebensschwelle wird auf 0,01 gesenkt, die Aassuche erfolgt nun ohne Absolutbetrag in der Formel, und bei der Mittelwertbildung wird durch (na × coords) statt nur durch (na) geteilt. Änderungen sind zur besseren Übersichtlichkeit rot markiert.
Kommen wir nun zur Beschreibung des Algorithmus-Codes und schauen wir uns das Ergebnis an. Die Klasse „C_AO_DOAm_dingo“ ist eine spezialisierte Version der Basisklasse „C_AO“. Es handelt sich um einen Optimierungsalgorithmus, der auf der Modifizierung des Verhaltens von Dingos basiert. Daher erbt die Klasse „Dingo-Optimierungsalgorithmus M“ von C_AO, was bedeutet, dass sie über die grundlegenden Funktionen verfügt. Für die Schlüsselparameter sind folgende Standardwerte festgelegt:
- popSize (Populationsgröße, d. h. Anzahl der Dingos): 50.
- P (Wahrscheinlichkeit für die Wahl zwischen Jagd und Aassuche): 0,5.
- Q (Wahrscheinlichkeit, zwischen Gruppenangriff und Verfolgung zu wählen): 0,7.
- Init – erstmaliger Start des Algorithmus, einschließlich der Initialisierung der Agenten (Dingos) und ihrer Parameter unter Verwendung der vorgegebenen Bereiche und Schrittweiten.
- Moving – die Hauptphase des Algorithmus, in der sich die Agenten gemäß den Regeln des Algorithmus bewegen und miteinander interagieren.
- Revision – Überprüfung oder Bewertung des Zustands des Algorithmus nach einer bestimmten Phase oder Epoche.
- P – Wahrscheinlichkeit, dass ein Dingo jagt oder nach Aas sucht.
- Q – Wahrscheinlichkeit, dass ein Dingo an einem Gruppenangriff oder einer Verfolgung teilnimmt.
- beta1, beta2 – dienen zur Erzeugung von Zufallsvektoren oder Schritten bei der Optimierung innerhalb vorgegebener Wertebereiche;
- naIni, naEnd — legen die minimale und maximale Anzahl der am Angriff beteiligten Dingos fest, die variieren kann;
- survival — Array, in dem die „Überlebens“- bzw. Fitnessindikatoren jedes Dingos gespeichert sind.
- UpdateSurvivalRates — Aktualisierung der Überlebensraten der Agenten;
- GroupAttack — Implementierung des Verhaltens bei Gruppenangriffen;
- Persecution – Implementierung des Verhaltens bei der Verfolgung;
- Scavenger – Implementierung des Verhaltens bei der Aassuche;
- SurvivalProcedure – Prozedur im Zusammenhang mit dem Überleben der Agenten;
- GetAttackVector — Abrufen eines Vektors, der die Angriffsrichtung bestimmt;
- CalculateAttackSum – berechnet die gesamte „Wirkung“ des Angriffs.
//————————————————————————————————————————————————————————————————————
class C_AO_DOAm_dingo : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOAm_dingo () { }
  C_AO_DOAm_dingo ()
  {
    ao_name = "DOAm";
    ao_desc = "Dingo Optimization Algorithm M";
    ao_link = "https://www.mql5.com/en/articles/19187";

    popSize = 50;     // population size (number of dingoes)
    P       = 0.5;    // Hunting or Scavenger rate
    Q       = 0.7;    // Group attack or chase

    ArrayResize (params, 3);

    params [0].name = "popSize"; params [0].val = popSize;
    params [1].name = "P";       params [1].val = P;
    params [2].name = "Q";       params [2].val = Q;
  }

  void SetParams ()
  {
    popSize = (int)params [0].val;
    P       = params [1].val;
    Q       = params [2].val;
  }

  bool Init (const double &rangeMinP  [],  // minimum values
             const double &rangeMaxP  [],  // maximum values
             const double &rangeStepP [],  // step change
             const int     epochsP = 0);   // number of epochs

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double P;          // hunting or scavenging probability
  double Q;          // group attack or chase probability

  private: //---------------------------------------------------------
  double beta1;       // -2 < beta1 < 2
  double beta2;       // -1 < beta2 < 1
  int    naIni;       // minimum number of attacking dingoes
  int    naEnd;       // maximum number of attacking dingoes
  double survival []; // array of survival indicators

  // Auxiliary methods
  void   UpdateSurvivalRates ();
  void   GroupAttack         (int agentIdx, int na);
  void   Persecution         (int agentIdx);
  void   Scavenger           (int agentIdx);
  void   SurvivalProcedure   (int agentIdx);
  void   GetAttackVector     (int na, int &attackVector []);
  double CalculateAttackSum  (int agentIdx, int na);
};
//————————————————————————————————————————————————————————————————————
Diese Methode dient zur Initialisierung des Dingo-Optimierungsalgorithmus M. Sie bereitet den Algorithmus auf den Betrieb vor, indem sie die Anfangsbedingungen für die Optimierung festlegt, bestimmt, wie die Dingos Angriffsgruppen bilden, und ihren anfänglichen „Überlebenszustand“ festlegt.
//————————————————————————————————————————————————————————————————————
//--- Initialization
bool C_AO_DOAm_dingo::Init (const double &rangeMinP  [],
                            const double &rangeMaxP  [],
                            const double &rangeStepP [],
                            const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Initialize algorithm parameters
  naIni = 2;               // minimum number of attackers
  naEnd = popSize / naIni; // maximum number of attackers

  ArrayResize     (survival, popSize);
  ArrayInitialize (survival, 1.0);

  return true;
}
//————————————————————————————————————————————————————————————————————
Die „Moving“-Methode ist die Hauptfunktion, die für die Ausführung eines Schritts (oder einer Iteration) des Algorithmus zuständig ist; sie simuliert das Verhalten eines Dingo-Rudels bei der Suche nach der optimalen Lösung. Die Methode steuert das Verhalten der Dingo-Population dynamisch und ermöglicht es ihr, den Lösungsraum mithilfe verschiedener Strategien zu erkunden, die auf ihrer Überlebensrate („survival“) und probabilistischen Entscheidungen beruhen. Eine ausführlichere Beschreibung der wichtigsten Methoden wurde im vorherigen Artikel gegeben. Hier werden wir uns die für diese Implementierung spezifischen Methoden genauer ansehen.
//————————————————————————————————————————————————————————————————————
//--- Main step of the algorithm
void C_AO_DOAm_dingo::Moving ()
{
  // Starting initialization of the population
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Update survival rates
  UpdateSurvivalRates ();

  // Update beta parameters for the current iteration
  //beta1 = -2.0 + 4.0 * u.RNDprobab ();
  //beta2 = -1.0 + 2.0 * u.RNDprobab ();
  beta1 = u.RNDfromCI (-2.0, 2.0);
  beta2 = u.RNDfromCI (-1.0, 1.0);

  // Main loop for all dingoes
  for (int r = 0; r < popSize; r++)
  {
    // Check the survival rate (Section 2.2.4)
    //if (survival[r] <= 0.3)
    if (survival [r] <= 0.01)
    {
      // Strategy 4: Survival (Eq. 6)
      SurvivalProcedure (r);
    }
    else
    {
      // Choose between hunting and scavenging
      if (u.RNDprobab () < P)  // If hunting
      {
        if (u.RNDprobab () < Q)  // If group attack
        {
          // Strategy 1: Group attack (Eq. 2)
          int na = naIni + (int)((naEnd - naIni) * u.RNDprobab ());
          GroupAttack (r, na);
        }
        else  // Chase
        {
          // Strategy 2: Chase (Eq. 3)
          Persecution (r);
        }
      }
      else  // Scavenging
      {
        // Strategy 3: Scavenging (Eq. 4)
        Scavenger (r);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „GroupAttack“ implementiert „Strategie 1: Gruppenangriff“. Diese Strategie kommt zum Einsatz, wenn ein Dingo beschließt, als Teil einer Gruppe ein Beutetier anzugreifen. Zunächst wird die Hilfsmethode „CalculateAttackSum“ aufgerufen. Sie nimmt den Index des aktuellen Dingos (agentIdx) und die Anzahl der am Angriff beteiligten Dingos (na) als Eingabewerte und berechnet die Gesamtstärke bzw. -richtung des Angriffs, indem sie die Beiträge aller Teilnehmer addiert. Das Ergebnis dieser komplexen Operation wird in der Variablen „sumAttack“ gespeichert.
Anschließend aktualisiert die Methode die Position (Koordinaten) des aktuellen Dingos. Die Methode durchläuft nacheinander jede Koordinate c des Suchraums und berechnet einen neuen Wert für die Position des Dingos. Die aktualisierte Formel lautet wie folgt:
Neue Koordinate = Koordinate der besten Lösung + beta1 * gesamter Angriffsvektor
wobei:
- cB [c] bezeichnet die c-te Koordinate der derzeit besten Lösung, die bei der Optimierung gefunden wurde,
- beta1 — Koeffizient, der die Intensität oder Richtung der Wirkung des Gruppenangriffs regelt,
- sumAttack — im vorherigen Schritt ermitteltes Ergebnis.
Der so ermittelte neue Koordinatenwert wird dann in den zulässigen Bereich „eingepasst“. Die u.SeInDiSp-Methode stellt sicher, dass der neue Wert innerhalb der festgelegten Mindest- (rangeMin) und Höchstgrenzen (rangeMax) bleibt, wobei die Schrittweite (rangeStep) der Änderung berücksichtigt wird.
Letztlich bildet die „GroupAttack“-Methode eine koordinierte Suche nach einer optimalen Lösung durch eine Gruppe von Dingos ab. Sie fasst Informationen von mehreren Individuen über „sumAttack“ zusammen, berücksichtigt die beste gefundene Lösung (cB) und ermittelt anhand eines zufälligen Koeffizienten beta1 eine neue, potenziell vorteilhaftere Position für den Dingo im Suchraum.
//————————————————————————————————————————————————————————————————————
//--- Strategy 1: Group attack (Eq. 2)
void C_AO_DOAm_dingo::GroupAttack (int agentIdx, int na)
{
  // Calculate the total attack vector
  double sumAttack = CalculateAttackSum (agentIdx, na);

  // Apply the group attack formula (Eq. 2)
  for (int c = 0; c < coords; c++)
  {
    // v = beta1 * sumatory - theBestVct
    a [agentIdx].c [c] = cB [c] + beta1 * sumAttack;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „CalculateAttackSum“ dient zur Berechnung des gesamten Angriffsvektors, der in „Strategie 1: Gruppenangriff“ verwendet wird. Sie legt fest, wie ein bestimmter Dingo (agentIdx) mit anderen Dingos interagiert, die an einem Gruppenangriff (na) teilnehmen.
Zunächst erstellt die Methode eine temporäre Liste (attackVector), die die Indizes der direkt am Angriff beteiligten Dingos enthält. Die Größe dieser Liste wird durch den Parameter „na“ (Anzahl der Angreifer) bestimmt. Anschließend wird die Hilfsmethode „GetAttackVector“ aufgerufen. Diese Methode wählt auf der Grundlage des aktuellen Zustands der Population „na“ Dingos aus, die an dem Angriff teilnehmen sollen, und schreibt deren Indizes in den „attackVector“. Die Variable „sumatory“ wird mit null initialisiert. Als Nächstes folgt die Hauptschleife, die alle am Angriff beteiligten Dingos durchläuft; dabei wird der Index (attackerIdx) jedes angreifenden Dingos aus attackVector entnommen.
Innerhalb dieser Schleife befindet sich eine weitere Schleife, die alle Koordinaten (c) des Suchraums durchläuft (Schleife: von „0“ bis „coords - 1“). An jeder Koordinate wird die Differenz zwischen der Position des angreifenden Dingos und der Position des Dingos, für den der Gesamtangriff berechnet wird, bestimmt. Diese Differenz wird dann durch die Gesamtzahl der möglichen Angriffsteilnehmer (na) und die Gesamtzahl der Koordinaten (coords) geteilt und zu „sumatory“ addiert.
Schließlich gibt die Methode den Wert von „sumatory“ zurück. Dieser Wert gibt die durchschnittliche Positionsdifferenz zwischen den angreifenden Dingos und dem Ziel-Dingo unter Berücksichtigung der Anzahl der Teilnehmer und der Dimensionen an. Dieser Wert wird dann verwendet, um die Position des Ziel-Dingos im Rahmen eines Gruppenangriffs zu aktualisieren.
Somit sammelt „CalculateAttackSum“ Informationen über die aktuellen Positionen der an einem gemeinsamen Angriff beteiligten Dingos und gibt einen zusammengesetzten Wert aus, der deren gesamte Verschiebung relativ zum angegriffenen Dingo widerspiegelt. Dieser Wert bestimmt dann die Bewegung des angegriffenen Dingos.
//————————————————————————————————————————————————————————————————————
//--- Calculate the sum for a group attack
double C_AO_DOAm_dingo::CalculateAttackSum (int agentIdx, int na)
{
  // Create a vector of attacking dingoes
  int attackVector [];
  ArrayResize (attackVector, na);
  GetAttackVector (na, attackVector);

  // Calculate the average difference in positions
  double sumatory = 0.0;
  for (int j = 0; j < na; j++)
  {
    int attackerIdx = attackVector [j];
    // Calculate the average over all coordinates
    for (int c = 0; c < coords; c++)
    {
      sumatory += (a [attackerIdx].c [c] - a [agentIdx].c [c]) / (na * coords);
    }
  }

  return sumatory;
}
//————————————————————————————————————————————————————————————————————
Die Methode „GetAttackVector“ ist dafür zuständig, eine Liste von Dingos zu erstellen, die direkt am Gruppenangriff teilnehmen werden. Sie erzeugt eine Menge zufälliger, eindeutiger Indizes, von denen jeder einem Dingo aus der gesamten Population entspricht. Die Methode legt zunächst die Größe des Ausgabe-Arrays „attackVector“ auf die angegebene Zahl „na“ (die Anzahl der Angreifer) fest. Der Zähler „c“ wird ebenfalls mit null initialisiert. Er erfasst, wie viele Dingos bereits für den Angriff ausgewählt wurden.
Die Methode startet eine Schleife, die so lange fortgesetzt wird, bis „na“ Dingos ausgewählt sind. In jeder Iteration der Schleife wird ein zufälliger Dingo-Index (idx) aus der gesamten verfügbaren Population generiert (von „0“ bis „popSize - 1“). Bevor der generierte Index zur Liste der Angreifer hinzugefügt wird, wird eine Überprüfung durchgeführt. Die Methode durchläuft die bereits ausgewählten Indizes im Array „attackVector“ an den Positionen „0“ bis „c - 1“. Wenn der zufällig generierte Index (idx) mit einem der zuvor ausgewählten Indizes übereinstimmt (d. h. attackVector[i] == idx), wird das Flag „found“ auf „true“ gesetzt. Wenn das Flag weiterhin „false“ ist (das heißt, der angegebene Index wurde noch nicht ausgewählt), wird dieser neue, eindeutige Index (idx) dem Array „attackVector“ unter dem aktuellen Index „c“ hinzugefügt. Danach wird der Zähler „c“ um eins erhöht.
Im Wesentlichen ist „GetAttackVector“ dafür zuständig, zufällig „na“ verschiedene Dingos aus der gesamten Population auszuwählen, damit diese eine Angriffsgruppe bilden können. Dieser Vorgang stellt sicher, dass sich jeder Dingo in der Gruppe von den anderen unterscheidet, wodurch Doppelungen vermieden werden und Vielfalt in der Angriffsgruppe gewährleistet ist.
//————————————————————————————————————————————————————————————————————
//--- Form the attacking dingo vector
void C_AO_DOAm_dingo::GetAttackVector (int na, int &attackVector [])
{
  int c = 0;
  ArrayResize (attackVector, na);

  while (c < na)
  {
    int idx = u.RNDintInRange (0, popSize - 1);

    // Check that the index is not repeated
    bool found = false;
    for (int i = 0; i < c; i++)
    {
      if (attackVector [i] == idx)
      {
        found = true;
        break;
      }
    }

    if (!found)
    {
      attackVector [c] = idx;
      c++;
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „Persecution“ implementiert „Strategie 2: Verfolgung“. Das Ziel dieser Methode ist es, die Position eines bestimmten Dingos (agentIdx) so zu aktualisieren, dass er die Verfolgung aufnimmt. Die Methode wählt zunächst einen zufälligen Dingo aus der gesamten Population aus; sein Index wird in der Variablen r1 gespeichert.
Als Nächstes folgt eine Schleife, die alle Dimensionen (c) des Raums durchläuft, in dem sich die Dingos befinden. Für jede Dimension wird die neue Position des Dingos (agentIdx) nach folgender Formel berechnet: Zum Basiswert (cB[c]), der die Position des besten Dingos darstellt, wird das Produkt aus drei Faktoren addiert: beta1, einem Koeffizienten, der die Stärke des Verfolgungseinflusses steuert; MathExp(beta2), der Exponentialfunktion des Koeffizienten beta2; und der Differenz zwischen der Position eines zufällig ausgewählten Dingos (a[r1].c[c]) und der aktuellen Position des angreifenden Dingos (a[agentIdx].c[c]) in der jeweiligen Dimension.
Die neue Position wird sofort mithilfe der Hilfsfunktion zur Normalisierung u.SeInDiSp angepasst, die sicherstellt, dass sie in jeder Dimension unter Berücksichtigung der Schrittweite rangeStep[c] innerhalb des zulässigen Bereichs von rangeMin[c] bis rangeMax[c] bleibt.
Letztlich bewirkt die Persecution-Methode, dass sich der angegebene Dingo (agentIdx) auf einen zufällig ausgewählten anderen Dingo (r1) zubewegt, wobei die als Grundlage dienende beste Position berücksichtigt wird und die Parameter beta1 und beta2 zur Anpassung der Verfolgungsintensität und -dynamik verwendet werden. In diesem Fall bleibt die neue Position stets innerhalb der festen Grenzen des Suchraums.
//————————————————————————————————————————————————————————————————————
//--- Strategy 2: Chase (Eq. 3)
void C_AO_DOAm_dingo::Persecution (int agentIdx)
{
  // Select a random dingo
  int r1 = u.RNDintInRange (0, popSize - 1);

  // Apply the chase formula (Eq. 3)
  for (int c = 0; c < coords; c++)
  {
    // v = theBestVct + beta1 * exp(beta2) * (Positions[r1] - Positions[r])
    a [agentIdx].c [c] = cB [c] + beta1 * MathExp (beta2) * (a [r1].c [c] - a [agentIdx].c [c]);
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
Die Scavenger-Methode implementiert „Strategie 3: Aassuche“. Das Ziel dieser Methode besteht darin, die Position eines bestimmten Dingos (agentIdx) so zu aktualisieren, dass er sich an eine neue Position bewegt, die eine Art „Kompromiss“ oder „Zwischenwert“ zwischen seiner aktuellen Position und der Position eines zufällig ausgewählten anderen Dingos darstellt.
Die Methode wählt zunächst zufällig einen Dingo aus der gesamten Population aus und speichert dessen Index in der Variablen r1. Dieser Dingo wird als eine Art Bezugspunkt dienen. Außerdem wird ein zufälliger binärer Wert für das Vorzeichen (sign) generiert. Dieser Wert ist entweder „1,0“ oder „-1,0“. Dadurch wird festgelegt, ob die Differenzbildung „vorwärts“ oder „rückwärts“ erfolgt.
Als Nächstes folgt eine Schleife, die alle Dimensionen des Raums durchläuft, in dem sich die Dingos befinden. Für jede Dimension wird die neue Position des Dingos (agentIdx) wie folgt berechnet: Die Position eines zufällig ausgewählten Dingos (a[r1].c[c]) wird mit dem Exponentialwert des Koeffizienten „beta2“ multipliziert; von diesem Wert wird die aktuelle Position des angreifenden Dingos abgezogen (oder addiert, je nach Vorzeichen), und der resultierende Wert wird durch 2,0 geteilt.
Das bedeutet im Grunde, dass die neue Position irgendwo zwischen der aktuellen Position des Dingos und einer neuen „attraktiven“ Position liegen wird, abhängig von beta2 und dem gewählten Dingo. Wie bei anderen Methoden wird die neue Position nach ihrer Berechnung sofort mithilfe der Hilfsfunktion „u.SeInDiSp“ angepasst. Diese Funktion stellt sicher, dass die neue Position für jede Dimension innerhalb des zulässigen Bereichs (von rangeMin[c] bis rangeMax[c]) bleibt.
Bei der Scavenger-Methode wird die Position des Dingos also so aktualisiert, dass er an einen Punkt verschoben wird, der dem Mittelwert aus seiner aktuellen Position und einer Position entspricht, die sich aus einer exponentiellen Transformation der Position des anderen Dingos und einem zufälligen Vorzeichen ergibt. Dies ahmt das Verhalten eines Tieres nach, das nach Beute sucht, die sich „unterwegs“ oder „irgendwo zwischen“ bekannten Punkten befinden könnte.
//————————————————————————————————————————————————————————————————————
//--- Strategy 3: Scavenging (Eq. 4)
void C_AO_DOAm_dingo::Scavenger (int agentIdx)
{
  // Select a random dingo
  int r1 = u.RNDintInRange (0, popSize - 1);
  double sign = u.RNDbool() ? 1.0 : -1.0;

  // Apply the scavenging formula (Eq. 4)
  for (int c = 0; c < coords; c++)
  {
    // v = (exp(beta2) * Positions[r1] - (-1)^binary * Positions[r]) / 2
    a [agentIdx].c [c] = (MathExp (beta2) * a [r1].c [c] - sign * a [agentIdx].c [c]) / 2.0;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „SurvivalProcedure“ implementiert „Strategie 4: Überlebensprozedur“. Das Hauptziel dieser Methode besteht darin, die Position eines bestimmten Dingos (agentIdx) anhand von Informationen zweier anderer Dingos zu aktualisieren, um eine neue, vorteilhaftere Position zu finden. Die Methode wählt zunächst zufällig zwei verschiedene Dingos aus der gesamten Population aus. Ihre Indizes werden in den Variablen r1 und r2 gespeichert. Es ist garantiert, dass r1 und r2 nicht gleich sind.
Außerdem wird ein zufälliger binärer Wert (Vorzeichen) generiert, der entweder „1,0“ oder „-1,0“ sein kann. Damit wird festgelegt, ob die Position des zweiten Dingos mit unverändertem oder umgekehrtem Vorzeichen subtrahiert wird. Anschließend folgt eine Schleife, die alle Dimensionen durchläuft. Für jede Dimension wird eine neue Dingo-Position wie folgt berechnet: Zur besten gefundenen Position (cB[c]) wird die Hälfte der Differenz zwischen der Position des ersten zufällig ausgewählten Dingos (a[r1].c[c]) und der Position des zweiten zufällig ausgewählten Dingos (a[r2].c[c]) addiert, wobei das Vorzeichen der Position des zweiten Dingos abhängig von „sign“ umgekehrt werden kann. Nach der Berechnung der neuen Position sollte diese mithilfe der Hilfsfunktion „SeInDiSp“ angepasst werden.
Im Allgemeinen veranschaulicht die Methode „SurvivalProcedure“ eine Strategie, bei der ein Dingo seine Position aktualisiert, indem er diese als Abweichung von der besten gefundenen Position berechnet und dazu die Hälfte der Differenz zwischen den Positionen zweier anderer, zufällig ausgewählter Dingos addiert. Das zufällige Vorzeichen bringt ein Element der Unvorhersehbarkeit in die Richtungswahl für diese Differenz ein, und die Positionsbegrenzung stellt sicher, dass der Dingo in seinem Arbeitsbereich bleibt. Dies lässt sich als Versuch interpretieren, einen „Mittelwert“ zwischen zwei anderen potenziell „vielversprechenden“ Punkten zu ermitteln, wobei die beste bekannte Position berücksichtigt wird.
//————————————————————————————————————————————————————————————————————
//--- Strategy 4: Survival procedure (Eq. 6)
void C_AO_DOAm_dingo::SurvivalProcedure (int agentIdx)
{
  // Select two different random dingoes
  int r1, r2;
  do
  {
    r1 = u.RNDintInRange (0, popSize - 1);
    r2 = u.RNDintInRange (0, popSize - 1);
  }
  while (r1 == r2);

  double sign = u.RNDbool() ? 1.0 : -1.0;

  // Apply the survival formula (Eq. 6)
  for (int c = 0; c < coords; c++)
  {
    // v = theBestVct + (Positions[r1] - (-1)^binary * Positions[r2]) / 2
    a [agentIdx].c [c] = cB [c] + (a [r1].c [c] - sign * a [r2].c [c]) / 2.0;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode „UpdateSurvivalRates“ ist dafür zuständig, die „Überlebensraten“ für jeden Dingo in der Population zu berechnen und zu aktualisieren. Diese Indikatoren bestimmen die Wahrscheinlichkeit, mit der ein Dingo das Verhalten eines Agenten in der nächsten Iteration mitbestimmt.
Zunächst initialisiert die Methode zwei Variablen: minFitness und maxFitness. Anschließend durchläuft sie nacheinander alle Dingos in der Population. Für jeden Dingo wird sein aktueller Fitnesswert (a[i].f) mit den aktuellen Werten minFitness und maxFitness verglichen. Wenn die aktuelle Fitness kleiner als minFitness ist, wird minFitness aktualisiert. Ist die aktuelle Fitness größer als maxFitness, wird maxFitness aktualisiert. Nach dieser Schleife enthält minFitness den kleinsten Fitnesswert der gesamten Population und maxFitness den größten.
Ist der Unterschied zwischen maxFitness und minFitness sehr gering (praktisch null, was bedeutet, dass alle Dingos die gleiche Fitness aufweisen), wird allen Dingos ein Überlebenswert von „0,5“ zugewiesen. Dadurch wird eine Division durch Null verhindert und es werden gleiche Chancen für alle geschaffen.
Wenn sich die Fitness der Dingos unterscheidet, wird der Vorgang in einer Schleife für alle Dingos wiederholt. Für jeden Dingo wird dessen Überlebensrate (survival [i]) berechnet. Die Formel für diesen Indikator lautet wie folgt: (maxFitness - a [i].f) / (maxFitness - minFitness). Diese Formel normiert den Fitnesswert des Dingos auf den Bereich aller Fitnesswerte.
Der Dingo mit der geringsten Fitness, die nahe an minFitness liegt, hat eine Überlebensrate nahe 1,0 (da maxFitness - a[i].f groß ist). Ein Dingo mit der höchsten Fitness, die nahe an maxFitness liegt, hat eine Überlebensrate nahe 0,0 (da maxFitness - a[i].f nahe null liegt).
Letztlich wandelt die Methode „UpdateSurvivalRates“ absolute Dingo-Fitnesswerte in relative „Überlebensraten“ um, wobei höhere Fitnesswerte niedrigeren Überlebensraten entsprechen und umgekehrt. Dies lässt sich als eine Strategie interpretieren, bei der diejenigen, die „leiden“ (eine geringe Fitness aufweisen), eine größere Chance haben, zu „überleben“ oder sich zu verändern, während diejenigen, die am „erfolgreichsten“ sind (mit hoher Fitness), weniger Anreiz haben, sich zu verändern.
//————————————————————————————————————————————————————————————————————
//--- Update survival rates
void C_AO_DOAm_dingo::UpdateSurvivalRates ()
{
  // Find the minimum and maximum 'fitness'
  double minFitness =  DBL_MAX;
  double maxFitness = -DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f < minFitness) minFitness = a [i].f;
    if (a [i].f > maxFitness) maxFitness = a [i].f;
  }

  // Calculate survival rates
  if (MathAbs (maxFitness - minFitness) < DBL_EPSILON)
  {
    ArrayInitialize (survival, 0.5);
  }
  else
  {
    for (int i = 0; i < popSize; i++)
    {
      // survival_rate = (max - fit) / (max - min)
      survival [i] = (maxFitness - a [i].f) / (maxFitness - minFitness);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Die Methode Revision sucht nach dem Sortieren den besten Dingo in der aktuellen Population und aktualisiert die Bewertungswerte der global besten Lösung, wenn dieser Dingo die bisher bekannten besten Ergebnisse übertrifft. Dies ist ein Standardverfahren bei Optimierungsalgorithmen, um die im Verlauf der Suche gefundene beste Lösung zu speichern und zu verfolgen.
//————————————————————————————————————————————————————————————————————
//--- Update the best and worst solutions
void C_AO_DOAm_dingo::Revision ()
{
  // Sort the population to find the best and worst
  static S_AO_Agent aT [];
  ArrayResize (aT, popSize);
  u.Sorting (a, aT, popSize);

  // Update the global best solution
  if (a [0].f > fB)
  {
    fB = a [0].f;
    ArrayCopy (cB, a [0].c, 0, 0, WHOLE_ARRAY);
  }
}
//————————————————————————————————————————————————————————————————————
Testergebnisse
Ergebnisse aus 50 Durchläufen statt der üblichen 10 (um den Einfluss ungewöhnlich guter, aber zufallsbedingter Ergebnisse abzumildern)
DOA|Dingo Optimization Algorithm|50.0|0.5|0.7|
=============================
5 Hilly's; Func runs: 10000; result: 0.4796838225601811
25 Hilly's; Func runs: 10000; result: 0.4536754883347326
500 Hilly's; Func runs: 10000; result: 0.4636906699500103
=============================
5 Forest's; Func runs: 10000; result: 0.9414536230352631
25 Forest's; Func runs: 10000; result: 0.8790978288567921
500 Forest's; Func runs: 10000; result: 0.9145376343407303
=============================
5 Megacity's; Func runs: 10000; result: 0.7861538461538461
25 Megacity's; Func runs: 10000; result: 0.8606153846153848
500 Megacity's; Func runs: 10000; result: 0.8480461538461537
=============================
All score: 6.62695 (73.63%)
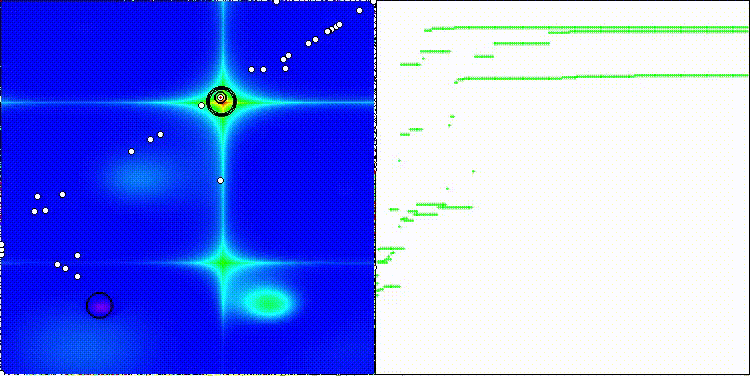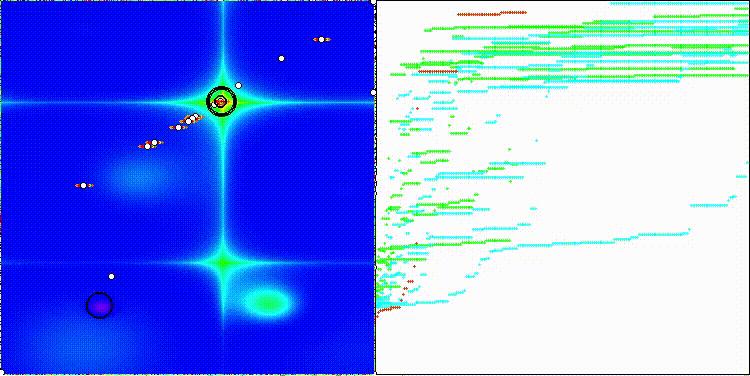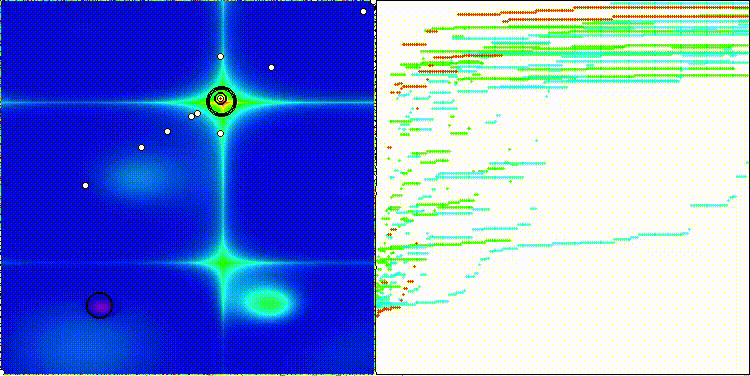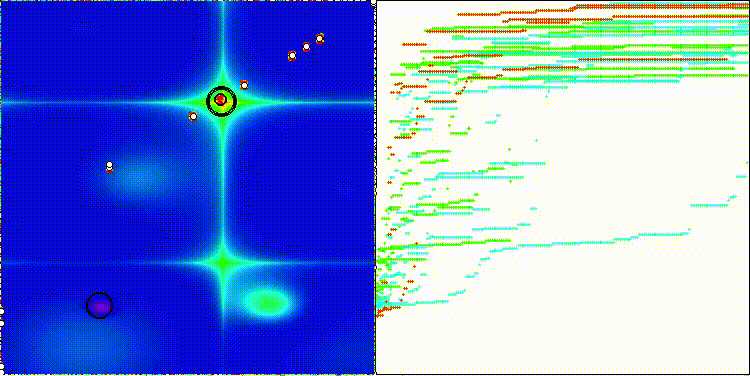
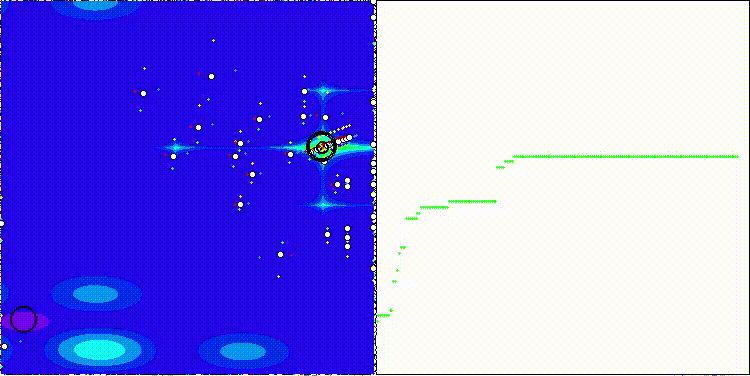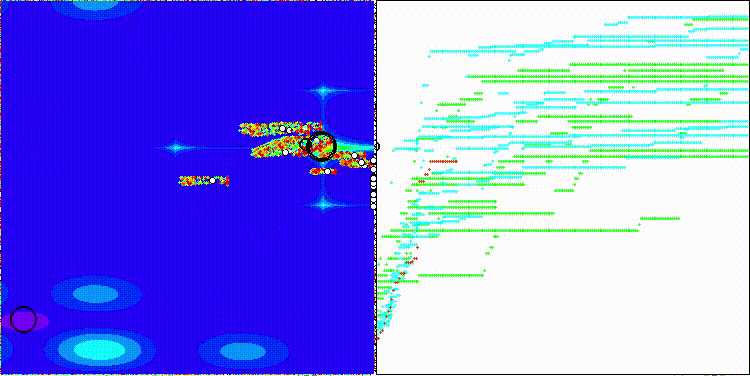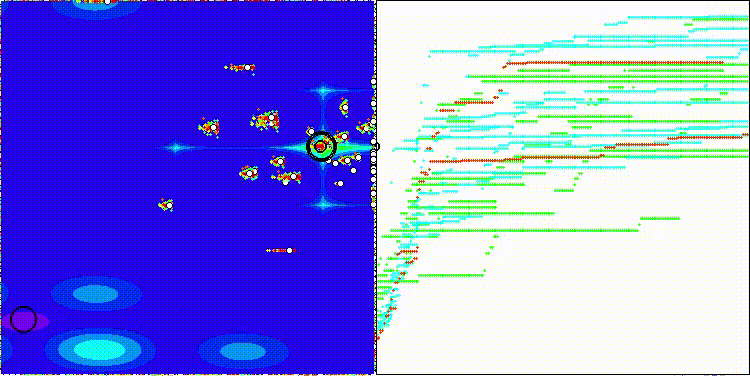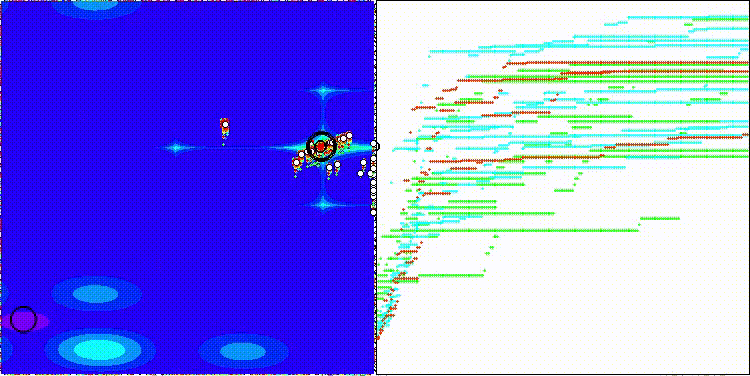
Die Visualisierung zeigt ein komplexes, sich veränderndes Muster im Suchbereich, das mit dem Einsatz verschiedener Jagdstrategien zusammenhängt (die charakteristischen diagonalen Muster, die vom Vorgängeralgorithmus übernommen wurden, sind weiterhin erkennbar). Trotz der hohen Gesamtwerte gibt es jedoch bei allen Testfunktionen eine sehr große Streuung der Ergebnisse.
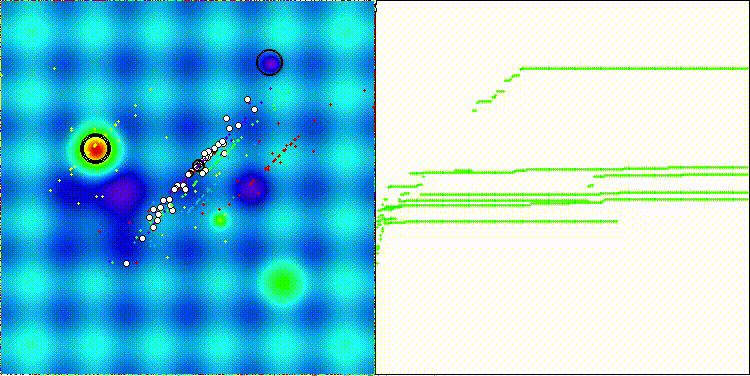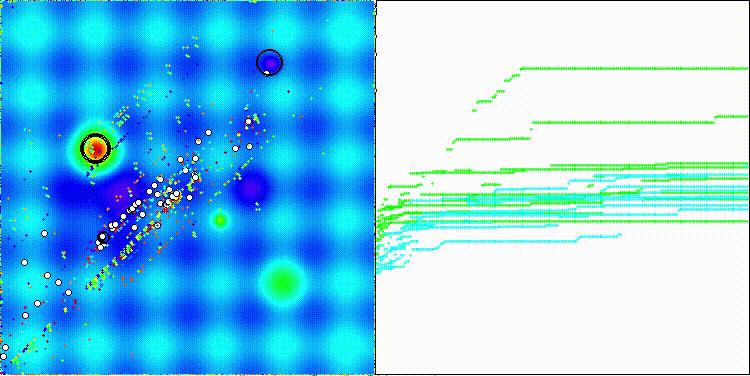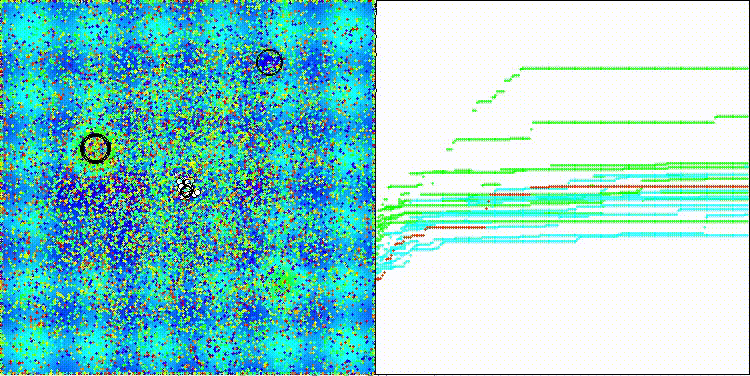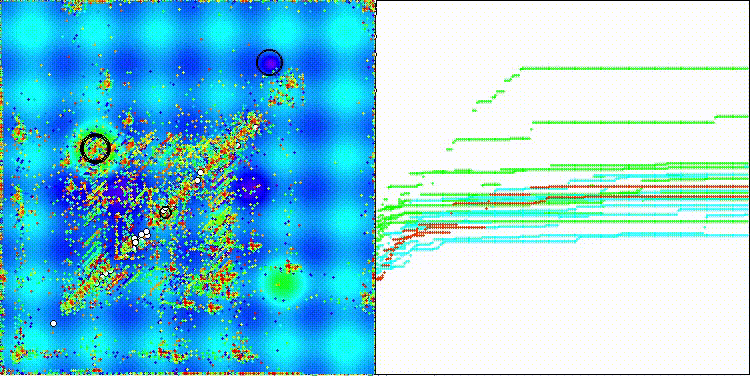
DOAm_dingo auf der Testfunktion Hilly
DOAm_dingo auf der Testfunktion Forest
DOAm_dingo auf der Testfunktion Megacity
Aufgrund der Testergebnisse belegt der DOAm_dingo-Algorithmus den ersten Platz in unserer Rangliste der populationsbasierten Optimierungsverfahren.
| # | AO | Beschreibung | Hilly | Hilly Final | Forest | Forest Final | Megacity (diskret) | Megacity Final | Final Result | % von MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | DOAm_dingo | dingo_optimization_algorithm_M | 0.47968 | 0.45367 | 0.46369 | 1.39704 | 0.94145 | 0.87909 | 0.91454 | 2.73508 | 0.78615 | 0.86061 | 0.84805 | 2.49481 | 6.627 | 73,63 |
| 1 | ANS | nachbarschaftsübergreifende Suche | 0.94948 | 0.84776 | 0.43857 | 2.23581 | 1.00000 | 0.92334 | 0.39988 | 2.32323 | 0.70923 | 0.63477 | 0.23091 | 1.57491 | 6.134 | 68,15 |
| 2 | CLA | Codeschloss-Algorithmus (joo) | 0.95345 | 0.87107 | 0.37590 | 2.20042 | 0.98942 | 0.91709 | 0.31642 | 2.22294 | 0.79692 | 0.69385 | 0.19303 | 1.68380 | 6.107 | 67,86 |
| 3 | AMOm | Optimierung der Tiermigration M | 0.90358 | 0.84317 | 0.46284 | 2.20959 | 0.99001 | 0.92436 | 0.46598 | 2.38034 | 0.56769 | 0.59132 | 0.23773 | 1.39675 | 5.987 | 66,52 |
| 4 | (P+O)ES | (P+O)-Evolutionsstrategien | 0.92256 | 0.88101 | 0.40021 | 2.20379 | 0.97750 | 0.87490 | 0.31945 | 2.17185 | 0.67385 | 0.62985 | 0.18634 | 1.49003 | 5.866 | 65,17 |
| 5 | CTA | Kometenschweif-Algorithmus (joo) | 0.95346 | 0.86319 | 0.27770 | 2.09435 | 0.99794 | 0.85740 | 0.33949 | 2.19484 | 0.88769 | 0.56431 | 0.10512 | 1.55712 | 5.846 | 64,96 |
| 6 | TETA | Algorithmus der zeitlichen Entwicklung und Bewegung (joo) | 0.91362 | 0.82349 | 0.31990 | 2.05701 | 0.97096 | 0.89532 | 0.29324 | 2.15952 | 0.73462 | 0.68569 | 0.16021 | 1.58052 | 5.797 | 64,41 |
| 7 | SDSm | Stochastische Diffusionssuche M | 0.93066 | 0.85445 | 0.39476 | 2.17988 | 0.99983 | 0.89244 | 0.19619 | 2.08846 | 0.72333 | 0.61100 | 0.10670 | 1.44103 | 5.709 | 63,44 |
| 8 | BOAm | Billard-Optimierungsalgorithmus M | 0.95757 | 0.82599 | 0.25235 | 2.03590 | 1.00000 | 0.90036 | 0.30502 | 2.20538 | 0.73538 | 0.52523 | 0.09563 | 1.35625 | 5.598 | 62,19 |
| 9 | AAm | Bogenschieß-Algorithmus M | 0.91744 | 0.70876 | 0.42160 | 2.04780 | 0.92527 | 0.75802 | 0.35328 | 2.03657 | 0.67385 | 0.55200 | 0.23738 | 1.46323 | 5.548 | 61,64 |
| 10 | ESG | Evolution sozialer Gruppen (joo) | 0.99906 | 0.79654 | 0.35056 | 2.14616 | 1.00000 | 0.82863 | 0.13102 | 1.95965 | 0.82333 | 0.55300 | 0.04725 | 1.42358 | 5.529 | 61,44 |
| 11 | SIA | simuliertes isotropes Annealing (joo) | 0.95784 | 0.84264 | 0.41465 | 2.21513 | 0.98239 | 0.79586 | 0.20507 | 1.98332 | 0.68667 | 0.49300 | 0.09053 | 1.27020 | 5.469 | 60,76 |
| 12 | EOm | extremal_optimization_M | 0.76166 | 0.77242 | 0.31747 | 1.85155 | 0.99999 | 0.76751 | 0.23527 | 2.00277 | 0.74769 | 0.53969 | 0.14249 | 1.42987 | 5.284 | 58,71 |
| 13 | BBO | biogeografiebasierte Optimierung | 0.94912 | 0.69456 | 0.35031 | 1.99399 | 0.93820 | 0.67365 | 0.25682 | 1.86867 | 0.74615 | 0.48277 | 0.17369 | 1.40261 | 5.265 | 58,50 |
| 14 | ACS | künstliche kooperative Suche | 0.75547 | 0.74744 | 0.30407 | 1.80698 | 1.00000 | 0.88861 | 0.22413 | 2.11274 | 0.69077 | 0.48185 | 0.13322 | 1.30583 | 5.226 | 58,06 |
| 15 | DA | dialektischer Algorithmus | 0.86183 | 0.70033 | 0.33724 | 1.89940 | 0.98163 | 0.72772 | 0.28718 | 1.99653 | 0.70308 | 0.45292 | 0.16367 | 1.31967 | 5.216 | 57,95 |
| 16 | BHAm | Black-Hole-Algorithmus M | 0.75236 | 0.76675 | 0.34583 | 1.86493 | 0.93593 | 0.80152 | 0.27177 | 2.00923 | 0.65077 | 0.51646 | 0.15472 | 1.32195 | 5.196 | 57,73 |
| 17 | ASO | Anarchy-Society-Optimierung | 0.84872 | 0.74646 | 0.31465 | 1.90983 | 0.96148 | 0.79150 | 0.23803 | 1.99101 | 0.57077 | 0.54062 | 0.16614 | 1.27752 | 5.178 | 57,54 |
| 18 | RFO | Royal-Flush-Optimierung (joo) | 0.83361 | 0.73742 | 0.34629 | 1.91733 | 0.89424 | 0.73824 | 0.24098 | 1.87346 | 0.63154 | 0.50292 | 0.16421 | 1.29867 | 5.089 | 56,55 |
| 19 | AOSm | Atomorbital-Suche M | 0.80232 | 0.70449 | 0.31021 | 1.81702 | 0.85660 | 0.69451 | 0.21996 | 1.77107 | 0.74615 | 0.52862 | 0.14358 | 1.41835 | 5.006 | 55,63 |
| 20 | TSEA | Schildkrötenpanzer-Evolutionsalgorithmus (joo) | 0.96798 | 0.64480 | 0.29672 | 1.90949 | 0.99449 | 0.61981 | 0.22708 | 1.84139 | 0.69077 | 0.42646 | 0.13598 | 1.25322 | 5.004 | 55,60 |
| 21 | BSA | Backtracking-Suchalgorithmus | 0.97309 | 0.54534 | 0.29098 | 1.80941 | 0.99999 | 0.58543 | 0.21747 | 1.80289 | 0.84769 | 0.36953 | 0.12978 | 1.34700 | 4.959 | 55,10 |
| 22 | DE | Differential Evolution | 0.95044 | 0.61674 | 0.30308 | 1.87026 | 0.95317 | 0.78896 | 0.16652 | 1.90865 | 0.78667 | 0.36033 | 0.02953 | 1.17653 | 4.955 | 55,06 |
| 23 | SRA | Successful Restaurateur Algorithm (joo) | 0.96883 | 0.63455 | 0.29217 | 1.89555 | 0.94637 | 0.55506 | 0.19124 | 1.69267 | 0.74923 | 0.44031 | 0.12526 | 1.31480 | 4.903 | 54,48 |
| 24 | CRO | Chemical Reaction Optimization | 0.94629 | 0.66112 | 0.29853 | 1.90593 | 0.87906 | 0.58422 | 0.21146 | 1.67473 | 0.75846 | 0.42646 | 0.12686 | 1.31178 | 4.892 | 54,36 |
| 25 | BIO | Blood Inheritance Optimization (joo) | 0.81568 | 0.65336 | 0.30877 | 1.77781 | 0.89937 | 0.65319 | 0.21760 | 1.77016 | 0.67846 | 0.47631 | 0.13902 | 1.29378 | 4.842 | 53,80 |
| 26 | DOA | dream_optimization_algorithm | 0.85556 | 0.70085 | 0.37280 | 1.92921 | 0.73421 | 0.48905 | 0.24147 | 1.46473 | 0.77231 | 0.47354 | 0.18561 | 1.43146 | 4.825 | 53,62 |
| 27 | BSA | Bird Swarm Algorithm | 0.89306 | 0.64900 | 0.26250 | 1.80455 | 0.92420 | 0.71121 | 0.24939 | 1.88479 | 0.69385 | 0.32615 | 0.10012 | 1.12012 | 4.809 | 53,44 |
| 28 | DEA | Delfin-Echolokationsalgorithmus | 0.75995 | 0.67572 | 0.34171 | 1.77738 | 0.89582 | 0.64223 | 0.23941 | 1.77746 | 0.61538 | 0.44031 | 0.15115 | 1.20684 | 4.762 | 52,91 |
| 29 | HS | Harmony Search | 0.86509 | 0.68782 | 0.32527 | 1.87818 | 0.99999 | 0.68002 | 0.09590 | 1.77592 | 0.62000 | 0.42267 | 0.05458 | 1.09725 | 4.751 | 52,79 |
| 30 | SSG | Saplings Sowing and Growing | 0.77839 | 0.64925 | 0.39543 | 1.82308 | 0.85973 | 0.62467 | 0.17429 | 1.65869 | 0.64667 | 0.44133 | 0.10598 | 1.19398 | 4.676 | 51,95 |
| 31 | BCOm | Bacterial Chemotaxis Optimization M | 0.75953 | 0.62268 | 0.31483 | 1.69704 | 0.89378 | 0.61339 | 0.22542 | 1.73259 | 0.65385 | 0.42092 | 0.14435 | 1.21912 | 4.649 | 51,65 |
| 32 | ABO | African Buffalo Optimization | 0.83337 | 0.62247 | 0.29964 | 1.75548 | 0.92170 | 0.58618 | 0.19723 | 1.70511 | 0.61000 | 0.43154 | 0.13225 | 1.17378 | 4.634 | 51,49 |
| 33 | (PO)ES | (PO)-Evolutionsstrategien | 0.79025 | 0.62647 | 0.42935 | 1.84606 | 0.87616 | 0.60943 | 0.19591 | 1.68151 | 0.59000 | 0.37933 | 0.11322 | 1.08255 | 4.610 | 51,22 |
| 34 | FBA | fraktalbasierter Algorithmus | 0.79000 | 0.65134 | 0.28965 | 1.73099 | 0.87158 | 0.56823 | 0.18877 | 1.62858 | 0.61077 | 0.46062 | 0.12398 | 1.19537 | 4.555 | 50,61 |
| 35 | TSm | Tabu-Suche M | 0.87795 | 0.61431 | 0.29104 | 1.78330 | 0.92885 | 0.51844 | 0.19054 | 1.63783 | 0.61077 | 0.38215 | 0.12157 | 1.11449 | 4.536 | 50,40 |
| 36 | BSO | Brain-Storm-Optimierung | 0.93736 | 0.57616 | 0.29688 | 1.81041 | 0.93131 | 0.55866 | 0.23537 | 1.72534 | 0.55231 | 0.29077 | 0.11914 | 0.96222 | 4.498 | 49,98 |
| 37 | WOAm | Wal-Optimierungsalgorithmus M | 0.84521 | 0.56298 | 0.26263 | 1.67081 | 0.93100 | 0.52278 | 0.16365 | 1.61743 | 0.66308 | 0.41138 | 0.11357 | 1.18803 | 4.476 | 49,74 |
| 38 | AEFA | Algorithmus des künstlichen elektrischen Feldes | 0.87700 | 0.61753 | 0.25235 | 1.74688 | 0.92729 | 0.72698 | 0.18064 | 1.83490 | 0.66615 | 0.11631 | 0.09508 | 0.87754 | 4.459 | 49,55 |
| 39 | AEO | Optimierungsalgorithmus auf Basis künstlicher Ökosysteme | 0.91380 | 0.46713 | 0.26470 | 1.64563 | 0.90223 | 0.43705 | 0.21400 | 1.55327 | 0.66154 | 0.30800 | 0.28563 | 1.25517 | 4.454 | 49,49 |
| 40 | CAm | Kamel-Algorithmus M | 0.78684 | 0.56042 | 0.35133 | 1.69859 | 0.82772 | 0.56041 | 0.24336 | 1.63149 | 0.64846 | 0.33092 | 0.13418 | 1.11356 | 4.444 | 49,37 |
| 41 | ACOm | Ameisenkolonie-Optimierung M | 0.88190 | 0.66127 | 0.30377 | 1.84693 | 0.85873 | 0.58680 | 0.15051 | 1.59604 | 0.59667 | 0.37333 | 0.02472 | 0.99472 | 4.438 | 49,31 |
| 42 | CMAES | Kovarianzmatrix-Adaptions-Evolutionsstrategie | 0.76258 | 0.72089 | 0.00000 | 1.48347 | 0.82056 | 0.79616 | 0.00000 | 1.61672 | 0.75846 | 0.49077 | 0.00000 | 1.24923 | 4.349 | 48,33 |
| 43 | DA_duelist | duelist_algorithm | 0.92782 | 0.53778 | 0.27792 | 1.74352 | 0.86957 | 0.47536 | 0.18193 | 1.52686 | 0.62153 | 0.33569 | 0.11715 | 1.07437 | 4.345 | 48,28 |
| 44 | BFO-GA | Bacterial Foraging Optimization - GA | 0.89150 | 0.55111 | 0.31529 | 1.75790 | 0.96982 | 0.39612 | 0.06305 | 1.42899 | 0.72667 | 0.27500 | 0.03525 | 1.03692 | 4.224 | 46,93 |
| RW | Random Walk | 0.48754 | 0.32159 | 0.25781 | 1.06694 | 0.37554 | 0.21944 | 0.15877 | 0.75375 | 0.27969 | 0.14917 | 0.09847 | 0.52734 | 2.348 | 26.09 | |
Zusammenfassung
Die hier betrachtete Modifikation des DOA_dingo-Algorithmus zeichnet sich durch ihre hohe Suchleistung aus. Es ist jedoch zu beachten, dass es sich bei diesen beeindruckenden Ergebnissen um Durchschnittswerte handelt, die in einer Reihe von Tests ermittelt wurden. Das bedeutet, dass der Benutzer die Optimierung mehrmals durchführen muss, um eine ausreichende Erkundung des Suchraums zu gewährleisten.
Andererseits weist der Algorithmus bei glatten Funktionen eine eher mäßige Konvergenzgeschwindigkeit auf. Dennoch ist DOA_dingo eine sehr nützliche und vielversprechende Methode. Ich würde empfehlen, diese Methode in der Anfangsphase der Suche einzusetzen und anschließend auf präzisere Algorithmen umzusteigen. Außerdem ist es äußerst wichtig, alle Parameter vorab auf denselben Wertebereich zu normalisieren.
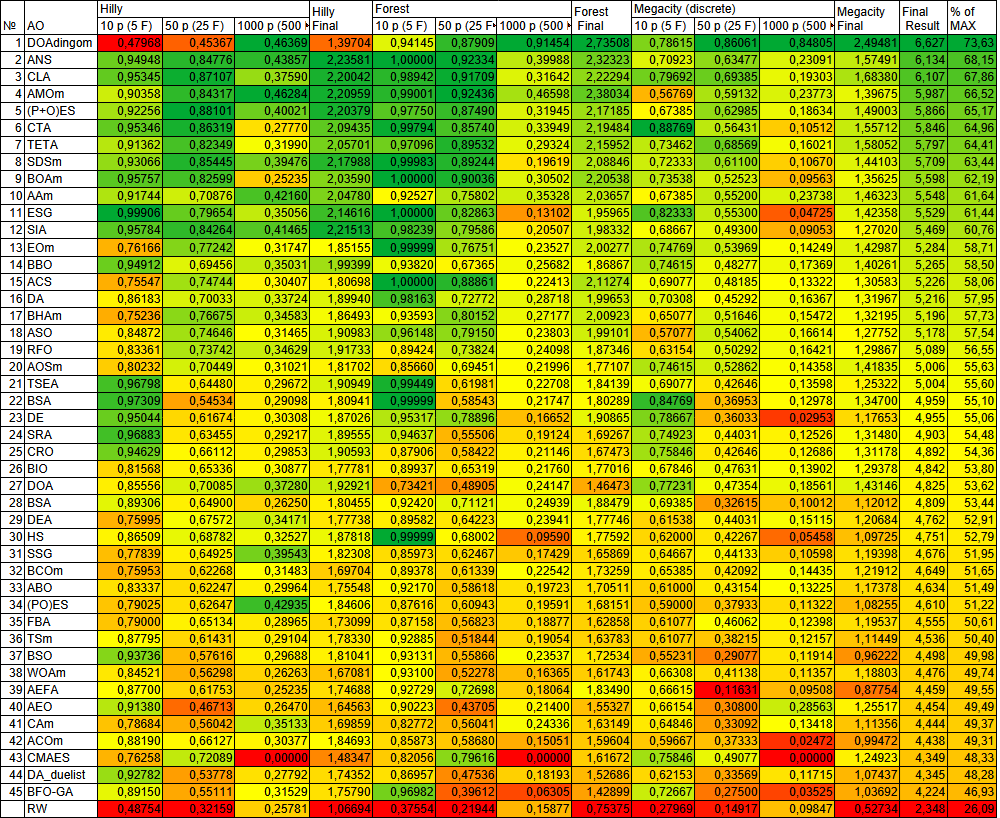
Abbildung 2. Farbcodierter Vergleich der Algorithmen in den jeweiligen Tests
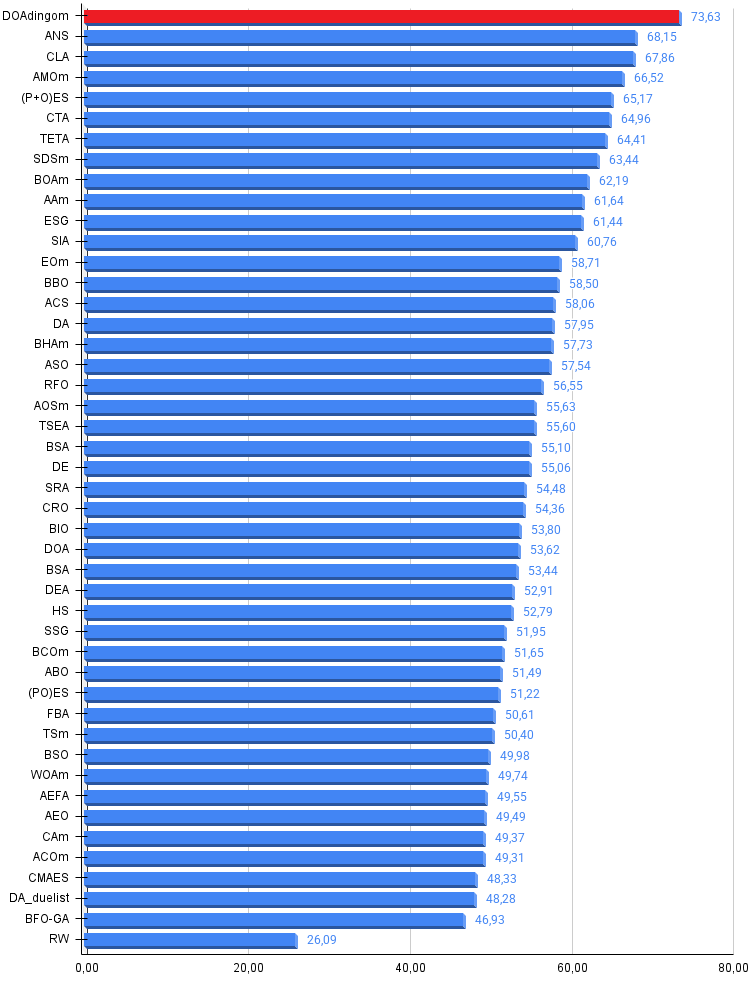
Abbildung 3. Histogramm der Ergebnisse der Algorithmustests (Skala von 0 bis 100, je höher, desto besser; wobei 100 das höchstmögliche theoretische Ergebnis darstellt; im Archiv befindet sich ein Skript zur Berechnung der Bewertungstabelle)
Vor- und Nachteile von DOAm_dingo:
Vorteile:
- Schnell.
- Sehr hohe Durchschnittswerte.
Nachteile:
- Große Schwankungsbreite bei den Ergebnissen.
- Neigung, sich festzufahren.
Dem Artikel liegt ein Archiv mit den aktuellen Versionen der Algorithmus-Quellcodes bei. Der Autor des Artikels übernimmt keine Gewähr für die absolute Richtigkeit der Beschreibung der kanonischen Algorithmen. An vielen von ihnen wurden Änderungen vorgenommen, um die Suchfähigkeiten zu verbessern. Die in den Artikeln dargelegten Schlussfolgerungen und Einschätzungen basieren auf den Ergebnissen der Experimente.
Im Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | #C_AO.mqh | Include | Basisklasse für populationsbasierte Optimierungsalgorithmen |
| 2 | #C_AO_enum.mqh | Include | Enumeration populationsbasierter Optimierungsalgorithmen |
| 3 | TestFunctions.mqh | Include | Bibliothek mit Testfunktionen |
| 4 | TestStandFunctions.mqh | Include | Funktionsbibliothek für den Teststand |
| 5 | Utilities.mqh | Include | Bibliothek mit Hilfsfunktionen |
| 6 | CalculationTestResults.mqh | Include | Skript zur Berechnung der Ergebnisse für die Vergleichstabelle |
| 7 | Testing AOs.mq5 | Skript | Der einheitliche Teststand für alle populationsbasierten Optimierungsalgorithmen |
| 8 | Simple use of population optimization algorithms.mq5 | Skript | Ein einfaches Beispiel für die Verwendung populationsbasierter Optimierungsalgorithmen ohne Visualisierung |
| 9 | Test_AO_DOAm_dingo.mq5 | Skript | Testumgebung für DOAm_dingo |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19187
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.


Es wurde ein Artikel mit dem Titel „Modifikation des Dingo-Optimierungsalgorithmus – Dingo Optimization Algorithm M (DOAm)“ veröffentlicht:
Autor: Andrey Dik