

Modificación del algoritmo de optimización de Dingo — Dingo Optimization Algorithm M (DOAm)
 61
 2

Índice
Introducción
Preguntémonos: ¿existen algoritmos metaheurísticos basados en poblaciones que, con un número limitado de iteraciones —10 000, como en nuestro caso—, sean capaces de lograr un resultado del 100%? Un algoritmo así tendría que ser tan potente que, a veces, dudo de que sea posible conseguir semejante joya para la optimización. ¿Y usted qué opina?
Pues bien, puede que existan algoritmos próximos a ese objetivo, y hoy vamos a conocer uno de los métodos de optimización más singulares; más concretamente, una versión modificada por mí del algoritmo de Dingo Optimization Algorithm, que ya analizamos en el artículo anterior. Esta versión nos acerca un poco más al cumplimiento de una tarea tan difícil.
Implementación del algoritmo
Mientras trabajaba en el algoritmo de optimización «Dingo Optimization Algorithm», me interesó el principio de modelado de la caza del dingo, que incluye varias estrategias. Ya hemos conocido este algoritmo y hemos analizado en detalle sus principios de funcionamiento. Las pruebas del algoritmo arrojaron resultados medios; no entró en la tabla de clasificación, ya que le faltaba un 20 % más para alcanzar el umbral de entrada. Parecería que se podría dejar a un lado y seguir adelante. Sin embargo, decidí experimentar con las fórmulas, y este fue el resultado:
Fórmula del ataque en grupo (Ecuación 2), versión de los autores:
x⃗ᵢ(t+1) = β₁ · [Σₖ₌₁ⁿᵃ φ⃗ₖ(t)]/nₐ - x⃗*(t)
a[agentIdx].c[c] = cB[c] + beta1 * sumAttack;
Como se puede observar, en la fórmula se ha cambiado el signo: en lugar de restar la mejor solución, la sumamos. Además, el método de cálculo de sumAttack es más complejo: se divide entre (na * coords), en lugar de simplemente «na».
El umbral de supervivencia en la versión original es survival[r] <= 0.3; lo cambiaremos por survival[r] <= 0.01. Reducimos drásticamente el umbral, lo que significa que aplicaremos estrategias de supervivencia solo a los agentes más «débiles».
Fórmula de búsqueda de carroña (Ecuación 4), versión de los autores del algoritmo:
x⃗ᵢ(t+1) = ½ · e^β₂ · |x⃗ᵣ₁(t) - (-1)^σ · x⃗ᵢ(t)|
Nueva versión:
a[agentIdx].c[c] = (MathExp(beta2) * a[r1].c[c] - sign * a[agentIdx].c[c]) / 2.0;
Ahora se eliminará el módulo (valor absoluto), lo que permitirá obtener coordenadas negativas. Además, la nueva versión del algoritmo promediará la diferencia de posiciones sobre el conjunto de todas las coordenadas, es decir, dividiéndola entre (na × coords), y no coordenada por coordenada.
¿Por qué estos cambios pueden mejorar el funcionamiento del algoritmo? El cambio de signo en el ataque en grupo puede generar un movimiento «hacia la mejor solución teniendo en cuenta las posiciones de los demás», y no «alejándose de la mejor», como en la propuesta de los autores. La reducción del umbral de supervivencia permite a la mayoría de los agentes utilizar las estrategias principales de caza, recurriendo a la supervivencia solo en casos extremos. La ausencia del módulo en la fórmula de búsqueda de carroña permite un movimiento más libre en el espacio de búsqueda.
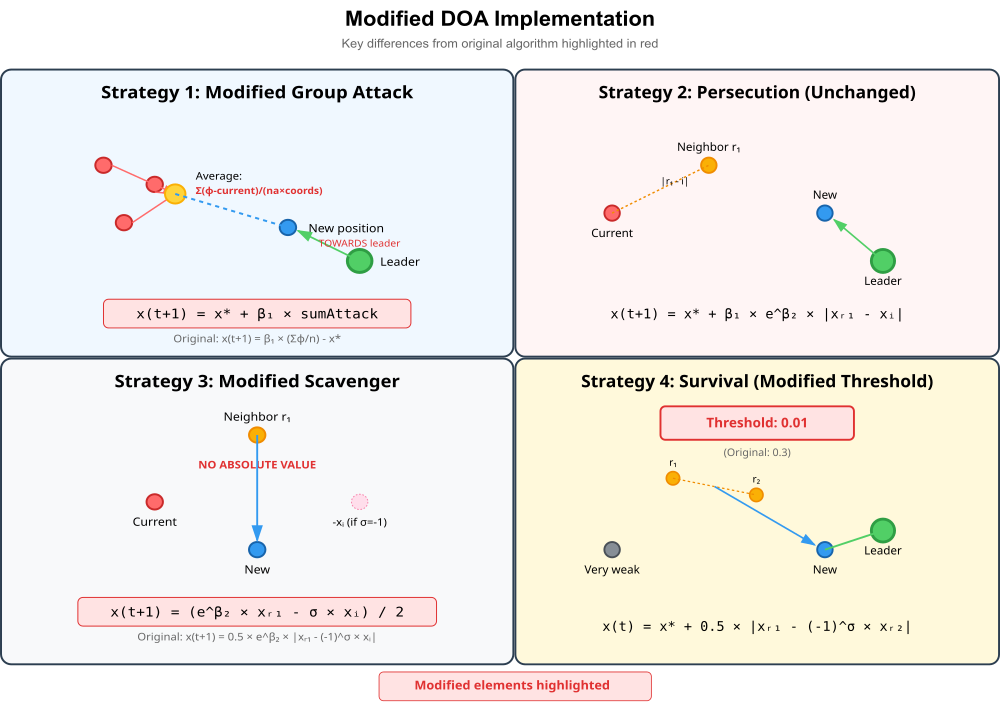
Figura 1. Modificaciones de las estrategias DOAm_dingo
La ilustración anterior muestra las diferencias clave entre la versión modificada y la original, descrita por los autores del algoritmo: en el ataque en grupo, el movimiento se realiza hacia el líder, en lugar de alejarse de él; el umbral de supervivencia se ha reducido a 0,01; ahora la búsqueda de carroña se realiza sin el módulo en la fórmula y el promedio se calcula dividiendo entre (na × coords), en lugar de simplemente (na). Las modificaciones aparecen resaltadas en rojo para mayor claridad.
Ahora pasemos a describir el código del algoritmo y veamos qué hemos conseguido. La clase «C_AO_DOAm_dingo» es una versión especializada de la clase base «C_AO». Se trata de una versión especializada de la clase base “C_AO”, que implementa un algoritmo de optimización basado en una modificación del comportamiento del dingo; la clase «Dingo Optimization Algorithm M» hereda de «C_AO», por lo que dispone de su funcionalidad básica. Configuramos los valores por defecto de los parámetros clave:
- popSize — (tamaño de la población, es decir, número de dingos): 50.
- P — (probabilidad de elegir entre la caza y la búsqueda de carroña): 0,5.
- Q — (probabilidad de elegir entre un ataque en grupo y una persecución): 0,7.
- Init — se encarga de la ejecución inicial del algoritmo, incluida la inicialización de los agentes (dingos) y de sus parámetros, utilizando los intervalos y los pasos de variación proporcionados.
- Moving — se encarga de la fase principal del algoritmo, en la que los agentes se desplazan e interactúan de acuerdo con las reglas del algoritmo.
- Revision — se encarga de revisar o evaluar el estado del algoritmo tras una etapa o época determinada.
- P — probabilidad de que el dingo cace o busque carroña.
- Q — probabilidad de que un dingo participe en un ataque en grupo o en una persecución.
- beta1, beta2 — se utilizan para generar vectores aleatorios o pasos en el proceso de optimización, con rangos de valores predeterminados;
- naIni, naEnd — determinan el número mínimo y máximo de dingos que participan en el ataque, que puede variar;
- survival — array que almacena las tasas de «supervivencia» o aptitud de cada dingo.
- UpdateSurvivalRates — actualiza las tasas de supervivencia de los agentes;
- GroupAttack — implementa el comportamiento de ataque en grupo;
- Persecution — implementa el comportamiento de persecución;
- Scavenger — implementa el comportamiento de búsqueda de carroña;
- SurvivalProcedure — procedimiento relacionado con la supervivencia de los agentes;
- GetAttackVector — obtiene el vector que determina la dirección del ataque;
- CalculateAttackSum — calcula el «efecto» total del ataque.
//————————————————————————————————————————————————————————————————————
class C_AO_DOAm_dingo : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOAm_dingo () { }
  C_AO_DOAm_dingo ()
  {
    ao_name = "DOAm";
    ao_desc = "Dingo Optimization Algorithm M";
    ao_link = "https://www.mql5.com/ru/articles/19187";

    popSize = 50;     // tamaño de la población (número de dingos)
    P       = 0.5;    // probabilidad de caza o de búsqueda de carroña (Hunting or Scavenger rate)
    Q       = 0.7;    // probabilidad de ataque en grupo o persecución (Group attack or persecution)

    ArrayResize (params, 3);

    params [0].name = "popSize"; params [0].val = popSize;
    params [1].name = "P";       params [1].val = P;
    params [2].name = "Q";       params [2].val = Q;
  }

  void SetParams ()
  {
    popSize = (int)params [0].val;
    P       = params [1].val;
    Q       = params [2].val;
  }

  bool Init (const double &rangeMinP  [],  // valores mínimos
             const double &rangeMaxP  [],  // valores máximos
             const double &rangeStepP [],  // paso de variación
             const int     epochsP = 0);   // número de épocas

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double P;          // probabilidad de caza o de búsqueda de carroña
  double Q;          // probabilidad de ataque en grupo o persecución

  private: //---------------------------------------------------------
  double beta1;       // -2 < beta1 < 2
  double beta2;       // -1 < beta2 < 1
  int    naIni;       // número mínimo de dingos atacantes
  int    naEnd;       // número máximo de dingos atacantes
  double survival []; // array de tasas de supervivencia

  // Métodos auxiliares
  void   UpdateSurvivalRates ();
  void   GroupAttack         (int agentIdx, int na);
  void   Persecution         (int agentIdx);
  void   Scavenger           (int agentIdx);
  void   SurvivalProcedure   (int agentIdx);
  void   GetAttackVector     (int na, int &attackVector []);
  double CalculateAttackSum  (int agentIdx, int na);
};
//————————————————————————————————————————————————————————————————————
Este método está diseñado para inicializar el algoritmo «Dingo Optimization Algorithm M». Lo prepara para su ejecución estableciendo las condiciones iniciales del proceso de optimización, definiendo cómo formarán los dingos los grupos de ataque y fijando el estado inicial de su «supervivencia».
//————————————————————————————————————————————————————————————————————
//--- Inicialización
bool C_AO_DOAm_dingo::Init (const double &rangeMinP  [],
                            const double &rangeMaxP  [],
                            const double &rangeStepP [],
                            const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  //------------------------------------------------------------------
  // Inicialización de los parámetros del algoritmo
  naIni = 2;               // número mínimo de atacantes
  naEnd = popSize / naIni; // número máximo de atacantes

  ArrayResize     (survival, popSize);
  ArrayInitialize (survival, 1.0);

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «Moving» es la función principal encargada de ejecutar un paso (o iteración) del algoritmo; simula el comportamiento de una manada de dingos durante la búsqueda de la solución óptima. Este método controla dinámicamente el comportamiento de la población de dingos, permitiéndoles explorar el espacio de soluciones mediante diversas estrategias basadas en su «supervivencia» y en decisiones probabilísticas. En el artículo anterior se ofrecía una descripción más detallada de los métodos principales. Aquí nos detendremos con más detalle en los métodos específicos.
//————————————————————————————————————————————————————————————————————
//--- Paso principal del algoritmo
void C_AO_DOAm_dingo::Moving ()
{
  // Inicialización de la población
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }

    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Actualizamos las tasas de supervivencia
  UpdateSurvivalRates ();

  // Actualizamos los parámetros beta para la iteración actual
  //beta1 = -2.0 + 4.0 * u.RNDprobab ();
  //beta2 = -1.0 + 2.0 * u.RNDprobab ();
  beta1 = u.RNDfromCI (-2.0, 2.0);
  beta2 = u.RNDfromCI (-1.0, 1.0);

  // Bucle principal sobre todos los dingos
  for (int r = 0; r < popSize; r++)
  {
    // Comprobamos el índice de supervivencia (sección 2.2.4)
    //if (survival[r] <= 0.3)
    if (survival [r] <= 0.01)
    {
      // Estrategia 4: Procedimiento de supervivencia (ec. 6)
      SurvivalProcedure (r);
    }
    else
    {
      // Elección entre la caza y la búsqueda de carroña
      if (u.RNDprobab () < P)  // Si caza
      {
        if (u.RNDprobab () < Q)  // Si se produce un ataque en grupo
        {
          // Estrategia 1: Ataque en grupo (Ec. 2)
          int na = naIni + (int)((naEnd - naIni) * u.RNDprobab ());
          GroupAttack (r, na);
        }
        else  // Persecución
        {
          // Estrategia 2: Persecución (Ec. 3)
          Persecution (r);
        }
      }
      else  // Búsqueda de carroña
      {
        // Estrategia 3: Búsqueda de carroña (Ec. 4)
        Scavenger (r);
      }
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «GroupAttack» implementa la «Estrategia 1: Ataque en grupo». Esta estrategia se aplica cuando un dingo decide atacar a su presa formando parte de un grupo. Lo primero que se hace es llamar al método auxiliar «CalculateAttackSum». Toma el índice del dingo actual (agentIdx) y el número de dingos que participan en el ataque (na), y calcula la fuerza total o la dirección del ataque sumando las aportaciones de todos los participantes. El resultado de esta compleja operación se almacena en la variable «sumAttack».
A continuación, el método actualiza la posición (coordenadas) del dingo actual. El método recorre iterativamente cada coordenada «c» del espacio de búsqueda y calcula un nuevo valor para la posición del dingo. La fórmula actualizada es la siguiente:
Nueva coordenada = Coordenada de la mejor solución + beta1 * vector de ataque total
donde:
- «cB [c]» representa la coordenada c-ésima de la mejor solución actual encontrada en la optimización,
- beta1 — coeficiente que regula la intensidad o la dirección del impacto de un ataque en grupo,
- sumAttack — resultado obtenido en el paso anterior.
A continuación, el nuevo valor de la coordenada obtenido se «ajusta» a los límites permitidos. El método «u.SeInDiSp» garantiza que el nuevo valor se mantenga dentro de los límites mínimo (rangeMin) y máximo (rangeMax) establecidos, teniendo en cuenta el paso de variación (rangeStep).
En resumen, el método «GroupAttack» simula la búsqueda coordinada de una solución óptima por parte de un grupo de dingos. Agrega la información de varios individuos mediante «sumAttack», tiene en cuenta la mejor solución encontrada «cB» y utiliza un coeficiente aleatorio «beta1» para determinar una nueva posición, potencialmente más ventajosa, del dingo en el espacio de búsqueda.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 1: Ataque en grupo (Eq. 2)
void C_AO_DOAm_dingo::GroupAttack (int agentIdx, int na)
{
  // Calculamos el vector de ataque total
  double sumAttack = CalculateAttackSum (agentIdx, na);

  // Aplicamos la fórmula del ataque en grupo (Eq. 2)
  for (int c = 0; c < coords; c++)
  {
    // v = beta1 * sumatory - theBestVct
    a [agentIdx].c [c] = cB [c] + beta1 * sumAttack;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «CalculateAttackSum» sirve para calcular el vector de ataque total, que se utiliza en la «Estrategia 1: Ataque en grupo». Determina cómo un dingo concreto (agentIdx) interactuará con los demás dingos que participan en el ataque en grupo (na).
En primer lugar, el método crea una lista temporal (attackVector) que contendrá las tasas de los dingos que participan directamente en el ataque. El tamaño de esta lista viene determinado por el parámetro «na» (número de atacantes). Luego se invoca el método auxiliar «GetAttackVector». Este método, basándose en el estado actual de la población, selecciona «na» dingos que participarán en el ataque y registra sus tasas en «attackVector». Se inicializa una variable denominada «sumatory» (sumador) con el valor cero. A continuación viene el ciclo principal, que recorre todos los dingos que participan en el ataque y toma de «attackVector» el índice (attackerIdx) de cada dingo atacante.
Dentro de este ciclo hay otro ciclo que recorre todas las coordenadas (c) del espacio de búsqueda (ciclo: de «0» a «coords - 1»). En cada coordenada se calcula la diferencia entre la posición del dingo atacante y la posición del dingo para el que se calcula el ataque total. Esta diferencia se divide a continuación entre el número total de posibles participantes en el ataque (na) y el número total de coordenadas (coords), y se suma a «sumatory».
Por último, el método devuelve el valor «sumatory». Este valor representa la diferencia media entre las posiciones de los dingos atacantes y la del dingo objetivo, ajustada en función del número de participantes y de dimensiones. El valor se utilizará posteriormente para actualizar la posición del dingo objetivo en el marco de un ataque en grupo.
De este modo, «CalculateAttackSum» recopila información sobre las posiciones actuales de los dingos que participan en el ataque conjunto y calcula una magnitud global que refleja su desplazamiento total con respecto al dingo atacado. Esta magnitud determina entonces el movimiento del dingo atacado.
//————————————————————————————————————————————————————————————————————
//--- Cálculo de la suma para un ataque en grupo
double C_AO_DOAm_dingo::CalculateAttackSum (int agentIdx, int na)
{
  // Creamos un vector de dingos atacantes
  int attackVector [];
  ArrayResize (attackVector, na);
  GetAttackVector (na, attackVector);

  // Calculamos la diferencia media entre las posiciones
  double sumatory = 0.0;
  for (int j = 0; j < na; j++)
  {
    int attackerIdx = attackVector [j];
    // Calculamos la media de todas las coordenadas
    for (int c = 0; c < coords; c++)
    {
      sumatory += (a [attackerIdx].c [c] - a [agentIdx].c [c]) / (na * coords);
    }
  }

  return sumatory;
}
//————————————————————————————————————————————————————————————————————
El método «GetAttackVector» se encarga de generar la lista de dingos que participarán directamente en el ataque en grupo. Crea un conjunto de tasas aleatorias y únicas, cada uno de los cuales corresponde a un dingo de la población. El método establece en primer lugar el tamaño del array de salida «attackVector» en el número especificado «na» (número de atacantes). Además, se inicializa el contador «c» con el valor cero, que llevará la cuenta de cuántos dingos se han seleccionado ya para el ataque.
El método entra en un bucle que continuará hasta que se hayan seleccionado «na» dingos. En cada iteración del ciclo se genera un índice aleatorio (idx) de un dingo de entre toda la población disponible (de «0» a «popSize - 1»). Antes de añadir el índice generado a la lista de atacantes, se lleva a cabo una comprobación. El método recorre las tasas ya seleccionados (de «0» a «c - 1») del array «attackVector». Si el índice generado aleatoriamente (idx) coincide con alguno de los seleccionados anteriormente (es decir, attackVector [i] == idx), se establece el indicador «found» en «verdadero». Si el indicador sigue en «falso» (es decir, si aún no se ha seleccionado dicho índice), este nuevo índice único (idx) se añade al array «attackVector» en el índice actual «c». A continuación, el contador c se incrementa en una unidad.
En esencia, «GetAttackVector» se encarga de seleccionar al azar «na» dingos únicos de toda la población para que formen un grupo de ataque. Este proceso garantiza que cada dingo del grupo sea diferente de los demás, lo que evita la repetición y asegura la diversidad en el grupo de ataque.
//————————————————————————————————————————————————————————————————————
//--- Formación del vector de dingos atacantes
void C_AO_DOAm_dingo::GetAttackVector (int na, int &attackVector [])
{
  int c = 0;
  ArrayResize (attackVector, na);

  while (c < na)
  {
    int idx = u.RNDintInRange (0, popSize - 1);

    // Comprobamos que el índice no se repita
    bool found = false;
    for (int i = 0; i < c; i++)
    {
      if (attackVector [i] == idx)
      {
        found = true;
        break;
      }
    }

    if (!found)
    {
      attackVector [c] = idx;
      c++;
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «Persecution» implementa la «Estrategia 2: Persecución». El objetivo de este método es actualizar la posición de un dingo concreto (agentIdx) para que comience la persecución. El método selecciona primero un dingo al azar de toda la población; el índice se almacena en la variable «r1».
A continuación viene un ciclo que recorre todas las dimensiones (c) del espacio en el que se encuentran los dingos. Para cada dimensión se aplica la siguiente fórmula para calcular la nueva posición del dingo (agentIdx): al valor de referencia (cB [c]), que representa la posición del mejor dingo, se le suma el producto de tres magnitudes: beta1, el coeficiente que controla el grado de influencia de la persecución; MathExp (beta2), la función exponencial del coeficiente beta2; y la diferencia entre la posición del dingo seleccionado al azar (a [r1].c [c]) y la posición actual del dingo atacante (a [agentIdx].c [c]) en esa dimensión.
La nueva posición se corrige inmediatamente mediante la función auxiliar de normalización «u.SeInDiSp», que garantiza que la nueva posición se mantenga dentro de los límites admisibles, desde «rangeMin [c]» hasta «rangeMax [c]» para cada dimensión, teniendo en cuenta el paso «rangeStep [c]».
En definitiva, el método «Persecution» hace que el dingo indicado (agentIdx) comience a moverse hacia otro dingo elegido al azar (r1), teniendo en cuenta la mejor posición de referencia y utilizando los parámetros «beta1» y «beta2» para regular la intensidad y la dinámica de dicha persecución. En cualquier caso, la nueva posición siempre se mantiene dentro de los estrictos límites del espacio de búsqueda.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 2: Persecución (Eq. 3)
void C_AO_DOAm_dingo::Persecution (int agentIdx)
{
  // Elegimos un dingo al azar
  int r1 = u.RNDintInRange (0, popSize - 1);

  // Aplicamos la fórmula de persecución (Eq. 3)
  for (int c = 0; c < coords; c++)
  {
    // v = theBestVct + beta1 * exp(beta2) * (Positions[r1] - Positions[r])
    a [agentIdx].c [c] = cB [c] + beta1 * MathExp (beta2) * (a [r1].c [c] - a [agentIdx].c [c]);
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «Scavenger» pone en práctica la «Estrategia 3: Búsqueda de carroña». El objetivo de este método es actualizar la posición de un dingo concreto (agentIdx) para que se desplace a una nueva posición, que es una especie de «término medio» o un valor «intermedio» entre su posición actual y la de otro dingo elegido al azar.
El método selecciona primero un dingo al azar de toda la población, y su índice se almacena en la variable «r1». Este dingo servirá como punto de referencia. Además, se genera un valor binario aleatorio (sign). Este valor será «1.0» o «-1.0». Esto determina si se utilizará la resta «directa» de la diferencia o la «inversa».
A continuación viene el ciclo, que recorre todas las dimensiones del espacio en el que se encuentran los dingos. Para cada dimensión, la nueva posición del dingo (agentIdx) se calcula de la siguiente manera: se toma la posición de un dingo elegido al azar (a [r1].c [c]) y se multiplica por la exponencial del coeficiente «beta2»; de este valor se resta (o se suma, según sign) la posición actual del dingo atacante, y el resultado obtenido se divide entre 2,0.
Esto significa, en la práctica, que la nueva posición se situará en algún punto entre la posición actual del dingo y la nueva posición «atractiva», que dependerá de «beta2» y del otro dingo seleccionado. Al igual que en otros métodos, una vez calculada la nueva posición, esta se corrige inmediatamente mediante la función auxiliar «u.SeInDiSp». Esta función garantiza que la nueva posición se mantenga dentro de los límites permitidos (desde «rangeMin [c]» hasta «rangeMax [c]») para cada dimensión.
De este modo, el método «Scavenger» actualiza la posición del dingo desplazándolo a un punto que se encuentra a mitad de camino entre su posición actual y la posición determinada mediante una transformación exponencial de la posición de otro dingo y un signo aleatorio. Esto imita el comportamiento de un animal que busca una presa que puede encontrarse «en el camino» o «en algún punto entre» puntos conocidos.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 3: Búsqueda de carroña (Ec. 4)
void C_AO_DOAm_dingo::Scavenger (int agentIdx)
{
  // Elegimos un dingo al azar
  int r1 = u.RNDintInRange (0, popSize - 1);
  double sign = u.RNDbool() ? 1.0 : -1.0;

  // Aplicamos la fórmula para la búsqueda de carroña (Ec. 4)
  for (int c = 0; c < coords; c++)
  {
    // v = (exp(beta2) * Positions[r1] - (-1)^binary * Positions[r]) / 2
    a [agentIdx].c [c] = (MathExp (beta2) * a [r1].c [c] - sign * a [agentIdx].c [c]) / 2.0;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «SurvivalProcedure» implementa la «Estrategia 4: Procedimiento de supervivencia». El objetivo principal de este método es actualizar la posición de un dingo concreto (agentIdx) utilizando la información de otros dos dingos para encontrar una nueva posición más ventajosa. El método selecciona primero, al azar, dos dingos distintos de toda la población. Sus tasas se almacenan en las variables «r1» y «r2». Se garantiza que «r1» y «r2» no coinciden.
Además, se genera un valor binario aleatorio (sign), que puede ser «1.0» o «-1.0». Este valor determina si la posición del segundo dingo se restará con su signo original o con el signo invertido. Luego se ejecuta un ciclo que recorre todas las dimensiones del espacio y, para cada dimensión, la nueva posición del dingo se calcula de la siguiente manera: a la mejor posición encontrada (cB [c]) se le suma la mitad de la diferencia entre la posición del primer dingo aleatorio (a [r1].c [c]) y la posición del segundo dingo aleatorio (a[r2]. c[c]), pudiendo invertirse el signo de la posición del segundo dingo en función de «sign». Una vez calculada la nueva posición, esta se corrige siempre mediante la función auxiliar «SeInDiSp».
En general, el método «SurvivalProcedure» muestra una estrategia en la que un dingo actualiza su posición calculándola como una variación respecto a la mejor posición encontrada, a la que suma la mitad de la diferencia entre las posiciones de otros dos dingos elegidos al azar. El signo aleatorio añade un elemento de imprevisibilidad a la elección de la dirección de esta diferencia, mientras que la restricción de posición garantiza que el dingo permanezca dentro de su área de trabajo. Esto puede interpretarse como un intento de encontrar un «término medio» entre otros dos puntos potencialmente «ventajosos», teniendo en cuenta la mejor posición conocida.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 4: Procedimiento de supervivencia (Eq. 6)
void C_AO_DOAm_dingo::SurvivalProcedure (int agentIdx)
{
  // Elegimos al azar dos dingos distintos
  int r1, r2;
  do
  {
    r1 = u.RNDintInRange (0, popSize - 1);
    r2 = u.RNDintInRange (0, popSize - 1);
  }
  while (r1 == r2);

  double sign = u.RNDbool() ? 1.0 : -1.0;

  // Aplicamos la fórmula de supervivencia (Eq. 6)
  for (int c = 0; c < coords; c++)
  {
    // v = theBestVct + (Positions[r1] - (-1)^binary * Positions[r2]) / 2
    a [agentIdx].c [c] = cB [c] + (a [r1].c [c] - sign * a [r2].c [c]) / 2.0;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «UpdateSurvivalRates» se encarga de calcular y actualizar las «tasas de supervivencia» de cada dingo de la población. Estas tasas determinan la probabilidad de que cada dingo sea seleccionado para participar en la siguiente iteración evolutiva.
En primer lugar, el método inicializa dos variables: «minFitness» y «maxFitness». A continuación, recorre en un bucle todos los dingos de la población. Para cada dingo, se compara su valor actual de aptitud (a [i].f) con los valores actuales de «minFitness» y «maxFitness». Si la aptitud actual es inferior a «minFitness», se actualiza «minFitness». Si la aptitud actual es mayor que «maxFitness», se actualiza «maxFitness». Como resultado de este ciclo, «minFitness» contendrá el valor de aptitud más bajo de toda la población, y «maxFitness», el más alto.
Si la diferencia entre «maxFitness» y «minFitness» es muy pequeña (prácticamente igual a cero, lo que significa que todos los dingos tienen la misma aptitud), a todos los dingos se les asigna un índice de supervivencia igual a «0,5». Esto evita la división por cero y garantiza la igualdad de oportunidades para todos.
Si la aptitud de los dingos varía, el método vuelve a recorrer en un bucle todos los dingos. Para cada dingo se calcula su índice de supervivencia (survival [i]). La fórmula para este índice es la siguiente: (maxFitness - a [i].f) / (maxFitness - minFitness). Esta fórmula normaliza el valor de la aptitud del dingo con respecto al rango de todos los valores de aptitud.
El dingo con menor aptitud, cercana a «minFitness», obtendrá un índice de supervivencia cercano a 1,0 (ya que maxFitness - a [i].f tendrá un valor grande). El dingo con mayor aptitud, cercana a «maxFitness», obtendrá un índice de supervivencia cercano a 0,0 (ya que maxFitness - a [i].f estará cerca de cero).
En definitiva, el método UpdateSurvivalRates transforma los valores absolutos de aptitud de los dingos en «tasas de supervivencia» relativas, en los que unos valores de aptitud más altos se corresponden con tasas de supervivencia más bajas, y viceversa. Esto puede interpretarse como una estrategia en la que quienes «sufren» (tienen una baja aptitud) tienen más posibilidades de «sobrevivir» o de cambiar, mientras que los más «exitosos» (con una alta aptitud) tienen menos incentivos para cambiar.
//————————————————————————————————————————————————————————————————————
//--- Actualización de las tasas de supervivencia
void C_AO_DOAm_dingo::UpdateSurvivalRates ()
{
  // Buscamos los valores mínimo y máximo de aptitud
  double minFitness =  DBL_MAX;
  double maxFitness = -DBL_MAX;

  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f < minFitness) minFitness = a [i].f;
    if (a [i].f > maxFitness) maxFitness = a [i].f;
  }

  // Calculamos las tasas de supervivencia
  if (MathAbs (maxFitness - minFitness) < DBL_EPSILON)
  {
    ArrayInitialize (survival, 0.5);
  }
  else
  {
    for (int i = 0; i < popSize; i++)
    {
      // survival_rate = (max - fit) / (max - min)
      survival [i] = (maxFitness - a [i].f) / (maxFitness - minFitness);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «Revision» se centra en buscar el mejor dingo de la población actual tras ordenarla y, si dicho dingo supera los mejores resultados conocidos hasta el momento, actualiza los indicadores de la mejor solución global. Se trata de un procedimiento estándar en los algoritmos de optimización, cuyo objetivo es conservar y realizar un seguimiento de la mejor solución encontrada a lo largo de todo el proceso de búsqueda.
//————————————————————————————————————————————————————————————————————
//--- Actualización de la mejor y la peor solución
void C_AO_DOAm_dingo::Revision ()
{
  // Ordenamos la población para identificar a los mejores y a los peores
  static S_AO_Agent aT [];
  ArrayResize (aT, popSize);
  u.Sorting (a, aT, popSize);

  // Actualizamos la mejor solución global
  if (a [0].f > fB)
  {
    fB = a [0].f;
    ArrayCopy (cB, a [0].c, 0, 0, WHOLE_ARRAY);
  }
}
//————————————————————————————————————————————————————————————————————
Resultados de las pruebas
Resultados de 50 ejecuciones, en lugar de las 10 habituales (para atenuar el efecto de los resultados excelentes obtenidos por azar)
DOA|Dingo Optimization Algorithm|50.0|0.5|0.7|
=============================
5 Hilly's; Func runs: 10000; result: 0.4796838225601811
25 Hilly's; Func runs: 10000; result: 0.4536754883347326
500 Hilly's; Func runs: 10000; result: 0.4636906699500103
=============================
5 Forest's; Func runs: 10000; result: 0.9414536230352631
25 Forest's; Func runs: 10000; result: 0.8790978288567921
500 Forest's; Func runs: 10000; result: 0.9145376343407303
=============================
5 Megacity's; Func runs: 10000; result: 0.7861538461538461
25 Megacity's; Func runs: 10000; result: 0.8606153846153848
500 Megacity's; Func runs: 10000; result: 0.8480461538461537
=============================
All score: 6.62695 (73.63%)
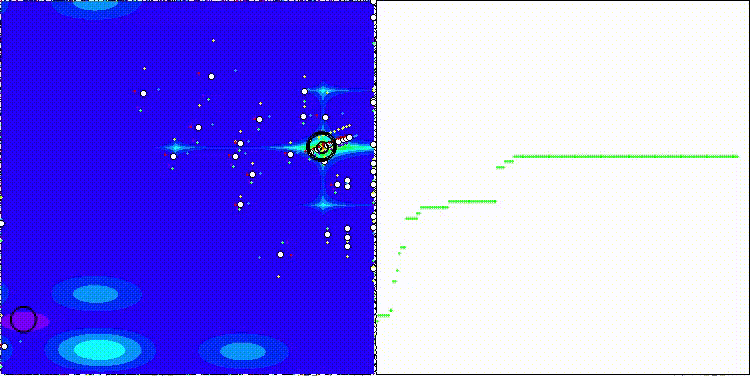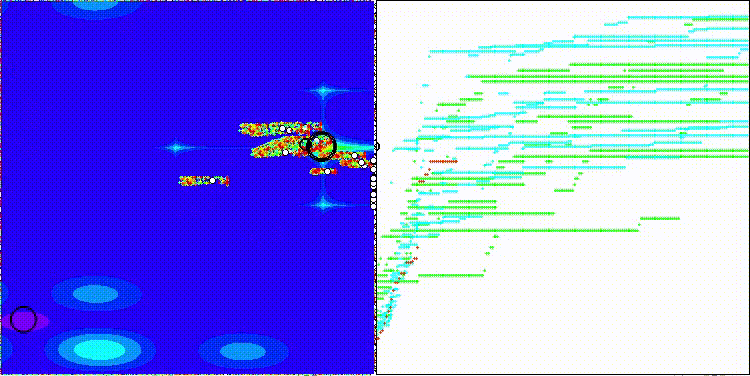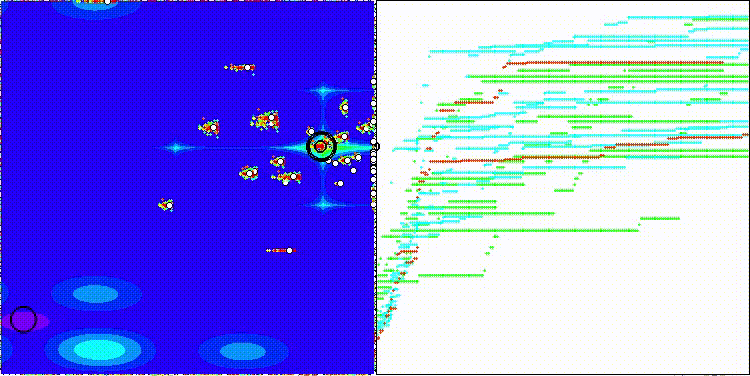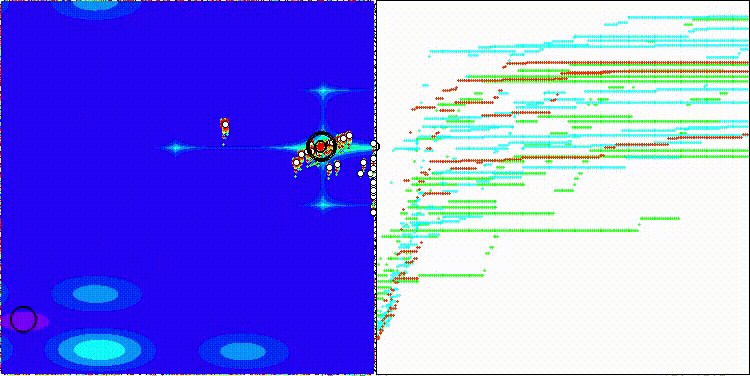
En la visualización se aprecia un patrón complejo y cambiante en la zona de búsqueda, relacionado con la aplicación de diversas estrategias de caza (se observan «rasgos familiares de diagonalidad», heredados de su progenitor). Sin embargo, a pesar de los buenos resultados generales, se observa una dispersión muy grande en los resultados de todas las funciones de prueba.
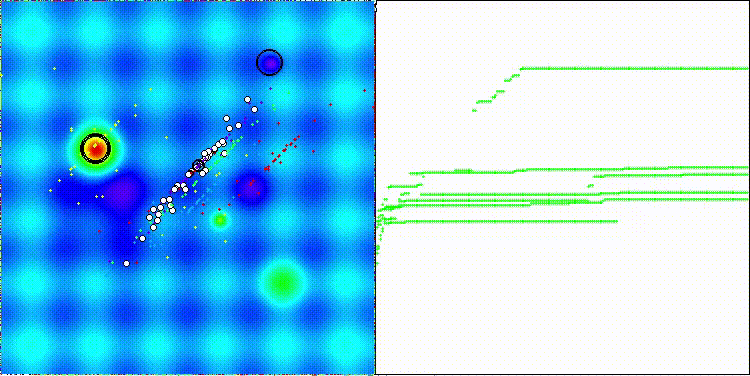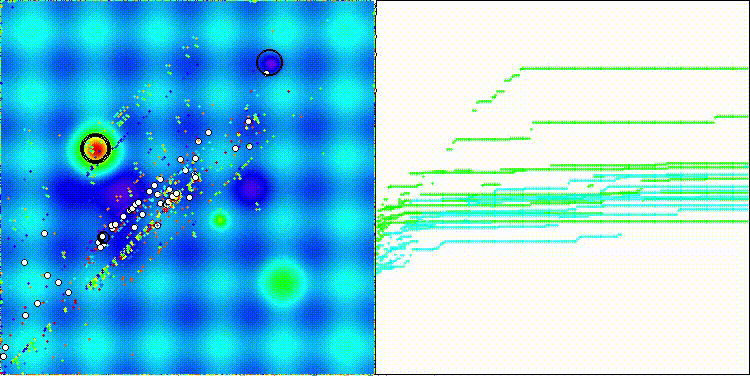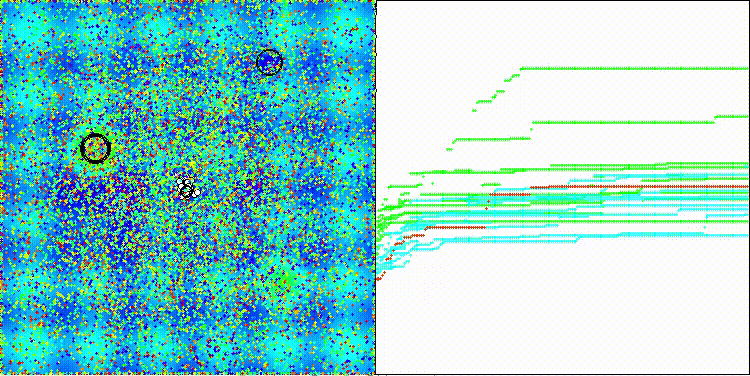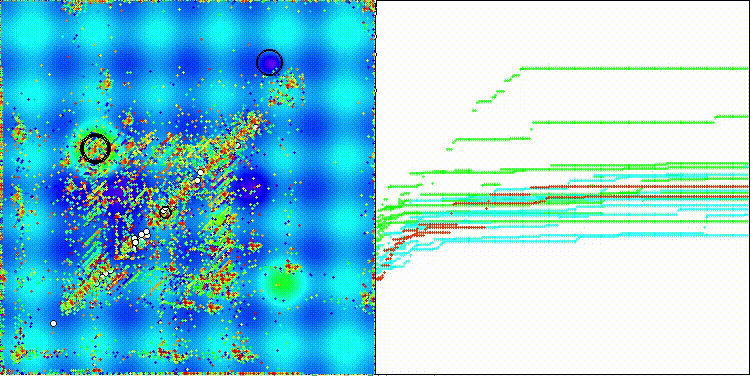
DOAm_dingo en la función de prueba Hilly
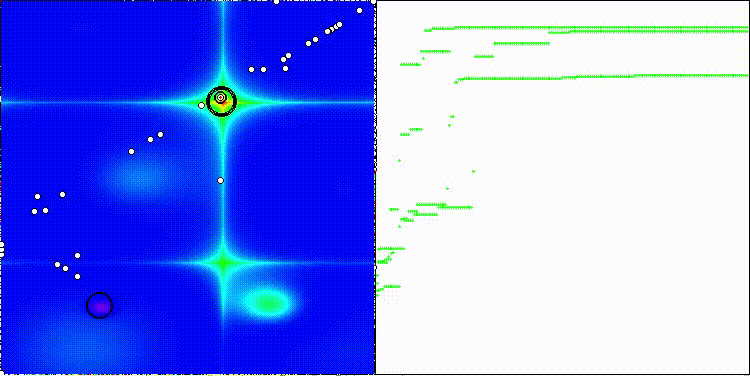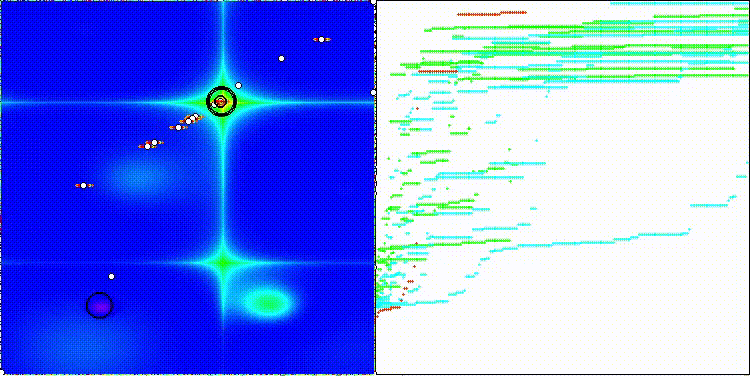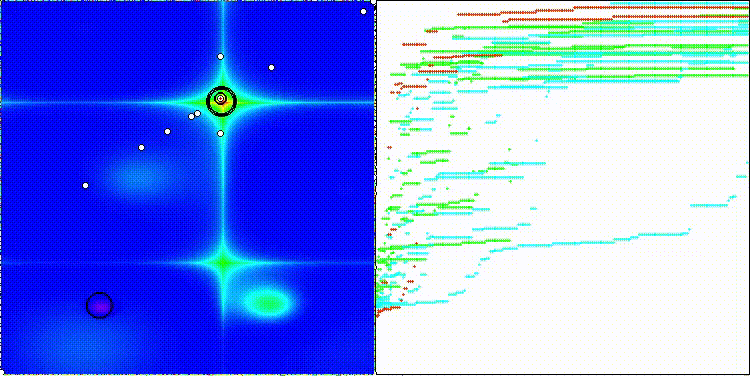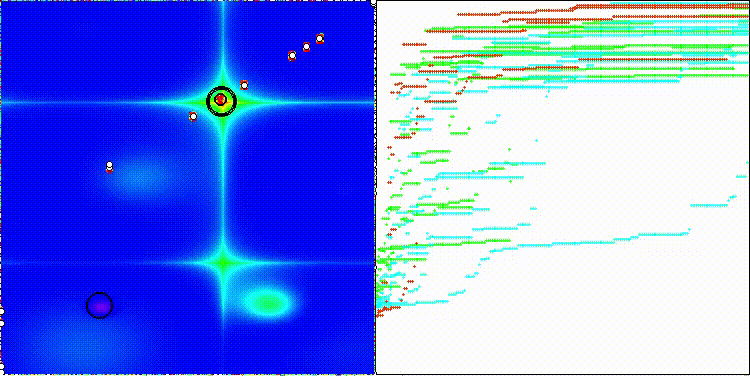
DOAm_dingo en la función de prueba Forest
DOAm_dingo en la función de prueba Megacity
Según los resultados de las pruebas, el algoritmo DOAm_dingo ocupa el primer puesto en nuestra tabla de clasificación de métodos de optimización poblacional.
| N.º | AO | Descripción | Hilly | Hilly Final | Forest | Forest Final | Megacity (discreta) | Megacity Final | Final Resultado | % del MÁX. | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | DOAm_dingo | dingo_optimization_algorithm_M | 0,47968 | 0,45367 | 0,46369 | 1,39704 | 0,94145 | 0,87909 | 0,91454 | 2,73508 | 0,78615 | 0,86061 | 0,84805 | 2,49481 | 6.627 | 73,63 |
| 1 | ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 2 | CLA | code lock algorithm (CLA) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| 3 | AMOm | animal migration optimization | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 5 | CTA | comet tail algorithm (CTA) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| 6 | TETA | time evolution travel algorithm | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| 7 | SDSm | stochastic diffusion search (SDS) | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 8 | BOAm | billiards optimization algorithm (BOA) | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5.598 | 62,19 |
| 9 | AAm | archery algorithm (AA) | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| 10 | ESG | evolution of social groups (ESG) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5.529 | 61,44 |
| 11 | SIA | simulated isotropic annealing (SIA) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 12 | EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| 13 | BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 14 | ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 15 | DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 16 | BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 17 | ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 18 | RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 19 | AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 20 | TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 21 | BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4,959 | 55,10 |
| 22 | DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 23 | SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 24 | CRO | chemical reaction optimisation | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| 25 | BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 26 | DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4.825 | 53,62 |
| 27 | BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1,12012 | 4,809 | 53,44 |
| 28 | DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4.762 | 52,91 |
| 29 | HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 30 | SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 31 | BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| 32 | ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 33 | (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| 34 | FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 35 | TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| 36 | BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 37 | WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 38 | AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| 39 | AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 40 | CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 41 | ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 42 | CMAES | covariance_matrix_adaptation_evolution_strategy | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| 43 | DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| 44 | BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| RW | random walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26,09 | |
Conclusiones
La modificación del algoritmo DOA_dingo que se ha analizado destaca por su gran capacidad de búsqueda. Sin embargo, hay que tener en cuenta que estos impresionantes resultados son valores medios obtenidos en una serie de ensayos. Esto significa que, para garantizar una exploración suficiente del espacio de búsqueda, el usuario tendrá que realizar la optimización varias veces.
A pesar de sus ventajas, el algoritmo presenta una velocidad de convergencia bastante modesta en funciones suaves. No obstante, DOA_dingo es un método muy útil y prometedor. Yo recomendaría utilizarlo en la fase inicial de la búsqueda, para luego pasar a algoritmos más precisos. Asimismo, es de vital importancia normalizar previamente todos los parámetros a un mismo rango de valores.
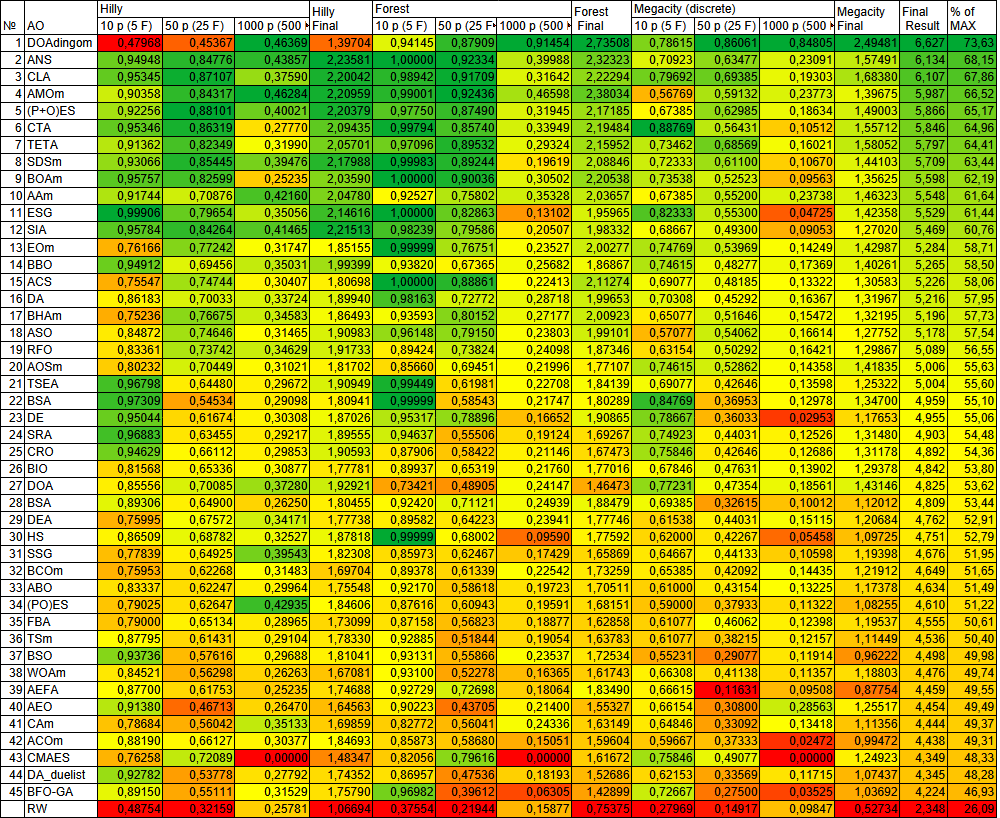
Figura 2. Escala de colores de los algoritmos según las pruebas correspondientes
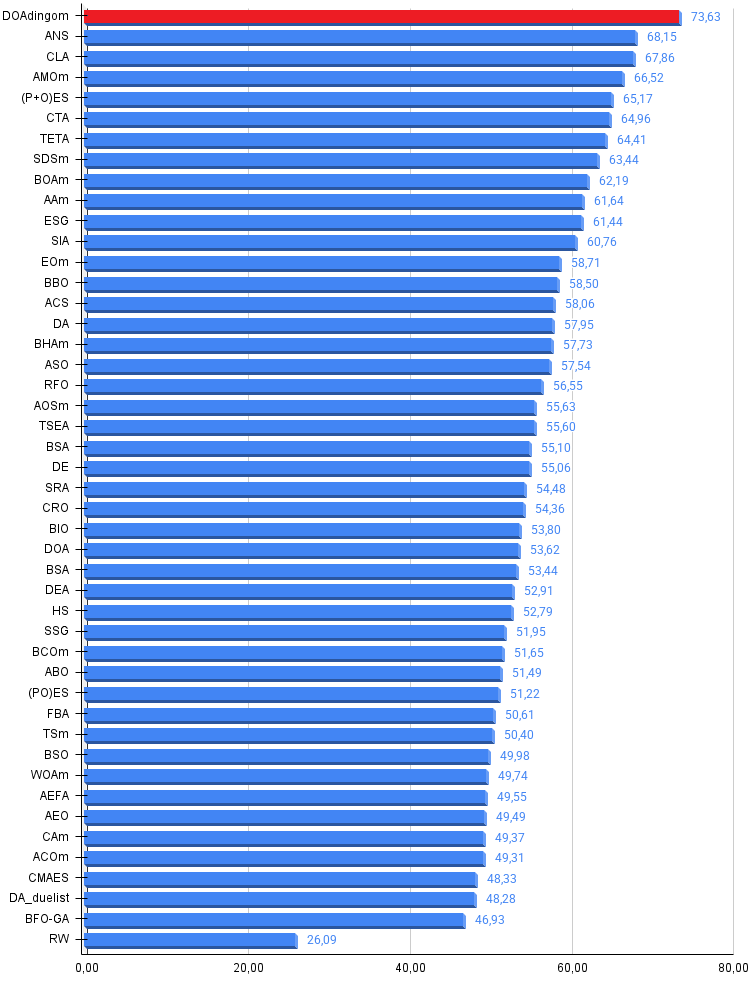
Figura 3. Histograma de los resultados de las pruebas de los algoritmos (en una escala de 0 a 100; cuanto mayor sea el valor, mejor, donde 100 es el resultado teórico máximo posible; en el archivo se incluye el script para calcular la tabla de clasificación)
Ventajas e inconvenientes del algoritmo DOAm_dingo:
Ventajas:
- Es rápido.
- Resultados medios muy elevados.
Desventajas:
- Gran variabilidad en los resultados.
- Tendencia a atascarse.
Se adjunta al artículo un archivo comprimido con las versiones actualizadas de los códigos de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos, ya que en muchos de ellos se han introducido modificaciones para mejorar las capacidades de búsqueda. Las conclusiones y consideraciones que figuran en los artículos se basan en los resultados de los experimentos realizados.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase padre de los algoritmos de optimización poblacional |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de algoritmos de optimización poblacional |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados destinados a la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | Banco de pruebas unificado para todos los algoritmos de optimización poblacional |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Ejemplo sencillo de uso de algoritmos de optimización poblacional sin visualización |
| 9 | Test_AO_DOAm_dingo.mq5 | Script | Banco de pruebas para DOAm_dingo |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19187
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Creación de sistemas de trading basados en IA en MQL5 (Parte 2): Desarrollo de un programa integrado con ChatGPT y con interfaz de usuario
 Desarrollo de estrategias de trading con los osciladores Parafrac y Parafrac V2: análisis del rendimiento de una única entrada
 Automatización del indicador del sentimiento del mercado
 Desarrollo de un sistema de ruptura basado en la volatilidad

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Se ha publicado el artículo «Modificación del algoritmo de optimización Dingo — Dingo Optimization Algorithm M (DOAm)»:
Autor: Andrey Dik