

Neuronale Netze im Trading: Zerlegen statt Skalieren (Fazit)
 18
 0

Einleitung
Die heutigen Finanzmärkte sind nicht nur ein Ort, an dem Käufer und Verkäufer aufeinandertreffen, sondern ein komplexes, dynamisches Ökosystem, in dem jeder Kurstick das Ergebnis des augenblicklichen Zusammenspiels von Hunderten Faktoren ist. Hier gibt es keinen Platz für Zufall im üblichen Sinne des Wortes: Hinter dem scheinbaren Chaos verbergen sich Muster, wenn auch in komplexen, vielschichtigen Formen. Gerade die Fähigkeit, diese verborgenen Muster zu erkennen und ihre Entwicklung vorauszusehen, entscheidet über den Erfolg eines Traders oder eines algorithmischen Systems. In früheren Artikeln haben wir uns mit dem SSCNN-Framework (Spatial-Sequential Convolutional Neural Network) vertraut gemacht. Hinter dieser Bezeichnung – die auf den ersten Blick vielleicht etwas sperrig wirkt – verbirgt sich ein sehr schlüssiges und elegantes Konzept, das räumliche und zeitliche Abhängigkeiten in einem einzigen Rechenalgorithmus vereint.
Das SSCNN basiert auf der Vorstellung, dass eine Zeitreihe eine zeitlich entfaltete Darstellung mehrdimensionaler Prozesse ist. Jeder Zeitpunkt ist nicht nur mit der Vergangenheit und der Zukunft verbunden, sondern auch mit parallelen Strukturen – internen Merkmalsräumen, die sich entweder synchron oder mit einer Verzögerung verändern.
Um diese Zusammenhänge zu erfassen, nutzt das Modell eine Kaskade von Blöcken, die lokale Muster extrahieren können, sowie Module zur sequenziellen Verarbeitung, die den Kontext beibehalten und akkumulieren. Die zentrale Komponente hierbei ist das Modul zur aufmerksamkeitsbasierten Normalisierung – eine Kombination aus Attention und Normalisierung, die es dem System ermöglicht, sich auf wirklich relevante Datensegmente zu konzentrieren und gleichzeitig den Lernprozess zu stabilisieren. Dank dieser Architektur ist das SSCNN nicht nur in der Lage, Signale auf verschiedenen Detailebenen zu analysieren, sondern auch, sich an veränderte Datenstrukturen anzupassen – was angesichts der stark schwankenden Volatilität und wechselnder Marktregime besonders für Finanzinstrumente wichtig ist.
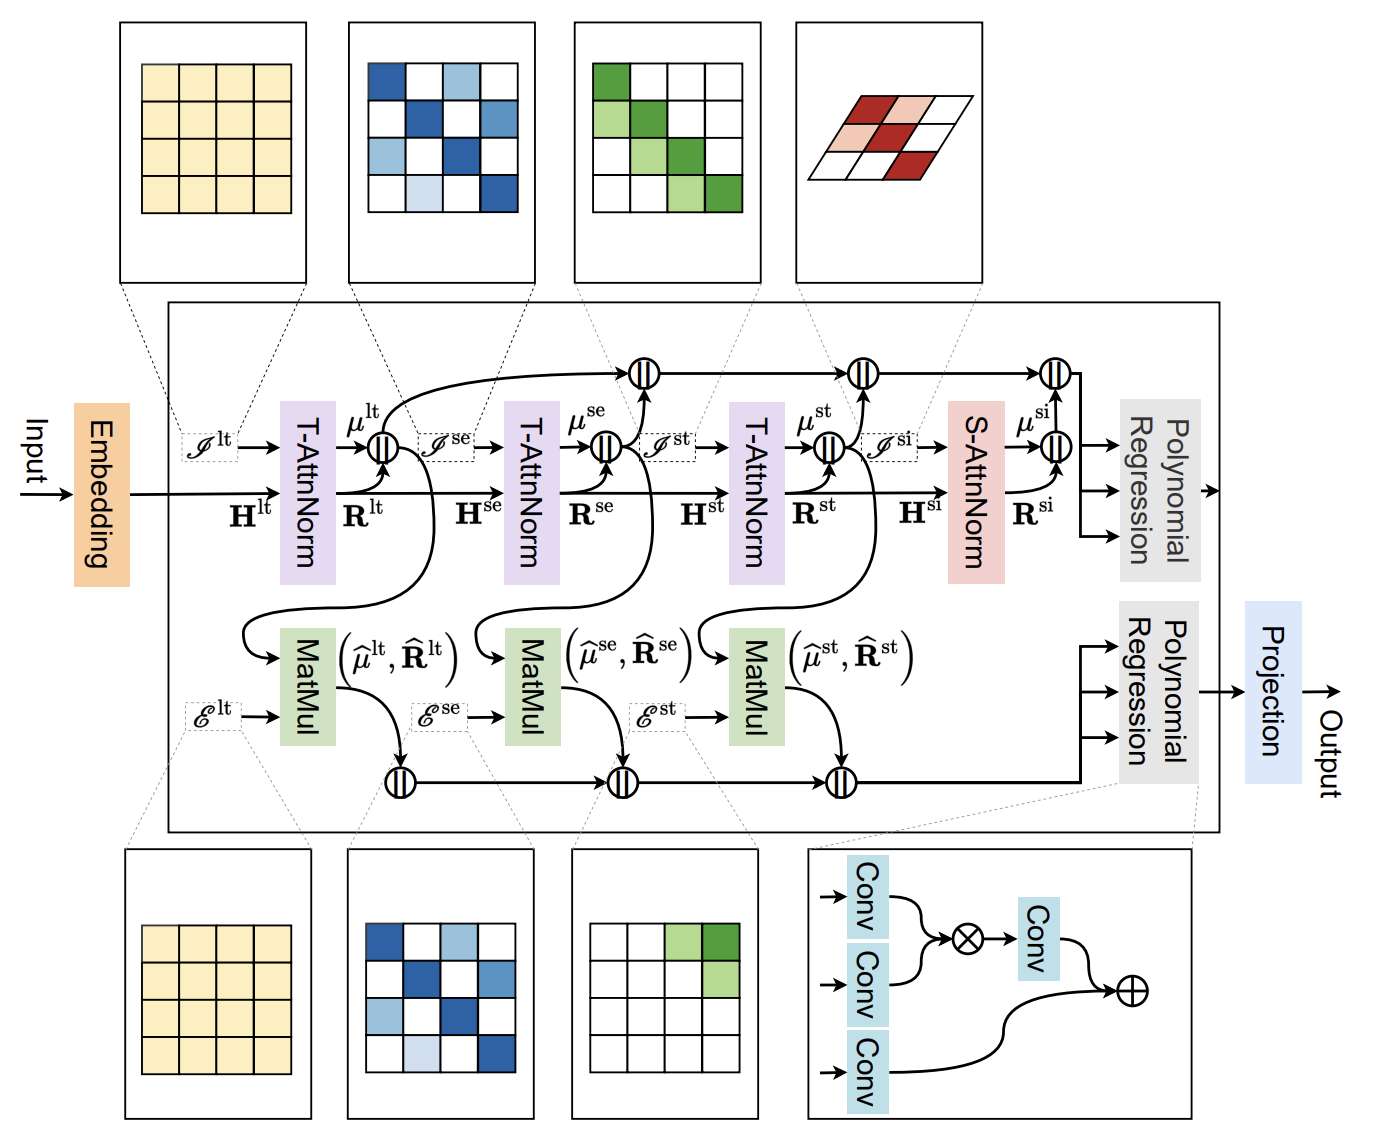
Ein weiterer wichtiger Vorteil ist die Modularität. Die SSCNN-Architektur ist leicht skalierbar und lässt sich auf eine bestimmte Aufgabe zuschneiden – sei es die Prognose des kurzfristigen Kursmomentums oder die Erkennung langfristiger Zyklen. Das Konzept der schichtweisen Datenwahrnehmung, bei dem jede Ebene des Modells ihre eigenen Merkmale extrahiert und diese an die nächste Ebene weiterleitet, sorgt für Flexibilität und Robustheit.
In früheren Artikeln haben wir ausführlich untersucht, wie diese Ideen in Code umgesetzt und in die MQL5-Umgebung integriert wurden, und damit den Grundstein für ein vollwertiges Handelssystem gelegt.
Nun nähern wir uns der letzten Phase, in der die Theorie auf die Praxis in ihrer anspruchsvollsten Form treffen muss. Wir werden die einzelnen Komponenten zu einer kohärenten Framework-Architektur zusammenführen und untersuchen, wie SSCNN Marktdaten verarbeitet und interpretiert. Wir werden die Wirksamkeit der implementierten Lösungen unter Bedingungen testen, die den realen Handelsbedingungen sehr nahe kommen. Dieser Schritt ist nicht nur wichtig, um die Prognosegenauigkeit oder die Stabilität des Modells zu messen, sondern auch, um zu verstehen, wie tiefgreifend seine Algorithmen den Markt erfassen, verborgene Strukturen erkennen und Kontextverschiebungen wahrnehmen. Schließlich hängt der Erfolg eines Handelssystems letztlich nicht von der Komplexität seiner Architektur ab, sondern davon, wie gut es mit Rauschen, unerwarteten Ausschlägen und tückischen Wendungen in den Charts umgeht.
Encoder
In früheren Artikeln haben wir die einzelnen Bausteine der SSCNN-Architektur entwickelt, und heute beginnen wir damit, diese zu einem einzigen Encoder zusammenzufassen – jenem Knotenpunkt, an dem eine Vielzahl von Informationsströmen (langfristige Trends, saisonale Muster, kurzfristige Schwankungen und räumliche Abhängigkeiten) sorgfältig zerlegt, geordnet, auf einen festgelegten Prognosehorizont projiziert und anschließend zu einer einheitlichen Prognosedarstellung zusammengeführt werden.
Die Klasse CNeuronSSCNNEncoder setzt diese Idee in Code um. Ihre Aufgabe besteht nicht lediglich darin, eine Reihe von Modulen nacheinander aufzurufen, sondern deren Betrieb zu synchronisieren: jede Komponente entsprechend ihrer eigenen Logik zu isolieren, sie auf den erforderlichen Prognosehorizont zu extrapolieren, die entsprechenden Statistiken zu prognostizieren und erst dann all dies zu einer reichhaltigen, strukturierten Darstellung für die abschließende polynomielle Regression zusammenzufügen. Der Encoder verwaltet Datenströme, organisiert bei Bedarf Transpositionen für einen korrekten phasenbasierten Betrieb und stellt sicher, dass jedes Ergebnis aus einem separaten Teilsystem an der richtigen Konkatenationsposition im erforderlichen Format landet. Die Klassenstruktur ist unten dargestellt.
class CNeuronSSCNNEncoder   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronPeriodNorm       cLongNorm;
   CNeuronConvOCL          cLongExtrapolate;
   CNeuronTransposeOCL     cLongMeanSTDevTransp;
   CNeuronBaseOCL          cLongMeanExtrapolate;
   CNeuronTransposeVRCOCL  cSeasonTransp;
   CNeuronAttentNorm       cSeasonNorm;
   CNeuronTransposeVRCOCL  cUnSeasonTransp;
   CNeuronConvOCL          cSeasonExtrapolate;
   CNeuronConvOCL          cSeasonMeanExtrapolate;
   CNeuronAttentNorm       cShortNorm;
   CNeuronConvOCL          cShortExtrapolate;
   CNeuronConvOCL          cShortMeanExtrapolate;
   CNeuronSAttentNorm      cSpatialNorm;
   CNeuronConvOCL          cSpatialExtrapolate;
   CNeuronConvOCL          cSpatialMeanExtrapolate;
   CNeuronBaseOCL          cConcatenated;
   CNeuronTransposeOCL     cTranspose;
   CNeuronPolynomialRegression   cFusion;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNNEncoder(void) {};
                    ~CNeuronSSCNNEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNNEncoder; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { }
  };
Die Verarbeitungskette innerhalb des Encoders ist sorgfältig aufgebaut. Alle internen Objekte werden statisch deklariert, sodass der Konstruktor und der Destruktor der Klasse leer bleiben und der eigentliche Aufbau des Berechnungsgraphen zentral in der Methode Init erfolgt.
bool CNeuronSSCNNEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                               uint units_count, uint variables, uint forecast,
                               uint season_period, uint short_period,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count + forecast,
                                variables, optimization_type, batch))
      return false;
   activation = None;
Der Algorithmus der Methode beginnt mit der Initialisierung der übergeordneten Klasse CNeuronTransposeOCL, an die die grundlegenden Parameter der zu erstellenden Architektur übergeben werden. Dieser Aufruf richtet die allgemeine Infrastruktur ein: Allokation globaler Puffer, Festlegen der Tensorgrößen und Binden des OpenCL-Kontexts.
Beachten Sie, dass die Dimensionalität des Ergebnistensors als Summe aus der Länge der analysierten Sequenz und dem Prognosehorizont angegeben wird. Hier wird deutlich, dass wir am Modulausgang erwarten, die bereinigten Originaldaten und die gewünschte Prognose in einer einzigen, vergleichbaren Darstellung zu erhalten.
Unmittelbar nach der grundlegenden Initialisierung deaktivieren wir explizit die Aktivierungsfunktion für die aktuelle Schicht (activation = None), da der Encoder mit numerischen Darstellungen und Statistiken arbeitet.
Als Nächstes fahren wir mit der Initialisierung der internen Objekte fort. Der langfristige Zweig kommt zuerst – cLongNorm. Hier wird ein Modul zur periodenbasierten Normalisierung erstellt, das die stabile Komponente der Zeitreihe (den Trend) aufbereitet.
   int index = 0;
   if(!cLongNorm.Init(0, index, OpenCL, 1, units_count, iWindow, optimization, iBatch))
      return false;
Als Nächstes initialisieren wir cLongExtrapolate – einen Trend-Extrapolationsblock, der die Langfristkomponente bis zum Prognosehorizont erweitert.
   index++;
   if(!cLongExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
An dieser Stelle sei darauf hingewiesen, dass in der Implementierung des Autors die Matrix der trainierbaren Parameter E zur Datenextrapolation verwendet wird.
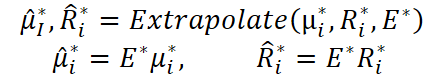
In unserer Implementierung haben wir uns jedoch dafür entschieden, eine Faltungsschicht ohne Aktivierungsfunktion zu verwenden, um diese Aufgabe zu erfüllen. Eine Faltungsschicht ohne Aktivierung ist ebenfalls ein linearer Operator, bietet jedoch zusätzliche technische Vorteile. Faltungen ermöglichen die gemeinsame Nutzung von Parametern (gemeinsam genutzte Gewichte), sind hardwareoptimiert und beschreiben auf natürliche Weise lokale und quasi-lokale Transformationen, wie sie häufig in Zeitreihen vorkommen.
Nachdem wir nun die Residuen der Langfristkomponente extrapoliert haben, ist es an der Zeit, die Mittelwerte selbst zu extrapolieren. Ein praktisches Detail ist, dass CNeuronPeriodNorm einen Tensor zurückgibt, in dem die Werte paarweise gespeichert sind – Mittelwert und Varianz. Anstatt eine explizite Dekonkatenation durchzuführen und Daten zu kopieren, haben wir einen eleganten Trick verwendet: den Tensor einfach zu transponieren.
Bei der Transposition werden die Daten so neu angeordnet, dass die Pipeline nacheinander separate Sequenzen aller Mittelwerte und aller Varianzen bildet, wobei die Sequenz der Mittelwerte an erster Stelle steht. Dadurch ist es möglich, den transponierten Tensor direkt an das Modul zur Extrapolation der Mittelwerte zu übergeben. Im Wesentlichen nutzen wir die Reihenfolge, in der die Elemente im Speicher abgelegt sind, um mit minimalem Aufwand logisch voneinander getrennte Datenströme zu erhalten.
   index++;
   if(!cLongMeanSTDevTransp.Init(0, index, OpenCL, iWindow, 2, optimization, iBatch))
      return false;
   if(!cLongMeanSTDevTransp.getGradient().Fill(0))
      return false;
   index++;
   if(!cLongMeanExtrapolate.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cLongExtrapolate.SetActivationFunction(None);
   if(!cLongMeanExtrapolate.getPrevOutput().Fill(1))
      return false;
Es gibt jedoch noch zwei weitere konkrete, aber wichtige Punkte, um die man sich im Voraus kümmern sollte. Zunächst geht es um den Schutz vor Verunreinigung der Varianzgradienten. Da unser Extrapolationsmodul ausschließlich mit Mittelwerten arbeitet, müssen wir sicherstellen, dass keine zufälligen Werte – die die anschließende Backpropagation verfälschen könnten – in den Gradientenspeicher für die Varianzen gelangen. In der Praxis wird dies bei der Initialisierung einfach und zuverlässig gehandhabt: Der Gradientenpuffer des Transponierobjekts wird auf Null gesetzt. Dadurch werden jede im Speicher verbliebene statische Reste explizit gelöscht, und es wird verhindert, dass unerwünschte Werte σ² beeinflussen.
Der zweite Punkt betrifft die Extrapolation der Mittelwerte selbst. In der ursprünglichen Formulierung füllen die Autoren den Tensor einfach mit den erhaltenen Werten. Wir hingegen haben einen technisch effizienteren Weg eingeschlagen: Um den erforderlichen gefüllten Tensor zu erhalten, verwenden wir das äußere Produkt in seiner einfachsten Form. Man nehme einen Spaltenvektor der Mittelwerte µ der Größe N×1 und multipliziere ihn mit einem Zeilenvektor aus Einsen der Größe 1×M. Das Ergebnis ist eine N×M-Matrix, wobei jede Zeile eine Kopie des entsprechenden µi ist. Damit erfolgt das Kopieren der Werte in einen Tensor der gewünschten Größe ohne explizite Schleifen. Die praktischen Vorteile dieses Ansatzes liegen auf der Hand: Es handelt sich um eine lineare Operation, die sich leicht auf einer GPU parallelisieren lässt, speichereffizient ist und sich problemlos in OpenCL umsetzen lässt.
Dadurch erhalten wir mit minimalem Codeaufwand und geringem Overhead einen übersichtlichen, einfachen und effizient umsetzbaren Mechanismus zur Extrapolation von Mittelwerten. Es bewahrt die Semantik des ursprünglichen Entwurfs des Autors (eine lineare Projektion über die Zeit), macht ihn jedoch schlanker und gut geeignet für parallele Berechnungen in OpenCL.
Als Nächstes folgt der saisonale Zweig. Zunächst konfiguriert das Objekt cSeasonTransp die Transposition nach Zyklen: Wir gruppieren die Daten anhand des Parameters season_period nach den Phasen eines einzelnen Zyklus. Dies vereinfacht den anschließenden Vorgang der Auswahl übereinstimmender Phasen und ermöglicht die Verwendung eines universellen Normalisierungsmoduls mit Attention-Koeffizienten, CNeuronAttentNorm.
   index++;
   if(!cSeasonTransp.Init(0, index, OpenCL, iWindow, units_count / season_period, season_period,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cSeasonNorm.Init(0, index, OpenCL, season_period, cSeasonTransp.GetCount(), iWindow,
                                                                          optimization, iBatch))
      return false;
   index++;
   if(!cUnSeasonTransp.Init(0, index, OpenCL, iWindow, season_period, cSeasonTransp.GetCount(),
                                                                          optimization, iBatch))
      return false;
Das Objekt cSeasonNorm extrahiert die saisonale Komponente und normalisiert die Residuen, während cUnSeasonTransp die Daten vor der Extrapolation wieder in ihre ursprüngliche Ausrichtung zurückbringt. Die Extrapolation der saisonalen Komponenten erfolgt direkt durch die Objekte cSeasonExtrapolate und cSeasonMeanExtrapolate.
   index++;
   if(!cSeasonExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSeasonMeanExtrapolate.Init(0, index, OpenCL, season_period, season_period, iCount, iWindow, 1,
                                                                                optimization, iBatch))
      return false;
   cSeasonMeanExtrapolate.SetActivationFunction(None);
Der kurzfristige Zweig wird durch einen ähnlichen Satz von Modulen definiert, jedoch ohne Transponierung der Daten. Das Objekt cShortNorm extrahiert lokale, schnelle Effekte über das Fenster short_period; cShortExtrapolate erstellt deren Prognose; und cShortMeanExtrapolate erstellt eine Prognose der Statistiken der Kurzfrist-Schicht. Beachten Sie, dass wir in den Initialisierungsparametern des Objekts zur Mittelwert-Extrapolation cShortNorm.GetUnits() verwenden, um die Formate anzugleichen – dadurch wird sichergestellt, dass nachfolgende Blöcke die Ausgaben des Normalisierers korrekt als Eingaben akzeptieren.
   index++;
   if(!cShortNorm.Init(0, index, OpenCL, units_count / short_period, short_period, iWindow, optimization, iBatch))
      return false;
   index++;
   if(!cShortExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1, optimization, iBatch))
      return false;
   cShortExtrapolate.SetActivationFunction(None);
   index++;
   if(!cShortMeanExtrapolate.Init(0, index, OpenCL, cShortNorm.GetUnits(), cShortNorm.GetUnits(), iCount, iWindow,
                                                                                          1, optimization, iBatch))
      return false;
   cShortMeanExtrapolate.SetActivationFunction(None);
   index++;
Als Nächstes wird der räumliche Zweig initialisiert: cSpatialNorm ist ein S-AttnNorm-Modul, das räumlich kohärente Muster zwischen den univariaten Sequenzen einzelner Merkmale identifiziert.
   if(!cSpatialNorm.Init(0, index, OpenCL, units_count, variables, optimization, iBatch))
      return false;
   index++;
   if(!cSpatialExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, iWindow, 1,
                                                                             optimization, iBatch))
      return false;
   cSpatialExtrapolate.SetActivationFunction(None);
   index++;
   if(!cSpatialMeanExtrapolate.Init(0, index, OpenCL, units_count, units_count, iCount, 1, iWindow,
                                                                             optimization, iBatch))
      return false;
   cSpatialMeanExtrapolate.SetActivationFunction(None);
   index++;
Darauf folgen die Objekte cSpatialExtrapolate und cSpatialMeanExtrapolate, die die räumliche Komponente und deren Statistiken für einen festgelegten Prognosehorizont prognostizieren.
Alle Prognosekomponenten und ihre Statistiken werden anschließend zu einem einzigen Tensor, cConcatenated, zusammengefasst. Hier multiplizieren wir die Tensordimension ausdrücklich mit acht, da die Ausgabe jedes Zweigs ein Paar aus Komponentenwert und Statistik (Rlt, μlt, Rse, μse, Rst, μst, Rsi, μsi) bildet, also acht Informationsströme pro Einheit.
   if(!cConcatenated.Init(0, index, OpenCL, 8 * Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cTranspose.Init(0, index, OpenCL, 8 * iWindow, iCount, optimization, iBatch))
      return false;
Der daraus resultierende breite Tensor wird anschließend durch das Modul cTranspose transponiert, um die Daten in das von der abschließenden Fusionsschicht erwartete Format zu bringen.
Der letzte Initialisierungsschritt ist cFusion, unser Modul für den polynomiellen Regressor (Fusion), das als Eingabe einen kombinierten Merkmalssatz der Größe 8*iWindow erhält und für jeden Zeitschritt eine komprimierte, aber aussagekräftige Darstellung der Länge iWindow ausgibt. Genau hier wird das Schema zur Kombination multiplikativer und additiver Effekte zwischen den Komponenten implementiert.
   index++;
   if(!cFusion.Init(0, index, OpenCL, iCount, 8 * iWindow, iWindow, optimization, iBatch))
      return false;
//---
   return true;
  }
In jeder Phase überprüfen wir den Initialisierungsprozess des Objekts, und falls ein Fehler auftritt, gibt die Methode false zurück. Diese defensive Programmierung ermöglicht es, den Aufbau des Encoders sofort abzubrechen, sobald ein Problem auftritt. Wenn alle Module erfolgreich erstellt und konfiguriert wurden, gibt die Methode true zurück; dies zeigt an, dass der Encoder betriebsbereit ist.
Nach der Initialisierung der Objektstruktur fahren wir damit fort, den Vorwärtsdurchlauf des Encoders in der Methode feedForward zu organisieren, in der jedes Modul zum richtigen Zeitpunkt aufgerufen wird und die Steuerung an das nächste übergibt. Die Methode ist schrittweise aufgebaut und spiegelt die Logik der Verarbeitung von vier Komponenten wider: langfristig, saisonal, kurzfristig und räumlich; anschließend werden diese zu einem einzigen Merkmalsvektor kombiniert und an die polynomielle Fusionsstufe weitergeleitet. Das lässt sich im Code deutlich erkennen: Bei jedem Schritt rufen wir FeedForward für den entsprechenden Block auf, prüfen, ob der Vorgang erfolgreich war, und fahren fort – sollte an irgendeiner Stelle ein Fehler auftreten, gibt die Funktion false zurück und die Kette wird unterbrochen.
bool CNeuronSSCNNEncoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.FeedForward(NeuronOCL))
      return false;
   if(!cLongExtrapolate.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cLongMeanSTDevTransp.FeedForward(cLongNorm.GetMeanSTDevs()))
      return false;
   if(!MatMul(cLongMeanSTDevTransp.getOutput(), cLongMeanExtrapolate.getPrevOutput(),
              cLongMeanExtrapolate.getOutput(), 1, 1, iCount, iWindow, true))
      return false;
Zuerst wird der langfristige Zweig ausgeführt. Der Aufruf von cLongNorm.FeedForward berechnet die normalisierte langfristige Komponente der analysierten Daten – dies ist ein vorbereitender Schritt, der den Trend von lokalen Effekten trennt. Anschließend verwendet cLongExtrapolate.FeedForward das Normalisierungsergebnis und erstellt eine Prognose der Residuen der langfristigen Komponente für den gewünschten Prognosehorizont. An dieser Stelle ist zu beachten, dass das Modul bereits durch cLongNorm strukturierte Daten erhält.
Als Nächstes müssen die statistischen Werte – die Mittelwerte und Standardabweichungen – extrapoliert werden. Zu diesem Zweck wird zunächst der Statistik-Tensor cLongMeanSTDevTransp transponiert, um die Reihen der Mittelwerte getrennt von den Reihen der Varianzen zu gruppieren (die Transpositionstechnik haben wir bereits zuvor erläutert). Anschließend wird die Matrixmultiplikation durchgeführt. Hier projizieren wir im Wesentlichen die transponierten Statistiken mithilfe eines Zeilenvektors in das von uns benötigte Format. Diese Implementierung sorgt dafür, dass die Mittelwerte über den gesamten Prognosehorizont hinweg wie gewünscht repliziert werden, ohne dass unnötige Kopiervorgänge erforderlich sind.
Als Nächstes startet der saisonale Zweig. Zunächst transponiert cSeasonTransp die analysierten Daten entlang der Zyklusphasen – damit werden sie für die phasenorientierte Normalisierung vorbereitet.
//--- Season
   if(!cSeasonTransp.FeedForward(cLongNorm.AsObject()))
      return false;
   if(!cSeasonNorm.FeedForward(cSeasonTransp.AsObject()))
      return false;
   if(!cUnSeasonTransp.FeedForward(cSeasonNorm.AsObject()))
      return false;
   if(!cSeasonExtrapolate.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.FeedForward(cSeasonNorm.GetMeans()))
      return false;
Anschließend führt cSeasonNorm eine zyklusbasierte attention-basierte Normalisierung durch und ermittelt dabei relevante Phasenpositionen. Die inverse Transposition cUnSeasonTransp versetzt die Daten wieder in ihre ursprüngliche Form, sodass sie für die Extrapolation bereit sind. Anschließend erhält cSeasonExtrapolate die wiederhergestellten saisonalen Residuen und prognostiziert sie, während cSeasonMeanExtrapolate die Mittelwerte der vom Normalisierungsmodul erhaltenen saisonalen Komponenten extrapoliert.
Der kurzfristige Zweig folgt einem ähnlichen Ablauf:
- cShortNorm verarbeitet bereits saisonal bereinigte Daten und identifiziert lokale, schnelle Effekte;
- cShortExtrapolate prognostiziert diese kurzfristigen Residuen;
- cShortMeanExtrapolate erzeugt Prognosen für deren statistische Kennzahlen.
//--- Short
   if(!cShortNorm.FeedForward(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.FeedForward(cShortNorm.GetMeans()))
      return false;
Beachten Sie, dass die Weitergabe von Daten vom saisonalen Zweig für den kurzfristigen Zweig eine bewusste Entscheidung ist: Zuerst werden die großen Zyklen entfernt, anschließend werden lokale Ausschläge erfasst.
Als Nächstes folgt der räumliche Zweig. Das Modul cSpatialNorm analysiert Mengen von Zeitreihen innerhalb eines Zeitschnitts und identifiziert räumlich kohärente Strukturen. Anschließend prognostizieren cSpatialExtrapolate und cSpatialMeanExtrapolate die räumlichen Residuen bzw. deren statistische Kennzahlen.
//--- Spatial
   if(!cSpatialNorm.FeedForward(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.FeedForward(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.FeedForward(cSpatialNorm.GetMeans()))
      return false;
Diese Vorgehensweise stellt sicher, dass die räumliche Normalisierung lokale Effekte erfasst, die bereits um Trend und Saisonalität bereinigt wurden.
Sobald alle Zweige ihre Prognosen erstellt haben, beginnt die sorgfältige Zusammenstellung der Merkmale. Beim ersten Aufruf der Methode Concat werden die extrapolierten Residuen und Mittelwerte für den langfristige Zweig und den saisonalen Zweig in einem breiten Puffer zusammengeführt.
//--- Concat
   if(!Concat(cLongExtrapolate.getOutput(), cLongMeanExtrapolate.getOutput(),
              cSeasonExtrapolate.getOutput(), cSeasonMeanExtrapolate.getOutput(),
              cConcatenated.getOutput(), iCount, iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getOutput(), cShortExtrapolate.getOutput(),
              cShortMeanExtrapolate.getOutput(), cConcatenated.getPrevOutput(),
              4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!Concat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getOutput(),
              cSpatialMeanExtrapolate.getOutput(), cConcatenated.getOutput(),
              6 * iCount, iCount, iCount, iWindow))
      return false;
Anschließend fügt der zweite Aufruf von Concat die Daten des kurzfristigen Zweigs hinzu und erweitert damit den akkumulierten Tensor. Der dritte Aufruf der Konkatenationsmethode fügt dem Ergebnis die räumlichen Komponenten hinzu.
Schließlich folgt die Fusionsphase. Zunächst wandelt cTranspose den breiten Tensor der analysierten Daten in eine für einen polynomiellen Regressor geeignete Form um – dabei handelt es sich um eine Permutation der Merkmals- und Zeitschrittdimensionen, die die Datenstruktur für die anschließende Aggregation zweckmäßig aufbereitet. Das Modul cFusion führt dann die polynomielle Fusion selbst durch: eine Kombination aus additiven und multiplikativen Pfaden, die eine kompakte und dennoch aussagekräftige Darstellung der Prognose liefert.
//--- Fusion
   if(!cTranspose.FeedForward(cConcatenated.AsObject()))
      return false;
   if(!cFusion.FeedForward(cTranspose.AsObject()))
      return false;
//---
   return CNeuronTransposeOCL::feedForward(cFusion.AsObject());
  }
Der Algorithmus des Vorwärtsdurchlaufs endet mit einem Aufruf der gleichnamigen Methode in der übergeordneten Klasse CNeuronTransposeOCL, die den Ergebnistensor in eine Menge von Sequenzen mit jeweils einem Merkmal umwandelt, die für die Analyse durch die nachfolgenden neuronalen Schichten des Modells geeignet sind.
Bei jedem Schritt überprüft der Code das Ergebnis jeder Operation gründlich. Und das ist nicht nur eine Formalität, sondern eine bewusste Sicherheitsmaßnahme: Jede Ausnahme, jeder Fehler bei der Pufferzuweisung oder jedes ungültige Format führt sofort zum Abbruch der Ausführung, was die Fehlersuche erleichtert und sicherstellt, dass sich das Modell im Produktivbetrieb sicher verhält.
Aus architektonischer Sicht spiegelt die Reihenfolge der Aufrufe einen Bottom-up-Ansatz wider: Zunächst extrahieren und extrapolieren wir grobe, stabile Komponenten; anschließend bearbeiten wir eine Abfolge von Komponenten mit höherer Auflösung; danach untersuchen wir räumliche Beziehungen; und schließlich führen wir alles sorgfältig im Fusionsmodul zusammen. Dieser Ansatz vereinfacht die Fehlersuche, verleiht jedem Block eine eindeutige Semantik und ermöglicht eine schrittweise Qualitätsprüfung – vom Trend bis zu lokalen Ausschlägen.
Betrachten wir den Vorwärtsdurchlauf als ein Drehbuch, in dem wir die Darsteller nacheinander auf die Bühne bringen, dann ist calcInputGradients in diesem Zusammenhang der Moment nach der Aufführung, in dem wir die Requisiten sorgfältig abbauen, die Anmerkungen des Regisseurs einsammeln und das Fehlersignal an jedes Modul zurücksenden müssen, damit dieses sein Verhalten anpassen kann.
bool CNeuronSSCNNEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Im Hauptteil der Methode überprüfen wir sofort die Gültigkeit des Zeigers auf das Quelldatenobjekt NeuronOCL. Das ist ein einfacher, aber unverzichtbarer Schutzmechanismus: Ohne einen gültigen Zeiger weiß niemand, wohin die Gradienten zurückgegeben werden sollen, daher beenden wir den Vorgang im Fehlerfall ordnungsgemäß.
Als Nächstes folgt die Fusionsphase. Da der letzte Schritt im Vorwärtsdurchlauf die polynomielle Fusion und Transposition war, propagieren wir in umgekehrter Reihenfolge zunächst die Gradienten durch diese Module zurück.
//--- Fusion
   if(!CNeuronTransposeOCL::calcInputGradients(cFusion.AsObject()))
      return false;
   if(!cTranspose.CalcHiddenGradients(cFusion.AsObject()))
      return false;
   if(!cConcatenated.CalcHiddenGradients(cTranspose.AsObject()))
      return false;
Wir rufen die gleichnamige Methode in der übergeordneten Klasse CNeuronTransposeOCL auf, die den Fehler aus dem externen Kontext an das Modul des polynomiellen Regressors weiterleitet. Als Nächstes leiten wir die Gradienten nach unten an das Transpositionsobjekt cTranspose weiter. Abschließend übergeben wir die ermittelten Werte an das breite Tensorobjekt cConcatenated, das die konkatenierten Ergebnisse aller Komponenten enthält.
Als Nächstes müssen wir den Beitrag jeder Komponente nacheinander entpacken, indem wir Schritt für Schritt eine Dekonkatenation (DeConcat) durchführen und den gemeinsamen Gradienten in seine Bestandteile zerlegen.
//--- DeConcat
   if(!DeConcat(cConcatenated.getPrevOutput(), cSpatialExtrapolate.getGradient(),
                cSpatialMeanExtrapolate.getGradient(), cConcatenated.getGradient(),
                6 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cConcatenated.getGradient(), cShortExtrapolate.getGradient(),
                cShortMeanExtrapolate.getGradient(), cConcatenated.getPrevOutput(),
                4 * iCount, iCount, iCount, iWindow))
      return false;
   if(!DeConcat(cLongExtrapolate.getGradient(), cLongMeanExtrapolate.getGradient(),
                cSeasonExtrapolate.getGradient(), cSeasonMeanExtrapolate.getGradient(),
                cConcatenated.getGradient(), iCount, iCount, iCount, iCount, iWindow))
      return false;
Zunächst extrahieren wir die Gradienten für den räumlichen Zweig (cSpatialExtrapolate und cSpatialMeanExtrapolate) aus cConcatenated. Die nächsten beiden Aufrufe der Methode DeConcat zerlegen die Gradienten für die Kurzfrist-, Saisonalitäts- und Langfrist-Komponenten. Im Wesentlichen wird ein einziger breiter Puffer auf die Empfänger verteilt: Jedes Modul erhält genau den Teil des Gradienten, den es während des Vorwärtsdurchlaufs erzeugt hat.
Nun beginnt die sequenzielle Backpropagation der Gradienten entlang der Zweige in der logischen Reihenfolge, die ihrer Konstruktionsreihenfolge entgegengesetzt ist. Für den räumlichen Zweig leiten wir zunächst die Gradienten der Statistiken weiter – dadurch wird der Fehler von dem Block, der die Mittelwerte der räumlichen Komponente vorhergesagt hat, auf das für diese Mittelwerte zuständige Normalisierungsmodul übertragen.
//--- Spatial
   if(!cSpatialNorm.GetMeans().CalcHiddenGradients(cSpatialMeanExtrapolate.AsObject()))
      return false;
   if(!cSpatialNorm.CalcHiddenGradients(cSpatialExtrapolate.AsObject()))
      return false;
Anschließend berechnet die Methode cSpatialNorm.CalcHiddenGradients den Gradienten aus dem Spatial-Hauptzweig und bereitet ihn für die Weiterleitung nach unten vor.
Der kurzfristige Zweig erfordert besondere Aufmerksamkeit: Zunächst übergibt cShortNorm.CalcHiddenGradients den Gradienten der räumlichen Normalisierung an den Normalisierer für Kurzfrist-Effekte.
//--- Short
   if(!cShortNorm.CalcHiddenGradients(cSpatialNorm.AsObject()))
      return false;
   CBufferFloat* temp = cShortNorm.getGradient();
   if(!cShortNorm.SetGradient(cShortNorm.getPrevOutput(), false) ||
      !cShortNorm.CalcHiddenGradients(cShortExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cShortNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cShortNorm.SetGradient(temp, false))
      return false;
   if(!cShortNorm.GetMeans().CalcHiddenGradients(cShortMeanExtrapolate.AsObject()))
      return false;
Als Nächstes müssen wir die Fehlersignale aus dem Datenextrapolationsobjekt ermitteln. Um zu vermeiden, dass die zuvor ermittelten Werte verloren gehen, speichern wir den aktuellen Zeiger auf den Puffer der Fehlersignale in der lokalen Variablen temp. Als Nächstes folgt eine clevere Technik: Wir ersetzen vorübergehend den aktuellen Zeiger des Normalisierers auf die Gradientenpuffer durch einen freien Gradientenpuffer derselben Größe. Anschließend berechnen wir die Gradienten in Bezug auf das Extrapolationsmodul. Anschließend summieren wir die Werte der beiden Informationsströme und stellen die Zeiger auf die Datenpuffer in ihrem ursprünglichen Zustand wieder her. Am Ende des Blocks zur Verteilung der Fehlersignale für die Kurzfrist-Komponente leiten wir den Fehler aus dem Mittelwert-Vorhersageblock des kurzfristigen Zweigs an den Pfad zurück, der diese Mittelwerte erzeugt hat.
Der saisonale Zweig wird nach einem ähnlichen Verfahren verarbeitet, jedoch mit einer zusätzlichen Transposition.
//--- Season
   if(!cUnSeasonTransp.CalcHiddenGradients(cShortNorm.AsObject()))
      return false;
   temp = cUnSeasonTransp.getGradient();
   if(!cUnSeasonTransp.SetGradient(cUnSeasonTransp.getPrevOutput(), false) ||
      !cUnSeasonTransp.CalcHiddenGradients(cSeasonExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cUnSeasonTransp.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cUnSeasonTransp.SetGradient(temp, false))
      return false;
   if(!cSeasonNorm.GetMeans().CalcHiddenGradients(cSeasonMeanExtrapolate.AsObject()))
      return false;
   if(!cSeasonNorm.CalcHiddenGradients(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonTransp.CalcHiddenGradients(cSeasonNorm.AsObject()))
      return false;
Zunächst gibt cUnSeasonTransp.CalcHiddenGradients die Gradienten aus der Kurzfrist-Normalisierung an den Block für die inverse Transposition zurück. Auch hier wenden wir die Technik mit temporärem Puffer an: Wir speichern ihn in temp, schalten den Gradienten auf einen freien Puffer um, führen CalcHiddenGradients aus, akkumulieren das Ergebnis und schreiben es zurück in cUnSeasonTransp. Dadurch werden die korrekte Summierung der Beiträge und die Ausrichtung der Skalen gewährleistet.
Als Nächstes leiten wir die Fehler an den Seasonal-Normalizer weiter und machen die Transposition rückgängig – das heißt, wir kehren zu dem Format zurück, in dem die Daten vom Langfrist-Normalisierer eingegangen sind.
Der langfristige Zweig enthält den heikelsten Abschnitt – die Rückwärtsoperation für die Matrixmultiplikation über die Statistiken. In der Methode MatMulGrad führen wir die Rückwärtsoperation aus, die der Vektormultiplikation aus dem Vorwärtsdurchlauf entspricht: Sie berechnet den Fehlerbeitrag für den transponierten Puffer cLongMeanSTDevTransp ausgehend von cLongMeanExtrapolate. Genau genommen verteilen wir die Gradienten auf die Mittelwerte und berücksichtigen dabei die Replikationsstruktur, die wir bei der Extrapolation der Mittelwerte verwendet haben. Anschließend leitet es die resultierenden Gradienten an das Normalisierungsmodul weiter.
//--- Long
   if(!MatMulGrad(cLongMeanSTDevTransp.getOutput(), cLongMeanSTDevTransp.getGradient(),
                  cLongMeanExtrapolate.getPrevOutput(), cLongMeanExtrapolate.getGradient(),
                  cLongMeanExtrapolate.getGradient(), 1, 1, iCount, iWindow, true))
      return false;
   if(!cLongNorm.GetMeanSTDevs().CalcHiddenGradients(cLongMeanSTDevTransp.AsObject()))
      return false;
   if(!cLongNorm.CalcHiddenGradients(cSeasonTransp.AsObject()))
      return false;
   temp = cLongNorm.getGradient();
   if(!cLongNorm.SetGradient(cLongNorm.getPrevOutput(), false) ||
      !cLongNorm.CalcHiddenGradients(cLongExtrapolate.AsObject()) ||
      !SumAndNormilize(temp, cLongNorm.getGradient(), temp, iWindow, false, 0, 0, 0, 1) ||
      !cLongNorm.SetGradient(temp, false))
      return false;
Anschließend übergibt cLongNorm.CalcHiddenGradients die bei der Saisonalitäts-Transposition akkumulierten Gradienten zurück an den Langfrist-Normalisierer, und wir wenden erneut die Technik mit temporärem Puffer an. Dadurch wird sichergestellt, dass die Beiträge aus der Extrapolation des Residuums der Langfrist-Komponente und aus anderen abhängigen Modulen akkumuliert werden, ohne dass Zwischenergebnisse verloren gehen.
Schließlich leitet die abgeschlossene Backpropagation-Kette die Gradienten an die vorherige Schicht (NeuronOCL) weiter. Dies ist ein natürlicher Austrittspunkt für das Fehlersignal: Nach allen internen Neuberechnungen übergibt der Encoder einen korrekt gebildeten Beitrag an den vorherigen Knoten im Berechnungsgraphen.
//---
   if(!NeuronOCL.CalcHiddenGradients(cLongNorm.AsObject()))
      return false;
//---
   return true;
  }
Über die gesamte Methode hinweg werden alle Aufrufe durch Ergebnisprüfungen abgesichert. Hier geht es nicht nur um Zuverlässigkeit – es handelt sich um eine Fail-Fast-Strategie: Wir erkennen Probleme frühzeitig, um subtile Inkonsistenzen in Puffern zu vermeiden, die später nur schwer aufzuspüren wären. Wichtige Techniken, die in der gesamten Methode immer wieder vorkommen und besondere Beachtung verdienen:
- die Verwendung temporärer Datenpuffer zur Akkumulation von Teilgradienten,
- das Umschalten des aktiven Gradientenpuffers, um keine Daten zu verlieren,
- der Aufruf von SumAndNormilize, um die Beiträge über die Fensterdimension korrekt zu aggregieren.
Das Fazit: Die Methode folgt sorgfältig der umgekehrten Reihenfolge des Vorwärtsdurchlaufs, entpackt die konkatenierten Puffer, verteilt die Gradienten auf die Zweige, akkumuliert mehrere Beitragsquellen mithilfe temporärer Puffer und Normalisierung und leitet den Fehler schließlich an die darunterliegende Ebene weiter. Dieses Verfahren stellt sicher, dass jedes Modul genau den Gradienten erhält, den es hervorgerufen hat, und dass die Gesamtanpassung konsistent erfolgt und während des Trainings stabil konvergiert.
Sobald die Gradienten erfasst und sorgfältig auf alle Zweige des Encoders verteilt wurden, beginnt die letzte Phase – die eigentliche Aktualisierung der trainierbaren Parameter. In unserem Code läuft dies auf aufeinanderfolgende Aufrufe gleichnamiger Methoden in den internen Komponenten hinaus: Jedes Modul ist dafür zuständig, den akkumulierten Gradienten auf seine eigenen Gewichte anzuwenden.
bool CNeuronSSCNNEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
//--- Long
   if(!cLongNorm.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cLongExtrapolate.UpdateInputWeights(cLongNorm.AsObject()))
      return false;
//--- Season
   if(!cSeasonNorm.UpdateInputWeights(cSeasonTransp.AsObject()))
      return false;
   if(!cSeasonExtrapolate.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cSeasonMeanExtrapolate.UpdateInputWeights(cSeasonNorm.GetMeans()))
      return false;
//--- Short
   if(!cShortNorm.UpdateInputWeights(cUnSeasonTransp.AsObject()))
      return false;
   if(!cShortExtrapolate.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cShortMeanExtrapolate.UpdateInputWeights(cShortNorm.GetMeans()))
      return false;
//--- Spatial
   if(!cSpatialNorm.UpdateInputWeights(cShortNorm.AsObject()))
      return false;
   if(!cSpatialExtrapolate.UpdateInputWeights(cSpatialNorm.AsObject()))
      return false;
   if(!cSpatialMeanExtrapolate.UpdateInputWeights(cSpatialNorm.GetMeans()))
      return false;
//--- Fusion
   if(!cFusion.UpdateInputWeights(cTranspose.AsObject()))
      return false;
//---
   return true;
  }
Letztendlich ist die Methode updateInputWeights ein kompakter und zugleich leistungsstarker Dispatcher: Sie durchläuft einfach die Liste der Komponenten, überträgt jeder einzelnen die Verantwortung für die Aktualisierung ihrer eigenen Gewichte und erfasst sorgfältig die Ausführungsstatus. Dieser Ansatz bewahrt die Modularität, erleichtert das Testen und vereinfacht die Erweiterung der Architektur: Wenn neue trainierbare Komponenten hinzugefügt werden, reicht es aus, deren Aktualisierung an der entsprechenden Stelle in dieser Kette einzufügen.
Damit ist unsere ausführliche Erörterung der Logik hinter der Konstruktion des Encoders abgeschlossen. Der vollständige Quellcode für die Klasse CNeuronSSCNNEncoder und alle ihre Methoden ist im Anhang enthalten und kann als Referenz für die Implementierung oder Anpassung dienen.
Objekt der obersten Ebene
Das SSCNN-Framework wurde ursprünglich als Komposition aus einer Kette von Encodern konzipiert, von denen jeder die Analyse vertieft und den Abstraktionsgrad der Merkmale erhöht. In der Praxis ermöglicht dies, zunächst die offensichtlichen Komponenten (Trend, Saisonalität, lokale Spitzen) auszurichten und zu extrahieren und anschließend systematisch mit einer zunehmend reichhaltigen und komprimierten Darstellung zu arbeiten, um subtile Zusammenhänge zu erkennen. Gerade um diesen Ablauf zu steuern, führen wir das Objekt der obersten Ebene CNeuronSSCNN ein, das von CNeuronSCNN erbt.
Die Klasse fungiert als Dispatcher: Sie kapselt eine Abfolge von Encodern ein, organisiert den Fluss der Tensoren zwischen ihnen, übernimmt den Abgleich von Größe und Format und gewährleistet korrekte Vorwärts- und Rückwärtsdurchläufe durch die gesamte Kette.
class CNeuronSSCNN    :  public   CNeuronSCNN
  {
protected:
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSSCNN(void) {};
                    ~CNeuronSSCNN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period, uint layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSSCNN; }
  };
Es ist anzumerken, dass das Verhalten von CNeuronSSCNN vollständig der von seiner Elternklasse geerbten Logik entspricht: Wir erfinden keinen neuen Algorithmus, sondern legen lediglich explizit fest, welche Encoder in der neuen Konfiguration verwendet werden. Der Grund für die Neudefinition der Klasse ist rein pragmatischer Natur: Wir müssen einen bestimmten Encoder-Typ und dessen Parameter festlegen, um mehrere Ebenen nacheinander aufbauen zu können. In den neuen Methoden nehmen wir nur gezielte Änderungen vor: Wir tauschen die Typen und Formate der verwendeten Encoder aus, ohne die Rechenlogik selbst zu verändern. Daher ist es nicht erforderlich, die bereits behandelten Algorithmen im Detail zu untersuchen – ihre Umsetzung bleibt unverändert. Der vollständige Quellcode für die Klasse und alle ihre Methoden ist im Anhang verfügbar.
Training des Modells
Ein paar Worte zum Trainingsprozess des Modells. Wir verfolgen eine zweistufige Strategie: Zunächst erfolgt ein intensives Offline-Training, gefolgt von einer anschließenden Online-Feinabstimmung im Betriebsmodus. Um die Offline-Phase zu beschleunigen, haben wir die Darstellung des Umgebungszustands im Environment State Encoder bewusst vereinfacht und auf das Training der Hilfsprognosemodule verzichtet; dies führt zu einer erheblichen Verkürzung der Vorbereitungszeit, verringert jedoch die Aussagekraft der anfänglichen Repräsentation. Der Trainingsprozess wird in der Methode Train implementiert.
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
Zunächst berechnet die Methode den Start- und Endindex des Trainingsfensters und lädt anschließend historische Daten aus dem Terminal. Das ist die übliche Datenaufbereitung: Wir benötigen die Rohpreise und Zeitstempel, die als Grundlage für alle nachfolgenden Merkmale und Stichproben dienen.
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Der folgende Block prüft, ob die Größe der Indikatorpuffer erfolgreich angepasst wurde. Wenn mindestens ein Puffer nicht allokiert werden kann, geben wir eine Debug-Meldung aus und beenden den Expert Advisor ordnungsgemäß (ExpertRemove), damit er nicht in einem inkonsistenten Zustand weiterläuft.
Als Nächstes folgt die Schleife, die darauf wartet, dass die Indikatoren berechnet werden. Wir prüfen, ob die Indikatoren innerhalb einer begrenzten Anzahl von Iterationen berechnet wurden. Dies schützt vor Situationen, in denen die Daten noch nicht bereitstehen: Anstatt mit unvollständigen Daten zu beginnen, geben wir dem System etwas Zeit – aber nicht unbegrenzt. Wird der Grenzwert überschritten, geben wir eine Meldung aus und beenden den Betrieb.
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Anschließend aktualisieren wir die Indikatoren mithilfe der Methode Refresh und versetzen das Array Rates in den Series-Modus, damit der indexbasierte Zugriff bei historischen Daten in der üblichen Reihenfolge funktioniert. Anschließend passen wir die Anzahl der verfügbaren Bars an. Dabei wird berücksichtigt, dass wir für jedes Trainingsbeispiel die vorherigen HistoryBars-Werte sowie einen Puffer für den Prognosehorizont NForecast benötigen. Ist das Ergebnis kleiner als Null, deutet dies darauf hin, dass nicht genügend Daten vorliegen, und wir brechen den Vorgang ab.
Wir bereiten die Arbeitsvektoren sowie das Early-Stopping-Flag vor. Außerdem erfassen wir die aktuelle Uhrzeit; diese wird für regelmäßige UI-Aktualisierungen und zur Zeitüberwachung benötigt.
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
Die Haupttrainingsschleife läuft über Epochen (epoch). Der Vorgang läuft so lange, bis das Epochs-Limit erreicht ist, IsStopped ausgelöst wird (externer Stopp) oder das Stop-Flag aufgrund eines internen Fehlers gesetzt wird. Zu Beginn jeder Epoche löschen wir den internen Zustand im Encoder.
   for(int epoch = 0; (epoch < Epochs && !IsStopped() && !Stop); epoch ++)
     {
      if(!cEncoder.Clear())
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
Innerhalb einer Epoche läuft eine Schleife über die posit-Positionen und iteriert dabei von der Startgrenze in Richtung der Endgrenze. Für jede Position bereiten wir zunächst die Eingabedaten durch den Aufruf von CreateBuffers vor – dadurch werden die Puffer State und Time gebildet, die anschließend in das Netzwerk eingespeist werden. Als Nächstes bilden wir den Zustandsvektor des Kontos und generieren eine Referenzaktion.
for(int posit = start - HistoryBars - NForecast - 1; posit >= end; posit--)
  {
   if(!CreateBuffers(posit, GetPointer(bState), GetPointer(bTime), Result))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
   const vector<float> target_action = OraculAction(account, Result);
   if(!bAccount.AssignArray(account))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Wir nutzen hybrides Lernen – basierend auf Belohnungssignalen und einer Referenztrajektorie mit Look-ahead.
Als Nächstes folgt ein Vorwärtsdurchlauf. Zunächst erzeugt der Environment State Encoder eine Repräsentation des aktuellen Marktzustands.
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
Anschließend gibt der Actor die Aktion des Agenten aus. Der Critic bewertet die Qualität der Aktion im aktuellen Zustand.
   if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
Alle Aufrufe werden durch Überprüfungen abgesichert – tritt ein Fehler auf, brechen wir den Vorgang sofort ab und setzen das Stop-Flag.
Der Study-Block ist der zentrale Schritt bei einer belohnungsbasierten Aktualisierung. Wir ermitteln die Aktion des Agenten und berechnen die Belohnung. Ein interessantes Detail: Ist die Belohnung negativ, multiplizieren wir sie mit 2; mit anderen Worten: Wir erhöhen die Strafen für schlechte Entscheidungen. Diese Verstärkung beschleunigt das Lernen anhand von Fehlerbeispielen, erfordert jedoch Vorsicht: Eine zu aggressive Bestrafung kann das Training destabilisieren.
//--- Study
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(reward < 0)
   reward *= 2;
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true)
  )
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Als Nächstes führen wir einen sequenziellen Rückwärtsdurchlauf durch: zuerst den Critic, dann den Encoder und schließlich den Actor. Dies ist ein klassisches Actor-Critic-Schema: Der Critic wird auf Grundlage des Wertschätzungsfehlers aktualisiert, und anschließend wird das Signal an den Actor und den Encoder gesendet. Hier ist es wichtig, die Reihenfolge einzuhalten: Critic -> Encoder -> Actor, damit die Gradienten korrekt durch die gemeinsame Graphstruktur propagieren.
Als Nächstes folgt die Oracul-Phase – das Training anhand der Referenztrajektorie. Wir führen erneut einen Vorwärtsdurchlauf durch den Encoder und den Actor durch, da wir deren Parameter kurz zuvor aktualisiert haben, und das Ergebnis der Analyse desselben Umgebungszustands wird erwartungsgemäß anders ausfallen.
//--- Oracul
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Action.AssignArray(target_action))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
Anschließend ersetzen wir die Aktion des Agenten durch die Referenzaktion und berechnen die Belohnung dafür. Als Nächstes führen wir einen Rückwärtsdurchlauf für den Actor durch – das heißt, wir trainieren ihn darauf, die Referenz nachzuahmen.
if(!cActor.backProp(Action, GetPointer(cEncoder), LatentLayer))
   {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.feedForward(Action, 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
//---
if(GetTickCount() - ticks > 500)
  {
   double percent = (epoch + 1.0 - double(posit - end) / (start - end - HistoryBars - NForecast)) /
                                                                                    Epochs * 100.0;
   string str = "";
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                                    cActor.getRecentAverageError());
   str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                                   cCritic.getRecentAverageError());
   Comment(str);
   ticks = GetTickCount();
  }
 }
}
Als Nächstes führen wir Critic für die Referenzaktion aus und führen dabei Vorwärts- und Rückwärtsdurchläufe durch. Danach optimieren wir die Encoder-Parameter erneut. Daher lernen wir bei jedem Schritt zunächst aus unserer eigenen Erfahrung (Reinforcement) und passen die Policy anschließend in Richtung der Referenz an (Supervised). Dies führt oft zu einer stabileren und schnelleren Konvergenz.
Während der Schleife erzeugen wir etwa alle 500 ms eine Statuszeichenfolge, die den Fortschritt in Prozent und die aktuellen Fehler von Actor und Critic enthält. Dies ist ein wichtiger Mechanismus, um den Nutzer über den Trainingsfortschritt auf dem Laufenden zu halten.
Sobald alle Epochen abgeschlossen sind, löschen wir den Kommentar, geben die abschließenden Metriken im Terminal-Log aus und beenden das Programm anschließend ordnungsgemäß.
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor", cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic", cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
Der vollständige Quellcode für das Offline-Trainingsprogramm ist im Anhang enthalten. Dort finden Sie auch den Quellcode aller Programme, die bei der Erstellung dieses Artikels verwendet wurden, sowie die Architektur der trainierbaren Modelle, die nahezu unverändert aus der vorherigen Arbeit übernommen wurde. In der Encoder-Architektur haben wir lediglich den Typ der Hauptschicht des Encoders geändert.
Tests
Wie bereits erwähnt, besteht der Trainingsprozess aus zwei aufeinanderfolgenden Phasen. In der ersten Offline-Phase wurde das Modell anhand historischer Daten für das Währungspaar EURUSD im H1-Zeitrahmen für das gesamte Jahr 2024 trainiert. Dieser Zeitraum umfasste eine breite Palette von Marktszenarien – von ruhigen Phasen bis hin zu starken Kurssprüngen – und ermöglichte es dem Modell, sich sowohl mit typischen als auch mit seltenen Situationen vertraut zu machen.
In der zweiten Phase führten wir ein Online-Fine-Tuning unter Bedingungen durch, die den realen Marktbedingungen sehr nahe kamen. Das Training wurde im MetaTrader 5-Strategietester durchgeführt, wo das Modell einen Live-Datenstrom der Bars sequenziell verarbeitete. In diesem Modus zeigt sich die Robustheit gegenüber Rauschen und Verzerrungen, und er ermöglicht es, das Verhalten bei Änderungen des Marktkontexts anzupassen.
Schließlich haben wir das Modell anhand völlig neuer Daten getestet – Kursnotierungen für den Zeitraum von Januar bis März 2025. Alle Parameter und Einstellungen blieben unverändert. Die erzielten Ergebnisse vermitteln ein objektives Bild von der Genauigkeit und der praktischen Zuverlässigkeit des vorgeschlagenen Ansatzes. Die Testergebnisse sind im Folgenden aufgeführt.
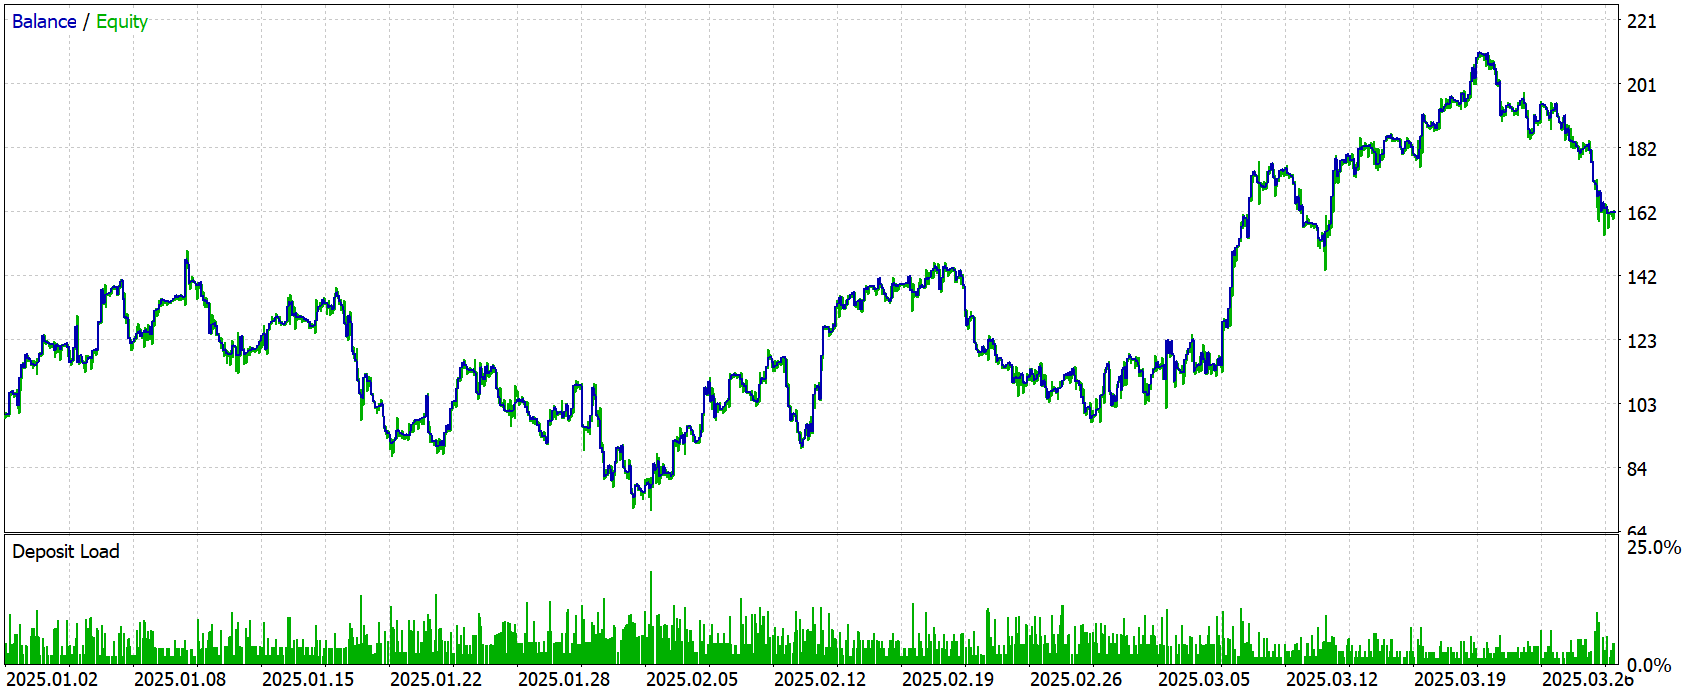
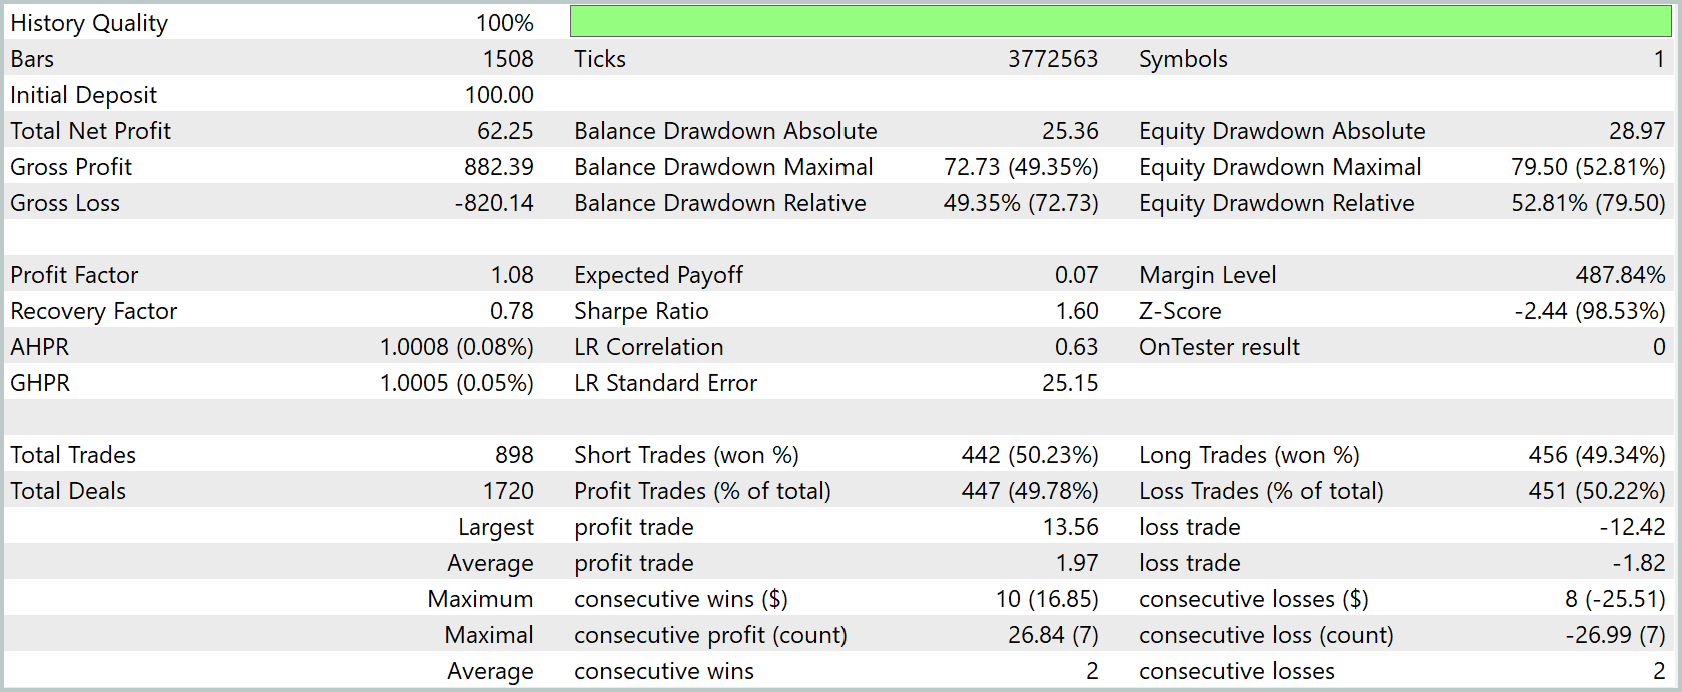
Die Testergebnisse zeigen eine mäßig positive Entwicklung. Ausgehend von einer Einzahlung von 100 US-Dollar erzielte der EA einen Gewinn von 62,25 US-Dollar, was eine geringfügige positive Differenz zwischen Gesamtgewinn und Gesamtverlust zeigt. Gleichzeitig liegt der Profitfaktor kaum über 1, was darauf hindeutet, dass die Strategie nicht besonders effektiv ist.
Während des Testzeitraums wurden 898 Trades ausgeführt, wobei Kauf- und Verkaufstrades nahezu gleichmäßig verteilt waren. In beiden Fällen lag die Trefferquote bei etwa 50 %, mit einer leichten Tendenz zu Short-Positionen. Der durchschnittliche profitable Trade brachte 1,97 US-Dollar ein, während der durchschnittliche Verlusttrade einen Verlust von 1,82 US-Dollar verursachte. Der maximale Gewinn belief sich auf 13,56 US-Dollar, während der maximale Verlust bei 12,42 US-Dollar lag.
Insgesamt zeigt der EA einen stabilen Betrieb und eine präzise Handelsausführung, doch die Rentabilität und Robustheit der Strategie bleiben fraglich.
Fazit
Dieser Artikel bildet den Abschluss der Arbeiten zur Umsetzung der von den Autoren des SSCNN-Frameworks vorgeschlagenen Ansätze unter Verwendung von MQL5. Dem Leser wurde das Konzept der räumlich-zeitlichen Merkmalsintegration vorgestellt, bei dem jeder Zeitpunkt die komplexen Wechselbeziehungen zwischen internen Datenstrukturen und externen Marktimpulsen widerspiegelt.
Dieses Modell erweitert nicht nur unser Verständnis des Marktverhaltens, sondern bietet auch ein Instrument zur Anpassung an Veränderungen der Marktregime – von ruhigen Phasen bis hin zu turbulenten Veränderungen der Volatilität. Die Implementierung der aufmerksamkeitsbasierten Normalisierung verstärkt die Fokussierung auf signifikante Bereiche und stabilisiert den Trainingsprozess, wodurch SSCNN zu einem flexiblen Analysemechanismus wird, der in der Lage ist, die strukturelle Komplexität finanzieller Zeitreihen aufzuschlüsseln.
Literaturverzeichnis
- Parsimony or Capability? Decomposition Delivers Both in Long-term Time Series Forecasting
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Aufbau eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19134
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Marktsimulation: Positionsanzeige (VI)
 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Fazit)
 Duellanten-Algorithmus
 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Encoder)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.