Redes neuronales en el trading: Entrenamiento de modelos de picos profundos (SEW-ResNet)
 18
 0

Introducción
Los mercados financieros son un escenario en el que se enfrentan los intereses de millones de participantes, y cada decisión se traduce en ganancias o pérdidas. En estas circunstancias, la capacidad de extraer rápidamente información de flujos de datos complejos se convierte en un factor decisivo para el éxito. En las últimas décadas, han sido precisamente las redes neuronales artificiales las que han alcanzado una posición de liderazgo en el ámbito del procesamiento de la información, demostrando su eficacia en los ámbitos más diversos, desde la visión artificial hasta la traducción automática de textos. Su éxito se debe al aprendizaje profundo: cuantas más capas tiene la arquitectura del modelo, más complejos y multifacéticos son los patrones que este puede captar y describir. En el mundo del trading, este principio se muestra de forma especialmente clara. Los modelos profundos son capaces de distinguir las más mínimas regularidades en el comportamiento de los precios y de distinguir el ruido a corto plazo de las tendencias estables.
No obstante, el desarrollo de los modelos de redes neuronales se ha topado con una paradoja. El aumento de la profundidad de la red, que se suponía que iba a reportar únicamente beneficios, provocó en un momento dado un efecto inesperado. En lugar de un aumento de la precisión, lo que obteníamos era un estancamiento y, en ocasiones, incluso un deterioro. La situación se asemejaba a un mecanismo sobrecargado, en el que los nuevos eslabones no facilitaban el funcionamiento, sino que provocaban fallos. La solución se encontró en el concepto de las conexiones residuales: el modelo no solo aprende a extraer nuevas características, sino también a corregir las ya encontradas, añadiéndoles pequeños ajustes. Esta idea se materializó en la arquitectura ResNet, que supuso un auténtico avance, ya que permitió crear modelos muy profundos sin perder calidad.
Sin embargo, paralelamente a las arquitecturas clásicas, ha surgido una corriente que atrae cada vez más la atención de investigadores y profesionales: las redes neuronales de picos. Su particularidad radica en que se asemejan más al funcionamiento del cerebro. A diferencia de los modelos a los que estamos acostumbrados, en estas redes la información se transmite mediante impulsos individuales, es decir, eventos. Para los mercados financieros, este enfoque resulta especialmente valioso, ya que también en ellos predomina la lógica basada en eventos: la publicación de un informe, una declaración del regulador, un repentino repunte de la actividad… Todos ellos son eventos clave ante los que el sistema debe reaccionar de forma inmediata. Además, los modelos de picos prometen una mayor eficiencia energética y la capacidad de procesar flujos de datos en tiempo real.
Sin embargo, a pesar de su impresionante verosimilitud biológica y de las nuevas perspectivas que ofrecían, los modelos de picos seguían siendo inferiores a las redes neuronales clásicas en una serie de tareas prácticas. Esto se ponía especialmente de manifiesto en conjuntos de datos complejos, en los que se requería una gran precisión y profundidad de análisis. En un momento dado, quedó claro que el camino hacia el progreso pasaba por integrar las ideas del aprendizaje profundo en la arquitectura de los modelos de picos. Así surgieron los primeros intentos de adaptar ResNet al formato de picos. El concepto de Spiking ResNet parecía prometedor: trasladar los bloques residuales de la arquitectura clásica y sustituir las funciones de activación por neuronas de pico. Este enfoque permitía aplicar el principio, contrastado por el paso del tiempo, de la profundidad y las conexiones residuales en un nuevo contexto basado en eventos.
Los resultados fueron dispares. Por un lado, los modelos convertidos a partir de redes neuronales clásicas demostraron una precisión excepcional y pusieron el listón muy alto para otras soluciones. Por otra parte, durante el entrenamiento directo de Spiking ResNet surgieron algunos problemas: una pérdida de calidad al aumentar la profundidad, gradientes evanescentes y explosivos, y dificultades para implementar una aplicación identidad correcta. Todo ello hacía que la tarea de construir modelos de picos verdaderamente profundos y estables siguiera sin resolverse.
En este contexto, la aparición del framework SEW-ResNet, presentado en el artículo «Deep Residual Learning in Spiking Neural Networks», supuso un importante paso adelante. La idea principal consistía en analizar desde una nueva perspectiva el mecanismo del aprendizaje residual aplicado a las arquitecturas de picos. Los autores del framework propusieron un enfoque «Spike-Element-Wise» que permite implementar de forma natural la aplicación identidad y, al mismo tiempo, evitar problemas clave relacionados con los gradientes. Las pruebas prácticas han confirmado la validez del concepto. SEW-ResNet no solo ha demostrado una mayor precisión, sino también la capacidad de escalar a medida que aumenta la profundidad del modelo, algo que antes no se había conseguido. Es más, por primera vez se ha logrado construir una red neuronal de picos con más de 100 capas, que mantenía la estabilidad del aprendizaje y superaba en resultados a muchas soluciones existentes.
Si trasladamos esta conversación a las finanzas, queda claro que este tipo de desarrollos abren horizontes totalmente nuevos. Los modelos profundos, entrenados con datos de impulsos, pueden analizar los acontecimientos del mercado tal y como se producen en la realidad. No como series de números promediados, sino en forma de secuencia de señales discretas, cada una de las cuales es relevante. Esta perspectiva se ajusta más a la naturaleza del mercado, donde el precio rara vez evoluciona de forma suave y uniforme, sino que suele reaccionar ante picos de liquidez, noticias o el estado de ánimo de los participantes. Tecnologías como SEW-ResNet prometen enseñar a los algoritmos a detectar estos cambios en el momento en que se producen.
Por lo tanto, la cuestión de construir modelos de picos estables y profundos trasciende con creces el ámbito del interés académico. En el ámbito financiero, donde la rapidez de reacción y la capacidad para procesar datos complejos determinan la ventaja competitiva, la implantación de este tipo de soluciones puede suponer un paso clave hacia nuevas estrategias y herramientas. Hoy nos encontramos en el umbral de la integración de las ideas de SEW-ResNet en sistemas algorítmicos prácticos. Analizaremos este proceso desde la perspectiva de la implementación de los enfoques propuestos mediante las herramientas de MQL5. Esto permitirá comprender mejor la propia arquitectura y evaluar su potencial de aplicación en condiciones reales de mercado.
Algoritmo SEW-ResNet
En la base de cualquier framework de redes neuronales de picos se encuentra una idea sencilla, pero fundamental: la unidad computacional básica es la neurona de pico. En las redes neuronales artificiales clásicas, este elemento puede describirse como una suma generalizada de productos, en la que las señales recorren las conexiones ponderadas y, a continuación, se transforman mediante una función de activación. Sin embargo, en el modelo de picos, todo parece mucho más dinámico y más cercano a la biología. En este caso, la información no fluye de forma continua, sino que se transmite en forma de eventos individuales: impulsos o picos. Cada uno de estos impulsos es similar a una descarga eléctrica que, en el cerebro real, se transmite de neurona en neurona.
Para formalizar este proceso y hacerlo apto para el cálculo, se introduce un modelo unificado. Este describe la dinámica de la neurona a lo largo del tiempo, dividiéndola en una secuencia de pasos discretos. En cada paso, el sistema resuelve tres tareas fundamentales:
- Calcular el nuevo potencial de membrana.
- Determinar si se ha producido un pico.
- Reiniciar el potencial en caso de activación.
La primera ecuación describe la evolución del potencial.
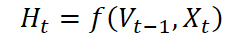
Aquí, Vt-1 es el potencial de membrana en el paso anterior, y Xt es la corriente de entrada recibida en ese instante. La función f(•) determina el tipo de actualización del potencial y varía en función del tipo de neurona seleccionado. De hecho, se trata de la física de la neurona a nivel interno, que describe cómo reacciona ante una señal entrante.
El siguiente paso consiste en comprobar si el potencial de membrana ha superado el umbral.
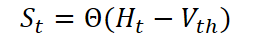
Si el potencial alcanza el umbral Vth, la neurona se activa y genera un pico. La función de Heaviside Θ(•) actúa aquí como un conmutador rígido que devuelve 1 cuando se supera el umbral y 0 en caso contrario. En otras palabras, o bien se produce un evento, o bien no se produce.
A continuación, se activa el mecanismo de reinicio.
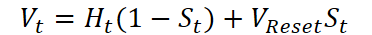
Si se ha producido un pico, el potencial vuelve al nivel fijo VReset. Esto se asemeja al proceso de descarga de una batería: tras liberar energía, el sistema debe volver a su estado inicial para prepararse para la siguiente señal. Si, por el contrario, no se ha producido ningún pico, el potencial mantiene su valor actual y sigue acumulándose.
Todo ello conforma un esquema coherente que permite reproducir la dinámica de las neuronas biológicas y, al mismo tiempo, sigue siendo computacionalmente sencillo. Es más, la flexibilidad viene dada por la función f(•). En el caso del modelo más sencillo, Integrate-and-Fire, tiene la siguiente forma:
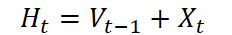
Es decir, el potencial aumenta simplemente en una cantidad igual a la magnitud de la corriente de entrada. En cambio, en el modelo más realista «Leaky Integrate-and-Fire» se tiene en cuenta la fuga de la carga acumulada.
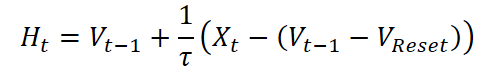
El parámetro τ determina la velocidad de esta fuga, lo que refleja el hecho de que una neurona no puede almacenar energía indefinidamente: pierde carga gradualmente si el pico no llega a generarse.
De este modo, el investigador dispone de un esquema universal en el que los procesos básicos (generación de picos y reinicio del potencial) son idénticos para todos los modelos, y el ajuste preciso se consigue mediante la elección de la función f(•).
Sin embargo, en este camino surge una dificultad importante relacionada con el entrenamiento. La función escalonada clásica, que determina si se generará un pico, no es diferenciable. Esto significa que el método estándar de retropropagación del error, en el que se basa el aprendizaje profundo, no puede funcionar en este caso. A primera vista, parece un obstáculo importante. Si no se puede calcular el gradiente, tampoco es posible ajustar los pesos del modelo.
Se encontró una solución en el denominado método de gradientes sustitutos. Su esencia radica en que, para la pasada directa, utilizamos la función escalonada original, ya que es precisamente esta la que refleja la naturaleza de los picos. Sin embargo, cuando se trata de calcular derivadas durante la pasada inversa, la sustituimos por una aproximación suave —la función σ(•)—, que se comporta de manera similar, pero tiene un gradiente analítico fácil de utilizar. Este doble uso de las funciones permite entrenar modelos de picos de forma similar a las redes neuronales profundas habituales, conservando al mismo tiempo la naturaleza basada en eventos de los cálculos.
Esta combinación (el modelo unificado de neuronas y el método de gradientes sustitutos) sienta unas bases sólidas para el diseño de arquitecturas complejas. Es precisamente aquí donde comienza la historia de SEW-ResNet.
Si hablamos de arquitecturas profundas, fue precisamente el bloque residual el que sirvió de base para el desarrollo de ResNet y permitió superar el principal problema de las redes muy profundas: la degradación del rendimiento. La idea parecía sencilla, pero revolucionaria. Si no podemos entrenar todas las nuevas capas para que reproduzcan con exactitud la señal de entrada, dejemos una ruta alternativa para ellas: una línea recta por la que la información pueda pasar sin distorsiones. En eso consistía el concepto de aplicación identidad. Esto garantizaba que la profundidad del modelo no afectara a la calidad. En el peor de los casos, las nuevas capas no estropearán nada y, en el mejor, enriquecerán la representación de los datos.
En la red ResNet clásica, este bloque está formado por dos capas convolucionales consecutivas, normalización y la función de activación ReLU. Si designamos la entrada del bloque como Xl y la salida como Yl, la fórmula general queda así:
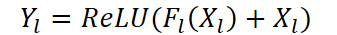
Aquí, Fl(•) es una contribución que se añade a la señal original. Si es igual a cero, el resultado será simplemente Yl = ReLU(Xl). Y dado que la activación tras la función ReLU no es negativa, para la mayoría de los valores obtenemos, de hecho, una aplicación identidad: la entrada es igual a la salida. Ahí radicaba el secreto del éxito de ResNet.
El intento de trasladar este diseño al mundo de los picos parecía totalmente natural. En los trabajos sobre Spiking ResNet, el bloque tiene la misma estructura, solo que en lugar de ReLU se utiliza una neurona de pico.
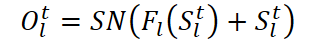
En este caso, Sl y Ol son la entrada y la salida del bloque en el paso de tiempo t, mientras que SN indica la activación de una neurona de pico.
Y aquí es donde se pone de manifiesto una diferencia fundamental. En las redes clásicas, la función ReLU actúa como un filtro suave. Deja pasar los valores positivos sin modificarlos. Por eso, conseguir una aplicación identidad en estas redes es sencillo. Sin embargo, en el caso de una neurona de pico, las condiciones son mucho más estrictas. Para garantizar la igualdad SN(Slt) = Slt, la última neurona del bloque debe activarse ante cada pico de entrada y permanecer inactiva cuando este no se produzca. En el caso del modelo IF más sencillo, esto aún se puede lograr: basta con elegir el umbral de activación y las condiciones iniciales de tal forma que la entrada 1 siempre genere un pico y la entrada 0 nunca lo haga. Pero en cuanto tomamos un modelo más complejo, como LIF con una constante de tiempo τ entrenable, la situación se complica. El potencial se actualiza en incrementos fraccionarios que dependen de τ, por lo que resulta prácticamente imposible establecer un umbral universal válido para todos los casos.
Por lo tanto, los bloques residuales de Spiking ResNet presentan limitaciones. No son adecuados para todos los modelos de neuronas, lo que significa que, ya desde el nivel básico, se incumple el principio de universalidad.
Pero ese no es el único problema. Incluso si conseguimos configurar los bloques de tal forma que implementen la aplicación identidad, nos enfrentamos a una amenaza mucho más grave: los gradientes evanescentes y explosivos. En una red profunda, la transmisión del gradiente a través de una secuencia de bloques de picos se reduce al producto de factores relacionados con la derivada de la función de activación escalonada. Y dado que esta función es discreta, las aproximaciones sustitutas de su derivada casi siempre dan valores muy pequeños (lo que provoca el desvanecimiento del gradiente) o, por el contrario, generan un crecimiento inestable (explosión). Como resultado, a medida que aumenta el número de capas, la red se vuelve prácticamente imposible de entrenar. Los errores no se propagan hacia el interior, los pesos no se ajustan y los gradientes tienden a cero o al infinito.
Este efecto es precisamente la famosa degradación, solo que en los modelos de picos se manifiesta de forma aún más marcada que en los clásicos. Y precisamente por eso, Spiking ResNet, en su forma original, nunca logró demostrar que la profundidad aportara una ventaja. Es más, a menudo un modelo de picos profundo funcionaba peor que su equivalente menos profundo.
Cabe señalar, sin embargo, que estos bloques sí han encontrado su lugar: en la conversión de los modelos clásicos en modelos de picos. En ese caso, la tarea es distinta: adaptar un modelo ya preparado al formato basado en eventos. En este caso, los bloques de picos pueden usarse en combinación con una normalización adicional y reproducen con bastante éxito las características de frecuencia de las activaciones ReLU originales.
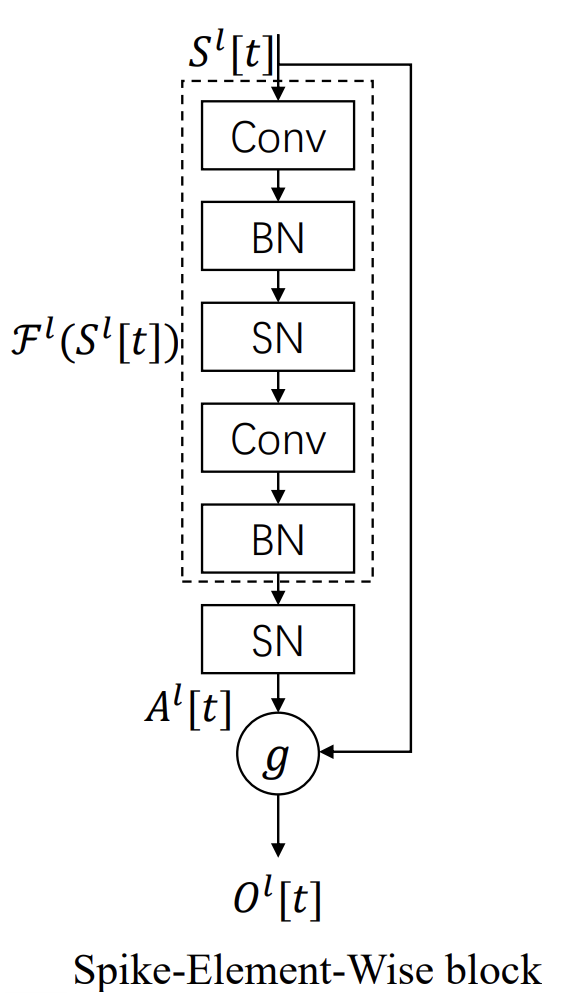
Y aquí es donde entra en escena el bloque Spike-Element-Wise, que, en esencia, desempeña el mismo papel que en su día desempeñó el clásico bloque residual: ha permitido que las SNN crezcan en profundidad manteniendo la estabilidad.
¿Qué hace que el bloque SEW sea tan especial? En primer lugar, su sencillez. Se basa en la operación g, que actúa componente a componente y combina dos flujos de información: la salida de la transformación de picos y la señal original. Gracias a la naturaleza binaria de los picos, este diseño funciona como un conmutador perfecto: con los ajustes adecuados, el bloque se vuelve totalmente transparente y realiza la aplicación identidad. No se trata de un ajuste fino que dependa de un modelo concreto de neurona o de los parámetros de la dinámica de la membrana, sino de una técnica universal que funciona en cualquier configuración. Ahí es precisamente donde reside la fuerza de SEW: es universal.
Imaginemos una larga cadena de bloques SEW. En las arquitecturas clásicas de tipo ResNet, a partir de una determinada profundidad empezamos a perder la señal: los gradientes se van reduciendo cada vez más y la red deja de aprender. O, por el contrario, en los bloques RBA las señales aumentan de forma descontrolada, lo que provoca explosiones. En SEW, ese escenario es imposible. Su salida siempre está acotada, los gradientes se mantienen iguales a uno y el entrenamiento puede alcanzar cientos de bloques de profundidad. En otras palabras, SEW nos devuelve el mismo lujo que ResNet aportó al mundo de los modelos neuronales clásicos.
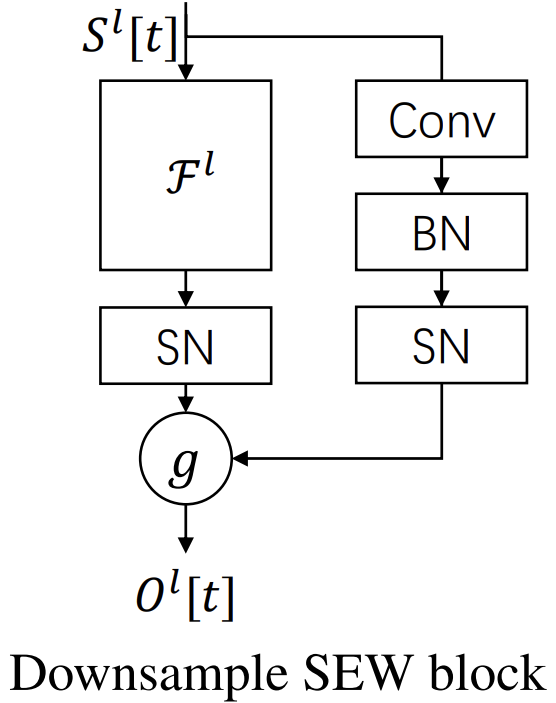
También resulta interesante ver cómo se resuelve el problema del submuestreo. En las redes ResNet clásicas, cuando cambian las dimensiones, el atajo se implementa mediante convoluciones sin activación. En el bloque SEW se añade una neurona de pico al atajo, lo que da lugar a un esquema más orgánico y neurobiológicamente realista. En definitiva, los bloques de submuestreo modifican la dimensionalidad y siguen funcionando en modo de picos, conservando la plausibilidad biológica del modelo.
Desde una perspectiva más amplia, el bloque SEW abre las puertas a una clase de aplicaciones completamente nueva. Antes de su aparición, las arquitecturas SNN eran más bien un tema de interés académico. Era demasiado complicado mantener el equilibrio entre la profundidad y la facilidad de entrenamiento. Con la llegada de SEW, estas arquitecturas empiezan a perfilarse como competidoras serias de los modelos clásicos de redes neuronales en tareas reales. Y es que las ventajas de las SNN son evidentes: son eficientes desde el punto de vista energético, asíncronas, se adaptan perfectamente a los chips neuromórficos y permiten diseñar cálculos más cercanos a la dinámica real del cerebro.
Al pasar de la descripción teórica a los experimentos prácticos, se hace evidente la diferencia entre Spiking ResNet y SEW-ResNet. En tareas estáticas —como la clasificación de imágenes de los conjuntos CIFAR o ImageNet—, ambas arquitecturas ofrecen resultados similares, pero basta con aumentar la profundidad de la red, añadiendo más capas, para que el rendimiento de Spiking ResNet empiece a deteriorarse. Los gradientes se desvanecen, el error aumenta y, en lugar de una mejora, se produce un deterioro de la calidad. Es el típico caso en el que la profundidad se convierte en un enemigo.
En estas condiciones, SEW-ResNet se comporta de manera diametralmente opuesta. Cuanto más profundo es el modelo, más estable es su comportamiento y mayor es la precisión final. Esto es especialmente importante cuando se trata de tareas en las que el éxito depende de la capacidad del modelo para captar dependencias temporales de largo alcance. En los mercados financieros nos encontramos precisamente ante esta situación. Picos de actividad esporádicos y bruscos, periodos de calma prolongada, cambios de régimen del mercado y dependencias temporales a largo plazo que es necesario retener en la memoria.
Para comprender el valor de SEW-ResNet en el trading, se puede establecer una analogía con el propio mercado. En él también hay señales en forma de picos: noticias inesperadas, movimientos bruscos de las cotizaciones y aumentos repentinos de liquidez. Los modelos clásicos de redes neuronales, que funcionan con activaciones promediadas, se asemejan a un operador bursátil que solo ve un gráfico suavizado y pasa por alto los impulsos bruscos. Las arquitecturas de picos, especialmente SEW-ResNet, permiten percibir el mercado en su forma natural, basada en eventos, donde lo importante no es la tendencia suave, sino precisamente el momento del salto y su contexto.
En las pruebas comparativas realizadas con conjuntos de datos que simulaban un flujo de eventos, SEW-ResNet demostró una ventaja significativa tanto en precisión como en velocidad de convergencia. Es más, resultó ser el primer enfoque que permitió entrenar modelos SNN con más de 100 capas sin que se produjera un deterioro catastrófico.
En su aplicación práctica a los datos financieros, SEW-ResNet abre nuevos horizontes. Permite crear modelos capaces de detectar patrones locales en las cotizaciones y relacionarlos con dependencias históricas a largo plazo. Por ejemplo, el modelo puede detectar un breve repunte de actividad en respuesta a una noticia económica y, al mismo tiempo, tener en cuenta que, en el pasado, esos repuntes dieron lugar a una tendencia sostenida a medio plazo. Esto es posible precisamente gracias a la profundidad, que ahora, en lugar de perjudicar el entrenamiento, lo potencia.
Además, la elevada eficiencia energética y la naturaleza basada en eventos de las SNN permiten considerar SEW-ResNet en el contexto de los sistemas de baja latencia. En el contexto del trading de alta frecuencia o del análisis algorítmico, donde cada milisegundo cuenta, la capacidad del modelo para procesar rápidamente eventos de pico se convierte en una ventaja fundamental.
A continuación se muestra una representación del framework realizada por el autor.
Implementación en MQL5
Tras haber analizado detenidamente los fundamentos teóricos y las características arquitectónicas del framework SEW-ResNet, llega la siguiente etapa lógica: pasar a la implementación práctica. Y aquí es importante avanzar de lo sencillo a lo complejo, de los cimientos a la estructura que se construye sobre ellos. El primer eslabón de esta cadena es la construcción de la función básica de la neurona de pico.
A primera vista, puede parecer bastante lógico implementar el proceso de generación del pico como una función independiente. Del mismo modo que en nuestra biblioteca se han implementado las funciones clásicas de activación. Sin embargo, las neuronas de pico plantean requisitos fundamentalmente diferentes. A diferencia de las activaciones tradicionales, que calculan al instante el valor de salida a partir de la señal de entrada, la neurona de pico evoluciona en el tiempo. No solo reacciona a la entrada, sino que acumula información e incrementa su potencial de membrana hasta que, al alcanzar el umbral, genera un pico: un impulso discreto que transmite información.
Esta dinámica temporal no puede reducirse a una mera función estática. Para una simulación correcta se requiere memoria independiente: búferes de acumulación de potencial, que, en esencia, se asemejan a los estados ocultos de los modelos recurrentes. Y ahí radica precisamente el principal reto. El uso de la activación de picos como una simple función requeriría automáticamente modificar todos los objetos de capa creados anteriormente. De hecho, destruiríamos la compatibilidad arquitectónica de la biblioteca y perderíamos la modularidad creada.
Por eso, la solución resultó ser otra, más madura: implementamos la generación de picos como un objeto de capa neuronal independiente. A primera vista, esta medida puede parecer excesiva, pero en realidad es estratégica. El objeto de la capa se puede integrar en cualquier arquitectura existente sin afectar al funcionamiento del resto de componentes. Este se convierte en un bloque independiente que se puede combinar con otras capas, aumentando así la complejidad del modelo.
Pero antes de pasar directamente al código, conviene detenernos un momento en los principios clave de nuestra implementación. En la descripción teórica del framework SEW-ResNet, los autores expusieron las ideas básicas —una base que abre un amplio campo para la experimentación—, pero sin soluciones técnicas concretas. Son precisamente estas soluciones las que nos permiten construir modelos de picos profundos que se pueden entrenar de verdad.
El primer principio se refiere a la acumulación del potencial de membrana de la neurona. Para ello, hemos tomado prestado de los modelos recurrentes el mecanismo de actualización mediante puertas del estado. Cada neurona de pico cuenta ahora con su propia puerta, que controla la rapidez o lentitud con la que el potencial de membrana reacciona a las señales entrantes. Y lo que resulta especialmente importante, esta puerta se ha implementado como un parámetro entrenable, independiente de los datos de entrada.
El sentido práctico de este enfoque se puede entender fácilmente usando una analogía con un operador bursátil. Cada neurona aprende a desarrollar su propia estrategia para reaccionar ante los acontecimientos. Si la señal es ruidosa e inestable, la neurona se comporta de forma conservadora, acumula información y solo reacciona ante cambios realmente significativos. Sin embargo, si la señal es limpia y predecible, la neurona es capaz de generar instantáneamente un pico, captando así un impulso importante. Como resultado, cada elemento se convierte en único y el modelo en su conjunto adquiere la flexibilidad necesaria para trabajar con diferentes tipos de secuencias de entrada.
Este enfoque resulta especialmente relevante en los mercados financieros, donde los datos suelen mostrar una alternancia entre periodos de calma y repentinos picos de actividad. Hay acontecimientos que exigen una respuesta prudente, mientras que otros requieren una reacción rápida y decidida. La posibilidad de configurar cada neurona en función de las características específicas de la señal de entrada permite que el modelo se adapte a estas condiciones, manteniendo la precisión y la estabilidad del entrenamiento.
Además, tomaremos prestado del framework SpikingBrain un eficaz mecanismo de entrenamiento adaptativo de los valores umbral, implementado en el núcleo FloatToSpike. Este mecanismo permite a las neuronas ajustar de forma flexible su umbral de activación según las estadísticas de las señales de entrada, lo cual resulta especialmente importante cuando se trabaja con datos heterogéneos y con ruido. Sin embargo, en nuestra implementación hemos introducido un cambio pequeño, pero fundamental, que potencia las capacidades del modelo.
Ahora, al generarse un pico, el potencial acumulado de la neurona se reduce en una cantidad igual al umbral de activación.
__kernel void FloatToSpike(__global float* values,
                           __global const float* levels,
                           __global float* outputs
                          )
  {
   const size_t id = get_global_id(0);
   float val = IsNaNOrInf(values[id], 0.0f);
   if(val == 0.0f)
      outputs[id] = 0.0f;
   else
     {
      const float lev = IsNaNOrInf(levels[id], 0.0f);
      if(fabs(val) < lev)
         outputs[id] = 0.0f;
      else
        {
         outputs[id] = (float)sign(val);
         values[id] = IsNaNOrInf(sign(val)*(fabs(val)-lev), 0.0f);
        }
     }
  }
Hemos optado deliberadamente por no efectuar el reinicio del potencial a un valor fijo VReset. A primera vista, puede parecer un detalle sin importancia, pero en la práctica ofrece un nivel de flexibilidad totalmente nuevo. Este enfoque permite crear una especie de gradación de picos. Una señal más intensa deja un rastro más prolongado en el potencial de membrana, lo que influye en los acontecimientos posteriores. En otras palabras, la neurona es ahora capaz de acumular el historial de picos significativos, creando un efecto de inercia temporal.
En el contexto de los mercados financieros, esto adquiere un valor práctico especial. Los acontecimientos del mercado rara vez son hechos únicos y aislados. El movimiento del precio de un instrumento suele prolongarse en una serie de impulsos relacionados entre sí, y la reacción del mercado ante una noticia puede prolongarse en el tiempo. La capacidad de una neurona para retener parte del potencial acumulado permite al modelo recordar acontecimientos significativos y reaccionar adecuadamente a sus consecuencias, creando así una memoria dinámica interna. Esta organización del funcionamiento de las neuronas hace que SEW-ResNet sea más sensible a los patrones reales del mercado, al tiempo que reduce la influencia del ruido aleatorio.
De esta forma, un pequeño cambio puntual en el mecanismo hace que la neurona pase de ser un simple conmutador de «pico/sin pico» a ser un elemento dinámico completo con una respuesta gradual. Esta combinación de precisión, adaptabilidad y capacidad para acumular información a lo largo del tiempo es una de las características distintivas clave de nuestra implementación y sienta unas bases sólidas para la creación de modelos profundos, robustos y adaptables.
La solución propuesta se ha implementado en forma de un nuevo objeto, CNeuronSpikeActivation, que hereda de la clase base CNeuronBaseOCL. Este objeto representa toda la dinámica de una neurona de pico, incluida la acumulación del potencial de membrana, el umbral adaptativo y el mecanismo de gradación de la generación de impulsos.
class CNeuronSpikeActivation  :  CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL    cHV;
   CParams           cLevels;
   CParams           cGates;
   //---
   virtual bool      FloatToSpike(void);
   virtual bool      FloatToSpikeGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikeActivation(void) {};
                    ~CNeuronSpikeActivation(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint neurons, ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const  {  return defNeuronSpikeActivation;   }
   //--- methods for working with files
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
Dentro del objeto se distinguen varios componentes clave:
- cHV se encarga de la dinámica interna de la neurona, acumulando potencial y teniendo en cuenta los eventos de pico;
- cLevels almacena los parámetros de los valores umbral, lo que permite un entrenamiento adaptativo del umbral;
- cGates implementa un mecanismo de actualización del potencial de membrana mediante puertas, lo que permite a cada neurona regular de forma individual la velocidad de respuesta a la señal de entrada.
De esta forma, cada neurona puede desarrollar una estrategia única para reaccionar ante eventos ruidosos o significativos, lo cual resulta especialmente importante para el análisis de series financieras.
Todos los objetos internos de la nueva clase se declaran de forma estática, lo que ha permitido dejar vacíos el constructor y el destructor de la clase: no se requiere ninguna acción adicional al crear o eliminar un objeto. Esta solución simplifica considerablemente la arquitectura, la hace más predecible y facilita la integración de la nueva neurona en la biblioteca existente.
Todo el proceso de inicialización de una nueva capa neuronal se concentra en el método Init, que se convierte en el punto de entrada para la configuración de todos los componentes del objeto. Aquí se configuran los parámetros clave.
bool CNeuronSpikeActivation::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                  uint numNeurons, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
La inicialización comienza con una llamada al método homónimo de la clase base, que configura los parámetros fundamentales de la neurona. Una vez completada con éxito la ejecución, se crean e inicializan los componentes internos. cHV se encarga de la dinámica del potencial de membrana. Se le asigna una activación nula y se vacían los búferes para que la neurona comience en un estado limpio.
   uint index = 0;
   if(!cHV.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cHV.SetActivationFunction(None);
   cHV.Clear();
A continuación, se crea el objeto cLevels, que se encarga de los umbrales de activación adaptativos. Se le asigna la función de activación SoftPlus, que garantiza una actualización suave y estable de los umbrales, y los pesos se inicializan con el valor -3.0f, lo cual crea un umbral inicial conservador. Este umbral permite a la neurona acumular señales de entrada y reaccionar únicamente ante eventos realmente significativos; sin embargo, no desactivamos todas las neuronas desde el inicio del entrenamiento. Esto es importante. Las neuronas siguen siendo capaces de generar los primeros picos incluso al inicio, lo que garantiza un flujo continuo de información en el modelo y permite que los gradientes se propaguen de forma eficaz durante el proceso de entrenamiento.
En otras palabras, evitamos que las neuronas se mantengan totalmente pasivas en las primeras etapas: se incorporan de inmediato al proceso de entrenamiento, pero actúan con cautela. Este equilibrio entre la inicialización conservadora y la actividad neuronal crea las condiciones óptimas para el entrenamiento gradual del modelo y estabiliza las primeras fases del entrenamiento.
   index++;
   if(!cLevels.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cLevels.SetActivationFunction(SoftPlus);
   CBufferFloat* temp = cLevels.getWeightsParams();
   if(!temp ||
      !temp.Fill(-3.0f))
      return false;
En el siguiente paso se inicializa el objeto cGates, que implementa el mecanismo de actualización del potencial de membrana mediante puertas. Se le asigna la activación SIGMOID, lo cual permite que cada neurona aprenda un coeficiente de respuesta individual ante nuevas señales. Los pesos se inicializan con ceros, lo que da lugar a un comportamiento neutro al inicio del entrenamiento. En estas condiciones, tras aplicar la función SIGMOID a la señal, el resultado se sitúa en torno a 0,5, punto en el que la sigmoide es prácticamente lineal. Esto es fundamental. En esta zona, los gradientes mantienen una magnitud suficiente, lo que permite ajustar rápidamente los parámetros de la puerta en la dirección deseada.
En otras palabras, al inicio del entrenamiento, la neurona alcanza un estado equilibrado: la puerta no bloquea ni deja pasar la señal por completo, sino que deja margen para la adaptación. Ya desde las primeras fases del entrenamiento, el modelo es capaz de ajustar de forma flexible la velocidad de acumulación del potencial de membrana de cada neurona, adaptándose a las características de los datos de partida. Esto resulta especialmente importante en el caso de las series temporales financieras, en las que las señales pueden ser tanto tranquilas y predecibles como bruscas y ruidosas. Y una reacción dinámica adecuada de las neuronas influye directamente en la precisión de las predicciones.
   index++;
   if(!cGates.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cGates.SetActivationFunction(SIGMOID);
   temp = cGates.getWeightsParams();
   if(!temp ||
      !temp.Fill(0.0f))
      return false;
//---
   return true;
  }
De esta forma, el método de inicialización configura la capa neuronal y crea una estructura lista para funcionar, flexible y adaptativa, capaz de acumular información, controlar el umbral de activación y reaccionar de forma individualizada a las señales de entrada.
Una vez finalizada la inicialización del objeto, el siguiente paso lógico es diseñar el algoritmo de pasada directa, es decir, la forma en que la neurona procesa los datos de entrada y genera picos. Este proceso se implementa en el método feedForward, que constituye el núcleo del funcionamiento de la neurona.
bool CNeuronSpikeActivation::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!cHV.SwapOutputs())
      return false;
El algoritmo comienza con una pequeña fase de preparación. En primer lugar, comprobamos la validez del puntero recibido al objeto de la capa anterior NeuronOCL. Esto garantiza que los datos que se van a procesar existan realmente. A continuación, se invoca el método SwapOutputs para el objeto cHV, lo que garantiza la actualización del estado interno del potencial de membrana. Los valores actuales pasan a ser los anteriores y la neurona está lista para procesar un nuevo paso temporal. Este paso es de vital importancia para que la acumulación de potencial y la formación de picos funcionen correctamente, teniendo en cuenta el historial de señales.
Si la red se encuentra en modo de entrenamiento, se ejecuta además una pasada directa para los objetos internos cLevels y cGates. El primero se encarga de ajustar el umbral de activación, y el segundo, de actualizar la puerta del potencial de membrana. Son precisamente estos componentes los que permiten a la neurona regular de forma flexible su sensibilidad ante los datos analizados y aprender eficazmente a partir de señales ruidosas o cambiantes.
   if(bTrain)
     {
      if(!cLevels.FeedForward())
         return false;
      if(!cGates.FeedForward())
         return false;
     }
A continuación, se realiza una suma elemento por elemento de la señal de entrada y del potencial de membrana, teniendo en cuenta las puertas. Esta operación pone en práctica el principio fundamental de las neuronas de pico: la señal de entrada se acumula teniendo en cuenta el estado de la neurona y su reacción individual ante lo nuevo. Este enfoque permite al modelo conservar la memoria dinámica y reaccionar con flexibilidad ante complejas dependencias temporales, lo cual es especialmente importante en el caso de las series temporales financieras, en las que cada cambio puede tener un efecto duradero en los acontecimientos posteriores.
   if(!GateElementMult(NeuronOCL.getOutput(), cHV.getPrevOutput(),
                       cGates.getOutput(), cHV.getOutput()))
      return false;
   return FloatToSpike();
  }
La llamada al método FloatToSpike finaliza la pasada directa, generando picos a partir del estado actual de la membrana y del umbral adaptativo. El resultado de la ejecución del método feedForward es la señal de salida de la neurona, lista para su posterior procesamiento como parte de una red SEW-ResNet profunda.
Como se puede observar, el algoritmo del método de pasada directa tiene un carácter lineal y predecible. Cada acción —la actualización del potencial de membrana, la aplicación de la puerta y la generación de picos— se realiza de forma secuencial y transparente, sin ramificaciones complejas ni conflictos entre los flujos de datos. Este enfoque tiene una importante consecuencia práctica: la propagación del gradiente de error y el entrenamiento del modelo se mantienen estables y no se complican por el procesamiento paralelo de la información, lo cual resulta especialmente valioso cuando se trabaja con redes profundas y un gran número de neuronas.
En esta implementación, se propone dejar al lector el estudio de los métodos de pasada inversa, que se encargan de calcular los gradientes y actualizar los pesos. El código completo de la clase CNeuronSpikeActivation y de todos sus métodos se incluye en el anexo, lo que permite al lector estudiar en detalle su implementación y utilizarla para crear sus propios modelos.
De este modo, CNeuronSpikeActivation es una herramienta versátil y flexible para crear modelos de picos profundos basados en SEW-ResNet en MQL5. Su arquitectura permite experimentar con distintos esquemas de acumulación de potencial, umbral adaptativo y generación de picos, sin afectar a la compatibilidad con los objetos ya existentes de las capas neuronales. Es precisamente este enfoque modular y ampliable el que permite construir modelos profundos, estables y adaptativos para el análisis de series temporales complejas, propias de los mercados financieros.
Hoy hemos trabajado mucho, así que es hora de hacer una pequeña pausa para asimilar lo aprendido. En el próximo artículo volveremos a abordar la implementación de los enfoques propuestos por los autores del framework SEW-ResNet, con nuevas energías y una perspectiva renovada, y seguiremos desarrollando modelos de picos eficaces y adaptativos mediante MQL5.
Conclusión
En este artículo hemos conocido el framework SEW-ResNet, cuya principal ventaja es la posibilidad de implementar directamente el entrenamiento residual en modelos de picos. Esto permite crear modelos profundos sin degradación del rendimiento. El uso de la naturaleza binaria de los picos, junto con las operaciones elemento a elemento, garantiza la resistencia frente a gradientes evanescentes y explosivos.
En la parte práctica, hemos analizado en detalle los principios de implementación de las neuronas de pico y de construcción de un algoritmo básico de pasada directa mediante MQL5. Se muestra cómo el uso de un umbral adaptativo, la actualización del potencial de membrana controlada por una puerta y el mecanismo de acumulación del potencial permiten a las neuronas responder de forma eficaz a datos secuenciales y ruidosos.
En el próximo artículo seguiremos ampliando las funcionalidades de SEW-ResNet para crear un modelo de picos profundo y completo destinado al análisis y la predicción de datos financieros.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos fuera de línea |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos en línea |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura que describe el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19839
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.