

Algoritmo de optimización del dingo — Dingo Optimization Algorithm (DOA)
 13
 0

Índice
Introducción
En este artículo conoceremos el algoritmo de optimización del dingo (Dingo Optimization Algorithm, DOA), que fue desarrollado en 2021 por un grupo internacional de investigadores dirigido por Hernán Peraza-Vázquez. El artículo se publicó en la revista Mathematical Problems in Engineering (DOI: 10.1155/2021/9107547).
El algoritmo se inspira en el comportamiento de caza de los dingos australianos (Canis lupus dingo), los mamíferos carnívoros más grandes de Australia. Los dingos muestran un comportamiento social complejo y utilizan diversas estrategias de caza en función del tamaño y el tipo de presa.
Implementación del algoritmo
El algoritmo DOA simula las tres estrategias de caza principales del dingo:
- Ataque en grupo — los dingos rodean a la presa y la atacan en conjunto, lo que resulta especialmente eficaz en la caza de animales de gran tamaño, como los canguros;
- Persecución — caza individual de presas pequeñas, en la que el dingo persigue a su presa hasta agotarla;
- Búsqueda de carroña — comportamiento oportunista al explorar nuevos territorios y buscar carroña.
Además, el algoritmo incluye un mecanismo de supervivencia que actualiza las posiciones de los individuos más débiles de la población, imitando la selección natural. El algoritmo establece un equilibrio entre la exploración (exploration) y la explotación (exploitation) del espacio de búsqueda mediante dos parámetros probabilísticos: P — la probabilidad de elegir entre la caza y la búsqueda de carroña — y Q — la probabilidad de elegir entre el ataque en grupo y la persecución durante la caza.
Imagina que tienes una manada de 50 dingos que buscan el lugar ideal para cazar en un territorio extenso. Cada dingo representa una posible solución al problema de optimización, y el territorio es el espacio de búsqueda.
1. Ataque en grupo (probabilidad del 35 %). La danza de los depredadores
En la sabana australiana, una manada de dingos rodea una manada de canguros. No se trata de una persecución caótica, sino de una operación coordinada. Varios individuos —desde dos valientes hasta la mitad de la manada— se adelantan, formando una red invisible de posiciones.
Cada dingo atacante comparte su experiencia con el grupo: dónde se encuentra y qué ve. Su conocimiento colectivo se funde en un único punto de comprensión: la sabiduría promediada de la manada. Sin embargo, aquí surge la paradoja de la caza: la nueva posición se define alejándose del alfa, del líder. ¿Por qué? Porque si todos siguen ciegamente al líder, la manada se convertirá en una multitud predecible. El coeficiente β₁ actúa como la fuerza del viento: a veces de cola (positivo), a veces de cara (negativo), creando maniobras impredecibles para la manada. El resultado: un caos regido por la lógica. Los dingos se dispersan en abanico por el territorio, explorando aquellos rincones de las zonas de caza que el líder podría haber pasado por alto. Por ahora se trata de hipótesis que deben confirmarse con la práctica.
Cuando los dingos cazan en grupo, se eligen al azar entre 2 y 25 individuos para el ataque. La nueva posición del dingo se calcula de la siguiente manera:
Nueva_posición = β₁ × (Posición_media_de_los_atacantes) - Posición_del_líder
Ejemplo: Si hay 5 dingos en los puntos [10, 20, 30, 40, 50], su posición media es 30. Para β₁ = 1,5 y la posición del líder = 45:
Nueva posición = 1,5 × 30 - 45 = 0
El dingo se aleja del líder para explorar nuevas zonas.
2. Persecución (probabilidad del 35 %). El cazador solitario
Un dingo joven se separa de la manada. Delante de él hay una liebre, rápida y escurridiza. Se trata de una caza individual, en la que lo importante no es la fuerza del grupo, sino la destreza individual. El dingo tiene en su campo de visión dos puntos: la posición del alfa (la sabiduría acumulada del mejor cazador) y la de un congénere aleatorio cercano. La distancia al vecino determina el alcance de la acometida: cuanto más lejos esté el vecino, más audaz será el salto. La función exponencial e^β₂ actúa como la adrenalina en la sangre: si β₂ es positivo, se produce un subidón de energía y el salto se alarga; si es negativo, hay cautela y movimientos cortos y precisos.
La trayectoria de la persecución es sinuosa: el dingo se dirige hacia la posición del líder, pero su camino se ve alterado por la presencia de su compañero, lo que crea una espiral de persecución que se va estrechando poco a poco alrededor del objetivo. Caza en solitario, en la que el dingo se desplaza con respecto al líder de la manada y a un compañero aleatorio:
Ejemplo: El líder está en el punto 100, el dingo actual en el punto 60 y el vecino en el punto 80:
Si β₁ = 1,5 y β₂ = 0,5: Nueva posición = 100 + 1,5 × e^0,5 × |80 - 60| = 100 + 1,5 × 1,65 × 20 ≈ 149,5
El dingo sigue al líder, pero teniendo en cuenta la distancia hasta el vecino.
3. Búsqueda de carroña (probabilidad del 30 %). El vagabundeo del oportunista
El sol del mediodía abrasa la tierra roja. Algunos dingos pasan al modo carroñero; esto no es un signo de debilidad, sino de sabiduría evolutiva. ¿Para qué gastar energía en una persecución si se puede encontrar una presa ya disponible?
El dingo carroñero elige a un vecino al azar como punto de referencia, pero aquí se produce un truco cuántico: con una probabilidad del 50 %, su propia posición se «refleja» respecto a cero (se multiplica por -1), como si viera su reflejo en un abrevadero. Esto crea una enorme distancia para el cálculo: la distancia entre el vecino real y el «anti-yo» fantasmal.
La nueva posición se define como una parte de la distancia fantasma, ajustada teniendo en cuenta la influencia exponencial del estado de ánimo (e^β₂). Resultado: saltos impredecibles por el territorio, exploración de los lugares más insospechados. Así es precisamente como se descubren oasis ocultos y carroña olvidada.
Comportamiento exploratorio para descubrir nuevas áreas:
Ejemplo: Posición actual = 40, vecino = 70, β₂ = 0,3, signo positivo:
Nueva posición = 0,5 × e^0,3 × |70 - 40| = 0,5 × 1,35 × 30 ≈ 20,25
Esto genera un movimiento más aleatorio que permite explorar el espacio.
4. Mecanismo de supervivencia. Una segunda oportunidad para los rezagados
En cualquier manada hay rezagados. Su tasa de supervivencia cae por debajo del umbral crítico de 0,3: se encuentran en posiciones desfavorables y sus intentos de caza fracasan. La naturaleza les da la oportunidad de renacer. Un dingo débil recibe una «inyección genética» de dos congéneres elegidos al azar. Sus posiciones, quizá con la inversión de una de ellas (una mutación natural), crean un vector de cambio. Este vector, reducido a la mitad por seguridad, se suma a la posición del alfa.
La metáfora es sencilla: el débil sigue al fuerte, pero con un componente aleatorio procedente del acervo genético de la manada. No se trata simplemente de imitar al líder, sino de una evolución controlada en la que los rezagados reciben orientación, pero conservan su individualidad. Tras cada iteración, se calcula la «tasa de supervivencia» de cada dingo:
Índice_de_supervivencia = (Peor_resultado - Resultado_actual) / (Peor - Mejor)
Si la tasa de supervivencia es < 0,3 (individuo débil), la posición se actualiza:
Ejemplo:
Dingo débil: posición [5, 5], aptitud = 90 (mala)
Líder: [45, 50]
Dingo r₁: [30, 35]
Dingo r₂: [25, 20]
σ = 0 (signo positivo)
Vector de diferencia = |[30, 35] - [25, 20]| = |[5, 15]| = [5, 15]; nueva posición = [45, 50] + 0,5 × [5, 15] = [45, 50] + [2,5, 7,5] = [47,5, 57,5]
Desplazamos las soluciones débiles más cerca del líder, con una pequeña variación aleatoria. Ahora podemos resumir toda la información en un algoritmo paso a paso:
- Inicialización: Colocamos 50 dingos de forma aleatoria en el espacio de búsqueda
- Ciclo principal (500 iteraciones):
- Para cada dingo, generamos β₁ ∈ [-2, 2] y β₂ ∈ [-1, 1]
- Lanzamos una «moneda» con una probabilidad P = 0,5:
- Si sale «caza», volvemos a lanzar con Q = 0,7:
- 70 % de probabilidad → ataque en grupo
- 30 % de probabilidad → persecución
- Si sale la búsqueda de carroña → usamos la estrategia de búsqueda de carroña
- Si sale «caza», volvemos a lanzar con Q = 0,7:
- Comprobamos la tasa de supervivencia y, si es necesario, aplicamos el procedimiento de supervivencia
- Actualización: Guardamos la mejor solución encontrada
La ilustración que se muestra a continuación visualiza las cuatro estrategias del algoritmo DOA: ataque en grupo: muestra cómo varios dingos forman una posición media y se alejan del líder; persecución: muestra el movimiento hacia el líder teniendo en cuenta la distancia al vecino; búsqueda de carroña: ilustra una exploración aleatoria con posible inversión de la posición; y supervivencia: muestra el desplazamiento de los individuos débiles hacia el líder con la adición de un vector aleatorio. Cada estrategia incluye una fórmula matemática y una representación gráfica de los vectores de movimiento.
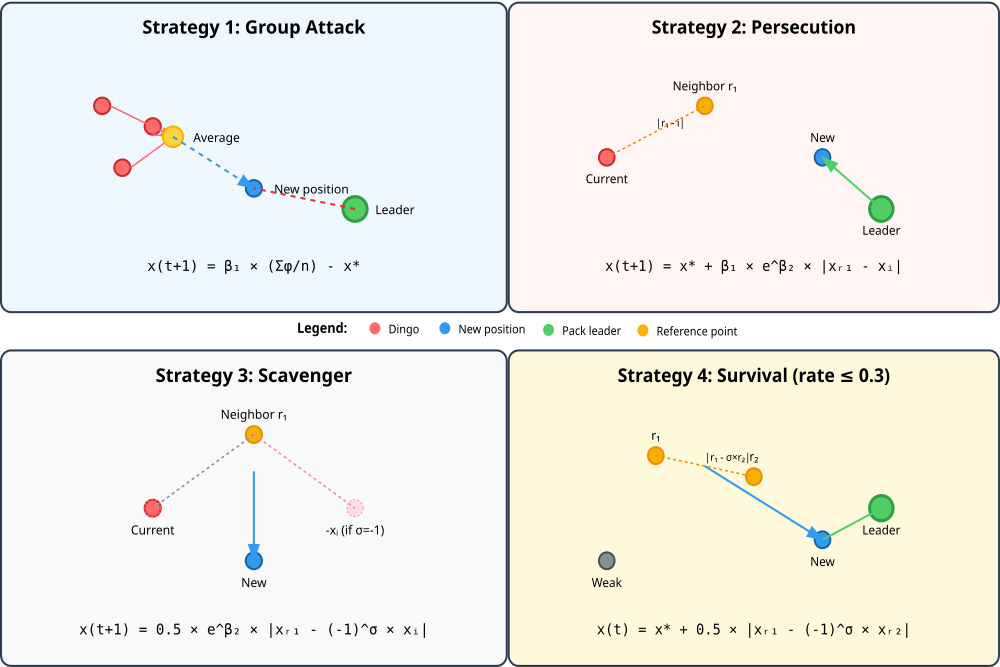
Figura 1. Modelado matemático de las estrategias de caza del dingo
Tras un análisis detallado, pasemos a escribir el código. La clase «C_AO_DOA_dingo» implementa el algoritmo de optimización del dingo (DOA) y deriva de la clase más general «C_AO», lo que implica que cuenta con funcionalidad heredada para dar soporte a los algoritmos de optimización. Características principales de la clase.
Parámetros del algoritmo:- popSize — determina el tamaño de la «población» (el número de «dingos»).
- P — representa la probabilidad de elegir entre dos estrategias de comportamiento del dingo: caza o búsqueda de carroña.
- Q — determina la probabilidad de ataque en grupo o persecución de la presa.
Inicialización: el método «Init()» es el punto de entrada para inicializar el algoritmo; acepta los intervalos de valores admisibles de los parámetros, sus pasos de variación y el número de épocas (ciclos de funcionamiento del algoritmo).
Ciclo principal:
- Moving () — este método implementa la fase principal de «movimiento» o búsqueda de una solución por parte del algoritmo, en la que los agentes (dingos) interactúan y se desplazan por el espacio de búsqueda.
- Revision () — este método se encarga de «revisar» las decisiones tomadas, evaluar los resultados y ajustar el comportamiento de los agentes.
- survival — array que almacena los índices de supervivencia de cada agente.
- attackVector — array que se utiliza para almacenar los índices de los agentes que participan en el ataque.
- UpdateSurvivalRates () — actualiza los índices de supervivencia de los agentes.
- GroupAttack () — implementa la estrategia de ataque en grupo.
- Persecution () — describe el proceso de persecución de la presa.
- Scavenger () — implementa el comportamiento de búsqueda de carroña.
- SurvivalProcedure () — ejecuta el procedimiento relacionado con la supervivencia del agente.
En general, la clase «C_AO_DOA_dingo» simula el comportamiento de una manada de dingos, utilizando sus instintos naturales de caza, búsqueda de carroña e interacción en grupo para resolver problemas de optimización. Cuenta con un sistema flexible de parámetros que permite ajustar su comportamiento y utiliza una serie de métodos internos para simular los procesos que conducen a la búsqueda de la solución óptima.
//————————————————————————————————————————————————————————————————————
class C_AO_DOA_dingo : public C_AO
{
  public: //----------------------------------------------------------
  ~C_AO_DOA_dingo () { }
  C_AO_DOA_dingo ()
  {
    ao_name = "DOA";
    ao_desc = "Dingo Optimization Algorithm";
    ao_link = "https://www.mql5.com/ru/articles/19458";

    popSize = 50;     // tamaño de la población (número de dingos)
    P       = 0.5;    // probabilidad de caza o de búsqueda de carroña
    Q       = 0.7;    // probabilidad de ataque en grupo o persecución

    ArrayResize (params, 3);

    params [0].name = "popSize"; params [0].val = popSize;
    params [1].name = "P";       params [1].val = P;
    params [2].name = "Q";       params [2].val = Q;
  }

  void SetParams ()
  {
    popSize = (int)params [0].val;
    P       = params [1].val;
    Q       = params [2].val;
  }

  bool Init (const double &rangeMinP  [],
             const double &rangeMaxP  [],
             const double &rangeStepP [],
             const int     epochsP = 0);

  void Moving   ();
  void Revision ();

  //------------------------------------------------------------------
  double P;          // probabilidad de caza o de búsqueda de carroña
  double Q;          // probabilidad de ataque en grupo o persecución

  private: //---------------------------------------------------------
  double survival []; // array de índices de supervivencia
  int    attackVector []; // array para almacenar los índices de los atacantes

  // Métodos auxiliares
  void UpdateSurvivalRates ();
  void GroupAttack         (int agentIdx, int na, double beta1);
  void Persecution         (int agentIdx, double beta1, double beta2);
  void Scavenger           (int agentIdx, double beta2);
  void SurvivalProcedure   (int agentIdx);
};
//————————————————————————————————————————————————————————————————————
El método «Init» es el punto de entrada para la inicialización del algoritmo DOA. Realiza las siguientes tareas clave:
Inicialización estándar:
- En la primera línea se invoca otro método, «StandardInit», que lleva a cabo las acciones comunes a todos los algoritmos de optimización para configurar los intervalos de búsqueda de los parámetros (rangeMinP, rangeMaxP) y los pasos de modificación de estos (rangeStepP).
- Si la inicialización estándar falla (devuelve «false»), el método también interrumpe su ejecución.
//————————————————————————————————————————————————————————————————————
//--- Inicialización
bool C_AO_DOA_dingo::Init (const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0)
{
  if (!StandardInit (rangeMinP, rangeMaxP, rangeStepP)) return false;

  ArrayResize     (survival, popSize);
  ArrayInitialize (survival, 1.0);

  // Reservamos el tamaño máximo para el vector de atacantes
  ArrayResize (attackVector, popSize / 2);

  return true;
}
//————————————————————————————————————————————————————————————————————
El método «Moving» es la función principal que ejecuta un paso iterativo del algoritmo. Modela el comportamiento de la población de «dingos» con el objetivo de encontrar la solución óptima.
Inicialización en la primera llamada: en la primera llamada, cuando la bandera «revision» está establecida en falso, el método asigna valores aleatorios a todos los parámetros (coordenadas) de cada individuo de la población. Los intervalos y los pasos de estos parámetros se establecen de antemano. Tras la inicialización, la bandera «revision» se establece en verdadero y el método finaliza en este paso.
Evaluación de la tasa de supervivencia: Si ya se ha realizado la inicialización, el método llama primero a una subrutina para actualizar los índices de «supervivencia» de todos los individuos de la población. Este indicador refleja en qué medida la solución actual (la posición del individuo) se ajusta al objetivo fijado o cuál es su grado de «aptitud». A continuación, el método recorre cada individuo de la población.
Se generan dos parámetros aleatorios para el individuo actual. Estos parámetros influyen en las características específicas de la estrategia de comportamiento elegida. Basándose en relaciones probabilísticas, el individuo elige una de las siguientes estrategias:- Probabilidad P — si el número aleatorio es menor que «P», el individuo pasa a la estrategia de «caza».
- Probabilidad Q (en el marco de la caza) — si el individuo ha elegido la «caza», con probabilidad «Q» aplica un «ataque en grupo». En un ataque en grupo, un individuo se desplaza teniendo en cuenta las posiciones de varios individuos más de la población. El número de otros individuos participantes se determina de forma aleatoria dentro de un intervalo determinado.
- Persecución (en el marco de la caza) — si un individuo ha elegido «caza», pero no «ataque en grupo» (con una probabilidad de 1-Q), aplica la estrategia de «persecución». Durante la persecución, el individuo se desplaza guiándose por las mejores soluciones y atacando a la «presa».
- Búsqueda de carroña (alternativa a la caza) — si el número aleatorio es mayor o igual que «P», el individuo elige la estrategia de «búsqueda de carroña». Esta estrategia simula la búsqueda de presas restantes o la exploración aleatoria del espacio de soluciones.
- Comprobación de la tasa de supervivencia y ajuste — tras aplicar la estrategia principal seleccionada (caza, persecución o búsqueda de carroña), el método comprueba la tasa de supervivencia del individuo en cuestión. Si la tasa de supervivencia es inferior a un umbral determinado (en este caso, 0,3), se aplica un «procedimiento de supervivencia» especial. Este procedimiento tiene como objetivo ayudar al individuo débil a mejorar sus indicadores o a sobrevivir mediante un cambio de posición.
De este modo, el método «Moving» controla la evolución de la población, permitiendo que cada individuo tome decisiones sobre su comportamiento, interactúe con los demás y se adapte a las condiciones, imitando el comportamiento natural de los dingos.
//————————————————————————————————————————————————————————————————————
//--- Paso principal del algoritmo
void C_AO_DOA_dingo::Moving ()
{
  // Inicialización de la población
  if (!revision)
  {
    for (int i = 0; i < popSize; i++)
    {
      for (int j = 0; j < coords; j++)
      {
        a [i].c [j] = u.RNDfromCI (rangeMin [j], rangeMax [j]);
        a [i].c [j] = u.SeInDiSp (a [i].c [j], rangeMin [j], rangeMax [j], rangeStep [j]);
      }
    }
    revision = true;
    return;
  }

  //------------------------------------------------------------------
  // Actualizamos los índices de supervivencia de toda la población
  UpdateSurvivalRates ();

  // Ciclo principal para todos los dingos
  for (int i = 0; i < popSize; i++)
  {
    // Generamos un valor beta para cada agente
    double beta1 = u.RNDfromCI (-2.0, 2.0);
    double beta2 = u.RNDfromCI (-1.0, 1.0);

    // Primero, elegimos una estrategia
    if (u.RNDprobab () < P)  // Caza
    {
      if (u.RNDprobab () < Q)  // Ataque en grupo
      {
        // Estrategia 1: Ataque en grupo (Eq. 2)
        int na = 2 + (int)((popSize / 2 - 2) * u.RNDprobab ());
        GroupAttack (i, na, beta1);
      }
      else  // Persecución
      {
        // Estrategia 2: Persecución (Eq. 3)
        Persecution (i, beta1, beta2);
      }
    }
    else  // Búsqueda de carroña
    {
      // Estrategia 3: Búsqueda de carroña (Eq. 4)
      Scavenger (i, beta2);
    }

    // Después de la estrategia principal, comprobamos la tasa de supervivencia
    if (survival [i] <= 0.3)
    {
      // Estrategia 4: Procedimiento de supervivencia para los individuos débiles (Eq. 6)
      SurvivalProcedure (i);
    }
  }
}
//————————————————————————————————————————————————————————————————————
El siguiente método «GroupAttack» implementa una de las principales estrategias de comportamiento del algoritmo: la Estrategia 1: Ataque en grupo. Modela una situación en la que un grupo de dingos se une para atacar.
Selección de los participantes en el ataque. El método determina en primer lugar cuántos individuos más (cantidad dinámica «na») participarán en el ataque junto con el individuo actual «agentIdx». A continuación, selecciona al azar «na» índices únicos de individuos de toda la población. Estos individuos seleccionados formarán el «grupo atacante». Es importante que los individuos seleccionados sean diferentes para evitar reutilizar el mismo individuo.
Aplicación de la fórmula de ataque. El método recorre cada coordenada (parámetro) de la solución «c». Para cada coordenada, calcula el valor medio de dicha coordenada entre todos los individuos que forman parte del grupo atacante. A continuación, utilizando ese valor medio, el parámetro «beta1» (que se generó anteriormente) y el valor «cB [c]» (que representa la mejor solución conocida hasta el momento), calcula un nuevo valor para la coordenada en cuestión del individuo actual «agentIdx». En la implementación mostrada, la actualización se calcula como cB[c] - beta1 * (sum / na) , aunque esto difiere de la forma teórica presentada arriba.
Una vez calculado el nuevo valor de la coordenada, se ajusta a los límites permitidos y al paso de discretización, de forma similar a como se hizo durante la inicialización.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 1: Ataque en grupo (Equación 2)
void C_AO_DOA_dingo::GroupAttack (int agentIdx, int na, double beta1)
{
  // x_i(t+1) = beta1 * [sum(phi_k(t))/na] - x*(t)

  // Formamos un subconjunto de dingos atacantes
  ArrayResize (attackVector, na);
  int count = 0;

  while (count < na)
  {
    int idx = u.RNDintInRange (0, popSize - 1);

    bool unique = true;
    for (int j = 0; j < count; j++)
    {
      if (attackVector [j] == idx)
      {
        unique = false;
        break;
      }
    }

    if (unique)
    {
      attackVector [count++] = idx;
    }
  }

  // Aplicamos la fórmula
  for (int c = 0; c < coords; c++)
  {
    double sum = 0.0;

    for (int j = 0; j < na; j++)
    {
      sum += a [attackVector [j]].c [c];
    }

    //a [agentIdx].c [c] = beta1 * (sum / na) - cB [c];
    a [agentIdx].c [c] = cB [c] - beta1 * (sum / na);
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «Persecution» (Persecución) implementa la Estrategia 2, basada en el principio de «perseguir» a un determinado objetivo. Esta estrategia está diseñada para actualizar la posición de un individuo concreto dentro de la población. El método selecciona primero al azar otro individuo de la población. Este individuo se denominará «atacante» (r1). Es importante que el individuo atacante no sea el mismo individuo que estamos actualizando (es decir, «agentIdx» no debe coincidir con «r1»).
La estrategia «Persecution» intenta desplazar al individuo objetivo (agentIdx) en la dirección determinada por la combinación de la mejor solución encontrada (cB) y la diferencia entre otro individuo aleatorio y el propio individuo objetivo.
- cB (la mejor solución) garantiza que el movimiento se dirija hacia la mejor solución conocida.
- beta1 y exp(beta2): estos parámetros controlan la «intensidad» o el «alcance» del paso de persecución. Un valor mayor de «beta1» o «beta2» provocará desplazamientos más significativos.
- |x_r1 (t) - x_i (t)| (diferencia) determina a qué distancia se encuentra el otro individuo. Cuanto mayor sea la diferencia, más intenso será el efecto de la persecución.
De este modo, esta estrategia simula el comportamiento en el que un individuo (o, más bien, sus acciones) intenta «alcanzar» o acercarse a otro individuo igualmente aleatorio, pero toda esta dinámica se desplaza hacia la mejor solución encontrada en la población.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 2: Persecución (Equation 3)
void C_AO_DOA_dingo::Persecution (int agentIdx, double beta1, double beta2)
{
  // x_i(t+1) = x*(t) + beta1 * exp(beta2) * |x_r1(t) - x_i(t)|

  int r1;
  do
  {
    r1 = u.RNDintInRange (0, popSize - 1);
  }
  while (r1 == agentIdx);

  double expBeta2 = MathExp (beta2);

  for (int c = 0; c < coords; c++)
  {
    double diff = MathAbs (a [r1].c [c] - a [agentIdx].c [c]);
    a [agentIdx].c [c] = cB [c] + beta1 * expBeta2 * diff;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «Scavenger» describe la Estrategia 3: búsqueda de carroña, imitando el comportamiento de un individuo (un dingo) que busca restos. En primer lugar, el método selecciona al azar otro individuo (r1) de toda la población. Este individuo se convierte en una referencia para la búsqueda. El individuo seleccionado no puede ser el mismo que el individuo actual que está realizando la búsqueda. Para determinar la dirección de la búsqueda se utiliza el signo aleatorio «sigma». Este signo puede ser +1 o -1; se elige al azar. Esto añade un elemento de imprevisibilidad a la dirección de búsqueda.
A continuación, para cada característica (coordenada) de la solución, se calcula la diferencia entre el valor de dicha característica en otro individuo y en el individuo actual, multiplicada por un signo «sigma» elegido al azar. Esto significa que la posición actual del individuo se suma o se resta de la posición de otro individuo. De esta diferencia se toma el valor absoluto (MathAbs) para obtener la magnitud de la distancia.
Esta diferencia absoluta se multiplica por la mitad de la exponencial de «beta2»; este parámetro, al aparecer en el exponente, determina la intensidad con la que variará la posición. El multiplicador 0,5 escala este efecto. El valor resultante de la multiplicación se convierte en la nueva coordenada del individuo actual. Al igual que en otros métodos, el nuevo valor de la coordenada se limita posteriormente a los límites permitidos, definidos por «rangeMin», «rangeMax» y «rangeStep».
La estrategia de «búsqueda de carroña» impulsa al individuo a desplazarse una distancia que depende de la diferencia entre su propia posición y la de otro individuo, y esta dirección puede ser tanto «hacia delante» como «hacia atrás» respecto del individuo actual, determinada por el signo aleatorio «sigma». La intensidad de este desplazamiento también se regula mediante el parámetro «beta2». Esta estrategia añade un elemento de búsqueda más aleatoria y, quizá, menos dirigida, simulando el comportamiento de un individuo que puede seguir el rastro de una presa o buscar carroña.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 3: Búsqueda de carroña (Equation 4)
void C_AO_DOA_dingo::Scavenger (int agentIdx, double beta2)
{
  // x_i(t+1) = 0,5 * exp(beta2) * |x_r1(t) - (-1)^sigma * x_i(t)|

  int r1;
  do
  {
    r1 = u.RNDintInRange (0, popSize - 1);
  }
  while (r1 == agentIdx);

  double sigma = u.RNDbool () ? 1.0 : -1.0;
  double halfExpBeta2 = 0.5 * MathExp (beta2);

  for (int c = 0; c < coords; c++)
  {
    double diff = MathAbs (a [r1].c [c] - sigma * a [agentIdx].c [c]);
    a [agentIdx].c [c] = halfExpBeta2 * diff;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «SurvivalProcedure» describe la Estrategia 4: Procedimiento de supervivencia. Simula una situación en la que un individuo (un dingo) reajusta su posición con el fin de sobrevivir o mejorar sus posibilidades, basándose en la posición de los demás individuos.
El método selecciona dos individuos distintos (r1 y r2) de la población, cada uno de los cuales debe ser diferente del individuo actual que está llevando a cabo el procedimiento de supervivencia (agentIdx). Además, estos dos individuos seleccionados deben ser diferentes entre sí.
Para cada característica (coordenada) se produce un cambio aleatorio de signo (sigma). Este signo puede ser +1 o -1; se elige al azar. Esto determina si el segundo individuo (r2) participa en el cálculo de forma directa o con un valor invertido. Para cada coordenada:
- se calcula la diferencia entre las características correspondientes del primer individuo seleccionado (a [r1].c [c]) y del segundo individuo (a [r2].c [c]), a la que se aplica el signo aleatorio «sigma»;
- se toma el valor absoluto de esa diferencia «diff»;
- la diferencia absoluta obtenida se multiplica por 0,5;
- A la mejor solución conocida hasta el momento (cB [c]) se le suma la mitad de esa diferencia. Esto significa que la nueva posición del individuo se desplaza desde la mejor solución en la dirección determinada por la diferencia entre los otros dos individuos. El nuevo valor calculado se convierte en la nueva coordenada para el individuo actual;
- Al igual que en los métodos anteriores, el valor de la coordenada obtenido se corrige posteriormente para que se mantenga dentro de los límites admisibles.
La estrategia «Procedimiento de supervivencia» consiste en un mecanismo mediante el cual un individuo actualiza su posición utilizando la información proporcionada por otros dos individuos. La actualización de la posición se produce como un desplazamiento respecto a la mejor solución actual (cB), y la magnitud y la dirección de dicho desplazamiento dependen de la diferencia entre las posiciones de dos individuos aleatorios. Esto puede interpretarse como la búsqueda de un «nicho» o un «recurso» que se encuentra en algún punto intermedio entre otros dos individuos, pero con cierto grado de aleatoriedad a la hora de determinar hacia dónde dirigirse exactamente.
//————————————————————————————————————————————————————————————————————
//--- Estrategia 4: Procedimiento de supervivencia (Equation 6)
void C_AO_DOA_dingo::SurvivalProcedure (int agentIdx)
{
  // x_i(t) = x*(t) + 0,5 * |x_r1(t) - (-1)^sigma * x_r2(t)|

  int r1, r2;

  r1 = u.RNDintInRange (0, popSize - 1);
  while (r1 == agentIdx)
  {
    r1 = u.RNDintInRange (0, popSize - 1);
  }

  r2 = u.RNDintInRange (0, popSize - 1);
  while (r2 == agentIdx || r2 == r1)
  {
    r2 = u.RNDintInRange (0, popSize - 1);
  }

  double sigma = u.RNDbool () ? 1.0 : -1.0;

  for (int c = 0; c < coords; c++)
  {
    double diff = MathAbs (a [r1].c [c] - sigma * a [r2].c [c]);
    a [agentIdx].c [c] = cB [c] + 0.5 * diff;
    a [agentIdx].c [c] = u.SeInDiSp (a [agentIdx].c [c], rangeMin [c], rangeMax [c], rangeStep [c]);
  }
}
//————————————————————————————————————————————————————————————————————
El método «UpdateSurvivalRates» se encarga de la actualización de los índices de supervivencia de cada individuo de la población. Se trata de un paso importante que ayuda a determinar la probabilidad de que cada individuo pueda «sobrevivir» y mantener su posición (o, por el contrario, ser descartado) en el proceso evolutivo.
En primer lugar, el método recorre todos los individuos de la población para determinar los dos valores extremos: la aptitud mínima (minFitness) y la aptitud máxima (maxFitness). En este caso, el primer individuo se toma como estimación inicial para estos valores. A continuación, se calcula el rango (range) entre la aptitud máxima y la mínima. Este rango refleja la variabilidad en el éxito de las soluciones en la población actual.
Si el rango de aptitud es igual a cero (lo que significa que todos los individuos tienen la misma aptitud), la tasa de supervivencia de cada individuo se establece en 0,5. En este caso, se parte de la hipótesis de que todos los individuos tienen las mismas posibilidades de sobrevivir, ya que no hay un líder claro ni un rezagado.
Si el rango de aptitud no es igual a cero, se calcula para cada individuo su tasa de supervivencia (survival [i]) mediante la fórmula: (aptitud máxima — aptitud del individuo actual) / rango de aptitud.
El método normaliza la aptitud de cada individuo en relación con los mejores y peores individuos de la población, transformándola en un índice que luego utilizarán otras partes del algoritmo para decidir qué individuos deben cambiar su posición de forma más activa y cuáles deben conservarla.
//————————————————————————————————————————————————————————————————————
//--- Actualización de los índices de supervivencia (Equation 5)
void C_AO_DOA_dingo::UpdateSurvivalRates ()
{
  // survival(i) = (fitness_max - fitness(i)) / (fitness_max - fitness_min)

  double minFitness = a [0].f;
  double maxFitness = a [0].f;

  for (int i = 1; i < popSize; i++)
  {
    if (a [i].f < minFitness) minFitness = a [i].f;
    if (a [i].f > maxFitness) maxFitness = a [i].f;
  }

  double range = maxFitness - minFitness;

  if (range < DBL_EPSILON)
  {
    ArrayInitialize (survival, 0.5);
  }
  else
  {
    for (int i = 0; i < popSize; i++)
    {
      survival [i] = (maxFitness - a [i].f) / range;
    }
  }
}
//————————————————————————————————————————————————————————————————————
El método «Revision» es de vital importancia para la mayoría de los algoritmos heurísticos de optimización. Su objetivo es conservar la mejor solución encontrada hasta ese momento (o en cualquier momento anterior). Esto garantiza que el algoritmo no «se olvide» de una buena solución, aunque otros individuos evolucionen y, tal vez, encuentren soluciones que temporalmente parezcan menos exitosas. De este modo, «fB» y «cB» siempre almacenan la mejor aptitud encontrada y sus coordenadas correspondientes.
//————————————————————————————————————————————————————————————————————
//--- Actualización de la mejor solución
void C_AO_DOA_dingo::Revision ()
{
  for (int i = 0; i < popSize; i++)
  {
    if (a [i].f > fB)
    {
      fB = a [i].f;
      ArrayCopy (cB, a [i].c, 0, 0, WHOLE_ARRAY);
    }
  }
}
//————————————————————————————————————————————————————————————————————
Tras implementar este método de optimización tan prometedor y polifacético, por fin podemos pasar a la fase de pruebas.
Resultados de las pruebas
Según los resultados de las pruebas, el algoritmo alcanza el 35 % del 100 % posible; lamentablemente, las expectativas no se han cumplido del todo.
=============================
5 Hilly's; Func runs: 10000; result: 0.49066480903390775
25 Hilly's; Func runs: 10000; result: 0.399914179876301
500 Hilly's; Func runs: 10000; result: 0.35798310869836164
=============================
5 Forest's; Func runs: 10000; result: 0.29643143556801427
25 Forest's; Func runs: 10000; result: 0.20458050042664944
500 Forest's; Func runs: 10000; result: 0.17091405461356773
=============================
5 Megacity's; Func runs: 10000; result: 0.36615384615384616
25 Megacity's; Func runs: 10000; result: 0.4489230769230771
500 Megacity's; Func runs: 10000; result: 0.45393846153845924
=============================
All score: 3.18950 (35.44%)
En la visualización del complejo patrón de movimiento de los agentes se puede observar cómo cambian las estrategias del algoritmo. En general, la extraña distribución de los individuos-agentes a lo largo de la «diagonal» del espacio de búsqueda apunta a un posible error en la lógica interna del algoritmo cometido por los autores.
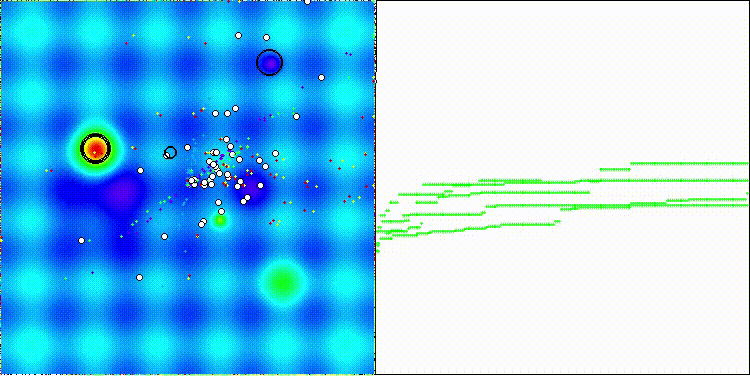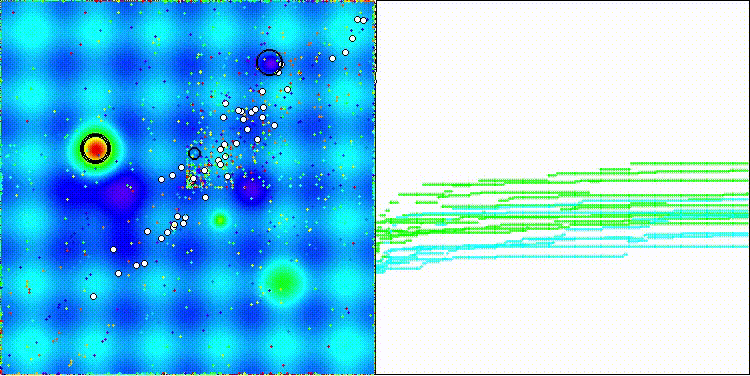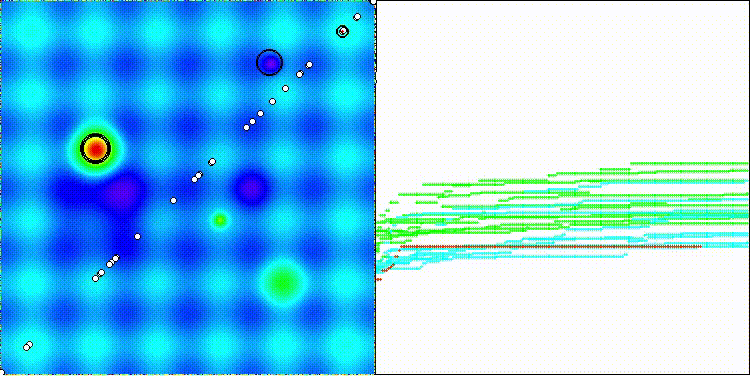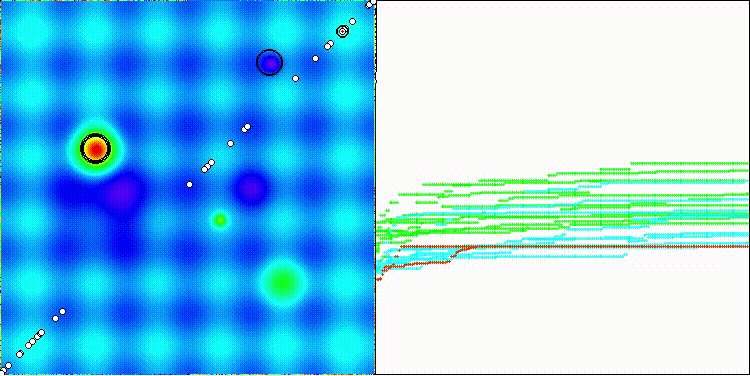
DOA_dingo en la función de prueba Hilly
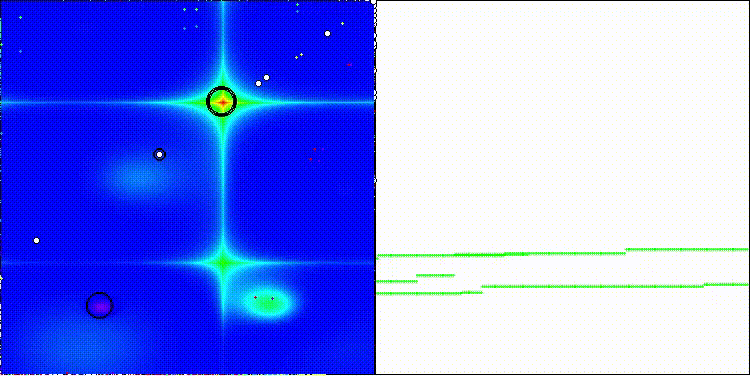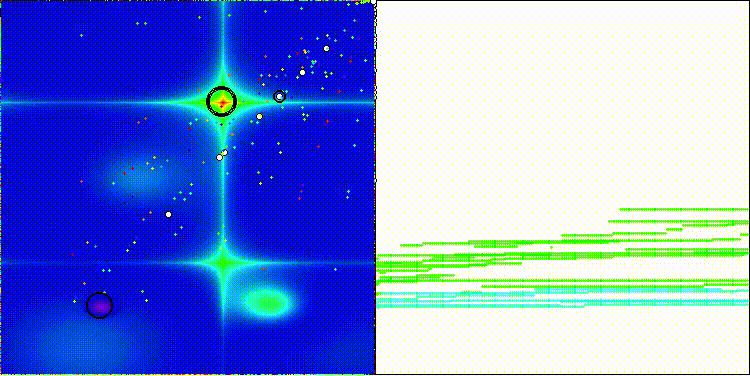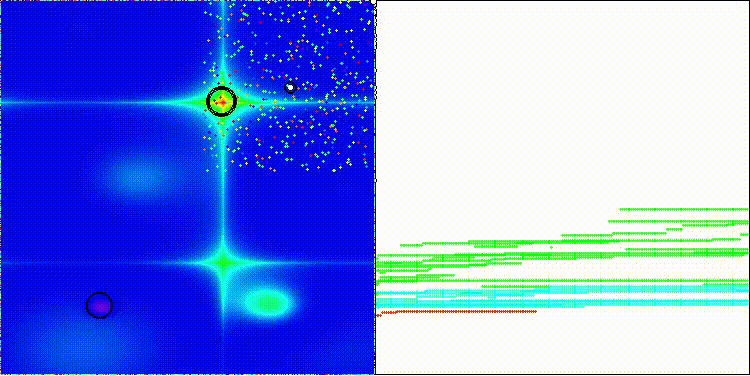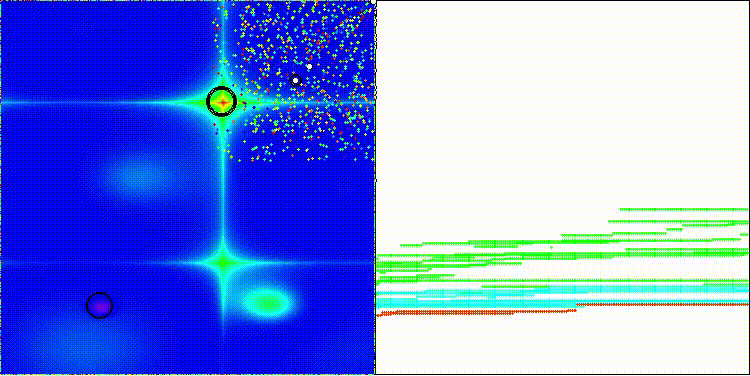
DOA_dingo en la función de prueba Forest
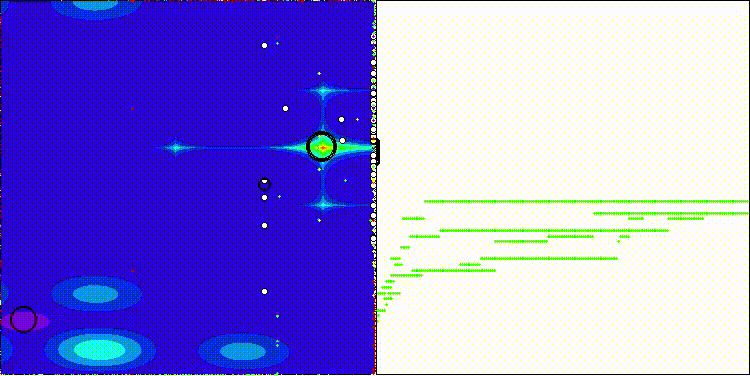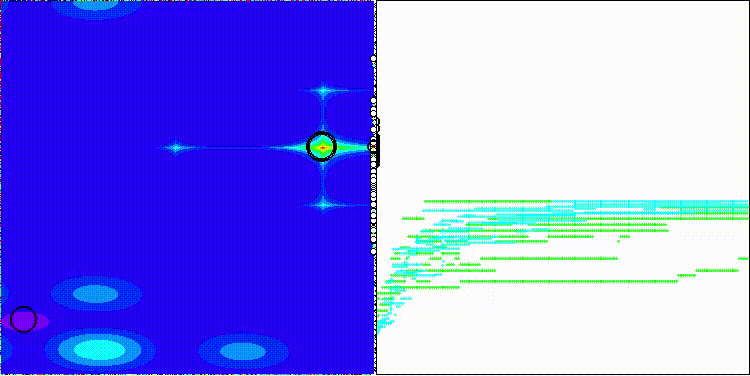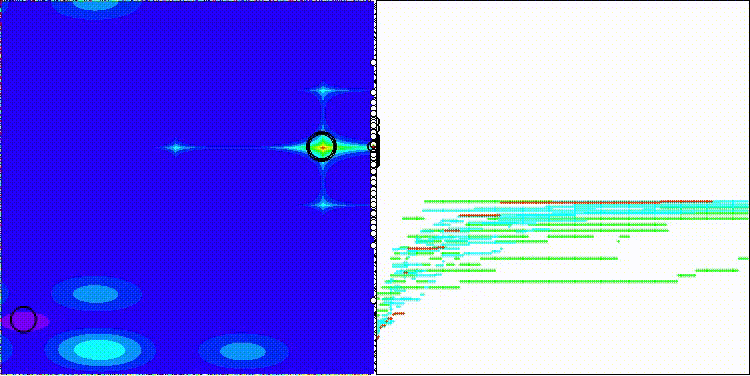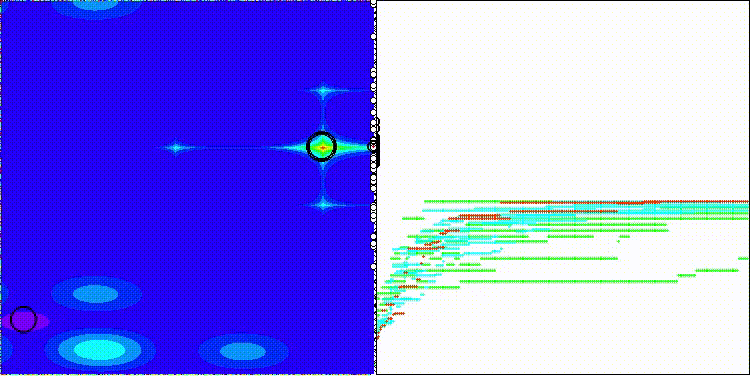
DOA_dingo en la función de prueba Megacity
En la tabla de clasificación, el algoritmo DOA_dingo se presenta con fines informativos tras las pruebas realizadas.
| N.º | AO | Descripción | Hilly | Hilly Final | Forest | Forest Final | Megacity (discreta) | Megacity Final | Final Resultado | % de MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | across neighbourhood search | 0,94948 | 0,84776 | 0,43857 | 2,23581 | 1,00000 | 0,92334 | 0,39988 | 2,32323 | 0,70923 | 0,63477 | 0,23091 | 1,57491 | 6,134 | 68,15 |
| 2 | CLA | code lock algorithm (joo) | 0,95345 | 0,87107 | 0,37590 | 2,20042 | 0,98942 | 0,91709 | 0,31642 | 2,22294 | 0,79692 | 0,69385 | 0,19303 | 1,68380 | 6,107 | 67,86 |
| 3 | AMOm | animal migration optimization M | 0,90358 | 0,84317 | 0,46284 | 2,20959 | 0,99001 | 0,92436 | 0,46598 | 2,38034 | 0,56769 | 0,59132 | 0,23773 | 1,39675 | 5,987 | 66,52 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,92256 | 0,88101 | 0,40021 | 2,20379 | 0,97750 | 0,87490 | 0,31945 | 2,17185 | 0,67385 | 0,62985 | 0,18634 | 1,49003 | 5,866 | 65,17 |
| 5 | CTA | comet tail algorithm (joo) | 0,95346 | 0,86319 | 0,27770 | 2,09435 | 0,99794 | 0,85740 | 0,33949 | 2,19484 | 0,88769 | 0,56431 | 0,10512 | 1,55712 | 5,846 | 64,96 |
| 6 | TETA | time evolution travel algorithm (joo) | 0,91362 | 0,82349 | 0,31990 | 2,05701 | 0,97096 | 0,89532 | 0,29324 | 2,15952 | 0,73462 | 0,68569 | 0,16021 | 1,58052 | 5,797 | 64,41 |
| 7 | SDSm | stochastic diffusion search M | 0,93066 | 0,85445 | 0,39476 | 2,17988 | 0,99983 | 0,89244 | 0,19619 | 2,08846 | 0,72333 | 0,61100 | 0,10670 | 1,44103 | 5,709 | 63,44 |
| 8 | BOAm | billiards optimization algorithm M | 0,95757 | 0,82599 | 0,25235 | 2,03590 | 1,00000 | 0,90036 | 0,30502 | 2,20538 | 0,73538 | 0,52523 | 0,09563 | 1,35625 | 5,598 | 62,19 |
| 9 | AAm | archery algorithm M | 0,91744 | 0,70876 | 0,42160 | 2,04780 | 0,92527 | 0,75802 | 0,35328 | 2,03657 | 0,67385 | 0,55200 | 0,23738 | 1,46323 | 5,548 | 61,64 |
| 10 | ESG | evolution of social groups (joo) | 0,99906 | 0,79654 | 0,35056 | 2,14616 | 1,00000 | 0,82863 | 0,13102 | 1,95965 | 0,82333 | 0,55300 | 0,04725 | 1,42358 | 5,529 | 61,44 |
| 11 | SIA | simulated isotropic annealing (joo) | 0,95784 | 0,84264 | 0,41465 | 2,21513 | 0,98239 | 0,79586 | 0,20507 | 1,98332 | 0,68667 | 0,49300 | 0,09053 | 1,27020 | 5,469 | 60,76 |
| 12 | EOm | extremal_optimization_M | 0,76166 | 0,77242 | 0,31747 | 1,85155 | 0,99999 | 0,76751 | 0,23527 | 2,00277 | 0,74769 | 0,53969 | 0,14249 | 1,42987 | 5,284 | 58,71 |
| 13 | BBO | biogeography based optimization | 0,94912 | 0,69456 | 0,35031 | 1,99399 | 0,93820 | 0,67365 | 0,25682 | 1,86867 | 0,74615 | 0,48277 | 0,17369 | 1,40261 | 5,265 | 58,50 |
| 14 | ACS | artificial cooperative search | 0,75547 | 0,74744 | 0,30407 | 1,80698 | 1,00000 | 0,88861 | 0,22413 | 2,11274 | 0,69077 | 0,48185 | 0,13322 | 1,30583 | 5,226 | 58,06 |
| 15 | DA | dialectical algorithm | 0,86183 | 0,70033 | 0,33724 | 1,89940 | 0,98163 | 0,72772 | 0,28718 | 1,99653 | 0,70308 | 0,45292 | 0,16367 | 1,31967 | 5,216 | 57,95 |
| 16 | BHAm | black hole algorithm M | 0,75236 | 0,76675 | 0,34583 | 1,86493 | 0,93593 | 0,80152 | 0,27177 | 2,00923 | 0,65077 | 0,51646 | 0,15472 | 1,32195 | 5,196 | 57,73 |
| 17 | ASO | anarchy society optimization | 0,84872 | 0,74646 | 0,31465 | 1,90983 | 0,96148 | 0,79150 | 0,23803 | 1,99101 | 0,57077 | 0,54062 | 0,16614 | 1,27752 | 5,178 | 57,54 |
| 18 | RFO | royal flush optimization (joo) | 0,83361 | 0,73742 | 0,34629 | 1,91733 | 0,89424 | 0,73824 | 0,24098 | 1,87346 | 0,63154 | 0,50292 | 0,16421 | 1,29867 | 5,089 | 56,55 |
| 19 | AOSm | atomic orbital search M | 0,80232 | 0,70449 | 0,31021 | 1,81702 | 0,85660 | 0,69451 | 0,21996 | 1,77107 | 0,74615 | 0,52862 | 0,14358 | 1,41835 | 5,006 | 55,63 |
| 20 | TSEA | turtle shell evolution algorithm (joo) | 0,96798 | 0,64480 | 0,29672 | 1,90949 | 0,99449 | 0,61981 | 0,22708 | 1,84139 | 0,69077 | 0,42646 | 0,13598 | 1,25322 | 5,004 | 55,60 |
| 21 | BSA | backtracking_search_algorithm | 0,97309 | 0,54534 | 0,29098 | 1,80941 | 0,99999 | 0,58543 | 0,21747 | 1,80289 | 0,84769 | 0,36953 | 0,12978 | 1,34700 | 4,959 | 55,10 |
| 22 | DE | differential evolution | 0,95044 | 0,61674 | 0,30308 | 1,87026 | 0,95317 | 0,78896 | 0,16652 | 1,90865 | 0,78667 | 0,36033 | 0,02953 | 1,17653 | 4,955 | 55,06 |
| 23 | SRA | successful restaurateur algorithm (joo) | 0,96883 | 0,63455 | 0,29217 | 1,89555 | 0,94637 | 0,55506 | 0,19124 | 1,69267 | 0,74923 | 0,44031 | 0,12526 | 1,31480 | 4,903 | 54,48 |
| 24 | CRO | chemical reaction optimisation | 0,94629 | 0,66112 | 0,29853 | 1,90593 | 0,87906 | 0,58422 | 0,21146 | 1,67473 | 0,75846 | 0,42646 | 0,12686 | 1,31178 | 4,892 | 54,36 |
| 25 | BIO | blood inheritance optimization (joo) | 0,81568 | 0,65336 | 0,30877 | 1,77781 | 0,89937 | 0,65319 | 0,21760 | 1,77016 | 0,67846 | 0,47631 | 0,13902 | 1,29378 | 4,842 | 53,80 |
| 26 | DOA | dream_optimization_algorithm | 0,85556 | 0,70085 | 0,37280 | 1,92921 | 0,73421 | 0,48905 | 0,24147 | 1,46473 | 0,77231 | 0,47354 | 0,18561 | 1,43146 | 4,825 | 53,62 |
| 27 | BSA | bird swarm algorithm | 0,89306 | 0,64900 | 0,26250 | 1,80455 | 0,92420 | 0,71121 | 0,24939 | 1,88479 | 0,69385 | 0,32615 | 0,10012 | 1,12012 | 4,809 | 53,44 |
| 28 | DEA | dolphin_echolocation_algorithm | 0,75995 | 0,67572 | 0,34171 | 1,77738 | 0,89582 | 0,64223 | 0,23941 | 1,77746 | 0,61538 | 0,44031 | 0,15115 | 1,20684 | 4,762 | 52,91 |
| 29 | HS | harmony search | 0,86509 | 0,68782 | 0,32527 | 1,87818 | 0,99999 | 0,68002 | 0,09590 | 1,77592 | 0,62000 | 0,42267 | 0,05458 | 1,09725 | 4,751 | 52,79 |
| 30 | SSG | saplings sowing and growing | 0,77839 | 0,64925 | 0,39543 | 1,82308 | 0,85973 | 0,62467 | 0,17429 | 1,65869 | 0,64667 | 0,44133 | 0,10598 | 1,19398 | 4,676 | 51,95 |
| 31 | BCOm | bacterial chemotaxis optimization M | 0,75953 | 0,62268 | 0,31483 | 1,69704 | 0,89378 | 0,61339 | 0,22542 | 1,73259 | 0,65385 | 0,42092 | 0,14435 | 1,21912 | 4,649 | 51,65 |
| 32 | ABO | african buffalo optimization | 0,83337 | 0,62247 | 0,29964 | 1,75548 | 0,92170 | 0,58618 | 0,19723 | 1,70511 | 0,61000 | 0,43154 | 0,13225 | 1,17378 | 4,634 | 51,49 |
| 33 | (PO)ES | (PO) evolution strategies | 0,79025 | 0,62647 | 0,42935 | 1,84606 | 0,87616 | 0,60943 | 0,19591 | 1,68151 | 0,59000 | 0,37933 | 0,11322 | 1,08255 | 4,610 | 51,22 |
| 34 | FBA | fractal-based Algorithm | 0,79000 | 0,65134 | 0,28965 | 1,73099 | 0,87158 | 0,56823 | 0,18877 | 1,62858 | 0,61077 | 0,46062 | 0,12398 | 1,19537 | 4,555 | 50,61 |
| 35 | TSm | tabu search M | 0,87795 | 0,61431 | 0,29104 | 1,78330 | 0,92885 | 0,51844 | 0,19054 | 1,63783 | 0,61077 | 0,38215 | 0,12157 | 1,11449 | 4,536 | 50,40 |
| 36 | BSO | brain storm optimization | 0,93736 | 0,57616 | 0,29688 | 1,81041 | 0,93131 | 0,55866 | 0,23537 | 1,72534 | 0,55231 | 0,29077 | 0,11914 | 0,96222 | 4,498 | 49,98 |
| 37 | WOAm | wale optimization algorithm M | 0,84521 | 0,56298 | 0,26263 | 1,67081 | 0,93100 | 0,52278 | 0,16365 | 1,61743 | 0,66308 | 0,41138 | 0,11357 | 1,18803 | 4,476 | 49,74 |
| 38 | AEFA | artificial electric field algorithm | 0,87700 | 0,61753 | 0,25235 | 1,74688 | 0,92729 | 0,72698 | 0,18064 | 1,83490 | 0,66615 | 0,11631 | 0,09508 | 0,87754 | 4,459 | 49,55 |
| 39 | AEO | artificial ecosystem-based optimization algorithm | 0,91380 | 0,46713 | 0,26470 | 1,64563 | 0,90223 | 0,43705 | 0,21400 | 1,55327 | 0,66154 | 0,30800 | 0,28563 | 1,25517 | 4,454 | 49,49 |
| 40 | CAm | camel algorithm M | 0,78684 | 0,56042 | 0,35133 | 1,69859 | 0,82772 | 0,56041 | 0,24336 | 1,63149 | 0,64846 | 0,33092 | 0,13418 | 1,11356 | 4,444 | 49,37 |
| 41 | ACOm | ant colony optimization M | 0,88190 | 0,66127 | 0,30377 | 1,84693 | 0,85873 | 0,58680 | 0,15051 | 1,59604 | 0,59667 | 0,37333 | 0,02472 | 0,99472 | 4,438 | 49,31 |
| 42 | CMAES | covariance_matrix_adaptation_evolution_strategy | 0,76258 | 0,72089 | 0,00000 | 1,48347 | 0,82056 | 0,79616 | 0,00000 | 1,61672 | 0,75846 | 0,49077 | 0,00000 | 1,24923 | 4,349 | 48,33 |
| 43 | DA_duelist | duelist_algorithm | 0,92782 | 0,53778 | 0,27792 | 1,74352 | 0,86957 | 0,47536 | 0,18193 | 1,52686 | 0,62153 | 0,33569 | 0,11715 | 1,07437 | 4,345 | 48,28 |
| 44 | BFO-GA | bacterial foraging optimization - ga | 0,89150 | 0,55111 | 0,31529 | 1,75790 | 0,96982 | 0,39612 | 0,06305 | 1,42899 | 0,72667 | 0,27500 | 0,03525 | 1,03692 | 4,224 | 46,93 |
| 45 | SOA | simple optimization algorithm | 0,91520 | 0,46976 | 0,27089 | 1,65585 | 0,89675 | 0,37401 | 0,16984 | 1,44060 | 0,69538 | 0,28031 | 0,10852 | 1,08422 | 4,181 | 46,45 |
| DOA_dingo | dingo_optimization_algorithm | 0,49066 | 0,39991 | 0,35798 | 1,24855 | 0,29643 | 0,20458 | 0,17091 | 0,67192 | 0,36615 | 0,44892 | 0,45394 | 1,26901 | 3,189 | 35,44 | |
| RW | random walk | 0,48754 | 0,32159 | 0,25781 | 1,06694 | 0,37554 | 0,21944 | 0,15877 | 0,75375 | 0,27969 | 0,14917 | 0,09847 | 0,52734 | 2,348 | 26,09 | |
Conclusiones
En este artículo hemos analizado un interesante algoritmo de optimización, que destaca por los enfoques que utiliza. A primera vista, el algoritmo puede no parecer la forma más acertada de encontrar la solución óptima. Sin embargo, en el transcurso de numerosos experimentos se puso de manifiesto un potencial inesperado: si se perfeccionan adecuadamente las ideas en las que se basa el DOA, el algoritmo es capaz de ofrecer resultados muy satisfactorios, a la altura de los mejores métodos poblacionales.
¿Qué es lo que se descubrió exactamente? Lo contaremos en el próximo artículo. Además, a los aficionados a la optimización más atentos les espera un pequeño regalo: en el archivo se puede encontrar una pequeña modificación en el código del algoritmo que ya ha influido considerablemente en los resultados; pueden comentarlo en los comentarios.
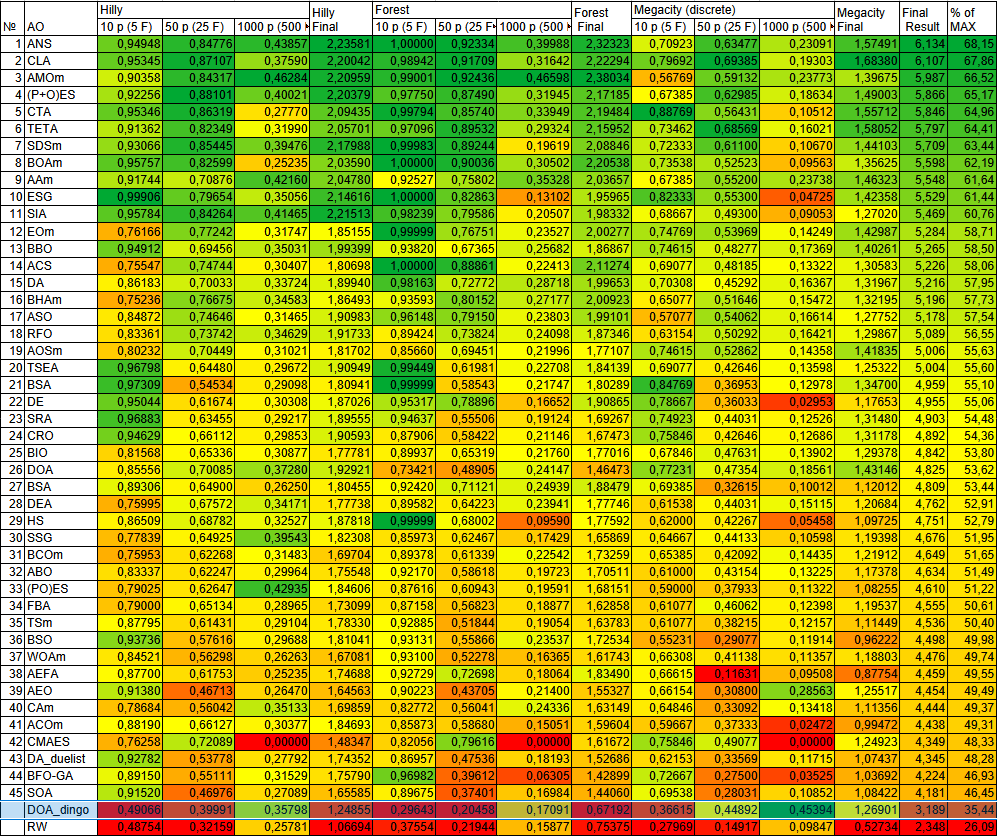
Figura 2. Gradación cromática de los algoritmos según las pruebas correspondientes
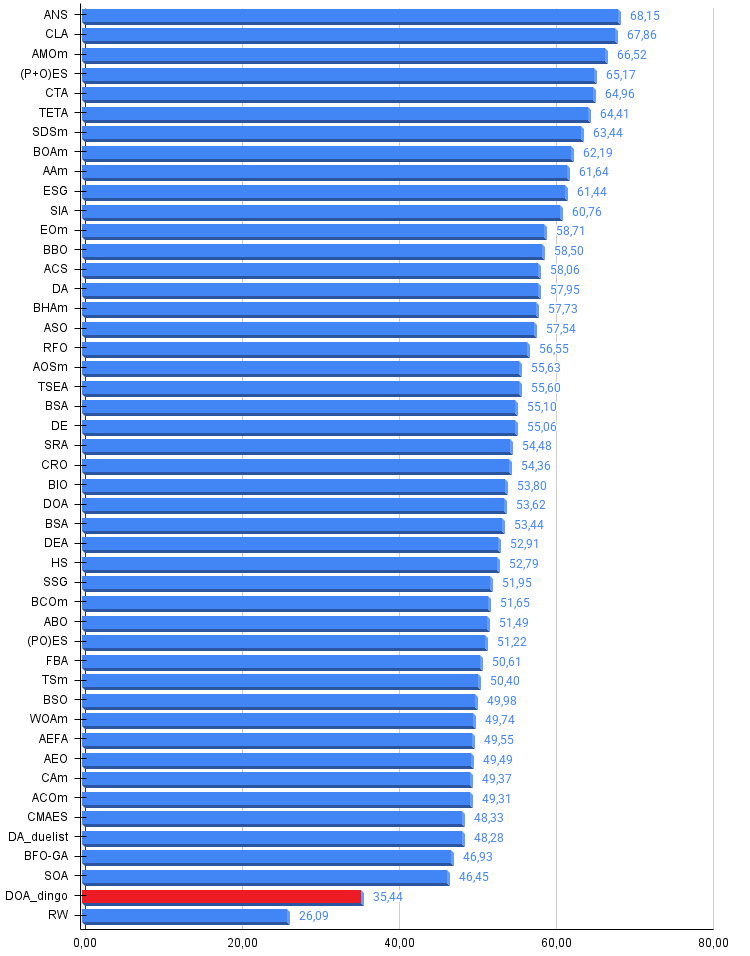
Figura 3. Histograma de los resultados de las pruebas de los algoritmos (en una escala de 0 a 100; cuanto mayor sea el valor, mejor; donde 100 es el resultado teórico máximo posible; en el archivo se incluye el script para calcular la tabla de clasificación)
Ventajas y desventajas del algoritmo DOA_dingo:
Ventajas:
- Es rápido.
Desventajas:
- La dispersión de los resultados.
- La exploración deficiente del espacio de búsqueda.
Se adjunta al artículo un archivo comprimido con las versiones actualizadas de los códigos de los algoritmos. El autor del artículo no se hace responsable de la exactitud absoluta en la descripción de los algoritmos canónicos, ya que en muchos de ellos se han introducido modificaciones para mejorar las capacidades de búsqueda. Las conclusiones y los juicios expuestos en los artículos se basan en los resultados de los experimentos realizados.
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | #C_AO.mqh | Archivo de inclusión | Clase base de los algoritmos de optimización poblacional |
| 2 | #C_AO_enum.mqh | Archivo de inclusión | Enumeración de algoritmos de optimización poblacional |
| 3 | TestFunctions.mqh | Archivo de inclusión | Biblioteca de funciones de prueba |
| 4 | TestStandFunctions.mqh | Archivo de inclusión | Biblioteca de funciones del banco de pruebas |
| 5 | Utilities.mqh | Archivo de inclusión | Biblioteca de funciones auxiliares |
| 6 | CalculationTestResults.mqh | Archivo de inclusión | Script para calcular los resultados destinados a la tabla comparativa |
| 7 | Testing AOs.mq5 | Script | Banco de pruebas unificado para todos los algoritmos de optimización poblacional |
| 8 | Simple use of population optimization algorithms.mq5 | Script | Ejemplo sencillo de uso de algoritmos de optimización poblacional sin visualización |
| 9 | Test_AO_DOA_dingo.mq5 | Script | Banco de pruebas para DOA_dingo |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19458
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del básico al intermedio: Sobrecarga de operadores (VI)
 Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Extralonger)
 Red neuronal en la práctica: El caso de la puerta XOR
 Trading algorítmico de arbitraje basado en la teoría de grafos

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso