Redes neuronales en el trading: Entrenamiento de modelos de picos profundos (Integración de picos)
 28
 0

Introducción
Los mercados financieros han sido siempre un escenario de lucha entre opuestos: el orden y el caos, el cálculo racional y los arrebatos emocionales irracionales. Recuerdan a un mar agitado, en cuya superficie se aprecia el juego de las olas —las fluctuaciones de los precios—, mientras que bajo el agua se ocultan corrientes complejas: los factores fundamentales, los cambios macroeconómicos y el estado de ánimo de los participantes. En este mundo, todo trader, inversor o investigador busca la clave para comprender los patrones del mercado. Algunos se basan en la intuición, otros en fórmulas rigurosas, pero en las últimas décadas se ha prestado cada vez más atención a la inteligencia artificial y a las arquitecturas de redes neuronales.
Las redes neuronales clásicas, diseñadas para el procesamiento de imágenes y audio, parecían herramientas universales. Sin embargo, cuando las trasladamos al ámbito de las series temporales financieras, especialmente en el caso de datos de alta frecuencia, surgen contradicciones fundamentales. El mercado no es una curva suave de una función, sino un flujo de acontecimientos: operaciones, órdenes, picos de volatilidad y altibajos de liquidez. Se trata de una serie de golpes discretos de un metrónomo, en la que cada tick del precio puede considerarse un impulso. Precisamente por eso, las redes neuronales de picos (SNN, Spiking Neural Networks) han despertado el interés de los investigadores en los últimos años. Están más cerca de la propia naturaleza del mercado, donde todo se mide por la sucesión de acontecimientos en el tiempo.
Sin embargo, el paso de los modelos clásicos a los de picos no es solo un detalle técnico, sino un cambio cualitativo de paradigma. Lo que funciona en el mundo de las activaciones suaves puede resultar inútil en un contexto de picos. Un claro ejemplo es la famosa arquitectura ResNet. En su versión clásica, ResNet supuso una revolución en el aprendizaje automático, al permitir construir decenas e incluso cientos de capas sin perder capacidad de aprendizaje. El secreto residía en las conexiones de atajo, que permitían que la señal y el gradiente atravesaran la red casi sin distorsiones.
Y aquí es importante destacar lo siguiente. En una ResNet estándar, la conexión de atajo no es una vía que evite la capa sin modificar la señal. También se somete a la función de activación ReLU. Sin embargo, dado que ReLU es positiva y continua, la conexión de atajo transmite la señal casi sin alteraciones y los gradientes circulan libremente. Es precisamente esta característica la que ha convertido a ResNet en un símbolo de profundidad y estabilidad.
La situación es totalmente diferente en los modelos de picos. En este caso, la activación es un impulso binario. La conexión de atajo, al pasar por la función de activación por picos, pierde su carácter de función identidad. La binarización destruye la propia idea de la conexión de atajo como canal directo. Como consecuencia, la profundidad deja de funcionar: los gradientes o bien se atenúan o bien se vuelven inestables, y la red pierde su capacidad de aprendizaje. Ante este problema, los autores de SEW-ResNet propusieron una solución que puede calificarse a la vez de sencilla y genial.
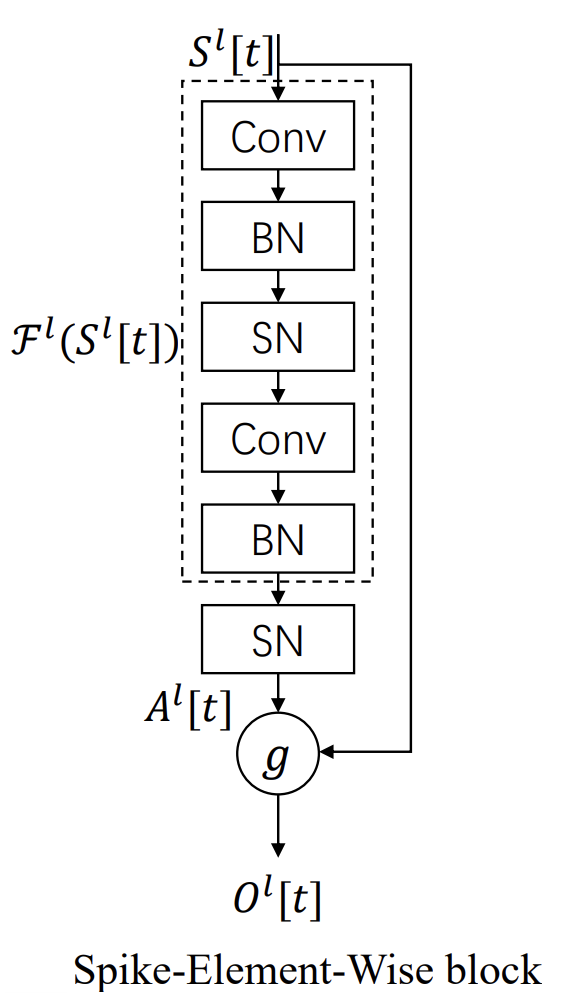
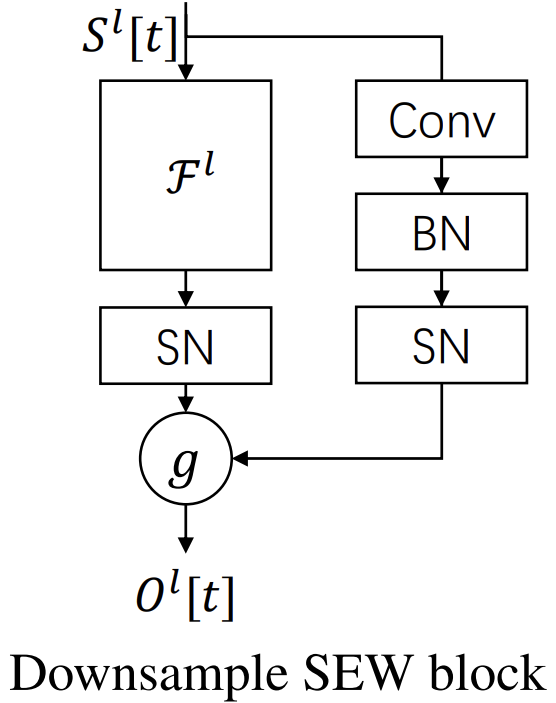
Dejaron la conexión de atajo fuera de la función de activación. En lugar de hacerla pasar por una activación binaria, mantuvieron la conexión de atajo al margen de esta y la combinaron con el resultado de la transformación residual después de la activación, definiendo esta combinación mediante una operación independiente elemento a elemento. De este modo, la conexión de atajo recupera su verdadera función. Actúa realmente como una función identidad, y la señal no se pierde en la dinámica discreta.
Este cambio parece mínimo, pero sus consecuencias son enormes. Ahora, los modelos de picos profundos vuelven a ser entrenables. Esto significa que se pueden construir modelos con decenas de capas y esperar que funcionen con la misma estabilidad que sus predecesores en el mundo de las redes clásicas.
Además, los autores de SEW-ResNet ampliaron el concepto de conexión de atajo. En la ResNet clásica, la operación de combinación estaba fijada de forma rígida: se trataba de una simple suma. En SEW-ResNet hay margen para elegir: suma, AND lógico, su inversión y otras funciones g(•,•). Esto abre un nuevo capítulo en el diseño de arquitecturas. La conexión de atajo se puede adaptar a una tarea concreta.
En el ámbito financiero, esto resulta especialmente valioso. Imaginemos el mercado de divisas. Los impulsos breves provocados por las noticias se superponen a las tendencias a largo plazo determinadas por la política de los bancos centrales. Las acciones se caracterizan por las fluctuaciones estacionales y la influencia de los resultados trimestrales, mientras que las criptomonedas, por los aumentos repentinos de actividad en sus comunidades y las actualizaciones tecnológicas. No basta con una única arquitectura para todos los procesos: se necesita flexibilidad. SEW-ResNet la ofrece. Se puede elegir una conexión de atajo que capte mejor las características de un activo concreto.
Para el trader y el investigador, esto supone un nuevo nivel de calidad en el análisis. Si los métodos clásicos solo permiten captar la temperatura media del mercado, SEW-ResNet ofrece la posibilidad de percibir simultáneamente los rápidos ticks del mercado y los movimientos a largo plazo. La conexión de atajo se convierte en una especie de canal de memoria fiable que evita que el modelo olvide lo que ha ocurrido anteriormente y, al mismo tiempo, le permite percibir nuevos acontecimientos.
SEW-ResNet puede considerarse un paso importante en la evolución de los modelos de picos. Se trata de un restablecimiento fundamental del mecanismo clave de la profundidad en condiciones de dinámica binaria.
A continuación se muestra una representación del framework elaborada por el autor.
En la parte práctica del artículo anterior nos centramos en los elementos fundamentales de una neurona de picos adaptada a las series temporales financieras. Se prestó especial atención a dos mecanismos clave:
- umbrales de activación entrenables;
- puertas de acumulación del potencial de membrana.
El umbral de activación entrenable permitirá a la neurona regular de forma flexible su sensibilidad a los impulsos de entrada. En la terminología del mercado, esto se asemeja a una adaptación a la volatilidad. La neurona aprende a distinguir entre las fluctuaciones del precio debidas al ruido y los acontecimientos realmente significativos. Gracias a ello, incluso en un mercado muy volátil, el modelo sigue siendo capaz de reaccionar únicamente ante señales significativas, evitando un exceso de picos falsos.
Las puertas de acumulación del potencial de membrana permiten controlar la integración de los eventos analizados. En lugar de limitarse a sumar los picos entrantes, la neurona controla la acumulación del potencial y el momento en que este da lugar a la generación de un pico. Esta característica permitirá al modelo construir una memoria temporal: registrar secuencias de eventos relevantes y tomar la decisión de generar un pico solo cuando la señal acumulada supere el umbral adaptado al contexto actual del mercado.
Estos mecanismos se han implementado en la neurona de picos básica, creando una plataforma para construir arquitecturas más complejas.
Optimización de un programa OpenCL
Hoy vamos a continuar el trabajo iniciado. Pero antes de seguir adelante con la implementación de los enfoques propuestos por los autores del framework SEW-ResNet, hagamos un pequeño paréntesis y prestemos atención a otra característica importante de los modelos de picos: el silencio de la neurona hasta que se produce un evento. Esta propiedad permite reducir considerablemente los costes computacionales, ya que la neurona espera la señal y no gasta recursos en procesar entradas vacías. En los algoritmos que hemos implementado anteriormente, una entrada nula no supone ningún ahorro de recursos. La operación de multiplicar por cero se realizaba cada vez, aunque el resultado se conocía de antemano.
En los modelos clásicos de redes neuronales, este comportamiento está plenamente justificado. Una entrada nula es algo poco habitual, una excepción a la regla, y la introducción de un control adicional a menudo solo complica y ralentiza los cálculos. Pero los modelos de picos funcionan de otra manera. En este caso, la mayoría de las entradas son nulas en cada instante, ya que solo son relevantes algunos eventos concretos: breves impulsos en medio del silencio. Por lo tanto, añadir un punto de control que permita omitir las operaciones con ceros resulta una solución lógica y justificada.
Si establecemos un paralelismo con los mercados financieros, el silencio de una neurona se asemeja a la «calma» que se observa en un gráfico entre los picos de actividad de negociación. En los periodos en los que el mercado está tranquilo, cada tick del precio aporta poca información, y analizar cada uno de ellos supondría un desperdicio de recursos. La neurona de picos se comporta de manera similar. Permanece inactiva hasta que recibe una señal que contenga información relevante. En cuanto se produce un evento (un repentino aumento del volumen, una ruptura de un nivel o un impulso provocado por noticias), la neurona reacciona al instante. Este enfoque ahorra recursos computacionales y mejora la robustez de la red frente al ruido, filtrando los cambios insignificantes que no aportan ningún valor.
Sin embargo, con el fin de preservar la versatilidad de los componentes de nuestra biblioteca, no hemos creado nuevos objetos, sino que hemos optado por añadir puntos de control a los algoritmos existentes. Empecemos por la pasada directa de la capa totalmente conectada, donde se han introducido los cambios más significativos en el kernel del programa OpenCL.
En primer lugar, se ha añadido una comprobación de los valores iguales a cero en los datos analizados. En segundo lugar, hemos prescindido del bucle clásico que recorre todos los datos de entrada en un único hilo. En su lugar, los cálculos se distribuyen entre los hilos del grupo de trabajo y los resultados se suman una vez que todos los hilos han finalizado su trabajo. Este enfoque aumenta considerablemente la eficiencia y permite aprovechar las capacidades de procesamiento paralelo de la GPU.
__kernel void FeedForward(__global const float *matrix_w,
                          __global const float *matrix_i,
                          __global float *matrix_o,
                          const int inputs,
                          const int activation
                         )
  {
   const int i = get_global_id(0);
   const int total_out = get_global_size(0);
   const int loc = get_local_id(1);
   const int total_loc = get_local_size(1);
El algoritmo del kernel comienza determinando el identificador global del hilo actual. A cada neurona de la capa le corresponde un grupo de trabajo independiente formado por hilos agrupados según la primera dimensión del espacio de tareas. Esto permite calcular las salidas de todas las neuronas en paralelo.
A continuación, determinamos el identificador local del hilo en el grupo de trabajo y el número total de hilos del grupo. Esto es importante para distribuir los cálculos entre varios hilos, con el fin de acelerar el procesamiento de grandes volúmenes de datos analizados.
El array local Temp se utiliza para almacenar sumas parciales dentro del grupo de trabajo. Permite coordinar los hilos mientras cada hilo calcula la parte que le corresponde de los productos de las entradas por los pesos.
__local float Temp[LOCAL_ARRAY_SIZE];
A continuación, se crean variables locales para acumular la suma (sum) y almacenar temporalmente el valor de entrada (inp). La variable shift determina el desplazamiento en la matriz de pesos para la neurona actual. Dado que los pesos se almacenan en un array plano, el desplazamiento permite acceder correctamente a los elementos correspondientes a una neurona concreta.
   float sum = 0;
   float inp;
   int shift = RCtoFlat(i, 0, total_out, (inputs + 1), 1);
Una vez finalizados los preparativos, creamos el bucle principal para calcular la suma de las entradas multiplicadas por sus pesos. Aquí conservamos el bucle como medida de respaldo para procesar tensores de datos de entrada que superen el tamaño permitido del grupo de trabajo. A cada hilo se le asigna su propio conjunto de entradas, lo que permite distribuir el trabajo.
   for(int k = loc; k < inputs; k += total_loc)
     {
      inp = IsNaNOrInf(matrix_i[k], 0.0f);
      if(inp == 0.0f)
         continue;
En el cuerpo del bucle, primero extraemos el valor del búfer de datos de entrada. Cada iteración toma la siguiente señal de entrada. Si obtenemos un valor igual a cero, pasamos inmediatamente a la siguiente iteración, sin realizar más operaciones. Este enfoque permite evitar los costosos accesos a la memoria global para leer los pesos, así como la propia operación de multiplicación. La comprobación de valores iguales a cero convierte el ciclo en un filtro inteligente que se centra únicamente en los eventos relevantes, lo que ahorra recursos computacionales y agiliza el análisis de los datos de mercado.
Cuando se recibe una señal significativa, sumamos los productos de las entradas y los pesos.
      sum += IsNaNOrInf(inp * matrix_w[shift + k], 0.0f);
     }
   if(loc == 0)
      sum += IsNaNOrInf(matrix_w[shift + inputs], 0.0f);
Una vez finalizadas todas las iteraciones del ciclo, solo un hilo del grupo de trabajo añade el sesgo. Luego sumamos todos los resultados parciales de los hilos del grupo de trabajo utilizando el array local Temp. Esto garantiza la correcta combinación de los resultados de los cálculos en paralelo.
   sum = LocalSum(sum, 1, Temp);
//---
   if(loc == 0)
      matrix_o[i] = fActivation(sum, activation);
  }
Por último, se aplica la función de activación seleccionada a la suma obtenida.
Este enfoque mantiene la versatilidad de la capa y permite integrarla posteriormente en modelos clásicos y de picos más complejos, sin alterar la arquitectura de la red. Al mismo tiempo, ahorramos recursos y aceleramos el procesamiento al analizar picos, donde muchas entradas pueden valer cero en cada paso, lo que refleja los periodos de calma en el mercado.
Cabe señalar que la incorporación de grupos de trabajo modifica el espacio de ejecución del kernel. Por consiguiente, para que el objeto funcione correctamente, es necesario realizar algunas modificaciones puntuales en el método que se encarga de poner el kernel en la cola de ejecución.
bool CNeuronBaseOCL::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(CheckPointer(OpenCL) == POINTER_INVALID || CheckPointer(NeuronOCL) == POINTER_INVALID)
      return false;
   uint global_work_offset[2] = { 0, 0 };
   uint global_work_size[2] = { Output.Total(),
                                (uint)MathMin((NeuronOCL.Neurons() + 3) / 4, OpenCL.GetMaxLocalSize(1))
                              };
   uint local_work_size[2] = { 1, global_work_size[1] };
//---
   const int kernel = def_k_FeedForward;
   setBuffer(kernel, def_k_ff_matrix_w, NeuronOCL.getWeightsIndex())
   setBuffer(kernel, def_k_ff_matrix_i, NeuronOCL.getOutputIndex())
   setBuffer(kernel, def_k_ff_matrix_o, Output.GetIndex())
   setArgument(kernel, def_k_ff_inputs, NeuronOCL.Neurons())
   setArgument(kernel, def_k_ff_activation, (int)activation)
//---
   kernelExecuteLoc(kernel, global_work_offset, global_work_size, local_work_size)
//---
   return true;
  }
También añadimos una comprobación similar de valores iguales a cero en el kernel de la pasada directa de la capa convolucional. Sin embargo, en este caso no usamos grupos de trabajo. Esto se debe a que se supone que los núcleos de convolución son relativamente pequeños y, en este caso, la distribución de los cálculos entre los hilos no supone una aceleración significativa.
No obstante, la comprobación de las entradas con valor cero sigue siendo de vital importancia. Permite evitar operaciones innecesarias de multiplicación y accesos a la memoria global, incluso en las capas convolucionales, lo que ahorra recursos al procesar grandes volúmenes de series temporales financieras.
__kernel void FeedForwardConv(__global const float *matrix_w,
                              __global const float *matrix_i,
                              __global float *matrix_o,
                              const int inputs,
                              const int step,
                              const int window_in,
                              const int window_out,
                              const int activation
                             )
  {
   const size_t i = get_global_id(0);
   const int out = get_global_id(1);
   const size_t v = get_global_id(2);
   const size_t outputs = get_global_size(0);
//---
   const int shift_out = window_out * i;
   const int shift_in = step * i;
//---
   const int shift_var_in = v * inputs;
   const int shift_var_out = v * window_out * outputs;
   const int shift_var_w = v * window_out * (window_in + 1);
//---
   float sum = 0;
   float inp;
//---
   int shift = (window_in + 1) * out;
   int stop = (window_in <= (inputs - shift_in) ? window_in : (inputs - shift_in));
   for(int k = 0; k < stop; k ++)
     {
      inp = IsNaNOrInf(matrix_i[shift_var_in + shift_in + k], 0.0f);
      if(inp == 0.0f)
         continue;
      sum += IsNaNOrInf(inp * matrix_w[shift_var_w + shift + k], 0.0f);
     }
   sum += IsNaNOrInf(matrix_w[shift_var_w + shift + window_in], 0.0f);
//---
   matrix_o[shift_var_out + out + shift_out] = fActivation(sum, activation);;
  }
De este modo, la comprobación de entradas con valor cero se convierte en una herramienta de optimización universal, aplicable tanto a las capas totalmente conectadas como a las capas convolucionales, que preserva la eficiencia y la precisión del modelo.
Módulo Spike ResNeXt Bottleneck
Tras optimizar los algoritmos existentes, retomamos la implementación de los enfoques propuestos por los autores del framework SEW-ResNet. Sin embargo, nos desviaremos ligeramente del trabajo original e incorporaremos las soluciones propuestas a la arquitectura ResNeXt.
La elección de ResNeXt se debe a sus características. Combina las ventajas de ResNet (bloques residuales y conexiones de atajo) con el concepto de bloques ramificados, que permiten procesar en paralelo varias rutas independientes. Esta arquitectura aporta una mayor flexibilidad y mejora la capacidad de la red para extraer características.
La incorporación de bloques SEW en ResNeXt abre nuevas posibilidades para trabajar con series temporales financieras. Gracias a sus múltiples vías paralelas, el modelo puede ahora procesar diversos aspectos de los datos analizados. Unas registran los impulsos a corto plazo y los picos de volatilidad; otras captan las tendencias a largo plazo; la conexión de atajo, situada fuera de la activación por picos, conserva la integridad de la señal, mientras que los umbrales de activación entrenables y las puertas de acumulación del potencial de membrana garantizan la adaptación a las condiciones concretas del mercado.
De este modo, obtenemos una arquitectura híbrida que combina las ideas de SEW-ResNet y ResNeXt, capaz de analizar de forma profunda y eficaz las series temporales financieras, reduciendo los cálculos superfluos y aumentando la resistencia al ruido.
Comenzamos creando el módulo Bottleneck dentro de la clase CNeuronSpikeResNeXtBottleneck, que hereda la funcionalidad de la neurona de picos básica con activación CNeuronSpikeActivation. Este objeto se convierte en un componente fundamental para la integración de bloques SEW en la arquitectura ResNeXt.
class CNeuronSpikeResNeXtBottleneck :  public CNeuronSpikeActivation
  {
protected:
   CLayer            cBottleneck;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;


public:
                     CNeuronSpikeResNeXtBottleneck(void) {};
                    ~CNeuronSpikeResNeXtBottleneck(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint chanels_in, uint chanels_out, uint units_in,
                          uint units_out, uint group_size, uint groups,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSpikeResNeXtBottleneck;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
Dentro de la clase se define el objeto cBottleneck, un array dinámico que se rellena con punteros a los componentes de la arquitectura de la ruta principal de procesamiento de datos.
Hay que prestar especial atención al carácter dinámico de la arquitectura. No es fija, sino que depende totalmente del conjunto de parámetros que el usuario establezca durante la inicialización. Por eso hemos descartado una lista fija de componentes internos y utilizamos un array dinámico que se genera sobre la marcha durante el proceso de inicialización.
El proceso de inicialización se lleva a cabo en el método Init. Es precisamente aquí donde se crea y se rellena el array cBottleneck, formando, bloque a bloque, la ruta principal de procesamiento de señales y garantizando la flexibilidad de la arquitectura del objeto.
bool CNeuronSpikeResNeXtBottleneck::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                         uint chanels_in, uint chanels_out, uint units_in,
                                         uint units_out, uint group_size, uint groups,
                                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeActivation::Init(numOutputs, myIndex, open_cl, chanels_out * units_out, optimization_type, batch))
      return false;
El proceso comienza con la inicialización de la neurona de picos básica mediante la llamada al método homónimo de la clase padre, lo que establece los parámetros generales de la capa, el número de salidas y el modo de optimización. A continuación, se crean punteros locales a distintos tipos de componentes.
   CNeuronConvOCL *conv = NULL;
   CNeuronMultiWindowsConvOCL *mwconv = NULL;
   CNeuronBatchNormOCL *norm = NULL;
   CNeuronSpikeActivation *spike = NULL;
   CNeuronTransposeOCL* transp = NULL;
Una vez finalizados los trabajos preparatorios, pasamos a la inicialización propiamente dicha de los componentes internos. En primer lugar, se crea un bloque de proyección de los datos de entrada, en el que la señal se proyecta en la representación interna de la neurona. Se crea e inicializa una capa convolucional con los parámetros especificados para los canales, los grupos y el tamaño de la secuencia analizada.
   cBottleneck.Clear();
   cBottleneck.SetOpenCL(OpenCL);
//--- Projection in
   uint index = 0;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, chanels_in, chanels_in, group_size * groups, units_in, 1, optimization, iBatch) ||
      !cBottleneck.Add(conv))
     {
      DeleteObj(conv)
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
A continuación, se añade BatchNorm para normalizar los resultados y una activación por picos, que permite que la neurona reaccione únicamente ante eventos significativos, ignorando los ceros debidos al ruido.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cBottleneck.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
   norm.SetActivationFunction(None);
   index++;
   spike = new CNeuronSpikeActivation();
   if(!spike ||
      !spike.Init(0, index, OpenCL, norm.Neurons(), optimization, iBatch) ||
      !cBottleneck.Add(spike))
     {
      DeleteObj(spike)
      return false;
     }
Después se crea el bloque Feature Extraction. Aquí se crean neuronas convolucionales multicanal, diseñadas para realizar operaciones de convolución por grupos, tal y como proponen los autores de la arquitectura ResNeXt. A los resultados de la convolución se les aplican sucesivamente la función de activación SoftPlus, la normalización por lotes y la activación por picos.
//--- Feature Extraction
   index++;
   uint windows[];
   if(ArrayResize(windows, groups) < (int)groups)
      return false;
   ArrayFill(windows, 0, groups, group_size);
   mwconv = CNeuronMultiWindowsConvOCL();
   if(!mwconv ||
      !mwconv.Init(0, index, OpenCL, windows, group_size, groups, units_in, optimization, iBatch) ||
      !cBottleneck.Add(mwconv))
     {
      DeleteObj(mwconv)
      return false;
     }
   mwconv.SetActivationFunction(SoftPlus);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, mwconv.Neurons(), iBatch, optimization) ||
      !cBottleneck.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
   norm.SetActivationFunction(None);
   index++;
   spike = new CNeuronSpikeActivation();
   if(!spike ||
      !spike.Init(0, index, OpenCL, norm.Neurons(), optimization, iBatch) ||
      !cBottleneck.Add(spike))
     {
      DeleteObj(spike)
      return false;
     }
Este bloque cumple una función clave. Extrae características de la señal analizada, formando patrones estables y ricos en información que, a continuación, se transmiten a través de las ramificaciones de ResNeXt. De este modo, Feature Extraction permite centrarse en los eventos significativos y adaptarse a los distintos patrones que se dan en las series temporales financieras.
La siguiente etapa es la proyección de los resultados. La señal se agrega al pasar por la capa convolucional y por BatchNorm.
//--- Projection out
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, group_size * groups, group_size * groups, chanels_out, units_in,
                                                                           1, optimization, iBatch) ||
      !cBottleneck.Add(conv))
     {
      DeleteObj(conv)
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cBottleneck.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
   norm.SetActivationFunction(None);
En este punto, conviene prestar atención a la flexibilidad de la arquitectura del objeto. Se ha previsto la posibilidad de modificar en la salida tanto la dimensionalidad de las características como la longitud de la secuencia.
Si la longitud de la secuencia no varía, el proceso de inicialización del objeto finaliza aquí. En este caso, la activación final de los datos se realizará mediante la funcionalidad de la clase padre, lo que garantizará la coherencia con el resto de los componentes de la red.
   if(units_in == units_out)
      return true;
Sin embargo, si es necesario modificar la longitud de la secuencia, hay que añadir algunos objetos más que garanticen la correcta transformación de la forma de los tensores. En primer lugar, añadimos una activación por picos, que preparará los valores obtenidos en el paso anterior.
   index++;
   spike = new CNeuronSpikeActivation();
   if(!spike ||
      !spike.Init(0, index, OpenCL, norm.Neurons(), optimization, iBatch) ||
      !cBottleneck.Add(spike))
     {
      DeleteObj(spike)
      return false;
     }
A continuación viene el bloque de proyección de la longitud de la secuencia. En primer lugar, los datos se transponen de una serie temporal a una secuencia de características.
//--- Projection units
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, units_in, chanels_out, optimization, iBatch) ||
      !cBottleneck.Add(transp))
     {
      DeleteObj(transp)
      return false;
     }
El bloque convolucional ajusta la longitud de la secuencia correspondiente a cada característica al tamaño especificado.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, units_in, units_in, units_out, chanels_out, 1, optimization, iBatch) ||
      !cBottleneck.Add(conv))
     {
      DeleteObj(conv)
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
Los valores obtenidos se normalizan y se realiza la transposición inversa, que devuelve el tensor a la representación de una secuencia temporal multimodal, pero con la longitud ya ajustada.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cBottleneck.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
   norm.SetActivationFunction(None);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, chanels_out, units_out, optimization, iBatch) ||
      !cBottleneck.Add(transp))
     {
      DeleteObj(transp)
      return false;
     }
//---
   return true;
  }
Cada componente se añade al array dinámico cBottleneck y, ante cualquier error de inicialización, el objeto se elimina de forma segura mediante DeleteObj, lo que evita las fugas de memoria.
El resultado es un módulo versátil y flexible, capaz de procesar series temporales financieras, filtrar el ruido, tener en cuenta los eventos poco frecuentes y trabajar con diferentes configuraciones del modelo. Además, la arquitectura dinámica permite adaptar la neurona a tareas concretas, manteniendo la eficacia y la precisión del análisis.
Durante el proceso de inicialización del objeto, obtuvimos una arquitectura compleja y estructurada del mismo, que incluye numerosos componentes: neuronas convolucionales, convoluciones multicanal, normalización y activación por picos. Sin embargo, el uso de un array dinámico de punteros a los componentes internos permite ocultar toda esta complejidad a la hora de implementar los algoritmos de pasada directa y pasada inversa.
Aunque el análisis abarca múltiples facetas, el flujo de datos sigue siendo lineal. La señal pasa sucesivamente por todos los bloques internos. Esto significa que, para una pasada directa, basta con recorrer en un bucle todos los componentes del array cBottleneck, transmitiendo la señal de forma secuencial de un bloque a otro.
El método feedForward implementa el algoritmo de pasada directa. Al inicio del método se crean dos variables:
- prev, que apunta a la fuente de la señal de entrada,
- current, queirá recibiendo sucesivamente las referencias a cada bloque del array.
Inicialmente, prev hace referencia al objeto de datos de origen recibido en los parámetros del método.
bool CNeuronSpikeResNeXtBottleneck::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL *prev = NeuronOCL;
   CNeuronBaseOCL *current = NULL;
A continuación, se inicia el recorrido por todos los componentes del array dinámico en un bucle. En cada iteración, current obtiene una referencia al bloque correspondiente, ya sea una neurona convolucional, BatchNorm, una convolución multicanal o una activación por picos.
   for(int i = 0; i < cBottleneck.Total(); i++)
     {
      current = cBottleneck[i];
      if(!current ||
         !current. Feedforward(prev))
         return false;
      prev = current;
     }
Cada componente procesa secuencialmente la señal recibida del bloque anterior, realiza cálculos internos y devuelve el resultado. Si falta algún bloque o se produce un error durante el procesamiento, el método finaliza inmediatamente su ejecución y devuelve false. Una vez procesado correctamente el bloque actual, el puntero prev se actualiza y pasa a apuntar a él, lo que garantiza la transmisión de la señal al siguiente componente del array.
Al finalizar el ciclo, se invoca el método del mismo nombre de la clase padre, que lleva a cabo la activación final de los datos. Es precisamente aquí donde se generan los picos, teniendo en cuenta los umbrales entrenables y la acumulación del potencial de membrana, lo que permite a la neurona reaccionar únicamente ante eventos significativos.
   return CNeuronSpikeActivation::feedforward(prev);
  }
De este modo, incluso con una arquitectura del objeto compleja y estructurada, el flujo de datos sigue siendo lineal y controlable. El uso de un array dinámico oculta la complejidad interna, simplifica la implementación del algoritmo y permite añadir fácilmente nuevos componentes o modificar la arquitectura sin tener que reescribir la pasada directa.
Tras un análisis detallado del método feedForward, que garantiza una transmisión secuencial y lineal de la señal a través de todos los componentes internos del objeto, el siguiente paso lógico es organizar la retropropagación del error. En los modelos de picos, al igual que en las redes neuronales clásicas, la distribución correcta de los gradientes es de vital importancia. Permite que el modelo se adapte a eventos poco frecuentes y filtre el ruido, lo cual resulta especialmente relevante en el caso de las series temporales financieras. En este contexto, el método calcInputGradients desempeña la misma función que la pasada directa, pero con una lógica inversa en el recorrido de la señal.
bool CNeuronSpikeResNeXtBottleneck::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
El método comienza comprobando que el puntero al objeto de datos de origen sea correcto, con el fin de evitar el procesamiento de datos vacíos, lo que podría provocar errores o actualizaciones incorrectas de los pesos.
A continuación, se determina el bloque desde el que comenzará la transmisión inversa de la señal de error. Si el array dinámico cBottleneck contiene elementos, la transmisión comienza en el último bloque, ya que este es el punto final de la pasada directa. De lo contrario, la señal de error se envía inmediatamente a la neurona de origen.
   CNeuronBaseOCL *current = (cBottleneck.Total() > 0 ? cBottleneck[-1] : NeuronOCL);
   if(!CNeuronSpikeActivation::calcInputGradients(current))
      return false;
Este paso es fundamental: garantiza que la retropropagación comience desde el punto correcto, lo cual es especialmente importante en arquitecturas complejas con numerosas transformaciones internas.
Se invoca el método homónimo de la clase padre, que genera los gradientes iniciales en el nivel de salida. Esta llamada tiene en cuenta el potencial de membrana acumulado y los umbrales de activación entrenables, lo que permite a la neurona de picos reaccionar correctamente ante eventos significativos e ignorar los impulsos nulos o de ruido.
Luego comienza un bucle que recorre todos los elementos del array en orden inverso. En cada iteración, la señal de error se transmite desde el bloque actual al anterior mediante la llamada al método CalcHiddenGradients, que calcula los gradientes de los componentes ocultos.
   for(int i = cBottleneck.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cBottleneck[i - 1] : NeuronOCL);
      if(!current ||
         !current.CalcHiddenGradients(cBottleneck[i]))
         return false;
     }
//--- result
   return true;
  }
De este modo, cada componente interno de la arquitectura recibe correctamente la señal de error y puede actualizar sus parámetros. Si falta algún bloque o el cálculo falla, el método finaliza inmediatamente su ejecución y devuelve false.
Es importante señalar que, a pesar de la complejidad y la estructura en múltiples capas de la arquitectura, el flujo del error sigue siendo lineal y controlable. El uso de un array dinámico permite ocultar la complejidad interna y ofrece flexibilidad. Es posible modificar o ampliar fácilmente el modelo, así como añadir nuevos componentes sin alterar el algoritmo de pasada inversa.
Esto es especialmente importante para el análisis de series temporales financieras, ya que las señales pueden contener ruido, eventos poco frecuentes y patrones complejos. Una distribución adecuada de los gradientes garantiza que el modelo se entrene de forma eficaz, refleje con precisión la dinámica de los mercados y prediga de forma fiable los cambios futuros.
En definitiva, el método calcInputGradients actúa como un reflejo lógico de la pasada directa, lo que garantiza la retroalimentación y el control preciso de los parámetros de todos los componentes del objeto. Muestra cómo la arquitectura dinámica y la transmisión secuencial de la señal pueden funcionar conjuntamente, ocultando la complejidad y permitiendo que el modelo se adapte a la información más variada e impredecible que contienen las series temporales financieras.
Módulo de conexiones residuales
La siguiente etapa de nuestro trabajo consiste en desarrollar el módulo de conexiones residuales. Durante el análisis de los datos, la dimensionalidad del tensor puede variar, por lo que, para que las operaciones posteriores se realicen correctamente, es fundamental ajustar los tamaños de los tensores de salida de los dos flujos de información paralelos. Sin esta sincronización, no es posible sumar o combinar correctamente los resultados de las vías principal y secundaria del modelo, lo que comprometería la integridad de la información y afectaría a la precisión de las previsiones.
El módulo de conexiones residuales actúa como puente, garantizando la coherencia de las dimensiones y permitiendo que la señal se transmita correctamente por toda la arquitectura. Para implementar el nuevo objeto, a pesar de lo inusual que pueda parecer, utilizamos como clase base la clase CNeuronSpikeResNeXtBottleneck creada anteriormente. Su capacidad para trabajar con una arquitectura dinámica resulta muy oportuna. Toda la funcionalidad se transfiere al nuevo objeto, y la estructura interna se crea simplemente rellenando el array dinámico con la nueva configuración.
class CNeuronSpikeResNeXtResidual :  public CNeuronSpikeResNeXtBottleneck
  {
public:
                     CNeuronSpikeResNeXtResidual(void) {};
                    ~CNeuronSpikeResNeXtResidual(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint chanels_in, uint chanels_out,
                          uint units_in, uint units_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSpikeResNeXtResidual;   }
  };
Por lo tanto, para crear un objeto de conexiones residuales plenamente operativo, basta con sobrescribir el método de inicialización.
bool CNeuronSpikeResNeXtResidual::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint chanels_in, uint chanels_out, uint units_in,
                                       uint units_out, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeActivation::Init(numOutputs, myIndex, open_cl, chanels_out * units_out, optimization_type, batch))
      return false;
El método Init construye la arquitectura interna exclusivamente a través de un array dinámico, llenándolo con componentes que armonizan los tamaños de los tensores en la salida de los flujos paralelos. En primer lugar, se llama al método de inicialización de la clase padre común CNeuronSpikeActivation para preparar el objeto para su funcionamiento.
A continuación, el array dinámico cBottleneck, heredado de la clase padre, se vacía y recibe una referencia al objeto OpenCL para realizar los cálculos. Todos los componentes posteriores se irán añadiendo precisamente a este array, formando una ruta de procesamiento de datos lineal, pero configurable dinámicamente.
Si el número de canales de entrada y salida es diferente, se crea una capa convolucional para la proyección de los canales, a la que se le asigna inmediatamente la función de activación SoftPlus.
   CNeuronConvOCL *conv = NULL;
   CNeuronBatchNormOCL *norm = NULL;
   CNeuronSpikeActivation *spike = NULL;
   CNeuronTransposeOCL* transp = NULL;
//---
   cBottleneck.Clear();
   cBottleneck.SetOpenCL(OpenCL);
//--- Projection Chanels
   uint index = 0;
   if(chanels_in != chanels_out)
     {
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, chanels_in, chanels_in, chanels_out, units_in, 1, optimization, iBatch) ||
         !cBottleneck.Add(conv))
        {
         DeleteObj(conv)
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
      index++;
     }
A continuación, si es necesario modificar la longitud de la secuencia, se añaden componentes para la proyección de la dimensión correspondiente. Pero primero, si es necesario, añadimos la normalización y la activación por picos para la proyección de la dimensión de las características.
//--- Projection Units
   if(units_in != units_out)
     {
      if(chanels_in != chanels_out)
        {
         norm = new CNeuronBatchNormOCL();
         if(!norm ||
            !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
            !cBottleneck.Add(norm))
           {
            DeleteObj(norm)
            return false;
           }
         norm.SetActivationFunction(None);
         index++;
         spike = new CNeuronSpikeActivation();
         if(!spike ||
            !spike.Init(0, index, OpenCL, norm.Neurons(), optimization, iBatch) ||
            !cBottleneck.Add(spike))
           {
            DeleteObj(spike)
            return false;
           }
         index++;
        }
A continuación, llevamos a cabo una transposición de la representación de los datos y añadimos una capa convolucional con activación SoftPlus, cuya función es ajustar la dimensión de la secuencia temporal.
      transp = new CNeuronTransposeOCL();
      if(!transp ||
         !transp.Init(0, index, OpenCL, units_in, chanels_out, optimization, iBatch) ||
         !cBottleneck.Add(transp))
        {
         DeleteObj(transp)
         return false;
        }
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, units_in, units_in, units_out, chanels_out, 1, optimization, iBatch) ||
         !cBottleneck.Add(conv))
        {
         DeleteObj(conv)
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
      index++;
      norm.SetActivationFunction(None);
      index++;
      transp = new CNeuronTransposeOCL();
      if(!transp ||
         !transp.Init(0, index, OpenCL, chanels_out, units_out, optimization, iBatch) ||
         !cBottleneck.Add(transp))
        {
         DeleteObj(transp)
         return false;
        }
      index++;
     }
Después realizamos la transposición inversa de los datos.
Este enfoque permite armonizar las dimensiones de los tensores y garantizar una transmisión correcta de la señal a lo largo de toda la estructura.
Al finalizar la inicialización, se añade una capa BatchNorm, que estabiliza las señales de salida y las prepara para la posterior activación por picos mediante los mecanismos de la clase padre común.
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, Neurons(), iBatch, optimization) ||
      !cBottleneck.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
//---
   return true;
  }
De este modo, el método Init convierte un conjunto complejo de operaciones de ajuste de dimensiones e integración de conexiones residuales en un proceso transparente y controlable. La estructura dinámica permite crear modelos con distintos parámetros, manteniendo el flujo lineal de la señal y garantizando la correcta formación de características incluso en las series temporales financieras más complejas.
Hoy hemos trabajado mucho y hemos avanzado considerablemente en la implementación del framework. Ha llegado el momento de hacer una pequeña pausa, ordenar los pensamientos y dejar que todos los conceptos se asienten. En el archivo adjunto encontrará el código completo de todos los objetos descritos. Y volveremos al trabajo con energías renovadas en el próximo artículo para continuar con el análisis en profundidad de las posibilidades de SEW-ResNet y la aplicación de sus enfoques a los modelos financieros.
Conclusión
A lo largo de este artículo hemos analizado en detalle la implementación de los componentes clave del framework SEW-ResNet mediante MQL5. Hemos analizado la pasada directa y la pasada inversa de Bottleneck, hemos implementado puntos de comprobación de valores cero, hemos optimizado los algoritmos de cálculo y hemos creado un módulo de conexiones residuales capaz de armonizar las dimensiones de los tensores en una arquitectura dinámica compleja. El uso de arrays dinámicos ha permitido ocultar la complejidad interna y garantizar la flexibilidad a la hora de trabajar con flujos de datos de diferentes estructuras.
Las soluciones implementadas demuestran cómo los enfoques modernos basados en picos pueden integrarse en modelos financieros, lo que permite una extracción precisa y eficiente de características, el filtrado de eventos poco frecuentes y un entrenamiento coherente con datos históricos.
El código completo de todos los objetos descritos se incluye en el archivo adjunto, lo que permite reproducir y ampliar los métodos propuestos. Hemos dado un paso importante hacia la aplicación práctica de SEW-ResNet al análisis de series temporales financieras y hemos sentado las bases para futuros experimentos. En el próximo artículo continuaremos la investigación, incorporando nuevas funcionalidades del framework y profundizando en la comprensión de su potencial para el trading.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19870
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.