
Guía de aprendizaje automático para MetaTrader 5 (Parte 3): Método de etiquetado mediante exploración de tendencias
 26
 4

Introducción
Bienvenidos a la tercera entrega de nuestra serie «Guía de aprendizaje automático para MetaTrader 5». Hemos avanzado mucho desde los problemas fundamentales de integridad de los datos que se abordaron en la primera parte y las técnicas revolucionarias de etiquetado que se presentaron en la segunda parte. Ahora ya estamos listos para abordar la implementación del método adaptativo de etiquetado mediante exploración de tendencias.
Los mercados financieros no son estáticos. Lo que funcionó ayer puede fallar mañana, y lo que parece una señal fuerte puede ser, en realidad, ruido redundante generado por la superposición de observaciones. Este artículo aborda estos retos de frente con técnicas eficaces extraídas de la investigación de Marcos López de Prado. Vamos a implementar el método de exploración de tendencias, que revoluciona nuestra forma de concebir los horizontes de predicción. En lugar de elegir arbitrariamente un horizonte de predicción de 5 o 10 días, la exploración de tendencias determina de forma dinámica el horizonte con mayor significación estadística para cada condición del mercado. Es como tener un telescopio que ajusta automáticamente el enfoque para captar la imagen más nítida de las tendencias del mercado.
Este artículo se basa directamente en los conceptos de la parte 2, por lo que, si aún no la has leído, te recomendamos encarecidamente que lo hagas primero. Al finalizar este artículo, dispondrás de un sistema de etiquetado completo y listo para su uso en producción que se adapta a las condiciones del mercado. No se trata solo de teoría académica, sino de un marco práctico que aborda los retos reales de la operativa en los mercados financieros.
Método de etiquetado mediante exploración de tendencias
Teoría y motivación
El método de triple barrera que analizamos en la segunda parte supuso una mejora significativa con respecto al etiquetado con horizonte temporal fijo, pero seguía basándose en límites de tiempo predeterminados para nuestras barreras verticales. Teníamos que decidir desde el principio si mantendríamos las posiciones durante 50 barras, 100 barras o cualquier otro plazo arbitrario. Este enfoque parte de la base de que el horizonte de predicción óptimo es constante en todas las condiciones de mercado, una suposición que, como bien sabe cualquiera que haya operado en mercados volátiles, es fundamentalmente errónea. Consideremos dos escenarios de mercado diferentes: un mercado alcista en tendencia, en el que el impulso se mantiene durante semanas, y un mercado lateral con oscilaciones erráticas, en el que las tendencias se invierten cada pocos días. Utilizar el mismo horizonte temporal para ambos escenarios es como llevar la misma chaqueta tanto en verano como en invierno; puede que a veces funcione, pero rara vez es lo más adecuado.
El método de exploración de tendencias resuelve este problema de forma elegante, al permitir que sean los propios datos los que determinen el horizonte de predicción óptimo para cada observación. En lugar de imponer un horizonte temporal fijo, analiza varios periodos prospectivos y selecciona aquel que presenta la evidencia estadística más sólida de una tendencia.
Así es como funciona: para cada posible punto de entrada en una operación, el algoritmo examina los datos futuros y calcula los estadísticos t para distintos horizontes futuros (por ejemplo, 5 barras, 10 barras, 15 barras, hasta un máximo determinado). A continuación, selecciona el horizonte que ofrece el resultado más significativo desde el punto de vista estadístico, preguntándose, en esencia: «¿En qué momento futuro se define con mayor claridad la tendencia?».
Este enfoque ofrece varias ventajas clave con respecto a los horizontes fijos:
- Adaptabilidad al mercado: En períodos de volatilidad, el algoritmo podría optar por horizontes temporales más cortos, en los que las tendencias son más marcadas. En mercados tranquilos y con tendencia, podría optar por horizontes temporales más largos para aprovechar los movimientos sostenidos.
- Rigor estadístico: las etiquetas se basan en la significación estadística y no en umbrales arbitrarios. Una tendencia solo se etiqueta como tal si cumple unos criterios estadísticos rigurosos.
- Reducción del ruido: Al exigir significación estadística, el método filtra de forma natural los movimientos aleatorios de los precios que no constituyen tendencias significativas.
- Respuesta dinámica: A medida que cambian las condiciones del mercado, el horizonte óptimo se ajusta automáticamente sin necesidad de intervención manual.
Los fundamentos matemáticos son sencillos, pero muy eficaces. Para cada horizonte potencial h, calculamos el estadístico t de la tendencia lineal de las rentabilidades durante ese periodo. El estadístico t mide a cuántas desviaciones estándar se encuentra la tendencia observada respecto a cero (ausencia de tendencia). Cuanto mayores sean los valores absolutos, mayor será la evidencia estadística de que existe una tendencia.
El algoritmo selecciona el horizonte que maximiza el valor absoluto del estadístico t, pero solo si dicho valor supera un umbral mínimo de significación. Esto garantiza que no nos limitemos a elegir la opción «menos ruidosa» entre las fluctuaciones aleatorias, sino que identifiquemos tendencias verdaderamente significativas.
Uno de los aspectos más elegantes de la exploración de tendencias es la forma en que gestiona automáticamente los diferentes tipos de comportamiento del mercado. En mercados con tendencia, suele seleccionar horizontes más largos para captar el movimiento completo. En mercados con reversión a la media, elige horizontes más cortos en los que las reversiones son más evidentes desde el punto de vista estadístico. Durante los periodos de consolidación, es posible que no detecte tendencias estadísticamente significativas en ningún horizonte temporal, lo que, naturalmente, generaría señales de «mantener».
Esta adaptabilidad hace que la exploración de tendencias resulte especialmente valiosa para las estrategias que deben dar buenos resultados en distintos regímenes de mercado. En lugar de optimizarse para condiciones específicas y esperar que estas se mantengan, el algoritmo adapta continuamente su enfoque analítico a la dinámica actual del mercado.
Implementación
Los fragmentos de código que implementan el método de exploración de tendencias descrito en el libro de Marcos López de Prado Machine Learning for Asset Managers (sección 5.4) se presentan a continuación.
import numpy as np
import pandas as pd
import statsmodels.api as sm

from multiprocess import mp_pandas_obj


# SNIPPET 5.1 T-VALUE OF A LINEAR TREND
# ---------------------------------------------------
def tValLinR(close):
    # tValue from a linear trend
    x = np.ones((close.shape[0], 2))
    x[:, 1] = np.arange(close.shape[0])
    ols = sm.OLS(close, x).fit()
    return ols.tvalues[1]
# SNIPPET 5.2 IMPLEMENTATION OF THE TREND-SCANNING METHOD
def getBinsFromTrend(close, span, molecule):
    """
    Derive labels from the sign of t-value of linear trend
    Output includes:
    - t1: End time for the identified trend
    - tVal: t-value associated with the estimated trend coefficient
    - bin: Sign of the trend
    """
    out = pd.DataFrame(index=molecule, columns=["t1", "tVal", "bin"])
    hrzns = range(*span)

    for dt0 in molecule:
        df0 = pd.Series()
        iloc0 = close.index.get_loc(dt0)
        if iloc0 + max(hrzns) > close.shape[0]:
            continue
        for hrzn in hrzns:
            dt1 = close.index[iloc0 + hrzn - 1]
            df1 = close.loc[dt0:dt1]
            df0.loc[dt1] = tValLinR(df1.values)
        dt1 = df0.replace([-np.inf, np.inf, np.nan], 0).abs().idxmax()
        out.loc[dt0, ["t1", "tVal", "bin"]] = (
            df0.index[-1],
            df0[dt1],
            np.sign(df0[dt1]),
        )  # prevent leakage

    out["t1"] = pd.to_datetime(out["t1"])
    out["bin"] = pd.to_numeric(out["bin"], downcast="signed")
    return out.dropna(subset=["bin"])
def trendScanningLabels(close, span, num_threads=4, verbose=True):
    out = mp_pandas_obj(
        getBinsFromTrend,
        ("molecule", close.index),
        num_threads,
        verbose=verbose,
        close=close,
        span=span,
    )
    return out.astype({"bin": "int8"})
Aunque trendScanningLabels utiliza el motor de multiprocesamiento al que se accede llamando a mp_pandas_obj (véase el archivo adjunto multiprocess.py), la implementación original es demasiado lenta para su uso en operaciones reales. Mi versión optimizada, que se muestra a continuación, utiliza Numba para compilar el bucle principal en código máquina rápido, lo que elimina los cuellos de botella de rendimiento de Python. Estas mejoras hacen que la función sea aproximadamente 350 veces más rápida, al tiempo que introducen actualizaciones clave en la funcionalidad que resuelven las limitaciones del código original.
from numba import njit, prange


@njit(parallel=True, cache=True)
def _window_stats_numba(y, window_length):
    """
    Compute slopes, t-values, and R² for all fixed-length windows.
    This function is optimized for performance using Numba's JIT compilation.

    :param y: (np.ndarray) The input data array.
    :param window_length: (int) The length of the sliding window.
    :return: (tuple) A tuple containing:
        - t_values: (np.ndarray) The t-values for each window.
        - slopes: (np.ndarray) The slopes for each window.
        - r_squared: (np.ndarray) The R² values for each window.
    """
    n = len(y)
    num_windows = n - window_length + 1

    t_values = np.empty(num_windows)
    slopes = np.empty(num_windows)
    r_squared = np.empty(num_windows)

    t = np.arange(window_length)
    mean_t = t.mean()
    Var_t = ((t - mean_t) ** 2).sum()

    for i in prange(num_windows):
        window = y[i : i + window_length]
        mean_y = window.mean()
        sum_y = window.sum()
        sum_y2 = (window**2).sum()

        # Slope estimation
        S_ty = (window * t).sum()
        slope = (S_ty - window_length * mean_t * mean_y) / Var_t
        slopes[i] = slope

        # SSE calculation
        beta0 = mean_y - slope * mean_t
        SSE = sum_y2 - beta0 * sum_y - slope * S_ty

        # R² calculation
        SST = sum_y2 - (sum_y**2) / window_length
        epsilon = 1e-9
        r_squared[i] = max(0.0, 1.0 - SSE / (SST + epsilon)) if SST > epsilon else 0.0

        # t-value calculation
        sigma2 = SSE / (window_length - 2 + epsilon)
        se_slope = np.sqrt(sigma2 / Var_t)
        t_values[i] = slope / (se_slope + epsilon)

    return t_values, slopes, r_squared
La función que se muestra a continuación coordina el proceso de obtención de etiquetas de exploración de tendencias.
from typing import List, Tuple, Union

import numpy as np
import pandas as pd

from loguru import logger

def trend_scanning_labels(
    close: pd.Series,
    span: Union[List[int], Tuple[int, int]] = (5, 20),
    volatility_threshold: float = 0.1,
    lookforward: bool = True,
    use_log: bool = True,
    verbose: bool = False,
) -> pd.DataFrame:
    """
    `Trend scanning <https://papers.ssrn.com/sol3/papers.cfm?abstract_id=3257419>`_ is both a classification and
    regression labeling technique.
    It fits OLS regressions over multiple rolling windows and selects the one with the highest absolute t-value.
    The sign of the t-value indicates trend direction, while its magnitude reflects confidence.
    The method incorporates volatility-based masking to avoid spurious signals in low-volatility regimes.
    This implementation offers a robust, leakage-proof trend-scanning label generator with:
      - Expanding, data-adaptive volatility thresholding
      - Full feature masking (t-value, slope, R²) in low-volatility regimes
      - Boundary protection to avoid look-ahead leaks
      - Support for both look-forward and look-backward scan

    Parameters
    ----------
    close : pd.Series
        Time-indexed raw price series. Must be unique and sorted (monotonic).
    span : list[int] or tuple(int, int), default=(5, 20)
        If list, exact window lengths to scan. If tuple `(min, max)`, uses
        `range(min, max)` as horizons.
    volatility_threshold : float, default=0.1
        Quantile level (0-1) on the expanding rolling std of log-prices. Windows
        below this vol threshold are zero-masked.
    lookforward : bool, default=True
        If True, labels trend on `[t, t+L-1]`; else on `[t-L+1, t]` by reversing.
    use_log : bool, default=True
        Apply log transformation before trend analysis
    verbose : bool, default=False
        Print progress for each horizon.

    Returns
    -------
    pd.DataFrame
        Indexed by the valid subset of `close.index`. Columns:
        - t1 : pd.Timestamp
        End of the event window (lookforward) or start (lookbackward).
        - window : int
        Chosen optimal horizon (argmax |t-value|).
        - slope : float
        Estimated slope over that window.
        - t_value : float
        t-stat for the slope (clipped to ±min(var, 20)).
        - r_squared : float
        Goodness-of-fit (zero if below vol threshold).
        - ret : float
        Hold-period return over the chosen window.
        - bin : int8
        Sign of `t_value` (-1, 0, +1), zero if |t_value|≈0.

    Notes
    -----
    1. Log-transformation stabilizes variance before regression.
    2. Uses a precompiled Numba `_window_stats_numba` for the heavy sliding
       O(N·H) regressions.
    3. Boundary slices ensure no forward-looking data leak into features.
    """
    # Input validation and setup
    close = close.sort_index() if not close.index.is_monotonic_increasing else close.copy()
    hrzns = list(range(*span)) if isinstance(span, tuple) else span
    max_hrzn = max(hrzns)

    if lookforward:
        valid_indices = close.index[:-max_hrzn].to_list()
    else:
        valid_indices = close.index[max_hrzn - 1 :].to_list()

    if not valid_indices:
        return pd.DataFrame(columns=["t1", "window", "slope", "t_value", "rsquared", "ret", "bin"])

    # Log transformation
    if use_log:
        close_processed = close.clip(lower=1e-8).astype(np.float64)
        y = np.log(close_processed).values
    else:
        y = close.values.astype(np.float64)

    N = len(y)

    # Compute volatility threshold
    volatility = pd.Series(y, index=close.index).rolling(max_hrzn, min_periods=1).std().ffill()
    vol_threshold = volatility.expanding().quantile(volatility_threshold).ffill().values

    # Precompute all window stats
    window_stats = np.full((3, N, len(hrzns)), np.nan)
    for k, hrzn in enumerate(hrzns):
        if verbose:
            print(f"Processing horizon {hrzn}", end="\r", flush=True)
        y_window = y if lookforward else y[::-1]
        t_vals, slopes, r_sq = _window_stats_numba(y_window, hrzn)
        if not lookforward:
            t_vals, slopes, r_sq = t_vals[::-1], slopes[::-1], r_sq[::-1]
            start_idx = hrzn - 1
        else:
            start_idx = 0
        n = len(t_vals)
        valid_vol = volatility.iloc[start_idx : start_idx + n].values
        mask = valid_vol > vol_threshold[start_idx : start_idx + n]
        window_stats[0, start_idx : start_idx + n, k] = np.where(mask, t_vals, 0)
        window_stats[1, start_idx : start_idx + n, k] = np.where(mask, slopes, 0)
        window_stats[2, start_idx : start_idx + n, k] = np.where(mask, r_sq, 0)

    # Integer positions for events
    event_idx = close.index.get_indexer(valid_indices)

    # Extract sub-blocks for these events
    t_block = window_stats[0, event_idx, :]  # shape: (E, H)
    s_block = window_stats[1, event_idx, :]
    rsq_block = window_stats[2, event_idx, :]

    # Best horizon per event (argmax of abs t-value)
    best_j = np.nanargmax(np.abs(t_block), axis=1)  # (E,)

    # Gather optimal metrics
    opt_tval = t_block[np.arange(len(event_idx)), best_j]
    opt_slope = s_block[np.arange(len(event_idx)), best_j]
    opt_rsq = rsq_block[np.arange(len(event_idx)), best_j]
    opt_hrzn = np.array(hrzns)[best_j]

    # Compute t1 indices vectorised
    if lookforward:
        t1_idx = np.clip(event_idx + opt_hrzn - 1, 0, N - 1)
    else:
        t1_idx = np.clip(event_idx - opt_hrzn + 1, 0, N - 1)

    # Map to timestamps and returns
    t1_arr = close.index[t1_idx]
    a, b = (event_idx, t1_idx) if lookforward else (t1_idx, event_idx)
    rets = close.iloc[b].array / close.iloc[a].array - 1

    # Filter labels by t-value
    tval_abs = np.abs(opt_tval)
    mask = (tval_abs > 1e-6)
    bins = np.where(mask, np.sign(opt_tval), 0).astype("int8")

    # Assemble DataFrame
    df = pd.DataFrame(
        {
            "t1": t1_arr,
            "window": opt_hrzn,
            "slope": opt_slope,
            "t_value": opt_tval,
            "rsquared": opt_rsq,
            "ret": rets,
            "bin": bins,
        },
        index=pd.Index(valid_indices),
    )

    return df
Cabe señalar que la regresión de exploración de tendencias y = α + βt + ε supone una varianza constante del error, hipótesis que no se cumple con los precios sin transformar, pero sí con los logaritmos de los precios.
Principales mejoras con respecto a la implementación original
1. Filtrado por regímenes de volatilidad
El método original de exploración de tendencias trata todas las condiciones del mercado por igual. Nuestra implementación introduce umbrales de volatilidad dinámicos:
# Expanding volatility percentile calculation
vol_threshold = volatility.expanding().quantile(volatility_threshold).ffill().values

# Zero out statistics during low-volatility periods
vol_mask = valid_vol > vol_threshold[start_idx : start_idx + n]
Esto evita que el algoritmo genere señales espurias durante los periodos de baja actividad, en los que los movimientos de los precios son principalmente ruido. Mediante el uso de cuantiles de ventana expansiva, el umbral se adapta a los cambios en los regímenes de volatilidad del mercado.
2. Diseño de doble función: etiquetas y características
Nuestra implementación puede funcionar en dos modos:
- lookforward=True: Genera etiquetas analizando las tendencias futuras a partir de cada punto de observación
- lookforward=False: Genera características analizando las tendencias pasadas hasta cada punto de observación
# Feature generation example (no data leakage)
trend_features = trend_scanning_labels(
    close_prices,
    span=(5, 20),
    lookforward=False,  # Look backward for features
    verbose=True
)

# Label generation example
trend_labels = trend_scanning_labels(
    close_prices,
    span=(5, 20),
    lookforward=True,   # Look forward for labels
    verbose=True
)
Esta doble funcionalidad permite que la misma lógica robusta de detección de tendencias sirva tanto para la ingeniería de características como para la generación de etiquetas dentro de un marco unificado.
3. Protección rigurosa de los límites
A diferencia de la implementación original, la nuestra incluye una protección estricta de los límites:
# Remove observations that would require future data
iloc0 = slice(0, -max_hrzn) if lookforward else slice(max_hrzn - 1, None)
t_series = t_series.iloc[iloc0]
Esto garantiza que ninguna información futura contamine las características o las etiquetas, preservando la integridad temporal esencial para realizar pruebas retrospectivas fiables y operar en tiempo real.
Por qué esta implementación es superior
- Lista para producción: gestiona problemas relacionados con datos reales, como los regímenes de volatilidad y la inestabilidad numérica
- Sin fuga de datos: unos límites temporales estrictos evitan cualquier sesgo de anticipación
- Eficiencia computacional: la compilación JIT de Numba proporciona una aceleración significativa
- Flexible: una única implementación cubre tanto las necesidades de generación de características como las de etiquetado
- Robusta: el enmascaramiento de la volatilidad y la limitación de los valores t mejoran la calidad de las señales
Esta implementación mejorada de la exploración de tendencias constituye la base para unas etiquetas de aprendizaje automático verdaderamente adaptativas que responden a las condiciones del mercado, al tiempo que mantienen la integridad temporal esencial para unos sistemas de negociación algorítmica fiables. Las etiquetas de exploración de tendencias pueden utilizarse en modelos de regresión para predecir la magnitud de la tendencia, estableciendo los valores t como variable objetivo, o en modelos de clasificación, estableciendo la etiqueta como variable objetivo y utilizando los valores t como pesos de las muestras.
Análisis del rendimiento de las etiquetas de exploración de tendencias
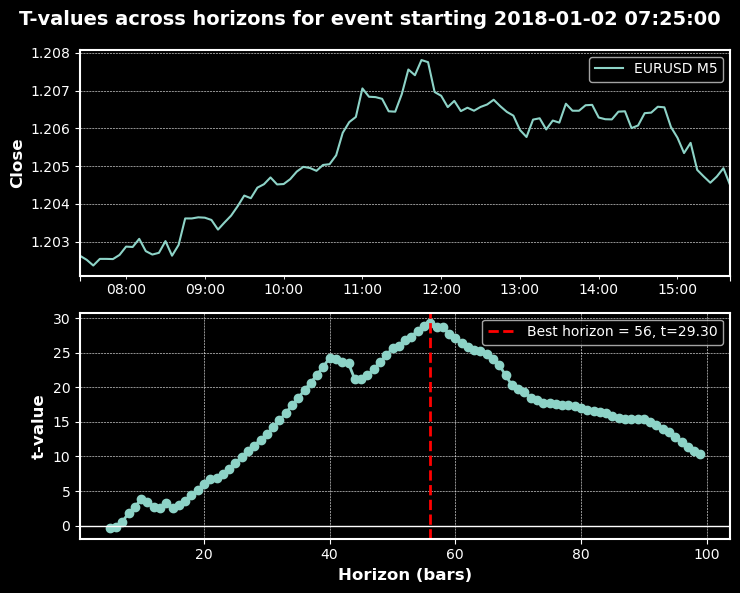
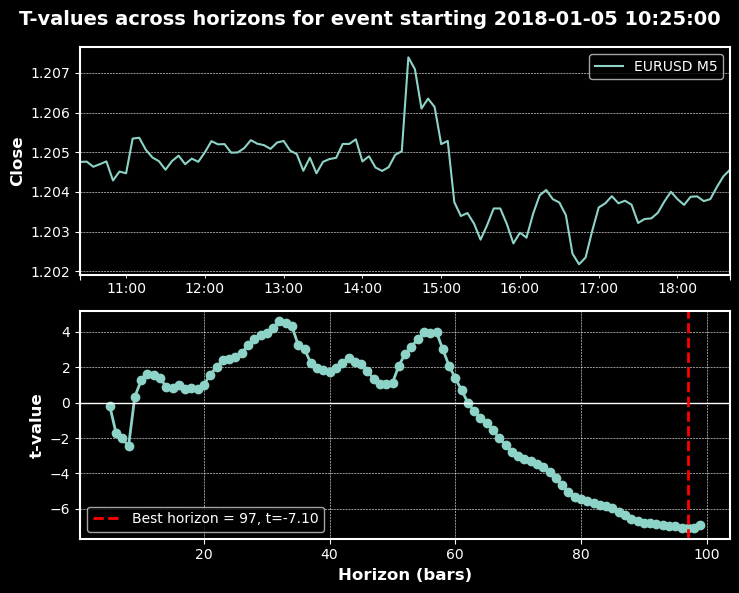
Ahora pongamos a prueba la exploración de tendencias utilizando datos de EURUSD en M5, desde el 1 de enero de 2018 hasta el 31 de diciembre de 2021. Utilizaremos una estrategia de cruce de medias móviles con la MA20 y la MA50 como modelo principal y aplicaremos el metaetiquetado a las etiquetas generadas mediante el etiquetado con horizonte temporal fijo, el método de triple barrera y el etiquetado por exploración de tendencias. Los eventos de negociación (t_events) que se introducen en triple_barrier_labels y trend_scanning_labels vienen determinados por los cruces de las medias móviles. Para aplicar el metaetiquetado con la exploración de tendencias, solo clasifico una operación como 1 si la dirección predicha por la estrategia de cruce de medias móviles coincide con la indicada por las etiquetas de exploración de tendencias; en caso contrario, la clasifico como 0. He entrenado un bosque aleatorio utilizando características con capacidad predictiva para un modelo de seguimiento de tendencias, como diversas medias móviles, características de tendencia como el ADX y las obtenidas al ejecutar trend_scanning_labels con lookforward=False (véase el archivo adjunto ma_crossover_feature_engine.py). Las etiquetas de exploración de tendencias se generaron explorando ventanas de entre 5 y 99, con el parámetro span=(5, 100). He utilizado el método de triple barrera para el etiquetado a fin de establecer mi umbral de limitación de pérdidas, pero sin barrera de toma de beneficios, de modo que las tendencias sigan su curso hasta que se alcance la barrera horizontal. A continuación se indican los ajustes pertinentes:
- variable objetivo de volatilidad = desviación estándar de las rentabilidades con ponderación exponencial (EWM) de 20 días (véase get_daily_vol en el archivo adjunto volatility.py).
- barrera de toma de beneficios = 0
- barrera de limitación de pérdidas = 2
- barrera horizontal = 100
Los gráficos que se muestran a continuación ilustran la exploración de tendencias en acción con los parámetros mencionados anteriormente:
Informes de clasificación
Los resultados que se muestran a continuación reflejan la precisión, la exhaustividad y la puntuación F1 del clasificador de bosque aleatorio entrenado para distintos umbrales de volatilidad, tanto sin ponderación como utilizando los valores t como pesos de las muestras.
Métricas de clasificación de la exploración de tendencias según el umbral de volatilidad
| 0,0 | 0,05 | 0,1 | 0,2 | 0,3 | ||
|---|---|---|---|---|---|---|
| Clase | ||||||
| -1 | precisión | 0,505 | 0,489 | 0,486 | 0,448 | 0,428 |
| -1 | exhaustividad | 0,545 | 0,382 | 0,408 | 0,440 | 0,413 |
| -1 | puntuación F1 | 0,524 | 0,429 | 0,444 | 0,444 | 0,420 |
| -1 | número de muestras | 1043 | 985 | 909 | 752 | 622 |
| 0 | precisión | NaN | 0,176 | 0,297 | 0,525 | 0,658 |
| 0 | exhaustividad | NaN | 1,000 | 0,926 | 0,875 | 0,858 |
| 0 | puntuación F1 | NaN | 0,299 | 0,449 | 0,656 | 0,745 |
| 0 | número de muestras | NaN | 115 | 256 | 566 | 840 |
| 1 | precisión | 0,495 | 0,479 | 0,464 | 0,444 | 0,425 |
| 1 | exhaustividad | 0,455 | 0,319 | 0,259 | 0,228 | 0,260 |
| 1 | puntuación F1 | 0,474 | 0,383 | 0,332 | 0,301 | 0,323 |
| 1 | número de muestras | 1022 | 965 | 900 | 747 | 603 |
| exactitud | 0,500 | 0,387 | 0,407 | 0,482 | 0,550 |
| 0,0 | 0,05 | 0,1 | 0,2 | 0,3 | ||
|---|---|---|---|---|---|---|
| Clase | ||||||
| -1 | precisión | 0,514 | 0,514 | 0,509 | 0,502 | 0,490 |
| -1 | exhaustividad | 0,513 | 0,585 | 0,538 | 0,516 | 0,468 |
| -1 | puntuación F1 | 0,513 | 0,548 | 0,523 | 0,509 | 0,479 |
| -1 | número de muestras | 1043 | 945 | 865 | 721 | 596 |
| 1 | precisión | 0,504 | 0,513 | 0,506 | 0,501 | 0,485 |
| 1 | exhaustividad | 0,505 | 0,442 | 0,478 | 0,487 | 0,508 |
| 1 | puntuación F1 | 0,504 | 0,475 | 0,492 | 0,494 | 0,496 |
| 1 | número de muestras | 1022 | 935 | 858 | 719 | 589 |
| exactitud | 0,509 | 0,514 | 0,508 | 0,501 | 0,488 |
| Umbral | Exactitud no ponderada | Exactitud ponderada |
|---|---|---|
| 0,0 | 0,500 | 0,509 |
| 0,05 | 0,387 | 0,514 |
| 0,1 | 0,407 | 0,508 |
| 0,2 | 0,482 | 0,501 |
| 0,3 | 0,550 | 0,488 |
| Clase | Métrica | 0,0 | 0,05 | 0,1 | 0,2 | 0,3 |
|---|---|---|---|---|---|---|
| Modelo no ponderado | ||||||
| -1 | puntuación F1 | 0,524 | 0,429 | 0,444 | 0,444 | 0,420 |
| 0 | puntuación F1 | NaN | 0,299 | 0,449 | 0,656 | 0,745 |
| 1 | puntuación F1 | 0,474 | 0,383 | 0,332 | 0,301 | 0,323 |
| Modelo ponderado (valores t como pesos de la muestra) | ||||||
| -1 | puntuación F1 | 0,513 | 0,548 | 0,523 | 0,509 | 0,479 |
| 0 | puntuación F1 | No aplicable (clasificación binaria) | ||||
| 1 | puntuación F1 | 0,504 | 0,475 | 0,492 | 0,494 | 0,496 |
Consideraciones: cuándo utilizar modelos ponderados frente a modelos no ponderados
Modelo ponderado (valores t como pesos de la muestra)
- Dar más peso a las señales estadísticamente más sólidas: reducir el peso de las etiquetas con ruido o débiles para reflejar la solidez de la evidencia.
- Estabilidad frente a exactitud máxima: es preferible un rendimiento constante en distintos umbrales que un único punto de alta exactitud.
- Preparación para la producción: robustez y fiabilidad para los sistemas de negociación en operativa real.
- Gestión del desequilibrio entre clases: mitiga el predominio de clases neutras o con ruido.
Modelo no ponderado
- Explorar la calidad de la señal sin procesar: establecer una referencia de la ventaja estadística sin el sesgo de la ponderación.
- Modelizar las zonas neutras o sin operaciones: conservar la clase neutra (0) cuando sea pertinente para los límites de decisión.
- Investigación y creación de prototipos: experimentación rápida antes de introducir restricciones estadísticas.
- Optimizar para el umbral de máximo rendimiento: si se busca un único umbral operativo y la varianza es aceptable.
Rendimiento fuera de muestra
Los resultados que se muestran a continuación utilizan posiciones de tamaño uniforme para las operaciones realizadas al producirse cruces de MA20 y MA50 para EURUSD en M5, desde el 31 de diciembre de 2021 hasta el 31 de diciembre de 2024. Las metaetiquetas de exploración de tendencias se generaron utilizando las predicciones de un bosque aleatorio entrenado con etiquetas de exploración de tendencias, con un umbral de volatilidad de 0,05 y los valores t como pesos de la muestra.
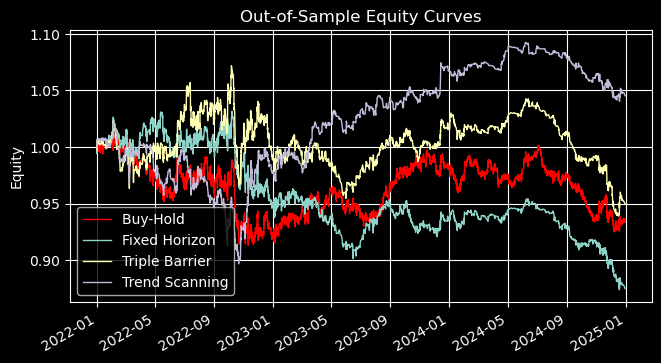
Metaetiquetado frente a Comparación del rendimiento del modelo principal (MACrossover 20/50)
| Métrica | Horizonte fijo | Triple barrera | Exploración de tendencias |
|---|---|---|---|
| Rentabilidad total | -12,49 % (↓88,4 %) | -5,04 % (↑34,5 %) | 4,53 % (↔ 0,0 %) |
| Rentabilidad anualizada | -4,35 % (↓92,4 %) | -1,71 % (↑35,1 %) | 1,49 % (↔ 0,0 %) |
| Índice de Sharpe | -3,72 (↓360 %) | -1,66 (↓5,1 %) | 2,62 (↑37,3 %) |
| Índice de Sortino | -5,09 (↓354 %) | -3,66 (↓2,2 %) | 4,25 (↑88,5 %) |
| Índice de Calmar | -0,285 (↓22,3 %) | -0,138 (↑28,9 %) | 0,121 (↔ 0,0 %) |
| Caída máxima desde máximos | 15,27 % (↓57,4 %) | 12,38 % (↑8,8 %) | 12,32 % (↔ 0,0 %) |
| Porcentaje de operaciones ganadoras | 49,6 % (↔) | 40,3 % (↑14,5 %) | 21,2 % (↑88,5 %) |
| Factor de beneficio | 0,96 (↓3,0 %) | 0,98 (↔) | 1,04 (↔) |
| Esperanza matemática | -0,0046 % (↓332 %) | -0,0016 % (↓18 %) | -0,0762 % (↑34 %) |
| Criterio de Kelly | -0,0206 (↓308 %) | -0,0068 (↓14 %) | -0,3255 (↑34 %) |
Conclusiones clave
Los resultados fuera de muestra ponen de manifiesto claras diferencias entre los tres enfoques de metaetiquetado:
- El etiquetado con horizonte temporal fijo deterioró el rendimiento de forma sistemática, con rentabilidades negativas, unos índices de Sharpe y Sortino deficientes y caídas desde máximos más pronunciadas. Esto sugiere que las salidas basadas en plazos rígidos no son adecuadas para esta estrategia.
- El método de triple barrera logró mejoras modestas en la rentabilidad y el control de las caídas desde máximos, pero los indicadores ajustados al riesgo (Sharpe y Sortino) siguieron siendo débiles. Aportó cierta estabilidad, pero no una ventaja decisiva.
- La exploración de tendencias destacó por registrar el mayor aumento en la rentabilidad ajustada al riesgo. El índice de Sharpe mejoró en más de un 37 % y el de Sortino casi se duplicó, mientras que las caídas desde máximos se mantuvieron estables. Esto indica que ponderar las operaciones en función de su significación estadística da lugar a unos resultados más sólidos y consistentes.
En la práctica, el etiquetado con horizonte temporal fijo puede resultar útil únicamente para la evaluación comparativa; el método de triple barrera, para un control moderado del riesgo; y la exploración de tendencias, para su uso en entornos de producción, donde la estabilidad y la rentabilidad ajustada al riesgo son lo más importante.
Métricas ampliadas de rendimiento con metaetiquetado
| horizonte fijo | triple barrera | exploración de tendencias | |
|---|---|---|---|
| rentabilidad total | -0,124942 | -0,050359 | 0,045288 |
| rentabilidad anualizada | -0,043504 | -0,017072 | 0,01487 |
| volatilidad | 0,888104 | 0,709836 | 0,521126 |
| volatilidad a la baja | 0,649197 | 0,323178 | 0,32075 |
| índice de Sharpe | -3,722773 | -1,66439 | 2,616468 |
| índice de Sortino | -5,092763 | -3,655701 | 4,251009 |
| var_95 | -0,005302 | -0,003206 | -0,002467 |
| cvar_95 | -0,007848 | -0,004445 | -0,003576 |
| asimetría | -0,107052 | 1,311478 | 2,165464 |
| curtosis | 3,459559 | 4,599455 | 14,055488 |
| concentración positiva | 0,000775 | 0,000923 | 0,003244 |
| concentración negativa | 0,000796 | 0,000342 | 0,000683 |
| concentración temporal | 0,004943 | 0,004943 | 0,004943 |
| caída máxima desde máximos | 0,152723 | 0,123841 | 0,123154 |
| caída media desde máximos | 0,021861 | 0,016572 | 0,013556 |
| duración de la caída desde máximos | 91 días 05:53:45 | 64 días 09:48:32 | 51 días 23:37:23 |
| ulcer_index | 0,04722 | 0,035056 | 0,029828 |
| calmar_ratio | -0,284854 | -0,137858 | 0,120745 |
| avg_trade_duration | 0 días 06:01:02 | 0 días 07:39:46 | 0 días 04:24:31 |
| bet_frequency | 26 | 66 | 33 |
| bets_per_year | 8 | 21 | 10 |
| num_trades | 2665 | 2665 | 2665 |
| trades_per_year | 888 | 888 | 888 |
| win_rate | 0,495685 | 0,403002 | 0,212383 |
| avg_win | 0,002258 | 0,002348 | 0,002342 |
| avg_loss | -0,002311 | -0,001612 | -0,0016 |
| best_trade | 0,017643 | 0,017643 | 0,017643 |
| worst_trade | -0,01916 | -0,012522 | -0,012522 |
| profit_factor | 0,961558 | 0,983383 | 1,038523 |
| esperanza matemática | -0,000046 | -0,000016 | -0,000762 |
| kelly_criterion | -0,020585 | -0,00681 | -0,325531 |
| operaciones_ganadoras_consecutivas | 6 | 6 | 3 |
| operaciones_perdedoras_consecutivas | 8 | 12 | 3 |
| proporción_de_posiciones_largas | 0,5 | 0,484375 | 1,0 |
| tasa_de_filtrado_de_señales | 0,469546 | 0,469546 | 0,469546 |
| umbral_de_confianza | 0,5 | 0,5 | 0,5 |
Resumen de resultados: estrategias de etiquetado
La exploración de tendencias se perfila como la estrategia más robusta según múltiples métricas:
- Rentabilidad: es la única estrategia con rentabilidades total (+4,5 %) y anualizada (+1,5 %) positivas.
- Rendimiento ajustado al riesgo: los índices de Sharpe (2,62) y de Sortino (4,25) más altos, y la volatilidad (0,52) y el índice de úlcera (0,03) más bajos.
- Resiliencia ante las caídas desde máximos: la menor duración de las caídas desde máximos (52 días) y la menor caída media desde máximos (0,0136).
- Comportamiento de las colas: una fuerte asimetría positiva (2,17) y una elevada curtosis (14,06) sugieren un potencial alcista asimétrico.
- Eficiencia en las operaciones: el factor de beneficio más alto (1,04) a pesar de tener el porcentaje de operaciones ganadoras más bajo (21,2 %).
- Sesgo: totalmente sesgado hacia posiciones largas (proporción de posiciones largas = 1,0), con la mayor concentración positiva (0,0032).
El etiquetado con horizonte temporal fijo y el método de triple barrera presentan rentabilidades negativas y métricas ajustadas al riesgo menos favorables, aunque el método de triple barrera ofrece ventajas en el control de la volatilidad a la baja y en la frecuencia de operaciones.
Conclusión
La metodología de exploración de tendencias resulta útil cuando se aplica con los filtros adecuados, aunque su impacto depende del marco de evaluación. No todas las señales de tendencia merecen la pena para operar: centrarse en los periodos de alta confianza ofrece resultados mucho mejores.
Hemos pasado de marcas temporales erróneas y etiquetas rígidas a un sistema adaptativo y probabilístico que refleja el comportamiento real de las operaciones. La idea clave es de carácter metodológico: adapta tus etiquetas a la realidad de la operativa. Cada decisión de diseño influye en lo que aprende tu modelo: si te equivocas, la complejidad no te servirá de nada; si aciertas, incluso los modelos más sencillos pueden dar excelentes resultados.
El futuro del aprendizaje automático en el ámbito financiero no reside en algoritmos más complejos, sino en una preparación de datos más inteligente. Una vez sentadas estas bases, estamos listos para explorar la siguiente etapa: pesos de las muestras, selección de modelos, validación cruzada y despliegue en producción. El viaje continúa.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19253
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


Lo siento, pero para mí las cifras no cuadran en absoluto:
Rentabilidad total +4,53 %, índice de Sharpe 2,62, caída máxima (DD) 12,32 %, tasa de acierto 21,2 % y luego:
Ganancia media = 0,002342 frente a pérdida media pérdida media = -0,0016 → la expectativa de -0,000762 (-0,076 % por operación) se acerca bastante
Esto da un PR de 0,395 y no de 1,038, y con un número de operaciones de 2665, resulta en una rentabilidad total del -203 % ( 2665 * -0,000762)
Dios mío, ¿todavía te crees esos artículos sobre el Departamento de Defensa?
Tenía un grave error en el método de cálculo de los indicadores de eficacia, del que solo me di cuenta más tarde. Pido disculpas. Es una pena que los autores no tengan la posibilidad de corregir sus errores.
No es asunto mío a qué se dedica el servicio. Además, vuestro traductor, en lugar de «aprendizaje automático», ha escrito «Ministerio de Defensa»)))
Tenía un grave error en el método de cálculo de los indicadores de eficacia, del que solo me di cuenta más tarde. Pido disculpas. Es una pena que los autores no tengan la posibilidad de corregir sus errores.