

Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Extralonger)
 13
 0

Introducción
La predicción de la dinámica de los sistemas complejos es, tradicionalmente, una de las tareas clave del análisis de datos. De la calidad y la profundidad de las previsiones no solo depende el interés académico de los investigadores, sino también resultados de carácter totalmente práctico: la optimización de los flujos, la reducción de costos y la gestión de riesgos. Este problema se manifiesta con mayor intensidad en dos ámbitos que, a primera vista, parecen muy alejados entre sí: los sistemas de transporte inteligentes y los mercados financieros. A primera vista, las carreteras, con sus flujos de vehículos, y los mercados bursátiles, con sus flujos de órdenes, tienen poco en común. Sin embargo, un análisis detallado revela una profunda similitud estructural.
En los estudios sobre transporte, los datos constituyen una red en la que los nodos son estaciones de monitorización y las aristas reflejan las relaciones entre ellos. En el mundo financiero, los activos, las bolsas, los brókeres y las plataformas de negociación desempeñan un papel similar, y entre ellos circulan continuamente la información y el capital. Si en la red viaria la señal es el tráfico de vehículos, en los sistemas financieros esa señal son los precios, los volúmenes, la liquidez y el comportamiento de los participantes en el mercado. En ambos casos, el objetivo consiste en identificar, a partir del análisis de datos históricos, las regularidades de la dinámica espaciotemporal y elaborar una previsión para el futuro.
Los enfoques tradicionales para resolver este tipo de problemas se basaban en un análisis por separado de las componentes espaciales y temporales. En los estudios sobre transporte, esto suponía analizar las series temporales del tráfico independientemente de la topología de la red viaria. En finanzas, métodos análogos se centraban bien en la evolución temporal de las series de precios, bien en las correlaciones estructurales entre activos. Esta brecha entre el espacio y el tiempo genera graves limitaciones: los algoritmos consumen demasiados recursos y su capacidad para realizar previsiones a largo plazo se reduce drásticamente.
La principal dificultad radica en que el procesamiento de las características temporales requiere iteraciones repetidas a lo largo de las relaciones espaciales. Al mismo tiempo, el análisis de las dependencias estructurales entre los nodos requiere múltiples pasadas por el eje temporal. Como resultado, la complejidad de los cálculos aumenta en un orden de magnitud con respecto a los problemas de predicción pura de series temporales. Si a esto le sumamos los volúmenes de datos en rápido crecimiento propios de los sistemas de transporte y los mercados financieros, resulta evidente que, sin un enfoque radicalmente nuevo, es prácticamente imposible avanzar más allá de un horizonte de varias horas o de varios pasos.
Una de las posibles soluciones a este problema fue propuesta por los autores del artículo «Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting». Los autores se inspiran en las ideas de Albert Einstein sobre la indivisibilidad del espacio y el tiempo, y sostienen que los factores espaciales y temporales deben considerarse de forma indisociable y simultánea. Esta idea se plasma en el concepto de «Unified Spatial-Temporal Representation» —una representación espaciotemporal unificada—, que elimina la necesidad de separar artificialmente los datos en componentes temporales y espaciales. La información espacial se incluye en cada paso temporal, y la información temporal, en cada nodo de la red.
En los sistemas de transporte, este enfoque ha permitido, por primera vez en la historia, ampliar el horizonte de previsión de las habituales 2 a 4 horas a una semana entera. En el caso de los mercados financieros, el potencial es aún más impresionante. Imagine un modelo capaz no solo de reaccionar ante impulsos a corto plazo, sino también de elaborar previsiones fundamentadas en horizontes relevantes para el trading estratégico, la gestión de riesgos y la planificación de inversiones. En un contexto en el que incluso una pequeña ventaja a la hora de comprender la dinámica futura de los precios puede traducirse en resultados financieros significativos, la capacidad de realizar previsiones basadas en una representación espaciotemporal unificada abre horizontes totalmente nuevos.
Además, la unificación del espacio y el tiempo reduce drásticamente los costes computacionales. Si en el planteamiento clásico la complejidad de los algoritmos crecía vertiginosamente y, de hecho, limitaba a los investigadores a los límites de un horizonte corto, Extralonger demuestra una reducción de la complejidad en un orden de magnitud. Esto se traduce en un funcionamiento más rápido de los algoritmos y en la posibilidad de aplicarlos en condiciones reales, donde son fundamentales la velocidad de respuesta y la eficiencia en el uso de los recursos. Como resultado, el entrenamiento de los modelos se acelera cientos de veces, y el consumo de memoria se reduce a niveles que permiten realizar previsiones a largo plazo incluso en condiciones de infraestructura limitada.
Para los mercados financieros, este hecho reviste una importancia especial. Y es que el mercado no solo consiste en enormes conjuntos de datos históricos, sino también en un flujo continuo de nuevas señales que requieren un procesamiento en tiempo real. Las arquitecturas tradicionales solían tropezar precisamente en esta fase. La complejidad excesiva les impedía hacer frente a las tareas de planificación a largo plazo y las obligaba a sacrificar velocidad o fiabilidad. Y, a veces, ambas cosas. El framework Extralonger demuestra que estos compromisos ya no son necesarios.
El algoritmo Extralonger
La mayoría de los modelos de predicción existentes se basan en la denominada representación clásica de los datos.
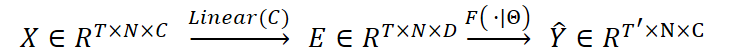
donde T es la longitud de la ventana temporal, N es el número de nodos de la red, C es el número de características originales y D es la dimensión del espacio de características transformado.
En la práctica, esto significa que los datos se proyectan primero de forma lineal en un espacio de dimensión fija y, a continuación, se procesan mediante módulos encargados de extraer la información temporal y espacial.
La arquitectura clásica suele incluir dos tipos de módulos: el temporal y el espacial. Se pueden combinar en distinto orden: primero analizar el tiempo y luego el espacio. O, a la inversa, intentar procesar ambas dimensiones a la vez. Sin embargo, en la práctica, cualquier división de este tipo presentaba el mismo inconveniente: procesar las características a lo largo de un eje requería múltiples iteraciones sobre el otro. Como consecuencia, la complejidad computacional aumentaba rápidamente. Por ejemplo, en el caso de los mecanismos de autoatención, alcanzaba un orden de O(NT2 + TN2), con un aumento similar del consumo de memoria. Para los mercados financieros, esto significa que la predicción en horizontes largos se vuelve extremadamente intensiva en recursos. Los grandes volúmenes de cotizaciones históricas y de interrelaciones entre instrumentos simplemente sobrecargan el sistema.
Ya se habían realizado intentos anteriores para eludir estas restricciones. En particular, mediante modelos convolucionales (CNN). En este caso, los datos se procesaban como una imagen, en la que un eje corresponde al tiempo y el otro, al conjunto de nodos. Este enfoque permite, efectivamente, considerar el espacio y el tiempo de forma simultánea, pero tiene sus limitaciones. La ventana de convolución no permite abarcar la imagen completa, sino solo regiones locales. Además, la complejidad del algoritmo se expresaba en este caso como O(k2TN), donde k es el tamaño del núcleo de convolución, lo que, de todos modos, limitaba las posibilidades de ampliar el horizonte.
El framework Extralonger cambia radicalmente esta situación mediante la introducción de Unified Spatial-Temporal Representation: una representación espaciotemporal unificada. La esencia de la idea es sencilla: el espacio y el tiempo no están separados, sino que se describen de forma unificada. Para ello, la representación inicial X∈RT×N×C se comprime primero en la dimensión de características, tras lo cual se aplican dos proyecciones lineales: una en el espacio y otra en el tiempo. Como resultado, se forman dos conjuntos de representaciones:
- Et ∈ RT×D: cada paso temporal contiene información sobre todos los nodos de la red,
- Es ∈ RN×D: cada nodo acumula datos de todos los pasos temporales.
De este modo, cada observación empieza a contener una representación espaciotemporal completa, y no solo un corte local. Ahí radica la diferencia fundamental: si la representación clásica se basaba en características particulares, la nueva proporciona una cobertura integral.
Este enfoque presenta una serie de ventajas fundamentales. En primer lugar, la reducción de la complejidad. Al eliminar las iteraciones redundantes, las dependencias temporales y espaciales se procesan ahora conjuntamente, y la complejidad del algoritmo se reduce a O(T2 + N2). Esto permite construir pronósticos a decenas y cientos de pasos por delante, sin topar con el límite de los recursos computacionales.
En segundo lugar, agregación simultánea. Mientras que los métodos clásicos se veían obligados a avanzar a lo largo de un único eje, incorporando gradualmente información desde el otro, Extralonger permite que cada nodo esté conectado directamente con todos los demás en cualquier paso temporal. Por lo tanto, el algoritmo es capaz de tener en cuenta simultáneamente la interacción entre los distintos instrumentos y la dinámica de su evolución a lo largo del tiempo, lo cual es de vital importancia para un análisis integral de las correlaciones y las relaciones entre mercados.
Y, por último, en tercer lugar, cobertura completa del campo receptivo. Mediante el uso de autoatención en el marco de una representación unificada, Extralonger garantiza la conexión de cada nodo con cualquier otro nodo en todos los instantes temporales. Esto permite al modelo detectar las dependencias de más largo alcance, desde ciclos diarios y semanales hasta patrones más complejos relacionados, por ejemplo, con la estacionalidad del mercado de valores o con fases de tendencia que se prolongan durante varios días. A modo de comparación: en las RNN, en Attention o en modelos Transformer clásicos, la agregación se realiza por dimensiones separadas, mientras que las CNN están limitadas a una ventana de percepción local.
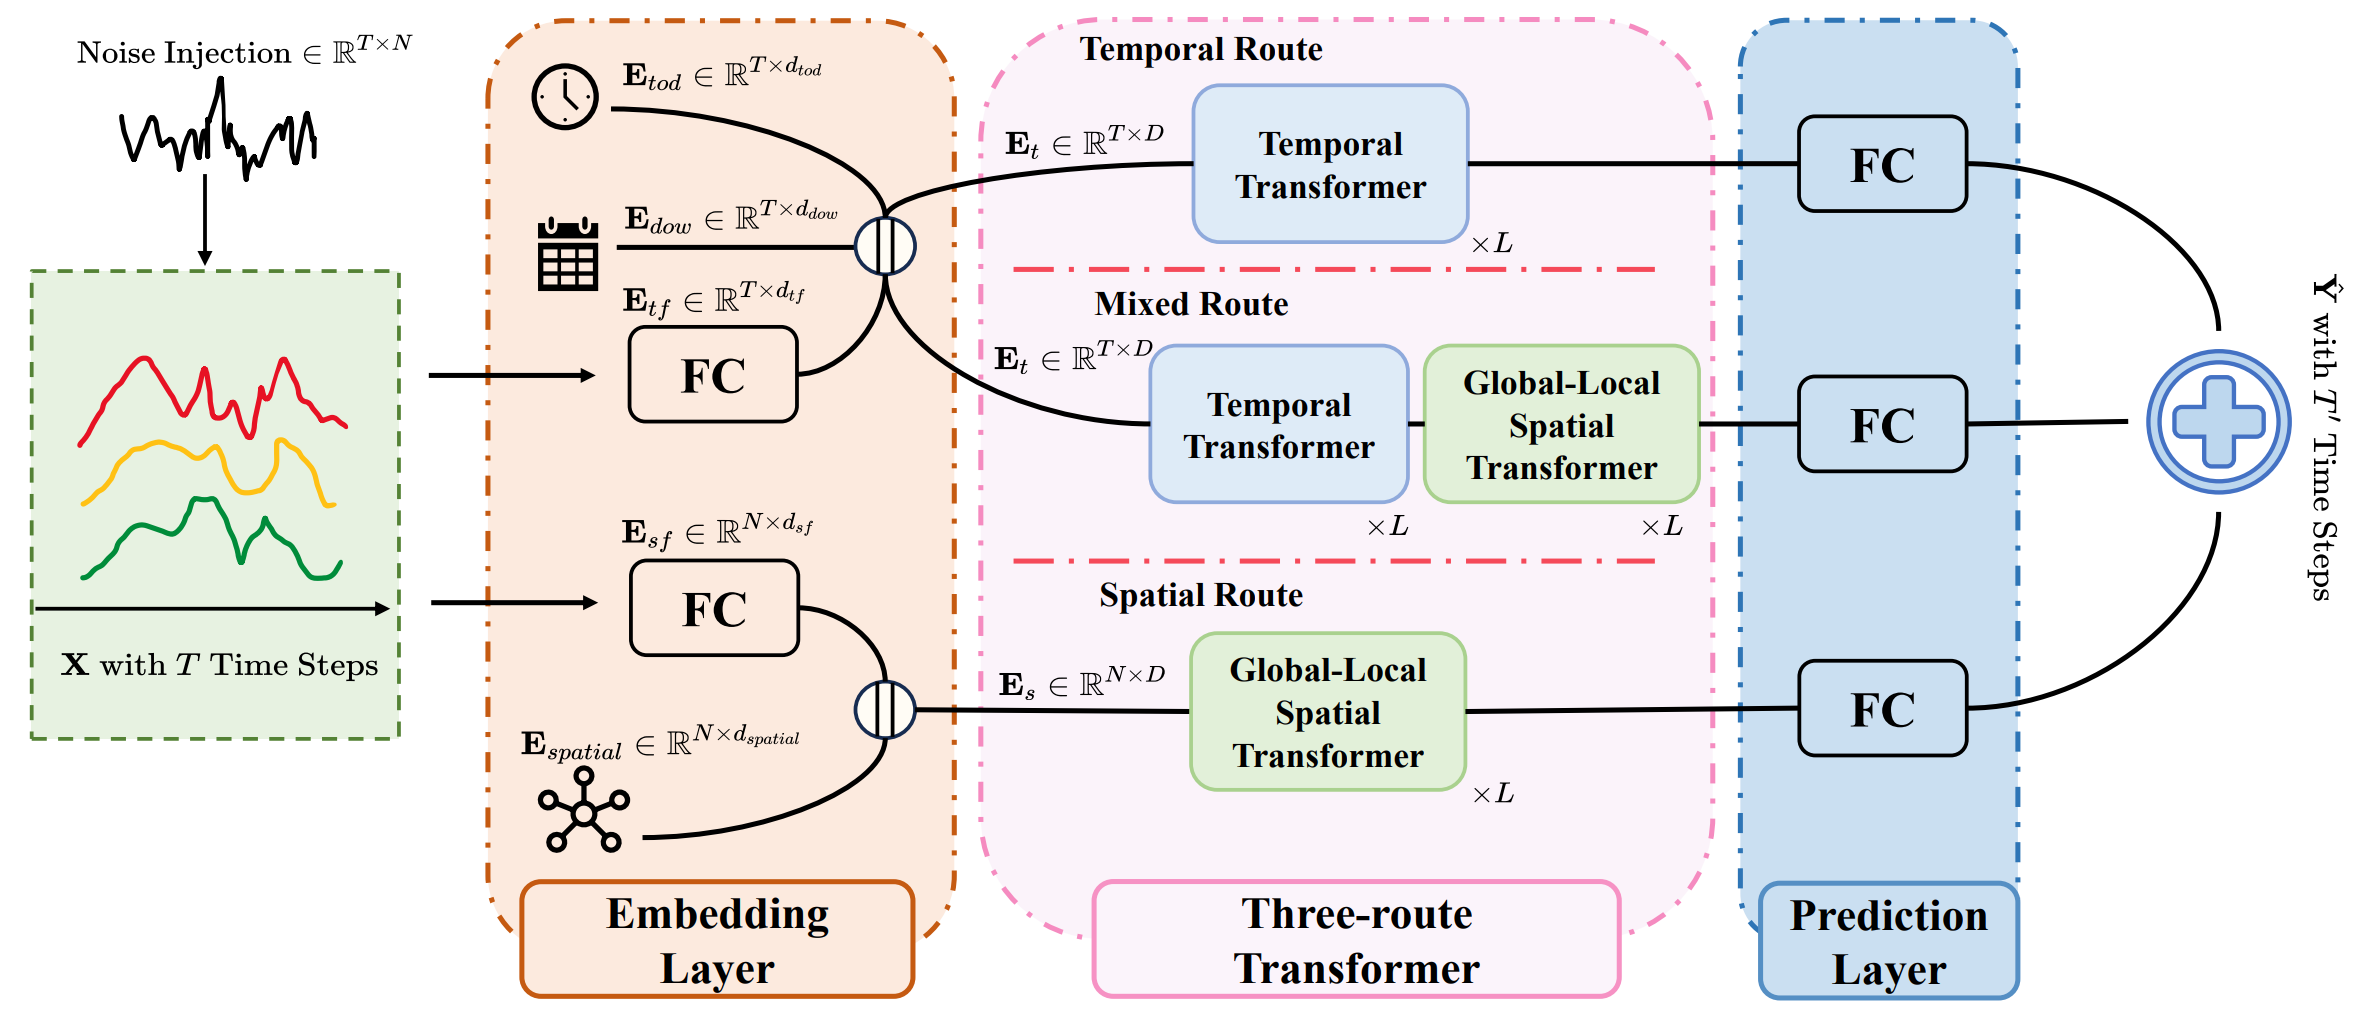
La arquitectura de Extralonger se compone de tres componentes principales:
- capa de embedding (embedding layer),
- módulo Transformer de tres rutas (three-route Transformer)
- capa de predicción (prediction layer).
La capa de embedding transforma los datos de origen en una representación interna que incluye dos elementos clave: la representación espacial Es y la representación temporal Et. La particularidad de la arquitectura radica en que los datos se someten a preprocesamiento ya en la entrada. Se introduce ruido entrenable en el conjunto de datos de partida X, lo que contribuye a aumentar la robustez del modelo frente a las fluctuaciones ruidosas del mercado.
A continuación, se aplican dos proyecciones lineales totalmente conectadas: una forma características temporales Etf∈RT×dtf, y la otra, características espaciales Esf∈RN×dsf.
Con el fin de captar la ciclicidad propia de los procesos reales, se han incorporado embeddings de periodicidad entrenables a la arquitectura Extralonger. Para el eje temporal se utiliza el embedding timestamp-of-day Etod∈RT×d_tod, que refleja el ciclo diario, y day-of-week Edow∈RT×d_dow, que modela la estacionalidad semanal. Del mismo modo, para la dimensión espacial se introduce un embedding entrenable Espatial∈RN×d_spatial, que permite detectar patrones espaciales estables.
Las representaciones finales se obtienen mediante la concatenación de estos embeddings:
- representación temporal Et = Etf ‖ Etod ‖ Edow ∈ RT×D,
- representación espacial Es = Esf ‖ Espatial ∈ RN×D.
De este modo, ya en la fase de formación de características, se incorporan al modelo los ciclos fundamentales y las relaciones espaciales. Esto resulta especialmente valioso para los mercados financieros: las fluctuaciones diarias de la liquidez, los ritmos semanales de actividad y las correlaciones entre instrumentos y plataformas de negociación se reflejan de inmediato en la estructura de los datos.
El núcleo del sistema es un Transformer de tres rutas, en el que funcionan en paralelo tres vías: temporal, espacial y mixta. Gracias al uso de una representación espaciotemporal unificada, las tres rutas son capaces de tener en cuenta simultáneamente tanto la estructura temporal como la espacial de los datos. Cada ruta se centra en su propio objetivo. El Transformer temporal, tanto en la ruta puramente temporal como en la mixta, se implementa como codificador Transformer estándar, mientras que la ruta espacial y la ruta mixta se complementan con un módulo especial: Global-Local Spatial Transformer, que permite captar de forma eficaz tanto las relaciones locales como las globales.
A diferencia del mecanismo estándar de autoatención, en el que todos los nodos de la red se procesan de la misma manera y sin tener en cuenta su estructura real, el Global-Local Spatial Transformer se ha diseñado específicamente para aprovechar las características topológicas del sistema objeto de estudio. En un problema de transporte, se trata de una red vial en la que algunas estaciones están conectadas directamente, mientras que otras lo están solo de forma indirecta. En el mundo de las finanzas, una estructura análoga se manifiesta en forma de grafo de activos: algunos valores están fuertemente correlacionados entre sí, mientras que otros solo están relacionados a través de las tendencias generales del mercado.
El Transformer tradicional considera que todas las relaciones tienen la misma importancia. Esto permite representar la estructura global, pero, al mismo tiempo, conduce a la difuminación de las particularidades locales. Por el contrario, los modelos que se centran exclusivamente en las relaciones locales captan bien los detalles, pero pierden la capacidad de percibir las dependencias de largo alcance. Es precisamente aquí donde surge la necesidad de encontrar un equilibrio: considerar, al mismo tiempo, las regularidades globales y las locales.
El módulo GLST pone en práctica esta idea de forma directa, combinando dos mecanismos de atención: el global y el local. En la primera etapa, a partir de la representación espacial Es se construyen las matrices Query, Key y Value. A partir de ellos se calculan los coeficientes de atención global.
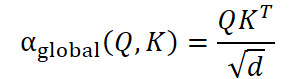
Esta matriz refleja la intensidad de las relaciones entre todos los nodos a la vez. En el contexto financiero, esto puede entenderse como una matriz de correlaciones cruzadas entre instrumentos.
A continuación, entra en juego la atención local. Para formarla se utiliza la matriz de adyacencia A, que define la estructura de las conexiones reales. En los problemas de transporte, A codifica las conexiones viarias; en el ámbito financiero, en cambio, esta matriz puede corresponder a un grafo de correlaciones estables o a una red de influencias recíprocas entre instrumentos. La aplicación de A limita la atención únicamente a los nodos adyacentes, creando así un componente local.

donde ⊙ es el producto elemento a elemento.
De este modo, la parte global capta dependencias amplias, mientras que la parte local centra la atención en las conexiones más cercanas y significativas.
Ambas matrices se someten a una normalización SoftMax y se combinan en una única expresión.
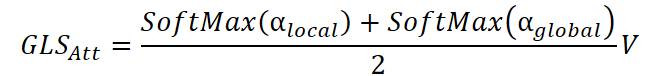
El resultado es una agregación equilibrada, en la que cada nodo recibe simultáneamente información sobre todo el sistema y sobre las conexiones más cercanas.
Luego, siguiendo el espíritu del Transformer clásico, se aplica una capa de normalización, conexiones residuales (skip-connection) y una red Feed-Forward. Estos pasos forman la representación espacial actualizada final Ês.
Es importante destacar que este módulo encaja de forma especialmente natural en los mercados financieros. Las correlaciones entre activos varían con el tiempo; las relaciones entre los instrumentos pueden ser estables o dinámicas. El uso de la atención global-local aporta flexibilidad al modelo: este puede adaptarse a la estructura actual del mercado, distinguir entre dependencias sólidas y temporales y, por lo tanto, generar una previsión más fiable.
Como resultado, el Global-Local Spatial Transformer se convierte en una especie de puente entre los niveles micro y macro de análisis. A nivel micro, rastrea las señales locales del mercado y las interrelaciones a corto plazo. A nivel macro, detecta las tendencias globales y las correlaciones a largo plazo. La combinación de estas dos perspectivas hace que el modelo sea potente desde el punto de vista teórico y aplicable a la operativa real, donde es precisamente la combinación de los detalles y el contexto global lo que determina el éxito de las estrategias.
Una vez que el Transformer de tres rutas finaliza el procesamiento de los datos y genera representaciones espaciotemporales, llega la etapa final: la predicción. Su objetivo consiste en convertir los embeddings abstractos en valores predictivos concretos para un horizonte de planificación determinado.
Para ello se utilizan proyecciones lineales que convierten los tensores de salida del espacio oculto de nuevo al formato de predicciones. Dado que la formulación del problema en Extralonger es asimétrica (T → T′), es decir, que la longitud de la ventana histórica T y la longitud del intervalo de predicción T′ no coinciden, es necesario proyectar explícitamente las salidas del Transformer a la dimensionalidad T′. En otras palabras, a partir de un fragmento histórico de duración fija obtenemos una previsión para un horizonte más largo o más corto, lo cual es especialmente importante en los mercados financieros, donde el tamaño de la ventana puede adaptarse en función de la estrategia.
Tras la proyección, se combinan los resultados de las tres rutas (temporal, espacial y mixta). En este caso, los autores del framework no utilizan el entrenamiento automático de los pesos, sino una combinación predefinida: el ajuste manual de los coeficientes de ponderación. Este enfoque permite ajustar de forma explícita la contribución de cada ruta a la previsión final: si se desea, se puede potenciar el papel del componente temporal en los mercados con tendencias marcadas o, por el contrario, hacer hincapié en las dependencias espaciales si resulta más importante la estructura de las correlaciones entre activos.
En conjunto, la arquitectura propuesta convierte a Extralonger en una potente herramienta, en la que cada módulo potencia al resto. La ruta temporal captura dinámicas extendidas de las cotizaciones y los volúmenes; la espacial, las interdependencias entre activos y mercados; y la mixta combina ambos aspectos, creando una percepción integral del panorama del mercado.
A continuación se muestra una representación gráfica del framework Extralonger, elaborada por el autor.
Implementación mediante MQL5
Tras analizar los aspectos teóricos del framework Extralonger, pasamos a la parte práctica de nuestro trabajo, en la que intentaremos recrear una de las posibles variantes de implementación de sus algoritmos mediante MQL5. La ventaja de la arquitectura propuesta por los autores radica en su modularidad. Cada componente puede aislarse, probarse y, si es necesario, sustituirse o perfeccionarse. Esto resulta especialmente valioso para los sistemas de trading, en los que son importantes la flexibilidad y la capacidad de adaptación a las particularidades de mercados concretos. En nuestro caso, también seguiremos un enfoque de desarrollo por etapas —módulo a módulo—, aprovechando al máximo el conjunto de objetos ya desarrollados para evitar la duplicación de funcionalidades.
Como se ha señalado en la parte teórica, el procesamiento de los datos de partida comienza con la adición de ruido entrenable. En este sentido, es importante destacar que, en este contexto, por «ruido» no se entiende la componente aleatoria tradicional generada por los generadores de números pseudoaleatorios. Por el contrario, se trata de una matriz de parámetros entrenables que actúa como un sesgo adicional. En otras palabras, no se trata de una distorsión caótica, sino de una ampliación deliberada del espacio de características que permite al modelo captar dependencias ocultas que no resultan evidentes en los datos originales.
Si establecemos una analogía con las arquitecturas clásicas, esta capa desempeña la misma función que la codificación posicional entrenable en los modelos Transformer. Allí permite al modelo distinguir posiciones en una secuencia temporal, mientras que aquí añade la posibilidad de desplazar los datos en una dirección favorable para la posterior extracción de patrones. Y es precisamente esta característica la que hace que este enfoque resulte especialmente valioso para los mercados financieros: estos sesgos pueden, de hecho, codificar patrones estacionales estables o correlaciones débiles que no se reflejan directamente en las series de precios.
En nuestra biblioteca ya existe el objeto CNeuronLearnabledPE, que cumple una función similar. Su finalidad consiste en añadir un sesgo posicional entrenable a los datos originales y, en el contexto de la implementación del framework Extralonger, encaja perfectamente con la tarea del ruido entrenable. En esencia, podemos recurrir a una solución ya existente y probada a lo largo del tiempo, sin necesidad de inventar un nuevo componente.
Esto no solo ahorra esfuerzo, sino que también garantiza la estabilidad, ya que el objeto ha sido probado en experimentos anteriores.
La siguiente etapa, tras añadir el sesgo entrenable, consiste en la formación de proyecciones en los planos temporal y espacial. En la descripción teórica del framework Extralonger, para ello se utilizan dos capas totalmente conectadas que, al funcionar en paralelo, generan dos conjuntos de embeddings.
En nuestra implementación, podemos asignar esta tarea a los objetos de la capa convolucional CNeuronConvOCL. Es una solución natural y práctica. Las operaciones de convolución ya han demostrado su eficacia como herramienta versátil para transformar arrays de entrada. Permiten gestionar fácilmente el número de canales de entrada y salida especificando el tamaño del kernel. Por lo tanto, la formación de proyecciones temporales y espaciales puede implementarse como dos capas convolucionales paralelas: la primera opera a lo largo del eje temporal y forma Et, mientras que la segunda opera a lo largo del eje de los nodos y forma Es. Esto corresponde plenamente a la idea de los autores de Extralonger y, al mismo tiempo, mantiene la uniformidad de nuestra implementación.
Adición de embeddings espaciales
A continuación viene la etapa de adición de embeddings espaciales y temporales. A primera vista, no parece haber ninguna dificultad especial. Ya nos hemos encontrado con operaciones similares. La creación de un embedding espacial en condiciones de una estructura de datos fija se asemeja al paso anterior, con la adición de ruido entrenable. Sin embargo, en esta fase no sumamos los tensores, sino que los concatenamos, combinando la información procedente de diferentes fuentes. El proceso se ha organizado en un nuevo objeto, CNeuronSpatialEmbedding, que hereda la funcionalidad básica de CNeuronBaseOCL y la amplía para adaptarla a nuestras tareas.
class CNeuronSpatialEmbedding   :     public CNeuronBaseOCL
  {
protected:
   uint              iWindow;
   uint              iUnits;
   uint              iEmbeddingDim;
   CParams           cEmbedding;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpatialEmbedding(void) {};
                    ~CNeuronSpatialEmbedding(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSpatialEmbedding;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
La arquitectura de la neurona se define en el método de inicialización Init. Es precisamente aquí donde se definen sus parámetros clave: el número de secuencias unitarias, el tamaño de cada una de ellas y la dimensión del embedding.
bool CNeuronSpatialEmbedding::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint units, uint window, uint embed_dim,
                                   ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, (window + embed_dim)*units,
                                                           optimization_type, batch))
      return false;
   activation = None;
Dentro del método, primero se invoca la inicialización de la clase padre de la neurona compatible con OpenCL. La dimensión del tensor de resultados se calcula como la suma de la longitud de la representación de una secuencia unitaria y la del embedding, multiplicada por el número de dichas secuencias. Si la inicialización básica no se realiza correctamente, el método finaliza adecuadamente su ejecución devolviendo una indicación de error.
Después la neurona configura la función de activación, aunque por el momento no se utiliza para la propia neurona.
A continuación, inicializamos el objeto de generación de embeddings. Y aquí ya utilizamos la tangente hiperbólica TANH como función de activación, lo que aporta no linealidad y limita los valores al intervalo [-1, 1]. Esto ayuda al modelo a formar representaciones más estables de las regularidades del mercado y evita que los valores extremos influyan en exceso en el proceso de aprendizaje.
   if(!cEmbedding.Init(0, 0, OpenCL, embed_dim * units, optimization, iBatch))
      return false;
   cEmbedding.SetActivationFunction(TANH);
//---
   iUnits = units;
   iWindow = window;
   iEmbeddingDim = embed_dim;
//---
   return true;
  }
Luego se guardan los parámetros de la neurona para las operaciones posteriores de propagación directa e inversa.
Como resultado, el método Init combina armoniosamente la teoría con la práctica. La neurona queda totalmente preparada para procesar datos, concatenar embeddings y transmitir la información estructurada a la siguiente etapa. Esto sienta una base sólida para desarrollar modelos de trading capaces de analizar las señales del mercado en distintos horizontes temporales e identificar dependencias ocultas importantes para tomar decisiones de trading bien fundamentadas.
En el método feedForward se construye un algoritmo de propagación directa de los datos a través de la neurona, desde las entradas hasta las salidas. En el contexto financiero, esto es similar a cómo un trader analiza secuencialmente los datos históricos y forma una representación integral de la situación actual del mercado.
En primer lugar, se comprueba si el puntero pasado a la neurona anterior NeuronOCL sigue siendo válido. Si no existe, el método devuelve directamente false. Esto es importante. Sin datos de partida, la propagación directa no es posible, del mismo modo que sin cotizaciones de mercado no es posible tomar decisiones.
bool CNeuronSpatialEmbedding::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
A continuación, si la neurona se encuentra en modo de entrenamiento (bTrain=true), se invoca la propagación directa para el objeto cEmbedding. Aquí se generan embeddings espaciales que codifican las dependencias clave del mercado en la ventana de datos seleccionada. Si esta operación no se ha realizado correctamente, el método devuelve false para indicar que se ha producido un problema al crear los embeddings.
   if(bTrain)
      if(!cEmbedding.FeedForward())
         return false;
Tenga en cuenta que la operación solo se lleva a cabo durante el proceso de entrenamiento. Y es que, en este caso, los embeddings no dependen de los datos originales, sino que únicamente codifican las posiciones de las secuencias. Por lo tanto, durante el uso operativo, los valores permanecen fijos y eliminamos operaciones superfluas, lo que permitirá acelerar la toma de decisiones.
Una vez generados los embeddings, llega el paso clave: la concatenación de los datos originales con los embeddings. El método Concat combina las salidas de la neurona anterior y del embedding en un único tensor Output, teniendo en cuenta el tamaño de la representación de cada secuencia unitaria y la dimensión del embedding.
   if(!Concat(NeuronOCL.getOutput(), cEmbedding.getOutput(), Output, iWindow, iEmbeddingDim, iUnits))
      return false;
//---
   return true;
  }
Por último, si todas las operaciones se han realizado correctamente, el método devuelve true, lo que indica que la propagación directa de la neurona se ha ejecutado correctamente y que el tensor de resultados está listo para transmitirse a la siguiente capa del modelo.
Como se puede observar, el algoritmo del método de propagación directa es bastante sencillo y tiene una estructura lineal. Comprueba secuencialmente los datos de entrada, genera embeddings espaciales y los concatena con las salidas de la capa anterior, creando así un tensor listo para transmitirse. Los métodos de propagación inversa están organizados de forma similar: repiten la misma estructura, pero en sentido contrario. Gracias a esta organización tan clara y coherente, ambos métodos resultan fáciles de comprender y permiten centrarse en las características clave del funcionamiento de la neurona con series temporales de datos financieros.
Para profundizar en el tema, se recomienda consultar por cuenta propia la implementación de la propagación inversa. El código completo de la clase CNeuronSpatialEmbedding y de todos sus métodos se incluye en el archivo adjunto, lo que permite seguir el funcionamiento de la neurona desde su inicialización hasta la generación de embeddings y la transmisión de información al modelo.
Embedding temporal
Con los embeddings temporales, la situación resulta un poco más complicada. En primer lugar, son varios, y cada uno codifica distintos ciclos temporales. Los autores del framework proponen utilizar dos niveles: intradía e intrasemanal. Se trata de una tarea que ya conocemos de experimentos anteriores con el codificador temporal del framework HimNet, en los que también generábamos embeddings de series temporales. En aquel entonces se utilizaban bloques recurrentes, y en cada paso el tensor de datos de entrada solo recibía los embeddings del estado analizado.
Ahora la tarea es un poco más complicada. En cada pasada por la neurona se analiza una secuencia temporal completa, y cada uno de sus pasos temporales debe recibir sus propios embeddings. Esto se asemeja al trabajo de un trader que no se limita a fijarse en el precio actual o en un indicador, sino que evalúa al mismo tiempo toda una serie de señales históricas para detectar ciclos y patrones ocultos.
Por supuesto, vamos a utilizar el trabajo previo realizado con HimNet, pero lo adaptaremos a la nueva arquitectura, en la que los embeddings temporales se generan simultáneamente para todos los pasos de la secuencia, lo que permite al modelo captar con mayor precisión la dinámica del mercado y reaccionar de forma más adecuada a sus cambios.
Comenzamos a trabajar en la construcción del algoritmo de embeddings temporales en el lado del programa OpenCL, donde creamos el kernel ConcatByLabel. Este kernel resuelve la tarea de concatenar los datos de origen con varios niveles de embeddings; en nuestro caso, se trata de dos embeddings temporales correspondientes a los ciclos intradía e intrasemanales. En el contexto financiero, esto equivale a analizar varios horizontes temporales a la vez: tanto las fluctuaciones a corto plazo como los ciclos más largos influyen en el pronóstico, y el modelo debe tenerlos todos en cuenta.
El kernel utiliza una malla tridimensional de identificadores globales: row_id, col_id y buffer_id. Esto nos permite procesar simultáneamente las filas y las columnas del tensor de origen, así como elegir con qué búfer trabajamos: los datos originales o uno de los embeddings.
__kernel void ConcatByLabel(__global const float* data,
                            __global const float* label,
                            __global const float* embedding1,
                            __global const float* embedding2,
                            __global float *output,
                            const int dimension_data,
                            const int dimension_emb1,
                            const int dimension_emb2,
                            const int frame1,
                            const int frame2,
                            const int period1,
                            const int period2
                           )
  {
   const size_t row_id = get_global_id(0);
   const size_t col_id = get_global_id(1);
   const size_t buffer_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_cols = get_global_size(1);
   const size_t total_buffers = get_global_size(2);
En primer lugar, se asignan identificadores globales a cada elemento de trabajo (work-item):
- row_id: índice de la fila, que corresponde a una marca temporal o a un paso temporal;
- col_id: índice de columna, que corresponde a una variable o característica concreta;
- buffer_id: determina con qué búfer trabaja este elemento de trabajo (work-item): datos de origen, primer o segundo embedding.
Las dimensiones globales del espacio de tareas determinan la cuadrícula general de elementos de trabajo (work-items). En este caso, es importante tener en cuenta que total_buffers determina cuántos conjuntos de datos diferentes concatenamos. En función de ello, se determina la dimensión final del vector de salida.
   __global const float *buffer;
   int dimension_in, dimension_out;
   int shift_in, shift_out;
//---
   switch(total_buffers)
     {
      case 1:
         dimension_out = dimension_data;
         break;
      case 2:
         dimension_out = dimension_data + dimension_emb1;
         break;
      case 3:
         dimension_out = dimension_data + dimension_emb1 + dimension_emb2;
         break;
      default:
         return;
     }
Si hay más de tres búferes, el kernel simplemente finaliza su ejecución, lo que evita un uso incorrecto.
El siguiente paso consiste en seleccionar un búfer concreto y calcular los desplazamientos para la lectura y la escritura de datos.
   switch(buffer_id)
     {
      case 0:
         buffer = data;
         dimension_in = dimension_data;
         shift_in = RCtoFlat(row_id, col_id, total_rows, dimension_in, 0);
         shift_out = RCtoFlat(row_id, col_id, total_rows, dimension_out, 0);
         break;
      case 1:
         buffer = embedding1;
         dimension_in = dimension_emb1;
         shift_in = ((int)IsNaNOrInf(label[row_id] / frame1, 0)) % period1;
         shift_in = RCtoFlat(shift_in, col_id, period1, dimension_in, 0);
         shift_out = RCtoFlat(row_id, dimension_data + col_id, total_rows, dimension_out, 0);
         break;
      case 2:
         buffer = embedding2;
         dimension_in = dimension_emb2;
         shift_in = ((int)IsNaNOrInf(label[row_id] / frame2, 0)) % period2;
         shift_in = RCtoFlat(shift_in, col_id, period2, dimension_in, 0);
         shift_out = RCtoFlat(row_id, dimension_data + dimension_emb1 + col_id, total_rows,
                                                                           dimension_out, 0);
         break;
     }
Para los datos de origen, shift_in y shift_out se calculan directamente mediante la función RCtoFlat, que convierte los índices bidimensionales de fila y columna en un índice lineal del búfer global.
En el caso de los embeddings, shift_in depende del valor de la marca temporal de un paso individual de la secuencia label[row_id], dividido por el periodo (frame1 o frame2). Esto permite seleccionar de forma cíclica el embedding correspondiente a una fase concreta del ciclo temporal, lo cual resulta especialmente importante en el caso de los datos financieros con patrones intradía e intrasemanales recurrentes.
Una vez finalizado el trabajo preparatorio, se escriben los datos correspondientes en el búfer de resultados.
   if(col_id < dimension_in)
      output[shift_out] = IsNaNOrInf(buffer[shift_in], 0);
  }
Aquí cabe señalar que presuponemos el uso de distintas dimensionalidades para los datos de origen y los embeddings. Al poner el kernel en la cola de ejecución, se prevé utilizar el parámetro máximo; por lo tanto, antes de realizar operaciones de acceso a los búferes, comprobamos que el índice de columna se corresponda con el búfer utilizado. Además, los datos se limpian de valores no válidos (NaN o Inf) para no afectar a los cálculos posteriores.
Como resultado, el kernel genera un tensor totalmente concatenado que tiene en cuenta todos los embeddings especificados y los datos de entrada. Cada paso temporal recibe su propio conjunto de embeddings, lo que permite al modelo ver toda la dinámica del mercado de forma simultánea, incluidas las fluctuaciones a corto plazo y los ciclos más largos, mejorando así la calidad de las predicciones y la estabilidad de los modelos de trading.
Una vez diseñado el algoritmo de propagación directa, el siguiente paso lógico es organizar el proceso de retropropagación del error. Si la propagación directa genera embeddings y los combina con los datos originales, la propagación inversa se encarga de ajustar los pesos y mejorar la calidad de la representación de la información. En el contexto financiero, esto se asemeja al trabajo de un trader que, al evaluar las consecuencias de las decisiones tomadas anteriormente, ajusta su estrategia de cara al siguiente paso. Los errores de predicción en los pasos temporales anteriores permiten al modelo ajustar los embeddings para reflejar mejor la dinámica del mercado.
En este caso, la propagación inversa se lleva a cabo entre los datos originales y los embeddings correspondientes. Y se implementa en el kernel ConcatByLabelGrad. En esencia, se trata de un paso en el que la red devuelve los errores a cada componente, lo que permite ajustar los pesos y mejorar la predicción.
__kernel void ConcatByLabelGrad(__global float* data_gr,
                                __global const float* label,
                                __global float* embedding1_gr,
                                __global float* embedding2_gr,
                                __global float *output_gr,
                                const int dimension_data,
                                const int dimension_emb1,
                                const int dimension_emb2,
                                const int frame1,
                                const int frame2,
                                const int period1,
                                const int period2,
                                const int units
                               )
  {
   const size_t row_id = get_global_id(0);
   const size_t col_id = get_global_id(1);
   const size_t buffer_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_cols = get_global_size(1);
   const size_t total_buffers = get_global_size(2);
//---
   __global float *buffer;
   int dimension_in, dimension_out;
   int shift_in, shift_out, shift_col;
   int period, frame, rows;
En primer lugar, cada elemento de trabajo se identifica en el espacio tridimensional de tareas. Esto permite que un elemento de trabajo procese una combinación concreta de paso temporal, característica y búfer.
A continuación, se determina la dimensionalidad final del tensor de resultados, en este caso, de los gradientes de error.
   switch(total_buffers)
     {
      case 1:
         dimension_out = dimension_data;
         break;
      case 2:
         dimension_out = dimension_data + dimension_emb1;
         break;
      case 3:
         dimension_out = dimension_data + dimension_emb1 + dimension_emb2;
         break;
      default:
         return;
     }
Creo que habrán notado la repetición de las operaciones del kernel de propagación directa. Sin embargo, a partir de aquí nos esperan algunas diferencias. Si el búfer que se está procesando contiene los datos originales (buffer_id == 0), los gradientes simplemente se copian directamente desde el búfer de gradientes de error en el nivel de resultados. A continuación, finalizamos la ejecución del kernel.
   switch(buffer_id)
     {
      case 0:
         if(col_id < dimension_data && row_id<units)
           {
            shift_in = RCtoFlat(row_id, col_id, total_rows, dimension_in, 0);
            shift_out = RCtoFlat(row_id, col_id, total_rows, dimension_out, 0);
            data_gr[shift_in] = IsNaNOrInf(output_gr[shift_out], 0);
           }
         return;
Sin embargo, en el caso de los embeddings (buffer_id == 1 o 2), el algoritmo es un poco más complejo. Aquí, en primer lugar, determinamos para qué periodo y con qué desplazamiento vamos a recopilar los gradientes.
      case 1:
         rows = period1;
         buffer = embedding1_gr;
         dimension_in = dimension_emb1;
         shift_in = RCtoFlat(row_id, col_id, period1, dimension_in, 0);
         shift_col = dimension_data;
         period = period1;
         frame = frame1;
         break;
      case 2:
         rows = period2;
         buffer = embedding2_gr;
         dimension_in = dimension_emb2;
         shift_in = RCtoFlat(row_id, col_id, period2, dimension_in, 0);
         shift_col = dimension_data + dimension_emb1;
         period = period2;
         frame = frame2;
         break;
     }
A continuación, comprobamos si el elemento de trabajo actual cae dentro de las dimensiones del embedding correspondiente, según la dimensión de la representación y la periodicidad de los datos. Y solo después de eso organizamos un ciclo que recorre todos los pasos temporales del tensor de gradientes de error a nivel de resultados y acumula la contribución del error para cada embedding.
   if(row_id >= rows || col_id >= dimension_in)
      return;
   float grad = 0;
   for(uint r = 0; r < total_rows; r ++)
     {
      int row = ((int)IsNaNOrInf(label[r] / frame, 0)) % period;
      if(row != row_id)
         continue;
         shift_out = RCtoFlat(r, shift_col + col_id, total_rows, dimension_out, 0);
      grad += IsNaNOrInf(output_gr[shift_out], 0);
     }
   buffer[shift_in] = IsNaNOrInf(grad, 0);
  }
En el cuerpo del ciclo, primero calculamos a qué objeto de periodicidad corresponde el paso actual, para que los gradientes se acumulen según la posición de fase correspondiente del ciclo temporal. Y solo cuando el valor obtenido coincide con el elemento analizado, sumamos los errores a nivel de resultados.
El gradiente de error acumulado se guarda en el búfer global de gradientes del embedding correspondiente. Al mismo tiempo, no olvidemos limpiar el resultado obtenido de valores no válidos (NaN o Inf).
Como resultado, el kernel ConcatByLabelGrad distribuye cuidadosamente los errores entre los datos de origen y los embeddings, garantizando una actualización correcta de los pesos en todos los niveles de la secuencia temporal. Esto permite que el modelo se adapte a los complejos ciclos de las series temporales financieras, mejorando la precisión de los pronósticos y la robustez frente al ruido.
Hemos realizado un trabajo considerable, y el artículo ya resulta bastante sustancioso. Propongo que hagamos una pequeña pausa para que la información se asiente y podamos percibirla con calma. Continuaremos con la implementación que hemos iniciado y la analizaremos en detalle en el próximo artículo.
Conclusión
En este artículo nos hemos familiarizado con el framework Extralonger, que integra factores espaciales y temporales en un único modelo para la predicción de series temporales. Este enfoque permite reducir considerablemente la complejidad computacional y los requisitos de memoria en comparación con los métodos clásicos. Esto amplía los horizontes de predicción hasta escalas sin precedentes.
El valor particular de este enfoque radica en proporcionar a cada elemento de la secuencia temporal su propio embedding, lo que permite al modelo tener en cuenta simultáneamente las fluctuaciones a corto plazo y los patrones a largo plazo. Este principio puede adaptarse para resolver diversas tareas en las que son importantes las interacciones entre factores espaciales y temporales, desde los mercados financieros hasta la planificación de las infraestructuras urbanas o la predicción de las condiciones meteorológicas.
Extralonger abre una nueva vía para crear modelos de predicción eficaces basados en datos espaciotemporales, combinando una alta precisión, ahorro de recursos y escalabilidad para grandes horizontes temporales.
Referencias
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19494
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Trading algorítmico de arbitraje basado en la teoría de grafos
 Particularidades del trabajo con números del tipo double en MQL4
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 35): Entrenamiento y despliegue de modelos predictivos

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso