Генетическое программирование — Genetic Programming (GP)
 23
 0

Содержание
Введение
Генетическое программирование (GP) Джона Коза — один из самых известных эволюционных методов. Его выращивают не числа, а программы: формулы, правила, деревья решений. Трейдеру GP знаком как способ вырастить торговое правило из индикаторов. Но под любой такой задачей лежит один и тот же механизм: популяция деревьев, отбор по пригодности и обмен поддеревьями между родителями.
В этой статье GP перенесён в нашу серию в каноническом виде, по статье Коза 1994 года и деталям из его книги 1992 года. Задача — понять, насколько хорош этот механизм сам по себе, если поставить его на наш стенд, что и остальные алгоритмы. Каждая координата задачи здесь — это отдельное дерево-формула, а значение формулы переводится в значение параметра.
Первый же прогон дал неожиданный результат: каноническая версия набрала показатели ниже чистого случайного поиска при том же бюджете испытаний. На нашем стенде главным выявленным фактором оказались не деревья и не кроссовер, а формула отбора. Она чувствительна к масштабу пригодности, и на нашем стенде отбор почти перестаёт отличать хорошие решения от плохих.
Этот вывод полезен далеко за пределами GP. Любой алгоритм с пропорциональным отбором зависит от того, в каких единицах измерена пригодность. Если критерий оптимизации советника меняется в узком диапазоне — профит-фактор от 1.10 до 1.15 или коэффициент Шарпа от 0.8 до 0.9, — такой отбор работает почти вслепую. В статье показано, как это обнаружить и как исправить одним параметром. Читатель получит готовый к использованию код GP на MQL5 и понимание того, где у этого метода сильные и слабые стороны.
Реализация алгоритма
Идея генетического программирования. Обычный генетический алгоритм работает со строкой фиксированной длины, например с вектором параметров. GP работает с деревом-выражением вроде (x + 0.3) · (y − 0.7). Во внутренних узлах стоят операции: +, −, ×, ÷. В листьях — входные данные и случайные константы. Размер и форму дерева заранее никто не задаёт. Они меняются в ходе эволюции.
Цикл устроен как у обычной эволюции:
- Создаётся несколько сотен или тысяч случайных деревьев разной формы и глубины.
- Каждое дерево запускается на задаче и получает оценку: насколько близко его результат к нужному.
- Родители выбираются пропорционально оценке, поэтому хорошие деревья чаще дают потомство.
- Новое поколение получается двумя способами. Около 10% деревьев копируется как есть. Остальные 90% рождаются кроссовером: в каждом из двух родителей выбирается случайная ветка, и ветки меняются местами. Обмен поддеревьями всегда даёт синтаксически правильную программу, поэтому потомок гарантированно вычислим.
- Новое поколение целиком заменяет старое, и цикл повторяется.
Ключевой расчёт Коза такой. Если два неидеальных дерева решают задачу частично хорошо, у каждого есть полезные куски. Перестановка кусков между ними может собрать дерево лучше обоих. В статье Коза есть показательный пример. Решение задачи мультиплексора получилось из двух родителей: один правильно обрабатывал чётные адреса, другой — нечётные. Потомок взял у каждого его удачную часть.
В 1994 году Коза добавил к методу автоматически определяемые функции (ADF). Программа может вырастить собственные подпрограммы и вызывать их многократно — примерно так же, как программист выносит повторяющийся код в функцию. В нашей реализации ADF не используются: для поиска вектора параметров они не нужны. Дальше разберём, как эта схема ложится на задачу оптимизации и какие детали взяты из канона.
Особь — это набор формул. В обычных алгоритмах серии особь — это вектор чисел. В GP особь — это программа. Здесь программа состоит из стольких деревьев, сколько координат у задачи. Каждое дерево — формула, которая вычисляется в одно число, и это число становится значением своей координаты.
Дерево строится из двух видов узлов. Внутренние узлы — это четыре операции: сложение, вычитание, умножение и деление. Все они принимают два аргумента. Листья — это случайные константы из отрезка [−1; 1]. Коза называет их эфемерными случайными константами: константа выбирается один раз при создании листа и дальше не меняется. Деление защищено: если делитель равен нулю, результат равен единице. Так формула никогда не ломается.
Значение формулы может оказаться любым, поэтому его нужно перевести в диапазон параметра. Значение сначала ограничивается отрезком [−1; 1], а затем линейно растягивается на диапазон координаты: −1 соответствует минимуму, 1 — максимуму.
Получается, что GP ищет не точку напрямую. Он ищет выражения из случайных констант, которые в эту точку вычисляются. Входных данных у формул здесь нет: листья — только константы.
Начальная популяция. Деревья первого поколения строятся методом ramped half-and-half. Особям по кругу назначается глубина от 2 до 6. Половина особей строится методом full: все ветви доходят до заданной глубины. Другая половина строится методом grow: на каждом шаге вместо операции может появиться лист, и дерево получается неровным. Так в популяции оказываются деревья разных размеров и форм.
Отбор. Коза использует пропорциональный отбор. У каждой особи есть отставание от лучшей в поколении: s = fMax − f. Из него считается скорректированная пригодность:a = 1 / (1 + s)
Чем больше a, тем чаще особь выбирается в родители. У лучшей особи s = 0 и a = 1. У отстающих a меньше единицы.
Скрещивание. Новое поколение строится из старого целиком. 10% мест занимают копии особей, выбранных отбором. Остальные 90% получаются скрещиванием.При скрещивании выбираются два родителя. В первом родителе выбирается точка: с вероятностью 90% это внутренний узел, с вероятностью 10% — лист. Точка выбирается равномерно по всей программе. Её ветвь определяет координату k. Во втором родителе точка выбирается только в ветви той же координаты k. Затем поддеревья под этими точками меняются местами. Обмен идёт только между формулами одной и той же координаты, поэтому формула для периода индикатора никогда не попадёт в формулу для уровня стоп-лосса.
Если после обмена дерево стало глубже 17 уровней, потомок получает ветвь родителя без изменений. Это ограничение не даёт деревьям разрастаться бесконечно.Мутации в каноническом GP нет. Новые формулы рождаются только из обмена кусками уже существующих формул.
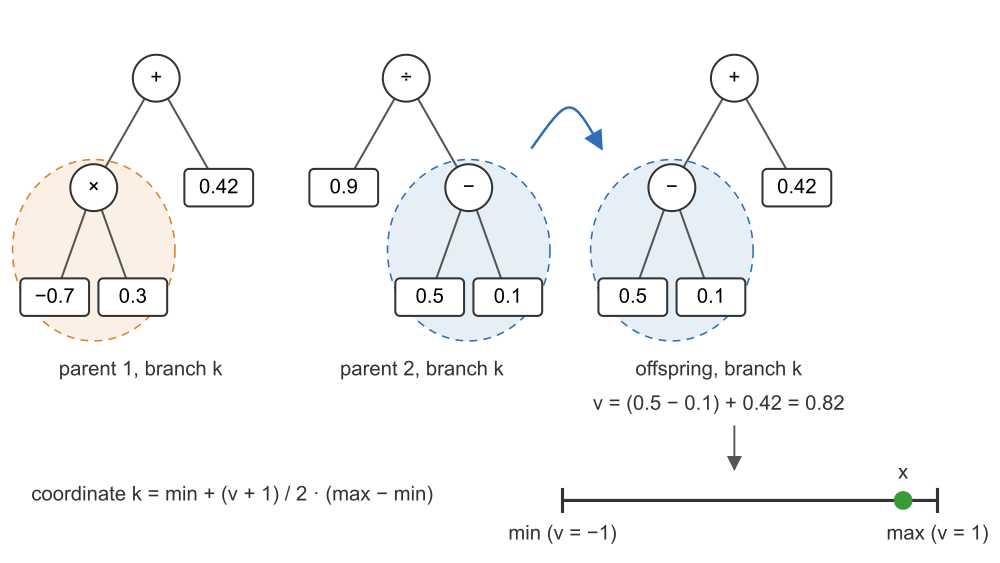
Рисунок 1. Кроссовер поддеревьев и перевод ветви в координату
На рисунке у первого родителя выделено поддерево с умножением, у второго — поддерево с вычитанием. Потомок получает дерево первого родителя, в котором поддерево с умножением заменено вычитанием из второго. Формула потомка даёт v = (0.5 − 0.1) + 0.42 = 0.82. Это значение переводится в координату: −1 соответствует минимуму диапазона, 1 — максимуму, поэтому 0.82 ложится почти у верхней границы.
Псевдокодсоздать M особей методом ramped half-and-half (глубина 2..6) повторять до исчерпания бюджета: для каждой особи: для каждой координаты k: x[k] = Wrap(значение дерева k) оценить пригодность f всех особей, запомнить лучшую за прогон a[i] = 1 / (1 + (fMax − f[i])) новое поколение: 10% мест: копия особи, выбранной пропорционально a 90% мест: два родителя пропорционально a точка в родителе 1: 90% внутренний узел, 10% лист точка в родителе 2: в той же ветви k обменять поддеревья если глубина > 17: вернуть ветвь родителя старое поколение заменяется новым целиком
Обратите внимание на последнюю строку: элитизма нет. Лучшая особь может не попасть в следующее поколение. Результатом прогона по Коза считается лучшая особь, найденная за всё время, и именно её запоминает алгоритм.
Код: класс и методы. Класс C_AO_GP наследует C_AO. Стенд работает с вектором координат a[i].c, а GP — с деревьями. Поэтому класс хранит деревья отдельно и в каждой эпохе переводит их в координаты агентов.
Константы. Коды операций, число функций и два технических ограничения вынесены в определения. GP_MIN_DEP — нижняя граница глубины начальных деревьев. GP_BIG ограничивает результат операции, чтобы умножение больших чисел не дало переполнения.
Структуры. Дерево хранится в префиксной записи: сначала операция, потом её левый аргумент целиком, потом правый. Такая запись — простой массив узлов, без указателей. Поддерево в ней всегда занимает непрерывный отрезок массива, и обмен поддеревьями сводится к копированию отрезков.S_GP_Node — один узел: код операции и значение константы для листа. S_GP_Branch — одно дерево, то есть одна координата. В нём хранится длина и кэш значения: если ветвь не менялась, её не нужно вычислять заново. S_GP_Prog — особь целиком: массив ветвей и пригодность. S_GP_Pop — поколение особей.
У всех операций по два аргумента, поэтому размер дерева однозначно связан с числом листьев. В дереве из len узлов внутренних узлов (len − 1) / 2, а листьев (len + 1) / 2. Это используется при выборе точки скрещивания.
#define GP_OP_ADD   0
#define GP_OP_SUB   1
#define GP_OP_MUL   2
#define GP_OP_DIV   3
#define GP_OP_ERC   4
#define GP_NFUNC    4        // все функции двухместные
#define GP_MIN_DEP  2        // нижняя глубина ramped half-and-half
#define GP_BIG      1.0e10   // ограничение результата операции

//+------------------------------------------------------------------+
//| узел дерева в префиксной записи                                  |
//+------------------------------------------------------------------+
struct S_GP_Node
  {
   int               op;     // GP_OP_*
   double            val;    // константа для GP_OP_ERC
  };

//+------------------------------------------------------------------+
//| ветвь = одно дерево = одна координата                            |
//| все функции двухместные: внутренних узлов (len-1)/2,             |
//| листьев (len+1)/2                                                |
//+------------------------------------------------------------------+
struct S_GP_Branch
  {
   S_GP_Node         n [];
   int               len;
   double            v;      // кэш значения ветви
   bool              ok;     // кэш действителен
  };

struct S_GP_Prog
  {
   S_GP_Branch       br [];
   double            f;
  };

struct S_GP_Pop
  {
   S_GP_Prog         p [];
  };
Класс. Открытые параметры: pCross — доля скрещивания, pInternal — вероятность выбрать точку скрещивания во внутреннем узле, initDepth — максимальная глубина начальных деревьев, maxDepth — предел глубины после скрещивания, fScale — множитель отставания в отборе. Поле avgSize — средний размер ветви, по нему можно следить за ростом деревьев. Закрытые поля: два поколения gen[2] и индекс текущего cur. Новое поколение строится во втором массиве, затем индексы меняются местами. Массив cum хранит накопленные суммы для рулетки отбора.
SetParams. Метод переносит значения из params в поля и проверяет их. Популяция не меньше двух особей, вероятности — в отрезке [0; 1]. Начальная глубина не меньше GP_MIN_DEP, а предел глубины не меньше начальной. Исправленные значения записываются обратно в params, поэтому журнал теста показывает то, с чем алгоритм реально работал.
//+------------------------------------------------------------------+
//|                        class C_AO_GP                             |
//+------------------------------------------------------------------+
class C_AO_GP : public C_AO
  {
public:
                    ~C_AO_GP() {}
                     C_AO_GP()
     {
      ao_name = "GP";
      ao_desc = "Genetic Programming";
      ao_link = "https://www.mql5.com/ru/articles/25549";

      popSize   = 50;      // M
      pCross    = 0.9;     // доля кроссовера, остальное — репродукция
      pInternal = 0.9;     // вероятность точки кроссовера во внутреннем узле
      initDepth = 6;       // максимальная глубина начальных деревьев
      maxDepth  = 17;      // максимальная глубина после кроссовера
      fScale    = 10000.0; // множитель s в отборе; 1.0 — канон

      ArrayResize(params, 6);
      params [0].name = "popSize";
      params [0].val = popSize;
      params [1].name = "pCross";
      params [1].val = pCross;
      params [2].name = "pInternal";
      params [2].val = pInternal;
      params [3].name = "initDepth";
      params [3].val = initDepth;
      params [4].name = "maxDepth";
      params [4].val = maxDepth;
      params [5].name = "fScale";
      params [5].val = fScale;
     }

   void               SetParams()
     {
      popSize   = (int)params [0].val;
      pCross    = params [1].val;
      pInternal = params [2].val;
      initDepth = (int)params [3].val;
      maxDepth  = (int)params [4].val;
      fScale    = params [5].val;

      if(popSize < 2)
         popSize = 2;
      if(pCross < 0.0)
         pCross = 0.0;
      if(pCross > 1.0)
         pCross = 1.0;
      if(pInternal < 0.0)
         pInternal = 0.0;
      if(pInternal > 1.0)
         pInternal = 1.0;
      if(initDepth < GP_MIN_DEP)
         initDepth = GP_MIN_DEP;
      if(maxDepth < initDepth)
         maxDepth = initDepth;
      if(fScale < 0.0)
         fScale = 0.0;

      params [0].val = popSize;
      params [1].val = pCross;
      params [2].val = pInternal;
      params [3].val = initDepth;
      params [4].val = maxDepth;
      params [5].val = fScale;
     }

   bool               Init(const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0);

   void               Moving();
   void               Revision();

   //----------------------------------------------------------------
   double             pCross;
   double             pInternal;
   int                initDepth;
   int                maxDepth;
   double             fScale;     // a = 1/(1 + fScale*s); 1.0 — канон

   double             avgSize;    // средний размер ветви в узлах (рост деревьев)

private:
   S_GP_Pop           gen [2];    // текущее и следующее поколения
   int                cur;
   double             cum [];     // накопленная скорректированная приспособленность
   double             cumSum;

   void               Ramped();
   void               Gen(S_GP_Branch &b, int d, bool full, bool root);
   void               Push(S_GP_Branch &b, int op, double val);

   double             EvalRec(const S_GP_Branch &b, int &pos);
   double             BranchValue(S_GP_Branch &b);
   double             Wrap(double v, int k);

   int                SubtreeEnd(const S_GP_Branch &b, int i);
   int                DepthRec(const S_GP_Branch &b, int &pos);
   int                Depth(const S_GP_Branch &b);
   int                NthNode(const S_GP_Branch &b, int r, bool internal);
   void               PickInProgram(const S_GP_Prog &p, int &k, int &i);
   int                PickInBranch(const S_GP_Branch &b);

   void               CopyBranch(S_GP_Branch &dst, const S_GP_Branch &src);
   void               CopyProg(S_GP_Prog &dst, const S_GP_Prog &src);
   void               Splice(S_GP_Branch &dst,
                             const S_GP_Branch &a, int i, int ie,
                             const S_GP_Branch &b, int j, int je);

   void               PrepRoulette();
   int                Spin();
   void               Crossover(int p1, int p2, int c1, int c2);
   void               Breed();

   int                RndInt(int n);
  };
Init вызывает стандартную инициализацию базового класса. Затем для обоих поколений создаются особи, у каждой — по ветви на координату. Ветви пока пустые, кэш помечен как недействительный. Сами деревья построят первый вызов Moving.
//+------------------------------------------------------------------+
//|                              Init                                |
//+------------------------------------------------------------------+
bool C_AO_GP::Init(const double &rangeMinP  [],
                   const double &rangeMaxP  [],
                   const double &rangeStepP [],
                   const int     epochsP = 0)
  {
   if(!StandardInit(rangeMinP, rangeMaxP, rangeStepP))
      return false;

   cur     = 0;
   avgSize = 0.0;

   for(int g = 0; g < 2; g++)
     {
      ArrayResize(gen [g].p, popSize);
      for(int i = 0; i < popSize; i++)
        {
         ArrayResize(gen [g].p [i].br, coords);
         gen [g].p [i].f = -DBL_MAX;
         for(int k = 0; k < coords; k++)
           {
            gen [g].p [i].br [k].len = 0;
            gen [g].p [i].br [k].v   = 0.0;
            gen [g].p [i].br [k].ok  = false;
           }
        }
     }

   ArrayResize(cum, popSize);
   cumSum = 0.0;
   return true;
  }
RndInt. Случайное целое из [0; n − 1]. Штатный MathRand даёт только 15 бит, то есть числа до 32767. В программе из 1000 ветвей узлов может быть больше, поэтому два вызова склеиваются в 30-битное число.
//+------------------------------------------------------------------+
//| случайное целое [0; n-1], 30 бит (MathRand даёт только 15)       |
//+------------------------------------------------------------------+
int C_AO_GP::RndInt(int n)
  {
   if(n <= 1)
      return 0;
   long r = ((long)MathRand() << 15) | (long)MathRand();
   return (int)(r % n);
  }
Push добавляет узел в конец ветви. Массив растёт с запасом в 64 элемента, чтобы не перераспределять память на каждом узле.
//+------------------------------------------------------------------+
//| добавить узел в конец ветви                                      |
//+------------------------------------------------------------------+
void C_AO_GP::Push(S_GP_Branch &b, int op, double val)
  {
   if(ArraySize(b.n) <= b.len)
      ArrayResize(b.n, b.len + 1, 64);
   b.n [b.len].op  = op;
   b.n [b.len].val = val;
   b.len++;
  }
Gen рекурсивно строит дерево в префиксной записи. На нулевой глубине всегда ставится лист — случайная константа. В режиме grow лист может появиться и раньше, с вероятностью 1/5: это доля листьев среди всех пяти типов узлов (четыре операции и константа). Корень всегда операция, как у Коза. Иначе выбирается случайная операция, и для неё строятся два поддерева на единицу меньшей глубины.
//+------------------------------------------------------------------+
//| full / grow, корень всегда функция [GP I]                        |
//| grow: терминал с вероятностью |T|/(|T|+|F|) = 1/5                |
//+------------------------------------------------------------------+
void C_AO_GP::Gen(S_GP_Branch &b, int d, bool full, bool root)
  {
   if(d == 0 || (!full && !root && u.RNDprobab() < 1.0 / (GP_NFUNC + 1)))
     {
      Push(b, GP_OP_ERC, u.RNDfromCI(-1.0, 1.0));   // ERC фиксируется навсегда
      return;
     }

   Push(b, RndInt(GP_NFUNC), 0.0);
   Gen(b, d - 1, full, false);
   Gen(b, d - 1, full, false);
  }
Ramped строит поколение 0. Особи по кругу получают глубину от GP_MIN_DEP до initDepth. Режим full или grow чередуется блоками по числу уровней глубины. Все ветви одной особи строятся с одинаковыми настройками.
//+------------------------------------------------------------------+
//| ramped half-and-half: глубины GP_MIN_DEP..initDepth по кругу,    |
//| половина full, половина grow; все ветви особи — с её настройками |
//+------------------------------------------------------------------+
void C_AO_GP::Ramped()
  {
   int levels = initDepth - GP_MIN_DEP + 1;

   for(int i = 0; i < popSize; i++)
     {
      int  d    = GP_MIN_DEP + i % levels;
      bool full = ((i / levels) % 2) == 0;

      for(int k = 0; k < coords; k++)
        {
         gen [cur].p [i].br [k].len = 0;
         gen [cur].p [i].br [k].ok  = false;
         Gen(gen [cur].p [i].br [k], d, full, true);
        }
     }
  }
EvalRec. Интерпретатор префиксной записи. Указатель pos идёт по массиву слева направо. Лист возвращает свою константу. Операция сначала вычисляет левый аргумент, затем правый, и применяет себя к ним. Деление на ноль даёт единицу. Результат ограничивается величиной GP_BIG, чтобы цепочка умножений не превратилась в бесконечность.
//+------------------------------------------------------------------+
//| интерпретатор префиксной записи                                  |
//+------------------------------------------------------------------+
double C_AO_GP::EvalRec(const S_GP_Branch &b, int &pos)
  {
   int op = b.n [pos].op;

   if(op == GP_OP_ERC)
     {
      double c = b.n [pos].val;
      pos++;
      return c;
     }

   pos++;
   double x = EvalRec(b, pos);
   double y = EvalRec(b, pos);
   double v = 0.0;

   switch(op)
     {
      case GP_OP_ADD:
         v = x + y;
         break;
      case GP_OP_SUB:
         v = x - y;
         break;
      case GP_OP_MUL:
         v = x * y;
         break;
      case GP_OP_DIV:
         v = (y == 0.0) ? 1.0 : x / y;   // защищённое деление
         break;
     }

   if(v >  GP_BIG)
      v =  GP_BIG;
   if(v < -GP_BIG)
      v = -GP_BIG;
   return v;
  }
BranchValue − значение ветви с кэшем. Скрещивание меняет только одну ветвь потомка, остальные копируются от родителя вместе с готовым значением. Поэтому в каждом поколении пересчитывается лишь одна ветвь на особь. На 1000 координатах это ускоряет работу в сотни раз.
//+------------------------------------------------------------------+
//| значение ветви с кэшем: при кроссовере меняется одна ветвь       |
//+------------------------------------------------------------------+
double C_AO_GP::BranchValue(S_GP_Branch &b)
  {
   if(!b.ok)
     {
      int pos = 0;
      b.v  = EvalRec(b, pos);
      b.ok = true;
     }
   return b.v;
  }
Wrap переводит значение формулы в координату. Значение ограничивается отрезком [−1; 1] и линейно растягивается на диапазон координаты. Затем SeInDiSp приводит результат к шагу дискретизации, если он задан. У такой обёртки есть особенность. Формулы из нескольких операций легко дают значения больше единицы по модулю, и тогда координата встаёт точно на границу диапазона. Моделирование начальной популяции показало, что на границе оказывается около половины координат. Это смещение заложено в сам способ перевода формулы в число.
//+------------------------------------------------------------------+
//| обёртка: насыщение на [-1; 1], линейно в диапазон координаты     |
//+------------------------------------------------------------------+
double C_AO_GP::Wrap(double v, int k)
  {
   if(v >  1.0)
      v =  1.0;
   if(v < -1.0)
      v = -1.0;
   double x = rangeMin [k] + (v + 1.0) * 0.5 * (rangeMax [k] - rangeMin [k]);
   return u.SeInDiSp(x, rangeMin [k], rangeMax [k], rangeStep [k]);
  }
SubtreeEnd находит конец поддерева, начинающегося в узле i. Счётчик need показывает, сколько ещё поддеревьев нужно пройти. Лист закрывает одно, операция открывает два вместо одного. Когда счётчик становится нулём, поддерево закончилось.
//+------------------------------------------------------------------+
//| индекс сразу за поддеревом с корнем i                            |
//+------------------------------------------------------------------+
int C_AO_GP::SubtreeEnd(const S_GP_Branch &b, int i)
  {
   int need = 1;
   while(need > 0)
     {
      need += (b.n [i].op == GP_OP_ERC ? 0 : 2) - 1;
      i++;
     }
   return i;
  }
DepthRec и Depth. Глубина дерева: у листа она нулевая, у операции — на единицу больше глубины более глубокого аргумента. Depth вызывает рекурсию с начала ветви.
int C_AO_GP::DepthRec(const S_GP_Branch &b, int &pos)
  {
   int op = b.n [pos].op;
   pos++;
   if(op == GP_OP_ERC)
      return 0;
   int d1 = DepthRec(b, pos);
   int d2 = DepthRec(b, pos);
   return 1 + (d1 > d2 ? d1 : d2);
  }

int C_AO_GP::Depth(const S_GP_Branch &b)
  {
   int pos = 0;
   return DepthRec(b, pos);
  }
NthNode возвращает индекс r-го по счёту внутреннего узла или листа ветви. Нужен, чтобы выбрать точку скрещивания равномерно среди узлов нужного вида.
//+------------------------------------------------------------------+
//| r-й (с нуля) внутренний узел или лист ветви                      |
//+------------------------------------------------------------------+
int C_AO_GP::NthNode(const S_GP_Branch &b, int r, bool internal)
  {
   for(int i = 0; i < b.len; i++)
     {
      if((b.n [i].op != GP_OP_ERC) == internal)
        {
         if(r == 0)
            return i;
         r--;
        }
     }
   return 0;
  }
PickInProgram выбирает точку скрещивания в первом родителе. Сначала решается вид узла: с вероятностью pInternal — внутренний, иначе лист. Затем считается, сколько узлов этого вида во всей программе, и выбирается один из них равномерно. Ветвь, в которую попала точка, определяет координату k. Поэтому ветви с крупными деревьями выбираются чаще: так у Коза, где точка выбирается по всей программе.
//+------------------------------------------------------------------+
//| точка в P1 по всей программе: правило 90/10, затем равномерно    |
//| среди всех внутренних узлов (или листьев) всех ветвей            |
//+------------------------------------------------------------------+
void C_AO_GP::PickInProgram(const S_GP_Prog &p, int &k, int &i)
  {
   bool wantInt = u.RNDprobab() < pInternal;
   int  totInt  = 0;
   int  totLeaf = 0;

   for(int b = 0; b < coords; b++)
     {
      totInt  += (p.br [b].len - 1) / 2;
      totLeaf += (p.br [b].len + 1) / 2;
     }

   if(wantInt && totInt == 0)
      wantInt = false;

   int r = RndInt(wantInt ? totInt : totLeaf);

   for(int b = 0; b < coords; b++)
     {
      int nb = wantInt ? (p.br [b].len - 1) / 2 : (p.br [b].len + 1) / 2;
      if(r < nb)
        {
         k = b;
         i = NthNode(p.br [b], r, wantInt);
         return;
        }
      r -= nb;
     }

   k = coords - 1;
   i = 0;
  }
PickInBranch выбирает точку во втором родителе, но только внутри ветви k. Правило то же: внутренний узел с вероятностью pInternal, если он вообще есть, иначе лист.
//+------------------------------------------------------------------+
//| точка в P2 внутри заданной ветви, правило 90/10                  |
//+------------------------------------------------------------------+
int C_AO_GP::PickInBranch(const S_GP_Branch &b)
  {
   int  nInt    = (b.len - 1) / 2;
   bool wantInt = nInt > 0 && u.RNDprobab() < pInternal;
   int  n       = wantInt ? nInt : (b.len + 1) / 2;
   return NthNode(b, RndInt(n), wantInt);
  }
CopyBranch и CopyProg. Копирование ветви и особи целиком. Вместе с узлами копируется кэш значения, поэтому скопированную ветвь не нужно вычислять заново.
void C_AO_GP::CopyBranch(S_GP_Branch &dst, const S_GP_Branch &src)
  {
   if(ArraySize(dst.n) < src.len)
      ArrayResize(dst.n, src.len, 64);
   for(int i = 0; i < src.len; i++)
      dst.n [i] = src.n [i];
   dst.len = src.len;
   dst.v   = src.v;
   dst.ok  = src.ok;
  }

void C_AO_GP::CopyProg(S_GP_Prog &dst, const S_GP_Prog &src)
  {
   for(int k = 0; k < coords; k++)
      CopyBranch(dst.br [k], src.br [k]);
   dst.f = src.f;
  }
Splice. Собирает новую ветвь из трёх кусков: начало первой ветви до точки i, вставленное поддерево второй ветви от j до je, и остаток первой ветви после её поддерева. Благодаря префиксной записи это три простых копирования. Кэш новой ветви сбрасывается, её значение будет вычислено заново.
//+------------------------------------------------------------------+
//| dst = a[0..i) + b[j..je) + a[ie..len)                            |
//| dst не должен совпадать с a или b                                |
//+------------------------------------------------------------------+
void C_AO_GP::Splice(S_GP_Branch &dst,
                     const S_GP_Branch &ab, int i, int ie,
                     const S_GP_Branch &bb, int j, int je)
  {
   int newLen = i + (je - j) + (ab.len - ie);
   if(ArraySize(dst.n) < newLen)
      ArrayResize(dst.n, newLen, 64);

   int w = 0;
   for(int s = 0;  s < i;      s++)
      dst.n [w++] = ab.n [s];
   for(int s = j;  s < je;     s++)
      dst.n [w++] = bb.n [s];
   for(int s = ie; s < ab.len; s++)
      dst.n [w++] = ab.n [s];

   dst.len = newLen;
   dst.ok  = false;
  }
PrepRoulette готовит рулетку отбора. Сначала находится лучшая пригодность в поколении. Затем для каждой особи считается скорректированная пригодность a = 1 / (1 + fScale · s), где s — отставание от лучшей. Значения складываются в накопленную сумму. При fScale = 1 формула совпадает с каноном. Множитель fScale растягивает шкалу отставания, и именно он оказался ключом к работе алгоритма на стенде.
//+------------------------------------------------------------------+
//| a_i = 1/(1+fScale*s_i), s_i = fMax - f_i  (s_i — не из статьи)   |
//| fScale = 1 — канон; > 1 растягивает шкалу f стенда для отбора    |
//+------------------------------------------------------------------+
void C_AO_GP::PrepRoulette()
  {
   double fMax = -DBL_MAX;
   for(int i = 0; i < popSize; i++)
      if(gen [cur].p [i].f > fMax)
         fMax = gen [cur].p [i].f;

   cumSum = 0.0;
   for(int i = 0; i < popSize; i++)
     {
      cumSum += 1.0 / (1.0 + fScale * (fMax - gen [cur].p [i].f));
      cum [i] = cumSum;
     }
  }
Spin. Один поворот рулетки. Случайное число от нуля до общей суммы указывает на сектор, и бинарный поиск по накопленным суммам находит особь, которой этот сектор принадлежит.
//+------------------------------------------------------------------+
//| пропорциональный отбор, бинарный поиск по накопленной сумме      |
//+------------------------------------------------------------------+
int C_AO_GP::Spin()
  {
   double r  = u.RNDprobab() * cumSum;
   int    lo = 0;
   int    hi = popSize - 1;

   while(lo < hi)
     {
      int mid = (lo + hi) / 2;
      if(cum [mid] < r)
         lo = mid + 1;
      else
         hi = mid;
     }
   return lo;
  }
Crossover. Скрещивание двух родителей. В первом выбирается точка и её ветвь k, во втором — точка в той же ветви. Первый потомок — копия первого родителя, в ветви k которого поддерево заменено поддеревом второго. Второй потомок строится зеркально. Если ветвь потомка стала глубже maxDepth, она заменяется ветвью родителя. Когда в поколении осталось одно место, второй потомок не строится.
//+------------------------------------------------------------------+
//| кроссовер поддеревьев с типизацией ветвей;                       |
//| c2 < 0 — второй потомок не нужен (последнее место в поколении)   |
//+------------------------------------------------------------------+
void C_AO_GP::Crossover(int p1, int p2, int c1, int c2)
  {
   int nxt = cur ^ 1;
   int k, i;

   PickInProgram(gen [cur].p [p1], k, i);
   int ie = SubtreeEnd(gen [cur].p [p1].br [k], i);
   int j  = PickInBranch(gen [cur].p [p2].br [k]);
   int je = SubtreeEnd(gen [cur].p [p2].br [k], j);

//--- потомок 1: P1 с поддеревом из P2
   CopyProg(gen [nxt].p [c1], gen [cur].p [p1]);
   Splice(gen [nxt].p [c1].br [k],
          gen [cur].p [p1].br [k], i, ie,
          gen [cur].p [p2].br [k], j, je);
   if(Depth(gen [nxt].p [c1].br [k]) > maxDepth)
      CopyBranch(gen [nxt].p [c1].br [k], gen [cur].p [p1].br [k]);   // [GP I]

//--- потомок 2: P2 с поддеревом из P1
   if(c2 < 0)
      return;

   CopyProg(gen [nxt].p [c2], gen [cur].p [p2]);
   Splice(gen [nxt].p [c2].br [k],
          gen [cur].p [p2].br [k], j, je,
          gen [cur].p [p1].br [k], i, ie);
   if(Depth(gen [nxt].p [c2].br [k]) > maxDepth)
      CopyBranch(gen [nxt].p [c2].br [k], gen [cur].p [p2].br [k]);
  }
Breed строит новое поколение. Сначала готовится рулетка. Первые round((1 − pCross) · M) мест занимают копии выбранных особей. Остальные места заполняются потомками скрещивания, по два за раз.
//+------------------------------------------------------------------+
//| новое поколение: round((1-pCross)*M) копий, остальное кроссовер  |
//+------------------------------------------------------------------+
void C_AO_GP::Breed()
  {
   int nxt = cur ^ 1;
   PrepRoulette();

   int nR  = (int)MathRound((1.0 - pCross) * popSize);
   int cnt = 0;

   for(; cnt < nR && cnt < popSize; cnt++)
      CopyProg(gen [nxt].p [cnt], gen [cur].p [Spin()]);

   while(cnt < popSize)
     {
      int  p1  = Spin();
      int  p2  = Spin();
      bool two = cnt + 1 < popSize;

      Crossover(p1, p2, cnt, two ? cnt + 1 : -1);
      cnt += two ? 2 : 1;
     }
  }
Moving. При первом вызове строится поколение 0. При следующих из текущего поколения выводится новое, и индексы поколений меняются местами. Затем каждая ветвь каждой особи вычисляется и переводится в координату агента. Попутно считается средний размер ветви.
//+------------------------------------------------------------------+
//|                            Moving                                |
//+------------------------------------------------------------------+
void C_AO_GP::Moving()
  {
   if(!revision)
      Ramped();                  // поколение 0
   else
     {
      Breed();                   // следующее поколение из текущего
      cur ^= 1;
     }

   long nodes = 0;
   for(int i = 0; i < popSize; i++)
      for(int k = 0; k < coords; k++)
        {
         a [i].c [k] = Wrap(BranchValue(gen [cur].p [i].br [k]), k);
         nodes += gen [cur].p [i].br [k].len;
        }

   avgSize = (double)nodes / ((double)popSize * coords);
  }
Revision переносит пригодность, посчитанную стендом, в особи текущего поколения: по ней строится следующая рулетка. Если найдено решение лучше рекорда, оно копируется в cB и fB. Элитизма нет: рекорд хранится отдельно и в поколение не возвращается.
//+------------------------------------------------------------------+
//|                           Revision                               |
//| поколенческая замена без элитизма: сохраняется только лучший     |
//| за прогон (cB / fB) — это и есть результат по Коза               |
//+------------------------------------------------------------------+
void C_AO_GP::Revision()
  {
   for(int i = 0; i < popSize; i++)
     {
      gen [cur].p [i].f = a [i].f;

      if(a [i].f > fB)
        {
         fB = a [i].f;
         ArrayCopy(cB, a [i].c, 0, 0, coords);
        }
     }

   if(!revision)
      revision = true;
  }
Результаты тестов
Все прогоны выполнены по стандартному протоколу серии: 10 повторов, бюджет 10 000 вычислений функции, популяция 50 особей. Генератор случайных чисел инициализируется в начале каждого повтора от счётчика микросекунд (MathSrand(GetMicrosecondCount()) в StandardInit). Поэтому повторы независимы, но не воспроизводятся бит в бит: воспроизводимыми должны быть средние, а не отдельные траектории. По опыту серии одна и та же конфигурация даёт от прогона к прогону разброс итога около 1–2 пунктов. Различия меньше этого мы считаем неотличимыми.
Канонический GP: ниже случайного поиска. Первый прогон с каноническими настройками (50|0.9|0.9|6|17, без множителя в отборе) дал 18.32%. Для сравнения в таблице приведён чистый случайный поиск на том же бюджете.| Тест | GP канон | Случайный поиск (RW) |
|---|---|---|
| Hilly 5 | 0.385 | 0.500 |
| Hilly 25 | 0.262 | 0.323 |
| Hilly 500 | 0.227 | 0.258 |
| Forest 5 | 0.213 | 0.308 |
| Forest 25 | 0.065 | 0.115 |
| Forest 500 | 0.027 | 0.044 |
| Megacity 5 | 0.264 | 0.361 |
| Megacity 25 | 0.121 | 0.170 |
| Megacity 500 | 0.083 | 0.102 |
| Итог | 18.32% | 24.23% |
Канонический GP проиграл случайному поиску во всех девяти тестах. Алгоритм не просто плохо ищет — он ищет хуже, чем если бы не искал вовсе. Такой результат означает, что какой-то механизм работает против поиска.
Почему отбор не работает. Причина нашлась в формуле отбора a = 1 / (1 + s). Коза писал её для задач, где отставание s измеряется в единицах ошибки: десятками и сотнями. Тогда разница между хорошей и плохой программой огромна, и отбор работает жёстко.Функции нашего стенда нормированы в отрезок [0; 1]. Разница в пригодности между особями одного поколения — сотые доли. Посмотрим, что это даёт. Пусть лучшая особь имеет пригодность 0.50, а худшая — 0.48. У лучшей a = 1. У худшей a = 1 / (1 + 0.02) ≈ 0.98. Худшая особь выбирается в родители почти так же часто, как лучшая. Отбор становится почти случайным.
Без отбора GP превращается в случайное перемешивание формул. К этому добавляется смещение обёртки: около половины координат начальной популяции стоят на границах диапазона. Скрещивание без давления отбора не уводит их оттуда, и поиск оказывается хуже равномерного случайного.
Исправление: растянуть шкалу отставания. Исправление сводится к одному множителю в формуле отбора:a = 1 / (1 + fScale · s)
При fScale = 1 это канон. Множитель переводит отставание в другой масштаб, не меняя ничего в самом алгоритме. Возьмём тот же пример при fScale = 10000. У худшей особи a = 1 / (1 + 200) ≈ 0.005, у лучшей — по-прежнему 1. Теперь лучшая выбирается в 200 раз чаще худшей, и отбор снова работает.
Значение 10000 подобрано эмпирически, по одной простой оценке: множитель должен перевести отставание в сотые доли в величины порядка десятков и сотен, как в задачах Коза. Оно не универсально. Для другой задачи множитель нужно выбирать под реальный разброс пригодности в популяции.
Итоговый результат:
GP|Genetic Programming|50.0|0.9|0.9|6.0|17.0|10000.0|
=============================
5 Hilly's; Func runs: 10000; result: 0.5649657657794556
25 Hilly's; Func runs: 10000; result: 0.5054425881682872
500 Hilly's; Func runs: 10000; result: 0.24995892177687798
=============================
5 Forest's; Func runs: 10000; result: 0.6961303955170414
25 Forest's; Func runs: 10000; result: 0.5111270767334167
500 Forest's; Func runs: 10000; result: 0.05802827268493972
=============================
5 Megacity's; Func runs: 10000; result: 0.5919999999999999
25 Megacity's; Func runs: 10000; result: 0.3882666666666667
500 Megacity's; Func runs: 10000; result: 0.11005333333333434
=============================
All score: 3.67597 (40.84%)
| Тест | GP канон | GP, fScale 10000 | Случайный поиск (RW) |
|---|---|---|---|
| Hilly 5 | 0.385 | 0.565 | 0.500 |
| Hilly 25 | 0.262 | 0.505 | 0.323 |
| Hilly 500 | 0.227 | 0.250 | 0.258 |
| Forest 5 | 0.213 | 0.696 | 0.308 |
| Forest 25 | 0.065 | 0.511 | 0.115 |
| Forest 500 | 0.027 | 0.058 | 0.044 |
| Megacity 5 | 0.264 | 0.592 | 0.361 |
| Megacity 25 | 0.121 | 0.388 | 0.170 |
| Megacity 500 | 0.083 | 0.110 | 0.102 |
| Итог | 18.32% | 40.84% | 24.23% |
Один множитель поднял результат с 18.32% до 40.84%. Это больше чем вдвое, при неизменных деревьях, скрещивании и всех канонических параметрах.
Сильнее всего вырос средний блок. На 25 пар переменных Forest поднялся с 0.065 до 0.511, почти в восемь раз. Hilly и Megacity выросли примерно вдвое и втрое. На 5 пар переменных GP теперь уверенно обходит случайный поиск во всех трёх функциях.
На 500 пар переменных картина другая. Forest и Megacity лишь немного выше случайного поиска, а Hilly остаётся чуть ниже него. Эти различия меньше обычного разброса стенда, поэтому в высокой размерности GP и случайный поиск мы считаем неотличимыми. Вероятная причина — в устройстве скрещивания: за одну операцию меняется одна ветвь из тысячи. За весь бюджет каждая координата меняется лишь несколько раз, и в высокой размерности алгоритм просто не успевает. Зато различия на 5 и 25 парах переменных — от 0.06 до 0.40 в каждой ячейке — заметно больше разброса, и превосходство над случайным поиском там надёжно.
Проверка композитным тестом. На основном стенде каждая функция повторяется много раз. Алгоритм, который переносит найденные значения между координатами, мог бы этим воспользоваться. В GP такой перенос в принципе исключён: обмен поддеревьями идёт только между формулами одной и той же координаты. Композитный тест проверяет это на практике. Десять координат разбиты на пять пар, и каждая пара принадлежит своей функции: Hilly, Forest, Megacity, Peaks и Skin.
Ориентир — среднее по тестам с 5 функциями на основном стенде: около 0.62. Композит дал 0.69, то есть не ниже ориентира. Разброс между запусками большой, от 0.42 до 0.98: стандартное отклонение около 0.19, стандартная ошибка среднего по 10 запускам около 0.06. Разница 0.07 — примерно одна стандартная ошибка, поэтому результаты статистически неотличимы. Падения нет, и GP не опирается на многократное повторение одной функции на стенде.
GP|Genetic Programming (Koza)|50.0|0.9|0.9|6.0|17.0|10000.0|
=============================
Composite anti-cheat test: Hilly + Forest + Megacity + Peaks + Skin
Pairs: 5; Coordinates: 10; Epochs: 200; Repeats: 10
=============================
Run 1/10: 0.6155437843058152
Run 2/10: 0.47462815962665933
Run 3/10: 0.4249327710088736
Run 4/10: 0.9756237447658387
Run 5/10: 0.6956564232565177
Run 6/10: 0.8540098680168213
Run 7/10: 0.8358692638307126
Run 8/10: 0.4719561069329249
Run 9/10: 0.8225568790150184
Run 10/10: 0.7592135198536807
=============================
Average result: 0.6929990521 (69.30%)
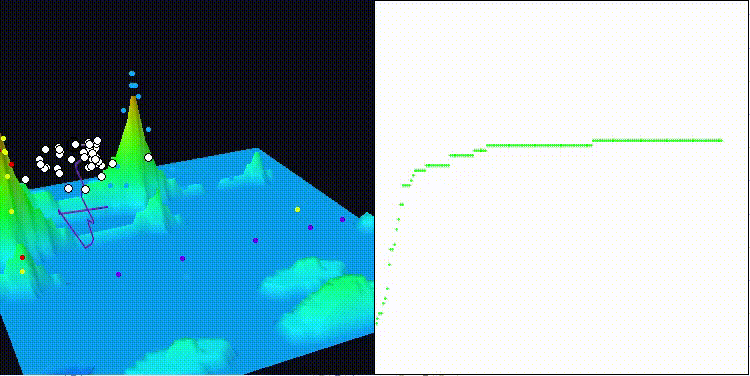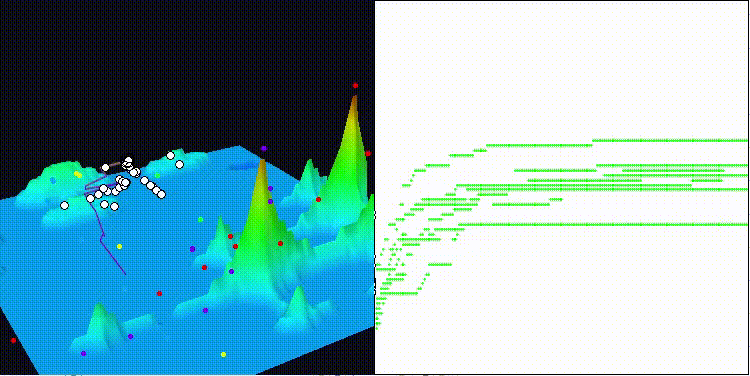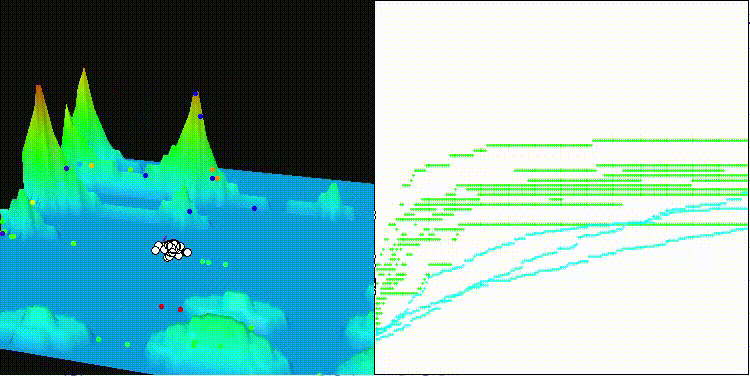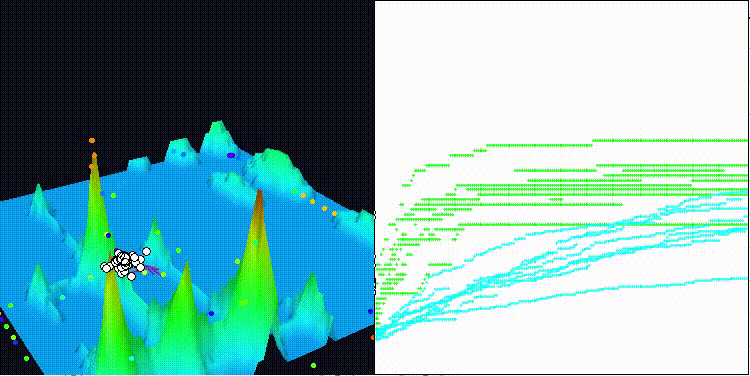
Визуализация работы GP на тестовых функциях и на произвольно выбранной дополнительной.
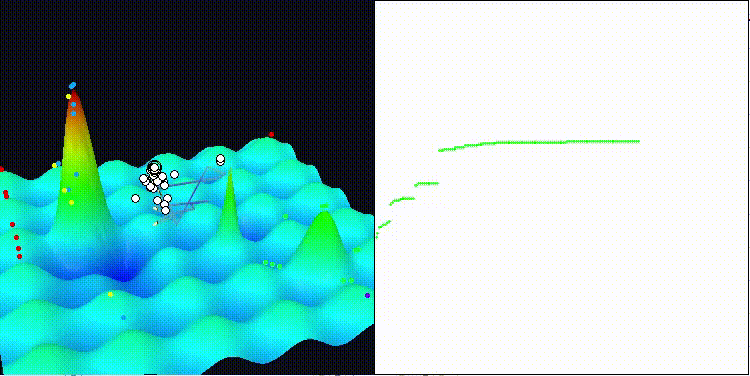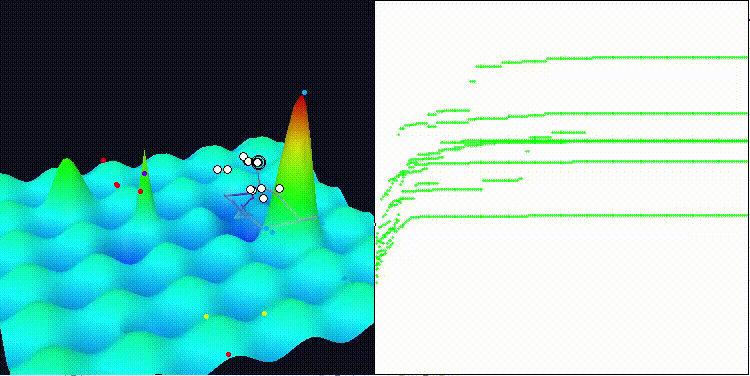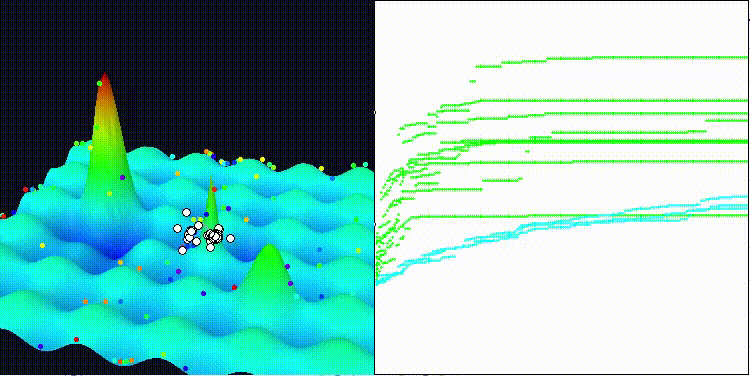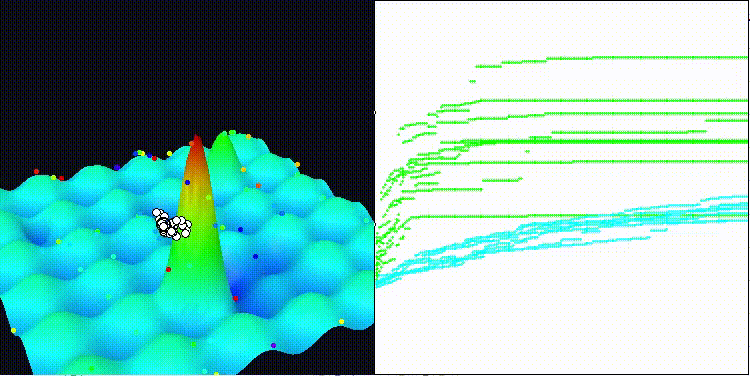
GP на тестовой функции Hilly
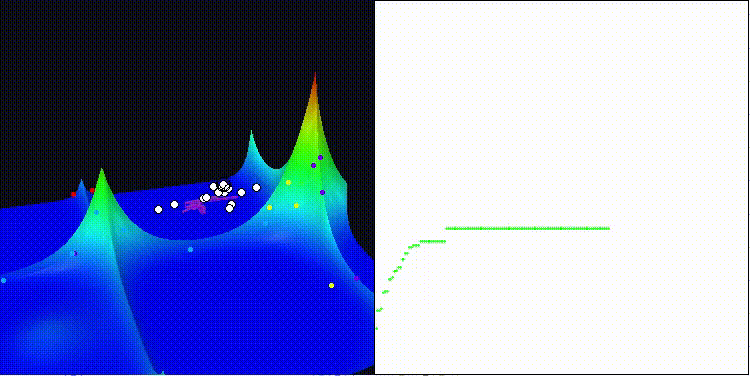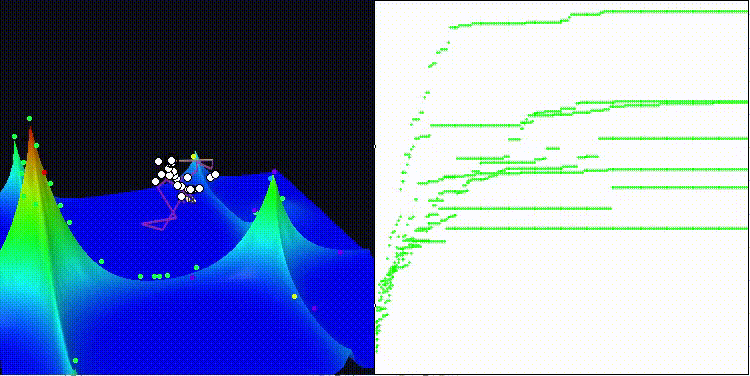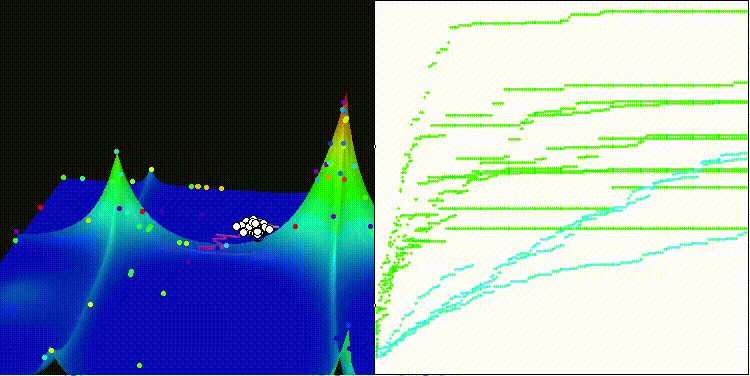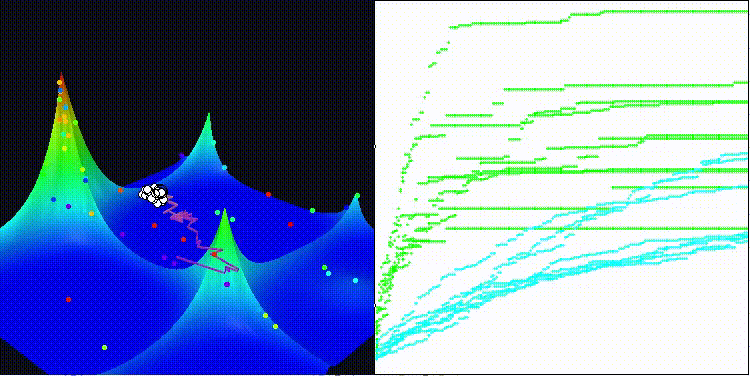
GP на тестовой функции Forest
GP на тестовой функции Megacity
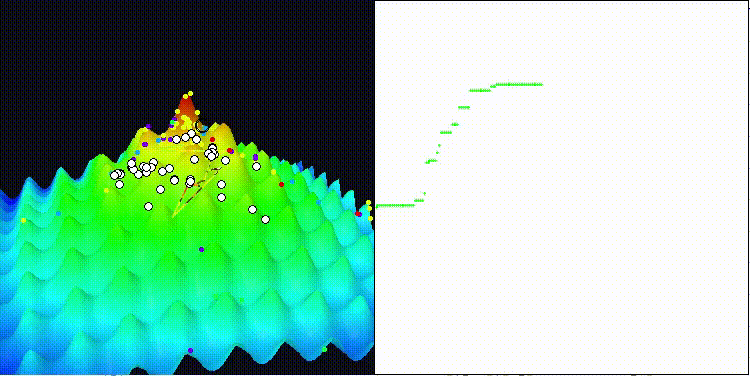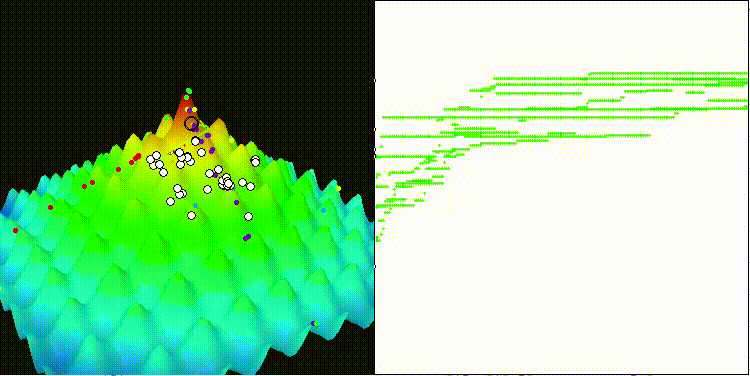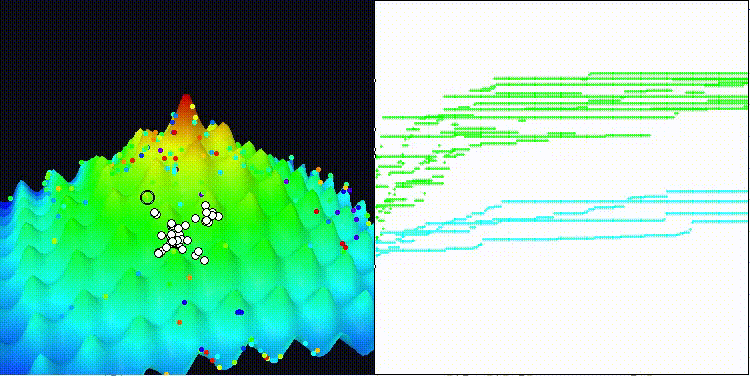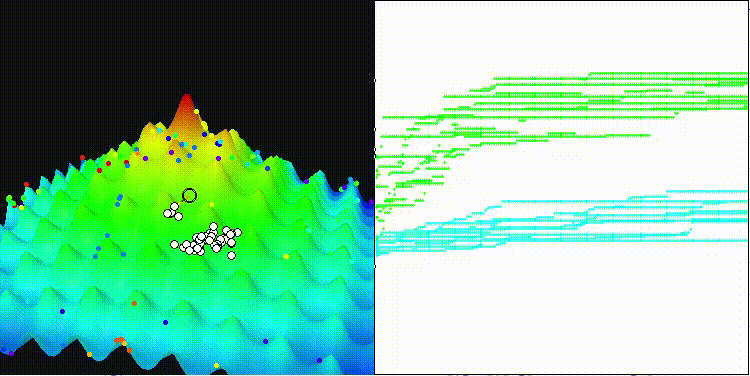
GP на функции Ackley
По результатам тестирования алгоритм GP представлен ознакомительно в нашей рейтинговой таблице лучших популяционных методов оптимизации.
| cc | AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | across neighbourhood search | 1,00000 | 0,88228 | 0,40138 | 2,28366 | 1,00000 | 0,95281 | 0,28092 | 2,23373 | 0,94667 | 0,85733 | 0,22389 | 2,02789 | 6,545 | 72,72 |
| 2 | AMOm | animal migration optimization M | 0,91624 | 0,83603 | 0,46790 | 2,22017 | 0,98482 | 0,92010 | 0,36391 | 2,26883 | 0,91733 | 0,81707 | 0,25177 | 1,98617 | 6,475 | 71,94 |
| 3 | CLA | code lock algorithm (joo) | 0,95139 | 0,86199 | 0,37879 | 2,19217 | 0,99349 | 0,93500 | 0,26497 | 2,19346 | 0,93600 | 0,84267 | 0,24060 | 2,01927 | 6,405 | 71,17 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,86571 | 0,89539 | 0,39740 | 2,15850 | 0,97761 | 0,89820 | 0,26878 | 2,14459 | 0,92133 | 0,80240 | 0,23952 | 1,96325 | 6,266 | 69,62 |
| 5 | SDSm | stochastic diffusion search M | 0,95195 | 0,84944 | 0,36249 | 2,16388 | 0,98061 | 0,88457 | 0,22112 | 2,08630 | 0,92267 | 0,79013 | 0,21380 | 1,92660 | 6,177 | 68,63 |
| 6 | AAm | archery algorithm M | 0,84685 | 0,73320 | 0,42590 | 2,00595 | 0,96709 | 0,77837 | 0,27789 | 2,02335 | 0,86133 | 0,77707 | 0,28712 | 1,92552 | 5,955 | 66,17 |
| 7 | SIA | simulated isotropic annealing (joo) | 0,93543 | 0,86504 | 0,38483 | 2,18530 | 0,94069 | 0,80609 | 0,23835 | 1,98513 | 0,86400 | 0,66160 | 0,19536 | 1,72096 | 5,891 | 65,46 |
| 8 | TETA | time evolution travel algorithm (joo) | 0,91452 | 0,86369 | 0,25579 | 2,03400 | 0,99654 | 0,91291 | 0,14394 | 2,05339 | 0,85467 | 0,82213 | 0,10443 | 1,78123 | 5,869 | 65,21 |
| 9 | ESG | evolution of social groups (joo) | 0,98111 | 0,79857 | 0,31167 | 2,09135 | 0,98954 | 0,82270 | 0,15032 | 1,96256 | 0,92133 | 0,73440 | 0,15315 | 1,80888 | 5,863 | 65,14 |
| 10 | CTA | comet tail algorithm (joo) | 0,92435 | 0,86786 | 0,27838 | 2,07059 | 0,99039 | 0,84571 | 0,19448 | 2,03058 | 0,95467 | 0,69680 | 0,11008 | 1,76155 | 5,863 | 65,14 |
| 11 | COA | coyote_optimization_algorithm | 0,88909 | 0,70681 | 0,32718 | 1,92308 | 0,99467 | 0,85358 | 0,15152 | 1,99977 | 0,88533 | 0,71040 | 0,18981 | 1,78554 | 5,708 | 63,43 |
| 12 | CSBO | circulatory_system_based_optimization | 0,87793 | 0,79105 | 0,30025 | 1,96923 | 0,95026 | 0,88027 | 0,15364 | 1,98417 | 0,85813 | 0,71525 | 0,14777 | 1,72115 | 5,776 | 63,05 |
| 13 | ECBO | enhanced colliding bodies optimization | 0,94024 | 0,72363 | 0,32356 | 1,98743 | 0,99477 | 0,80291 | 0,13056 | 1,92824 | 0,87600 | 0,70160 | 0,17433 | 1,75193 | 5,668 | 62,98 |
| 14 | BCO(B) | bezier_curve-based_optimization | 0,99069 | 0,77836 | 0,30678 | 2,07583 | 0,98481 | 0,74554 | 0,13778 | 1,86813 | 0,96400 | 0,58773 | 0,14361 | 1,69534 | 5,639 | 62,66 |
| 15 | DA | dialectical algorithm | 0,93117 | 0,75400 | 0,26205 | 1,94722 | 0,98925 | 0,81375 | 0,08662 | 1,88962 | 0,92667 | 0,68107 | 0,11315 | 1,72089 | 5,558 | 61,76 |
| 16 | BBO | biogeography based optimization | 0,95876 | 0,70609 | 0,35752 | 2,02237 | 0,92981 | 0,70660 | 0,16970 | 1,80611 | 0,87467 | 0,63013 | 0,20813 | 1,71293 | 5,541 | 61,57 |
| 17 | BHAm | black hole algorithm M | 0,79558 | 0,76207 | 0,34682 | 1,90447 | 0,99836 | 0,75798 | 0,13826 | 1,89460 | 0,85067 | 0,64427 | 0,17020 | 1,66514 | 5,464 | 60,71 |
| 18 | HS | harmony search | 0,91420 | 0,69049 | 0,29924 | 1,90393 | 0,97627 | 0,73373 | 0,14193 | 1,85193 | 0,91733 | 0,62720 | 0,15364 | 1,69817 | 5,454 | 60,60 |
| 19 | RFO | royal flush optimization (joo) | 0,80989 | 0,74481 | 0,34546 | 1,90016 | 0,95251 | 0,77926 | 0,15185 | 1,88362 | 0,80400 | 0,66427 | 0,19071 | 1,65898 | 5,443 | 60,48 |
| 20 | BOAm | billiards optimization algorithm M | 0,76177 | 0,72421 | 0,25275 | 1,73873 | 0,90890 | 0,81960 | 0,28853 | 2,01703 | 0,83733 | 0,74613 | 0,09763 | 1,68109 | 5,437 | 60,41 |
| 21 | ASO | anarchy society optimization | 0,73070 | 0,73713 | 0,31195 | 1,77978 | 0,99732 | 0,87700 | 0,17619 | 2,05051 | 0,72000 | 0,68773 | 0,18988 | 1,59761 | 5,428 | 60,31 |
| 22 | OOAm | osprey_optimization_algorithm | 0,67372 | 0,68299 | 0,34866 | 1,70537 | 0,99999 | 0,86410 | 0,15774 | 2,02183 | 0,78933 | 0,70613 | 0,18442 | 1,67988 | 5,407 | 60,08 |
| 23 | EOm | extremal optimization_M | 0,76527 | 0,75205 | 0,31908 | 1,83640 | 0,99999 | 0,76426 | 0,12437 | 1,88862 | 0,84133 | 0,64133 | 0,15247 | 1,63513 | 5,360 | 59,56 |
| 24 | ACS | artificial cooperative search | 0,75545 | 0,77162 | 0,31653 | 1,84360 | 1,00000 | 0,80488 | 0,10705 | 1,91193 | 0,76933 | 0,60800 | 0,14157 | 1,51890 | 5,274 | 58,60 |
| 25 | SSG | saplings sowing and growing | 0,75436 | 0,63206 | 0,35935 | 1,74577 | 0,91907 | 0,69694 | 0,19755 | 1,81356 | 0,81867 | 0,60533 | 0,21347 | 1,63747 | 5,197 | 57,74 |
| 26 | AOSm | atomic orbital search M | 0,76184 | 0,68435 | 0,31344 | 1,75963 | 0,90015 | 0,80044 | 0,11501 | 1,81560 | 0,82800 | 0,63280 | 0,15696 | 1,61776 | 5,193 | 57,70 |
| 27 | TSEA | turtle shell evolution algorithm (joo) | 0,95809 | 0,64852 | 0,29571 | 1,90232 | 0,99522 | 0,58104 | 0,10542 | 1,68168 | 0,92133 | 0,52160 | 0,14567 | 1,58860 | 5,173 | 57,48 |
| 28 | DE | flow_direction_algorithm | 0,96398 | 0,62346 | 0,26089 | 1,84833 | 0,98482 | 0,77018 | 0,11459 | 1,86959 | 0,93067 | 0,36213 | 0,11000 | 1,40280 | 5,121 | 56,90 |
| 29 | BIO | blood inheritance optimization (joo) | 0,72580 | 0,66522 | 0,31228 | 1,70330 | 0,99995 | 0,68125 | 0,11540 | 1,79660 | 0,85467 | 0,59333 | 0,15364 | 1,60164 | 5,102 | 56,69 |
| 30 | (PO)ES | (PO) evolution strategies | 0,73972 | 0,58190 | 0,38896 | 1,71058 | 0,91199 | 0,59975 | 0,21262 | 1,72436 | 0,82400 | 0,56240 | 0,23432 | 1,62072 | 5,056 | 56,18 |
| 31 | BO | bonobo optimizer | 0,75555 | 0,64366 | 0,32657 | 1,72578 | 0,94332 | 0,70442 | 0,13999 | 1,78773 | 0,73467 | 0,61440 | 0,16728 | 1,51635 | 5,030 | 55,89 |
| 32 | SRA | successful restaurateur algorithm (joo) | 0,89010 | 0,63359 | 0,29115 | 1,81484 | 0,96634 | 0,55285 | 0,08914 | 1,60833 | 0,89333 | 0,52800 | 0,13911 | 1,56044 | 4,984 | 55,38 |
| 33 | FDAm | flow_direction_algorithm_M | 0,87573 | 0,58806 | 0,27135 | 1,73514 | 0,99997 | 0,64399 | 0,09633 | 1,74029 | 0,84267 | 0,48453 | 0,11888 | 1,44608 | 4,922 | 54,70 |
| 34 | CRO | chemical reaction optimisation | 0,91281 | 0,65681 | 0,29866 | 1,86828 | 0,90513 | 0,56020 | 0,10939 | 1,57472 | 0,82800 | 0,50133 | 0,14149 | 1,47082 | 4,914 | 54,60 |
| 35 | BCOm | bacterial chemotaxis optimization M | 0,82589 | 0,61733 | 0,31584 | 1,75906 | 0,95296 | 0,63718 | 0,11984 | 1,70998 | 0,76533 | 0,51653 | 0,15800 | 1,43986 | 4,909 | 54,54 |
| 36 | DOA | dream optimization algorithm | 0,78522 | 0,78121 | 0,36036 | 1,92679 | 0,61584 | 0,42117 | 0,12254 | 1,15955 | 0,86667 | 0,72587 | 0,21127 | 1,80381 | 4,890 | 54,33 |
| 37 | ABO | african buffalo optimization | 0,92295 | 0,62528 | 0,29885 | 1,84708 | 0,92992 | 0,57468 | 0,09372 | 1,59832 | 0,73333 | 0,51333 | 0,14324 | 1,38990 | 4,835 | 53,72 |
| 38 | BSA | bird swarm algorithm | 0,94432 | 0,67941 | 0,26401 | 1,88774 | 0,91649 | 0,65619 | 0,12054 | 1,69322 | 0,80933 | 0,33547 | 0,10652 | 1,25132 | 4,832 | 53,69 |
| 39 | TSm | tabu search M | 0,87806 | 0,61040 | 0,28993 | 1,77839 | 0,98116 | 0,52165 | 0,08544 | 1,58825 | 0,82667 | 0,49547 | 0,13552 | 1,45766 | 4,824 | 53,60 |
| 40 | BSA | backtracking search algorithm | 0,87128 | 0,53190 | 0,28675 | 1,68993 | 0,92408 | 0,51602 | 0,09153 | 1,53163 | 0,96000 | 0,47253 | 0,13760 | 1,57013 | 4,792 | 53,24 |
| 41 | BEA | bacterial_evolutionary_algorithm | 0,92170 | 0,59615 | 0,29340 | 1,81125 | 0,96906 | 0,44500 | 0,08233 | 1,49639 | 0,90533 | 0,43173 | 0,13676 | 1,47382 | 4,781 | 53,13 |
| 42 | BWOm | beluga_whale_optimization_M | 0,78488 | 0,56872 | 0,29557 | 1,64917 | 0,91370 | 0,61760 | 0,12988 | 1,66118 | 0,81333 | 0,49946 | 0,15004 | 1,46283 | 4,773 | 53,04 |
| 43 | WOAm | whale optimization algorithm M | 0,93893 | 0,59477 | 0,26695 | 1,80065 | 0,98036 | 0,53873 | 0,07112 | 1,59021 | 0,78667 | 0,47600 | 0,11892 | 1,38159 | 4,772 | 53,02 |
| 44 | ACA | andean_condor_algorithm | 0,78444 | 0,53260 | 0,33108 | 1,64812 | 0,79071 | 0,44960 | 0,10685 | 1,34716 | 0,92266 | 0,67733 | 0,17613 | 1,77612 | 4,771 | 53,02 |
| 45 | CSO | competitive swarm optimizer | 0,85151 | 0,60786 | 0,29896 | 1,75833 | 0,84085 | 0,58491 | 0,11974 | 1,54550 | 0,80000 | 0,48560 | 0,14184 | 1,42744 | 4,731 | 52,57 |
| GP | genetic_programming | 0,56496 | 0,50544 | 0,24995 | 1,32035 | 0,69613 | 0,51112 | 0,05803 | 1,26528 | 0,59199 | 0,38826 | 0,11005 | 1,09030 | 3,676 | 40,84 | |
| RW | random walk | 0,49970 | 0,32333 | 0,25791 | 1,08094 | 0,30754 | 0,11470 | 0,04400 | 0,46624 | 0,36133 | 0,17013 | 0,10244 | 0,63390 | 2,181 | 24,23 | |
Выводы
Канонический GP Коза, поставленный на наш стенд без изменений, проиграл случайному поиску во всех девяти тестах. Главным выявленным фактором стала формула пропорционального отбора: она чувствительна к масштабу пригодности. На функциях с небольшим разбросом пригодности отбор почти перестаёт различать особи, и эволюция идёт вслепую. Деревья, кроссовер и остальные канонические параметры при исправлении не менялись.
Один множитель в формуле отбора исправил это и поднял результат с 18.32% до 40.84%. Всё остальное осталось каноническим. Это хорошо показывает, что в эволюционном алгоритме главная движущая сила — давление отбора. Без него самый изощрённый механизм рекомбинации бесполезен.
Для трейдера отсюда практическое правило, которое касается не только GP. Если оптимизатор использует пропорциональный отбор, посмотрите, в каком диапазоне меняется ваш критерий. Профит-фактор от 1.10 до 1.15 или Шарп от 0.8 до 0.9 дают такой же почти равномерный отбор, как и у нас на стенде. Тогда критерий нужно растянуть: вычесть худшее значение, умножить на коэффициент или перейти к ранговому отбору.
GP сохраняет своё главное преимущество: он ищет не числа, а формулы. Для оптимизации вектора параметров он не лучший выбор, особенно в высокой размерности. Но если задача — вырастить торговое правило или формулу индикатора, GP остаётся естественным инструментом, и теперь мы знаем, как настроить его отбор под шкалу своей задачи.
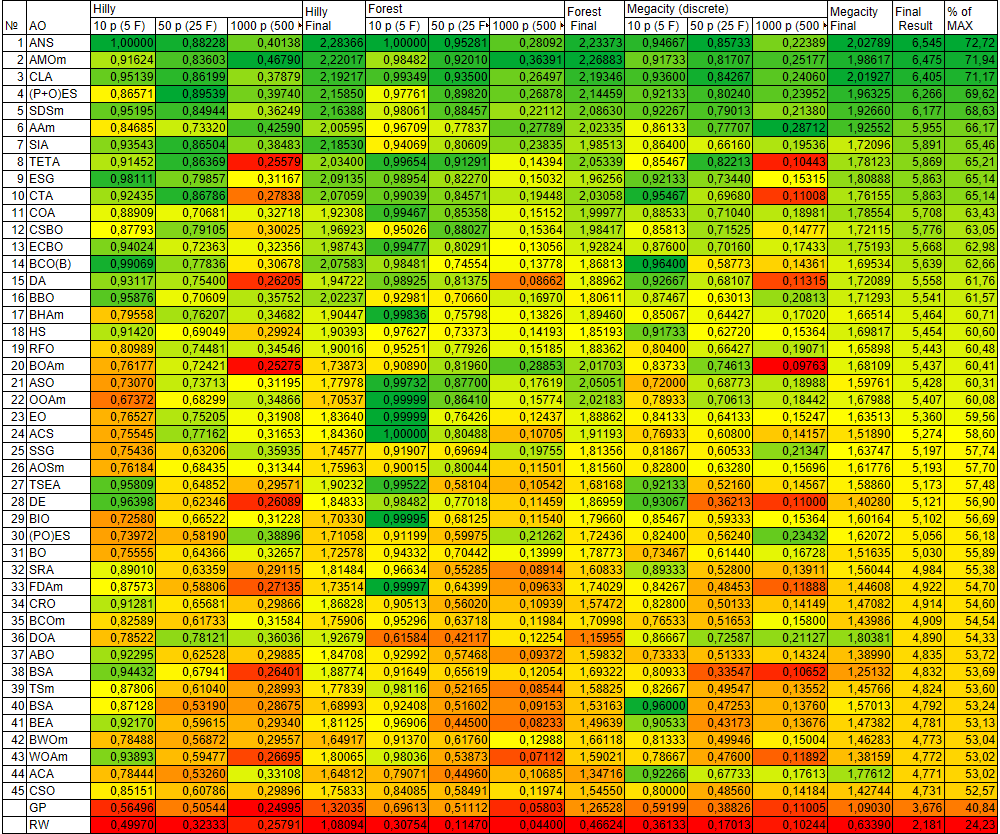
Рисунок 2. Цветовая градация алгоритмов по результатам соответствующих тестов
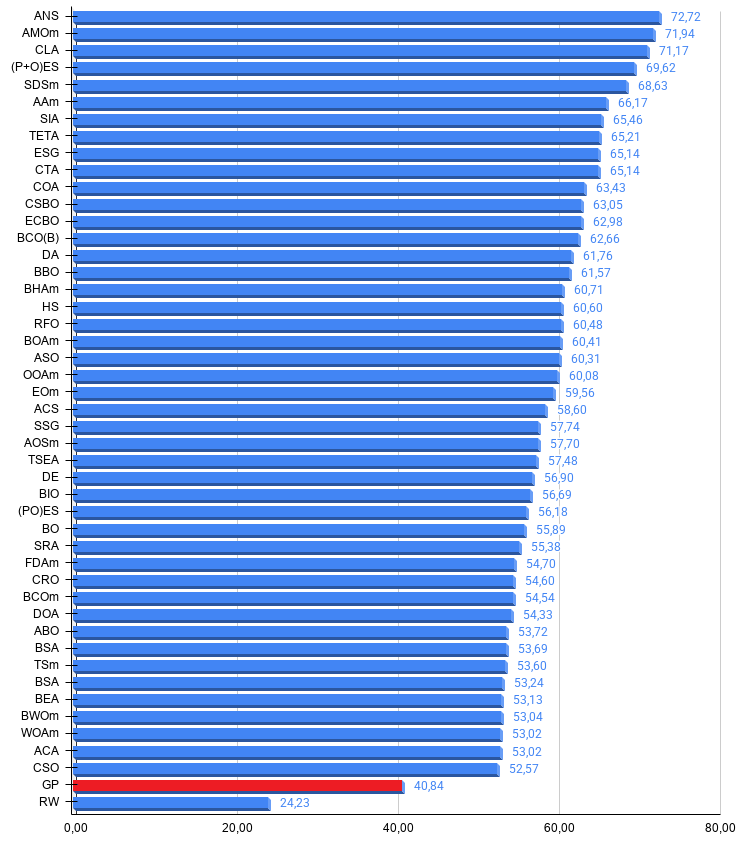
Рисунок 3. Гистограмма результатов тестирования алгоритмов (по шкале от 0 до 100: чем больше, тем лучше, где 100 — максимально возможный теоретический результат). В архиве приведёнскрипт для расчёта рейтинговой таблицы
Плюсы и минусы итоговой версии GP
Плюсы:
- ищет не только числа, но и формулы: тот же код подходит для выращивания торговых правил;
- скрещивание поддеревьев сохраняет удачные куски формул и переносит их между особями;
- на задачах малой и средней размерности уверенно обходит случайный поиск, на 25 переменных пар — с большим запасом;
- после исправления отбора хороший результат получен на канонических значениях Коза для всех остальных параметров;
Минусы:
- в каноническом виде отбор зависит от масштаба пригодности и на нормированных задачах почти не работает;
- множитель fScale подбирается под разброс пригодности конкретной задачи;
- на 500 переменных пар результат остаётся на уровне случайного поиска: за одно скрещивание меняется одна координата;
- обёртка формулы в диапазон ставит около половины координат начальной популяции на границы;
- нет мутации и элитизма: новые формулы рождаются только из старых, а лучшая особь может потеряться;
- сложная реализация и затраты памяти на хранение деревьев.
К статье прикреплён архив с актуальными версиями кода алгоритмов. Автор статьи не несёт ответственности за абсолютную точность в описании канонических алгоритмов, во многие из них внесены изменения для улучшения поисковых возможностей. Выводы и суждения, представленные в статьях, основываются на результатах проведённых экспериментов.
Программы, используемые в статье
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | #C_AO.mqh | Включаемый файл | Родительский класс популяционных алгоритмов оптимизации |
| 2 | #C_AO_enum.mqh | Включаемый файл | Перечисление популяционных алгоритмов оптимизации |
| 3 | TestFunctions.mqh | Включаемый файл | Библиотека тестовых функций |
| 4 | TestStandFunctions.mqh | Включаемый файл | Библиотека функций тестового стенда |
| 5 | TestStand3D.mqh | Включаемый файл | 3D-панель визуализации для тестового стенда |
| 6 | Utilities.mqh | Включаемый файл | Библиотека вспомогательных функций |
| 7 | CalculationTestResults.mqh | Включаемый файл | Скрипт для расчёта результатов в сравнительную таблицу |
| 8 | Test_AO_All.mq5 | Скрипт | Единый испытательный стенд для всех популяционных алгоритмов оптимизации |
| 9 | Test_AO_AntiCheat | Скрипт | Тест на читерство алгоритмов оптимизации |
| 10 | Simple use of population optimization algorithms.mq5 | Скрипт | Простой пример использования популяционных алгоритмов оптимизации без визуализации |
| 11 | Test_AO_GP.mq5 | Скрипт | Испытательный стенд для GP |
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.