

Оптимизация на основе кривых Безье — Bezier Curve-based Optimization (BCO)
 38
 0

Содержание
Введение
В 1960-х годах инженер Renault Пьер Безье искал способ описать плавные обводы кузова так, чтобы их мог повторить станок с числовым управлением. Решение оказалось изящным. Кривую задают несколько контрольных точек, которые не лежат на ней, а лишь притягивают её к себе: сдвинул точку — изогнул линию. Сегодня кривые Безье есть в каждом графическом редакторе, в шрифтах, анимации и не только.
В этом году группа авторов во главе с Вэйгуо Чжао предложила применить ту же идею к поиску оптимума. Алгоритм Bezier Curve-based Optimization (BCO) строит новую позицию агента как точку на кривой, контрольными точками которой служат сам агент, его соседи, лучшее найденное решение и центр популяции. Алгоритм заявлен как эффективный для задач большой размерности — то есть ровно для случая, когда у советника десятки параметров.
Звучит убедительно, и именно здесь стоит насторожиться. Трейдер, выбирающий оптимизатор, видит название, красивую идею и таблицы сравнений с конкурентами. Он не видит, что происходит внутри: работает ли механизм, вынесенный в название, и не выигрывает ли алгоритм за счёт особенностей тестовых функций. А от этого зависит, можно ли ждать тех же результатов на собственной задаче.
В этой статье мы разберём BCO по частям. Реализуем алгоритм на MQL5, проверим на стандартном стенде, композитном тесте и стенде со сдвигом области поиска и посмотрим, как именно он получает свой результат.
Реализация алгоритма
Начнём с того, что такое кривая Безье. Это плавная линия, которая выходит из начальной точки и приходит в конечную. Между ними могут стоять промежуточные точки — они не лежат на кривой, а притягивают её к себе, как магниты, и задают её изгиб. Все эти точки называются контрольными.
Положение на кривой задаёт параметр α. При α = 0 мы стоим в начальной точке, при α = 1 — в конечной, при промежуточных значениях — где-то на пути между ними. Если взять α больше единицы, точка выйдет за конечную, продолжая кривую за её пределы.
В BCO эта конструкция используется так. Начальная контрольная точка P0 — всегда текущее положение агента. Остальные контрольные точки строятся из других агентов, лучшего найденного решения и центра популяции. Новая позиция агента — это точка на получившейся кривой при случайном α.
Авторы используют кривые трёх порядков. Чем выше порядок, тем больше контрольных точек и тем сложнее траектория:
Линейная:     B1(α) = (1 − α)·P0 + α·P1
Квадратичная: B2(α) = (1 − α)²·P0 + 2·(1 − α)·α·P1 + α²·P2
Кубическая:   B3(α) = (1 − α)³·P0 + 3·(1 − α)²·α·P1 + 3·(1 − α)·α²·P2 + α³·P3
Коэффициенты при контрольных точках в сумме всегда дают единицу. Поэтому новая позиция — это просто взвешенное среднее контрольных точек, а α определяет, какая из них получает больший вес. При α больше единицы часть коэффициентов становится отрицательной, и точка выходит за пределы контрольных точек.
Линейная кривая — прямой отрезок от агента к цели, то есть обычный шаг в сторону P1. Квадратичная проходит к цели через одного соседа, кубическая — через двух, и может увести агента дальше всего.
Кто решает, какую кривую строить. Выбор кривой определяет фактор баланса A. Это случайное число, которое заново разыгрывается для каждого агента на каждой итерации. Его типичная величина задаётся огибающей A0, которая плавно убывает от единицы до нуля за время оптимизации:
A0 = sin(π/2 · (1 − t/T))          убывает от 1 до 0
A  = (0.4 + 2·ln(1/r)) · A0        r — случайное число из (0; 1]
Здесь t — номер текущей итерации, T — их общее число. Если A оказывается больше единицы, агент исследует: с равными шансами строится кубическая или квадратичная кривая. Если A не больше единицы, агент уточняет решение по одной из трёх линейных кривых. В начале оптимизации исследуют примерно три агента из четырёх, к концу — почти никто. Так алгоритм сам переходит от поиска к уточнению, без отдельных фаз и дополнительных параметров.
Все пять операторов BCO:
Кривая               Формулы    Когда применяется   Что делает
Кубическая           Eq.17–18   A > 1, 50%          дальний прыжок через двух соседей
Квадратичная         Eq.15–16   A > 1, 50%          шаг вдоль направления от x_j к xbest или к центру
Линейная к лучшему   Eq.8–9     A ≤ 1, 50%          шаг к точке, построенный от лучшего решения
Линейная к центру    Eq.11–12   A ≤ 1, 25%          шаг к точке, построенный от центра популяции
Покоординатная       Eq.13–14   A ≤ 1, 25%          обмен координатами с соседями
Как меняется параметр кривой α. Параметр α тоже подчиняется расписанию. Он разбрасывается вокруг единицы, а ширину разброса задаёт величина α0, которая быстро растёт с номером итерации:
α0 = 1 + 80·(t/T) + 0.02·(10·t/T)³
α  = 1 + (2·r − 1) / α0            r — случайное число из [0; 1)
Вот как сужается разброс α по ходу оптимизации:
Доля бюджета t/T   α0     Разброс α
0.0                1      от 0 до 2
0.1                9      1 ± 0.11
0.5                43.5   1 ± 0.023
1.0                101    1 ± 0.01
В этом расписании кроется главная особенность алгоритма; её легко пропустить за красивой геометрией. В самом начале α меняется от нуля до двух, и кривая работает в полную силу: новая точка может оказаться где угодно между контрольными точками или за последней из них. Но уже к десятой части бюджета α почти всегда близко к единице. А при α ≈ 1 точка на кривой любого порядка почти совпадает с последней контрольной точкой — это хорошо видно на иллюстрации ниже.
Практический смысл простой. После короткого начального этапа BCO фактически перестаёт строить кривые. Линейный оператор ставит агента почти в точку P1, квадратичный — в P2, кубический — в P3.
Поэтому естественно предположить, что основную работу делают формулы, по которым строится последняя контрольная точка, а не геометрия кривой. Это вывод из расписания α, а не из эксперимента: вариант с α = 1 отдельно не тестировали.
Алгоритм от этого хуже не становится, но становится понятно, где искать источник его силы и слабостей.
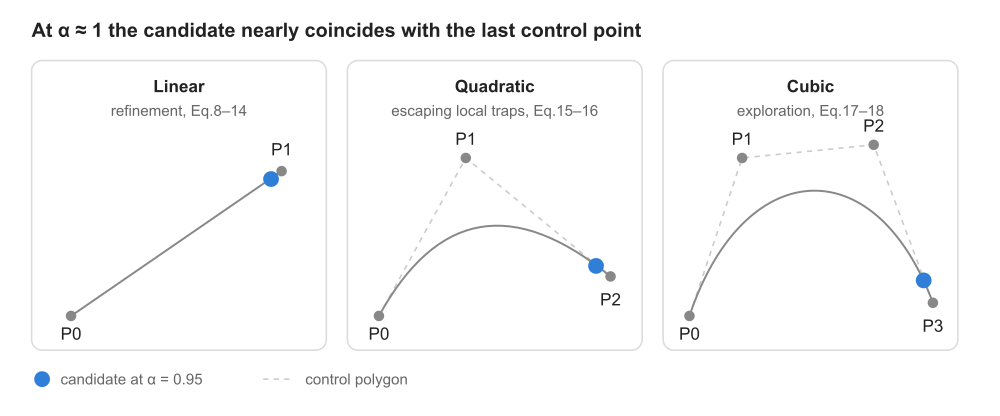
Рисунок 1. Кривые Безье трёх порядков в BCO
На рисунке показаны три кривые, которыми оперирует BCO. Первая контрольная точка P0 — всегда текущий агент. Выделенная точка — кандидат при α = 0.95: он почти совпадает с последней контрольной точкой. Именно в таком режиме алгоритм проводит большую часть оптимизации.
Простой пример. Посмотрим, как это работает на цифрах. Возьмём задачу с двумя параметрами, например период и уровень индикатора, и трёх участников: агента x_i = (2; 1), его соседа x_j = (4; 3). Лучшее найденное решение будет xbest = (6; 2). Пусть агенту выпал линейный оператор к лучшему. Сначала строится цель:
P1 = xbest + (x_j − x_i)/2 = (6; 2) + (1; 1) = (7; 3)
Агент идёт не точно в лучшее решение, а в точку рядом с ним, смещённую в сторону соседа. Новая позиция — точка на отрезке от агента к цели: (1 − α)·x_i + α·P1. Что получится при разных α:
Момент оптимизации   α      Кандидат       Что произошло
начало               0.5    (4.5; 2.0)     остановился на полпути к цели
начало               1.5    (9.5; 4.0)     проскочил цель и ушёл дальше
середина и конец     0.98   (6.9; 2.96)    близко к цели
В начале оптимизации один и тот же оператор может дать и осторожный шаг, и прыжок за цель — в этом смысл параметра кривой. Позже α почти всегда близко к единице, и оператор сводится к простому правилу: встань рядом с лучшим решением со сдвигом в сторону соседа.
С квадратичной кривой всё устроено иначе. Её последняя контрольная точка — не лучшее решение, а шаг от агента в направлении от соседа к лучшему. Пусть случайный множитель n = 1.5:
P2 = x_i + n·(xbest − x_j) = (2; 1) + 1.5·(2; −1) = (5; −0.5)
Теперь между агентом и целью стоит сосед x_j — промежуточная контрольная точка, которая изгибает путь:
Момент оптимизации   α      Кандидат        Что произошло
начало               0.5    (3.75; 1.63)    путь изогнут в сторону соседа
середина и конец     0.98   (4.96; −0.36)   практически точно в P2
Обратите внимание: кандидат не оказывается рядом с лучшим решением (6; 2). Разность xbest − x_j = (2; −1) задаёт только направление, и агент смещается параллельно линии, соединяющей соседа x_j с лучшим решением xbest, а не к самому xbest.
Множитель n случаен и может быть отрицательным — тогда шаг идёт в обратную сторону. Это не притяжение, а шаг по разностному вектору, поэтому авторы и отводят квадратичной кривой роль выхода из ловушек, а не уточнения.
Дальше всё как обычно: кандидата оценивают, и он заменяет агента, только если оказался лучше. В реальной задаче координат не две, а столько, сколько параметров у советника, но каждый оператор работает по той же схеме.
Псевдокод записан так, как алгоритм работает в нашей реализации: в схеме C_AO кандидаты всей популяции строятся в Moving, фитнес считает стенд, а отбор выполняется в Revision. Обозначения: x_i — принятое решение агента i, xbest — глобально лучшее решение, M — центр популяции, U — равномерное случайное на [0; 1), n — нормальное N(0, 1), T — число итераций.
Инициализация:
  каждому агенту — случайная точка в области поиска
  оценить всех, принять стартовые решения, найти xbest

Для каждой итерации t = 1..T:
  τ  = t / T
  α0 = 1 + 80τ + 0.02·(10τ)³          // сужение разброса α
  A0 = sin(π/2 · (1 − τ))              // огибающая фактора баланса
  M  = среднее принятых решений по каждой координате

  Для каждого агента i:
    α = 1 + (2U − 1) / α0
    A = (0.4 + 2·ln(1/U)) · A0

    если A > 1:                        // разведка
      с вероятностью 0.5 — КУБИЧЕСКАЯ кривая:
        j, k — случайные соседи
        P3 по одной из трёх формул:
          80%: M   + 2·n·(x_k − x_j)
          10%: x_j + 2·n·(x_k − x_j)
          10%: x_j + 2·n·(случайная точка области), k = i
        кандидат = B3(α; x_i, x_j, x_k, P3)
      иначе — КВАДРАТИЧНАЯ кривая:
        j — случайный сосед
        P2 = x_i + n·(xbest − x_j)  или  x_i + n·(M − x_j)
        кандидат = B2(α; x_i, x_j, P2)

    иначе:                             // уточнение
      50% — ЛИНЕЙНАЯ к лучшему:
        P1 = xbest + (x_j − x_i)/2  или  xbest − (x_j + x_i)/2
      25% — ЛИНЕЙНАЯ к центру:
        P1 = M + n·(x_i − M)  или  M + n·M
      25% — ПОКООРДИНАТНАЯ:
        по каждой координате с вероятностью 0.5
        P1[c] = интерполяция x_i[c] и x_k[c] (k свой для каждой c),
        иначе P1[c] = x_i[c]
      кандидат = B1(α; x_i, P1)

    координата вне границ → случайная точка диапазона

  оценить кандидатов
  обновить xbest
  кандидат лучше принятого решения агента → заменить его
В кубической ветви нормальное случайное число n во всех трёх формулах берётся своё для каждой координаты. В первой формуле так сделано и у авторов, во второй и третьей это наше изменение — почему, объяснено в описании метода Cubic.
Описание класса C_AO_BCO_Bezier. Класс наследуется от базового C_AO и, как все алгоритмы серии, реализует три метода: Init, Moving и Revision. Вся популяция хранится в массиве структур агентов a[]: принятые решения лежат в cB и fB каждого агента, кандидаты текущей итерации — в c и f. Собственный массив у класса один — mean[], центр популяции. У алгоритма единственный внешний параметр — размер популяции, по умолчанию 20.
Нижняя граница размера популяции не случайна. Кубическому оператору нужны три разных агента: сам агент и два соседа. При меньшей популяции цикл выбора соседа никогда бы не завершился. При popSize = 3 выбор соседей в кубическом операторе вырожден: после исключения двух агентов остаётся ровно один, поэтому на практике популяцию стоит брать заметно больше.
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
class C_AO_BCO_Bezier : public C_AO
  {
public:
                    ~C_AO_BCO_Bezier() {}
                     C_AO_BCO_Bezier()
     {
      ao_name = "BCO(Bezier)";
      ao_desc = "Bezier Curve-based Optimization";
      ao_link = "https://www.mql5.com/ru/articles/24988";

      popSize = 20;     // размер популяции

      ArrayResize(params, 1);
      params [0].name = "popSize";
      params [0].val  = popSize;
     }

   void               SetParams()
     {
      popSize = (int)params [0].val;

      if(popSize < 3)
         popSize = 3;   // Eq.17 требует трёх разных агентов

      params [0].val = popSize;
     }

   bool               Init(const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0);

   void               Moving();
   void               Revision();

private:
   int                epochs;      // бюджет стенда в эпохах
   int                epochNow;    // выполненных эпох (номер итерации It)
   double             alpha0;      // Eq.10: знаменатель разброса alpha
   double             a0;          // Eq.19: огибающая фактора баланса A
   double             mean [];     // центр принятой популяции на начало итерации

   void               MakeCandidate(int i);
   void               Cubic(int i, double al);        // Eq.17-18
   void               Quadratic(int i, double al);    // Eq.15-16
   void               LinearBest(int i, double al);   // Eq.8-9
   void               LinearMean(int i, double al);   // Eq.11-12
   void               LinearCross(int i, double al);  // Eq.13-14

   void               PutCoord(int i, int c, double x);
   int                Other(int i, int j);
   double             RndOpen();
   double             Gauss();
  };
Метод Init. Он выполняет стандартную инициализацию и запоминает бюджет в эпохах. Число эпох здесь обязательно: от доли пройденного бюджета зависят оба расписания алгоритма, и без него BCO не знает, где он находится на пути от разведки к уточнению.
//+------------------------------------------------------------------+
//|                              Init                                |
//+------------------------------------------------------------------+
bool C_AO_BCO_Bezier::Init(const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0)
  {
   if(!StandardInit(rangeMinP, rangeMaxP, rangeStepP))
      return false;

   epochs   = (epochsP > 0) ? epochsP : 1;
   epochNow = 0;
   alpha0   = 1.0;
   a0       = 1.0;

   ArrayResize(mean, coords);

   return true;
  }
Вспомогательные методы. Четыре небольших метода обслуживают операторы. PutCoord: координата, вышедшая за границу, не прижимается к ней, а заменяется случайной точкой диапазона. Other выбирает случайного соседа, отличного от одного или двух заданных агентов. RndOpen даёт равномерное число без нуля, чтобы логарифм был определён. Gauss возвращает стандартное нормальное число по методу Бокса — Мюллера.
//+------------------------------------------------------------------+
//| SpaceBound оригинала: вышедшая координата — равномерно в диапазон|
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::PutCoord(int i, int c, double x)
  {
   if(x < rangeMin [c] || x > rangeMax [c])
      x = u.RNDfromCI(rangeMin [c], rangeMax [c]);

   a [i].c [c] = u.SeInDiSp(x, rangeMin [c], rangeMax [c], rangeStep [c]);
  }

//+------------------------------------------------------------------+
//| случайный индекс агента, не равный i и j (j = -1 — не учитывать) |
//+------------------------------------------------------------------+
int C_AO_BCO_Bezier::Other(int i, int j)
  {
   int k;
   do
      k = u.RNDminusOne(popSize);
   while(k == i || k == j);
   return k;
  }

//+------------------------------------------------------------------+
//| равномерное на (0; 1]                                            |
//+------------------------------------------------------------------+
double C_AO_BCO_Bezier::RndOpen()
  {
   double r;
   do
      r = u.RNDprobab();
   while(r <= 0.0);
   return r;
  }

//+------------------------------------------------------------------+
//| N(0,1), Box-Muller                                               |
//+------------------------------------------------------------------+
double C_AO_BCO_Bezier::Gauss()
  {
   return sqrt(-2.0 * log(RndOpen())) * cos(2.0 * M_PI * u.RNDprobab());
  }
Метод MakeCandidate. Это диспетчер. Для каждого агента он разыгрывает параметр кривой α и фактор баланса A, а затем передаёт управление одному из пяти операторов с вероятностями из таблицы в разделе об идее авторов.
//+------------------------------------------------------------------+
//|   MakeCandidate — выбор оператора (Eq.10, Eq.19).                |
//|   A > 1:  50% кубическая / 50% квадратичная;                     |
//|   A <= 1: 50% к лучшему / 25% к центру / 25% покоординатная.     |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::MakeCandidate(int i)
  {
   double al = 1.0 + (2.0 * u.RNDprobab() - 1.0) / alpha0;    // Eq.10
   double A  = (0.4 + 2.0 * log(1.0 / RndOpen())) * a0;       // Eq.19

   if(A > 1.0)
     {
      if(u.RNDprobab() > 0.5)
         Cubic(i, al);
      else
         Quadratic(i, al);
     }
   else
     {
      if(u.RNDprobab() > 0.5)
         LinearBest(i, al);
      else
        {
         if(u.RNDprobab() > 0.5)
            LinearMean(i, al);
         else
            LinearCross(i, al);
        }
     }
  }
Метод Cubic. Кубическая кривая — единственное место, где наша реализация намеренно отходит от авторской. Коэффициенты Бернштейна вычисляются один раз на агента, а последняя контрольная точка P3 строится по одной из трёх формул.
В авторской версии у второй и третьей формул есть особенность, которую нельзя переносить буквально. Во второй формуле из всего вектора соседа вычитается одно число — значение соседа k в одной случайной координате. В результате все координаты кандидата одновременно тянутся к одному значению. На стандартном стенде, где многомерная функция складывается из одинаковых двумерных копий, это заметно даже глазами: при 500 функциях Hilly пары координат лучшего решения выстраиваются вдоль диагонали x = y. В третьей формуле одно случайное число на все координаты даёт точку на главной диагонали области поиска, и сдвиг на эту точку тоже согласован по всем координатам.
Оба эффекта используют структуру тестовых функций, а не свойства задачи. В реальной оптимизации советника параметры имеют разный смысл и разные диапазоны, и перенос значения одного параметра во все остальные бессмыслен. Поэтому во второй формуле используется обычная покоординатная разность, а в третьей — своя случайная точка для каждой координаты. В обеих формулах и нормальное число берётся своё для каждой координаты.
В третьей формуле, как и у авторов, сосед k не выбирается и остаётся равным самому агенту, так что вторая промежуточная точка кривой совпадает с P0.
//+------------------------------------------------------------------+
//|   Cubic — кубическая кривая, исследование (Eq.17-18).            |
//|   P0 = x_i, P1 = x_j, P2 = x_k, P3 — по одной из трёх формул.    |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::Cubic(int i, double al)
  {
   int    j    = Other(i, -1);
   int    k    = i;
   double ur   = 0.0;
   double r    = u.RNDprobab();
   double p3   = 0.0;
   int    mode = 0;

   if(r < 0.8)
     {
      mode = 0;
      k  = Other(i, j);
     }
   else
      if(r > 0.9)
        {
         mode = 1;
         k  = Other(i, j);
        }
      else
        {
         mode = 2;
        }

   double b  = 1.0 - al;
   double w0 = b * b * b;
   double w1 = 3.0 * b * b * al;
   double w2 = 3.0 * b * al * al;
   double w3 = al * al * al;

   for(int c = 0; c < coords; c++)
     {
      switch(mode)
        {
         case 0:
            p3 = mean [c] + 2.0 * Gauss() * (a [k].cB [c] - a [j].cB [c]);
            break;
         case 1:
            p3 = a [j].cB [c] + 2.0 * Gauss() * (a [k].cB [c] - a [j].cB [c]);
            break;
         default:
            p3 = a [j].cB [c] + 2.0 * Gauss() * (rangeMin [c] + u.RNDprobab() * (rangeMax [c] - rangeMin [c]));
            break;
        }

      PutCoord(i, c, w0 * a [i].cB [c] + w1 * a [j].cB [c] + w2 * a [k].cB [c] + w3 * p3);
     }
  }
Метод Quadratic. Квадратичная кривая строится по агенту, соседу и точке P2, смещённой от агента на случайный шаг вдоль направления от соседа к лучшему решению или к центру популяции. Здесь нормальное число одно на весь вектор, как в оригинале: шаг идёт вдоль направления, а не разбрасывает координаты независимо.
//+------------------------------------------------------------------+
//|   Quadratic — квадратичная кривая, выход из ловушек (Eq.15-16).  |
//|   P0 = x_i, P1 = x_j, P2 = x_i + randn*(xbest|M - x_j).          |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::Quadratic(int i, double al)
  {
   int    j      = Other(i, -1);
   double n      = Gauss();
   bool   toBest = u.RNDprobab() > 0.5;

   double b  = 1.0 - al;
   double w0 = b * b;
   double w1 = 2.0 * b * al;
   double w2 = al * al;
   double ref, p2;

   for(int c = 0; c < coords; c++)
     {
      ref = toBest ? cB [c] : mean [c];
      p2  = a [i].cB [c] + n * (ref - a [j].cB [c]);

      PutCoord(i, c, w0 * a [i].cB [c] + w1 * a [j].cB [c] + w2 * p2);
     }
  }
Методы LinearBest и LinearMean. Оба метода строят линейную кривую от агента к точке P1 и отличаются лишь тем, где эта точка. В LinearBest она строится от лучшего решения, в LinearMean — от центра популяции. Но рядом с ними её ставит только одна из двух формул каждого метода.
В каждом методе одна из двух формул зависит от положения начала координат. В LinearBest это вычитание полусуммы двух агентов из лучшего решения: когда популяция сошлась, результат близок к нулю. В LinearMean это масштабирование центра популяции случайным множителем, то есть сдвиг по лучу из начала координат. Мы перенесли обе формулы без изменений, а их влияние проверили отдельно на стенде со сдвигом области поиска.
//+------------------------------------------------------------------+
//|   LinearBest — линейная кривая к лучшему (Eq.8-9).               |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::LinearBest(int i, double al)
  {
   int  j    = Other(i, -1);
   bool diff = u.RNDprobab() < 0.5;
   double p1;

   for(int c = 0; c < coords; c++)
     {
      if(diff)
         p1 = cB [c] + (a [j].cB [c] - a [i].cB [c]) * 0.5;
      else
         p1 = cB [c] - (a [j].cB [c] + a [i].cB [c]) * 0.5;

      PutCoord(i, c, (1.0 - al) * a [i].cB [c] + al * p1);
     }
  }

//+------------------------------------------------------------------+
//|   LinearMean — линейная кривая к центру популяции (Eq.11-12).    |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::LinearMean(int i, double al)
  {
   double n   = Gauss();
   bool   rel = u.RNDprobab() > 0.5;
   double p1;

   for(int c = 0; c < coords; c++)
     {
      if(rel)
         p1 = mean [c] + n * (a [i].cB [c] - mean [c]);
      else
         p1 = mean [c] + n * mean [c];

      PutCoord(i, c, (1.0 - al) * a [i].cB [c] + al * p1);
     }
  }
Метод LinearCross. Покоординатный оператор — самый простой по записи и, судя по диагностике, самый результативный в высокой размерности. Для каждой координаты с вероятностью 0.5 выбирается свой случайный сосед. Интерполяция к нему применяется дважды: сначала строится P1 = (1 − α)·x_i + α·x_k, затем кандидат = (1 − α)·x_i + α·P1. В итоге вес соседа равен α², а не α. Так устроено и в авторской реализации (Eq.13–14), мы перенесли его без изменений.
При α ≈ 1 это почти копирование координаты соседа, то есть равномерный кроссовер с отдельным донором для каждой координаты. В начале оптимизации, когда α доходит до 2, вес соседа доходит до 4, и координата может уйти далеко за значение соседа. В диагностическом прогоне канонической версии на нештатном композите из 1000 координат на этот оператор пришлась почти половина всех принятых улучшений, хотя он получает лишь восьмую часть кандидатов. Итоговую версию так не измеряли.
//+------------------------------------------------------------------+
//|   LinearCross — покоординатная интерполяция (Eq.13-14).          |
//|   Партнёр k выбирается заново для каждой координаты.             |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::LinearCross(int i, double al)
  {
   double p1;

   for(int c = 0; c < coords; c++)
     {
      if(u.RNDprobab() > 0.5)
        {
         int k = Other(i, -1);
         p1 = (1.0 - al) * a [i].cB [c] + al * a [k].cB [c];
        }
      else
         p1 = a [i].cB [c];

      PutCoord(i, c, (1.0 - al) * a [i].cB [c] + al * p1);
     }
  }
Метод Moving. На первом вызове Moving расставляет агентов случайно. Далее он пересчитывает оба расписания по номеру итерации, находит центр принятых решений и строит кандидата для каждого агента. Первая эпоха стенда уходит на инициализацию, поэтому номер итерации отсчитывается от второй, а на последней эпохе доля бюджета τ равна единице.
//+------------------------------------------------------------------+
//|                            Moving                                |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::Moving()
  {
//--- первый прогон: стартовая популяция
   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
         for(int c = 0; c < coords; c++)
            a [i].c [c] = u.SeInDiSp(u.RNDfromCI(rangeMin [c], rangeMax [c]), rangeMin [c], rangeMax [c], rangeStep [c]);
      return;
     }

//--- расписания: It = epochNow (1..epochs-1), MaxIt = epochs-1
   int maxIt = epochs - 1;
   if(maxIt < 1)
      maxIt = 1;

   double tau = (double)epochNow / (double)maxIt;
   if(tau > 1.0)
      tau = 1.0;

   alpha0 = 1.0 + 80.0 * tau + 0.02 * pow(10.0 * tau, 3.0);   // Eq.10
   a0     = sin(M_PI * 0.5 * (1.0 - tau));                    // Eq.19

//--- центр принятой популяции (фиксируется на итерацию)
   for(int c = 0; c < coords; c++)
     {
      mean [c] = 0.0;
      for(int i = 0; i < popSize; i++)
         mean [c] += a [i].cB [c];
      mean [c] /= (double)popSize;
     }

   for(int i = 0; i < popSize; i++)
      MakeCandidate(i);
  }
Метод Revision. Он обновляет глобально лучшее решение и выполняет жадный отбор: кандидат заменяет принятое решение агента, только если строго лучше его. На первом вызове стартовая популяция целиком становится принятой.
//+------------------------------------------------------------------+
//|                           Revision                               |
//+------------------------------------------------------------------+
void C_AO_BCO_Bezier::Revision()
  {
//--- обновление лучших решений
   for(int i = 0; i < popSize; i++)
     {
      if(a [i].f > fB)
        {
         fB = a [i].f;
         ArrayCopy(cB, a [i].c, 0, 0, coords);
        }
      if(a [i].f > a [i].fB)
        {
         a [i].fB = a [i].f;
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
        }
     }

   epochNow++;

//--- первый проход: стартовая популяция становится принятой
   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
        {
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
         a [i].fB = a [i].f;
        }

      revision = true;
      return;
     }
  }
Результаты тестов
На стандартном стенде BCO(Bezier) набирает 62.65% при размере популяции 20 и бюджете 10 000 вычислений функции. Распечатка тестового скрипта:
=============================
5 Hilly's; Func runs: 10000; result: 0.9627881798300842
25 Hilly's; Func runs: 10000; result: 0.7709349420050163
500 Hilly's; Func runs: 10000; result: 0.3028802237256021
=============================
5 Forest's; Func runs: 10000; result: 0.9772251652004798
25 Forest's; Func runs: 10000; result: 0.7454863396289857
500 Forest's; Func runs: 10000; result: 0.1343845224959618
=============================
5 Megacity's; Func runs: 10000; result: 0.9600000000000002
25 Megacity's; Func runs: 10000; result: 0.6005333333333335
500 Megacity's; Func runs: 10000; result: 0.18444000000000016
=============================
All score: 5.63867 (62.65%)
Картина по размерностям типична для сильных алгоритмов серии. На десяти координатах BCO почти всегда находит глобальный максимум всех трёх функций, включая дискретную Megacity. На пятидесяти координатах результат остаётся высоким, а на тысяче координат заметно падает, особенно на Forest и Megacity.
Вероятная причина в том, что при α ≈ 1 большинство операторов меняет сразу все координаты агента, а в тысячемерном пространстве такие шаги редко приводят к улучшению.
Композитный тест. Стандартные функции стенда складываются из одинаковых двумерных копий, и алгоритм может выигрывать за счёт этой структуры, а не за счёт поиска. Для проверки служит композитный тест серии: десять координат разбиты на пять пар, каждая пара принадлежит своей функции — Hilly, Forest, Megacity, Peaks и Skin — со своим диапазоном и положением оптимума. Если алгоритм опирается на одинаковость пар, на композите он проседает.
BCO(Bezier)|Bezier Curve-based Optimization|20.0|
=============================
Composite test: Hilly + Forest + Megacity + Peaks + Skin
Coordinates: 10; Epochs: 500; Repeats: 10
=============================
Run 1/10: 0.9985860518898402
Run 2/10: 0.983912846776397
Run 3/10: 0.986666573255872
Run 4/10: 0.9948107723080468
Run 5/10: 0.999999999994493
Run 6/10: 0.9069702846261777
Run 7/10: 0.9994983754899163
Run 8/10: 0.9948108474610533
Run 9/10: 0.9861650421688036
Run 10/10: 0.9948108473725867
=============================
Average result: 0.9846231641 (98.46%)
=============================
На композите BCO не хуже, чем на основном стенде в той же размерности. Композит составлен из других функций, — но провала, который означал бы опору на одинаковость двумерных блоков стенда, нет.
Значит, в малой размерности геометрия тестовых функций алгоритму не подыгрывает. Девять прогонов из десяти лежат в диапазоне от 0.984 до 1.000, один срывается в локальный максимум с результатом 0.907.
В большой размерности, где проявлялся перенос значения между координатами, десятимерный композит этот механизм увидеть не может. Здесь его отсутствие обеспечено кодом метода Cubic, и визуально при 500 функциях Hilly пары координат лучшего решения больше не выстраиваются вдоль диагонали. Сам композитный тест о поведении на 50 и 1000 координатах ничего не говорит.
Дополнительная проверка: сдвиг области поиска. Сдвиг области поиска на 15 её ширин не меняет результат BCO: 62.66% (в распечатке теста, приведённой ниже) против 62.65% на стандартном стенде. По отдельным ячейкам некоторые различия есть.
Зачем эта проверка понадобилась. В трёх формулах алгоритма участвует не разность точек, а их абсолютное положение: вычитание полусуммы агентов из лучшего решения в Eq.8, масштабирование центра популяции в Eq.11 и случайная точка области в третьей формуле Eq.17. Такие формулы тянут агентов к началу координат. На стандартном стенде диапазоны симметричны, и начало координат совпадает с центром области. Если оптимум функции лежит недалеко от центра, притяжение к нулю выглядит как хорошая сходимость и завышает результат — на картинке этого не видно.
Проверка устроена просто. Диапазон каждой координаты сдвигается на ShiftFactor ширин, а перед вычислением функции сдвиг вычитается обратно. Ландшафт остаётся прежним, меняется только положение начала координат относительно области поиска. При ShiftFactor = 0 скрипт воспроизводит стандартный стенд, что служит проверкой самого скрипта.
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
void OnStart()
  {
//--- алгоритм
   C_AO *AO = new C_AO_BCO_Bezier();
   AO.params [0].val = PopSize_P;
   AO.SetParams();
   Print(AO.GetName(), "|", AO.GetDesc(), "|", AO.GetParams(), "   ShiftFactor = ", ShiftFactor_P);

   double allScore = 0.0;
   double allTests = 0.0;

   EFunc funcList [3];
   funcList [0] = Function1;
   funcList [1] = Function2;
   funcList [2] = Function3;

   for(int n = 0; n < 3; n++)
     {
      if(funcList [n] == NONE_Func)
         continue;

      C_Function *F = SelectFunction(funcList [n]);
      if(F == NULL)
         continue;

      Print("=============================");
      FuncTests(AO, *F, Test1FuncRuns_P, allScore, allTests);
      FuncTests(AO, *F, Test2FuncRuns_P, allScore, allTests);
      FuncTests(AO, *F, Test3FuncRuns_P, allScore, allTests);
      delete F;
     }

   Print("=============================");
   if(allTests > 0.0)
      Print("All score: ", DoubleToString(allScore, 5), " (", DoubleToString(allScore * 100.0 / allTests, 2), "%)");

   delete AO;
  }

//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
void FuncTests(C_AO          &ao,
               C_Function    &f,
               const int      funcCount,
               double        &allScore,
               double        &allTests)
  {
   if(funcCount <= 0)
      return;
   allTests++;

   double aveResult  = 0.0;
   int    epochCount = NumbTestFuncRuns_P / (int)ao.params [0].val;
   int    params     = funcCount * 2;

   double rangeMin [], rangeMax [], rangeStep [], shift [], cTmp [];
   ArrayResize(rangeMin,  params);
   ArrayResize(rangeMax,  params);
   ArrayResize(rangeStep, params);
   ArrayResize(shift,     params);
   ArrayResize(cTmp,      params);

   for(int i = 0; i < funcCount; i++)
     {
      shift     [i * 2]     = ShiftFactor_P * (f.GetMaxRangeX() - f.GetMinRangeX());
      rangeMin  [i * 2]     = f.GetMinRangeX() + shift [i * 2];
      rangeMax  [i * 2]     = f.GetMaxRangeX() + shift [i * 2];
      rangeStep [i * 2]     = ArgumentStep_P;

      shift     [i * 2 + 1] = ShiftFactor_P * (f.GetMaxRangeY() - f.GetMinRangeY());
      rangeMin  [i * 2 + 1] = f.GetMinRangeY() + shift [i * 2 + 1];
      rangeMax  [i * 2 + 1] = f.GetMaxRangeY() + shift [i * 2 + 1];
      rangeStep [i * 2 + 1] = ArgumentStep_P;
     }

   for(int test = 0; test < NumberRepetTest_P; test++)
     {
      if(!ao.Init(rangeMin, rangeMax, rangeStep, epochCount))
         break;

      for(int epochCNT = 1; epochCNT <= epochCount && !IsStopped(); epochCNT++)
        {
         ao.Moving();

         //--- фитнес на исходном ландшафте: сдвиг вычитается
         for(int set = 0; set < ArraySize(ao.a); set++)
           {
            for(int c = 0; c < params; c++)
               cTmp [c] = ao.a [set].c [c] - shift [c];

            ao.a [set].f = f.CalcFunc(cTmp);
           }

         ao.Revision();
        }

      aveResult += ao.fB;
     }

   aveResult /= (double)NumberRepetTest_P;
   Print(funcCount, " ", f.GetFuncName(), "'s; Func runs: ", NumbTestFuncRuns_P, "; result: ", aveResult);
   allScore += aveResult;
  }
При сдвиге на 15 ширин все три формулы почти всегда выбрасывают кандидата далеко за границу области, и он заменяется случайной точкой диапазона. Притяжение к центру пропадает, а соответствующие ветки превращаются в случайный перезапуск координат. Если бы результат держался на притяжении к центру, он бы заметно упал.
У такой проверки есть ограничение: при большом сдвиге эти ветки не просто теряют притяжение к нулю, но и превращаются в случайный перезапуск координат. Тест смешивает три эффекта: зависимость от абсолютных координат, обработку границ и случайный перезапуск. Он отвечает только на один вопрос: держится ли общий балл на притяжении к началу координат.
BCO(Bezier)|Bezier Curve-based Optimization|20.0| ShiftFactor = 15.0
=============================
5 Hilly's; Func runs: 10000; result: 0.9906970448986909
25 Hilly's; Func runs: 10000; result: 0.7783677787030886
500 Hilly's; Func runs: 10000; result: 0.30678870196191793
=============================
5 Forest's; Func runs: 10000; result: 0.9848167768003198
25 Forest's; Func runs: 10000; result: 0.7455405909304438
500 Forest's; Func runs: 10000; result: 0.13778671015355712
=============================
5 Megacity's; Func runs: 10000; result: 0.9640000000000001
25 Megacity's; Func runs: 10000; result: 0.5877333333333333
500 Megacity's; Func runs: 10000; result: 0.14361333333333404
=============================
All score: 5.63934 (62.66%)
Восемь ячеек из девяти близки к стандартному стенду. Отличается Megacity на 500 функциях: 0.184 против 0.144. Возможно, притяжение к началу координат помогало на ступенчатой функции в большой размерности, а при сдвиге эта потеря компенсировалась небольшим приростом в других ячейках, поэтому общий балл её скрывает. Общий балл BCO не держится на притяжении к началу координат, но о нулевом вкладе формул с началом координат во всех задачах говорить нельзя — Megacity 1000 координат показывает, что в отдельных режимах он может быть.
Далее можно ознакомиться с визуализацией работы алгоритма на тестовых функциях, а также на двух дополнительных, выбранных из списка функций. Обратите внимание, как хорошо алгоритм справляется с функцией Ackley.
Это следствие операторов, опирающихся на центр популяции. В начале оптимизации агенты разбросаны равномерно, их среднее положение близко к центру области поиска, и такие операторы часто пробуют точки рядом с ним. Функции, у которых оптимум лежит в центре области, как у Ackley, получают от этого преимущество.
Это не использование структуры тестовых функций: центр популяции смещается вместе с агентами и не зависит от выбора системы координат. Совсем другое дело — перенос значения одной координаты в другие, который мы убрали из кубического оператора. Однако и результат на Ackley не стоит считать мерилом силы алгоритма: в реальной задаче оптимум редко оказывается точно посередине диапазонов параметров.

BCO(Bezier) на тестовой функции Hilly

BCO(Bezier) на тестовой функции Forest

BCO(Bezier) на тестовой функции Megacity

BCO(Bezier) на тестовой функции Ackley

BCO(Bezier) на тестовой функции Skin
По итогам тестирования алгоритм BCO занимает достаточно высокое 14-е место в нашей рейтинговой таблице популяционных методов оптимизации. В рейтинговую таблицу BCO(Bezier) внесён с результатами стенда со сдвигом области поиска, а не стандартного стенда. Это наиболее справедливая оценка алгоритма: в трёх его формулах участвует положение начала координат, и на стенде со сдвигом эти формулы не могут дать ему преимущества. На итоговом балле это практически не сказывается: 62.66% против 62.65% на стандартном стенде, и место алгоритма от выбора прогона не зависит. По отдельным ячейкам два прогона различаются.
| cc | AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | across neighbourhood search | 1,00000 | 0,88228 | 0,40138 | 2,28366 | 1,00000 | 0,95281 | 0,28092 | 2,23373 | 0,94667 | 0,85733 | 0,22389 | 2,02789 | 6,545 | 72,72 |
| 2 | AMOm | animal migration optimization M | 0,91624 | 0,83603 | 0,46790 | 2,22017 | 0,98482 | 0,92010 | 0,36391 | 2,26883 | 0,91733 | 0,81707 | 0,25177 | 1,98617 | 6,475 | 71,94 |
| 3 | CLA | code lock algorithm (joo) | 0,95139 | 0,86199 | 0,37879 | 2,19217 | 0,99349 | 0,93500 | 0,26497 | 2,19346 | 0,93600 | 0,84267 | 0,24060 | 2,01927 | 6,405 | 71,17 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,86571 | 0,89539 | 0,39740 | 2,15850 | 0,97761 | 0,89820 | 0,26878 | 2,14459 | 0,92133 | 0,80240 | 0,23952 | 1,96325 | 6,266 | 69,62 |
| 5 | SDSm | stochastic diffusion search M | 0,95195 | 0,84944 | 0,36249 | 2,16388 | 0,98061 | 0,88457 | 0,22112 | 2,08630 | 0,92267 | 0,79013 | 0,21380 | 1,92660 | 6,177 | 68,63 |
| 6 | AAm | archery algorithm M | 0,84685 | 0,73320 | 0,42590 | 2,00595 | 0,96709 | 0,77837 | 0,27789 | 2,02335 | 0,86133 | 0,77707 | 0,28712 | 1,92552 | 5,955 | 66,17 |
| 7 | SIA | simulated isotropic annealing (joo) | 0,93543 | 0,86504 | 0,38483 | 2,18530 | 0,94069 | 0,80609 | 0,23835 | 1,98513 | 0,86400 | 0,66160 | 0,19536 | 1,72096 | 5,891 | 65,46 |
| 8 | TETA | time evolution travel algorithm (joo) | 0,91452 | 0,86369 | 0,25579 | 2,03400 | 0,99654 | 0,91291 | 0,14394 | 2,05339 | 0,85467 | 0,82213 | 0,10443 | 1,78123 | 5,869 | 65,21 |
| 9 | ESG | evolution of social groups (joo) | 0,98111 | 0,79857 | 0,31167 | 2,09135 | 0,98954 | 0,82270 | 0,15032 | 1,96256 | 0,92133 | 0,73440 | 0,15315 | 1,80888 | 5,863 | 65,14 |
| 10 | CTA | comet tail algorithm (joo) | 0,92435 | 0,86786 | 0,27838 | 2,07059 | 0,99039 | 0,84571 | 0,19448 | 2,03058 | 0,95467 | 0,69680 | 0,11008 | 1,76155 | 5,863 | 65,14 |
| 11 | COA | coyote_optimization_algorithm | 0,88909 | 0,70681 | 0,32718 | 1,92308 | 0,99467 | 0,85358 | 0,15152 | 1,99977 | 0,88533 | 0,71040 | 0,18981 | 1,78554 | 5,708 | 63,43 |
| 12 | CSBO | circulatory_system_based_optimization | 0,87793 | 0,79105 | 0,30025 | 1,96923 | 0,95026 | 0,88027 | 0,15364 | 1,98417 | 0,85813 | 0,71525 | 0,14777 | 1,72115 | 5,776 | 63,05 |
| 13 | ECBO | enhanced colliding bodies optimization | 0,94024 | 0,72363 | 0,32356 | 1,98743 | 0,99477 | 0,80291 | 0,13056 | 1,92824 | 0,87600 | 0,70160 | 0,17433 | 1,75193 | 5,668 | 62,98 |
| 14 | BCO(B) | bezier_curve-based_optimization | 0,99069 | 0,77836 | 0,30678 | 2,07583 | 0,98481 | 0,74554 | 0,13778 | 1,86813 | 0,96400 | 0,58773 | 0,14361 | 1,69534 | 5,639 | 62,66 |
| 15 | DA | dialectical algorithm | 0,93117 | 0,75400 | 0,26205 | 1,94722 | 0,98925 | 0,81375 | 0,08662 | 1,88962 | 0,92667 | 0,68107 | 0,11315 | 1,72089 | 5,558 | 61,76 |
| 16 | BBO | biogeography based optimization | 0,95876 | 0,70609 | 0,35752 | 2,02237 | 0,92981 | 0,70660 | 0,16970 | 1,80611 | 0,87467 | 0,63013 | 0,20813 | 1,71293 | 5,541 | 61,57 |
| 17 | BHAm | black hole algorithm M | 0,79558 | 0,76207 | 0,34682 | 1,90447 | 0,99836 | 0,75798 | 0,13826 | 1,89460 | 0,85067 | 0,64427 | 0,17020 | 1,66514 | 5,464 | 60,71 |
| 18 | HS | harmony search | 0,91420 | 0,69049 | 0,29924 | 1,90393 | 0,97627 | 0,73373 | 0,14193 | 1,85193 | 0,91733 | 0,62720 | 0,15364 | 1,69817 | 5,454 | 60,60 |
| 19 | RFO | royal flush optimization (joo) | 0,80989 | 0,74481 | 0,34546 | 1,90016 | 0,95251 | 0,77926 | 0,15185 | 1,88362 | 0,80400 | 0,66427 | 0,19071 | 1,65898 | 5,443 | 60,48 |
| 20 | BOAm | billiards optimization algorithm M | 0,76177 | 0,72421 | 0,25275 | 1,73873 | 0,90890 | 0,81960 | 0,28853 | 2,01703 | 0,83733 | 0,74613 | 0,09763 | 1,68109 | 5,437 | 60,41 |
| 21 | ASO | anarchy society optimization | 0,73070 | 0,73713 | 0,31195 | 1,77978 | 0,99732 | 0,87700 | 0,17619 | 2,05051 | 0,72000 | 0,68773 | 0,18988 | 1,59761 | 5,428 | 60,31 |
| 22 | OOAm | osprey_optimization_algorithm | 0,67372 | 0,68299 | 0,34866 | 1,70537 | 0,99999 | 0,86410 | 0,15774 | 2,02183 | 0,78933 | 0,70613 | 0,18442 | 1,67988 | 5,407 | 60,08 |
| 23 | EOm | extremal optimization_M | 0,76527 | 0,75205 | 0,31908 | 1,83640 | 0,99999 | 0,76426 | 0,12437 | 1,88862 | 0,84133 | 0,64133 | 0,15247 | 1,63513 | 5,360 | 59,56 |
| 24 | ACS | artificial cooperative search | 0,75545 | 0,77162 | 0,31653 | 1,84360 | 1,00000 | 0,80488 | 0,10705 | 1,91193 | 0,76933 | 0,60800 | 0,14157 | 1,51890 | 5,274 | 58,60 |
| 25 | SSG | saplings sowing and growing | 0,75436 | 0,63206 | 0,35935 | 1,74577 | 0,91907 | 0,69694 | 0,19755 | 1,81356 | 0,81867 | 0,60533 | 0,21347 | 1,63747 | 5,197 | 57,74 |
| 26 | AOSm | atomic orbital search M | 0,76184 | 0,68435 | 0,31344 | 1,75963 | 0,90015 | 0,80044 | 0,11501 | 1,81560 | 0,82800 | 0,63280 | 0,15696 | 1,61776 | 5,193 | 57,70 |
| 27 | TSEA | turtle shell evolution algorithm (joo) | 0,95809 | 0,64852 | 0,29571 | 1,90232 | 0,99522 | 0,58104 | 0,10542 | 1,68168 | 0,92133 | 0,52160 | 0,14567 | 1,58860 | 5,173 | 57,48 |
| 28 | DE | flow_direction_algorithm | 0,96398 | 0,62346 | 0,26089 | 1,84833 | 0,98482 | 0,77018 | 0,11459 | 1,86959 | 0,93067 | 0,36213 | 0,11000 | 1,40280 | 5,121 | 56,90 |
| 29 | BIO | blood inheritance optimization (joo) | 0,72580 | 0,66522 | 0,31228 | 1,70330 | 0,99995 | 0,68125 | 0,11540 | 1,79660 | 0,85467 | 0,59333 | 0,15364 | 1,60164 | 5,102 | 56,69 |
| 30 | (PO)ES | (PO) evolution strategies | 0,73972 | 0,58190 | 0,38896 | 1,71058 | 0,91199 | 0,59975 | 0,21262 | 1,72436 | 0,82400 | 0,56240 | 0,23432 | 1,62072 | 5,056 | 56,18 |
| 31 | BO | bonobo optimizer | 0,75555 | 0,64366 | 0,32657 | 1,72578 | 0,94332 | 0,70442 | 0,13999 | 1,78773 | 0,73467 | 0,61440 | 0,16728 | 1,51635 | 5,030 | 55,89 |
| 32 | SRA | successful restaurateur algorithm (joo) | 0,89010 | 0,63359 | 0,29115 | 1,81484 | 0,96634 | 0,55285 | 0,08914 | 1,60833 | 0,89333 | 0,52800 | 0,13911 | 1,56044 | 4,984 | 55,38 |
| 33 | FDAm | flow_direction_algorithm_M | 0,87573 | 0,58806 | 0,27135 | 1,73514 | 0,99997 | 0,64399 | 0,09633 | 1,74029 | 0,84267 | 0,48453 | 0,11888 | 1,44608 | 4,922 | 54,70 |
| 34 | CRO | chemical reaction optimisation | 0,91281 | 0,65681 | 0,29866 | 1,86828 | 0,90513 | 0,56020 | 0,10939 | 1,57472 | 0,82800 | 0,50133 | 0,14149 | 1,47082 | 4,914 | 54,60 |
| 35 | BCOm | bacterial chemotaxis optimization M | 0,82589 | 0,61733 | 0,31584 | 1,75906 | 0,95296 | 0,63718 | 0,11984 | 1,70998 | 0,76533 | 0,51653 | 0,15800 | 1,43986 | 4,909 | 54,54 |
| 36 | DOA | dream optimization algorithm | 0,78522 | 0,78121 | 0,36036 | 1,92679 | 0,61584 | 0,42117 | 0,12254 | 1,15955 | 0,86667 | 0,72587 | 0,21127 | 1,80381 | 4,890 | 54,33 |
| 37 | ABO | african buffalo optimization | 0,92295 | 0,62528 | 0,29885 | 1,84708 | 0,92992 | 0,57468 | 0,09372 | 1,59832 | 0,73333 | 0,51333 | 0,14324 | 1,38990 | 4,835 | 53,72 |
| 38 | BSA | bird swarm algorithm | 0,94432 | 0,67941 | 0,26401 | 1,88774 | 0,91649 | 0,65619 | 0,12054 | 1,69322 | 0,80933 | 0,33547 | 0,10652 | 1,25132 | 4,832 | 53,69 |
| 39 | TSm | tabu search M | 0,87806 | 0,61040 | 0,28993 | 1,77839 | 0,98116 | 0,52165 | 0,08544 | 1,58825 | 0,82667 | 0,49547 | 0,13552 | 1,45766 | 4,824 | 53,60 |
| 40 | BSA | backtracking search algorithm | 0,87128 | 0,53190 | 0,28675 | 1,68993 | 0,92408 | 0,51602 | 0,09153 | 1,53163 | 0,96000 | 0,47253 | 0,13760 | 1,57013 | 4,792 | 53,24 |
| 41 | BEA | bacterial_evolutionary_algorithm | 0,92170 | 0,59615 | 0,29340 | 1,81125 | 0,96906 | 0,44500 | 0,08233 | 1,49639 | 0,90533 | 0,43173 | 0,13676 | 1,47382 | 4,781 | 53,13 |
| 42 | BWOm | beluga_whale_optimization_M | 0,78488 | 0,56872 | 0,29557 | 1,64917 | 0,91370 | 0,61760 | 0,12988 | 1,66118 | 0,81333 | 0,49946 | 0,15004 | 1,46283 | 4,773 | 53,04 |
| 43 | WOAm | whale optimization algorithm M | 0,93893 | 0,59477 | 0,26695 | 1,80065 | 0,98036 | 0,53873 | 0,07112 | 1,59021 | 0,78667 | 0,47600 | 0,11892 | 1,38159 | 4,772 | 53,02 |
| 44 | ACA | andean_condor_algorithm | 0,78444 | 0,53260 | 0,33108 | 1,64812 | 0,79071 | 0,44960 | 0,10685 | 1,34716 | 0,92266 | 0,67733 | 0,17613 | 1,77612 | 4,771 | 53,02 |
| 45 | CSO | competitive swarm optimizer | 0,85151 | 0,60786 | 0,29896 | 1,75833 | 0,84085 | 0,58491 | 0,11974 | 1,54550 | 0,80000 | 0,48560 | 0,14184 | 1,42744 | 4,731 | 52,57 |
| RW | random walk | 0,49970 | 0,32333 | 0,25791 | 1,08094 | 0,30754 | 0,11470 | 0,04400 | 0,46624 | 0,36133 | 0,17013 | 0,10244 | 0,63390 | 2,181 | 24,23 | |
Выводы
Наша реализация BCO(Bezier) — рабочий алгоритм: 62.65% на стандартном стенде. Важно, что это оценка не опубликованного BCO, а версии с изменённым кубическим оператором. Дополнительные проверки закрывают две конкретные ловушки: в размерности 10 результат не опирается на одинаковость двумерных блоков стенда, а общий балл не меняется при сдвиге области поиска. Авторскую реализацию не стоит переносить буквально, а заявленную силу в большой размерности наши тесты не подтверждают.
Анализ расписания показывает, что кривые Безье в BCO работают в полную силу только на коротком начальном этапе: уже к десятой доле бюджета параметр кривой прижимается к единице, и дальше кандидат почти совпадает с последней контрольной точкой. Эффективность определяют прежде всего формулы, по которым строятся контрольные точки, а не геометрия кривой.
Второй урок касается переноса алгоритмов из статей. В авторской реализации есть операторы, которые переносят значение одной координаты во все остальные и сдвигают агентов вдоль диагонали области. На стандартном стенде это видно глазами: пары координат лучшего решения выстраиваются вдоль линии x = y. Для оптимизации советника, где у каждого параметра свой смысл и свой диапазон, такое поведение бессмысленно, поэтому в нашей реализации эти формулы заменены покоординатными.
Для оптимизации торговых систем BCO хорошо подходит к задачам с числом параметров от единиц до нескольких десятков: здесь он надёжно находит глобальную область и уточняет её. Для задач с сотнями параметров лучше выбрать алгоритм из верхней части рейтинговой таблицы, устойчивый в высокой размерности.
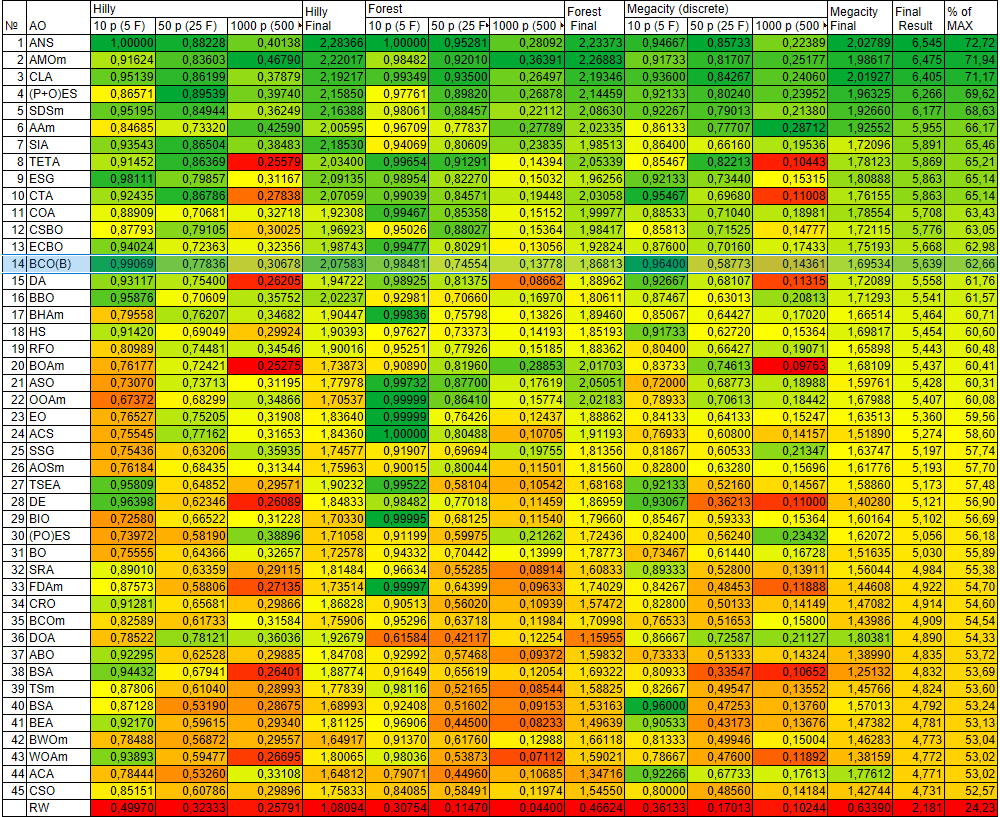
Рисунок 2. Цветовая градация алгоритмов по результатам соответствующих тестов.
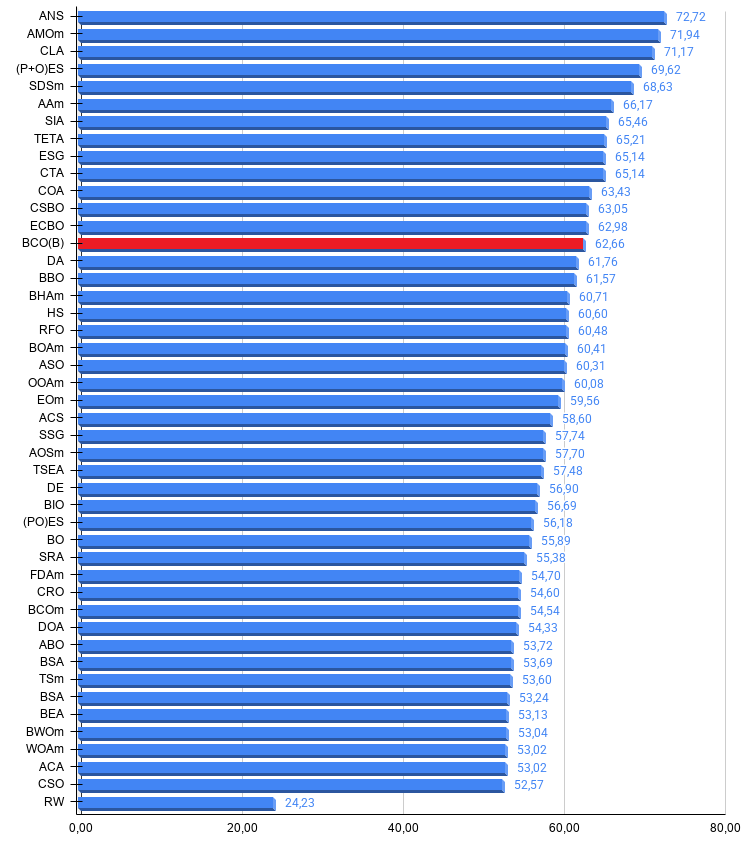
Рисунок 3. Гистограмма результатов тестирования алгоритмов (по шкале от 0 до 100: чем больше, тем лучше, где 100 — максимально возможный теоретический результат). В архиве приведён скрипт для расчёта рейтинговой таблицы
Плюсы и минусы алгоритма BCO(Bezier):
Плюсы- Единственный внешний параметр — размер популяции (помимо него алгоритму нужен бюджет итераций).
- Высокие результаты в малой и средней размерности, включая дискретную функцию Megacity.
- Плавный переход от разведки к уточнению без ручной настройки фаз.
- Простые и быстрые операторы, без сортировок и сложных структур данных.
- Нужен заранее известный бюджет итераций: от него зависят оба расписания.
- По расписанию α геометрия кривых Безье работает в полную силу лишь в начале оптимизации.
- Популяция не может быть меньше трёх агентов.
К статье прикреплён архив с актуальными версиями кода алгоритмов. Автор статьи не несёт ответственности за абсолютную точность в описании канонических алгоритмов, во многие из них внесены изменения для улучшения поисковых возможностей. Выводы и суждения, представленные в статьях, основываются на результатах проведённых экспериментов.
Программы, используемые в статье
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | #C_AO.mqh | Включаемый файл | Родительский класс популяционных алгоритмов оптимизации |
| 2 | #C_AO_enum.mqh | Включаемый файл | Перечисление популяционных алгоритмов оптимизации |
| 3 | TestFunctions.mqh | Включаемый файл | Библиотека тестовых функций |
| 4 | TestStandFunctions.mqh | Включаемый файл | Библиотека функций тестового стенда |
| 5 | TestStand3D.mqh | Включаемый файл | 3D-панель визуализации для тестового стенда |
| 6 | Utilities.mqh | Включаемый файл | Библиотека вспомогательных функций |
| 7 | CalculationTestResults.mqh | Включаемый файл | Скрипт для расчёта результатов в сравнительную таблицу |
| 8 | Test_AO_All.mq5 | Скрипт | Единый испытательный стенд для всех популяционных алгоритмов оптимизации |
| 9 | Test_AO_AntiCheat | Скрипт | Тест на читерство алгоритмов оптимизации |
| 10 | Simple use of population optimization algorithms.mq5 | Скрипт | Простой пример использования популяционных алгоритмов оптимизации без визуализации |
| 11 | Test_AO_BCO_Bezier.mq5 | Скрипт | Испытательный стенд для BCO_Bezier |
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Особенности написания Пользовательских Индикаторов
 За пределами GARCH (Часть IV): Реализация анализа разбиений в MQL5

 Рыночная микроструктура в MQL5 (Часть 3): Оценка параметра d модели ARFIMA методом GPH

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования