

Алгоритм оптимизации скопы — Osprey Optimization Algorithm(OOA)
 25
 0

Содержание
Введение
Трейдер, который самостоятельно оптимизирует параметры торговой системы, регулярно сталкивается с одной и той же ситуацией: в научных публикациях появляется новый алгоритм, он показывает первые места на бенчмарках. Возникает вопрос, можно ли этому верить и стоит ли тратить время на реализации в MQL5. У читателя нет ни стенда, ни времени проверять формулы, и как алгоритм поведёт себя на 15 параметрах советника с несимметричными диапазонами и ступенчатой целевой функцией заранее неизвестно.
После ознакомления с материалом читатель получит готовую реализацию алгоритма OOA и его модификации OOAm в рамках C_AO с измеренными результатами по каждой функции стенда. Их можно подставить в свой оптимизатор без переделки. Также станет понятно, почему канонический OOA на задачах типичной для трейдинга размерности, порядка 10–50 параметров, за исключением одной функции, практически превращается в случайный поиск. Будет показано, какие именно две формулы за это отвечают. Кроме того, будет предложен воспроизводимый способ проверки, позволяющий отделить в чужом алгоритме реально работающие механизмы от декоративных, прежде чем строить на нём собственные решения.
Скопа, или osprey (Pandion haliaetus), — крупная хищная птица, почти полностью специализирующаяся на ловле рыбы. Во время охоты она сначала обследует водоём с высоты, выбирая потенциальную добычу, а затем резко пикирует к цели и захватывает её когтями. Такое поведение естественным образом раскладывается на две стадии, хорошо знакомые в задачах глобальной оптимизации: исследование пространства поиска и последующее уточнение найденного решения. Именно эта аналогия легла в основу Osprey Optimization Algorithm.
Osprey Optimization Algorithm (OOA) взят не случайно: в 2026 году вышла работа Bouali & Alamri с улучшенной версией EOOA, заявляющая первое место на 11 из 12 функций CEC2022. Улучшение можно оценить только относительно базы, поэтому статья идёт от базы: описание и псевдокод канона, реализация, тестирование, разбор проблем, затем несколько модификаций, каждая измерена отдельно. Итог: от 30% до 60%, и честное обозначение точки, где OOAm перестаёт быть OOA.
Реализация алгоритма
Скопа — хищная птица, охотящаяся на рыбу: высматривает добычу с высоты, пикирует и уносит её на удобное место, чтобы съесть. Авторы OOA моделируют это двумя фазами, которые каждая особь популяции проходит на каждой итерации.
Фаза 1, разведка (атака на рыбу). Для i-й скопы рыбами считаются все особи с лучшим значением целевой функции плюс глобально лучшая особь:
FP_i = { x_k | F_k < F_i } ∪ { x_best } (4) Скопа случайно выбирает одну рыбу SF из этого множества и атакует её:
x_new_j = x_j + r_j · (SF_j − I_j · x_j), r_j ∈ [0,1], I_j ∈ {1, 2} (5)
Если новая позиция лучше — она принимается, иначе скопа остаётся на месте (6).
Фаза 2, эксплуатация (перенос рыбы). Поймав рыбу, скопа ищет удобное место поблизости. Моделируется случайным шагом, который затухает с номером итерации t:
x_new_j = x_j + (lb_j + r_j · (ub_j − lb_j)) / t (7) и снова принимает новую позицию только при улучшении (8).
Важная деталь, к которой мы вернёмся: множители r_j и I_j в формуле (5) записаны с индексом координаты j, покоординатные. В формуле (7) r напечатан без индексов, но в псевдокоде статьи и в определении после (8) он также покоординатный. Рыба выбирается из FP_i равновероятно. Авторы оценивают сложность как O(N·m·(1 + 2T)), но в этой оценке смешаны операции над координатами и стоимость вызова целевой функции. Практически важнее другое: за итерацию алгоритм делает 2N вызовов целевой функции — при дорогой функции (а бэктест советника именно такой) время определяется числом вызовов целевой функции. Собственные накладные расходы — O(N·m) на построение кандидатов и O(N²) на сбор множеств рыб за итерацию.
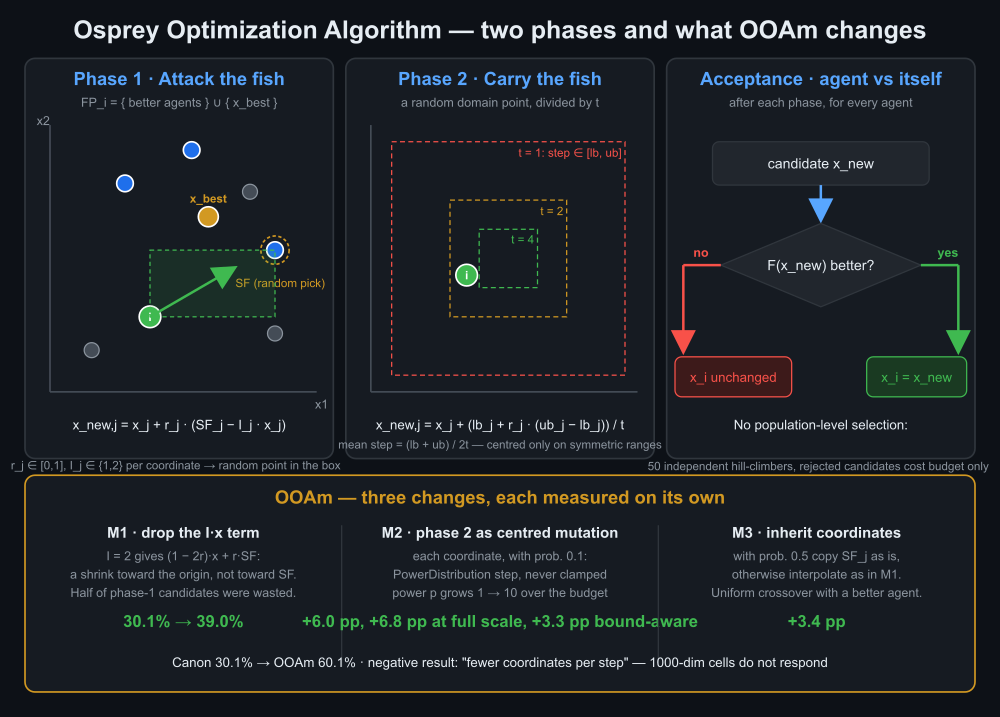
Рисунок 1. Две фазы OOA и правки OOAm
На иллюстрации слева — фаза 1: для скопы i (зелёная) множество рыб — это агенты с лучшим фитнесом (синие) плюс глобально лучший x_best (жёлтый); из них случайно выбирается одна, SF. Бокс между x_i и SF показывает, куда попадает новая позиция при I = 1; при I = 2 соответствующая координата уходит из бокса и сжимается к началу координат (разбор — в проблеме 2). В центре — фаза 2: шаг равен случайной точке домена, делённой на номер итерации. Пунктирные рамки показывают, как область возможного шага сжимается при t = 1, 2, 4, а формула среднего шага (lb + ub)/2t — почему на несимметричном диапазоне он не центрирован. Справа — правило приёмки: после каждой фазы кандидат сравнивается только с текущей позицией того же агента, отбора на уровне популяции нет, отвергнутый кандидат стоит одной оценки. Внизу — три правки OOAm с измеренным вкладом каждой: M1 убирает член I·x, из-за которого примерно половина координат каждого кандидата фазы 1 сжималась к началу координат; M2 заменяет фазу 2 центрированной мутацией части координат со степенным шагом, не выходящим за диапазон и затухающим по бюджету; M3 добавляет копирование координат рыбы как есть — единственное, что сдвинуло ячейки с 1000 координатами.
Псевдокод алгоритма OOA:
Вход: N, T, lb, ub, F(·)
Инициализация: x_i ~ U[lb, ub], F(x_i), x_best
для t = 1 .. T:
  для i = 1 .. N:
    // фаза 1 — разведка
    FP = { x_k : F_k < F_i } ∪ { x_best }
    SF = случайный элемент FP
    для j = 1 .. m:
      r_j ~ U[0,1];  I_j ~ {1,2}
      x_new_j = x_j + r_j·(SF_j − I_j·x_j)
    ограничить x_new в [lb, ub]
    если F(x_new) < F_i: x_i = x_new
    // фаза 2 — эксплуатация
    для j = 1 .. m:
      x_new_j = x_j + (lb_j + r_j·(ub_j − lb_j)) / t
    ограничить x_new в [lb, ub]
    если F(x_new) < F_i: x_i = x_new
  обновить x_best
Реализация канона в C_AO. Стенд оценивает всю популяцию батчем, поэтому одна итерация OOA раскладывается на две эпохи стенда: сначала разведка для всех агентов, затем эксплуатация для всех. У авторов внутри цикла по агентам используется схема Гаусса–Зейделя — агент i в фазе 2 уже видит свой результат фазы 1, а рыбы для него — уже обновлённые соседи; у нас — Якоби, все агенты фазы считаются по принятым позициям. По опыту предыдущих алгоритмов серии эта разница даёт единицы процентных пунктов на малом бюджете и исчезает на большом. Глобально лучшая позиция cB обновляется после каждой эпохи; поскольку фаза 2 её не использует, это эквивалентно канону, где x_best фиксируется в начале итерации. Стенд максимизирует, так что все сравнения обращены.
//+------------------------------------------------------------------+
//| OOA — Osprey Optimization Algorithm                              |
//| Dehghani M., Trojovsky P. (2023), Front. Mech. Eng. 8:1126450    |
//| Канон по статье: формулы (4)-(8), Algorithm 1.                   |
//| Итерация OOA = 2 эпохи стенда: фаза 0 — разведка (4)-(6),        |
//| фаза 1 — эксплуатация (7)-(8). В каждой фазе одна оценка ФФ на   |
//| агента и жадная приёмка «строго лучше».                          |
//+------------------------------------------------------------------+
class C_AO_OOA : public C_AO
  {
public:
                    ~C_AO_OOA() {}
                     C_AO_OOA()
     {
      ao_name = "OOA";
      ao_desc = "Osprey Optimization Algorithm";
      ao_link = "https://www.mql5.com/ru/users/joo";

      popSize = 50;   // размер популяции

      ArrayResize(params, 1);
      params [0].name = "popSize";
      params [0].val  = popSize;
     }

   void               SetParams()
     {
      popSize = (int)params [0].val;
      if(popSize < 1)
         popSize = 1;
      params [0].val = popSize;
     }

   bool               Init(const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0);

   void               Moving();
   void               Revision();

private:
   int                phase;      // 0 — разведка (атака рыбы); 1 — эксплуатация (перенос рыбы)
   int                t;          // номер итерации OOA, с 1
   int                idx [];     // буфер индексов агентов лучше текущего

   void               MakeExploration(int i);
   void               MakeExploitation(int i);
  };

//+------------------------------------------------------------------+
//|                              Init                                |
//+------------------------------------------------------------------+
bool C_AO_OOA::Init(const double &rangeMinP  [],
                    const double &rangeMaxP  [],
                    const double &rangeStepP [],
                    const int     epochsP = 0)
  {
   if(!StandardInit(rangeMinP, rangeMaxP, rangeStepP))
      return false;

   phase = 0;
   t     = 1;
   ArrayResize(idx, popSize);
   return true;
  }

//+------------------------------------------------------------------+
//|   MakeExploration — фаза 1 канона, (4)-(5).                      |
//|   Рыба равновероятно из {агенты лучше i} U {xbest}.              |
//|   x_new_j = x_j + r_j*(fish_j - I_j*x_j), r_j in [0,1],          |
//|   I_j in {1,2} — покоординатные.                                 |
//+------------------------------------------------------------------+
void C_AO_OOA::MakeExploration(int i)
  {
   int nBetter = 0;

   for(int k = 0; k < popSize; k++)
      if(a [k].fB > a [i].fB)
         idx [nBetter++] = k;

   int fish = -1;                                   // -1 -> cB (xbest)
   int k    = u.RNDminusOne(nBetter + 1);
   if(k < nBetter)
      fish = idx [k];

   double I, r, f, x;

   for(int c = 0; c < coords; c++)
     {
      I = (u.RNDprobab() < 0.5) ? 1.0 : 2.0;       // round(1+rand)
      r = u.RNDprobab();
      f = (fish < 0) ? cB [c] : a [fish].cB [c];

      x = a [i].cB [c] + r * (f - I * a [i].cB [c]);

      a [i].c [c] = u.SeInDiSp(x, rangeMin [c], rangeMax [c], rangeStep [c]);
     }
  }

//+------------------------------------------------------------------+
//|   MakeExploitation — фаза 2 канона, (7).                         |
//|   x_new_j = x_j + (lb_j + r_j*(ub_j - lb_j)) / t                 |
//+------------------------------------------------------------------+
void C_AO_OOA::MakeExploitation(int i)
  {
   double x;

   for(int c = 0; c < coords; c++)
     {
      x = a [i].cB [c] + (rangeMin [c] + u.RNDprobab() * (rangeMax [c] - rangeMin [c])) / (double)t;

      a [i].c [c] = u.SeInDiSp(x, rangeMin [c], rangeMax [c], rangeStep [c]);
     }
  }

//+------------------------------------------------------------------+
//|                            Moving                                |
//+------------------------------------------------------------------+
void C_AO_OOA::Moving()
  {
   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
         for(int c = 0; c < coords; c++)
            a [i].c [c] = u.SeInDiSp(u.RNDfromCI(rangeMin [c], rangeMax [c]),
                                     rangeMin [c], rangeMax [c], rangeStep [c]);
      return;
     }

   if(phase == 0)
     {
      for(int i = 0; i < popSize; i++)
         MakeExploration(i);
     }
   else
     {
      for(int i = 0; i < popSize; i++)
         MakeExploitation(i);
     }
  }

//+------------------------------------------------------------------+
//|                           Revision                               |
//+------------------------------------------------------------------+
void C_AO_OOA::Revision()
  {
   for(int i = 0; i < popSize; i++)
     {
      if(a [i].f > fB)
        {
         fB = a [i].f;
         ArrayCopy(cB, a [i].c, 0, 0, coords);
        }
     }

   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
        {
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
         a [i].fB = a [i].f;
        }
      phase    = 0;
      t        = 1;
      revision = true;
      return;
     }

   for(int i = 0; i < popSize; i++)
     {
      if(a [i].f > a [i].fB)
        {
         a [i].fB = a [i].f;
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
        }
     }

   if(phase == 0)
      phase = 1;
   else
     {
      phase = 0;
      t++;
     }
  }
//+------------------------------------------------------------------+
Условия для всех прогонов в статье одинаковые: 10 000 вызовов целевой функции, 10 повторов, три функции стенда — гладкая многоэкстремальная Hilly, гребнистая Forest и ступенчатая Megacity — по 5, 25 и 500 экземпляров, то есть 10, 50 и 1000 координат. Полезно помнить, сколько на этом бюджете набирает случайный поиск: 24% композита, а по ячейкам — примерно 0,49/0,33/0,26 на Hilly, 0,31/0,12/0,04 на Forest и 0,33/0,17/0,10 на Megacity. Если алгоритм в какой-то ячейке держится в пределах разброса от этих чисел, то на данном стенде и бюджете он не даёт измеримого выигрыша над разбрасыванием точек — это не значит, что поиск внутри алгоритма не устроен, но значит, что его устройство здесь не окупается.
О разбросе: каждое число в распечатках — среднее по 10 повторам. Повторные прогоны одних и тех же конфигураций расходились по композиту на 0,2–0,5 процентного пункта (канон: 30,09 / 30,04 / 30,48%; промежуточная версия OOAm: 45,03 / 44,87%), отдельные ячейки шумят сильнее — Megacity с 50 координатами гуляла на ±0,04. Поэтому разницы меньше процентного пункта по композиту в статье не интерпретируются, а выводы строятся на сдвигах, которые заметно превышают этот разброс. Доверительных интервалов и тестов значимости по отдельным ячейкам я не считал — это ограничение работы.
OOA|Osprey Optimization Algorithm|50.0|
=============================
5 Hilly's; Func runs: 10000; result: 0.7524472449768058
25 Hilly's; Func runs: 10000; result: 0.4076037142863795
500 Hilly's; Func runs: 10000; result: 0.26855759321428957
=============================
5 Forest's; Func runs: 10000; result: 0.32551678200872486
25 Forest's; Func runs: 10000; result: 0.15456661677348416
500 Forest's; Func runs: 10000; result: 0.05797317689104511
=============================
5 Megacity's; Func runs: 10000; result: 0.44266666666666665
25 Megacity's; Func runs: 10000; result: 0.19120000000000004
500 Megacity's; Func runs: 10000; result: 0.10732000000000093
=============================
All score: 2.70785 (30.09%)
Размер популяции на результат почти не влияет: 10, 25, 50, 100 агентов дают от 28 до 31%. Дефолт 50 остаётся. Композит 30% сам по себе не говорит ничего. Говорит структура. Посмотрите на Forest: 0,33 / 0,15 / 0,06 против 0,31 / 0,12 / 0,04 у случайного поиска. На гребне алгоритм держится на уровне случайного поиска. На Megacity картина немногим лучше, а на 1000 координатах все три функции — 0,27 / 0,06 / 0,11 — в пределах разброса от случайного поиска. Весь запас над случайным поиском собран в двух ячейках — Hilly с 10 и 50 координатами. То есть OOA умеет одно: скатываться по гладкому склону в малой размерности. Для оптимизации торговой системы это слишком мало. Почему так — стало ясно после трёх разборов.
Проблема 1: код EOOA — не тот OOA. Работа 2026 года заявляет, что фазы OOA сохранены без изменений и к ним лишь добавлена третья. Я начал реализацию с авторского EOOA.m как с самого свежего источника — и первая же версия OOA на стенде повела себя странно: Megacity с 1000 координатами давала 0,30, втрое выше случайного поиска и выше любого другого алгоритма серии в этой ячейке, а Hilly с 10 координатами — всего 0,57. Когда я открыл первоисточник, причина нашлась: код реализует формулы не так, как они написаны.
| Статья OOA (2023) | Код EOOA.m (2026) | |
|---|---|---|
| r в (5) и (7) | покоординатный | один скаляр на всего агента |
| I в (5) | покоординатный | один скаляр на всего агента |
| выбор рыбы из (4) | равновероятно из {лучшие} ∪ {x_best} | нет лучших → x_best; иначе 50/50 x_best / случайный лучший |
Разница принципиальная. Покоординатный r двигает агента в случайную точку бокса между ним и рыбой; скалярный — в случайную точку отрезка между ними. Скалярный I = 2 масштабирует весь вектор целиком, как единое целое. Моя гипотеза — аномалию на Megacity давало именно это, но отдельно по r, по I и по выбору рыбы я версии не разводил, так что причина здесь не доказана. Плюс выбор рыбы в коде сильно смещён к глобально лучшему, чего в статье нет. Обе версии я прогнал на стенде: композит близкий, 30% против 31%, но ячейки распределены совершенно по-разному. Это два разных алгоритма под одним названием. Все результаты канона ниже, как и листинг выше, относятся к версии по первоисточнику: r и I покоординатные, рыба выбирается из множества лучших плюс x_best (об одной тонкости этого выбора — в разборе кода OOAm).
Проблема 2: проход сквозь рыбу сжигает половину разведки. В формуле (5) есть множитель I ∈ {1, 2}. При I = 1 всё понятно — агент двигается к рыбе. Что происходит при I = 2? Раскроем скобки:
x_new_j = (1 − 2r_j)·x_j + r_j·SF_j
При r = 0,5 первое слагаемое обнуляется, и координата становится половиной координаты рыбы — не за рыбой, как подсказывает метафора атаки с проходом сквозь цель, а на полпути от начала координат к рыбе. Такая координата не привязана ни к текущей позиции агента, ни к рыбе; это, по существу, случайное значение, притянутое к нулю. В каноне I выбирается для каждой координаты отдельно, поэтому I = 2 выпадает примерно на половине координат каждого кандидата. На десяти координатах это пять испорченных координат из десяти, на пятидесяти — двадцать пять, и практически ни один кандидат фазы 1 не остаётся чистым движением к рыбе. Жадная приёмка такие кандидаты в основном отбраковывает, и фаза 1 работает намного хуже, чем могла бы.
Проверка заняла одну строку: I = 1 всегда. Результат — с 30 до 39% при том же бюджете. Megacity с 10 координатами поднялась с 0,43 до 0,73, Forest с 10 координатами — с 0,32 до 0,46. Девять процентных пунктов от того, что кандидаты фазы 1 перестали портиться.
Проблема 3: фаза 2 не ищет локально. По замыслу фаза 2 — локальный поиск: маленькие шаги возле найденной позиции. Формула (7) делает другое. Она берёт случайную точку домена и делит её на номер итерации: на первой итерации это прыжок на случайное место, дальше шаг убывает как 1/t, причём по всем координатам разом и без всякой связи с тем, где мы находимся на ландшафте. Есть и второй дефект, который на симметричном стенде не виден, а на реальных параметрах советника проявится: среднее шага равно (lb + ub) / 2t, и оно равно нулю только когда lb = −ub. Для параметра: период с диапазоном от 5 до 200 фаза 2 каждую итерацию систематически тянет предложения к верхней границе. Отсюда и ноль на Forest: гребень требует мелкой доводки с адаптивным масштабом, а её в алгоритме просто нет.
Плюсы и минусы канонического OOA
Плюсы:
- Один параметр — размер популяции, и тот почти ни на что не влияет: настраивать нечего, сломать нельзя.
- Простая и дешёвая структура — две оценки на агента за итерацию, никаких сортировок и вспомогательных массивов.
- На гладких многоэкстремальных функциях малой размерности скатывается по склону заметно лучше случайного поиска.
Минусы:
- На гребнистых и ступенчатых ландшафтах и на большой размерности результат не выходит за пределы разброса случайного поиска.
- Формула атаки при I = 2 сжимает примерно половину координат каждого кандидата к началу координат, и большинство кандидатов фазы 1 отбраковывается.
- Фаза переноса не является локальным поиском и на несимметричных диапазонах даёт систематический снос предложений к одной границе.
- Нет отбора на уровне популяции: слабый агент живёт до конца прогона и тратит свою долю бюджета.
Модификации. Дальше — правки. Правило одно: каждая вводится отдельным параметром, у которого есть нулевое положение, возвращающее прежнее поведение, и каждая измеряется на той же базе, что и предыдущая. Только так можно потом сказать, что именно сработало. Все прогоны — при популяции 50.
M1. Убираем член I·x. Обосновано в проблеме 2:
x_new_j = x_j + r_j·(SF_j − x_j)
без масштабирования. от 30 до 39%.
M2. Фаза 2 как центрированное возмущение. Вместо формулы (7) — каждая координата с вероятностью pertProb получает случайное возмущение, центрированное на нуле, масштаб которого убывает по мере расходования бюджета. Хотя бы одна координата возмущается всегда. Снос на несимметричных диапазонах исчезает по построению.
Первая версия использовала гауссов шаг с масштабом, линейно убывающим от 10% ширины диапазона до 0,1%. Сравнение с M1 — единственное различие в фазе 2 — дало 39 → 45%. Forest с 10 координатами: 0,46 → 0,80; Forest с 50: 0,18 → 0,41. Гребень наконец начал отрабатываться.
Здесь случилась неудача, и поучительная. Ячейки с 1000 координатами оставались на нуле, и первая гипотеза была очевидной: 10% возмущённых координат из тысячи — это сто координат за шаг, кандидат заведомо хуже, надо возмущать одну-две. Проверил — одна-две координаты не изменили эти ячейки вообще, а всё остальное ухудшили. Причина оказалась в арифметике бюджета: за прогон каждый агент получает около ста шагов фазы 2, и сколько координат за шаг ни возмущай, тысячу координат такой бюджет покрыть не может. Локальный поиск в большой размерности не спасёт. Единственный источник прогресса там — готовые координаты, уже найденные другими агентами популяции.
M3. Наследуем координаты у рыбы. Так появилась третья правка. В фазе 1 координата с вероятностью copyProb берётся у рыбы как есть, а не интерполируется. По сути это равномерный кроссовер с более сильным агентом поверх движения к нему. Идея простая: если рыба в среднем лучше, то и её координаты в среднем лучше, и скопировать пару-тройку готовых — выгоднее, чем искать самому.
| copyProb | 0 | 0,07 | 0,3 | 0,5 | 0,7 | 0,9 |
|---|---|---|---|---|---|---|
| композит | 45,0 | 46,3 | 48,3 | 48,4 | 48,5 | 43,8 |
Широкое плато от 0,3 до 0,7 и обрыв на 0,9: агент становится копией рыбы, разнообразие популяции схлопывается. Выбрано 0,5. Ячейки с 1000 координатами впервые сдвинулись с места — немного, на 0,03–0,04, но синхронно во всех трёх функциях.
M2, продолжение: масштаб шага. Оставалось проверить масштаб возмущения в фазе 2, и здесь ждал самый большой прирост из всех.
| начальный масштаб, доля диапазона | 0,03 | 0,1 | 0,3 | 1,0 |
|---|---|---|---|---|
| композит | 43,4 | 48,3 | 53,0 | 55,3 |
Монотонный рост до самого края: при масштабе 1,0 координата может прыгнуть в любую точку домена, и это работает лучше всего. Здесь стоит остановиться и признать: при таком масштабе фаза 2 уже не локальный поиск. Это мутация — 10% координат прыгают куда угодно, с затуханием к концу прогона.
И у гауссова шага такого масштаба есть очевидный дефект: большинство кандидатов вылетает за диапазон, ограничитель прижимает их к границе, и оценка тратится на точку, которую никто не выбирал. В C_AO_Utilities для этого давно есть PowerDistribution(x, min, max, p) : она берёт случайное число из [−1, 1], возводит модуль в степень p и масштабирует результат в расстояние от x до соответствующей границы. Шаг никогда не выходит из диапазона, а степень p задаёт его масштаб: p = 1 — равномерно до границы, p = 10 — медиана шага около 0,1% расстояния до неё. Это ровно те два края, которые мы нашли для гауссова расписания, так что p растёт линейно от 1 до 10 по доле бюджета. Побочный эффект — затухание становится геометрическим, а не линейным, и у распределения тяжёлый хвост: редкие большие прыжки сохраняются до конца.
Замена дала 55 → 58,5%. Hilly с 50 координатами: 0,64 → 0,71; Forest с 50: 0,61 → 0,68; Forest с 10 — ровно 1,00. Два эффекта здесь сложились — отсутствие потерь на границе и геометрическое затухание, — и одним прогоном их не разделить; важен итог.
Параметры: что открыто, что зашито и почему. У канонического OOA один параметр — размер популяции. Исследовательская версия OOAm по ходу дела обросла семью. Это удобно, пока вклад каждой правки измеряется по отдельности, и неприемлемо для готового алгоритма: каждая лишняя ручка — способ настроить его неправильно. В финальной версии оставлено три.
popSize — как у канона. pertProb — доля возмущаемых координат в фазе 2; оптимум 0,1 плоский, но параметр по смыслу связан с размерностью задачи, и за пределами стенда он может понадобиться. copyProb — доля копируемых координат в фазе 1; плато широкое, но именно этот параметр определяет баланс между кроссовером и интерполяцией, и на ландшафтах, не похожих на стендовые, его стоит иметь под рукой.
Убран переключатель каноническая фаза 2 / новая (он нужен был только чтобы измерить вклад новой фазы; канон живёт в отдельном классе, и тащить в OOAm заведомо худший режим незачем). Зашито: расписание степени PowerDistribution, константы P_MIN = 1 и P_MAX = 10 . Это найденные значения, а не настройки: оба края оси проверены, и внутри стенда двигать их некуда. Если кому-то понадобится другое расписание — это правка двух чисел в конструкторе.
И последнее, что нужно сказать прямо. После M3 и с шагом масштаба домена фаза 1 — это наполовину кроссовер с более сильным агентом, фаза 2 — мутация. От скопы осталась схема выбора партнёра — случайный из лучших плюс x_best — и жадная приёмка агент против самого себя.
Переходим к самой реализации OOAm. Класс устроен так же, как канонический: два метода движения — по одному на фазу, Moving их чередует, Revision принимает результаты. Разберём по частям.
Три открытых параметра — popSize, pertProb, copyProb — и два зашитых: P_MIN и P_MAX, края расписания степени для фазы 2. Они объявлены константами и задаются в списке инициализации конструктора, потому что это найденные значения, а не настройки. SetParams только читает массив params и ограничивает вероятности отрезком [0, 1]; ограничение снизу на популяцию — единица, третьей фазы с партнёрами здесь нет.
Из приватных полей: phase чередует фазы, epochs и epochNow нужны только расписанию степени, idx — буфер под индексы агентов лучше текущего, чтобы не выделять память в каждом вызове.
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
class C_AO_OOAm : public C_AO
  {
public:
                    ~C_AO_OOAm() {}
                     C_AO_OOAm() : P_MIN(1.0), P_MAX(10.0)
     {
      ao_name = "OOAm";
      ao_desc = "Osprey Optimization Algorithm M";
      ao_link = "https://www.mql5.com/ru/articles/24779";

      popSize  = 50;    // размер популяции
      pertProb = 0.1;   // фаза 1: вероятность возмущения координаты
      copyProb = 0.5;   // фаза 0: вероятность взять координату рыбы как есть

      ArrayResize(params, 3);
      params [0].name = "popSize";
      params [0].val  = popSize;
      params [1].name = "pertProb";
      params [1].val  = pertProb;
      params [2].name = "copyProb";
      params [2].val  = copyProb;
     }

   void               SetParams()
     {
      popSize  = (int)params [0].val;
      pertProb =      params [1].val;
      copyProb =      params [2].val;

      if(popSize < 1)
         popSize = 1;

      if(pertProb < 0.0)
         pertProb = 0.0;
      if(pertProb > 1.0)
         pertProb = 1.0;

      if(copyProb < 0.0)
         copyProb = 0.0;
      if(copyProb > 1.0)
         copyProb = 1.0;

      params [0].val = popSize;
      params [1].val = pertProb;
      params [2].val = copyProb;
     }

   bool               Init(const double &rangeMinP  [],
                           const double &rangeMaxP  [],
                           const double &rangeStepP [],
                           const int     epochsP = 0);

   void               Moving();
   void               Revision();

   //--- видимые параметры
   double             pertProb;
   double             copyProb;

private:
   //--- расписание степени PowerDistribution (найдено, зашито)
   const double       P_MIN;       // старт: равномерно до границы
   const double       P_MAX;       // финиш: медиана шага 0.5^P_MAX от расстояния до границы

   int                phase;       // 0 — разведка; 1 — эксплуатация
   int                epochs;      // бюджет стенда в эпохах
   int                epochNow;    // выполненных эпох (расписание p)
   int                idx [];      // буфер индексов агентов лучше текущего

   void               MakeExploration(int i);
   void               MakeExploitation(int i);
  };
Init. Ничего своего — стандартная инициализация C_AO плюс обнуление счётчиков. Единственное, что стоит отметить: epochsP здесь используется по назначению. Расписание фазы 2 привязано к доле израсходованного бюджета, а не к номеру итерации, поэтому алгоритму нужно знать, сколько эпох ему отведено.
//+------------------------------------------------------------------+
//|                              Init                                |
//+------------------------------------------------------------------+
bool C_AO_OOAm::Init(const double &rangeMinP  [],
                     const double &rangeMaxP  [],
                     const double &rangeStepP [],
                     const int     epochsP = 0)
  {
   if(!StandardInit(rangeMinP, rangeMaxP, rangeStepP))
      return false;

   phase    = 0;
   epochs   = (epochsP > 0) ? epochsP : 1;
   epochNow = 0;

   ArrayResize(idx, popSize);

   return true;
}
MakeExploration — фаза 1. Здесь сосредоточены две правки из трёх. Сначала собираем множество рыб: все агенты с лучшим фитнесом, чем у текущего. Выбор одним RNDminusOne(nBetter + 1) : значения от 0 до nBetter − 1 — индекс в буфере, значение nBetter — глобально лучший cB . Здесь есть тонкость, которую нужно назвать прямо. Глобально лучшая позиция cB всегда совпадает с принятой позицией самого сильного агента популяции, а он для всех остальных уже входит в число лучших. Поэтому x_best в этой схеме представлен дважды — как элемент буфера и как отдельный вариант — и выбирается с вероятностью 2/(n + 1) вместо 1/n, где n — число лучших агентов. Математическое объединение множеств в формуле (4) такого дубля не даёт. Та же схема стоит и в листинге канона, так что сравнения канона и OOAm между собой корректны, но строгое соответствие формуле (4) требует выбора равновероятно из буфера лучших, а x_best — только когда буфер пуст. Смещение небольшое при большой популяции и заметное при малой: при популяции 10 у агента в середине рейтинга x_best выпадает примерно в 40% случаев вместо 20%.
Дальше цикл по координатам. Каждая с вероятностью copyProb копируется у рыбы как есть — это M3, наследование готовых координат. Иначе — интерполяция x + r·(fish − x) с покоординатным r, и это M1: от формулы (5) остался только случай I = 1, масштабирующий член выброшен. SeInDiSp тут нужен только под шаг сетки — интерполяция между двумя точками домена из домена выйти не может.
//+------------------------------------------------------------------+
//|   MakeExploration — фаза 0 (M1 + M4).                            |
//|   Рыба равновероятно из {агенты лучше i} U {xbest}.              |
//|   Координата: с вероятностью copyProb — копия координаты рыбы,   |
//|   иначе x_j + r_j*(fish_j - x_j).                                |
//+------------------------------------------------------------------+
void C_AO_OOAm::MakeExploration(int i)
  {
   int nBetter = 0;

   for(int k = 0; k < popSize; k++)
      if(a [k].fB > a [i].fB)
         idx [nBetter++] = k;

   int fish = u.RNDminusOne(nBetter + 1);   // == nBetter -> xbest
   double f, x;

   for(int c = 0; c < coords; c++)
     {
      f = (fish == nBetter) ? cB [c] : a [idx [fish]].cB [c];

      if(u.RNDprobab() < copyProb)
         x = f;
      else
         x = a [i].cB [c] + u.RNDprobab() * (f - a [i].cB [c]);

      a [i].c [c] = u.SeInDiSp(x, rangeMin [c], rangeMax [c], rangeStep [c]);
     }
  }
MakeExploitation — фаза 2. Это M2 целиком. Степень p считается один раз на вызов из доли пройденных эпох. Затем каждая координата с вероятностью pertProb получает шаг PowerDistribution от своего текущего значения — функция сама масштабирует шаг в расстояние до ближайшей границы, так что за диапазон он не выходит; SeInDiSp опять только под сетку. Остальные координаты копируются без изменений.
Последний блок — страховка: если ни одна координата не выпала (на 10 координатах при pertProb 0,1 это случается в трети случаев), возмущается одна случайная. Без этого кандидат совпал бы с текущей позицией, и оценка ушла бы впустую.
//+------------------------------------------------------------------+
//|   MakeExploitation — фаза 1 (M3).                                |
//|   Каждая координата с вероятностью pertProb получает шаг         |
//|   PowerDistribution со степенью p, растущей от P_MIN к P_MAX по  |
//|   доле бюджета; хотя бы одна координата возмущается всегда.      |
//+------------------------------------------------------------------+
void C_AO_OOAm::MakeExploitation(int i)
  {
   double frac = (double)epochNow / (double)epochs;
   if(frac > 1.0)
      frac = 1.0;

   double p     = P_MIN + (P_MAX - P_MIN) * frac;
   int    cLast = -1;

   for(int c = 0; c < coords; c++)
     {
      if(u.RNDprobab() < pertProb)
        {
         a [i].c [c] = u.SeInDiSp(u.PowerDistribution(a [i].cB [c], rangeMin [c], rangeMax [c], p),
                                  rangeMin [c], rangeMax [c], rangeStep [c]);
         cLast = c;
        }
      else
         a [i].c [c] = a [i].cB [c];
     }

   if(cLast < 0)
     {
      int c = u.RNDminusOne(coords);
      a [i].c [c] = u.SeInDiSp(u.PowerDistribution(a [i].cB [c], rangeMin [c], rangeMax [c], p),
                               rangeMin [c], rangeMax [c], rangeStep [c]);
     }
  }
Moving. Первый вызов — стартовая популяция. Дальше по значению phase вызывается либо разведка для всех агентов, либо эксплуатация для всех. Отличие от канона — только в том, что вызывается внутри.
//+------------------------------------------------------------------+
//|                            Moving                                |
//+------------------------------------------------------------------+
void C_AO_OOAm::Moving()
  {
//--- первый прогон: стартовая популяция
   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
         for(int c = 0; c < coords; c++)
            a [i].c [c] = u.SeInDiSp(u.RNDfromCI(rangeMin [c], rangeMax [c]),
                                     rangeMin [c], rangeMax [c], rangeStep [c]);
      return;
     }

   if(phase == 0)
     {
      for(int i = 0; i < popSize; i++)
         MakeExploration(i);
     }
   else
     {
      for(int i = 0; i < popSize; i++)
         MakeExploitation(i);
     }
  }
Revision. Жадная приёмка строго лучше — как в формулах (6) и (8) первоисточника. После первого прохода стартовая популяция становится принятой. Счётчик эпох увеличивается каждый вызов, включая первый, — это сделано намеренно: инициализация тоже тратит бюджет. В конце — переключение фазы; счётчик итераций t из канона не нужен, потому что от него зависела только старая формула (7).
//+------------------------------------------------------------------+
//|                           Revision                               |
//+------------------------------------------------------------------+
void C_AO_OOAm::Revision()
  {
//--- глобальный лучший
   for(int i = 0; i < popSize; i++)
     {
      if(a [i].f > fB)
        {
         fB = a [i].f;
         ArrayCopy(cB, a [i].c, 0, 0, coords);
        }
     }

   epochNow++;

//--- первый проход: стартовая популяция становится принятой
   if(!revision)
     {
      for(int i = 0; i < popSize; i++)
        {
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
         a [i].fB = a [i].f;
        }

      phase    = 0;
      revision = true;
      return;
     }

//--- жадная приёмка (строго лучше)
   for(int i = 0; i < popSize; i++)
     {
      if(a [i].f > a [i].fB)
        {
         a [i].fB = a [i].f;
         ArrayCopy(a [i].cB, a [i].c, 0, 0, coords);
        }
     }

   phase = 1 - phase;
  }
Результаты тестов
OOAm|Osprey Optimization Algorithm M|10.0|0.1|0.4|
=============================
5 Hilly's; Func runs: 10000; result: 0.6737218136981569
25 Hilly's; Func runs: 10000; result: 0.682999182089673
500 Hilly's; Func runs: 10000; result: 0.348669696566686
=============================
5 Forest's; Func runs: 10000; result: 0.9999997445998876
25 Forest's; Func runs: 10000; result: 0.8641036272986075
500 Forest's; Func runs: 10000; result: 0.15774611224698892
=============================
5 Megacity's; Func runs: 10000; result: 0.7893333333333333
25 Megacity's; Func runs: 10000; result: 0.7061333333333335
500 Megacity's; Func runs: 10000; result: 0.1844266666666669
=============================
All score: 5.40713 (60.08%)
Малая популяция на том же бюджете — это пятьсот итераций вместо ста, и расписание фазы 2 растягивается впятеро: алгоритм получает много мелких шагов там, где они нужны. Forest с 50 координатами поднялась с 0,68 до 0,86, Megacity с 50 — с 0,61 до 0,71, все три ячейки с 1000 координатами дали лучшие значения за всю работу. Цена — Hilly с 10 координатами: 0,84 → 0,67, десяти агентам не хватает, чтобы удерживать несколько холмов одновременно. Два параметра менялись вместе, и разложить прирост между ними по одному прогону нельзя; для таблицы серии взята эта конфигурация.

OOAm на тестовой функции Hilly

OOAm на тестовой функции Forest

OOAm на тестовой функции Megacity

OOAm на тестовой функции Ackley

OOAm на тестовой функции Skin
По итогам тестирования алгоритма OOAm занимает 21-е место в рейтинговой таблице.
cc | AO | Description | Hilly | Hilly Final | Forest | Forest Final | Megacity (discrete) | Megacity Final | Final Result | % of MAX | ||||||
| 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | 10 p (5 F) | 50 p (25 F) | 1000 p (500 F) | ||||||||
| 1 | ANS | across neighbourhood search | 1,00000 | 0,88228 | 0,40138 | 2,28366 | 1,00000 | 0,95281 | 0,28092 | 2,23373 | 0,94667 | 0,85733 | 0,22389 | 2,02789 | 6,545 | 72,72 |
| 2 | AMOm | animal migration optimization M | 0,91624 | 0,83603 | 0,46790 | 2,22017 | 0,98482 | 0,92010 | 0,36391 | 2,26883 | 0,91733 | 0,81707 | 0,25177 | 1,98617 | 6,475 | 71,94 |
| 3 | CLA | code lock algorithm (joo) | 0,95139 | 0,86199 | 0,37879 | 2,19217 | 0,99349 | 0,93500 | 0,26497 | 2,19346 | 0,93600 | 0,84267 | 0,24060 | 2,01927 | 6,405 | 71,17 |
| 4 | (P+O)ES | (P+O) evolution strategies | 0,86571 | 0,89539 | 0,39740 | 2,15850 | 0,97761 | 0,89820 | 0,26878 | 2,14459 | 0,92133 | 0,80240 | 0,23952 | 1,96325 | 6,266 | 69,62 |
| 5 | SDSm | stochastic diffusion search M | 0,95195 | 0,84944 | 0,36249 | 2,16388 | 0,98061 | 0,88457 | 0,22112 | 2,08630 | 0,92267 | 0,79013 | 0,21380 | 1,92660 | 6,177 | 68,63 |
| 6 | AAm | archery algorithm M | 0,84685 | 0,73320 | 0,42590 | 2,00595 | 0,96709 | 0,77837 | 0,27789 | 2,02335 | 0,86133 | 0,77707 | 0,28712 | 1,92552 | 5,955 | 66,17 |
| 7 | SIA | simulated isotropic annealing (joo) | 0,93543 | 0,86504 | 0,38483 | 2,18530 | 0,94069 | 0,80609 | 0,23835 | 1,98513 | 0,86400 | 0,66160 | 0,19536 | 1,72096 | 5,891 | 65,46 |
| 8 | TETA | time evolution travel algorithm (joo) | 0,91452 | 0,86369 | 0,25579 | 2,03400 | 0,99654 | 0,91291 | 0,14394 | 2,05339 | 0,85467 | 0,82213 | 0,10443 | 1,78123 | 5,869 | 65,21 |
| 9 | ESG | evolution of social groups (joo) | 0,98111 | 0,79857 | 0,31167 | 2,09135 | 0,98954 | 0,82270 | 0,15032 | 1,96256 | 0,92133 | 0,73440 | 0,15315 | 1,80888 | 5,863 | 65,14 |
| 10 | CTA | comet tail algorithm (joo) | 0,92435 | 0,86786 | 0,27838 | 2,07059 | 0,99039 | 0,84571 | 0,19448 | 2,03058 | 0,95467 | 0,69680 | 0,11008 | 1,76155 | 5,863 | 65,14 |
| 11 | COA | coyote_optimization_algorithm | 0,88909 | 0,70681 | 0,32718 | 1,92308 | 0,99467 | 0,85358 | 0,15152 | 1,99977 | 0,88533 | 0,71040 | 0,18981 | 1,78554 | 5,708 | 63,43 |
| 12 | CSBO | circulatory_system_based_optimization | 0,87793 | 0,79105 | 0,30025 | 1,96923 | 0,95026 | 0,88027 | 0,15364 | 1,98417 | 0,85813 | 0,71525 | 0,14777 | 1,72115 | 5,776 | 63,05 |
| 13 | ECBO | enhanced colliding bodies optimization | 0,94024 | 0,72363 | 0,32356 | 1,98743 | 0,99477 | 0,80291 | 0,13056 | 1,92824 | 0,87600 | 0,70160 | 0,17433 | 1,75193 | 5,668 | 62,98 |
| 14 | DA | dialectical algorithm | 0,93117 | 0,75400 | 0,26205 | 1,94722 | 0,98925 | 0,81375 | 0,08662 | 1,88962 | 0,92667 | 0,68107 | 0,11315 | 1,72089 | 5,558 | 61,76 |
| 15 | BBO | biogeography based optimization | 0,95876 | 0,70609 | 0,35752 | 2,02237 | 0,92981 | 0,70660 | 0,16970 | 1,80611 | 0,87467 | 0,63013 | 0,20813 | 1,71293 | 5,541 | 61,57 |
| 16 | BHAm | black hole algorithm M | 0,79558 | 0,76207 | 0,34682 | 1,90447 | 0,99836 | 0,75798 | 0,13826 | 1,89460 | 0,85067 | 0,64427 | 0,17020 | 1,66514 | 5,464 | 60,71 |
| 17 | HS | harmony search | 0,91420 | 0,69049 | 0,29924 | 1,90393 | 0,97627 | 0,73373 | 0,14193 | 1,85193 | 0,91733 | 0,62720 | 0,15364 | 1,69817 | 5,454 | 60,60 |
| 18 | RFO | royal flush optimization (joo) | 0,80989 | 0,74481 | 0,34546 | 1,90016 | 0,95251 | 0,77926 | 0,15185 | 1,88362 | 0,80400 | 0,66427 | 0,19071 | 1,65898 | 5,443 | 60,48 |
| 19 | BOAm | billiards optimization algorithm M | 0,76177 | 0,72421 | 0,25275 | 1,73873 | 0,90890 | 0,81960 | 0,28853 | 2,01703 | 0,83733 | 0,74613 | 0,09763 | 1,68109 | 5,437 | 60,41 |
| 20 | ASO | anarchy society optimization | 0,73070 | 0,73713 | 0,31195 | 1,77978 | 0,99732 | 0,87700 | 0,17619 | 2,05051 | 0,72000 | 0,68773 | 0,18988 | 1,59761 | 5,428 | 60,31 |
| 21 | OOAm | osprey_optimization_algorithm | 0,67372 | 0,68299 | 0,34866 | 1,70537 | 0,99999 | 0,86410 | 0,15774 | 2,02183 | 0,78933 | 0,70613 | 0,18442 | 1,67988 | 5,407 | 60,08 |
| 22 | EOm | extremal optimization_M | 0,76527 | 0,75205 | 0,31908 | 1,83640 | 0,99999 | 0,76426 | 0,12437 | 1,88862 | 0,84133 | 0,64133 | 0,15247 | 1,63513 | 5,360 | 59,56 |
| 23 | ACS | artificial cooperative search | 0,75545 | 0,77162 | 0,31653 | 1,84360 | 1,00000 | 0,80488 | 0,10705 | 1,91193 | 0,76933 | 0,60800 | 0,14157 | 1,51890 | 5,274 | 58,60 |
| 24 | SSG | saplings sowing and growing | 0,75436 | 0,63206 | 0,35935 | 1,74577 | 0,91907 | 0,69694 | 0,19755 | 1,81356 | 0,81867 | 0,60533 | 0,21347 | 1,63747 | 5,197 | 57,74 |
| 25 | AOSm | atomic orbital search M | 0,76184 | 0,68435 | 0,31344 | 1,75963 | 0,90015 | 0,80044 | 0,11501 | 1,81560 | 0,82800 | 0,63280 | 0,15696 | 1,61776 | 5,193 | 57,70 |
| 26 | TSEA | turtle shell evolution algorithm (joo) | 0,95809 | 0,64852 | 0,29571 | 1,90232 | 0,99522 | 0,58104 | 0,10542 | 1,68168 | 0,92133 | 0,52160 | 0,14567 | 1,58860 | 5,173 | 57,48 |
| 27 | DE | flow_direction_algorithm | 0,96398 | 0,62346 | 0,26089 | 1,84833 | 0,98482 | 0,77018 | 0,11459 | 1,86959 | 0,93067 | 0,36213 | 0,11000 | 1,40280 | 5,121 | 56,90 |
| 28 | BIO | blood inheritance optimization (joo) | 0,72580 | 0,66522 | 0,31228 | 1,70330 | 0,99995 | 0,68125 | 0,11540 | 1,79660 | 0,85467 | 0,59333 | 0,15364 | 1,60164 | 5,102 | 56,69 |
| 29 | (PO)ES | (PO) evolution strategies | 0,73972 | 0,58190 | 0,38896 | 1,71058 | 0,91199 | 0,59975 | 0,21262 | 1,72436 | 0,82400 | 0,56240 | 0,23432 | 1,62072 | 5,056 | 56,18 |
| 30 | BO | bonobo optimizer | 0,75555 | 0,64366 | 0,32657 | 1,72578 | 0,94332 | 0,70442 | 0,13999 | 1,78773 | 0,73467 | 0,61440 | 0,16728 | 1,51635 | 5,030 | 55,89 |
| 31 | SRA | successful restaurateur algorithm (joo) | 0,89010 | 0,63359 | 0,29115 | 1,81484 | 0,96634 | 0,55285 | 0,08914 | 1,60833 | 0,89333 | 0,52800 | 0,13911 | 1,56044 | 4,984 | 55,38 |
| 32 | FDAm | flow_direction_algorithm_M | 0,87573 | 0,58806 | 0,27135 | 1,73514 | 0,99997 | 0,64399 | 0,09633 | 1,74029 | 0,84267 | 0,48453 | 0,11888 | 1,44608 | 4,922 | 54,70 |
| 33 | CRO | chemical reaction optimisation | 0,91281 | 0,65681 | 0,29866 | 1,86828 | 0,90513 | 0,56020 | 0,10939 | 1,57472 | 0,82800 | 0,50133 | 0,14149 | 1,47082 | 4,914 | 54,60 |
| 34 | BCOm | bacterial chemotaxis optimization M | 0,82589 | 0,61733 | 0,31584 | 1,75906 | 0,95296 | 0,63718 | 0,11984 | 1,70998 | 0,76533 | 0,51653 | 0,15800 | 1,43986 | 4,909 | 54,54 |
| 35 | DOA | dream optimization algorithm | 0,78522 | 0,78121 | 0,36036 | 1,92679 | 0,61584 | 0,42117 | 0,12254 | 1,15955 | 0,86667 | 0,72587 | 0,21127 | 1,80381 | 4,890 | 54,33 |
| 36 | ABO | african buffalo optimization | 0,92295 | 0,62528 | 0,29885 | 1,84708 | 0,92992 | 0,57468 | 0,09372 | 1,59832 | 0,73333 | 0,51333 | 0,14324 | 1,38990 | 4,835 | 53,72 |
| 37 | BSA | bird swarm algorithm | 0,94432 | 0,67941 | 0,26401 | 1,88774 | 0,91649 | 0,65619 | 0,12054 | 1,69322 | 0,80933 | 0,33547 | 0,10652 | 1,25132 | 4,832 | 53,69 |
| 38 | TSm | tabu search M | 0,87806 | 0,61040 | 0,28993 | 1,77839 | 0,98116 | 0,52165 | 0,08544 | 1,58825 | 0,82667 | 0,49547 | 0,13552 | 1,45766 | 4,824 | 53,60 |
| 39 | BSA | backtracking search algorithm | 0,87128 | 0,53190 | 0,28675 | 1,68993 | 0,92408 | 0,51602 | 0,09153 | 1,53163 | 0,96000 | 0,47253 | 0,13760 | 1,57013 | 4,792 | 53,24 |
| 40 | BEA | bacterial_evolutionary_algorithm | 0,92170 | 0,59615 | 0,29340 | 1,81125 | 0,96906 | 0,44500 | 0,08233 | 1,49639 | 0,90533 | 0,43173 | 0,13676 | 1,47382 | 4,781 | 53,13 |
| 41 | BWOm | beluga_whale_optimization_M | 0,78488 | 0,56872 | 0,29557 | 1,64917 | 0,91370 | 0,61760 | 0,12988 | 1,66118 | 0,81333 | 0,49946 | 0,15004 | 1,46283 | 4,773 | 53,04 |
| 42 | WOAm | whale optimization algorithm M | 0,93893 | 0,59477 | 0,26695 | 1,80065 | 0,98036 | 0,53873 | 0,07112 | 1,59021 | 0,78667 | 0,47600 | 0,11892 | 1,38159 | 4,772 | 53,02 |
| 43 | ACA | andean_condor_algorithm | 0,78444 | 0,53260 | 0,33108 | 1,64812 | 0,79071 | 0,44960 | 0,10685 | 1,34716 | 0,92266 | 0,67733 | 0,17613 | 1,77612 | 4,771 | 53,02 |
| 44 | CSO | competitive swarm optimizer | 0,85151 | 0,60786 | 0,29896 | 1,75833 | 0,84085 | 0,58491 | 0,11974 | 1,54550 | 0,80000 | 0,48560 | 0,14184 | 1,42744 | 4,731 | 52,57 |
| 45 | FBA | fractal-based algorithm | 0,69419 | 0,64267 | 0,28955 | 1,62641 | 0,99812 | 0,54905 | 0,08705 | 1,63422 | 0,76133 | 0,51253 | 0,13689 | 1,41075 | 4,671 | 51,90 |
| RW | random walk | 0,49970 | 0,32333 | 0,25791 | 1,08094 | 0,30754 | 0,11470 | 0,04400 | 0,46624 | 0,36133 | 0,17013 | 0,10244 | 0,63390 | 2,181 | 24,23 | |
Выводы
Канонический OOA выглядит привлекательно: один параметр, который почти ни на что не влияет, простая и дешёвая структура, две оценки на агента за итерацию. На гладком склоне в малой размерности он действительно работает. Но стоит ландшафту стать гребнистым или ступенчатым, а числу параметров — вырасти, как его результат на стенде перестаёт выходить за пределы разброса случайного поиска. Причины не в неудачной настройке, а в самих формулах: атака на рыбу примерно половину координат каждого кандидата тянет не к цели, а к началу координат, и такие кандидаты в основном отбраковываются; перенос рыбы не ищет рядом, а прыгает по всему домену, да ещё и сносит предложения к одной из границ, если диапазон несимметричен. А улучшенная версия 2026 года, с которой всё началось, построена на коде, реализующем базовый алгоритм иначе, чем он описан у авторов, — так что её сравнение с OOA проведено с другой реализацией. Насколько это влияет на заявленные результаты EOOA на CEC2022, я не проверял; это вопрос к авторам, а не установленный факт.
Хорошая новость в том, что слабый алгоритм — не приговор. Убрав одну вредную формулу, заменив вторую на честную мутацию с шагом, не выходящим за границы, и дав агентам наследовать готовые координаты у более сильных соседей, мы получили OOAm — с 30% до 60% на том же бюджете. На 10–50 координатах — размерностях, типичных для торговых систем, — это на стенде уже сильный оптимизатор: гребнистая Forest на десяти координатах решается полностью, на пятидесяти — на 0,86. Перенос этого результата на реальные советники ещё предстоит проверить. Настраивать почти нечего — три параметра, из них два с широкими плоскими оптимумами. Есть и граница, которую стоит знать заранее: на тысяче координат алгоритм упирается в потолок, и это свойство схемы, а не параметров.
Но главное, что стоит унести из статьи, — не цифра 60%, а способ, которым она получена. Одна правка — один параметр — один прогон на той же базе: так получена вся цепочка до 58,5%. Финальные 60% — это уже совместная перенастройка двух параметров, популяции и copyProb, и я честно не знаю, как прирост делится между ними. Неудачи записываются наравне с удачами, потому что иногда объясняют больше: наша единственная неудача показала, что локальный поиск в большой размерности бесполезен при любом разумном бюджете, и именно после этого появилась правка, которая сработала. Половина улучшений в научных статьях построена на базе, которую никто не проверял. Прежде чем доверять любому новому алгоритму — прогоните канон и посмотрите на ячейки, а не на итоговую цифру.
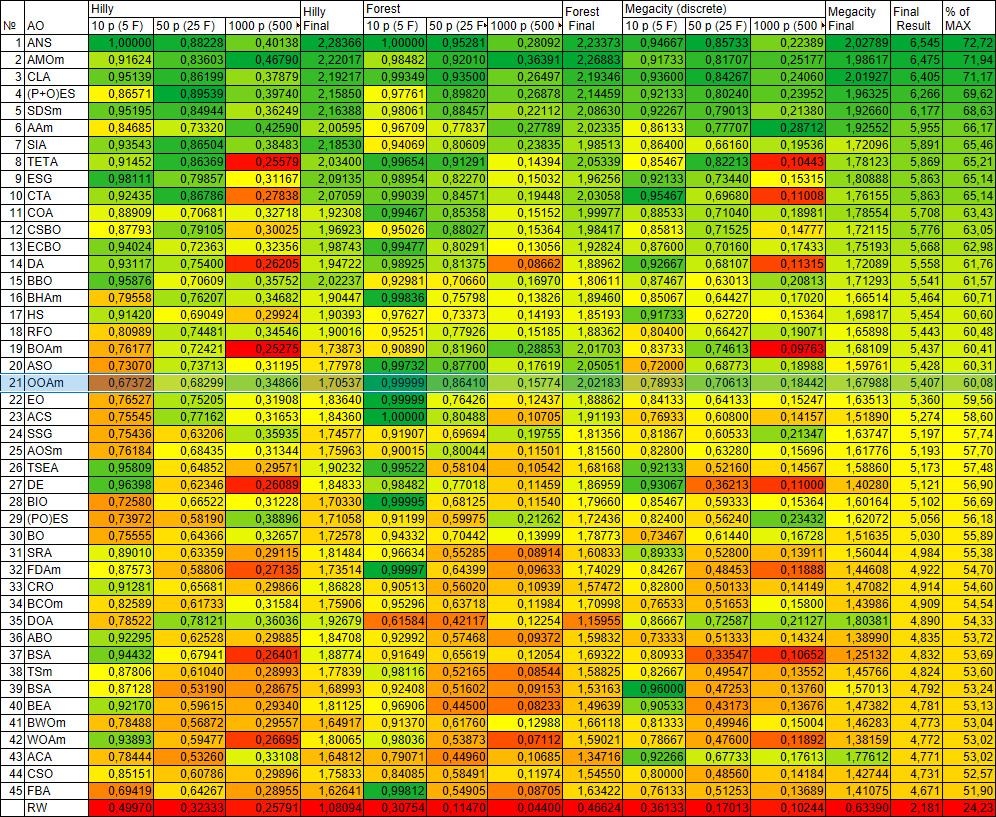
Рисунок 2. Цветовая градация алгоритмов по результатам соответствующих тестов.
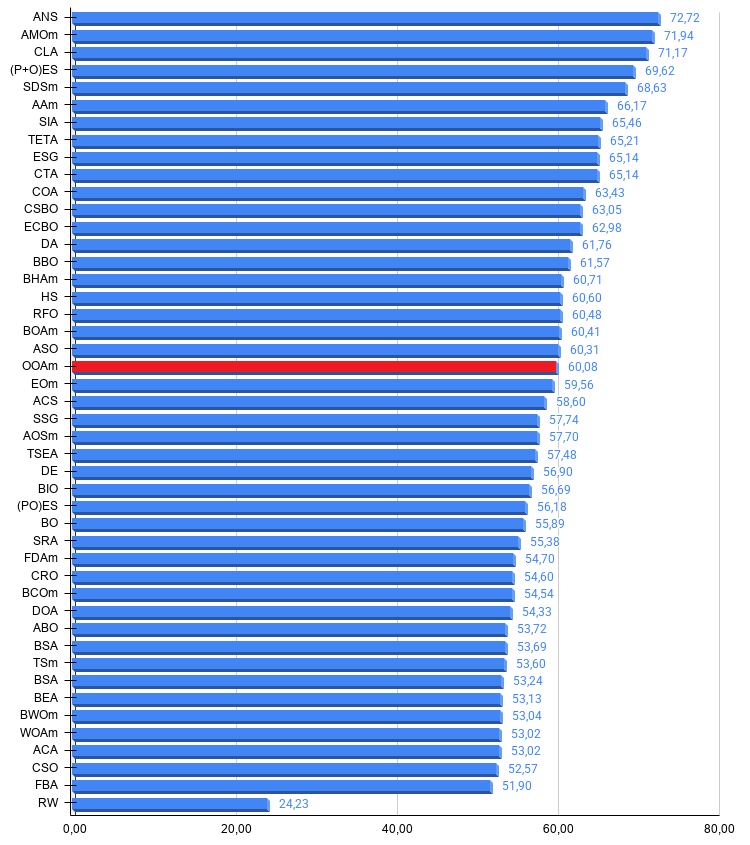
Рисунок 3. Гистограмма результатов тестирования алгоритмов (по шкале от 0 до 100: чем больше, тем лучше, где 100 — максимально возможный теоретический результат). В архиве приведён скрипт для расчёта рейтинговой таблицы
Плюсы и минусы алгоритма OOAm:
Плюсы:
- Один из лучших результаты по таблице на многомерных задачах.
- Малое количество внешних параметров.
Минусы:
- Склонность к застреванию на задачах с гладкими, но сложными поверхностями (увеличение популяции частично исправляет этот недостаток).
- От исходной метафоры осталась только схема выбора партнёра: по структуре это ближе к генетическому алгоритму без отбора, и называть OOAm улучшенной скопой можно с оговоркой.
К статье прикреплён архив с актуальными версиями кодов алгоритмов. Автор статьи не несёт ответственности за абсолютную точность в описании канонических алгоритмов, во многие из них внесены изменения для улучшения поисковых возможностей. Выводы и суждения, представленные в статьях, основываются на результатах проведённых экспериментов.
Программы, используемые в статье
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | #C_AO.mqh | Включаемый файл | Родительский класс популяционных алгоритмов оптимизации |
| 2 | #C_AO_enum.mqh | Включаемый файл | Перечисление популяционных алгоритмов оптимизации |
| 3 | TestFunctions.mqh | Включаемый файл | Библиотека тестовых функций |
| 4 | TestStandFunctions.mqh | Включаемый файл | Библиотека функций тестового стенда |
| 5 | TestStand3D.mqh | Включаемый файл | 3D-панель визуализации для тестового стенда |
| 6 | Utilities.mqh | Включаемый файл | Библиотека вспомогательных функций |
| 7 | CalculationTestResults.mqh | Включаемый файл | Скрипт для расчёта результатов в сравнительную таблицу |
| 8 | Test_AO_All.mq5 | Скрипт | Единый испытательный стенд для всех популяционных алгоритмов оптимизации |
| 9 | Test_AO_AntiCheat | Скрипт | Тест на читерство алгоритмов оптимизации |
| 10 | Simple use of population optimization algorithms.mq5 | Скрипт | Простой пример использования популяционных алгоритмов оптимизации без визуализации |
| 11 | Test_AO_OOAm.mq5 | Скрипт | Испытательный стенд для OOAm |
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Свинговые экстремумы и откаты в MQL5 (Часть 3): Определение структурной валидности за рамками простых максимумов и минимумов
 Автоматическое принятие и отклонение изменений ML-советника в MIDAS/MQL5: защита от переобучения через проверку устойчивости
 Нейроструктурный торговый движок — NSTE (Часть II): Шестиступенчатый квантовый фильтр "Врата Джардина"
 От начального к среднему уровню: Технические индикаторы (II)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования