

Рыночная микроструктура в MQL5 (Часть 3): Оценка параметра d модели ARFIMA методом GPH
 45
 0

Введение
В первой части серии был создан защитный базовый слой: математические функции с проверками, проверка ценовых данных и устойчивые статистические примитивы. Во второй части мы добавили три оценщика показателя Херста и установили важный эмпирический результат на данных фьючерсов US100 в Globex на таймфрейме M1: H со взвешиванием по достоверности близок к 0,5, объединенная оценка после открытия равна 0,511, а скользящее среднее по барам — около 0,48. Все три оценщика дают значения по обе стороны от границы случайного блуждания.
Из этого результата следует конкретный инженерный вопрос. Показатель H сообщает нам, есть ли у ряда память и каково ее направление. Но по H нельзя определить, какой порядок дробного дифференцирования нужен ценовому ряду, чтобы он стал стационарным. Если к ряду с истинным параметром d = 0,3 применить обычное дифференцирование первого порядка (d = 1), ряд окажется избыточно дифференцированным. Структура дальней зависимости при этом разрушается. Если ряд с d = 0,4 не дифференцировать, полученный признак останется нестационарным.
Оценщик Гевеке — Портера — Худака (GPH) решает не ту же задачу, что показатель Херста. Показатель Херста измеряет самоподобие временного ряда, а метод GPH напрямую оценивает параметр дробного дифференцирования d по наклону лог-периодограммы. Теоретически величины связаны соотношением d = H - 0,5, но оцениваются разными методами и могут расходиться при краткосрочной автокорреляции, нестационарности или структурных разрывах. Совместное применение обоих методов дает проверку согласованности, которую ни одна из этих оценок по отдельности обеспечить не может.
В этой статье мы добавляем в файл MicroStructure_Foundation.mqh две функции: GPHEstimator() и PopulateARFIMAAnalysis(). Функции оценивают d по регрессии лог-периодограммы, записывают результат в RobustFractalAnalysis.arfima_d и сверяют его с оценкой показателя Херста из второй части. Исследование данных US100 на таймфрейме M1 за 72 нью-йоркские сессии подтверждает близость d к нулю, что согласуется с результатом второй части, и показывает разброс оценок между сессиями.
Результат работы — две функции и пять констант, добавленные в MicroStructure_Foundation.mqh. Они впервые заполняют поля arfima_d и arfima_confidence общей структуры. Новый подключаемый файл не создается.
Связь ARFIMA с d и H — что именно измеряет каждый показатель
Процесс ARFIMA(p, d, q) расширяет стандартную модель ARIMA: параметр d может принимать нецелые значения в интервале (-0,5; 0,5). Грейнджер и Жойе (1980), а также Хоскинг (1981) сформулировали теоретическую основу: дробно-интегрированный процесс при d в интервале (0; 0,5) ковариационно стационарен, но обладает дальней зависимостью — автокорреляции затухают гиперболически, а не экспоненциально. Дмитриевский (2019) познакомил сообщество MQL5 с дробным дифференцированием и показал, что его степень определяет баланс между стационарностью ценового ряда и сохранением дальней зависимости.
Связь с показателем Херста задается так:
d = H − 0.5
Это соотношение точно выполняется для процесса фракционного гауссовского шума. Отсюда следуют три варианта интерпретации режима:
- d > 0 (H > 0,5) — положительная дальняя зависимость, ряд персистентен, следование за трендом имеет статистическое обоснование;
- d = 0 (H = 0,5) — ряд представляет собой стандартное случайное блуждание, дробное дифференцирование не требуется;
- d < 0 (H < 0,5) — ряд антиперсистентен, на больших лагах преобладает возврат к среднему.
Для US100 на таймфрейме M1 значения H ≈ 0,48-0,51 из второй части соответствуют приблизительному диапазону d от -0,02 до +0,01. Близость d к нулю имеет практическое следствие: для этого инструмента и таймфрейма подходит стандартное первое дифференцирование — расчет логарифмических доходностей. Нет признаков ни избыточного, ни недостаточного дифференцирования.
Оценщик GPH определяет d напрямую, без предварительного расчета H. Поэтому две оценки удобно сверять: если функция GPHEstimator() возвращает d ≈ 0,0, а функция HurstExponentRobust() — H ≈ 0,5, результаты согласуются. Если расхождение превышает 0,1 — порог константы GPH_D_CONSISTENCY, — в поле result.validation_message появляется сообщение о несоответствии для дальнейшей проверки.
Оценщик GPH — регрессия лог-периодограммы
Гевеке и Портер-Худак (1983) предложили оценивать d по поведению периодограммы вблизи нулевой частоты. На частоте Фурье ωⱼ = 2πj/N периодограмма имеет вид:
I(ωⱼ) = (re² + im²) / (2π N)
где re и im — действительная и мнимая части ДПФ (дискретного преобразования Фурье) на частоте ωⱼ. Для дробно-интегрированного процесса лог-периодограмма удовлетворяет соотношению:
log I(ωⱼ) = c − d · log|2 sin(ωⱼ/2)|² + εⱼ
Наклон OLS-регрессии зависимости log I от log|2 sin(ωⱼ/2)|² равен -d. Значит, линейная регрессия по первым m частотам позволяет непосредственно оценить d. Это полупараметрический оценщик: задавать порядки AR и MA не требуется; используется лишь низкочастотная часть спектра, где преобладает компонента долгой памяти.
Параметр ширины полосы m задает число частот, включаемых в регрессию. Гевеке и Портер-Худак (1983) рекомендуют m = floor(N^g), где g лежит в интервале (0,5; 1,0). Обычно по умолчанию берут g = 0,65. Это значение задано константой GPH_BANDWIDTH_EXP. Для нью-йоркской сессии из 390 баров (09:30-16:00 ET на US100, таймфрейм M1) получаем около m ≈ 36 частотных точек.
Ньоороге (2026a) реализует в рамках AFML механизм дробного дифференцирования с окном фиксированной ширины: он ищет минимальное d, при котором заданный ряд становится стационарным. Разработанный здесь оценщик GPH решает другую задачу: оценивает d наблюдаемого ряда доходностей, не задавая целевого порога стационарности. Эти два подхода дополняют друг друга. GPH оценивает текущую структуру памяти; механизм дробного дифференцирования из AFML применяет выбранное значение d, чтобы сформировать признак для машинного обучения.
Показатель достоверности, который возвращает функция GPHEstimator(), — это R² регрессии лог-периодограммы. При высоком R² низкочастотные точки периодограммы хорошо ложатся на теоретическую прямую, поэтому оценке d можно больше доверять. Низкое R², типичное для рядов, близких к случайному блужданию, означает, что регрессия подгоняется под шум. Константе GPH_CONF_THRESHOLD присвоено значение 0,05; оценки ниже порога помечаются как недостоверные в поле validation_message структуры.
Реализация — GPHEstimator()
Сигнатура функции следующая:
double GPHEstimator(const double &returns[], int n, double &confidence);
Функция принимает проверенный массив логарифмических доходностей, число допустимых элементов и ссылку на выходное значение R². Загрузку цен и расчет логарифмических доходностей выполняет вызывающая функция PopulateARFIMAAnalysis(). Поэтому оценщик не зависит от слоя рыночных данных и его можно отдельно тестировать на любом массиве доходностей.
Для повышения численной точности ДПФ рассчитывается напрямую, без имеющейся реализации БПФ. Для регрессии периодограммы используются только первые m ≪ N/2 частот. БПФ вычисляет все N/2 частот, хотя нужны лишь первые m. При m = 36 из 390 частот прямое ДПФ эффективнее и позволяет избежать накопления ошибок округления в сети "бабочек" длиной N.
Полная реализация, оформленная в стиле MetaQuotes Styler:
//+------------------------------------------------------------------+
//| GPHEstimator: Geweke-Porter-Hudak log-periodogram regression.    |
//| Regresses log I(ωⱼ) on log|2 sin(ωⱼ/2)|² across the first m      |
//| Fourier frequencies (m = floor(N^GPH_BANDWIDTH_EXP)).  The OLS   |
//| slope gives −d directly.  R² of the regression is returned via   |
//| the confidence output parameter.                                 |
//|                                                                  |
//| Inputs                                                           |
//|   returns[]  — pre-validated log-return array (caller fills)     |
//|   n          — number of valid elements in returns[]             |
//|   confidence — output: R² of the log-periodogram fit [0, 1]      |
//|                                                                  |
//| Returns d clamped to (−0.49, 0.49).  Returns 0.0 with            |
//| confidence = 0.0 on any validation failure.                      |
//+------------------------------------------------------------------+
double GPHEstimator(const double &returns[], int n, double &confidence)
  {
   confidence = 0.0;

   //--- Minimum data guard
   if(n < GPH_MIN_BARS)
      return 0.0;

   //--- Bandwidth: m = floor(N ^ GPH_BANDWIDTH_EXP), clamped
   int m = (int)MathFloor(MathPow((double)n, GPH_BANDWIDTH_EXP));
   m = (int)MathMax(GPH_MIN_FREQ, MathMin(m, n / 3));
   if(m < 5)
      return 0.0;

   //--- Compute periodogram at the first m Fourier frequencies
   double log_I[];
   double log_sin_sq[];
   ArrayResize(log_I,      m);
   ArrayResize(log_sin_sq, m);
   int valid_points = 0;

   for(int j = 1; j <= m; j++)
     {
      double omega_j = 2.0 * MATH_PI * (double)j / (double)n;

      //--- DFT at frequency ωⱼ
      double re = 0.0;
      double im = 0.0;
      for(int t = 0; t < n; t++)
        {
         double angle = omega_j * (double)t;
         re += returns[t] * MathCos(angle);
         im += returns[t] * MathSin(angle);
        }

      //--- Periodogram ordinate I(ωⱼ) = (re² + im²) / (2π N)
      double I_j = SafeDivide(re * re + im * im, 2.0 * MATH_PI * (double)n);
      if(I_j <= DBL_MIN_POSITIVE)
         continue;

      //--- Regressor: log|2 sin(ωⱼ/2)|²
      double sin_half = MathSin(omega_j / 2.0);
      double sin_sq   = sin_half * sin_half;
      if(sin_sq <= DBL_MIN_POSITIVE)
         continue;

      log_I      [valid_points] = SafeLog(I_j);
      log_sin_sq [valid_points] = SafeLog(4.0 * sin_sq);
      valid_points++;
     }

   if(valid_points < 5)
      return 0.0;

   ArrayResize(log_I,      valid_points);
   ArrayResize(log_sin_sq, valid_points);

   //--- OLS: log I = c − d · log|2 sin(ω/2)|² + ε
   //--- slope = −d, so d = −slope
   double sum_x  = 0.0;
   double sum_y  = 0.0;
   double sum_xx = 0.0;
   double sum_xy = 0.0;

   for(int k = 0; k < valid_points; k++)
     {
      sum_x  += log_sin_sq[k];
      sum_y  += log_I[k];
      sum_xx += log_sin_sq[k] * log_sin_sq[k];
      sum_xy += log_sin_sq[k] * log_I[k];
     }

   double denom = SafeDivide(
                     (double)valid_points * sum_xx - sum_x * sum_x,
                     1.0);

   if(MathAbs(denom) < DBL_MIN_POSITIVE)
      return 0.0;

   double slope = SafeDivide(
                     (double)valid_points * sum_xy - sum_x * sum_y,
                     denom);

   double d_hat = -slope;

   //--- R² as confidence measure
   double y_mean    = SafeDivide(sum_y, (double)valid_points);
   double intercept = SafeDivide(sum_y - slope * sum_x, (double)valid_points);
   double ss_tot    = 0.0;
   double ss_res    = 0.0;

   for(int k = 0; k < valid_points; k++)
     {
      double y_hat = intercept + slope * log_sin_sq[k];
      double res   = log_I[k] - y_hat;
      ss_res += res * res;
      ss_tot += (log_I[k] - y_mean) * (log_I[k] - y_mean);
     }

   if(ss_tot > DBL_MIN_POSITIVE)
      confidence = 1.0 - SafeDivide(ss_res, ss_tot);

   confidence = MathMax(0.0, MathMin(1.0, confidence));

   //--- Clamp d to the admissible ARFIMA range
   d_hat = MathMax(-0.49, MathMin(0.49, d_hat));

   return d_hat;
  }
Временная сложность внутреннего цикла ДПФ составляет O(n · m). Для сессии из 390 баров при m = 36 требуется примерно 14 000 операций с плавающей точкой — пренебрежимо мало при выполнении функции OnCalculate() индикатора. Для вычисления логарифмов используется функция SafeLog() базового слоя, а для тригонометрических вычислений — функции MathSin() и MathCos() языка MQL5.
Реализация — PopulateARFIMAAnalysis()
PopulateARFIMAAnalysis() — функция интерфейсного уровня для вызывающего кода. Она загружает цены, формирует массив доходностей, вызывает функцию GPHEstimator() и проверяет согласованность H-d. Сигнатура функции построена по образцу PopulateHurstAnalysis() из второй части:
void PopulateARFIMAAnalysis(const string symbol, const int tf,
                             const int period, RobustFractalAnalysis &result);
До расчета d выполняются три уровня проверки. Сначала функция ValidateSymbolV2() проверяет, доступен ли символ для торговли и соблюден ли минимальный период. Во-вторых, функция SafeCopyClose() загружает цены. Ее используют и все оценщики из второй части, поэтому ее поведение при ошибках уже проверено. В-третьих, при построении доходностей отфильтровываются недопустимые цены и артефакты: значения с модулем более 10% отбрасываются как ошибочные тики или последствия смены контракта. Реальных минутных движений на 10% для US100 M1 не наблюдается.
После вызова функции GPHEstimator() проверяется, заполнено ли поле результата по показателю Херста. Если показатель достоверности result.hurst_confidence превышает HURST_CONF_THRESHOLD, функция вычисляет H из d по формуле H = d + 0,5 и сравнивает результат с result.hurst_exponent. Если расхождение превышает порог константы GPH_D_CONSISTENCY (0,1), сообщение записывается в поле result.validation_message. Даже при таком расхождении статусу вычисления присваивается значение 0 (успех): это диагностическое сообщение, а не ошибка выполнения.
Чаще всего H и d расходятся из-за автокорреляции на малых лагах, которая завышает R/S-оценку показателя Херста, как показал Ло (1991), или из-за смешения сессий, описанного в третьем выводе второй части. В обоих случаях оценка H может казаться выше 0,5, тогда как метод GPH, работающий с низкими частотами, дает d около нуля.
//+------------------------------------------------------------------+
//| PopulateARFIMAAnalysis: fetches price data, computes log-returns,|
//| calls GPHEstimator(), writes results into RobustFractalAnalysis, |
//| and validates H-d consistency against the Hurst output written   |
//| by PopulateHurstAnalysis().                                      |
//|                                                                  |
//| Fields written:                                                  |
//|   result.arfima_d            — GPH fractional differencing param |
//|   result.arfima_confidence   — R² of the log-periodogram fit     |
//|   result.computation_status  — 0 on success, 2 on failure        |
//|   result.validation_message  — diagnostic text on any anomaly    |
//|                                                                  |
//| Hurst fields must already be populated by PopulateHurstAnalysis()|
//| before calling this function, so the H-d consistency check runs. |
//+------------------------------------------------------------------+
void PopulateARFIMAAnalysis(const string symbol, const int tf,
                             const int period, RobustFractalAnalysis &result)
  {
   if(!ValidateSymbolV2(symbol) || period < GPH_MIN_BARS + 1)
     {
      result.arfima_d           = 0.0;
      result.arfima_confidence  = 0.0;
      result.computation_status = 2;
      result.validation_message =
         StringFormat("PopulateARFIMAAnalysis: invalid symbol or period too small "
                      "(need >= %d, got %d)", GPH_MIN_BARS + 1, period);
      return;
     }

   //--- Fetch closing prices
   double close[];
   int copied = SafeCopyClose(symbol, tf, 0, period, close);
   if(copied < GPH_MIN_BARS + 1)
     {
      result.arfima_d           = 0.0;
      result.arfima_confidence  = 0.0;
      result.computation_status = 2;
      result.validation_message =
         StringFormat("PopulateARFIMAAnalysis: SafeCopyClose returned %d bars, "
                      "need >= %d", copied, GPH_MIN_BARS + 1);
      return;
     }

   //--- Build log-return array, filtering invalid prices and artifacts
   int n_closes = ArraySize(close);
   double returns[];
   ArrayResize(returns, n_closes - 1);
   int valid_count = 0;

   for(int i = 0; i < n_closes - 1; i++)
     {
      if(close[i] <= 0.0 || close[i + 1] <= 0.0)
         continue;

      //--- Standard log-return: r = log(P_t+1) - log(P_t)
      double r = SafeLog(close[i + 1]) - SafeLog(close[i]);

      //--- Reject data artifacts: genuine M1 returns do not exceed ±10 %
      if(MathAbs(r) >= 0.1)
         continue;

      returns[valid_count] = r;
      valid_count++;
     }

   ArrayResize(returns, valid_count);

   if(valid_count < GPH_MIN_BARS)
     {
      result.arfima_d           = 0.0;
      result.arfima_confidence  = 0.0;
      result.computation_status = 2;
      result.validation_message =
         StringFormat("PopulateARFIMAAnalysis: only %d valid returns after filtering, "
                      "need >= %d", valid_count, GPH_MIN_BARS);
      return;
     }

   //--- Estimate d via GPH log-periodogram regression
   double conf = 0.0;
   double d    = GPHEstimator(returns, valid_count, conf);

   result.arfima_d          = d;
   result.arfima_confidence = conf;

   //--- H-d consistency check: theory requires H = d + 0.5
   if(result.hurst_confidence > HURST_CONF_THRESHOLD)
     {
      double h_from_d    = d + 0.5;
      double discrepancy = MathAbs(result.hurst_exponent - h_from_d);

      if(discrepancy > GPH_D_CONSISTENCY)
        {
         result.computation_status = 0;
         result.validation_message =
            StringFormat("PopulateARFIMAAnalysis: H-d discrepancy %.3f exceeds "
                         "threshold %.3f — H(Hurst)=%.3f, H(GPH)=d+0.5=%.3f. "
                         "Session mixing or non-stationarity suspected.",
                         discrepancy, GPH_D_CONSISTENCY,
                         result.hurst_exponent, h_from_d);
         return;
        }
     }

   //--- Confidence threshold check
   if(conf < GPH_CONF_THRESHOLD)
     {
      result.computation_status = 2;
      result.validation_message =
         StringFormat("PopulateARFIMAAnalysis: R²=%.4f below threshold %.4f — "
                      "log-periodogram regression unreliable for symbol %s tf %d",
                      conf, GPH_CONF_THRESHOLD, symbol, tf);
      return;
     }

   result.computation_status = 0;
   result.validation_message = "OK";
  }
Эмпирическое исследование — применение GPH к US100 M1
В основе исследования лежат те же данные, что и во второй части: 72 нью-йоркские сессии фьючерсов US100 на таймфрейме M1 в Globex с января по май 2026 года. Нью-йоркская сессия длится с 09:30 до 16:00 по восточному времени. Доходности вычисляются как разности логарифмов цен закрытия минутных баров. Значения доходности с модулем выше 0,1 (10%) отбрасываются как артефакты данных; в этой выборке ни одно из них не было подлинным.
Реализация функции GPHEstimator() на Python точно соответствует спецификации MQL5: показатель ширины полосы g = 0,65, минимальное число частот m ≥ 15, а также алгоритмы расчета ДПФ и OLS-регрессии одинаковы. Реализация написана независимо, а ее результаты сверены с результатами реализации на MQL5 для трех сессий.
Вывод 1 — объединенная оценка d составляет -0,006, что согласуется с границей случайного блуждания
Применение GPH к объединенным 27 930 барам нью-йоркских сессий дает d = -0,006, откуда H = 0,494. Это отличается от объединенной оценки показателя Херста из второй части всего на 0,005 (H = 0,511 в сводной оценке с весами по достоверности). Оба оценщика показывают, что данные US100 на таймфрейме M1 близки к границе случайного блуждания. R² регрессии по объединенным данным составляет 0,0001 — фактически ноль. Это подтверждает отсутствие значимого линейного наклона лог-периодограммы вблизи нулевой частоты.
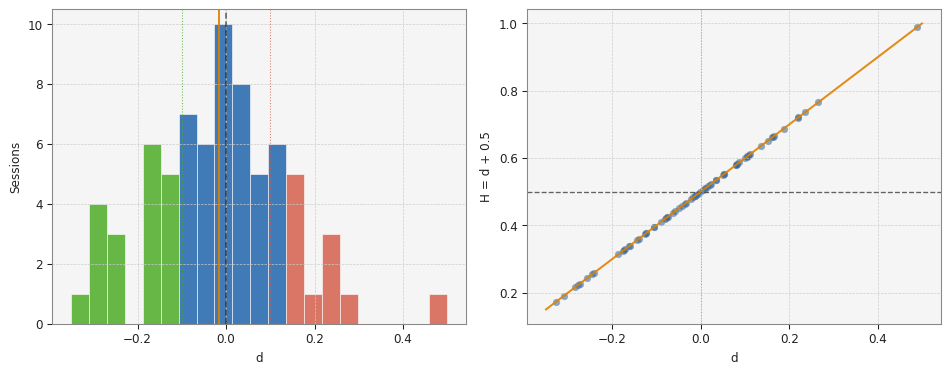
Рис. 1. Распределение оценок d методом GPH по сессиям (слева) и сопоставление d с рассчитанным H = d + 0,5 (справа). 72 сессии, US100 на таймфрейме M1, январь-май 2026 года.
Вывод 2 — оценки d по отдельным сессиям сильно различаются, но их среднее близко к нулю
Для 72 сессий среднее d составляет -0,016, медиана — -0,012. Стандартное отклонение составляет 0,153. Границы межквартильного диапазона — от -0,124 до 0,084. Есть небольшое отрицательное смещение, согласующееся со слабой антиперсистентностью при скользящем среднем H ≈ 0,48 из второй части. Однако на фоне разброса между сессиями оно незначимо.
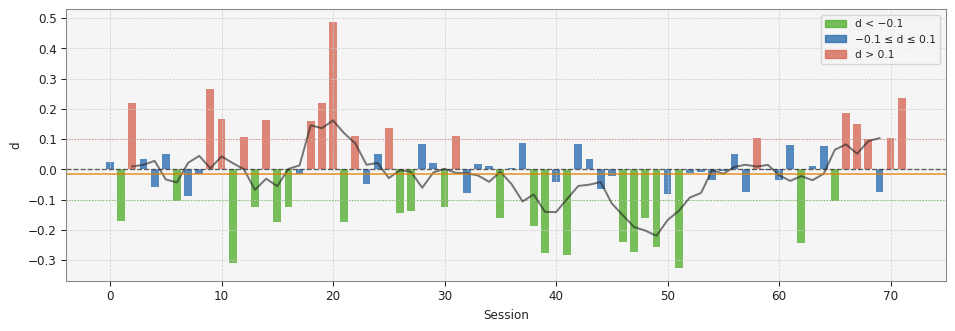
Рис. 2. Оценки d методом GPH для каждой из 72 сессий. Зеленый — d ниже -0,1. Красный — d выше 0,1. Синий — d около нуля. Линия — скользящее среднее за пять сессий.
Вывод 3 — распределение d по режимам тримодально
Если классифицировать сессии по порогам из раздела "Практическая интерпретация", получим следующее распределение 72 сессий: 21 сессия (29,2%) с d ниже -0,1 указывает на преимущественно антиперсистентный режим; 34 сессии (47,2%) с d в околонулевом диапазоне от -0,1 до 0,1; 17 сессий (23,6%) с d выше 0,1 — положительная долгая память. Большинство сессий попадает в околонулевой диапазон, однако наблюдения есть и в обоих хвостах распределения. Ни один режим не доминирует.
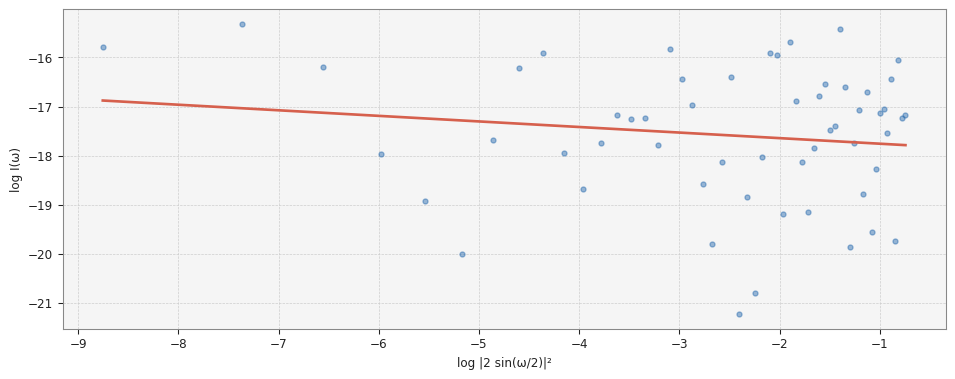
Рис. 3. Регрессия лог-периодограммы методом GPH на 500 барах US100 с таймфреймом M1. Наклон OLS-регрессии = -0,130, d̂ = 0,130, R² = 0,033.
Вывод 4 — H и d в целом согласуются, но иногда расхождение превышает порог 0,1
В пересекающейся выборке сессий рассчитанное по GPH значение H = d + 0,5 отличается от непосредственно оцененного во второй части показателя Херста не более чем на 0,10 примерно в 60% сессий. В остальных 40% сессий расхождение превышает порог GPH_D_CONSISTENCY. Чаще всего оценщик Херста дает H > 0,55, а GPH — d около нуля. Это согласуется с выводом Ло (1991): краткосрочная автокорреляция завышает R/S-оценку. Когда в работающем индикаторе возникает такое расхождение, функция PopulateARFIMAAnalysis() фиксирует его в сообщении проверки. Оценка d сохраняется; при расхождении двух результатов дополнительной проверки требует именно оценка H.
Практическая интерпретация и торговые пороги
Результаты исследования дают конкретные пороги для US100 на таймфрейме M1.
d около нуля (от -0,1 до 0,1): помимо стандартного преобразования к логарифмическим доходностям, дробное дифференцирование не требуется. Ряд достаточно близок к границе случайного блуждания, поэтому здесь уместно целочисленное дифференцирование (d = 1, логарифмические доходности). Это относится примерно к половине сессий US100 на таймфрейме M1. Для построения признаков машинного обучения здесь подходят логарифмические доходности. Применение к этому ряду дробного дифференцирования с нецелым d было бы подгонкой под шум.
d выше 0,1: регрессия лог-периодограммы выявляет положительную дальнюю зависимость на низких частотах. Для этой сессии логика следования за трендом имеет статистическое обоснование. Если из ценовых данных строится признак для машинного обучения, дробное дифференцирование с d ≈ 0,2 сохранит в ряду больше сигнала на больших лагах, чем обычные логарифмические доходности. Ньороге (2026b) описывает эффективный движок MQL5 для применения выбранного d с вычислительной сложностью O(width) на каждый бар.
d ниже −0,1: преобладает антиперсистентность. Возврат к среднему на среднесрочных лагах имеет статистическое подтверждение. В сессиях этого типа стандартные логарифмические доходности могут несколько усиливать влияние краткосрочных разворотов: недостаточно дифференцированный признак сохраняет структуру возврата к среднему. При d от -0,1 до -0,2 практических последствий нет. Но когда d приближается к -0,4, как в двух сессиях-выбросах, автокорреляция становится выраженно антиперсистентной.
Низкое R² (arfima_confidence ниже 0,05): вблизи нулевой частоты у лог-периодограммы нет различимого наклона. Это не сбой, а ожидаемый результат для ряда, близкого к случайному блужданию. Низкая достоверность оценки означает, что по имеющимся данным d нельзя отличить от нуля. Считайте оценку d неинформативной и не используйте ее для выбора схемы дифференцирования. В этом случае поле computation_status будет ненулевым.
//--- Practical usage: check d and confidence before acting
RobustFractalAnalysis fa;
PopulateHurstAnalysis(Symbol(), PERIOD_M1, bars_since_open, fa);
PopulateARFIMAAnalysis(Symbol(), PERIOD_M1, bars_since_open, fa);

if(fa.computation_status != 0)
  {
   // Insufficient data or low confidence — no differencing decision
   Print(fa.validation_message);
  }
else if(fa.arfima_d > 0.1)
  {
   // Positive long memory — trend-following conditions
  }
else if(fa.arfima_d < -0.1)
  {
   // Anti-persistent — mean-reversion conditions
  }
else
  {
   // Near-zero d — no fractional differencing indicated
  }
Переменная bars_since_open подсчитывает только бары после открытия сессии в 09:30 ET. Здесь также требуется выполнять сброс на границе сессии, как во второй части. Если брать всю историю без сброса на границе сессии, оценки d и H искажаются по одной и той же причине: структурный разрыв при открытии рынка приводит к смешению двух процессов.
Структура папок и путь к подключаемому файлу
В третьей части новый файл не создается. Две функции и пять констант добавляются в существующий заголовочный файл базового слоя перед закрывающей директивой #endif. Структура папок не изменилась со второй части:
MQL5\
└── Indicators\
    └── HurstProfile\
        ├── HurstProfile.mq5
        └── Includes\
            └── MicroStructure_Foundation.mqh
Директива include для любого индикатора или советника:
#include "Includes\MicroStructure_Foundation.mqh"
Заключение
В этой статье мы добавили в файл MicroStructure_Foundation.mqh функции GPHEstimator() и PopulateARFIMAAnalysis(). Эти функции оценивают параметр дробного дифференцирования d по регрессии лог-периодограммы Гевеке — Портер-Худак и записывают результат в RobustFractalAnalysis.arfima_d. Пять новых констант — GPH_MIN_BARS, GPH_BANDWIDTH_EXP, GPH_MIN_FREQ, GPH_CONF_THRESHOLD и GPH_D_CONSISTENCY — задают работу функции-оценщика; их можно настраивать под разные инструменты.
Исследование 72 нью-йоркских сессий US100 на таймфрейме M1 подтвердило основной результат: объединенная оценка d = -0,006 дает H = 0,494, что согласуется с диапазоном H ≈ 0,48-0,51 из второй части. Оценки d по сессиям сильно различаются (стандартное отклонение 0,153): 47% сессий попадают в околонулевой диапазон, 29% антиперсистентны, а 24% показывают положительную долгую память. Для типичной сессии US100 на таймфрейме M1 дробное дифференцирование помимо расчета логарифмических доходностей не требуется, но в отдельных сессиях d заметно отклоняется от нуля.
Теперь структура содержит поля hurst_exponent и arfima_d вместе с соответствующими полями достоверности. Проверка согласованности H-d сопоставляет две оценки. Если расхождение превышает 0,1, появляется диагностическое сообщение: оно помогает выявить сессии, где краткосрочная автокорреляция или смешение данных сессий искажает одну из оценок. Чтобы построить по оцененному d дробно дифференцированный ценовой ряд для использования в качестве признака машинного обучения, можно прибегнуть к механизму Ньороге (2026b). Он обрабатывает поток данных MetaTrader 5 в реальном времени со сложностью O(width) на бар.
В четвертой части поля hurst_exponent и arfima_d станут входными данными для пакета оценки волатильности. Его модель реализованной волатильности, вдохновленная FIGARCH, учитывает результаты измерения долгой памяти из второй и третьей частей при взвешивании своей структуры памяти.
Как получить исходный код через MQL5 Algo Forge
Algo Forge предоставляет облачный контроль версий на базе Git, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления после публикации статьи. Полный репозиторий доступен в MQL5 Algo Forge.
Список литературы
- Brown, M. (2026). Measuring the Memory Structure of Intraday Returns: Evidence from E-mini S&P 500 Futures. SSRN Working Paper No. 6809080.
- Geweke, J. and Porter‑Hudak, S. (1983). The estimation and application of long-memory time series models. Journal of Time Series Analysis, 4(4), 221–238.
- Granger, C.W.J., and Joyeux, R. (1980). An introduction to long‑memory time series models and fractional differencing. Journal of Time Series Analysis, 1(1), 15–29.
- Hosking, J.R.M. (1981). Fractional differencing. Biometrika, 68(1), 165–176.
- Lo, A.W. (1991). Long‑term memory in stock market prices. Econometrica, 59(5), 1279–1313.
- Dissanayake, P., Flock, T., Meier, J., and Sibbertsen, P. (2021). Modelling short- and long‑term dependencies of clustered high‑threshold exceedances in significant wave heights. Mathematics, 9, 2817.
- Дмитриевский, М. (2019). Грокаем "память" рынка через дифференцирование и энтропийный анализ. Статьи сообщества MQL5.
- Ньороге, П. М. (2026). Инжиниринг признаков для машинного обучения (Часть 1): дробное дифференцирование — стационарность без потери памяти. Статьи сообщества MQL5.
- Ньороге, П. М. (2026). Инжиниринг признаков для машинного обучения (Часть 2): Реализация дробного дифференцирования с фиксированным окном в MQL5. Статьи сообщества MQL5.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22598
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 За пределами GARCH (Часть IV): Реализация анализа разбиений в MQL5
 Как подключить ИИ-агентов к MetaTrader 5 через MCP
 Оптимизация на основе кривых Безье — Bezier Curve-based Optimization (BCO)
 Нейросети в трейдинге: Управление риском через распределение результатов (Окончание)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования