Artículos sobre aprendizaje automático en el trading

Creación de robots comerciales basados en inteligencia artificial: integración nativa con Python, operaciones con matrices y vectores, bibliotecas de matemáticas y estadística y mucho más.
Aprenda a usar el aprendizaje automático en el trading. Neuronas, perceptrones, redes convolucionales y recurrentes, modelos predictivos: parta de lo básico y avance hasta construir su propia IA. Aprenderá a entrenar y aplicar redes neuronales para el comercio algorítmico en los mercados financieros.
Nuevo artículo

Está perdiendo oportunidades comerciales:
- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Registro
Entrada
Usted acepta la política del sitio web y las condiciones de uso
Si no tiene cuenta de usuario, regístrese

Uso del algoritmo de aprendizaje automático PatchTST para predecir la acción del precio durante las próximas 24 horas
En este artículo, aplicamos un algoritmo de red neuronal relativamente complejo lanzado en 2023 llamado PatchTST para predecir la acción del precio durante las próximas 24 horas. Utilizaremos el repositorio oficial, haremos ligeras modificaciones, entrenaremos un modelo para EURUSD y lo aplicaremos para realizar predicciones futuras tanto en Python como en MQL5.


Redes neuronales en el trading: Modelos "ligeros" de pronóstico de series temporales
Los modelos ligeros de pronóstico de series temporales logran un alto rendimiento utilizando un número mínimo de parámetros, lo que, a su vez, reduce el consumo de recursos computacionales y agiliza la toma de decisiones. De este modo consiguen una calidad de previsión comparable a la de modelos más complejos.

Indicador de fuerza y dirección de la tendencia en barras 3D
Hoy estudiaremos un nuevo enfoque del análisis de las tendencias del mercado basado en la visualización tridimensional y el análisis tensorial de la microestructura del mercado.

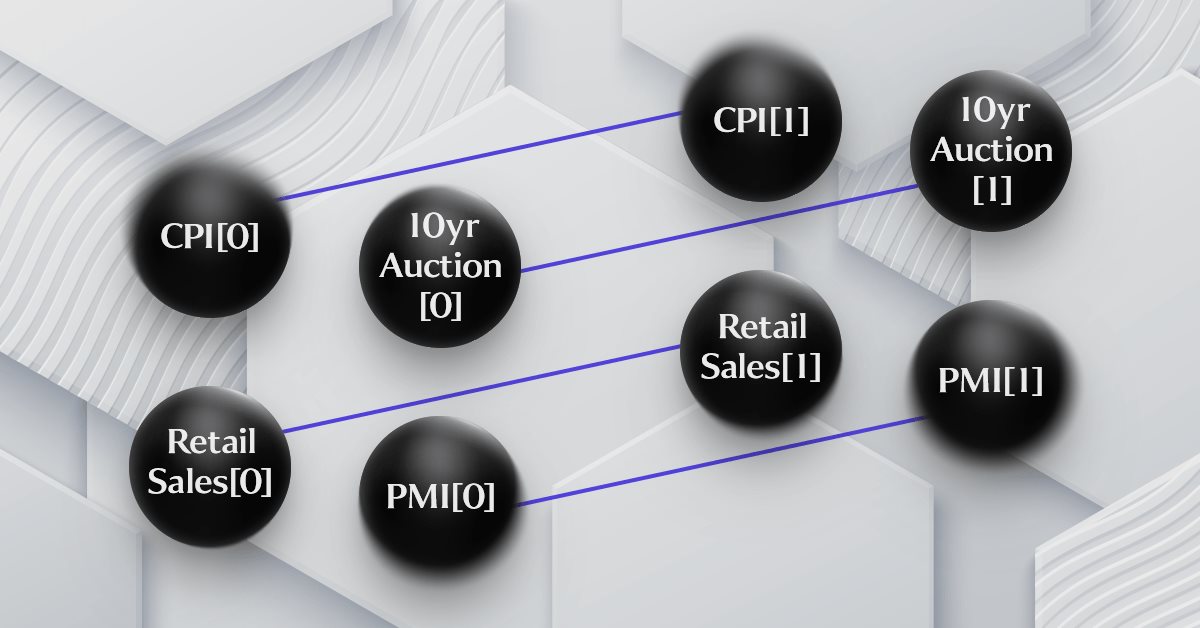
Teoría de categorías en MQL5 (Parte 16): Funtores con perceptrones multicapa
Seguimos analizando los funtores y cómo se pueden implementar utilizando redes neuronales artificiales. Dejaremos temporalmente el enfoque que implica el pronóstico de la volatilidad e intentaremos implementar nuestra propia clase de señales para establecer señales de entrada y salida para una posición.


Algoritmos de optimización de la población: Algoritmo híbrido de optimización de forrajeo bacteriano con algoritmo genético (Bacterial Foraging Optimization - Genetic Algorithm, BFO-GA)
Este artículo presenta un nuevo enfoque para resolver problemas de optimización combinando las ideas de los algoritmos de optimización de forrajeo bacteriano (BFO) y las técnicas utilizadas en el algoritmo genético (GA) en un algoritmo híbrido BFO-GA. Dicha técnica utiliza enjambres bacterianos para buscar una solución óptima de manera global y operadores genéticos para refinar los óptimos locales. A diferencia del BFO original, ahora las bacterias pueden mutar y heredar genes.

Aprendizaje automático y Data Science (Parte 32): Mantener actualizados los modelos de IA, aprendizaje en línea
En el cambiante mundo del comercio, adaptarse a los cambios del mercado no es solo una opción, es una necesidad. Cada día surgen nuevos patrones y tendencias, lo que dificulta que incluso los modelos de aprendizaje automático más avanzados sigan siendo eficaces ante condiciones en constante evolución. En este artículo, exploraremos cómo mantener tus modelos relevantes y receptivos a los nuevos datos del mercado mediante el reentrenamiento automático.

Red neuronal en la práctica: La primera neurona
En este artículo, comenzaremos a crear algo que muchos se sorprenden al ver funcionando: una simple y modesta neurona que lograremos programar con muy poco código en MQL5. La neurona funcionó perfectamente en las pruebas que realicé. Bueno, retrocedamos un poco en esta misma serie sobre redes neuronales, para que puedas entender de qué estoy hablando.


ADAM poblacional (Estimación Adaptativa de Momentos)
Este artículo presenta la transformación del conocido y popular método de optimización ADAM basado en gradientes en un algoritmo basado en poblaciones y su modificación con la introducción de individuos híbridos. El nuevo enfoque permite crear agentes que combinen elementos de soluciones exitosas mediante una distribución de probabilidades. Una innovación clave es la generación de poblaciones híbridas que acumulan de forma adaptativa la información de las soluciones más prometedoras, mejorando la eficacia de la búsqueda en espacios multidimensionales complejos.

Redes neuronales en el trading: Análisis de nubes de puntos (PointNet)
El análisis directo de nubes de puntos evita alcanza un tamaño de datos innecesario y mejora la eficacia de los modelos en tareas de clasificación y segmentación. Estos enfoques demuestran un alto rendimiento y solidez frente a las perturbaciones de los datos de origen.

Redes neuronales: así de sencillo (Parte 40): Enfoques para utilizar Go-Explore con una gran cantidad de datos
Este artículo analizará el uso del algoritmo Go-Explore durante un largo periodo de aprendizaje, ya que la estrategia de elección aleatoria puede no conducir a una pasada rentable a medida que aumenta el tiempo de entrenamiento.


Marcado de datos en el análisis de series temporales (Parte 4): Descomposición de la interpretabilidad usando el marcado de datos
En esta serie de artículos, presentaremos varias técnicas de marcado de series temporales que pueden producir datos que se ajusten a la mayoría de los modelos de inteligencia artificial (IA). El marcado dirigido de datos puede hacer que un modelo de IA entrenado resulte más relevante para las metas y objetivos del usuario, mejorando la precisión del modelo y ayudando a este a dar un salto de calidad.


Redes neuronales: así de sencillo (Parte 64): Método de clonación conductual ponderada conservadora (CWBC)
Como resultado de las pruebas realizadas en artículos anteriores, hemos concluido que la optimalidad de la estrategia entrenada depende en gran medida de la muestra de entrenamiento utilizada. En este artículo, nos familiarizaremos con un método bastante sencillo y eficaz para seleccionar trayectorias para el entrenamiento de modelos.


Métodos de optimización de la biblioteca ALGLIB (Parte I)
En este artículo nos familiarizaremos con los métodos de optimización de la biblioteca ALGLIB para MQL5. El artículo incluye ejemplos sencillos e ilustrativos de la aplicación de ALGLIB para resolver problemas de optimización, lo que hará que el proceso de dominio de los métodos resulte lo más accesible posible. Asimismo, analizaremos con detalle la conectividad de algoritmos como BLEIC, L-BFGS y NS y resolveremos un sencillo problema de prueba basado en ellos.


Redes neuronales: así de sencillo (Parte 37): Atención dispersa (Sparse Attention)
En el artículo anterior, analizamos los modelos relacionales que utilizan mecanismos de atención en su arquitectura. Una de las características de dichos modelos es su mayor uso de recursos informáticos. Este artículo propondrá uno de los posibles mecanismos para reducir el número de operaciones computacionales dentro del bloque Self-Attention o de auto-atención, lo cual aumentará el rendimiento del modelo en su conjunto.

El papel de la calidad del generador de números aleatorios en la eficiencia de los algoritmos de optimización
En este artículo, analizaremos el generador de números aleatorios Mersenne Twister y lo compararemos con el estándar en MQL5. También determinaremos la influencia de la calidad del generador de números aleatorios en los resultados de los algoritmos de optimización.


Redes neuronales: así de sencillo (Parte 60): Online Decision Transformer (ODT)
En los 2 últimos artículos nos hemos centrado en el método Decision Transformer, que modela las secuencias de acciones en el contexto de un modelo autorregresivo de recompensas deseadas. En el artículo de hoy, analizaremos otro algoritmo para optimizar este método.

Redes neuronales: así de sencillo (Parte 77): Transformador de covarianza cruzada (XCiT)
En nuestros modelos, a menudo utilizamos varios algoritmos de atención. Y, probablemente, lo más frecuente es utilizar transformadores. Su principal desventaja es la necesidad de recursos. En este artículo, estudiaremos un nuevo algoritmo que puede ayudar a reducir los costes informáticos sin perder calidad.

Marcado de datos en el análisis de series temporales (Parte 1):Creamos un conjunto de datos con marcadores de tendencia utilizando el gráfico de un asesor
En esta serie de artículos, presentaremos varias técnicas de etiquetado de series temporales que pueden producir datos que se ajusten a la mayoría de los modelos de inteligencia artificial (IA). El etiquetado específico de datos puede hacer que un modelo de IA entrenado resulte más relevante para las metas y objetivos del usuario, mejorar la precisión del modelo e incluso ayudarle a dar un salto cualitativo.


Introducción a MQL5 (Parte 6): Guía para principiantes sobre las funciones de matriz en MQL5 (II)
Embárquese en la siguiente fase de nuestro viaje MQL5. En este artículo para principiantes analizaremos el resto de funciones de la matriz y desmitificaremos conceptos complejos para que pueda elaborar estrategias de negociación eficaces. Hablaremos de ArrayPrint, ArrayInsert, ArraySize, ArrayRange, ArrarRemove, ArraySwap, ArrayReverse y ArraySort. Aumente su experiencia en negociación algorítmica con estas funciones de matriz esenciales. ¡Únase a nosotros en el camino hacia el dominio de MQL5!


Utilización del modelo de aprendizaje automático CatBoost como filtro para estrategias de seguimiento de tendencias
CatBoost es un potente modelo de aprendizaje automático basado en árboles que se especializa en la toma de decisiones basada en características estacionarias. Otros modelos basados en árboles, como XGBoost y Random Forest, comparten características similares en cuanto a su solidez, capacidad para manejar patrones complejos e interpretabilidad. Estos modelos tienen una amplia gama de usos, desde el análisis de características hasta la gestión de riesgos. En este artículo, vamos a explicar el procedimiento para utilizar un modelo CatBoost entrenado como filtro para una estrategia clásica de seguimiento de tendencias con cruce de medias móviles.

Redes neuronales en el trading: Resultados prácticos del método TEMPO
Continuamos familiarizándonos con el método TEMPO. En este artículo, analizaremos la efectividad de los enfoques propuestos con datos históricos reales.


Análisis cuantitativo de tendencias: Recopilamos estadísticas en Python
¿Qué es el análisis cuantitativo de tendencias en el mercado Forex? Recopilamos estadísticas sobre las tendencias, su magnitud y distribución en el par de divisas EURUSD. Cómo el análisis cuantitativo de tendencias puede ayudarle a crear un asesor comercial rentable.

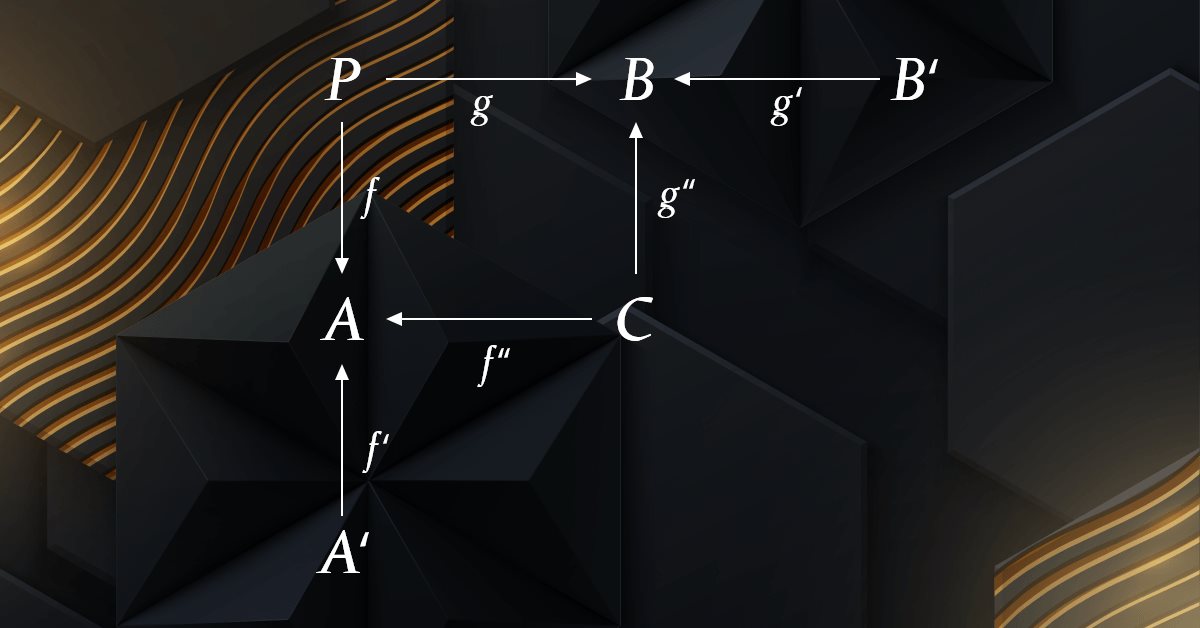
Teoría de categorías en MQL5 (Parte 4): Intervalos, experimentos y composiciones
La teoría de categorías es una rama de las matemáticas diversa y en expansión, relativamente inexplorada aún en la comunidad MQL5. Esta serie de artículos tiene como objetivo describir algunos de sus conceptos para crear una biblioteca abierta y seguir utilizando esta maravillosa sección para crear estrategias comerciales.

Redes neuronales en el trading: Sistema multiagente con validación conceptual (FinCon)
Hoy le proponemos familiarizarnos con el framework FinCon, un sistema multiagente basado en grandes modelos lingüísticos (LLM). El framework usa el refuerzo verbal conceptual para mejorar la toma de decisiones y la gestión del riesgo con el fin de realizar eficazmente diversas tareas financieras.


Hibridación de algoritmos basados en poblaciones. Esquema secuencial y paralelo
En este artículo, nos sumergiremos en el mundo de la hibridación de algoritmos de optimización analizando tres tipos clave: la mezcla de estrategias y la hibridación secuencial y paralela. Asimismo, realizaremos una serie de experimentos combinando y probando los algoritmos de optimización correspondientes.

Redes neuronales: así de sencillo (Parte 94): Optimización de la secuencia de entrada
Al trabajar con series temporales, siempre utilizamos los datos de origen en su secuencia histórica. Pero, ¿es ésta la mejor opción? Existe la opinión de que cambiar la secuencia de los datos de entrada mejorará la eficacia de los modelos entrenados. En este artículo te invito a conocer uno de los métodos para optimizar la secuencia de entrada.


Visión por computadora para el trading (Parte 1): Creamos una funcionalidad básica sencilla
Sistema de previsión de EURUSD mediante visión por computadora y aprendizaje profundo. Descubra cómo las redes neuronales convolucionales pueden reconocer patrones de precios complejos en el mercado de divisas y predecir la evolución de los tipos con una precisión de hasta el 54%. El artículo revela la metodología de creación de un algoritmo que usa tecnologías de inteligencia artificial para analizar visualmente los gráficos en lugar de los indicadores técnicos tradicionales. El autor muestra el proceso de transformación de los datos de precios en "imágenes", su procesamiento por una red neuronal y una visión única de la "conciencia" de la IA a través de mapas de activación y mapas de calor de la atención. El práctico código Python que utiliza la biblioteca MetaTrader 5 permite a los lectores reproducir el sistema y aplicarlo a sus propias transacciones.

Teoría de categorías en MQL5 (Parte 15): Funtores con grafos
El artículo continúa la serie sobre la implementación de la teoría de categorías en MQL5, analizando los funtores como un puente entre grafos y conjuntos. Volveremos nuevamente a los datos del calendario y, a pesar de sus limitaciones en el uso de un simulador de estrategias, justificaremos el uso de funtores para predecir la volatilidad mediante la correlación.

Redes neuronales: así de sencillo (Parte 71): Previsión de estados futuros basada en objetivos (GCPC)
En trabajos anteriores, hemos introducido el método del Decision Transformer y varios algoritmos derivados de él. Asimismo, hemos experimentado con distintos métodos de fijación de objetivos. Durante los experimentos, hemos trabajado con distintas formas de fijar objetivos, pero el aprendizaje de la trayectoria ya recorrida por parte del modelo siempre quedaba fuera de nuestra atención. En este artículo, queremos presentar un método que llenará este vacío.


Análisis angular de los movimientos de precios: un modelo híbrido para predecir los mercados financieros
¿Qué es el análisis angular de los mercados financieros? ¿Cómo usar los ángulos de precios y el aprendizaje automático para predecir con una exactitud de 67? ¿Cómo combinar un modelo de regresión y clasificación con características angulares y obtener un algoritmo que funcione? ¿Qué tiene que ver Gann con esto? ¿Por qué los ángulos de movimiento de los precios son una buena señal para el aprendizaje automático?

Teoría de Categorías en MQL5 (Parte 5): Ecualizadores
La teoría de categorías es un apartado diverso y en expansión de las matemáticas, que solo recientemente ha comenzado a ser trabajado por la comunidad MQL5. Esta serie de artículos tiene por objetivo repasar algunos de sus conceptos para crear una biblioteca abierta y seguir usando este maravilloso apartado en la creación de estrategias comerciales.

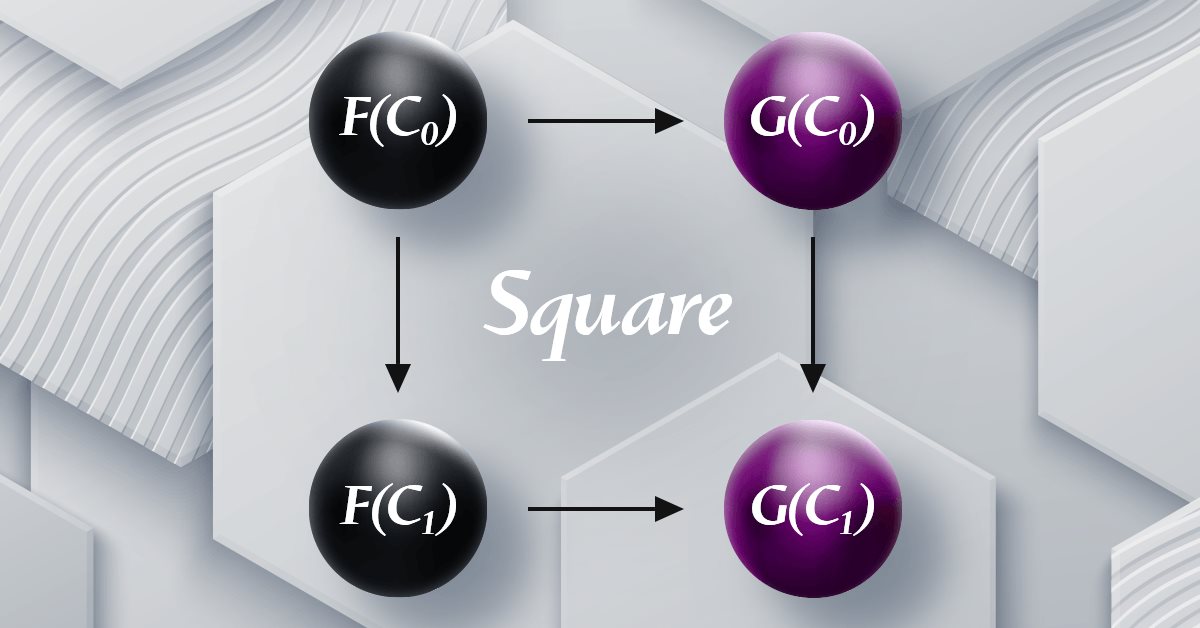
Teoría de categorías en MQL5 (Parte 19): Inducción cuadrática de la naturalidad
Continuamos analizando las transformaciones naturales considerando la inducción cuadrática de la naturalidad. Pequeñas restricciones en la implementación de las capacidades multidivisa para los asesores ensamblados usando el wizard MQL5 significan que estamos demostrando nuestras capacidades en la clasificación de datos usando un script. Las principales áreas de aplicación son la clasificación de las variaciones de precios y, como consecuencia, su previsión.


Características del Wizard MQL5 que debe conocer (Parte 22): Redes generativas adversativas (RGAs) condicionales
Las redes generativas antagónicas son un emparejamiento de redes neuronales que se entrenan entre sí para obtener resultados más precisos. Adoptamos el tipo condicional de estas redes mientras buscamos una posible aplicación en la previsión de series de tiempo financieras dentro de una clase de señales expertas.

Clústeres de series temporales en inferencia causal
Los algoritmos de agrupamiento en el aprendizaje automático son importantes algoritmos de aprendizaje no supervisado que pueden dividir los datos originales en grupos con observaciones similares. Utilizando estos grupos, puede analizar el mercado de un grupo específico, buscar los grupos más estables utilizando nuevos datos y hacer inferencias causales. El artículo propone un método original de agrupación de series temporales en Python.

Características del Wizard MQL5 que debe conocer (Parte 23): Redes neuronales convolucionales (CNNs, Convolutional Neural Networks)
Las redes neuronales convolucionales son otro algoritmo de aprendizaje automático que tiende a especializarse en descomponer conjuntos de datos multidimensionales en partes constituyentes clave. Examinamos cómo se consigue esto normalmente y exploramos una posible aplicación para los operadores en otra clase de señal del asistente MQL5.

Algoritmo de optimización Brain Storm - Brain Storm Optimization (Parte I): Clusterización
En este artículo analizaremos un innovador método de optimización denominado BSO (Brain Storm Optimization), inspirado en el fenómeno natural de la tormenta de ideas. También discutiremos un nuevo enfoque de resolución de tareas de optimización multimodales que utiliza el método BSO y nos permite encontrar múltiples soluciones óptimas sin tener que determinar de antemano el número de subpoblaciones. En este artículo, también analizaremos los métodos de clusterización K-Means y K-Means++.

Teoría de categorías en MQL5 (Parte 22): Una mirada distinta a las medias móviles
En el presente artículo intentaremos simplificar los conceptos tratados en esta serie centrándonos en solo un indicador, el más común y probablemente el más fácil de entender: la media móvil. También veremos el significado y las posibles aplicaciones de las transformaciones naturales verticales.

Ingeniería de características con Python y MQL5 (Parte I): Predicción de medias móviles para modelos de IA de largo plazo
Las medias móviles son, con diferencia, los mejores indicadores para que nuestros modelos de IA realicen predicciones. Sin embargo, podemos mejorar aún más nuestra precisión transformando cuidadosamente nuestros datos. Este artículo le mostrará cómo puede crear modelos de IA capaces de realizar previsiones a más largo plazo que las que realiza actualmente sin que ello suponga una disminución significativa de su nivel de precisión. Es realmente sorprendente lo útiles que son las medias móviles.


Modelos ocultos de Márkov en sistemas comerciales de aprendizaje automático
Los modelos ocultos de Márkov (HMM) son una potente clase de modelos probabilísticos diseñados para analizar datos secuenciales, donde los eventos observados dependen de alguna secuencia de estados no observados (ocultos) que forman un proceso de Márkov. Los principales supuestos del HMM incluyen la propiedad de Márkov para estados ocultos, lo que significa que la probabilidad de transición al siguiente estado depende solo del estado actual y la independencia de las observaciones dado el conocimiento del estado oculto actual.


Obtenga una ventaja sobre cualquier mercado (Parte IV): Índices CBOE de volatilidad del euro y el oro
Analizaremos datos alternativos curados por el 'Chicago Board Of Options Exchange' (CBOE) para mejorar la precisión de nuestras redes neuronales profundas al pronosticar el símbolo XAUEUR (oro).