Artículos sobre análisis de datos y estadísticas en MQL5

Los artículos sobre los modelos matemáticos y leyes de probabilidades serán interesantes para muchos operadores. Es que las matemáticas han sido puestas como base de los indicadores, y el conocimiento de las estadísticas es necesario para el análisis de los resultados del trading y el desarrollo de las estrategias.
Lea sobre la lógica difusa, filtros digitales, perfil del mercado, mapas de Kohonen, gas neuronal y muchas otras herramientas que pueden ser utilizadas para el trading.
Nuevo artículo

Está perdiendo oportunidades comerciales:
- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Registro
Entrada
Usted acepta la política del sitio web y las condiciones de uso
Si no tiene cuenta de usuario, regístrese


Algoritmos de optimización de la población: Algoritmo híbrido de optimización de forrajeo bacteriano con algoritmo genético (Bacterial Foraging Optimization - Genetic Algorithm, BFO-GA)
Este artículo presenta un nuevo enfoque para resolver problemas de optimización combinando las ideas de los algoritmos de optimización de forrajeo bacteriano (BFO) y las técnicas utilizadas en el algoritmo genético (GA) en un algoritmo híbrido BFO-GA. Dicha técnica utiliza enjambres bacterianos para buscar una solución óptima de manera global y operadores genéticos para refinar los óptimos locales. A diferencia del BFO original, ahora las bacterias pueden mutar y heredar genes.


Optimización de carteras en Python y MQL5
Este artículo explora técnicas avanzadas de optimización de cartera utilizando Python y MQL5 con MetaTrader 5. Demuestra cómo desarrollar algoritmos para el análisis de datos, la asignación de activos y la generación de señales comerciales, enfatizando la importancia de la toma de decisiones basada en datos en la gestión financiera moderna y la mitigación de riesgos.


Desarrollo de un sistema de repetición (Parte 34): Sistema de órdenes (III)
En este artículo concluiremos la primera fase de la construcción. Aunque será algo relativamente rápido, explicaré detalles que quizás no se comentaron anteriormente. Pero aquí explicaré algunas cosas que mucha gente no entiende por qué son como son. Uno de estos casos es el del ratón. ¡¡¡¿Sabes por qué tienes que pulsar la tecla Shift o Ctrl en tu teclado?!!!

Elementos del análisis de correlación en MQL5: Prueba chi-cuadrado de Pearson de independencia y ratio de correlación.
El artículo analiza las herramientas clásicas del análisis de correlaciones. Se hace hincapié en los breves antecedentes teóricos, así como en la aplicación práctica de la prueba de independencia chi-cuadrado de Pearson y la ratio de correlación.


ADAM poblacional (Estimación Adaptativa de Momentos)
Este artículo presenta la transformación del conocido y popular método de optimización ADAM basado en gradientes en un algoritmo basado en poblaciones y su modificación con la introducción de individuos híbridos. El nuevo enfoque permite crear agentes que combinen elementos de soluciones exitosas mediante una distribución de probabilidades. Una innovación clave es la generación de poblaciones híbridas que acumulan de forma adaptativa la información de las soluciones más prometedoras, mejorando la eficacia de la búsqueda en espacios multidimensionales complejos.

De novato a experto: Depuración colaborativa en MQL5
La resolución de problemas puede establecer una rutina concisa para dominar habilidades complejas, como la programación en MQL5. Este enfoque le permite concentrarse en la resolución de problemas al tiempo que desarrolla sus capacidades. Cuantos más problemas abordes, más conocimientos avanzados se transferirán a tu cerebro. Personalmente, creo que la depuración es la forma más efectiva de dominar la programación. Hoy repasaremos el proceso de limpieza de código y analizaremos las mejores técnicas para transformar un programa desordenado en uno limpio y funcional. Lea este artículo y descubra información valiosa.


Desarrollo de un sistema de repetición (Parte 38): Pavimentando el terreno (II)
Muchas personas que se hacen llamar programadores de MQL5 no tienen los conocimientos básicos que presentaré en este artículo. Muchos consideran que MQL5 es limitado; sin embargo, todo se debe a la falta de conocimientos. Así que no te avergüences de no saber. Avergüénzate, en cambio, de no preguntar. El simple hecho de obligar a MetaTrader 5 a no permitir que un indicador se duplique, en ningún caso nos da los medios para realizar una comunicación bidireccional entre el indicador y el Expert Advisor. Todavía estamos muy lejos de esto. No obstante, el hecho de que el indicador no se duplique en el gráfico nos da cierta tranquilidad.

El papel de la calidad del generador de números aleatorios en la eficiencia de los algoritmos de optimización
En este artículo, analizaremos el generador de números aleatorios Mersenne Twister y lo compararemos con el estándar en MQL5. También determinaremos la influencia de la calidad del generador de números aleatorios en los resultados de los algoritmos de optimización.

Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 5): Volatility Navigator EA
Determinar la dirección del mercado puede ser sencillo, pero saber cuándo entrar puede resultar complicado. Como parte de la serie titulada «Desarrollo de un kit de herramientas para el análisis de la acción del precio», me complace presentar otra herramienta que proporciona puntos de entrada, niveles de toma de ganancias y colocación de órdenes stop loss. Para lograrlo, hemos utilizado el lenguaje de programación MQL5. Profundicemos en cada paso de este artículo.


Reconocimiento de patrones mediante deformación dinámica del tiempo (Dynamic Time Warping, DTW) en MQL5
En este artículo, analizamos el concepto de deformación dinámica del tiempo como medio para identificar patrones predictivos en series de tiempo financieras. Veremos cómo funciona y presentaremos su implementación en MQL5.


Métodos de optimización de la biblioteca ALGLIB (Parte I)
En este artículo nos familiarizaremos con los métodos de optimización de la biblioteca ALGLIB para MQL5. El artículo incluye ejemplos sencillos e ilustrativos de la aplicación de ALGLIB para resolver problemas de optimización, lo que hará que el proceso de dominio de los métodos resulte lo más accesible posible. Asimismo, analizaremos con detalle la conectividad de algoritmos como BLEIC, L-BFGS y NS y resolveremos un sencillo problema de prueba basado en ellos.


Análisis cuantitativo de tendencias: Recopilamos estadísticas en Python
¿Qué es el análisis cuantitativo de tendencias en el mercado Forex? Recopilamos estadísticas sobre las tendencias, su magnitud y distribución en el par de divisas EURUSD. Cómo el análisis cuantitativo de tendencias puede ayudarle a crear un asesor comercial rentable.

Redes neuronales: así de sencillo (Parte 40): Enfoques para utilizar Go-Explore con una gran cantidad de datos
Este artículo analizará el uso del algoritmo Go-Explore durante un largo periodo de aprendizaje, ya que la estrategia de elección aleatoria puede no conducir a una pasada rentable a medida que aumenta el tiempo de entrenamiento.

Marcado de datos en el análisis de series temporales (Parte 1):Creamos un conjunto de datos con marcadores de tendencia utilizando el gráfico de un asesor
En esta serie de artículos, presentaremos varias técnicas de etiquetado de series temporales que pueden producir datos que se ajusten a la mayoría de los modelos de inteligencia artificial (IA). El etiquetado específico de datos puede hacer que un modelo de IA entrenado resulte más relevante para las metas y objetivos del usuario, mejorar la precisión del modelo e incluso ayudarle a dar un salto cualitativo.

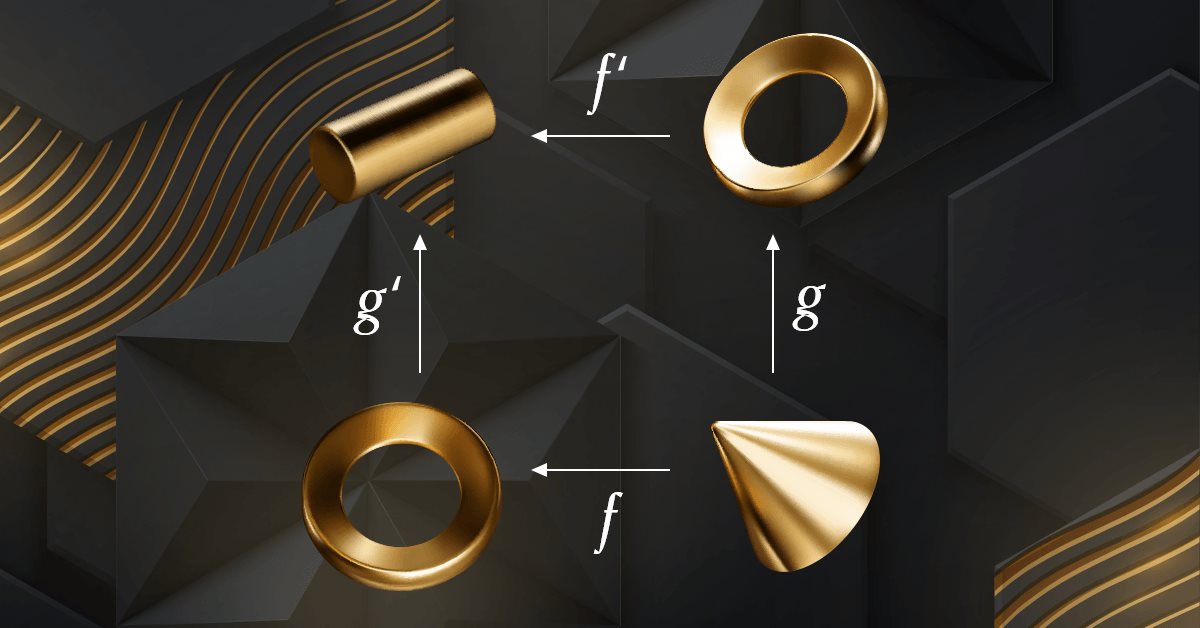
Teoría de Categorías en MQL5 (Parte 6): Productos fibrados monomórficos y coproductos fibrados epimórficos
La teoría de categorías es un apartado diverso y en expansión de las matemáticas, que solo recientemente ha comenzado a ser trabajado por la comunidad MQL5. Esta serie de artículos tiene por objetivo repasar algunos de sus conceptos para crear una biblioteca abierta y seguir usando este maravilloso apartado en la creación de estrategias comerciales.


Implementación en MQL5 de la prueba de Augmented Dickey-Fuller (ADF)
En este artículo demostramos la implementación de la prueba Dickey-Fuller aumentada (ADF, por sus siglas en inglés), y la aplicamos para realizar pruebas de cointegración utilizando el método Engle-Granger.


Utilización del modelo de aprendizaje automático CatBoost como filtro para estrategias de seguimiento de tendencias
CatBoost es un potente modelo de aprendizaje automático basado en árboles que se especializa en la toma de decisiones basada en características estacionarias. Otros modelos basados en árboles, como XGBoost y Random Forest, comparten características similares en cuanto a su solidez, capacidad para manejar patrones complejos e interpretabilidad. Estos modelos tienen una amplia gama de usos, desde el análisis de características hasta la gestión de riesgos. En este artículo, vamos a explicar el procedimiento para utilizar un modelo CatBoost entrenado como filtro para una estrategia clásica de seguimiento de tendencias con cruce de medias móviles.


Desarrollamos un asesor experto para controlar los puntos de entrada en las operaciones swing
A medida que el año se acerca a su fin, los tráders a largo plazo suelen hacer balance del año, analizando la historia, el comportamiento y las tendencias del mercado para evaluar el potencial de los movimientos futuros. En este artículo, analizaremos el desarrollo de un asesor experto para el seguimiento de operaciones a largo plazo utilizando MQL5. El objetivo será hacer frente a problemas como la pérdida de oportunidades comerciales debido al trading manual y a la falta de sistemas de supervisión automatizados. Como ejemplo de definición eficaz de una estrategia para nuestra solución y también para desarrollar la misma, utilizaremos uno de los pares comerciales más destacados.


Desarrollo de un sistema de repetición — Simulación de mercado (Parte 14): Nacimiento del SIMULADOR (IV)
En este artículo, continuaremos con la fase de desarrollo del simulador. Sin embargo, ahora veremos cómo crear efectivamente un movimiento del tipo "RANDOM WALK" (paseo aleatorio). Este tipo de movimiento es bastante intrigante, ya que sirve de base para todo lo que sucede en el mercado de capitales. Además, comenzarás a comprender algunos conceptos esenciales para quienes realizan análisis de mercado.

Clústeres de series temporales en inferencia causal
Los algoritmos de agrupamiento en el aprendizaje automático son importantes algoritmos de aprendizaje no supervisado que pueden dividir los datos originales en grupos con observaciones similares. Utilizando estos grupos, puede analizar el mercado de un grupo específico, buscar los grupos más estables utilizando nuevos datos y hacer inferencias causales. El artículo propone un método original de agrupación de series temporales en Python.


Pronosticamos barras Renko con ayuda de IA CatBoost
¿Cómo utilizar las barras Renko junto con la IA? Hoy analizaremos el trading Renko en Fórex con una precisión de previsión del 59,27%. Asimismo, exploraremos las ventajas de las barras Renko para filtrar el ruido del mercado, aprenderemos por qué los indicadores de volumen son más importantes que los patrones de precios y cómo establecer el tamaño óptimo del bloque Renko para el EURUSD. s decir, veremos una guía paso a paso para integrar CatBoost, Python y MetaTrader 5 para crear nuestro propio sistema de previsión Forex Renko. Resulta ideal para tráders que buscan ir más allá del análisis técnico tradicional.


Hibridación de algoritmos basados en poblaciones. Esquema secuencial y paralelo
En este artículo, nos sumergiremos en el mundo de la hibridación de algoritmos de optimización analizando tres tipos clave: la mezcla de estrategias y la hibridación secuencial y paralela. Asimismo, realizaremos una serie de experimentos combinando y probando los algoritmos de optimización correspondientes.


Análisis angular de los movimientos de precios: un modelo híbrido para predecir los mercados financieros
¿Qué es el análisis angular de los mercados financieros? ¿Cómo usar los ángulos de precios y el aprendizaje automático para predecir con una exactitud de 67? ¿Cómo combinar un modelo de regresión y clasificación con características angulares y obtener un algoritmo que funcione? ¿Qué tiene que ver Gann con esto? ¿Por qué los ángulos de movimiento de los precios son una buena señal para el aprendizaje automático?

Teoría de categorías en MQL5 (Parte 15): Funtores con grafos
El artículo continúa la serie sobre la implementación de la teoría de categorías en MQL5, analizando los funtores como un puente entre grafos y conjuntos. Volveremos nuevamente a los datos del calendario y, a pesar de sus limitaciones en el uso de un simulador de estrategias, justificaremos el uso de funtores para predecir la volatilidad mediante la correlación.


Visión por computadora para el trading (Parte 1): Creamos una funcionalidad básica sencilla
Sistema de previsión de EURUSD mediante visión por computadora y aprendizaje profundo. Descubra cómo las redes neuronales convolucionales pueden reconocer patrones de precios complejos en el mercado de divisas y predecir la evolución de los tipos con una precisión de hasta el 54%. El artículo revela la metodología de creación de un algoritmo que usa tecnologías de inteligencia artificial para analizar visualmente los gráficos en lugar de los indicadores técnicos tradicionales. El autor muestra el proceso de transformación de los datos de precios en "imágenes", su procesamiento por una red neuronal y una visión única de la "conciencia" de la IA a través de mapas de activación y mapas de calor de la atención. El práctico código Python que utiliza la biblioteca MetaTrader 5 permite a los lectores reproducir el sistema y aplicarlo a sus propias transacciones.

Desarrollo de un sistema de repetición — Simulación de mercado (Parte 05): Vistas previas
Hemos logrado desarrollar una forma de ejecutar la repetición de mercado de manera bastante realista y aceptable. Ahora, vamos a continuar con nuestro proyecto y agregar datos para mejorar el comportamiento de la repetición.

Desarrollo de un sistema de repetición (Parte 33): Sistema de órdenes (II)
Vamos a continuar el desarrollo del sistema de órdenes, pero verás que haremos una reutilización masiva de cosas ya vistas en otros artículos. Aun así, tendremos una pequeña recompensa en este artículo. Desarrollaremos, en primer lugar, un sistema que pueda ser operado junto al servidor de negociación real, ya sea usando una cuenta demo o una cuenta real. Haremos uso masivo y extensivo de la plataforma MetaTrader 5 para proporcionarnos todo el soporte que necesitaremos en este inicio de viaje.

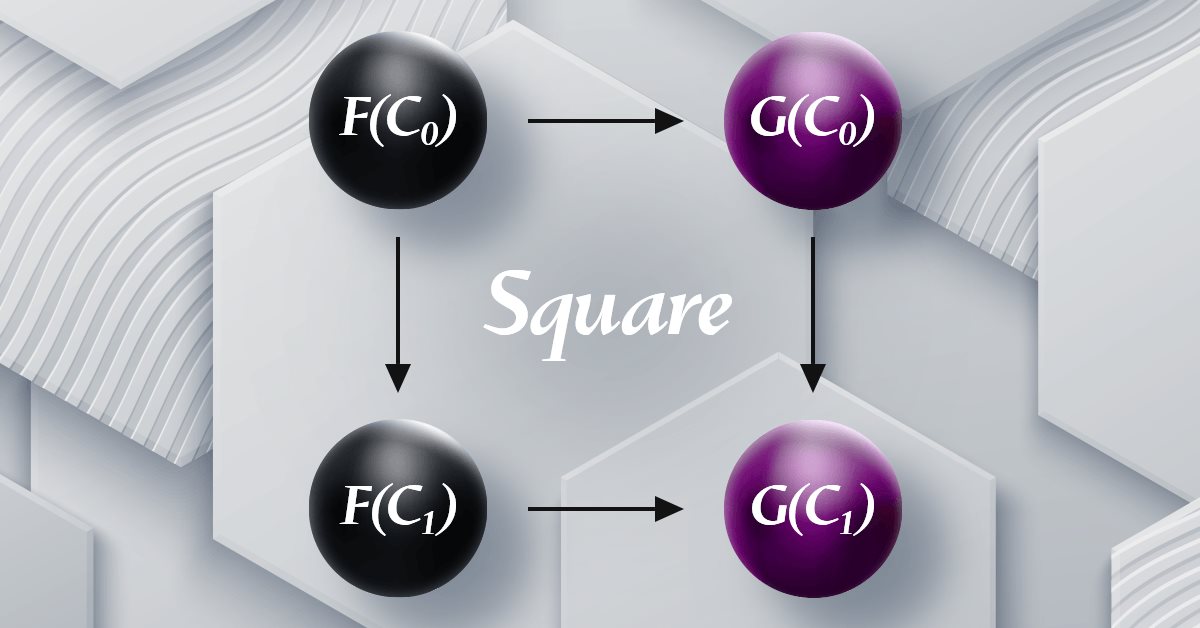
Teoría de categorías en MQL5 (Parte 19): Inducción cuadrática de la naturalidad
Continuamos analizando las transformaciones naturales considerando la inducción cuadrática de la naturalidad. Pequeñas restricciones en la implementación de las capacidades multidivisa para los asesores ensamblados usando el wizard MQL5 significan que estamos demostrando nuestras capacidades en la clasificación de datos usando un script. Las principales áreas de aplicación son la clasificación de las variaciones de precios y, como consecuencia, su previsión.


Desarrollo de un sistema de repetición — Simulación de mercado (Parte 13): Nacimiento del SIMULADOR (III)
Aquí optimizaremos un poco las cosas para facilitar lo que haremos en el próximo artículo. Y también te explicaré cómo puedes visualizar lo que está generando el simulador en términos de aleatoriedad.

Algoritmo de optimización Brain Storm - Brain Storm Optimization (Parte I): Clusterización
En este artículo analizaremos un innovador método de optimización denominado BSO (Brain Storm Optimization), inspirado en el fenómeno natural de la tormenta de ideas. También discutiremos un nuevo enfoque de resolución de tareas de optimización multimodales que utiliza el método BSO y nos permite encontrar múltiples soluciones óptimas sin tener que determinar de antemano el número de subpoblaciones. En este artículo, también analizaremos los métodos de clusterización K-Means y K-Means++.

Operar con noticias de manera sencilla (Parte 1): Creando una base de datos
Operar con noticias puede ser complicado y abrumador, en este artículo repasaremos los pasos para obtener datos de noticias. Además, conoceremos el calendario económico de MQL5 y lo que ofrece.


Teoría de Categorías en MQL5 (Parte 23): Otra mirada a la media móvil exponencial doble
En este artículo, seguiremos analizando desde un nuevo ángulo los indicadores comerciales más populares. Vamos a procesar una composición horizontal de transformaciones naturales. El mejor indicador para ello será la media móvil exponencial doble (Double Exponential Moving Average, DEMA).

Algoritmo de optimización de reacciones químicas (CRO) (Parte II): Ensamblaje y resultados
En la segunda parte, reuniremos los operadores químicos en un único algoritmo y presentaremos un análisis detallado de sus resultados. Descubramos cómo el método de optimización de reacciones químicas (CRO) aborda la solución de problemas complejos en funciones de prueba.

Ingeniería de características con Python y MQL5 (Parte I): Predicción de medias móviles para modelos de IA de largo plazo
Las medias móviles son, con diferencia, los mejores indicadores para que nuestros modelos de IA realicen predicciones. Sin embargo, podemos mejorar aún más nuestra precisión transformando cuidadosamente nuestros datos. Este artículo le mostrará cómo puede crear modelos de IA capaces de realizar previsiones a más largo plazo que las que realiza actualmente sin que ello suponga una disminución significativa de su nivel de precisión. Es realmente sorprendente lo útiles que son las medias móviles.


Modelos ocultos de Márkov en sistemas comerciales de aprendizaje automático
Los modelos ocultos de Márkov (HMM) son una potente clase de modelos probabilísticos diseñados para analizar datos secuenciales, donde los eventos observados dependen de alguna secuencia de estados no observados (ocultos) que forman un proceso de Márkov. Los principales supuestos del HMM incluyen la propiedad de Márkov para estados ocultos, lo que significa que la probabilidad de transición al siguiente estado depende solo del estado actual y la independencia de las observaciones dado el conocimiento del estado oculto actual.


Desarrollo de un sistema de repetición (Parte 40): Inicio de la segunda fase (I)
Esta es la nueva fase del sistema de repetición/simulación. En esta etapa, la conversación será realmente una conversación, y el contenido se volverá bastante denso. Les insto a leer el artículo con atención y a utilizar siempre las referencias que se proporcionen. Esto les ayudará a comprender mejor lo que se les está explicando.

Integración de MQL5 con paquetes de procesamiento de datos (Parte 1): Análisis avanzado de datos y procesamiento estadístico
La integración permite un flujo de trabajo continuo en el que los datos financieros sin procesar de MQL5 se pueden importar a paquetes de procesamiento de datos como Jupyter Lab para realizar análisis avanzados que incluyen pruebas estadísticas.

Arbitraje estadístico mediante reversión a la media en el trading de pares: Cómo superar al mercado con matemáticas
Este artículo describe los fundamentos del arbitraje estadístico a nivel de cartera. Su objetivo es facilitar la comprensión de los principios del arbitraje estadístico a lectores sin conocimientos matemáticos profundos y proponer un marco conceptual de partida. El artículo incluye un Asesor Experto en funcionamiento, algunas notas sobre su prueba retrospectiva de un año y las respectivas configuraciones de prueba retrospectiva (archivo .ini) para la reproducción del experimento.


Características del Wizard MQL5 que debe conocer (Parte 07): Dendrogramas
La clasificación de datos para el análisis y la predicción es un área muy diversa del aprendizaje automático con un gran número de enfoques y métodos. En este artículo analizaremos uno de estos enfoques, a saber, la Clasificación Jerárquica Aglomerativa (Agglomerative Hierarchical Classification).

Asesor Experto Grid-Hedge Modificado en MQL5 (Parte IV): Optimización de la estrategia de cuadrícula simple (I)
En esta cuarta parte, revisamos los asesores expertos (EA) Simple Hedge y Simple Grid desarrollados anteriormente. Nuestro enfoque se centra en perfeccionar Simple Grid EA a través del análisis matemático y un enfoque de fuerza bruta, apuntando al uso óptimo de la estrategia. Este artículo profundiza en la optimización matemática de la estrategia, preparando el escenario para la futura exploración de la optimización basada en codificación en entregas posteriores.