
Aprendizado de Máquina e Data Science (Parte 43): Identificação de padrões ocultos em indicadores com modelos de misturas gaussianas latentes (LGMM)
 25
 0

Sumário
- Introdução
- Modelo de misturas gaussianas latentes (Latent Gaussian Mixture Model, LGMM)
- Fundamentos matemáticos do LGMM
- Treinamento do LGMM com dados de indicadores
- Indicador MQL5 baseado no LGMM
- Como determinar o número ideal de componentes para o LGMM
- Combinação do modelo de misturas gaussianas latentes com um classificador
- Robô de negociação baseado no LGMM
- Conclusão
Introdução
Quase todas as estratégias que utilizamos para negociar se baseiam na identificação de determinados padrões. Analisamos indicadores em busca de regularidades e sinais de confirmação, além de inserir objetos gráficos e traçar linhas de suporte e resistência, para avaliar as condições atuais do mercado.
No entanto, identificar padrões nos mercados financeiros é uma tarefa mais simples para o ser humano do que para um programa. Automatizar essa identificação é muito mais difícil devido à própria natureza dos mercados, caracterizados por ruído e comportamento caótico.
Para enfrentar esse desafio, alguns passaram a recorrer à inteligência artificial (AI) e ao aprendizado de máquina, utilizando, por exemplo, técnicas de visão computacional que analisam imagens e dados de forma semelhante à maneira como os seres humanos interpretam essas informações, tema que já abordamos em um dos artigos anteriores.
Neste artigo, vamos explorar um modelo probabilístico chamado Latent Gaussian Mixture Model (LGMM, modelo de misturas gaussianas latentes), capaz de detectar padrões. Com dados de indicadores, avaliaremos sua eficácia para revelar regularidades ocultas e na geração de previsões precisas para os mercados financeiros.
Modelo de misturas gaussianas latentes (Latent Gaussian Mixture Model, LGMM)
O Latent Gaussian Mixture Model é um modelo probabilístico que parte da hipótese de que os dados são gerados por uma mistura de várias distribuições gaussianas, cada uma associada a uma variável oculta (latente).
O LGMM é uma extensão do Gaussian Mixture Model (GMM, modelo de misturas gaussianas). Nessa formulação, as variáveis latentes indicam a qual cluster cada observação pertence.
Os modelos gaussianos latentes são utilizados para analisar dados quando os processos que geram as observações não são observados diretamente e, por hipótese, seguem uma distribuição gaussiana (normal).
O termo latent se refere justamente a essas variáveis não observáveis. Podemos compará-las a sinais elétricos invisíveis em um circuito, que influenciam o comportamento do sistema, mas não são medidos diretamente.
Nos mercados financeiros, essas variáveis latentes podem representar padrões de negociação que permanecem ocultos nos dados e que muitas vezes interpretamos incorretamente ou sequer percebemos.
Em termos simples, o LGMM é composto pelos seguintes elementos fundamentais:
- Variáveis latentes (ocultas)São variáveis não observáveis que, por hipótese, seguem uma distribuição gaussiana. Representam fatores ocultos que influenciam os dados observados.
- ObservaçõesSão os dados efetivamente coletados, que geralmente não seguem uma distribuição gaussiana. Esses dados podem ser descritos por diferentes modelos estatísticos e estão relacionados às variáveis latentes por meio de uma função conhecida.
- ParâmetrosOs parâmetros definem a relação entre as variáveis latentes e as observações e incluem as médias e variâncias das respectivas distribuições.
Fundamentos matemáticos do LGMM
O LGMM é um modelo generativo probabilístico que utiliza clusterização para agrupar as observações. Seus principais elementos são:
Variáveis latentes
- Não são observadas diretamente;
- Indicam o componente (cluster) do qual uma determinada observação foi gerada;
- Geralmente são modeladas por uma distribuição categórica (discreta), por exemplo:
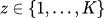
Modelo de mistura
A distribuição de probabilidade dos dados é representada por uma soma ponderada de várias distribuições gaussianas.
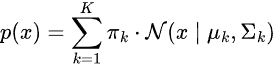
em que:
 O coeficiente de mistura representa a probabilidade a priori de cada componente
 ;

 A distribuição gaussiana é definida por uma média
 e uma matriz de covariância

.
Representação por variáveis latentes
Em vez de modelar diretamente p(x), utilizamos a seguinte representação:
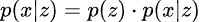
em que:

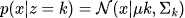
O objetivo do modelo é estimar as variáveis latentes e os parâmetros correspondentes .
O método mais utilizado para estimar esses parâmetros é o algoritmo Expectation-Maximization (EM).
Algoritmo Expectation-Maximization (EM) para o LGMM
O algoritmo consiste em duas etapas principais: cálculo das expectativas (Expectation) e maximização (Maximization).
Etapa 01: Expectation
Nessa etapa, calcula-se a probabilidade a posteriori de cada observação pertencer a cada uma das distribuições gaussianas.
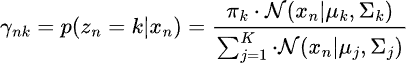
Etapa 02: Maximization
Nessa etapa, os parâmetros do modelo são atualizados com base nos valores calculados .
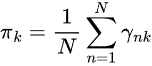
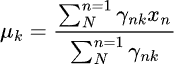
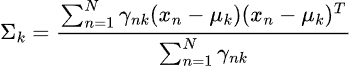
Durante o treinamento, as etapas 01 e 02 são repetidas até que o modelo atinja a convergência.
O LGMM é utilizado em diversas aplicações práticas, incluindo clusterização com atribuição probabilística aos clusters (soft clustering), detecção de anomalias, estimação de densidade de probabilidade e reconhecimento de fala.
Treinamento do LGMM com dados de indicadores
Sabemos que os indicadores contêm padrões que ajudam os traders a tomar decisões mais embasadas no mercado. Vamos utilizar o LGMM para tentar identificar esses padrões.
Primeiro, vamos coletar os dados dos indicadores no MetaTrader 5 utilizando código MQL5.
- Symbol = XAUUSD.
- Timeframe = DAILY.
Nome do arquivo: Get XAUUSD Data.mq5
#include <Arrays\ArrayString.mqh>
#include <Arrays\ArrayObj.mqh>
#include <pandas.mqh> //https://www.mql5.com/en/articles/17030

input datetime start_date = D'2005.01.01';
input datetime end_date = D'2023.01.01';

input string symbol = "XAUUSD";
input ENUM_TIMEFRAMES timeframe = PERIOD_D1;

struct indicator_struct
 {
   long handle;
   CArrayString buffer_names; //buffer_names array
 };

indicator_struct indicators[15]; //Structure for keeping indicator handle alongside its buffer names
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//---

   vector time, open, high, low, close;
   if (!SymbolSelect(symbol, true))
      {
         printf("%s failed to select symbol %s, Error = %d",__FUNCTION__,symbol,GetLastError());
         return;
      }

 //---

   time.CopyRates(symbol, timeframe, COPY_RATES_TIME, start_date, end_date);
   open.CopyRates(symbol, timeframe, COPY_RATES_OPEN, start_date, end_date);
   high.CopyRates(symbol, timeframe, COPY_RATES_HIGH, start_date, end_date);
   low.CopyRates(symbol, timeframe, COPY_RATES_LOW, start_date, end_date);
   close.CopyRates(symbol, timeframe, COPY_RATES_CLOSE, start_date, end_date);

   CDataFrame df;

   df.insert("Time", time);
   df.insert("Open", open);
   df.insert("High", high);
   df.insert("Low", low);
   df.insert("Close", close);

//--- Oscillators

   indicators[0].handle = iATR(symbol, timeframe, 14);
   indicators[0].buffer_names.Add("ATR");

   indicators[1].handle = iBearsPower(symbol, timeframe, 13);
   indicators[1].buffer_names.Add("BearsPower");

   indicators[2].handle = iBullsPower(symbol, timeframe, 13);
   indicators[2].buffer_names.Add("BullsPower");

   indicators[3].handle = iChaikin(symbol, timeframe, 3, 10, MODE_EMA, VOLUME_TICK);
   indicators[3].buffer_names.Add("Chainkin");

   indicators[4].handle = iCCI(symbol, timeframe, 14, PRICE_OPEN);
   indicators[4].buffer_names.Add("CCI");

   indicators[5].handle = iDeMarker(symbol, timeframe, 14);
   indicators[5].buffer_names.Add("Demarker");

   indicators[6].handle = iForce(symbol, timeframe, 13, MODE_SMA, VOLUME_TICK);
   indicators[6].buffer_names.Add("Force");

   indicators[7].handle = iMACD(symbol, timeframe, 12, 26, 9, PRICE_OPEN);
   indicators[7].buffer_names.Add("MACD MAIN_LINE");
   indicators[7].buffer_names.Add("MACD SIGNAL_LINE");

   indicators[8].handle = iMomentum(symbol, timeframe, 14, PRICE_OPEN);
   indicators[8].buffer_names.Add("Momentum");

   indicators[9].handle = iOsMA(symbol, timeframe, 12, 26, 9, PRICE_OPEN);
   indicators[9].buffer_names.Add("OsMA");

   indicators[10].handle = iRSI(symbol, timeframe, 14, PRICE_OPEN);
   indicators[10].buffer_names.Add("RSI");

   indicators[11].handle = iRVI(symbol, timeframe, 10);
   indicators[11].buffer_names.Add("RVI MAIN_LINE");
   indicators[11].buffer_names.Add("RVI SIGNAL_LINE");

   indicators[12].handle = iStochastic(symbol, timeframe, 5, 3,3,MODE_SMA,STO_LOWHIGH);
   indicators[12].buffer_names.Add("StochasticOscillator MAIN_LINE");
   indicators[12].buffer_names.Add("StochasticOscillator SIGNAL_LINE");

   indicators[13].handle = iTriX(symbol, timeframe, 14, PRICE_OPEN);
   indicators[13].buffer_names.Add("TEMA");

   indicators[14].handle = iWPR(symbol, timeframe, 14);
   indicators[14].buffer_names.Add("WPR");

//--- Get buffers

   for (uint ind=0; ind<indicators.Size(); ind++) //Loop through all the indicators
      {
         for (uint buffer_no=0; buffer_no<(uint)indicators[ind].buffer_names.Total(); buffer_no++) //Their buffer names resemble their buffer numbers
            {
               string name = indicators[ind].buffer_names.At(buffer_no); //Get the name of the buffer, it is helpful for the DataFrame and CSV file

               vector buffer = {};
               if (!buffer.CopyIndicatorBuffer(indicators[ind].handle, buffer_no, start_date, end_date)) //Copy indicator buffer
                  {
                     printf("func=%s line=%d | Failed to copy %s indicator buffer, Error = %d",__FUNCTION__,__LINE__,name,GetLastError());
                     continue;
                  }

               df.insert(name, buffer); //Insert a buffer vector and its name to a dataframe object
            }
      }

   df.to_csv(StringFormat("Oscillators.%s.%s.csv",symbol,EnumToString(timeframe)), true); //Save all the data to a CSV file
  }
Resultados.
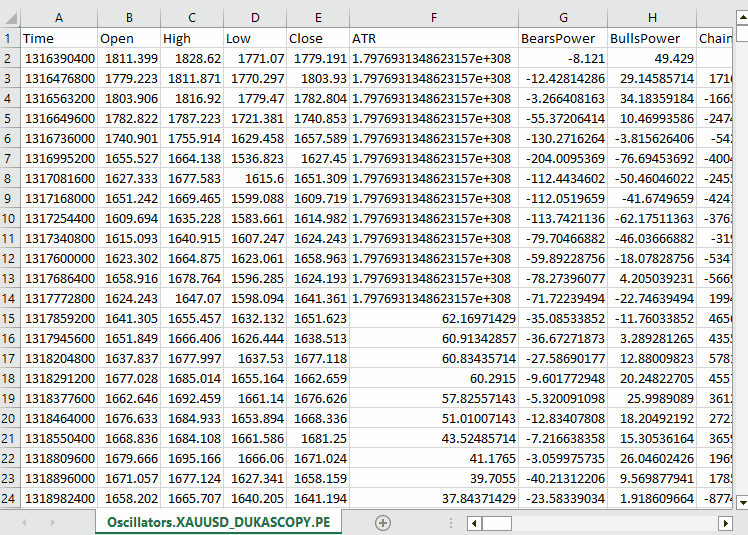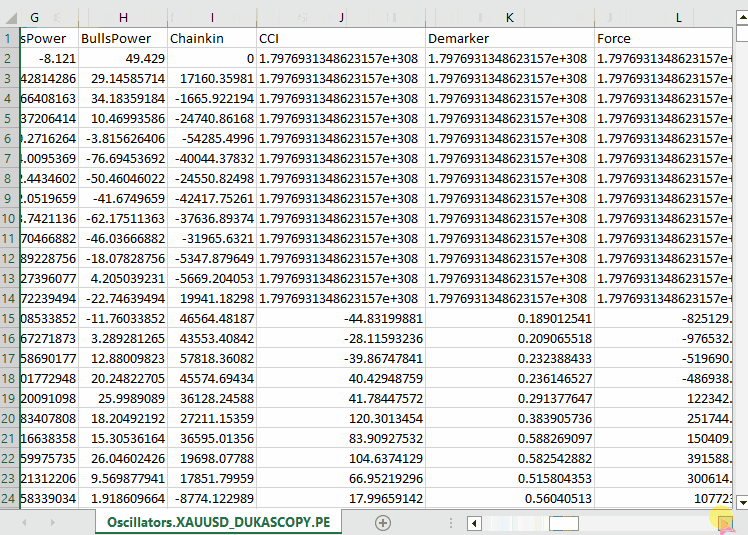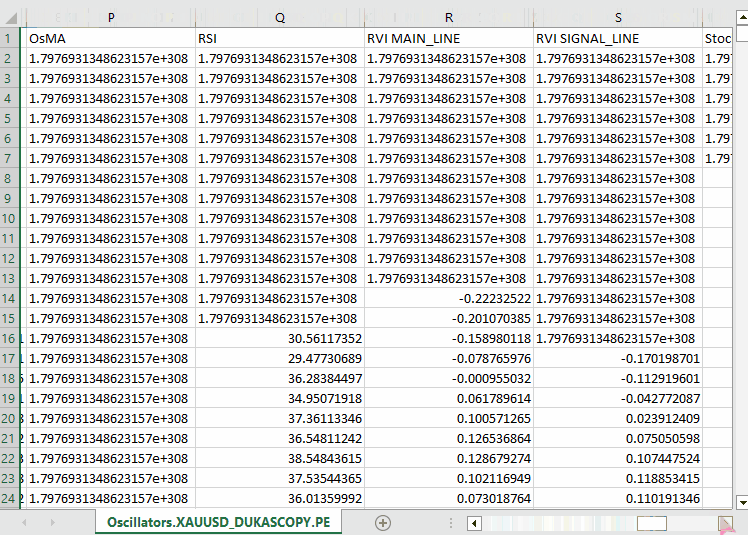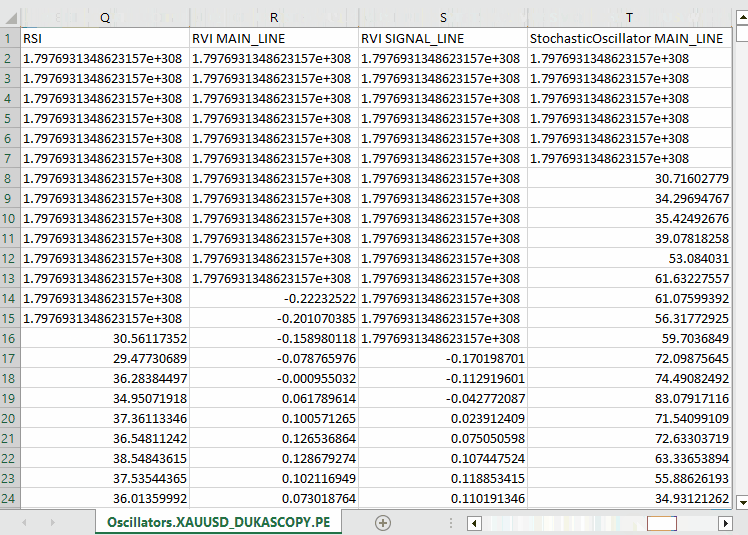
Observe que coletamos praticamente todos os osciladores integrados ao MQL5. A maioria deles gera dados estacionários, pois normalmente apresenta valores mínimos e máximos fixos. Por exemplo, o indicador RSI assume valores entre 0 e 100.
O LGMM consegue trabalhar com dados de diferentes propriedades estatísticas, incluindo dados não estacionários. Ainda assim, ao utilizar dados estacionários, é mais fácil para o modelo identificar estruturas e padrões significativos, pois as propriedades estatísticas das séries temporais estacionárias permanecem constantes ao longo do tempo.
Você pode utilizar quaisquer outros dados.
Além dos dados dos indicadores, também coletamos as variáveis Open, High, Low, Close e Time (OHLCT) para utilizar no treinamento. Esses dados podem ser utilizados para visualização e para construir a variável-alvo em modelos preditivos de aprendizado de máquina, além do LGMM.
No script Python (Jupyter Notebook), primeiro importamos as dependências e inicializamos as aplicações e, em seguida, carregamos os dados coletados.
Nome do arquivo: main.ipynb
import pandas as pd
import numpy as np
import MetaTrader5 as mt5
import os
from Trade.TerminalInfo import CTerminalInfo
import matplotlib.pyplot as plt
import seaborn
import warnings

warnings.filterwarnings("ignore")
seaborn.set_style("darkgrid")

if not mt5.initialize():
    print("Failed to Initialize MetaTrade5, Error = ",mt5.last_error())
    mt5.shutdown()


terminal = CTerminalInfo() # similarly to CTerminalInfo from MQL5. For getting information about the MetaTrader5 app
Importamos os dados da pasta compartilhada onde os salvamos.
common_path = os.path.join(terminal.common_data_path(), "Files")
symbol = "XAUUSD"
timeframe = "PERIOD_D1"

df = pd.read_csv(os.path.join(common_path, f"Oscillators.{symbol}.{timeframe}.csv")) # the same naming pattern as the one used in the MQL5 script

# Identify max float value
max_float = np.finfo(float).max

# Replace all max float (double) values with NaN produced by preliminary indicator calculations
df = df.replace(max_float, np.nan)
df.dropna(inplace=True)
df["Time"] = pd.to_datetime(df["Time"], unit="s")

df.head()
Resultados.
        Time    Open    High    Low     Close   ATR     BearsPower      BullsPower      Chainkin        CCI     ...     MACD SIGNAL_LINE        Momentum        OsMA    RSI     RVI MAIN_LINE   RVI SIGNAL_LINE StochasticOscillator MAIN_LINE  StochasticOscillator SIGNAL_LINE        TEMA    WPR
0       2005-01-03      438.45  438.71  426.72  429.55  5.481429        -12.314215      -0.324215       -1079.046551    -51.013015      ...     0.175727        99.870165       -0.582169       46.666555       -0.082596       0.018515        26.976532       32.920132       -0.000089       -85.144357
1       2005-01-04      429.52  430.18  423.71  427.51  5.450000        -13.677899      -7.207899       -1129.324384    -235.622347     ...     -0.000779       98.615544       -1.252741       37.393138       -0.158362       -0.048541       22.158658       27.150101       -0.000190       -82.774252
2       2005-01-05      427.50  428.77  425.10  426.58  5.162143        -10.743913      -7.073913       -1496.644248    -196.837418     ...     -0.247283       97.044402       -1.816758       35.666584       -0.227422       -0.119850       17.070979       22.068723       -0.000325       -86.990027
3       2005-01-06      426.31  427.85  420.17  421.37  5.234286        -13.606211      -5.926211       -3349.884147    -164.038728     ...     -0.576309       97.480164       -2.194161       34.651526       -0.269634       -0.187300       14.096364       17.775334       -0.000482       -95.312500
4       2005-01-07      421.39  425.48  416.57  419.02  5.605000        -15.098181      -6.188181       -4970.426959    -168.301515     ...     -1.015433       95.440750       -2.669414       30.754440       -0.305796       -0.243045       11.442611       14.203318       -0.000670       -91.609589
Vamos preparar a variável-alvo para a tarefa de classificação, para utilizá-la posteriormente em modelos de aprendizado de máquina destinados à criação de classificadores. Removemos as características que não correspondem a indicadores.
lookahead = 1

df["future_close"] = df["Close"].shift(-lookahead)
new_df = df.dropna()

new_df["Direction"] = np.where(new_df["future_close"]>new_df["Close"], 1, -1) # if a the close value in the next bar(s)=lookahead is above the current close price, thats a long signal otherwise that's a short signal
from sklearn.model_selection import train_test_split

X = new_df.drop(columns=[
    "Time",
    "Open",
    "High",
    "Low",
    "Close",
    "future_close",
    "Direction"
])

y = new_df["Direction"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, shuffle=True, random_state=42)
Precisamos verificar se temos os dados dos indicadores necessários.
X_train.head()
Resultados.
        ATR     BearsPower      BullsPower      Chainkin        CCI     Demarker        MACD MAIN_LINE  MACD SIGNAL_LINE        Momentum        OsMA    RSI     RVI MAIN_LINE   RVI SIGNAL_LINE StochasticOscillator MAIN_LINE  StochasticOscillator SIGNAL_LINE        TEMA    WPR
1057    30.139286       34.958195       62.858195       16280.794393    268.371098      251356.076923   -1.759289       -15.645899      107.768519      13.886610       62.077386       0.229591        0.108028        92.301971       83.886543       -0.002663       -8.048595
3806    3.096429        0.724299        3.314299        -1279.189840    69.806094       696.923077      -0.121217       -0.952863       100.299538      0.831645        52.157089       0.096237        0.080054        67.031250       71.466497       -0.000077       -21.325052
38884   5.927143        -8.488258       -3.858258       -2005.866698    -213.672289     -3333.080000    -0.049837       0.496440        99.774916       -0.546277       39.550361       -0.022395       0.035070        28.046540       49.606252       0.000012        -73.130342
10351   2.060714        -0.491108       1.158892        723.246254      40.384615       2508.735385     1.293179        0.953618        100.533084      0.339561        58.791715       0.217352        0.294053        57.239819       69.770534       0.000123        -19.070322
38170   5.632143        -5.682364       -3.262364       -1321.008995    -109.039933     -1673.607692    -0.609996       0.785433        99.712893       -1.395429       41.917705       -0.062258       -0.053202       13.322009       9.490964        0.000035        -77.826942
Por fim, vamos treinar o modelo LGMM.
from sklearn.mixture import GaussianMixture
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType

components = 3

gmm = GaussianMixture(n_components=components, covariance_type="full", random_state=42)
gmm.fit(X_train)

latent_features_train = gmm.predict_proba(X_train)
latent_features_test = gmm.predict_proba(X_test)
Utilizo 3 componentes para o modelo Gaussian Mixture, supondo que ele conseguirá agrupar os padrões observados nos indicadores em 3 clusters. Supostamente, um cluster corresponde a uma tendência de alta (sinal de compra), outro a um sinal de baixa e o terceiro a uma consolidação ou movimento lateral.No entanto, isso é apenas uma suposição.
Assim como em outros métodos de aprendizado não supervisionado e clusterização, interpretar os componentes obtidos pelo modelo é bastante difícil. Por enquanto, só podemos supor que cada componente corresponde a uma das três classes descritas.
Provavelmente, você está se perguntando por que chamo o modelo de Latent Gaussian Mixture Model (LGMM), embora eu esteja utilizando o modelo GaussianMixture da biblioteca Scikit-Learn.
O modelo GaussianMixture importado é funcionalmente equivalente ao LGMM descrito na seção matemática deste artigo. Em teoria, trata-se do mesmo modelo.
Vamos exibir o array latent_features_train.
latent_features_train
Resultados.
array([[9.48947877e-13, 1.08107288e-62, 1.00000000e+00],
       [9.71935407e-01, 2.80542130e-02, 1.03801388e-05],
       [5.35722226e-03, 9.94642667e-01, 1.10916653e-07],
       ...,
       [7.72441751e-08, 8.80712550e-41, 9.99999923e-01],
       [9.99975623e-01, 1.07924534e-33, 2.43771745e-05],
       [1.91968188e-01, 8.08030586e-01, 1.22621110e-06]], shape=(3760, 3))
O modelo LGMM gerou um array com três elementos para cada linha de previsão. Cada coluna corresponde a um dos três clusters e contém, para cada linha, a probabilidade de a observação pertencer a esse cluster. Em cada linha, a soma das probabilidades das três colunas é igual a 1.
Como esses valores ainda são difíceis de interpretar diretamente, vamos converter o modelo para o formato ONNX, visualizar os clusters no MQL5 e avaliar o que os resultados desse modelo probabilístico revelam.
Indicador MQL5 baseado no Latent Gaussian Mixture Model (LGMM)
Primeiro, vamos salvar o LGMM no formato ONNX.
# Define input type (shape should match your training data)
initial_type = [("float_input", FloatTensorType([None, X_train.shape[1]]))]

# Convert the pipeline to ONNX format
onnx_model = convert_sklearn(gmm, initial_types=initial_type)

# Save the model to a file
with open(os.path.join(common_path, f"LGMM.{symbol}.{timeframe}.onnx"), "wb") as f:
    f.write(onnx_model.SerializeToString())
A seguir, apresentamos a arquitetura do modelo visualizada no Netron.
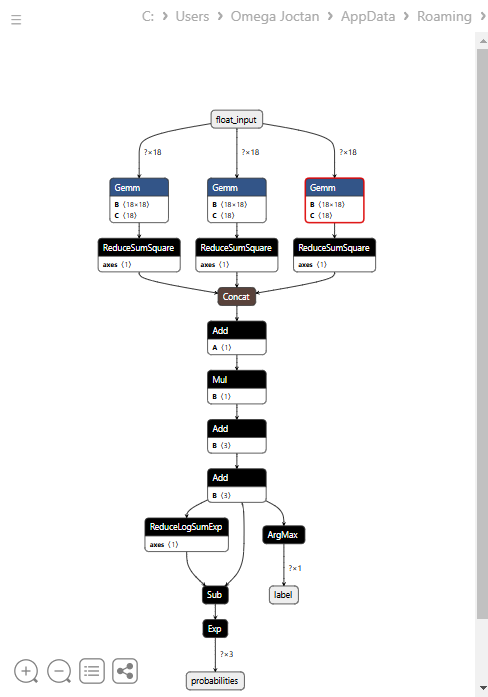
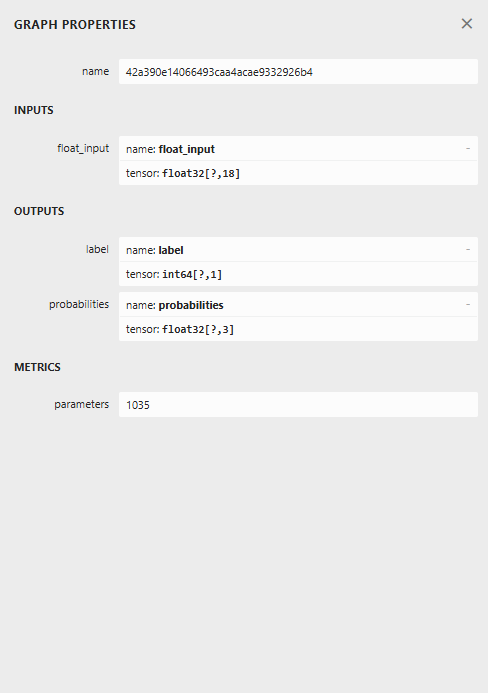
A arquitetura do modelo apresenta uma característica incomum: o nó final possui duas saídas, uma para o rótulo previsto e outra para as probabilidades. Precisamos levar isso em consideração ao implementar o código de carregamento do modelo no MQL5.
Carregamento do LGMM no MQL5
Arquivo: Gaussian Mixture.mqh
Precisaremos de uma estrutura capaz de receber e armazenar os dois arrays de resultados, um para cada saída do modelo.
class CGaussianMixture
  {
protected:

   bool initialized;
   long onnx_handle;
   void PrintTypeInfo(const long num,const string layer,const OnnxTypeInfo& type_info);

   ulong inputs[]; //Inputs of a model in dimensions [nxn]
   struct outputs_struct
    {
      ulong outputs[];
    } model_output_structure[];  //Outputs of the model structure array
Em seguida.
bool CGaussianMixture::OnnxLoad(long &handle)
 {
//--- since not all sizes defined in the input tensor we must set them explicitly
//--- first index - batch size, second index - series size, third index - number of series (only Close)

   OnnxTypeInfo type_info; //Getting onnx information for Reference In case you forgot what the loaded ONNX is all about

   long input_count=OnnxGetInputCount(handle);
   if (MQLInfoInteger(MQL_DEBUG))
      Print("model has ",input_count," input(s)");

   for(long i=0; i<input_count; i++)
     {
      string input_name=OnnxGetInputName(handle,i);
      if (MQLInfoInteger(MQL_DEBUG))
         Print(i," input name is ",input_name);

      if(OnnxGetInputTypeInfo(handle,i,type_info))
        {
          if (MQLInfoInteger(MQL_DEBUG))
            PrintTypeInfo(i,"input",type_info);
          ArrayCopy(inputs, type_info.tensor.dimensions);
        }
     }

   long output_count=OnnxGetOutputCount(handle);
   if (MQLInfoInteger(MQL_DEBUG))
      Print("model has ",output_count," output(s)");

   ArrayResize(model_output_structure, (int)output_count);

   for(long i=0; i<output_count; i++)
     {
      string output_name=OnnxGetOutputName(handle,i);
      if (MQLInfoInteger(MQL_DEBUG))
         Print(i," output name is ",output_name);

      if(OnnxGetOutputTypeInfo(handle,i,type_info))
       {
         if (MQLInfoInteger(MQL_DEBUG))
            PrintTypeInfo(i,"output",type_info);

         ArrayCopy(model_output_structure[i].outputs, type_info.tensor.dimensions);
       }

       //--- Set the output shape

         replace(model_output_structure);
         if(!OnnxSetOutputShape(handle, i, model_output_structure[i].outputs))
          {
            if (MQLInfoInteger(MQL_DEBUG))
              {
                printf("Failed to set the Output[%d] shape Err=%d",i,GetLastError());
                DebugBreak();
              }

             return false;
          }
     }

//---

   replace(inputs);

//--- Setting the input size

   for (long i=0; i<input_count; i++)
     if (!OnnxSetInputShape(handle, i, inputs)) //Giving the Onnx handle the input shape
       {
         if (MQLInfoInteger(MQL_DEBUG))
           printf("Failed to set the input shape Err=%d",GetLastError());
         DebugBreak();
         return false;
       }


   initialized = true;
   if (MQLInfoInteger(MQL_DEBUG))
      Print("ONNX model Initialized");

   return true;
 }
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
bool CGaussianMixture::Init(string onnx_filename, uint flags=ONNX_DEFAULT)
 {
   onnx_handle = OnnxCreate(onnx_filename, flags);

   if (onnx_handle == INVALID_HANDLE)
     return false;

   return OnnxLoad(onnx_handle);
 }
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
bool CGaussianMixture::Init(const uchar &onnx_buff[], ulong flags=ONNX_DEFAULT)
 {
  onnx_handle = OnnxCreateFromBuffer(onnx_buff, flags); //creating onnx handle buffer

   if (onnx_handle == INVALID_HANDLE)
     return false;

  return OnnxLoad(onnx_handle);
 }
Implementamos nessa classe o método predict, que retorna dois valores em uma estrutura: o rótulo previsto e um vetor de probabilidades.
struct pred_struct
 {
   vector proba;
   long label;
 };
pred_struct CGaussianMixture::predict(const vector &x)
 {
   pred_struct res;

   if (!this.initialized)
    {
      if (MQLInfoInteger(MQL_DEBUG))
         printf("%s The model is not initialized yet to make predictions | call Init function first",__FUNCTION__);

      return res;
    }

//---

   vectorf x_float; //Convert inputs from a vector of double values to those float values
   x_float.Assign(x);

   vector label = vector::Zeros(model_output_structure[0].outputs[1]); //outputs[1] we get the second shape (columns) from an array
   vector proba = vector::Zeros(model_output_structure[1].outputs[1]); //outputs[1] we get the second shape (columns) from an array

   if (!OnnxRun(onnx_handle, ONNX_DATA_TYPE_FLOAT, x_float, label, proba)) //Run the model and get the predicted label and probability
     {
       if (MQLInfoInteger(MQL_DEBUG))
          printf("Failed to get predictions from Onnx err %d",GetLastError());

       DebugBreak();
       return res;
     }

//---

   res.label = (long)label[label.Size()-1]; //Get the last item available at the label's array
   res.proba = proba;

   return res;
 }
Vamos chamar o método predict dentro da função principal do indicador para obter os atributos latentes.
Arquivo: LGMM Indicator.mq5
int OnCalculate(const int32_t rates_total,
                const int32_t prev_calculated,
                const datetime &time[],
                const double &open[],
                const double &high[],
                const double &low[],
                const double &close[],
                const long &tick_volume[],
                const long &volume[],
                const int32_t &spread[])
  {
//--- Main calculation loop

   int lookback = 20;

   for (int i = prev_calculated; i < rates_total && !IsStopped(); i++)
   {
      if (i+1<lookback) //prevent data not found errors during copy buffer
         continue;

      int reverse_index = rates_total - 1 - i;

      //--- Get the indicators data

      vector x = getX(reverse_index, lookback);

      if (x.Size()==0)
         continue;

      pred_struct res = lgmm.predict(x);

      vector proba = res.proba;
      long label = res.label;

      ProbabilityBuffer[i] = proba.Max();

      // Determine color based on histogram value

      if (label == 0)
         ColorBuffer[i] = 0;
      else if (label == 1)
         ColorBuffer[i] = 1;
      else
         ColorBuffer[i] = 2;

      Comment("bars [",i+1,"/",rates_total,"]"," Proba: ",proba," label: ",label);
   }

//---
   return(rates_total);
  }
Na função getX(), precisamos reunir os buffers de todos os indicadores, exatamente como fizemos no script durante a coleta dos dados para o treinamento.
vector getX(uint start=0, uint count=10)
 {
//--- Get buffers

   CDataFrame df;
   for (uint ind=0; ind<indicators.Size(); ind++) //Loop through all the indicators
      {
        uint buffers_total = indicators[ind].buffer_names.Total();

         for (uint buffer_no=0; buffer_no<buffers_total; buffer_no++) //Their buffer names resemble their buffer numbers
            {
               string name = indicators[ind].buffer_names.At(buffer_no); //Get the name of the buffer, it is helpful for the DataFrame and CSV file

               vector buffer = {};
               if (!buffer.CopyIndicatorBuffer(indicators[ind].handle, buffer_no, start, count)) //Copy indicator buffer
                  {
                     printf("func=%s line=%d | Failed to copy %s indicator buffer, Error = %d",__FUNCTION__,__LINE__,name,GetLastError());
                     continue;
                  }

               df.insert(name, buffer); //Insert a buffer vector and its name to a dataframe object
            }
      }

   return df.iloc(-1); //Return the latest information from the dataframe which is the most recent buffer
 }
Nota: todos os indicadores são inicializados na função Init, logo após o carregamento do modelo a partir da pasta common, onde foi salvo com o Python.
#include <Gaussian Mixture.mqh>
#include <Arrays\ArrayString.mqh>
#include <MALE5\Pandas\pandas.mqh>

CGaussianMixture lgmm;

input string symbol = "XAUUSD";
input ENUM_TIMEFRAMES timeframe = PERIOD_D1;

struct indicator_struct
 {
   long handle;
   CArrayString buffer_names;
 };

indicator_struct indicators[15];

//--- Indicator buffers

double ProbabilityBuffer[];
double ColorBuffer[];
double MaBuffer[];
//+------------------------------------------------------------------+
//| Custom indicator initialization function                         |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- indicator buffers mapping

   Comment("");

   // Setting indicator properties
   SetIndexBuffer(0, ProbabilityBuffer, INDICATOR_DATA);
   SetIndexBuffer(1, ColorBuffer, INDICATOR_COLOR_INDEX);

   // Setting histogram drawing style
   PlotIndexSetInteger(0, PLOT_DRAW_TYPE, DRAW_COLOR_HISTOGRAM);

   // Set indicator labels
   IndicatorSetString(INDICATOR_SHORTNAME, "3-Color Histogram");
   IndicatorSetInteger(INDICATOR_DIGITS, _Digits);

//---

   string filename = StringFormat("LGMM.%s.%s.onnx",symbol, EnumToString(timeframe));
   if (!lgmm.Init(filename, ONNX_COMMON_FOLDER))
      {
         printf("%s Failed to initialize the GaussianMixture model (LGMM) in ONNX format file={%s}, Error = %d",__FUNCTION__,filename,GetLastError());
      }

//--- Oscillators

   indicators[0].handle = iATR(symbol, timeframe, 14);
   indicators[0].buffer_names.Add("ATR");

   //...
   //...
   //...

   indicators[14].handle = iWPR(symbol, timeframe, 14);
   indicators[14].buffer_names.Add("WPR");

   for (uint i=0; i<indicators.Size(); i++)
     if (indicators[i].handle==INVALID_HANDLE)
        {
          printf("%s Invalid %s handle, Error = %d",__FUNCTION__,indicators[i].buffer_names[0],GetLastError());
          return INIT_FAILED;
        }

//---
   return(INIT_SUCCEEDED);
  }
Em seguida, aplicamos o indicador ao gráfico do XAUUSD, no mesmo timeframe utilizado para treinar o modelo.
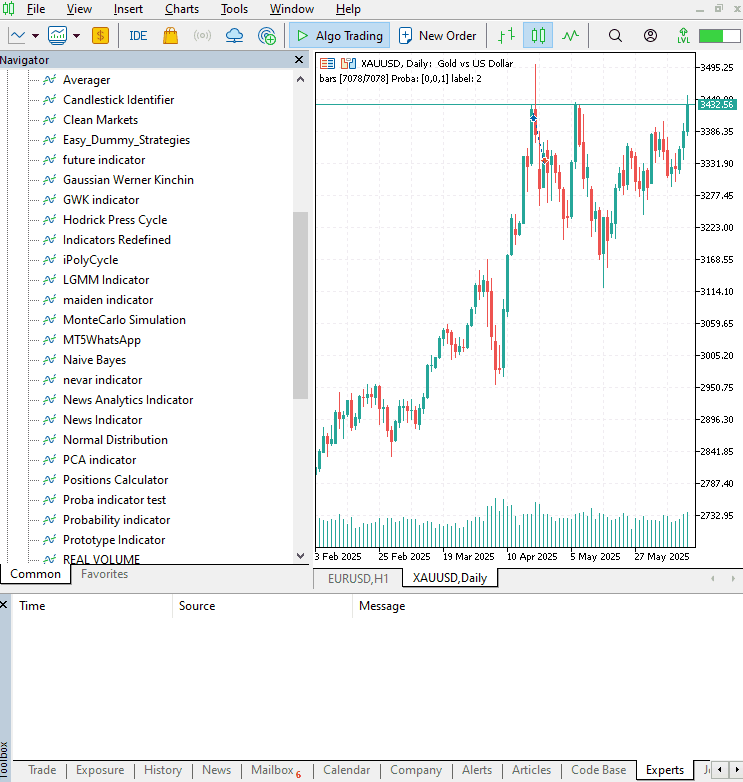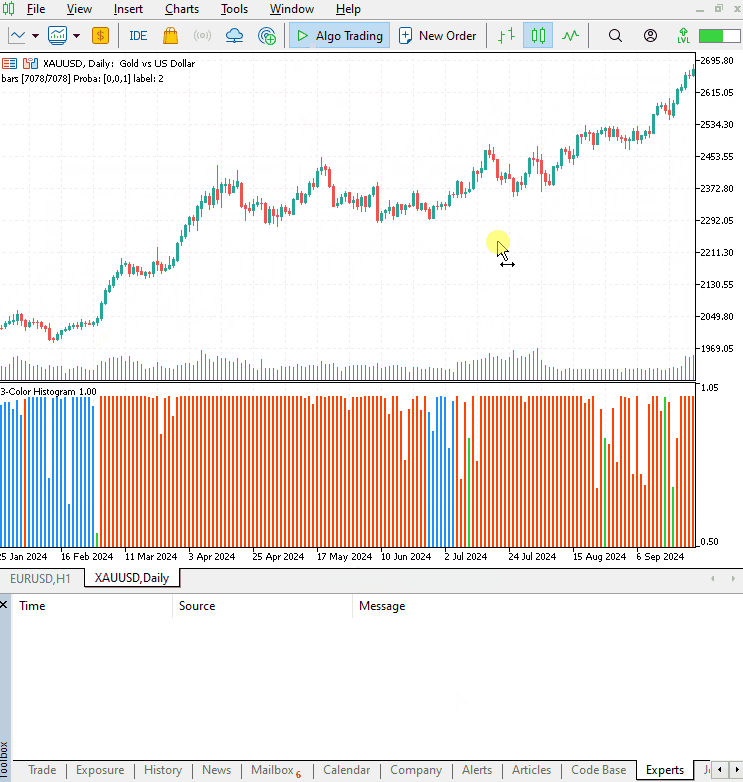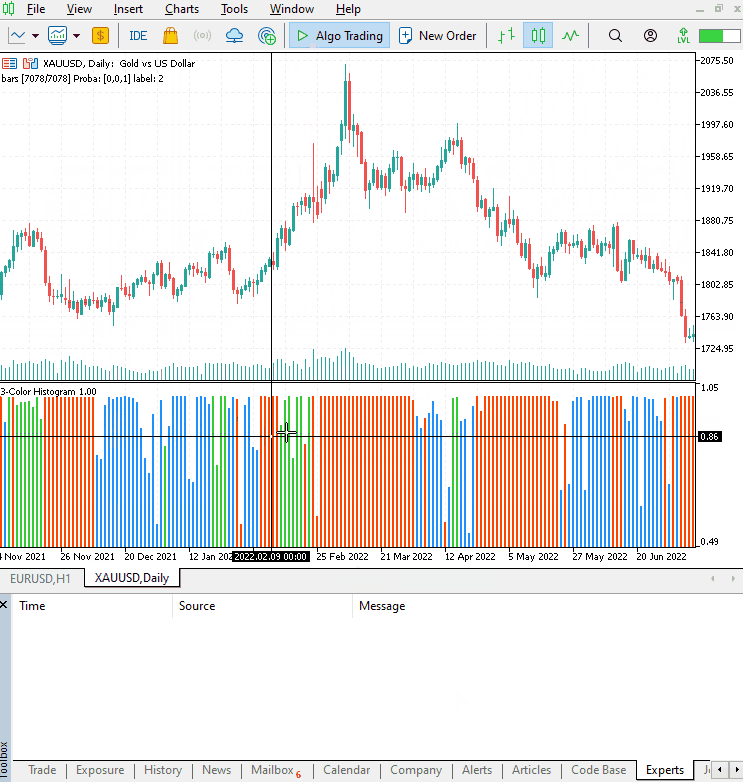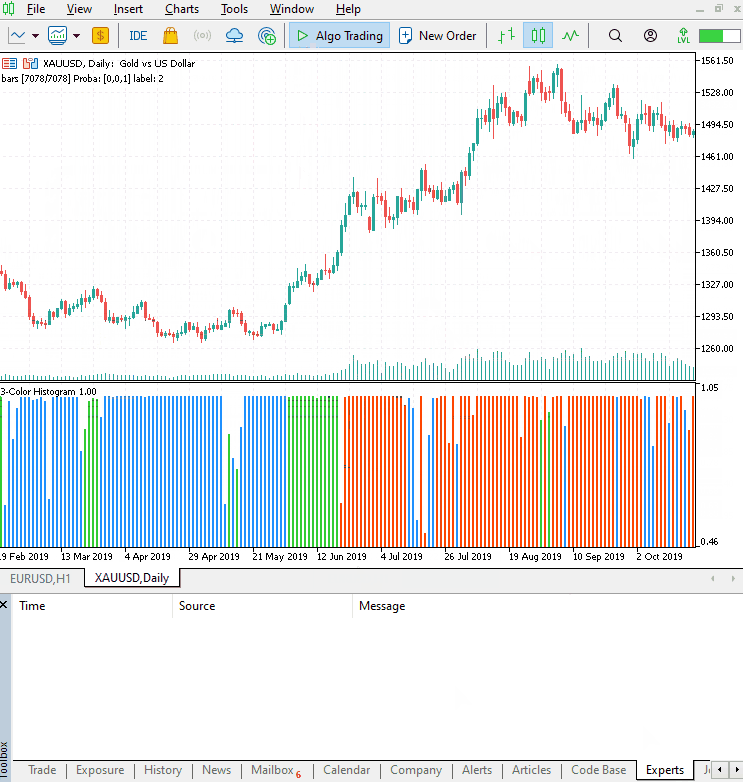
O indicador resultante ainda é difícil de interpretar. No entanto, um padrão predomina claramente: o componente representado em vermelho. Ao que parece, esse padrão surge em períodos de alta volatilidade do mercado, tanto em tendências de alta quanto de baixa. O significado dos demais componentes ainda não está claro. Isso pode indicar que o número de componentes escolhido para o modelo não foi o ideal. Vamos, então, tentar determinar o número ideal de componentes.
Como determinar o número ideal de componentes para o LGMM
A classe GaussianMixture da biblioteca Scikit-Learn permite calcular os valores do Critério de Informação de Akaike (Akaike Information Criterion, AIC) e do Critério de Informação Bayesiano (Bayesian Information Criterion, BIC). Vamos traçar as curvas de AIC e BIC em função do número de componentes e tentar identificar o ponto de cotovelo (elbow point).
O ponto de cotovelo é aquele a partir do qual a inclusão de novos componentes produz apenas pequenas reduções nos valores de AIC e BIC, fazendo com que a curva comece a se estabilizar.
Arquivo: main.ipynb
lowest_bic = np.inf
bic = []
aic = []
n_components_range = range(1, 10)

for n_components in n_components_range:
    gmm = GaussianMixture(n_components=n_components, random_state=42)
    gmm.fit(X)
    bic.append(gmm.bic(X_train))
    aic.append(gmm.aic(X_train))
    if bic[-1] < lowest_bic:
        best_gmm = gmm
        lowest_bic = bic[-1]

# Plot the BIC and AIC scores
plt.figure(figsize=(8, 5))
plt.plot(n_components_range, bic, label='BIC', marker='o')
plt.plot(n_components_range, aic, label='AIC', marker='o')
plt.xlabel('Number of components')
plt.ylabel('Score')
plt.title('LGMM selection: AIC vs BIC')
plt.legend()
plt.grid(True)
plt.show()
Resultados.

As curvas de AIC e BIC apresentam uma queda acentuada quando passamos de um para dois componentes e continuam diminuindo à medida que adicionamos novos componentes. No entanto, após cinco componentes, a redução dos valores de ambas as métricas se torna consideravelmente menor. Isso indica que cinco é o número ideal de componentes para este modelo.
Vamos voltar ao código, treinar novamente o modelo e atualizar o indicador.
Arquivo: main.ipynb
components = 5 # according to the elbow point

gmm = GaussianMixture(n_components=components, covariance_type="full", random_state=42)
gmm.fit(X_train)

latent_features_train = gmm.predict_proba(X_train)
latent_features_test = gmm.predict_proba(X_test)
Agora, o modelo utiliza cinco componentes em vez de três, ou seja, retorna cinco probabilidades que podemos representar no gráfico. Portanto, precisamos aumentar para cinco o número de cores do histograma do indicador e tratar separadamente os cinco rótulos que o modelo pode prever.
Arquivo: LGMM Indicator.mq5
#property indicator_color1 clrDodgerBlue, clrLimeGreen, clrCrimson, clrOrange, clrYellow
Função OnCalculate
int OnCalculate(const int32_t rates_total,
                const int32_t prev_calculated,
                const datetime &time[],
                const double &open[],
                const double &high[],
                const double &low[],
                const double &close[],
                const long &tick_volume[],
                const long &volume[],
                const int32_t &spread[])
  {
//--- Main calculation loop

   int lookback = 20;

   for (int i = prev_calculated; i < rates_total && !IsStopped(); i++)
   {
      if (i+1<lookback) //prevent data not found errors during copy buffer
         continue;

      //...
      //...
      //...

      // Determine color based on predicted label

      if (label == 0)
         ColorBuffer[i] = 0;
      else if (label == 1)
         ColorBuffer[i] = 1;
      else if (label == 2)
         ColorBuffer[i] = 2;
      else if (label == 3)
         ColorBuffer[i] = 3;
      else
         ColorBuffer[i] = 4;

      Comment("bars [",i+1,"/",rates_total,"]"," Proba: ",proba," label: ",label);
   }
Nova aparência do indicador.
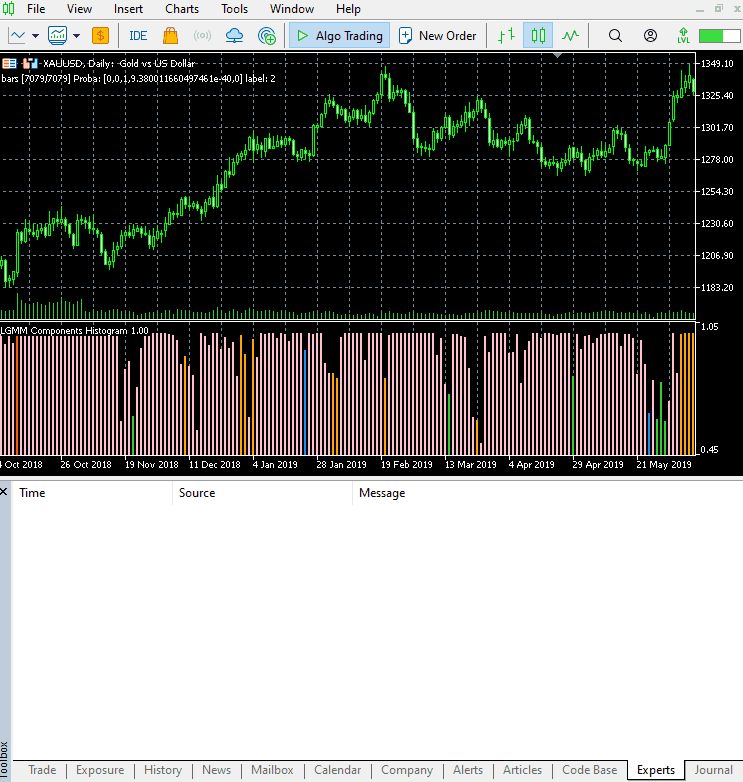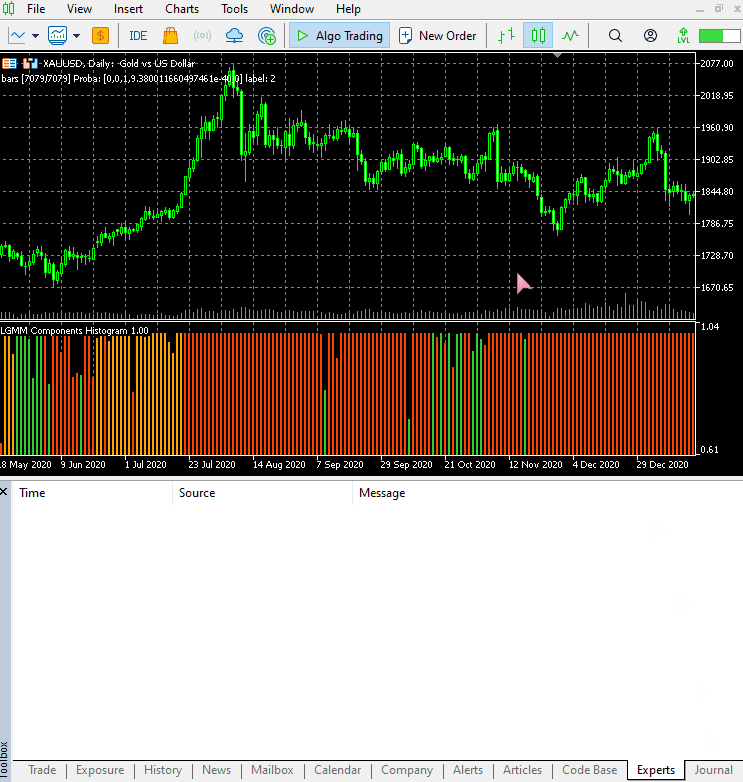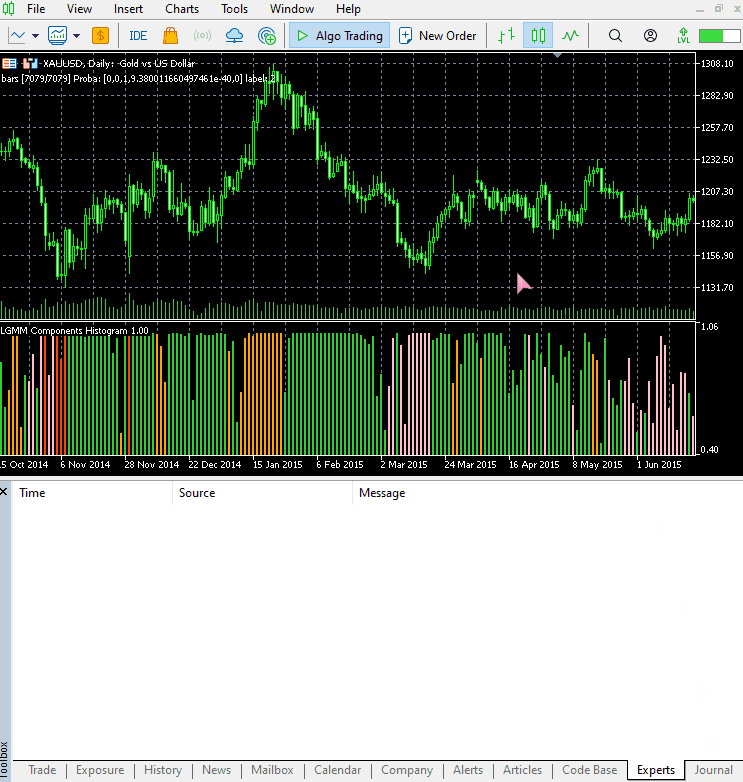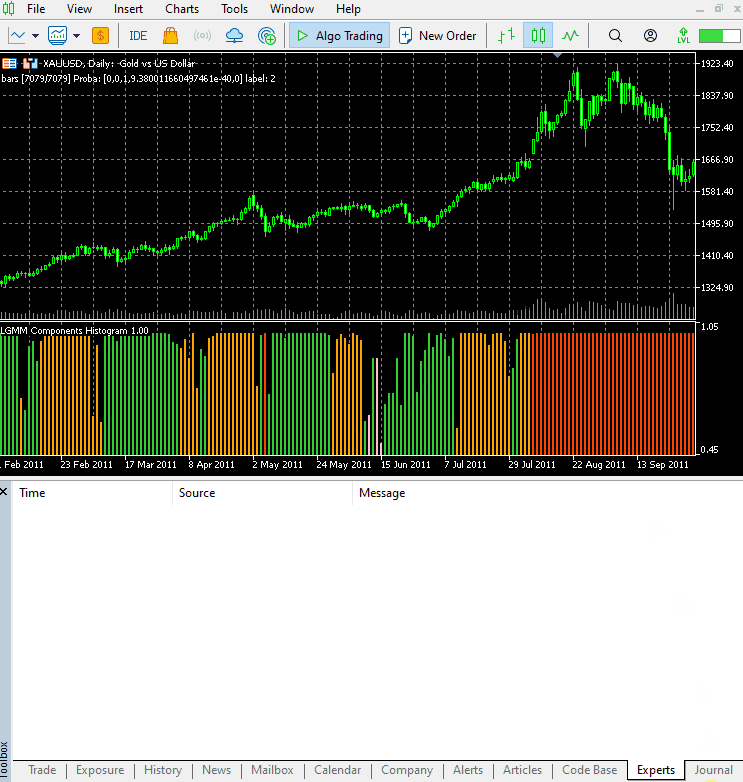
O resultado ficou ótimo, mas ainda é difícil interpretar os valores, já que estamos trabalhando com osciladores simples que indicam regiões de sobrevenda e sobrecompra. Sugiro que você experimente esse indicador e compartilhe suas impressões na seção de discussão.
Agora, vamos tentar combinar o LGMM com outro modelo de aprendizado de máquina.
Combinação do modelo de misturas gaussianas latentes com um classificador
Vimos como utilizar o LGMM para obter atributos latentes que representam as probabilidades de pertencimento a determinados clusters. Como esses atributos são difíceis de interpretar diretamente, vamos combiná-los com os atributos dos indicadores e utilizá-los em um classificador Random Forest (floresta aleatória). Espero que esse modelo de aprendizado de máquina consiga identificar como os atributos latentes contribuem para a previsão dos sinais de negociação.
Arquivo: main.ipynb
Já havíamos criado a variável-alvo ao dividir os dados em conjuntos de treinamento e teste. Para facilitar, vamos apresentá-la novamente.
from sklearn.model_selection import train_test_split

X = new_df.drop(columns=[
    "Time",
    "Open",
    "High",
    "Low",
    "Close",
    "future_close",
    "Direction"
])

y = new_df["Direction"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, shuffle=True, random_state=42)
Após treinar o LGMM, utilizamos o modelo para gerar previsões com os dados de treinamento e de teste.
latent_features_train = gmm.predict_proba(X_train)
latent_features_test = gmm.predict_proba(X_test)
Como esses resultados são difíceis de interpretar sem identificar cada coluna, vamos adicionar os nomes dos atributos latentes.
latent_features_train_df = pd.DataFrame(latent_features_train, columns=[f"LATENT_FEATURE_{i}" for i in range(latent_features_train.shape[1])])
latent_features_test_df = pd.DataFrame(latent_features_test, columns=[f"LATENT_FEATURE_{i}" for i in range(latent_features_test.shape[1])])
latent_features_train_df
Resultados.
| LATENT_FEATURE_0 | LATENT_FEATURE_1 | LATENT_FEATURE_2 | LATENT_FEATURE_3 | LATENT_FEATURE_4 | |
|---|---|---|---|---|---|
| 0 | 0.000000e+00 | 5.368039e-08 | 9.999999e-01 | 1.566000e-57 | 8.541983e-37 |
| 1 | 3.316692e-124 | 8.262106e-01 | 2.931424e-06 | 1.725415e-01 | 1.244990e-03 |
| 2 | 6.572730e-49 | 7.441120e-08 | 3.481699e-08 | 9.461818e-01 | 5.381811e-02 |
| 3 | 0.000000e+00 | 1.165057e-126 | 1.413762e-05 | 4.101964e-16 | 9.999859e-01 |
| 4 | 0.000000e+00 | 4.446778e-289 | 1.000000e+00 | 1.717945e-36 | 4.234123e-21 |
Vamos combinar os atributos latentes com os dados originais dos indicadores.
all_columns = X_train.columns.tolist() + latent_features_train_df.columns.tolist()

X_latent_train_arr = np.hstack([X_train, latent_features_train_df])
X_latent_test_arr = np.hstack([X_test, latent_features_test_df])

X_Train_latent = pd.DataFrame(X_latent_train_arr, columns=all_columns)
X_Test_latent = pd.DataFrame(X_latent_test_arr, columns=all_columns)

X_Train_latent.columns
Resultados.
Index(['ATR', 'BearsPower', 'BullsPower', 'Chainkin', 'CCI', 'Demarker',
       'Force', 'MACD MAIN_LINE', 'MACD SIGNAL_LINE', 'Momentum', 'OsMA',
       'RSI', 'RVI MAIN_LINE', 'RVI SIGNAL_LINE',
       'StochasticOscillator MAIN_LINE', 'StochasticOscillator SIGNAL_LINE',
       'TEMA', 'WPR', 'LATENT_FEATURE_0', 'LATENT_FEATURE_1',
       'LATENT_FEATURE_2', 'LATENT_FEATURE_3', 'LATENT_FEATURE_4'],
      dtype='object')
Em seguida, vamos utilizar os dados combinados para alimentar o classificador Random Forest.
from sklearn.ensemble import RandomForestClassifier
from sklearn.utils.class_weight import compute_class_weight

classes = np.unique(y_train)
weights = compute_class_weight(class_weight='balanced', classes=classes, y=y_train)

class_weights_dict = dict(zip(classes, weights))

params = {
    "n_estimators": 100,
    "min_samples_split": 2,
    "max_depth": 10,
    "max_leaf_nodes": 10,
    "criterion": "gini",
    "random_state": 42
}

model = RandomForestClassifier(**params, class_weight=class_weights_dict)

model.fit(X_Train_latent, y_train)
Avaliação do modelo.
y_train_pred = model.predict(X_Train_latent)

print("Train classification report\n", classification_report(y_train, y_train_pred))

y_test_pred = model.predict(X_Test_latent)

print("Test classification report\n", classification_report(y_test, y_test_pred))
Resultados.
Train classification report
               precision    recall  f1-score   support

          -1       0.60      0.67      0.63      1766
           1       0.68      0.61      0.64      1994

    accuracy                           0.64      3760
   macro avg       0.64      0.64      0.64      3760
weighted avg       0.64      0.64      0.64      3760

Test classification report
               precision    recall  f1-score   support

          -1       0.45      0.47      0.45       445
           1       0.50      0.48      0.49       495

    accuracy                           0.47       940
   macro avg       0.47      0.47      0.47       940
weighted avg       0.47      0.47      0.47       940
O modelo apresentou um desempenho insatisfatório no conjunto de teste. Há várias maneiras de melhorá-lo, mas, por enquanto, vamos analisar o gráfico de importância dos atributos gerado a partir desse modelo.
importances = model.feature_importances_
feature_names = X_Train_latent.columns if hasattr(X_Train_latent, 'columns') else [f'feature_{i}' for i in range(X_Train_latent.shape[1])]

# Create DataFrame and sort
importance_df = pd.DataFrame({'feature': all_columns, 'importance': importances})
importance_df = importance_df.sort_values('importance', ascending=False)

# Plot
plt.figure(figsize=(8, 6))
plt.barh(importance_df['feature'], importance_df['importance'], color='red')
plt.title('RFC Feature Importance (Gini Importance)')
plt.xlabel('Importance Score')
plt.gca().invert_yaxis()  # Most important on top
plt.show()
Resultados.
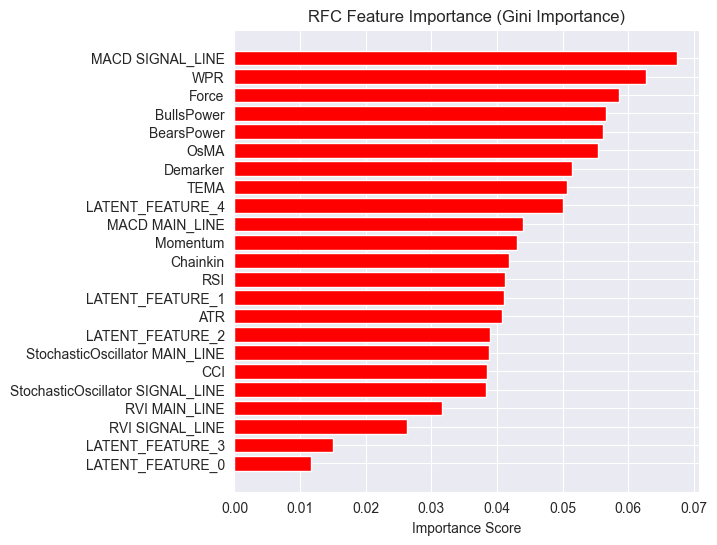
Os atributos latentes são relevantes para as previsões do modelo, indicando que contêm padrões e informações que contribuem para as previsões.
O desempenho relativamente baixo do modelo pode estar relacionado à definição da variável-alvo. É possível que o valor escolhido para o parâmetro lookahead = 1 não seja o mais adequado.
Quando utilizamos indicadores para tomar decisões de negociação, geralmente não tentamos prever apenas o comportamento da barra seguinte. Por exemplo, se o RSI estiver abaixo do limite de 30 (região de sobrevenda), podemos considerar a possibilidade de o mercado iniciar um movimento de alta ao longo das próximas barras, e não necessariamente na barra seguinte, como pressupõe a configuração atual de treinamento do modelo.
Por isso, vamos redefinir a variável-alvo utilizando lookahead = 5.
lookahead = 5

df["future_close"] = df["Close"].shift(-lookahead)
new_df = df.dropna()

new_df["Direction"] = np.where(new_df["future_close"]>new_df["Close"], 1, -1) # if a the close value in the next bar(s)=lookahead is above the current close price, thats a long signal otherwise that's a short signal
A avaliação do modelo nos conjuntos de treinamento e validação agora apresenta resultados diferentes.
Train classification report
               precision    recall  f1-score   support

          -1       0.56      0.70      0.62      1706
           1       0.69      0.54      0.61      2050

    accuracy                           0.61      3756
   macro avg       0.62      0.62      0.61      3756
weighted avg       0.63      0.61      0.61      3756

Test classification report
               precision    recall  f1-score   support

          -1       0.46      0.61      0.52       392
           1       0.63      0.48      0.55       548

    accuracy                           0.54       940
   macro avg       0.55      0.55      0.53       940
weighted avg       0.56      0.54      0.54       940
O gráfico de importância dos atributos também mudou.
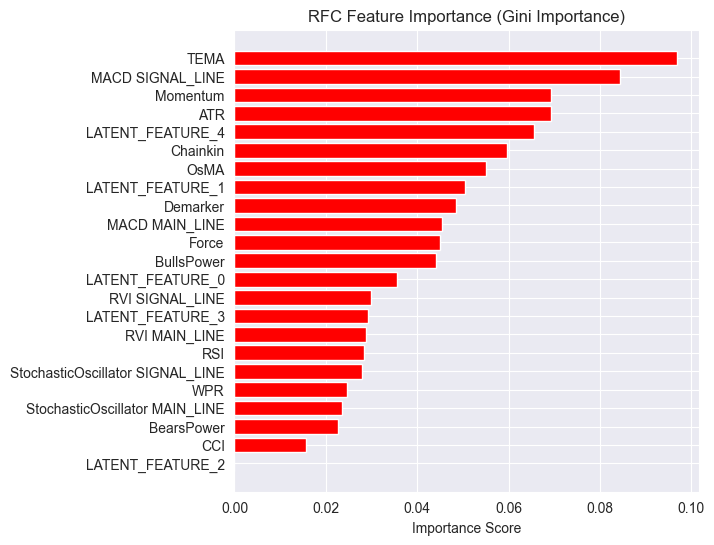
O modelo alcançou uma acurácia geral de 54%. Embora não seja um resultado muito elevado, é suficiente para corroborar as observações feitas no gráfico de importância dos atributos.
Alguns dos atributos latentes gerados pelo LGMM ficaram entre os preditores mais relevantes do modelo.
O atributo LATENT_FEATURE_4 ocupou a quinta posição em importância para o classificador Random Forest. Outros atributos latentes, como LATENT_FEATURE_0 e LATENT_FEATURE_1, também receberam valores elevados de importância, ficando à frente de alguns indicadores originais no ranking.
De modo geral, a maioria dos atributos gerados pelo LGMM contém padrões úteis para o modelo de classificação.
Com essas informações, já temos um ponto de partida para interpretar o indicador.
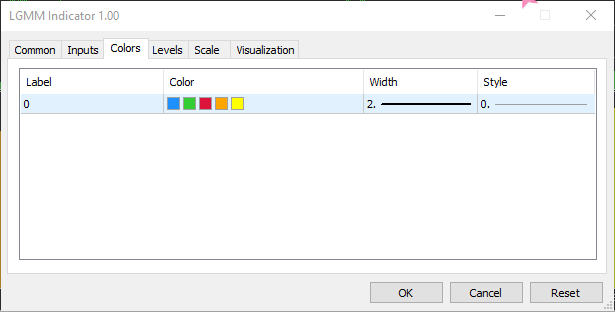
As cores exibidas no indicador correspondem aos respectivos atributos latentes.
Robô de negociação baseado no LGMM
No nosso EA, vamos importar as bibliotecas necessárias.
Nome do arquivo: LGMM BASED EA.mq5
#include <Random Forest.mqh>
#include <Arrays\ArrayString.mqh>
#include <pandas.mqh> //https://www.mql5.com/en/articles/17030
#include <Trade\Trade.mqh>
#include <Trade\PositionInfo.mqh>
#include <Trade\SymbolInfo.mqh>
#include <errordescription.mqh>

CSymbolInfo m_symbol;
CTrade m_trade;
CPositionInfo m_position;
CRandomForestClassifier rfc;
Precisamos verificar se estamos utilizando o mesmo símbolo e timeframe usados na coleta dos dados de treinamento.
#define MAGICNUMBER 11062025

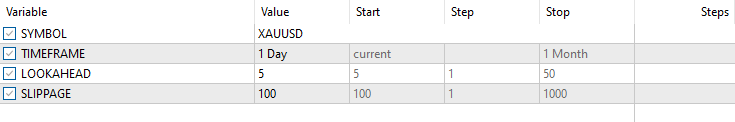
input string SYMBOL = "XAUUSD";
input ENUM_TIMEFRAMES TIMEFRAME = PERIOD_D1;
input uint LOOKAHEAD = 5;
input uint SLIPPAGE = 100;
Vamos inicializar os dois modelos (LGMM e classificador Random Forest) na função OnInit.
int OnInit()
  {

   if (!MQLInfoInteger(MQL_DEBUG) && !MQLInfoInteger(MQL_TESTER))
    {
      ChartSetSymbolPeriod(0, SYMBOL, TIMEFRAME);
      if (!SymbolSelect(SYMBOL, true))
         {
            printf("%s failed to select SYMBOL %s, Error = %s",__FUNCTION__,SYMBOL,ErrorDescription(GetLastError()));
            return INIT_FAILED;
         }
    }

//--- Loading the Gaussian Mixture model

   string filename = StringFormat("LGMM.%s.%s.onnx",SYMBOL, EnumToString(TIMEFRAME));
   if (!lgmm.Init(filename, ONNX_COMMON_FOLDER))
      {
         printf("%s Failed to initialize the GaussianMixture model (LGMM) in ONNX format file={%s}, Error = %s",__FUNCTION__,filename,ErrorDescription(GetLastError()));
      }

//--- Loading the RFC model

   filename = StringFormat("rfc.%s.%s.onnx",SYMBOL,EnumToString(TIMEFRAME));
   Print(filename);
   if (!rfc.Init(filename, ONNX_COMMON_FOLDER))
      {
         printf("func=%s line=%d, Failed to Load the RFC in ONNX file={%s}, Error = %s",__FUNCTION__,__LINE__,filename,ErrorDescription(GetLastError()));
         return INIT_FAILED;
      }
//...
//... other lines of code
//...
}
Na função getX(), chamamos o LGMM para gerar os atributos latentes, que serão combinados com os dados dos indicadores para formar o conjunto final de entrada do classificador Random Forest.
vector getX(uint start=0, uint count=10)
 {
//--- Get buffers

   CDataFrame df;
   for (uint ind=0; ind<indicators.Size(); ind++) //Loop through all the indicators
      {
        uint buffers_total = indicators[ind].buffer_names.Total();

         for (uint buffer_no=0; buffer_no<buffers_total; buffer_no++) //Their buffer names resemble their buffer numbers
            {
               string name = indicators[ind].buffer_names.At(buffer_no); //Get the name of the buffer, it is helpful for the DataFrame and CSV file

               vector buffer = {};
               if (!buffer.CopyIndicatorBuffer(indicators[ind].handle, buffer_no, start, count)) //Copy indicator buffer
                  {
                     printf("func=%s line=%d | Failed to copy %s indicator buffer, Error = %d",__FUNCTION__,__LINE__,name,GetLastError());
                     continue;
                  }

               df.insert(name, buffer); //Insert a buffer vector and its name to a dataframe object
            }
      }

   if ((uint)df.shape()[0]==0)
      return vector::Zeros(0);

//--- predict the latent features

   vector indicators_data = df.iloc(-1); //index=-1 returns the last row from the dataframe which is the most recent buffer from all indicators

//--- Given the indicators let's predict the latent features

   vector latent_features = lgmm.predict(indicators_data).proba;

   if (latent_features.Size()==0)
      return vector::Zeros(0);

   return hstack(indicators_data, latent_features); //Return indicators data stacked alongside latent features
 }
Por fim, vamos implementar uma estratégia de negociação simples, baseada nos sinais gerados pelo classificador Random Forest.
void OnTick()
  {
//--- Close trades after AI predictive horizon is over

   CloseTradeAfterTime(MAGICNUMBER, PeriodSeconds(TIMEFRAME)*LOOKAHEAD);

//--- Refresh tick information

   if (!m_symbol.RefreshRates())
     {
       printf("func=%s line=%s. Failed to copy rates, Error = %s",__FUNCTION__,ErrorDescription(GetLastError()));
       return;
     }

//---

    vector x = getX(); //Get all the input for the model

    if (x.Size()==0)
      return;

    long signal = rfc.predict(x).cls; //the class predicted by the random forest classifier
    double proba = rfc.predict(x).proba; //probability of the predictions

    double volume = m_symbol.LotsMin();

    if (!PosExists(POSITION_TYPE_SELL, MAGICNUMBER) && !PosExists(POSITION_TYPE_BUY, MAGICNUMBER)) //no position is open
      {
        if (signal == 1) //If a model predicts a bullish signal
          m_trade.Buy(volume, SYMBOL, m_symbol.Ask()); //Open a buy trade
        else if (signal == -1) // if a model predicts a bearish signal
          m_trade.Sell(volume, SYMBOL, m_symbol.Bid()); //open a sell trade
      }
  }
As operações serão encerradas após um determinado número de barras (LOOKAHEAD) no timeframe utilizado durante o treinamento do modelo. O valor do parâmetro LOOKAHEAD deve ser igual ao utilizado na definição da variável-alvo no script de treinamento.
Configurações do testador.
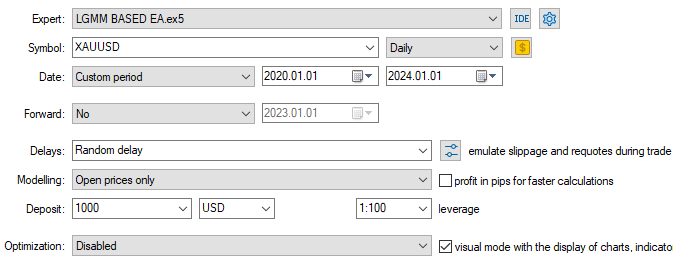
Dados de entrada.
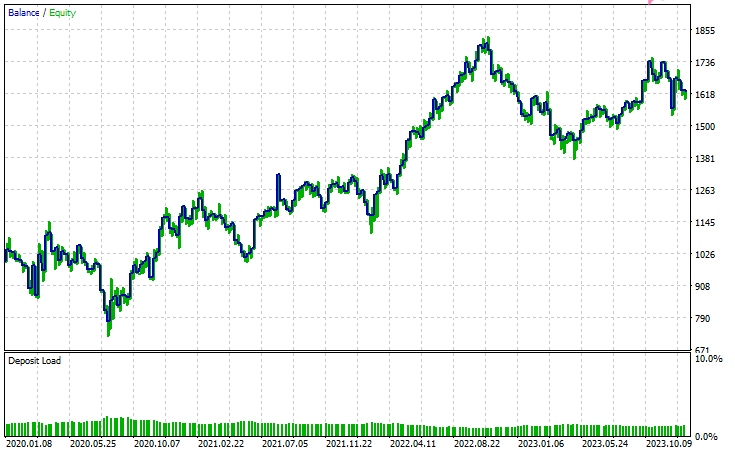
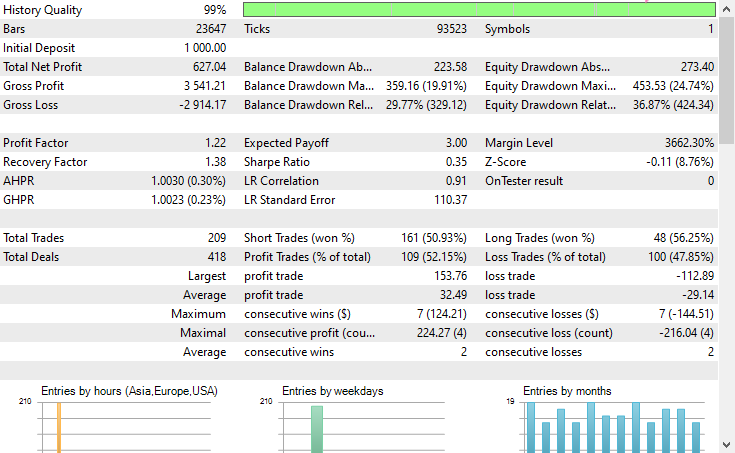
Resultados dos testes
Conclusão
O Latent Gaussian Mixture Model (LGMM) é uma técnica bastante eficaz para extrair atributos relevantes que representam padrões não observáveis diretamente nos dados e que podem ser úteis para modelos de aprendizado de máquina. No entanto, assim como outros modelos de aprendizado de máquina e métodos de previsão, também apresenta algumas limitações.
Visão geral do modelo de misturas gaussianas latentes (Latent Gaussian Mixture Model, LGMM)
| Aspecto | Descrição |
|---|---|
| O que é o LGMM | Método de extração de atributos latentes que representam padrões não observáveis nos dados. Esses atributos podem ser úteis para modelos de aprendizado de máquina. |
| Principais vantagens | Identifica estruturas ocultas relevantes nos dados, que podem contribuir para melhorar o desempenho de outros modelos de aprendizado de máquina. |
Limitações do LGMM
| Limitação | Explicação |
|---|---|
| Pressupõe uma distribuição gaussiana | O LGMM pressupõe que cada observação seja gerada por um dos componentes da mistura, descrito por uma distribuição normal multivariada, o que raramente corresponde às características dos dados financeiros, que geralmente apresentam comportamento caótico e não linear. |
| Sensibilidade à inicialização | Esse modelo exige uma escolha cuidadosa do número de componentes. Uma inicialização inadequada ou uma seleção incorreta dos parâmetros pode comprometer significativamente seu desempenho. |
| Dificuldade de interpretação dos resultados | Os atributos latentes são difíceis de compreender ou explicar. Como se trata de um método de aprendizado não supervisionado, o modelo agrupa as observações em clusters e atribui identificadores a esses grupos, mas não determina automaticamente o significado dos padrões identificados. |
| Sensibilidade a valores atípicos | A estimação dos parâmetros das distribuições gaussianas é sensível a valores atípicos. Alguns valores extremos podem distorcer a média e aumentar a variância, comprometendo os resultados do modelo. |
Esse modelo é especialmente útil para redução de dimensionalidade, permitindo representar os dados por meio de um número menor de atributos latentes relevantes, e para gerar novos atributos que acrescentem informações úteis aos modelos de aprendizado de máquina. Na minha opinião, essas são as finalidades para as quais vale mais a pena utilizar o modelo.
Boa sorte a todos!
Continue acompanhando nossos artigos e contribua para o desenvolvimento de algoritmos de aprendizado de máquina para MQL5 neste repositório do GitHub.
Tabela de arquivos anexados
| Nome do arquivo | Descrição e finalidade |
|---|---|
| Include\errordescription.mqh | Contém a descrição de todos os códigos de erro gerados pelo MetaTrader 5. |
| Include\Gaussian Mixture.mqh | Biblioteca que contém uma classe para inicializar e colocar em operação um modelo de misturas gaussianas armazenado no formato ONNX. |
| Include\pandas.mqh | Contém uma classe para armazenar e processar dados, semelhante à oferecida pela biblioteca Pandas em Python. |
| Include\Random Forest.mqh | Biblioteca que contém uma classe para inicializar e colocar em operação um classificador Random Forest armazenado no formato ONNX. |
| Indicators\LGMM Indicator.mq5 | Indicador para visualizar os atributos latentes extraídos pelo modelo de misturas gaussianas latentes (LGMM). |
| Scripts\Get XAUUSD Data.mq5 | Script que coleta do MetaTrader 5 os dados dos osciladores e os valores OHLCT e os salva em um arquivo CSV. |
| Experts\LGMM BASED EA.mq5 | EA que abre e encerra operações com base nas previsões geradas por um classificador Random Forest, alimentado com a combinação dos atributos latentes extraídos pelo LGMM e dos dados dos osciladores. |
| Python Code\main.ipynb | Notebook Jupyter (script Python) utilizado para análise de dados, treinamento de modelos de aprendizado de máquina, entre outras tarefas. |
| Python Code\Trade\TerminalInfo.py | Contém uma classe semelhante à CTerminalInfo do MQL5, utilizada para obter informações sobre o aplicativo MetaTrader 5 para desktop selecionado. |
| Python\requirements.txt | Lista todas as dependências Python utilizadas no projeto e suas respectivas versões. |
| Common\Files* | Contém um arquivo CSV com os dados de treinamento e alguns arquivos de modelos ONNX utilizados neste artigo, disponibilizados apenas como exemplo. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18497
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Desenvolvimento de ferramentas para análise de Price Action (Parte 28): Ferramenta para operar rompimentos da faixa de abertura
 Desenvolvimento de um Kit de Ferramentas para Análise da Ação do Preço (Parte 25): Rompimento de Fractais com EMA Dupla
 Criação de EAs auto-otimizáveis em MQL5 (Parte 8): Análise de múltiplas estratégias (2)
 Repensando as estratégias clássicas (Parte 13): Atualização da estratégia de cruzamento de médias móveis (Parte 2)

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso