
Machine Learning e Data Science (Parte 42): Previsão dos mercados acionários com N-BEATS em Python
 25
 1

Sumário
- O que é N-BEATS?
- Como funciona o N-BEATS
- Principais objetivos do modelo N-BEATS
- Construção do modelo N-BEATS
- Previsão fora da amostra usando o modelo N-BEATS
- Previsão de múltiplas séries temporais
- Sinais de negociação baseados em N-BEATS no MetaTrader 5
- Conclusão
O que é N-BEATS?
N-BEATS (Neural Basis Expansion Analysis for Time Series) é um modelo de aprendizado profundo desenvolvido especificamente para a previsão de séries temporais. Sua arquitetura flexível permite realizar previsões tanto de séries temporais univariadas quanto multivariadas.
O modelo foi apresentado em 2019 por pesquisadores da Element AI (atualmente parte da ServiceNow), no artigo "N-BEATS: Neural basis expansion analysis for interpretable time series forecasting".
Os pesquisadores da Element AI desenvolveram o N-BEATS para desafiar o domínio dos modelos estatísticos clássicos, como ARIMA e ETS, na previsão de séries temporais, preservando ao mesmo tempo as capacidades oferecidas pelos modelos clássicos de machine learning.
Sabemos que a previsão de séries temporais é uma tarefa complexa. Por isso, especialistas em machine learning e usuários às vezes recorrem a modelos de aprendizado profundo, como RNN e LSTM, que frequentemente apresentam as seguintes limitações:
- São complexos demais para tarefas simples
- São difíceis de interpretar
- Nem sempre superam os modelos estatísticos de referência, apesar de sua complexidade
Por outro lado, os modelos tradicionais de previsão de séries temporais, como ARIMA, muitas vezes são simples demais para diversas aplicações.
Diante disso, os autores decidiram desenvolver um modelo de aprendizado profundo para previsão de séries temporais que combinasse bom desempenho, interpretabilidade e a capacidade de funcionar sem ajustes específicos para cada domínio de aplicação.

Principais objetivos do modelo N-BEATS
Ao desenvolver esse modelo de machine learning, os pesquisadores estabeleceram objetivos específicos para superar as limitações tanto dos modelos clássicos quanto daqueles baseados em redes neurais profundas.
A seguir, apresentamos uma descrição detalhada dos principais objetivos do N-BEATS:
- Simplicidade do modelo sem comprometer a precisão
Como os modelos lineares mais simples de previsão de séries temporais, como ARIMA, não conseguem capturar dependências complexas tão bem quanto os modelos de aprendizado profundo, os desenvolvedores optaram por utilizar arquiteturas simples de redes neurais (MLP) para realizar as previsões. Essas arquiteturas são mais interpretáveis, funcionam mais rapidamente e são mais fáceis de depurar.
O uso de modelos profundos, como RNN, LSTM ou Transformers, aumenta a complexidade, torna o modelo mais difícil de configurar e ajustar, além de deixar o treinamento mais lento. - Interpretabilidade por meio da estrutura
Como as MLPs e outros modelos neurais não produzem resultados facilmente interpretáveis, os desenvolvedores buscaram criar um modelo capaz de gerar previsões compreensíveis para as pessoas, decompondo a saída em componentes de tendência e sazonalidade, de maneira semelhante aos modelos clássicos de séries temporais, como ETS.
O modelo N-BEATS permite explicar explicitamente as variações nos dados, por exemplo: "Esse salto nos valores foi causado pela tendência" ou "Essa queda tem caráter sazonal". Isso é possível graças às camadas de expansão em funções de base (como funções polinomiais ou de Fourier). - Precisão competitiva sem configurações específicas
O objetivo é desenvolver um modelo versátil, capaz de funcionar de maneira eficaz com uma ampla variedade de séries temporais e exigir o mínimo de intervenção manual especializada.
Modelos como Prophet exigem que o usuário especifique padrões de tendência e sazonalidade.
O N-BEATS aprende automaticamente esses padrões diretamente dos dados. - Suporte à modelagem global de múltiplas séries temporais
Muitos modelos de previsão de séries temporais trabalham com uma única série de dados por vez (dados em painel). O N-BEATS foi desenvolvido para prever várias séries temporais simultaneamente.Isso é especialmente importante para dados financeiros, quando precisamos prever mais de um indicador, como os preços de fechamento do NASDAQ e do S&P 500 ao mesmo tempo. - Treinamento rápido e escalável
O N-BEATS foi projetado para permitir um treinamento rápido e facilmente paralelizável, diferentemente das RNNs ou dos modelos baseados em mecanismos de atenção. - Alto desempenho em relação aos métodos de referência
O N-BEATS busca superar métodos clássicos consolidados, como ARIMA e ETS, em avaliações comparativas por backtesting realizadas em condições equivalentes. - Arquitetura modular e extensível
Os modelos clássicos de previsão de séries temporais possuem estruturas estáticas e são difíceis de modificar. O N-BEATS oferece uma arquitetura que pode ser facilmente adaptada, permitindo adicionar blocos personalizados, como blocos de tendência, blocos de sazonalidade ou blocos genéricos.
Antes de implementar o modelo, vamos examinar brevemente como ele funciona.
Como funciona o modelo N-BEATS (breve introdução à intuição matemática)
Vamos analisar a arquitetura do modelo N-BEATS.
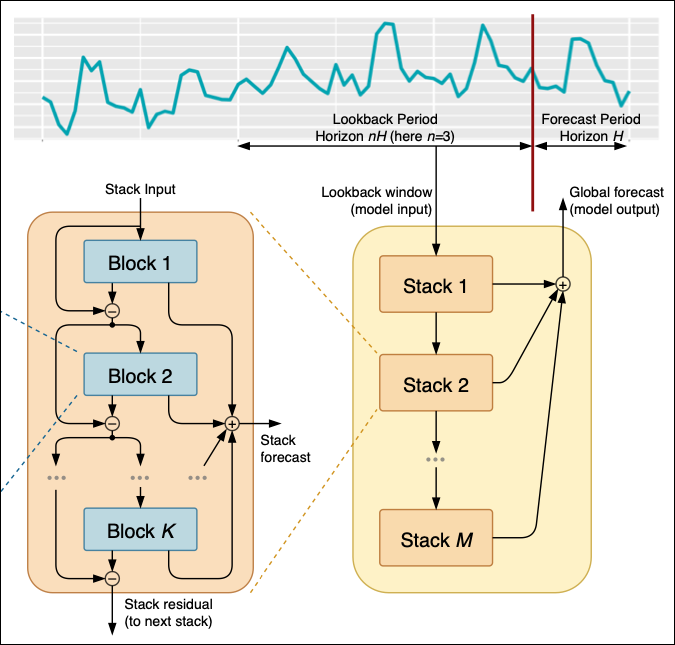
Figura 01
Na parte superior, temos uma série temporal que passa por filtragem e processamento em várias pilhas (stacks), numeradas de 1 a M.
Cada pilha é composta por blocos numerados de 1 a K. Cada bloco produz uma previsão ou um resíduo, que é passado para a próxima pilha.
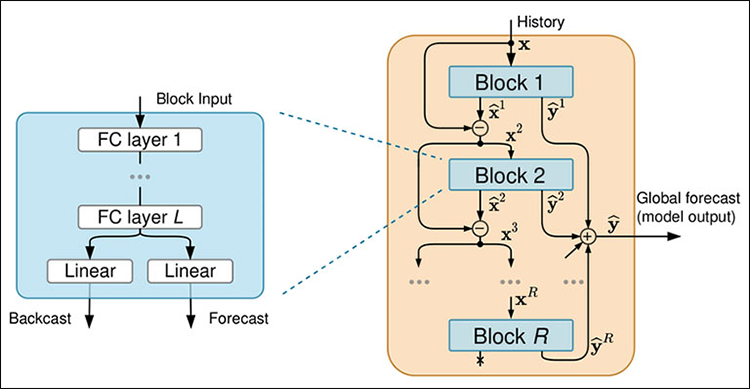
Figura 02
Cada bloco contém quatro camadas totalmente conectadas de uma rede neural, responsáveis por gerar o backcast ou o forecast.
Fluxo de dados no modelo
01: Nas pilhas
Primeiro, o modelo define o período de dados históricos (lookback period) e o horizonte de previsão (forecast period).
Lookback period é o intervalo de dados históricos analisado para prever valores futuros. Forecast period é o horizonte para o qual a previsão será realizada.
Após a definição desses períodos, o processamento começa na pilha 01, que utiliza os dados do lookback period para gerar as previsões iniciais. Por exemplo, se o lookback period corresponder aos preços de fechamento das últimas horas, a pilha 01 utilizará esses dados para prever os valores das próximas 24 horas.
A previsão inicial e seus resíduos (diferença entre o valor real e o valor previsto) são passados para a pilha seguinte (pilha 02), que os utiliza para refinar a previsão.
Essa sequência se repete em todas as pilhas seguintes, até a pilha M, com cada uma aprimorando as previsões da anterior.
Ao final, as previsões de todas as pilhas são combinadas para produzir uma previsão global. Por exemplo, a pilha 01 prevê um pico, a pilha 02 corrige a tendência e a pilha M refina os padrões de longo prazo. A previsão global integra todas essas informações para obter a maior precisão possível.
Podemos considerar cada pilha como uma camada de análise. A pilha 01 é responsável pelas oscilações de curto prazo (como as variações horárias dos preços de fechamento), enquanto a pilha 02 identifica padrões de longo prazo (como as tendências diárias).
Cada pilha contribui de maneira específica para a previsão final.
02: Dentro dos blocos de entrada
O bloco 01 recebe como entrada os dados da pilha, que podem corresponder aos dados originais do período anterior ou aos resíduos da pilha precedente. Em seguida, o bloco gera uma previsão (forecast) e um backcast (reconstrução dos dados de entrada). Por exemplo, se receber dados de consumo de energia elétrica das últimas 24 horas, o bloco produzirá uma previsão para as próximas 24 horas e um backcast para aproximar os dados originais.
O backcast ajuda a compreender como a previsão de cada bloco influencia o conjunto das previsões.
Cada pilha contém vários blocos que funcionam sequencialmente. Após o bloco 01 processar os dados de entrada e gerar o forecast e o backcast, o bloco seguinte recebe os resíduos do bloco anterior e os dados originais da pilha. Dessa forma, o bloco atual pode gerar previsões mais precisas, considerando tanto as previsões anteriores quanto os dados originais.
Esse refinamento iterativo nos blocos de cada pilha permite melhorar gradualmente a precisão. Depois que todos os blocos da pilha são processados, o resíduo do último bloco (Block K) é passado para a pilha seguinte.
03: Estrutura interna de um bloco
Dentro de cada bloco, os dados passam por quatro camadas totalmente conectadas de uma rede neural, que extraem os atributos necessários para gerar o forecast e o backcast.
As camadas totalmente conectadas de cada bloco realizam transformações nos dados e extraem seus atributos. Após passar por essas camadas, o fluxo de dados é dividido em duas partes (veja a Figura 02): uma destinada ao backcast e outra ao forecast.
O backcast aproxima os dados de entrada e permite refinar os resíduos que serão passados ao bloco seguinte, enquanto o forecast gera os valores previstos para o horizonte de previsão.
Construção do modelo N-BEATS em Python
Vamos começar instalando todos os módulos listados no arquivo requirements.txt, descrito na tabela de anexos e disponibilizado ao final do artigo.
pip install -r requirements.txt
No arquivo test.ipynb, começamos importando todos os módulos necessários.
import MetaTrader5 as mt5
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns
import warnings

sns.set_style("darkgrid")
warnings.filterwarnings("ignore")
Em seguida, inicializamos o MetaTrader 5.
if not mt5.initialize():
    print("Metratrader5 initialization failed, Error code =", mt5.last_error())
    mt5.shutdown()
Coletamos 1.000 barras do timeframe diário do instrumento NASDAQ (símbolo NAS100).
rates = mt5.copy_rates_from_pos("NAS100", mt5.TIMEFRAME_D1, 1, 1000)
rates_df = pd.DataFrame(rates)
Embora esse modelo utilize abordagens características dos métodos clássicos de machine learning, que frequentemente trabalham com múltiplas variáveis, o N-BEATS adota uma abordagem univariada, semelhante à dos modelos tradicionais de séries temporais, como ARIMA e VAR.
A seguir, mostramos como preparar os dados de uma série temporal univariada.
univariate_df = rates_df[["time", "close"]].copy()
univariate_df["ds"] = pd.to_datetime(univariate_df["time"], unit="s") # convert the time column to datetime
univariate_df["y"] = univariate_df["close"] # closing prices
univariate_df["unique_id"] = "NAS100" # add a unique_id column | very important for univariate models

# Final dataframe
univariate_df = univariate_df[["unique_id", "ds", "y"]].copy()

univariate_df
Resultados.
| unique_id | ds | y | |
|---|---|---|---|
| 0 | NAS100 | 2021-08-30 | 9.655648 |
| 1 | NAS100 | 2021-08-31 | 9.654988 |
| 2 | NAS100 | 2021-09-01 | 9.655763 |
| 3 | NAS100 | 2021-09-02 | 9.654981 |
| 4 | NAS100 | 2021-09-03 | 9.658335 |
| ... | ... | ... | ... |
| 995 | NAS100 | 2025-07-07 | 10.028180 |
| 996 | NAS100 | 2025-07-08 | 10.031142 |
| 997 | NAS100 | 2025-07-09 | 10.037376 |
| 998 | NAS100 | 2025-07-10 | 10.036098 |
| 999 | NAS100 | 2025-07-11 | 10.033283 |
univariate_df["unique_id"] = "NAS100" # add a unique_id column | very important for univariate models
O módulo neuralforecast, que inclui o modelo N-BEATS, permite realizar previsões tanto de séries temporais individuais quanto de múltiplas séries temporais organizadas em painel. O parâmetro unique_id informa ao modelo a qual série temporal cada linha pertence. Isso é especialmente importante quando:
- Você precisa gerar previsões para vários ativos ou símbolos (como AAPL, TSLA, MSFT e EURUSD).
- Você deseja treinar um único modelo com várias séries temporais em lote.
Esse parâmetro é obrigatório, mesmo quando trabalhamos com apenas uma série temporal, devido aos mecanismos internos de agrupamento e indexação.
O treinamento do modelo exige apenas algumas linhas de código.
from neuralforecast import NeuralForecast
from neuralforecast.models import NBEATS # Neural Basis Expansion Analysis for Time Series

# Define model and horizon
horizon = 30  # forecast 30 days into the future

model = NeuralForecast(
    models=[NBEATS(h=horizon, # predictive horizon of the model
                   input_size=90, # considered autorregresive inputs (lags), y=[1,2,3,4] input_size=2 -> lags=[1,2].
                   max_steps=100, # maximum number of training steps (epochs)
                   scaler_type='robust', # scaler type for the time series data
                   )],
    freq='D' # frequency of the time series data
)

# Fit the model
model.fit(df=univariate_df)
Resultados.
Seed set to 1
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
HPU available: False, using: 0 HPUs

  | Name         | Type          | Params | Mode
-------------------------------------------------------
0 | loss         | MAE           | 0      | train
1 | padder_train | ConstantPad1d | 0      | train
2 | scaler       | TemporalNorm  | 0      | train
3 | blocks       | ModuleList    | 2.6 M  | train
-------------------------------------------------------
2.6 M     Trainable params
7.3 K     Non-trainable params
2.6 M     Total params
10.541    Total estimated model params size (MB)
31        Modules in train mode
0         Modules in eval mode

Epoch 99: 100%
 1/1 [00:01<00:00,  0.88it/s, v_num=32, train_loss_step=0.259, train_loss_epoch=0.259]
`Trainer.fit` stopped: `max_steps=100` reached.
Podemos visualizar os valores previstos e reais no mesmo eixo.
forecast = model.predict() # predict future values based on the fitted model

# Merge forecast with original data
plot_df = pd.merge(univariate_df, forecast, on='ds', how='outer')

plt.figure(figsize=(7,5))
plt.plot(plot_df['ds'], plot_df['y'], label='Actual')
plt.plot(plot_df['ds'], plot_df['NBEATS'], label='Forecast')
plt.axvline(plot_df['ds'].max() - pd.Timedelta(days=horizon), color='gray', linestyle='--')
plt.legend()
plt.title('N-BEATS Forecast')
plt.show()
Resultados.
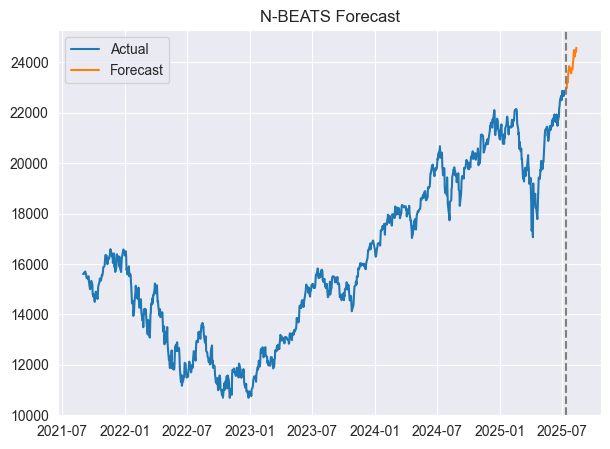
A seguir, mostramos o DataFrame resultante da combinação dos dados.
| unique_id_x | ds | y | unique_id_y | NBEATS | |
|---|---|---|---|---|---|
| 0 | NAS100 | 2021-08-31 | 15599.4 | NaN | NaN |
| 1 | NAS100 | 2021-09-01 | 15611.5 | NaN | NaN |
| 2 | NAS100 | 2021-09-02 | 15599.3 | NaN | NaN |
| 3 | NAS100 | 2021-09-03 | 15651.7 | NaN | NaN |
| 4 | NAS100 | 2021-09-06 | 15700.4 | NaN | NaN |
| ... | ... | ... | ... | ... | ... |
| 1025 | NaN | 2025-08-09 | NaN | NAS100 | 24235.187500 |
| 1026 | NaN | 2025-08-10 | NaN | NAS100 | 24466.316406 |
| 1027 | NaN | 2025-08-11 | NaN | NAS100 | 24454.646484 |
| 1028 | NaN | 2025-08-12 | NaN | NAS100 | 24405.820312 |
| 1029 | NaN | 2025-08-13 | NaN | NAS100 | 24571.919922 |
Ótimo! O modelo gerou previsões para os próximos 30 dias.
Para avaliar o modelo, vamos seguir o procedimento padrão: separar os dados em dois conjuntos, utilizando um para treinamento e outro para teste.
Previsão fora da amostra usando o modelo N-BEATS
Primeiro, dividimos os dados em conjuntos de treinamento e teste.
split_date = '2024-01-01'  # the split date for training and testing

train_df = univariate_df[univariate_df['ds'] < split_date]
test_df = univariate_df[univariate_df['ds'] >= split_date]
Treinamos o modelo com o conjunto de treinamento.
model = NeuralForecast(
    models=[NBEATS(h=horizon, # predictive horizon of the model
                   input_size=90, # considered autorregresive inputs (lags), y=[1,2,3,4] input_size=2 -> lags=[1,2].
                   max_steps=100, # maximum number of training steps (epochs)
                   scaler_type='robust', # scaler type for the time series data
                   )],
    freq='D' # frequency of the time series data
)

# Fit the model
model.fit(df=train_df)
Como a função predict gera previsões para os próximos N dias, de acordo com o horizonte de previsão definido, precisamos combinar os dados previstos com o DataFrame de valores reais para avaliar o desempenho do modelo fora da amostra.
test_forecast = model.predict() # predict future 30 days based on the training data

df_test = pd.merge(test_df, test_forecast, on=['ds', 'unique_id'], how='outer') # merge the test data with the forecast
df_test.dropna(inplace=True) # drop rows with NaN values

df_test
Resultados.
| unique_id | ds | y | NBEATS | |
|---|---|---|---|---|
| 3 | NAS100 | 2024-01-02 | 16554.3 | 16569.835938 |
| 4 | NAS100 | 2024-01-03 | 16368.1 | 16596.839844 |
| 5 | NAS100 | 2024-01-04 | 16287.2 | 16603.513672 |
| 6 | NAS100 | 2024-01-05 | 16307.1 | 16729.607422 |
| 9 | NAS100 | 2024-01-08 | 16631.0 | 16854.746094 |
| 10 | NAS100 | 2024-01-09 | 16672.4 | 16918.466797 |
| 11 | NAS100 | 2024-01-10 | 16804.7 | 16958.833984 |
| 12 | NAS100 | 2024-01-11 | 16814.3 | 17130.972656 |
| 13 | NAS100 | 2024-01-12 | 16808.8 | 17055.396484 |
| 16 | NAS100 | 2024-01-15 | 16828.7 | 17272.376953 |
| 17 | NAS100 | 2024-01-16 | 16841.9 | 17227.498047 |
| 18 | NAS100 | 2024-01-17 | 16727.7 | 17408.158203 |
| 19 | NAS100 | 2024-01-18 | 16987.0 | 17499.619141 |
| 20 | NAS100 | 2024-01-19 | 17336.7 | 17318.767578 |
| 23 | NAS100 | 2024-01-22 | 17329.3 | 17399.562500 |
| 24 | NAS100 | 2024-01-23 | 17426.1 | 17289.140625 |
| 25 | NAS100 | 2024-01-24 | 17503.1 | 17236.478516 |
| 26 | NAS100 | 2024-01-25 | 17469.4 | 17188.691406 |
| 27 | NAS100 | 2024-01-26 | 17390.1 | 17315.134766 |
Vamos avaliar os resultados.
from sklearn.metrics import mean_absolute_percentage_error, r2_score

mape = mean_absolute_percentage_error(df_test['y'], df_test['NBEATS'])
r2_score_ = r2_score(df_test['y'], df_test['NBEATS'])

print(f"mean_absolute_percentage_error (MAPE): {mape} \n R2 Score: {r2_score_}")
Resultados.
mean_absolute_percentage_error (MAPE): 0.015779373328172166
R2 Score: 0.35350182943487285
De acordo com a métrica MAPE, as previsões do modelo apresentam alta precisão em termos percentuais. No entanto, o valor de R2 = 0.35 indica que o modelo explica apenas 35% da variação da variável-alvo.
A seguir, apresentamos um gráfico com os valores reais e previstos no mesmo eixo.
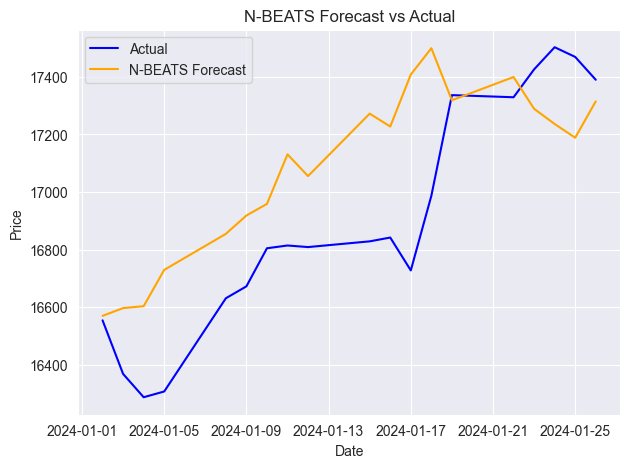
Como qualquer modelo de previsão de séries temporais, o N-BEATS precisa ser atualizado regularmente com novos dados sequenciais para manter suas previsões relevantes e precisas. Nos exemplos anteriores, avaliamos o modelo com base em previsões para os 30 dias seguintes, utilizando dados diários. Entretanto, essa abordagem não é totalmente adequada, pois o modelo deixa de considerar muitas informações diárias disponíveis entre as previsões.
A abordagem correta é atualizar o modelo à medida que novos dados são disponibilizados.
O N-BEATS oferece uma maneira prática de atualizar o modelo sem precisar retreiná-lo completamente, economizando bastante tempo.
Ao executar:
NBEATS.predict(df=new_dataframe) O modelo utiliza os pesos aprendidos durante o treinamento para realizar inferência com os novos dados. Dessa forma, as previsões são atualizadas com base nos dados recém-incorporados à amostra, sem necessidade de alterar os pesos do modelo.
Previsão de múltiplas séries temporais
Como vimos anteriormente na seção "Principais objetivos do modelo N-BEATS", o modelo foi desenvolvido para realizar previsões de múltiplas séries temporais com eficiência.
Essa capacidade é especialmente interessante porque o modelo aproveita os padrões aprendidos em uma série temporal para melhorar as previsões das demais séries.
Vamos ver como utilizar esse recurso.
Primeiro, coletamos os dados de cada instrumento no MetaTrader 5.
rates_nq = mt5.copy_rates_from_pos("NAS100", mt5.TIMEFRAME_D1, 1, 1000)
rates_df_nq = pd.DataFrame(rates_nq)

rates_snp = mt5.copy_rates_from_pos("US500", mt5.TIMEFRAME_D1, 1, 1000)
rates_df_snp = pd.DataFrame(rates_snp)
Preparamos um conjunto de dados univariados separado para cada símbolo.
# NAS100
rates_df_nq["ds"] = pd.to_datetime(rates_df_nq["time"], unit="s")
rates_df_nq["y"] = rates_df_nq["close"]
rates_df_nq["unique_id"] = "NAS100"
df_nq = rates_df_nq[["unique_id", "ds", "y"]]

# US500
rates_df_snp["ds"] = pd.to_datetime(rates_df_snp["time"], unit="s")
rates_df_snp["y"] = rates_df_snp["close"]
rates_df_snp["unique_id"] = "US500"
df_snp = rates_df_snp[["unique_id", "ds", "y"]]
Combinamos os dois conjuntos de dados e ordenamos os registros pelas colunas de data e unique_id.
multivariate_df = pd.concat([df_nq, df_snp], ignore_index=True) # combine both dataframes
multivariate_df = multivariate_df.sort_values(['unique_id', 'ds']).reset_index(drop=True) # sort by unique_id and date

multivariate_df
Resultados.
| unique_id | ds | y | |
|---|---|---|---|
| 0 | NAS100 | 2021-08-31 | 15599.4 |
| 1 | NAS100 | 2021-09-01 | 15611.5 |
| 2 | NAS100 | 2021-09-02 | 15599.3 |
| 3 | NAS100 | 2021-09-03 | 15651.7 |
| 4 | NAS100 | 2021-09-06 | 15700.4 |
| ... | ... | ... | ... |
| 1995 | US500 | 2025-07-08 | 6229.9 |
| 1996 | US500 | 2025-07-09 | 6264.9 |
| 1997 | US500 | 2025-07-10 | 6280.3 |
| 1998 | US500 | 2025-07-11 | 6255.8 |
| 1999 | US500 | 2025-07-14 | 6271.9 |
Assim como fizemos anteriormente, dividimos os dados em conjuntos de treinamento e teste.
split_date = '2024-01-01'  # the split date for training and testing

train_df = multivariate_df[multivariate_df['ds'] < split_date]
test_df = multivariate_df[multivariate_df['ds'] >= split_date]
Em seguida, treinamos o modelo.
from neuralforecast import NeuralForecast
from neuralforecast.models import NBEATS # Neural Basis Expansion Analysis for Time Series

# Define model and horizon
horizon = 30  # forecast 30 days into the future

model = NeuralForecast(
    models=[NBEATS(h=horizon, # predictive horizon of the model
                   input_size=90, # considered autorregresive inputs (lags), y=[1,2,3,4] input_size=2 -> lags=[1,2].
                   max_steps=100, # maximum number of training steps (epochs)
                   scaler_type='robust', # scaler type for the time series data
                   )],
    freq='D' # frequency of the time series data
)

# Fit the model
model.fit(df=train_df)
Geramos previsões utilizando os dados que não fizeram parte do conjunto de treinamento.
test_forecast = model.predict() # predict future 30 days based on the training data

df_test = pd.merge(test_df, test_forecast, on=['ds', 'unique_id'], how='outer') # merge the test data with the forecast
df_test.dropna(inplace=True) # drop rows with NaN values

df_test
Resultados.
| unique_id | ds | y | NBEATS | |
|---|---|---|---|---|
| 6 | NAS100 | 2024-01-02 | 16554.3 | 16267.765625 |
| 7 | US500 | 2024-01-02 | 4747.4 | 4706.230957 |
| 8 | NAS100 | 2024-01-03 | 16368.1 | 16230.808594 |
| 9 | US500 | 2024-01-03 | 4707.3 | 4706.517090 |
| 10 | NAS100 | 2024-01-04 | 16287.2 | 16136.568359 |
| 11 | US500 | 2024-01-04 | 4690.9 | 4686.380859 |
| 12 | NAS100 | 2024-01-05 | 16307.1 | 16218.930664 |
| 13 | US500 | 2024-01-05 | 4695.8 | 4704.896484 |
Por fim, avaliamos o desempenho do modelo para os dois instrumentos e visualizamos os valores reais e previstos no mesmo eixo.
from sklearn.metrics import mean_absolute_percentage_error, r2_score

unique_ids = df_test['unique_id'].unique()

for unique_id in unique_ids:

    df_unique = df_test[df_test['unique_id'] == unique_id].copy()

    mape = mean_absolute_percentage_error(df_unique['y'], df_unique['NBEATS'])
    r2_score_ = r2_score(df_unique['y'], df_unique['NBEATS'])


    print(f"Unique ID: {unique_id} - MAPE: {mape}, R2 Score: {r2_score_}")


    plt.figure(figsize=(7, 4))
    plt.plot(df_unique['ds'], df_unique['y'], label='Actual', color='blue')
    plt.plot(df_unique['ds'], df_unique['NBEATS'], label='Forecast', color='orange')
    plt.title(f'Actual vs Forecast for {unique_id}')
    plt.xlabel('Date')
    plt.ylabel('Value')
    plt.legend()
    plt.show()
Resultados.
Unique ID: NAS100 - MAPE: 0.0221775184381915, R2 Score: -0.16976266747298419

Unique ID: US500 - MAPE: 0.007412931117247571, R2 Score: 0.3782229067061038

Sinais de negociação baseados em N-BEATS no MetaTrader 5
Agora já conseguimos obter previsões com o modelo N-BEATS. Portanto, vamos integrá-lo a um robô de negociação desenvolvido em Python.
No arquivo NBEATS-tradingbot.py, começamos implementando uma função para realizar o treinamento inicial do modelo completo:
def train_nbeats_model(forecast_horizon: int=30,
                       start_bar: int=1,
                       number_of_bars: int=1000,
                       input_size: int=90,
                       max_steps: int=100,
                       mt5_timeframe: int=mt5.TIMEFRAME_D1,
                       symbol_01: str="NAS100",
                       symbol_02: str="US500",
                       test_size_percentage: float=0.2,
                       scaler_type: str='robust'):

    """
        Train NBEATS model on NAS100 and US500 data from MetaTrader 5.

        Args:
            start_bar: starting bar to be used to in CopyRates from MT5
            number_of_bars: The number of bars to extract from MT5 for training the model
            forecast_horizon: the number of days to predict in the future
            input_size: number of previous days to consider for prediction
            max_steps: maximum number of training steps (epochs)
            mt5_timeframe: timeframe to be used for the data extraction from MT5
            symbol_01: unique identifier for the first symbol (default is NAS100)
            symbol_02: unique identifier for the second symbol (default is US500)
            test_size_percentage: percentage of the data to be used for testing (default is 0.2)
            scaler_type: type of scaler to be used for the time series data (default is 'robust')

        Returns:
            NBEATS: the n-beats model object
    """

    # Getting data from MetaTrader 5

    rates_nq = mt5.copy_rates_from_pos(symbol_01, mt5_timeframe, start_bar, number_of_bars)
    rates_df_nq = pd.DataFrame(rates_nq)

    rates_snp = mt5.copy_rates_from_pos(symbol_02, mt5_timeframe, start_bar, number_of_bars)
    rates_df_snp = pd.DataFrame(rates_snp)

    if rates_df_nq.empty or rates_df_snp.empty:
        print(f"Failed to retrieve data for {symbol_01} or {symbol_02}.")
        return None

    # Getting NAS100 data
    rates_df_nq["ds"] = pd.to_datetime(rates_df_nq["time"], unit="s")
    rates_df_nq["y"] = rates_df_nq["close"]
    rates_df_nq["unique_id"] = symbol_01
    df_nq = rates_df_nq[["unique_id", "ds", "y"]]

    # Getting US500 data
    rates_df_snp["ds"] = pd.to_datetime(rates_df_snp["time"], unit="s")
    rates_df_snp["y"] = rates_df_snp["close"]
    rates_df_snp["unique_id"] = symbol_02
    df_snp = rates_df_snp[["unique_id", "ds", "y"]]

    multivariate_df = pd.concat([df_nq, df_snp], ignore_index=True) # combine both dataframes
    multivariate_df = multivariate_df.sort_values(['unique_id', 'ds']).reset_index(drop=True) # sort by unique_id and date

    # Group by unique_id and split per group
    train_df_list = []
    test_df_list = []

    for _, group in multivariate_df.groupby('unique_id'):
        group = group.sort_values('ds')
        split_idx = int(len(group) * (1 - test_size_percentage))

        train_df_list.append(group.iloc[:split_idx])
        test_df_list.append(group.iloc[split_idx:])

    # Concatenate all series
    train_df = pd.concat(train_df_list).reset_index(drop=True)
    test_df = pd.concat(test_df_list).reset_index(drop=True)

    # Define model and horizon

    model = NeuralForecast(
        models=[NBEATS(h=forecast_horizon, # predictive horizon of the model
                    input_size=input_size, # considered autorregresive inputs (lags), y=[1,2,3,4] input_size=2 -> lags=[1,2].
                    max_steps=max_steps, # maximum number of training steps (epochs)
                    scaler_type=scaler_type, # scaler type for the time series data
                    )],
        freq='D' # frequency of the time series data
    )

    # fit the model on the training data

    model.fit(df=train_df)

    test_forecast = model.predict() # predict future 30 days based on the training data

    df_test = pd.merge(test_df, test_forecast, on=['ds', 'unique_id'], how='outer') # merge the test data with the forecast
    df_test.dropna(inplace=True) # drop rows with NaN values


    unique_ids = df_test['unique_id'].unique()
    for unique_id in unique_ids:

        df_unique = df_test[df_test['unique_id'] == unique_id].copy()

        mape = mean_absolute_percentage_error(df_unique['y'], df_unique['NBEATS'])
        print(f"Unique ID: {unique_id} - MAPE: {mape:.2f}")

    return model
Essa função reúne todas as etapas de treinamento descritas anteriormente e retorna um objeto do modelo N-BEATS, que pode ser utilizado diretamente para gerar previsões.
A função responsável por prever os próximos valores utiliza uma abordagem semelhante à da função de treinamento.
def predict_next(model,
                  symbol_unique_id: str,
                  input_size: int=90):

    """
        Predict the next values for a given unique_id using the trained model.

        Args:
            model (NBEATS): the trained NBEATS model
            symbol_unique_id (str): unique identifier for the symbol to predict
            input_size (int): number of previous days to consider for prediction

        Returns:
            DataFrame: containing the predicted values for the next days
    """

    # Getting data from MetaTrader 5

    rates = mt5.copy_rates_from_pos(symbol_unique_id, mt5.TIMEFRAME_D1, 1, input_size * 2)  # Get enough data for prediction
    if rates is None or len(rates) == 0:
        print(f"Failed to retrieve data for {symbol_unique_id}.")
        return pd.DataFrame()

    rates_df = pd.DataFrame(rates)

    rates_df["ds"] = pd.to_datetime(rates_df["time"], unit="s")
    rates_df = rates_df[["ds", "close"]].rename(columns={"close": "y"})
    rates_df["unique_id"] = symbol_unique_id
    rates_df = rates_df.sort_values(by="ds").reset_index(drop=True)

    # Prepare the dataframe for reference & prediction
    univariate_df = rates_df[["unique_id", "ds", "y"]]
    forecast = model.predict(df=univariate_df)

    return forecast
Alimentamos o modelo com uma quantidade de dados equivalente ao dobro do valor de input_size utilizado durante o treinamento, para garantir que ele tenha informações suficientes.
Vamos chamar a função predict duas vezes para cada símbolo e examinar os dados obtidos.
trained_model = train_nbeats_model(max_steps=10)

print(predict_next(trained_model, "NAS100").head())
print(predict_next(trained_model, "US500").head())
Resultados.
Predicting DataLoader 0: 100%|████████████████████████████████████████████████████████████████████████████████████████████████| 1/1 [00:00<00:00, 45.64it/s]
  unique_id         ds        NBEATS
0    NAS100 2025-07-16  22836.160156
1    NAS100 2025-07-17  22931.242188
2    NAS100 2025-07-18  22984.792969
3    NAS100 2025-07-19  23037.224609
4    NAS100 2025-07-20  23119.804688
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
HPU available: False, using: 0 HPUs
Predicting DataLoader 0: 100%|████████████████████████████████████████████████████████████████████████████████████████████████| 1/1 [00:00<00:00, 71.43it/s]
  unique_id         ds       NBEATS
0     US500 2025-07-16  6234.584961
1     US500 2025-07-17  6254.846680
2     US500 2025-07-18  6261.153320
3     US500 2025-07-19  6282.960449
4     US500 2025-07-20  6307.293945
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
HPU available: False, using: 0 HPUs
Os dados obtidos para ambos os símbolos contêm previsões dos preços de fechamento para os próximos 30 dias (a data atual é 16/07/2025). Precisamos selecionar o valor previsto especificamente para o dia atual.
today = dt.datetime.now().date() # today's date

forecast_df = predict_next(trained_model, "NAS100") # Get the predicted values for NAS100, 30 days into the future
today_pred_close_nq = forecast_df[forecast_df['ds'].dt.date == today]['NBEATS'].values # extract today's predicted close value for NAS100

forecast_df = predict_next(trained_model, "US500") # Get the predicted values for US500, 30 days into the future
today_pred_close_snp = forecast_df[forecast_df['ds'].dt.date == today]['NBEATS'].values # extract today's predicted close value for US500

print(f"Today's predicted NAS100 values:", today_pred_close_nq)
print(f"Today's predicted US500 values:", today_pred_close_snp)
Resultados.
Today's predicted NAS100 values: [22836.16]
Today's predicted US500 values: [6234.585]
Por fim, podemos utilizar esses valores previstos em uma estratégia de negociação simples.
# Trading modules

from Trade.Trade import CTrade
from Trade.PositionInfo import CPositionInfo
from Trade.SymbolInfo import CSymbolInfo

SLIPPAGE = 100 # points
MAGIC_NUMBER = 15072025 # unique identifier for the trades
TIMEFRAME = mt5.TIMEFRAME_D1 # timeframe for the trades

# Create trade objects for NAS100 and US500
m_trade_nq = CTrade(magic_number=MAGIC_NUMBER,
                 filling_type_symbol = "NAS100",
                 deviation_points=SLIPPAGE)

m_trade_snp = CTrade(magic_number=MAGIC_NUMBER,
                 filling_type_symbol = "US500",
                 deviation_points=SLIPPAGE)

# Training the NBEATS model INITIALLY
trained_model = train_nbeats_model(max_steps=10,
                                    input_size=90,
                                    forecast_horizon=30,
                                    start_bar=1,
                                    number_of_bars=1000,
                                    mt5_timeframe=TIMEFRAME,
                                    symbol_01="NAS100",
                                    symbol_02="US500"
                                   )

m_symbol_nq = CSymbolInfo("NAS100") # Create symbol info object for NAS100
m_symbol_snp = CSymbolInfo("US500") # Create symbol info object for US500

m_position = CPositionInfo() # Create position info object


def pos_exists(pos_type: int, magic: int, symbol: str) -> bool:

    """ Checks whether a position exists given a magic number, symbol, and the position type

    Returns:
        bool: True if a position is found otherwise False
    """

    if mt5.positions_total() < 1: # no positions whatsoever
        return False

    positions = mt5.positions_get()

    for position in positions:
        if m_position.select_position(position):
            if m_position.magic() == magic and m_position.symbol() == symbol and m_position.position_type()==pos_type:
                return True

    return False


def RunStrategyandML(trained_model: NBEATS):

    today = dt.datetime.now().date() # today's date

    forecast_df = predict_next(trained_model, "NAS100") # Get the predicted values for NAS100, 30 days into the future
    today_pred_close_nq = forecast_df[forecast_df['ds'].dt.date == today]['NBEATS'].values # extract today's predicted close value for NAS100

    forecast_df = predict_next(trained_model, "US500") # Get the predicted values for US500, 30 days into the future
    today_pred_close_snp = forecast_df[forecast_df['ds'].dt.date == today]['NBEATS'].values # extract today's predicted close value for US500

    # convert numpy arrays to float values

    today_pred_close_nq = float(today_pred_close_nq[0]) if len(today_pred_close_nq) > 0 else None
    today_pred_close_snp = float(today_pred_close_snp[0]) if len(today_pred_close_snp) > 0 else None

    print(f"Today's predicted NAS100 values:", today_pred_close_nq)
    print(f"Today's predicted US500 values:", today_pred_close_snp)

    # Refreshing the rates for NAS100 and US500 symbols

    m_symbol_nq.refresh_rates()
    m_symbol_snp.refresh_rates()

    ask_price_nq = m_symbol_nq.ask() # get today's close price for NAS100
    ask_price_snp = m_symbol_snp.ask() # get today's close price for US500

    # Trading operations for the NAS100 symol

    if not pos_exists(pos_type=mt5.ORDER_TYPE_BUY, magic=MAGIC_NUMBER, symbol="NAS100"):
        if today_pred_close_nq > ask_price_nq: # if predicted close price for NAS100 is greater than the current ask price
            # Open a buy trade
            m_trade_nq.buy(volume=m_symbol_nq.lots_min(),
                            symbol="NAS100",
                            price=m_symbol_nq.ask(),
                            sl=0.0,
                            tp=today_pred_close_nq) # set take profit to the predicted close price

    print("ask: ", m_symbol_nq.ask(), "bid: ", m_symbol_nq.bid(), "last: ", ask_price_nq)
    print("tp: ", today_pred_close_nq, "lots: ", m_symbol_nq.lots_min())
    print("istp within range: ", (m_symbol_nq.ask() - today_pred_close_nq) > m_symbol_nq.stops_level())

    if not pos_exists(pos_type=mt5.ORDER_TYPE_SELL, magic=MAGIC_NUMBER, symbol="NAS100"):
        if today_pred_close_nq < ask_price_nq: # if predicted close price for NAS100 is less than the current bid price
            m_trade_nq.sell(volume=m_symbol_nq.lots_min(),
                             symbol="NAS100",
                             price=m_symbol_nq.bid(),
                             sl=0.0,
                             tp=today_pred_close_nq) # set take profit to the predicted close price


    # Buy and sell operations for the US500 symbol


    if not pos_exists(pos_type=mt5.ORDER_TYPE_BUY, magic=MAGIC_NUMBER, symbol="US500"):
        if today_pred_close_snp > ask_price_snp: # if the predicted price for US500 is greater than the current ask price
            m_trade_snp.buy(volume=m_symbol_snp.lots_min(),
                            symbol="US500",
                            price=m_symbol_snp.ask(),
                            sl=0.0,
                            tp=today_pred_close_snp)

    if not pos_exists(pos_type=mt5.ORDER_TYPE_SELL, magic=MAGIC_NUMBER, symbol="US500"):
        if today_pred_close_snp < ask_price_snp: # if the predicted price for US500 is less than the current bid price
            m_trade_snp.sell(volume=m_symbol_snp.lots_min(),
                             symbol="US500",
                             price=m_symbol_snp.bid(),
                             sl=0.0,
                             tp=today_pred_close_snp)


RunStrategyandML(trained_model=trained_model) # Run the strategy and ML model once to initialize
Resultados.
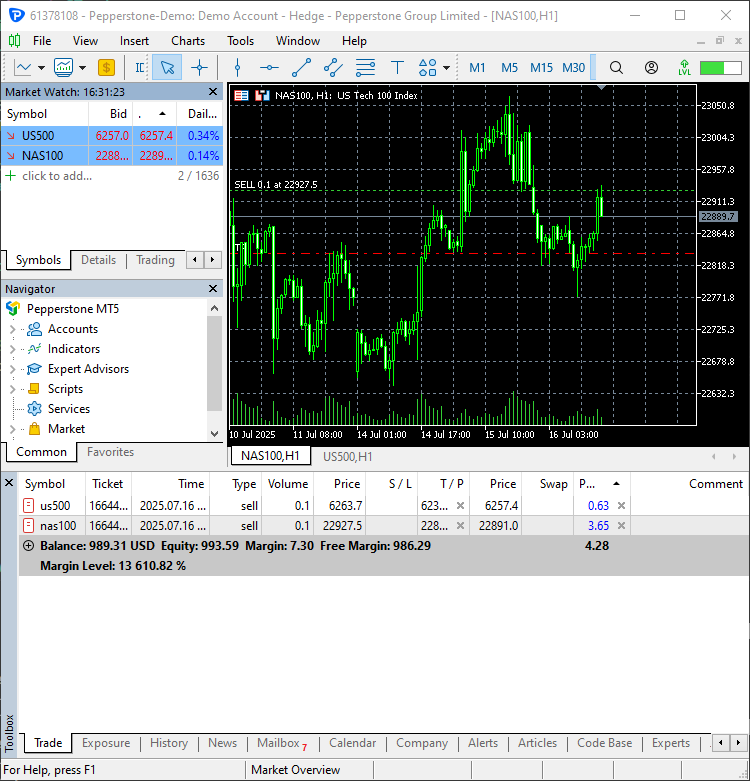
Duas novas operações foram abertas.
Agora podemos programar o treinamento e automatizar o modelo para que ele gere previsões e abra operações no início de cada dia.
# Schedule the strategy to run every day at 00:00
schedule.every().day.at("00:00").do(RunStrategyandML, trained_model=trained_model)

while True:

    schedule.run_pending()
    time.sleep(10)
Conclusão
O N-BEATS é um modelo eficiente para análise e previsão de séries temporais. Ele supera modelos clássicos, como ARIMA, VAR e PROPHET, entre outros, graças ao uso de redes neurais capazes de identificar padrões complexos.
O N-BEATS é uma boa alternativa para quem deseja prever séries temporais utilizando abordagens não tradicionais.
Um aspecto de que gosto nesse modelo é a inclusão de técnicas de normalização e ferramentas de avaliação, que facilitam sua utilização.
No entanto, como qualquer modelo de machine learning, o N-BEATS apresenta algumas limitações que devemos considerar:
- Desenvolvido principalmente para previsão univariadaComo vimos anteriormente, o treinamento do modelo exige apenas dois atributos: ds (data) e a variável-alvo y, de maneira semelhante ao modelo PROPHET, que já abordamos anteriormente.
No contexto financeiro, essas informações podem ser insuficientes para representar adequadamente a dinâmica do mercado. - Risco de sobreajuste em dados ruidososAssim como outras redes neurais profundas, o N-BEATS pode sofrer sobreajuste quando os dados contêm muito ruído.
- Interpretabilidade limitadaEmbora o N-BEATS utilize a decomposição em funções de base para facilitar a interpretação dos resultados, ele continua sendo uma rede neural profunda e apresenta menor interpretabilidade em comparação com modelos de séries temporais, como ARIMA ou PROPHET.
- Menor difusãoÉ provável que você ainda não tenha tido contato com esse modelo.
Apesar de seu alto desempenho em pesquisas acadêmicas, ele não alcançou a mesma popularidade de modelos como ARIMA, XGBoost e LSTM na comunidade de machine learning. Também existem poucas publicações disponíveis na internet sobre suas aplicações.
Tabela de anexos
| Nome do arquivo | Descrição e finalidade |
|---|---|
| Trade\PositionInfo.py | Contém a classe CPositionInfo, análoga à classe correspondente em MQL5; fornece informações sobre todas as posições abertas no MetaTrader 5. |
| Trade\SymbolInfo.py | Contém a classe CSymbolInfo, análoga à classe correspondente em MQL5; fornece todas as informações sobre o símbolo selecionado no MetaTrader 5. |
| Trade\Trade.py | Contém a classe CTrade, análoga à classe correspondente em MQL5; fornece funções para abrir e fechar operações no MetaTrader 5. |
| error_description.py | Contém funções que convertem os códigos de erro do MetaTrader 5 em descrições legíveis. |
| NBEATS-Tradingbot.py | Script em Python que utiliza o modelo N-BEATS para tomar decisões de negociação. |
| test.ipynb | Notebook Jupyter para realizar experimentos com o modelo N-BEATS. |
| requirements.txt | Contém todas as dependências Python utilizadas neste projeto. |
Fontes e referências
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18242
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 76): Uso de padrões do Awesome Oscillator e canais de envelopes com aprendizado supervisionado
 Repensando as estratégias clássicas (Parte 14): Análise de múltiplas estratégias
 Automatização de estratégias de negociação em MQL5 (Parte 24): Sistema de negociação por rompimento da sessão de Londres com gerenciamento de risco e trailing stops
 Desenvolvimento de ferramentas para análise de Price Action (Parte 32): Módulo de reconhecimento de padrões de candles em Python (II): Reconhecimento com TA-Lib

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Confira o novo artigo: Ciência de Dados e Aprendizado de Máquina (Parte 46): Previsão dos mercados de ações usando o N-BEATS em Python.
Autor: Omega J Msigwa