

Ciência de Dados e ML (Parte 36): Lidando com Mercados Financeiros Tendenciosos
 65
 3

Conteúdo
- Introdução
- Limitações de uma variável-alvo desbalanceada em machine learning
- Técnicas para lidar com o problema de conjunto de dados desbalanceados
- Escolhendo a métrica de avaliação adequada
- Um Expert Advisor (EA) para testes
- Técnicas de oversampling
- Técnicas de undersampling
- Métodos híbridos
- Conclusão
Introdução
Diferentes mercados de Forex e instrumentos financeiros apresentam comportamentos distintos em diferentes períodos. Enquanto alguns mercados financeiros, como ações e índices, frequentemente apresentam tendências de alta no longo prazo, outros, como o mercado Forex, podem apresentar movimentos de baixa e outros padrões de comportamento. Essa incerteza aumenta a complexidade da tarefa de prever o mercado utilizando técnicas de Inteligência Artificial (IA) e modelos de Machine Learning (ML).
Vamos selecionar alguns mercados financeiros (símbolos de trading) e visualizar a direção de 1.000 barras do mercado no timeframe diário. Se o preço de fechamento de uma barra estiver acima do preço de abertura, podemos classificá-la como uma barra de alta (1). Caso contrário, podemos classificá-la como uma barra de baixa (0).
import pandas as pd
import numpy as np

symbols = [
    "EURUSD",
    "USTEC",
    "XAUUSD",
    "USDJPY",
    "BTCUSD",
    "CA60",
    "UK100"
]

for symbol in symbols:

    df = pd.read_csv(fr"C:\Users\Omega Joctan\AppData\Roaming\MetaQuotes\Terminal\1640F6577B1C4EC659BF41EA9F6C38ED\MQL5\Files\{symbol}.PERIOD_D1.data.csv")
    df["Candle type"] = (df["Close"] > df["Open"]).astype(int)

    print(f"{symbol}(unique):",np.unique(df["Candle type"], return_counts=True))
Resultado.
EURUSD(unique): (array([0, 1]), array([496, 504]))
USTEC(unique): (array([0, 1]), array([472, 528]))
XAUUSD(unique): (array([0, 1]), array([472, 528]))
USDJPY(unique): (array([0, 1]), array([408, 592]))
BTCUSD(unique): (array([0, 1]), array([478, 522]))
CA60(unique): (array([0, 1]), array([470, 530]))
UK100(unique): (array([0, 1]), array([463, 537]))
Como podemos observar no resultado acima, nenhum dos símbolos de trading está perfeitamente equilibrado, pois historicamente ocorreram quantidades diferentes de candles de baixa e de alta.
Não há nada de errado em o mercado apresentar um viés em determinada direção. No entanto, esse viés presente nos dados históricos pode causar alguns problemas durante o treinamento de modelos de machine learning. Veja como:
Suponha que desejemos treinar um modelo para o USDJPY utilizando o conjunto de dados atual, que possui 1.000 barras. Temos 408 candles de baixa (identificados como 0), correspondentes a 40,8% de todos os sinais de trading, enquanto temos 592 candles de alta (identificados como 1), que representam 59,2% de todos os sinais de trading.
A predominância dos sinais de alta em relação aos sinais de baixa tende a influenciar os modelos de machine learning, pois eles geralmente favorecem a classe dominante e, consequentemente, passam a produzir previsões que favorecem essa classe.
Como todos os modelos buscam atingir o menor valor de perda possível acompanhado da maior acurácia possível, eles tenderão a favorecer a classe de alta, que ocorreu em 59,2% dos casos, como uma maneira simples de alcançar um valor elevado de acurácia.
Isso não é difícil de entender. Utilizando apenas essa informação e ignorando todos os preditores e tudo o que está acontecendo no mercado, poderíamos simplesmente afirmar, ao prever o USDJPY, que todas as barras serão de alta. Fazendo isso, estaríamos corretos em aproximadamente 59,2% das vezes. Nada mal, certo? Errado!
Ao fazer isso, estaríamos supondo que aquilo que aconteceu no passado necessariamente voltará a acontecer, uma suposição extremamente equivocada no mundo do trading.
Como podemos perceber, ter uma variável-alvo desbalanceada em dados de classificação para machine learning representa um problema. A seguir, veremos algumas das principais limitações decorrentes dessa situação.
Limitações de Variáveis-Alvo Desbalanceadas em Machine Learning
- Baixo desempenho na classe minoritária
Como mencionado anteriormente, o modelo tende a direcionar suas previsões para a classe majoritária porque busca otimizar a acurácia geral. Por exemplo, em dados de detecção de fraude com 99% de casos legítimos e 1% de casos fraudulentos, como a maioria das pessoas não comete fraude, um modelo poderia sempre prever "não fraude" e ainda assim alcançar 99% de acurácia, mas falharia em detectar as fraudes. - Métricas de avaliação enganosas
O valor da acurácia torna-se pouco confiável. Podemos ter um modelo com acurácia geral de 72% sem perceber que uma das classes foi prevista com 95% de acurácia, enquanto outra apresentou apenas 50%. - Overfitting dos modelos na classe majoritária
Os modelos podem memorizar ruídos presentes na classe majoritária e tomar decisões enviesadas, em vez de aprender os padrões gerais presentes nos preditores. Por exemplo, em dados de diagnóstico médico com 95% de indivíduos saudáveis e 5% de indivíduos com determinada doença, o modelo pode simplesmente ignorar os casos da doença. - Baixa capacidade de generalização para dados não vistos anteriormente (dados reais)
Em dados do mundo real, a distribuição pode mudar de forma rápida e frequente. Se um modelo tiver sido treinado em um ambiente enviesado, provavelmente apresentará falhas mais cedo ou mais tarde, pois foi treinado com uma distribuição que não representa adequadamente as condições reais.
Técnicas para Lidar com o Problema de Conjunto de Dados Desbalanceados
Agora que conhecemos as limitações associadas a uma variável-alvo desbalanceada (enviesada) em um problema de classificação, vamos discutir diferentes maneiras de lidar com essa questão.
01: Escolhendo a Métrica de Avaliação Adequada
A primeira técnica para lidar com dados desbalanceados é escolher uma métrica de avaliação adequada. Como vimos anteriormente, a acurácia de um classificador — calculada dividindo-se o número total de previsões corretas pelo número total de previsões — pode ser enganosa quando os dados estão desbalanceados.
Em problemas com dados desbalanceados, outras métricas são muito mais úteis do que a acurácia. Entre elas estão a precision, que mede a precisão das previsões do classificador para uma determinada classe, e o recall, que mede a capacidade do classificador de identificar corretamente uma classe.
Ao trabalhar com conjunto de dados desbalanceados, muitos especialistas em machine learning utilizam o F1-score, pois ele é mais adequado para esse tipo de situação.
Ele corresponde à média harmônica entre precision e recall, representada pela seguinte fórmula.
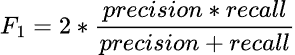
Portanto, se o classificador prever a classe minoritária, mas essa previsão estiver incorreta e o número de falsos positivos aumentar, a precision será baixa e, consequentemente, o F1-score também será baixo.
Da mesma forma, se o classificador tiver dificuldade para identificar corretamente a classe minoritária, o número de falsos negativos aumentará e, consequentemente, o recall e o F1-score serão baixos.
O F1-score só aumenta quando melhoram tanto a cobertura quanto a qualidade geral das previsões.
Para entender melhor esse conceito, vamos treinar um classificador RandomForest simples utilizando os dados desbalanceados do USDJPY.
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# Global variables

symbol = "USDJPY"
timeframe = "PERIOD_D1"
lookahead = 1
common_path = r"C:\Users\Omega Joctan\AppData\Roaming\MetaQuotes\Terminal\Common\Files"

df = pd.read_csv(f"{common_path}\{symbol}.{timeframe}.data.csv")

# Target variable

df["future_close"] = df["Close"].shift(-lookahead) # future closing price based on lookahead value
df.dropna(inplace=True)

df["Signal"] = (df["future_close"] > df["Close"]).astype(int)

print("Signals(unique): ",np.unique(df["Signal"], return_counts=True))

X = df.drop(columns=["Signal", "future_close"])
y = df["Signal"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42, shuffle=False)

model = RandomForestClassifier(n_estimators=100,
                               max_depth=5,
                               min_samples_split=3,
                               random_state=42)

model.fit(X_train, y_train)
Após o treinamento, podemos salvar o modelo no formato ONNX para utilizá-lo posteriormente no MetaTrader 5.
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
import os

def saveModel(model, n_features: int, technique_name: str):

    initial_type = [("input", FloatTensorType([None, n_features]))]

    onnx_model = convert_sklearn(model, initial_types=initial_type, target_opset=14)

    with open(os.path.join(common_path, f"{symbol}.{timeframe}.{technique_name}.onnx"), "wb") as f:
        f.write(onnx_model.SerializeToString())
saveModel(model=model, n_features=X_train.shape[1], technique_name="no-sampling")
Precisei utilizar o método classification report para observar as diferentes métricas disponíveis no Scikit-Learn.
Train Classification report
               precision    recall  f1-score   support

           0       0.98      0.41      0.57       158
           1       0.68      1.00      0.81       204

    accuracy                           0.74       362
   macro avg       0.83      0.70      0.69       362
weighted avg       0.81      0.74      0.71       362
Análise do classification report do treinamento
A acurácia geral do modelo durante o treinamento foi de 0,74, o que pode parecer um resultado razoável à primeira vista. No entanto, uma análise mais detalhada das métricas de cada classe revela um desequilíbrio significativo no desempenho do modelo entre as duas classes. A classe 0 apresenta uma precision muito alta, de 0,98, mas um recall baixo, de 0,41, resultando em um F1-score de apenas 0,57.
Isso significa que, embora o modelo apresente alta precisão quando prevê a classe 0, ele deixa de identificar uma grande quantidade de amostras que realmente pertencem a essa classe, indicando baixa sensibilidade.
A classe 1, por outro lado, apresenta recall de 1,00 e F1-score de 0,81, mas uma precision relativamente menor, de 0,68.
Isso sugere que o modelo apresenta um viés excessivo em favor da previsão da classe 1, possivelmente resultando em um grande número de falsos positivos.
O recall perfeito de 1,00 para a classe 1 é um sinal de alerta, pois pode indicar overfitting ou um viés em favor da classe majoritária.
O modelo está prevendo quase tudo como classe 1 e deixando de identificar muitas amostras que realmente pertencem à classe 0, como podemos observar pelo baixo recall de 0,41 da classe 0.
De modo geral, essas métricas não apenas demonstram o desbalanceamento, como também levantam dúvidas sobre a capacidade de generalização do modelo e sobre a consistência de seu desempenho entre as diferentes classes. Claramente, há algo errado aqui.
Vamos utilizar técnicas de oversampling para melhorar nosso modelo e buscar um maior equilíbrio nas previsões.
Um Expert Advisor (EA) para Testes
Sempre existe uma diferença entre os resultados obtidos na análise de um modelo de machine learning, como o classification report apresentado acima, e os resultados reais das operações no MetaTrader 5. Como salvaremos o modelo no formato ONNX para utilizá-lo posteriormente, podemos criar um robô de trading simples que utilize modelos treinados com cada uma das técnicas de reamostragem discutidas neste artigo e e usá-los para tomar decisões de trading no Strategy Tester utilizando a amostra de treinamento.
Os dados utilizados foram coletados pelo arquivo chamado Collectdata.mq5, um script que coleta os dados de treinamento de 01.01.2025 até 01.01.2023. Você pode encontrá-lo nos arquivos anexados a este artigo.
No Expert Advisor (EA) chamado Test Resampling Techniques.mq5, inicializamos o modelo no formato ONNX e, em seguida, o utilizamos para realizar previsões.
#include <Random Forest.mqh>
CRandomForestClassifier random_forest; //A class for loading the RFC in ONNX format

#include <Trade\Trade.mqh>
#include <Trade\PositionInfo.mqh>

CTrade m_trade;
CPositionInfo m_position;

input string symbol_ = "USDJPY";
input int magic_number= 14042025;
input int slippage = 100;
input ENUM_TIMEFRAMES timeframe_ = PERIOD_D1;
input string technique_name = "randomoversampling";

int lookahead = 1;
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---

   if (!random_forest.Init(StringFormat("%s.%s.%s.onnx", symbol_, EnumToString(timeframe_), technique_name), ONNX_COMMON_FOLDER)) //Initializing the RFC in ONNX format from a commmon folder
     return INIT_FAILED;

//--- Setting up the CTrade module

   m_trade.SetExpertMagicNumber(magic_number);
   m_trade.SetDeviationInPoints(slippage);
   m_trade.SetMarginMode();
   m_trade.SetTypeFillingBySymbol(symbol_);

//---
   return(INIT_SUCCEEDED);
  }
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---

  }
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---

   vector x = {
      iOpen(symbol_, timeframe_, 1),
      iHigh(symbol_, timeframe_, 1),
      iLow(symbol_, timeframe_, 1),
      iClose(symbol_, timeframe_, 1)
   };

   long signal = random_forest.predict_bin(x); //Predicted class
   double proba = random_forest.predict_proba(x).Max(); //Maximum predicted probability

   MqlTick ticks;
   if (!SymbolInfoTick(symbol_, ticks))
      {
         printf("Failed to obtain ticks information, Error = %d",GetLastError());
         return;
      }

   double volume_ = SymbolInfoDouble(symbol_, SYMBOL_VOLUME_MIN);


   if (signal == 1)
     {
        if (!PosExists(POSITION_TYPE_BUY) && !PosExists(POSITION_TYPE_SELL))
            m_trade.Buy(volume_, symbol_, ticks.ask,0,0);
     }

   if (signal == 0)
     {
        if (!PosExists(POSITION_TYPE_SELL) && !PosExists(POSITION_TYPE_BUY))
            m_trade.Sell(volume_, symbol_, ticks.bid,0,0);
     }

//---

   CloseTradeAfterTime((Timeframe2Minutes(timeframe_)*lookahead)*60); //Close the trade after a certain lookahead and according the the trained timeframe
  }
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
bool PosExists(ENUM_POSITION_TYPE type)
 {
    for (int i=PositionsTotal()-1; i>=0; i--)
      if (m_position.SelectByIndex(i))
         if (m_position.Symbol()==symbol_ && m_position.Magic() == magic_number && m_position.PositionType()==type)
            return (true);

    return (false);
 }
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
bool ClosePos(ENUM_POSITION_TYPE type)
 {
    for (int i=PositionsTotal()-1; i>=0; i--)
      if (m_position.SelectByIndex(i))
         if (m_position.Symbol() == symbol_ && m_position.Magic() == magic_number && m_position.PositionType()==type)
            {
              if (m_trade.PositionClose(m_position.Ticket()))
                return true;
            }

    return (false);
 }
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+
void CloseTradeAfterTime(int period_seconds)
{
   for (int i = PositionsTotal() - 1; i >= 0; i--)
      if (m_position.SelectByIndex(i))
         if (m_position.Magic() == magic_number)
            if (TimeCurrent() - m_position.Time() >= period_seconds)
               m_trade.PositionClose(m_position.Ticket(), slippage);
}
//+------------------------------------------------------------------+
//|                                                                  |
//+------------------------------------------------------------------+

int Timeframe2Minutes(ENUM_TIMEFRAMES tf)
{
    switch(tf)
    {
        case PERIOD_M1:  return 1;
        case PERIOD_M2:  return 2;
        case PERIOD_M3:  return 3;
        case PERIOD_M4:  return 4;
        case PERIOD_M5:  return 5;
        case PERIOD_M6:  return 6;
        case PERIOD_M10: return 10;
        case PERIOD_M12: return 12;
        case PERIOD_M15: return 15;
        case PERIOD_M20: return 20;
        case PERIOD_M30: return 30;
        case PERIOD_H1:  return 60;
        case PERIOD_H2:  return 120;
        case PERIOD_H3:  return 180;
        case PERIOD_H4:  return 240;
        case PERIOD_H6:  return 360;
        case PERIOD_H8:  return 480;
        case PERIOD_H12: return 720;
        case PERIOD_D1:  return 1440; // 1 day = 1440 minutes
        case PERIOD_W1:  return 10080; // 1 week = 7 * 1440 minutes
        case PERIOD_MN1: return 43200; // Approx. 1 month = 30 * 1440 minutes

        default:
            PrintFormat("Unknown timeframe: %d", tf);
            return 0;
    }
}
Como treinamos o modelo utilizando uma variável-alvo baseada em um valor de número de barras à frente igual a 1, precisamos encerrar a operação depois que o número de barras definido pelo antecipação tiver transcorrido no timeframe atual. Dessa forma, garantimos que o valor de antecipação seja respeitado, mantendo e encerrando nossas operações de acordo com o horizonte de previsão do modelo.
Antes de analisarmos os resultados das operações realizadas pelos modelos treinados com dados reamostrados, vamos observar o desempenho de trading de um modelo treinado com os dados originais, sem reamostragem (dados brutos).
Configurações do Strategy Tester.
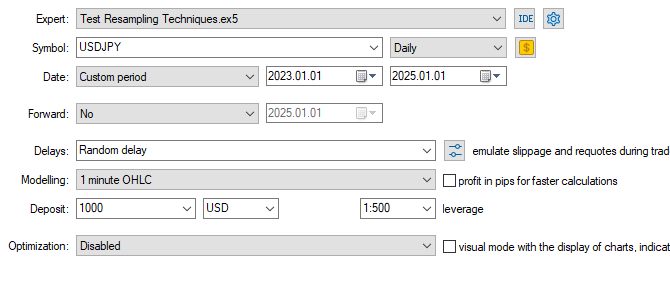
Parâmetros de entrada: technique_name = no-sampling.
Resultados do Strategy Tester.
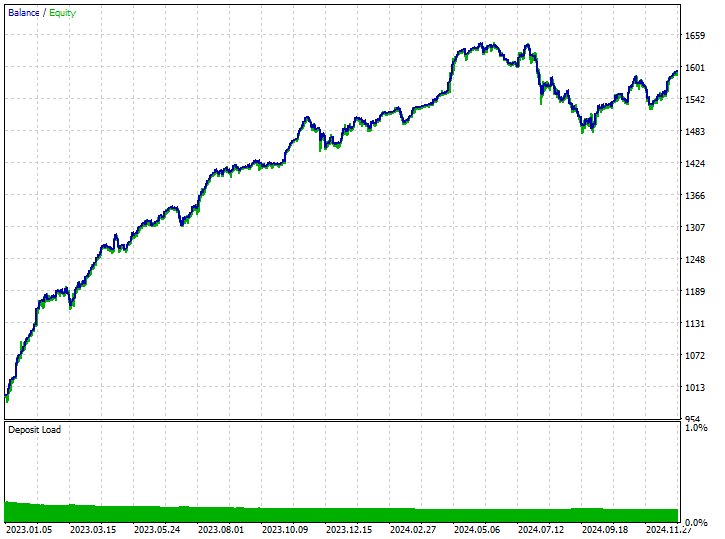
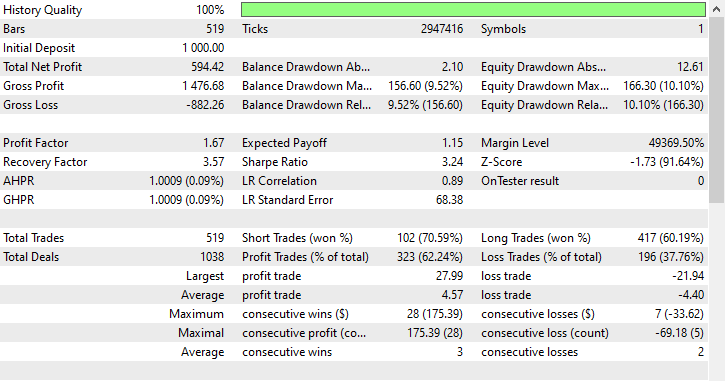
Apesar de o modelo ter conseguido identificar alguns bons sinais e apresentar resultados operacionais relevantes, com as operações lucrativas representando 62,24% de todas as operações realizadas, existe um desequilíbrio evidente. Ao observarmos separadamente as operações de venda e de compra vencedoras, podemos perceber uma proporção de aproximadamente 1:4 entre operações curtas e longas.
Das 519 operações realizadas, 102 foram operações curtas, com uma taxa de acerto de 70,59%, enquanto 417 foram operações curtas, com uma taxa de acerto de 60,19%. Claramente, há algo fora do esperado, pois, se analisarmos a direção dos candles entre 1º de janeiro de 2023 e 1º de janeiro de 2025 utilizando um valor de antecipação igual a 1:
print("classes in y: ",np.unique(y, return_counts=True))
Resultado.
classes in y: (array([0, 1]), array([225, 293]))
Podemos observar que ocorreram 225 movimentos de baixa e 293 movimentos de alta. Como a maioria dos candles do USDJPY apresentou movimentos de alta durante esse período de dois anos (de 1º de janeiro de 2023 a 1º de janeiro de 2025), até mesmo um modelo ruim que favorecesse os movimentos de alta poderia gerar lucro. Não é tão difícil assim.
Agora podemos entender que a principal razão pela qual o modelo conseguiu gerar algum lucro foi o fato de ter favorecido as operações longas em uma proporção quatro vezes maior do que as operações curtas.
Como o mercado apresentou predominantemente movimentos de alta durante esse período, o modelo conseguiu gerar algum lucro.
Vamos prosseguir com as técnicas de reamostragem e analisar como podemos reduzir esse viés na tomada de decisões dos nossos modelos.
Técnicas de Oversampling
Random Oversampling
Essa é uma técnica utilizada para lidar com o desbalanceamento entre classes em conjunto de dados por meio da duplicação aleatória de amostras existentes da classe minoritária.
Ela consiste em selecionar aleatoriamente exemplos existentes da classe minoritária e duplicá-los para aumentar sua representatividade nos dados de treinamento, buscando equilibrar a distribuição das classes em conjunto de dados desbalanceados.
A ferramenta mais utilizada para essa tarefa é a imbalanced-learn. Abaixo, apresentamos uma maneira simples de utilizá-la.
from imblearn.over_sampling import RandomOverSampler

print("b4 Target: ",np.unique(y_train, return_counts=True))

rus = RandomOverSampler(random_state=42)
X_resampled, y_resampled = rus.fit_resample(X_train, y_train)

print("After Target: ",np.unique(y_resampled, return_counts=True))
Saídas.
b4 Target:  (array([0, 1]), array([304, 395]))
After Target:  (array([0, 1]), array([395, 395]))
Podemos ajustar o mesmo RandomForestClassifier utilizado anteriormente aos dados reamostrados e observar a diferença nos resultados em comparação com aqueles obtidos sem a reamostragem dos dados.
model.fit(X_resampled, y_resampled)
Avaliação do modelo.
y_train_pred = model.predict(X_train)

print("Train Classification report\n",classification_report(y_train, y_train_pred))
Resultado.
Train Classification report
               precision    recall  f1-score   support

           0       0.82      0.85      0.83       158
           1       0.88      0.86      0.87       204

    accuracy                           0.85       362
   macro avg       0.85      0.85      0.85       362
weighted avg       0.85      0.85      0.85       362
Excelente! Esses resultados indicam uma melhora significativa em todas as métricas. Os F1-scores de 0,87 para ambas as classes sugerem que o modelo está produzindo previsões mais equilibradas e consistentes, indicando uma boa capacidade de generalização e um aprendizado bem distribuído entre as classes da variável-alvo.
Apesar de sua simplicidade e eficácia, o oversampling pode aumentar o risco de overfitting ao criar cópias das amostras da classe minoritária, que podem não acrescentar novas informações ao modelo.
Utilizando as mesmas configurações do Strategy Tester, podemos testar o modelo treinado com esses dados.
Parâmetros de entrada: technique_name = randomoversampling.
Resultados do Strategy Tester.
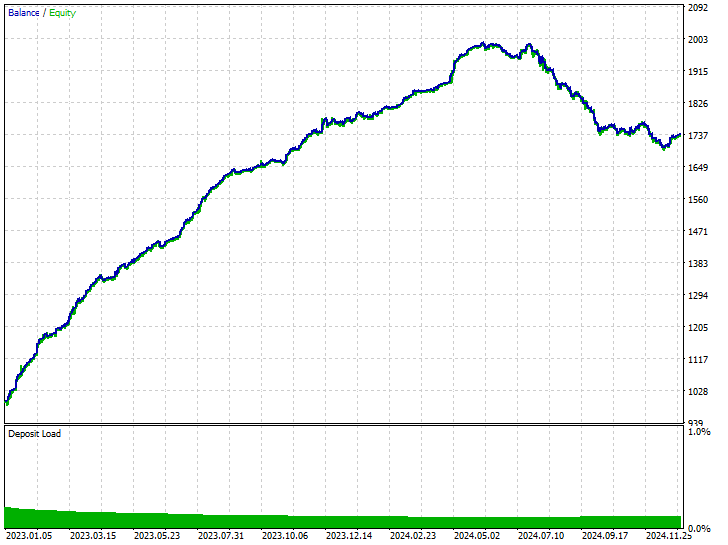
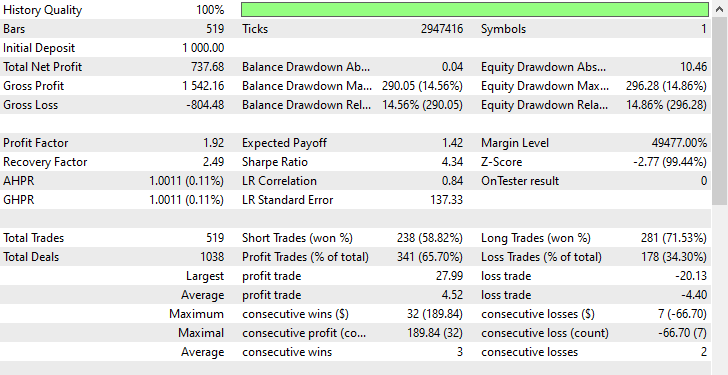
Como podemos observar, houve melhorias em diversos aspectos do trading. Esse modelo é mais robusto do que aquele treinado com os dados brutos. Agora, o robô abre mais operações curtas, o que resultou em uma redução significativa na quantidade de operações longas.
Novamente, neste período de treinamento, o mercado apresentou 225 movimentos de baixa e 293 de alta, respectivamente, conforme a definição da variável-alvo; este novo modelo, treinado com dados submetidos a sobreamostragem, parece abrir 238 operações short (venda) e 281 de long (compra), respectivamente. Esse é um bom indício de que o modelo não apresenta viés, uma vez que toma decisões baseadas principalmente nos padrões aprendidos.
Técnicas de Undersampling
Existem diversas técnicas de undersampling disponíveis em diferentes módulos do Python. Algumas delas são:
Random Undersampling
Essa é uma técnica utilizada para lidar com o desbalanceamento entre classes em conjunto de dados, reduzindo o número de amostras da classe majoritária para equilibrá-la com a classe minoritária.
Ela consiste em remover, de maneira aleatória ou estratégica, amostras da classe majoritária.
De maneira semelhante ao que fizemos com o oversampling, podemos aplicar undersampling à classe majoritária da seguinte forma.
from imblearn.under_sampling import RandomUnderSampler

print("b4 Target: ",np.unique(y_train, return_counts=True))

rus = RandomUnderSampler(random_state=42)
X_resampled, y_resampled = rus.fit_resample(X_train, y_train)

print("After Target: ",np.unique(y_resampled, return_counts=True))
Resultado.
b4 Target:  (array([0, 1]), array([304, 395]))
After Target:  (array([0, 1]), array([304, 304]))
O Random Undersampling e outras técnicas de undersampling podem reduzir o desempenho do modelo ao remover amostras relevantes da classe majoritária, resultando em um conjunto de treinamento menos representativo. Isso pode potencialmente causar underfitting no modelo.
Essa técnica melhorou o desempenho do modelo nos dados de treinamento para ambas as classes.
Train Classification report
               precision    recall  f1-score   support

           0       0.76      0.90      0.82       158
           1       0.91      0.78      0.84       204

    accuracy                           0.83       362
   macro avg       0.83      0.84      0.83       362
weighted avg       0.84      0.83      0.83       362
Utilizando as mesmas configurações do Strategy Tester, podemos testar o modelo treinado com esses dados.
Parâmetros de entrada: technique_name = randomundersampling.
Resultados do Strategy Tester.
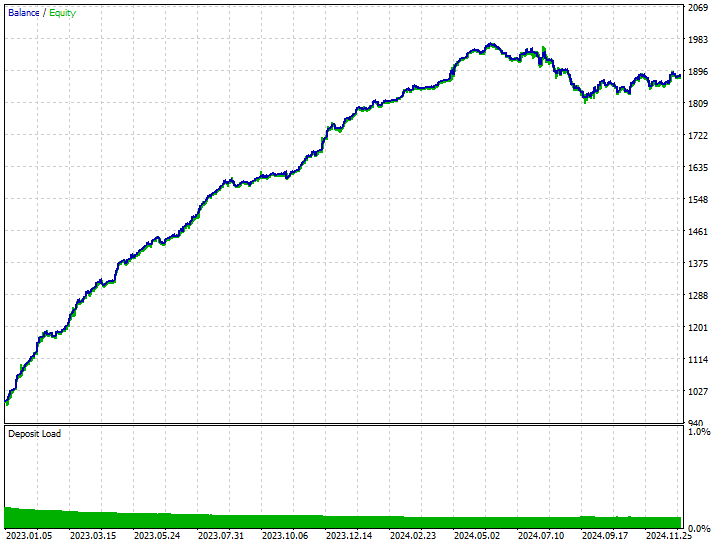
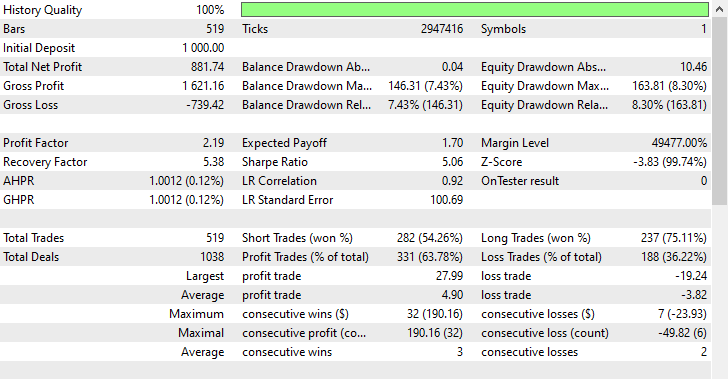
Essa técnica resultou em 282 operações curtas e 237 operações longas. Embora o modelo tenha favorecido as operações short em relação às operações longas — algo que não refletia o comportamento predominante do mercado —, ainda assim conseguiu gerar mais lucro do que o modelo enviesado treinado com dados brutos e do que o modelo submetido a oversampling, que favorecia os movimentos de alta.
Esses resultados mostram que o modelo pode gerar lucro operando em ambas as direções do mercado, independentemente do comportamento predominante observado historicamente.
Tomek Links
Tomek Links referem-se a pares de amostras pertencentes a classes diferentes que estão muito próximas umas das outras, sendo frequentemente consideradas vizinhas mais próximas. A seguir, apresentamos uma explicação simples de como a técnica Tomek Links funciona ao aplicar undersampling em dados de machine learning.
Imagine que temos dois pontos, A e B, pertencentes a classes diferentes. O ponto A pertence à classe majoritária, enquanto o ponto B pertence à classe minoritária (ou vice-versa).
Se esses dois pontos (A e B) estiverem próximos um do outro, ou seja, forem vizinhos, uma observação pertencente à classe majoritária — neste caso, A — será removida.
Essa técnica ajuda a tornar os limites de decisão mais claros e as classes mais distintas, ao mesmo tempo em que remove algumas amostras da classe majoritária.
from imblearn.under_sampling import TomekLinks

tl = TomekLinks()
X_resampled, y_resampled = tl.fit_resample(X_train, y_train)

print(f"Before --> y (unique): {np.unique(y_train, return_counts=True)}\nAfter  --> y (unique): {np.unique(y_resampled, return_counts=True)}")
Saídas.
Before --> y (unique): (array([0, 1]), array([304, 395]))
After  --> y (unique): (array([0, 1]), array([304, 283]))
Essa técnica pode gerar resultados preditivos equilibrados e impressionantes a partir do modelo, mas é limitada à classificação binária, menos eficaz em casos de dados com alta sobreposição e, assim como outras técnicas de amostragem, pode levar à perda de dados.
Essa técnica também apresentou um desempenho melhor nos dados de treinamento.
Train Classification report
               precision    recall  f1-score   support

           0       0.69      0.94      0.80       158
           1       0.93      0.68      0.78       204

    accuracy                           0.79       362
   macro avg       0.81      0.81      0.79       362
weighted avg       0.83      0.79      0.79       362
Utilizando a mesma configuração de teste, podemos testar o modelo treinado com esses dados no Testador de Estratégias.
Parâmetros de entrada: technique_name = tomek-links.
Resultados do Strategy Tester.

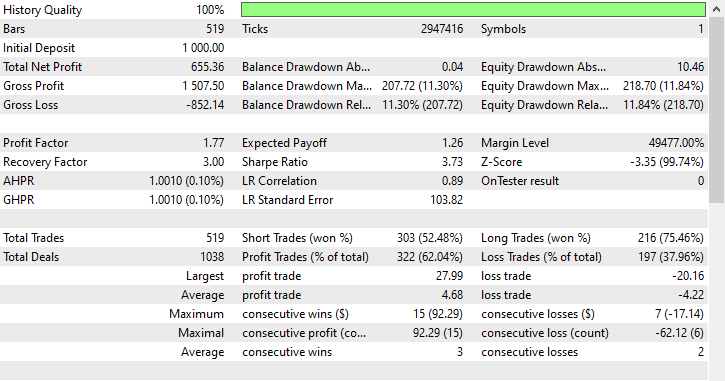
Assim como ocorreu com a técnica Random Undersampling, o Tomek Links favoreceu as operações curtas: foram abertas 303 operações curtas e 216 operações longas. Mesmo assim, o modelo conseguiu gerar lucro.
Cluster centroids
Essa é uma técnica de undersampling na qual a classe majoritária é reduzida substituindo suas amostras pelos centroides dos clusters, geralmente obtidos por meio do algoritmo K-means.
Ela funciona da seguinte maneira.
- O algoritmo K-means é aplicado à classe majoritária.
- É definido o número K de amostras desejadas.
- As amostras da classe majoritária são substituídas pelos K centros dos clusters.
- O resultado é combinado com a classe minoritária para criar um conjunto de dados balanceado.
from imblearn.under_sampling import ClusterCentroids

cc = ClusterCentroids(random_state=42)
X_resampled, y_resampled = cc.fit_resample(X, y)

print(f"Before --> y (unique): {np.unique(y_train, return_counts=True)}\nAfter  --> y (unique): {np.unique(y_resampled, return_counts=True)}")
Saídas.
Before --> y (unique): (array([0, 1]), array([158, 204]))
After  --> y (unique): (array([0, 1]), array([225, 225]))
Abaixo está o desempenho, nos dados de treinamento, do modelo treinado com dados submetidos a undersampling utilizando Cluster Centroids.
Train Classification report
               precision    recall  f1-score   support

           0       0.64      0.86      0.73       158
           1       0.85      0.62      0.72       204

    accuracy                           0.73       362
   macro avg       0.75      0.74      0.73       362
weighted avg       0.76      0.73      0.73       362
Até o momento, essa técnica apresentou o menor valor de acurácia. O valor de 0,73 pode indicar que o modelo apresenta menos overfitting do que os anteriores e, portanto, pode ser o melhor modelo obtido até agora. Vamos analisar seu desempenho em um ambiente de trading.
Parâmetros de entrada: technique_name = cluster-centroids.
Resultados do Strategy Tester.
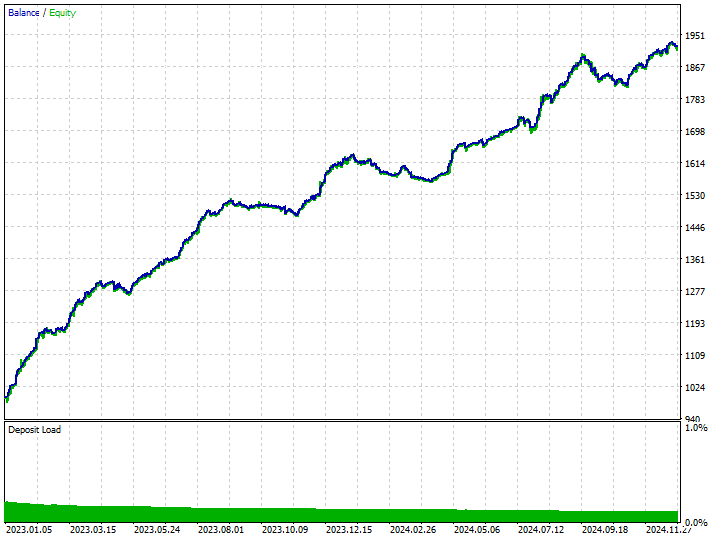
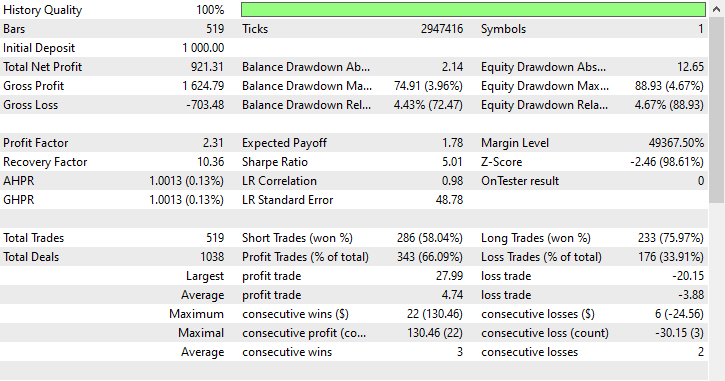
Essa técnica apresentou o maior número de operações lucrativas: 343 de um total de 519 operações, correspondendo a uma taxa de acerto de 66,09%, enquanto o lucro obtido ficou próximo do valor do depósito inicial. Embora o modelo tenha favorecido as operações curtas, ele apresentou alta precisão na previsão dos sinais de alta, alcançando uma expressiva taxa de 75,97% de operações longas vencedoras.
Métodos Híbridos
SMOTE + Tomek Links
Primeiro, o SMOTE é aplicado e, em seguida, o Tomek Links é utilizado para remover ruídos dos dados.
from imblearn.combine import SMOTETomek

smt = SMOTETomek(random_state=42)
X_resampled, y_resampled = smt.fit_resample(X_train, y_train)

print(f"Before --> y (unique): {np.unique(y_train, return_counts=True)}\nAfter  --> y (unique): {np.unique(y_resampled, return_counts=True)}")
Saídas.
Before --> y (unique): (array([0, 1]), array([158, 204]))
After  --> y (unique): (array([0, 1]), array([159, 159]))
Abaixo está o resultado do modelo treinado com dados de treinamento reamostrados por meio dessa técnica.
Train Classification report
               precision    recall  f1-score   support

           0       0.74      0.73      0.73       158
           1       0.79      0.80      0.80       204

    accuracy                           0.77       362
   macro avg       0.77      0.77      0.77       362
weighted avg       0.77      0.77      0.77       362
Abaixo estão os resultados das operações.
Parâmetros de entrada: technique_name = smote-tomeklinks.
Resultados do Strategy Tester.
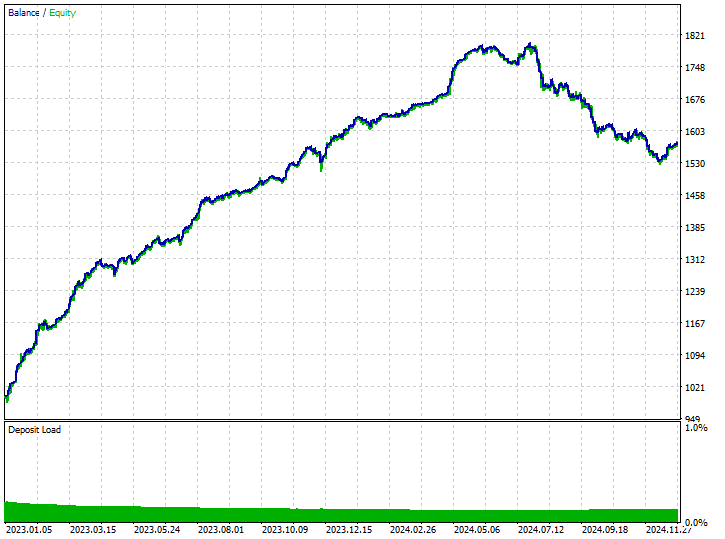
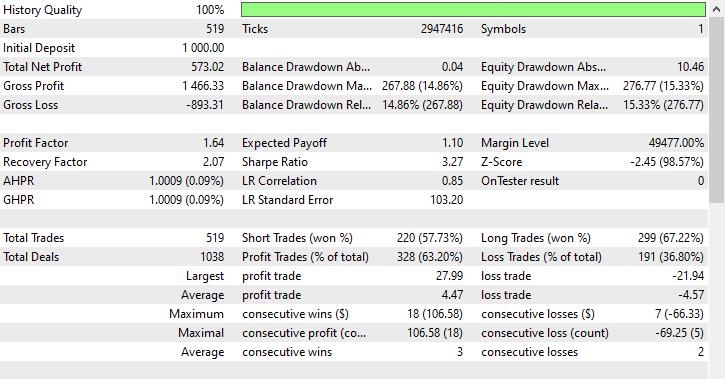
Foram realizadas 220 operações curtas e 299 operações longas, respectivamente. Nada mal.
SMOTE + ENN (Edited Nearest Neighbors)
O SMOTE gera amostras sintéticas e, em seguida, o ENN remove as amostras classificadas incorretamente.
from imblearn.combine import SMOTEENN

sme = SMOTEENN(random_state=42)
X_resampled, y_resampled = sme.fit_resample(X_train, y_train)

print(f"Before --> y (unique): {np.unique(y_train, return_counts=True)}\nAfter  --> y (unique): {np.unique(y_resampled, return_counts=True)}")
Essa técnica removeu uma quantidade significativa de dados, reduzindo o conjunto de treinamento para apenas 61 amostras.
Before --> y (unique): (array([0, 1]), array([158, 204]))
After  --> y (unique): (array([0, 1]), array([37, 24]))
Abaixo está o classification report da amostra de treinamento.
Train Classification report
               precision    recall  f1-score   support

           0       0.46      0.76      0.58       158
           1       0.63      0.32      0.42       204

    accuracy                           0.51       362
   macro avg       0.55      0.54      0.50       362
weighted avg       0.56      0.51      0.49       362
Como esperado, o modelo resultante apresentou baixo desempenho, pois foi treinado com apenas 61 amostras, uma quantidade insuficiente para que qualquer modelo consiga aprender padrões relevantes. Vamos observar os resultados das operações.
Parâmetros de entrada: technique_name = smote-enn.
Resultados do Strategy Tester.
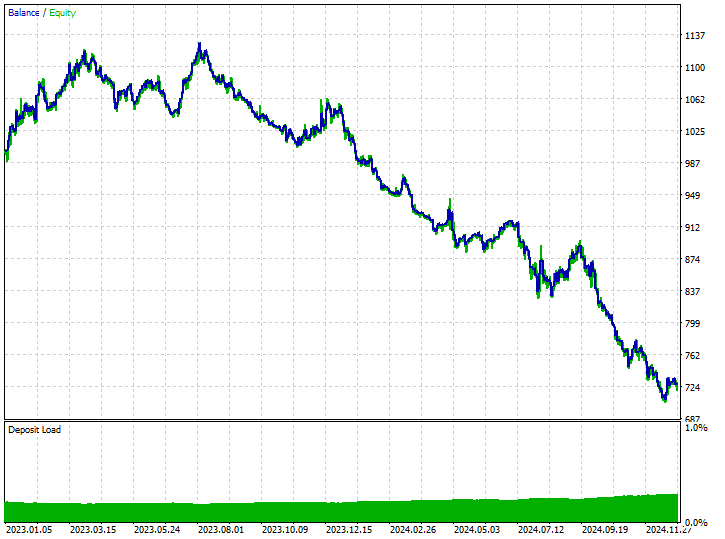
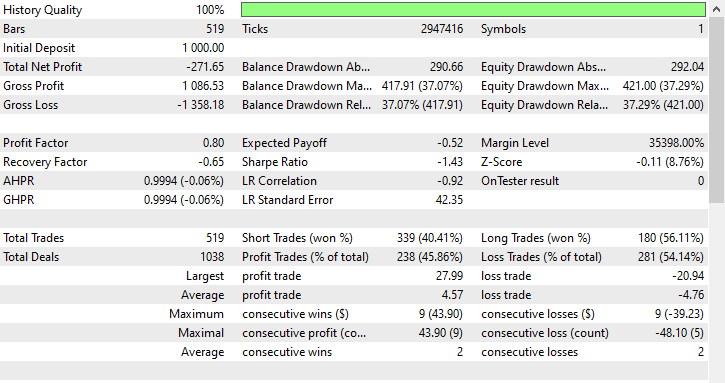
Essa técnica não ajudou e, na verdade, piorou os resultados. Ela introduziu um viés nas operações, pois o robô abriu 180 operações de compra e 339 operações de venda, de um total de 519 operações.
Isso não significa que a técnica seja ruim; apenas indica que ela não é a opção mais adequada para esta situação.
Conclusão
Vivemos em um mundo imperfeito, no qual nem todos os fenômenos possuem explicações adequadas ou caminhos claramente definidos. Isso também se aplica ao mundo do trading, onde os mercados mudam de maneira rápida e frequente, fazendo com que muitas das nossas estratégias se tornem obsoletas rapidamente.
Embora não possamos controlar o que acontece no mercado, o melhor que podemos fazer é garantir que tenhamos sistemas e estratégias de trading robustos, desenvolvidos para funcionar mesmo em condições extremas.
Como a história nem sempre se repete, é importante desenvolver sistemas de trading menos enviesados e capazes de funcionar em diferentes condições de mercado. Esses sistemas devem considerar os padrões observados anteriormente, sem depender excessivamente deles para tomar decisões de trading. Por mais úteis que essas técnicas possam ser, é importante considerar suas limitações e os trade-offs associados ao uso de técnicas de reamostragem em dados de machine learning. Entre essas limitações estão o risco de overfitting causado pelo oversampling, a possível perda de informações relevantes ao aplicar undersampling e a introdução de ruído ou viés caso a reamostragem não seja realizada de maneira adequada.
Encontrar o equilíbrio adequado é fundamental para desenvolver modelos robustos, capazes de generalizar bem diante de condições de mercado ainda não observadas.
Atenciosamente.
Tabela de Anexos
| Nome do arquivo | Descrição/Uso |
|---|---|
| Experts\Test Resampling Techniques.mq5 | Um Expert Advisor (EA) para utilizar arquivos .ONNX no MQL5 |
| Include\pandas.mqh | Biblioteca Pandas semelhante à do Python para manipulação e armazenamento de dados |
| Scripts\Collectdata.mq5 | Um script para coletar os dados de treinamento |
| Common\*.onnx | Modelos de machine learning no formato ONNX |
| Common\*.csv | Dados de treinamento de diferentes instrumentos para utilização em machine learning |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/17736
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Técnicas do MQL5 Wizard que você deve conhecer (Parte 60): Aprendizado por Inferência (Wasserstein-VAE) com Padrões da Média Móvel e do Oscilador Estocástico
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 67): Uso dos padrões do TRIX e da Faixa Percentual de Williams
 Automatizando Estratégias de Trading em MQL5 (Parte 15): Padrão Harmônico Cypher Baseado em Price Action com Visualização
 Criação de EAs auto-otimizáveis em MQL5 (Parte 7): Negociação simultânea com indicadores de vários períodos

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Os componentes necessários são a versão mais recente de tudo o que foi importado para o notebook; você pode executar o comando `pip install` sem se preocupar com conflitos de versões. Como alternativa, você pode seguir o link na tabela de anexos, que o levará ao site Kaggle.com, onde é possível editar e modificar o código.
Identificador não declarado: isso pode significar que uma variável ou um objeto não está definido. Verifique seu código ou me envie uma mensagem direta com uma captura de tela do código.