

Repensando as estratégias clássicas (Parte 13): Atualização da estratégia de cruzamento de médias móveis (Parte 2)
 39
 0

Em nossa discussão anterior sobre o cruzamento de médias móveis, exploramos maneiras de reduzir a defasagem característica desses indicadores. Como todos sabemos, as estratégias baseadas no cruzamento de médias móveis geram sinais com atraso. No entanto, ao definir o mesmo período para ambas as médias móveis (por exemplo, um período de três, como fizemos no artigo anterior), podemos obter sinais de negociação com defasagem significativamente menor. Isso é possível porque aplicamos os indicadores de média móvel separadamente aos preços de abertura e de fechamento, utilizando o mesmo período para ambos. Em seguida, observamos os cruzamentos entre a média móvel dos preços de abertura e a média móvel dos preços de fechamento. O uso de períodos curtos, geralmente inferiores a cinco, também contribui para reduzir a defasagem.
Vimos, portanto, que essa estratégia apresenta vantagens em relação à abordagem clássica de cruzamento de médias móveis. No primeiro artigo, comparamos a nova estratégia de cruzamento proposta com a versão tradicional. Hoje, continuaremos aprimorando essa estratégia, buscando reduzir ainda mais a defasagem dos sinais. Para isso, investigaremos a possibilidade de prever os cruzamentos antes que eles efetivamente ocorram. Dessa forma, poderemos reagir mais rapidamente às oportunidades de negociação. Diferentemente da maioria dos participantes do mercado, que aguardam a confirmação e só reagem quando o cruzamento já se tornou evidente, nosso objetivo é desenvolver modelos estatísticos capazes de antecipar esses cruzamentos, permitindo abrir posições antes mesmo do início do movimento dos preços.
Identificar sinais de negociação em meio ao ruído do mercado pode ser uma tarefa difícil. Existem, porém, alguns princípios de análise de dados que podem nos ajudar. Nesse contexto, vale recorrer a uma apresentação da equipe do Laboratório de Propulsão a Jato da NASA (NASA Jet Propulsion Laboratory), vinculado ao Instituto de Tecnologia da Califórnia (Caltech). A apresentação reúne diversas ideias úteis. O link para a apresentação está disponível aqui. A apresentação trata da análise de Big Data e apresenta um princípio-chave relacionado ao tema que estamos discutindo. Se o assunto despertar seu interesse, recomendo consultar a apresentação completa. Em resumo, a ideia é que determinados problemas complexos de análise de dados podem se tornar mais fáceis de resolver quando projetamos os dados em espaços de maior dimensionalidade. A Figura 1, abaixo, mostra um trecho da apresentação original que ilustra esse princípio.
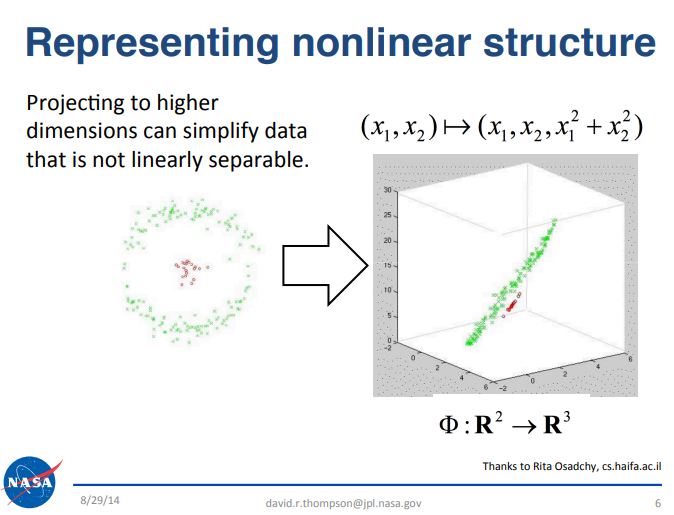
Figura 1: O slide faz parte da apresentação pública "Big Data Analytics", realizada pela equipe do Laboratório de Propulsão a Jato da NASA (NASA JPL) no Instituto de Tecnologia da Califórnia (Caltech), em setembro de 2014.
Como exemplo, consideremos um conjunto de dados com três atributos, no qual o objetivo é classificar os dias como de alta ou de baixa. Alcançar uma alta precisão nessa classificação pode ser difícil em um espaço limitado a apenas três dimensões. No entanto, ao projetarmos o conjunto de dados em um espaço de maior dimensionalidade, podemos obter resultados melhores, pois determinadas classes se tornam mais fáceis de separar em espaços de atributos com mais dimensões. Embora os métodos de machine learning não garantam bons resultados em todos os casos, vale a pena testar essa abordagem.
Esse princípio contrasta com o que discutimos em uma série relacionada de artigos sobre a criação de EAs auto-otimizáveis em MQL5, na qual exploramos as vantagens de técnicas de redução de dimensionalidade, como o UMAP, capazes de reduzir de 30 para apenas quatro o número de atributos de um conjunto de dados. Normalmente, buscamos reduzir a dimensionalidade para simplificar os modelos e melhorar sua capacidade de generalização. No artigo de hoje, porém, seguiremos o caminho oposto: aumentaremos deliberadamente a dimensionalidade do conjunto de dados para avaliar os possíveis benefícios dessa abordagem.
Para isso, utilizaremos um método elaborado manualmente para gerar um grande número de novas colunas de atributos. Em trabalhos futuros, utilizaremos métodos algorítmicos mais flexíveis para gerar esses atributos.
Primeiros passos no MQL5
Começaremos criando um script para extrair os dados necessários do terminal MetaTrader 5. Primeiro, definiremos as constantes que serão utilizadas. Por exemplo, adotaremos um período fixo para todas as médias móveis e utilizaremos exclusivamente médias móveis simples (Simple Moving Average, SMA) ao longo de todo o artigo.
//+------------------------------------------------------------------+
//|                                                      ProjectName |
//|                                      Copyright 2020, CompanyName |
//|                                       http://www.companyname.net |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- Define our moving average indicator
#define MA_PERIOD 2                 //--- Moving Average Period
#define MA_TYPE   MODE_SMA          //--- Type of moving average we have
#define HORIZON   5                 //--- Forecast horizon
Além disso, definiremos as variáveis globais, os handles dos indicadores e os buffers das médias móveis.
//--- Our handlers for our indicators
int ma_handle,ma_o_handle,ma_h_handle,ma_l_handle;

//--- Data structures to store the readings from our indicators
double ma_reading[],ma_o_reading[],ma_h_reading[],ma_l_reading[];

//--- File name
string file_name = Symbol() + " Market Data As Series Moving Average.csv";

//--- Amount of data requested
input int size = 3000;
Em seguida, passaremos à implementação da lógica principal do script. Ao executá-lo, inicializaremos os handles das médias móveis e copiaremos os valores dos indicadores para os respectivos buffers. Ao preparar a gravação dos dados no arquivo, precisamos lembrar que será necessário preencher um grande número de colunas. As oito primeiras colunas serão as tradicionais: preços de abertura (open), máxima (high), mínima (low) e fechamento (close), além dos valores correspondentes das médias móveis. Também acrescentaremos colunas para indicar os aumentos de preço em cada intervalo considerado.
Outras colunas serão destinadas ao cálculo das variações relativas entre diferentes níveis de preço. Por exemplo, além de calcularmos a variação do preço de abertura em relação ao seu valor histórico, também calcularemos sua variação em relação ao preço de fechamento, ao preço mínimo e assim por diante. Faremos cálculos semelhantes para as médias móveis. Ao final, teremos um conjunto de dados com 40 colunas. Por último, gravaremos os valores necessários no arquivo e fecharemos o respectivo handle.
//+------------------------------------------------------------------+
//| Our script execution                                             |
//+------------------------------------------------------------------+
void OnStart()
  {
  int fetch = size + (HORIZON * 2);
//---Setup our technical indicators
   ma_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE);
   ma_o_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_OPEN);
   ma_h_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_HIGH);
   ma_l_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_LOW);

//---Set the values as series
   CopyBuffer(ma_handle,0,0,fetch,ma_reading);
   ArraySetAsSeries(ma_reading,true);
   CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading);
   ArraySetAsSeries(ma_o_reading,true);
   CopyBuffer(ma_h_handle,0,0,fetch,ma_h_reading);
   ArraySetAsSeries(ma_h_reading,true);
   CopyBuffer(ma_l_handle,0,0,fetch,ma_l_reading);
   ArraySetAsSeries(ma_l_reading,true);

//---Write to file
   int file_handle=FileOpen(file_name,FILE_WRITE|FILE_ANSI|FILE_CSV,",");

   for(int i=size;i>=1;i--)
     {
      if(i == size)
        {
         FileWrite(file_handle,"Time",
                              //--- OHLC
                              "True Open",
                              "True High",
                              "True Low",
                              "True Close",
                              //--- MA OHLC
                              "True MA C",
                              "True MA O",
                              "True MA H",
                              "True MA L",
                              //--- Growth in OHLC
                              "Diff Open",
                              "Diff High",
                              "Diff Low",
                              "Diff Close",
                              //--- Growth in MA OHLC
                              "Diff MA Close 2",
                              "Diff MA Open 2",
                              "Diff MA High 2",
                              "Diff MA Low 2",
                              //--- Grwoth between channels
                              "O - C",
                              "Delta O - C",
                              "O - L",
                              "Delta O - L",
                              "O - H",
                              "Delta O - H",
                              "H - L",
                              "Delta H - L",
                              "C - H",
                              "Delta C - H",
                              "C - L",
                              "Delta C - L",
                              //--- Grwoth between MA channels
                              "MA O - C",
                              "MA Delta O - C",
                              "MA O - L",
                              "MA Delta O - L",
                              "MA O - H",
                              "MA Delta O - H",
                              "MA H - L",
                              "MA Delta H - L",
                              "MA C - H",
                              "MA Delta C - H",
                              "MA C - L",
                              "MA Delta C - L"
                  );
        }

      else
        {
         FileWrite(file_handle,
                   iTime(_Symbol,PERIOD_CURRENT,i),
                   //--- OHLC
                   iOpen(_Symbol,PERIOD_CURRENT,i),
                   iHigh(_Symbol,PERIOD_CURRENT,i),
                   iLow(_Symbol,PERIOD_CURRENT,i),
                   iClose(_Symbol,PERIOD_CURRENT,i),
                   //--- MA OHLC
                   ma_reading[i],
                   ma_o_reading[i],
                   ma_h_reading[i],
                   ma_l_reading[i],
                   //--- Growth in OHLC
                   iOpen(_Symbol,PERIOD_CURRENT,i)   - iOpen(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iHigh(_Symbol,PERIOD_CURRENT,i)   - iHigh(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iLow(_Symbol,PERIOD_CURRENT,i)    - iLow(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iClose(_Symbol,PERIOD_CURRENT,i)  - iClose(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   //--- Growth in MA OHLC
                   ma_reading[i] - ma_reading[(i + HORIZON)],
                   ma_o_reading[i] - ma_o_reading[(i + HORIZON)],
                   ma_h_reading[i] - ma_h_reading[(i + HORIZON)],
                   ma_l_reading[i] - ma_l_reading[(i + HORIZON)],
                   //--- Growth between channels
                   iOpen(_Symbol,PERIOD_CURRENT,i) - iClose(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i + HORIZON) - iClose(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   iOpen(_Symbol,PERIOD_CURRENT,i) - iLow(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i + HORIZON) - iLow(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   iOpen(_Symbol,PERIOD_CURRENT,i) - iHigh(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i + HORIZON) - iHigh(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   iHigh(_Symbol,PERIOD_CURRENT,i) - iLow(_Symbol,PERIOD_CURRENT,i),
                   iHigh(_Symbol,PERIOD_CURRENT,i + HORIZON) - iLow(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   iClose(_Symbol,PERIOD_CURRENT,i)  -  iHigh(_Symbol,PERIOD_CURRENT,i),
                   iClose(_Symbol,PERIOD_CURRENT,i + HORIZON)  -  iHigh(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   iClose(_Symbol,PERIOD_CURRENT,i)  -  iLow(_Symbol,PERIOD_CURRENT,i),
                   iClose(_Symbol,PERIOD_CURRENT,i + HORIZON)  -  iLow(_Symbol,PERIOD_CURRENT,i + HORIZON),
                   //--- Growth between moving average channels
                   ma_o_reading[i] - ma_reading[i],
                   ma_o_reading[(i + HORIZON)] -  ma_reading[(i + HORIZON)],
                   ma_o_reading[i] -  ma_l_reading[i],
                   ma_o_reading[(i + HORIZON)] - ma_l_reading[(i + HORIZON)],
                   ma_o_reading[i] -  ma_h_reading[i],
                   ma_o_reading[(i + HORIZON)] - ma_h_reading[(i + HORIZON)],
                   ma_h_reading[i] - ma_l_reading[i],
                   ma_h_reading[(i + HORIZON)] - ma_l_reading[(i + HORIZON)],
                   ma_reading[i] -  ma_h_reading[i],
                   ma_reading[(i + HORIZON)] - ma_h_reading[(i + HORIZON)],
                   ma_reading[i] -  ma_l_reading[i],
                   ma_reading[(i + HORIZON)] - ma_l_reading[(i + HORIZON)]
                   );
        }
     }
//--- Close the file
   FileClose(file_handle);
  }
//+------------------------------------------------------------------+
Análise dos dados em Python
Depois de executar o script no terminal e obter os dados necessários, podemos passar à análise e ao processamento dos dados. Começaremos importando as bibliotecas usuais de análise numérica.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
Em seguida, carregaremos os conjuntos de dados. Como o conjunto de dados contém muitas colunas, podemos observar que algumas delas aparecem truncadas na exibição.
data = pd.read_csv("C:\\Users\\Westwood\\AppData\\Roaming\\MetaQuotes\\Terminal\\D0E8209F77C8CF37AD8BF550E51FF075\\MQL5\\Files\\EURUSD Market Data As Series Moving Average.csv")
data 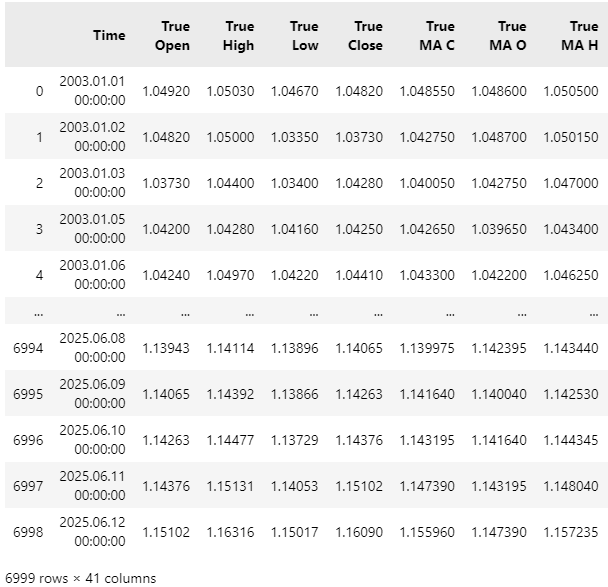
Figura 2: Visualização dos dados obtidos do MetaTrader 5.
Em seguida, definiremos a variável-alvo. Vale lembrar que, em nosso exemplo, ela corresponde ao cruzamento das médias móveis. Uma maneira simples de acompanhar esse cruzamento é observar o ponto médio (midpoint) entre as duas médias móveis. Monitoraremos se esse ponto médio está subindo ou caindo e utilizaremos essa informação em nossos modelos estatísticos.
HORIZON             = 10

#Classical Target
data['Target']      =  0

#High Low Mid Point Target
data['Target 2']    = 0

#Open Close Mid Point Target
data['Target 3']    = 0

data.loc[data['True Close'].shift(-HORIZON) > data['True Close'],'Target'] = 1

#The Mid Point Between The High And The Low Moving Average
data.loc[((data['True MA H'].shift(-HORIZON) + data['True MA L'].shift(-HORIZON)) / 2) > ((data['True MA H'] + data['True MA L']) / 2),'Target 2'] = 1

#The Open And Close Mid Point
data.loc[((data['True MA O'].shift(-HORIZON) + data['True MA C'].shift(-HORIZON)) / 2) > ((data['True MA O'] + data['True MA C']) / 2),'Target 3'] = 1

data = data.iloc[:-HORIZON,:]
Antes de prosseguirmos, gostaria de apresentar uma breve demonstração dos benefícios de projetar conjuntos de dados em espaços de maior dimensionalidade. Se você ainda não conhece esse princípio, essa demonstração pode ser bastante convincente. Primeiro, criaremos uma cópia do conjunto de dados original contendo apenas as quatro colunas tradicionais: preços open, high, low e close. Em seguida, recalcularemos nossa variável-alvo com base nesse conjunto reduzido.
#Copy the dataset
X = data.iloc[:,:5].copy()
X['Target'] = data['True Close'].shift(-HORIZON) - data['True Close']
X.dropna(inplace=True)
Depois, definiremos uma função que recebe um conjunto de dados e acrescenta a ele uma quantidade arbitrária de colunas preenchidas com zeros. Por exemplo, se aplicarmos essa função à cópia do nosso conjunto de dados e especificarmos cinco colunas, ela retornará um conjunto com cinco colunas adicionais, todas preenchidas com zeros.
def fill_zeros(f_data,f_n):
    #Copy the original data
    res = f_data.copy()

    #We want to keep the target at the end
    t = 'Target'
    v = res.pop('Target')

    #Add columns of zeros
    for i in np.arange(f_n):
        name = str(i) + ' Col'
        res[name] = 0

    #Place the target back
    res[t]= v

    #Return the new dataframe
    return(res)
Faremos um teste simples, aplicando a validação cruzada ao modelo enquanto aumentamos gradualmente o número de colunas preenchidas com zeros. Assim, poderemos observar como esse aumento afeta o erro de validação cruzada. O gráfico está longe de apresentar uma curva suave, o que indica que o erro varia de forma irregular à medida que a dimensionalidade aumenta.
Ainda assim, podemos observar claramente que o erro atinge novos valores mínimos, inferiores aos registrados anteriormente. No início do gráfico, temos o erro do modelo sem nenhuma coluna adicional preenchida com zeros. À medida que acrescentamos essas colunas, o erro inicialmente aumenta de forma acentuada, mas depois diminui até atingir mínimos que não haviam sido alcançados. Isso levanta uma questão interessante: por que o desempenho do modelo melhora se não estamos fornecendo nenhuma informação adicional? Afinal, vale lembrar que as colunas preenchidas com zeros não contêm dados úteis para o modelo.
#Load our libraries
from sklearn.neural_network import MLPRegressor
from sklearn.model_selection import cross_val_score,TimeSeriesSplit

tscv = TimeSeriesSplit(n_splits=5,gap=HORIZON)
EPOCHS = 50

#Observe what happens to our error levels as we increase the number of columns in the dataset
res = []

for i in np.arange(EPOCHS):
    #Fetch new data with addtional columns of zeros
    new_data = fill_zeros(X,(1+i))

    #Record the new error
    res.append(np.mean(np.abs(cross_val_score(MLPRegressor(hidden_layer_sizes=(new_data.iloc[:,1:-1].shape[1],2,50,100),random_state=0,shuffle=False),X.iloc[:,1:-1],X.iloc[:,-1],cv=tscv,n_jobs=-1))))

plt.plot(res,color='black')
plt.grid()
plt.ylabel('RMSE Error')
plt.xlabel('Additional Columns of Zero')
plt.title('Our Error Levels Can Fall Without Any New Information')
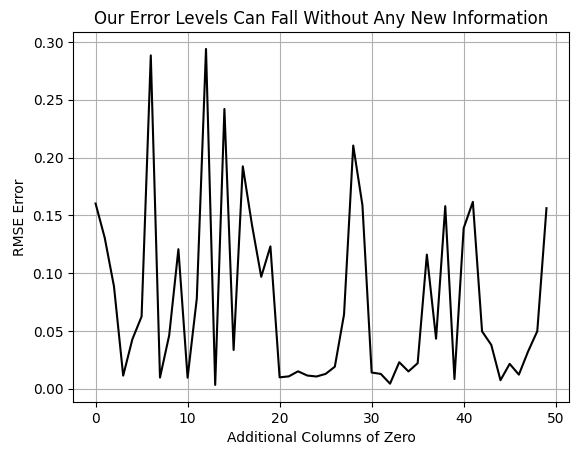
Figura 3: O nível de erro do modelo diminui, mesmo sem fornecermos nenhuma informação adicional.
Existem várias explicações plausíveis para esse comportamento. Neste artigo, adotaremos a perspectiva de que o aumento da dimensionalidade pode trazer benefícios por si só. Portanto, interpretaremos esses resultados como uma confirmação da utilidade de projetar os dados em espaços de maior dimensionalidade. Embora existam outras explicações igualmente válidas, para os objetivos da nossa discussão, o experimento anterior oferece uma justificativa suficiente para acrescentarmos 32 colunas à nossa amostra. Nossa hipótese é que, ao aumentar o número de colunas adicionais, poderemos alcançar novos mínimos de erro. Desta vez, porém, em vez de preenchê-las com zeros, incluiremos informações relevantes.
Agora, passaremos à definição das colunas de entrada e saída. Primeiro, reuniremos todas as colunas de entrada e as armazenaremos em uma variável chamada X.
X = data.iloc[:,1:-4].columns
Em seguida, listaremos as variáveis-alvo.
y2 = data['Target 2']
Também precisaremos definir uma função que retorne uma nova instância do modelo estatístico.
return(RandomForestClassifier(random_state=0,n_estimators=500,max_depth=3,min_samples_leaf=20))
Em seguida, excluiremos do treinamento todos os dados referentes ao período de backtest, para evitar que o modelo se sobreajuste ao conjunto completo de dados. É importante reservar uma parte dos dados exclusivamente para testes. Depois, padronizaremos e escalonaremos o conjunto de dados. Para isso, subtrairemos a média de cada coluna e dividiremos o resultado pelo respectivo desvio-padrão, repetindo esse procedimento para as 40 colunas. Assim, obteremos um conjunto de dados padronizado.
data = data.iloc[:-(365*2),:]

Z = pd.DataFrame(columns=['Z1','Z2'])

Z['Z1'] = data.loc[:,X].mean()
Z['Z2'] = data.loc[:,X].std()

data.loc[:,X] = (data.loc[:,X] - data.loc[:,X].mean()) / data.loc[:,X].std()
Treinaremos o modelo com os dados de treinamento e, em seguida, prepararemos sua exportação para o formato ONNX, permitindo utilizá-lo no MQL5.
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
from sklearn.ensemble import GradientBoostingRegressor

model = GradientBoostingRegressor(random_state=0,max_depth=3)
model.fit(data.loc[:,X],data.loc[:,'Target 2'])

initial_types = [("FLOAT INPUT",FloatTensorType([1,len(X)]))]

model_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12)

onnx.save(model_proto,"EURUSD GBR PRICE D1.onnx")
Reunindo tudo
Agora, passaremos à implementação do EA. Nossa primeira tarefa será definir as constantes globais cujos valores permanecerão inalterados. Observe que muitas dessas definições são iguais às que utilizamos anteriormente no script de extração de dados. O período e o tipo de média móvel permanecerão iguais aos definidos anteriormente. Além disso, definiremos o tempo de permanência de cada posição e o timeframe em que as negociações serão realizadas.
//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
//--- Define our moving average indicator
#define MA_PERIOD 2                             //Moving Average Period
#define MA_TYPE   MODE_SMA                      //Type of moving average we have
#define HORIZON   10                            //Forecast horizon
#define TF PERIOD_D1
Em seguida, declararemos as principais variáveis globais. Por exemplo, os valores Z1 e Z2, utilizados para padronizar e escalonar nosso conjunto de dados, precisarão ser armazenados no EA. Também serão necessárias variáveis globais para os handles das médias móveis e seus respectivos buffers.
//+------------------------------------------------------------------+
//| Global definitions                                               |
//+------------------------------------------------------------------+
float Z1[] =
  {
   1.23933432e+00,  1.24403263e+00,  1.23474846e+00,  1.23936216e+00,
   1.23935910e+00,  1.23933128e+00,  1.24402971e+00,  1.23474522e+00,
   3.83991053e-05,  3.60920275e-05,  3.66240614e-05,  3.55759706e-05,
   3.68749001e-05,  3.98194600e-05,  3.78958300e-05,  3.79070139e-05,
   -2.78415082e-05, -3.06646429e-05,  4.58586036e-03,  4.58408532e-03,
   -4.69831123e-03, -4.70061831e-03,  9.28417159e-03,  9.28470363e-03,
   -4.67046972e-03, -4.66995367e-03,  4.61370187e-03,  4.61474996e-03,
   -2.78151462e-05, -3.07597060e-05,  4.58606247e-03,  4.58415002e-03,
   -4.69842067e-03, -4.70034430e-03,  9.28448314e-03,  9.28449433e-03,
   -4.67060553e-03, -4.66958460e-03,  4.61387762e-03,  4.61490973e-03
  };

float Z2[]=
  {
   0.12576155, 0.12640182, 0.125071, 0.12572605, 0.12568469,
   0.125719, 0.12636385, 0.12503521, 0.0150256, 0.01494947,
   0.01478075, 0.01493629, 0.0141562, 0.01423137, 0.01419596,
   0.01404453, 0.00669432, 0.0066951, 0.00482275, 0.004823,
   0.00493041, 0.00493002, 0.0063063, 0.00630607, 0.0048614,
   0.0048616, 0.00471017, 0.0047104, 0.00471147, 0.00471252,
   0.00361188, 0.00361259, 0.00371563, 0.00371488, 0.00513505,
   0.00513498, 0.0037117, 0.0037125, 0.00353196, 0.00353191
  };

//--- Our handlers for our indicators
int ma_handle,ma_o_handle,ma_h_handle,ma_l_handle;

//--- Data structures to store the readings from our indicators
double ma_reading[],ma_o_reading[],ma_h_reading[],ma_l_reading[];

int fetch = HORIZON * 2;
int timer = 0;
int state = 0;
Incorporaremos nosso modelo ONNX ao EA como um recurso.
//+------------------------------------------------------------------+
//| Resources                                                        |
//+------------------------------------------------------------------+
//+------------------------------------------------------------------+
//| DISCLAIMER                                                       |
//| This ONNX model was trained from 1 January 2003 until 29 January |
//| 2023. For reliable results, ensure that all back tests are done  |
//| beyond the model's training period.                              |
//+------------------------------------------------------------------+
#resource "\\Files\\MA Approximation\\EURUSD GBR MA D1.onnx" as const uchar onnx_proto[];
Depois, incluiremos as bibliotecas e dependências necessárias. Precisaremos da biblioteca MQL5 para gerenciar as operações de negociação, além de uma biblioteca personalizada para trabalhar com modelos ONNX e obter informações sobre as operações de negociação.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\ONNX\ONNXFloat.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade         Trade;
ONNXFloat      *onnx_handler;
Time           *time_handler;
TradeInfo      *trade_handler;
Durante a inicialização do EA, carregaremos essas bibliotecas e inicializaremos os indicadores técnicos.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   onnx_handler  = new ONNXFloat(onnx_proto);
   time_handler  = new Time(Symbol(),TF);
   trade_handler = new TradeInfo(Symbol(),TF);

   Print("Onnx Handler Pointer: ",onnx_handler);

   onnx_handler.DefineOnnxInputShape(0,1,40);

   onnx_handler.DefineOnnxOutputShape(0,1,1);

//---Setup our technical indicators
   ma_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE);
   ma_o_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_OPEN);
   ma_h_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_HIGH);
   ma_l_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_LOW);

//---
   return(INIT_SUCCEEDED);
  }
Também excluiremos os objetos criados dinamicamente e liberaremos os recursos dos indicadores técnicos que não forem mais utilizados.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   IndicatorRelease(ma_handle);
   IndicatorRelease(ma_o_handle);
   IndicatorRelease(ma_h_handle);
   IndicatorRelease(ma_l_handle);
   delete time_handler;
   delete trade_handler;
   delete onnx_handler;
  }
A cada atualização dos preços, verificaremos se uma nova vela foi formada. Em caso afirmativo, atualizaremos os indicadores técnicos antes de verificar os sinais de negociação.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(time_handler.NewCandle())
     {
      update();
      check_signal();
     }
  }
A rotina de atualização dos indicadores técnicos funcionará da seguinte forma: primeiro, copiaremos os valores de todos os indicadores para os respectivos buffers. Com isso, prepararemos o vetor de entrada do nosso modelo ONNX. O modelo receberá o mesmo conjunto de 40 parâmetros de entrada que utilizamos na etapa anterior. Antes de alimentar o modelo com esses dados, faremos sua padronização e o ajuste de escala. Em seguida, o modelo gerará uma previsão.
//+------------------------------------------------------------------+
//| Update our technical data                                        |
//+------------------------------------------------------------------+
void update(void)
  {

//---Set the values as series
   CopyBuffer(ma_handle,0,0,fetch,ma_reading);
   ArraySetAsSeries(ma_reading,true);
   CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading);
   ArraySetAsSeries(ma_o_reading,true);
   CopyBuffer(ma_h_handle,0,0,fetch,ma_h_reading);
   ArraySetAsSeries(ma_h_reading,true);
   CopyBuffer(ma_l_handle,0,0,fetch,ma_l_reading);
   ArraySetAsSeries(ma_l_reading,true);

   vectorf model_input_vector =
     {
      //--- OHLC
      iOpen(_Symbol,PERIOD_CURRENT,0),
      iHigh(_Symbol,PERIOD_CURRENT,0),
      iLow(_Symbol,PERIOD_CURRENT,0),
      iClose(_Symbol,PERIOD_CURRENT,0),
      //--- MA OHLC
      ma_reading[0],
      ma_o_reading[0],
      ma_h_reading[0],
      ma_l_reading[0],
      //--- Growth in OHLC
      iOpen(_Symbol,PERIOD_CURRENT,0)   - iOpen(_Symbol,PERIOD_CURRENT,(0 + HORIZON)),
      iHigh(_Symbol,PERIOD_CURRENT,0)   - iHigh(_Symbol,PERIOD_CURRENT,(0 + HORIZON)),
      iLow(_Symbol,PERIOD_CURRENT,0)    - iLow(_Symbol,PERIOD_CURRENT,(0 + HORIZON)),
      iClose(_Symbol,PERIOD_CURRENT,0)  - iClose(_Symbol,PERIOD_CURRENT,(0 + HORIZON)),
      //--- Growth in MA OHLC
      ma_reading[0]   - ma_reading[(0 + HORIZON)],
      ma_o_reading[0] - ma_o_reading[(0 + HORIZON)],
      ma_h_reading[0] - ma_h_reading[(0 + HORIZON)],
      ma_l_reading[0] - ma_l_reading[(0 + HORIZON)],
      //--- Growth between channels
      iOpen(_Symbol,PERIOD_CURRENT,0) - iClose(_Symbol,PERIOD_CURRENT,0),
      iOpen(_Symbol,PERIOD_CURRENT,0 + HORIZON) - iClose(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      iOpen(_Symbol,PERIOD_CURRENT,0) - iLow(_Symbol,PERIOD_CURRENT,0),
      iOpen(_Symbol,PERIOD_CURRENT,0 + HORIZON) - iLow(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      iOpen(_Symbol,PERIOD_CURRENT,0) - iHigh(_Symbol,PERIOD_CURRENT,0),
      iOpen(_Symbol,PERIOD_CURRENT,0 + HORIZON) - iHigh(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      iHigh(_Symbol,PERIOD_CURRENT,0) - iLow(_Symbol,PERIOD_CURRENT,0),
      iHigh(_Symbol,PERIOD_CURRENT,0 + HORIZON) - iLow(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      iClose(_Symbol,PERIOD_CURRENT,0)  -  iHigh(_Symbol,PERIOD_CURRENT,0),
      iClose(_Symbol,PERIOD_CURRENT,0 + HORIZON)  -  iHigh(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      iClose(_Symbol,PERIOD_CURRENT,0)  -  iLow(_Symbol,PERIOD_CURRENT,0),
      iClose(_Symbol,PERIOD_CURRENT,0 + HORIZON)  -  iLow(_Symbol,PERIOD_CURRENT,0 + HORIZON),
      //--- Growth between moving average channels
      ma_o_reading[0] - ma_reading[0],
      ma_o_reading[(0 + HORIZON)] -  ma_reading[(0 + HORIZON)],
      ma_o_reading[0] -  ma_l_reading[0],
      ma_o_reading[(0 + HORIZON)] - ma_l_reading[(0 + HORIZON)],
      ma_o_reading[0] -  ma_h_reading[0],
      ma_o_reading[(0 + HORIZON)] - ma_h_reading[(0 + HORIZON)],
      ma_h_reading[0] - ma_l_reading[0],
      ma_h_reading[(0 + HORIZON)] - ma_l_reading[(0 + HORIZON)],
      ma_reading[0] -  ma_h_reading[0],
      ma_reading[(0 + HORIZON)] - ma_h_reading[(0 + HORIZON)],
      ma_reading[0] -  ma_l_reading[0],
      ma_reading[(0 + HORIZON)] - ma_l_reading[(0 + HORIZON)]
     };

   for(int i =0;i<40;i++)
     {
      model_input_vector[i] = ((model_input_vector[i] - Z1[i]) / Z2[i]);
     }

   onnx_handler.Predict(model_input_vector);
  }
Nossa função de verificação dos sinais funcionará conforme o esperado. Primeiro, caso não haja posições abertas, redefiniremos o temporizador para seu estado inicial, fazendo o sistema retornar à condição inicial. Se o modelo ONNX prever um movimento de alta dos preços, abriremos uma posição de compra (buy). Se prever um movimento de baixa, abriremos uma posição de venda (sell). Observe que os sinais de alta e de baixa são determinados pelas probabilidades das classes fornecidas pelo modelo: uma probabilidade superior a 0,5 indica uma expectativa de alta, enquanto uma probabilidade inferior a 0,5 indica uma expectativa de baixa.
Além do sinal gerado pelo modelo ONNX, também buscaremos a confirmação por meio do padrão de cruzamento das médias móveis. Se já houver uma posição aberta, acompanharemos o temporizador e, quando ela atingir o tempo de permanência definido, fecharemos todas as posições abertas e reiniciaremos o ciclo.
//+------------------------------------------------------------------+
//| Check if we have oppurtunities to trade                          |
//+------------------------------------------------------------------+
void check_signal(void)
  {
   if(PositionsTotal() == 0)
     {
      timer = 0;
      state = 0;

      if(onnx_handler.GetPrediction() > 0.5
        {
         state =1;
         Trade.Buy(trade_handler.MinVolume(),trade_handler.GetSymbol(),trade_handler.GetAsk(),0,0,"");
        }

      else
         if(onnx_handler.GetPrediction() < 0.5 && ma_reading[0] < ma_o_reading[0])
           {
            state =-1;
            Trade.Sell(trade_handler.MinVolume(),trade_handler.GetSymbol(),trade_handler.GetBid(),0,0,"");
           }
     }

   else
     {
      timer++;
      if(timer >= HORIZON)
         Trade.PositionClose(Symbol());
     }

  }
Não se esqueça de utilizar as diretivas #undef.
//+------------------------------------------------------------------+
//| Undefine system constants                                        |
//+------------------------------------------------------------------+
#undef HORIZON
#undef MA_PERIOD
#undef MA_TYPE
#undef TF
Agora, testaremos o sistema com dados que não foram apresentados ao modelo durante o treinamento. Para isso, selecionaremos todas as datas fora do período de treinamento. Vale lembrar que o treinamento terminou em 29 de janeiro de 2023.
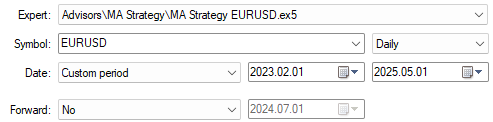
Figura 4: O período de teste não coincide com o período de treinamento ao qual o modelo foi exposto.
É indispensável selecionar a opção de atraso aleatório (Random delay), para simular de maneira mais realista as condições imprevisíveis das sessões de negociação no mercado.
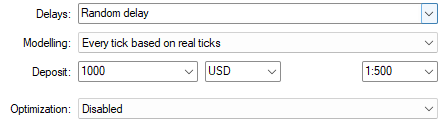
Figura 5: Random delay para testes realistas.
A curva de rentabilidade da nossa estratégia é apresentada na Figura 6. Conseguimos manter a tendência positiva de alta da curva de rentabilidade, mesmo ao testar o modelo com dados que ele não havia encontrado durante o treinamento. É possível que, graças ao treinamento com uma representação mais detalhada do mercado, construída com o uso das 40 colunas de atributos geradas, o modelo tenha desenvolvido uma maior capacidade de generalização e de adaptação a condições diferentes daquelas observadas durante o treinamento.
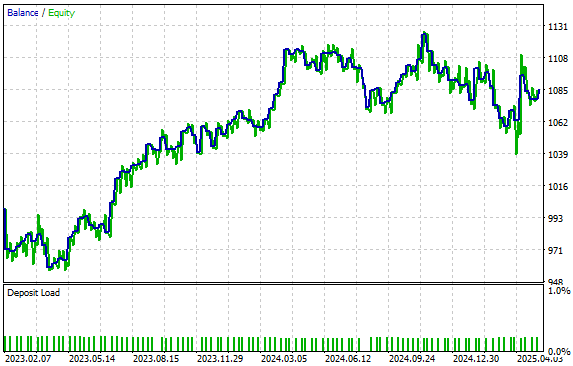
Figura 6: Visualização da curva de capital gerada pelo nosso modelo.
Por fim, podemos consultar os relatórios detalhados de desempenho da nossa estratégia. Observamos que 52,9% das operações foram lucrativas e que o lucro médio superou o prejuízo médio. Esses resultados são bastante promissores. Isso sugere que a criação criteriosa de atributos mais detalhados pode trazer benefícios ao desempenho dos modelos. Embora essa tarefa possa exigir bastante tempo e esforço, o trabalho adicional pode valer a pena.
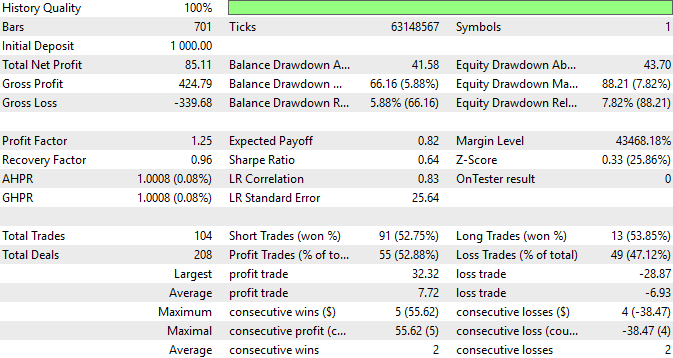
Figura 7: Relatórios dos resultados da nossa estratégia de negociação.
Conclusão
Ao longo deste artigo, apresentamos diversas ideias práticas de como repensar estratégias consolidadas e ampliar suas possibilidades.
Partimos da hipótese de que os modelos podem, em determinadas situações, apresentar um desempenho melhor em espaços de maior dimensionalidade e conseguimos reduzir progressivamente a defasagem dos sinais da estratégia de cruzamento de médias móveis. Para isso, ampliamos deliberadamente o conjunto de dados com novos atributos, oferecendo ao modelo uma representação mais detalhada do mercado. No entanto, é importante manter expectativas realistas.
Precisamos reconhecer que aumentar a dimensionalidade de um conjunto de dados nem sempre resulta em um desempenho melhor do modelo. Em vez de tratar essa abordagem como uma solução garantida, devemos encará-la como uma hipótese que vale a pena testar: em determinadas situações, projetar os dados em espaços de maior dimensionalidade pode trazer melhorias. Não há garantias de sucesso, mas é uma possibilidade que merece ser explorada. Além disso, vimos que a defasagem característica dos indicadores técnicos não precisa ser aceita como uma limitação inevitável. Com pensamento crítico e criatividade, podemos encontrar maneiras de reduzi-la. Ao que tudo indica, o potencial do terminal MetaTrader 5 é realmente enorme.
| Nome do arquivo | Descrição do arquivo |
|---|---|
| EURUSD GBR MA D1.onnx | Modelo ONNX que criamos utilizando um conjunto de dados multidimensional com novas colunas de atributos. |
| Proof of Case Article.ipynb | Notebook Jupyter criado para demonstrar os benefícios de projetar dados em espaços de maior dimensionalidade. |
| MA Strategy EURUSD.ex5 | Versão compilada do EA desenvolvido para utilizar o modelo treinado com o conjunto de dados ampliado. |
| Fetch Data MA.mq5 | Script MQL5 para extrair um conjunto de dados multidimensional e gravá-lo em um arquivo CSV. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18525
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Desenvolvimento de um Kit de Ferramentas para Análise da Ação do Preço (Parte 25): Rompimento de Fractais com EMA Dupla
 A arte de trabalhar com logs (Parte 8): Registros de erros com tradução automática
 Aprendizado de Máquina e Data Science (Parte 43): Identificação de padrões ocultos em indicadores com modelos de misturas gaussianas latentes (LGMM)
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 71): Utilização de padrões MACD e OBV

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso