

Machine Learning e Data Science (Parte 45): Previsão de séries temporais no Forex com o modelo PROPHET do Facebook
 23
 0

Sumário
- O que é o modelo Prophet
- Características do modelo Prophet
- Implementação do modelo Prophet em Python
- Inclusão de feriados no modelo Prophet
- EA para MetaTrader 5 baseado no modelo Prophet
- Conclusão
O que é o modelo Prophet
O Prophet é uma ferramenta de código aberto para previsão de séries temporais, desenvolvida pela Meta (anteriormente Facebook). Seu objetivo é facilitar a geração de previsões precisas para aplicações empresariais e analíticas, especialmente quando os dados apresentam tendências e padrões sazonais bem definidos.
O modelo foi apresentado pelo Facebook (S. J. Taylor e Benjamin Letham, 2018) e, inicialmente, foi desenvolvido para prever dados diários com sazonalidade semanal e anual, considerando também os efeitos dos feriados. Posteriormente, foi ampliado para trabalhar com outros tipos de dados sazonais. Os melhores resultados são obtidos em séries temporais com padrões sazonais bem definidos e um histórico de dados suficientemente extenso.
Conceitos principais:
- Trend (tendência): representa a direção geral de crescimento ou queda dos dados ao longo de um período prolongado, desconsiderando as oscilações sazonais.
- Seasonality (sazonalidade): corresponde às oscilações que ocorrem em períodos mais curtos e não caracterizam, por si só, uma tendência.
Neste artigo, vamos analisar e implementar esse modelo com dados do Forex para avaliar como ele pode contribuir para a compreensão dos dados de mercado. Antes disso, porém, vamos examinar suas características em mais detalhes.
Características do modelo Prophet
O Prophet pode ser interpretado como um modelo de regressão não linear, representado pela seguinte equação:
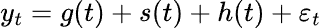
Figura 01
em que:
 representa a tendência linear por partes (ou componente de crescimento);
 representa os diferentes componentes sazonais;
 considera os efeitos dos feriados; e
 representa o erro aleatório, modelado como ruído branco.
1. Componente de tendência
O componente de tendência  admite pontos de mudança (changepoints), identificados automaticamente caso não sejam definidos manualmente. Esses pontos correspondem a momentos em que a trajetória da tendência pode mudar, como em movimentos de alta ou queda acentuados.
Também é possível utilizar um modelo de crescimento logístico em vez do linear. Nesse caso, introduz-se um parâmetro de capacidade (cap), que permite modelar efeitos de saturação. Essa abordagem é útil quando o crescimento desacelera à medida que se aproxima de um limite natural.
2. Sazonalidade
No Prophet, a sazonalidade  é modelada por meio de séries de Fourier.
Por padrão:
- A sazonalidade anual utiliza uma série de Fourier de ordem 10.
- A sazonalidade semanal utiliza uma série de Fourier de ordem 3.
Esses termos de Fourier permitem que o modelo identifique padrões sazonais recorrentes.
3. Efeitos dos feriados
Os efeitos dos feriados  são incorporados ao modelo por meio de variáveis indicadoras (one-hot encoding), permitindo ajustar as previsões em torno de datas específicas que, historicamente, provocaram alterações no comportamento dos dados. Entre os exemplos estão a divulgação de notícias econômicas e os feriados nacionais.
O modelo é estimado por meio de uma abordagem bayesiana, que permite identificar automaticamente os pontos de mudança e estimar outros parâmetros.
Embora o modelo básico de decomposição aditiva pareça simples, os cálculos envolvidos são bastante complexos do ponto de vista matemático. Se não houver uma compreensão adequada de seu funcionamento, o modelo poderá produzir previsões incorretas.
O Prophet oferece duas abordagens de modelagem:
- Modelo de crescimento linear por partes (padrão)
- Modelo logístico
01. Modelo linear por partes
Essa é a abordagem utilizada por padrão no Prophet. Ela pressupõe que a tendência dos dados segue uma trajetória linear, mas pode mudar em determinados momentos, chamados pontos de mudança. É adequada para séries que apresentam crescimento ou queda relativamente constantes, mesmo quando ocorrem mudanças bruscas de tendência.
Essa abordagem é descrita pela fórmula apresentada na Figura 01.
02. Modelo logístico
Esse modelo é adequado para séries que apresentam crescimento com saturação: após uma fase inicial de crescimento acelerado, o ritmo diminui à medida que os valores se aproximam de um limite máximo. Esse comportamento é comum em sistemas reais sujeitos a restrições naturais ou empresariais, como o crescimento da base de usuários em um mercado próximo da saturação.
O modelo logístico inclui um parâmetro de capacidade que define o limite superior do crescimento.
Essa abordagem é descrita pela seguinte fórmula:
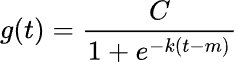
Imagem 02
em que:
 representa a capacidade máxima,
 é a taxa de crescimento e
 é o parâmetro de deslocamento.
Implementação do modelo Prophet em Python
Utilizando dados do EURUSD no período gráfico de uma hora, vamos tentar identificar a tendência e a sazonalidade da série, além de prever valores futuros com o Prophet.
A primeira etapa é instalar todas as dependências listadas no arquivo requirements.txt, disponibilizado ao final do artigo.
pip install -r requirements.txt
Importação.
import pandas as pd
import numpy as np
import MetaTrader5 as mt5
import matplotlib.pyplot as plt
import seaborn as sns
from prophet import Prophet

plt.style.use('fivethirtyeight')
sns.set_style("darkgrid")
Vamos obter os dados do MetaTrader 5.
if not mt5.initialize(r"c:\Program Files\MetaTrader 5 IC Markets (SC)\terminal64.exe"):
    print("Failed to initialize MetaTrader5. Error = ",mt5.last_error())
    mt5.shutdown()

symbol = "EURUSD"
timeframe = mt5.TIMEFRAME_H1

rates = mt5.copy_rates_from_pos(symbol, timeframe, 1, 10000)

if rates is None:
    print(f"Failed to copy rates for symbol={symbol}. MT5 Error = {mt5.last_error()}")
O Prophet exige uma coluna temporal com valores do tipo datetime (marcas de tempo), indispensável ao funcionamento do modelo.
Após obter os dados de cotação do MetaTrader 5, vamos convertê-los em um DataFrame do Pandas. Em seguida, converteremos a coluna de tempo, cujos valores estão expressos em segundos, para o formato datetime.
rates_df = pd.DataFrame(rates) # we convert rates object to a dataframe
rates_df["time"] = pd.to_datetime(rates_df["time"], unit="s") # we convert the time from seconds to datatime

rates_df
Resultados.
| time | open | high | low | close | tick_volume | spread | real_volume | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2023-11-10 23:00:00 | 1.06849 | 1.06873 | 1.06826 | 1.06846 | 762 | 0 | 0 |
| 1 | 2023-11-13 00:00:00 | 1.06828 | 1.06853 | 1.06779 | 1.06841 | 1059 | 10 | 0 |
| 2 | 2023-11-13 01:00:00 | 1.06854 | 1.06907 | 1.06854 | 1.06906 | 571 | 0 | 0 |
| 3 | 2023-11-13 02:00:00 | 1.06904 | 1.06904 | 1.06822 | 1.06839 | 1053 | 0 | 0 |
| 4 | 2023-11-13 03:00:00 | 1.06840 | 1.06886 | 1.06811 | 1.06867 | 1204 | 0 | 0 |
O Prophet é um modelo univariado e exige apenas duas colunas no DataFrame: uma coluna do tipo datetime, denominada ds (date stamp), e a variável-alvo, denominada y.
Para começar, vamos criar um conjunto de dados simples a partir das informações obtidas do MetaTrader 5. Ele conterá duas colunas: time, com as marcas de tempo, e volatility, com os valores de volatilidade. Esses serão os dados utilizados nas próximas etapas da modelagem com o Prophet.
prophet_df = pd.DataFrame({
    "time": rates_df["time"],
    "volatility": rates_df["high"] - rates_df["low"]
}).set_index("time")

prophet_df
A volatilidade, calculada pela diferença entre o preço máximo e o mínimo, é utilizada como variável-alvo.
Diferentemente de outros modelos de previsão de séries temporais, como ARIMA e VAR (abordados anteriormente), que exigem que a variável-alvo seja estacionária, o Prophet não apresenta essa restrição. Ele também consegue trabalhar com dados não estacionários. No entanto, os modelos de machine learning geralmente apresentam melhores resultados com variáveis estacionárias, pois suas propriedades estatísticas permanecem constantes ao longo do tempo, incluindo a média, a variância e o desvio-padrão, o que facilita o treinamento.
Neste caso, optamos por uma variável-alvo estacionária para simplificar a tarefa.
Agora, vamos representar graficamente os dados do DataFrame e analisar seus atributos.
# Color pallete for plotting
color_pal = ["#F8766D", "#D39200", "#93AA00",
             "#00BA38", "#00C19F", "#00B9E3",
             "#619CFF", "#DB72FB"]

prophet_df.plot(figsize=(7,5), color=color_pal, title="Volatility (high-low) against time", ylabel="volatility", xlabel="time")
Resultados.
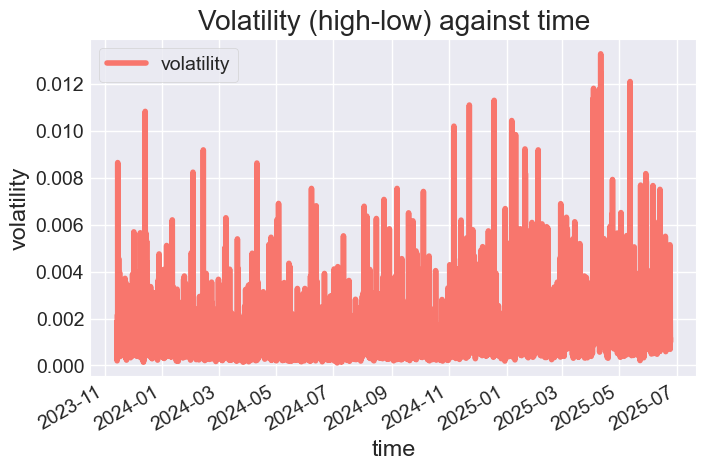
Figura 03
Também podemos organizar os dados em X, com os atributos temporais, e y, com a volatilidade, para avaliar a relação entre essas características e o comportamento do mercado.
def create_features(df, label=None):
    """
    Creates time series features from datetime index.
    """

    df = df.copy()
    df['date'] = df.index
    df['hour'] = df['date'].dt.hour
    df['dayofweek'] = df['date'].dt.dayofweek
    df['quarter'] = df['date'].dt.quarter
    df['month'] = df['date'].dt.month
    df['year'] = df['date'].dt.year
    df['dayofyear'] = df['date'].dt.dayofyear
    df['dayofmonth'] = df['date'].dt.day
    df['weekofyear'] = df['date'].dt.isocalendar().week

    X = df[['hour','dayofweek','quarter','month','year',
           'dayofyear','dayofmonth','weekofyear']]
    if label:
        y = df[label]
        return X, y
    return X

X, y = create_features(prophet_df, label='volatility')

features_and_target = pd.concat([X, y], axis=1)
Resultados.
| hour | dayofweek | quarter | month | year | dayofyear | dayofmonth | weekofyear | volatility | |
|---|---|---|---|---|---|---|---|---|---|
| time | |||||||||
| 2023-11-13 16:00:00 | 16 | 0 | 4 | 11 | 2023 | 317 | 13 | 46 | 0.00122 |
| 2023-11-13 17:00:00 | 17 | 0 | 4 | 11 | 2023 | 317 | 13 | 46 | 0.00179 |
| 2023-11-13 18:00:00 | 18 | 0 | 4 | 11 | 2023 | 317 | 13 | 46 | 0.00186 |
| 2023-11-13 19:00:00 | 19 | 0 | 4 | 11 | 2023 | 317 | 13 | 46 | 0.00125 |
| 2023-11-13 20:00:00 | 20 | 0 | 4 | 11 | 2023 | 317 | 13 | 46 | 0.00150 |
Podemos visualizar graficamente a relação entre esses atributos e a volatilidade para realizar uma análise manual.
sns.pairplot(features_and_target.dropna(),
             hue='hour',
             x_vars=['hour','dayofweek',
                     'year','weekofyear'],
             y_vars='volatility',
             height=5,
             plot_kws={'alpha':0.45, 'linewidth':0.5}
            )

plt.suptitle(f"{symbol} close prices by Hour, Day of Week, Year, and Week")
plt.show()
Resultados.

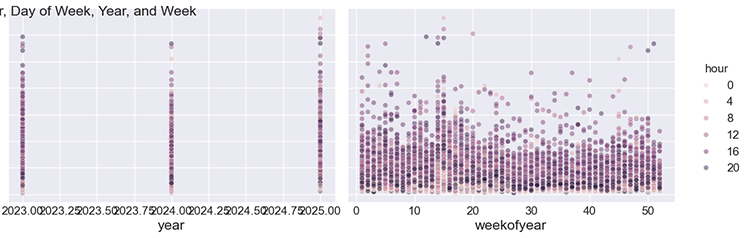
Figura 04
Observamos que a volatilidade das barras horárias apresenta variações associadas à hora do dia, ao dia da semana, ao ano e à semana do ano. Isso reforça nossa confiança de que os dados são adequados para utilização no modelo Prophet.
Treinamento do modelo Prophet
Vamos começar dividindo os dados em conjuntos de treinamento e teste.
split_date = '01-Jan-2025' # threshold date between training and testing samples, all values after this date are for testing

prophet_df_train = prophet_df.loc[prophet_df.index <= split_date].copy().reset_index().rename(columns={"time": "ds", "volatility": "y"})
prophet_df_test = prophet_df.loc[prophet_df.index > split_date].copy().reset_index().rename(columns={"time": "ds", "volatility": "y"})
Em seguida, treinamos o modelo Prophet com os dados de treinamento.
model = Prophet()
model.fit(prophet_df_train)
Após o treinamento, normalmente é necessário avaliar o desempenho do modelo com dados fora da amostra de treinamento, ou seja, informações que ele ainda não utilizou. No entanto, o Prophet apresenta suas previsões em um formato diferente do utilizado por outros modelos.
test_fcst = model.predict(df=prophet_df_test)
Em vez de retornar apenas um vetor de valores previstos, o modelo retorna um DataFrame completo, com diversas colunas que contêm as previsões e informações sobre os componentes do modelo.
test_fcst.head()
Resultados.
	ds      trend   	yhat_lower      yhat_upper      trend_lower     trend_upper     additive_terms  additive_terms_lower    additive_terms_upper    daily   daily_lower     daily_upper     weekly  weekly_lower    weekly_upper    multiplicative_terms    multiplicative_terms_lower      multiplicative_terms_upper      yhat
0       2025-01-02 00:00:00     0.001674        0.000168        0.001993        0.001674        0.001674        -0.000571       -0.000571       -0.000571       -0.000510       -0.000510       -0.000510       -0.000061       -0.000061       -0.000061       0.0     0.0     0.0     0.001102
1       2025-01-02 01:00:00     0.001674        0.000161        0.001977        0.001674        0.001674        -0.000614       -0.000614       -0.000614       -0.000556       -0.000556       -0.000556       -0.000057       -0.000057       -0.000057       0.0     0.0     0.0     0.001060
2       2025-01-02 02:00:00     0.001674        0.000337        0.002123        0.001674        0.001674        -0.000483       -0.000483       -0.000483       -0.000430       -0.000430       -0.000430       -0.000054       -0.000054       -0.000054       0.0     0.0     0.0     0.001191
A tabela a seguir descreve o significado de algumas das colunas (atributos) retornadas pelo método predict.
| Coluna | Significado |
|---|---|
| ds | Data e hora (marca de tempo) do ponto para o qual a previsão é gerada. |
| yhat | Valor final previsto pelo modelo. |
| yhat_lower, yhat_upper | Limites inferior e superior do intervalo de confiança (80% ou 95%) para yhat. |
| trend | Valor do componente de tendência no instante ds (por exemplo, crescimento ou queda gradual). |
| trend_lower, trend_upper | Limites do intervalo de confiança do componente de tendência. |
| additive_terms | Soma de todos os componentes sazonais e dos efeitos dos feriados no instante ds (por exemplo, sazonalidade diária + semanal + efeitos dos feriados). |
| additive_terms_lower, additive_terms_upper | Limites do intervalo de confiança dos componentes aditivos. |
| daily | Componente de sazonalidade diária (por exemplo, padrões horários que se repetem ao longo do dia). |
| daily_lower, daily_upper | Limites do intervalo de confiança do componente de sazonalidade diária. |
| weekly | Componente de sazonalidade semanal (por exemplo, diferenças entre dias úteis e fins de semana). |
| weekly_lower, weekly_upper | Limites do intervalo de confiança do componente de sazonalidade semanal. |
As colunas mais importantes para nossa análise são yhat, yhat_lower, yhat_upper, trend, os componentes sazonais (daily, weekly, yearly), os efeitos dos feriados (quando presentes) e os limites inferior e superior dos intervalos de incerteza dos componentes (colunas com os sufixos _lower e _upper).
Vamos representar graficamente os valores reais e as previsões do conjunto de teste, incluindo também os valores reais do conjunto de treinamento.
f, ax = plt.subplots(figsize=(7,5))
ax.scatter(prophet_df_test["ds"], prophet_df_test['y'], color='r') # plot actual values from the testing sample in red

fig = model.plot(test_fcst, ax=ax) # plot the forecasts
Resultado.
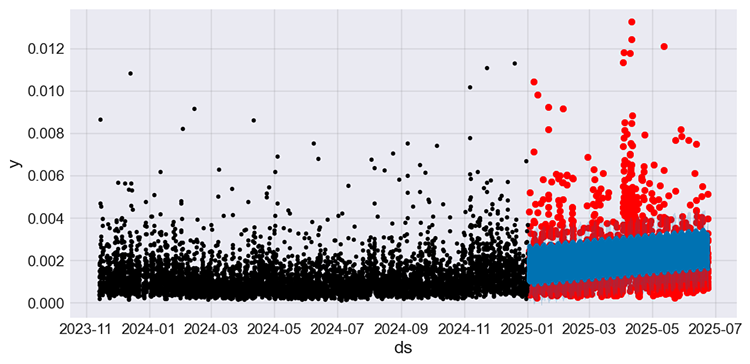
Figura 05
Os valores em preto correspondem ao conjunto de treinamento; em vermelho, estão os valores reais do conjunto de teste; e, em azul, as previsões do modelo para esse mesmo conjunto.
Esse gráfico não permite avaliar com clareza o desempenho do modelo. Por isso, vamos representar os valores reais e as previsões do conjunto de teste em gráficos separados.
Vamos avaliar o modelo com os dados de janeiro de 2025, o primeiro mês do conjunto de teste.
f, ax = plt.subplots(figsize=(7, 5))

ax.scatter(prophet_df_test["ds"], prophet_df_test['y'], color='r')
fig = model.plot(test_fcst, ax=ax)
ax.set_xbound(
            lower=pd.to_datetime("2025-01-01"), # starting data on the x axis
            upper=pd.to_datetime("2025-02-01")) # ending data on the x axis

ax.set_ylim(0, 0.005)
plot = plt.suptitle("January 2025, Actual vs Forecasts")
Resultados.
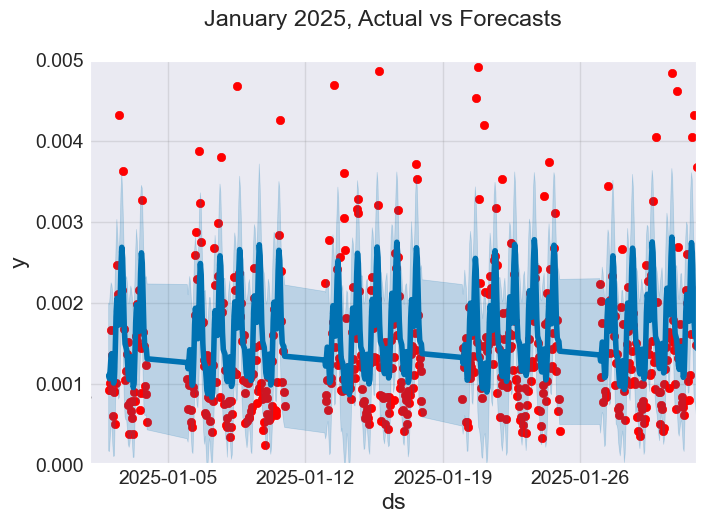
Figura 06
Pelo gráfico acima, observamos que o Prophet acerta algumas previsões, mas apresenta dificuldades para lidar com valores atípicos nos dados.
Podemos aprofundar a análise comparando os valores reais com as previsões do modelo durante a primeira semana de janeiro (de 1º a 8 de janeiro).
f, ax = plt.subplots(figsize=(9, 5))

ax.scatter(prophet_df_test["ds"], prophet_df_test['y'], color='r')
fig = model.plot(test_fcst, ax=ax)
ax.set_xbound(
            lower=pd.to_datetime("2025-01-01"),
            upper=pd.to_datetime("2025-01-08"))

ax.set_ylim(0, 0.005)
plot = plt.suptitle("January 01-08, 2025. Actual vs Forecasts")
Resultados.
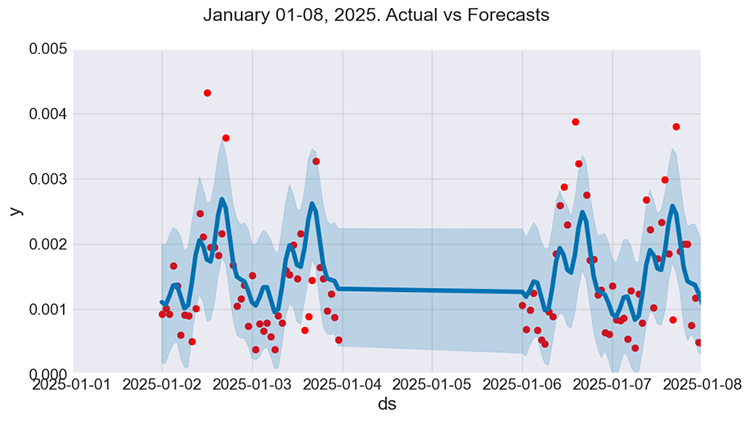
Figura 07
O resultado é consideravelmente melhor. Ainda assim, embora o modelo consiga identificar determinados padrões, suas previsões não ficam tão próximas dos valores reais quanto gostaríamos. E essa proximidade é justamente o que buscamos em modelos de regressão.
Apesar disso, o modelo demonstra uma capacidade razoável de generalização.
Vamos avaliar seu desempenho utilizando métricas de qualidade.
import sklearn.metrics as metric

def forecast_accuracy(forecast, actual):
    # Convert to numpy arrays if they aren't already
    forecast = np.asarray(forecast)
    actual = np.asarray(actual)

    metrics = {
        'mape': metric.mean_absolute_percentage_error(actual, forecast),
        'me': np.mean(forecast - actual),  # Mean Error
        'mae': metric.mean_absolute_error(actual, forecast),
        'mpe': np.mean((forecast - actual) / actual),  # Mean Percentage Error
        'rmse': metric.root_mean_squared_error(actual, forecast),
        'minmax': 1 - np.mean(np.minimum(forecast, actual) / np.maximum(forecast, actual)),
        "r2_score": metric.r2_score(forecast, actual)
    }
    return metrics

results = forecast_accuracy(test_pred, prophet_df_test["y"])

for metric_name, value in results.items():
    print(f"{metric_name:<10}: {value:.6f}")
Resultados.
mape      : 0.603277
me        : 0.000130
mae       : 0.000829
mpe       : 0.430299
rmse      : 0.001221
minmax    : 0.339292
r2_score  : -4.547775
Neste caso, nosso principal interesse é a métrica MAPE (Mean Absolute Percentage Error, erro percentual absoluto médio). Um valor próximo de 0,6 indica que, em média, as previsões do modelo apresentam um desvio de 60% em relação aos valores reais. Em outras palavras, o modelo produz previsões muito imprecisas, com erros expressivos.
Inclusão de feriados no modelo Prophet
O Prophet foi desenvolvido desde o início para considerar eventos capazes de provocar alterações anômalas em séries temporais. No modelo, esses eventos são tratados como feriados.
Na prática, feriados e outros eventos especiais podem afetar os dados empresariais de maneira irregular. Alguns exemplos são:
- Feriados nacionais (como Ano-Novo e Natal)
- Eventos empresariais (como Black Friday e lançamentos de produtos)
- Eventos financeiros (como comunicados de bancos centrais e encerramentos de trimestre)
- Eventos locais (como eleições e fenômenos meteorológicos extremos)
Essas datas não seguem necessariamente um padrão sazonal regular, mas podem se repetir anualmente, trimestralmente, diariamente etc.
Em séries temporais financeiras utilizadas em trading, as notícias econômicas podem ser tratadas como feriados, pois provocam efeitos semelhantes. Isso pode ajudar o modelo a superar uma das limitações observadas até aqui: a dificuldade de levar em conta os valores extremos nas previsões.
Como mostra a fórmula do Prophet apresentada na Figura 01, considerar os efeitos dos feriados permite representar melhor o comportamento da série temporal, já que o componente de feriados é um dos elementos fundamentais do modelo.
Para isso, precisamos coletar as notícias econômicas. Vamos realizar essa etapa em MQL5.
Nome do arquivo: OHLC + News.mq5
input datetime start_date = D'01.01.2023';
input datetime end_date = D'24.6.2025';
input ENUM_TIMEFRAMES timeframe = PERIOD_H1;

MqlRates rates[];
struct news_data_struct
  {
    datetime time[]; //News release time
    double open[]; //Candle opening price
    double high[]; //Candle high price
    double low[]; //Candle low price
    double close[]; //Candle close price
    string name[]; //Name of the news
    ENUM_CALENDAR_EVENT_SECTOR sector[]; //The sector a news is related to
    ENUM_CALENDAR_EVENT_IMPORTANCE importance[]; //Event importance
    double actual[]; //actual value
    double forecast[]; //forecast value
    double previous[]; //previous value

    void Resize(uint size)
      {
          ArrayResize(time, size);
          ArrayResize(open, size);
          ArrayResize(high, size);
          ArrayResize(low, size);
          ArrayResize(close, size);
          ArrayResize(name, size);
          ArrayResize(sector, size);
          ArrayResize(importance, size);
          ArrayResize(actual, size);
          ArrayResize(forecast, size);
          ArrayResize(previous, size);
      }

  } news_data;
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//---

   if (!ChartSetSymbolPeriod(0, Symbol(), timeframe))
      return;

   SaveNews(StringFormat("%s.%s.OHLC + News.csv",Symbol(),EnumToString(timeframe)));
  }
//+------------------------------------------------------------------+
//|                                                                  |
//|   The function which collects news alongsided OHLC values and    |
//|   saves the data to a CSV file                                   |
//|                                                                  |
//+------------------------------------------------------------------+
void SaveNews(string csv_name)
 {
//--- get OHLC values first

   ResetLastError();
   if (CopyRates(Symbol(), timeframe, start_date, end_date, rates)<=0)
     {
       printf("%s failed to get price information from %s to %s. Error = %d",__FUNCTION__,string(start_date),string(end_date),GetLastError());
       return;
     }

   uint size = rates.Size();
   news_data.Resize(size-1);

//---

   FileDelete(csv_name); //Delete an existing csv file of a given name
   int csv_handle = FileOpen(csv_name,FILE_WRITE|FILE_SHARE_WRITE|FILE_CSV|FILE_ANSI|FILE_COMMON,",",CP_UTF8); //csv handle

   if(csv_handle == INVALID_HANDLE)
     {
       printf("Invalid %s handle Error %d ",csv_name,GetLastError());
       return; //stop the process
     }

   FileSeek(csv_handle,0,SEEK_SET); //go to file begining
   FileWrite(csv_handle,"Time,Open,High,Low,Close,Name,Sector,Importance,Actual,Forecast,Previous"); //write csv header

   MqlCalendarValue values[]; //https://www.mql5.com/en/docs/constants/structures/mqlcalendar#mqlcalendarvalue
   for (uint i=0; i<size-1; i++)
      {
         news_data.time[i] = rates[i].time;
         news_data.open[i] = rates[i].open;
         news_data.high[i] = rates[i].high;
         news_data.low[i] = rates[i].low;
         news_data.close[i] = rates[i].close;

         int all_news = CalendarValueHistory(values, rates[i].time, rates[i+1].time, NULL, NULL); //we obtain all the news with their values https://www.mql5.com/en/docs/calendar/calendarvaluehistory

         for (int n=0; n<all_news; n++)
            {
              MqlCalendarEvent event;
              CalendarEventById(values[n].event_id, event); //Here among all the news we select one after the other by its id https://www.mql5.com/en/docs/calendar/calendareventbyid

              MqlCalendarCountry country; //The couhtry where the currency pair originates
              CalendarCountryById(event.country_id, country); //https://www.mql5.com/en/docs/calendar/calendarcountrybyid

              if (StringFind(Symbol(), country.currency)>-1) //We want to ensure that we filter news that has nothing to do with the base and the quote currency for the current symbol pair
                {
                     news_data.name[i] = event.name;
                     news_data.sector[i] = event.sector;
                     news_data.importance[i] = event.importance;

                     news_data.actual[i] = !MathIsValidNumber(values[n].GetActualValue()) ? 0 : values[n].GetActualValue();
                     news_data.forecast[i] = !MathIsValidNumber(values[n].GetForecastValue()) ? 0 : values[n].GetForecastValue();
                     news_data.previous[i] = !MathIsValidNumber(values[n].GetPreviousValue()) ? 0 : values[n].GetPreviousValue();
                }
            }

          FileWrite(csv_handle,StringFormat("%s,%f,%f,%f,%f,%s,%s,%s,%f,%f,%f",
                                 (string)news_data.time[i],
                                 news_data.open[i],
                                 news_data.high[i],
                                 news_data.low[i],
                                 news_data.close[i],
                                 news_data.name[i],
                                 EnumToString(news_data.sector[i]),
                                 EnumToString(news_data.importance[i]),
                                 news_data.actual[i],
                                 news_data.forecast[i],
                                 news_data.previous[i]
                               ));
       }
//---

   FileClose(csv_handle);
 }
Após a coleta das notícias, a função SaveNews salva os dados em um arquivo CSV na pasta compartilhada.
No script Python, esses dados são carregados a partir do mesmo diretório.
from Trade.TerminalInfo import CTerminalInfo
import os

terminal = CTerminalInfo()
data_path = os.path.join(terminal.common_data_path(), "Files")

timeframe = "PERIOD_H1"
df = pd.read_csv(os.path.join(data_path, f"{symbol}.{timeframe}.OHLC + News.csv"))

df
Resultados.
| Time | Open | High | Low | Close | Name | Sector | Importance | Actual | Forecast | Previous | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2023.01.02 01:00:00 | 1.06967 | 1.06983 | 1.06927 | 1.06983 | New Year's Day | CALENDAR_SECTOR_HOLIDAYS | CALENDAR_IMPORTANCE_NONE | 0.0 | 0.0 | 0.0 |
| 1 | 2023.01.02 02:00:00 | 1.06984 | 1.07059 | 1.06914 | 1.07041 | New Year's Day | CALENDAR_SECTOR_HOLIDAYS | CALENDAR_IMPORTANCE_NONE | 0.0 | 0.0 | 0.0 |
| 2 | 2023.01.02 03:00:00 | 1.07059 | 1.07069 | 1.06858 | 1.06910 | New Year's Day | CALENDAR_SECTOR_HOLIDAYS | CALENDAR_IMPORTANCE_NONE | 0.0 | 0.0 | 0.0 |
| 3 | 2023.01.02 04:00:00 | 1.06909 | 1.06909 | 1.06828 | 1.06880 | New Year's Day | CALENDAR_SECTOR_HOLIDAYS | CALENDAR_IMPORTANCE_NONE | 0.0 | 0.0 | 0.0 |
| 4 | 2023.01.02 05:00:00 | 1.06881 | 1.07029 | 1.06880 | 1.06897 | New Year's Day | CALENDAR_SECTOR_HOLIDAYS | CALENDAR_IMPORTANCE_NONE | 0.0 | 0.0 | 0.0 |
Como o script MQL5 coleta notícias para cada linha dos dados, a coluna correspondente também apresenta valores null nos períodos em que não há notícias. Essas linhas precisam ser filtradas.
news_df = df[df['Name'] != "(null)"].copy()
Assim como estruturamos o conjunto de dados principal em duas colunas (ds e y), o conjunto de dados dos feriados também deve conter duas colunas: ds e holiday. A coluna holiday armazena os nomes das notícias.
holidays = news_df[['Time', 'Name']].rename(columns={
    'Time': 'ds',
    'Name': 'holiday'
})

holidays['ds'] = pd.to_datetime(holidays['ds'])  # Ensure datetime format
holidays
Resultados.
| ds | holiday | |
|---|---|---|
| 0 | 2023-01-02 01:00:00 | New Year's Day |
| 1 | 2023-01-02 02:00:00 | New Year's Day |
| 2 | 2023-01-02 03:00:00 | New Year's Day |
| 3 | 2023-01-02 04:00:00 | New Year's Day |
| 4 | 2023-01-02 05:00:00 | New Year's Day |
Além disso, o DataFrame de feriados pode incluir duas colunas opcionais: lower_window e upper_window. Essas colunas indicam ao modelo como um evento influencia os dados antes e depois de sua ocorrência.
Na prática, a influência de todos os eventos raramente se limita ao momento de sua divulgação — muitas vezes se estende aos períodos anteriores e posteriores.
holidays['lower_window'] = 0
holidays['upper_window'] = 1  # Extend effect to 1 hour after
A coluna lower_window define a influência do evento antes de sua ocorrência, enquanto a coluna upper_window define sua influência sobre a série temporal após o evento.
- Na coluna lower_window, os valores podem ser iguais ou inferiores a zero (≤ 0), sendo 0 o valor padrão, o que significa que o feriado não afeta os valores anteriores da série temporal. O valor -1 indica que o evento influenciou uma barra anterior, e assim por diante.
- Na coluna upper_window, os valores podem ser iguais ou superiores a zero (≥ 0), e o valor padrão também é 0, indicando que o evento não afeta os valores futuros da série temporal. O valor 1 indica uma influência sobre a barra seguinte, e assim por diante.
Agora, vamos adicionar esses atributos ao modelo.
holidays['lower_window'] = -1 # The anticipation of the news affect the volatility 1 bar before it's release
holidays['upper_window'] = 1  # The news affects the volatility 1 bar after its release

holidays
Agora, nosso DataFrame com os dados dos feriados apresenta a seguinte estrutura:
| ds | holiday | lower_window | upper_window | |
|---|---|---|---|---|
| 0 | 2023-01-02 01:00:00 | New Year's Day | -1 | 1 |
| 1 | 2023-01-02 02:00:00 | New Year's Day | -1 | 1 |
| 2 | 2023-01-02 03:00:00 | New Year's Day | -1 | 1 |
| 3 | 2023-01-02 04:00:00 | New Year's Day | -1 | 1 |
| 4 | 2023-01-02 05:00:00 | New Year's Day | -1 | 1 |
| ... | ... | ... | ... | ... |
| 15369 | 2025-06-20 18:00:00 | Eurogroup Meeting | -1 | 1 |
| 15370 | 2025-06-20 19:00:00 | Eurogroup Meeting | -1 | 1 |
| 15371 | 2025-06-20 20:00:00 | Eurogroup Meeting | -1 | 1 |
| 15372 | 2025-06-20 21:00:00 | Eurogroup Meeting | -1 | 1 |
| 15373 | 2025-06-20 22:00:00 | Eurogroup Meeting | -1 | 1 |
Vamos configurar o Prophet com o DataFrame de feriados e treiná-lo com os dados preparados anteriormente.
model_w_holidays = Prophet(holidays=holidays)
model_w_holidays.fit(prophet_df_train)
Agora, vamos avaliar as previsões do modelo considerando as notícias, representando graficamente os valores previstos e reais, como fizemos antes.
# Predict on training set with model
test_fcst = model_w_holidays.predict(df=prophet_df_test)

test_pred = test_fcst.yhat # We get the predictions

# Plot the forecast with the actuals

f, ax = plt.subplots(figsize=(10,5))
ax.scatter(prophet_df_test["ds"], prophet_df_test['y'], color='r')

fig = model_w_holidays.plot(test_fcst, ax=ax)
Resultados.
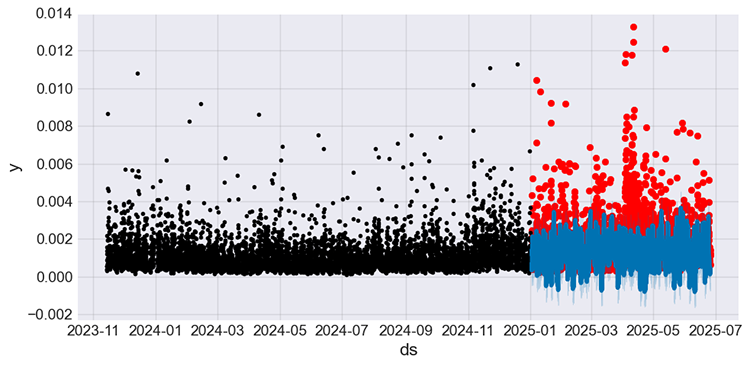
Figura 08
Em comparação com o modelo sem notícias (Figura 05), que produzia previsões com pouca variação, o novo modelo consegue captar melhor as oscilações que antes não eram consideradas.
Vamos avaliar novamente seu desempenho utilizando as mesmas métricas.
results = forecast_accuracy(test_pred, prophet_df_test["y"])

for metric_name, value in results.items():
    print(f"{metric_name:<10}: {value:.6f}")
Resultados.
mape      : 0.549152
me        : -0.000633
mae       : 0.000970
mpe       : -0.175082
rmse      : 0.001487
minmax    : 0.461444
r2_score  : -2.793478
A métrica MAPE indica uma redução relativa de aproximadamente 8% no erro das previsões. O valor passou de cerca de 60% para 55%, uma queda de cinco pontos percentuais. Essa melhoria também é confirmada pela métrica r2_score.
Ainda assim, um modelo com erro de 55% não pode ser considerado satisfatório. Um bom modelo deve apresentar um erro inferior a 50% (< 50%). Portanto, ainda podemos melhorar seu desempenho por meio de um tratamento mais adequado dos feriados e das notícias econômicas.
Neste exemplo, definimos lower_window como -1 e upper_window como 1, indicando que o modelo considera os efeitos da notícia sobre a volatilidade em uma janela que se estende de uma barra antes até uma barra depois de sua divulgação. Embora essa configuração tenha melhorado os resultados, não podemos afirmar que seja a mais adequada.
Sabemos que as notícias variam tanto na intensidade quanto na duração de seus efeitos. Por isso, utilizar os mesmos valores para todos os eventos não é uma abordagem conceitualmente correta. Além disso, o modelo considerou todas as notícias, inclusive as de baixa importância, que geralmente são ignoradas pelos traders por ocorrerem com muita frequência e terem efeitos difíceis de identificar no gráfico.
Para resolver esses dois problemas, precisamos definir os valores de lower_window e upper_window dinamicamente, de acordo com o tipo de notícia e seu impacto observado historicamente.
Exemplo de pseudocódigo.
def get_windows(name):
    if "CPI" in name:
        return (-1, 4) # CPI news affects one previous bar volatility, and it affects the volatility of four bars ahead (4 hours impact forward)
    elif "NFP" in name:
        return (-1, 2) # NFP news affects one previous bar volatility, and it affects the volatility of two bars ahead (2 hours impact afterward)
    elif "FOMC" in name or "Rate" in name:
        return (-2, 6) # NFP news affects two previous bar volatility, and it affects the volatility of six bars ahead (6 hours impact afterward)
    else:
        return (0, 1)  # Default


holidays[['lower_window', 'upper_window']] = holidays['holiday'].apply(
    lambda name: pd.Series(get_windows(name))
)
Como existem dezenas de milhares de tipos diferentes de notícias e precisamos determinar com precisão os parâmetros que representam seus efeitos, essa abordagem é extremamente complexa de implementar. No entanto, é a solução mais adequada do ponto de vista conceitual. Por isso, essa etapa ficará a cargo do leitor.
Por enquanto, uma solução razoável é filtrar as notícias e manter apenas os eventos de importância alta e moderada.
news_df = df[
    (df['Name'] != "(null)") & # Filter rows without news at all
    ((df['Importance'] == "CALENDAR_IMPORTANCE_HIGH") | (df['Importance'] == "CALENDAR_IMPORTANCE_MODERATE")) # Filter other news except high importance news
].copy()

news_df
Resultados.
| Time | Open | High | Low | Close | Name | Sector | Importance | Actual | Forecast | Previous | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 7 | 2023.01.02 08:00:00 | 1.06921 | 1.06973 | 1.06724 | 1.06858 | S&P Global Manufacturing PMI | CALENDAR_SECTOR_BUSINESS | CALENDAR_IMPORTANCE_MODERATE | 47.10 | 47.400 | 47.400 |
| 8 | 2023.01.02 09:00:00 | 1.06878 | 1.06909 | 1.06627 | 1.06784 | S&P Global Manufacturing PMI | CALENDAR_SECTOR_BUSINESS | CALENDAR_IMPORTANCE_MODERATE | 47.80 | 47.800 | 47.800 |
| 31 | 2023.01.03 08:00:00 | 1.06636 | 1.06677 | 1.06514 | 1.06524 | Unemployment | CALENDAR_SECTOR_JOBS | CALENDAR_IMPORTANCE_MODERATE | 2.52 | 2.522 | 2.538 |
| 37 | 2023.01.03 14:00:00 | 1.05283 | 1.05490 | 1.05241 | 1.05355 | S&P Global Manufacturing PMI | CALENDAR_SECTOR_BUSINESS | CALENDAR_IMPORTANCE_HIGH | 46.20 | 46.200 | 46.200 |
| 38 | 2023.01.03 15:00:00 | 1.05353 | 1.05698 | 1.05304 | 1.05602 | Construction Spending m/m | CALENDAR_SECTOR_HOUSING | CALENDAR_IMPORTANCE_MODERATE | 0.20 | 0.200 | -0.300 |
Em seguida, selecionamos as colunas com a data e a hora e com o nome do evento, montamos o DataFrame holidays e acrescentamos os valores de lower_window e upper_window.
holidays = news_df[['Time', 'Name']].rename(columns={
    'Time': 'ds',
    'Name': 'holiday'
})

holidays['ds'] = pd.to_datetime(holidays['ds'])  # Ensure datetime format

holidays['lower_window'] = 0
holidays['upper_window'] = 1

holidays
Após treinar novamente o modelo, o gráfico abaixo apresenta os valores do conjunto de treinamento em preto, os valores reais do conjunto de teste em vermelho e as previsões do modelo para o conjunto de teste em azul.
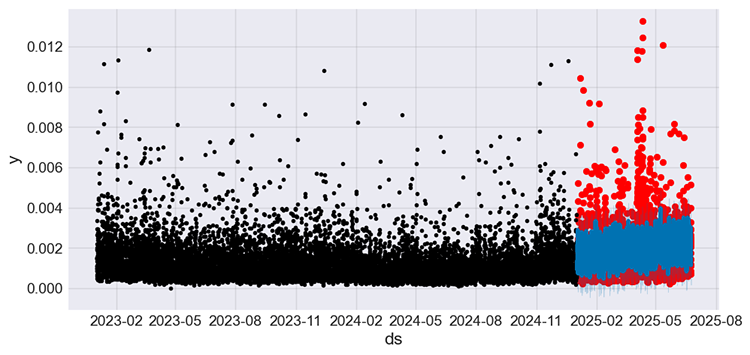
Figura 09
O desempenho do modelo melhorou mais uma vez. Segundo a métrica MAPE, o erro caiu para aproximadamente 50%. Com esse resultado, o modelo de regressão já pode ser utilizado para gerar previsões.
mape      : 0.506827
me        : -0.000053
mae       : 0.000783
mpe       : 0.271597
rmse      : 0.001234
minmax    : 0.320422
r2_score  : -3.318859
Vale observar que as notícias foram importadas separadamente de um arquivo CSV, enquanto os dados de treinamento foram obtidos diretamente do MetaTrader 5.
O Prophet alinha (sincroniza) automaticamente as datas do DataFrame holidays com as do conjunto de treinamento principal, desde que as marcas de tempo de holidays estejam dentro do intervalo de treinamento ou de previsão.
Apesar dessa sincronização automática, é importante garantir que ambos os conjuntos de dados tenham a mesma data inicial para obter o melhor desempenho possível.
Neste caso, foi necessário voltar à etapa de obtenção dos dados de preços do MetaTrader 5, no arquivo main.ipynb, e ajustar as datas inicial e final para que coincidissem com as utilizadas no script OHLC + News.mq5.
# set time zone to UTC
timezone = pytz.timezone("Etc/UTC")

# create 'datetime' objects in UTC-time to avoid the implementation of a local time zone offset
utc_from = datetime(2023, 1, 1, tzinfo=timezone)
utc_to = datetime(2025, 6, 24, hour = 0, tzinfo=timezone)

rates = mt5.copy_rates_range(symbol, timeframe, utc_from, utc_to)
Criação de um EA para MetaTrader 5 baseado no modelo Prophet
Para criar um EA baseado no Prophet, precisamos gerar previsões em tempo real para a variável-alvo, que, neste caso, é a volatilidade.
Isso exige a implementação de um pipeline capaz de obter dados de mercado atualizados para os símbolos de interesse, além das notícias mais recentes. No script de treinamento main.ipynb, os dados foram extraídos do MetaTrader 5 por meio do pacote MetaTrader 5-Python. No entanto, como esse pacote não permite obter notícias, precisamos recorrer ao MQL5.
A proposta é estabelecer uma troca de dados entre o script Python e o EA desenvolvido em MQL5.
- O EA Data for Prophet.mq5, executado em um gráfico do MetaTrader 5, salva periodicamente os dados de notícias e os valores OHLC em um arquivo CSV na pasta compartilhada.
- Em seguida, o script Python Prophet-trading-bot.py lê esse arquivo e treina periodicamente o modelo Prophet.
- Após o treinamento, o modelo gera previsões que são utilizadas para tomar decisões de negociação no próprio script Python.
Arquivo: Data for Prophet.mq5
input uint collect_news_interval_seconds = 60;
input uint training_bars = 1000;

input ENUM_TIMEFRAMES timeframe = PERIOD_H1;
//... other lines of code
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- create timer

   EventSetTimer(collect_news_interval_seconds);

   if (!ChartSetSymbolPeriod(0, Symbol(), timeframe))
      return INIT_FAILED;
//---
   return(INIT_SUCCEEDED);
  }
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//--- destroy timer
   EventKillTimer();
  }
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
  }
//+------------------------------------------------------------------+
//| Timer function                                                   |
//+------------------------------------------------------------------+
void OnTimer()
  {
//---
   MqlDateTime time_struct;
   TimeToStruct(TimeGMT(), time_struct);

   SaveNews(StringFormat("%s.%s.OHLC.date=%s.hour=%d + News.csv",Symbol(),EnumToString(timeframe), TimeToString(TimeGMT(), TIME_DATE), time_struct.hour));
  }
Para garantir que o arquivo correto seja utilizado, seu nome inclui a data e a hora atuais em UTC.
Por padrão, esse EA coleta notícias e outros dados e os salva em um arquivo CSV a cada minuto, conforme definido na função OnTimer.
No script Python, carregamos os dados do arquivo CSV salvo na pasta compartilhada.
Arquivo: Prophet-trading-bot.py
def prophet_vol_predict() -> float:

    # Getting the data with news

    now_utc = datetime.utcnow()
    current_date = now_utc.strftime("%Y.%m.%d")
    current_hour = now_utc.hour

    filename = f"{symbol}.{timeframe}.OHLC.date={current_date}.hour={current_hour} + News.csv" # the same file naming as in MQL5 script
    common_path = os.path.join(terminal.common_data_path(), "Files")
    csv_path = os.path.join(common_path, filename)

    # Keep trying to read a CSV file until it is found, as there could be a temporary difference in values for the file due to the change in time
    while True:
        if os.path.exists(csv_path):
            try:
                rates_df = pd.read_csv(csv_path)
                rates_df["Time"] = pd.to_datetime(rates_df["Time"], unit="s", errors="ignore")  # Convert time from seconds to datetime

                print("File loaded successfully.")
                break  # Exit the loop once file is read
            except Exception as e:
                print(f"Error reading the file: {e}")
                time.sleep(30)
        else:
            print("File not found. Retrying in 30 seconds...")
            time.sleep(30)
Em seguida, preparamos a coluna de volatilidade e extraímos os nomes das notícias para montar, respectivamente, o conjunto de dados de treinamento e o DataFrame de feriados.
# Getting continous variables for the prophet model

prophet_df = pd.DataFrame({
    "time": rates_df["Time"],
    "volatility": rates_df["High"] - rates_df["Low"]
}).set_index("time")

prophet_df = prophet_df.reset_index().rename(columns={"time": "ds", "volatility": "y"}).copy()

print("Prophet df\n",prophet_df.head())

# Getting the news data for the model as well

news_df = rates_df[
    (rates_df['Name'] != "(null)") & # Filter rows without news at all
    ((rates_df['Importance'] == "CALENDAR_IMPORTANCE_HIGH") | (rates_df['Importance'] == "CALENDAR_IMPORTANCE_MODERATE")) # Filter other news except high importance news
].copy()

holidays = news_df[['Time', 'Name']].rename(columns={
    'Time': 'ds',
    'Name': 'holiday'
})

holidays['ds'] = pd.to_datetime(holidays['ds'])  # Ensure datetime format

holidays['lower_window'] = 0
holidays['upper_window'] = 1

print("Holidays df\n", holidays)
Na função prophet_vol_pred, o modelo é treinado com os dados obtidos. Em seguida, a função retorna um único valor previsto: a volatilidade esperada para a próxima barra.
    # re-training the prophet model

    prophet_model = Prophet(holidays=holidays)
    prophet_model.fit(prophet_df)

    # Making future predictions

    future = prophet_model.make_future_dataframe(periods=1) # prepare the dataframe for a single value prediction
    forecast = prophet_model.predict(future) # Predict the next one value

    return forecast.yhat[0] # return a single predicted value
Assim como ocorre com outros modelos de machine learning utilizados na previsão de séries temporais, o Prophet precisa ser atualizado regularmente para incorporar informações recentes que possam influenciar as previsões futuras. Por isso, o modelo é retreinado antes de cada nova previsão.
Vamos executar a função e analisar o resultado.
print("predicted volatility: ",prophet_vol_predict())
Resultados.
File loaded successfully.
Prophet df
                     ds        y
0  2025.04.29 01:00:00  0.00100
1  2025.04.29 02:00:00  0.00210
2  2025.04.29 03:00:00  0.00170
3  2025.04.29 04:00:00  0.00215
4  2025.04.29 05:00:00  0.00278
Holidays df
                      ds                                     holiday  lower_window  upper_window
8   2025-04-29 09:00:00                        GfK Consumer Climate             0             1
14  2025-04-29 15:00:00          Retail Inventories excl. Autos m/m             0             1
31  2025-04-30 08:00:00                       Consumer Spending m/m             0             1
33  2025-04-30 10:00:00                                Unemployment             0             1
35  2025-04-30 12:00:00                                     GDP y/y             0             1
..                  ...                                         ...           ...           ...
978 2025-06-24 19:00:00                 FOMC Member Williams Speech             0             1
979 2025-06-24 20:00:00                         2-Year Note Auction             0             1
982 2025-06-24 23:00:00  Fed Vice Chair for Supervision Barr Speech             0             1
984 2025-06-25 01:00:00                            Jobseekers Total             0             1
994 2025-06-25 11:00:00  Bbk Executive Board Member Mauderer Speech             0             1

[186 rows x 4 columns]
16:01:50 - cmdstanpy - INFO - Chain [1] start processing
16:01:50 - cmdstanpy - INFO - Chain [1] done processing
predicted volatility:  0.0013592111956094713
Agora que conseguimos obter a volatilidade prevista, podemos utilizá-la em uma estratégia de negociação.
symbol = "EURUSD"
timeframe = "PERIOD_H1"
terminal = CTerminalInfo()
m_position = CPositionInfo()

def main():

    m_symbol = CSymbolInfo(symbol=symbol)

    magic_number = 25062025
    slippage = 100

    m_trade = CTrade(magic_number=magic_number,
                     filling_type_symbol=symbol,
                     deviation_points=slippage)

    m_symbol.refresh_rates() # Get recent information from the market

    # we want to open random buy and sell trades if they don't exist and use the predicted volatility to set our stoploss and takeprofit targets

    predicted_volatility = prophet_vol_predict()
    print("predicted volatility: ",prophet_vol_predict())

    if pos_exists(mt5.POSITION_TYPE_BUY, magic_number, symbol) is False:
        m_trade.buy(volume=m_symbol.lots_min(),
                    symbol=symbol,
                    price=m_symbol.ask(),
                    sl=m_symbol.ask()-predicted_volatility,
                    tp=m_symbol.ask()+predicted_volatility)

    if pos_exists(mt5.POSITION_TYPE_SELL, magic_number, symbol) is False:
        m_trade.sell(volume=m_symbol.lots_min(),
                     symbol=symbol,
                     price=m_symbol.bid(),
                     sl=m_symbol.bid()+predicted_volatility,
                     tp=m_symbol.bid()-predicted_volatility)
Essa função recebe a volatilidade prevista pelo modelo Prophet e a utiliza para definir os níveis de stop loss e take profit das operações. Antes de abrir uma nova operação, verificamos se não há outra posição aberta do mesmo tipo.
Chamada da função.
main()
Resultado.
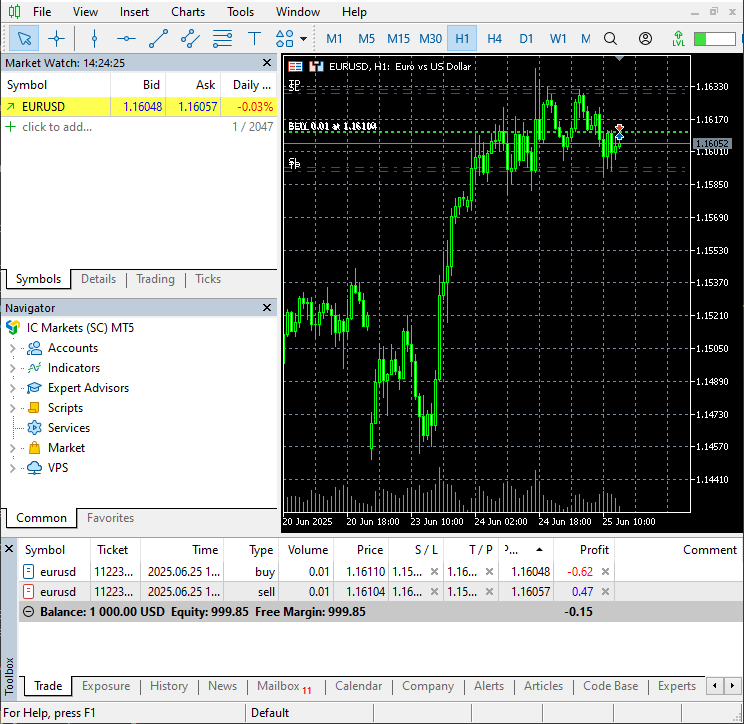
Figura 10
No MetaTrader 5, foram abertas duas operações em direções opostas, com níveis de stop loss e take profit calculados com base na volatilidade prevista.
Podemos automatizar o treinamento e monitorar regularmente as operações e os sinais de negociação.
schedule.every(1).minute.do(main) # train and run trading operations after every one minute

while True:

    schedule.run_pending()
    time.sleep(1)
Conclusão
Embora muitos artigos, publicações e tutoriais afirmem que o Prophet é uma boa opção para a previsão de séries temporais, nos testes realizados ao longo desta série ele apresentou um dos piores desempenhos entre os modelos avaliados.
O Prophet pode ser útil em tarefas de previsão relativamente simples, como estimar a demanda de uma empresa em função das condições climáticas, dos feriados ou de fatores sazonais. No entanto, os mercados financeiros são muito mais complexos. Como mostram os gráficos das Figuras 05 a 09, que comparam os valores reais e previstos no conjunto de teste, o modelo Prophet não consegue prever com precisão a maior parte dos valores.
É provável que existam maneiras de melhorar seu desempenho, mas, por enquanto, recomendo utilizá-lo apenas em tarefas relativamente simples.
Principais limitações do modelo:
- Estrutura simples, que não permite representar interações complexas entre os dados.
- Baixo desempenho na previsão de volatilidade: como vimos, o modelo apresenta dificuldades ao trabalhar com dados do mercado Forex.
- Ausência de modelagem multivariada: na configuração apresentada, o modelo utiliza apenas duas colunas, uma para o tempo e outra para a variável-alvo.
- Ausência de mecanismos integrados de validação cruzada e ajuste de hiperparâmetros: os ajustes relacionados à tendência, à sazonalidade e aos pontos de mudança precisam ser realizados manualmente.
Boa sorte a todos!
Fontes e referências
- https://facebook.github.io/prophet/
- https://otexts.com/fpp3/prophet.html
- https://www.geeksforgeeks.org/time-series-analysis-using-facebook-prophet/
- https://www.kaggle.com/code/omegajoctan/time-series-forecasting-with-prophet/edit
Tabela de arquivos anexos
| Nome do arquivo | Descrição e finalidade |
|---|---|
| Python code\main.ipynb | Notebook Jupyter para análise de dados e estudo do modelo Prophet. |
| Python code\Prophet-trading-bot.py | Robô de negociação desenvolvido em Python para MetaTrader 5. |
| Python code\requirementx.txt | Arquivo de texto com as dependências Python e suas respectivas versões. |
| Python code\error_description.py | Contém as descrições de todos os códigos de erro gerados pelo MetaTrader 5. |
| Python code\Trade\* | Contém classes de negociação (CTrade, CPositionInfo etc.) para Python, semelhantes às disponíveis no MQL5. |
| Experts\Data for Prophet.mq5 | EA que coleta periodicamente os dados necessários para o treinamento do modelo Prophet e os salva em um arquivo CSV. |
| Scripts\OHLC + News.mq5 | Script que coleta e salva em um arquivo CSV os dados necessários para o treinamento do modelo Prophet. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18549
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Ciência de Dados e ML (Parte 42): Previsão de Séries Temporais no Mercado Forex com ARIMA em Python
 Desenvolvimento de ferramentas para análise de Price Action (Parte 29): EA "Boom and Crash Interceptor"
 Está chegando o novo MetaTrader 5 e MQL5
 A arte de trabalhar com logs (Parte 9): aplicando o padrão Builder e definindo configurações padrão

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso