
Ciência de Dados e ML (Parte 42): Previsão de Séries Temporais no Mercado Forex com ARIMA em Python
 27
 1

Conteúdo
- O que é previsão de séries temporais?
- Introdução aos modelos ARIMA
- Principais componentes de um modelo ARIMA
- Modelo ARIMA em Python
- Construindo um modelo ARIMA para o EURUSD
- Previsões fora da amostra utilizando ARIMA
- Gráficos dos resíduos do modelo ARIMA
- Modelo SARIMA
- Conclusão
O que é Previsão de Séries Temporais?
A previsão de séries temporais é o processo de utilizar dados históricos para prever valores futuros em uma sequência de observações. Essa sequência normalmente é organizada cronologicamente, daí o nome série temporal.
Variáveis fundamentais nos dados de séries temporais
Embora possamos incluir quantas variáveis explicativas desejarmos em nossos dados, qualquer conjunto de dados utilizado na análise ou previsão de séries temporais precisa conter estas duas variáveis.
- Tempo
Esta é uma variável independente que representa os momentos específicos em que os dados foram observados. - Variável-alvo
É o valor que queremos prever com base em observações anteriores e, possivelmente, em outros fatores. (Por exemplo, o preço de fechamento diário de uma ação, a temperatura registrada a cada hora ou o tráfego de um site por minuto).
O objetivo da previsão de séries temporais é aproveitar os padrões e as tendências históricas presentes nos dados para realizar previsões fundamentadas sobre valores futuros.
Já discutimos anteriormente a previsão de séries temporais utilizando modelos convencionais de IA. Neste artigo, abordaremos a previsão de séries temporais utilizando um modelo concebido para problemas de séries temporais, conhecido como ARIMA.
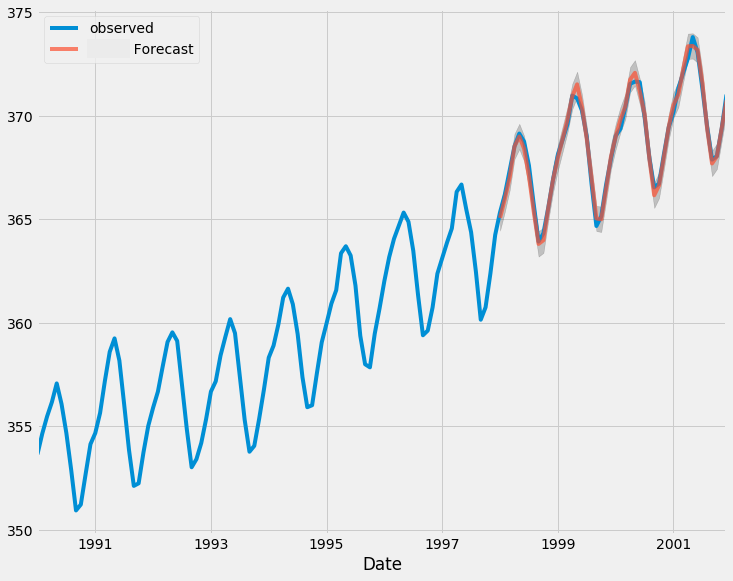
A previsão de séries temporais pode ser dividida em dois tipos.
- Previsão de séries temporais univariadas
É um problema de previsão de séries temporais no qual uma única variável preditora é utilizada para prever seus próprios valores futuros. Por exemplo, utilizar os preços de fechamento atuais de uma ação para prever seus preços de fechamento futuros.
Esse é o tipo de previsão que os modelos ARIMA são capazes de realizar. - Previsão de séries temporais multivariadas
É um problema de previsão de séries temporais no qual múltiplas variáveis preditoras são utilizadas para prever o valor futuro de uma variável-alvo.
De maneira semelhante ao que fizemos neste artigo.
Introdução aos Modelos ARIMA
ARIMA é a sigla para Modelo Autorregressivo Integrado de Médias Móveis (Autoregressive Integrated Moving Average).
Ele pertence a uma classe de modelos que explicam determinada série temporal com base em seus valores anteriores, ou seja, em suas defasagens e nos erros de previsão defasados.
A equação pode ser utilizada para prever valores futuros. Qualquer série temporal "não sazonal" que apresente padrões e não seja simplesmente um ruído branco aleatório pode ser modelada utilizando modelos ARIMA.
Portanto, o ARIMA, abreviação de Autoregressive Integrated Moving Average, é um algoritmo de previsão baseado na ideia de que as informações contidas apenas nos valores históricos de uma série temporal podem ser utilizadas para prever seus valores futuros.
Os modelos ARIMA são especificados por três parâmetros de ordem: (p, d, q).
Onde:
- p é a ordem do componente autorregressivo (AR).
- q é a ordem do componente de médias móveis (MA).
- d é o número de diferenciações necessárias para tornar a série temporal estacionária.
O significado de p, d e q no modelo ARIMA
O significado de p
p representa a ordem do componente autorregressivo (AR). Refere-se ao número de valores defasados de Y que serão utilizados como variáveis preditoras.
O significado de d
O termo Autorregressivo no ARIMA significa que se trata de um modelo de regressão linear que utiliza seus próprios valores defasados como variáveis preditoras. Como sabemos, os modelos de regressão linear funcionam melhor quando as variáveis preditoras não estão correlacionadas e são independentes entre si. Por isso, precisamos tornar a série temporal estacionária.
A abordagem mais comum para tornar uma série estacionária é aplicar a diferenciação. Ou seja, subtrair o valor anterior do valor atual. Às vezes, dependendo da complexidade da série, pode ser necessário aplicar mais de uma diferenciação.
Portanto, o valor de d representa o número mínimo de diferenciações necessárias para tornar a série estacionária. Se a série temporal já for estacionária, então d = 0.
O significado de q
q representa a ordem do componente de médias móveis (MA). Refere-se ao número de erros de previsão defasados que devem ser incluídos no modelo ARIMA.
Principais Componentes de um Modelo ARIMA
Para compreender o ARIMA, precisamos analisar separadamente os elementos que compõem sua estrutura. Depois de decompor esses componentes, fica mais fácil entender como esse método de previsão de séries temporais funciona como um todo.
O nome ARIMA pode ser dividido em três partes (AR, I, MA), conforme descrito a seguir.
Componente Autorregressivo AR(p)
O componente autorregressivo (AR) modela o valor atual com base em valores passados da própria série. Para esclarecer, a "estrutura autorregressiva" funciona como um modelo de regressão no qual utilizamos os valores históricos defasados da própria série temporal como variáveis regressoras.
Esse componente é calculado pela seguinte fórmula:

Onde:
-
 é o valor atual da série temporal no instante t.
-
 é o termo constante.
-
 até
 são os parâmetros autorregressivos (coeficientes) que indicam quanto cada valor defasado contribui para o valor atual.
-
 até
 são os valores anteriores defasados da série temporal.
-
 é o termo de erro no instante t.
Componente Integrado I(d)
O componente Integrado (I) envolve a diferenciação da série temporal, considerando que ela deve ser estacionária, ou seja, sua média e variância devem permanecer constantes ao longo do tempo.
Basicamente, subtraímos uma observação de outra para eliminar tendências e sazonalidades. Ao aplicar a diferenciação, buscamos obter a estacionariedade. Essa etapa é necessária porque ajuda o modelo a se ajustar aos dados, e não ao ruído.
Componente de Médias Móveis MA(q)
O componente de Médias Móveis (MA) concentra-se na relação entre uma observação e um erro residual. Ao analisar como a observação atual se relaciona com os erros anteriores, podemos extrair informações úteis sobre possíveis tendências presentes nos dados.
Podemos considerar os resíduos como parte desses erros, e o conceito do modelo de médias móveis permite estimar ou considerar seu impacto sobre a observação mais recente. Isso é particularmente útil para acompanhar e identificar mudanças de curto prazo nos dados ou choques aleatórios. No componente de Médias Móveis (MA) de uma série temporal, podemos obter informações valiosas sobre seu comportamento, o que, por sua vez, permite realizar previsões com maior precisão.

Onde:
-
 é uma constante.
-
 é o parâmetro MA.
-
 é o erro anterior.
-
 é o erro atual.
Modelo ARIMA em Python
Portanto, um modelo ARIMA é simplesmente a combinação dos três componentes descritos anteriormente: AR, I e MA. Sua equação passa a ser a seguinte:

Agora, o desafio dos modelos ARIMA é encontrar os parâmetros adequados (os valores de p, d e q). Como esses valores determinam o funcionamento do modelo, vamos entender como identificá-los.
Determinando a ordem do componente AR (p)
Podemos determinar o número necessário de termos AR analisando o gráfico da Função de Autocorrelação Parcial (PACF).
A autocorrelação parcial pode ser descrita como a correlação entre a série temporal e seus valores defasados, após excluir as contribuições das defasagens intermediárias. Assim, a PACF representa, de certa forma, a correlação direta entre determinada defasagem e a série temporal. Dessa maneira, podemos identificar se essa defasagem precisa ou não ser incluída no componente AR.
Comece instalando todas as dependências pelo Prompt de Comando (CMD). O arquivo requirements.txt está anexado ao final deste artigo.
pip install -r requirements.txt
Importações.
# Importing required libraries
import pandas as pd
import numpy as np
import MetaTrader5 as mt5

# Use auto_arima to automatically select best ARIMA parameters

import seaborn as sns
import matplotlib.pyplot as plt
import warnings
import os

# Suppress warning messages for cleaner output
warnings.filterwarnings("ignore")

# Set seaborn plot style for better visualization
sns.set_style("darkgrid")
Obtendo os dados do MetaTrader 5.
# Getting (EUR/USD OHLC data) from MetaTrader5

mt5_exe_file = r"c:\Users\Omega Joctan\AppData\Roaming\Pepperstone MetaTrader 5\terminal64.exe" # Change this to your MetaTrader5 path
if not mt5.initialize(mt5_exe_file):
    print("Failed to initialize Metatrader5, error = ",mt5.last_error)
    exit()

# select a symbol into the market watch
symbol = "EURUSD"
timeframe = mt5.TIMEFRAME_D1

if not mt5.symbol_select(symbol, True):
    print(f"Failed to select {symbol}, error = {mt5.last_error}")
    mt5.shutdown()
    exit()

rates = mt5.copy_rates_from_pos(symbol, timeframe, 1, 1000) # Get 1000 bars historically
df = pd.DataFrame(rates)

print(df.head(5))
print(df.shape)
Gráfico da PACF.
from statsmodels.graphics.tsaplots import plot_pacf
import matplotlib.pyplot as plt

plt.figure(figsize=(6,4))
plot_pacf(series.diff().dropna(), lags=5)

plt.title("Partial Autocorrelation Plot")
plt.xlabel('Lag')  # X-axis label
plt.ylabel('PACF')  # Y-axis label

plt.savefig("pacf plot.png")
plt.show()
Saídas.
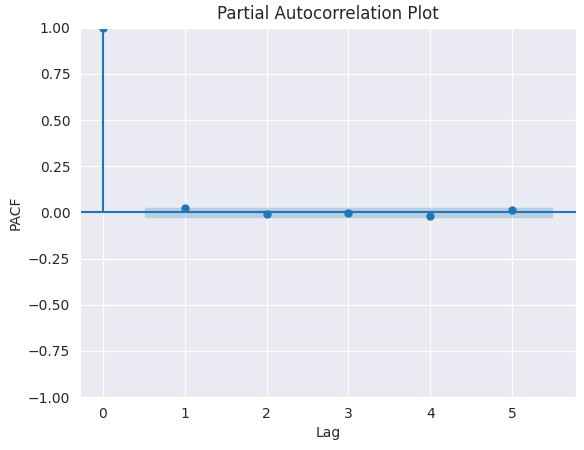
Para determinar o valor adequado de p, procuramos a defasagem a partir da qual a PACF deixa de apresentar valores significativos no gráfico (aproxima-se de zero e permanece estatisticamente insignificante). O valor dessa defasagem é o candidato adequado para p.
Com base no gráfico acima, o valor adequado de p é 0 (todas as defasagens superiores a 0 são estatisticamente insignificantes).
Determinando a ordem de diferenciação (d) em um modelo ARIMA
Como explicado anteriormente, o objetivo de diferenciar uma série temporal é torná-la estacionária, já que o modelo ARIMA pressupõe estacionariedade. No entanto, devemos tomar cuidado para não aplicar diferenciações insuficientes ou excessivas à série temporal.
A ordem adequada de diferenciação é o número mínimo de diferenciações necessárias para obter uma série aproximadamente estacionária, que oscile em torno de uma média definida e cujo gráfico da Função de Autocorrelação (ACF) se aproxime de zero relativamente rápido.
Se as autocorrelações permanecerem positivas por muitas defasagens (10 ou mais), a série precisará de diferenciações adicionais. Por outro lado, se a autocorrelação na defasagem 1 for excessivamente negativa, provavelmente a série foi diferenciada em excesso.
Se não conseguirmos decidir entre duas ordens de diferenciação, escolheremos aquela que apresentar o menor desvio padrão na série diferenciada.
Utilizando os preços de fechamento do EURUSD, vamos determinar a ordem adequada de diferenciação.
Primeiramente, precisamos verificar se a série fornecida é estacionária (neste caso, os preços de fechamento), utilizando o Teste Aumentado de Dickey-Fuller (Teste ADF), disponível no pacote statsmodels do Python. Verificamos a estacionariedade porque precisamos determinar a ordem de diferenciação apenas quando a série não é estacionária.
A hipótese nula (H₀) do teste ADF estabelece que a série temporal não é estacionária. Portanto, se o valor-p do teste for inferior ao nível de significância (0,05), rejeitamos a hipótese nula e concluímos que a série temporal é estacionária.
Assim, no nosso caso, se o valor-p for maior que 0,05, prosseguiremos com a determinação da ordem adequada de diferenciação.
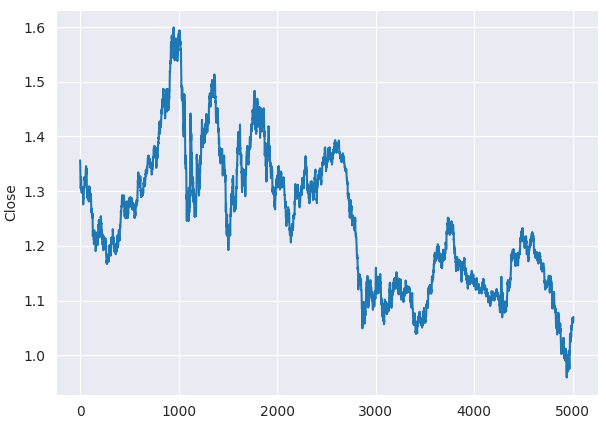
Mesmo antes de realizar o teste ADF, podemos perceber que os preços de fechamento do EURUSD não são estacionários simplesmente observando o gráfico de linhas.
plt.figure(figsize=(7,5))
sns.lineplot(df, x=df.index, y="Close")
plt.savefig("close prices.png")
Saídas.
Verificando a estacionariedade.
from statsmodels.tsa.stattools import adfuller

series = df["Close"]
result = adfuller(series)

print(f'p-value: {result[1]}')
Saídas.
p-value: 0.3707268514544181
Como podemos observar, o valor-p é muito superior ao nível de significância (0,05). Vamos diferenciar a série uma vez e depois duas vezes, observando como fica o gráfico de autocorrelação em cada caso.
# Original Series
fig, axes = plt.subplots(3, 2, sharex=True, figsize=(9, 9))

axes[0, 0].plot(series); axes[0, 0].set_title('Original Series')
plot_acf(series, ax=axes[0, 1])

# 1st Differencing
axes[1, 0].plot(series.diff().dropna()); axes[1, 0].set_title('1st Order Differencing')
plot_acf(series.diff().dropna(), ax=axes[1, 1])

# 2nd Differencing
axes[2, 0].plot(series.diff().diff()); axes[2, 0].set_title('2nd Order Differencing')
plot_acf(series.diff().diff().dropna(), ax=axes[2, 1])

plt.savefig("acf plots.png")
plt.show()
Saídas.
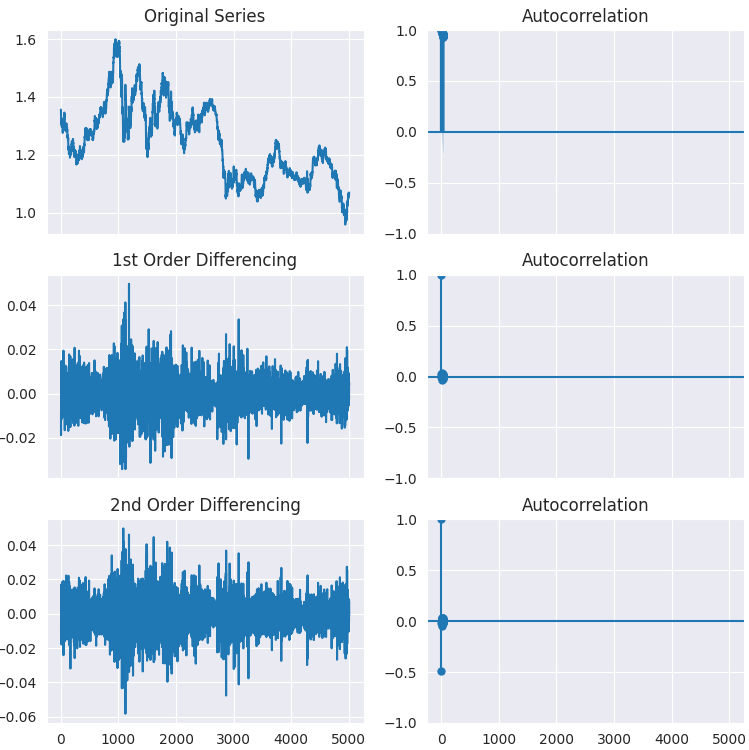
Como podemos observar nos gráficos, a diferenciação de primeira ordem é suficiente, pois a diferenciação de segunda ordem não apresenta uma melhoria significativa na estacionariedade. Isso pode ser confirmado novamente por meio do teste ADF.
result = adfuller(series.diff().dropna())
print(f'p-value d=1: {result[1]}')

result = adfuller(series.diff().diff().dropna())
print(f'p-value d=2: {result[1]}')
Saídas.
p-value d=1: 0.0
p-value d=2: 0.0
Determinando a ordem do componente MA (q)
Assim como analisamos o gráfico da PACF para determinar o número de termos AR (p), utilizaremos o gráfico da ACF para determinar o número de termos MA. Novamente, o componente MA representa, tecnicamente, o erro de uma previsão defasada.
O gráfico da ACF indica quantos termos MA são necessários para eliminar qualquer autocorrelação presente na série após torná-la estacionária.
plt.figure(figsize=(7,5))
plot_pacf(series.diff().dropna(), lags=20)

plt.title("Partial Autocorrelation Plot")
plt.xlabel('Lag')  # X-axis label
plt.ylabel('PACF')  # Y-axis label

plt.savefig("pacf plot finding q.png")
plt.show()
Saídas.
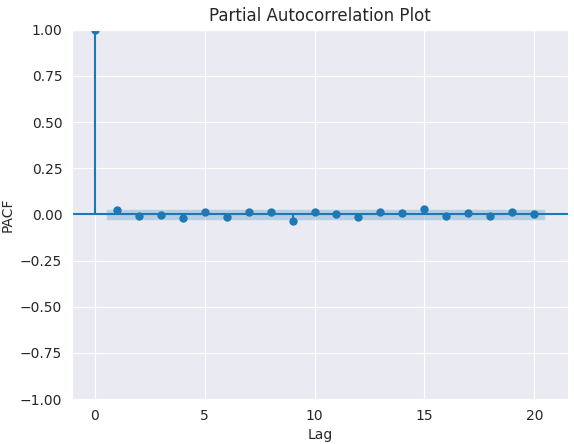
O melhor valor de q é 0.
Os métodos apresentados anteriormente para determinar os valores de p, d e q são básicos e manuais. Podemos automatizar esse processo e encontrar os parâmetros com muito menos esforço utilizando uma função auxiliar do pacote pmdarima, chamada auto_arima.
from pmdarima.arima import auto_arima

model = auto_arima(series, seasonal=False, trace=True)
print(model.summary())
Saídas.
Executando uma busca passo a passo para minimizar o AIC
 ARIMA(2,1,2)(0,0,0)[0] intercept   : AIC=-35532.282, Time=3.21 sec
 ARIMA(0,1,0)(0,0,0)[0] intercept   : AIC=-35537.068, Time=0.49 sec
 ARIMA(1,1,0)(0,0,0)[0] intercept   : AIC=-35537.492, Time=0.59 sec
 ARIMA(0,1,1)(0,0,0)[0] intercept   : AIC=-35537.511, Time=0.74 sec
 ARIMA(0,1,0)(0,0,0)[0]             : AIC=-35538.731, Time=0.25 sec
 ARIMA(1,1,1)(0,0,0)[0] intercept   : AIC=-35535.683, Time=1.22 sec

Best model:  ARIMA(0,1,0)(0,0,0)[0]
Total fit time: 6.521 seconds
E pronto! Obtivemos os mesmos parâmetros encontrados anteriormente por meio da análise manual.
Construindo um modelo ARIMA para o EURUSD
Agora que determinamos os valores de p, d e q, temos tudo o que precisamos para ajustar (treinar) o modelo ARIMA.
from statsmodels.tsa.arima.model import ARIMA

arima_model = ARIMA(series, order=(0,1,0))
arima_model = arima_model.fit()
print(arima_model.summary())
Saídas.
                               SARIMAX Results
==============================================================================
Dep. Variable:                  Close   No. Observations:                 4007
Model:                 ARIMA(0, 1, 0)   Log Likelihood               13987.647
Date:                Mon, 26 May 2025   AIC                         -27973.293
Time:                        16:59:38   BIC                         -27966.998
Sample:                             0   HQIC                        -27971.062
                               - 4007
Covariance Type:                  opg
==============================================================================
                 coef    std err          z      P>|z|      [0.025      0.975]
------------------------------------------------------------------------------
sigma2      5.427e-05   7.78e-07     69.768      0.000    5.27e-05    5.58e-05
===================================================================================
Ljung-Box (L1) (Q):                   1.47   Jarque-Bera (JB):              1370.86
Prob(Q):                              0.22   Prob(JB):                         0.00
Heteroskedasticity (H):               0.49   Skew:                             0.09
Prob(H) (two-sided):                  0.00   Kurtosis:                         5.86
===================================================================================

Warnings:
[1] Covariance matrix calculated using the outer product of gradients (complex-step).
Agora, vamos treinar esse modelo com alguns dados e usá-lo para fazer previsões em dados fora da amostra, de forma semelhante ao que fazemos com modelos clássicos de aprendizado de máquina.
Começaremos dividindo os dados em conjuntos de treinamento e teste.
series = df["Close"]

train_size = int(len(series) * 0.8)
train, test = series[:train_size], series[train_size:]
Ajustando o modelo aos dados de treinamento.
from statsmodels.tsa.arima.model import ARIMA

arima_model = ARIMA(train, order=(0,1,0))
arima_model = arima_model.fit()
print(arima_model.summary())
Realizando previsões com os dados de treinamento.
predicted = arima_model.predict(start=1, end=len(train))
Visualizando os resultados.
plt.figure(figsize=(7,4))
plt.plot(train.index, train, label='Actual')
plt.plot(train.index, predicted, label='Forecasted mean', linestyle='--')
plt.title('Actual vs Forecast')
plt.legend()
plt.show()
Saídas.
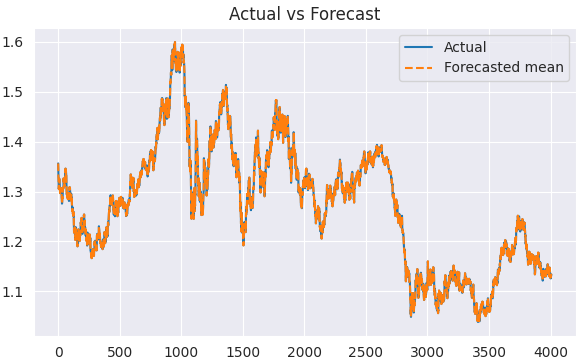
Agora que temos os valores reais e suas respectivas previsões, podemos avaliar o modelo utilizando qualquer técnica de avaliação ou função de perda de nossa preferência.
Mas, antes disso, vamos descobrir como utilizar esse modelo ARIMA para realizar previsões com dados fora da amostra.
Previsões Fora da Amostra Utilizando ARIMA
Diferentemente dos algoritmos clássicos de aprendizado de máquina, esses modelos tradicionais de previsão de séries temporais adotam uma abordagem diferente ao realizar previsões com informações que ainda não foram observadas.
Nas estruturas e bibliotecas clássicas de aprendizado de máquina em Python, um método chamado predict, quando recebe um array de dados, realiza uma previsão ou estimativa dos próximos valores (futuros). Entretanto, a função predict disponibilizada pelo módulo ARIMA desempenha uma função bastante diferente.
Nos modelos ARIMA, esse método não necessariamente prevê o futuro. Ele é especialmente útil para realizar previsões com base nos dados dentro da amostra, ou seja, nas informações que já fazem parte do modelo, correspondentes aos dados de treinamento.
Para compreender melhor essa diferença, vamos distinguir entre ‘prediction’ (estimativa de valores desconhecidos em geral)
A predição consiste em estimar valores desconhecidos (futuros ou não) utilizando qualquer modelo, enquanto a previsão de séries temporais se refere à estimativa de valores futuros a partir dos padrões e das dependências temporais presentes nos dados.
A predição pode ser aplicada a problemas como classificar a direção do mercado ou estimar os próximos preços de fechamento, enquanto a previsão de séries temporais é utilizada para estimar os próximos preços de uma ação com base nos valores atuais.
No modelo ARIMA, o método predict normalmente é utilizado para gerar previsões referentes a valores históricos com os quais o modelo já foi treinado. Por isso, ele recebe um índice inicial e um índice final. Ele também pode receber o número de etapas anteriores para as quais desejamos realizar previsões (avaliações).
predicted = arima_model.predict(start=1, end=len(train))
print(arima_model.predict(steps=10))
Para prever valores futuros, precisamos utilizar um método chamado forecast().
Como mencionado anteriormente, os modelos tradicionais de séries temporais, como o ARIMA, dependem dos valores anteriores para prever os próximos valores, conforme podemos observar em sua fórmula na Figura 03.
Isso significa que precisamos atualizar constantemente o modelo com novas informações para que ele continue relevante. Por exemplo, para que um modelo ARIMA faça uma previsão do preço de fechamento do EURUSD de amanhã, ele precisa receber o preço de fechamento de hoje desse mesmo instrumento (símbolo). O mesmo procedimento se aplica ao dia seguinte e aos demais dias.
Essa abordagem é bastante diferente daquela utilizada no aprendizado de máquina clássico.
Agora, vamos realizar previsões com dados fora da amostra.
# Fit initial model

model = ARIMA(train, order=(0, 1, 0))
results = model.fit()

# Initialize forecasts
forecasts = [results.forecast(steps=1).iloc[0]]  # First forecast

# Update with test data iteratively
for i in range(len(test)):
    # Append new observation without refitting
    results = results.append(test.iloc[i:i+1], refit=False)

    # Forecast next step
    forecasts.append(results.forecast(steps=1).iloc[0])

forecasts = forecasts[:-1] # remove the last element which is the predicted next value

# Compare forecasts vs actual test data
plt.plot(test.index, test, label="Actual")
plt.plot(test.index, forecasts, label="Forecast", linestyle="--")
plt.legend()
O método append insere novas informações (dados atuais) no modelo. Nesse caso, o preço de fechamento atual do EURUSD é utilizado para prever o próximo preço de fechamento.
O parâmetro refit=False garante que o modelo não seja treinado novamente. Isso torna o processo uma maneira eficiente de atualizar o modelo ARIMA.
Vamos criar uma função com algumas métricas de avaliação que poderemos utilizar para analisar o desempenho do modelo ARIMA.
import sklearn.metrics as metric
from statsmodels.tsa.stattools import acf
from scipy.stats import pearsonr

def forecast_accuracy(forecast, actual):
    # Convert to numpy arrays if they aren't already
    forecast = np.asarray(forecast)
    actual = np.asarray(actual)

    metrics = {
        'mape': metric.mean_absolute_percentage_error(actual, forecast),
        'me': np.mean(forecast - actual),  # Mean Error
        'mae': metric.mean_absolute_error(actual, forecast),
        'mpe': np.mean((forecast - actual) / actual),  # Mean Percentage Error
        'rmse': metric.mean_squared_error(actual, forecast, squared=False),
        'corr': pearsonr(forecast, actual)[0],  # Pearson correlation
        'minmax': 1 - np.mean(np.minimum(forecast, actual) / np.maximum(forecast, actual)),
        'acf1': acf(forecast - actual, nlags=1)[1],  # ACF of residuals at lag 1
        "r2_score": metric.r2_score(forecast, actual)
    }

    return metrics
forecast_accuracy(forecasts, test)
Saídas.
{'mape': 0.0034114761554881936,
 'me': 6.360279441117738e-05,
 'mae': 0.0037872155688622737,
 'mpe': 6.825424905960248e-05,
 'rmse': 0.005018824533752777,
 'corr': 0.99656297100796,
 'minmax': 0.0034008221524469695,
 'acf1': 0.04637470541528736,
 'r2_score': 0.9931220697334551}
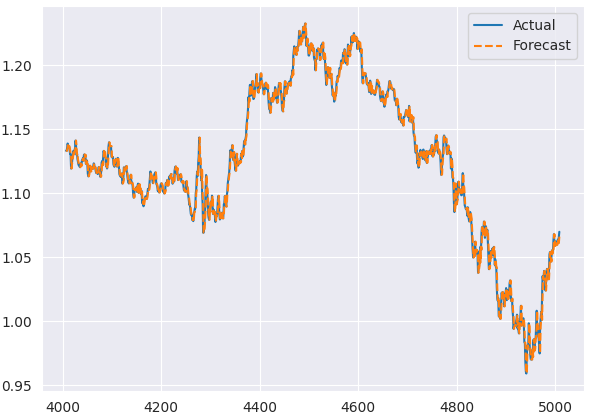
O valor de MAPE de 0,003 indica que o modelo apresenta uma precisão aproximada de 99,996%. Um valor aproximadamente equivalente também pode ser observado no r2_score.
Abaixo, apresentamos o gráfico que compara os valores reais e previstos no conjunto de teste.
Gráficos dos Resíduos do Modelo ARIMA
O ARIMA disponibiliza métodos para visualizar os resíduos, permitindo compreender melhor o comportamento do modelo.
results.plot_diagnostics(figsize=(8,8))
plt.show()
Saídas.
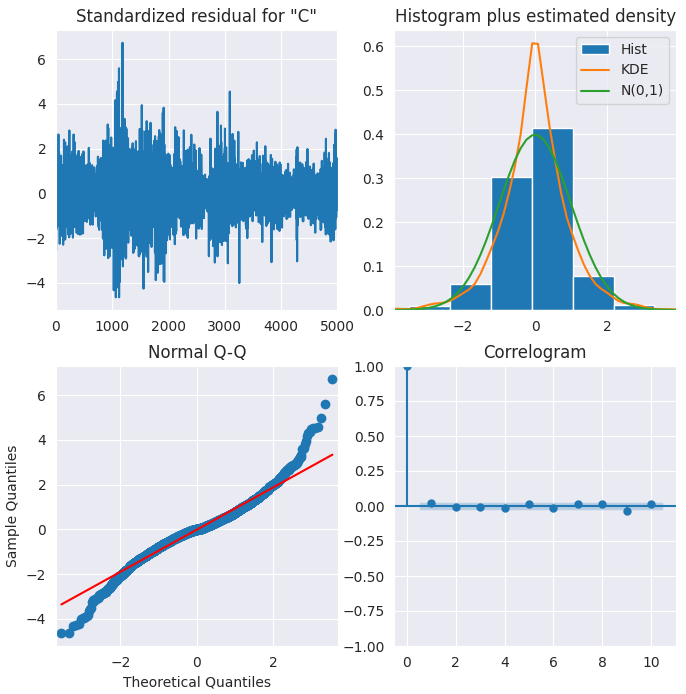
Resíduos Padronizados
Os erros residuais parecem oscilar em torno de uma média igual a zero e apresentam variância uniforme.
Histograma
O gráfico de densidade sugere uma distribuição normal, com a média ligeiramente deslocada para a direita.
Quantis Teóricos
A maioria dos pontos está perfeitamente alinhada com a linha vermelha. Desvios significativos indicariam que a distribuição apresenta assimetria.
Correlograma
O correlograma (ou gráfico da ACF) mostra que os erros residuais não apresentam autocorrelação. Caso o gráfico da ACF indicasse a presença de algum padrão nos erros residuais que não fosse explicado pelo modelo, precisaríamos procurar outras variáveis X (preditoras) para incluí-las no modelo.
De modo geral, o modelo parece apresentar um bom ajuste aos dados.
Modelo SARIMA
O modelo ARIMA convencional apresenta uma limitação. Ele não considera a sazonalidade.
A sazonalidade refere-se a padrões recorrentes nos dados financeiros que se repetem em intervalos regulares, como horários, diários, semanais, mensais, trimestrais e anuais.
Frequentemente, observamos determinados instrumentos apresentando padrões repetitivos. Por exemplo, as ações de empresas do setor varejista costumam apresentar altas no quarto trimestre (período de compras de fim de ano), enquanto algumas ações do setor de energia podem acompanhar padrões climáticos sazonais. No mercado Forex, podemos identificar um aumento da volatilidade durante determinadas sessões de negociação, entre outros exemplos.
Se os dados da série temporal apresentarem uma sazonalidade observável ou definida, devemos optar pelo modelo ARIMA Sazonal (SARIMA), pois ele utiliza a diferenciação sazonal.
Componentes do modelo SARIMAX(p, d, q)x(P, D, Q, S)
- Autorregressão (AR)
Como descrito anteriormente, a autorregressão analisa os valores históricos da série temporal para prever os valores atuais. - Médias Móveis (MA)
O componente de médias móveis continua modelando os erros de previsões anteriores. - Integração (I)
A integração está sempre presente para tornar a série temporal estacionária. - Componente Sazonal (S)
O componente sazonal identifica variações que se repetem em intervalos regulares.
A diferenciação sazonal é semelhante à diferenciação convencional. Entretanto, em vez de subtrair termos consecutivos, subtraímos o valor correspondente ao período sazonal anterior.
Antes de utilizar o modelo SARIMAX, vamos determinar os parâmetros adequados por meio de auto_arima.
from pmdarima.arima import auto_arima

# Auto-fit SARIMA (automatically detects P, D, Q, S)

auto_model = auto_arima(
    series,
    seasonal=True,          # Enable seasonality
    m=5,                    # Weeky cycle (5 days) for daily data
    trace=True,             # Show search progress
    stepwise=True,          # Faster optimization
    suppress_warnings=True,
    error_action="ignore"
)

print(auto_model.summary())
Saídas.
Executando uma busca passo a passo para minimizar o AIC
 ARIMA(2,1,2)(1,0,1)[5] intercept   : AIC=-35529.092, Time=3.81 sec
 ARIMA(0,1,0)(0,0,0)[5] intercept   : AIC=-35537.068, Time=0.29 sec
 ARIMA(1,1,0)(1,0,0)[5] intercept   : AIC=-35536.573, Time=0.97 sec
 ARIMA(0,1,1)(0,0,1)[5] intercept   : AIC=-35536.570, Time=4.38 sec
 ARIMA(0,1,0)(0,0,0)[5]             : AIC=-35538.731, Time=0.21 sec
 ARIMA(0,1,0)(1,0,0)[5] intercept   : AIC=-35536.048, Time=0.67 sec
 ARIMA(0,1,0)(0,0,1)[5] intercept   : AIC=-35536.024, Time=0.87 sec
 ARIMA(0,1,0)(1,0,1)[5] intercept   : AIC=-35534.248, Time=0.92 sec
 ARIMA(1,1,0)(0,0,0)[5] intercept   : AIC=-35537.492, Time=0.37 sec
 ARIMA(0,1,1)(0,0,0)[5] intercept   : AIC=-35537.511, Time=0.55 sec
 ARIMA(1,1,1)(0,0,0)[5] intercept   : AIC=-35535.683, Time=0.57 sec

Best model:  ARIMA(0,1,0)(0,0,0)[5]
Total fit time: 13.656 seconds
                               SARIMAX Results
==============================================================================
Dep. Variable:                      y   No. Observations:                 5009
Model:               SARIMAX(0, 1, 0)   Log Likelihood               17770.365
Date:                Tue, 27 May 2025   AIC                         -35538.731
Time:                        11:16:40   BIC                         -35532.212
Sample:                             0   HQIC                        -35536.446
                               - 5009
Covariance Type:                  opg
==============================================================================
                 coef    std err          z      P>|z|      [0.025      0.975]
------------------------------------------------------------------------------
sigma2      4.846e-05   6.06e-07     80.005      0.000    4.73e-05    4.96e-05
===================================================================================
Ljung-Box (L1) (Q):                   2.42   Jarque-Bera (JB):              2028.68
Prob(Q):                              0.12   Prob(JB):                         0.00
Heteroskedasticity (H):               0.34   Skew:                             0.08
Prob(H) (two-sided):                  0.00   Kurtosis:                         6.11
===================================================================================

Warnings:
[1] Covariance matrix calculated using the outer product of gradients (complex-step).
Embora não seja necessário ajustar o modelo manualmente mais uma vez, já que auto_arima retorna um modelo SARIMAX, realizar esse ajuste manual nos proporciona maior controle sobre os resultados. Portanto, vamos repetir o procedimento.
from statsmodels.tsa.statespace.sarimax import SARIMAX

model = SARIMAX(
    train,
    order=auto_model.order,                  # Non-seasonal (p,d,q)
    seasonal_order=auto_model.order+(5,),      # Seasonal (P,D,Q,S)
    enforce_stationarity=False
)

results = model.fit()
print(results.summary())
Saídas.
                                     SARIMAX Results
=========================================================================================
Dep. Variable:                             Close   No. Observations:                 4007
Model:             SARIMAX(0, 1, 0)x(0, 1, 0, 5)   Log Likelihood               12613.829
Date:                           Tue, 27 May 2025   AIC                         -25225.658
Time:                                   11:16:41   BIC                         -25219.364
Sample:                                        0   HQIC                        -25223.427
                                          - 4007
Covariance Type:                             opg
==============================================================================
                 coef    std err          z      P>|z|      [0.025      0.975]
------------------------------------------------------------------------------
sigma2         0.0001   1.68e-06     63.423      0.000       0.000       0.000
===================================================================================
Ljung-Box (L1) (Q):                   3.42   Jarque-Bera (JB):               676.61
Prob(Q):                              0.06   Prob(JB):                         0.00
Heteroskedasticity (H):               0.48   Skew:                            -0.01
Prob(H) (two-sided):                  0.00   Kurtosis:                         5.01
===================================================================================

Warnings:
[1] Covariance matrix calculated using the outer product of gradients (complex-step).
Como a ordem retornada por auto_model corresponde ao ARIMA(p,d,q), mesmo quando definimos o parâmetro seasonal como true. Precisamos acrescentar o valor 5 à tupla ao declarar o modelo SARIMAX, garantindo que a ordem sazonal seja especificada corretamente como (P, D, Q, S), neste caso acrescentando S=5 à tupla sazonal.
Antes de visualizar e analisar os resultados reais e previstos, precisamos remover do nosso array os primeiros elementos correspondentes ao tamanho da janela sazonal. Os valores anteriores a esse ponto estão incompletos.
predicted = results.predict(start=1, end=len(train))

clean_train = train[5:]
clean_predicted = predicted[5:]

plt.figure(figsize=(7,4))
plt.plot(clean_train.index[5:], clean_train[5:], label='Actual')
plt.plot(clean_train.index[5:], clean_predicted[5:], label='Forecasted mean', linestyle='--')
plt.title('Actual vs Forecast')
plt.legend()
plt.savefig("sarimax train actual&forecast plot.png")
plt.show()
Saídas.
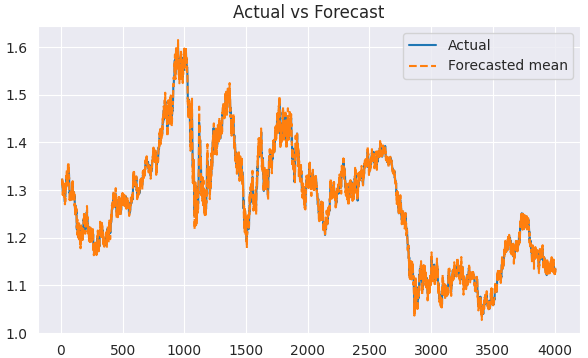
Podemos avaliar esse modelo da mesma maneira que avaliamos o modelo ARIMA.
# Initialize forecasts
forecasts = [results.forecast(steps=1).iloc[0]]  # First forecast

# Update with test data iteratively
for i in range(len(test)):
    # Append new observation without refitting
    results = results.append(test.iloc[i:i+1], refit=False)

    # Forecast next step
    forecasts.append(results.forecast(steps=1).iloc[0])

clean_test = test[5:]
forecasts = forecasts[5:-1] # remove the last element which is the predicted next value and the first 5 items
forecast_accuracy(forecasts, clean_test)
Saídas.
{'mape': 0.004900183060803821,
 'me': -6.94082142749275e-06,
 'mae': 0.005432456867698095,
 'mpe': -7.226495372320155e-06,
 'rmse': 0.007127465498996785,
 'corr': 0.9931778828074744,
 'minmax': 0.004880027322298863,
 'acf1': 0.10724254539104018,
 'r2_score': 0.9864021833085908}
Uma precisão de 98,6%, de acordo com o r2_score. Um resultado satisfatório.
Por fim, podemos utilizar o modelo ARIMA para realizar previsões em tempo real com base nos dados recebidos do MetaTrader 5.
Primeiramente, precisamos importar a biblioteca schedule para nos ajudar a executar as previsões após o intervalo de um dia, já que treinamos esse modelo utilizando o período gráfico diário.
import schedule # Make realtime predictions based on the recent data from MetaTrader5 def predict_close(): rates = mt5.copy_rates_from_pos(symbol, timeframe, 0, 1) if not rates: print(f"Failed to get recent OHLC values, error = {mt5.last_error}") time.sleep(60) rates_df = pd.DataFrame(rates) global results # Get the variable globally, outside the function global forecasts # Append new observation to the model without refitting new_obs_value = rates_df["close"].iloc[-1] new_obs_index = results.data.endog.shape[0] # continue integer index new_obs = pd.Series([new_obs_value], index=[new_obs_index]) # Its very important to continue making predictions where we ended on the training data results = results.append(new_obs, refit=False) # Forecast next step forecasts.append(results.forecast(steps=1).iloc[0]) print(f"Current Close Price: {new_obs_value} Forecasted next day Close Price: {forecasts[-1]}")
Agendando a execução das previsões.
schedule.every(1).days.do(predict_close) # call the predict function after a given time

while True:

    schedule.run_pending()
    time.sleep(60)

mt5.shutdown()
Saídas.
Current Close Price: 1.1374900000000001 Forecasted next day Close Price: 1.1337899981049262
Current Close Price: 1.1372200000000001 Forecasted next day Close Price: 1.1447100065656721
Com esses preços de fechamento previstos, você pode expandir essa abordagem para desenvolver uma estratégia de negociação e executar operações utilizando a integração MetaTrader5-Python.
Considerações Finais
Tanto o ARIMA quanto o SARIMA são modelos tradicionais sólidos de séries temporais, utilizados em diversas áreas e setores. No entanto, é fundamental compreender suas limitações e desvantagens, incluindo:
- Pressupõem estacionariedade (após a diferenciação)
Nem sempre trabalhamos com dados estacionários e, muitas vezes, queremos utilizar os dados em sua forma original. A diferenciação pode distorcer a estrutura natural e as tendências que esperamos identificar. - Pressuposto de linearidade
O ARIMA é essencialmente um modelo linear. Ele pressupõe que os valores futuros dependem linearmente dos valores defasados e dos erros anteriores. Esse pressuposto nem sempre corresponde ao comportamento dos mercados financeiros e do Forex, nos quais padrões complexos são frequentemente observados. Isso significa que esses modelos podem apresentar um desempenho insatisfatório em determinadas situações. - Modelos univariados
Ambos os modelos consideram apenas um recurso por vez. Sabemos que os mercados financeiros são complexos e que precisamos de múltiplos recursos e perspectivas para analisá-los. Esses modelos analisam o mercado sob uma única perspectiva (unidimensional), fazendo com que deixemos de considerar outros recursos que poderiam ser úteis.
Embora seja possível adicionar variáveis exógenas ao modelo SARIMAX, isso muitas vezes não é suficiente.
Apesar de suas limitações, quando utilizados com os parâmetros, o tipo de problema e as informações adequados, esses modelos podem apresentar resultados surpreendentes. Um modelo ARIMA simples pode superar modelos complexos, como as redes neurais recorrentes (RNNs), na previsão de séries temporais.
Atenciosamente.
Fontes e Referências
- https://www.geeksforgeeks.org/python-arima-model-for-time-series-forecasting/
- https://www.machinelearningplus.com/time-series/arima-model-time-series-forecasting-python/
- https://datascientest.com/pt/sarimax-model-what-is-it-how-can-it-be-applied-to-time-series
- https://www.kaggle.com/code/prashant111/arima-model-for-time-series-forecasting
Tabela de Anexos
| Nome do arquivo | Descrição e Utilização |
|---|---|
| forex_ts_forecasting_using_arima.py | Script Python que contém todos os exemplos apresentados, desenvolvidos na linguagem Python. |
| requirements.txt | Arquivo de texto que contém as dependências do Python e seus respectivos números de versão. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18247
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Caminhe em novos trilhos: Personalize indicadores no MQL5
 Machine Learning e Data Science (Parte 45): Previsão de séries temporais no Forex com o modelo PROPHET do Facebook
 Está chegando o novo MetaTrader 5 e MQL5
 Desenvolvimento de ferramentas para análise de Price Action (Parte 29): EA "Boom and Crash Interceptor"

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Conteúdo incrível.
Exatamente o que eu estava procurando.
Provavelmente não vou usar isso nas negociações, mas é muito interessante.
Ouvi falar pela primeira vez sobre o ARIMA no livro “Trading Systems & Methods”, de Perry J. Kaufman.
Alguém já teve sucesso operando com o ARIMA?