
Repensando as estratégias clássicas (Parte 14): Análise de múltiplas estratégias
 30
 0

Em uma série paralela de artigos sobre EAs que se auto-otimizam, decidimos criar um ensemble de várias estratégias e combiná-las em uma única estratégia mais eficaz.
Naquela série, definimos que as estratégias atuariam em conjunto, seguindo uma espécie de democracia em que cada estratégia teria direito a um voto. O peso de cada voto passou a ser um parâmetro ajustável que, conforme discutimos anteriormente, era ajustado pelo otimizador genético para maximizar a rentabilidade da estratégia de trading. Em seguida, eliminamos a estratégia à qual o otimizador genético atribuiu o menor peso, mantendo duas estratégias que agora serão analisadas e servirão de base para a construção dos modelos estatísticos.
Também coletamos dados de mercado por meio de um script MQL5, utilizando os resultados obtidos pelo otimizador genético como referência. Vale lembrar que selecionamos os resultados que apresentaram desempenho consistente tanto nos testes históricos quanto no teste forward, adotando essa consistência como principal critério de seleção.
No entanto, uma análise mais detalhada dos retornos das duas estratégias selecionadas pelo otimizador genético revelou uma forte correlação entre elas. Ambas registravam ganhos e perdas praticamente nos mesmos períodos. Na prática, utilizar duas estratégias altamente correlacionadas não é melhor do que utilizar apenas uma, o que esvazia completamente o propósito de uma abordagem multiestratégia.
Há muitos fatores que podem comprometer os resultados quando utilizamos inteligência artificial para desenvolver estratégias de trading. Ao que tudo indica, o otimizador genético tirou proveito da estrutura que oferecemos e selecionou estratégias com o maior grau possível de correlação. Do ponto de vista estritamente matemático, essa escolha pode ser considerada racional: para o otimizador genético, é mais fácil prever o saldo total da conta quando as estratégias predominantes são correlacionadas.
Inicialmente, eu esperava que o otimizador genético atribuísse pesos maiores às estratégias mais rentáveis e pesos menores às menos rentáveis. No entanto, como tínhamos apenas três estratégias disponíveis e realizamos a otimização uma única vez, não podemos descartar a possibilidade de que esse resultado tenha ocorrido por acaso. Em outras palavras, se repetíssemos a otimização dos pesos dos votos utilizando um algoritmo de otimização mais lento, porém mais exaustivo, talvez a seleção fosse diferente.
Por isso, decidi rever a abordagem para selecionar as configurações ideais das estratégias. Ao que parece, na etapa inicial, devemos fixar em 1 o peso de todos os votos. Dessa forma, obrigaremos o otimizador genético a se concentrar exclusivamente na busca por configurações dos indicadores utilizados que proporcionem resultados lucrativos. Como veremos adiante, essa abordagem se mostra mais eficaz do que o plano inicial. Não há avanços na análise multiestratégia quando utilizamos estratégias correlacionadas. Por isso, vamos reformular o problema de maneira mais adequada: como selecionar, da melhor forma possível, várias estratégias com retornos não correlacionados e maximizar a rentabilidade da conta.
Primeiros passos no MQL5
Primeiro, vamos escrever um script para coletar dados históricos de mercado, utilizando as configurações que proporcionaram a maior rentabilidade no teste anterior (no qual selecionamos as duas estratégias atuais). O sistema utilizará alguns parâmetros fixos obtidos durante a otimização genética. Esses parâmetros da nossa estratégia "ideal" permanecerão inalterados durante a extração dos dados.
//+------------------------------------------------------------------+
//|                                                      ProjectName |
//|                                      Copyright 2020, CompanyName |
//|                                       http://www.companyname.net |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- Define our moving average indicator
#define MA_PERIOD  100               //--- Period for our moving average
#define MA_TYPE    MODE_EMA          //--- Type of moving average we have
#define RSI_PERIOD 24                //--- Period For Our RSI Indicator
#define RSI_PRICE  PRICE_CLOSE       //--- Applied Price For our RSI Indicator
#define HORIZON    38                //--- Holding period
#define TF PERIOD_H3                 //--- Time Frame
O sistema dependerá de um conjunto de variáveis globais para acompanhar os valores dos indicadores técnicos por meio dos respectivos handles e buffers, que serão acessados durante a execução do script. Também definiremos variáveis adicionais para o nome do arquivo de saída e a quantidade de dados solicitada.
//--- Our handlers for our indicators
int ma_handle,ma_o_handle,rsi_handle;

//--- Data structures to store the readings from our indicators
double ma_reading[],ma_o_reading[],rsi_reading[];

//--- File name
string file_name = Symbol() + " Market Data As Series Multiple Strategy Analysis.csv";

//--- Amount of data requested
input int size = 3000;
No corpo do script, implementaremos as principais rotinas. Inicializaremos os indicadores e configuraremos a indexação dos dados dos indicadores no modo de série temporal para preservar a sequência cronológica dos dados. Esse modo será utilizado para estruturar e transferir os dados. Em seguida, registraremos todos os dados de mercado e realizaremos alguns cálculos aritméticos para acompanhar suas variações históricas. Para isso, utilizaremos o parâmetro de horizonte ajustado anteriormente pelo otimizador genético.
//+------------------------------------------------------------------+
//| Our script execution                                             |
//+------------------------------------------------------------------+
void OnStart()
  {
  int fetch = size + (HORIZON * 2);
//---Setup our technical indicators
   ma_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE);
   ma_o_handle = iMA(_Symbol,TF,MA_PERIOD,0,MA_TYPE,PRICE_OPEN);
   rsi_handle = iRSI(_Symbol,TF,RSI_PERIOD,RSI_PRICE);

//---Set the values as series
   CopyBuffer(ma_handle,0,0,fetch,ma_reading);
   ArraySetAsSeries(ma_reading,true);
   CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading);
   ArraySetAsSeries(ma_o_reading,true);
   CopyBuffer(rsi_handle,0,0,fetch,rsi_reading);
   ArraySetAsSeries(rsi_reading,true);

//---Write to file
   int file_handle=FileOpen(file_name,FILE_WRITE|FILE_ANSI|FILE_CSV,",");

   for(int i=size;i>=1;i--)
     {
      if(i == size)
        {
         FileWrite(file_handle,"Time","True Open","True High","True Low","True Close","True MA C","True MA O","True RSI","Open","High","Low","Close","MA Close","MA Open","RSI");
        }

      else
        {
         FileWrite(file_handle,
                   iTime(_Symbol,TF,i),
                   iOpen(_Symbol,TF,i),
                   iHigh(_Symbol,TF,i),
                   iLow(_Symbol,TF,i),
                   iClose(_Symbol,TF,i),
                   ma_reading[i],
                   ma_o_reading[i],
                   rsi_reading[i],
                   iOpen(_Symbol,TF,i)   - iOpen(_Symbol,TF,(i + HORIZON)),
                   iHigh(_Symbol,TF,i)   - iHigh(_Symbol,TF,(i + HORIZON)),
                   iLow(_Symbol,TF,i)    - iLow(_Symbol,TF,(i + HORIZON)),
                   iClose(_Symbol,TF,i)  - iClose(_Symbol,TF,(i + HORIZON)),
                   ma_reading[i] - ma_reading[(i + HORIZON)],
                   ma_o_reading[i] - ma_o_reading[(i + HORIZON)],
                   rsi_reading[i] - rsi_reading[(i + HORIZON)]
                   );
        }
     }
//--- Close the file
   FileClose(file_handle);
  }
//+------------------------------------------------------------------+
Análise dos dados em Python
Vamos analisar os dados de mercado coletados utilizando as bibliotecas numéricas do Python. Primeiro, importaremos a biblioteca pandas para ler os dados.
#Load our libraries
import pandas as pd
Em seguida, rotularemos as ações que a estratégia utilizada no treinamento teria executado diante de determinadas condições de mercado e calcularemos o lucro ou prejuízo que cada ação teria gerado.
#Read in the data
data = pd.read_csv("EURUSD Market Data As Series Multiple Strategy Analysis.csv")

#The optimal holding period suggested by our MT5 Genetic optimizer
HORIZON = 38

#Calculate the true market return
data['Return'] = data['True Close'].shift(-HORIZON) - data['True Close']

#The action suggested by our first strategy, MA Cross
data['Action 1'] = 0

#The action suggested by our second strategy, RSI Strategy
data['Action 2'] = 0

#Buy conditions
data.loc[data['True MA C'] > data['True MA O'],'Action 1'] = 1
data.loc[data['True RSI'] > 50,'Action 2'] = 1

#Sell conditions
data.loc[data['True MA C'] < data['True MA O'],'Action 1'] = -1
data.loc[data['True RSI'] < 50,'Action 2'] = -1

#Perform a linear transformation of the true market return, using our trading stragies
data['Return 1'] = data['Return'] * data['Action 1']
data['Return 2'] = data['Return'] * data['Action 2']

data = data.iloc[:-HORIZON,:]
Essa é uma etapa fundamental de qualquer modelagem estatística ou sistema de trading. É essencial verificar se o modelo não está sobreajustado aos dados. Caso contrário, qualquer análise ou teste perde o sentido, pois o modelo deixa de ser válido.
#Drop our back test data
_    = data.iloc[-((365 * 2 * 6)):,:]
data = data.iloc[:-((365 * 2 * 6)),:]
A rotulagem das variáveis-alvo é uma etapa indispensável do aprendizado supervisionado. Para facilitar a visualização, vamos definir os rótulos de modo a indicar se a estratégia 1 apresentou retorno superior ao da estratégia 2 ou vice-versa. A variável-alvo indicará se a estratégia 2 gerou um retorno maior do que a estratégia 1. Também compararemos essa abordagem com a capacidade do modelo de prever diretamente o retorno futuro do mercado. Worked for 1m Translated metrics Translated ONNX terminology
#Gether inputs
X = data.iloc[:,1:15]

#Both Strategies will earn equal reward
data['Target 1'] = 0
data['Target 2'] = 0

#Strategy 1 is more profitable
data.loc[data['Return 1'] > data['Return 2'],'Target 1'] = 1

#Strategy 2 is more profitable
data.loc[data['Return 2'] > data['Return 1'],'Target 2'] = 1

#Classical Target
data['Classical Target'] = 0

data.loc[data['Return'] > 0,'Classical Target'] = 1
Em seguida, importaremos as bibliotecas do scikit-learn para analisar as propriedades numéricas dos dados coletados.
#Loading our scikit learn libraries
from sklearn.model_selection import TimeSeriesSplit,cross_val_score
from sklearn.linear_model import LinearRegression,LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.neural_network import MLPRegressor
from sklearn.model_selection import RandomizedSearchCV
Criaremos objetos para a validação de séries temporais. Para isso, utilizaremos cinco partições de treinamento e validação, correspondentes ao horizonte ideal identificado pelo otimizador genético. Depois, calcularemos as médias e os desvios-padrão de cada coluna para padronizar o conjunto de dados, deixando cada variável com média zero e desvio-padrão igual a um.
#Prepare the data for time series modelling
tscv = TimeSeriesSplit(n_splits=5,gap=HORIZON)

Z1 = X.mean()
Z2 = X.std()

X = ((X-X.mean()) / X.std())
Agora, vamos medir a acurácia das previsões das novas variáveis-alvo e compará-la com a acurácia da previsão da variável-alvo tradicional. Utilizaremos os objetos de validação cruzada do scikit-learn para avaliar a acurácia de um classificador linear. Em seguida, armazenaremos os resultados em um array e construiremos um gráfico. Como podemos observar, a acurácia da previsão da variável-alvo tradicional fica próxima de 50%, enquanto a acurácia da previsão de qual das duas estratégias será mais rentável chega a cerca de 90%, superando significativamente a abordagem tradicional.
#Measuring our accuracy on our new target
res = []

model = LinearDiscriminantAnalysis()

res.append(np.mean(np.abs(cross_val_score(model,X,data['Classical Target'],cv=tscv,scoring='accuracy'))))

model = LinearDiscriminantAnalysis()

res.append(np.mean(np.abs(cross_val_score(model,X,data['Target 1'],cv=tscv,scoring='accuracy'))))

model = LinearDiscriminantAnalysis()

res.append(np.mean(np.abs(cross_val_score(model,X,data['Target 2'],cv=tscv,scoring='accuracy',n_jobs=-1))))

sns.barplot(res,color='black')
plt.xticks([0,1,2],['Classical Target','MA Cross Over Target','RSI Target'])
plt.axhline(res[0],linestyle=':',color='red')
plt.ylabel('5-Fold Percentage Accuracy %')
plt.title('Outperforming The Classical Target of Direct Price Prediction')
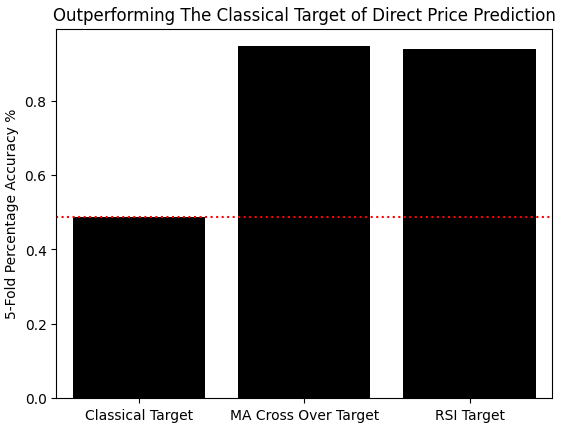
Figura 1: Melhoria em relação à tarefa clássica de previsão direta de preços por meio da modelagem da relação entre a estratégia e o mercado
Em seguida, utilizaremos o recurso de busca aleatória do scikit-learn para construir uma rede neural com base no nosso conjunto de dados de mercado. Primeiro, inicializaremos a rede neural com os parâmetros padrão, mantendo fixos os parâmetros shuffle e early_stopping.
#Use random search to build a neural network for our market data

#Initialize the model
model = MLPRegressor(shuffle=False,early_stopping=False)


distributions = {'solver':['lbfgs','adam','sgd'],
                 'hidden_layer_sizes':[(X.shape[1],2,10,20),(X.shape[1],30,50,10),(X.shape[1],14,14,14),(X.shape[1],5,20,2),(X.shape[1],1,2,3,4,5,6,10),(X.shape[1],1,14,14,1)],
                 'activation':['relu','identity','logistic','tanh']
                 }

rscv = RandomizedSearchCV(model,distributions,n_jobs=-1,n_iter=50)

rscv.fit(X,data.loc[:,['Target 1','Target 2']])
Exportaremos a rede neural treinada para o formato ONNX. Para começar, importaremos a biblioteca ONNX e os conversores necessários. ONNX (Open Neural Network Exchange) é um protocolo de código aberto que permite criar e exportar modelos de aprendizado de máquina em um formato independente de implementações específicas.
#Exporting our model to ONNX
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType

initial_types = [('float_input',FloatTensorType([1,X.shape[1]]))]
final_types = [('float_output',FloatTensorType([2,1]))]

model = rscv.best_estimator_

model.fit(X,data.loc[:,['Target 1','Target 2']])

onnx_proto = convert_sklearn(model=model,initial_types=initial_types,final_types=final_types,target_opset=12)

onnx.save(onnx_proto,'EURUSD NN MSA.onnx')
Para visualizar o grafo ONNX da nossa rede neural, primeiro importaremos a biblioteca Netron e, em seguida, chamaremos a função netron.start, passando o caminho do modelo ONNX.
#Viewing our ONNX graph in netron
import netron
netron.start('../EURUSD NN MSA.onnx')
A Figura 2 apresenta os metadados do nosso modelo ONNX. Como podemos observar, o modelo possui 14 parâmetros de entrada e 2 parâmetros de saída do tipo float. Além disso, contém outras informações importantes, como a origem do modelo e a versão do ONNX.
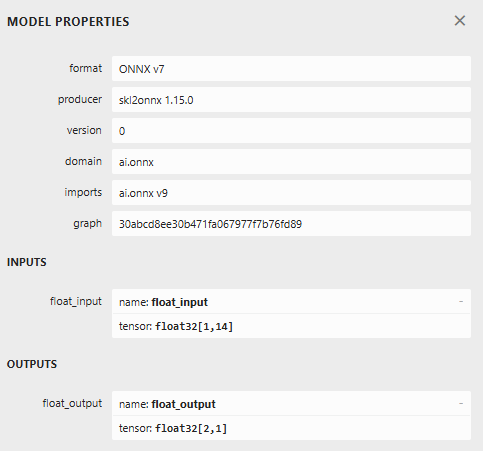
Figura 2: Visualização dos metadados do modelo ONNX para verificar se as dimensões dos dados de entrada e saída estão corretas
O formato ONNX representa modelos de aprendizado de máquina por meio de grafos compostos por nós computacionais e arestas que indicam o fluxo de informações entre esses nós. Dessa forma, qualquer modelo de aprendizado de máquina pode ser convertido para um formato universal, representado pelo grafo ONNX mostrado na Figura 3. Esse grafo corresponde à rede neural construída com o recurso de busca aleatória da biblioteca sklearn.

Figura 3: Visualização do grafo computacional que representa uma rede neural profunda, utilizando a biblioteca Netron
Desenvolvimento do EA em MQL5
Primeiro, carregaremos no EA o modelo ONNX criado na etapa anterior.
//+------------------------------------------------------------------+
//|                                                   MSA Test 1.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| ONNX Model                                                       |
//+------------------------------------------------------------------+
#resource "\\Files\\EURUSD NN MSA.onnx" as uchar onnx_buffer[];
Armazenaremos nos arrays correspondentes, Z1 e Z2, as médias e os desvios-padrão calculados em Python para cada atributo. Vale lembrar que esses valores serão utilizados para escalonar e padronizar os dados de entrada antes de gerar previsões com nosso modelo ONNX.
//+------------------------------------------------------------------+
//| ONNX Parameters                                                  |
//+------------------------------------------------------------------+
double Z1[] = { 1.18932220e+00,  1.19077958e+00,  1.18786462e+00,  1.18931542e+00,
                1.18994040e+00,  1.18994674e+00,  4.94395259e+01, -4.99204879e-04,
                -5.00701302e-04, -4.97575935e-04, -4.98995739e-04, -4.70848300e-04,
                -4.70289373e-04, -1.84697724e-02
                };

double Z2[] = {1.09599015e-01, 1.09698934e-01, 1.09479324e-01, 1.09593123e-01,
               1.09413744e-01, 1.09419007e-01, 1.00452009e+01, 1.31269558e-02,
               1.31336302e-02, 1.31513465e-02, 1.31174740e-02, 6.88794916e-03,
               6.89036979e-03, 1.28550006e+01
              };
Definiremos e manteremos as constantes do sistema durante toda a execução do programa. Essas constantes também foram selecionadas com o auxílio do otimizador genético no artigo anterior.
//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define MA_SHIFT         0
#define MA_TYPE          MODE_EMA
#define RSI_PRICE        PRICE_CLOSE
#define ONNX_INPUTS      14
#define ONNX_OUTPUTS     2
#define HORIZON 38
Os principais parâmetros da estratégia (o período da média móvel e o período do RSI) também foram selecionados pelo otimizador genético e permanecerão inalterados durante a execução do programa.
//+------------------------------------------------------------------+
//| Strategy Parameters                                              |
//+------------------------------------------------------------------+
int             MA_PERIOD                       =        100;  //Moving Average Period
int             RSI_PERIOD                      =         24;  //RSI Period
ENUM_TIMEFRAMES STRATEGY_TIME_FRAME             =  PERIOD_H3;  //Strategy Timeframe
int             HOLDING_PERIOD                  =         38;  //Position Maturity Period
Para que nosso aplicativo funcione plenamente, precisamos de um número considerável de dependências. Imagino que vocês já conheçam a biblioteca de trading. No entanto, também existem outras dependências, como as estratégias que desenvolvemos na série paralela de artigos. Quem acompanhou essa série já deve conhecê-las. Caso contrário, recomendo consultar os artigos anteriores, pois essas estratégias são indispensáveis para o funcionamento correto do nosso aplicativo de trading.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
#include <VolatilityDoctor\Strategies\OpenCloseMACrossover.mqh>
#include <VolatilityDoctor\Strategies\RSIMidPoint.mqh>
O programa também terá variáveis globais, embora em quantidade relativamente pequena. Precisaremos, por exemplo, de variáveis globais para as classes personalizadas que criamos, como as classes de negociação e controle de tempo, além da estratégia baseada no RSI e da estratégia de cruzamento de médias móveis. Também serão necessárias variáveis para obter os dados do modelo ONNX e armazenar suas previsões.
//+------------------------------------------------------------------+
//| Global Variables                                                 |
//+------------------------------------------------------------------+
//--- Custom Types
CTrade               Trade;
Time                 *TradeTime;
TradeInfo            *TradeInformation;
RSIMidPoint          *RSIMid;
OpenCloseMACrossover *MACross;
long                 onnx_model;
vectorf onnx_output;

//--- Our handlers for our indicators
int ma_handle,ma_o_handle,rsi_handle;

//--- Data structures to store the readings from our indicators
double ma_reading[],ma_o_reading[],rsi_reading[];

//--- System Types
int                  position_timer;
Na inicialização do aplicativo, criaremos os objetos dinâmicos necessários. Temos, por exemplo, uma classe responsável por acompanhar o tempo e as informações de negociação. Criaremos instâncias dessa classe, além dos respectivos handles dos indicadores. Em seguida, criaremos o modelo ONNX a partir do buffer carregado e verificaremos se o carregamento foi realizado corretamente.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- Create dynamic instances of our custom types
   TradeTime        = new Time(Symbol(),STRATEGY_TIME_FRAME);
   TradeInformation = new TradeInfo(Symbol(),STRATEGY_TIME_FRAME);
   MACross          = new OpenCloseMACrossover(Symbol(),STRATEGY_TIME_FRAME,MA_PERIOD,MA_SHIFT,MA_TYPE);
   RSIMid           = new RSIMidPoint(Symbol(),STRATEGY_TIME_FRAME,RSI_PERIOD,RSI_PRICE);
   onnx_model       = OnnxCreateFromBuffer(onnx_buffer,ONNX_DEFAULT);
   onnx_output      = vectorf::Zeros(ONNX_OUTPUTS);

//---Setup our technical indicators
   ma_handle        = iMA(_Symbol,STRATEGY_TIME_FRAME,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE);
   ma_o_handle      = iMA(_Symbol,STRATEGY_TIME_FRAME,MA_PERIOD,0,MA_TYPE,PRICE_OPEN);
   rsi_handle       = iRSI(_Symbol,STRATEGY_TIME_FRAME,RSI_PERIOD,RSI_PRICE);
   if(onnx_model != INVALID_HANDLE)
     {
      Print("Preparing ONNX model");

      ulong input_shape[] = {1,ONNX_INPUTS};

      if(!OnnxSetInputShape(onnx_model,0,input_shape))
        {
         Print("Failed To Specify ONNX model input shape");
         return(INIT_FAILED);
        }

      ulong output_shape[] = {ONNX_OUTPUTS,1};

      if(!OnnxSetOutputShape(onnx_model,0,output_shape))
        {
         Print("Failed To Specify ONNX model output shape");
         return(INIT_FAILED);
        }
     }

//--- Everything was fine
   Print("Successfully loaded all components for our Expert Advisor");
   return(INIT_SUCCEEDED);
  }
//--- End of OnInit Scope
Quando o aplicativo deixar de ser utilizado, precisaremos liberar a memória, excluindo os objetos que não são mais necessários, para encerrar sua execução com segurança.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//--- Delete the dynamic objects
   delete TradeTime;
   delete TradeInformation;
   delete MACross;
   delete RSIMid;
   OnnxRelease(onnx_model);
   IndicatorRelease(ma_handle);
   IndicatorRelease(ma_o_handle);
   IndicatorRelease(rsi_handle);
  }
//--- End of Deinit Scope
Sempre que novos dados de preços chegarem às funções OnTick e OnExpertStart, verificaremos primeiro se uma nova vela diária foi formada. Para isso, chamaremos a função new_candle da classe ChangeTime. Se uma nova vela tiver sido formada, atualizaremos os parâmetros da estratégia e verificaremos se há sinais de negociação. Caso haja sinais, abriremos posições. Caso contrário, aguardaremos até que se esgote o prazo de permanência definido para a posição e então a fecharemos.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- Check if a new daily candle has formed
   if(TradeTime.NewCandle())
     {
      //--- Update strategy
      Update();

      //--- If we have no open positions
      if(PositionsTotal() == 0)
        {
         //--- Reset the position timer
         position_timer = 0;

         //--- Check for a trading signal
         CheckSignal();
        }

      //--- Otherwise
      else
        {
         //--- The position has reached maturity
         if(position_timer == HOLDING_PERIOD)
            Trade.PositionClose(Symbol());
         //--- Otherwise keep holding
         else
            position_timer++;
        }
     }
  }
//--- End of OnTick Scope
O método update recebe como parâmetro o horizonte de previsão selecionado pelo otimizador genético. Em seguida, atualiza as estratégias utilizadas e os valores dos indicadores técnicos armazenados nos buffers.
//+------------------------------------------------------------------+
//| Update our technical indicators                                  |
//+------------------------------------------------------------------+
void Update(void)
  {
   int fetch = (HORIZON * 2);

//--- Update the strategy
   RSIMid.Update();
   MACross.Update();

//---Set the values as series
   CopyBuffer(ma_handle,0,0,fetch,ma_reading);
   ArraySetAsSeries(ma_reading,true);
   CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading);
   ArraySetAsSeries(ma_o_reading,true);
   CopyBuffer(rsi_handle,0,0,fetch,rsi_reading);
   ArraySetAsSeries(rsi_reading,true);
  }
//--- End of Update Scope
Para obter previsões do nosso modelo ONNX, utilizaremos a função OnnxRun. Antes de chamá-la, porém, precisamos atualizar as variáveis de entrada que serão passadas ao modelo e, em seguida, escaloná-las e padronizá-las, subtraindo a média e dividindo pelo desvio-padrão.
//+------------------------------------------------------------------+
//| Get A Prediction from our ONNX model                             |
//+------------------------------------------------------------------+
void OnnxPredict(void)
  {
   vectorf   input_variables =
     {
      iOpen(_Symbol,STRATEGY_TIME_FRAME,0),
      iHigh(_Symbol,STRATEGY_TIME_FRAME,0),
      iLow(_Symbol,STRATEGY_TIME_FRAME,0),
      iClose(_Symbol,STRATEGY_TIME_FRAME,0),
      ma_reading[0],
      ma_o_reading[0],
      rsi_reading[0],
      iOpen(_Symbol,STRATEGY_TIME_FRAME,0)   - iOpen(_Symbol,STRATEGY_TIME_FRAME,(0 + HORIZON)),
      iHigh(_Symbol,STRATEGY_TIME_FRAME,0)   - iHigh(_Symbol,STRATEGY_TIME_FRAME,(0 + HORIZON)),
      iLow(_Symbol,STRATEGY_TIME_FRAME,0)    - iLow(_Symbol,STRATEGY_TIME_FRAME,(0 + HORIZON)),
      iClose(_Symbol,STRATEGY_TIME_FRAME,0)  - iClose(_Symbol,STRATEGY_TIME_FRAME,(0 + HORIZON)),
      ma_reading[0] - ma_reading[(0 + HORIZON)],
      ma_o_reading[0] - ma_o_reading[(0 + HORIZON)],
      rsi_reading[0] - rsi_reading[(0 + HORIZON)]
     };

   for(int i = 0; i < ONNX_INPUTS;i++)
     {
      input_variables[i] = ((input_variables[i] - Z1[i])/ Z2[i]);
     }

   OnnxRun(onnx_model,ONNX_DEFAULT,input_variables,onnx_output);
  }
Para verificar os sinais de negociação com a estratégia de cruzamento de médias móveis, primeiro obtemos uma previsão do modelo ONNX sobre qual das estratégias será mais rentável em termos relativos. Depois, verificamos se a estratégia selecionada gera um sinal de entrada válido; somente nesse caso abrimos uma operação.
//+------------------------------------------------------------------+
//| Check for a trading signal using our cross-over strategy         |
//+------------------------------------------------------------------+
void CheckSignal(void)
  {

   OnnxPredict();

//--- MA Strategy is profitable
   if((onnx_output[0] > 0.5) && (onnx_output[1] < 0.5))
     {
      //--- Long positions when the close moving average is above the open
      if(MACross.BuySignal())
        {
         Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),0,0,"");
         return;
        }

      //--- Otherwise short
      else
         if(MACross.SellSignal())
           {
            Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),0,0,"");
            return;
           }
     }

//--- RSI strategy is profitable
   else
      if((onnx_output[0] < 0.5) && (onnx_output[1] > 0.5))
        {

         if(RSIMid.BuySignal())
           {
            Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),0,0,"");
            return;
           }

         //--- Otherwise short
         else
            if(MACross.SellSignal())
              {
               Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),0,0,"");
               return;
              }
        }
  }
//--- End of CheckSignal Scope
Por fim, removemos as definições de todas as constantes do sistema declaradas no início do programa (undefine).
//+------------------------------------------------------------------+
//| Undefine system constants                                        |
//+------------------------------------------------------------------+
#undef MA_SHIFT
#undef RSI_PRICE
#undef MA_TYPE
#undef ONNX_INPUTS
#undef ONNX_OUTPUTS
#undef HORIZON
//+------------------------------------------------------------------+
A escolha das datas para o teste histórico é simples. Precisamos testar o novo aplicativo no mesmo período de teste forward utilizado anteriormente. É com base nesse período que definimos as datas do teste.
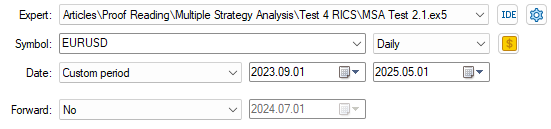
Figura 4: Seleção das datas para o backtesting considerando o teste forward anterior
Para utilizar configurações o mais realistas possível, selecionaremos o modo de atraso aleatório.
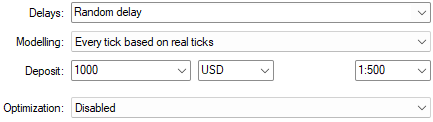
Figura 5: Atraso aleatório para um teste realista
Para minha surpresa, as novas configurações, que incluem modelos estatísticos, pioraram significativamente os resultados. Em geral, isso é um sinal claro de que houve algum erro na metodologia.
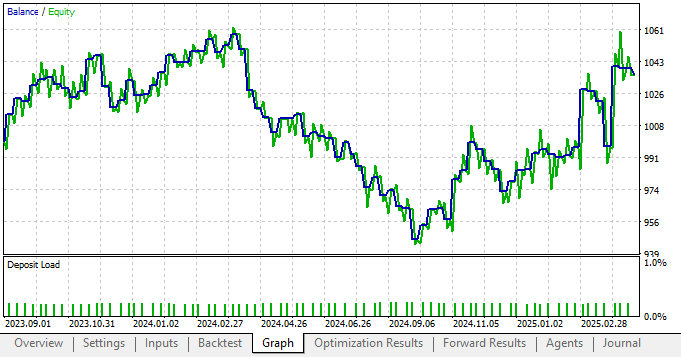
Figura 6: A nova curva de rentabilidade mostra uma piora em relação aos resultados sem modelagem estatística
Uma análise mais detalhada mostra que tanto o lucro líquido total quanto o índice de Sharpe diminuíram, o que é um sinal negativo. Isso indica que o aplicativo não está obtendo os benefícios esperados das técnicas de modelagem estatística escolhidas.
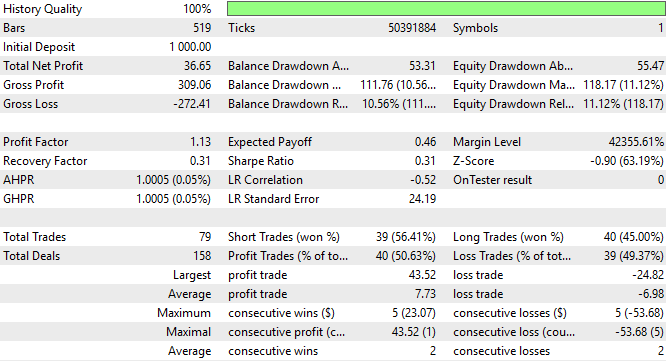
Figura 7: Análise detalhada da nova estratégia de trading baseada em modelos estatísticos
Reavaliação dos dados de mercado em Python
Depois de analisar novamente os dados de mercado em Python, decidi investigar com mais cuidado as possíveis fontes do erro. Comecei importando as bibliotecas usuais de visualização de dados e construí um gráfico dos retornos acumulados de cada uma das duas estratégias. O problema ficou evidente de imediato.import numpy as np import seaborn as sns import matplotlib.pyplot as plt
Como podemos observar no gráfico, as curvas das duas estratégias apresentam praticamente o mesmo comportamento e a mesma inclinação. Ambas sobem e caem ao mesmo tempo, dando a impressão de que estamos utilizando uma única estratégia.
fig , axs = plt.subplots(2,1,sharex=True)

fig.suptitle('Visualizing The Individual Cumulative Return of our 2 Strategies')

sns.lineplot(data['Return 1'].cumsum(),ax=axs[0],color='black')

sns.lineplot(data['Return 2'].cumsum(),ax=axs[1],color='black')
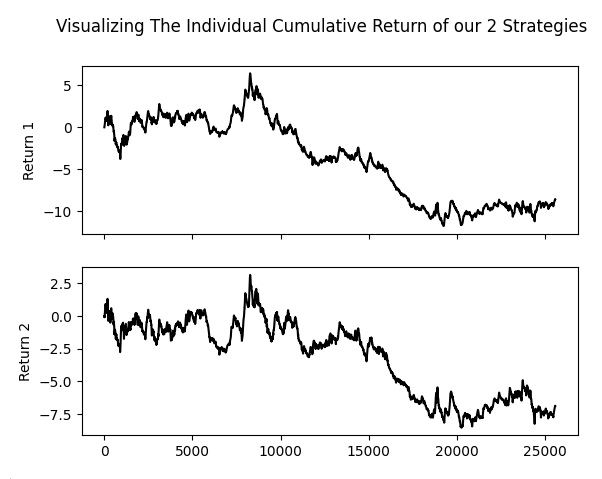
Figura 8: O otimizador genético aparentemente selecionou estratégias altamente correlacionadas e atribuiu a elas os maiores pesos de votação
Além disso, ao estimar o risco em janelas móveis a partir dos retornos das duas estratégias, encontramos outro problema. O perfil de risco é praticamente indistinguível do perfil do mercado. Mais uma vez, isso sugere que, na prática, estamos utilizando uma única estratégia. Sem os rótulos das colunas, seria extremamente difícil distinguir uma estratégia da outra.
fig , axs = plt.subplots(3,1,sharex=True)

fig.suptitle('Visualizing The Risk In Our 2 Strategies')

sns.lineplot(data['Return'].rolling(window=HORIZON).var(),ax=axs[0],color='black')
axs[0].axhline(data['Return'].var(),color='red',linestyle=':')

sns.lineplot(data['Return 1'].rolling(window=HORIZON).var(),ax=axs[1],color='black')
axs[1].axhline(data['Return 1'].var(),color='red',linestyle=':')

sns.lineplot(data['Return 2'].rolling(window=HORIZON).var(),ax=axs[2],color='black')
axs[2].axhline(data['Return 2'].var(),color='red',linestyle=':')
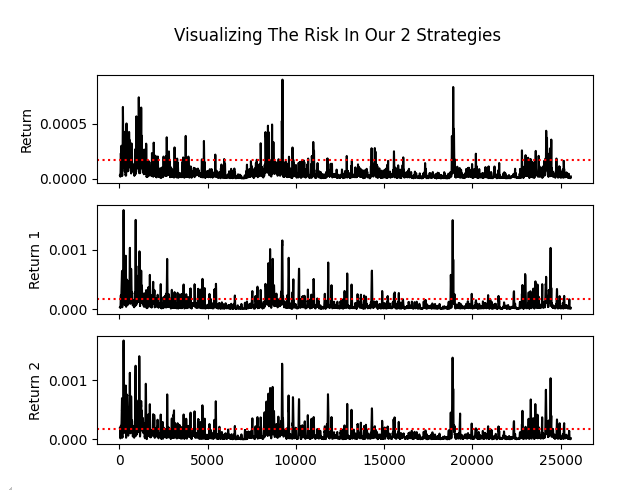
Figura 9: As duas estratégias são praticamente idênticas em termos de risco e retorno, o que compromete o princípio da análise multiestratégia
A confirmação definitiva veio com o cálculo da matriz de correlação de três séries de retornos: os retornos do mercado, da estratégia de cruzamento de médias móveis e da estratégia RSI. Podemos observar claramente que a correlação entre os retornos da estratégia de cruzamento de médias móveis e os da estratégia RSI é de aproximadamente 0,75, um valor muito alto. Isso acabou me convencendo de que o otimizador genético, em vez de utilizar os pesos dos votos principalmente para maximizar a rentabilidade, estava ajustando esses pesos de modo a favorecer estratégias altamente correlacionadas, já que isso simplifica a otimização.
plt.title('Correlation Between Market Return And Strategy Returns')
sns.heatmap(data.loc[:,['Return','Return 1','Return 2']].corr(),annot=True) 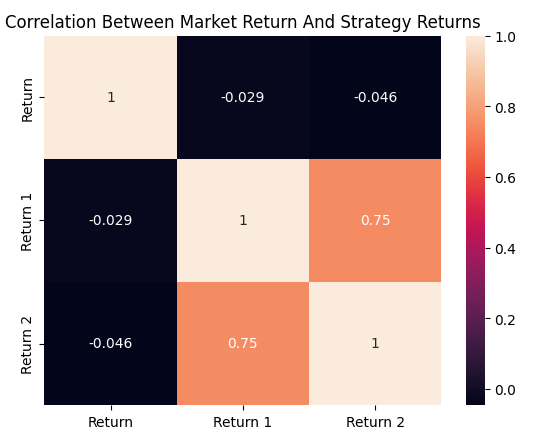
Figura 10: Matriz de correlação das estratégias de trading no EURUSD
Implementando melhorias
Agora que entendemos melhor o problema, podemos fazer mais uma tentativa de aprimorar nosso aplicativo. Para começar, voltaremos a uma versão anterior da nossa estratégia de trading, que incluía as três estratégias.
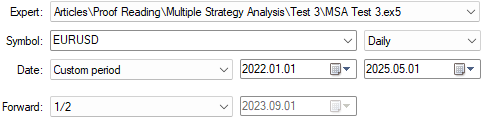
Figura 11: Seleção das datas do backtest para otimização
Como antes, utilizaremos o modo de atraso aleatório nos testes.
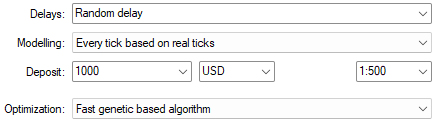
Figura 12: É indispensável ativar o modo Random Delay
No entanto, diferentemente dos testes anteriores, agora fixaremos em 1 o peso de cada voto, de modo que o otimizador genético só possa realizar ajustes que aumentem a rentabilidade total da estratégia. Além disso, exigiremos que o otimizador utilize as três estratégias, em vez de selecionar apenas as correlacionadas, o que iria contra nosso objetivo.
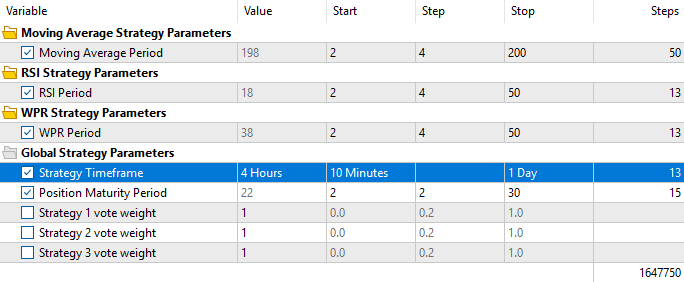
Figura 13: Desta vez, fixamos os pesos de todos os votos em 1, pois suspeitamos que o otimizador genético esteja explorando uma brecha
Os resultados já mostram uma melhora em relação às configurações anteriores. Inicialmente, quando utilizávamos as três estratégias, o lucro ficava aproximadamente entre US$ 40 e US$ 50. Agora, porém, observamos um aumento evidente da rentabilidade.
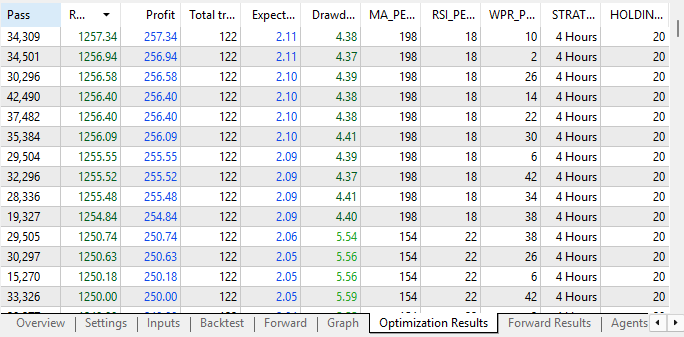
Figura 14: Os resultados da otimização melhoraram significativamente em relação à iteração anterior
Além disso, ao analisar os resultados do teste forward, observamos novamente um aumento do lucro. Agora, nossos testes apresentam resultados lucrativos tanto no backtest quanto no teste forward, o que é um importante sinal de estabilidade da configuração. O mais importante é que o otimizador genético agora consegue encontrar conjuntos de parâmetros para as estratégias que apresentam rentabilidade em ambos os testes. Era justamente isso que não conseguíamos alcançar anteriormente, quando o otimizador tinha liberdade para alterar os pesos dos votos. Isso confirma a hipótese de que a configuração atual é estável.
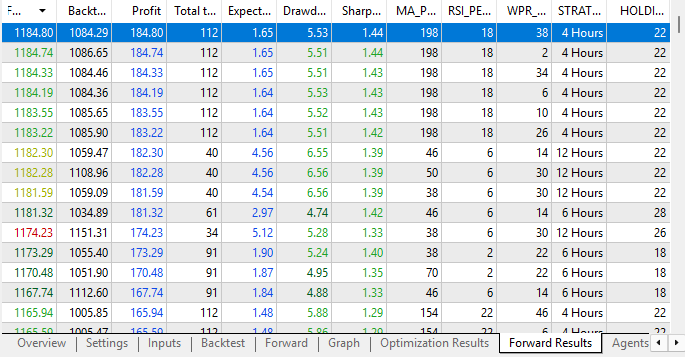
Figura 15: Os resultados do teste forward apresentam sinais claros de estabilidade e rentabilidade
Por fim, ao executar um backtest com os parâmetros mais rentáveis identificados a partir do teste forward, podemos observar claramente que as novas configurações proporcionam lucro tanto no backtest quanto no teste forward, com uma tendência de alta. É exatamente o resultado que buscamos.
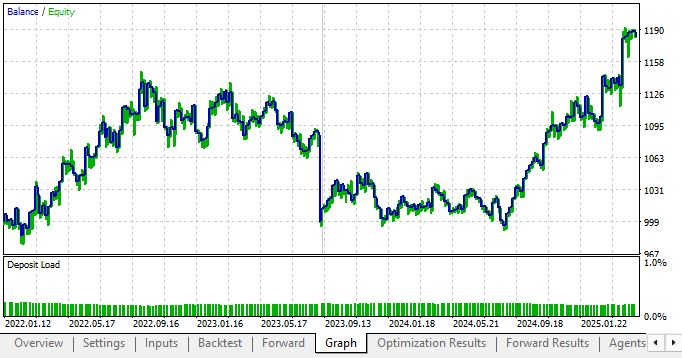
Figura 16: A curva de rentabilidade obtida com pesos fixos é significativamente mais lucrativa
Conclusão
Ao longo desta análise, aprendemos algumas lições importantes. Primeiro, constatamos que o problema conhecido como "reward hacking" é bastante comum e pode ocorrer mesmo sem percebermos. As ferramentas de inteligência artificial que utilizamos, neste caso, o otimizador genético, operam com rapidez e eficiência, às vezes até nos superando. No entanto, precisamos permanecer atentos para evitar que encontrem soluções formalmente válidas, mas sem utilidade prática, que apenas satisfaçam os critérios definidos para a otimização.
Após analisar cuidadosamente os retornos das estratégias selecionadas pelo otimizador, concluímos que devemos evitar estratégias correlacionadas, pois isso anula as vantagens de analisar múltiplas estratégias.
Vale destacar que a capacidade dos otimizadores genéticos é limitada pelo tempo que estamos dispostos a dedicar à otimização. No entanto, nossa análise não prova que o otimizador genético do MetaTrader 5 sempre explorará brechas na função de recompensa. Como utilizamos apenas um pequeno número de estratégias e executamos a otimização uma única vez, existe a possibilidade de que uma nova execução produza resultados diferentes.
Na verdade, isso indica que eu, como autor, não defini o problema com precisão suficiente para o otimizador genético. Uma abordagem mais adequada seria exigir inicialmente a utilização de todas as estratégias disponíveis e, somente depois, ajustar os pesos dos votos com maior cuidado.
O mais importante é que concluímos este estudo sabendo qual será o desafio do próximo artigo: tentar superar a rentabilidade alcançada com pesos uniformes, todos iguais a 1. Os resultados obtidos hoje servirão como referência de desempenho, que tentaremos superar no próximo estudo utilizando os modelos estatísticos que havíamos planejado aplicar originalmente neste artigo.
| Nome do arquivo | Descrição do arquivo |
|---|---|
| Fetch Data MSA.mq5 | Script MQL5 para coletar dados das duas estratégias selecionadas pelo otimizador genético. |
| MSA Test 2.1.mq5 | EA desenvolvido com base nas duas estratégias selecionadas e no modelo ONNX. |
| Analyzing Multiple Strategies I.ipynb | Notebook Jupyter para analisar os dados de mercado coletados com nosso script MQL5. |
| EURUSD NN MSA.onnx | Rede neural profunda que construímos utilizando o recurso de busca aleatória da biblioteca sklearn. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18847
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Caminhe em novos trilhos: Personalize indicadores no MQL5
 Desenvolvimento de ferramentas para análise de Price Action (Parte 32): Módulo de reconhecimento de padrões de candles em Python (II): Reconhecimento com TA-Lib
 Está chegando o novo MetaTrader 5 e MQL5
 Ferramentas de trading em MQL5 (Parte 5): criação de uma faixa de cotações com rolagem contínua para monitorar símbolos em tempo real

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso