
Recursos do Assistente MQL5 que você precisa conhecer (Parte 76): Uso de padrões do Awesome Oscillator e canais de envelopes com aprendizado supervisionado
 50
 0

Introdução
No artigo anterior, apresentamos a combinação dos indicadores Awesome Oscillator e Envelope Channels. Nos testes realizados, 7 ou 8 dos 10 padrões apresentaram resultados positivos em um teste walk-forward com uma janela de teste de dois anos. Depois de apresentar uma combinação de indicadores, normalmente investigamos se o machine learning pode melhorar o desempenho dos sinais gerados por eles e, em caso afirmativo, em que medida. Este artigo segue a mesma abordagem. Vamos analisar como os padrões 4, 8 e 9 podem ser modificados ao incorporar uma rede neural com aprendizado supervisionado para filtrar seus sinais. Para isso, utilizaremos uma rede neural convolucional (CNN), cujo tamanho dos kernels e número de canais são determinados por um kernel de produto escalar (dot product kernel) com mecanismo de atenção temporal cruzada (cross-time attention).
Kernel de produto escalar com mecanismo de atenção temporal cruzada
Esse kernel utiliza uma variante do mecanismo de atenção que, a partir de duas sequências, geralmente compostas por atributos de diferentes instantes ou camadas, calcula uma pontuação de atenção para cada par de elementos por meio do produto escalar. Essa abordagem permite identificar relações temporais e avaliar como um atributo passado ou futuro se relaciona com o atributo atual. Considere as duas sequências a seguir:
X=[x1,x2,...,xT]
Y=[y1,y2,...,yS]
Para cada par (xi,yj), o produto escalar é calculado da seguinte forma:
Scorei,j = xi⋅yj
Também é possível aplicar a função softmax ao longo de j ou i para obter pesos de atenção, que são utilizados para combinar ou reponderar os atributos ao longo do tempo. Essa abordagem é eficiente em termos de parâmetros, pois não exige o treinamento de parâmetros adicionais além daqueles utilizados nas projeções. O mecanismo também é flexível, podendo processar sequências de comprimento variável, amostragem irregular e interações entre diferentes modalidades ou instantes. Outra vantagem é sua capacidade de concentrar a atenção nos momentos mais relevantes, em vez de considerar apenas as regiões convolucionais locais. Entre suas aplicações estão a previsão de séries temporais, especialmente quando as defasagens são importantes, a análise de vídeos, em que os quadros apresentam relações temporais, o processamento de fala e qualquer outra área que envolva dependências temporais complexas.
Então, por que escolhemos justamente esse kernel para determinar o tamanho dos kernels e o número de canais da nossa rede neural convolucional? No caso dos kernels, há aspectos espaciais e temporais a considerar. Em primeiro lugar, os kernels de atenção indicam quais passos de tempo são mais relevantes. Isso talvez tenha menos importância quando se utilizam kernels pequenos e muito localizados, mas, à medida que o kernel aumenta, ele passa a captar mais contexto. Como as CNNs operam essencialmente sobre regiões locais dos dados, o mecanismo de atenção pode ampliar ou restringir adaptativamente o campo receptivo efetivo, influenciando o tamanho do kernel de acordo com a dinâmica temporal da sequência de dados.
Quanto aos canais, o kernel de atenção pode identificar quais canais ou dimensões dos atributos "recebem mais atenção". Isso fornece um critério para a poda de canais. Se o mecanismo de atenção ignora determinados canais de forma persistente, esses canais passam a representar um peso desnecessário, o que, na prática, equivale a uma redução do número de canais efetivamente utilizados. O mecanismo também pode indicar quando é necessário expandi-los. Se a atenção estiver muito dispersa e não houver um foco claro, talvez seja necessária uma representação mais rica, com um número maior de canais. Assim, como em artigos anteriores nos quais aplicamos aprimoramentos a redes neurais convolucionais, nossa abordagem utiliza uma arquitetura de CNN dinâmica, em vez de tamanhos fixos de kernel e um número fixo de canais para todos os casos. Utilizamos os padrões de atenção durante o treinamento e a inferência para reconfigurar a CNN, buscando modelos mais eficientes para os dados não estacionários dos mercados financeiros.
Apesar dessa abordagem dinâmica, voltada a aumentar a adaptabilidade e o desempenho do modelo, há algumas desvantagens que merecem ser mencionadas. Em primeiro lugar, o custo computacional cresce como O(N^2) em função do comprimento da sequência de dados de entrada, enquanto CNNs estáticas normalmente apresentam custo O(N). Isso torna a abordagem pouco prática para sequências longas. Em segundo lugar, há um paradoxo de interpretabilidade. As pontuações de atenção são úteis, mas combiná-las com a seleção dinâmica do tamanho do kernel e do número de canais torna o modelo mais difícil de interpretar e dificulta a extração de informações interpretáveis que permitam extrapolar as conclusões para cenários externos.
Além disso, essa abordagem nem sempre é superior. Alguns testes mostraram que, em tarefas estritamente locais, como a detecção de bordas em imagens, redes neurais convolucionais clássicas podem superar modelos que dependem fortemente de mecanismos de atenção. Os kernels de atenção também exigem muito mais dados do que CNNs clássicas, especialmente durante as etapas de treinamento e otimização, para que seja possível identificar dependências relevantes entre diferentes intervalos de tempo. Por fim, há o risco de sobreajuste. Se as alterações arquiteturais forem orientadas pela atenção, um grau excessivo de adaptabilidade pode fazer o modelo se sobreajustar ao ruído ou a variações aleatórias nos dados avaliados.
Entre as possíveis alternativas à nossa abordagem estão as convoluções dilatadas, que ampliam o campo receptivo sem aumentar o tamanho do kernel, permitindo captar dependências temporais distantes e esparsas; as convoluções dinâmicas ou adaptativas, nas quais os pesos dos kernels são definidos de acordo com as características dos dados de entrada ou dos sinais de atenção; as convoluções separáveis em profundidade, nas quais apenas o número de canais varia, com foco na eficiência computacional; os blocos de compressão e excitação (Squeeze-and-Excitation); e as redes convolucionais temporais. Cada uma dessas alternativas representa uma variação da nossa abordagem, com suas próprias vantagens e desvantagens. Elas são mencionadas aqui para oferecer uma visão mais completa das possibilidades de adaptação das redes neurais convolucionais.
A rede
Após essa breve apresentação do kernel de produto escalar com mecanismo de atenção temporal cruzada, vamos examinar o código em detalhes. Abaixo está o código da rede neural, implementada como uma classe:
import torch
import torch.nn as nn
import torch.nn.functional as F

class DotProductAttentionConv1D(nn.Module):
    def __init__(self, input_length=100):
        super(DotProductAttentionConv1D, self).__init__()
        self.input_length = input_length

        # Deeper and wider design with attention
        self.kernel_sizes, self.channels = self._design_architecture()

        self.conv_layers = nn.ModuleList()
        self.attention_layers = nn.ModuleList()  # For cross-time attention
        in_channels = 1

        for i, (out_channels, kernel_size) in enumerate(zip(self.channels, self.kernel_sizes)):
            # Convolutional block
            conv_layer = nn.Sequential(
                nn.Conv1d(in_channels, out_channels, kernel_size=kernel_size, padding=kernel_size // 2),
                nn.BatchNorm1d(out_channels),
                nn.ReLU(),
                nn.Dropout(0.2))
            self.conv_layers.append(conv_layer)

            # Attention block (cross-time attention)
            if i % 2 == 0:  # Apply attention to every other layer
                attn_layer = nn.MultiheadAttention(embed_dim=out_channels, num_heads=4)
                self.attention_layers.append(attn_layer)
            else:
                self.attention_layers.append(None)

            in_channels = out_channels

        # Fully connected head (same as original)
        self.head = nn.Sequential(
            nn.AdaptiveAvgPool1d(1),
            nn.Flatten(),
            nn.Linear(in_channels, 128),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def _dot_product_kernel(self, x):
        """Dot product similarity kernel with positional encoding"""
        # x shape: (B, C, L)
        x = x.permute(0, 2, 1)  # (B, L, C)
        # Compute dot product attention
        attention_scores = torch.bmm(x, x.transpose(1, 2))  # (B, L, L)
        attention_weights = F.softmax(attention_scores / (x.size(-1) ** 0.5), dim=-1)
        return torch.bmm(attention_weights, x).permute(0, 2, 1)  # (B, C, L)

    def _design_architecture(self):
        # Simulate attention response pattern
        num_layers = 10
        kernel_sizes = [3 + (i % 4) * 2 for i in range(num_layers)]  # cyclic 3, 5, 7, 9
        channels = [32 * (i + 1) for i in range(num_layers)]  # 32, 64, ..., 320

        return kernel_sizes, channels

    def forward(self, x):
        x = x.unsqueeze(1)  # (B, 1, L)

        for conv_layer, attn_layer in zip(self.conv_layers, self.attention_layers):
            x = conv_layer(x)

            if attn_layer is not None:
                # Reshape for attention (MultiheadAttention expects seq_len first)
                attn_input = x.permute(2, 0, 1)  # (L, B, C)
                attn_output, _ = attn_layer(attn_input, attn_input, attn_input)
                x = attn_output.permute(1, 2, 0)  # (B, C, L)

                # Also apply dot product kernel
                x = self._dot_product_kernel(x)

        return self.head(x)
Primeiramente, nossa classe herda de nn.Module, a classe-base padrão para redes neurais desenvolvidas com PyTorch. O parâmetro input_length define o comprimento esperado da sequência, mas a classe também pode ser adaptada para receber sequências de entrada de comprimento variável. A chamada a super garante a inicialização da classe-base, uma etapa fundamental para que os mecanismos internos do PyTorch funcionem corretamente e que, portanto, não deve ser ignorada. Com isso, passamos à definição da arquitetura, dos tamanhos dos kernels e do número de canais.
Como mencionado anteriormente, adotamos uma abordagem dinâmica. Em vez de utilizar valores fixos, o modelo seleciona algoritmicamente os tamanhos dos kernels e o número de canais, permitindo adaptar a arquitetura aos padrões de atenção presentes nos dados de entrada a cada propagação para frente. Uma possibilidade de aprimoramento seria utilizar estatísticas de atenção obtidas em execuções anteriores ou por meio de meta-aprendizado para orientar a escolha efetiva do tamanho do kernel e do número de canais em cada camada.
Após a execução da função responsável pela definição da arquitetura, passamos à construção das camadas. Aqui, ModuleList permite criar uma rede com profundidade variável, o que é especialmente importante para o empilhamento dinâmico de camadas. Em seguida, utilizamos um laço for para construir a rede camada por camada. Nessa etapa, o tamanho do kernel é definido individualmente para cada camada convolucional, permitindo utilizar filtros mais largos ou mais estreitos conforme a necessidade. Posteriormente, o mecanismo de atenção poderá ajudar a determinar a configuração mais adequada. O parâmetro padding, definido como kernel_size // 2, aplica um preenchimento que preserva o comprimento da sequência na saída para a maioria dos tamanhos de kernel. Isso é particularmente importante no processamento de séries temporais, em que os passos de tempo precisam permanecer alinhados. Por fim, a normalização em lote, a função de ativação ReLU e o Dropout, recursos clássicos do aprendizado profundo, ajudam a estabilizar o treinamento, acelerar a convergência e regularizar o modelo.
Dentro do laço for, além do bloco de convolução mencionado anteriormente, também temos um "bloco de atenção". Nele, adicionamos camadas de atenção com múltiplas cabeças (multi-head) de forma alternada. Esse mecanismo, que constitui um dos componentes centrais dos Transformers, permite captar dependências ao longo de toda a sequência. A adição é feita de forma alternada, e não em todas as posições da arquitetura, principalmente para reduzir o custo computacional. Isso permite que o modelo alterne entre o processamento local da CNN e a análise global das dependências. Por fim, o parâmetro de canais de entrada (in-channels) recebe o valor do parâmetro de canais de saída (out-channels). Isso ocorre porque cada canal do mapa de atributos passa a corresponder a uma dimensão do embedding, integrando as representações da CNN e do mecanismo de atenção.
Em seguida, chegamos à parte final da função de inicialização da classe, na qual definimos o bloco de saída totalmente conectado. Aqui, utilizamos o pooling adaptativo (adaptive pooling) para reduzir a dimensão temporal a 1, independentemente do comprimento da sequência de entrada, obtendo assim uma saída de tamanho fixo. Depois, achatamos o tensor (Flatten) para alimentar as camadas totalmente conectadas. Essas camadas densas realizam uma série de transformações não lineares que, ao final, produzem uma única saída sigmoide. Esse valor pode ser interpretado como uma previsão binária ou uma pontuação normalizada, mas, em nosso caso, representa a previsão da tendência dos preços: valores inferiores a 0,5 indicam uma tendência de baixa, enquanto valores superiores a 0,5 indicam uma tendência de alta. O Dropout ajuda a evitar o sobreajuste na etapa das camadas densas (dense layer stage).
Depois de examinarmos a inicialização da classe dessa rede, vamos analisar a função do kernel de produto escalar. O primeiro passo do cálculo consiste em reorganizar as dimensões do tensor de entrada para o formato (B, L, C), facilitando o cálculo dos produtos escalares entre os vetores de dados da sequência. Em seguida, realizamos uma multiplicação matricial em lote (batch matrix multiplication, BMM), que permite calcular eficientemente todos os produtos escalares entre pares de vetores em cada lote. O uso de GPUs pode acelerar ainda mais essa operação. Depois, aplicamos o escalonamento antes da função softmax, como é habitual nos mecanismos de atenção. Nesse caso, o fator de escala corresponde à raiz quadrada do tamanho do vetor de entrada, ou seja, da dimensão do embedding.
Em seguida, realizamos uma última multiplicação matricial em lote, combinando os atributos de diferentes instantes de acordo com os pesos atribuídos pelo mecanismo de atenção. Depois, reorganizamos novamente as dimensões do tensor resultante para recuperar o formato original da entrada e prepará-lo para as operações seguintes. É essa função que permite à rede captar relações e mudanças ao longo do tempo, indo além do que uma convolução convencional consegue identificar. Na rede, essa função é utilizada na propagação para frente.
A próxima função específica da nossa classe de rede é um recurso auxiliar para a definição da arquitetura. Em artigos anteriores, já utilizamos funções semelhantes na configuração de CNNs. Neste caso, percorremos ciclicamente diferentes tamanhos de kernel para simular uma variação orientada pelo mecanismo de atenção. Também aumentamos progressivamente o número de canais, seguindo uma abordagem clássica do aprendizado profundo, na qual as camadas mais avançadas procuram aprender representações mais abstratas e com maior número de dimensões.
A última função da classe da rede, como de costume, é a função de propagação para frente (forward pass). Primeiro, pré-processamos o vetor de entrada adicionando uma dimensão intermediária, ou canal, necessária para realizar convoluções unidimensionais. Em seguida, executamos a convolução em cada camada para extrair atributos locais dos dados de entrada. Depois, verificamos se há uma camada de atenção a ser processada. Vale lembrar que, na função de inicialização dessa classe, adicionamos as camadas de atenção de forma alternada, e não em todas as posições da arquitetura.
Quando há uma camada de atenção, reorganizamos as dimensões do tensor, pois o mecanismo de atenção com múltiplas cabeças do PyTorch espera um formato específico (canal, lote, comprimento), enquanto nossos dados estão organizados como (lote, canal, comprimento). Após obtermos a saída do mecanismo de atenção, calculamos o produto escalar chamando a função definida anteriormente. Também é importante observar que utilizamos tanto o bloco de atenção no estilo Transformer quanto o dot-product kernel na propagação para frente. Como alternativa, porém, poderíamos utilizar apenas um desses mecanismos. Essa comparação permitiria identificar qual dos algoritmos proporciona maior precisão ao modelo. Os dados resultantes são então encaminhados ao bloco de classificação/regressão.
Resumo do código por seção
| Seção | O que faz | Por que é importante |
|---|---|---|
| init + super | Configuração básica da classe | Necessária para o funcionamento do PyTorch |
| self.kernel_sizes, channels | Definição dinâmica da arquitetura da CNN | Extração adaptativa de atributos com configuração personalizada |
| Camadas ModuleList | Arquitetura modular e extensível | Escalabilidade e possibilidade de experimentar diferentes configurações |
| Blocos convolucionais | Extração de atributos locais | Vantagens das CNNs tradicionais, normalização em lote etc. |
| Blocos MultiheadAttention | Identificação de dependências temporais globais | Permitem captar dependências de longo alcance |
| _dot_product_kernel | Cálculo explícito da atenção | Fornece um sinal redundante ou inter-relacionado para identificar dependências entre diferentes instantes |
| Bloco totalmente conectado | Agregação de atributos e geração da saída | Flexibilidade para diferentes tarefas (classificação, regressão etc.) |
| forward logic (lógica de propagação para frente) | Fluxo de dados pela rede | Garante a execução correta de cada operação |
| _design_architecture | Define como os tamanhos dos kernels e o número de canais são selecionados | Permite orientar a configuração pelos dados ou pelo mecanismo de atenção. |
Função Awesome Oscillator
As funções dos indicadores utilizadas em MQL5 não são importadas quando usamos o módulo MetaTrader 5 no Python. Por isso, precisamos recorrer a bibliotecas existentes ou implementar nossas próprias funções. Optamos pela segunda alternativa e vamos mantê-la, implementando nossa função Awesome Oscillator em Python da seguinte forma:
def Awesome_Oscillator(df: pd.DataFrame, short_period: int = 5, long_period: int = 34) -> pd.DataFrame:
    """
    Calculate the Bill Williams Awesome Oscillator (AO) and append it to the input DataFrame.

    AO = SMA(Median Price, short_period) - SMA(Median Price, long_period)

    Args:
        df (pd.DataFrame): DataFrame with 'high' and 'low' columns.
        short_period (int): Short period for SMA (default 5).
        long_period (int): Long period for SMA (default 34).

    Returns:
        pd.DataFrame: Input DataFrame with 'AO' column added.
    """
    required_cols = {'high', 'low'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high' and 'low' columns")
    if not all(p > 0 for p in [short_period, long_period]):
        raise ValueError("Period values must be positive integers")

    result_df = df.copy()
    median_price = (result_df['high'] + result_df['low']) / 2
    short_sma = median_price.rolling(window=short_period).mean()
    long_sma = median_price.rolling(window=long_period).mean()
    result_df['AO'] = short_sma - long_sma

    return result_df
Entre os módulos importados para essa função está o pandas, utilizado para trabalhar com tabelas e séries temporais. Ele é especialmente eficiente no processamento de DataFrames e na aplicação de operações com janelas deslizantes. Também importamos o NumPy, uma biblioteca fundamental para cálculos matemáticos rápidos, amplamente utilizada nos bastidores, embora não seja mencionada explicitamente nesse trecho. A assinatura da função, definida na linha que começa com def, é clara e inclui anotações de tipo que indicam os dados de entrada necessários para chamá-la. Essas informações também facilitam o preenchimento automático de código na IDE, enquanto os valores padrão dos períodos de cálculo das médias já estão definidos. Esses valores correspondem às configurações clássicas de Bill Williams.
Depois de examinar a assinatura, passamos à validação dos dados de entrada da função, começando pelos requisitos obrigatórios. O DataFrame deve conter as colunas high (máxima) e low (mínima). Essa verificação impede que a ausência dessas colunas provoque erros difíceis de identificar nas etapas seguintes. Também verificamos se os períodos informados são números inteiros válidos e sem sinal. O uso de mensagens de erro compreensíveis para o usuário permite identificar problemas antecipadamente e facilita um diagnóstico mais preciso. Essa abordagem preventiva de validação dos dados de entrada também é importante para evitar o surgimento de valores NaN. Nunca confie em dados provenientes de fontes externas.
Em seguida, criamos uma cópia do DataFrame de entrada para garantir que os dados originais permaneçam intactos. Essa abordagem "não destrutiva" é essencial em pipelines que utilizam funções de indicadores em várias etapas. Depois, calculamos o preço mediano com base nos dados copiados. Esse é um componente fundamental do AO, pois representa o ponto médio entre a máxima e a mínima de cada barra, em vez de considerar apenas o preço de fechamento, reduzindo a influência das oscilações bruscas entre abertura e fechamento. Em seguida, calculamos as médias móveis simples de curto e longo prazo. O método rolling().mean() calcula uma média móvel que produz um sinal de tendência mais suave. A lógica do oscilador se baseia na comparação entre a média curta e a longa. Assim, ele mede o momentum pela diferença entre as médias móveis rápida e lenta.
Por fim, adicionamos uma nova coluna AO ao DataFrame copiado, contendo os valores calculados do indicador. Quando o momentum positivo de curto prazo supera o de longo prazo, isso indica um viés de alta. Já a queda do momentum de curto prazo para valores mais negativos pode indicar uma tendência de baixa ou a perda de força de um movimento de alta. Como observamos no artigo anterior, o AO utiliza a linha zero como referência, de modo que seus cruzamentos têm grande importância.
Função dos canais de envelopes
Sua implementação em Python é a seguinte:
def Envelope_Channels(df: pd.DataFrame, period: int = 20, deviation: float = 0.025) -> pd.DataFrame:
    """
    Calculate Envelope Channels (Upper & Lower Bands) and append to the input DataFrame.

    Envelope Channels = SMA(close, period) * (1 ± deviation)

    Args:
        df (pd.DataFrame): DataFrame with 'close' column.
        period (int): Period for SMA calculation (default 20).
        deviation (float): Deviation as a decimal (e.g., 0.025 for 2.5%, default 0.025).

    Returns:
        pd.DataFrame: Input DataFrame with 'Envelope_Upper' and 'Envelope_Lower' columns added.
    """
    required_cols = {'close'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'close' column")
    if period <= 0 or deviation < 0:
        raise ValueError("Period must be positive and deviation non-negative")

    result_df = df.copy()
    sma = result_df['close'].rolling(window=period).mean()
    result_df['Envelope_Upper'] = sma * (1 + deviation)
    result_df['Envelope_Lower'] = sma * (1 - deviation)
    result_df['Envelope_Mid'] = 0.5 * (result_df['Envelope_Upper'] + result_df['Envelope_Lower'])

    return result_df
Assim como no AO, a assinatura da função inclui anotações de tipo, e os parâmetros de período e desvio recebem valores padrão adequados. A validação dos dados de entrada se concentra na coluna de fechamento. Essa é a única coluna obrigatória do DataFrame, e sua verificação ajuda a evitar o problema conhecido como "lixo entra, lixo sai". Também verificamos se o período informado é diferente de zero e se o desvio não é negativo. Caso esses requisitos não sejam atendidos, um erro é gerado, interrompendo a execução do script.
Também criamos uma cópia do DataFrame de entrada, que chamamos de DataFrame de resultados. Essa é uma prática recomendada, como já discutimos anteriormente e em outros artigos desta série. O primeiro cálculo é o da média móvel simples (SMA) dos preços de fechamento. Os envelopes são construídos com base nessa média. Uma curva de SMA mais suave apresenta menos oscilações em zigue-zague, mas também maior defasagem. A SMA funciona como a linha central das bandas. Com esses dados básicos, passamos ao cálculo dos buffers superior e inferior do envelope, que formam os canais.
Quando o preço ultrapassa o limite superior, isso pode indicar sobrecompra; quando cai abaixo do limite inferior, pode indicar sobrevenda. O desvio é expresso em formato decimal, com valor padrão de 2,5%, ou 0,025. É importante escolher um desvio adequado ao ativo negociado, pois esse parâmetro costuma ser bastante sensível. Para ativos mais voláteis, podem ser utilizados desvios de até 5%. Também adicionamos ao DataFrame um buffer correspondente à linha central do envelope, cujo valor é simplesmente a média entre as bandas superior e inferior.
Atributos
Vamos testar 3 dos 10 padrões de sinais apresentados no artigo anterior. Neste artigo, chamamos esses padrões de atributos, pois eles são utilizados como dados de entrada da rede. Para nossos objetivos, porém, os dois termos podem ser usados de forma intercambiável. Como explicamos no artigo anterior e ao longo desta série, cada atributo é representado por um vetor que combina os sinais dos dois indicadores. Trata-se de uma sequência binária composta por zeros e uns. Em artigos anteriores, exploramos a possibilidade de ampliar esses vetores para além de dois valores, associando cada condição verificada nos indicadores a um sinal de alta ou de baixa. No entanto, os resultados dos testes foram muito inferiores aos que obtivemos, e continuamos obtendo, quando nos concentramos no sinal geral de tendência de alta ou de baixa.
Voltamos agora aos atributos 4, 8 e 9. A estrutura geral das funções utilizadas aqui não é muito diferente daquela que empregamos anteriormente. Cada função retorna um array NumPy bidimensional, cujo número de linhas corresponde ao número de linhas do DataFrame e que possui duas colunas. O índice [0] de cada linha corresponde a um padrão específico de alta (padrão de compra), enquanto o índice [1] corresponde a um padrão específico de baixa (padrão de venda). Em nosso sistema, o valor 1 indica a presença de um padrão de compra ou venda, enquanto 0 indica sua ausência. Cada padrão combina os sinais dos dois indicadores: AO e canais de envelopes. Ao comparar valores de diferentes colunas, utilizamos shift[n] em cada DataFrame. Por isso, cada DataFrame carregado precisa conter dados históricos suficientes para essas comparações.
Atributo 4
Em resumo, a lógica principal desse padrão consiste em identificar um sinal de alta quando o AO forma um vale acima de zero e o preço se aproxima da metade inferior do envelope. Por outro lado, um sinal de baixa ocorre quando o AO forma um pico abaixo de zero e o preço está na metade superior do envelope. Sua implementação em Python é a seguinte:
def feature_4(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 4.                                             |
//+------------------------------------------------------------------+

    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['AO'].shift(2) > df['AO'].shift(1)) &
                     (df['AO'].shift(1) < df['AO']) &
                     (df['AO'].shift(1) > 0.0) &
                     (df['close'].shift(2) >= df['Envelope_Mid'].shift(2)) &
                     (df['close'].shift(2) <= df['Envelope_Lower'].shift(2)) &
                     (df['close'].shift(1) >= df['Envelope_Mid'].shift(1)) &
                     (df['close'].shift(1) <= df['Envelope_Lower'].shift(1)) &
                     (df['close'] >= df['Envelope_Mid']) &
                     (df['close'] <= df['Envelope_Lower'])).astype(int)

    feature[:, 1] = ((df['AO'].shift(2) < df['AO'].shift(1)) &
                     (df['AO'].shift(1) > df['AO']) &
                     (df['AO'].shift(1) < 0.0) &
                     (df['close'].shift(2) <= df['Envelope_Mid'].shift(2)) &
                     (df['close'].shift(2) >= df['Envelope_Upper'].shift(2)) &
                     (df['close'].shift(1) <= df['Envelope_Mid'].shift(1)) &
                     (df['close'].shift(1) >= df['Envelope_Upper'].shift(1)) &
                     (df['close'] <= df['Envelope_Mid']) &
                     (df['close'] >= df['Envelope_Upper'])).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
No código acima, começamos preparando o array de saída para indicar, inicialmente, a ausência de sinais. Para isso, preenchemos o array com zeros e definimos duas colunas. Em seguida, atribuímos valores à primeira coluna, verificando se todas as condições do sinal de alta são atendidas. Para que qualquer uma das colunas receba o valor 1, é necessário que tanto as condições do AO quanto as do envelope sejam satisfeitas. No AO, o padrão de alta se caracteriza por uma queda seguida de uma recuperação do momentum, indicando uma reversão de alta. Essa formação em V também deve permanecer inteiramente acima da linha zero, ou seja, na região de alta. Quanto ao envelope, o preço deve estar próximo ou abaixo da linha central, mas fora da região de sobrevenda. Essa configuração pode representar uma correção, e não um rompimento, sendo favorável tanto ao enfraquecimento quanto à retomada da tendência.
Quando uma das colunas recebe o valor 1, é muito provável que a outra permaneça em zero, pois os sinais são simétricos e opostos. Assim, a lógica de baixa corresponde à inversão das condições descritas acima. O AO deve formar um pico abaixo da linha zero, enquanto o preço deve estar na metade superior do envelope. A última operação da função do atributo 4 consiste em atribuir zero às duas primeiras linhas, pois as comparações utilizam deslocamentos de até duas posições. Como já mencionamos, isso evita a geração de sinais espúrios devido aos valores NaN introduzidos pelo deslocamento no início da série.
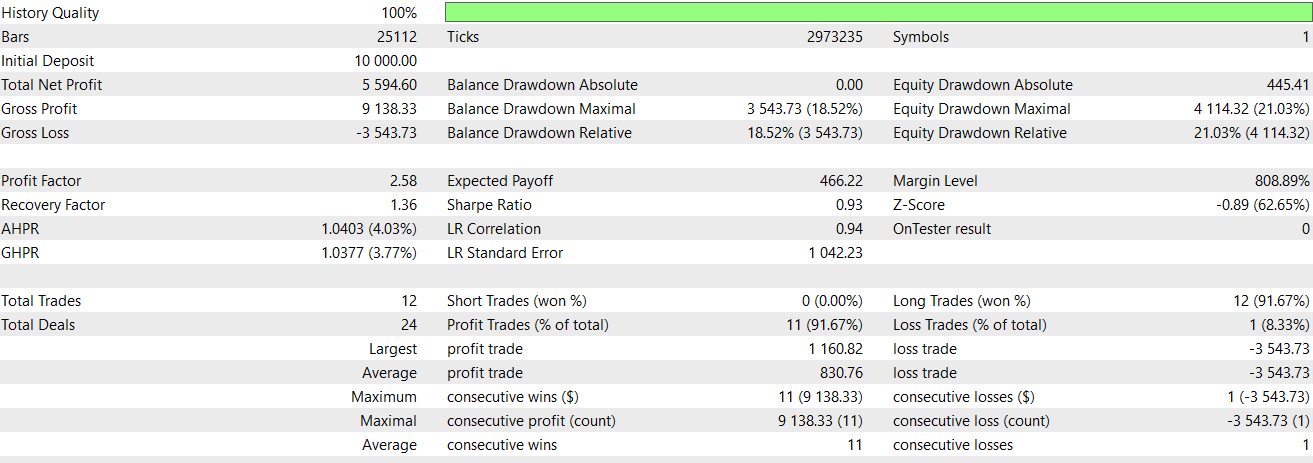
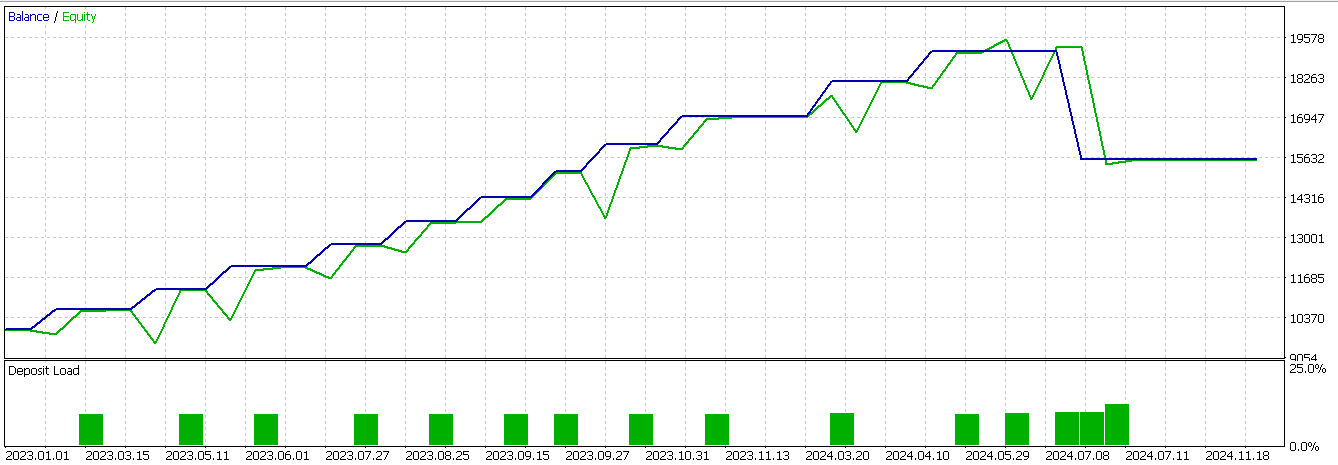
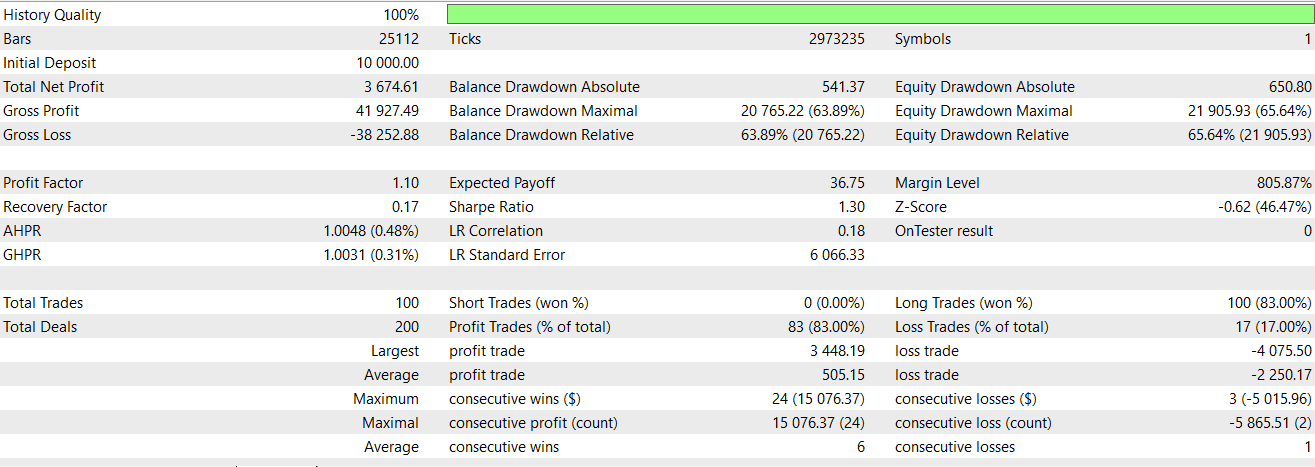
Realizamos a otimização e os testes forward do atributo 4, utilizando a rede neural convolucional apresentada anteriormente como filtro adicional. Conforme mencionado no artigo anterior, o ativo utilizado é USD/JPY, no timeframe de 30 minutos, e o período de teste, como temos adotado ao longo deste ano, abrange 2023 e 2024. O desempenho no teste forward é melhor do que o observado no artigo anterior, embora o resultado ainda seja negativo. Confira o relatório:
Atributo 8
Como vimos no artigo anterior, esse padrão de sinais apresenta uma configuração de alta quando o AO gera um sinal de compra e o preço sobe de forma consistente, com o AO acima da linha zero e o preço se afastando da banda inferior do envelope. Na configuração de baixa, tanto o AO quanto o preço apresentam movimento descendente, com o AO caindo abaixo da linha zero e o preço rompendo a banda inferior do envelope. Sua implementação em Python é a seguinte:
def feature_8(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 8.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['AO'].shift(2) > 0.0) &
                     (df['AO'].shift(1) > df['AO'].shift(2)) &
                     (df['AO'] > df['AO'].shift(1)) &
                     (df['close'].shift(2) > df['Envelope_Lower'].shift(2)) &
                     (df['close'].shift(1) > df['close'].shift(2)) &
                     (df['close'] > df['close'].shift(1))).astype(int)

    feature[:, 1] = ((df['AO'].shift(2) < 0.0) &
                     (df['AO'].shift(1) < df['AO'].shift(2)) &
                     (df['AO'] > df['AO'].shift(1)) &
                     (df['close'].shift(2) < df['Envelope_Lower'].shift(2)) &
                     (df['close'].shift(1) < df['close'].shift(2)) &
                     (df['close'] < df['close'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
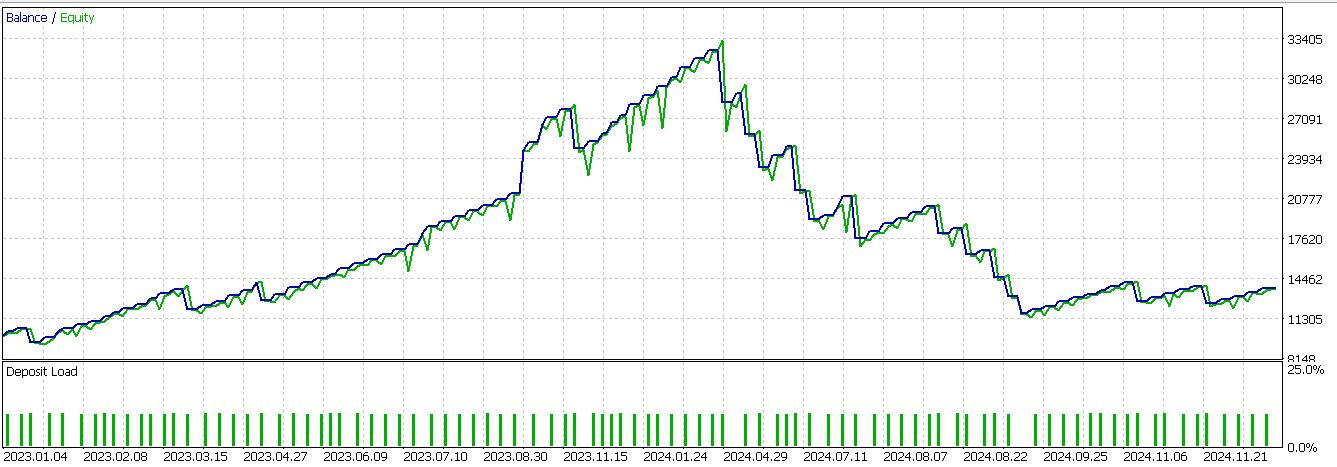
No código acima, atribuímos o valor 1 ao primeiro índice, confirmando a presença de um sinal de alta, quando o AO continua subindo e o preço apresenta uma aceleração clara a partir da região positiva. Também precisamos confirmar que o preço permanece acima da banda inferior do envelope e que o movimento não representa um falso repique. O segundo índice recebe o valor 1 quando o AO apresenta inicialmente um valor negativo e continua caindo, embora possa posteriormente subir devido a uma correção, enquanto o preço mantém uma forte tendência de baixa, abaixo da banda inferior do envelope. Em seguida, atribuímos zero às duas primeiras posições, assim como fizemos com o atributo 4. Nos testes do atributo 8, ainda não conseguimos obter um resultado lucrativo no teste forward. Confira o relatório:
Atributo 9
A lógica principal do nosso último padrão de sinais, como mencionamos no artigo anterior, consiste em identificar um sinal de alta quando o AO inverte sua direção, mas permanece acima da linha zero, enquanto o preço recua até a linha central do envelope e volta a subir. No caso do sinal de baixa, o AO sobe, mas permanece abaixo da linha zero, enquanto o preço avança até a linha central do envelope, sem conseguir ultrapassá-la. Sua implementação em Python é a seguinte:
def feature_9(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 9.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['AO'].shift(2) > df['AO'].shift(1)) &
                     (df['AO'].shift(1) > df['AO']) &
                     (df['AO'] > 0.0) &
                     (df['close'].shift(2) > df['Envelope_Mid'].shift(2)) &
                     (df['close'].shift(1) <= df['Envelope_Mid'].shift(1)) &
                     (df['close'] > df['Envelope_Mid'])).astype(int)

    feature[:, 1] = ((df['AO'].shift(2) < df['AO'].shift(1)) &
                     (df['AO'].shift(1) < df['AO']) &
                     (df['AO'] < 0.0) &
                     (df['close'].shift(2) < df['Envelope_Mid'].shift(2)) &
                     (df['close'].shift(1) >= df['Envelope_Mid'].shift(1)) &
                     (df['close'] < df['Envelope_Mid'])).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
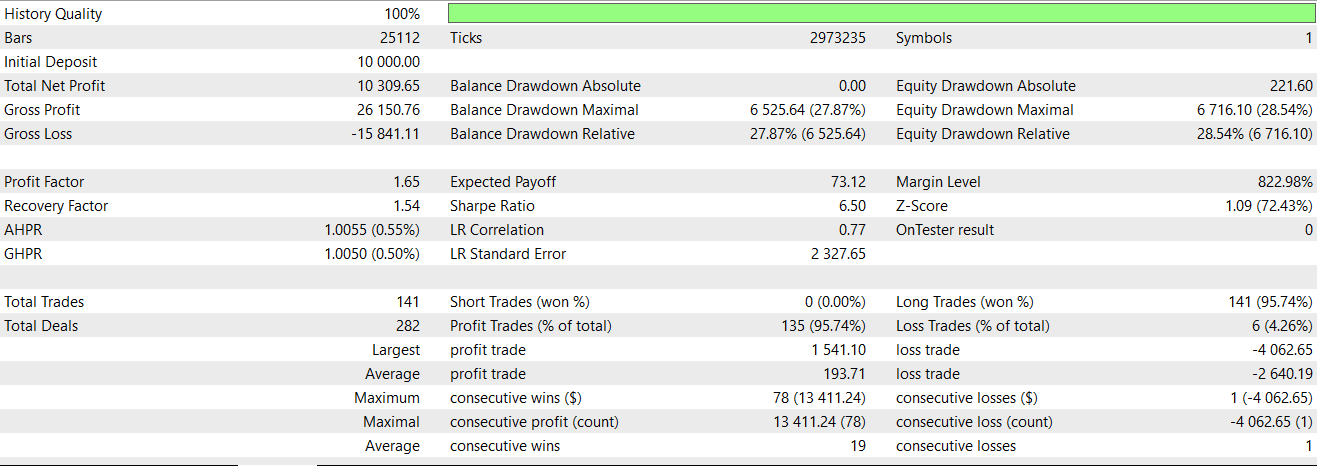
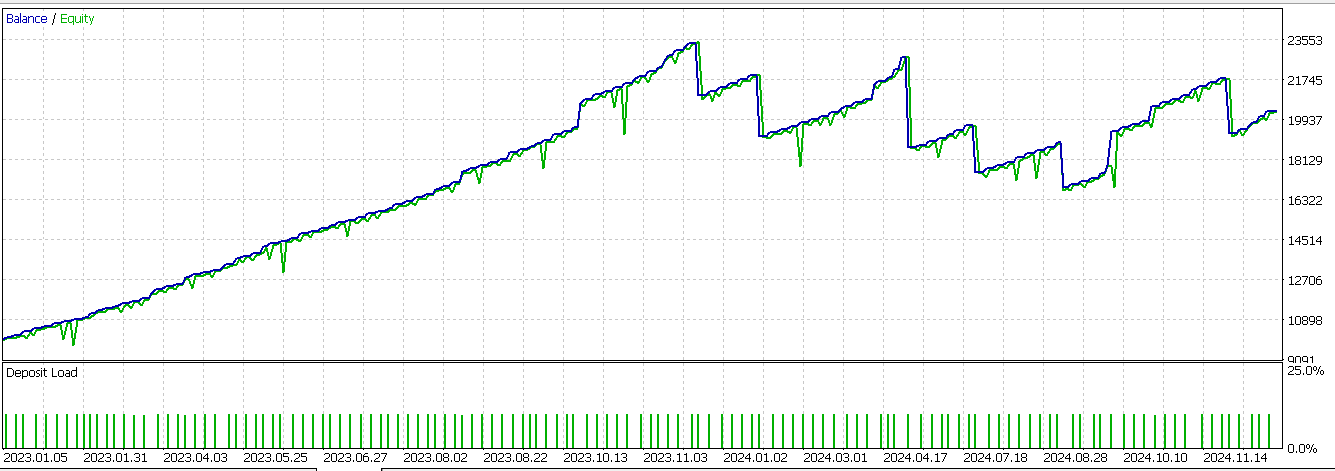
A lógica de implementação segue a mesma abordagem das duas funções analisadas anteriormente. Por isso, não vou repetir os principais pontos já discutidos. Os testes do nosso último padrão apresentam um resultado favorável no teste forward. O relatório é apresentado a seguir:
Conclusão
Analisamos a integração do machine learning, especificamente por meio de uma CNN com kernel de produto escalar e mecanismo de atenção temporal cruzada, para aprimorar os sinais do AO e dos canais de envelopes. Nos testes realizados, concentramos nossa análise em três padrões avaliados anteriormente (4, 8 e 9), buscando determinar se a inclusão de uma filtragem mais avançada por rede neural poderia melhorar a precisão de suas previsões.
Nossa abordagem de CNN dinâmica apresentou resultados promissores, especialmente para os atributos 4 e 9, nos quais conseguimos reduzir os prejuízos de testes forward que anteriormente haviam apresentado resultados desfavoráveis. O mecanismo de atenção do nosso kernel permitiu que a rede adaptasse dinamicamente tanto os tamanhos dos kernels quanto o número de canais de acordo com a relevância temporal dos dados, possibilitando identificar padrões mais complexos no comportamento do mercado. Essa capacidade de adaptação mostrou-se particularmente útil no contexto dos mercados financeiros não estacionários. Isso ocorre porque modelos com arquiteturas rígidas geralmente apresentam desempenho inferior diante de mudanças na volatilidade, na dinâmica das tendências ou no regime de mercado.
Entretanto, nem todos os resultados foram positivos. O atributo 8, que depende fortemente de um momentum direcional sustentado, não conseguiu gerar lucro, mesmo com a maior capacidade de adaptação da CNN. Isso sugere que determinados sinais possuem um potencial limitado, independentemente dos aprimoramentos aplicados ao modelo, reforçando a importância da seleção dos indicadores e sinais utilizados em uma estratégia de trading. Além do aprendizado supervisionado, que exploramos neste artigo, podemos voltar a considerar o aprendizado por reforço como uma alternativa para aprimorar nossos sinais. Em artigos futuros, poderemos explorar essa possibilidade no contexto das funções discutidas neste artigo.
| Arquivo | Descrição |
|---|---|
| WZ-76.mq5 | EA gerado pelo Assistente MQL5, com os arquivos utilizados incluídos no cabeçalho |
| SignalWZ-76.mqh | Classe de sinais personalizada utilizada pelo Assistente MQL5 na criação do EA |
| 76-4.onnx | Rede exportada para o padrão de sinais 4 |
| 76-8.onnx | Rede exportada para o padrão de sinais 8 |
| 76-9.onnx | Rede exportada para o padrão de sinais 9 |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18878
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.



