
Técnicas do MQL5 Wizard que você deve conhecer (Parte 60): Aprendizado por Inferência (Wasserstein-VAE) com Padrões da Média Móvel e do Oscilador Estocástico
 20
 0

Introdução
Ao analisar os padrões gerados pela combinação da MA com o Oscilador Estocástico, recorremos ao machine learning como uma forma de sistematizar nossa abordagem. Existem principalmente três métodos de treinamento de redes em machine learning: aprendizado supervisionado, aprendizado por reforço e inferência. Partindo da ideia de que cada um desses métodos de aprendizado pode ser utilizado em diferentes etapas do desenvolvimento de um modelo ou rede, defendemos que um modelo pode ser aprimorado ao incorporar todos eles.
Breve Recapitulação
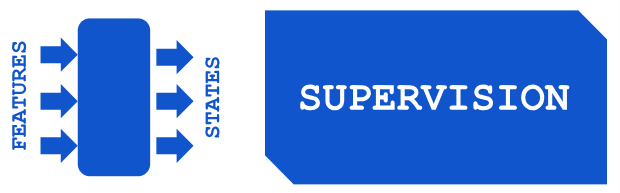
Fazendo uma breve recapitulação, em nosso artigo anterior sobre aprendizado supervisionado, modelamos o mapeamento de features para states. As features correspondem aos padrões dos indicadores MA e Oscilador Estocástico. Os states representam mudanças previstas no preço que ocorrem com defasagem em relação aos padrões dos indicadores e que são previstas pelo nosso modelo/rede. O diagrama simples abaixo ajuda a ilustrar esse processo.
O uso do termo ‘states’ para representar as variações previstas de preço é bastante apropriado, pois, a partir do aprendizado supervisionado, avançamos para o aprendizado por reforço. Como já é estabelecido no aprendizado por reforço, os states constituem um dos principais pontos de partida do processo de treinamento, que pode ser representado de maneira semelhante ao diagrama abaixo.
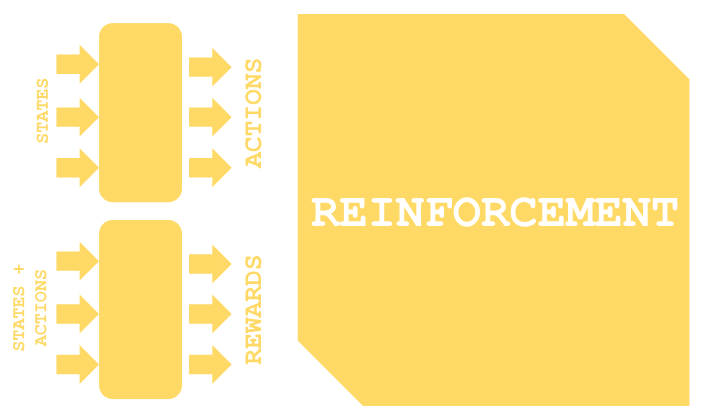
Existem diversas variações de aprendizado por reforço, dependendo do algoritmo utilizado, mas, em geral, muitas delas utilizam duas redes. A primeira é a policy network, representada pela rede superior no diagrama acima, enquanto a segunda é a value network, representada pela rede inferior.
O aprendizado por reforço pode ser utilizado como único método de treinamento de um modelo ou sistema. No entanto, no artigo anterior, argumentamos que ele também pode ser utilizado em modelos já implantados em produção. Nesse caso, o equilíbrio entre exploration e exploitation torna-se especialmente relevante para garantir que um modelo já treinado consiga se adaptar às mudanças nas condições de mercado. Além disso, vimos como as decisões de assumir posições compradas ou vendidas podem ser processadas posteriormente para selecionar o tipo de ação mais adequado para um state previsto.
Inferência
Isso nos leva à inferência, também conhecida como aprendizado não supervisionado. Qual é o objetivo da inferência? Quando comecei a refletir sobre essa questão, minha ideia inicial era que ela nos permitiria utilizar redes ou modelos treinados para uma determinada situação e, com pequenos ajustes e refinamentos, aplicá-los a outro contexto. Para os traders, isso significaria, por exemplo, treinar um modelo para EURUSD e, com pequenos ajustes, transferir esse conhecimento para EURJPY. No entanto, como muitos traders podem confirmar, até mesmo desenvolver um Expert Advisor que não seja baseado em arbitragem e consiga operar simultaneamente mais de um símbolo é um processo complexo, com uma relação risco-retorno que pode ser problemática.
Além disso, o custo computacional necessário para treinar diferentes modelos em vários pares de moedas já não é tão proibitivo quanto no passado. Isso se deve, em grande parte, às GPUs mais rápidas e à ampla disponibilidade da infraestrutura em nuvem, que tornou esses recursos acessíveis a um número muito maior de usuários. Em teoria, esse cenário deveria favorecer a criação de um grande número de modelos. Embora os custos de armazenamento também estejam diminuindo — especialmente considerando que grandes modelos com milhões de parâmetros agora podem ser armazenados como arquivos comuns de computador —, acredito que a inferência por meio de encoders apresenta uma alternativa interessante para compactar esse conhecimento e torná-lo mais fácil de armazenar.
Como a necessidade de armazenamento adicional ou especializado tornou-se quase irrelevante, devido ao seu baixo custo, esse benefício poderia ser facilmente ignorado. Isso é especialmente válido quando consideramos que, com um modelo de aprendizado supervisionado já treinado e um sistema de aprendizado por reforço implementado para mantê-lo atualizado, surge uma questão natural: o que a inferência acrescentaria? Nosso argumento é que nem todos os dados estão disponíveis na forma de séries temporais contínuas.
Se considerarmos dados históricos antigos que possam apresentar alguma semelhança com eventos atuais ou ainda em desenvolvimento, a inferência pode ajudar a estabelecer essa correspondência, reduzindo ao mesmo tempo o ruído branco. Por correspondência, estamos nos referindo à estrutura apresentada no diagrama abaixo:
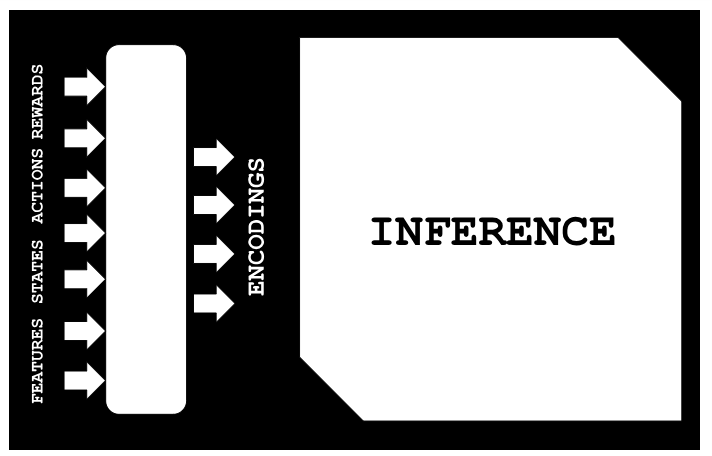
Assim, em uma situação na qual temos disponíveis as features dos dados históricos, mostraremos a seguir como podemos inferir, sem supervisão — neste caso, utilizando regressão linear —, os respectivos states-actions-rewards. Isso é possível porque treinamos um modelo Variational Autoencoder para relacionar features-states-actions-rewards (FSAR) a uma camada latente, que chamaremos de encodings. Com datasets contendo FSAR e encodings, ajustamos um modelo de regressão linear que nos ajuda a preencher os valores ausentes em um dataset FSAR. Essa será a principal aplicação que exploraremos neste artigo.
No entanto, se analisarmos de forma mais ampla os processos de aprendizado supervisionado e aprendizado por reforço, fica evidente que, com o passar do tempo, aumenta a necessidade de integrar de maneira mais abrangente o conhecimento adquirido. Embora seja possível realizar uma nova etapa de aprendizado supervisionado utilizando esse período mais extenso e, posteriormente, executar o aprendizado por reforço, o aprendizado por inferência pode representar uma alternativa mais escalável e abrangente.
Para concluir nossa introdução, inferência é o processo de estimar variáveis ocultas a partir de dados observados. Em modelos bayesianos, a inferência geralmente consiste em calcular a distribuição posterior das variáveis ocultas a partir dos datasets apresentados na camada visível. Matematicamente, portanto, ela pode ser definida formalmente da seguinte maneira:
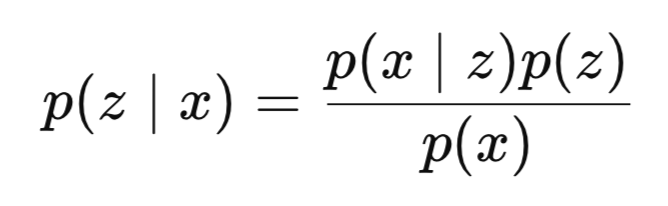
Onde:
- z é a variável latente, ou os encodings,
- x representa os dados observados, que, em nosso caso, correspondem ao FSAR,
- p(z∣x) é a distribuição posterior — aquilo que queremos aprender —, ou seja, a probabilidade de observar z dado que x foi observado,
- p(x∣z) é a likelihood, ou a probabilidade de observar x dado z,
- p(z) é a distribuição prior,
- p(x) é a evidence.
P(x) geralmente é intratável ou difícil de calcular.
Por que é difícil? O denominador, p(x), envolve uma integração sobre todas as possíveis variáveis latentes:
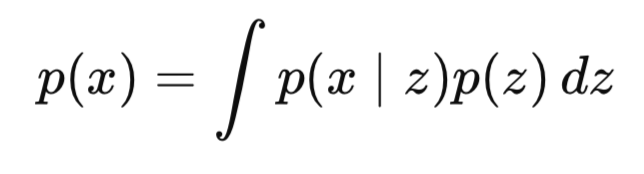
O denominador, p(x), envolve uma integração sobre todas as possíveis variáveis latentes:
Como os VAEs podem ajudar? Os VAEs transformam o problema de inferência aproximada em uma tarefa de otimização. Isso é feito por meio da introdução de um encoder/inference network e de um decoder/generative network. O encoder busca determinar q(z|x), que representa uma aproximação aprendida da posterior, enquanto a rede decodificadora modela p(x|z), responsável pela reconstrução dos dados — em nosso caso, FSAR — a partir do código latente (encodings).
A principal inovação dos VAEs, no entanto, é que, em vez de calcular exatamente a distribuição posterior, o VAE otimiza o Evidence Lower Bound (ELBO). O ELBO é a função objetivo utilizada para treinar VAEs, aproximando a verdadeira distribuição dos dados e, ao mesmo tempo, garantindo que o modelo aprenda representações latentes significativas e com menos ruído. Esta é a ideia principal:
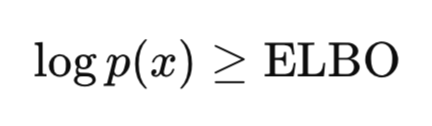
Como já mencionado anteriormente, calcular p(x) é muito difícil e computacionalmente intratável. No entanto, demonstrar que p(x) — e, consequentemente, log p(x) — é maior do que determinado valor é algo viável e computacionalmente tratável. Como nosso objetivo é maximizar p(x), ao maximizar ou elevar seu limite inferior, também acabamos aumentando p(x). O VAE aprende a inferir a estrutura latente a partir dos dados e é treinado de ponta a ponta por meio de gradient descent. Dessa forma, ele reúne em uma única estrutura tanto a inferência amortizada quanto a modelagem generativa.
Por que o VAE é fundamental para a filosofia da inferência? Porque o VAE aprende a realizar a inferência por meio do encoder. Isso significa que, em vez de resolver o problema de inferência sempre que um novo conjunto de dados é apresentado, utiliza-se um encoder compartilhado. Esse processo também é conhecido como inferência amortizada. Essa é uma excelente ferramenta para avaliar o trade-off entre fidelidade e regularidade, além de ajudar a compreender, de maneira geral, como as variáveis latentes representam a estrutura generativa dos dados.
Neste artigo, implementaremos o VAE explorando a Distância de Wasserstein em vez da tradicional KL-divergence para comparar distribuições. Os motivos para essa escolha são principalmente exploratórios, já que poderemos abordar a KL-divergence em artigos futuros. No entanto, argumenta-se que a KL-divergence impõe restrições excessivas ao espaço latente, o que, por sua vez, pode levar ao posterior collapse. Além disso, a Distância de Wasserstein é considerada uma métrica mais flexível para comparar distribuições, especialmente em situações nas quais as distribuições analisadas apresentam pouca ou nenhuma sobreposição.
A ideia central da Distância de Wasserstein é medir o “custo” necessário para transformar uma distribuição de probabilidade em outra. Por esse motivo, ela também é conhecida como Earth Mover's Distance. Ela é representada pela seguinte equação:
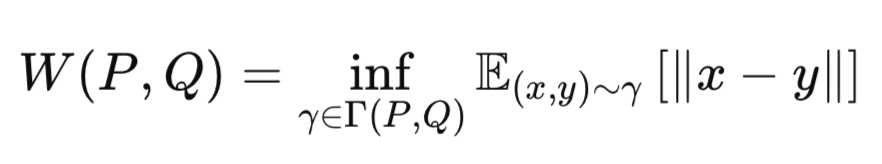
Onde:
-
P: distribuição verdadeira dos dados (por exemplo, a distribuição prior gaussiana p(z)).
-
Q: distribuição aproximada (por exemplo, a saída do encoder q(z∣x)).
-
γ: distribuição conjunta (coupling) entre P e Q.
-
Γ(P,Q): conjunto de todos os possíveis couplings entre P e Q.
-
∥x−y∥: métrica de distância (por exemplo, distância Euclidiana).
-
inf: ínfimo (maior limite inferior, ou seja, o menor custo de transporte possível).
Portanto, a Distância de Wasserstein calcula a menor quantidade de “trabalho” necessária para mover a massa de Q de modo que ela corresponda a P. O Wasserstein VAE é importante porque produz amostras mais nítidas e representações latentes mais expressivas. De modo geral, também é considerado mais estável durante o treinamento sob determinadas condições.
Existem principalmente duas implementações comuns do Wasserstein VAE: WVAE-MMD e WVAE-GAN. A primeira utiliza Maximum Mean Discrepancy para comparar p(z) e q(z). Essa será a abordagem utilizada neste artigo. Como observação, a segunda abordagem, WVAE-GAN, utiliza adversarial loss para alinhar as distribuições latentes. Também poderemos explorar essa implementação em artigos futuros. A Maximum Mean Discrepancy é representada pela seguinte equação:
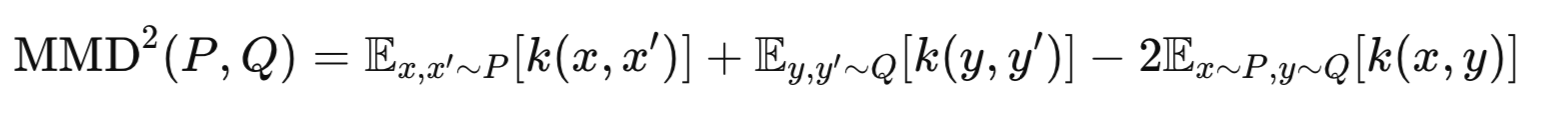
Onde:
-
P: distribuição prior verdadeira (por exemplo, p(z)=N(0,I)).
-
Q: distribuição do encoder (por exemplo, q(z∣x)).
-
k(⋅,⋅): função kernel (por exemplo, Gaussian RBF).
-
x,x′: duas amostras independentes de P.
-
y,y′: duas amostras independentes de Q.
Implementação do VAE
Começamos implementando nossos modelos/redes em Python, principalmente porque é mais prático treiná-los nesse ambiente do que diretamente em MQL5. Existem alternativas em MQL5 que utilizam OpenCL e podem reduzir essa diferença de desempenho. No entanto, ainda não exploramos essas abordagens nesta série. Implementamos uma classe Wasserstein VAE em Python da seguinte maneira:
class WassersteinVAEUnsupervised(nn.Module):
    def __init__(self, feature_dim, encoding_dim, k_neighbors=5):
        super().__init__()
        self.encoding_dim = encoding_dim
        self.k_neighbors = k_neighbors

        # Feature encoder
        self.feature_encoder = nn.Sequential(
            nn.Linear(feature_dim, 256),
            nn.ReLU(),
            nn.Linear(256, 128),
            nn.ReLU(),
            nn.Linear(128, encoding_dim * 2)  # mean and logvar
        )

        # Buffer for storing training references
        self.register_buffer('ref_encoding', torch.zeros(1, encoding_dim))
        self.register_buffer('ref_states', torch.zeros(1, 1))
        self.register_buffer('ref_actions', torch.zeros(1, 1))
        self.register_buffer('ref_rewards', torch.zeros(1, 1))
        self._references_loaded = False

    def encode(self, features):
        h = self.feature_encoder(features)
        z_mean, z_logvar = torch.chunk(h, 2, dim=1)
        return z_mean, z_logvar

    def reparameterize(self, mean, logvar):
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mean + eps * std

    def update_references(self, encoding_vectors, states, actions, rewards):
        """Store reference data for unsupervised prediction"""
        self.ref_encoding = encoding_vectors.detach().clone()
        self.ref_states = states.detach().clone().unsqueeze(-1)
        self.ref_actions = actions.detach().clone().unsqueeze(-1)
        self.ref_rewards = rewards.detach().clone().unsqueeze(-1)
        self._references_loaded = True

    def knn_predict(self, z, ref_values):
        # z shape: [batch_size, encoding_dim]
        # ref_values shape: [ref_size, 1] or [ref_size]

        # Ensure ref_values is properly shaped
        ref_values = ref_values.view(-1)  # Flatten to [ref_size]

        # Calculate distances between z and reference encodings
        distances = torch.cdist(z, self.ref_encoding)  # [batch_size, ref_size]

        # Get top-k nearest neighbors
        _, indices = torch.topk(distances, k=self.k_neighbors, largest=False)  # [batch_size, k]

        # Gather corresponding reference values
        neighbor_values = torch.gather(
            ref_values.unsqueeze(0).expand(indices.size(0), -1),  # [batch_size, ref_size]
            1,
            indices
        )  # [batch_size, k]

        # Average the nearest values
        predictions = neighbor_values.mean(dim=1, keepdim=True)  # [batch_size, 1]

        return predictions

    def gaussian_predict(self, z, ref_values):
        # Input validation
        assert z.dim() == 2, "z must be 2D [batch, encoding]"
        assert ref_values.dim() == 2, "ref_values must be 2D"

        # Calculate distances (Euclidean)
        distances = torch.cdist(z, self.ref_encoding)  # [batch, ref_size]

        # Convert to similarities (Gaussian weights)
        weights = torch.softmax(-distances, dim=1)  # [batch, ref_size]

        # Prepare reference values
        ref_values = ref_values.squeeze(-1) if ref_values.size(1) == 1 else ref_values
        ref_values = ref_values.unsqueeze(0) if ref_values.dim() == 1 else ref_values

        # Ensure proper shapes
        ref_values = ref_values.view(-1, 1)  # Force [792, 1] shape

        # Calculate distances
        distances = torch.cdist(z, self.ref_encoding)  # [batch_size, 792]

        # Convert to weights
        weights = torch.softmax(-distances, dim=1)  # [batch_size, 792]

        # Matrix multiplication Weighted combination
        predictions = torch.matmul(weights, ref_values)  # [batch, 1]

        return predictions.unsqueeze(-1) if predictions.dim() == 1 else predictions

    def linear_predict(self, z, ref_values):
        """Linear regression prediction using normal equations"""
        # Add bias term
        X = torch.cat([self.ref_encoding, torch.ones_like(self.ref_encoding[:, :1])], dim=1)
        y = ref_values

        # Compute closed-form solution
        XtX = torch.matmul(X.T, X)
        Xty = torch.matmul(X.T, y)
        theta = torch.linalg.solve(XtX, Xty)

        # Predict with new z values
        X_new = torch.cat([z, torch.ones_like(z[:, :1])], dim=1)
        return torch.matmul(X_new, theta)

    def predict_from_encoding(self, z):
        if not self._references_loaded:
            raise RuntimeError("Reference data not loaded")

        # Validate reference shapes
        self.ref_states = self.ref_states.view(-1, 1)
        self.ref_actions = self.ref_actions.view(-1, 1)
        self.ref_rewards = self.ref_rewards.view(-1, 1)

        states = self.knn_predict(z, self.ref_states)
        actions = self.gaussian_predict(z, self.ref_actions)
        rewards = self.linear_predict(z, self.ref_rewards)

        return states, actions, rewards

    def forward(self, features, states=None, actions=None, rewards=None):
        z_mean, z_logvar = self.encode(features)
        z = self.reparameterize(z_mean, z_logvar)

        if states is not None and actions is not None and rewards is not None:
            return {
                'z': z,
                'z_mean': z_mean,
                'z_logvar': z_logvar
            }
        else:
            pred_states, pred_actions, pred_rewards = self.predict_from_encoding(z)
            return {
                'states': pred_states,
                'actions': pred_actions,
                'rewards': pred_rewards
            }
Nossa implementação do Wasserstein VAE apresentada acima é composta principalmente por quatro elementos: um feature encoder, buffers de referência, métodos de previsão e um forward pass de modo duplo. O feature encoder é uma MLP de três camadas cuja função é comprimir os inputs nos parâmetros do espaço latente (z, z-mean e z-logvar). Os buffers de referência armazenam os inputs de um modelo pré-treinado referentes a features, states, actions e rewards, juntamente com seus respectivos encodings. Os métodos de previsão apresentados são utilizados para estimar states, actions e rewards em um dataset incompleto que contém apenas as features. Esses métodos são K-NN, Gaussian Weighting e Linear Regression. Eles operam no espaço latente, mapeando os encodings para os dados ausentes de states-actions-rewards. O forward pass de modo duplo é responsável tanto pelo treinamento quanto pela inferência.
Os principais componentes funcionais são o processo de encoding, o sistema de referência, os mecanismos de previsão e o fluxo de inferência. Durante o processo de encoding, as features-states-actions-rewards de entrada passam pela rede encoder. A saída transforma esses inputs em um ‘encoding’ composto por z, z-mean e z-log-var. Nesse processo, o reparameterization trick também permite realizar uma amostragem diferenciável. O sistema de referência armazena as saídas ‘congeladas’ juntamente com seus respectivos pares de inputs FSAR. Esse sistema exige inicialização explícita por meio da função update_references().
Os três mecanismos de previsão têm como objetivo estimar states, actions ou rewards. Nosso modelo parte do princípio de que as features estão sempre disponíveis como parte do dataset FSAR. No entanto, podem existir situações em que apenas SAR (states-actions-rewards) esteja ausente. O KNN é utilizado para mapear os states, ponderação gaussiana para mapear as actions e Linear Regression para mapear os rewards. Assim, o fluxo de inferência codifica nossas features de entrada no espaço latente, seleciona o método de previsão correspondente a cada tipo de input com base nas associações mencionadas anteriormente e, em seguida, retorna as respectivas estimativas de state/action/reward.
No entanto, algumas melhorias podem ser feitas na abordagem apresentada acima. De modo geral, elas podem ser agrupadas em três categorias: melhorias arquiteturais, melhorias no treinamento e melhorias de robustez. Entre as melhorias arquiteturais estão: adicionar spectral normalization para impor Lipschitz continuity; implementar uma temperature ajustável para o Gaussian Process weighting; incluir gerenciamento da memória de referência (FIFO/Pruning); e adicionar Monte Carlo sampling para estimar a incerteza. O processo de treinamento também pode ser aprimorado por meio da introdução de gradient penalty para as restrições de Wasserstein; da adição de regularização do espaço latente (termos MMD/coverage); da implementação da seleção adaptativa dos métodos de previsão; e da combinação dos métodos de previsão por meio de ensemble weighting.
As melhorias relacionadas à robustez são um pouco menos definidas. Ainda assim, algumas possibilidades incluem: capacidade de detecção de out-of-distribution; sistema de pontuação da qualidade das referências; ajuste dinâmico do tamanho da vizinhança; e escalonamento de ruído dependente dos inputs.
Implementação da MMD-Loss
A versão do Wasserstein VAE que estamos implementando utiliza MMD-Loss, e as duas funções de loss utilizadas em nosso VAE são apresentadas abaixo:
def mmd_loss(y_true, y_pred, kernel_mul=2.0, kernel_num=5):
    """
    MMD loss using Gaussian RBF kernel.
    Args:
        y_true: Ground truth samples (shape: [batch_size, dim])
        y_pred: Predicted samples (shape: [batch_size, dim])
        kernel_mul: Multiplier for kernel bandwidths
        kernel_num: Number of kernels to use
    Returns:
        MMD loss (scalar)
    """
    batch_size = y_true.size(0)

    # Combine real and predicted samples
    xx = y_true
    yy = y_pred
    xy = torch.cat([xx, yy], dim=0)

    # Compute pairwise distances
    distances = torch.cdist(xy, xy, p=2)

    # Compute MMD using multiple RBF kernels
    loss = 0.0
    for sigma in [kernel_mul ** k for k in range(-kernel_num, kernel_num + 1)]:
        if sigma == 0:
            continue
        kernel_val = torch.exp(-distances ** 2 / (2 * sigma ** 2))
        k_xx = kernel_val[:batch_size, :batch_size]
        k_yy = kernel_val[batch_size:, batch_size:]
        k_xy = kernel_val[:batch_size, batch_size:]

        # MMD formula: E[k(x,x)] + E[k(y,y)] - 2*E[k(x,y)]
        loss += (k_xx.mean() + k_yy.mean() - 2 * k_xy.mean())

    return loss / (2 * kernel_num)

def compute_loss(predictions, batch):
    # Ensure shapes match (squeeze if needed)
    pred_states = predictions['states'].squeeze(-1)  # [B, 1] → [B]
    pred_actions = predictions['actions'].squeeze(-1)
    pred_rewards = predictions['rewards'].squeeze(-1)

    # MMD Loss (distributional matching)
    mmd_state = mmd_loss(batch['states'], pred_states)
    mmd_action = mmd_loss(batch['actions'], pred_actions)
    mmd_reward = mmd_loss(batch['rewards'], pred_rewards)

    # Combine losses (adjust weights as needed)
    total_loss = mmd_state + mmd_action + mmd_reward

    return {
        'loss': total_loss,
        'mmd_state': mmd_state,
        'mmd_action': mmd_action,
        'mmd_reward': mmd_reward
    }
Os parâmetros de entrada da função MMD-Loss são y_true e y_pred. Eles representam uma comparação entre as amostras reais (ground truth) e as amostras geradas. O alinhamento das dimensões dessas amostras é importante para que a comparação possa ser realizada corretamente. Os inputs kernel_mul/kernel_num controlam as larguras de banda do kernel RBF e, consequentemente, afetam a sensibilidade às diferenças entre distribuições em diferentes escalas.
A combinação das amostras, xy, reúne as amostras reais e geradas para calcular todas as distâncias entre pares em uma única operação. Isso proporciona maior eficiência de memória e garante consistência no cálculo das distâncias. O cálculo da distância utiliza p=2 (distância Euclidiana), que é o padrão para MMD. Essa escolha influencia diretamente a sensibilidade às diferenças entre as distribuições. A operação ‘cdist’ é o elemento central do cálculo do ponto de vista matemático, pois a MMD depende das comparações entre pares.
A abordagem multi-kernel utiliza larguras de banda geometricamente espaçadas (kernel_mul^k) para capturar características das distribuições em diferentes escalas. Ela também evita o cenário sigma=0, que resultaria em divisões por zero. Cada kernel contribui igualmente para a loss final por meio do cálculo da média. O cálculo da MMD utiliza a fórmula central (k_xx + k_yy - 2k_xy), que quantifica as diferenças entre as distribuições. As operações de média fornecem estimativas das expectativas a partir de amostras finitas, enquanto a normalização pela quantidade de kernels mantém a escala da loss consistente entre diferentes configurações.
A MMD pode ser aprimorada por meio da seleção dos kernels. Entre as possibilidades estão: adicionar uma seleção adaptativa da largura de banda com base nas estatísticas das amostras; realizar experimentos com kernels diferentes do RBF para identificar quais são mais adequados a determinados tipos de dados; e implementar Automatic Relevance Determination para as larguras de banda. Também é possível melhorar a estabilidade numérica por meio da adição de um pequeno epsilon ao denominador; da implementação de cálculos no domínio logarítmico para valores de kernel muito pequenos; e da limitação de valores extremos de distância para evitar overflow. Outras melhorias podem abranger a eficiência computacional e a integração com o VAE.
Há uma quantidade considerável de código adicional necessária para executar essa inferência que não estamos destacando explicitamente aqui. No entanto, vale observar que a geração dos dados de entrada FSAR utiliza o código apresentado nos dois artigos anteriores sobre a MA e o Oscilador Estocástico. O artigo sobre aprendizado supervisionado fornece os componentes features e states dos inputs do nosso VAE, enquanto o código do artigo sobre aprendizado por reforço fornece actions e rewards.
Implementação da Linear Regression
Para utilizar nosso modelo de inferência, dependemos exclusivamente das funções de regressão que fazem o mapeamento da camada latente para os inputs ausentes, e não da própria rede VAE. Isso difere do que fizemos nos artigos anteriores, nos quais precisávamos exportar a rede treinada como um arquivo ONNX.
Isso ocorre porque nosso objetivo é completar o dataset de entrada de um VAE que já foi treinado.
Daqui em diante, teremos apenas os dados das features. Portanto, a questão passa a ser: quais são os states, actions e rewards correspondentes a essas features? Para responder a essa pergunta, durante a inicialização do nosso Expert Advisor, precisamos treinar um modelo de Linear Regression utilizando datasets formados por pares de features-encodings, states-encodings, actions-encodings e rewards-encodings. Com nosso modelo de Linear Regression treinado (ou ajustado), para qualquer novo ponto de dados das features, podemos mapeá-lo para um encoding e, em seguida, utilizar esse encoding no mesmo modelo para realizar o mapeamento de volta para states, actions e rewards.
Esse processo de ajuste utilizado para estabelecer as relações com os encodings utiliza aprendizado não supervisionado. Nossa Linear Regression é implementada em MQL5 da seguinte maneira:
//+------------------------------------------------------------------+
// Linear Regressor (unchanged from previous implementation)         |
//+------------------------------------------------------------------+
class LinearRegressor
{
private:
   vector m_coefficients;
   double m_intercept;

   matrix m_coefficients_2d;
   vector m_intercept_2d;

public:
   void Fit(const matrix &X, const vector &y)
   {  int n = (int)X.Rows();
      int p = (int)X.Cols();
      matrix X_with_bias(n, p + 1);
      for(int i = 0; i < n; i++)
      {  for(int j = 0; j < p; j++)
            X_with_bias[i][j] = X[i][j];
         X_with_bias[i][p] = 1.0;
      }
      matrix Xt = X_with_bias.Transpose();
      matrix XtX = Xt.MatMul(X_with_bias);
      matrix XtX_inv = XtX.Inv();
      vector y_col = y;
      y_col.Resize(n, 1);
      vector beta = XtX_inv.MatMul(Xt.MatMul(y_col));
      m_coefficients = beta;
      m_coefficients.Resize(p);
      m_intercept = beta[p];
   }

   void Fit2d(const matrix &X, const matrix &Y)
   {  int n = (int)X.Rows();    // Number of samples
      int p = (int)X.Cols();    // Number of input features
      int k = (int)Y.Cols();    // Number of output encodings
      // Add bias term (column of 1s) to X
      matrix X_with_bias(n, p + 1);
      for(int i = 0; i < n; i++)
      {  for(int j = 0; j < p; j++)
            X_with_bias[i][j] = X[i][j];
         X_with_bias[i][p] = 1.0;
      }
      // Calculate coefficients using normal equation: (X'X)^-1 X'Y
      matrix Xt = X_with_bias.Transpose();
      matrix XtX = Xt.MatMul(X_with_bias);
      matrix XtX_inv = XtX.Inv();
      matrix beta = XtX_inv.MatMul(Xt.MatMul(Y));
      // Split coefficients and intercept
      m_coefficients_2d.Resize(p, k);  // Coefficients for each output encodings
      m_intercept_2d.Resize(k);        // Intercept for each input feature
      for(int j = 0; j < p; j++)
      {  for(int d = 0; d < k; d++)
         {  m_coefficients_2d[j][d] = beta[j][d];
         }
      }
      for(int d = 0; d < k; d++)
      {  m_intercept_2d[d] = beta[p][d];
      }
   }

   double Predict(const vector &x)
   {  return m_intercept + m_coefficients.Dot(x);
   }

   vector Predict2d(const vector &X) const
   {  int p = (int)X.Size();    // Number of input features
      int k = (int)m_intercept_2d.Size(); // Number of output encodings
      vector predictions(k);  // vector to store predictions
      for(int d = 0; d < k; d++)
      {  // Initialize with intercept for this output dimension
         predictions[d] = m_intercept_2d[d];
         // Add contribution from each feature
         for(int j = 0; j < p; j++)
         {  predictions[d] += m_coefficients_2d[j][d] * X[j];
         }
      }
      return predictions;
   }
};
A estrutura principal mantém armazenamentos separados de coeficientes para 1D (nas variáveis m_coefficients/m_intercept) e 2D (nas variáveis m_coefficients_2d/m_intercept_2d). A álgebra matricial é utilizada para proporcionar maior eficiência em algumas operações em lote. A implementação oferece variantes de regressão tanto para uma única saída quanto para múltiplas saídas. Seus métodos de ajuste utilizam a Equação Normal, resolvendo diretamente (X'X)^-1X'y. O bias é tratado adicionando uma coluna de valores 1 às features de entrada. A especialização 2D da classe também permite processar simultaneamente múltiplas saídas por meio de operações matriciais.
Os métodos de previsão utilizam uma implementação baseada em dot product, proporcionando uma combinação linear eficiente entre os inputs e seus respectivos pesos. O tratamento das dimensões é realizado adequadamente tanto para cenários de saída única quanto de múltiplas saídas, enquanto o gerenciamento de memória pré-aloca o vetor de resultados para aumentar a eficiência. Utilizamos uma classe pseudo Wasserstein VAE para chamar e implementar nossas previsões de states, actions e rewards. Essa implementação é feita em MQL5 da seguinte maneira:
//+------------------------------------------------------------------+
// Wasserstein VAE Predictors Implementation (unchanged)             |
//+------------------------------------------------------------------+
class WassersteinVAEPredictors
{
private:
   LinearRegressor m_feature_predictor;
   LinearRegressor m_state_predictor;
   LinearRegressor m_action_predictor;
   LinearRegressor m_reward_predictor;
   bool m_predictors_trained;

public:
   WassersteinVAEPredictors() : m_predictors_trained(false) {}

   void FitPredictors(const matrix &features,
                      const vector &states,
                      const vector &actions,
                      const vector &rewards,
                      const matrix &encodings)
   {  m_feature_predictor.Fit2d(features, encodings);
      m_state_predictor.Fit(encodings, states);
      m_action_predictor.Fit(encodings, actions);
      m_reward_predictor.Fit(encodings, rewards);
      m_predictors_trained = true;
   }

   void PredictFromFeatures(const vector &y, vector &z)
   {  if(!m_predictors_trained)
      {  Print("Error: Predictors not trained yet");
         return;
      }
      z = m_feature_predictor.Predict2d(y);
   }

   void PredictFromEncodings(const vector &z, double &state, double &action, double &reward)
   {  if(!m_predictors_trained)
      {  Print("Error: Predictors not trained yet");
         return;
      }
      state = m_state_predictor.Predict(z);
      action = m_action_predictor.Predict(z);
      reward = m_reward_predictor.Predict(z);
   }
};
Além disso, em nossa classe de sinal personalizada, passamos a utilizar uma função ‘Infer’ para processar nossas previsões. Ela é implementada da seguinte maneira:
//+------------------------------------------------------------------+
//| Inference Learning Forward Pass.                                 |
//+------------------------------------------------------------------+
vector CSignal_WVAE::Infer(int Index, ENUM_POSITION_TYPE T)
{  vectorf _f = Get(Index, m_time.GetData(X()), m_close, m_ma, m_ma_lag, m_sto);
   vector _features;
   _features.Init(_f.Size());
   _features.Fill(0.0);
   for(int i = 0; i < int(_f.Size()); i++)
   {  _features[i] = _f[i];
   }
// Make a prediction
   vector _encodings;
   _encodings.Init(__ENCODINGS);
   _encodings.Fill(0.0);
   double _state = 0.0, _action = 0.0, _reward = 0.0;
   if(Index == 1)
   {  m_vae_1.PredictFromFeatures(_features, _encodings);
      m_vae_1.PredictFromEncodings(_encodings, _state, _action, _reward);
   }
   else if(Index == 2)
   {  m_vae_2.PredictFromFeatures(_features, _encodings);
      m_vae_2.PredictFromEncodings(_encodings, _state, _action, _reward);
   }
   else if(Index == 5)
   {  m_vae_5.PredictFromFeatures(_features, _encodings);
      m_vae_5.PredictFromEncodings(_encodings, _state, _action, _reward);
   }
   vector _inference;
   _inference.Init(3);
   _inference[0] = _state;
   _inference[1] = _action;
   _inference[2] = _reward;
   //
   if(T == POSITION_TYPE_BUY)
   {  if(_state > 0.5)
      {  _inference[0] -= 0.5;
         _inference[0] *= 2.0;
         if(_action < 0.0)
         {  _inference[0] = 0.0;
         }
      }
      else
      {  _inference[0] = 0.0;
      }
   }
   else if(T == POSITION_TYPE_SELL)
   {  if(_state < 0.5)
      {  _inference[0] -= 0.5;
         _inference[0] *= -2.0;
         if(_action > 0.0)
         {  _inference[0] = 0.0;
         }
      }
      else
      {  _inference[0] = 0.0;
      }
   }
   return(_inference);
}
Para os novos leitores, há guias disponíveis aqui e aqui explicando como montar um Expert Advisor utilizando o MQL5 Wizard. No artigo anterior, dos 10 padrões com os quais começamos, apenas os padrões 1, 2 e 5 apresentaram resultados satisfatórios no forward walk. Portanto, as funções de condição long e short deste Expert Advisor processam apenas esses três padrões. Estamos prevendo três valores: states, actions e rewards. Os states estão limitados ao intervalo de 0 a 1. As actions também estão limitadas a um intervalo semelhante, enquanto os rewards variam de -1 a +1. Qualquer pessoa com alguma experiência em treinamento e utilização de redes neurais sabe que, mesmo quando uma rede é treinada com targets que respeitam determinados limites, suas saídas durante os testes ou após a implantação nem sempre permanecem dentro desses intervalos esperados. Por esse motivo, geralmente é necessário aplicar algum tipo de normalização após a execução do forward pass.
Não realizamos nenhuma normalização neste caso. Apenas chamamos a atenção do leitor para esse aspecto, que deve ser considerado ao colocar uma rede treinada em produção. Carregamos no Python dois anos de dados de preços diários do EURUSD para treinar um VAE, que nos fornece um dataset relacionando features-states-actions-rewards aos respectivos encodings. Esse dataset é então utilizado para ajustar modelos de Linear Regression, que posteriormente usamos para mapear states, actions e rewards quando apenas as features são fornecidas. Dos dados carregados, processados por meio do módulo Python do MetaTrader 5, 80% são utilizados para treinamento e os 20% restantes são reservados para testes.
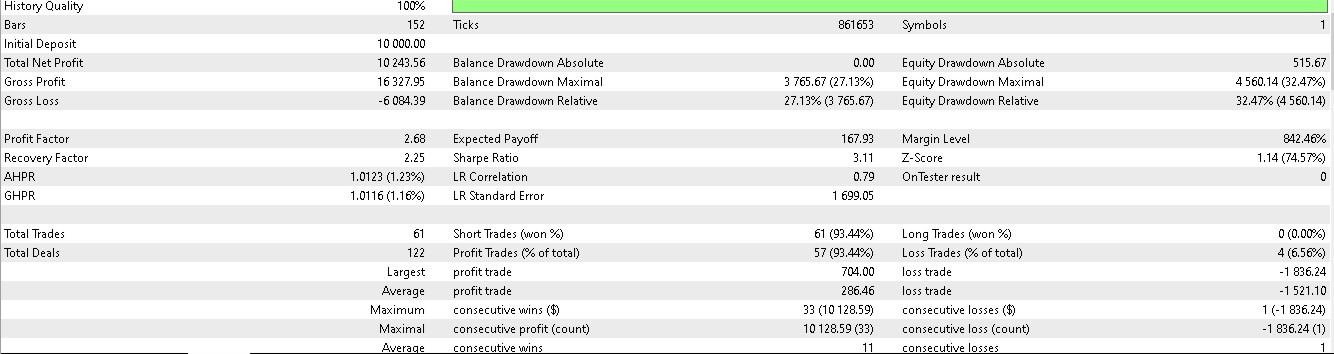
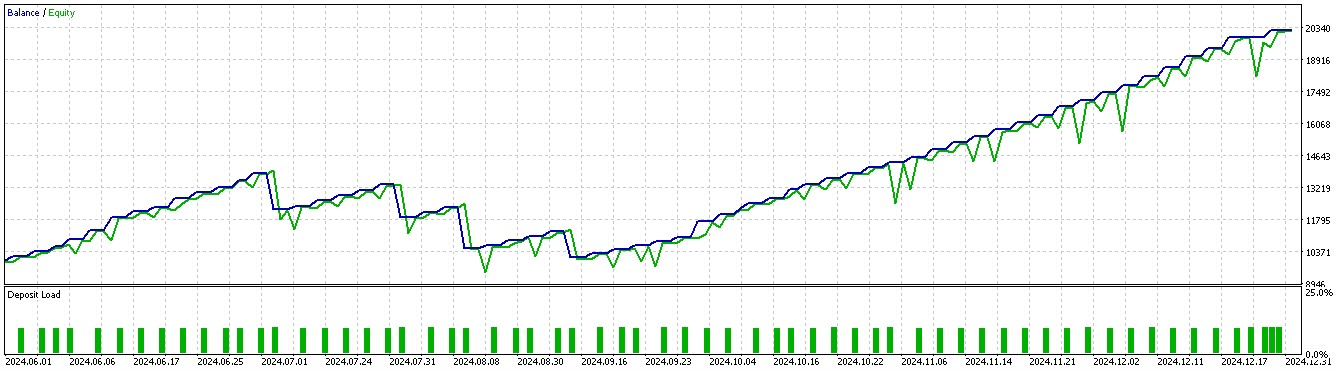
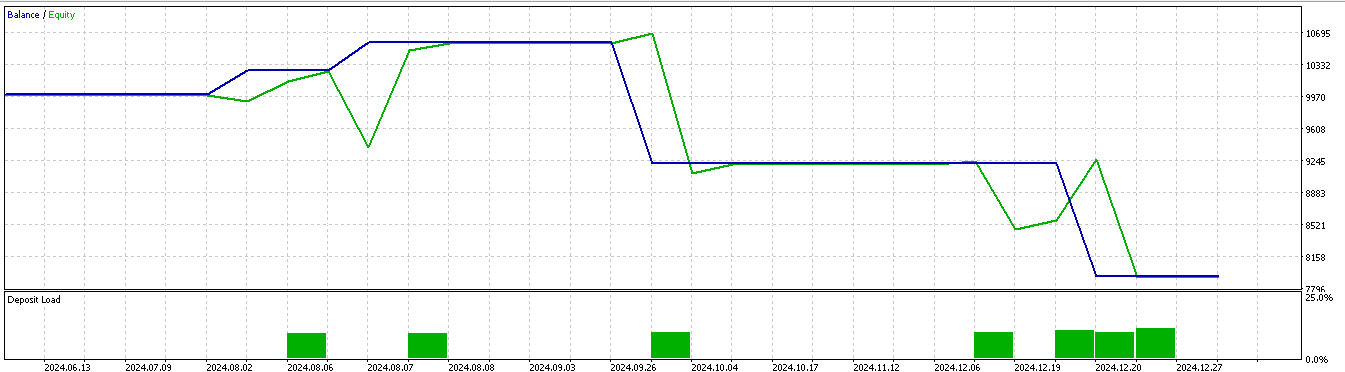
O período dos dados vai de 01.01.2023 a 01.01.2025. Portanto, um forward walk corresponderia aproximadamente aos cinco meses anteriores a 01.01.2025. Realizamos os testes em um período um pouco maior, abrangendo os seis meses anteriores, ou seja, de 01.07.2024 a 01.01.2025, e obtivemos os seguintes relatórios:
Para o padrão 1:
Para o padrão 2:

Para o padrão 5:
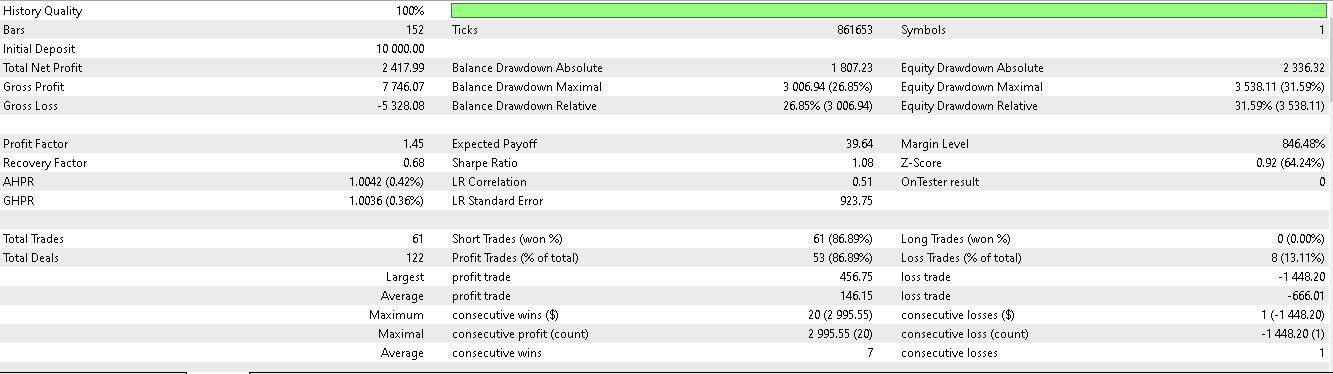
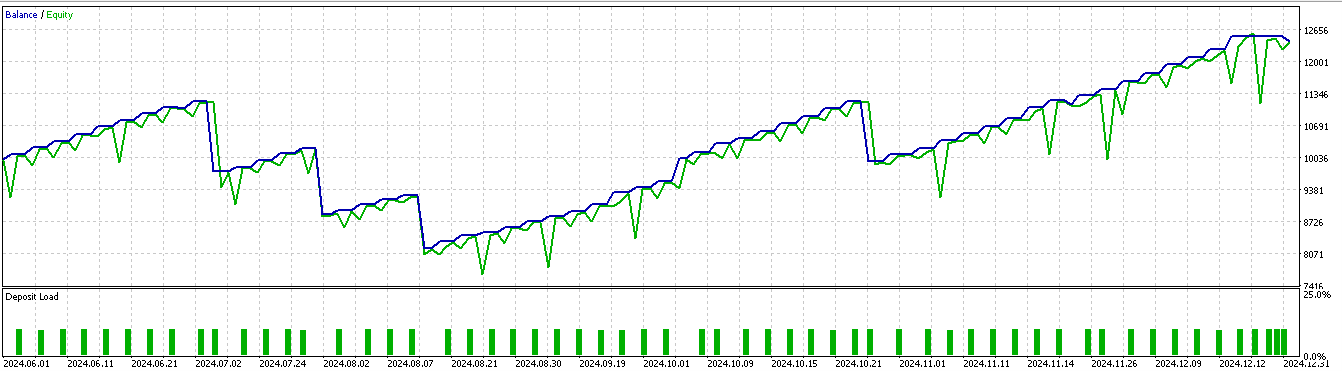
Parece que apenas os padrões 1 e 5 conseguem se beneficiar da inferência utilizando uma janela curta de dois anos para treinamento e teste.
Conclusão
Concluímos nossa análise dos padrões de Média Móvel e Oscilador Estocástico combinados com machine learning explorando o uso do aprendizado por inferência. Apresentamos uma possível abordagem de implementação para o aprendizado por inferência partindo do argumento de que, depois de concluído o aprendizado supervisionado e implementado o aprendizado por reforço em um ambiente de testes em tempo real, ainda existe a necessidade de uma abordagem mais abrangente para reunir e ‘armazenar’ todo o conhecimento adquirido tanto pelo aprendizado supervisionado quanto pelo aprendizado por reforço. Acredito que o aprendizado por inferência esteja bem posicionado para desempenhar esse papel, principalmente porque seu método de aprendizado não duplica simplesmente os métodos que já empregamos ele supervisiona o aprendizado por reforço.
| Nome | Descrição |
|---|---|
| wz_60.mq5 | Expert Advisor montado com o Wizard, incluído como referência para demonstrar os arquivos necessários para sua montagem |
| SignalWZ_60.mqh | Arquivo da classe Signal |
| 60_vae_1.onnx | Modelo VAE em formato ONNX para o padrão 1, não necessário para o Expert Advisor. |
| 60_vae_2.onnx | Modelo VAE em formato ONNX para o padrão 2, igualmente não necessário para o Expert Advisor. |
| 60_vae_5.onnx | Modelo VAE em formato ONNX para o padrão 5, igualmente não necessário para o Expert Advisor. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/17818
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Automatizando Estratégias de Trading em MQL5 (Parte 15): Padrão Harmônico Cypher Baseado em Price Action com Visualização
 Ciência de Dados e ML (Parte 36): Lidando com Mercados Financeiros Tendenciosos
 Está chegando o novo MetaTrader 5 e MQL5
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 67): Uso dos padrões do TRIX e da Faixa Percentual de Williams

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso