

Criação de EAs auto-otimizáveis em MQL5 (Parte 7): Negociação simultânea com indicadores de vários períodos
 17
 0

Os indicadores técnicos oferecem ao investidor moderno inúmeras possibilidades, mas também apresentam diversas dificuldades. Eles possuem várias limitações bem conhecidas, entre elas o atraso inerente ao seu funcionamento.
Nesta discussão, queremos nos concentrar em problemas mais sutis relacionados à escolha do período adequado para um indicador. O período do indicador é um parâmetro comum à maioria dos indicadores técnicos e determina a quantidade de dados históricos utilizada em seus cálculos.
De modo geral, períodos muito curtos fazem com que o indicador técnico capture uma quantidade significativa de ruído do mercado, enquanto períodos excessivamente longos costumam gerar sinais muito depois de o movimento do mercado já ter ocorrido. Em ambos os casos, isso leva à perda de oportunidades de negociação e a resultados insatisfatórios.
A solução proposta neste artigo elimina a dificuldade de determinar um período ideal e, em vez disso, permite utilizar simultaneamente todos os períodos disponíveis. Para isso, analisaremos uma família de algoritmos de machine learning conhecida como algoritmos de redução de dimensionalidade (Dimension Reduction Algorithms), com atenção especial a um algoritmo relativamente recente chamado Uniform Manifold Approximation and Projection (UMAP). Em seguida, mostraremos como essa família de algoritmos nos permite representar de forma significativa todos os dados disponíveis que descrevem o problema, produzindo uma representação mais informativa do que a forma original do conjunto de dados.
Além disso, abordaremos princípios relevantes de programação orientada a objetos (OOP) em MQL5 para criar classes que nos ajudem a gerenciar com eficiência o espaço de nomes, a memória e outras rotinas necessárias às nossas aplicações de negociação. Das quatro classes que desenvolveremos, uma será dedicada a agilizar a criação de aplicações que utilizam modelos ONNX.
Criação das classes necessárias em MQL5
Em nossa discussão anterior sobre EAs auto-otimizáveis, desenvolvemos uma classe RSI que nos forneceu uma forma coerente e estruturada de obter dados do indicador para diversos períodos do RSI. Caso você tenha perdido essa parte, o artigo pode ser encontrado aqui. No entanto, nesta discussão deixaremos o RSI de lado e o substituiremos pelo indicador Williams' Percent Range (WPR).
O WPR costuma ser considerado um oscilador de momentum, e seu intervalo completo de valores vai de 0 a -100. Valores entre 0 e -20 são considerados baixistas, enquanto valores entre -80 e -100 são considerados altistas. Em essência, o indicador funciona comparando o preço atual de determinado símbolo com o valor máximo alcançado durante o período escolhido pelo usuário. Nossa primeira tarefa será criar uma nova classe SingleBufferIndicator, que servirá de base tanto para a classe RSI quanto para a classe WPR. Como as classes RSI e WPR terão a mesma classe base, poderemos manter um comportamento consistente entre ambas. Começaremos definindo a classe SingleBufferIndicator e listando seus membros.
Essa abordagem de projeto oferece várias vantagens. Por exemplo, se futuramente implementarmos uma nova funcionalidade que desejamos disponibilizar em todas as classes de indicadores, precisaremos atualizar apenas uma classe: a classe base no arquivo SingleBufferIndicator.mqh. Depois disso, bastará recompilar as classes derivadas para que as alterações passem a estar disponíveis. A herança é um recurso fundamental da programação orientada a objetos, pois permite gerenciar várias classes de forma eficiente modificando apenas uma delas.
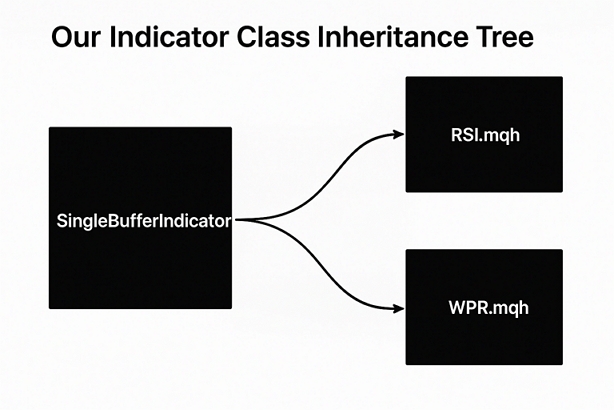
Fig. 1. Visualização da árvore de herança da nossa família de indicadores com um único buffer
Para começar, generalizaremos a funcionalidade utilizada no desenvolvimento da classe RSI para que possa ser aplicada a qualquer indicador que possua apenas um buffer. O MetaTrader 5 oferece todos os indicadores de que precisamos. O fato de estarmos criando uma classe específica para indicadores com um único buffer já deve indicar ao leitor que existem indicadores com mais de um buffer. Ao projetar classes, normalmente queremos que cada uma tenha uma finalidade clara e bem definida.
Tentar desenvolver uma única classe capaz de lidar com todos os indicadores, independentemente do número de buffers, pode tornar a implementação excessivamente complexa. Além disso, se o projeto não for feito com cuidado, o código poderá conter erros de lógica e outras falhas. Portanto, ao limitar o escopo da classe, aumentamos nossas chances de obter uma implementação robusta.
//+------------------------------------------------------------------+
//|                                        SingleBufferIndicator.mqh |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

class SingleBufferIndicator
  {

public:

   //--- Class methods
   bool              SetIndicatorValues(int buffer_size,bool set_as_series);
   double            GetReadingAt(int index);
   bool              SetDifferencedIndicatorValues(int buffer_size,int differencing_period,bool set_as_series);
   double            GetDifferencedReadingAt(int index);
   double            GetCurrentReading(void);

   //--- Have the indicator values been copied to the buffer?
   bool              indicator_values_initialized;
   bool              indicator_differenced_values_initialized;

   //--- How far into the future we wish to forecast
   int               forecast_horizon;

   //--- The buffer for our indicator
   double            indicator_reading[];
   vector            indicator_differenced_values;

   //--- The current size of the buffer the user last requested
   int               indicator_buffer_size;
   int               indicator_differenced_buffer_size;

   //--- The handler for our indicator
   int               indicator_handler;

   //--- The time frame our indicator should be applied on
   ENUM_TIMEFRAMES   indicator_time_frame;

   //--- The price should the indicator be applied on
   ENUM_APPLIED_PRICE indicator_price;

   //--- Give the user feedback
   string            user_feedback(int flag);

   //--- The Symbol our indicator should be applied on
   string            indicator_symbol;

   //--- Our period
   int               indicator_period;

   //--- Is our indicator valid?
   bool              IsValid(void);

   //---- Testing the Single Buffer Indicator Class
   //--- This method should be deleted in production
   virtual void      Test(void);
  };
//+------------------------------------------------------------------+
Agora precisamos de um método que copie os valores do indicador a partir de seu handle para o respectivo buffer. Esse método terá dois parâmetros: um deles definirá a quantidade de dados a copiar, enquanto o outro determinará a ordem dos dados. Quando o segundo parâmetro for true, os dados serão organizados do passado para o presente.
//+------------------------------------------------------------------+
//| Set our indicator values and our buffer size                     |
//+------------------------------------------------------------------+
bool              SingleBufferIndicator::SetIndicatorValues(int buffer_size,bool set_as_series)
  {

//--- Buffer size
   indicator_buffer_size = buffer_size;
   CopyBuffer(this.indicator_handler,0,0,buffer_size,indicator_reading);

//--- Should the array be set as series?
   if(set_as_series)
      ArraySetAsSeries(this.indicator_reading,true);
   indicator_values_initialized = true;

//--- Did something go wrong?
   vector indicator_test;
   indicator_test.CopyIndicatorBuffer(indicator_handler,0,0,buffer_size);
   if(indicator_test.Sum() == 0)
      return(false);

//--- Everything went fine.
   return(true);
  }
Em machine learning, registrar a variação de uma variável pode ser mais informativo do que utilizar seus valores originais. Por isso, também criaremos um método específico que calculará a variação das leituras do indicador e copiará esses valores para o buffer do indicador.
//+--------------------------------------------------------------+
//| Let's set the conditions for our differenced data            |
//+--------------------------------------------------------------+
bool              SingleBufferIndicator::SetDifferencedIndicatorValues(int buffer_size,int differencing_period,bool set_as_series)
  {
//--- Internal variables
   indicator_differenced_buffer_size = buffer_size;
   indicator_differenced_values = vector::Zeros(indicator_differenced_buffer_size);

//--- Prepare to record the differences in our RSI readings
   double temp_buffer[];
   int fetch = (indicator_differenced_buffer_size + (2 * differencing_period));
   CopyBuffer(indicator_handler,0,0,fetch,temp_buffer);
   if(set_as_series)
      ArraySetAsSeries(temp_buffer,true);

//--- Fill in our values iteratively
   for(int i = indicator_differenced_buffer_size;i > 1; i--)
     {
      indicator_differenced_values[i-1] = temp_buffer[i-1] - temp_buffer[i-1+differencing_period];
     }

//--- If the norm of a vector is 0, the vector is empty!
   if(indicator_differenced_values.Norm(VECTOR_NORM_P) != 0)
     {
      Print(user_feedback(2));
      indicator_differenced_values_initialized = true;
      return(true);
     }

   indicator_differenced_values_initialized = false;
   Print(user_feedback(3));
   return(false);
  }
Agora que definimos os métodos responsáveis por copiar os valores dos indicadores para seus buffers, precisamos de métodos para recuperar os dados armazenados nesses buffers. Observe que poderíamos simplesmente declarar o buffer do indicador como um membro público da classe, o que nos permitiria acessar rapidamente os valores desejados. O problema dessa abordagem é que ela contraria um dos principais objetivos da criação de uma classe: fornecer uma interface uniforme para ler e modificar os objetos.
//--- Get a differenced value at a specific index
double            SingleBufferIndicator::GetDifferencedReadingAt(int index)
  {
//--- Make sure we're not trying to call values beyond our index
   if(index > indicator_differenced_buffer_size)
     {
      Print(user_feedback(4));
      return(-1e10);
     }

//--- Make sure our values have been set
   if(!indicator_differenced_values_initialized)
     {
      //--- The user is trying to use values before they were set in memory
      Print(user_feedback(1));
      return(-1e10);
     }

//--- Return the differenced value of our indicator at a specific index
   if((indicator_differenced_values_initialized) && (index < indicator_differenced_buffer_size))
      return(indicator_differenced_values[index]);

//--- Something went wrong.
   return(-1e10);
  }
O método anterior retornava a diferença entre as leituras do indicador; agora precisamos de um método semelhante que retorne os valores efetivos do indicador, exatamente como são exibidos pelo próprio indicador.
//+------------------------------------------------------------------+
//| Get a reading at a specific index from our RSI buffer            |
//+------------------------------------------------------------------+
double            SingleBufferIndicator::GetReadingAt(int index)
  {
//--- Is the user trying to call indexes beyond the buffer?
   if(index > indicator_buffer_size)
     {
      Print(user_feedback(4));
      return(-1e10);
     }

//--- Get the reading at the specified index
   if((indicator_values_initialized) && (index < indicator_buffer_size))
      return(indicator_reading[index]);

//--- User is trying to get values that were not set prior
   else
     {
      Print(user_feedback(1));
      return(-1e10);
     }
  }
Também considerei útil criar uma função específica para retornar o valor do indicador no índice 0, ou seja, sua leitura atual.
//+------------------------------------------------------------------+
//| Get our current reading from the RSI indicator                   |
//+------------------------------------------------------------------+
double SingleBufferIndicator::GetCurrentReading(void)
  {
   double temp[];
   CopyBuffer(this.indicator_handler,0,0,1,temp);
   return(temp[0]);
  }
Outra função nos informará se o handle do indicador foi criado corretamente. Essa é uma medida de segurança bastante útil.
//+------------------------------------------------------------------+
//| Check if our indicator handler is valid                          |
//+------------------------------------------------------------------+
bool SingleBufferIndicator::IsValid(void)
  {
   return((this.indicator_handler != INVALID_HANDLE));
  }
Durante a interação do usuário com a classe do indicador, queremos alertá-lo sobre eventuais erros e indicar uma solução adequada para corrigi-los.
//+------------------------------------------------------------------+
//| Give the user feedback on the actions he is performing           |
//+------------------------------------------------------------------+
string SingleBufferIndicator::user_feedback(int flag)
  {
   string message;

//--- Check if the indicator loaded correctly
   if(flag == 0)
     {
      //--- Check the indicator was loaded correctly
      if(IsValid())
         message = "Indicator Class Loaded Correcrtly \nSymbol: " + (string) indicator_symbol + "\nPeriod: " + (string) indicator_period;
      return(message);
      //--- Something went wrong
      message = "Error loading Indicator: [ERROR] " + (string) GetLastError();
      return(message);
     }

//--- User tried getting indicator values before setting them
   if(flag == 1)
     {
      message = "Please set the indicator values before trying to fetch them from memory, call SetIndicatorValues()";
      return(message);
     }

//--- We sueccessfully set our differenced indicator values
   if(flag == 2)
     {
      message = "Succesfully set differenced indicator values.";
      return(message);
     }

//--- Failed  to set our differenced indicator values
   if(flag == 3)
     {
      message = "Failed to set our differenced indicator values: [ERROR] " + (string) GetLastError();
      return(message);
     }

//--- The user is trying to retrieve an index beyond the buffer size and must update the buffer size first
   if(flag == 4)
     {
      message = "The user is attempting to use call an index beyond the buffer size, update the buffer size first";
      return(message);
     }

//--- The class has been deactivated by the user
   if(flag == 5)
     {
      message = "Goodbye.";
      return(message);
     }

//--- No feedback
   else
      return("");
  }
Feito isso, podemos criar nossa classe WPR, que herdará da classe base SingleBufferIndicator. De modo geral, se você pretende acompanhar as instruções deste artigo, sua árvore de dependências deverá ser semelhante à apresentada na Fig. 1.
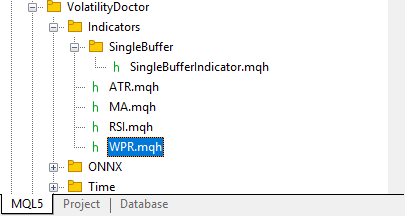
Fig. 2. Árvore de dependências das nossas classes de indicadores
Agora vamos ao primeiro passo na implementação da classe WPR: incluir a classe SingleBufferIndicator na classe WPR.
//+------------------------------------------------------------------+
//|                                                          WPR.mqh |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| Load the parent class                                            |
//+------------------------------------------------------------------+
#include <VolatilityDoctor\Indicators\SingleBuffer\SingleBufferIndicator.mqh>
Desta vez, antes de definir os membros da classe WPR, indicaremos que ela herda da classe SingleBufferIndicator usando dois-pontos ":". É dessa forma que definimos a herança entre classes em MQL5. Para os leitores menos familiarizados com os conceitos de OOP, herdar de uma classe nos permite chamar, a partir da classe WPR, os métodos implementados em SingleBufferIndicator. Como as classes WPR e RSI herdam de SingleBufferIndicator, ambas passam a oferecer uma funcionalidade consistente. Em outras palavras, todos os membros públicos de SingleBufferIndicator ficarão prontamente disponíveis em qualquer classe que herde dela.
//+------------------------------------------------------------------+
//| This class will provide us with usefull functionality for the WPR|
//+------------------------------------------------------------------+
class WPR : public SingleBufferIndicator
  {
public:
                     WPR();
                     WPR(string user_symbol,ENUM_TIMEFRAMES user_time_frame,int user_period);
                    ~WPR();
  };
Os indicadores WPR e RSI possuem apenas um buffer. No entanto, exigem parâmetros diferentes para sua inicialização. Por isso, é mais adequado que o construtor seja específico para cada indicador, já que as assinaturas dos construtores podem variar consideravelmente de um indicador para outro.
//+------------------------------------------------------------------+
//| Our default constructor for our Indicator class                  |
//+------------------------------------------------------------------+
void WPR::WPR()
  {
   indicator_values_initialized       = false;
   indicator_symbol                   = "EURUSD";
   indicator_time_frame               = PERIOD_D1;
   indicator_period                   = 5;
   indicator_handler                  = iWPR(indicator_symbol,indicator_time_frame,indicator_period);
//--- Give the user feedback on initilization
   Print(user_feedback(0));
//--- Remind the user they called the default constructor
   Print("Default Constructor Called: ",__FUNCSIG__," ",&this);
  }
O construtor parametrizado permite ao usuário especificar o símbolo, o timeframe e o período com os quais o indicador WPR deverá ser inicializado.
//+------------------------------------------------------------------+
//| Our parametric constructor for our Indicator class               |
//+------------------------------------------------------------------+
void WPR::WPR(string user_symbol,ENUM_TIMEFRAMES user_time_frame,int user_period)
  {
   indicator_values_initialized       = false;
   indicator_symbol                   = user_symbol;
   indicator_time_frame               = user_time_frame;
   indicator_period                   = user_period;
   indicator_handler                  = iWPR(indicator_symbol,indicator_time_frame,indicator_period);
//--- Give the user feedback on initilization
   Print(user_feedback(0));
  }
O destrutor da classe redefinirá nossos flags importantes e liberará os recursos associados ao indicador. Em MQL5, é uma boa prática liberar os recursos ao final da execução. Encapsular essa limpeza em uma classe específica reduz a carga cognitiva do desenvolvedor, pois ele não precisa acompanhar nem repetir manualmente essa rotina, já que a própria classe realiza a limpeza.
//+------------------------------------------------------------------+
//| Our destructor for our Indicator class                           |
//+------------------------------------------------------------------+
void WPR::~WPR()
  {
//--- Free up resources we don't need and reset our flags
   if(IndicatorRelease(indicator_handler))
     {
      indicator_differenced_values_initialized = false;
      indicator_values_initialized = false;
      Print(user_feedback(5));
     }
  }
//+------------------------------------------------------------------+
Outra funcionalidade de que precisamos é detectar quando uma nova vela está completa. Nesses momentos, podemos querer executar determinadas tarefas. Como essa funcionalidade é especialmente importante e, em alguns casos, pode ser necessário acompanhar simultaneamente a formação de velas em diferentes timeframes, vamos encapsulá-la em uma classe própria. Começaremos declarando os membros necessários da nossa classe Time.
//+------------------------------------------------------------------+
//|                                                         Time.mqh |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

class Time
  {
private:
   datetime          time_stamp;
   datetime          current_time;
   string            selected_symbol;
   ENUM_TIMEFRAMES   selected_time_frame;
public:
                     Time(string user_symbol,ENUM_TIMEFRAMES user_time_frame);
   bool              NewCandle(void);
                    ~Time();
  };
Observe que a classe não possui um construtor padrão, e isso é intencional. Neste caso específico, o uso de um construtor padrão não faria muito sentido.
//+------------------------------------------------------------------+
//| Create our time object                                           |
//+------------------------------------------------------------------+
Time::Time(string user_symbol,ENUM_TIMEFRAMES user_time_frame)
  {
   selected_time_frame = user_time_frame;
   selected_symbol = user_symbol;
   current_time = iTime(user_symbol,selected_time_frame,0);
   time_stamp   = iTime(user_symbol,selected_time_frame,0);
  }
No momento, o destrutor da classe está vazio.
//+------------------------------------------------------------------+
//| Our destructor is currently empty                                |
//+------------------------------------------------------------------+
Time::~Time()
  {
  }
//+------------------------------------------------------------------+
Por fim, precisamos de um método que nos permita determinar se uma nova vela foi formada. O método retornará true quando isso ocorrer, permitindo executar periodicamente nossas rotinas.
//+------------------------------------------------------------------+
//| Check if a new candle has fully formed                           |
//+------------------------------------------------------------------+
bool Time::NewCandle(void)
  {
   current_time = iTime(selected_symbol,selected_time_frame,0);

//--- Check if a new candle has formed
   if(time_stamp != current_time)
     {
      time_stamp = current_time;
      return(true);
     }

//--- No new candle has completely formed
   return(false);
  }
Em seguida, também precisaremos de uma classe específica para lidar com nossos objetos ONNX. À medida que nossos projetos crescem e se tornam mais complexos, queremos evitar repetir determinadas etapas várias vezes. No futuro, talvez seja mais conveniente ter uma classe ONNXFloat para todos os nossos modelos ONNX que recebem dados do tipo float. No momento em que este artigo foi escrito, o tipo de dados float era amplamente reconhecido como um tipo estável para a execução de modelos ONNX. Vamos começar definindo os membros da classe ONNXFloat.
//+------------------------------------------------------------------+
//|                                                    ONNXFloat.mqh |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| This class will help us work with ONNX Float models.             |
//+------------------------------------------------------------------+
class ONNXFloat
  {
private:
   //--- Our ONNX model handler
   long              onnx_model;
   int               onnx_outputs;
public:
   //--- Is our Model Valid?
   bool              OnnxModelIsValid(void);

   //--- Define the input shape of our model
   bool              DefineOnnxInputShape(int n_index,int n_stacks,int n_input_params);

   //--- Define the output shape of our model
   bool              DefineOnnxOutputShape(int n_index,int n_stacks, int n_output_params);

   vectorf           Predict(const vectorf &model_inputs);

   //--- ONNXFloat class constructor
                     ONNXFloat(const uchar &user_proto[]);

   //---- ONNXFloat class destructor
                    ~ONNXFloat();
  };
O construtor da nossa classe recebe o protótipo de um modelo ONNX e cria o modelo ONNX a partir do buffer fornecido pelo usuário. Observe que os buffers de modelos ONNX só podem ser passados por referência, e não por valor. O símbolo "&", conhecido como ampersand, colocado antes do nome do buffer do modelo ONNX em "&user_proto", indica explicitamente que esse parâmetro é uma referência a um objeto na memória. Sempre que uma função possui um parâmetro passado por referência, o usuário deve ter em mente que qualquer alteração feita nesse parâmetro dentro da função também modificará o parâmetro original fora dela.
No nosso caso, não pretendemos modificar o protótipo ONNX. Por isso, declaramos o parâmetro como const, indicando tanto ao programador quanto ao compilador que ele não deve ser alterado. Assim, mesmo que o programador ignore essa restrição, o compilador impedirá a modificação.
//+------------------------------------------------------------------+
//| Parametric Constructor For Our ONNXFloat class                   |
//+------------------------------------------------------------------+
ONNXFloat::ONNXFloat(const uchar &user_proto[])
  {
   onnx_model = OnnxCreateFromBuffer(user_proto,ONNX_DATA_TYPE_FLOAT);

   if(OnnxModelIsValid())
      Print("Volatility Doctor ONNXFloat Class Loaded Correctly: ",__FUNCSIG__," ",&this);

   else
      Print("Failed To Create The specified ONNX model: ",GetLastError());
  }
O destrutor da classe ONNXFloat liberará automaticamente a memória alocada para o nosso modelo ONNX.
//+------------------------------------------------------------------+
//| Our ONNXFloat class destructor                                   |
//+------------------------------------------------------------------+
ONNXFloat::~ONNXFloat()
  {
   OnnxRelease(onnx_model);
  }
//+------------------------------------------------------------------+
Também precisaremos de uma função específica para informar se nosso modelo ONNX é válido, retornando um flag lógico que será true somente quando o modelo estiver válido.
//+------------------------------------------------------------------+
//| A method that returns true if our ONNXFloat model is valid       |
//+------------------------------------------------------------------+
bool ONNXFloat::OnnxModelIsValid(void)
  {
//--- Check if the model is valid
   if(onnx_model != INVALID_HANDLE)
      return(true);

//--- Something went wrong
   return(false);
  }
A configuração dos parâmetros de entrada de qualquer modelo ONNX é uma etapa preparatória indispensável e que provavelmente precisaremos executar com frequência.
//+------------------------------------------------------------------+
//| Set the input shape of our ONNXFloat model                       |
//+------------------------------------------------------------------+
bool ONNXFloat::DefineOnnxInputShape(int n_index,int n_stacks,int n_input_params)
  {
   const ulong model_input_shape[] = {n_stacks,n_input_params};

   if(OnnxSetInputShape(onnx_model,n_index,model_input_shape))
     {
      Print("Succefully specified ONNX model output shape: ",__FUNCTION__," ",&this);
      return(true);
     }

//--- Something went wrong
   Print("Failed to set the passed ONNX model output shape: ",GetLastError());
   return(false);
  }
O mesmo se aplica às dimensões dos dados de saída do modelo ONNX.
//+------------------------------------------------------------------+
//| Set the output shape of our model                                |
//+------------------------------------------------------------------+
bool ONNXFloat::DefineOnnxOutputShape(int n_index,int n_stacks,int n_output_params)
  {
   const ulong model_output_shape[] = {n_output_params,n_stacks};
   onnx_outputs = n_output_params;

   if(OnnxSetOutputShape(onnx_model,n_index,model_output_shape))
     {
      Print("Succefully specified ONNX model input shape: ",__FUNCSIG__," ",&this);
      return(true);
     }

//--- Something went wrong
   Print("Failed to set the passed ONNX model input shape: ",GetLastError());
   return(false);
  }
Por fim, precisamos de uma função de previsão. Essa função receberá os dados de entrada do modelo ONNX por referência e, como não pretendemos modificá-los, declaramos esse parâmetro como const. Isso evita efeitos colaterais indesejados nos dados de entrada e, mais importante, instrui o compilador a rejeitar qualquer tentativa de modificá-los. Recursos de segurança desse tipo são extremamente valiosos, e sua presença faz do MQL5 uma linguagem de programação de primeira linha.
//+------------------------------------------------------------------+
//| Get a prediction from our model                                  |
//+------------------------------------------------------------------+
vectorf ONNXFloat::Predict(const vectorf &model_inputs)
  {
   vectorf model_output(onnx_outputs);
   if(OnnxRun(onnx_model,ONNX_DATA_TYPE_FLOAT,model_inputs,model_output))
     {
      vectorf res = model_output;
      return(res);
     }

   Comment("Failed to get a prediction from our ONNX model");
   Print("ONNX Run Failed: ",GetLastError());
   vectorf res = {10e8};
   return(res);
  }
A última classe de que precisaremos será responsável por obter informações úteis para negociação, como o volume mínimo de uma operação ou o preço Ask atual.
//+------------------------------------------------------------------+
//|                                                    TradeInfo.mqh |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"
class TradeInfo
  {
private:
                     string user_symbol;
                     ENUM_TIMEFRAMES user_time_frame;
                     double min_volume,max_volume,volume_step;
public:
                     TradeInfo(string selected_symbol,ENUM_TIMEFRAMES selected_time_frame);
                     double MinVolume(void);
                     double MaxVolume(void);
                     double VolumeStep(void);
                     double GetAsk(void);
                     double GetBid(void);
                     double GetClose(void);
                     string GetSymbol(void);
                    ~TradeInfo();
  };
O construtor parametrizado da classe recebe dois parâmetros, que especificam o símbolo e o timeframe desejados.
//+------------------------------------------------------------------+
//| The constructor will load our symbol information                 |
//+------------------------------------------------------------------+
TradeInfo::TradeInfo(string selected_symbol,ENUM_TIMEFRAMES selected_time_frame)
  {
      //--- Which symbol are you interested in?
      user_symbol = selected_symbol;
      user_time_frame = selected_time_frame;

      if(SymbolSelect(user_symbol,true))
         {
            //--- Load symbol details
            min_volume = SymbolInfoDouble(user_symbol,SYMBOL_VOLUME_MIN);
            max_volume = SymbolInfoDouble(user_symbol,SYMBOL_VOLUME_MAX);
            volume_step = SymbolInfoDouble(user_symbol,SYMBOL_VOLUME_STEP);
            Print("Trade Info Loaded Successfully: ",__FUNCSIG__);
         }

      else
         {
            Print("Error Symbol Information Could Not Be Found For: ",selected_symbol," ",GetLastError());
         }

  }
Também definiremos métodos para obter as leituras atuais de cada uma das quatro principais séries de preços, ou seja, esses métodos retornarão, respectivamente, os preços atuais de abertura, máxima, mínima e fechamento.
//+------------------------------------------------------------------+
//| Return the close of the selected symbol                          |
//+------------------------------------------------------------------+
double TradeInfo::GetClose(void)
   {
      double res = iClose(user_symbol,user_time_frame,0);
      return(res);
   }

//+------------------------------------------------------------------+
//| Return the open of the selected symbol                           |
//+------------------------------------------------------------------+
double TradeInfo::GetOpen(void)
   {
      double res = iOpen(user_symbol,user_time_frame,0);
      return(res);
   }

//+------------------------------------------------------------------+
//| Return the high of the selected symbol                           |
//+------------------------------------------------------------------+
double TradeInfo::GetHigh(void)
   {
      double res = iHigh(user_symbol,user_time_frame,0);
      return(res);
   }

//+------------------------------------------------------------------+
//| Return the low of the selected symbol                            |
//+------------------------------------------------------------------+
double TradeInfo::GetLow(void)
   {
      double res = iLow(user_symbol,user_time_frame,0);
      return(res);
   }
Ao trabalhar com vários símbolos, é útil ter uma forma de identificar rapidamente a qual símbolo a instância atual da classe está associada.
//+------------------------------------------------------------------+
//| Return the selected symbol                                       |
//+------------------------------------------------------------------+
string TradeInfo::GetSymbol(void)
   {
      string res = user_symbol;
      return(res);
   }
Nossa classe também oferece meios para obter rapidamente informações importantes sobre os limites de volume permitidos para o símbolo atual.
//+------------------------------------------------------------------+
//| Return the volume step allowed                                   |
//+------------------------------------------------------------------+
double TradeInfo::VolumeStep(void)
   {
      double res = volume_step;
      return(res);
   }

//+------------------------------------------------------------------+
//| Return the minimum volume allowed                                |
//+------------------------------------------------------------------+
double TradeInfo::MinVolume(void)
   {
      double res = min_volume;
      return(res);
   }

//+------------------------------------------------------------------+
//| Return the maximum volume allowed                                |
//+------------------------------------------------------------------+
double TradeInfo::MaxVolume(void)
   {
      double res = max_volume;
      return(res);
   }
Também precisaremos que a classe nos forneça rapidamente os preços Bid e Ask atuais.
//+------------------------------------------------------------------+
//| Return the current ask                                           |
//+------------------------------------------------------------------+
double TradeInfo::GetAsk(void)
   {
      return(SymbolInfoDouble(GetSymbol(),SYMBOL_ASK));
   }

//+------------------------------------------------------------------+
//| Return the current bid                                           |
//+------------------------------------------------------------------+
double TradeInfo::GetBid(void)
   {
      return(SymbolInfoDouble(GetSymbol(),SYMBOL_BID));
   }
No momento, o destrutor da classe Time está vazio.
//+------------------------------------------------------------------+
//| Destructor is currently empty                                    |
//+------------------------------------------------------------------+
TradeInfo::~TradeInfo()
  {
  }
//+------------------------------------------------------------------+
De modo geral, se você acompanhou o raciocínio até aqui, sua árvore de dependências deverá ser semelhante à apresentada na Fig. 3 abaixo.
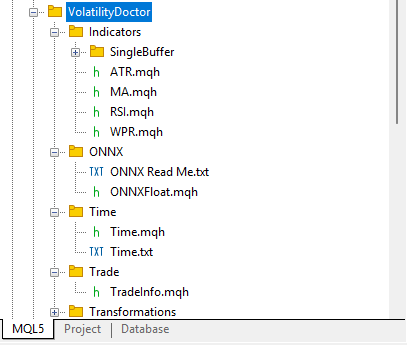
Fig. 3. Essas classes devem ser armazenadas em uma árvore de dependências semelhante à nossa
Agora vamos definir o script que obterá os dados de mercado necessários. Primeiro, queremos obter os dados das quatro principais séries de preços (OHLC), depois as variações dessas quatro séries e, por fim, os dados de 14 indicadores WPR.
//+------------------------------------------------------------------+
//|                                                      ProjectName |
//|                                      Copyright 2020, CompanyName |
//|                                       http://www.companyname.net |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define HORIZON 10

//+------------------------------------------------------------------+
//| Libraries                                                        |
//+------------------------------------------------------------------+
#include <VolatilityDoctor\Indicators\WPR.mqh>

//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
WPR *my_wpr_array[14];
string file_name = Symbol() + " WPR Algorithmic Input Selection.csv";

//+------------------------------------------------------------------+
//| Inputs                                                           |
//+------------------------------------------------------------------+
input int size = 3000;

//+------------------------------------------------------------------+
//| Our script execution                                             |
//+------------------------------------------------------------------+
void OnStart()
  {
//--- How much data should we store in our indicator buffer?
   int fetch = size + (2 * HORIZON);

//--- Store pointers to our WPR objects
   for(int i = 0; i <= 13; i++)
     {
      //--- Create an WPR object
      my_wpr_array[i] = new WPR(Symbol(),PERIOD_CURRENT,((i+1) * 5));
      //--- Set the WPR buffers
      my_wpr_array[i].SetIndicatorValues(fetch,true);
      my_wpr_array[i].SetDifferencedIndicatorValues(fetch,HORIZON,true);
     }

//---Write to file
   int file_handle=FileOpen(file_name,FILE_WRITE|FILE_ANSI|FILE_CSV,",");

   for(int i=size;i>=1;i--)
     {
      if(i == size)
        {
         FileWrite(file_handle,"Time","True Open","True High","True Low","True Close","Open","High","Low","Close","WPR 5","WPR 10","WPR 15","WPR 20","WPR 25","WPR 30","WPR 35","WPR 40","WPR 45","WPR 50","WPR 55","WPR 60","WPR 65","WPR 70","Diff WPR 5","Diff WPR 10","Diff WPR 15","Diff WPR 20","Diff WPR 25","Diff WPR 30","Diff WPR 35","Diff WPR 40","Diff WPR 45","Diff WPR 50","Diff WPR 55","Diff WPR 60","Diff WPR 65","Diff WPR 70");
        }

      else
        {
         FileWrite(file_handle,
                   iTime(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i),
                   iHigh(_Symbol,PERIOD_CURRENT,i),
                   iLow(_Symbol,PERIOD_CURRENT,i),
                   iClose(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i) - iOpen(Symbol(),PERIOD_CURRENT,i + HORIZON),
                   iHigh(_Symbol,PERIOD_CURRENT,i) - iHigh(Symbol(),PERIOD_CURRENT,i + HORIZON),
                   iLow(_Symbol,PERIOD_CURRENT,i) - iLow(Symbol(),PERIOD_CURRENT,i + HORIZON),
                   iClose(_Symbol,PERIOD_CURRENT,i) - iClose(Symbol(),PERIOD_CURRENT,i + HORIZON),
                   my_wpr_array[0].GetReadingAt(i),
                   my_wpr_array[1].GetReadingAt(i),
                   my_wpr_array[2].GetReadingAt(i),
                   my_wpr_array[3].GetReadingAt(i),
                   my_wpr_array[4].GetReadingAt(i),
                   my_wpr_array[5].GetReadingAt(i),
                   my_wpr_array[6].GetReadingAt(i),
                   my_wpr_array[7].GetReadingAt(i),
                   my_wpr_array[8].GetReadingAt(i),
                   my_wpr_array[9].GetReadingAt(i),
                   my_wpr_array[10].GetReadingAt(i),
                   my_wpr_array[11].GetReadingAt(i),
                   my_wpr_array[12].GetReadingAt(i),
                   my_wpr_array[13].GetReadingAt(i),
                   my_wpr_array[0].GetDifferencedReadingAt(i),
                   my_wpr_array[1].GetDifferencedReadingAt(i),
                   my_wpr_array[2].GetDifferencedReadingAt(i),
                   my_wpr_array[3].GetDifferencedReadingAt(i),
                   my_wpr_array[4].GetDifferencedReadingAt(i),
                   my_wpr_array[5].GetDifferencedReadingAt(i),
                   my_wpr_array[6].GetDifferencedReadingAt(i),
                   my_wpr_array[7].GetDifferencedReadingAt(i),
                   my_wpr_array[8].GetDifferencedReadingAt(i),
                   my_wpr_array[9].GetDifferencedReadingAt(i),
                   my_wpr_array[10].GetDifferencedReadingAt(i),
                   my_wpr_array[11].GetDifferencedReadingAt(i),
                   my_wpr_array[12].GetDifferencedReadingAt(i),
                   my_wpr_array[13].GetDifferencedReadingAt(i)
                  );
        }
     }
//--- Close the file
   FileClose(file_handle);

//--- Delete our WPR object pointers
   for(int i = 0; i <= 13; i++)
     {
      delete my_wpr_array[i];
     }
  }
//+------------------------------------------------------------------+
#undef HORIZON
Análise dos nossos dados com Python
Depois de concluir o script, aplique-o ao mercado de sua preferência para gerar os dados que utilizaremos na análise. Nesta discussão, aplicamos o script ao par de moedas EURGBP. Agora que os dados estão prontos, vamos carregar as bibliotecas Python necessárias para a análise.
#Load the libraries
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
Vamos carregar os dados.
#Read in the data
data = pd.read_csv("..\EURGBP WPR Algorithmic Input Selection.csv")

#Label the data
HORIZON = 10
data['Target'] = data['Close'].shift(-HORIZON) - data['Close']

#Drop the last 10 rows
data = data.iloc[:-HORIZON,:]
Criaremos cópias dos dados de entrada e dos dados-alvo.
#Define inputs and target
X = data.iloc[:,1:-1].copy()
y = data.iloc[:,-1].copy()
Vamos dimensionar e centralizar cada coluna numérica do conjunto de dados.
#Store Z-scores
Z1 = X.mean()
Z2 = X.std()

#Scale the data
X = ((X - Z1)/ Z2)
Carregaremos as bibliotecas numéricas necessárias para avaliar a precisão.
from sklearn.model_selection import cross_val_score,TimeSeriesSplit
from sklearn.linear_model import Ridge
Criaremos um objeto para validação cruzada de séries temporais.
tscv = TimeSeriesSplit(n_splits=5,gap=HORIZON)sdvdsvds Definiremos um método que sempre retornará os níveis de precisão obtidos na validação cruzada.
#Return our cross validated accuracy
def score(f_model,f_X,f_y):
    return(np.mean(np.abs(cross_val_score(f_model,f_X,f_y,scoring='neg_mean_squared_error',cv=tscv,n_jobs=-1))))
Também precisaremos de um método específico para retornar uma nova instância do modelo. Assim, não passaremos dados a modelos que já estejam em uso.
def get_model():
    return(Ridge())
Preencher a coluna com zeros nos permite medir a precisão obtida ao prever constantemente o retorno médio do mercado.
X['Null'] = 0
Vamos registrar o erro gerado ao prever constantemente o retorno médio do mercado (soma dos quadrados / soma dos quadrados das perdas). Agora que definimos esse nível de erro de referência, podemos afirmar com segurança que qualquer modelo que apresente um erro superior a 0,000324 não apresentará desempenho adequado para os objetivos desta discussão.
#This will be the last entry in our list of results
#Record our error if we always predict the average market return (total sum of squares/TSS)
tss = score(get_model(),X[['Null']],y)
tss
0.00032439931180771236
Agora criaremos um array para nos ajudar a acompanhar os resultados.
res = []
O primeiro resultado que queremos registrar corresponde aos níveis de erro obtidos ao utilizar os dados OHLC do mercado em sua forma original.
#This will be our first entry in our list of results
#Record our error using OHLC price data
res.append(score(get_model(),X.iloc[:,:8],y))
Em seguida, queremos conhecer os níveis de erro obtidos usando apenas os 14 períodos do indicador WPR que selecionamos.
#Second
#Record our error using just indicators
res.append(score(get_model(),X.iloc[:,8:-1],y))
Por fim, vamos registrar os níveis de erro obtidos utilizando todos os dados disponíveis.
#Third
#Record our error using all the data we have
res.append(score(get_model(),X.iloc[:,:-1],y))
Agora carregue a biblioteca UMAP. Os dados originais contêm 36 colunas, e a biblioteca UMAP nos ajudará a representá-los usando qualquer número de colunas maior ou igual a 1 e menor que o número original. Essa nova representação dos dados pode ser mais informativa do que os próprios dados em sua forma original. Nesse sentido, os algoritmos de redução de dimensionalidade podem ser considerados uma família de métodos que permite aproveitar de forma eficiente todos os dados disponíveis que descrevem nosso problema.
import umap
Queremos encontrar uma quantidade de representações vetoriais que seja, no máximo, duas unidades menor que o número original de colunas.
EPOCHS = X.iloc[:,:-1].shape[1] - 2
Vamos gerar iterativamente os embeddings dos dados com o UMAP. O número de colunas geradas começará em 1 e aumentará de uma em uma até atingir o limite superior definido na linha de código anterior.
for i in range(EPOCHS):
    reducer = umap.UMAP(n_components=(i+1),metric='euclidean',random_state=0,transform_seed=0,n_neighbors=30)
    X_embedded = pd.DataFrame(reducer.fit_transform(X.iloc[:,:-1]))
    res.append(score(get_model(),X_embedded,y))
Vamos combinar os resultados.
res.append(tss)
A linha vermelha contínua representa nosso erro crítico de referência. Esse é o erro obtido ao prever constantemente o retorno médio do mercado (TSS). A linha vermelha tracejada mostra o menor nível de erro que conseguimos alcançar. Ele corresponde ao modelo construído quando nossos dados originais foram projetados em duas colunas pelo algoritmo UMAP. Observe que esse nível de erro é consideravelmente inferior ao TSS e também ao erro obtido com os dados de mercado em sua forma original. Na prática, estamos utilizando simultaneamente todos os períodos do WPR, e isso se mostra muito mais vantajoso do que as alternativas que avaliamos.
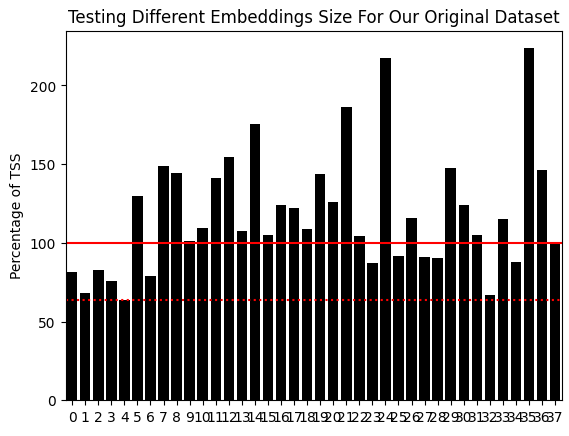
Fig. 4. Utilizando dois componentes incorporados do UMAP, superamos um modelo equivalente que utiliza todos os dados de mercado em sua forma original
Vamos transformar os dados usando as configurações ideais do UMAP que identificamos.
reducer = umap.UMAP(n_components=2,metric='euclidean',random_state=0,transform_seed=0,n_neighbors=30)
X_embedded = pd.DataFrame(reducer.fit_transform(X.iloc[:,:-1]))
Vamos atribuir nomes às nossas duas classes. Isso nos ajudará mais adiante a visualizar o que o UMAP está fazendo com nossos dados.
data['Class'] = 0

data.loc[data['Target'] > 0,'Class'] = 1
Vamos preparar um conjunto de dados para armazenar os dados transformados.
umap_data =pd.DataFrame(columns=['UMAP 1','UMAP 2'])
Vamos armazenar os níveis de preços projetados.
umap_data['UMAP 1'] = X_embedded.iloc[:,0]
umap_data['UMAP 2'] = X_embedded.iloc[:,1]
Sem o UMAP, é difícil visualizar nossos dados de maneira informativa devido ao grande número de dimensões. Na prática, o máximo que podemos fazer é criar gráficos de dispersão para pares de variáveis; fora isso, não há uma forma eficiente de visualizar simultaneamente 36 dimensões. Nas Fig. 5 e 6 abaixo, os pontos vermelhos representam movimentos altistas dos preços, enquanto os pontos pretos representam movimentos baixistas.
fig , axs = plt.subplots(2,2)

fig.suptitle('Visualizing EURGBP 2002-2025 Daily Price Data')

axs[0,0].scatter(data.loc[data['Target']>0 ,'Open'],data.loc[data['Target']>0 ,'Close'],color='red')
axs[0,0].scatter(data.loc[data['Target']<0 ,'Open'],data.loc[data['Target']<0 ,'Close'],color='black')

axs[0,1].scatter(data.loc[data['Target']>0 ,'True Open'],data.loc[data['Target']>0 ,'True Close'],color='red')
axs[0,1].scatter(data.loc[data['Target']<0 ,'True Open'],data.loc[data['Target']<0 ,'True Close'],color='black')

axs[1,1].scatter(data.loc[data['Target']>0 ,'WPR 5'],data.loc[data['Target']>0 ,'WPR 50'],color='red')
axs[1,1].scatter(data.loc[data['Target']<0 ,'WPR 5'],data.loc[data['Target']<0 ,'WPR 50'],color='black')

axs[1,0].scatter(data.loc[data['Target']>0 ,'WPR 15'],data.loc[data['Target']>0 ,'WPR 25'],color='red')
axs[1,0].scatter(data.loc[data['Target']<0 ,'WPR 15'],data.loc[data['Target']<0 ,'WPR 25'],color='black')
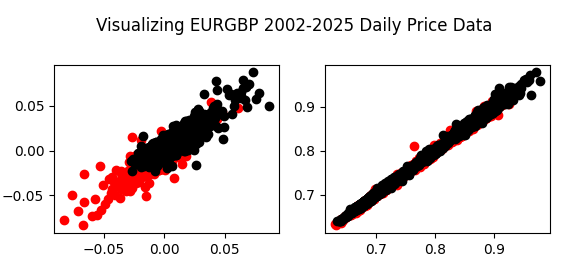
Fig. 5. À esquerda, é mostrada a relação entre a variação do preço de abertura e a variação do preço de fechamento. À direita, são exibidos os preços reais de abertura e fechamento
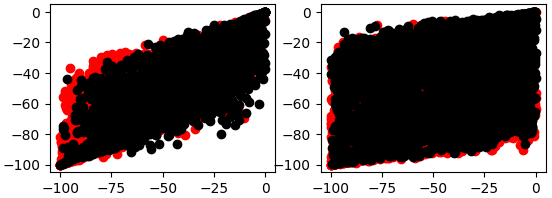
Fig. 6. No gráfico de dispersão à esquerda, é mostrada a relação entre o WPR com períodos 5 e 50, enquanto à direita é mostrada a relação entre o WPR com períodos 15 e 25
Como podemos observar, as Fig. 5 e 6 são difíceis de interpretar de maneira significativa, pois não há padrões claros nos dados. Além disso, criar gráficos de dispersão bidimensionais para fenômenos que ocorrem em mais de duas dimensões pode ser arriscado. Isso acontece porque uma aparente relação entre duas variáveis pode, na verdade, ser explicada por outros fatores que não conseguimos incluir no mesmo gráfico. Isso pode levar a conclusões equivocadas ou a uma confiança excessiva em relações que não são tão estáveis quanto parecem.
No entanto, após aplicar o UMAP, podemos representar facilmente todos os dados disponíveis em apenas duas dimensões. De modo geral, podemos observar que valores baixos e altos da primeira representação vetorial parecem estar associados, respectivamente, a movimentos baixistas e altistas dos preços.
sns.scatterplot(x=X_embedded.iloc[:,0],y=X_embedded.iloc[:,1],hue=data['Class'])
plt.grid()
plt.ylabel('Second UMAP Embedding')
plt.xlabel('First UMAP Embedding')
plt.title('Visualizing The Most Effective Embedding We Found')
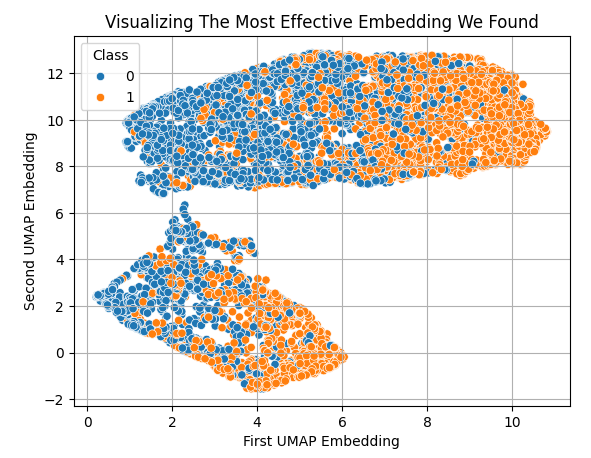
Fig. 7. Visualização dos embeddings UMAP dos dados originais do mercado
Agora vamos preparar nossos modelos para o teste com dados históricos. Primeiro, importaremos a biblioteca necessária.
from sklearn.model_selection import train_test_split
Vamos dividir os dados de mercado. Nossas amostras de treinamento abrangem o período de novembro de 2002 a agosto de 2018, portanto o período de teste com dados históricos começará em setembro de 2018.
train , test = train_test_split(data,test_size=0.3,shuffle=False)
train
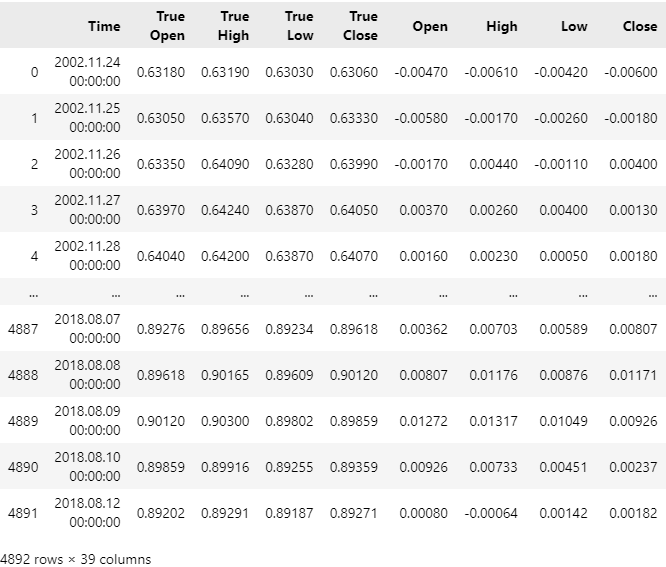
Fig. 8. Visualização dos dados de mercado em sua forma original
Agora vamos carregar nosso modelo estatístico.
from sklearn.neural_network import MLPRegressor
Vamos dimensionar os dados de treinamento.
#Sample mean
Z1 = train.iloc[:,1:-2].mean()

#Sample standard deviation
Z2 = train.iloc[:,1:-2].std()

train_scaled = train.copy()

train_scaled.iloc[:,1:-2] = ((train.iloc[:,1:-2] - Z1) / Z2)
Vamos projetar os dados de treinamento no espaço de embeddings.
reducer = umap.UMAP(n_components=2,metric='euclidean',random_state=0,transform_seed=0,n_neighbors=30)
X_embedded = pd.DataFrame(reducer.fit_transform(train_scaled.iloc[:,1:-2],columns=['UMAP 1','UMAP 2']))
Nosso sistema é construído em duas etapas. Primeiro, ajustaremos um modelo que aprenderá a aproximar o comportamento do algoritmo UMAP. Isso elimina a necessidade de reimplementar o algoritmo UMAP do zero em MQL5. O UMAP é um algoritmo bastante complexo, desenvolvido por uma equipe de pesquisadores que inclui profissionais com doutorado. Criar uma implementação numericamente estável desse algoritmo exige um esforço considerável de pesquisa. Por isso, tentar implementar por conta própria algoritmos desse tipo geralmente não é considerado uma boa prática.
#Learn To Estimate UMAP Embeddings From The Data
umap_model = MLPRegressor(shuffle=False,hidden_layer_sizes=(train.iloc[:,1:-2].shape[1],10,20,100,20,10,2),random_state=0,solver='lbfgs',activation='relu',learning_rate='constant',learning_rate_init=1e-4,power_t=1e-1)
np.mean(np.abs(cross_val_score(umap_model,train.iloc[:,1:-2],X_embedded,scoring='neg_mean_squared_error',n_jobs=-1)))
11.2489992665160363
Vamos treinar a função UMAP.
umap_model.fit(train.iloc[:,1:-2],X_embedded)
predictions = umap_model.predict(train.iloc[:,1:-2])
Agora precisamos de um modelo que preveja o retorno do mercado EURGBP com base nos embeddings UMAP dos dados de mercado. No scikit-learn, nossos modelos de redes neurais possuem um parâmetro importante chamado random_state. Esse parâmetro influencia os pesos e vieses iniciais com os quais a rede neural começa o treinamento. Dependendo do problema em questão, treinar repetidamente o modelo com diferentes estados iniciais pode produzir variações significativas de desempenho, como mostra a Fig. 9 abaixo.
EPOCHS = 100
res = []

for i in range(EPOCHS):
    #Try different random states
    model = MLPRegressor(shuffle=False,early_stopping=False,hidden_layer_sizes=(2,1,10,20,1),activation='identity',solver='lbfgs',random_state=i,max_iter=int(2e5))
    res.append(score(model,predictions,train['Target']))
Vamos visualizar nossos resultados.
plt.plot(res,color='black')
plt.axhline(np.min(res),color='red',linestyle=':')
plt.scatter(res.index(np.min(res)),np.min(res),color='red')
plt.grid()
plt.ylabel('Cross Validated RMSE')
plt.xlabel('Neural Network Random State')
plt.title('Our Neural Network Performance With Different Initial Conditions')
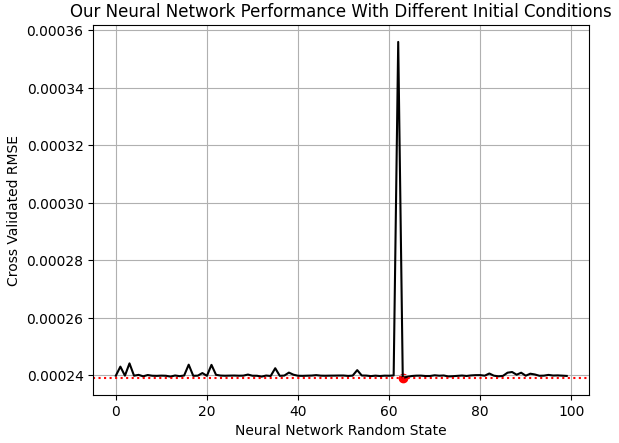
Fig. 9. Visualização do estado inicial ideal para nossa rede neural neste problema.
A rede neural que selecionamos prevê o retorno de 10 dias do mercado EURGBP com um erro 38% menor do que o obtido ao prever constantemente o retorno médio do mercado.
tss = score(Ridge(),train[['Close']]*0,train['Target'])
1-(np.min(res)/tss)
0.3822093585025088
Vamos ajustar o modelo usando o random_state ideal que identificamos na Fig. 9.
embedded_model = MLPRegressor(shuffle=False,early_stopping=False,hidden_layer_sizes=(2,1,10,20,1),activation='identity',solver='lbfgs',random_state=res.index(np.min(res)),max_iter=int(2e5))
embedded_model.fit(predictions,train['Target'])
Vamos carregar as bibliotecas necessárias para converter o modelo para o formato ONNX.
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
Vamos definir as dimensões dos parâmetros de nossos modelos.
umap_model_input_shape = [("float_input",FloatTensorType([1,train.iloc[:,1:-2].shape[1]]))]
umap_model_output_shape = [("float_output",FloatTensorType([X_embedded.iloc[:,:].shape[1],1]))]

embedded_model_input_shape = [("float_input",FloatTensorType([1,X_embedded.iloc[:,:].shape[1]]))]
embedded_model_output_shape = [("float_output",FloatTensorType([1,1]))]
Vamos converter os modelos ONNX em seus respectivos protótipos.
umap_proto = convert_sklearn(umap_model,initial_types=umap_model_input_shape,final_types=umap_model_output_shape,target_opset=12)
embeded_proto = convert_sklearn(embedded_model,initial_types=embedded_model_input_shape,final_types=embedded_model_output_shape,target_opset=12)
Vamos salvar os protótipos em disco.
onnx.save(umap_proto,"EURGBP WPR Ridge UMAP.onnx")
onnx.save(embeded_proto,"EURGBP WPR Ridge EMBEDDED.onnx")
Desenvolvimento da aplicação em MQL5
Agora vamos começar a desenvolver nossa aplicação. Primeiro, precisamos definir as constantes do sistema que permanecerão inalteradas durante a execução do programa.
//+------------------------------------------------------------------+
//|                             EURGBP Multiple Periods Analysis.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| REMINDER:                                                        |
//| These ONNX models were trained with Daily EURGBP data ranging    |
//| from 24 November 2002 until 12 August 2018. Test the strategy    |
//| outside of these time periods, on the Daily Time-Frame for       |
//| reliable results.                                                |
//+------------------------------------------------------------------+

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+

//--- ONNX Model I/O Parameters
#define UMAP_INPUTS 36
#define UMAP_OUTPUTS 2
#define EMBEDDED_INPUTS  2
#define EMBEDDED_OUTPUTS 1

//--- Our forecasting periods
#define HORIZON 10

//--- Our desired time frame
#define SYSTEM_TIMEFRAME_1 PERIOD_D1
Agora vamos carregar nossos modelos ONNX.
//+------------------------------------------------------------------+
//| Load our ONNX models as resources                                |
//+------------------------------------------------------------------+

//--- ONNX Model Prototypes
#resource  "\\Files\\EURGBP WPR UMAP.onnx" as const uchar umap_proto[];
#resource  "\\Files\\EURGBP WPR EMBEDDED.onnx" as const uchar embedded_proto[];
Em seguida, carregaremos as bibliotecas necessárias para a aplicação.
//+------------------------------------------------------------------+
//| Libraries We Need                                                |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Indicators\WPR.mqh>
#include <VolatilityDoctor\ONNX\OnnxFloat.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
Vamos definir as variáveis globais que utilizaremos ao longo de todo o programa. Observe que precisamos declarar apenas algumas variáveis globais. É exatamente isso que mencionamos na introdução desta discussão ao afirmar que a OOP nos ajuda a gerenciar o espaço de nomes de nossas aplicações. A maioria das variáveis e objetos que utilizamos está devidamente encapsulada nas classes que desenvolvemos.
//+------------------------------------------------------------------+
//| Global varaibles                                                 |
//+------------------------------------------------------------------+
CTrade Trade;
TradeInfo *TradeInformation;

//--- Our time object let's us know when a new candle has fully formed on the specified time-frame
Time *eurgbp_daily;

//--- All our different William's Percent Range Periods will be kept in a single array
WPR *wpr_array[14];

//--- Our ONNX class objects have usefull functions designed for rapid ONNX development
ONNXFloat *umap_onnx,*embedded_onnx;

//--- Model forecast
double expected_return;

int position_timer;
Também copiamos os valores de Z1 e Z2 utilizados para dimensionar os dados de treinamento em Python.
//--- The average column values from the training set
double Z1[] = {7.84311120e-01,  7.87104135e-01,  7.81713516e-01,  7.84343731e-01,
               5.23887980e-04,  5.26022077e-04,  5.25382257e-04,  5.25688880e-04,
               -5.08398234e+01, -5.07130228e+01, -5.05834313e+01, -5.04425081e+01,
               -5.02709031e+01, -5.01349627e+01, -5.00653250e+01, -5.01661938e+01,
               -5.03082375e+01, -5.04550339e+01, -5.05861939e+01, -5.06434696e+01,
               -5.07286211e+01, -5.07819768e+01,  1.96979782e-02,  5.29204133e-02,
               4.12732506e-02,  3.20037455e-02,  2.61762719e-02,  2.34184127e-02,
               2.62342592e-02,  3.32894491e-02,  3.81853070e-02,  3.85464026e-02,
               3.85499926e-02,  3.94004124e-02,  4.02388908e-02,  4.02388908e-02
               };

//--- The column standard deviation from the training set
double Z2[] = {8.29473604e-02, 8.35406090e-02, 8.23981331e-02, 8.28950223e-02,
               1.21995172e-02, 1.22880295e-02, 1.20471133e-02, 1.21798952e-02,
               3.00742110e+01, 3.05948913e+01, 3.05244154e+01, 3.03776475e+01,
               3.02862706e+01, 3.00844693e+01, 2.98788650e+01, 2.97182936e+01,
               2.95133008e+01, 2.93983475e+01, 2.92679071e+01, 2.91072869e+01,
               2.90154368e+01, 2.89821474e+01, 4.32293242e+01, 4.43537714e+01,
               4.02730688e+01, 3.66106699e+01, 3.41930128e+01, 3.21743917e+01,
               3.03647897e+01, 2.87462989e+01, 2.73771066e+01, 2.63857585e+01,
               2.54625376e+01, 2.43656339e+01, 2.33983568e+01, 2.26334633e+01
              };
Durante a inicialização, configuraremos nossos indicadores e inicializaremos as classes personalizadas. Se alguma delas não for inicializada corretamente, interromperemos a inicialização e informaremos ao usuário o que ocorreu.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- Do no display the indicators, they will clutter our view
   TesterHideIndicators(true);

//--- Setup our pointers to our WPR objects
   update_indicators();

//--- Get trade information on the symbol
   TradeInformation = new TradeInfo(Symbol(),SYSTEM_TIMEFRAME_1);

//--- Create our ONNXFloat objects
   umap_onnx     = new ONNXFloat(umap_proto);
   embedded_onnx = new ONNXFloat(embedded_proto);

//--- Create our Time management object
   eurgbp_daily = new Time(Symbol(),SYSTEM_TIMEFRAME_1);

//--- Check if the models are valid
   if(!umap_onnx.OnnxModelIsValid())
      return(INIT_FAILED);
   if(!embedded_onnx.OnnxModelIsValid())
      return(INIT_FAILED);

//--- Reset our position timer
   position_timer = 0;

//--- Specify the models I/O shapes
   if(!umap_onnx.DefineOnnxInputShape(0,1,UMAP_INPUTS))
      return(INIT_FAILED);
   if(!embedded_onnx.DefineOnnxInputShape(0,1,EMBEDDED_INPUTS))
      return(INIT_FAILED);

   if(!umap_onnx.DefineOnnxOutputShape(0,1,UMAP_OUTPUTS))
      return(INIT_FAILED);
   if(!embedded_onnx.DefineOnnxOutputShape(0,1,EMBEDDED_OUTPUTS))
      return(INIT_FAILED);

//---
   return(INIT_SUCCEEDED);
  }
Durante a desinicialização, liberaremos a memória e excluiremos os ponteiros que criamos para nossos objetos. Essa é uma boa prática de programação em MQL5 e ajuda a evitar problemas como vazamentos de memória ou estouro de buffer. O risco aumenta quando várias instâncias da aplicação são executadas na mesma máquina sem liberar adequadamente os recursos utilizados. Também vale observar que desenvolvedores com experiência não apenas em MQL5, mas especialmente em linguagens como C, talvez já estejam familiarizados com ponteiros como endereços de memória.
Aqui é necessário fazer um esclarecimento importante: os mecanismos de segurança incorporados ao MQL5 não permitem acesso direto à memória. Em vez disso, os desenvolvedores da MetaQuotes encontraram uma solução alternativa: cada objeto recebe um identificador exclusivo, que é então associado ao objeto correspondente. Portanto, os leitores que já estão familiarizados com ponteiros devem observar que a implementação de ponteiros em MQL5 não expõe endereços de memória ao desenvolvedor, pois os desenvolvedores do MQL5 consideraram esse tipo de acesso uma vulnerabilidade de segurança.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//--- Delete the pointers for our custom objects
   delete umap_onnx;
   delete embedded_onnx;
   delete eurgbp_daily;
   //--- Delete all pointers to our WPR objects
   for(int i = 0; i <= 13; i++)
     {
         delete wpr_array[i];
     }
  }
Sempre que recebemos preços atualizados, utilizamos o objeto Time para verificar se uma nova vela diária foi formada. Em caso afirmativo, atualizamos as leituras dos indicadores e, em seguida, se não houver operações abertas, procuramos uma oportunidade de negociação; caso contrário, gerenciamos as operações já abertas.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- Do we have a new daily candle?
   if(eurgbp_daily.NewCandle())
     {
      static int i = 0;
      Print(i+=1);
      update_indicators();

      if(PositionsTotal() == 0)
        {
         position_timer =0;
         find_setup();
        }

      else
         if((PositionsTotal() > 0) && (position_timer < HORIZON))
            position_timer += 1;

         else
            if((PositionsTotal() > 0) && (position_timer >= (HORIZON -1)))
               Trade.PositionClose(Symbol());

      Comment("Position Timer: ",position_timer);
     }
  }
Para encontrar a estratégia de negociação ideal, basta obter os dados de mercado correspondentes e prepará-los como dados de entrada para nosso modelo ONNX. Observe que, antes de armazenar os dados de entrada em um vetor constante do tipo vectorf, subtraímos a média de cada coluna e dividimos o resultado pelo desvio-padrão da respectiva coluna. Em seguida, passamos esse vetor constante para o método ONNXFloat.Predict() e obtemos a previsão do modelo. A criação dessas classes nos permitiu reduzir significativamente a quantidade total de linhas de código que precisamos escrever.
//+------------------------------------------------------------------+
//| Find A Trading Setup For Us                                      |
//+------------------------------------------------------------------+
void find_setup(void)
  {
//--- Update our indicators
   update_indicators();

//--- Prepare our input vector
   vectorf market_state(UMAP_INPUTS);

//--- Fill in the Market Data that has to embedded into UMAP form
   market_state[0] = (float) iOpen(_Symbol,SYSTEM_TIMEFRAME_1,0);
   market_state[1] = (float) iHigh(_Symbol,SYSTEM_TIMEFRAME_1,0);
   market_state[2] = (float) iLow(_Symbol,SYSTEM_TIMEFRAME_1,0);
   market_state[3] = (float) iClose(_Symbol,SYSTEM_TIMEFRAME_1,0);
   market_state[4] = (float)(iOpen(_Symbol,SYSTEM_TIMEFRAME_1,0) - iOpen(Symbol(),SYSTEM_TIMEFRAME_1,HORIZON));
   market_state[5] = (float)(iHigh(_Symbol,SYSTEM_TIMEFRAME_1,0) - iHigh(Symbol(),SYSTEM_TIMEFRAME_1,HORIZON));
   market_state[6] = (float)(iLow(_Symbol,SYSTEM_TIMEFRAME_1,0) - iLow(Symbol(),SYSTEM_TIMEFRAME_1,HORIZON));
   market_state[7] = (float)(iClose(_Symbol,SYSTEM_TIMEFRAME_1,0) - iClose(Symbol(),SYSTEM_TIMEFRAME_1,HORIZON));
   market_state[8] = (float) wpr_array[0].GetReadingAt(0);
   market_state[9] = (float) wpr_array[1].GetReadingAt(0);
   market_state[10] = (float) wpr_array[2].GetReadingAt(0);
   market_state[11] = (float) wpr_array[3].GetReadingAt(0);
   market_state[12] = (float) wpr_array[4].GetReadingAt(0);
   market_state[13] = (float) wpr_array[5].GetReadingAt(0);
   market_state[14] = (float) wpr_array[6].GetReadingAt(0);
   market_state[15] = (float) wpr_array[7].GetReadingAt(0);
   market_state[16] = (float) wpr_array[8].GetReadingAt(0);
   market_state[17] = (float) wpr_array[9].GetReadingAt(0);
   market_state[18] = (float) wpr_array[10].GetReadingAt(0);
   market_state[19] = (float) wpr_array[11].GetReadingAt(0);
   market_state[20] = (float) wpr_array[12].GetReadingAt(0);
   market_state[21] = (float) wpr_array[13].GetReadingAt(0);
   market_state[22] = (float) wpr_array[0].GetDifferencedReadingAt(0);
   market_state[23] = (float) wpr_array[1].GetDifferencedReadingAt(0);
   market_state[24] = (float) wpr_array[2].GetDifferencedReadingAt(0);
   market_state[25] = (float) wpr_array[3].GetDifferencedReadingAt(0);
   market_state[26] = (float) wpr_array[4].GetDifferencedReadingAt(0);
   market_state[27] = (float) wpr_array[5].GetDifferencedReadingAt(0);
   market_state[27] = (float) wpr_array[6].GetDifferencedReadingAt(0);
   market_state[29] = (float) wpr_array[7].GetDifferencedReadingAt(0);
   market_state[30] = (float) wpr_array[8].GetDifferencedReadingAt(0);
   market_state[31] = (float) wpr_array[9].GetDifferencedReadingAt(0);
   market_state[32] = (float) wpr_array[10].GetDifferencedReadingAt(0);
   market_state[33] = (float) wpr_array[11].GetDifferencedReadingAt(0);
   market_state[34] = (float) wpr_array[12].GetDifferencedReadingAt(0);
   market_state[35] = (float) wpr_array[13].GetDifferencedReadingAt(0);

//--- Standardize and scale each input
   for(int i =0; i < UMAP_INPUTS;i++)
     {
      market_state[i] = (float)((market_state[i] - Z1[i]) / Z2[i]);
     };

   const vectorf onnx_inputs = market_state;

   const vectorf umap_predictions = umap_onnx.Predict(onnx_inputs);
   Print("UMAP Model Returned Embeddings: ",umap_predictions);

   const vectorf expected_eurgbp_return = embedded_onnx.Predict(umap_predictions);
   Print("Embeddings Model Expects EURGBP Returns: ",expected_eurgbp_return);
   expected_return = expected_eurgbp_return[0];

   vector o,c;

   o.CopyRates(Symbol(),SYSTEM_TIMEFRAME_1,COPY_RATES_OPEN,0,HORIZON);
   c.CopyRates(Symbol(),SYSTEM_TIMEFRAME_1,COPY_RATES_CLOSE,0,HORIZON);

   bool bullish_reversal   = o.Mean() < c.Mean();
   bool bearish_reversal   = o.Mean() > c.Mean();

   if(bearish_reversal)
     {
      if(expected_return > 0)
        {
         Trade.Buy((TradeInformation.MinVolume()*2),Symbol(),TradeInformation.GetAsk(),0,0,"");
         return;
        }

      Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),0,0,"");
      return;
     }

   else
      if(bullish_reversal)
        {
         if(expected_return < 0)
           {
            Trade.Sell((TradeInformation.MinVolume()*2),Symbol(),TradeInformation.GetBid(),0,0,"");
           }

         Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),0,0,"");
         return;
        }

  }
Esta é a implementação do método que utilizamos para atualizar nossos indicadores técnicos.
//+------------------------------------------------------------------+
//| Update our indicator readings                                    |
//+------------------------------------------------------------------+
void update_indicators(void)
  {
//--- Store pointers to our WPR objects
   for(int i = 0; i <= 13; i++)
     {
      //--- Create an WPR object
      wpr_array[i] = new WPR(Symbol(),SYSTEM_TIMEFRAME_1,((i+1) * 5));
      //--- Set the WPR buffers
      wpr_array[i].SetIndicatorValues(60,true);
      wpr_array[i].SetDifferencedIndicatorValues(60,HORIZON,true);
     }
  }
Por fim, lembre-se sempre de remover, ao final do programa, as definições das constantes do sistema que você criou.
//+------------------------------------------------------------------+
//| Undefine system constants we no longer need                      |
//+------------------------------------------------------------------+
#undef EMBEDDED_INPUTS
#undef EMBEDDED_OUTPUTS
#undef UMAP_INPUTS
#undef UMAP_OUTPUTS
#undef HORIZON
#undef SYSTEM_TIMEFRAME_1
//+------------------------------------------------------------------+
Ao executar a aplicação, ela deverá ter uma aparência semelhante à mostrada na Fig. 10 abaixo. Isso é esperado, e tudo o que precisamos fazer é adicionar mais uma linha de código à rotina de inicialização para instruir o terminal a não exibir os indicadores durante os testes.
//--- Do no display the indicators, they will clutter our view
   TesterHideIndicators(true);
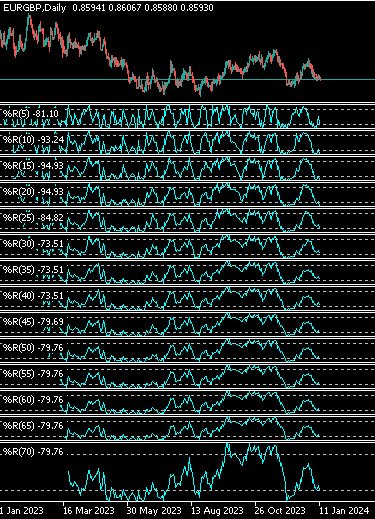
Fig. 10. Inicialmente, nossa visualização ficará sobrecarregada devido ao grande número de indicadores que utilizamos
Depois disso, podemos iniciar o teste com dados históricos. Vale lembrar que nossas amostras de treinamento abrangiam o período de novembro de 2002 a agosto de 2018; portanto, o teste com dados históricos deveria começar em setembro de 2018 e se estender até o presente. Infelizmente, minha conexão com a internet estava instável e não consegui baixar de forma confiável os dados históricos da minha corretora. Por isso, tive de realizar os testes do início de 2023 até o presente.
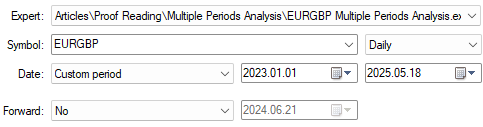
Fig. 11. Datas do teste com dados históricos
Sempre preferimos utilizar ticks baseados em dados reais para obter uma simulação mais realista do comportamento passado do mercado. Isso pode gerar uma carga considerável na sua rede, pois o volume de dados solicitado será elevado.
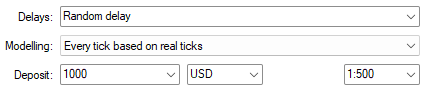
Fig. 12. As configurações utilizadas para testar a estratégia também são importantes
As classes que criamos fornecerão feedback contínuo durante os testes com dados históricos. Podemos verificar a ocorrência de erros examinando as mensagens exibidas. Como mostra a Fig. 13, nossas classes funcionam conforme o esperado e nenhum erro é registrado nos logs.
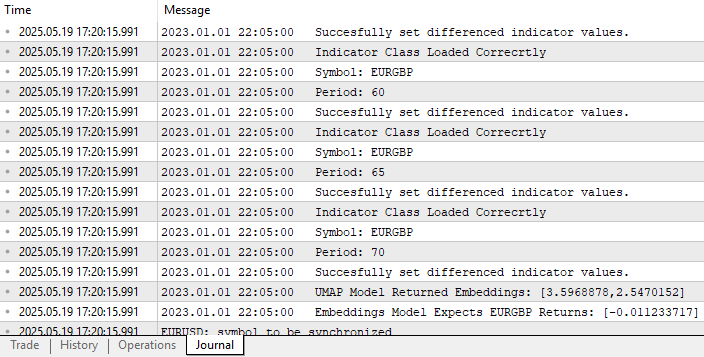
Fig. 13. As classes que criamos fornecerão feedback durante os testes com dados históricos. O feedback deve ser positivo e sempre terminar com uma previsão do modelo, caso não haja posições abertas.
Também podemos visualizar a curva de capital gerada pela nossa estratégia. Ela apresenta uma tendência ascendente de longo prazo, o que nos incentiva a continuar desenvolvendo a estratégia e, sempre que possível, buscar mecanismos adicionais de proteção para limitar as perdas.
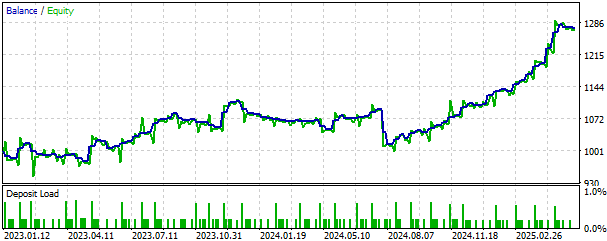
Fig. 14. Visualização da curva de capital gerada pela nossa estratégia de negociação.
Por fim, também podemos visualizar uma análise detalhada do desempenho da nossa estratégia de negociação. Como podemos observar, a estratégia apresentou uma taxa de acerto de 58% considerando todas as operações realizadas, além de um índice de Sharpe de 0,90.
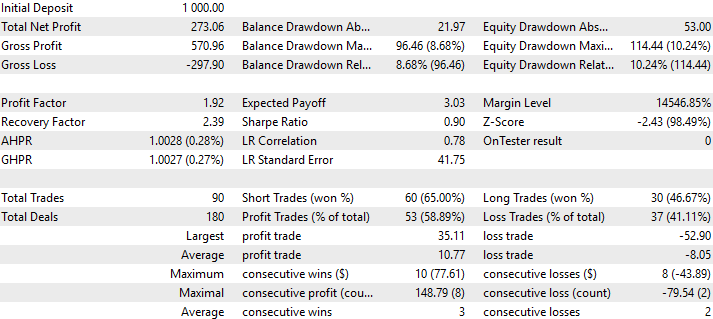
Fig. 15. Análise detalhada do desempenho da nossa estratégia de negociação com dados que ela ainda não havia visto
Conclusão
Analisamos benefícios da modelagem estatística que vão além da tarefa convencional de previsão de preços. Mostramos que:
- O machine learning pode ser utilizado na gestão de capital: ao aumentar o tamanho do lote quando nosso modelo confirma o sinal de negociação, estamos, na prática, transferindo ao modelo estatístico o controle sobre o volume das operações, permitindo que o sistema abra posições maiores quando estiver "mais confiante".
- O machine learning também pode ser utilizado para identificar formas mais informativas de analisar os dados: podemos recorrer a uma família de algoritmos de machine learning conhecida como métodos de redução de dimensionalidade para comprimir nossos dados, o que nos permite identificar padrões relevantes em grandes conjuntos de dados.
Isso significa que o leitor pode substituir o indicador WPR por uma combinação de seus indicadores preferidos e, aplicando os métodos de redução de dimensionalidade apresentados neste artigo, encontrar novas formas de representar suas próprias estratégias, potencialmente melhorando os resultados de negociação. Foi exatamente isso que observamos anteriormente, quando o modelo baseado em uma representação UMAP com apenas 2 colunas, derivadas das 36 colunas originais, apresentou desempenho superior ao obtido com os dados de mercado em sua forma original.
Além disso, o uso do algoritmo UMAP proposto neste artigo oferece diversas vantagens em relação a métodos populares como PCA (Principal Component Analysis, análise de componentes principais). Podemos destacar alguns benefícios práticos:
- UMAP é um método não linear: métodos populares de redução de dimensionalidade, como PCA, partem essencialmente do pressuposto de que existem relações lineares nos dados. Esses métodos perdem eficácia quando essa hipótese não se sustenta. O UMAP, por outro lado, foi desenvolvido especificamente para identificar relações não lineares. O leitor não deve interpretar isso como se o UMAP fosse mais "poderoso" que o PCA; é mais adequado dizer que o UMAP é mais "flexível" que o PCA.
- UMAP trabalha com a geometria dos dados, e não apenas com distâncias euclidianas: isso significa que o UMAP leva em consideração a estrutura geométrica dos dados, e não somente distâncias em linha reta. Diferentemente de métodos como PCA, que representam os dados por meio de relações lineares, o UMAP acompanha a curvatura presente nos próprios dados. O UMAP não parte da ideia de que a Terra é plana; em vez disso, assume que os dados podem estar distribuídos sobre uma superfície curva chamada variedade riemanniana, conceito oriundo da topologia matemática e utilizado para descrever espaços não lineares complexos. Isso permite ao UMAP preservar a geometria dos dados: ele acompanha sua estrutura, em vez de suavizá-la.
Para concluir, analisamos o valor da programação orientada a objetos em MQL5. Embora a programação orientada a objetos (OOP) seja considerada uma tecnologia ultrapassada, ela continua sendo extremamente valiosa, pois permite centralizar o gerenciamento e o tratamento de erros em um único arquivo. Isso economiza tempo ao evitar a repetição de trechos padronizados de código e nos permite transformar rapidamente nossas ideias em implementações com resultados previsíveis.
| Nome do arquivo | Descrição do arquivo |
|---|---|
| Use_All_Data.ipynb | Jupyter Notebook para análise dos dados de mercado. |
| Fetch_Data_Algorithmic_Input_Selection.mq5 | Script MQL5 para obter os dados de mercado necessários. |
| EURGBP_Multiple_Periods_Analysis.mq5 | EA que desenvolvemos para utilizar simultaneamente 14 períodos diferentes do WPR. |
| EURGBP_WPR_Algorithmic_Input_Selection.csv | Dados históricos de mercado fornecidos pela corretora. |
| EURGBP_WPR_EMBEDDED.onnx | Modelo ONNX responsável por aproximar a transformação UMAP que reduz 36 colunas de dados a dois embeddings. |
| EURGBP_WPR_UMAP.onnx | Modelo ONNX responsável por prever o retorno do mercado EURGBP com base nos dois embeddings UMAP. |
| EURGBP_Multiple_Periods_Analysis.ex5 | Versão compilada do nosso EA. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18187
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 67): Uso dos padrões do TRIX e da Faixa Percentual de Williams
 Trading com o calendário econômico MQL5 (Parte 10): Painel arrastável e efeitos de hover nos botões
 Ciência de Dados e ML (Parte 36): Lidando com Mercados Financeiros Tendenciosos
 Criando um Painel Administrativo de Trading em MQL5 (Parte X): Interface baseada em recursos externos

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso