

取引におけるニューラルネットワーク:Adaptive Graph Diffusionモデル(最終回)
 13
 0

はじめに
本日は、SAGDFNフレームワークの著者らが提案した手法の実装作業を締めくくります。 このフレームワークの著者らは、時空間予測における最も差し迫った問題、すなわち大規模グラフの処理の複雑さが増す一方であるという問題に対して、解決策の1つを提案しました。 従来のグラフニューラルネットワーク(GNN)モデルには、接続の冗長性という課題があります。すなわち、ノードの数が増えるほど、重要でない相互作用の洪水の中で、意味のある情報が失われてしまう可能性が高くなります。 すべての接続を無差別に処理しようとすると、計算負荷がノード数の2乗に比例して増加し、モデルの汎化能力が低下します。 SAGDFNの著者らは、真に重要な関係にのみ焦点を当て、データ処理の初期段階で無関係な関係を除外することで、この悪循環を断ち切ることを提案しました。
Significant Neighbors Sampling(SNS、重要近傍サンプリング)モジュールは、この構想における最初の構成要素でした。 その目的は、各ノードについて、最大の予測価値をもたらす関連性の高い近傍ノードの集合を特定することです。 従来のアプローチでは、グラフモデルはすべての近傍ノードを区別なく考慮するか、固定された構造に厳密に制限されるかのいずれかです。SNSはさらに一歩進んで、類似度指標に基づいて最も近い候補と、多様性を維持するためにランダムに選択された要素の両方を分析することで、接続の集合を動的に形成します。 これにより、グラフの次元数が低減されるだけでなく、モデルが事前に定義された構造に縛られることなく、接続の重要度を示すマップを適応的に構築することを学習するため、過学習のリスクも低減されます。
グラフ構造が形成されると、Sparse Spatial Multi-Head Attention(SSMHA)が機能し始めます。これは、前のステップで得られた疎な構造に対して動作する適応型Attention機構です。 このモジュールは、2つの重要な機能を同時に果たします。すなわち、近傍ノード間で重みを再配分すると同時に、Multi-Head Attentionを通じて各ノードがコンテキストのさまざまな側面を考慮できるようにします。 すべての重みの和が常に厳密に正規化される従来のSoftMaxとは異なり、SAGDFNではα-Entmaxを採用しており、これにより重要性の低い接続をより積極的にゼロにすることができます。 α = 1の場合、この関数は標準的なSoftMaxに帰着し、α = 2の場合、Sparse-SoftMaxに帰着します。Sparse-SoftMaxでは、重要度の低い要素が事実上計算から除外されます。 これにより、モデルに柔軟性がもたらされます。 重要な場面では、微弱な信号に対しても高い感度を維持することができます。 また、グラフが過密になった場合でも、真に重要なノードに焦点を当てることができます。
同様に重要なもう1つの構成要素が、OneStepFastGConvです。これは、空間特徴量の変換を1ステップで実行し、冗長な演算の連鎖を回避する、最適化されたグラフ畳み込みです。 この手法では、それぞれごくわずかな変換しかおこなわない複数の層を順次適用する代わりに、1ステップの集約をおこなうため、学習速度が向上し、メモリ要件も軽減されます。 このアプローチは、データ処理の1ミリ秒も無駄にできないリアルタイムのタスクで特に重要です。
これらのモジュールが連携して機能する様子は、息の合ったオーケストラを彷彿とさせます。SNSが主要な演奏者を選び、SSMHAが各演奏者に役割やアクセントを割り当て、FastGConvがこの不協和音のような信号群を、予測という調和のとれたメロディーへと変換するのです。 さらに、すべての要素は当初から拡張性を考慮して設計されています。 つまり、これらの要素は、比較的コンパクトなグラフだけでなく、数千のノードと数百万の潜在的な接続からなる大規模な構造でも、効率的に機能します。
以下に、著者が作成したSAGDFNフレームワークの構成図を示します。
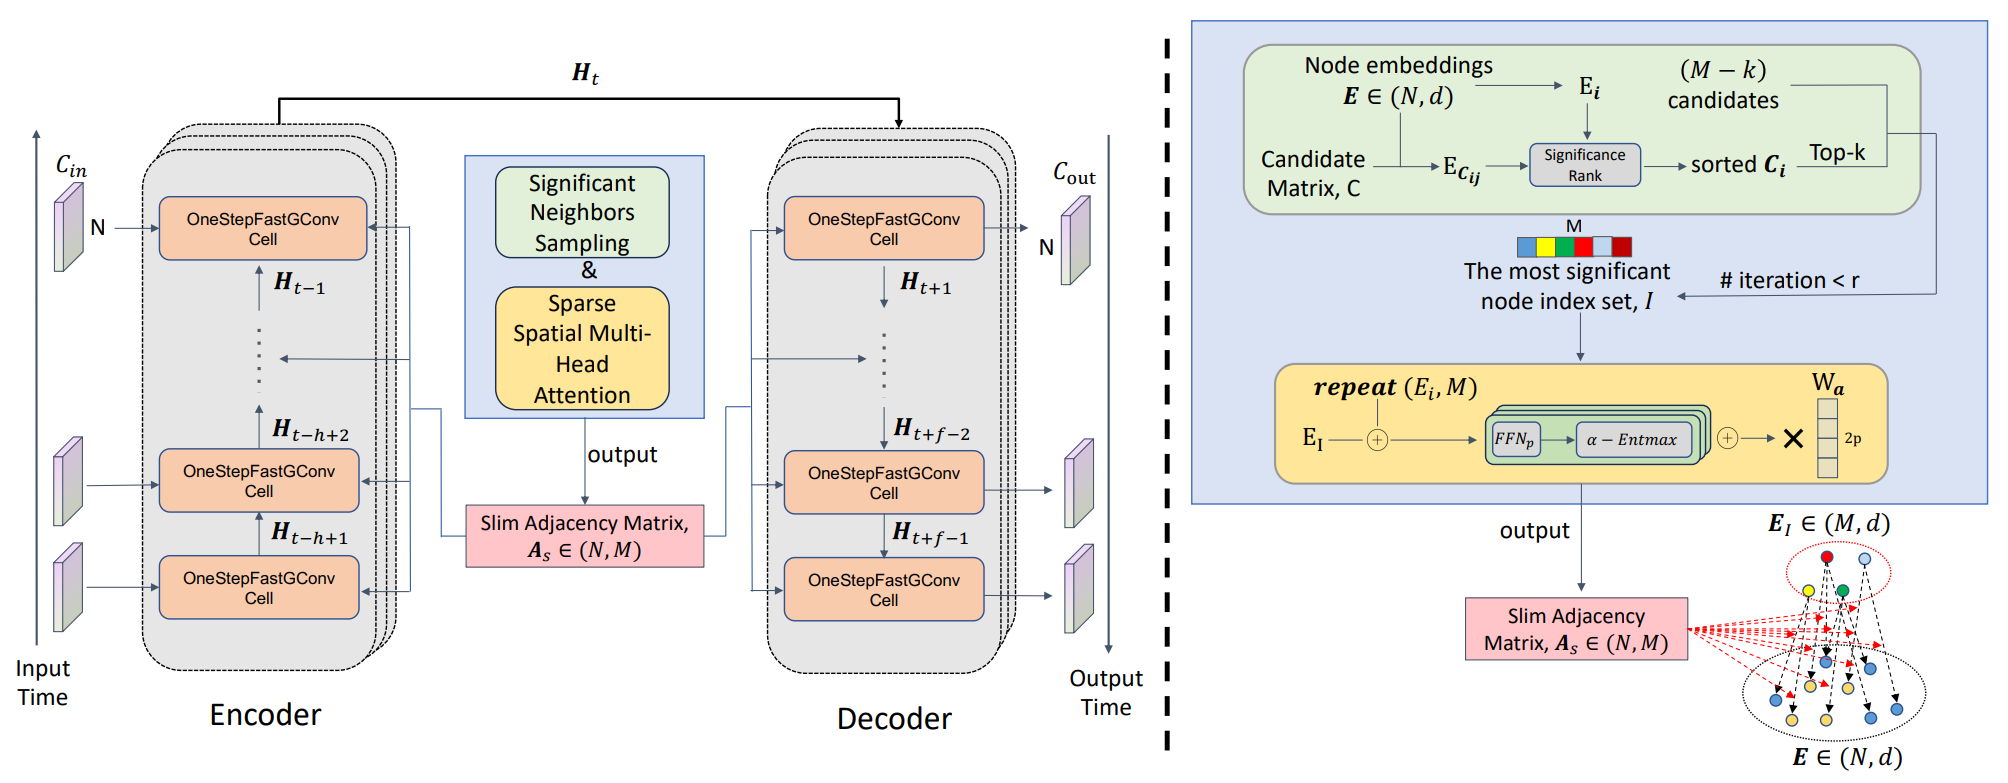
これまでの記事では、このフレームワークの主要な構成要素について体系的に検討してきました。 Significant Neighbors SamplingとSparse Spatial Multi-Head Attentionの両モジュールを、MQL5とOpenCLを用いて段階的に実装しました。 この過程では、元のアルゴリズムを単にそのまま再現したわけではありません。むしろ、モデルの計算効率と安定性を高めるために、いくつもの重要な最適化を施しました。 そこで、反復型のα-Entmax関数は最適なパラメータτの探索に多大なリソースを要するため、代わりに、より軽量で安定したSparse-SoftMaxを使用しました。 これにより、重要でない要素を選択的に除外するという考え方を維持しつつ、プロセッサの負荷を軽減できました。 さらに、近傍サンプリングモジュールにおける接続の形成手順が改善されました。 以前に選択した候補とランダムに選んだ候補を並列に評価することで、接続の多様性を高め、有用な情報を失う可能性を低減できました。
グラフを構築し、そのノード間で重みを配分する仕組みが整ったので、次の段階であるOneStepFastGConvモジュールの実装へ進みましょう。 このコンポーネントは、空間情報を集約し、最終的な予測の基礎となる特徴量を生成するため、SAGDFNアーキテクチャで特別な役割を果たします。
再帰型グラフ畳み込みオブジェクト
前回の記事では、すでにグラフ構造を構築し(重要近傍サンプリング)、主要な接続間で重みを慎重に配分する方法(Sparse Spatial Multi-Head Attention)を学びました。その流れを引き継ぎ、今回は再帰ブロックの中核となる高速グラフ畳み込みを取り上げます。 再帰型グラフモジュールに取り組むのは、今回が初めてではありません。HimNetではGCRUを使用し、密な構造で非常に優れた性能を得ました。 しかし、SAGDFNでは状況が異なります。 ここでは意図的に相互依存関係を表す疎行列を用いており、まさにこの疎性によって、異なるアルゴリズム上のアプローチが必要になります。 砂の上の家を建てることにならないよう、まずはOneStepFastGConvの基盤となる基本演算、すなわち疎行列と密行列の効率的な乗算から始めましょう。
この段階は極めて重要です。先に得られた疎な関係構造を、データ処理全体の枠組みに効率的に組み込めるようになるからです。 そのために、OpenCLプログラム内に、パフォーマンスとメモリ効率を優先しつつ、この演算を可能な限り簡潔に実行するカーネルを作成します。
__kernel void SparseMatMult(__global const float *sparse_index,
                            __global const float *sparse_data,
                            __global const float *full,
                            __global float *result,
                            const int full_rows
                           )
  {
   const size_t sparse_row = get_global_id(0);
   const size_t sparse_col = get_local_id(1);
   const size_t full_col = get_global_id(2);
   const size_t sparse_rows = get_global_size(0);
   const size_t sparse_cols = get_local_size(1);
   const size_t full_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
カーネルは実行開始時に、処理するタスクの座標、すなわち疎行列の行インデックスと列インデックスを決定します。このうち、列インデックスはワークグループ単位でまとめられています。 また、密行列の列インデックスも決定します。 これらのパラメータは一種の座標の3つ組を構成し、各ワークアイテムが担当するデータ領域を正確に特定できるようにします。 次に、すべての次元のサイズが決定されます。 これらは、各要素のアドレスを正しく計算するために必要です。
その後、ローカル配列Tempが確保され、ワークグループ内での同期と中間値の合計に使用されます。
次のステップでは、各ワークアイテムが、疎行列の現在の要素に対するメモリオフセットを決定し、密行列内の対応する行のインデックスを取得します。
   const int shift_sparse = RCtoFlat(sparse_row, sparse_col, sparse_rows, sparse_cols, 0);
   const int full_row = sparse_index[shift_sparse];
   const int shift_full = RCtoFlat(full_row, full_col, full_rows, full_cols, 0);
このインデックスが有効範囲内にある場合、疎行列の係数と密行列の要素の積が計算されます。 それ以外の場合は値として0を使用し、不正な演算を防ぎます。
   float res = (full_row >= 0 && full_row < full_rows ?
                IsNaNOrInf(sparse_data[shift_sparse] * full[shift_full], 0) : 0);
   res = LocalSum(res, 1, Temp);
得られた部分積はローカルな加算処理に渡され、そこでワークグループ内のすべてのワークアイテムの結果が合計されます。 合計処理が完了するとすぐに、各グループの最初のワークアイテム(ローカル列インデックスが0のもの)が、結果行列に最終値を書き込みます。 これにより、計算の並列性とデータ書き込みの制御を両立させ、アクセス競合を防ぐことができます。
   if(sparse_col == 0)
     {
      const int shift_result = RCtoFlat(sparse_row, full_col, sparse_rows, full_cols, 0);
      result[shift_result] = res;
     }
  }
このアプローチにより、GPUリソースを最適に活用することができます。 各ワークアイテムは自身の担当部分だけを処理し、全体の結果を合計することで、最終結果の正確性と一貫性を確保します。
順伝播を実装し、近傍からの寄与を丁寧に集約して出力の特徴量に反映する方法を学んだところで、次のステップは逆伝播です。ここでは、関与するすべての要素に誤差勾配を正しく分配します。 このアルゴリズムは、SparseMatMultGradカーネルに実装されており、以下の引数を受け取ります。
- 疎行列のインデックスと重み
- これらの重みに関する勾配用のバッファ
- 密行列とその勾配バッファ
- 結果の勾配の配列
- すべての次元のサイズ
__kernel void SparseMatMultGrad(__global const float *sparse_index,
                                __global const float *sparse_data,
                                __global float *sparse_gr,
                                __global const float *full,
                                __global float *full_gr,
                                __global const float *result_gr,
                                const int sparse_rows,
                                const int sparse_cols,
                                const int full_rows,
                                const int full_cols
                               )
  {
   const size_t row_id = get_global_id(0);
   const size_t local_id = get_local_id(1);
   const size_t col_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t total_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
カーネル本体では、各ワークアイテムにタスク空間内での座標が割り当てられます。
- row_id:行列内で処理中の行
- local_id:ワークグループ内のローカル識別子
- col_id:行列の列
ローカルメモリバッファTempは、リダクションや、同じワークグループ内のワークアイテム間で少量のデータを転送するために割り当てられます。 これが主要な調整ツールです。これにより、ワークアイテム間で中間結果をやり取りしたり、同期を取ったりすることができます。
ここで留意すべき点は、このカーネルでは、サイズの異なる2つの行列に誤差勾配を分配する必要があるということです。 行識別子と列識別子はいずれも、勾配の計算対象となる行列内の位置を示します。 そのため、カーネルを実行キューに入れる際には、各次元について、両行列のサイズのうち大きい方を使用する予定です。 余分なワークアイテムはカーネル内で除外されます。
まず、疎行列の重みに関する誤差勾配を計算するブロックがあります。 まず、インデックスの範囲をチェックします。現在の位置が有効範囲内にある場合、ワークアイテムはshift_sparseを計算します。これは、疎行列のインデックス配列およびデータ配列を一次元として扱ったときのオフセットです。
//--- Calculate sparse gradient
   if(row_id < sparse_rows && col_id < sparse_cols)
     {
      float grad = 0;
      int shift_sparse = 0;
      if(local_id == 0)
        {
         shift_sparse = RCtoFlat(row_id, col_id, sparse_rows, sparse_cols, 0);
         Temp[0] = sparse_index[shift_sparse];
        }
      BarrierLoc;
      uint full_row = (uint)Temp[0];
local_idが0のワークアイテムは、対応するインデックスを読み取り、ローカルメモリバッファの最初の要素に格納します。これにより、他のワークアイテムは、グローバルメモリに追加でアクセスすることなく、この値を利用できます。
バリア処理の後、ワークグループ内のすべてのワークアイテムは、密行列の行インデックスを把握しています。
取得した行インデックスの正しさを確認することが重要です。 チェックを通過すると、各ワークアイテムは特徴量次元で自身に割り当てられた位置を順に処理し、各要素の寄与を累積します。
      if(full_row < (uint)full_rows)
         for(int i = local_id; i < full_cols; i += total_local)
           {
            int shift_result = RCtoFlat(row_id, i, sparse_rows, full_cols, 0);
            int shift_full = RCtoFlat(full_row, i, full_rows, full_cols, 0);
            grad += IsNaNOrInf(result_gr[shift_result] * full[shift_full], 0);
           }
これは、特徴量に対する典型的なスカラー累積です。結果の各特徴量に対する勾配を求め、それを密行列内の対応するセルの値と掛け合わせ、すべての特徴量について合計します。
ローカル走査が完了すると、ワークグループ内のワークアイテム間でリダクションをおこない、指定された(row_id, col_id)ペアに対する寄与の合計を求めます。
      grad = LocalSum(grad, 1, Temp);
      if(local_id == 0)
         sparse_gr[shift_sparse] = grad;
     }
ワークグループの最終結果をグローバルバッファsparse_grの対応する要素に書き込むのは、1つのワークアイテムだけです。
2つ目の主要な部分である密行列に対する勾配の計算に移ると、逆の問題に直面します。 密行列の各要素について、その要素がブロックの出力に与える寄与を注意深く合計する必要があります。 しかし、ここでは、疎行列の要素との明示的な対応関係がないという問題に直面します。 したがって、必要なポインタを見つけるために、疎行列のインデックス行列全体をスキャンする必要があります。 これこそが、ローカルワークグループのワークアイテムに割り当てるタスクです。
まず、誤差勾配テンソルの各行を順に処理するためのループを設定します。 ここで、誤差勾配テンソルと疎行列の行数が同じであることを思い出してください。
//--- Calc full gradient
   if(row_id < full_rows && col_id < full_cols)
     {
      float grad = 0;
      for(int r = 0; r < sparse_rows; r ++)
        {
         float s = 0;
         for(int c = local_id; c < sparse_cols; c += total_local)
           {
            int shift_sparse = RCtoFlat(r, c, sparse_rows, sparse_cols, 0);
            if((int)sparse_index[shift_sparse] == (int)row_id)
              {
               s = sparse_data[shift_sparse];
               break;
              }
           }
ループ内では、疎行列のインデックスの中から、密行列の現在の行へのポインタを探します。 効率的な並列処理を実現するため、ローカルワークグループ内の各ワークアイテムは、疎行列の列の一部のみをスキャンし、最初の一致が見つかった時点でAttention係数を取得して検索を終了します。
ここで、最近傍の選択処理において、重複を排除する仕組みを実装したことを思い出してください。 したがって、疎行列のどの行でも、同じ接続が複数回出現することはないと考えられます。
次に、LocalSumを使用して、ワークグループ内のすべてのワークアイテムからのAttention係数を集計します。
         s = LocalSum(s, 1, Temp);
         if(s != 0 && local_id == 0)
           {
            int shift_result = RCtoFlat(r, col_id, sparse_rows, full_cols, 0);
            grad += IsNaNOrInf(s * result_gr[shift_result], 0);
           }
        }
合計がゼロでない場合、ワークグループの最初のワークアイテムは、得られた重みにブロックの誤差勾配バッファ内の対応する要素の値を掛け、その結果を変数gradに加算します。
ネストされたループのすべての反復が完了し、依存関係にあるすべての要素からの誤差勾配が累積されると、ワークグループの最初のワークアイテムが、その累積値をグローバルバッファfull_grに書き込みます。
      if(local_id == 0)
        {
         int shift_full = RCtoFlat(row_id, col_id, full_rows, full_cols, 0);
         full_gr[shift_full] = grad;
        }
     }
  }
準備作業が完了したので、メインプログラム内でのOneStepFastGConv再帰ブロックの具体的な実装に移りましょう。 ここでは、提案された手法をCNeuronFastGConvクラス内に実装します。このクラスは、すべての中間バッファとロジックを格納するコンパクトなコンテナとして設計されています。 クラスの構造を以下に示します。
class CNeuronFastGConv   :     public CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL          cInpAndHidden;
   CNeuronBaseOCL          cNormAttention;
   CNeuronBaseOCL          cInvDiag;
   CNeuronBaseOCL          cAX;
   CNeuronBaseOCL          cAXplusX;
   CNeuronBaseOCL          cNormAXplusX;
   CNeuronConvOCL          cZ_R;
   CNeuronBaseOCL          cZ;
   CNeuronBaseOCL          cR;
   CNeuronBaseOCL          cCandidate;
   CNeuronConvOCL          cHC;
   //---
   virtual bool      RandomWalk(CBufferFloat* data,
                                CBufferFloat* normal,
                                CBufferFloat* inv_diag,
                                const int rows,
                                const int cols
                               );
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)  override { return false; };
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override { return false; }
   //---
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronFastGConv(void) {};
                    ~CNeuronFastGConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   virtual bool      CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   //---
   virtual int       Type(void)   const   {  return defNeuronFastGConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   //---
   virtual uint      GetCount(void) const { return (uint)cInvDiag.Neurons(); }
   virtual uint      GetSparseDimension(void) const { return (uint)cNormAttention.Neurons() / GetCount(); }
   virtual uint      GetWindow(void) const { return (uint)Neurons() / GetCount(); }
  };
新しいクラスの構造を見ると、内部オブジェクトがかなり多く存在することがわかります。 ただし、これらはすべて静的に宣言されているため、クラスのコンストラクタとデストラクタを空のままにしておくことができます。 オブジェクトのアーキテクチャを設定するためのアルゴリズム全体が、Init初期化メソッドに移されました。
bool CNeuronFastGConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units, uint window, uint sparse_dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
メソッド内の最初の行では、親クラスに制御が渡されます。 ここでは、層をOpenCLコンテキストにバインドする基本処理と、モジュールがモデル内で機能するために必要な、継承したすべてのインターフェースの作成がおこなわれます。 この初期化が失敗した場合、このメソッドを続行する意味がないため、直ちにfalseを返します。 この早期終了により、さらなるエラーや不要な割り当てを防ぐことができます。
その直後に、活性化関数を明示的に無効にします。 これは理にかなっています。ブロック自体が各コンポーネントの活性化関数(ゲートにはシグモイド、隠れ状態候補にはtanh)を制御するため、ブロック全体に適用する外部の活性化関数は必要ありません。
次に、内部コンポーネントの初期化処理がおこなわれます。 最初のオブジェクトは、前回の隠れ状態と入力データを連結するように設計されています。
   int index = 0;
   if(!cInpAndHidden.Init(0, index, OpenCL, 2 * units * window, optimization, iBatch))
      return false;
次の行では、cNormAttentionを作成します。 ここには、正規化後の圧縮Attention行列Asが格納されます。 この行列は、Sparse Attentionモジュールから重みを受け取ります。
   index++;
   if(!cNormAttention.Init(0, index, OpenCL, units * sparse_dimension, optimization, iBatch))
      return false;
   index++;
   if(!cInvDiag.Init(0, index, OpenCL, units, optimization, iBatch))
      return false;
次に、cInvDiagを見ていきましょう。これは対角要素の逆数からなるベクトルで、正規化の際に拡散結果の各行に乗算するために使用されます。
次に、cAXが作成されます。 このバッファには、SpMMの結果が格納されます。 そのサイズはcInpAndHiddenに基づいており、これにより後続のステップとの次元の整合性が確保されます。
   index++;
   if(!cAX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cNormAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
cAXの次は、和AX + Xを格納するバッファcAXplusXです。 ここでは、対角行列の逆行列を適用する前に、中間結果を明示的に保存します。 このような明示的なバッファにより、デバッグが容易になり、演算の順序を制御できるようになります。
次に、最終的な正規化済みテンソルを格納するcNormAXplusXを作成します。このテンソルは(D+I)-1(AX + X)です。 その後、このテンソルはGRUに似たブロックに入力されます。 これが欠けていると、更新ゲートの仕組みが機能しなくなるため、このチェックも極めて重要です。
次に、cZ_Rを初期化します。 これは、ZゲートとRゲートのロジットを同時に生成するコンパクトな畳み込み層です。 ここでは、活性化関数としてシグモイド関数を使用します。 この手法はシンプルで信頼性が高く、ゲート値は常に[0,1]の範囲内に収まります。
   index++;
   if(!cZ_R.Init(0, index, OpenCL, 2 * window, 2 * window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cZ_R.SetActivationFunction(SIGMOID);
   index++;
   if(!cZ.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
   index++;
   if(!cR.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
次の2つのバッファ、cZとcRは、ゲート値を分離するために作成します。 バッファを個別に用意することで、隠れ状態を段階的に更新するロジックが簡素化されます。
cCandidateを初期化すると、隠れ状態候補を計算するブロックに渡す、連結済みの中間入力を格納するバッファが作成されます。
   index++;
   if(!cCandidate.Init(0, index, OpenCL, 2 * window * units, optimization, iBatch))
      return false;
   index++;
   if(!cHC.Init(0, index, OpenCL, 2 * window, 2 * window, window, units, 1, optimization, iBatch))
      return false;
   cHC.SetActivationFunction(TANH);
//---
   return true;
  }
cHCブロックは、隠れ状態候補を実際に計算します。 活性化関数としてTANHを使用するのは、候補値の範囲を制限し、スケールを安定させる標準的な手法です。
Initメソッド内のすべての呼び出しが正常に完了したら、最後にtrueを返し、層の設定が完了して実行可能な状態になったことを示します。
初期化から実行へとスムーズに移りましょう。 必要なメモリの確保と設定がすべて完了したので、今度はFeedForwardメソッドで、OneStepFastGConvを通る実際のデータの流れを見ていきます。
bool CNeuronFastGConv::FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
まず、このメソッドは入力値をチェックし、ソースデータオブジェクトへのポインタが有効であることを確認します。 これは単純ですが、不可欠な安全策です。データソースまたはSparse Attentionモジュールが存在しない場合、実行を継続できません。 この早期終了により、制御不能な障害を防ぎ、予測可能な診断が可能になります。
次に、層の設定パラメータを取得します。 これらの変数をローカル変数として保持しておくのは非常に便利です。ホットループ内でクラスメソッドを介してこれらを読み込むと、処理が遅くなり、可読性も低下します。
次の行でRandomWalkが起動されます。 これは、Attention行列の前処理ステップです。RandomWalkは、圧縮行列の各行にわたって統計情報を収集し、正規化をおこないます。 その後、cNormAttention (N×M)と、後続の正規化に用いる対角成分の逆数を格納するcInvDiag (N)に書き込みます。 RandomWalkはGPU上で並列実行され、Mにわたる総和を慎重に計算し、安定したinv_diag値を返す点に留意することが重要です。 この手順が失敗した場合は、実行を中断した方がよいでしょう。その後のすべての正規化処理は、この手順に依存しているからです。
   if(!RandomWalk(SparseAttent.getOutput(), cNormAttention.getOutput(), cInvDiag.getOutput(), window, sparse))
      return false;
   if(!SwapOutputs())
      return false;
   if(!Concat(SourceData.getOutput(), PrevOutput, cInpAndHidden.getOutput(), window, window, units))
      return false;
その後、SwapOutputsが実行されます。 これは、前の出力と現在の出力へのポインタを入れ替える、この層の内部メカニズムです(ローリングバッファ)。 この入れ替えにより、PrevOutputにはHt-1が格納され、現在のOutputは書き込みに使用できる状態になります。
次に、SpMM/GRUへの入力が組み立てられます。 ここでは、チャネル次元に沿って連結をおこないます。各行について、現在の観測データの断片Xtと、直前の隠れ状態Ht-1を組み合わせたベクトルを形成します。
準備作業が完了すると、主要な演算を実行します。疎なAttention行列に、入力データと隠れ状態を連結してあらかじめ用意した密行列を掛けます。
   if(!SparseMatMul(SparseAttent.GetIndexes(), cNormAttention.getOutput(), cInpAndHidden.getOutput(),
                                                  cAX.getOutput(), units, sparse, units, 2 * window))
      return false;
   if(!SumAndNormilize(cAX.getOutput(), cInpAndHidden.getOutput(), cAXplusX.getOutput(),
                                                         2 * window, false, 0, 0, 0, 1))
      return false;
次に、自己ループの分を加算します。 ここでは、AX+Xという加算をおこないます。
次のステップは、対角正規化を適用することです。
   if(!DiagMatMul(cInvDiag.getOutput(), cAXplusX.getOutput(), cNormAXplusX.getOutput(), units, 2 * window, 1, None))
      return false;
これは、各行に対して、あらかじめ計算したinv_diagをチャネルごとに掛けるだけの処理です。
次に、各ゲートのロジットを計算します。 cZ_R畳み込み層は、集約して正規化した特徴量を受け取り、2×hiddenのベクトル(ZおよびRのロジット)を返します。 初期化段階でSIGMOID活性化関数が設定されているため、この演算で得られる値は[0,1]の範囲になります。
   if(!cZ_R.FeedForward(cNormAXplusX.AsObject()))
      return false;
   if(!DeConcat(cZ.getOutput(), cR.getOutput(), cZ_R.getOutput(), window, window, units))
      return false;
次に、得られたロジットを個別のバッファに分割します。
その直後に、リセットゲートと前の隠れ状態との要素ごとの乗算をおこないます。 これにより、R⊙Ht-1が得られます。 この結果を、隠れ状態を修正したものとして候補の生成に使用します。
   if(!ElementMult(cR.getOutput(), PrevOutput, cR.getPrevOutput()))
      return false;
次に、候補生成用の入力を作成します。具体的には、R⊙Ht-1と現在のXtを連結します。
   if(!Concat(SourceData.getOutput(), cR.getPrevOutput(), cCandidate.getOutput(), window, window, units))
      return false;
   if(!cHC.FeedForward(cCandidate.AsObject()))
      return false;
   if(!GateElementMult(PrevOutput, cHC.getOutput(), cZ.getOutput(), Output))
      return false;
//---
   return true;
  }
cHC畳み込み層の順伝播メソッドを呼び出すと、非線形変換が実行され、tanhが適用されて、隠れ状態候補が返されます。 続いて、最終的な合成により新しい隠れ状態を生成します。
順伝播の説明から、逆伝播の処理の流れに移ります。ここでは、誤差がOneStepFastGConvの各処理をどのように逆方向に伝播するかを、詳しく確認する必要があります。 この処理は、CalcInputGradientsメソッドに実装されています。
bool CNeuronFastGConv::CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
このメソッドは、最初に安全性を確認します。入力データオブジェクトへの有効なポインタがなければ、実行できる処理はありません。 その場合は、falseを返して処理を適切に終了します。 これは単純ですが、必要なチェックです。後で原因不明のNaN値が発生するよりも、学習処理を早い段階で中断する方が適切です。
次に、設定パラメータが取得されます。 これらの数値は、すべての勾配テンソルの形状を規定するものであり、正しいアドレス指定をおこなうために必要です。
実際に最初に呼び出されるのはGateElementMultGradです。 これは、最終的な合成Ht = Z⊙Ht-1+(1−Z)⊙H̃に対応する逆伝播処理です。
   if(!GateElementMultGrad(PrevOutput, cInpAndHidden.getGradient(),
                           cHC.getOutput(), cHC.getGradient(),
                           cZ.getOutput(), cZ.getGradient(),
                           Gradient, None, cHC.Activation(), cZ_R.Activation()))
      return false;
この関数は、H̃(隠れ状態候補)に対する勾配、Z(更新ゲート)に対する勾配、およびHt-1(前の隠れ状態)に対する勾配の3つを同時に計算し、全体の勾配を各成分に慎重に分解します。
次に、候補生成用の畳み込み層を通じて誤差勾配を伝播させます。
   if(!cCandidate.CalcHiddenGradients(cHC.AsObject()))
      return false;
   if(!DeConcat(SourceData.getGradient(), cR.getPrevOutput(),
                cCandidate.getGradient(), window, window, units))
      return false;
次に、得られた勾配を、入力データに関する部分とR⊙Ht-1に関する部分の2つに分割します。
その後、ElementMultGradが、リセットゲートと前の隠れ状態への勾配の寄与を振り分けます。
   if(!ElementMultGrad(cR.getOutput(), cR.getGradient(),
                       PrevOutput, cInpAndHidden.getGradient(),
                       cR.getPrevOutput(), cZ_R.Activation(), None))
      return false;
次のステップでは、ZおよびRに関する局所勾配を、ロジットのフラットベクトルに再びまとめます。これをcZ_Rに入力し、その層の逆伝播をおこないます。
   if(!Concat(cZ.getGradient(), cR.getGradient(),
              cZ_R.getGradient(), window, window, units))
      return false;
   if(!cNormAXplusX.CalcHiddenGradients(cZ_R.AsObject()))
      return false;
   if(!DiagMatMulGrad(cInvDiag.getOutput(), cInvDiag.getGradient(),
                      cAXplusX.getOutput(), cAX.getGradient(),
                      cNormAXplusX.getGradient(), units, 2 * window, 1))
      return false;
   if(!SparseMatMulGrad(SparseAttent.GetIndexes(), cNormAttention.getOutput(),
                        cNormAttention.getGradient(), cInpAndHidden.getOutput(),
                        cInpAndHidden.getGradient(), cAX.getGradient(),
                        units, sparse, units, 2 * window))
      return false;
次に、ゲートのロジットを生成する畳み込み層で逆伝播を実行します。 その結果、cNormAXplusX、すなわち正規化された集約入力に対する勾配が得られます。
続いて、一連の反復処理により、誤差勾配を連結された入力データテンソルと正規化されたAttention係数に分配します。 まず、対角正規化を通じて勾配を逆伝播させます。 次に、SpMMを展開し、勾配を正規化されたAttention重みと連結された特徴量に割り当てます。
SparseMatMulGradを実行した後、2つのデータパスから得られた、連結された特徴量テンソルに対する誤差勾配を合算する必要がある点に注意してください。
   if(!SumAndNormilize(cAX.getGradient(), cInpAndHidden.getGradient(),
                      cInpAndHidden.getGradient(), 2 * window, false, 0, 0, 0, 1))
      return false;
次に、入力データレベルで誤差勾配を収集する必要があります。 ここでは、入力データを、主要な特徴量の連結と隠れ状態候補を計算するためのテンソルの連結という2つのデータパスで使用したことに留意する必要があります。 2番目のデータパスからの誤差勾配は、すでに伝播済みです。 次に、2番目のデータパスから値を抽出し、先に取得した値にそれらを加算する必要があります。
   if(!DeConcat(cAXplusX.getGradient(), cAXplusX.getPrevOutput(),
                cInpAndHidden.getGradient(), window, window, units))
      return false;
   if(!SumAndNormilize(SourceData.getGradient(), cAXplusX.getGradient(),
                      SourceData.getGradient(), window, false, 0, 0, 0, 1))
      return false;
   if(SourceData.Activation() != None)
      if(!DeActivation(SourceData.getOutput(), SourceData.getGradient(),
                       SourceData.getGradient(), SourceData.Activation()))
         return false;
また、入力データテンソルに活性化関数が設定されているかどうかも確認する必要があります。 必要に応じて、その活性化関数の導関数を用いて、得られた値を補正します。
最後の重要なステップは、正規化されたAttention行列cNormAttentionから、正規化前の状態であるSparseAttentへ誤差勾配を伝播させることです。 順伝播では正規化をおこないましたが、ここではこの対角正規化のステップを逆にたどり、SparseAttentモジュールが想定する形式で勾配を戻します。
   if(!DiagMatMul(cInvDiag.getOutput(), cNormAttention.getGradient(),
                  SparseAttent.getGradient(), units, sparse, 1, None))
      return false;
//---
   return true;
  }
最後に、このメソッドはtrueを返します。これは、すべての勾配が正しく逆伝播され、対応する入力および内部パラメータに対して正確に累積されたことを意味します。
以上で、CNeuronFastGConvクラスのメソッドを実装するために使用されるアルゴリズムに関する説明を終わります。 このオブジェクトとそのすべてのメソッドに関する完全なコードは、添付ファイルに含まれています。
最上位のSAGDFNオブジェクト
単一の再帰ブロックのオブジェクトを構築した後、最上位レベル、つまりエンコーダとデコーダを一体のシステムに結びつけるラッパーへと進みます。 CNeuronSAGDFNクラスは単なるコンテナにとどまらず、データフローを整理し、同一の圧縮隣接行列の共有を管理し、モデル全体を通じて時間的および空間的な変換の一貫性を確保します。
class CNeuronSAGDFN  :  public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cTranspose;
   CLayer                  cEmbedding;
   CNeuronSNSMHAttention   cAttention;
   CLayer                  cGCRU;
   CLayer                  cProjection;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSAGDFN(void) {};
                    ~CNeuronSAGDFN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps, uint variables, uint embedding_dim,
                          uint emb_layers, uint sparse_dimension, uint heads,
                          float sparse, uint gcru_layers,
                          uint forecast, uint forec_layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSAGDFN;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
CNeuronSAGDFNクラスの動作を設計する際には、SAGDFNフレームワークが、マルチモーダル時系列における単変量系列間の相関を分析して重要な空間的依存関係を特定することを基盤としている点に留意する必要があります。 一方、私たちは通常、時系列データを扱っています。 そこで、このオブジェクト内で、ソースデータテンソルの転置と、結果テンソルの逆転置を実装しました。
前者の操作を実行するために対応する内部オブジェクトを宣言し、後者の操作は親クラスであるCNeuronTransposeOCLを用いて実行する予定です。 この方法により、モジュールに入力するデータの準備作業が簡素化され、既存のパイプラインへのモデルの統合が容易になります。
さらに、オブジェクトのアーキテクチャを動的に変更できる機能も実装しました。 これを実現するために、次の3つの動的配列を組み込みました。
- cEmbedding:入力データから指定されたサイズの埋め込みを生成するためのミニモデル
- cGCRU:順次接続されたGCRU(グラフ畳み込み再帰ユニット)からなるスタックで、一連のOneStepFastGConvブロックを集約します
- cProjection:デコーダで隠れ表現を目的の予測値に変換する投影ブロック
このアプローチにより、再帰スタックの深さを柔軟に増やしたり、拡散ステップ数を変えて実験したりできます。CNeuronSAGDFNは、入力の転置、埋め込み、共有のAttention、およびGCRUスタックを単一のEncoder-Decoderに統合しています。 このクラスは、スタック全体で同じ圧縮隣接行列を再利用する仕組みを管理し、データ形式の互換性を確保するとともに、学習時の中核的な調整役を担います。
新しいオブジェクトのアーキテクチャの実際の構築は、Initメソッド内でおこなわれます。
bool CNeuronSAGDFN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint time_steps, uint variables, uint embedding_dim,
                         uint emb_layers, uint sparse_dimension, uint heads,
                         float sparse, uint gcru_layers,
                         uint forecast, uint forec_layers,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(emb_layers <= 0 || gcru_layers <= 0 || forec_layers <= 0)
      return false;
メソッドの本体では、まず受け取ったパラメータの簡単な検証がおこなわれます。いずれかのブロックの層数がゼロである場合、初期化は直ちに終了します。 これは素直で有用なチェックです。誤った構造の構築を続けるよりも、入力データを拒否するほうがよいのです。
その後、制御は親クラス内の同名のメソッドに渡され、そこでニューロンの基本構造が定義され、基本的なリソースが確保されます。 このステップが失敗した場合も、その時点でfalseを返して処理を終了します。その後のすべての処理は、正しく設定された基本コンテキストに依存しているためです。
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, variables, forecast, optimization_type, batch))
      return false;
次に、ソースデータのテンソルを所定の形式に転置するためのオブジェクトを初期化します。
   uint index = 0;
   if(!cTranspose.Init(0, index, OpenCL, time_steps, variables, optimization, iBatch))
      return false;
次に、埋め込みミニモデルの組み立てを開始します。 コンテナをクリアし、OpenCLコンテキストをバインドします。 最初の畳み込みブロックは、データの次元数を指定されたレベルに調整します。 これをcEmbeddingコンテナに追加し、その活性化関数としてSoftPlusを指定します。
//--- Embedding
   cEmbedding.Clear();
   cEmbedding.SetOpenCL(OpenCL);
   index++;
   CNeuronConvOCL *conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps, time_steps, embedding_dim, variables, 1, optimization, iBatch) ||
      !cEmbedding.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < emb_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                    embedding_dim, variables, 1, optimization, iBatch) ||
         !cEmbedding.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
次に、emb_layersにわたるループ内で、活性化関数がSoftPlusの畳み込み層を追加します。 その結果、チャネル幅が共通の深い埋め込みスタックが得られます。
畳み込み処理の後、バッチ正規化を追加します。これは、最後の畳み込み層の出力を正規化する独立したオブジェクトです。
   CNeuronBatchNormOCL *norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cEmbedding.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
次に、GCRUブロックを準備します。 cGCRUコンテナをクリアし、OpenCLをバインドして、直ちにcAttentionを初期化します。
//--- GCRUs
   cGCRU.Clear();
   cGCRU.SetOpenCL(OpenCL);
   index++;
   if(!cAttention.Init(0, index, OpenCL, variables, embedding_dim, heads,
                       sparse_dimension, sparse, optimization, iBatch))
      return false;
cAttentionはgcruオブジェクトが作成される前に初期化される点に注意してください。これは意図的なものであり、正しい動作です。すべてのGCRUブロックが同じ圧縮隣接行列を読み込むためです。 Attentionの初期化に失敗した場合は、処理を中止してエラーを通知します。
次に、ループ内で、必要な数のCNeuronFastGConvオブジェクトを作成します。 いずれかのgcruの作成に失敗した場合は、それを削除してfalseを返します。 これにより、再帰型グラフブロックのスタックが形成されます。これらのブロックはすべて、cAttentionが生成した行列に対して連携して処理をおこないます。
   CNeuronFastGConv *gcru = NULL;
   for(uint i = 0; i < gcru_layers; i++)
     {
      index++;
      gcru = new CNeuronFastGConv();
      if(!gcru ||
         !gcru.Init(0, index, OpenCL, variables, embedding_dim, sparse_dimension, optimization, iBatch) ||
         !cGCRU.Add(gcru))
        {
         DeleteObj(gcru);
         return false;
        }
     }
その後、投影ブロックcProjectionが構築されます。 最初の畳み込み層は、各変数のデータを埋め込み空間から予測空間へ変換します。
//--- Forecast
   cProjection.Clear();
   cProjection.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                 forecast, variables, 1, optimization, iBatch) ||
      !cProjection.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < forec_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, forecast, forecast,
                    forecast, variables, 1, optimization, iBatch) ||
         !cProjection.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
   norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cProjection.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
//---
   return true;
  }
次に、ループ処理をおこないながら、さらに畳み込み層を追加していきます。 ミニモデルの最後に、埋め込みスタックの場合と同様に、外部の活性化関数を持たないバッチ正規化層を追加します。 すべての追加が正常に完了した場合、Initはtrueを返し、アーキテクチャの構築が完了します。
層の構造からその実行へとスムーズに移行し、feedForwardメソッドを順を追って確認しながら、実行時に具体的に何が起きているのか、つまり、どのバッファが移動し、どのチェックがクラッシュを防ぎ、どこに微妙な落とし穴が潜んでいるのかを見ていきましょう。
bool CNeuronSAGDFN::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cTranspose.FeedForward(NeuronOCL))
      return false;
このメソッドでは、まず入力データを転置します。 ここで、マルチモーダルな時系列表現から、単変量系列の集合へと移行します。 処理が失敗した場合は、パイプラインを先に進めても意味がないため、適切に終了します。
その後、内部オブジェクト用のローカルポインタ変数を宣言します。 シンプルでありながら重要な操作で、これにより同じコードブロックを異なるオブジェクトで再利用できるようになります。
   CNeuronBaseOCL *inputs = cTranspose.AsObject();
   CNeuronBaseOCL *current = NULL;
まず、埋め込み処理がおこなわれます。 ループを用いて、cEmbeddingコンテナのすべてのコンポーネントを順に処理します。 各反復で、次の層を取得してcurrent変数に格納し、直ちにその順伝播メソッドを安全に呼び出します。 つまり、各埋め込み層は入力データを順次変換し、その結果を次の層に渡していくということです。
//--- Embedding
   for(int i = 0; i < cEmbedding.Total(); i++)
     {
      current = cEmbedding[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
実行が成功したら、inputs変数内のポインタを変更します。つまり、直前に得た結果を次の入力データとして扱うようにします。 その後、ループの次の反復に進みます。
その結果、ループのすべての反復が完了すると、inputs変数内のポインタは最後の埋め込み層、つまり分析対象の時間ウィンドウの最終的な密表現を指すようになります。
次の段階はGCRUスタックです。 まず、現在の表現に基づいて、圧縮行列As(インデックスと重み)を構成します。 Attention機構が正常に動作しなかった場合は、それ以上処理を進めずに停止するのが適切です。
//--- GCRUs
   if(!cAttention.FeedForward(inputs))
      return false;
   CNeuronFastGConv *gcru = NULL;
   for(int i = 0; i < cGCRU.Total(); i++)
     {
      gcru = cGCRU[i];
      if(!gcru ||
         !gcru.FeedForward(inputs, cAttention.AsObject()))
         return false;
      inputs = gcru;
     }
次に、cGCRUコンテナをループ処理し、各要素を順番に取り出して、その順伝播メソッドを呼び出します。
ここで、この場合は2つの引数、すなわち現在のテンソルとattentionオブジェクトへの参照が渡される点に注意してください。GCRUは、このオブジェクトからインデックスと重みAsを取得します。 各ステップが正常に完了するたびに、ローカルのソースデータ変数内のポインタを更新し、次の反復処理に進みます。
その結果、GCRUスタックは逐次的に動作します。各ブロックは同じ圧縮行列を読み込みますが、それを自身の状態に適用し、更新された隠れ表現を返します。
再帰ブロックのスタックの処理が完了したら、予測投影ブロックに進みます。 cProjectionコンテナに対するループも同様のロジックに従います。つまり、次の投影層を取り出し、順伝播メソッドを呼び出した後、ソースデータオブジェクトへのポインタを更新します。
//--- Forecast
   for(int i = 0; i < cProjection.Total(); i++)
     {
      current = cProjection[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
//--- result
   return CNeuronTransposeOCL::feedforward(inputs);
  }
概念的には、これは隠れ表現を各変数の最終的な予測の形状に変換する処理です。
最後に、親クラスのメソッドを使用して、データを元の形式に戻します。 これは転置を元に戻す操作です。これにより、予測データはシステムの他の部分が期待する形式に戻されます。 最後のステップが成功すると、このメソッドはtrueを返し、順伝播の処理全体が正常に完了します。
feedForwardメソッドは、処理が順を追って進む、見通しのよい構造で実装されています。データは転置された後、埋め込みスタックを通過し、共有の圧縮Attention行列を受け取り、GCRUブロックで順次処理され、予測値へと射影されて、元の形式に戻されます。 このデータパスはデバッグや拡張が容易です。ポインタの扱いに注意し、中間変換の効率を維持すればよいのです。
逆伝播のメソッドも同様の構造になっています。 そのため、ここではそれらの詳細な説明は省くことにします。 CNeuronSAGDFNクラスおよびそのすべてのメソッドの完全なコードは、添付ファイルに含まれており、自主学習にご利用いただけます。
テスト
モデルの学習は、綿密に計画された遠征のようなものです。実際の市場という大海原へと出航する前に、私たちは過去のデータという穏やかな港で徹底的に練習を重ねました。 この最初のオフライン段階の学習には、対照的な値動きに富んだ2024年通年のEURUSD通貨ペアの1時間足データを使用しました。 ここでは、横ばい相場がもたらす穏やかで、まるで鏡のような水面から、急激なトレンド変動による激しい嵐、さらにはニュースをきっかけとした予期せぬボラティリティの急上昇に至るまで、あらゆる状況が見られました。 このように多種多様な市場シナリオを通じて、モデルは確かな航行能力を身につけ、一般的な価格変動パターンもまれなパターンも認識し、厳しい状況下でも針路を見失わずに対応できるようになりました。
これらの準備が完了すると、訓練用ドックを離れ、実際の市場の流れの中で船の性能を試す時が来ました。 第2段階のオンラインファインチューニングは、実戦さながらの条件で、MetaTrader 5ストラテジーテスターを用いて実施しました。 ここでは、データがローソク足1本ずつ順次到着し、モデルはストリーミングデータの分析だけでなく、ノイズの渦の中でも、低流動性という絶えず姿を変える浅瀬でも、予期せぬニュースの突風の中でも、安定性を維持することを学びました。 この段階は、精密な微調整の役割を果たしました。すでに確立されていた枠組みを崩すことなく、現実に適合するように磨き上げることで、適応性を高め、過学習のリスクを低減しました。
最終テストは、まさに厳しい試練となりました。 過去の実験では一切使用していない、まったく新しい2025年1月のデータを用意し、それまでに得られたパラメータを一切変更せずにすべて読み込みました。 これが重要なポイントでした。微調整も追加の調整も一切おこなわず、モデルの汎化能力をありのままに反映した純粋なテストだったのです。
テストの結果を以下に示します。
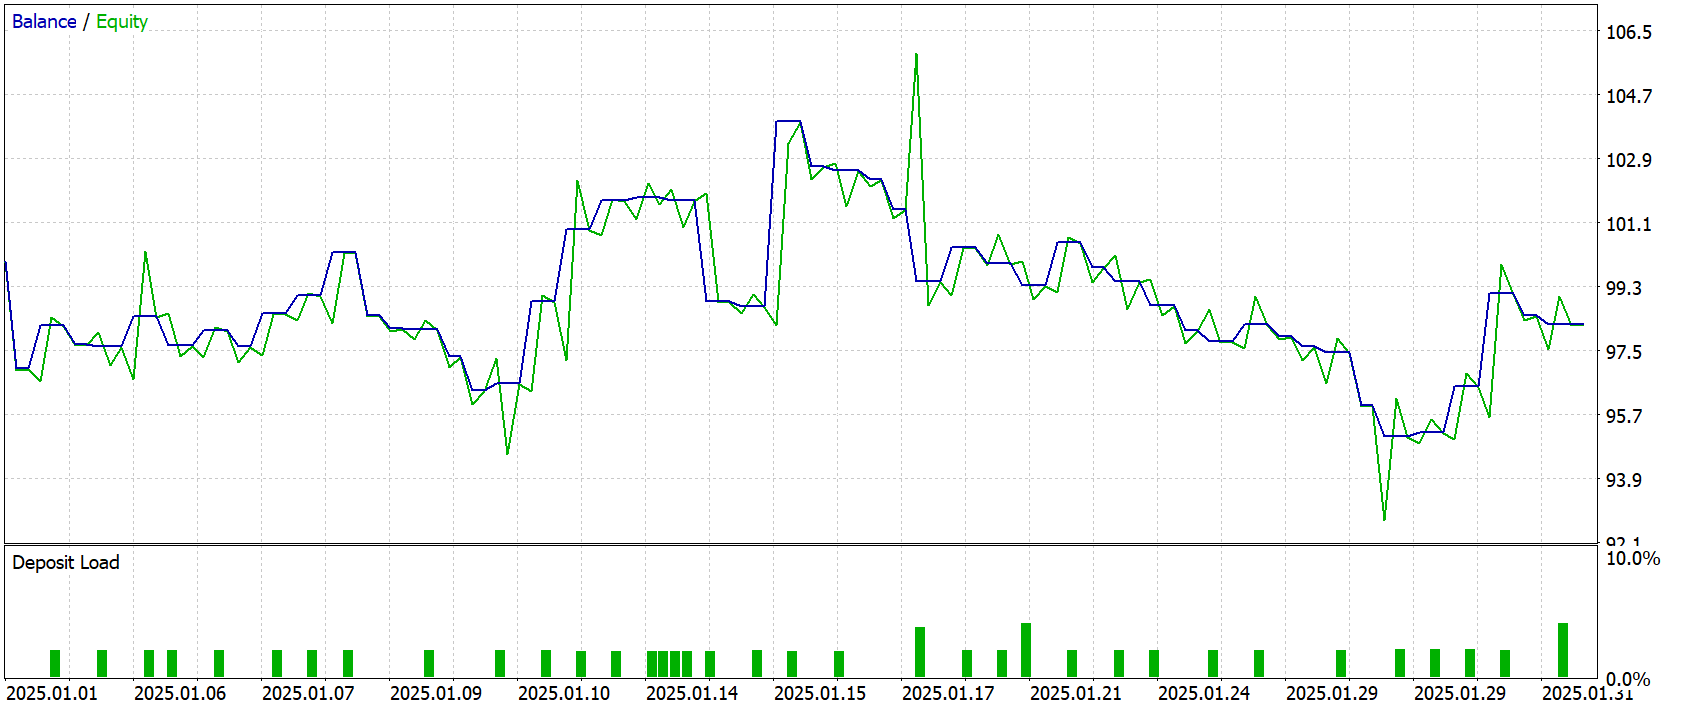
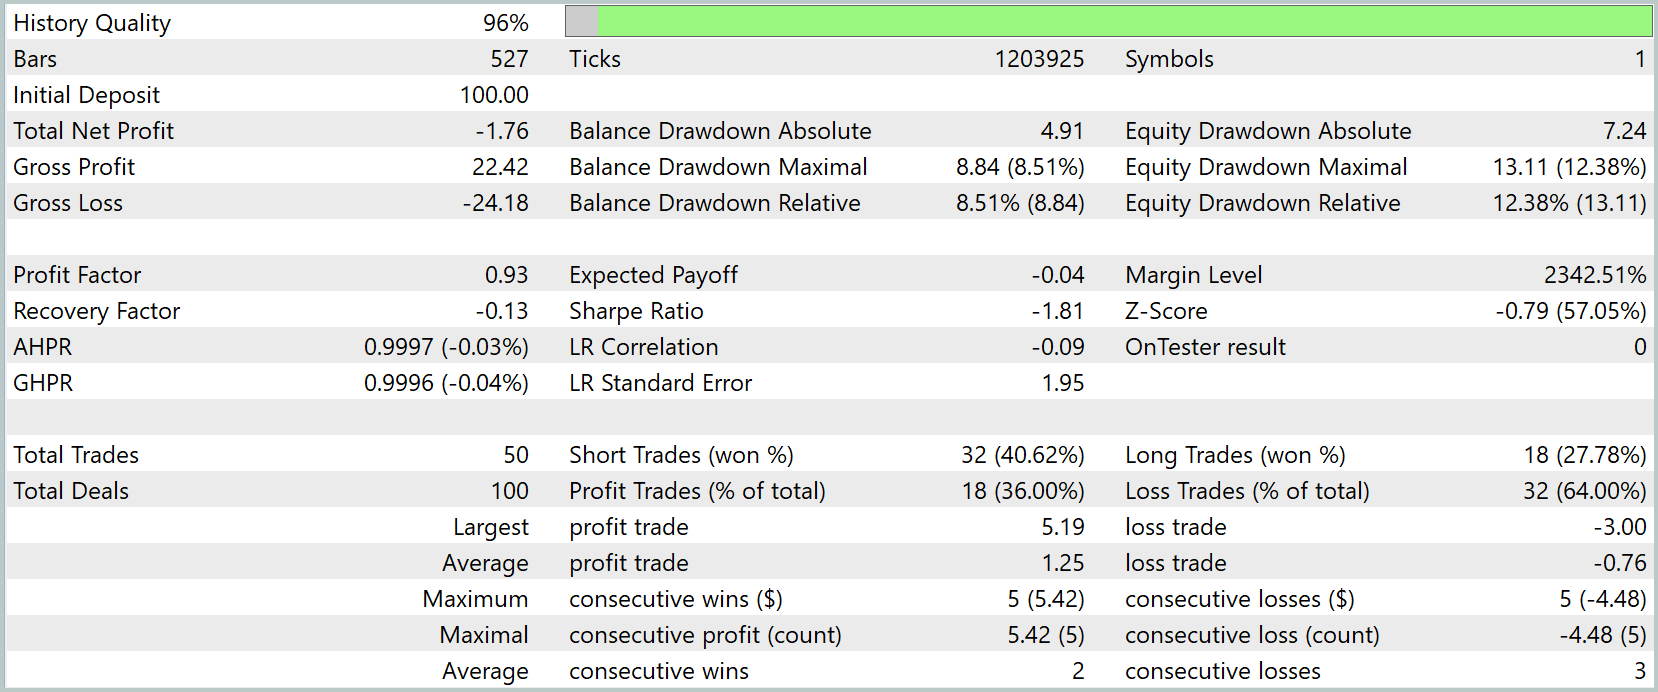
テスト結果によると、このモデルは慎重な挙動を示し、ある程度予測可能な状態を維持していました。 しかし、最終的なリターンは、初期預入額100.0米ドルに対して-1.76米ドルとマイナスになりました。 総利益は22.42米ドルでしたが、総損失はそれを上回る24.18米ドルに達しました。 これは主要な指標にも反映されており、プロフィットファクターは0.93となり、損失を出した取引がわずかに優勢だったことを示しています。 リカバリーファクターもマイナス圏に入り、-0.13となりました。
取引の内訳を見ると、このモデルは50件の注文を発注し、そのうち32件が売りポジションで、勝率は約40%だったのに対し、買い取引は18件にとどまり、勝率は28%弱でした。 利益が出た取引は18件で、全体の36%を占めた一方、損失が出た取引は32件でした。 最長連勝は5取引と比較的控えめで、その間の利益は約5.42米ドルでした。一方、最長連敗も5取引で、-4.48米ドルのドローダウンとなりました。
残高と有効証拠金の推移図を見ると、この戦略は緩やかな上昇期の後に下落期が続く波状の推移を示しており、急激な下落は見られないものの、持続的な上昇傾向も見られませんでした。 初期の適応期間を経て、一時的な上昇が見られたが、その上昇は持続せず、残高は徐々に開始時点の水準を下回るようになり、テスト期間終了までその水準の前後で変動し続けました。 このことから、当該期間において、このアルゴリズムはまだ一貫した優位性を確立できていないものの、壊滅的な失敗も経験していないことが示唆されます。ドローダウンは、残高ベースでは8.5%以内、有効証拠金ベースでは約12%にとどまりました。
全体として、このテスト結果は暫定的なものであり、モデルの汎化能力を向上させるためには、さらなる微調整や、場合によっては学習データセットの拡充が必要であることを示唆していると言えます。 このモデルは急激なドローダウンを起こしにくいものの、まだ安定した利益を示しておらず、その挙動はリスクの高いものというより、保守的かつ慎重なものとなっています。
結論
結論として、実施された検証により、開発された手法の現状を客観的に評価し、その長所と短所を特定することができたと言えます。 このモデルは市場の急激な変動に対する耐性を示し、不利なシナリオ下でもリスクを管理しながら、ドローダウンを比較的低い水準に抑えました。 しかし、現時点では全体的なリターンは依然としてマイナスであり、利益が出た取引と損失が出た取引の比率は、パラメータのさらなる最適化が必要であり、学習データセットの拡充も必要である可能性が高いことを示しています。
これらの結果は失敗ではありません。むしろ、現在の実装の限界を明らかにし、今後の開発の方向性を示すものです。 今後の取り組みでは、意思決定プロセスの洗練、ノイズフィルタリングの改善、そして変動の激しい市場における予測精度の向上に重点を置くべきです。 したがって、ここで紹介したフレームワークは、すでに安定して機能する基盤を提供しているものの、その潜在能力はまだ部分的にしか実現されておらず、さらなる改善や、実際の取引課題に即した調整の余地が残されています。
参考文献
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19425
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



