

Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (Final)
 23
 0

Introducción
Hoy concluimos el trabajo de implementación de los enfoques propuestos por los autores del framework SAGDFN. Los autores del framework han propuesto una de las soluciones al problema más acuciante de la predicción espaciotemporal: la complejidad cada vez mayor del procesamiento de grafos de gran tamaño. Los modelos tradicionales de redes neuronales de grafos (GNN) adolecen de un exceso de conexiones: cuantos más nodos haya, mayor es la probabilidad de que la información relevante se pierda en un flujo de interacciones poco significativas. Intentar procesar todas las conexiones sin distinción provoca un aumento cuadrático de la carga computacional y una disminución de la capacidad de generalización del modelo. Los autores de SAGDFN propusieron romper este círculo vicioso, centrándose únicamente en las relaciones verdaderamente significativas y descartando lo superfluo ya en las primeras fases del procesamiento de datos.
El módulo Significant Neighbors Sampling (SNS) fue la primera pieza de esta concepción. Su objetivo es identificar, para cada nodo, un conjunto de vecinos significativos que aporten el máximo valor predictivo. En el enfoque clásico, los modelos de grafos o bien toman todos los vecinos sin distinción, o bien se limitan estrictamente a una estructura fija. SNS fue más allá: forma dinámicamente un conjunto de conexiones, analizando tanto a los candidatos más cercanos según la métrica de similitud como a elementos seleccionados al azar para mantener la diversidad. Esto no solo reduce la dimensionalidad del grafo, sino que también disminuye el riesgo de sobreajuste, ya que el modelo no queda restringido a una estructura predefinida, sino que aprende a construir de forma adaptativa un mapa de la importancia de las conexiones.
Una vez formado el armazón del grafo, entra en juego Sparse Spatial Multi-Head Attention (SSMHA), un mecanismo de atención adaptativo que opera con la estructura dispersa obtenida en la etapa anterior. Este módulo cumple dos funciones clave a la vez: redistribuye los coeficientes de ponderación entre los vecinos y permite que cada nodo tenga en cuenta diversos aspectos del contexto gracias a la atención multicabeza. A diferencia del SoftMax clásico, en el que la suma de todos los pesos siempre está estrictamente normalizada, en SAGDFN se utilizó α-Entmax, que permite anular de forma más estricta las conexiones no significativas. Con α = 1, esta función se reduce al SoftMax habitual, y con α = 2, a Sparse-SoftMax, donde los elementos no significativos quedan, de hecho, excluidos de los cálculos. Esto aporta flexibilidad al modelo. El modelo puede seguir siendo sensible a señales débiles cuando es importante. Y, al mismo tiempo, centrarse en los nodos realmente significativos cuando la densidad del grafo se vuelve excesiva.
Otro elemento no menos importante es OneStepFastGConv, una convolución de grafos optimizada que realiza la transformación de las características espaciales en un solo paso, evitando cascadas de operaciones superfluas. En lugar de apilar sucesivamente varias capas, cada una de las cuales realiza solo una pequeña transformación, aquí se aplica una agregación en un solo paso, lo que acelera el entrenamiento y reduce los requisitos de memoria. Este enfoque es especialmente importante para las tareas en tiempo real, en las que cada milisegundo de procesamiento de datos cuenta.
El funcionamiento conjunto de estos módulos recuerda al trabajo coordinado de una orquesta: el SNS selecciona a los músicos clave, el SSMHA distribuye roles y acentos entre ellos, y el FastGConv transforma esa cacofonía de señales en una melodía coherente de predicción. Además, todos los elementos se concibieron desde el principio como escalables. Es decir, capaces de trabajar eficazmente tanto con grafos relativamente compactos como con estructuras de gran tamaño que cuentan con miles de nodos y millones de posibles conexiones.
A continuación se muestra una visualización del framework SAGDFN realizada por el autor.
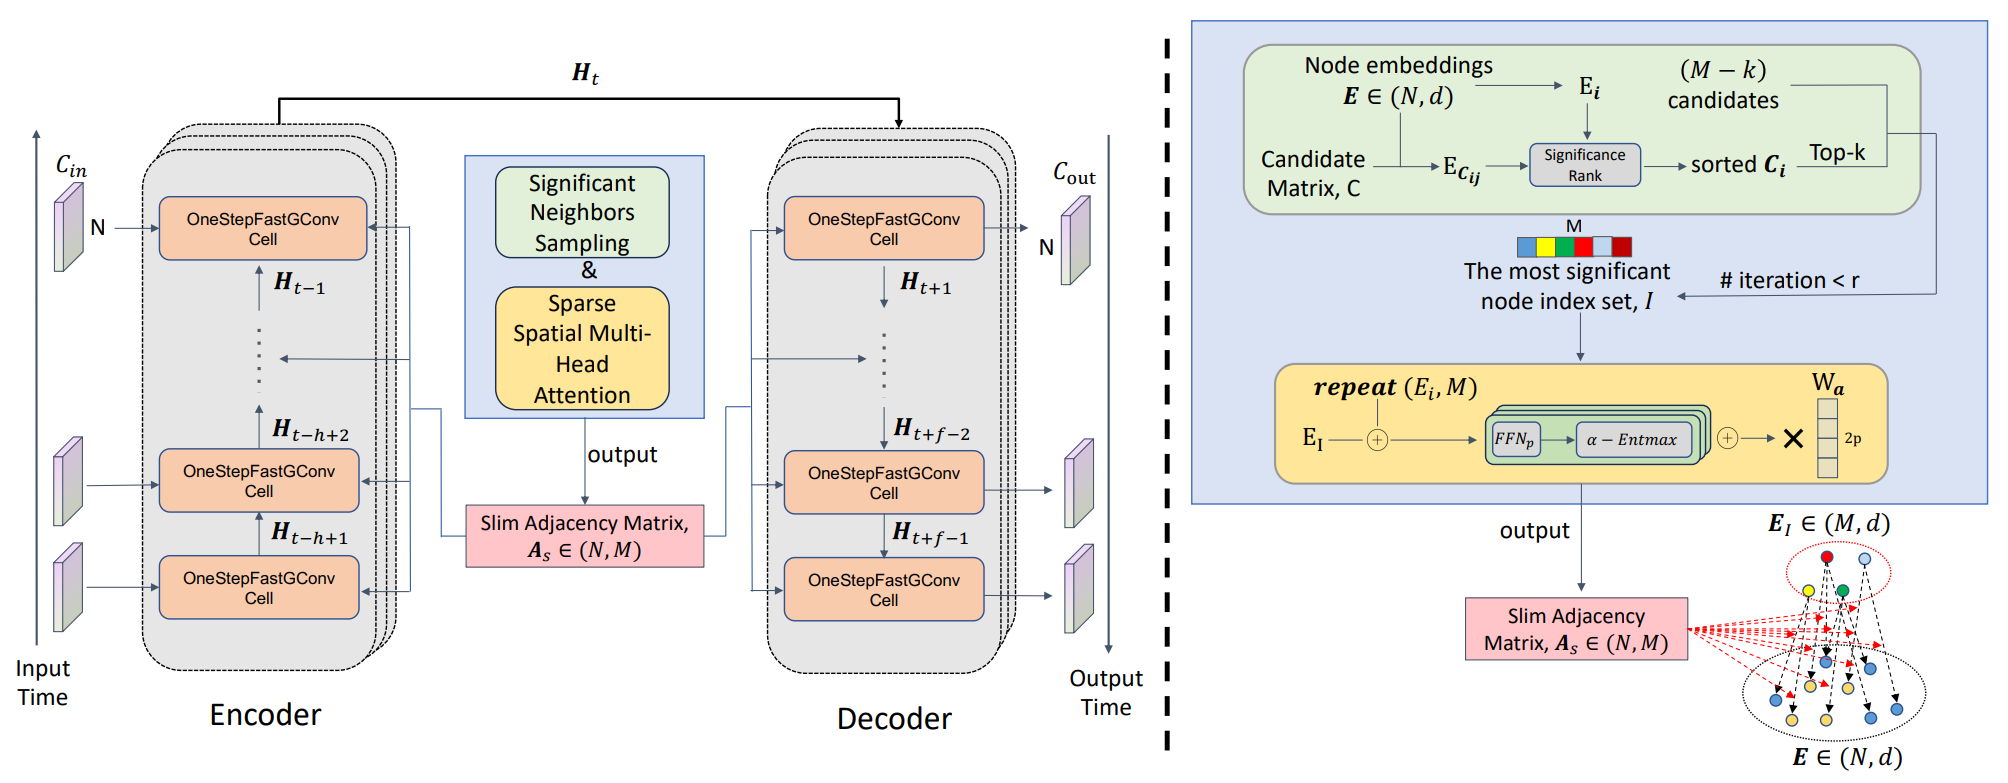
En los artículos anteriores hemos analizado paso a paso los componentes clave del framework. Hemos implementado, paso a paso, los módulos Significant Neighbors Sampling y Sparse Spatial Multi-Head Attention utilizando MQL5 y OpenCL. En este proceso no nos hemos limitado a repetir al pie de la letra el algoritmo original; al contrario, hemos introducido una serie de optimizaciones importantes destinadas a mejorar la eficiencia computacional y la estabilidad del modelo. Así, en lugar de la función iterativa α-Entmax, que requiere importantes recursos debido a la búsqueda del parámetro óptimo τ, aplicamos la función Sparse-SoftMax, más ligera y estable. Esto permitió mantener el concepto de filtrado selectivo de elementos poco significativos y reducir la carga del procesador. Además, se ha perfeccionado el procedimiento de creación de enlaces en el módulo de selección de vecinos. Organizamos una evaluación paralela de candidatos previamente seleccionados y aleatorios, lo que permitió aumentar la diversidad de las conexiones y reducir la probabilidad de perder información potencialmente útil.
Ahora que ya se han puesto a punto los mecanismos para construir el grafo y distribuir los pesos entre sus nodos, ha llegado el momento de pasar al siguiente paso lógico: la implementación del módulo OneStepFastGConv. Este componente desempeña un papel especial en la arquitectura SAGDFN, ya que es el encargado de agregar la información espacial y de generar las características en las que se basará la predicción final.
Objeto recurrente de convolución de grafos
Continuando la línea lógica del material anterior, en el que ya habíamos construido el armazón del grafo (Significant Neighbors Sampling) y habíamos aprendido a distribuir cuidadosamente los pesos entre los enlaces clave (Sparse Spatial Multi-Head Attention), pasamos al corazón del bloque recurrente: la convolución de grafos rápida. No es nuestra primera incursión en el mundo de los módulos de grafos recurrentes: en HimNet utilizamos el GCRU, y este dio muy buenos resultados en estructuras densas. Pero en SAGDFN, el panorama es diferente. Trabajamos deliberadamente con una matriz dispersa de interdependencias, y es precisamente este carácter disperso el que dicta una organización algorítmica diferente. Para no construir una casa sobre arena, empecemos por una operación básica en la que se basará posteriormente OneStepFastGConv: la multiplicación eficiente de una matriz dispersa por una matriz densa.
Esta etapa es fundamental, ya que es precisamente la que nos permitirá integrar de forma eficaz la estructura dispersa de relaciones obtenida anteriormente en el contexto general del procesamiento de datos. Para ello, creamos un kernel en la parte del programa OpenCL que realiza esta operación de la forma más sencilla posible y, al mismo tiempo, con especial atención al rendimiento y al ahorro de memoria.
__kernel void SparseMatMult(__global const float *sparse_index,
                            __global const float *sparse_data,
                            __global const float *full,
                            __global float *result,
                            const int full_rows
                           )
  {
   const size_t sparse_row = get_global_id(0);
   const size_t sparse_col = get_local_id(1);
   const size_t full_col = get_global_id(2);
   const size_t sparse_rows = get_global_size(0);
   const size_t sparse_cols = get_local_size(1);
   const size_t full_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
Al inicio del proceso, el kernel determina las coordenadas de la tarea que se va a ejecutar: los índices de fila y columna de la matriz dispersa; estos últimos se agrupan en grupos locales. Así como el índice de la columna de la matriz densa. Estos parámetros conforman una especie de trío de coordenadas que permite a cada flujo saber con exactitud de qué sección de datos es responsable. A continuación, se determinan los tamaños de todas las dimensiones. Son necesarios para direccionar correctamente los elementos.
Luego se asigna el array local Temp, utilizado para sincronizar y sumar los valores intermedios dentro del grupo de trabajo.
En la siguiente etapa, cada flujo determina el desplazamiento en memoria para el elemento actual de la matriz dispersa y extrae el índice de la fila correspondiente de la matriz densa.
   const int shift_sparse = RCtoFlat(sparse_row, sparse_col, sparse_rows, sparse_cols, 0);
   const int full_row = sparse_index[shift_sparse];
   const int shift_full = RCtoFlat(full_row, full_col, full_rows, full_cols, 0);
Si este índice se encuentra dentro de los límites permitidos, se calcula el producto del coeficiente de la matriz dispersa por el elemento de la matriz densa. De lo contrario, se utiliza el valor cero, lo que permite evitar operaciones incorrectas.
   float res = (full_row >= 0 && full_row < full_rows ?
                IsNaNOrInf(sparse_data[shift_sparse] * full[shift_full], 0) : 0);
   res = LocalSum(res, 1, Temp);
El producto parcial obtenido se envía a una rutina local de suma, que acumula los resultados de todos los flujos del grupo de trabajo. En cuanto finaliza la suma, el primer flujo de cada grupo (con índice local de columna igual a cero) escribe el valor final en la matriz resultante. De este modo se logra un equilibrio entre el paralelismo de los cálculos y el control sobre la escritura de datos, lo que evita conflictos de acceso.
   if(sparse_col == 0)
     {
      const int shift_result = RCtoFlat(sparse_row, full_col, sparse_rows, full_cols, 0);
      result[shift_result] = res;
     }
  }
Este enfoque garantiza un uso óptimo de los recursos de la GPU. Cada flujo realiza únicamente su parte del trabajo, y la suma colectiva garantiza la precisión y la coherencia del resultado final.
Una vez que hemos implementado la propagación directa y hemos aprendido a recopilar con precisión las contribuciones de los vecinos en las características resultantes, el siguiente paso es la propagación inversa: la distribución correcta del gradiente de error entre todos los elementos participantes. El algoritmo se ha implementado en el kernel SparseMatMultGrad, que recibe como entrada:
- los índices y pesos de la matriz dispersa,
- un búfer para los gradientes con respecto a estos pesos,
- una matriz densa y su búfer de gradientes,
- el array de gradientes del resultado,
- los tamaños de todas las dimensiones.
__kernel void SparseMatMultGrad(__global const float *sparse_index,
                                __global const float *sparse_data,
                                __global float *sparse_gr,
                                __global const float *full,
                                __global float *full_gr,
                                __global const float *result_gr,
                                const int sparse_rows,
                                const int sparse_cols,
                                const int full_rows,
                                const int full_cols
                               )
  {
   const size_t row_id = get_global_id(0);
   const size_t local_id = get_local_id(1);
   const size_t col_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t total_cols = get_global_size(2);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
En el cuerpo del kernel, cada flujo recibe sus propias coordenadas en el espacio de tareas:
- row_id — fila por la que se procesa la matriz;
- local_id — identificador local dentro del grupo de trabajo;
- col_id — columna de la matriz.
El búfer de memoria local Temp se reserva para las reducciones y la transferencia de pequeñas porciones de datos entre los flujos de un mismo grupo de trabajo. Es la herramienta principal de coordinación: a través de ella, los flujos intercambian resultados intermedios y se sincronizan.
Cabe señalar aquí que, en este kernel, tendremos que distribuir los gradientes del error entre dos matrices de distinto tamaño. Tanto los identificadores de fila como los de columna sirven de referencia precisamente a la matriz que recibe los gradientes. Con este fin, al poner el kernel en la cola de ejecución, tenemos previsto utilizar los valores máximos de ambas matrices. Y los flujos sobrantes se descartan dentro del kernel.
En primer lugar, viene el bloque de cálculo de los gradientes del error con respecto a los pesos de la matriz dispersa. Primero comprobamos el índice: si la posición actual se encuentra dentro del rango permitido, el flujo calcula shift_sparse, es decir, un desplazamiento lineal en los arrays de índices y de datos de la matriz dispersa.
//--- Cálculo del gradiente disperso
   if(row_id < sparse_rows && col_id < sparse_cols)
     {
      float grad = 0;
      int shift_sparse = 0;
      if(local_id == 0)
        {
         shift_sparse = RCtoFlat(row_id, col_id, sparse_rows, sparse_cols, 0);
         Temp[0] = sparse_index[shift_sparse];
        }
      BarrierLoc;
      uint full_row = (uint)Temp[0];
El flujo con local_id igual a 0 lee el índice correspondiente y lo almacena en el primer elemento del búfer de memoria local, para que los demás flujos puedan utilizar ese valor sin realizar accesos globales adicionales.
Tras la barrera, todos los flujos del grupo de trabajo conocen el índice de la fila de la matriz densa.
Por favor, ten en cuenta que es importante comprobar que el índice de la fila obtenido sea correcto. Y, tras superar con éxito el bloque de control, cada flujo recorre sus posiciones en la dimensión de características y acumula la contribución del elemento.
      if(full_row < (uint)full_rows)
         for(int i = local_id; i < full_cols; i += total_local)
           {
            int shift_result = RCtoFlat(row_id, i, sparse_rows, full_cols, 0);
            int shift_full = RCtoFlat(full_row, i, full_rows, full_cols, 0);
            grad += IsNaNOrInf(result_gr[shift_result] * full[shift_full], 0);
           }
Se trata de un producto escalar clásico por características: tomamos el gradiente del resultado para cada característica y lo multiplicamos por el valor de la celda correspondiente de la matriz densa, sumando por todas las características.
Una vez finalizado el recorrido local, se realiza una reducción por los flujos del grupo de trabajo para obtener la contribución total para el par (row_id, col_id) dado.
      grad = LocalSum(grad, 1, Temp);
      if(local_id == 0)
         sparse_gr[shift_sparse] = grad;
     }
Y solo un flujo escribe el resultado final del grupo de trabajo en el elemento correspondiente del búfer global sparse_gr.
Al pasar a la segunda gran parte, el cálculo del gradiente respecto a la matriz densa, nos encontramos con la tarea inversa. Para cada elemento de la matriz densa, hay que sumar cuidadosamente la contribución al resultado del bloque. Sin embargo, aquí nos encontramos con el problema de que no existe una vinculación explícita con los elementos de la matriz dispersa. Por lo tanto, tendremos que escanear toda la matriz de índices de la matriz dispersa en busca de los punteros necesarios. Es precisamente esta tarea la que asignaremos a los flujos del grupo local.
En primer lugar, organizamos un ciclo para recorrer las filas de la matriz de índices de los gradientes de error. Recordemos que el número de filas del tensor de gradientes de error y de la matriz dispersa es el mismo.
//--- Cálculo del gradiente denso
   if(row_id < full_rows && col_id < full_cols)
     {
      float grad = 0;
      for(int r = 0; r < sparse_rows; r ++)
        {
         float s = 0;
         for(int c = local_id; c < sparse_cols; c += total_local)
           {
            int shift_sparse = RCtoFlat(r, c, sparse_rows, sparse_cols, 0);
            if((int)sparse_index[shift_sparse] == (int)row_id)
              {
               s = sparse_data[shift_sparse];
               break;
              }
           }
Dentro del ciclo, intentamos encontrar un puntero a la fila actual de la matriz densa entre los índices de la matriz dispersa. Para lograr un paralelismo eficaz, cada flujo de un grupo local recorre solo una parte de las columnas de la matriz dispersa y, en la primera coincidencia, toma el coeficiente de atención e interrumpe la búsqueda.
Recordemos que, en el proceso de selección de los vecinos más cercanos, hemos implementado un mecanismo para eliminar duplicados. Por eso, no esperamos que una misma conexión aparezca más de una vez en cada fila de la matriz dispersa.
A continuación, mediante LocalSum, recopilamos información sobre los coeficientes de atención de todos los flujos del grupo de trabajo.
         s = LocalSum(s, 1, Temp);
         if(s != 0 && local_id == 0)
           {
            int shift_result = RCtoFlat(r, col_id, sparse_rows, full_cols, 0);
            grad += IsNaNOrInf(s * result_gr[shift_result], 0);
           }
        }
Si la suma resulta distinta de cero, el primer flujo del grupo de trabajo multiplica el peso obtenido por el valor del elemento correspondiente del búfer de gradientes de error del bloque y lo acumula en la variable grad.
Una vez completadas todas las iteraciones del sistema de ciclos y recopilado el gradiente de error total de todos los elementos dependientes, el primer flujo del grupo de trabajo escribe el valor acumulado en el búfer global full_gr.
      if(local_id == 0)
        {
         int shift_full = RCtoFlat(row_id, col_id, full_rows, full_cols, 0);
         full_gr[shift_full] = grad;
        }
     }
  }
Una vez completado el trabajo preparatorio, pasamos a la implementación práctica del bloque recurrente OneStepFastGConv en el lado del programa principal. Aquí implementamos los enfoques propuestos dentro de la clase CNeuronFastGConv, concebida como un contenedor compacto para todos los búferes intermedios y la lógica. A continuación se muestra la estructura de la clase.
class CNeuronFastGConv   :     public CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL          cInpAndHidden;
   CNeuronBaseOCL          cNormAttention;
   CNeuronBaseOCL          cInvDiag;
   CNeuronBaseOCL          cAX;
   CNeuronBaseOCL          cAXplusX;
   CNeuronBaseOCL          cNormAXplusX;
   CNeuronConvOCL          cZ_R;
   CNeuronBaseOCL          cZ;
   CNeuronBaseOCL          cR;
   CNeuronBaseOCL          cCandidate;
   CNeuronConvOCL          cHC;
   //---
   virtual bool      RandomWalk(CBufferFloat* data,
                                CBufferFloat* normal,
                                CBufferFloat* inv_diag,
                                const int rows,
                                const int cols
                               );
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)  override { return false; };
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override { return false; }
   //---
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronFastGConv(void) {};
                    ~CNeuronFastGConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   virtual bool      CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent);
   //---
   virtual int       Type(void)   const   {  return defNeuronFastGConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   //---
   virtual uint      GetCount(void) const { return (uint)cInvDiag.Neurons(); }
   virtual uint      GetSparseDimension(void) const { return (uint)cNormAttention.Neurons() / GetCount(); }
   virtual uint      GetWindow(void) const { return (uint)Neurons() / GetCount(); }
  };
En la estructura de la nueva clase vemos un número bastante elevado de objetos internos. Sin embargo, todos ellos se han declarado estáticamente, lo que nos permite dejar vacíos el constructor y el destructor de la clase. Todo el algoritmo de configuración de la arquitectura del objeto se ha trasladado al método de inicialización Init.
bool CNeuronFastGConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units, uint window, uint sparse_dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
La primera línea del método transfiere el control a la clase padre. Se trata de la vinculación básica de la capa al contexto OpenCL y de la creación de todas las interfaces heredadas necesarias para que el módulo funcione dentro del modelo. Si esta inicialización falla, el método pierde sentido, por lo que devolvemos inmediatamente false. Esta salida temprana evita errores posteriores y asignaciones innecesarias.
Inmediatamente después, desactivamos explícitamente la función de activación. Es lógico: el propio bloque controla las activaciones en los componentes (sigmoides para las puertas, tanh para los candidatos), por lo que aquí no se necesita una activación global externa.
A continuación tiene lugar el proceso de inicialización de los componentes internos. El primer objeto sirve para concatenar el estado oculto anterior y los datos de entrada.
   int index = 0;
   if(!cInpAndHidden.Init(0, index, OpenCL, 2 * units * window, optimization, iBatch))
      return false;
En la siguiente línea se crea cNormAttention. Aquí se almacena la matriz de atención dispersa compacta As tras la normalización. Este objeto recibirá los pesos del módulo Sparse Attention.
   index++;
   if(!cNormAttention.Init(0, index, OpenCL, units * sparse_dimension, optimization, iBatch))
      return false;
   index++;
   if(!cInvDiag.Init(0, index, OpenCL, units, optimization, iBatch))
      return false;
Pasemos ahora a cInvDiag: el vector de inversos de la diagonal, que multiplicará las filas del resultado de la difusión durante la normalización.
A continuación, se crea cAX. Este búfer almacena el resultado de SpMM. Su tamaño se ha tomado de cInpAndHidden, lo que garantiza la compatibilidad dimensional con los pasos siguientes.
   index++;
   if(!cAX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
   index++;
   if(!cNormAXplusX.Init(0, index, OpenCL, cInpAndHidden.Neurons(), optimization, iBatch))
      return false;
Después de cAX viene cAXplusX, un búfer para la suma AX + X. Aquí guardamos explícitamente el resultado intermedio antes de aplicar la inversión de la diagonal. Este búfer explícito facilita la depuración y permite controlar el orden de las operaciones.
A continuación, se crea cNormAXplusX, el tensor normalizado final (D+I)-1(AX + X). Luego se pasa a un bloque similar a GRU. Si falta, la mecánica de las puertas de actualización se rompe, por lo que, una vez más, la comprobación es fundamental.
Luego se inicializa cZ_R. Se trata de una capa convolucional compacta que generará simultáneamente los logits para las puertas Z y R. Como función de activación, utilizamos aquí la sigmoide. Este método es sencillo y fiable: las puertas siempre se encuentran en el intervalo [0,1].
   index++;
   if(!cZ_R.Init(0, index, OpenCL, 2 * window, 2 * window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cZ_R.SetActivationFunction(SIGMOID);
   index++;
   if(!cZ.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
   index++;
   if(!cR.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
Los dos búferes siguientes, cZ y cR, se crean para separar los valores de las puertas. La existencia de búferes independientes simplifica la lógica paso a paso de la actualización del estado oculto.
La inicialización de cCandidate crea un búfer para la entrada concatenada intermedia en el bloque de candidatos.
   index++;
   if(!cCandidate.Init(0, index, OpenCL, 2 * window * units, optimization, iBatch))
      return false;
   index++;
   if(!cHC.Init(0, index, OpenCL, 2 * window, 2 * window, window, units, 1, optimization, iBatch))
      return false;
   cHC.SetActivationFunction(TANH);
//---
   return true;
  }
El bloque cHC es, propiamente dicho, el cálculo del Candidate Hidden State. El uso de TANH como función de activación es una práctica estándar que hace que los candidatos queden acotados y sean estables en cuanto a escala.
Cuando todas las llamadas dentro del método Init se hayan ejecutado correctamente, al final devolvemos true, lo que indica que la capa está configurada y lista para funcionar.
Pasamos ahora gradualmente de la inicialización a la ejecución. Ahora que todo está asignado y configurado, el método FeedForward es un flujo de datos vivo a través de OneStepFastGConv.
bool CNeuronFastGConv::FeedForward(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
En primer lugar, el método comprueba las entradas y la validez de los punteros recibidos a los objetos de datos de origen. Se trata de una protección sencilla, pero imprescindible: si no hay una fuente de datos o un módulo de atención dispersa, no se puede seguir trabajando. Esta salida temprana evita fallos incontrolados y proporciona un diagnóstico predecible.
A continuación, extraemos los parámetros de configuración de la capa. Es muy práctico tener estas variables localmente: leerlas desde los métodos de la clase en un ciclo crítico es más lento y menos claro.
La siguiente línea ejecuta RandomWalk. Se trata de un procesamiento previo de la matriz de atención. RandomWalk recopila estadísticas por filas de la matriz slim y aplica una normalización suave. A continuación, almacena cNormAttention (N×M) y cInvDiag (N): los inversos de las diagonales para la normalización posterior. Lo importante aquí es que RandomWalk funciona en modo paralelo en la GPU, sumando cuidadosamente por M y devolviendo inv_diag estables. Si este paso falla, es mejor interrumpir la ejecución, ya que todas las normalizaciones dependen de él.
   if(!RandomWalk(SparseAttent.getOutput(), cNormAttention.getOutput(), cInvDiag.getOutput(), window, sparse))
      return false;
   if(!SwapOutputs())
      return false;
   if(!Concat(SourceData.getOutput(), PrevOutput, cInpAndHidden.getOutput(), window, window, units))
      return false;
A continuación, se ejecuta SwapOutputs. Se trata de un mecanismo interno de la capa que intercambia los punteros a la salida anterior y a la actual (búfer circular). El swap garantiza que PrevOutput contenga Ht-1 y que el Output actual esté libre para escritura.
A continuación, se monta la entrada para SpMM/GRU. Aquí se produce una concatenación a lo largo de la dimensión de canales: para cada fila se forma un vector que combina el fragmento observado actual Xt y el estado oculto anterior Ht-1.
Una vez finalizado el trabajo preparatorio, se lleva a cabo la operación clave: la multiplicación de la matriz dispersa de atención por la matriz densa, preparada previamente, de los datos de entrada concatenados y del estado oculto.
   if(!SparseMatMul(SparseAttent.GetIndexes(), cNormAttention.getOutput(), cInpAndHidden.getOutput(),
                                                  cAX.getOutput(), units, sparse, units, 2 * window))
      return false;
   if(!SumAndNormilize(cAX.getOutput(), cInpAndHidden.getOutput(), cAXplusX.getOutput(),
                                                         2 * window, false, 0, 0, 0, 1))
      return false;
A continuación, se realiza la suma con Self-Loop. Aquí sumamos AX+X.
El siguiente paso es aplicar la normalización diagonal.
   if(!DiagMatMul(cInvDiag.getOutput(), cAXplusX.getOutput(), cNormAXplusX.getOutput(), units, 2 * window, 1, None))
      return false;
Se trata simplemente de una multiplicación por canales de las filas por el inv_diag calculado previamente.
A continuación, se calculan los logits de las puertas. La capa de convolución cZ_R recibe características agregadas normalizadas y devuelve un vector de 2×hidden (logits para Z y R). Dado que la activación SIGMOID se estableció en la etapa de inicialización, al ejecutar esta operación obtenemos valores en el intervalo [0,1].
   if(!cZ_R.FeedForward(cNormAXplusX.AsObject()))
      return false;
   if(!DeConcat(cZ.getOutput(), cR.getOutput(), cZ_R.getOutput(), window, window, units))
      return false;
Después dividimos los logits obtenidos en búferes separados.
Inmediatamente después tiene lugar la multiplicación elemento a elemento de la puerta Reset por el estado oculto anterior. Aquí se forma R⊙Ht-1. El resultado se utiliza posteriormente como una versión modificada del estado oculto para generar candidatos.
   if(!ElementMult(cR.getOutput(), PrevOutput, cR.getPrevOutput()))
      return false;
A continuación, se forma la entrada de los candidatos: concatenamos R⊙Ht-1 junto con el Xt actual.
   if(!Concat(SourceData.getOutput(), cR.getPrevOutput(), cCandidate.getOutput(), window, window, units))
      return false;
   if(!cHC.FeedForward(cCandidate.AsObject()))
      return false;
   if(!GateElementMult(PrevOutput, cHC.getOutput(), cZ.getOutput(), Output))
      return false;
//---
   return true;
  }
La llamada al método de propagación directa de la capa de convolución cHC realiza una transformación no lineal y aplica la función tanh, devolviendo un estado oculto candidato. La composición final forma un nuevo estado oculto.
Después de describir la propagación directa, pasamos a la propagación inversa: ahora tenemos que analizar con detenimiento cómo se propaga el error hacia atrás a través de todos los componentes de OneStepFastGConv. El proceso está implementado en el método CalcInputGradients.
bool CNeuronFastGConv::CalcInputGradients(CNeuronBaseOCL *SourceData, CNeuronSNSMHAttention *SparseAttent)
  {
   if(!SourceData || !SparseAttent)
      return false;
//---
   const uint units = GetCount();
   const uint window = GetWindow();
   const uint sparse = GetSparseDimension();
El método se asegura de inmediato: si no hay punteros válidos a los objetos de datos de entrada, no hay nada que ejecutar. Y finalizamos correctamente la ejecución con el resultado false. Se trata de una comprobación sencilla, pero necesaria: es mejor interrumpir la pasada de entrenamiento en una fase temprana que obtener misteriosos NaN más adelante.
A continuación, se extraen los parámetros de configuración. Estos números determinan la forma de todos los tensores de gradiente y son necesarios para un direccionamiento correcto.
La primera llamada real es GateElementMultGrad. Esta es la expansión de la composición final Ht = Z⊙Ht-1+(1−Z)⊙H̃.
   if(!GateElementMultGrad(PrevOutput, cInpAndHidden.getGradient(),
                           cHC.getOutput(), cHC.getGradient(),
                           cZ.getOutput(), cZ.getGradient(),
                           Gradient, None, cHC.Activation(), cZ_R.Activation()))
      return false;
La función calcula tres cosas a la vez: el gradiente con respecto a H̃ (candidatos), con respecto a Z (puerta de actualización) y con respecto a Ht-1 (estado oculto anterior), descomponiendo cuidadosamente el gradiente total en sus componentes.
Después, propagamos el gradiente de error a través de la capa de convolución encargada de generar los candidatos.
   if(!cCandidate.CalcHiddenGradients(cHC.AsObject()))
      return false;
   if(!DeConcat(SourceData.getGradient(), cR.getPrevOutput(),
                cCandidate.getGradient(), window, window, units))
      return false;
A continuación, dividiremos los gradientes obtenidos en dos partes: la influencia de los datos de entrada y R⊙Ht-1.
Luego ElementMultGrad distribuye la contribución de la puerta de reinicio y del estado oculto anterior.
   if(!ElementMultGrad(cR.getOutput(), cR.getGradient(),
                       PrevOutput, cInpAndHidden.getGradient(),
                       cR.getPrevOutput(), cZ_R.Activation(), None))
      return false;
El siguiente paso consiste en agrupar los gradientes locales de Z y R de nuevo en un vector plano de logits, que introducimos en cZ_R para la retropropagación de la capa.
   if(!Concat(cZ.getGradient(), cR.getGradient(),
              cZ_R.getGradient(), window, window, units))
      return false;
   if(!cNormAXplusX.CalcHiddenGradients(cZ_R.AsObject()))
      return false;
   if(!DiagMatMulGrad(cInvDiag.getOutput(), cInvDiag.getGradient(),
                      cAXplusX.getOutput(), cAX.getGradient(),
                      cNormAXplusX.getGradient(), units, 2 * window, 1))
      return false;
   if(!SparseMatMulGrad(SparseAttent.GetIndexes(), cNormAttention.getOutput(),
                        cNormAttention.getGradient(), cInpAndHidden.getOutput(),
                        cInpAndHidden.getGradient(), cAX.getGradient(),
                        units, sparse, units, 2 * window))
      return false;
A continuación, iniciamos la propagación inversa a través de la capa de convolución encargada de generar los logits de las puertas. Como resultado, obtendremos el gradiente con respecto a cNormAXplusX, es decir, con respecto a la entrada agregada normalizada.
Después se lleva a cabo una serie de iteraciones en las que se distribuyen los gradientes de error entre el tensor concatenado de los datos de entrada y los coeficientes de atención normalizados. Primero propagamos el gradiente hacia atrás a través de la normalización diagonal. A continuación, retropropagamos a través de SpMM y distribuimos los gradientes entre los pesos de atención normalizados y las características concatenadas.
Es importante señalar que, tras ejecutar SparseMatMulGrad, debemos sumar el gradiente de error del tensor de características concatenado procedente de los dos flujos de información.
   if(!SumAndNormilize(cAX.getGradient(), cInpAndHidden.getGradient(),
                      cInpAndHidden.getGradient(), 2 * window, false, 0, 0, 0, 1))
      return false;
A continuación, debemos acumular los gradientes de error a nivel de los datos de entrada. En este punto hay que recordar que utilizamos los datos de entrada en dos flujos de información: la concatenación primaria de características y la concatenación del tensor para los candidatos. Ya hemos transmitido el gradiente de error desde el segundo flujo de información. Ahora debemos extraer los valores correspondientes al segundo flujo de información y sumarlos a los valores obtenidos anteriormente.
   if(!DeConcat(cAXplusX.getGradient(), cAXplusX.getPrevOutput(),
                cInpAndHidden.getGradient(), window, window, units))
      return false;
   if(!SumAndNormilize(SourceData.getGradient(), cAXplusX.getGradient(),
                      SourceData.getGradient(), window, false, 0, 0, 0, 1))
      return false;
   if(SourceData.Activation() != None)
      if(!DeActivation(SourceData.getOutput(), SourceData.getGradient(),
                       SourceData.getGradient(), SourceData.Activation()))
         return false;
Y no olvidemos comprobar si existe una función de activación para el tensor de datos de entrada. Si es necesario, ajustamos los valores obtenidos en función de su derivada.
El último paso significativo consiste en transferir el gradiente de error desde la matriz de atención normalizada cNormAttention a su estado inicial SparseAttent. En la propagación directa realizamos la normalización; ahora propagamos los gradientes hacia atrás a través de este paso diagonal, hasta la forma que espera el módulo SparseAttent.
   if(!DiagMatMul(cInvDiag.getOutput(), cNormAttention.getGradient(),
                  SparseAttent.getGradient(), units, sparse, 1, None))
      return false;
//---
   return true;
  }
Al final, el método devuelve true, lo que significa que todos los gradientes han recorrido correctamente el camino hacia atrás y se han acumulado cuidadosamente en las entradas y parámetros internos correspondientes.
Con esto concluimos el análisis de los algoritmos de construcción de los métodos de la clase CNeuronFastGConv. El código completo de este objeto y de todos sus métodos se incluye en el archivo adjunto.
Objeto de nivel superior SAGDFN
Una vez construido el objeto de un bloque recurrente, pasamos al nivel superior: el envoltorio que vincula el codificador y el decodificador en un único sistema. La clase CNeuronSAGDFN no es solo un contenedor: organiza el flujo de datos, controla el uso compartido de la misma matriz slim de adyacencia y garantiza la coherencia de las transformaciones temporales y espaciales en todo el modelo.
class CNeuronSAGDFN  :  public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cTranspose;
   CLayer                  cEmbedding;
   CNeuronSNSMHAttention   cAttention;
   CLayer                  cGCRU;
   CLayer                  cProjection;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSAGDFN(void) {};
                    ~CNeuronSAGDFN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps, uint variables, uint embedding_dim,
                          uint emb_layers, uint sparse_dimension, uint heads,
                          float sparse, uint gcru_layers,
                          uint forecast, uint forec_layers,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSAGDFN;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Al organizar el funcionamiento de la clase CNeuronSAGDFN, conviene tener en cuenta que el framework SAGDFN se basa en la identificación de dependencias espaciales clave y analiza las correlaciones de secuencias unitarias de una serie temporal multimodal. Por nuestra parte, solemos trabajar con secuencias temporales. Por ello, dentro del objeto hemos organizado la transposición del tensor de datos originales y la transposición inversa del tensor de resultados.
Para realizar la primera operación, declaramos el objeto interno correspondiente, y la última tenemos previsto ejecutarla mediante la clase padre CNeuronTransposeOCL. Esta solución simplifica las tareas de preparación de datos antes de pasarlos al módulo y facilita la integración del modelo en el pipeline existente.
Además, hemos previsto la posibilidad de modificar dinámicamente la arquitectura del objeto. Para ello, se incluyeron 3 arrays dinámicos:
- cEmbedding — minimodelo para generar embeddings de un tamaño determinado a partir de los datos de entrada;
- cGCRU — conjunto de GCRU (Graph-Convolutional Recurrent Unit) secuenciales que agrupa una secuencia de bloques OneStepFastGConv;
- cProjection — bloque de proyección que, en el decodificador, transforma las representaciones ocultas en predicciones objetivo.
Este enfoque permite aumentar de forma flexible la profundidad de la pila recurrente y experimentar con el número de pasos de difusión. CNeuronSAGDFN integra la transposición de las entradas, el embedding, el módulo Attention compartido y la pila GCRU en un único Codificador-Decodificador. Controla cómo se reutiliza la misma matriz slim de adyacencia en toda la pila, garantiza la compatibilidad de los formatos de datos y actúa como coordinador central durante el entrenamiento.
La construcción directa de la arquitectura del nuevo objeto se lleva a cabo en el método Init.
bool CNeuronSAGDFN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint time_steps, uint variables, uint embedding_dim,
                         uint emb_layers, uint sparse_dimension, uint heads,
                         float sparse, uint gcru_layers,
                         uint forecast, uint forec_layers,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(emb_layers <= 0 || gcru_layers <= 0 || forec_layers <= 0)
      return false;
En el cuerpo del método se lleva a cabo primero una sencilla validación de los parámetros recibidos: si el número de capas de cualquiera de los bloques es igual a cero, la inicialización se interrumpe inmediatamente. Se trata de una comprobación honesta y útil: es mejor rechazar los datos de entrada que seguir construyendo una estructura incorrecta.
A continuación, se transfiere el control al método homónimo de la clase padre, que define la forma general de la neurona y reserva los recursos básicos. Si este paso no se ha completado, también devolvemos cuidadosamente false, ya que todo lo posterior depende de un contexto básico correcto.
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, variables, forecast, optimization_type, batch))
      return false;
Luego inicializamos el objeto de transposición del tensor de datos de entrada al formato esperado.
   uint index = 0;
   if(!cTranspose.Init(0, index, OpenCL, time_steps, variables, optimization, iBatch))
      return false;
A continuación, empezamos a montar la minimodelo de embedding. Limpiamos el contenedor y vinculamos el contexto OpenCL. El primer bloque convolucional cambia la dimensión de los datos hasta el nivel especificado. Lo añadimos al contenedor cEmbedding y le asignamos SoftPlus como función de activación.
//--- Embedding
   cEmbedding.Clear();
   cEmbedding.SetOpenCL(OpenCL);
   index++;
   CNeuronConvOCL *conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps, time_steps, embedding_dim, variables, 1, optimization, iBatch) ||
      !cEmbedding.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < emb_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                    embedding_dim, variables, 1, optimization, iBatch) ||
         !cEmbedding.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
A continuación, en el ciclo sobre emb_layers, añadimos capas convolucionales adicionales con la activación SoftPlus. Esto proporciona una pila de embedding profundo con la misma anchura de canales.
Después de las convoluciones, añadimos BatchNorm: un objeto independiente que normaliza la salida de la última capa convolucional.
   CNeuronBatchNormOCL *norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cEmbedding.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
Después preparamos los bloques GCRU. Limpiamos el contenedor cGCRU, vinculamos OpenCL e inicializamos inmediatamente cAttention.
//--- GCRUs
   cGCRU.Clear();
   cGCRU.SetOpenCL(OpenCL);
   index++;
   if(!cAttention.Init(0, index, OpenCL, variables, embedding_dim, heads,
                       sparse_dimension, sparse, optimization, iBatch))
      return false;
Ten en cuenta que cAttention se inicializa antes de crear los objetos gcru; esto es intencionado y correcto, ya que todos los GCRU leerán la misma matriz de adyacencia slim. Si falla la inicialización de attention, nos detenemos y lo indicamos.
A continuación, en el ciclo creamos el número necesario de CNeuronFastGConv. Si no se crea algún gcru, lo eliminamos y devolvemos false. De este modo se forma una pila de bloques de grafos recurrentes; todos ellos operarán conjuntamente con la matriz creada por cAttention.
   CNeuronFastGConv *gcru = NULL;
   for(uint i = 0; i < gcru_layers; i++)
     {
      index++;
      gcru = new CNeuronFastGConv();
      if(!gcru ||
         !gcru.Init(0, index, OpenCL, variables, embedding_dim, sparse_dimension, optimization, iBatch) ||
         !cGCRU.Add(gcru))
        {
         DeleteObj(gcru);
         return false;
        }
     }
Después de esto se construye el bloque de proyección cProjection. La primera capa convolucional transforma los datos de la dimensión del embedding al espacio de predicción forecast para cada variable.
//--- Forecast
   cProjection.Clear();
   cProjection.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, embedding_dim, embedding_dim,
                 forecast, variables, 1, optimization, iBatch) ||
      !cProjection.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   for(uint i = 1; i < forec_layers; i++)
     {
      index++;
      conv = new CNeuronConvOCL();
      if(!conv ||
         !conv.Init(0, index, OpenCL, forecast, forecast,
                    forecast, variables, 1, optimization, iBatch) ||
         !cProjection.Add(conv))
        {
         DeleteObj(conv);
         return false;
        }
      conv.SetActivationFunction(SoftPlus);
     }
   norm = new CNeuronBatchNormOCL();
   index++;
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cProjection.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   norm.SetActivationFunction(None);
//---
   return true;
  }
Luego añadimos capas de convolución adicionales en el ciclo. Al final del minimodelo añadimos BatchNorm sin activación externa, tal y como se hacía en la pila de embeddings. Si todas las incorporaciones se han realizado correctamente, Init devuelve true, y la arquitectura queda montada.
Pasando gradualmente de la organización de las capas a su ejecución, repasemos el método feedForward y veamos qué ocurre exactamente en tiempo de ejecución: qué búferes se desplazan, qué comprobaciones evitan los fallos y dónde acechan los puntos delicados.
bool CNeuronSAGDFN::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cTranspose.FeedForward(NeuronOCL))
      return false;
El método comienza con la transposición de los datos de partida. Este es precisamente el momento en el que pasamos de la representación de una serie temporal multimodal a un conjunto de secuencias unitarias. Si la operación no se ha realizado correctamente, el pipeline posterior carece de sentido: salimos limpiamente.
A continuación, creamos variables locales de punteros a objetos internos. Una operación sencilla, pero fundamental, que permite reutilizar el mismo bloque de código con distintos objetos.
   CNeuronBaseOCL *inputs = cTranspose.AsObject();
   CNeuronBaseOCL *current = NULL;
En primer lugar, se realiza el embedding. Recorremos todos los componentes del contenedor cEmbedding en un ciclo. En cada iteración, asignamos la siguiente capa a la variable current y, acto seguido, llamamos de forma segura a su método de propagación directa. Esto significa que cada eslabón del embedding transforma secuencialmente los datos originales y pasa el resultado al siguiente.
//--- Embedding
   for(int i = 0; i < cEmbedding.Total(); i++)
     {
      current = cEmbedding[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
Una vez ejecutada con éxito la operación, modificamos el puntero de la variable inputs; es decir, transferimos el papel de datos de partida al resultado que acabamos de obtener. Y pasamos a la siguiente iteración del ciclo.
En definitiva, una vez completadas todas las iteraciones del ciclo, el puntero de la variable inputs apunta a la última capa de embedding: la representación densa ya preparada de la ventana temporal analizada.
La siguiente etapa es la pila GCRU. En primer lugar, formamos una matriz slim As (índices y pesos) a partir de las representaciones actuales. Si attention no ha funcionado, es mejor detenerse y no seguir intentándolo.
//--- GCRUs
   if(!cAttention.FeedForward(inputs))
      return false;
   CNeuronFastGConv *gcru = NULL;
   for(int i = 0; i < cGCRU.Total(); i++)
     {
      gcru = cGCRU[i];
      if(!gcru ||
         !gcru.FeedForward(inputs, cAttention.AsObject()))
         return false;
      inputs = gcru;
     }
A continuación, en el ciclo sobre el contenedor cGCRU, vamos tomando cada elemento por orden y ejecutamos su método de propagación directa.
Tenga en cuenta que, en este caso, se pasan dos argumentos: el tensor actual y una referencia al objeto attention, del que GCRU extraerá los índices y los pesos As. Tras cada paso ejecutado correctamente, volvemos a cambiar el puntero en la variable local de datos de entrada y pasamos a la siguiente iteración.
Como resultado, la pila GCRU funciona de forma secuencial: cada bloque lee la misma matriz slim, pero la aplica a su propio estado y devuelve la representación oculta actualizada.
Cuando la pila de bloques recurrentes ha terminado de ejecutarse, pasamos al bloque de proyección del pronóstico. El ciclo sobre el contenedor cProjection sigue la misma lógica: tomamos la siguiente capa de proyección y llamamos al método de propagación directa, tras lo cual modificamos el puntero al objeto de datos de entrada.
//--- Forecast
   for(int i = 0; i < cProjection.Total(); i++)
     {
      current = cProjection[i];
      if(!current ||
         !current.FeedForward(inputs))
         return false;
      inputs = current;
     }
//--- resultado
   return CNeuronTransposeOCL::feedforward(inputs);
  }
En términos conceptuales, se trata de transformar la representación oculta en la forma final del pronóstico para cada variable.
Por último, devolvemos los datos al formato original utilizando los métodos de la clase padre. Se trata de una transposición inversa: ahora los pronósticos vuelven al formato que espera el resto del sistema. Si el último paso se realiza con éxito, el método devolverá true y toda la cadena de propagación directa concluirá correctamente.
El método feedForward se implementa de forma lineal y transparente: los datos pasan por una transposición, luego por una pila de embedding, obtienen una matriz de atención slim común, se procesan secuencialmente mediante bloques GCRU, se proyectan en el pronóstico y se devuelven al formato original. Este flujo es fácil de depurar y ampliar; basta con cuidar el manejo de los punteros y la eficiencia de las transformaciones intermedias.
Los métodos de propagación inversa se construyen de manera análoga. Por eso, propongo que no nos detengamos en analizarlos en detalle. El código completo de la clase CNeuronSAGDFN y de todos sus métodos se incluye en el archivo adjunto y está disponible para su estudio por cuenta propia.
Pruebas
El entrenamiento del modelo se asemeja a una expedición bien planificada: antes de adentrarnos en el mar abierto del mercado real, nos entrenamos a fondo en el tranquilo puerto de la historia. Esta primera etapa offline se basó en los datos del par de divisas EURUSD con timeframe H1 durante todo 2024, un periodo lleno de contrastes. Aquí hubo tanto aguas tranquilas, casi espejadas, de los movimientos laterales, como tormentas turbulentas de movimientos tendenciales bruscos y ráfagas inesperadas de volatilidad provocada por las noticias. Esta diversidad de escenarios de mercado permitió al modelo desarrollar una navegación estable y aprender a reconocer tanto los patrones habituales como los poco frecuentes del movimiento del precio, sin perder el rumbo ni siquiera en condiciones difíciles.
Una vez finalizados los preparativos, llegó el momento de salir del muelle de entrenamiento y poner a prueba la nave en las corrientes del mercado real. La segunda fase —el ajuste online— se llevó a cabo ya en condiciones reales de operación en el probador de estrategias de MetaTrader 5. Aquí, los datos llegaban de forma secuencial, vela tras vela, y el modelo aprendía no solo a analizar la información en streaming, sino también a mantener la estabilidad en medio de remolinos de ruido, en los bajíos inestables de baja liquidez y durante inesperados vendavales de noticias. Esta fase desempeñó el papel de ajuste fino: no alteraba la estructura ya construida, sino que ayudaba a perfeccionarla para adaptarla a la realidad, aumentando la adaptabilidad y reduciendo el riesgo de sobreajuste.
La prueba final fue una auténtica prueba de fuego. Tomamos los datos de enero de 2025 —totalmente nuevos, no utilizados en experimentos anteriores— y cargamos sin ningún cambio todos los parámetros obtenidos previamente. Fue un momento decisivo: sin ajustes ni correcciones adicionales, solo una prueba limpia que reflejaba la capacidad real del modelo para generalizar.
A continuación se muestran los resultados de las pruebas.
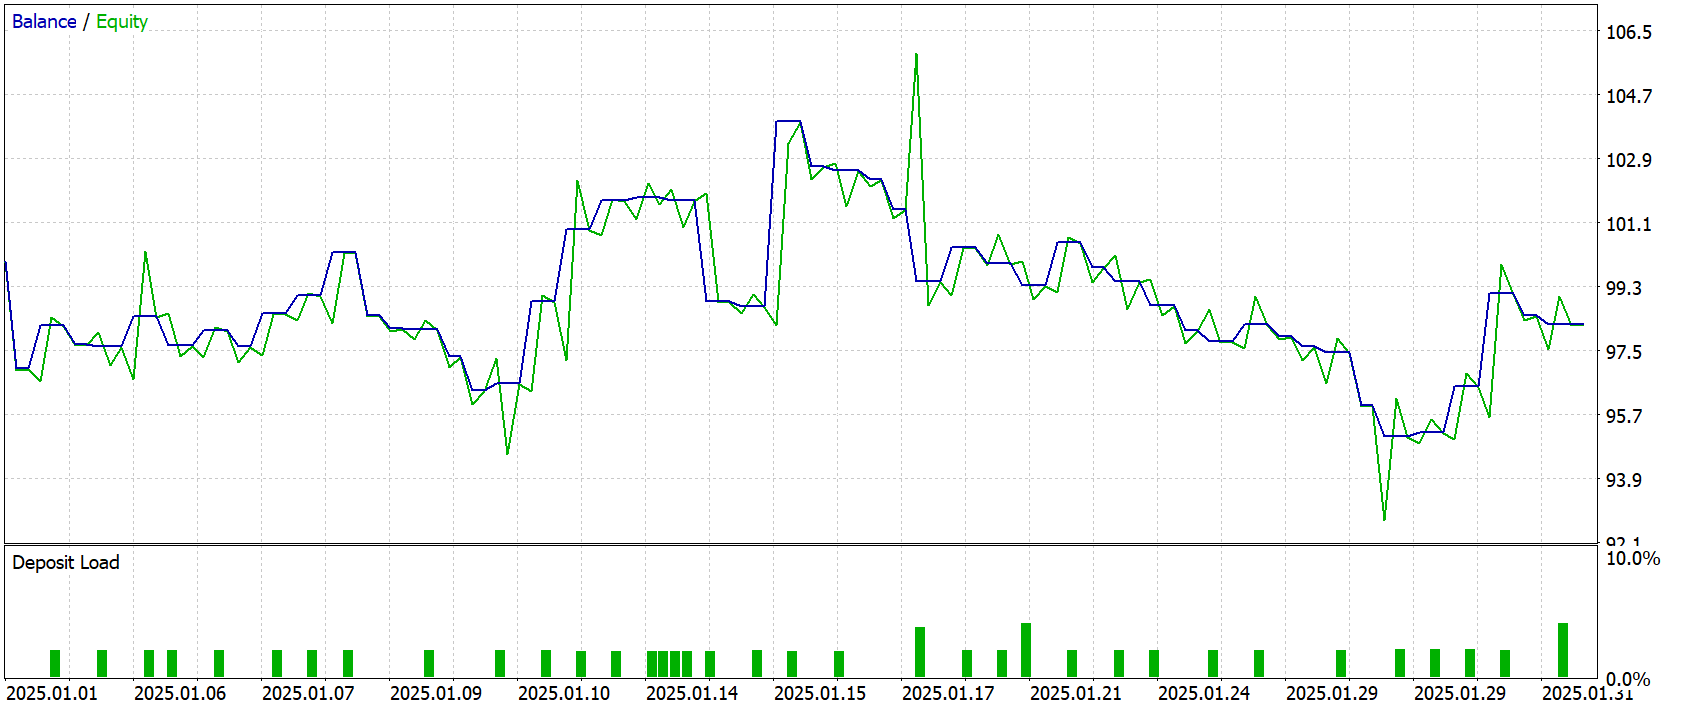
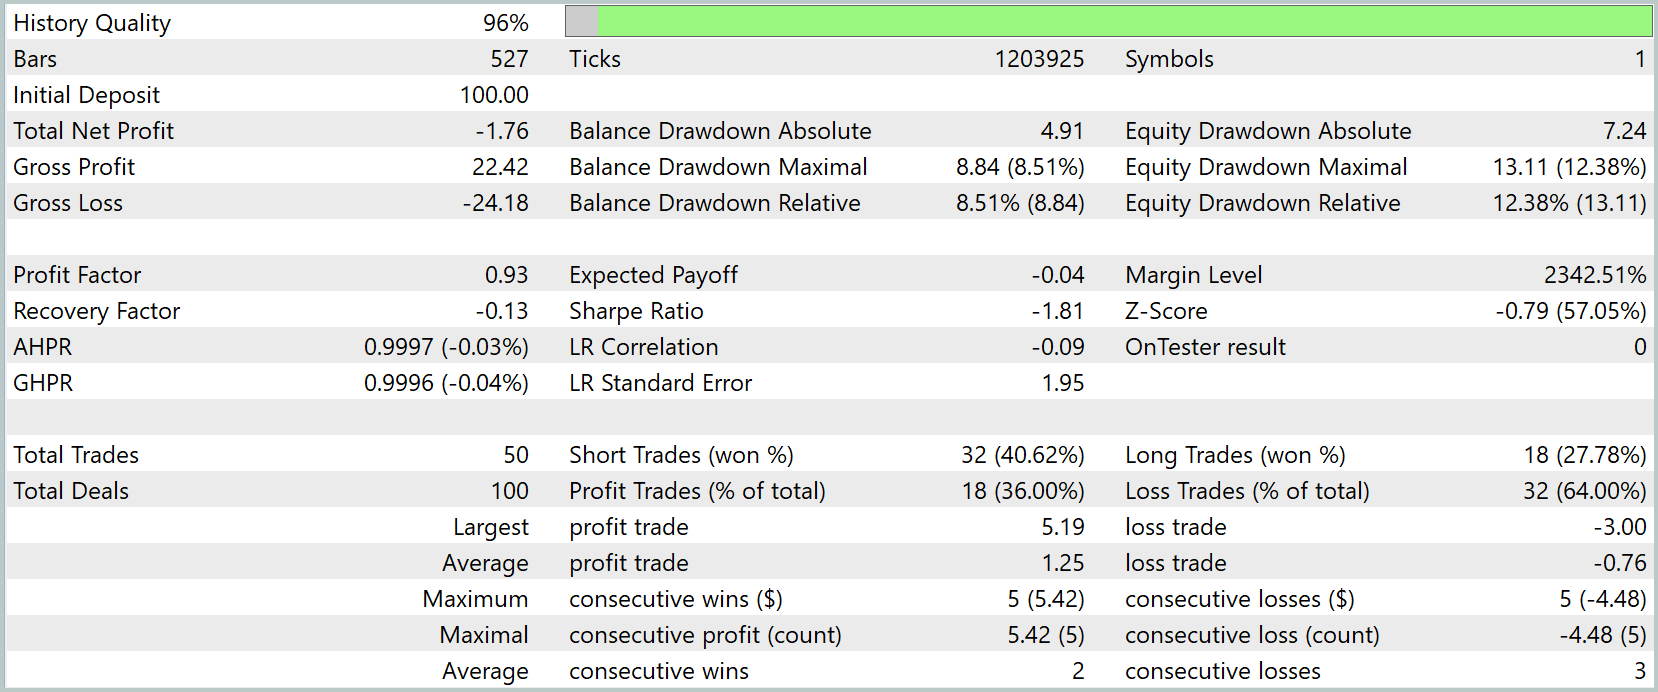
Los resultados de las pruebas demostraron que el modelo se comportó con cautela y de forma bastante predecible. La rentabilidad final fue negativa: -1,76 USD respecto a un depósito inicial de 100,0 USD. Las ganancias totales ascendieron a 22,42 USD, pero las pérdidas las superaron, alcanzando los 24,18 USD. Esto se reflejó también en las métricas clave: el factor de beneficio se fijó en 0,93, lo que indica un ligero predominio de las operaciones perdedoras. El factor de recuperación también entró en terreno negativo, situándose en -0,13.
Según el desglose de las operaciones, se observa que el modelo abrió 50 órdenes, de las cuales 32 correspondieron a posiciones cortas con una tasa de éxito de alrededor del 40 %, mientras que las posiciones largas fueron solo 18 y su tasa de éxito fue ligeramente inferior al 28 %. Las operaciones rentables ascendieron a 18, es decir, el 36 % del total, mientras que se registraron pérdidas en 32 operaciones. La racha máxima de ganancias fue relativamente modesta: cinco operaciones consecutivas que generaron una ganancia de unos 5,42 USD, mientras que la racha de pérdidas también alcanzó las cinco operaciones, con una caída de -4,48 USD.
El gráfico de balance y equity muestra que la estrategia se comportó de forma ondulante, con periodos de crecimiento moderado y posteriores descensos, sin desplomes bruscos, pero también sin una tendencia alcista sostenida. Tras la adaptación inicial, se observó un repunte a corto plazo que, sin embargo, no se consolidó, y el balance fue deslizándose gradualmente hacia la zona negativa, oscilando en torno al nivel inicial hasta el final del periodo de prueba. Esto indica que el algoritmo aún no ha logrado una ventaja estable en el intervalo de tiempo analizado, pero tampoco ha mostrado fallos catastróficos: la caída se mantuvo dentro del 8,5 % por balance y en torno al 12 % por equity.
En general, los resultados de las pruebas pueden calificarse de intermedios e indican que el modelo requiere un ajuste adicional y, posiblemente, una ampliación del conjunto de datos de entrenamiento para mejorar su capacidad de generalización. No tiende a sufrir caídas pronunciadas, pero por el momento no muestra una rentabilidad estable, lo que hace que su comportamiento sea más bien conservador y prudente que arriesgado.
Conclusión
Como conclusión del trabajo realizado, cabe señalar que las pruebas llevadas a cabo han permitido evaluar de forma objetiva el estado actual del enfoque desarrollado e identificar sus puntos fuertes y débiles. El modelo ha demostrado resistencia ante las fuertes fluctuaciones del mercado y un nivel moderado de caídas, manteniendo el control de los riesgos incluso en escenarios desfavorables. Sin embargo, la rentabilidad final sigue siendo negativa por el momento, y la proporción entre operaciones rentables y deficitarias apunta a la necesidad de optimizar aún más los parámetros y, probablemente, de ampliar el volumen de datos de entrenamiento.
Estos resultados no suponen un fracaso; al contrario, definen los límites de la implementación actual y marcan las líneas de desarrollo futuro. Los próximos pasos deben centrarse en perfeccionar el mecanismo de toma de decisiones, reforzar el filtrado de ruido y mejorar la precisión del pronóstico en condiciones de mercado cambiante. Así pues, el framework presentado ya demuestra hoy una base funcional y estable, pero su potencial solo se revela parcialmente, lo que deja margen para posteriores mejoras y para su adaptación práctica a tareas de trading reales.
Enlaces
- SAGDFN: A Scalable Adaptive Graph Diffusion Forecasting Network for Multivariate Time Series Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clase | Estructura de descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clase | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19425
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Robot de trading basado en un modelo GPT
 Particularidades del trabajo con números del tipo double en MQL4
 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (módulo de atención)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso