

取引におけるニューラルネットワーク:空間と時間の統合的視点(最終回)
 24
 0

はじめに
金融市場は生き物になぞらえることができます。個々の価格変動は脈拍に、また、ニュースやマクロ経済に関する政策決定は心臓の鼓動にたとえられ、それらが市場全体に変化の波を広げていきます。 金融市場は、何百万人もの参加者の行動を反映した複雑なリズムで、息づき、変動し、上昇と下降を繰り返します。 このような環境では、アナリストやトレーダーは、目先の動きを捉えるだけでなく、表面的なノイズに隠れがちな長期的なトレンドを予測するという課題に直面します。 ここでは、時空間データの取り扱いが中心となります。 なぜなら、どのような市場状況も、時間軸と、取引判断の空間を反映する価格軸という2つの次元に沿って同時に変化していくからです。
Extralongerフレームワークは、従来のモデルの限界を克服し、予測を新たなレベルへと引き上げることを目指しています。 その最大の利点は、極めて長い期間にわたって安定したパフォーマンスを発揮できる点にあります。 これに対し、既存のアルゴリズムの大部分は、数分あるいは数時間という時間間隔に限定されています。 こうした範囲内では、短期的な変動や局所的な傾向を追跡することは可能ですが、その先を見据え、形成されつつある大きな動きを捉えるような体系的な視点を構築することは不可能です。一方、Extralongerは、他の手法が方向を見失ってしまうような状況でも精度と安定性を維持しつつ、長期的な予測への道を開きます。
この特性は、特に取引において重要です。 日中取引向けの時間足で取引をおこなうトレーダーにとって、1分1分が極めて重要になることがあります。 しかし、それ以上に価値があるのは、明日や数日後に市場がどのように動くかを理解することです。 投資家にとって、1週間以上の期間にわたる将来の動向を把握することは、リスク管理や戦略策定のためのツールとなります。Extralongerはこれら2つのアプローチを組み合わせることで、市場を間近からも、遠くからも捉えられるようにします。 これは、旅人が虫眼鏡で地図の細部を調べ、望遠鏡で遠くの地形の輪郭を把握するのと同じです。
このフレームワークの2番目に重要な利点は、高い計算効率です。 従来の手法の問題点は、時間的次元と空間的次元を別々に分析することにあります。 時系列の変動を分析する際、アルゴリズムは市場データの各データ点や金融商品ごとに計算を繰り返す必要があり、空間的な関係を処理する際には、時間領域で演算を繰り返します。 この手順の重複により、必要なリソースが急速に膨れ上がってしまいます。 このモデルは、ますます多くのメモリと時間を必要とするため、予測期間が制限されてしまいます。 価格変動への対応速度が極めて重要となる金融市場において、こうした制約は深刻な障壁となります。
Extralongerは、この問題を根本的に新しい方法で解決します。 これは、統一時空間表現(Unified Spatial-Temporal Representation)という、時間と空間を統一して表現する概念に基づいています。 このアイデアは、アインシュタインの相対性理論に着想を得たものです。 物理学において空間と時間が単一の連続体を形成しているのと同様に、金融データにおいても、ある時点を価格水準から切り離して考えることはできず、また、時間的な文脈を考慮せずに局所的な市場構造を分析することもできません。 したがって、各データ要素には、時間的な情報と空間的な情報の両方が同時に含まれています。 これにより、計算を繰り返す必要がなくなり、モデルの複雑さが約1桁に低減されます。
その結果、Extralongerには次のような大きなメリットがあります。
- メモリ使用量の削減
- 学習の高速化
- 予測速度の向上
具体的には、計算リソースが限られている環境でも、このモデルの学習や実行が可能であるということです。
アーキテクチャの観点から見ると、Extralongerフレームワークは、時間的経路、空間的経路、および混合経路という3つの並列情報処理経路を中核として構築されています。 それぞれが固有の役割を果たしています。時間的経路は、市場で起こる一連の出来事を分析し、価格変動のパターンを探ります。空間的経路は、金融商品や資産間の相互関係のネットワークを調べ、隠れた相関関係や構造を明らかにします。混合経路は、両方のアプローチを組み合わせて、包括的な全体像を描き出します。
Extralongerにおいて、Global-Local Spatial Transformerモジュールは特別な役割を果たしており、アナリストが使う二重レンズに例えることができます。 一方では、大域Attentionによって、遠く離れた市場要素間のつながりを考慮に入れることが可能になります。 他方では、局所Attentionが、単一の取引セッション内における近接する通貨間の短期的な相関関係など、最も近い要素間の関係に焦点を当てます。 この組み合わせにより、このモデルは主要なトレンドと局所的な変動の双方を同等にうまく処理できるようになります。
Extralongerのもう一つの独自の特徴は、利用可能な履歴全体をカバーする受容野です。 つまり、このモデルは、入手可能なすべての過去データを同時に考慮に入れ、それを現在のあらゆる事象と関連付けることができるということです。 スライディングウィンドウや固定の時間ステップによって制約を受けるアルゴリズムとは異なり、Extralongerは市場全体を捉えます。 今日の価格動向を1週間前の出来事と比較したり、より長い時間間隔でのみ現れる長期的な依存関係を特定したりすることができます。 これは金融市場において特に重要な意味を持ちます。なぜなら、価格変動の多くは個別の出来事によって引き起こされるのではなく、徐々に蓄積されていく要因の積み重ねによって生じ、それが大規模なトレンドとして現れるからです。
著者によるExtralongerフレームワークの構成図を以下に示します。
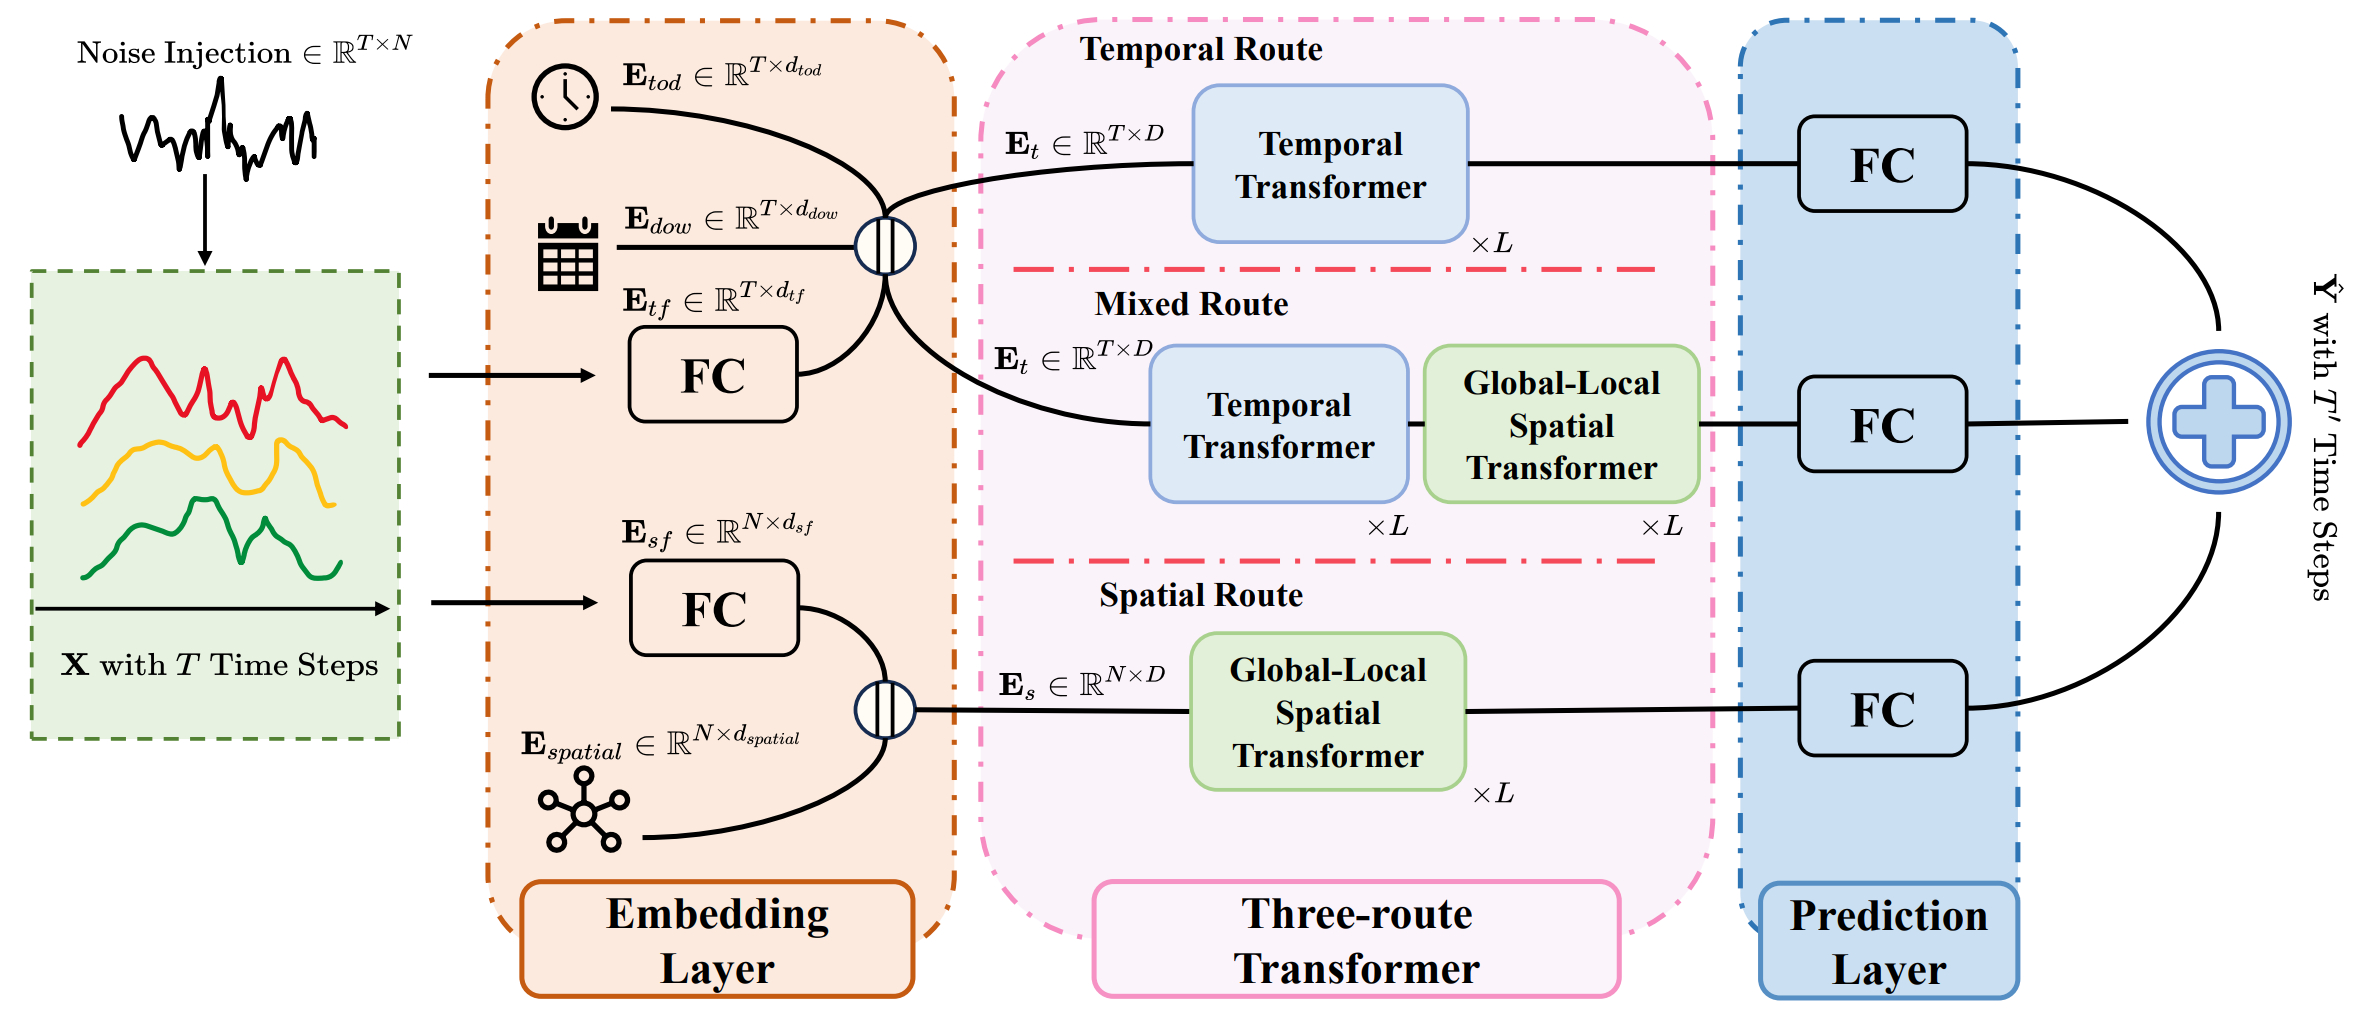
私たちのプロジェクトは、単純なものから複雑なものへ、個々の要素から一体的なアーキテクチャへと、段階的に発展しています。 当初、私たちはExtralongerの概念的な基盤に焦点を当て、MQL5を用いた実装に向けて最初の実践的な一歩を踏み出しました。 この段階で、空間的および時間的なエンコーディングモジュールを実装しました。これにより、データを市場構造に紐付けることが可能となり、さらなる統合に向けた基盤を築くことができました。
その後、フレームワークのアーキテクチャ設計に取り掛かりました。 以前は主にレンガを扱っていましたが、今では壁や床スラブを組み立て始めています。 Global-Local Spatial Transformerモジュールの実装については詳しく検討しました。 この段階では、個々の要素を統合し、一貫性のある計算プロセスとしてまとめることができました。 つまり、いずれ市場のあらゆる側面を捉えることを可能にする、まさにその観測フレームワークの構築に着手したのです。
この2つのステップは、大作の舞台を整えることに例えることができます。 まず、舞台セットを整え、主要な要素をどこに配置するかを決定しました。そして、最初のアクターであるデータ処理モジュールを舞台に登場させました。 そして今、この舞台作品の構想の全貌を観客の皆さんに明かす機会が訪れました。 それでは、Extralongerの核心であるアルゴリズムそのものについて見ていきましょう。 大域Attentionと局所Attention、統一表現、そして3つの並列経路が交わるこの部分でこそ、このアプローチの独自性が明らかになります。
最上位オブジェクト
Extralongerフレームワークのアプローチを実装した階層構造全体の最上位には、CNeuronExtralongerオブジェクトがあります。これは、主要なモジュールを単一の計算サイクルに統合する、アーキテクチャの中核と見なすことができます。 先ほど説明したクラスやブロックは個々の構造要素を担っていましたが、ここでは、それらすべてを結びつける中心となるノードについて扱います。
class CNeuronExtralonger   :  public CNeuronMHAttentionPooling
  {
protected:
   CLayer               cProjectionT;
   CLayer               cTimeModule;
   CLayer               cSpatialModule;
   CLayer               cMixModule;
   CNeuronBaseOCL       cConcatResults;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronExtralonger(void) {};
                    ~CNeuronExtralonger(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps_in, uint time_steps_out, uint variables,
                          uint dimension, uint emb_dimension, uint period1,
                          uint frame1, uint period2, uint frame2, uint layers,
                          uint heads, uint dimension_k, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronExtralonger;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
構造上、CNeuronExtralongerはCNeuronMHAttentionPoolingクラスを継承しており、このことから、その機能的な方向性がすぐにわかります。 データ処理は引き続き、集約機構を備えたMulti-Head Attentionを基盤としており、その上に追加の層を重ねることで、Extralonger独自のアイデアを実装しています。
ここで、私たちの実装と元の設計との重要な違いに触れておきます。 Extralongerのオリジナル版では、3つのデータフロー経路(時間的・空間的・混合)の重みがハードコーディングされており、固定されています。 このアプローチは、その単純さゆえに便利ですが、変動の激しい金融市場においては、必然的に柔軟性の低下を招くことになります。 状況によっては、短期的な時間的パターンが重要な役割を果たすこともあれば、全体的な空間的相関が極めて重要となることもあり、また、その両方の組み合わせが決定的となることもあります。 固定された重みでは、この重点の移り変わりを動的に考慮できず、その結果、予測精度が低下します。
まさにそのため、私たちの実装ではさらに一歩踏み込み、適応型のAttentionプーリング機構を導入しました。この機構は、R-MATフレームワークから取り入れたものです。 重要なのは、各経路の重み係数があらかじめ決められるのではなく、モデルの実行中に計算されるという点です。 新しい入力データ信号ごとに、時間的処理モジュール、空間的処理モジュール、混合モジュールへのAttentionの配分が個別に決まります。 その結果、システムは市場の状況に敏感に反応するようになります。 値動きが落ち着いた保ち合い局面では時間的分析の役割が大きくなり、外部ショックが発生した際には空間的な関係がより重要になり、ボラティリティが高い時期には混合経路が中心的な役割を果たします。
この仕組みにより、CNeuronExtralongerは、はるかに動的なツールになります。 Attentionの分布が常に一定である元の静的な方式とは異なり、適応型Attentionプーリングにより、システムは柔軟性と自己調整能力を備えるようになります。 状況に応じて重点をうまく切り替えることができる、経験豊富なトレーダーのように振る舞います。
このオブジェクトには、動的配列である4つの主要な構成要素が含まれています。 これらの配列には、内部の各情報フローを構成するニューラル層の列が格納されます。 一見すると、4つの内部モジュールを作成するのは奇妙に思えるかもしれません。 そもそも、Extralongerアーキテクチャで言及されているのは、時間的、空間的、混合の3つの分岐だけです。 ここで、ある特定の特徴に注目することが重要です。 時間的解析と混合解析の各分岐では、同じデータ準備ブロックを使用します。 重複を避け、管理性を向上させるため、データ準備ブロックを独立したコンポーネント「cProjectionT」として分離することにしました。 要するに、これは入力系列を後続の処理に適した埋め込みへと一貫した形で変換する汎用ゲートウェイです。
空間的解析の分岐と、それに対応するデータ準備モジュールを統合し、単一のユニット「cSpatialModule」にまとめました。 このように構成するのは、空間的な依存関係に特有の性質があるためです。 ここでは、データの前処理とモデル自体が非常に密接に結びついているため、これらを単一の内部構造として捉えるのが妥当です。
したがって、最終的な構成要素は次の4つになります。
- cProjectionT — 時間的分岐と混合分岐のデータ準備ブロック
- cTimeModule — 時間的解析モデル
- cSpatialModule — データ準備と空間的解析を統合したモデル
- cMixModule — 時間的特徴量と空間的特徴量を統合する混合経路
まさにこの構成によって、元のExtralongerアーキテクチャの論理を維持しつつ、実装のモジュール性と保守性を高めることができます。
アーキテクチャ全体のフレームワークから徐々に内部の詳細へと目を向けると、そこで初めて構造の真の複雑さが明らかになります。 最上位レベルで見えるのは、前処理用の時間射影ブロック、時間的モジュール、空間的モジュール、混合経路に対応する4つの動的配列だけです。 しかし、この整然とした外観の裏には、畳み込み層や正規化層、転置変換器、学習可能な埋め込み、Attentionブロックといった、より小さな構成要素からなる一つの生態系が隠れています。 これらは個別に存在するわけではありません。それぞれが厳密に定義された役割を果たし、相互作用することで、CNeuronExtralongerを通る動的な情報の流れを形成します。
この内部の世界全体は、Initメソッド内で生成されます。 ここで、モデルの構造と動作の論理が確立されるといえるでしょう。 初期化は、親クラスの同名メソッドを呼び出すことから始まります。このメソッドは、Multi-Head Attentionプーリングの基本的なフレームワークを提供します。
bool CNeuronExtralonger::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint time_steps_in, uint time_steps_out, uint variables,
                              uint dimension, uint emb_dimension, uint period1,
                              uint frame1, uint period2, uint frame2, uint layers,
                              uint heads, uint dimension_k, uint m_units, float sparse,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHAttentionPooling::Init(numOutputs, myIndex, open_cl, variables, time_steps_out,
                                       3, optimization_type, batch))
      return false;
そして、ここから最も興味深い部分が始まります。 一歩一歩、複雑な生物を組み立てていきます。その過程で、各層が全体像に独自のニュアンスを加えていきます。 その前に、少し準備をしておきましょう。オブジェクトへのポインタを一時的に格納するためのローカル変数をいくつか宣言しましょう。
   CNeuronBatchNormOCL           *norm    = NULL;
   CNeuronConvOCL                *conv    = NULL;
   CNeuronTransposeOCL           *transp  = NULL;
   CNeuronLearnabledPE           *lnoise  = NULL;
   CNeuronSpatialEmbedding       *semb    = NULL;
   CNeuronTempEmbedding          *temb    = NULL;
   CNeuronMLMHAttentionOCL       *att     = NULL;
   CNeuronGlobalLocalAttention   *glatt   = NULL;
最初に登場するのは、時間的分析と混合分析の各分岐に向けて入力データを準備するブロックです。 それは、コンサート前に楽器を調律する調律師のようなものです。 位置エンコーディングオブジェクトは、入力データストリームに学習可能なオフセットを追加します。フレームワークの開発者たちは、これを「学習可能なノイズ」と呼んでいます。 ここで強調しておきたいのは、これは単にランダムな成分を混ぜることではなく、市場の時間的なリズムを認識する能力をモデルに組み込むための意図的な試みであるということです。 価格や出来高のデータは決して「クリーン」なものではなく、常に微細な変動の影響を受けています。 学習可能なノイズの埋め込みによって、この特性がツールとして活用できるようになります。つまり、モデルはパターンとカオスをより的確に区別し、実際の市場のリズムに基づいて時間の認識を構築し始めるのです。
//--- Time projection
   cProjectionT.Clear();
   cProjectionT.SetOpenCL(OpenCL);
   int index = 0;
   lnoise = new CNeuronLearnabledPE();
   if(!lnoise ||
      !lnoise.Init(0, index, OpenCL, time_steps_in * variables, optimization, iBatch) ||
      !cProjectionT.Add(lnoise))
     {
      DeleteObj(lnoise);
      return false;
     }
その直後に、特別な役割を果たす畳み込み層が続きます。 この層は、各時間ステップを、その時点で分析対象となるすべての特徴量の情報を含む埋め込みに変換します。 要するに、出力としてコンパクトで情報量の多い表現が形成され、各ステップにおける一種の市場状態のスナップショットとなります。 価格、出来高、指標、その他の変数が、1つのベクトルにまとめられます。 このようにして、モデルは個々の独立した数値ではなく、時間の経過に伴う観測結果の全容を反映した包括的な表現を扱えるようになります。
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, variables, variables, dimension, time_steps_in, 1,
                 optimization, iBatch) ||
      !cProjectionT.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
次のステップは時間埋め込みであり、ここで時系列データには、周期や期間を反映する追加の次元が与えられます。 このアーキテクチャには、市場の日次および週次のリズムに関連する、短期とより長期の2種類の反復パターンが組み込まれています。 それは、音楽家がビートや拍子を感じ取るのと同じようなものです。 どのようなメロディーであれ、楽曲を構築するには欠かせないリズムの基盤が常に存在します。 金融データにおいては、これは取引時間帯の変化、季節的な変動、あるいは主要な市場参加者による定期的な活動パターンとして表れます。 時間埋め込みは、文字通りこのリズムをデータに織り込み、モデルが日ごとや週ごとに繰り返されるパターンに敏感に反応できるようにします。
   index++;
   temb = new CNeuronTempEmbedding();
   uint half_emb = (emb_dimension + 1) / 2;
   if(!temb ||
      !temb.Init(0, index, OpenCL, time_steps_in, dimension, half_emb, period1,
                 frame1, dimension - half_emb, period2, frame2, optimization, iBatch) ||
      !cProjectionT.Add(temb))
     {
      DeleteObj(temb);
      return false;
     }
正規化により、準備段階が終了します。 これは、絵の具を塗る前にキャンバスの表面を滑らかにすることになぞらえることができます。 表面が平らでないと、描かれる絵が歪んでしまいます。 正規化はランダムな歪みを除去し、データを安定した分布に整えることで、より複雑なモジュールによる後続処理の基盤を築きます。
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, temb.Neurons(), iBatch, optimization) ||
      !cProjectionT.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
データは前処理ブロックを出ると、時間的分析モジュールに委ねられます。 ここでMulti-Head Attentionが活躍し、複数の並列した視点を同時に提供します。 この機構は、数十の時間ステップを隔てた時点間の関連性を探し出し、単純な線形的視点では見えてこないパターンを認識するよう学習します。
//--- Temporal Module
   cTimeModule.Clear();
   cTimeModule.SetOpenCL(OpenCL);
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, layers, optimization, iBatch) ||
      !cTimeModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
次に、データを指定された予想対象期間に投影するブロックが作動します。 これは、過去のデータと未来をつなぐ架け橋に例えることができます。 このブロックには複数の畳み込み層が含まれており、埋め込みをマルチモーダルな時系列に変換すると同時に、必要な予想対象期間をカバーするよう系列を延長して、その長さを調整します。 これらの層は、それぞれ異なる被写界深度を持つレンズのような役割を果たします。局所的な動きを強調する層もあれば、広い視野をもたらす層もあります。
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 variables, time_steps_in, 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cTimeModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
その結果、単なる埋め込みの集合ではなく、予想対象期間に合わせて調整された予測軌道が得られます。
それと同時に、混合モジュールが動作を開始し、ここでデータはとりわけ変化に富んだ旅をたどることになります。 その役割は独特で、時間的特徴量と空間的特徴量を組み合わせ、単一の情報ストリームへと変換することです。 最初に働くのは、標準的なMulti-Head Attentionブロックで、時間的系列をそのままの形で分析します。 このブロックは、系列の構造に隠れたパターンや対応関係、繰り返し現れるモチーフを探し出し、後続の分析に向けて強固なフレームワークを構築します。
//--- Mixed Module
   cMixModule.Clear();
   cMixModule.SetOpenCL(OpenCL);
   uint att_layers = (layers + 1) / 2;
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, att_layers, optimization, iBatch) ||
      !cMixModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
その後、データは「転置」という、ある種の視点の転換を経ます。 当初は時系列を時間ステップという観点から捉えていましたが、ここでは焦点が特徴量に移り、この新しい座標系でGlobal-Local Attentionモジュールが働きます。 ここでは、市場全体を俯瞰する大域的な視点と、個々の金融商品間の微妙な関連性や短時間の急激な変動を見極める局所的な視点という、相反する2つの視点がバランスよく組み合わされています。 この組み合わせは、金融の文脈において特に重要です。市場は数週間にわたり大きなトレンドの範囲内で推移することがありますが、個々の資産はニュースや地域的な出来事によって、突然方向転換することがあるからです。
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, dimension + emb_dimension, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   for(uint i = (att_layers == layers ? 0 : att_layers - 1); i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_in, dimension_k, heads,
                     m_units, sparse, optimization, iBatch) ||
         !cMixModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
最後のステップは予測ブロックであり、これまでに蓄積されたすべての情報を、所定の予想対象期間にわたる計画策定に適した形式に変換する役割を担っています。 このブロック内の複数の畳み込み層が、埋め込みを、必要なウィンドウ長と同じ長さの予測値の系列に変換します。 ここで、抽象的な表現が具体的な結果、すなわち大域的な文脈と局所的な特性の両方を反映した予測へと変換されます。
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out,
                             dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_out,
                                                          optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                                     variables, time_steps_out, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
その結果、この混合モジュールは一種の合成実験室として機能します。まず、時間的なパターンが捉えられ、次にそれらが空間的な関係に重ね合わされます。最後に、得られた信号が予測ブロックを通過し、複数の分析レベルが織り交ぜられた本格的な出力となります。
データの内部処理プロセスの最終段階は、空間的なモジュールです。 このモジュールは、市場を独立した時系列の集まりとして捉える見方から脱却させる役割を担います。 まず、ここでは空間埋め込みが形成されます。これらは、金融商品、セクター、指数の間の長期的な関係を捉えます。
//--- Spatial Module
   cSpatialModule.Clear();
   cSpatialModule.SetOpenCL(OpenCL);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cSpatialModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, dimension, variables,
                 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   semb = new CNeuronSpatialEmbedding();
   if(!semb ||
      !semb.Init(0, index, OpenCL, variables, dimension, emb_dimension, optimization, iBatch) ||
      !cSpatialModule.Add(semb))
     {
      DeleteObj(semb);
      return false;
     }
これらに基づき、Global-Local Attentionブロックは、相関関係の全体像と、特定の資産間の詳細な関係を順に構築していきます。 このモジュールは、金融市場を、それぞれのつながりが互いに結びついた「生きたネットワーク」へと変えると言えます。そして、このネットワークそのものが分析の対象となります。
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, semb.Neurons(), iBatch, optimization) ||
      !cSpatialModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   for(uint i = 0; i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, variables, dimension_k,
                     heads, m_units, sparse, optimization, iBatch) ||
         !cSpatialModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
また、前述の2つの経路と同様に、分析結果は予測ブロックに送られ、そこですべての情報が、指定された期間にわたる計画策定に適した形式に丁寧にまとめられます。
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 time_steps_out, variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
3つの経路(時間的、混合、空間的)はすべて、連結点で合流します。 ここで各経路の結果が統合され、この段階で、本実装の主要なメカニズムである適応型Attentionプーリングが作動します。 重みが固定された元のバージョンとは異なり、ここでは、その時々にどの経路の役割がより重要かを、経路同士で決定できるようにしています。 その結果、最終的な信号は静的なものではなく、市場のリズムに合わせて息づく柔軟なツールとなります。
   index++;
   if(!cConcatResults.Init(0, index, OpenCL, 3 * variables * time_steps_out, optimization, iBatch))
      return false;
   cConcatResults.SetActivationFunction(None);
//---
   return true;
  }
このように、Initメソッドは、単なる呼び出しの羅列を動的なアーキテクチャへと変換します。そこでは各コンポーネントが意味のある役割を果たし、それらの相互作用によって独自の分析ツールが生まれます。 ここで、CNeuronExtralongerと呼ばれる生命体が誕生し、そのすべての部分が全体の成果に向けて機能します。
オブジェクトの初期化が完了したら、次はfeedForwardメソッドで実装される順伝播アルゴリズムの構築に進みます。 このメソッドのシグネチャだけでも、多くのことがわかります。 このメソッドは、パラメータとして、入力データオブジェクトNeuronOCLへのポインタと、解析対象の系列のタイムスタンプを格納した追加バッファSecondInputを受け取ります。
bool CNeuronExtralonger::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   CNeuronBaseOCL *prev = NeuronOCL;
   CNeuronBaseOCL *current = NULL;
最初の内部処理は、2つの局所変数の宣言です。 そのうちの1つには、ソースデータオブジェクトへのポインタが割り当てられます。 これは標準的なパススルー手法です。prevは利用可能な最新の結果を保持し、その結果が次の層に渡されます。 また、currentは一時変数として機能し、各反復処理で、処理中の層へのポインタが格納されます。 このアプローチにより、層の連鎖を線形に構築することが可能となり、不要なコピーを回避しつつ、計算の順序を制御し続けることができます。
次に、ソースデータ準備用コンテナcProjectionTの各要素を順に処理するループを開始します。 各射影について、現在のオブジェクトへのポインタを取得し、直ちにそのポインタの有効性を確認します。 次に、そのオブジェクトの順伝播メソッドを呼び出します。 いずれかの段階でエラーが発生した場合、このメソッドは直ちに終了し、falseを返します。 これはフェイルファストパターンです。破損したデータの処理を続けるよりも、最初の問題が発生した時点で処理を中止したほうがよいのです。
//--- Time projection
   for(int i = 0; i < cProjectionT.Total(); i++)
     {
      current = cProjectionT[i];
      if(!current ||
         !current.FeedForward(prev, SecondInput))
         return false;
      prev = current;
     }
このブロックでは、内部オブジェクトのFeedForwardメソッドが、直前の結果とSecondInputのタイムスタンプという2つの引数を受け取る点に注意してください。 時間埋め込みの生成には、追加の文脈情報が必要だからです。
処理が正常に完了した場合、prev変数をcurrentが指すオブジェクトへのポインタで更新し、次の反復処理では、直前に処理した層の出力を使用します。
射影処理が完了すると、制御は時間的モジュールに移ります。 cTimeModuleコンテナの各要素を処理するループもほぼ同じですが、ここでは内部オブジェクトのFeedForwardメソッドに引数を1つだけ渡して呼び出します。 これは、時間的モジュールが、得られた系列を追加のバッファなしで処理することを示しています。
//--- Temporal Module
   for(int i = 0; i < cTimeModule.Total(); i++)
     {
      current = cTimeModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
時間的モジュールのいずれかの層が欠落している場合、またはそのFeedForwardがエラーを通知した場合は、ここでも処理を終了し、falseを返します。
その後、焦点は混合モジュールに移ります。 ただし、このモジュールもデータ前処理の結果を使用する点に留意する必要があります。そのため、ループを開始する前に、prev変数にcProjectionTコンテナの最後の層へのポインタを代入します。 時間的分岐と混合分岐は並列の経路をたどり、同じ入力特徴量を異なる方法で処理します。
//--- Mixed Module
   prev = cProjectionT[-1];
   for(int i = 0; i < cMixModule.Total(); i++)
     {
      current = cMixModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
次に、cMixModuleの各要素について、同様にポインタの有効性を確認して順伝播メソッドを呼び出し、その後、prevに格納されたポインタを更新します。 エラーが発生すると、この関数は再び直ちに終了し、false を返します。
空間的なモジュールは独立して構成されており、NeuronOCLを入力データとして受け取ります。 つまり、Spatial分岐は、中間変換の結果を引き継がずに、他の分岐と並行して入力信号を解析します。 その後、cSpatialModuleの各層を、通常のフェイルファストのロジックに従って順次実行し、prevを更新します。
//--- Spatial Module
   prev = NeuronOCL;
   for(int i = 0; i < cSpatialModule.Total(); i++)
     {
      current = cSpatialModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
その結果、時間的分岐、混合分岐、空間的分岐という3つの完全な分岐が得られます。 次のステップは連結です。 3つの分岐からの出力を1つのバッファに連結し、ウィンドウを形成して、最終的な次元数を設定します。 連結に失敗した場合、このメソッドはfalseを返します。
//--- Concatenate
   if(!Concat(cTimeModule[-1].getOutput(), cMixModule[-1].getOutput(), cSpatialModule[-1].getOutput(),
              cConcatResults.getOutput(), iWindow, iWindow, iWindow, iUnits))
      return false;
//---
   return CNeuronMHAttentionPooling::feedForward(cConcatResults.AsObject());
  }
連結が正常に完了したら、集約された結果をAttentionプーリングモジュールに渡す必要があります。
アーキテクチャの観点から見ると、このシステムが複数の並列経路から構成され、各経路がそれぞれの目的に応じて入力データを解析することがわかります。射影は時間的表現を準備し、時間モジュールは系列を解析し、混合モジュールは射影の結果を組み合わせ、Spatialモジュールは空間的特徴量に焦点を当てます。 この仕組みはオーケストラに似ています。それぞれの楽器が独自のパートを担い、指揮者であるAttentionプーリングがそれらを一つにまとめ上げます。
誤差勾配の伝播メソッドは、順伝播とほぼ同じ構造ですが、データが逆方向に流れる点と、各経路からの誤差を慎重に加算する必要がある点が異なります。
bool CNeuronExtralonger::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                            CBufferFloat *SecondInput,
                                            CBufferFloat *SecondGradient,
                                            ENUM_ACTIVATION SecondActivation = None)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronMHAttentionPooling::calcInputGradients(cConcatResults.AsObject()))
      return false;
まず、ソースデータオブジェクトへのポインタの有効性を確認します。 空の場合、このメソッドは直ちにfalseを返します。 次に、親クラスにある同名のメソッドが呼び出されます。 このステップにより、後続のニューラル層から受け取った誤差勾配を、連結されたバッファまで伝播させることができます。 得られた値は、その後、時間的分岐、混合分岐、空間的分岐という3つの分岐に振り分けられます。 共有バッファに集められた誤差は、モデルのアーキテクチャに厳密に従って分割される点に注意が必要です。 各分岐には、正しい勾配が割り当てられています。 いずれかの操作が失敗した場合、処理は中断されます。
//--- DeConcatenate
   if(!cTimeModule[-1] || !cMixModule[-1] || !cSpatialModule[-1] ||
      !DeConcat(cTimeModule[-1].getGradient(), cMixModule[-1].getGradient(),
                cSpatialModule[-1].getGradient(), cConcatResults.getOutput(),
                iWindow, iWindow, iWindow, iUnits))
      return false;
次に、勾配がモジュール間を逆順に伝播し始めます。 まず、空間的分岐から処理します。 ループは末尾から先頭へと実行されます。各処理対象の要素は、次の層への参照を取得し、内部オブジェクトの誤差勾配伝播メソッドを呼び出します。 誤差は、層ごとに慎重に逆向きに伝播されます。
   CNeuronBaseOCL *next = NULL;
   CNeuronBaseOCL *current = NULL;
//--- Spatial Module
   for(int i = cSpatialModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cSpatialModule[i - 1] : NeuronOCL);
      next = cSpatialModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
混合モジュールにも同じ処理ロジックが適用されますが、ここでは時間的射影の最後の要素を基準点として使用する点が異なります。 これは、このモデルの並列構造を反映しています。つまり、異なる分岐はそれぞれのチャネルを通じて誤差を返しますが、その処理は常に同期しておこなわれます。
//--- Mixed Module
   for(int i = cMixModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cMixModule[i - 1] : cProjectionT[-1]);
      next = cMixModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
特に注目すべきなのは、時間的なモジュールです。 ここで注目すべき点は、このモジュールが誤差勾配をデータ前処理モジュールの最終層に渡すことです。 そして、そこは混合モジュールからの値を渡したばかりの箇所でもあります。 したがって、時間的な解析モジュールの逆伝播を実行する前に、保存済みの値を含む現在の誤差勾配バッファへのポインタを局所変数tempに格納します。その後、空きバッファへのポインタをオブジェクトに渡します。
//--- Temporal Module
   CBufferFloat *temp = current.getGradient();
   if(!current.SetGradient(current.getPrevOutput(), false))
      return false;
   for(int i = cTimeModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cTimeModule[i - 1] : cProjectionT[-1]);
      next = cTimeModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
   if(!SumAndNormilize(temp, current.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !current.SetGradient(temp, false))
      return false;
次に、再び末尾から先頭へと進むループで、勾配をモジュール内の下位層へと伝播させます。 時間的分岐に沿った逆伝播を完了した後、2つのデータストリームから得られた値を合計し、データバッファのポインタを元の状態に戻します。
最後のステップは、時間的射影を処理することです。 ここでは、勾配が元データのオブジェクトのレベルまで伝播されます。 ただし、空間的分岐からの誤差勾配は、すでにそこへ渡していることを思い出してください。 そこで、再びデータバッファを入れ替える手法を用い、その後で誤差勾配の伝播処理を実行します。
//--- Time projection
   temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false))
      return false;
   for(int i = cProjectionT.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cProjectionT[i - 1] : NeuronOCL);
      next = cProjectionT[i];
      if(!current ||
         !current.CalcHiddenGradients(next, SecondInput, SecondGradient, SecondActivation))
         return false;
     }
   if(!SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
このように、このメソッドは、Spatial、Mix、Temporalという3つの並列分岐に勾配を慎重に分配します。 各分岐では、逆伝播が層ごとに逆順に進み、分岐の合流点で誤差が合算されます。 これは、順伝播と同じアーキテクチャ上の考え方を反映しています。つまり、データは並列チャネルを通って流れるものの、最終的には単一の結果に統合されます。
すべてのメソッドを含むクラスの完全なコードは添付ファイルに記載されていますので、実装の全体的な構造や内部の仕組みを確認することができます。
モデルアーキテクチャ
Extralongerフレームワークを実装するために必要なオブジェクトの構築がすべて完了したら、次の自然なステップとして、モデル自体のアーキテクチャについて説明することになります。 ここで強調しておきたいのは、著者による実装のように、時系列の予測だけに限定しているわけではないということです。 私たちの目標は、より広範かつ実用的なものです。私たちは、自律的に意思決定をおこない、市場で取引を実行できる本格的な自動売買ロボットを開発しています。
この定式化において、価格系列の予測というタスクは、もはや最終目標ではなく、システムの一部、具体的には、Environmental-State Encoderとしてのみ機能します。 市場データを、アルゴリズムが理解できる形式に変換する一種のセンサーです。 Actor-Criticの概念を維持しつつ、Encoder、Actor、Criticの3つの機能モデルを開発します。
CreateDescriptionsメソッドは、それらのアーキテクチャを記述するために使用されます。 そこでは、モデルの3つの部分それぞれについて、層の記述を含む配列が慎重に作成され、初期化されます。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
このコードは、まず受け取った配列のポインタを確認することから始まります。 そのうちの1つがまだ存在しない場合は、新しいものが作成されます。 この手順により信頼性が確保されます。つまり、この後で層の記述を配列に格納する際に、必要な構造が存在しないために処理が失敗することを防ぎます。
次に、配列を空にし、Encoderの各層を段階的に構築していきます。 まず、ソースデータ層が追加されます。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次のステップは、ノイズを加えた正規化層であり、これは確率的な歪みを通じて学習の安定性を高めるのに役立ちます。
//--- Layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、一次差分の特徴量を追加するための層を作成します。 その目的は、バーの値を互いに結び付けることで、時間スライスを生成することです。 その結果、値そのものとそれらの差分が組み合わされるため、この層が生成する特徴量の数は2倍になります。
//--- Layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint prev_out = descr.layers*2 ;
次の層であるdefNeuronExtralongerは、特に注目に値します。 これは、作成した最上位のCNeuronExtralongerオブジェクトのアーキテクチャを定義しています。 要するに、これがExtralongerフレームワークの全体像です。 そこでは、時間ウィンドウ、予測期間、短期および長期の期間、隠れ特徴量の次元数など、必要なすべてのパラメータを指定します。 このブロックは、Encoderを、過去データと未来を統一された表現の中で結びつけるインテリジェントなフィルターへと変換します。
//--- Layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronExtralonger;
     {
      uint temp[] = {HistoryBars,   // History time steps
                     NForecast,     // Forecast time steps
                     ShortPeriod,   // Period 2
                     LongPeriod,    // Period 2
                     BarDescr/2     // M units
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   prev_count = descr.units[1];
   descr.window = prev_out;            // Variables
   descr.window_out = EmbeddingSize;   // Inside Dimension
     {
      uint temp[] = {EmbeddingSize,             // Embedding Dimension
                     PeriodSeconds(PERIOD_H1),  // Frame 1
                     PeriodSeconds(PERIOD_D1),  // Frame 2
                     2*EmbeddingSize/NHeads
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers=2;
   descr.step=NHeads;
   descr.probability=0.3f;
   descr.optimization=ADAM;
   descr.batch=BatchSize;
   descr.activation = None;
   if(!encoder. Add(descry))
     {
      delete descry;
      return false;
     }
   uint window=descr.window;
   uint count=prev_count;
Extralongerモジュールの出力として、後続の処理ですぐに利用できる、整形済みの予測値ブロックが得られます。 ただし、このモジュールにデータを入力する前に、一次差分の特徴量を追加してデータの情報を充実させていたことを忘れてはなりません。 この手法により、時系列の情報量は増えましたが、同時にデータの次元数も増加しました。
この問題を解決する最も簡単な方法は、余分な特徴量を単に捨てることのように思えます。 しかし、この方法では、そもそも一次差分を導入して得ようとした情報そのものが失われてしまいます。 単純化された解法ではなく、畳み込み層を採用しています。これにより、次元削減ができるだけでなく、最も重要な局所的なパターンを選別することも可能です。 その結果、モジュールの出力にはきめ細かなフィルタリングが施され、取引判断に必要な重要な特性をすべて保持したまま、データがよりコンパクトになります。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Environmental-State Encoderの最後の構成要素は、逆正規化層(defNeuronRevInDenormOCL)です。 この層は、値を分析対象データのスケールに戻し、エンコーディングと正規化の過程で生じたオフセットを解消します。 これにより、結果を実際の市場の値と比較できるようになります。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
ActorモデルとCriticモデルのアーキテクチャは、これまでの研究で用いたものをそのまま採用しており、変更は一切加えていません。 だからこそ、この記事ではその点について詳しく触れることはしません。 全体像を把握していただくために、付録には学習可能なすべてのモデルのアーキテクチャに関する詳細な説明が掲載されています。そこでは、実装の細部まで追跡し、構築されたソリューションの整合性を確認することができます。
テスト
モデルの学習は、取引に向けた包括的な準備です。 実際の市場に投入する前に、過去データを用いて、この戦略のバックテストを徹底的に実施しました。 第1段階のオフライン学習では、通貨ペアEURUSDのH1時間足データのうち、2024年1月から2025年6月までの期間のサンプルを使用しました。 この期間は、実に豊かで変化に富んだものとなりました。横ばい相場が続く穏やかな局面と、急激なトレンド相場が交互に現れ、ニュースの発表時にはボラティリティが急上昇しました。 こうした条件が相まって、このモデルは、複雑な状況でも方向を見失うことなく、幅広い市場シナリオを区別し、堅実な取引判断を下せるよう学習することができました。
準備の第1段階が完了すると、第2段階であるオンライン微調整へと進みました。この段階は、MetaTrader 5のストラテジーテスターで実施しました。 ここでは、データがリアルタイムでローソク足1本ずつ届き、モデルはライブデータストリーム上で動作する際の動的な特性を学習しました。市場のノイズの中でも安定性を維持し、流動性の低さに対処し、急激な価格変動の際にも適切に動作し続けることを学びました。 この段階は、いわば戦略を磨き上げる役割を果たしました。 この段階で、過去のデータに基づいて構築されたフレームワークそのものが変わったわけではありませんが、実際の運用条件への適応が進み、過学習のリスクが低減しました。
最終テストは2025年7月のデータを用いて実施しました。このデータはそれまで使用されておらず、モデルにとってはまったく新しいものでした。 前の段階で得られたすべてのパラメータは、変更を加えることなく読み込まれました。 この完全なアウトオブサンプルテストにより、微調整や調整を一切行わずに、モデルの汎化能力を客観的に評価することができました。
テストの結果を以下に示します。


このテスト結果により、調整を加えることなく、実際の市場環境下でモデルを評価することが可能になります。 まずは主要な数値から見ていきましょう。 初期預入額100米ドルの場合、最終的な純利益は3.02米ドルとなり、1か月のテスト期間中に残高が3パーセント増加したことになります。 総利益は27.26米ドルに達し、総損失は24.24米ドルでした。プロフィットファクターは1.12でした。 これは、利益が出た取引が損失が出た取引をわずかに上回っていることを示唆しています。
しかし、弱点もあります。リカバリーファクターはわずか0.22です。 これは、損失が続いた後、モデルが資金を回復するまでに時間がかかることを意味します。 最大残高ドローダウンは12.75%でした。これはかなり大きな数値ですが、完全自動取引においては致命的な水準ではありません。 1取引あたりの期待値は平均0.06米ドルと控えめでしたが、シャープレシオ(3.04)は、ボラティリティを考慮すると、リスクに対するリターンが良好であることを示しています。
取引統計も興味深いものです。 取引は合計50件あり、そのうち28件が売り取引(勝率53.57%)、22件が買い取引(勝率はわずか36.36%)でした。 全体として、利益が出た取引の割合は46%でした。 1回の取引における最大の利益は6.70米ドル、最大の損失は4.73米ドルでした。 連勝・連敗の傾向も示唆に富むものでした。このモデルの最大連勝数は5回で、最大連敗数は3回にとどまりました。
資産曲線も、数値が示す状況を裏付けています。 7月の最初の数日間は変動があり、ドローダウンが相次ぎましたが、その後、残高は徐々に上昇し始めました。 月の中旬には、利益の出る取引が何度か続き、資産はプラス圏に転じました。 7月の終わり頃になると、状況は落ち着き、結果も安定して推移し、新たな急落は見られませんでした。
このように、テストの結果、このモデルはリスクとリターンのバランスを保ちつつ、適度なリターンを生み出せることが示されました。 ただし、テスト期間がかなり短いため、本番環境への導入にはさらなる最適化が必要となるでしょう。 何よりもまず、これはドローダウンを軽減し、利益が出る取引の割合を高めることを意味します。 しかし最も重要なのは、このシステムが新しいデータを用いた厳密なアウトオブサンプルテストに合格し、汎化能力を実証したことです。これは、アルゴリズムモデルの品質を判断するうえで重要な基準となります。
また、Transformerの学習は、大規模な学習データセットを必要とするかなり複雑なプロセスであることも忘れてはなりません。
結論
今回の取り組みを通じて、Extralongerフレームワークが提案するアプローチは、空間的要因と時間的要因をシームレスに統合し、市場動向を分析するための強固な基盤を形成できることがわかりました。
テストによりアルゴリズムの実用的な有効性が確認されました。また、アーキテクチャが柔軟であるため、このシステムをさまざまな予測期間や金融商品の種類に対応させることができます。 MQL5での実装により、従来の手法を最新のニューラルネットワーク手法と組み合わせることで、より複雑なシステムに匹敵する結果が得られると同時に、高い透明性と管理しやすさを維持できることが明らかになりました。
リンク
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19564
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。



